> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-ocr-2.md).
# DeepSeek-OCR 2 : guide d'exécution et de fine-tuning
Guide pour exécuter et fine-tuner DeepSeek-OCR-2 localement.
**DeepSeek-OCR 2** est le nouveau modèle de 3 milliards de paramètres pour la vision de pointe et la compréhension des documents, publié le 27 janvier 2026 par DeepSeek. Le modèle se concentre sur l’image vers texte avec un raisonnement visuel plus puissant, et pas seulement sur l’extraction de texte.
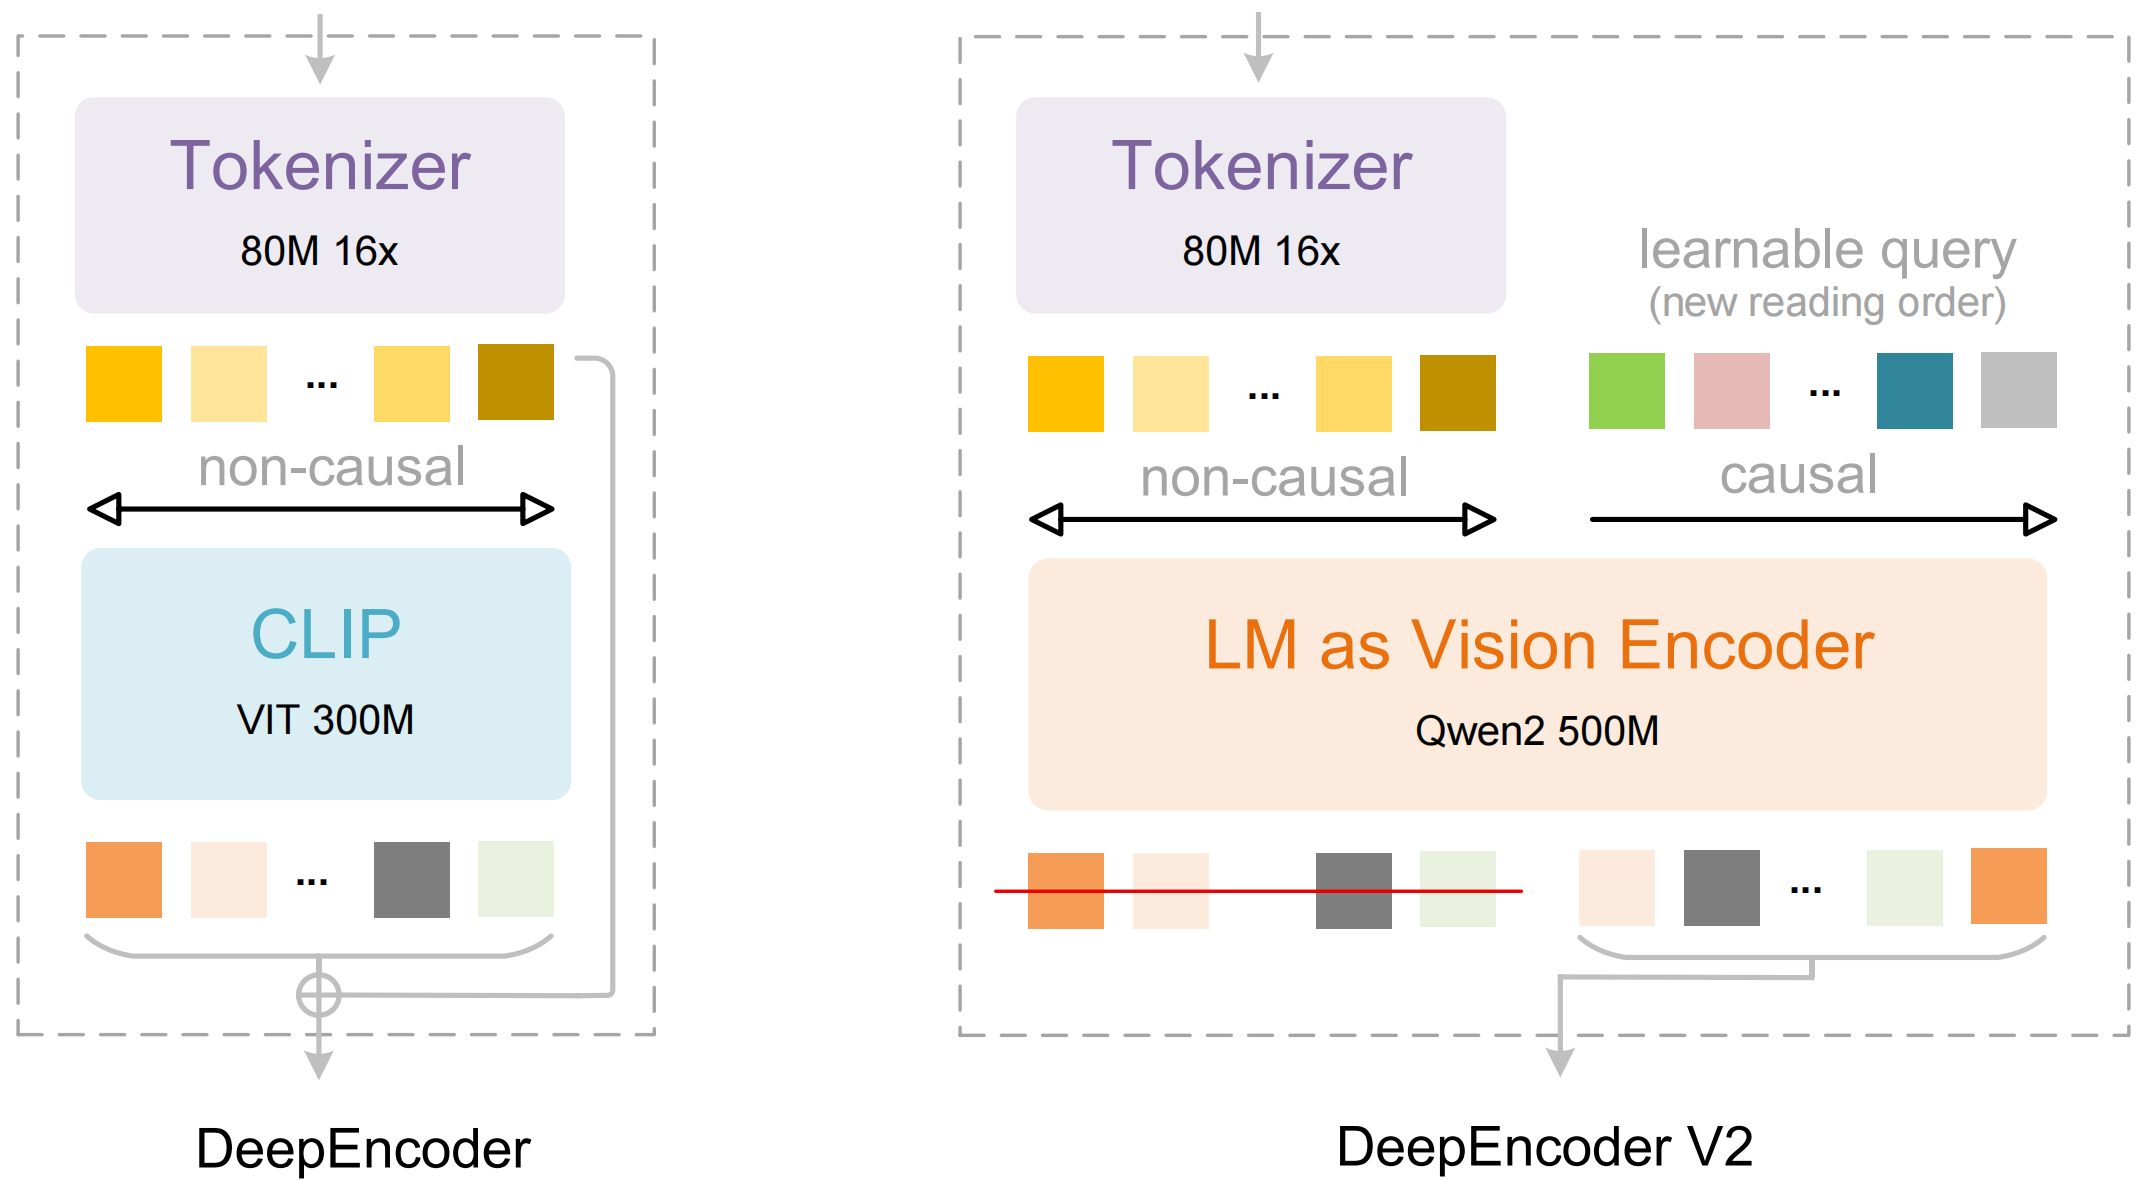
DeepSeek-OCR 2 introduit DeepEncoder V2, qui permet au modèle de « voir » une image dans le même ordre logique qu’un humain.
Contrairement aux LLM de vision traditionnels qui analysent les images selon une grille fixe (de haut à gauche → en bas à droite), DeepEncoder V2 construit d’abord une compréhension globale, puis apprend un ordre de lecture semblable à celui d’un humain : quoi regarder en premier, ensuite, et ainsi de suite. Cela améliore l’OCR sur les mises en page complexes en suivant mieux les colonnes, en reliant les étiquettes aux valeurs, en lisant les tableaux de manière cohérente et en gérant le texte mixte + la structure.
Vous pouvez désormais affiner DeepSeek-OCR 2 dans Unsloth via notre [**notebook d’affinage gratuit**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\).ipynb)**.** Nous avons démontré une [amélioration de 88,6 %](#fine-tuning-deepseek-ocr) pour la compréhension du langage.
Exécution de DeepSeek-OCR 2Affinage de DeepSeek-OCR 2
## 🖥️ **Exécution de DeepSeek-OCR 2**
Pour exécuter le modèle, comme pour le premier modèle, DeepSeek-OCR 2 a été modifié afin de permettre l’inférence et l’entraînement sur les dernières versions de transformers (aucun changement de précision). Vous pouvez trouver [ici](https://huggingface.co/unsloth/DeepSeek-OCR-2).
Pour exécuter le modèle dans [transformers](#transformers-run-deepseek-ocr-2-tutorial) ou [Unsloth](#unsloth-run-deepseek-ocr-tutorial), voici les paramètres recommandés :
### :gear: Paramètres recommandés
DeepSeek recommande ces paramètres :
* **Température = 0,0**
* `max_tokens = 8192`
* `ngram_size = 30`
* `window_size = 90`
**Modes pris en charge - Résolution dynamique :**
* Par défaut : (0-6)×768×768 + 1×1024×1024 — (0-6)×144 + 256 jetons visuels
**Exemples d’invites :**
```
# document : \n<|grounding|>Convertissez le document en markdown.
# autre image : \n<|grounding|>Faites l’OCR de cette image.
# sans mise en page : \nOCR libre.
# figures dans le document : \nAnalysez la figure.
# général : \nDécrivez cette image en détail.
# rec : \nLocalisez <|ref|>xxxx<|/ref|> dans l’image.
```
Transforme n’importe quel document en markdown à l’aide de Visual Causal Flow.
### 🦥 Unsloth : tutoriel pour exécuter DeepSeek-OCR 2
1. Obtenez la dernière version `unsloth` via `pip install --upgrade unsloth` . Si vous avez déjà Unsloth, mettez-le à jour via `pip install --upgrade --force-reinstall --no-deps --no-cache-dir unsloth unsloth_zoo`
2. Utilisez ensuite le code ci-dessous pour exécuter DeepSeek-OCR 2 :
{% code overflow="wrap" %}
```python
from unsloth import FastVisionModel
import torch
from transformers import AutoModel
import os
os.environ["UNSLOTH_WARN_UNINITIALIZED"] = '0'
from huggingface_hub import snapshot_download
snapshot_download("unsloth/DeepSeek-OCR-2", local_dir = "deepseek_ocr")
model, tokenizer = FastVisionModel.from_pretrained(
"./deepseek_ocr",
load_in_4bit = False, # Utilisez le 4 bits pour réduire l’utilisation de la mémoire. False pour LoRA 16 bits.
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth", # True ou "unsloth" pour les contextes longs
)
prompt = "\nOCR libre. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(tokenizer, prompt=prompt, image_file=image_file, output_path = output_path, base_size = 1024, image_size = 640, crop_mode=True, save_results = True, test_compress = False)
```
{% endcode %}
### 🤗 Transformers : tutoriel pour exécuter DeepSeek-OCR 2
Inférence à l’aide de Hugging Face transformers sur des GPU NVIDIA. Exigences testées sur python 3.12.9 + CUDA 11.8 :
```bash
torch==2.6.0
transformers==4.46.3
tokenizers==0.20.3
einops
addict
easydict
pip install flash-attn==2.7.3 --no-build-isolation
```
```python
from transformers import AutoModel, AutoTokenizer
import torch
import os
os.environ["CUDA_VISIBLE_DEVICES"] = '0'
model_name = 'unsloth/DeepSeek-OCR-2'
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModel.from_pretrained(model_name, _attn_implementation='flash_attention_2', trust_remote_code=True, use_safetensors=True)
model = model.eval().cuda().to(torch.bfloat16)
# prompt = "\nOCR libre. "
prompt = "\n<|grounding|>Convertissez le document en markdown. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(tokenizer, prompt=prompt, image_file=image_file, output_path = output_path, base_size = 1024, image_size = 768, crop_mode=True, save_results = True)
```
## 🦥 **Affinage de DeepSeek-OCR 2**
Unsloth prend désormais en charge l’affinage de DeepSeek-OCR 2. Comme pour le premier modèle, vous devrez utiliser notre [téléversement personnalisé](https://huggingface.co/unsloth/DeepSeek-OCR-2) pour que cela fonctionne sur `transformers` (aucun changement de précision). Comme pour le premier modèle, Unsloth entraîne DeepSeek-OCR-2 1,4× plus vite avec 40 % de VRAM en moins et des longueurs de contexte 5× plus longues, sans dégradation de la précision.\
\
Vous pouvez désormais affiner DeepSeek-OCR 2 via notre notebook Colab gratuit.
* DeepSeek-OCR 2 : [Notebook réservé à l’affinage](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_2_\(3B\).ipynb)
Voir ci-dessous les améliorations de précision du CER (Character Error Rate) pour la langue persane :
#### CER par échantillon (10 échantillons)
| idx | OCR1 avant | OCR1 après | OCR2 avant | OCR2 après |
| ---- | ---------: | ---------: | ---------: | ---------: |
| 1520 | 1.0000 | 0.8000 | 10.4000 | 1.0000 |
| 1521 | 0.0000 | 0.0000 | 2.6809 | 0.0213 |
| 1522 | 2.0833 | 0.5833 | 4.4167 | 1.0000 |
| 1523 | 0.2258 | 0.0645 | 0.8710 | 0.0968 |
| 1524 | 0.0882 | 0.1176 | 2.7647 | 0.0882 |
| 1525 | 0.1111 | 0.1111 | 0.9444 | 0.2222 |
| 1526 | 2.8571 | 0.8571 | 4.2857 | 0.7143 |
| 1527 | 3.5000 | 1.5000 | 13.2500 | 1.0000 |
| 1528 | 2.7500 | 1.5000 | 1.0000 | 1.0000 |
| 1529 | 2.2500 | 0.8750 | 1.2500 | 0.8750 |
#### CER moyen (10 échantillons)
* **OCR1 :** avant **1.4866**, après **0.6409** (**-57%**)
* **OCR2 :** avant **4.1863**, après **0.6018** (**-86%**)
## 📊 Benchmarks
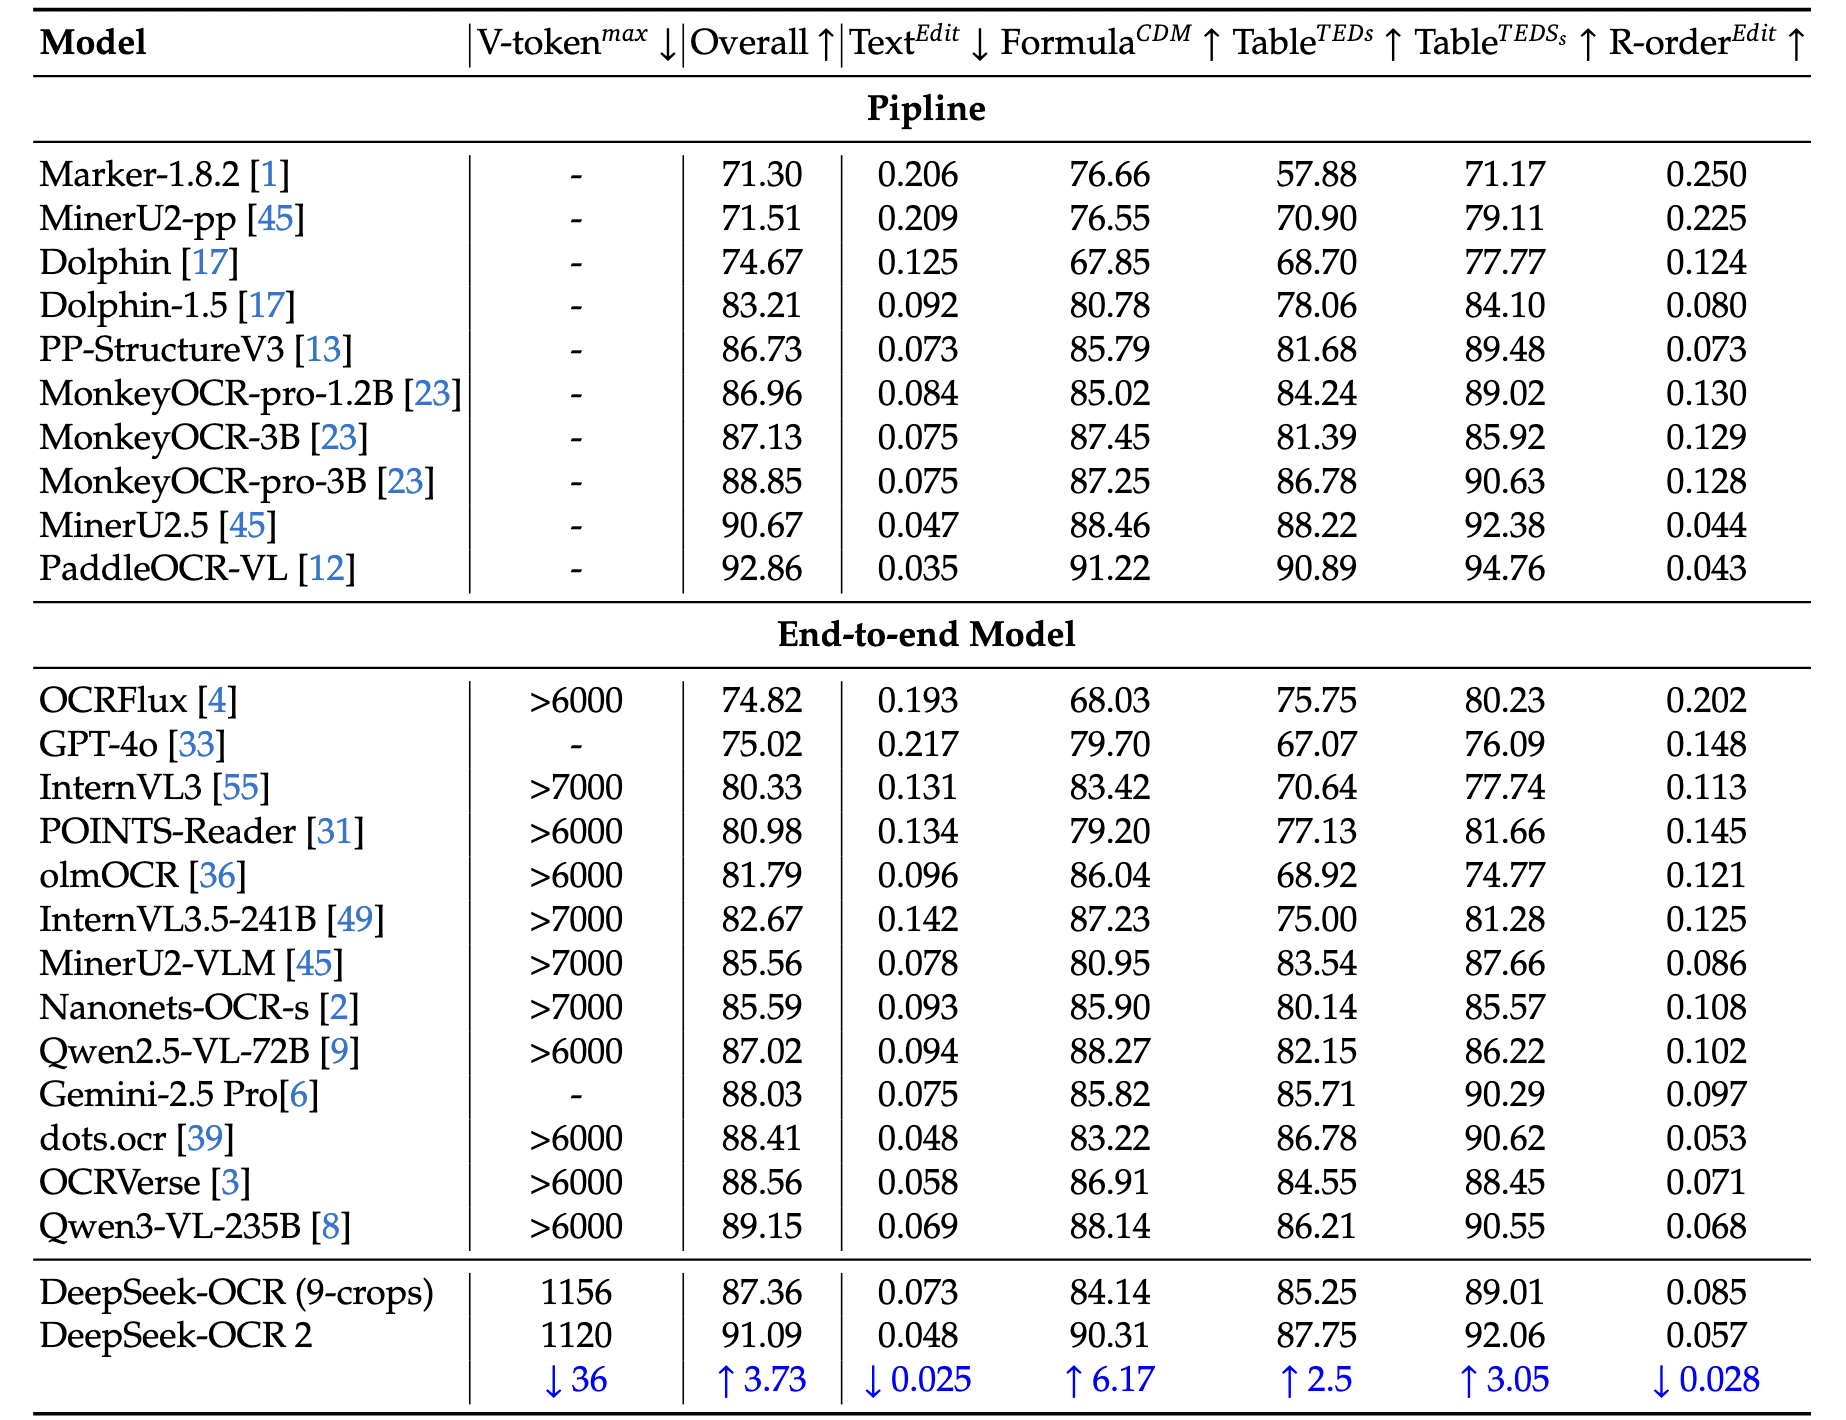
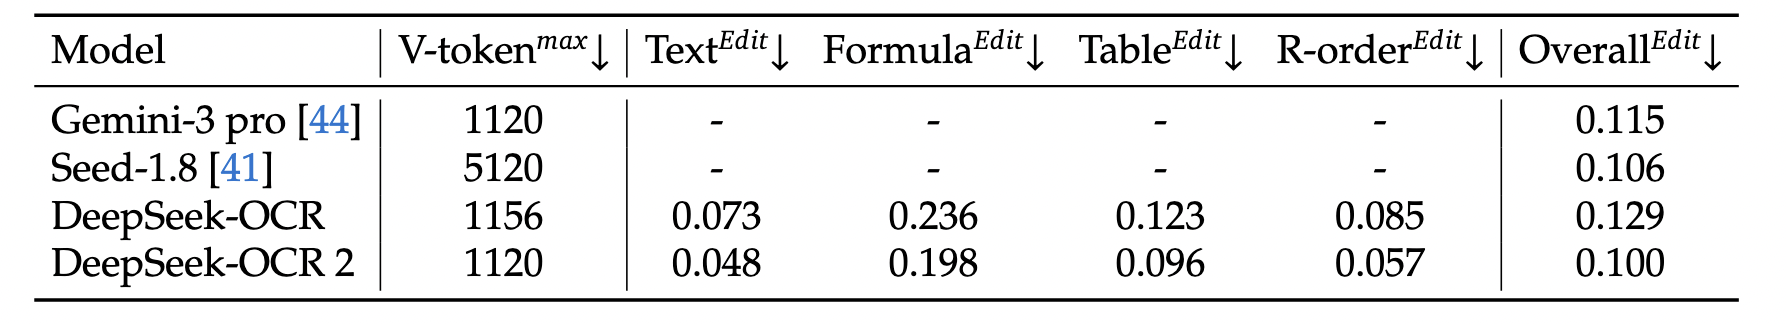
Les benchmarks du modèle DeepSeek-OCR 2 sont tirés de l’article de recherche officiel.
**Tableau 1 :** Évaluation complète de la lecture de documents sur OmniDocBench v1.5. V-tokenmax\
représente le nombre maximum de jetons visuels utilisés par page dans ce benchmark. R-order\
désigne l’ordre de lecture. À l’exception de DeepSeek OCR et DeepSeek OCR 2, tous les autres résultats de modèles\
dans ce tableau proviennent du dépôt OmniDocBench.
**Tableau 2 :** Distances d’édition pour différentes catégories d’éléments de document dans OmniDocBench v1.5.\
V-tokenmax désigne le nombre maximum le plus faible de jetons visuels.
Surpasse Gemini-3 Pro sur OmniDocBench
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-ocr-2.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.