> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/how-to-run-llms-with-docker.md).

# Comment exécuter des LLM locaux avec Docker : guide étape par étape

Découvrez comment exécuter des grands modèles de langage (LLM) avec Docker et Unsloth sur votre appareil local.

Vous pouvez désormais exécuter n’importe quel modèle, y compris Unsloth [GGUF dynamiques](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md), sur Mac, Windows ou Linux avec une seule ligne de code ou **aucun code** du tout. Nous avons collaboré avec Docker pour simplifier le déploiement des modèles, et Unsloth alimente désormais la plupart des modèles GGUF sur Docker.

Avant de commencer, assurez-vous de consulter [les exigences matérielles](#hardware-info--performance) et [nos conseils](#hardware-info--performance) pour optimiser les performances lors de l’exécution de LLM sur votre appareil.

<a href="/docs/fr/modeles/tutorials/how-to-run-llms-with-docker.md#method-1-docker-terminal" class="button primary">Tutoriel du terminal Docker</a><a href="#method-2-docker-desktop-no-code" class="button primary">Tutoriel Docker sans code</a>

Pour commencer, exécutez OpenAI [gpt-oss](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md) avec une seule commande :

```bash
docker model run ai/gpt-oss:20B
```

Ou pour exécuter un [modèle Unsloth](/docs/fr/commencer/unsloth-model-catalog.md) / quantification depuis Hugging Face :

```bash
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:F16
```

{% hint style="success" %}
Vous n’avez pas besoin de Docker Desktop ; Docker CE suffit pour exécuter des modèles.
{% endhint %}

#### **Pourquoi Unsloth + Docker ?**

Nous collaborons avec des laboratoires de modèles comme Google Gemma pour corriger les bugs des modèles et améliorer la précision. Nos GGUF dynamiques surpassent systématiquement les autres méthodes de quantification, vous offrant une inférence efficace et très précise.

Si vous utilisez Docker, vous pouvez exécuter des modèles instantanément sans aucune configuration. Docker utilise [Docker Model Runner](https://github.com/docker/model-runner) (DMR), qui vous permet d’exécuter des LLM aussi facilement que des conteneurs, sans problème de dépendances. DMR utilise des modèles Unsloth et `llama.cpp` sous le capot pour une inférence rapide, efficace et à jour.

## :gear: Infos sur le matériel + performances

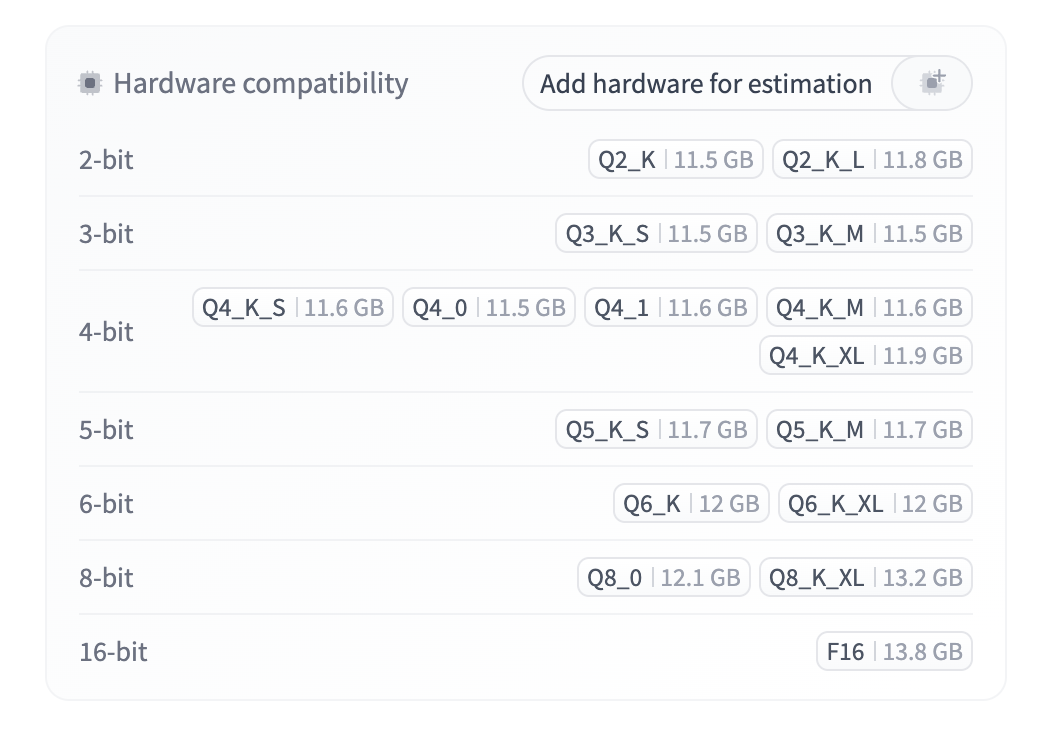
Pour de meilleures performances, essayez de faire en sorte que votre VRAM + RAM combinées soient au moins égales à la taille du modèle quantifié que vous téléchargez. Si vous en avez moins, le modèle fonctionnera quand même, mais beaucoup plus lentement.

Assurez-vous également que votre appareil dispose de suffisamment d’espace disque pour stocker le modèle. Si votre modèle tient tout juste en mémoire, vous pouvez vous attendre à environ \~5 tokens/s, selon la taille du modèle.

Disposer de RAM/VRAM supplémentaire améliore la vitesse d’inférence, et une VRAM additionnelle offrira le plus grand gain de performances (à condition que l’ensemble du modèle tienne)

{% hint style="info" %}
**Exemple :** Si vous téléchargez gpt-oss-20b (F16) et que le modèle fait 13,8 Go, assurez-vous que votre espace disque et votre RAM + VRAM soient > 13,8 Go.
{% endhint %}

**Recommandations de quantification :**

* Pour les modèles de moins de 30B paramètres, utilisez au moins une quantification 4 bits (Q4).
* Pour les modèles de 70B paramètres ou plus, utilisez une quantification minimale de 2 bits (par ex. UD\_Q2\_K\_XL).

## ⚡ Tutoriels étape par étape

Voici **deux façons** d’exécuter des modèles avec Docker : l’une utilisant le [terminal](#method-1-docker-terminal), et l’autre utilisant [Docker Desktop](#method-2-docker-desktop-no-code) sans code :

### Méthode n°1 : Terminal Docker

{% stepper %}
{% step %}

#### Installer Docker

Docker Model Runner est déjà disponible dans **les deux** [Docker Desktop](https://docs.docker.com/ai/model-runner/get-started/#docker-desktop) et [**Docker CE**](https://docs.docker.com/ai/model-runner/get-started/#docker-engine)**.**
{% endstep %}

{% step %}

#### Exécuter le modèle

Choisissez un modèle à exécuter, puis lancez la commande via le terminal.

* Parcourez le catalogue vérifié de modèles de confiance disponible sur [Docker Hub](https://hub.docker.com/r/ai) ou [la page Hugging Face d’Unsloth](https://huggingface.co/unsloth) .
* Allez dans le Terminal pour exécuter les commandes. Pour vérifier si vous avez `docker` installé, vous pouvez taper « docker » puis appuyer sur Entrée.
* Docker Hub lance par défaut Unsloth Dynamic 4 bits ; toutefois, vous pouvez sélectionner votre propre niveau de quantification (voir l’étape n°3).

Par exemple, pour exécuter OpenAI `gpt-oss-20b` en une seule commande :

```bash
docker model run ai/gpt-oss:20B
```

Ou pour exécuter un [Unsloth](/docs/fr/commencer/unsloth-model-catalog.md) quantification gpt-oss depuis Hugging Face :

```bash
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:UD-Q8_K_XL
```

**Voici à quoi devrait ressembler l’exécution de gpt-oss-20b via l’interface CLI :**

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FNQQGqQfLuX2a40i07Es1%2Funknown.png?alt=media&amp;token=6006e370-a298-4e5f-af9f-5c4e8c4a0fc8" alt="" width="563"><figcaption><p>gpt-oss-20b depuis Docker Hub</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFtzowkLonKo4N2LzEnhe%2Fgptoss%20ud8kxl.png?alt=media&amp;token=08eb6244-0626-4ad8-adbe-f5c4e5aa6d72" alt="" width="563"><figcaption><p>gpt-oss-20b avec la quantification UD-Q8_K_XL d’Unsloth</p></figcaption></figure></div>
{% endstep %}

{% step %}

#### Pour exécuter un niveau de quantification spécifique :

Si vous souhaitez exécuter une quantification précise d’un modèle, ajoutez `:` et le nom de la quantification au modèle (par ex. `Q4` pour Docker ou `UD-Q4_K_XL`). Vous pouvez consulter toutes les quantifications disponibles pour chaque modèle sur sa page Docker Hub. Par ex., voyez les quantifications सूचीées pour gpt-oss [ici](https://hub.docker.com/r/ai/gpt-oss#gptoss).

La même chose s’applique aux quantifications Unsloth sur Hugging Face : rendez-vous sur la [page HF du modèle](https://huggingface.co/unsloth/gpt-oss-20b-GGUF?show_file_info=gpt-oss-20b-Q2_K_L.gguf), choisissez une quantification, puis exécutez quelque chose comme : `docker model run hf.co/unsloth/gpt-oss-20b-GGUF:Q2_K_L`

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FI7MrphUugkU8eZ1f7lJz%2FScreenshot%202025-11-16%20at%2010.52.25%E2%80%AFPM.png?alt=media&amp;token=ae777fdb-258e-46d0-b06e-b68434f7fa58" alt="" width="563"><figcaption><p>niveaux de quantification gpt-oss sur <a href="https://hub.docker.com/r/ai/gpt-oss#gptoss">Docker Hub</a></p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F73UWIs9VAZ6Iz1omgZSm%2FScreenshot%202025-11-16%20at%2010.54.53%E2%80%AFPM.png?alt=media&amp;token=e8dee7f3-1b8b-4dda-a455-26df58102d16" alt="" width="563"><figcaption><p>niveaux de quantification gpt-oss Unsloth sur<a href="https://huggingface.co/unsloth/gpt-oss-20b-GGUF"> Hugging Face</a></p></figcaption></figure></div>
{% endstep %}
{% endstepper %}

### Méthode n°2 : Docker Desktop (sans code)

{% stepper %}
{% step %}

#### Installer Docker Desktop

Docker Model Runner est déjà disponible dans [Docker Desktop](https://docs.docker.com/ai/model-runner/get-started/#docker-desktop).

1. Choisissez un modèle à exécuter, ouvrez Docker Desktop, puis cliquez sur l’onglet des modèles.
2. Cliquez sur « Ajouter des modèles + » ou sur Docker Hub. Recherchez le modèle.

Parcourez le catalogue vérifié de modèles disponible sur [Docker Hub](https://hub.docker.com/r/ai).

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6R8uxbedMklVHsriLgpZ%2FScreenshot%202025-11-16%20at%206.36.49%E2%80%AFAM.png?alt=media&amp;token=0fb849f5-bc72-4883-9b25-1a756334ab4b" alt=""><figcaption><p>#1. Cliquez sur l’onglet « Modèles », puis sur « Ajouter des modèles + »</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fj7I69xgxDeHXkvVbjemq%2FScreenshot%202025-11-16%20at%206.46.47%E2%80%AFAM.png?alt=media&amp;token=3e25d495-f34b-47d6-9185-f145610eed10" alt=""><figcaption><p>#2. Recherchez le modèle souhaité.</p></figcaption></figure></div>
{% endstep %}

{% step %}

#### Récupérer le modèle

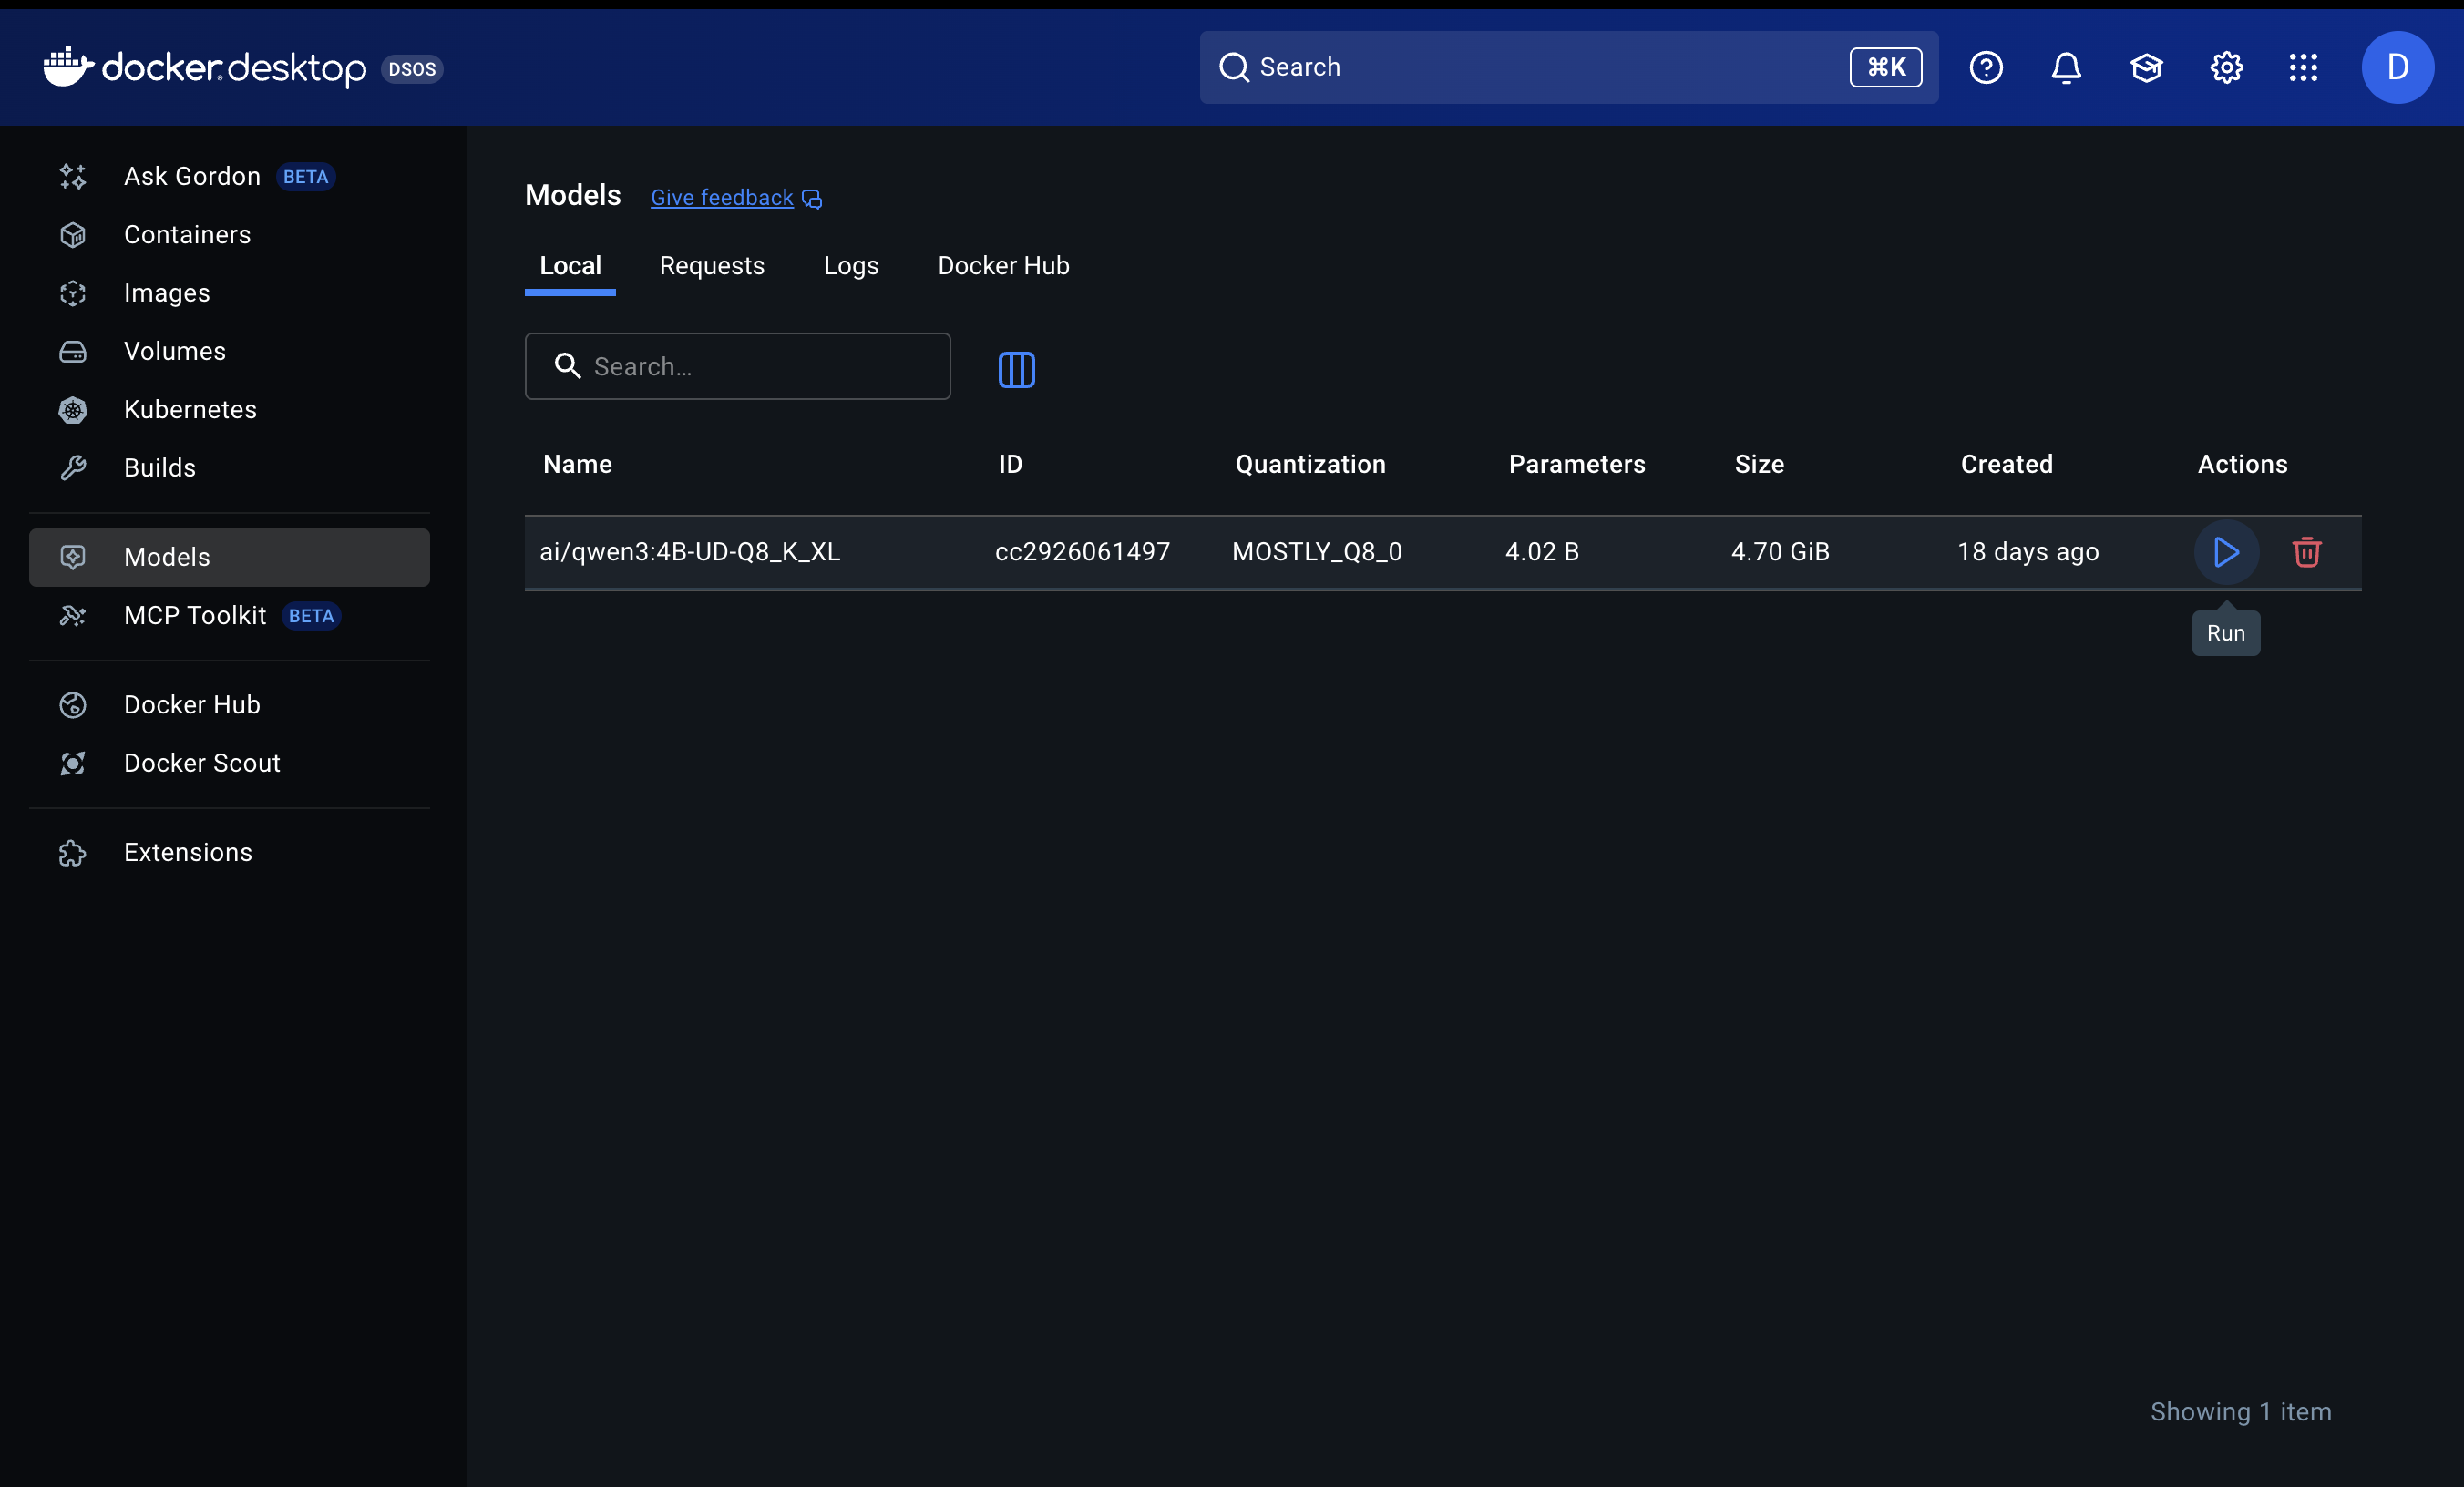
Cliquez sur le modèle que vous souhaitez exécuter pour voir les quantifications disponibles.

* Les quantifications vont de 1 à 16 bits. Pour les modèles de moins de 30B paramètres, utilisez au moins 4 bits (`Q4`).
* Choisissez une taille adaptée à votre matériel : idéalement, votre mémoire unifiée, votre RAM ou votre VRAM combinées devraient être égales ou supérieures à la taille du modèle. Par exemple, un modèle de 11 Go fonctionne bien sur 12 Go de mémoire unifiée.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FdQnwVwsMhYtWTzAGFih3%2FScreenshot%202025-11-16%20at%206.47.26%E2%80%AFAM.png?alt=media&amp;token=b1f0e29a-b3de-4d96-b79a-931441744565" alt=""><figcaption><p>#3. Sélectionnez la quantification que vous souhaitez récupérer.</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFGMZEXgQjBdVqP0vFTX3%2FScreenshot%202025-11-16%20at%206.54.09%E2%80%AFAM.png?alt=media&amp;token=b7f0c0d8-ebef-4e7e-99a9-c44c4c5f0844" alt=""><figcaption><p>#4. Attendez que le téléchargement du modèle soit terminé, puis lancez-le.</p></figcaption></figure></div>
{% endstep %}

{% step %}

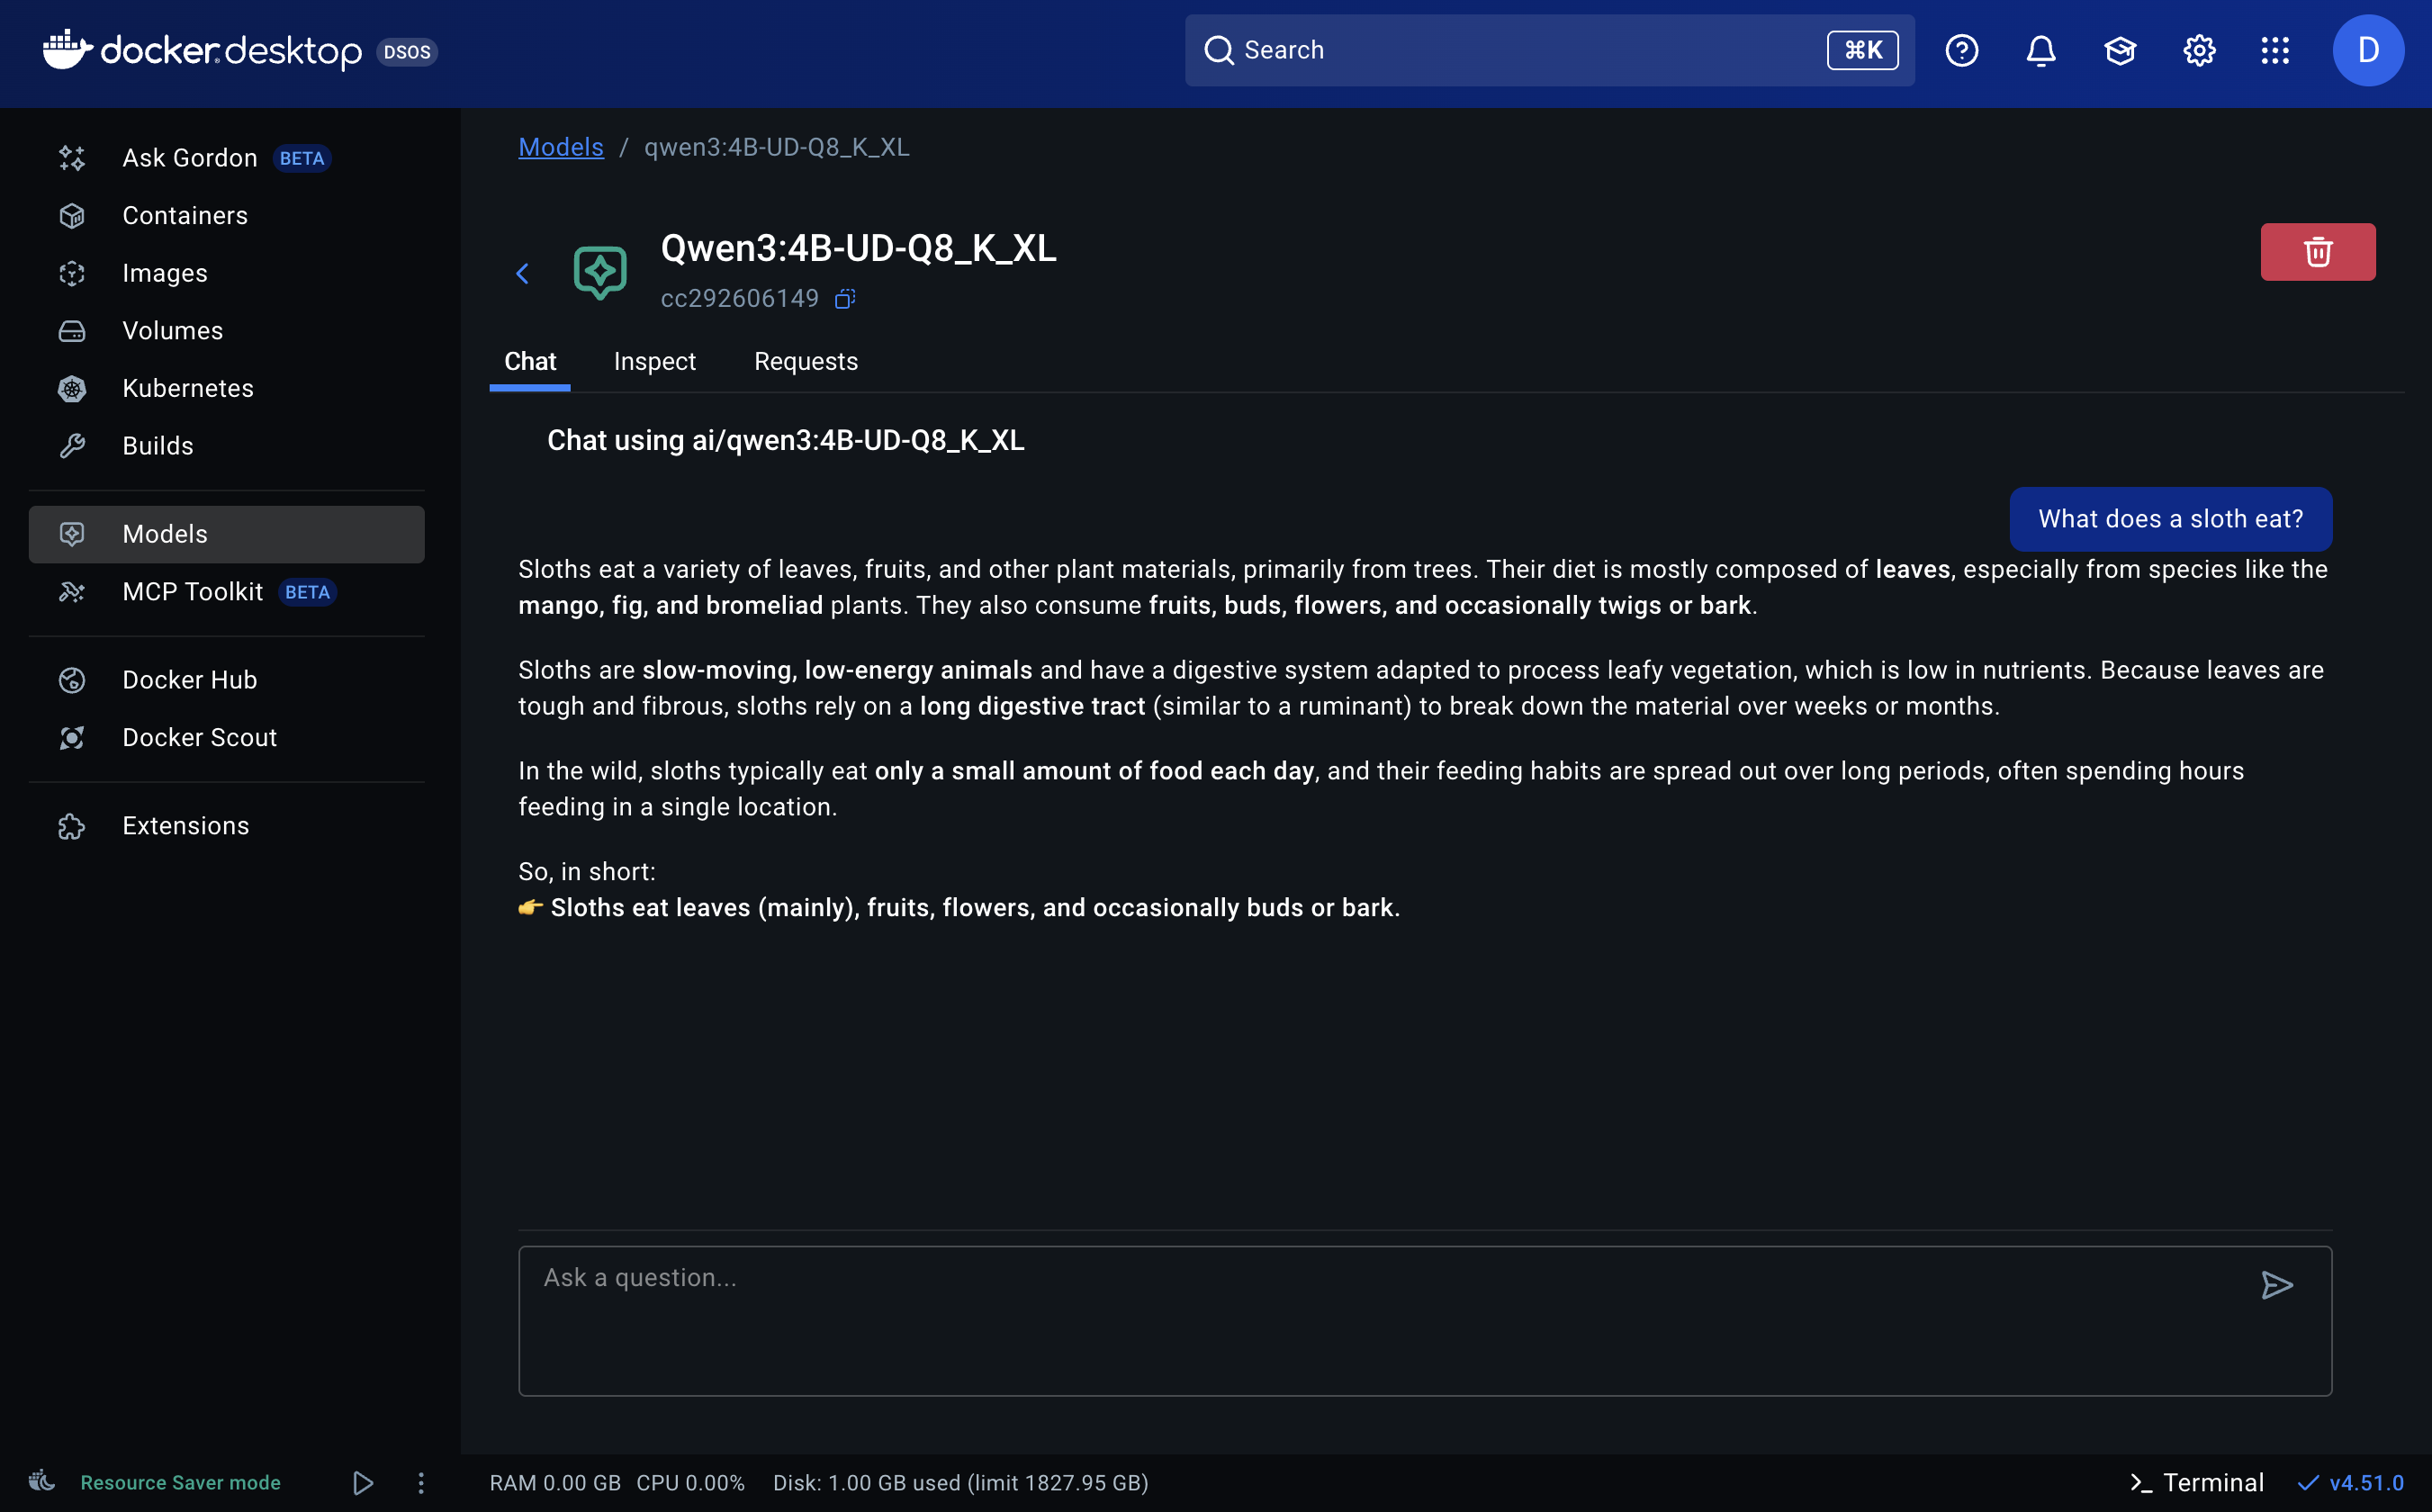
#### Exécuter le modèle

Saisissez n’importe quelle invite dans la boîte « Poser une question » et utilisez le LLM comme vous utiliseriez ChatGPT.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F9nVjWcVsYK9CeT8gk3nQ%2FScreenshot%202025-11-16%20at%206.54.50%E2%80%AFAM.png?alt=media&amp;token=d7e5b63d-9c3e-42b0-882c-de046bbcfc9a" alt="" width="563"><figcaption><p>Un exemple d’exécution de Qwen3-4B <code>UD-Q8_K_XL</code></p></figcaption></figure>
{% endstep %}
{% endstepper %}

#### **Pour exécuter les modèles les plus récents :**

Vous pouvez exécuter n’importe quel nouveau modèle sur Docker tant qu’il est pris en charge par `llama.cpp` ou `vllm` et disponible sur Docker Hub.

### Qu’est-ce que Docker Model Runner ?

Docker Model Runner (DMR) est un outil open source qui vous permet de récupérer et d’exécuter des modèles d’IA aussi facilement que vous exécutez des conteneurs. GitHub : <https://github.com/docker/model-runner>

Il fournit un environnement d’exécution cohérent pour les modèles, de la même manière que Docker a standardisé le déploiement des applications. Sous le capot, il utilise des backends optimisés (comme `llama.cpp`) pour une inférence fluide et efficace sur votre machine.

Que vous soyez chercheur, développeur ou amateur, vous pouvez désormais :

* Exécuter des modèles ouverts localement en quelques secondes.
* Éviter l’enfer des dépendances, tout est pris en charge dans Docker.
* Partager et reproduire des configurations de modèles sans effort.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/tutorials/how-to-run-llms-with-docker.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.