> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide.md).
# Guide de fine-tuning des LLM
Découvrez toutes les bases et les meilleures pratiques du fine-tuning. Adapté aux débutants.
## 1. Qu’est-ce que le fine-tuning ?
Le fine-tuning / l’entraînement / le post-entraînement des modèles personnalise leur comportement, améliore + injecte des connaissances et optimise les performances pour des domaines et des tâches spécifiques. Par exemple :
* d’OpenAI **GPT-5** a été post-entraîné pour améliorer le suivi des instructions et un comportement de chat utile.
* La méthode standard de post-entraînement s’appelle Supervised Fine-Tuning (SFT). Les autres méthodes incluent l’optimisation des préférences (DPO, ORPO), la distillation et [Apprentissage par renforcement (RL)](/docs/fr/commencer/reinforcement-learning-rl-guide.md) (GRPO, GSPO), où un « agent » apprend à prendre des décisions en interagissant avec un environnement et en recevant **des retours** sous forme de **récompenses** ou **pénalités**.
Avec [Unsloth](https://github.com/unslothai/unsloth), vous pouvez faire du fine-tuning ou du RL gratuitement sur Colab, Kaggle ou en local avec seulement 3 Go de VRAM en utilisant notre [notebooks](https://docs.unsloth.ai/get-started/unsloth-notebooks). En fine-tunant un modèle pré-entraîné sur un jeu de données, vous pouvez :
* **Mettre à jour + apprendre de nouvelles connaissances**: Injecter et apprendre de nouvelles informations spécifiques à un domaine.
* **Personnaliser le comportement**: Ajuster le ton, la personnalité ou le style de réponse du modèle.
* **Optimiser pour des tâches**: Améliorer la précision et la pertinence pour des cas d’usage spécifiques.
**Exemples de cas d’usage du fine-tuning ou du RL**:
* Permet aux LLM de prédire si un titre a un impact positif ou négatif sur une entreprise.
* Peut utiliser l’historique des interactions clients pour des réponses plus précises et personnalisées.
* Fine-tuner un LLM sur des textes juridiques pour l’analyse de contrats, la recherche en jurisprudence et la conformité.
Vous pouvez considérer un modèle fine-tuné comme un agent spécialisé conçu pour accomplir des tâches spécifiques de manière plus efficace et plus efficiente. **Le fine-tuning peut reproduire toutes les capacités du RAG**, mais pas l’inverse.
{% columns %}
{% column %}
#### :question:Qu’est-ce que LoRA/QLoRA ?
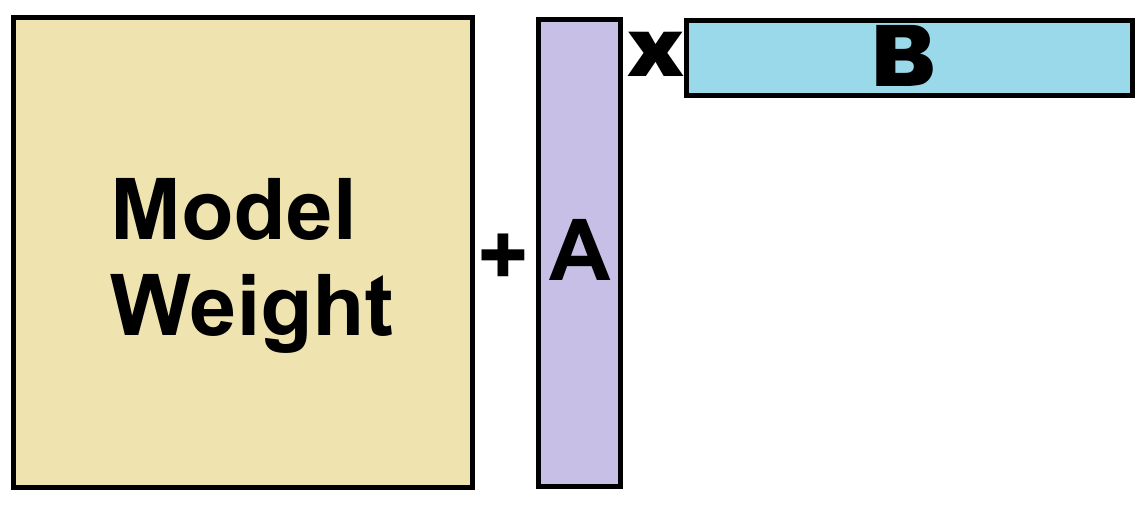
Dans les LLM, nous avons des poids de modèle. Llama 70B possède 70 milliards de nombres. Au lieu de modifier les 70 milliards de nombres, nous ajoutons plutôt de fines matrices A et B à chaque poids, et nous les optimisons. Cela signifie que nous n’optimisons que 1 % des poids. LoRA correspond au cas où le modèle d’origine est en 16 bits non quantifié, tandis que QLoRA quantifie en 4 bits pour économiser 75 % de mémoire.
{% endcolumn %}
{% column %}
Au lieu d’optimiser les poids du modèle (jaune), nous optimisons 2 fines matrices A et B.
{% endcolumn %}
{% endcolumns %}
#### Idées reçues sur le fine-tuning :
Vous avez peut-être entendu dire que le fine-tuning ne permet pas à un modèle d’apprendre de nouvelles connaissances ou que le RAG fonctionne mieux que le fine-tuning. C’est **false**. Vous pouvez entraîner un modèle de codage spécialisé avec le fine-tuning et le RL, tandis que le RAG ne peut pas modifier les poids du modèle et ne fait qu’augmenter ce que le modèle voit au moment de l’inférence. Lire plus de FAQ + idées reçues [ici](https://unsloth.ai/docs/fr/commencer/pages/a4c177d0cc0d485af2566701bc0c3f6f94175629#fine-tuning-vs.-rag-whats-the-difference):
{% content-ref url="/pages/a4c177d0cc0d485af2566701bc0c3f6f94175629" %}
[FAQ + Le fine-tuning est-il fait pour moi ?](/docs/fr/commencer/fine-tuning-for-beginners/faq-+-is-fine-tuning-right-for-me.md)
{% endcontent-ref %}
> [**Présentation d’Unsloth Studio :** ](/docs/fr/nouveau/studio.md) Notre nouvelle interface web open source pour entraîner et exécuter des modèles. Cela signifie que vous pouvez désormais fine-tuner des modèles sans code et disposer de fonctionnalités d’observabilité et de création automatique de jeux de données.
## 2. Choisir le bon modèle + la bonne méthode
Si vous débutez, il est préférable de commencer avec un petit modèle instruct comme Llama 3.1 (8B) et d’expérimenter à partir de là. Vous devrez aussi choisir entre le fine-tuning classique, le RL, l’entraînement QLoRA ou LoRA :
* **Apprentissage par renforcement (RL)** est utilisé lorsque vous avez besoin qu’un modèle excelle dans un comportement spécifique (par exemple, l’appel d’outils) en utilisant un environnement et une fonction de récompense plutôt que des données étiquetées. Nous avons plusieurs [exemples de notebooks](/docs/fr/commencer/unsloth-notebooks.md#grpo-reasoning-rl-notebooks), mais pour la plupart des cas d’usage, le SFT standard suffit.
* **LoRA** est une méthode d’entraînement économe en paramètres qui gèle généralement les poids du modèle de base et entraîne un petit ensemble de poids d’adaptateur à faible rang ajoutés (en précision 16 bits).
* **QLoRA** combine LoRA avec une précision 4 bits pour gérer de très grands modèles avec un minimum de ressources.
* Unsloth prend également en charge le fine-tuning complet (FFT) et le pré-entraînement, qui nécessitent beaucoup plus de ressources, mais le FFT est généralement inutile. Bien réalisé, LoRA peut égaler FFT.
* Unsloth **tous types de modèles**: [synthèse vocale](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md), [embedding](/docs/fr/notions-de-base/embedding-finetuning.md), GRPO, RL, [vision](/docs/fr/notions-de-base/vision-fine-tuning.md), multimodaux et plus encore.
{% hint style="info" %}
Les recherches montrent que **l’entraînement et le service dans la même précision** aident à préserver la précision. Cela signifie que si vous souhaitez servir en 4 bits, entraînez en 4 bits, et inversement.
{% endhint %}
Nous recommandons de commencer avec QLoRA, car c’est l’une des méthodes les plus accessibles et les plus efficaces pour entraîner des modèles. Nos [quantifications dynamiques 4 bits](https://unsloth.ai/blog/dynamic-4bit) quantifications, la perte de précision de QLoRA par rapport à LoRA est désormais en grande partie récupérée.
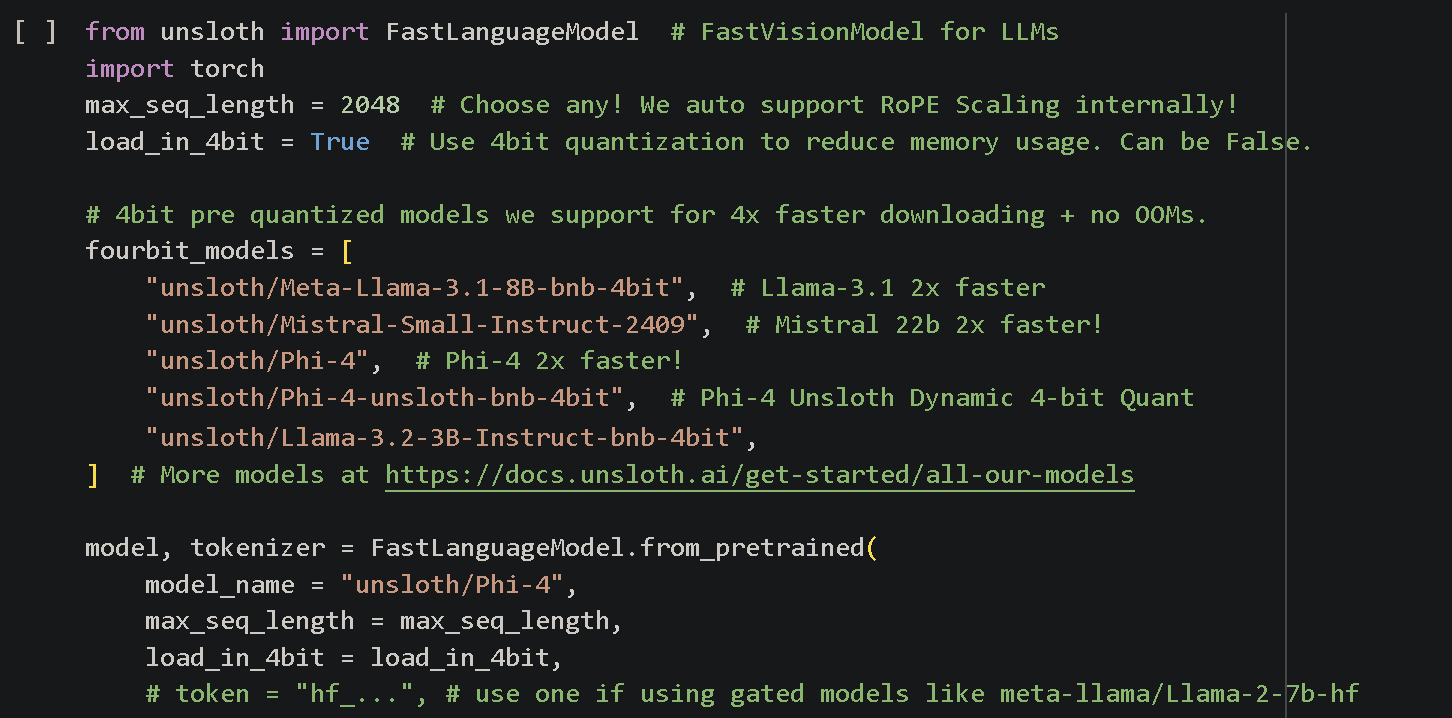
Vous pouvez changer le nom du modèle pour n’importe quel modèle de votre choix en l’associant au nom du modèle sur Hugging Face, par ex. '`unsloth/llama-3.1-8b-unsloth-bnb-4bit`'.
Nous recommandons de commencer avec **les modèles Instruct**, car ils permettent un fine-tuning direct à l’aide de modèles de chat conversationnels (ChatML, ShareGPT, etc.) et nécessitent moins de données que les **modèles Base** (qui utilisent Alpaca, Vicuna, etc.). En savoir plus sur les différences entre [les modèles instruct et base ici](/docs/fr/commencer/fine-tuning-llms-guide/what-model-should-i-use.md#instruct-or-base-model).
* Les noms de modèles se terminant par **`unsloth-bnb-4bit`** indiquent qu’il s’agit de [**quantifications dynamiques 4 bits d’Unsloth**](https://unsloth.ai/blog/dynamic-4bit) **des quantifs**. Ces modèles consomment légèrement plus de VRAM que les modèles BitsAndBytes 4 bits standard, mais offrent une précision nettement supérieure.
* Si le nom d’un modèle se termine simplement par **`bnb-4bit`**, sans « unsloth », cela fait référence à une quantification BitsAndBytes 4 bits standard.
* Les modèles avec **aucun suffixe** sont dans leurs formats originaux **16 bits ou 8 bits**. Bien qu’il s’agisse des modèles d’origine des créateurs officiels, nous incluons parfois des corrections importantes, comme des correctifs de modèle de chat ou de tokenizer. Il est donc recommandé d’utiliser nos versions lorsqu’elles sont disponibles.
Il existe d’autres paramètres que vous pouvez activer :
* **`max_seq_length = 2048`** – Contrôle la longueur du contexte. Bien que Llama-3 prenne en charge 8192, nous recommandons 2048 pour les tests. Unsloth permet un fine-tuning avec un contexte 4× plus long.
* **`dtype = None`** – Par défaut sur None ; utilisez `torch.float16` ou `torch.bfloat16` pour les GPU plus récents.
* **`load_in_4bit = True`** – Active la quantification 4 bits, réduisant l’utilisation de la mémoire d’un facteur 4 pour le fine-tuning. La désactiver active le fine-tuning LoRA en 16 bits. Vous pouvez aussi activer LoRA en 16 bits avec `load_in_16bit = True`
* Pour activer le fine-tuning complet (FFT), définissez `full_finetuning = True`. Pour un fine-tuning en 8 bits, définissez `load_in_8bit = True`.
* **Remarque :** Une seule méthode d’entraînement peut être réglée sur `Vrai` à la fois.
{% hint style="info" %}
Une erreur fréquente consiste à se lancer directement dans le fine-tuning complet (FFT), qui demande beaucoup de calcul. Commencez d’abord par tester avec LoRA ou QLoRA ; si cela ne fonctionne pas là, cela ne fonctionnera presque certainement pas avec FFT. Et si LoRA échoue, ne partez pas du principe que FFT va le résoudre par magie.
{% endhint %}
Vous pouvez aussi faire [Synthèse vocale (TTS)](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md), [raisonnement (GRPO)](/docs/fr/commencer/reinforcement-learning-rl-guide.md), [vision](/docs/fr/notions-de-base/vision-fine-tuning.md), [RL](/docs/fr/commencer/reinforcement-learning-rl-guide/preference-dpo-orpo-and-kto.md) (GRPO, DPO), [pré-entraînement continu](/docs/fr/notions-de-base/continued-pretraining.md), complétion de texte et d’autres méthodologies d’entraînement avec Unsloth.
{% columns %}
{% column %}
Lisez notre guide sur le choix des modèles :
{% content-ref url="/pages/6a7779ad1adc734a55034f8880a76401f04d84c5" %}
[What Model Should I Use?](/docs/fr/commencer/fine-tuning-llms-guide/what-model-should-i-use.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
Pour des tutoriels individuels sur les modèles :
{% content-ref url="/pages/41f2e6bbbe116f730cf3549300cf28972e8c72f4" %}
[Complete LLM Directory](/docs/fr/modeles/tutorials.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
## 3. Votre jeu de données
Pour les LLM, les jeux de données sont des collections de données qui peuvent être utilisées pour entraîner nos modèles. Afin d’être utiles à l’entraînement, les données textuelles doivent être dans un format pouvant être tokenisé.
* Vous devrez créer un jeu de données comportant généralement 2 colonnes - question et réponse. La qualité et la quantité se refléteront en grande partie dans le résultat final de votre fine-tuning, il est donc impératif de bien faire cette partie.
* Vous pouvez [générer des données de manière synthétique](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md#synthetic-data-generation) et structurer votre jeu de données (en paires question-réponse) à l’aide de ChatGPT ou de LLM locaux.
* Vous pouvez aussi utiliser notre nouveau notebook Synthetic Dataset, qui analyse automatiquement des documents (PDF, vidéos, etc.), génère des paires question-réponse et nettoie automatiquement les données à l’aide de modèles locaux comme Llama 3.2. [Accédez au notebook ici.](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Meta_Synthetic_Data_Llama3_2_\(3B\).ipynb)
* Le fine-tuning peut apprendre à partir d’un dépôt existant de documents et élargir continuellement sa base de connaissances, mais le simple fait d’y déverser des données ne fonctionnera pas aussi bien. Pour des résultats optimaux, constituez un jeu de données bien structuré, idéalement sous forme de paires question-réponse. Cela améliore l’apprentissage, la compréhension et la précision des réponses.
* Mais ce n’est pas toujours le cas, par exemple si vous fine-tunez un LLM pour le code, le simple fait de déverser toutes vos données de code peut en réalité permettre à votre modèle d’obtenir des améliorations significatives de performances, même sans formatage structuré. Tout dépend donc vraiment de votre cas d’usage.
***En savoir plus sur la création de votre jeu de données :***
{% content-ref url="/pages/106dfb3c53d8e4d182108e27a2e91ce2b4f38210" %}
[Guide des jeux de données](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md)
{% endcontent-ref %}
Pour la plupart de nos exemples de notebooks, nous utilisons le [jeu de données Alpaca](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset) cependant, d’autres notebooks comme Vision utiliseront des jeux de données différents, qui peuvent également nécessiter des images dans la sortie de réponse.
### 4. Comprendre les hyperparamètres d’entraînement
Apprenez à choisir les bons [hyperparamètres](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md) en utilisant les meilleures pratiques issues de la recherche et des expériences réelles - et comprenez comment chacun d’eux affecte les performances de votre modèle.
**Pour un guide complet sur la manière dont les hyperparamètres influencent l’entraînement, voir :**
{% content-ref url="/pages/f4254d24125c1e7ad4d5ad30f1a9c8f7d36e7c4d" %}
[Hyperparameters Guide](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md)
{% endcontent-ref %}
## 5. Installation + prérequis
Vous pouvez utiliser Unsloth de deux manières principales, via nos notebooks gratuits ou en local.
### Notebooks Unsloth
Nous recommandons aux débutants d’utiliser nos notebooks prêts à l’emploi [notebooks](/docs/fr/commencer/unsloth-notebooks.md) d’abord, car c’est le moyen le plus simple de commencer avec des étapes guidées. Vous pourrez ensuite exporter les notebooks pour les utiliser localement.
Unsloth propose des notebooks pas à pas pour [synthèse vocale](/docs/fr/notions-de-base/text-to-speech-tts-fine-tuning.md), [embedding](/docs/fr/notions-de-base/embedding-finetuning.md), GRPO, RL, [vision](/docs/fr/notions-de-base/vision-fine-tuning.md), le multimodal, différents cas d’usage et bien plus encore.
### Installation locale
Vous pouvez aussi installer Unsloth localement via [Docker](/docs/fr/commencer/install/docker.md) ou `pip install unsloth` (avec Linux, WSL ou [Windows](/docs/fr/commencer/install/windows-installation.md)). De plus, selon le modèle que vous utilisez, vous aurez besoin de suffisamment de VRAM et de ressources.
L’installation d’Unsloth nécessitera un appareil Windows ou Linux. Une fois Unsloth installé, vous pouvez copier-coller nos notebooks et les utiliser dans votre propre environnement local. Voir :
{% columns %}
{% column %}
{% content-ref url="/pages/47370eb8ad54f7198da9c5711a7d50efdf003784" %}
[Prérequis Unsloth](/docs/fr/commencer/fine-tuning-for-beginners/unsloth-requirements.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
{% content-ref url="/pages/7ffcb5efbe9e4cf09524c2b084bceb779bedad90" %}
[Installation](/docs/fr/commencer/install.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
## 6. Entraînement + évaluation
Une fois tout configuré, il est temps d’entraîner ! Si quelque chose ne fonctionne pas, n’oubliez pas que vous pouvez toujours modifier les hyperparamètres, votre jeu de données, etc.
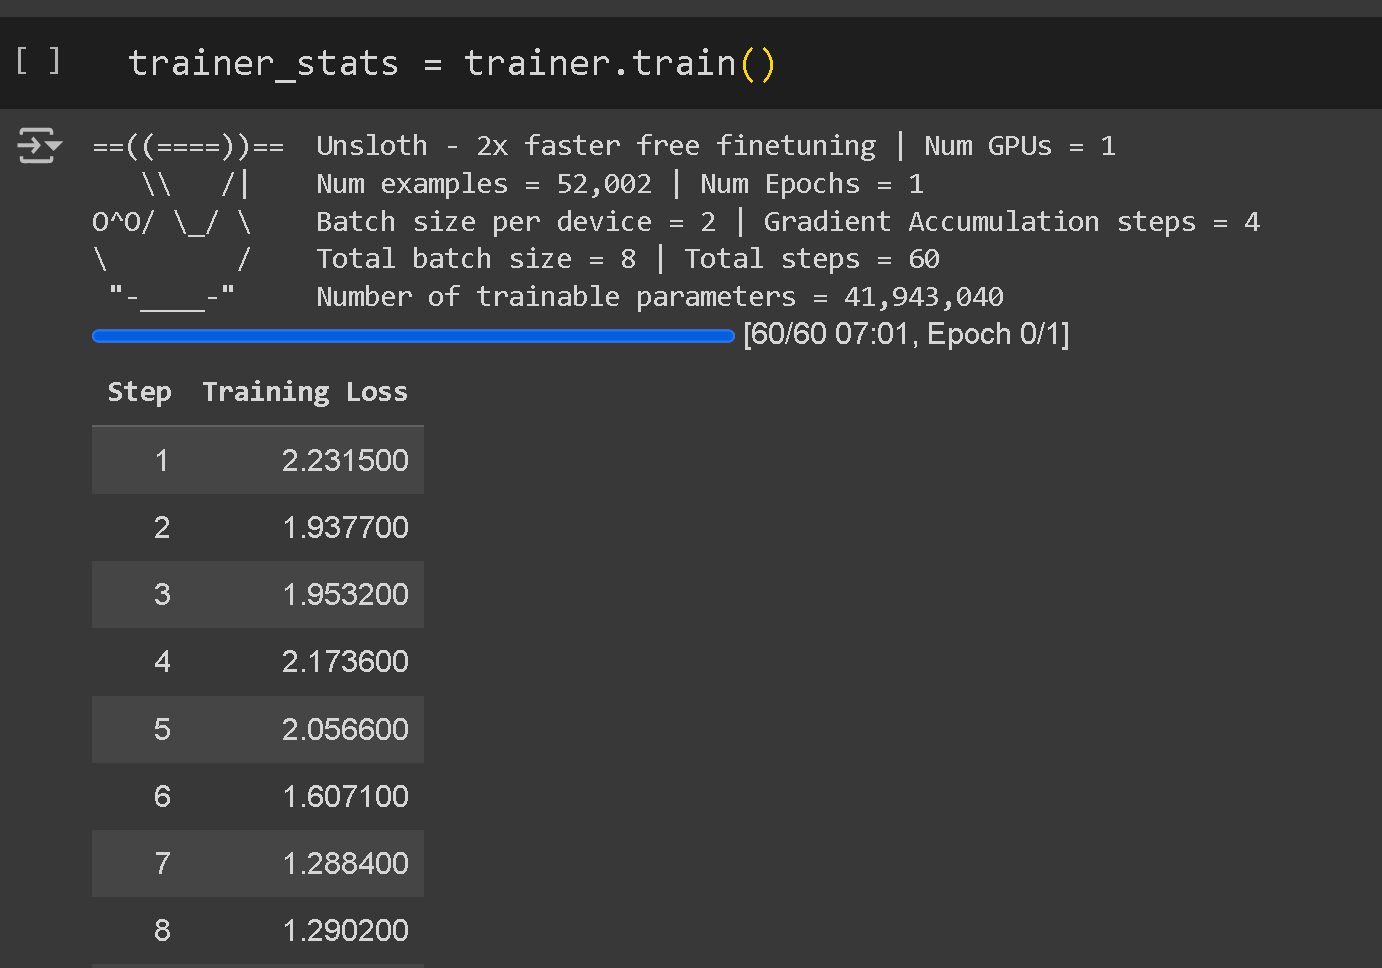
Vous verrez un journal de chiffres pendant l’entraînement. Il s’agit de la perte d’entraînement, qui montre à quel point le modèle apprend à partir de votre ensemble de données. Dans de nombreux cas, une perte autour de 0,5 à 1,0 est un bon signe, mais cela dépend de votre ensemble de données et de votre tâche. Si la perte ne diminue pas, vous devrez peut-être ajuster vos paramètres. Si la perte tombe à 0, cela pourrait signifier du surapprentissage, donc il est important de vérifier aussi la validation.
La perte d’entraînement apparaîtra sous forme de nombres
Nous recommandons généralement de conserver les paramètres par défaut, sauf si vous avez besoin d’un entraînement plus long ou de tailles de lot plus grandes.
* **`per_device_train_batch_size = 2`** – Augmentez-le pour une meilleure utilisation du GPU, mais attention à un entraînement plus lent en raison du remplissage. À la place, augmentez `gradient_accumulation_steps` pour un entraînement plus fluide.
* **`gradient_accumulation_steps = 4`** – Simule une taille de lot plus grande sans augmenter l’utilisation de la mémoire.
* **`max_steps = 60`** – Accélère l’entraînement. Pour des exécutions complètes, remplacez par `num_train_epochs = 1` (1 à 3 époques recommandées pour éviter le surapprentissage).
* **`learning_rate = 2e-4`** – Plus faible pour un fine-tuning plus lent mais plus précis. Essayez des valeurs comme `1e-4`, `5e-5`, ou `2e-5`.
#### Évaluation
Pour évaluer, vous pouvez effectuer une évaluation manuelle en discutant simplement avec le modèle pour voir s’il vous convient. Vous pouvez aussi activer l’évaluation pour Unsloth, mais gardez à l’esprit que cela peut prendre du temps selon la taille du jeu de données. Pour accélérer l’évaluation, vous pouvez : réduire la taille du jeu de données d’évaluation ou définir `evaluation_steps = 100`.
Pour les tests, vous pouvez également prendre 20 % de vos données d’entraînement et les utiliser pour les tests. Si vous avez déjà utilisé toutes les données d’entraînement, vous devrez alors l’évaluer manuellement. Vous pouvez aussi utiliser des outils d’évaluation automatique, mais gardez à l’esprit que ces outils automatisés peuvent ne pas correspondre parfaitement à vos critères d’évaluation.
## 7. Exécution + déploiement du modèle
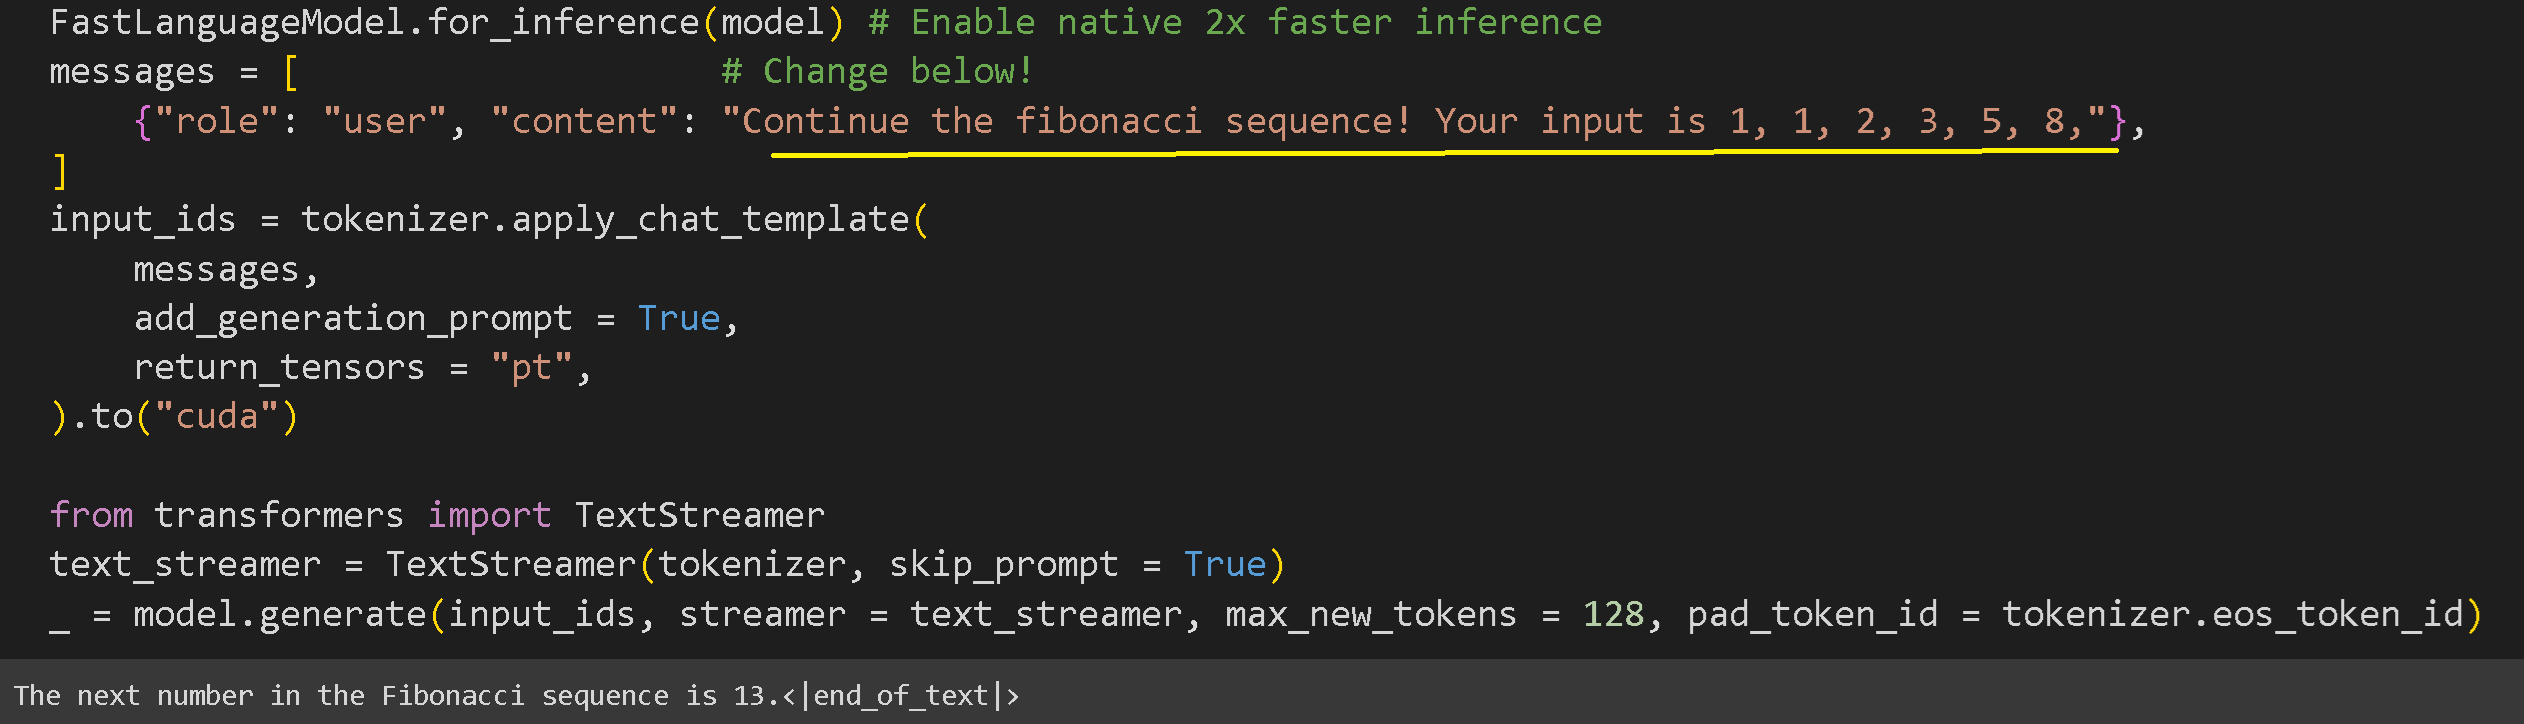
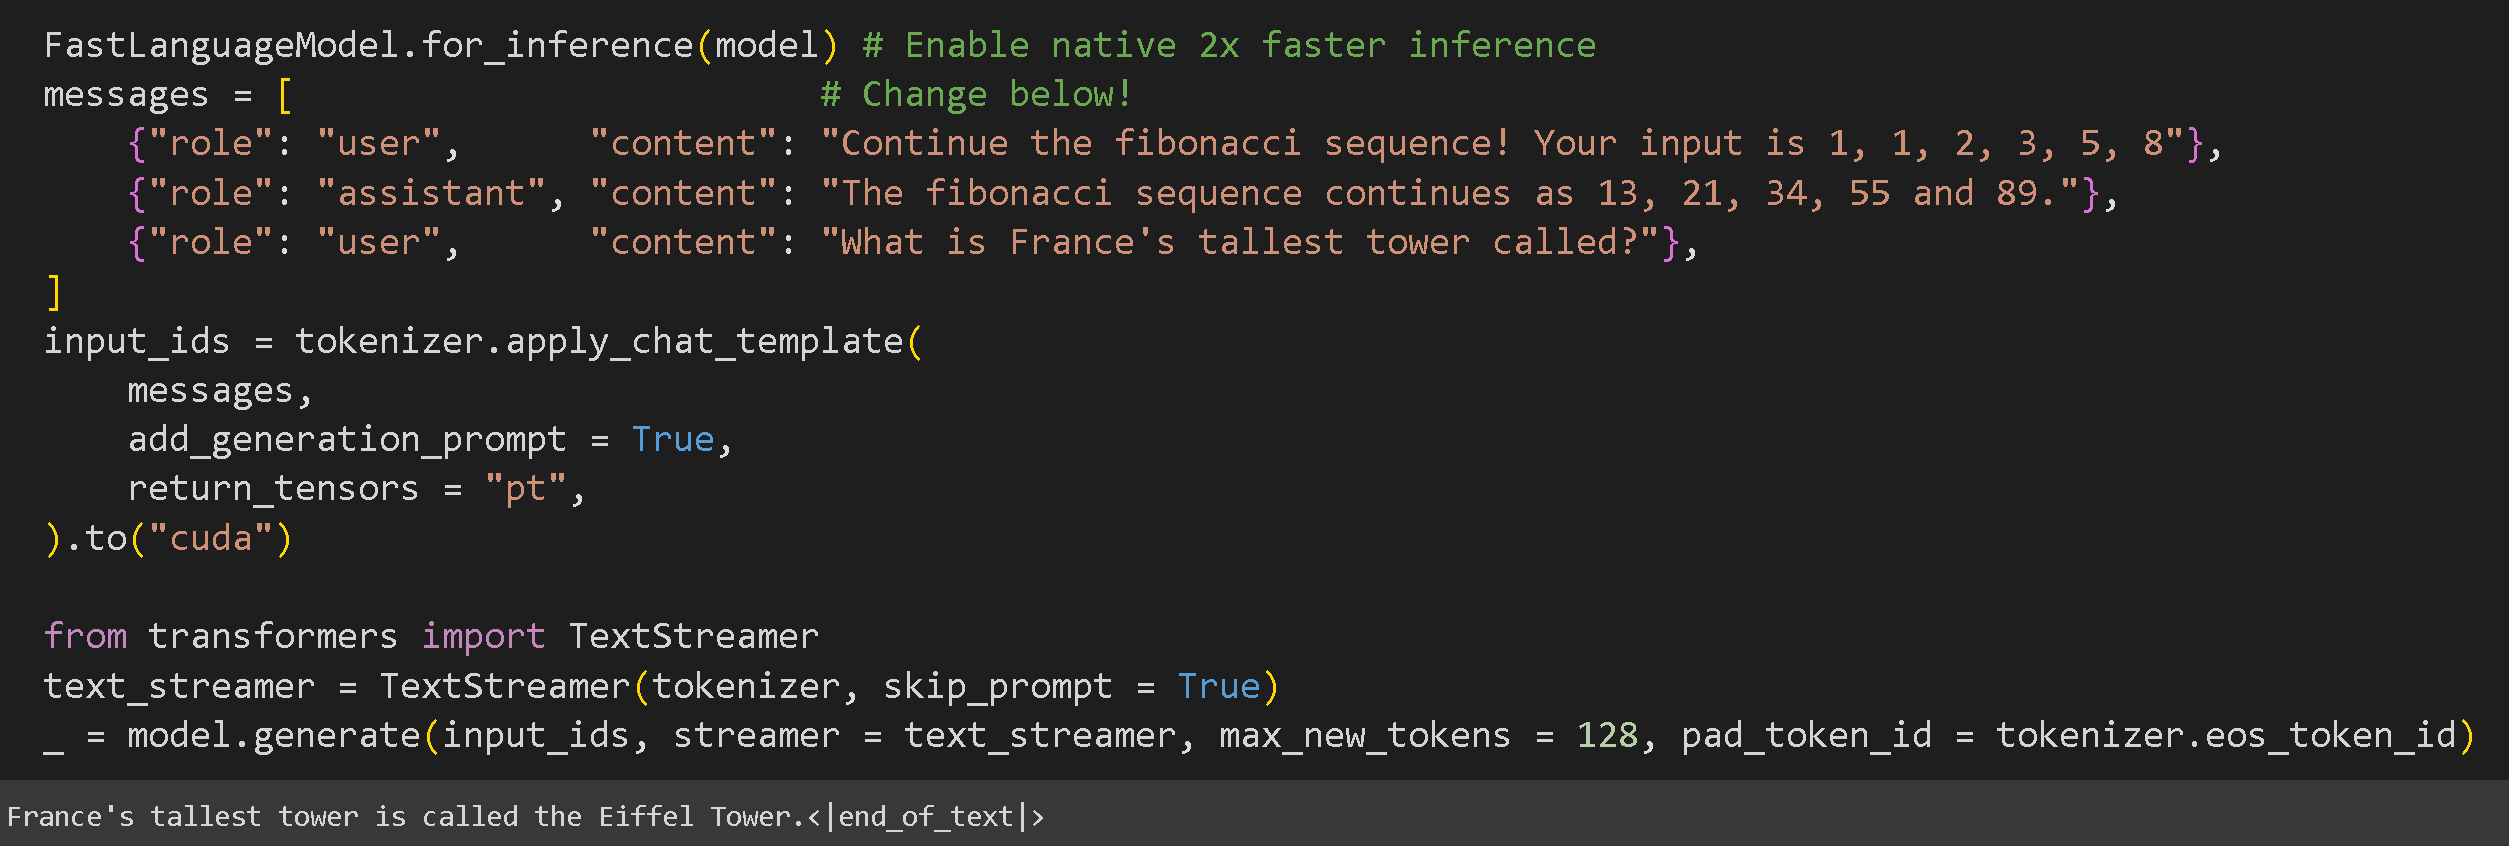
Maintenant, exécutons le modèle après avoir terminé le processus d’entraînement ! Vous pouvez modifier la partie soulignée en jaune ! En fait, comme nous avons créé un chatbot à plusieurs tours, nous pouvons maintenant aussi appeler le modèle comme s’il avait vu certaines conversations dans le passé comme ci-dessous :
Rappel : Unsloth fournit lui-même **une inférence 2x plus rapide** nativement aussi, donc n’oubliez jamais d’appeler `FastLanguageModel.for_inference(model)`. Si vous voulez que le modèle produise des réponses plus longues, réglez `max_new_tokens = 128` sur un nombre plus grand comme 256 ou 1024. Notez que vous devrez aussi attendre plus longtemps pour le résultat !
### Sauvegarde + déploiement
Pour sauvegarder et déployer votre modèle dans les moteurs d’inférence souhaités comme Ollama, vLLM, Open WebUI, vous devrez utiliser l’adaptateur LoRA au-dessus du modèle de base. Nous avons des guides dédiés pour chaque framework :
{% content-ref url="/pages/44b6f06033c7dbf3b6521a33337058e295acc604" %}
[Inférence et déploiement](/docs/fr/notions-de-base/inference-and-deployment.md)
{% endcontent-ref %}
{% columns %}
{% column %}
Si vous exécutez l’inférence sur un seul appareil (comme un ordinateur portable ou un Mac), utilisez llama.cpp pour convertir au format GGUF afin de l’utiliser dans Ollama, llama.cpp, LM Studio, etc. :
{% content-ref url="/pages/0ce33fc68eed069d43cdcfb76b9793ce71c64c1f" %}
[GGUF & llama.cpp](/docs/fr/notions-de-base/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
Si vous déployez un LLM pour une inférence d’entreprise ou multi-utilisateurs en FP8, AWQ, utilisez vLLM :
{% content-ref url="/pages/682151c53afcf1f6d611eb29ad62b7182b5187ea" %}
[vLLM](/docs/fr/notions-de-base/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
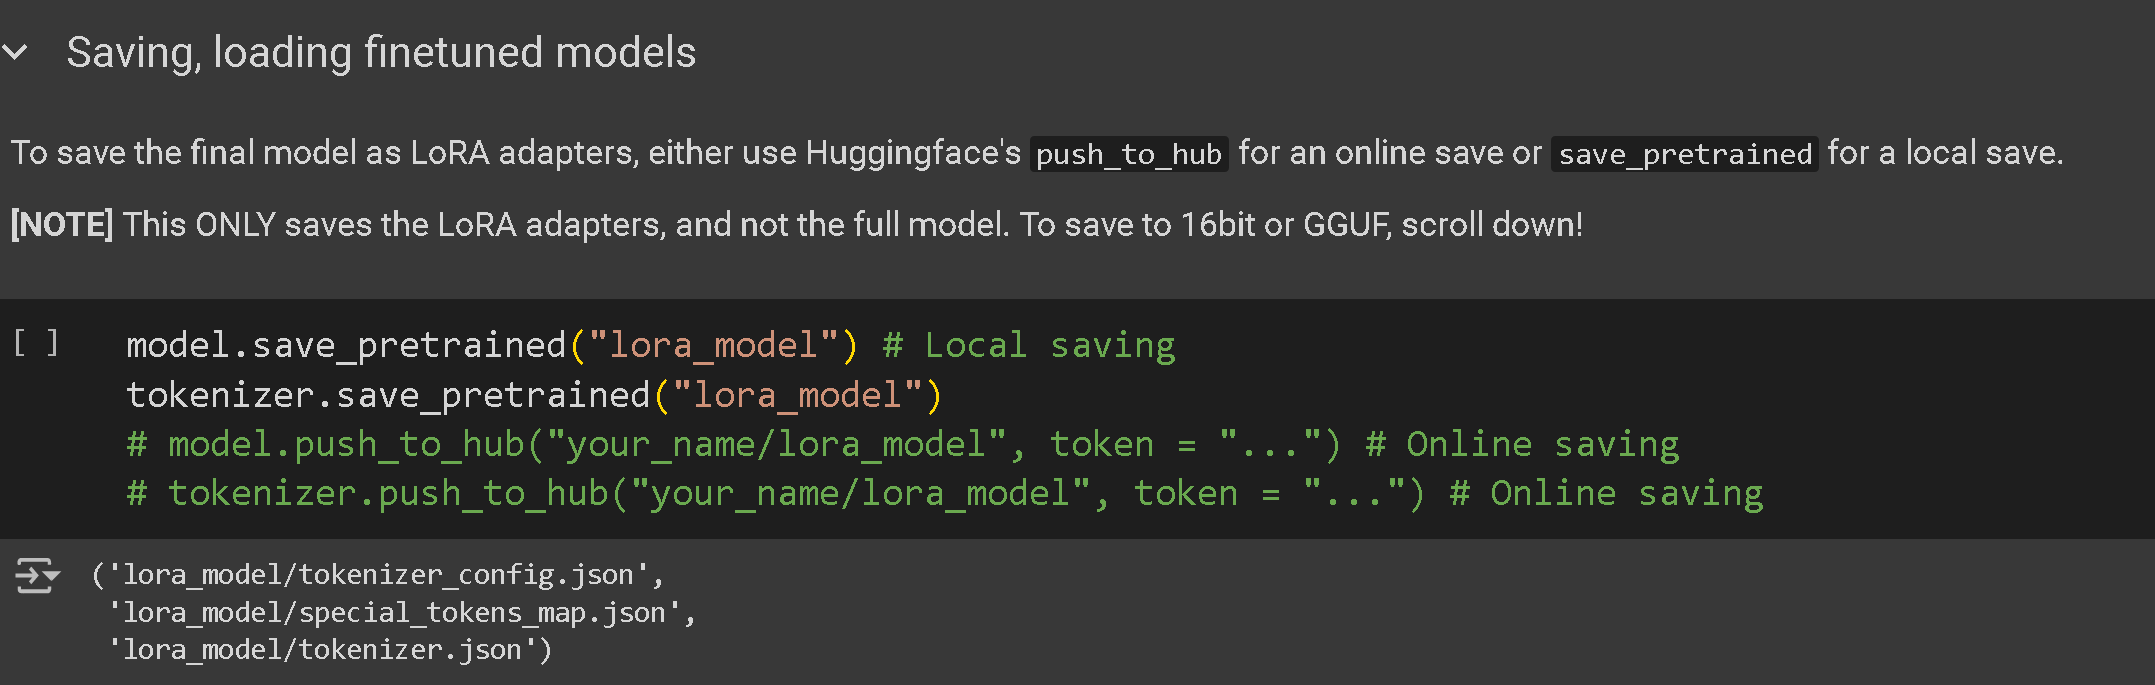
Nous pouvons maintenant sauvegarder le modèle fine-tuné sous la forme d’un petit fichier de 100 Mo appelé adaptateur LoRA, comme ci-dessous. Vous pouvez aussi le publier sur le Hub Hugging Face si vous souhaitez téléverser votre modèle ! N’oubliez pas d’obtenir un [jeton](https://huggingface.co/settings/tokens) et d’ajouter votre jeton !
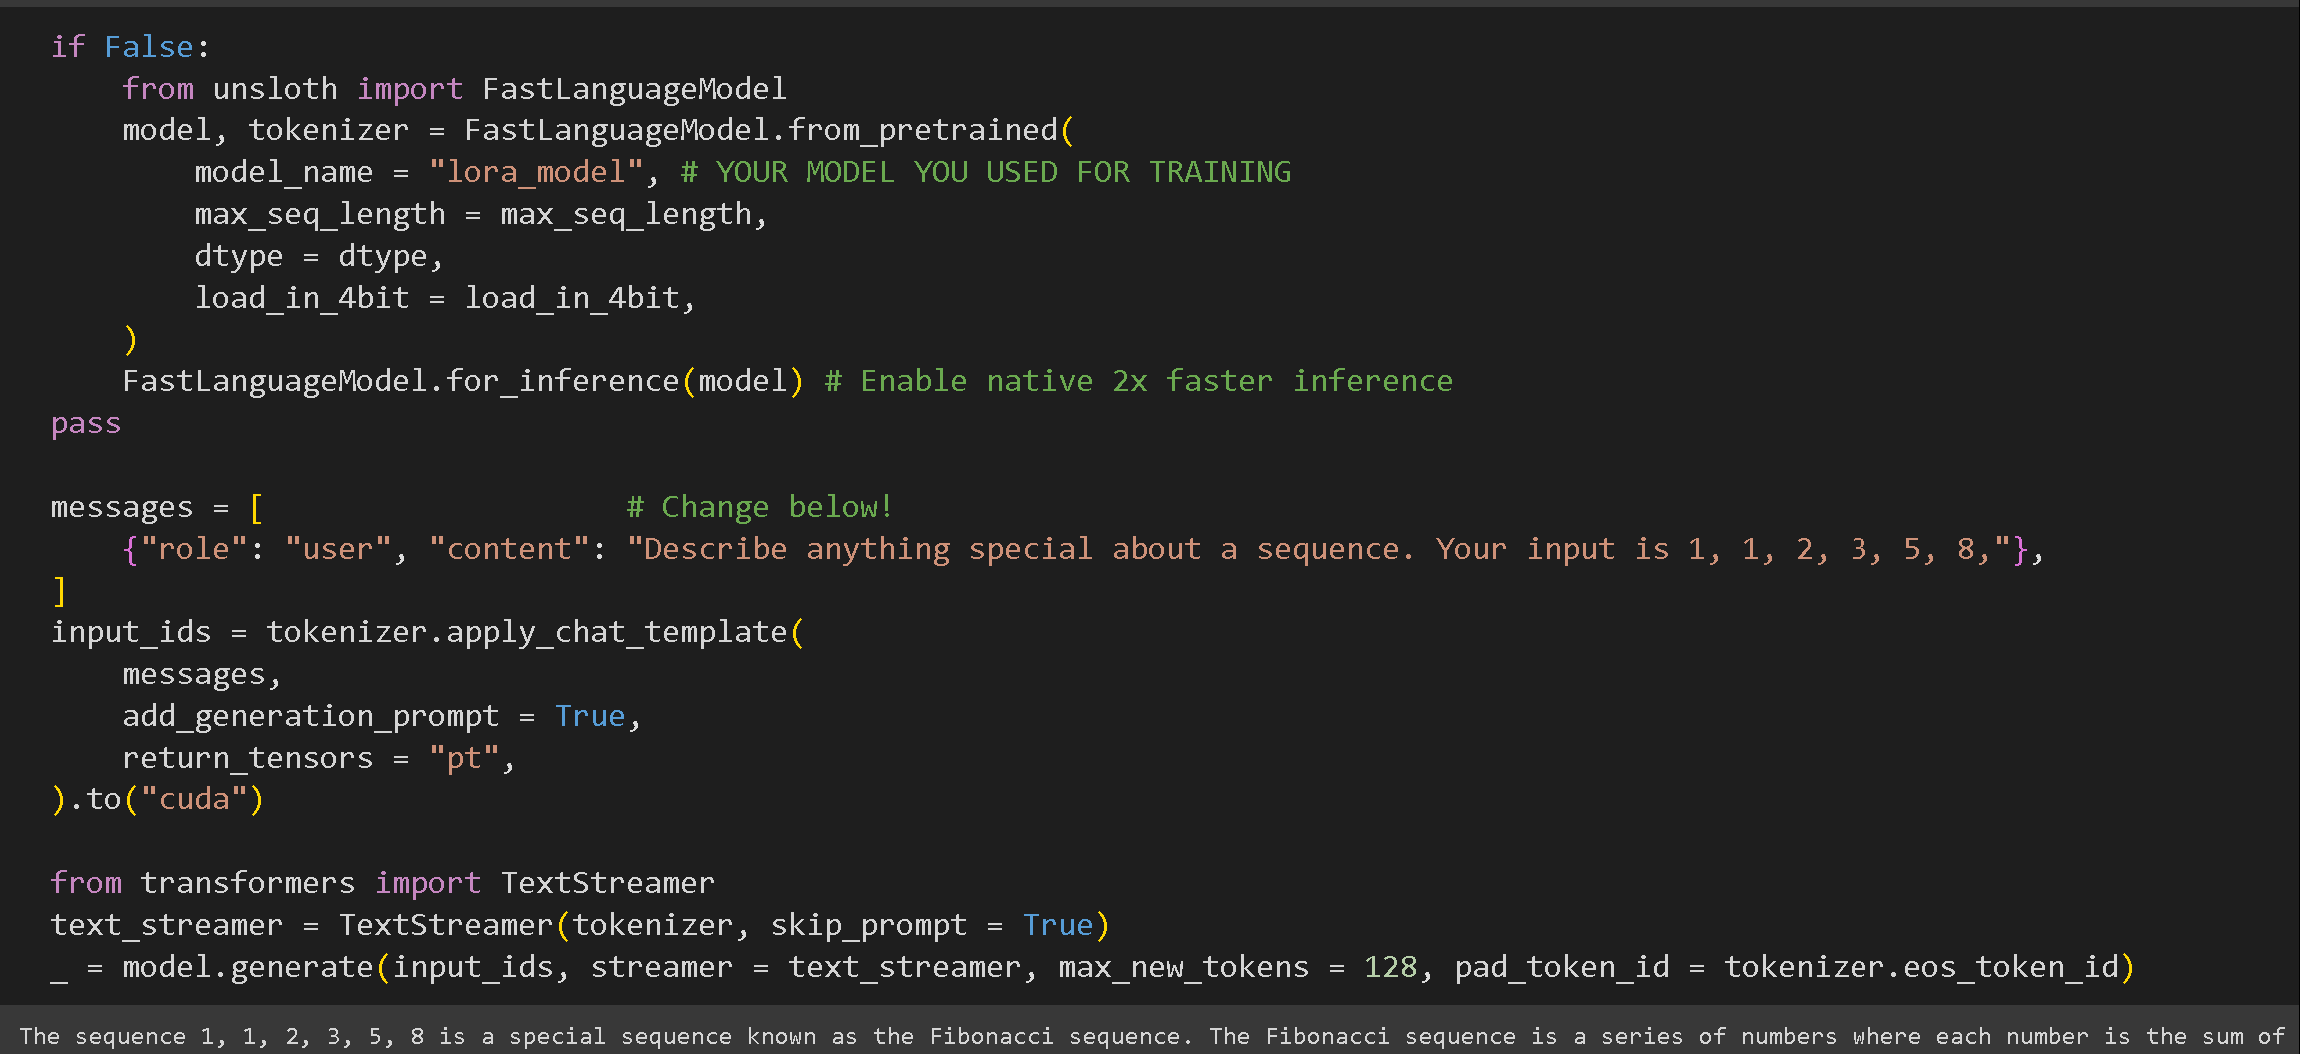
Après avoir enregistré le modèle, nous pouvons à nouveau utiliser Unsloth pour exécuter le modèle lui-même ! Utilisez `FastLanguageModel` à nouveau pour l’appeler en inférence !
## 8. Nous avons terminé !
Vous avez réussi à fine-tuner un modèle de langage et à l’exporter vers le moteur d’inférence de votre choix avec Unsloth !
Pour en savoir plus sur les astuces et conseils de fine-tuning, rendez-vous sur nos blogs, qui offrent une valeur pédagogique considérable :
Si vous avez besoin d’aide pour le fine-tuning, vous pouvez aussi rejoindre notre serveur Discord [ici](https://discord.gg/unsloth) ou [Reddit r/unsloth](https://www.reddit.com/r/unsloth/). Merci de nous avoir lus et j’espère que cela vous a été utile !
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.