> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/blog/fine-tuning-llms-with-nvidia-dgx-spark-and-unsloth.md).
# Fine-tuning des LLM avec NVIDIA DGX Spark et Unsloth
Tutoriel sur la manière de fine-tuner et de faire de l'apprentissage par renforcement (RL) avec OpenAI gpt-oss sur NVIDIA DGX Spark.
Unsloth permet l’ajustement fin local de LLM avec jusqu’à **200B paramètres** sur le NVIDIA DGX™ Spark. Avec 128 Go de mémoire unifiée, vous pouvez entraîner des modèles massifs tels que **gpt-oss-120b**, et exécuter ou déployer l’inférence directement sur DGX Spark.
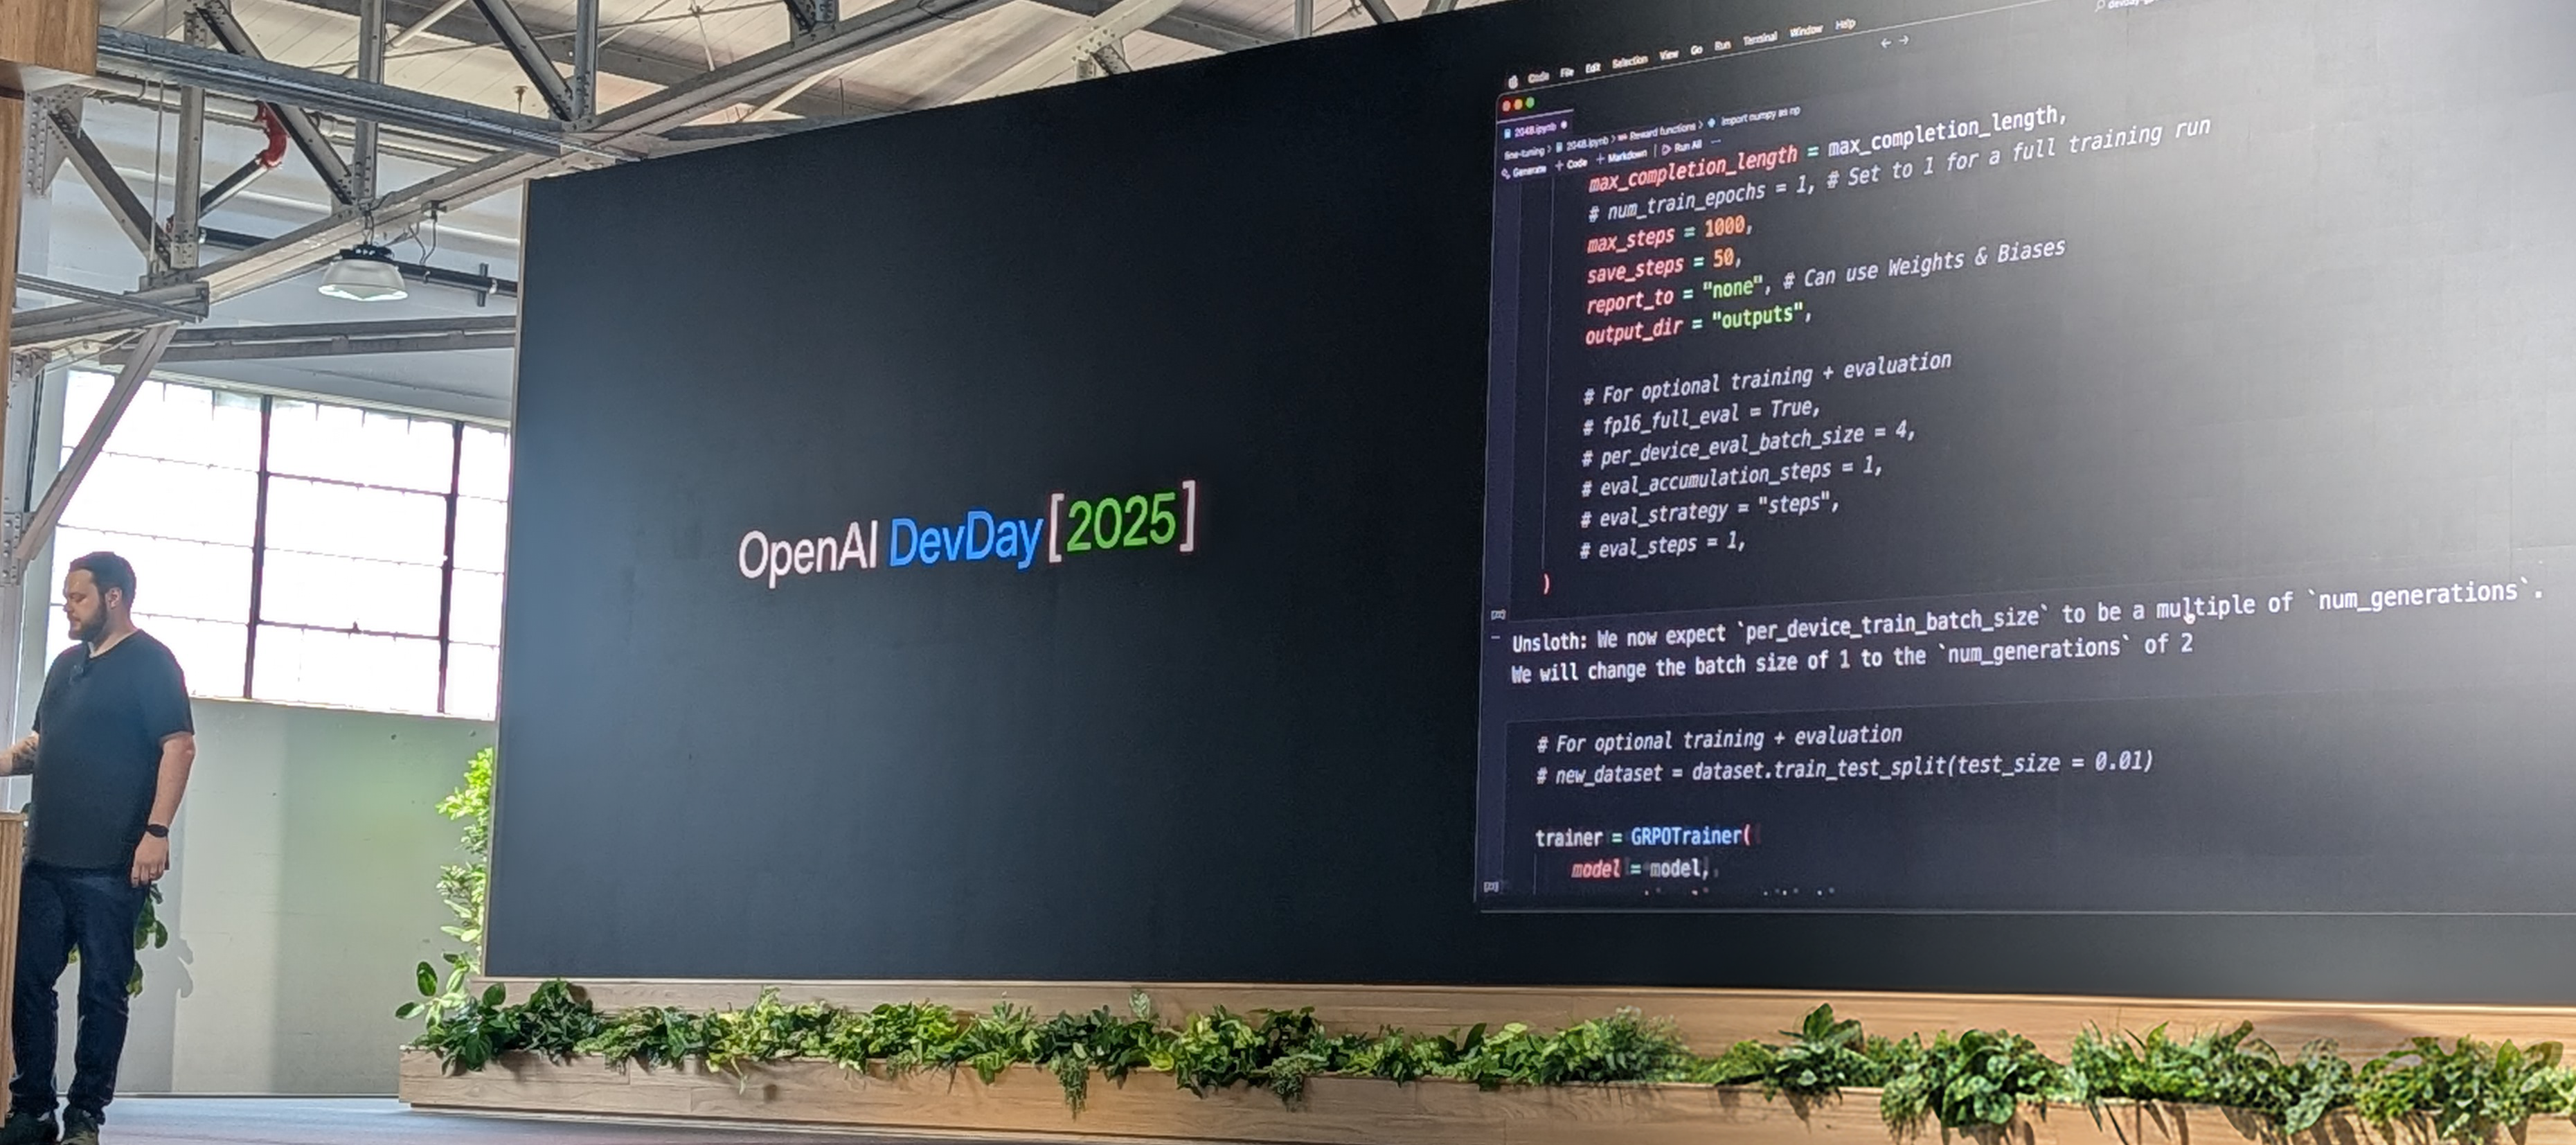
Comme montré à [OpenAI DevDay](https://x.com/UnslothAI/status/1976284209842118714), gpt-oss-20b a été entraîné avec RL et Unsloth sur DGX Spark pour gagner automatiquement à 2048. Vous pouvez vous entraîner avec Unsloth dans un conteneur Docker ou un environnement virtuel sur DGX Spark.
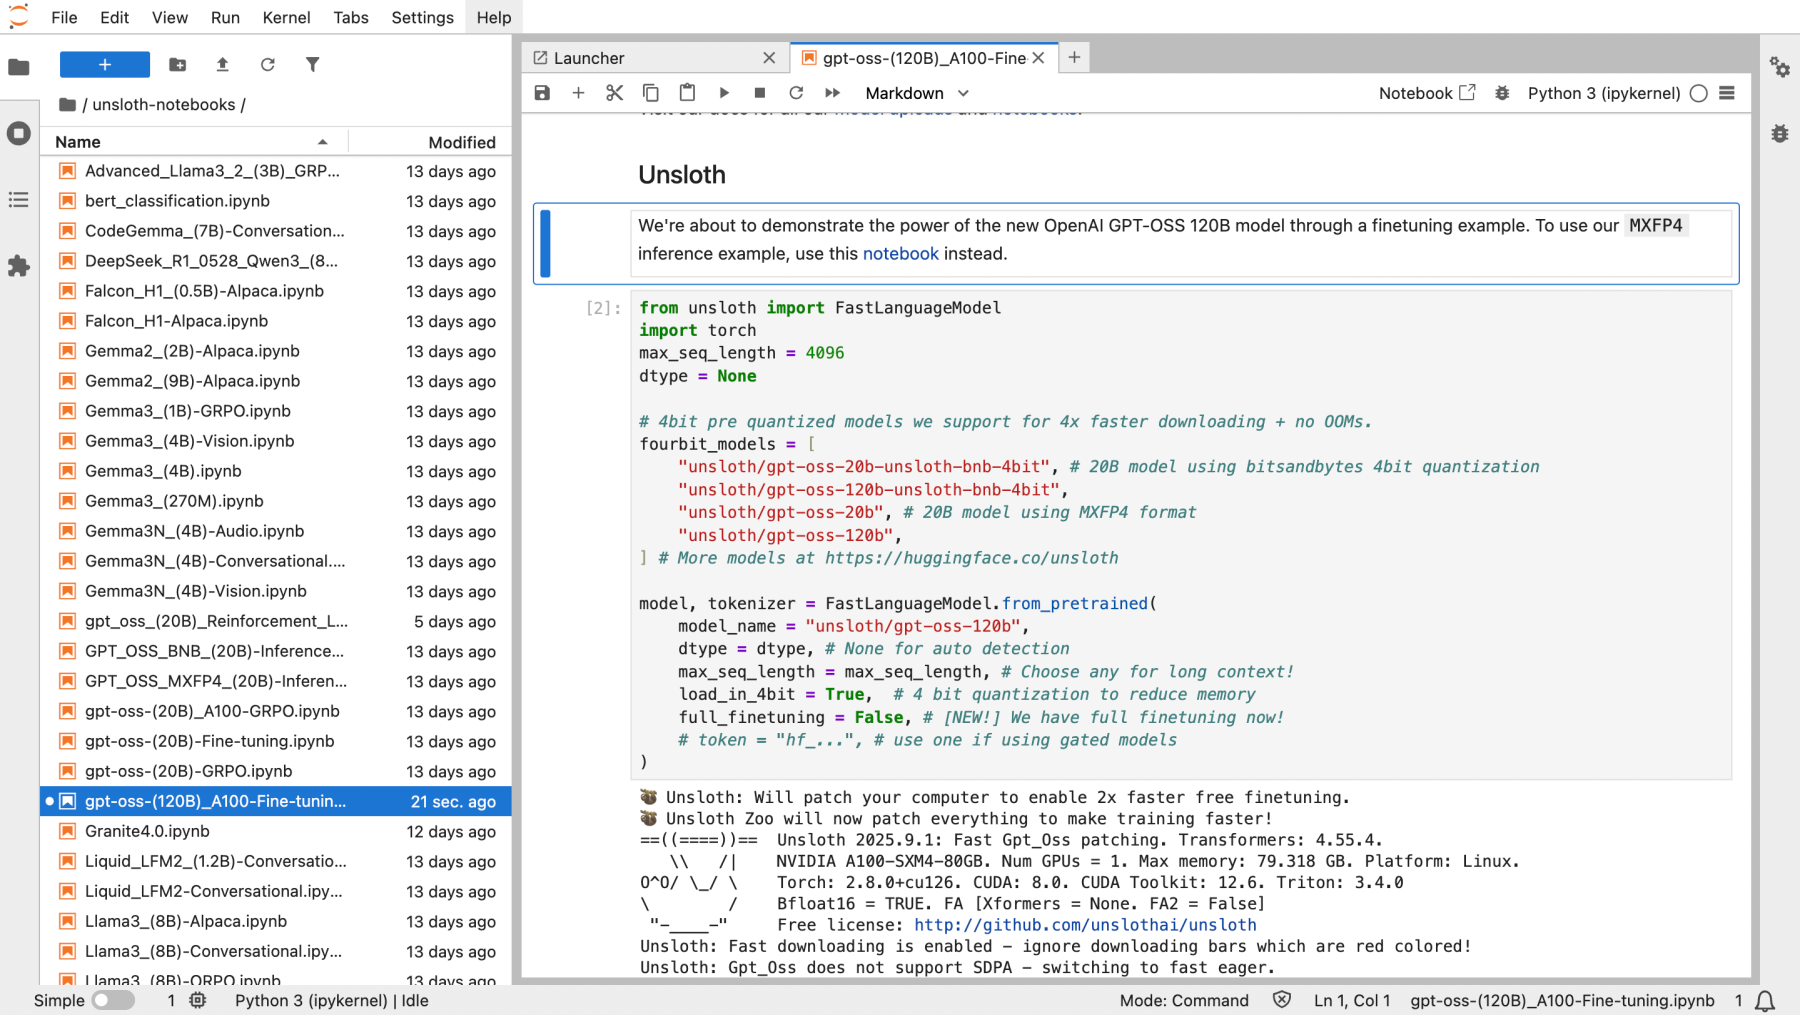
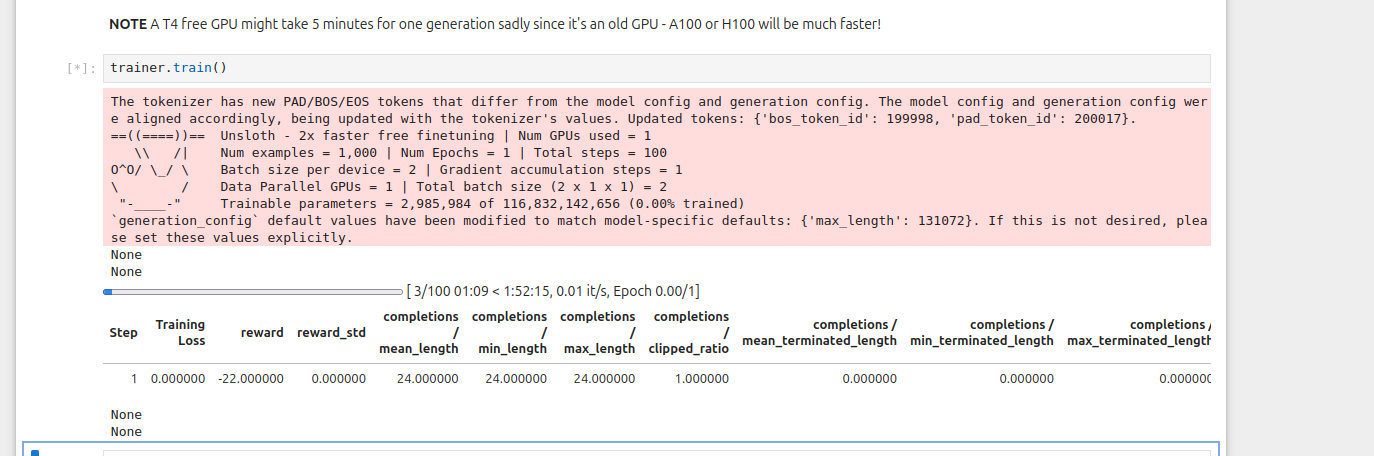
Dans ce tutoriel, nous entraînerons gpt-oss-20b avec RL à l’aide des notebooks Unsloth après avoir installé Unsloth sur votre DGX Spark. gpt-oss-120b utilisera environ **68 Go** de mémoire unifiée.
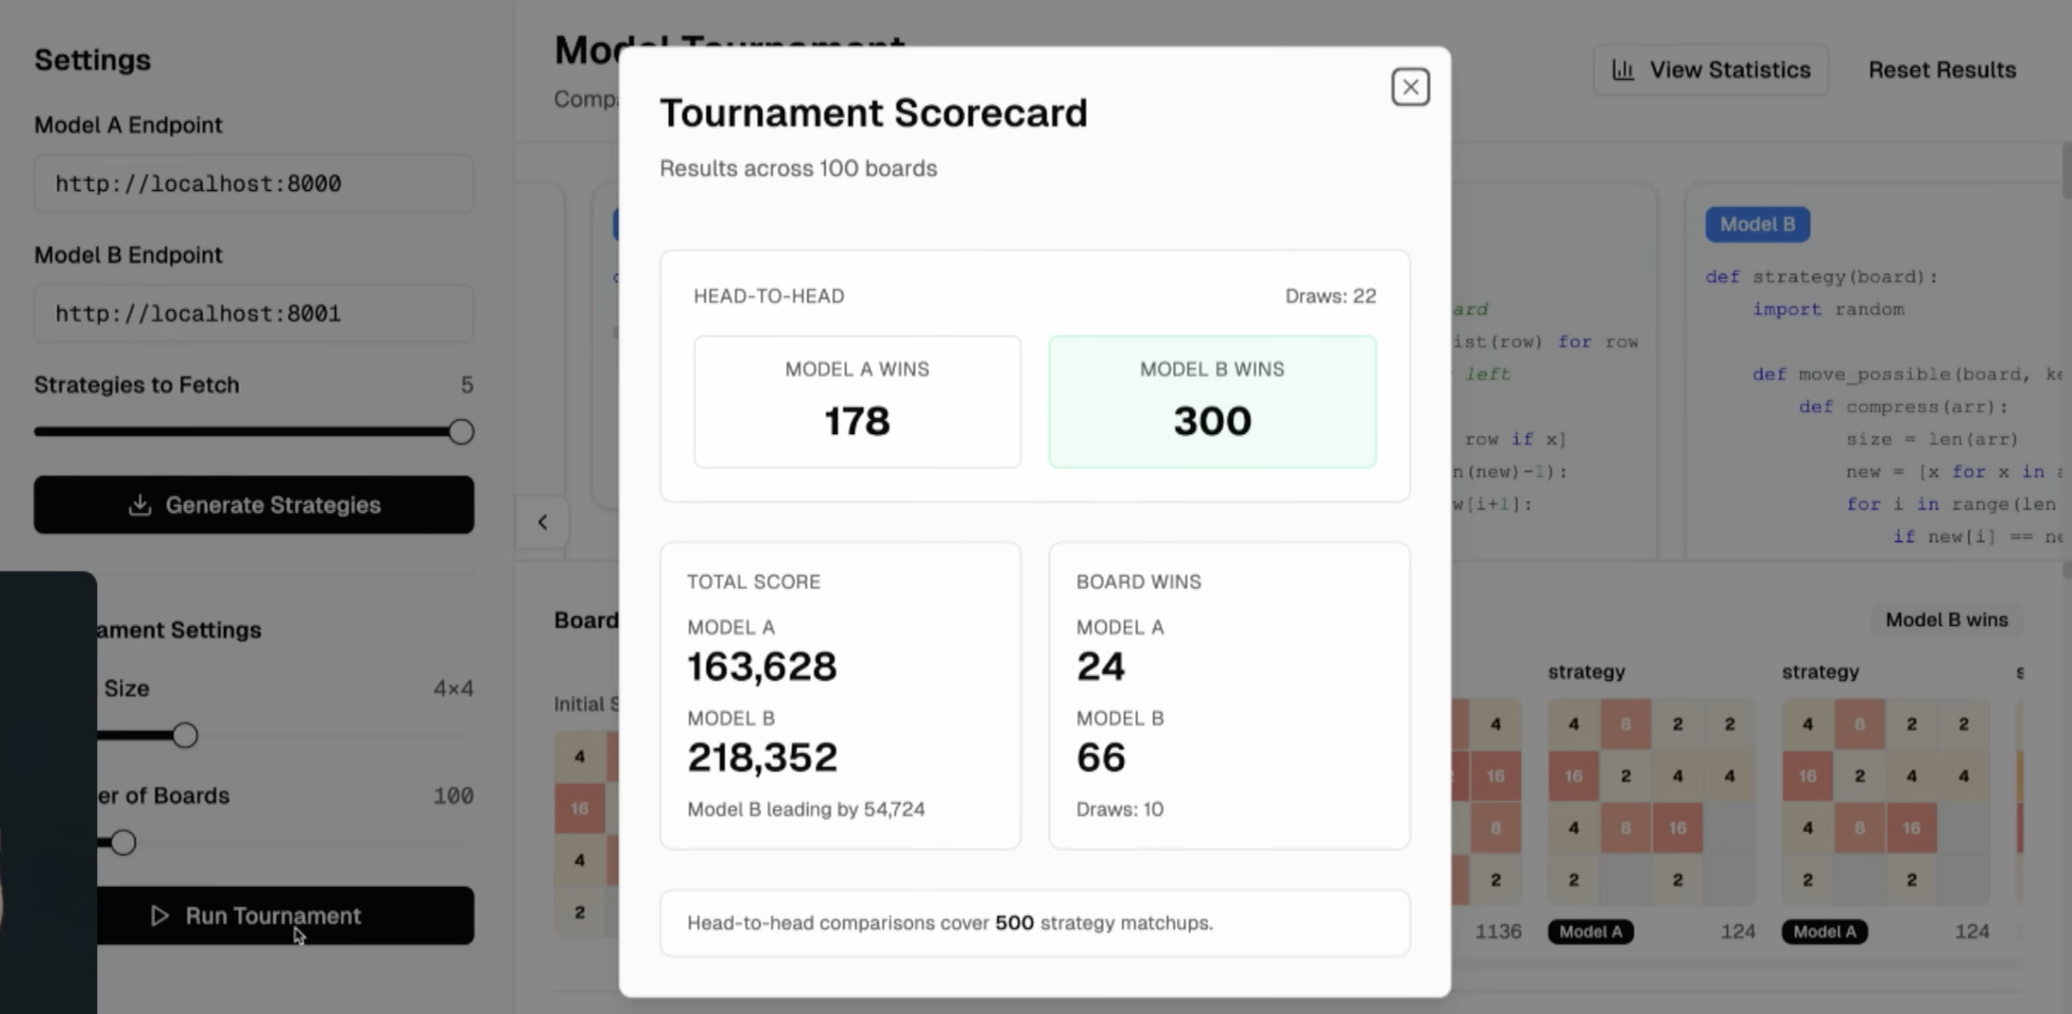
Après 1 000 étapes et 4 heures d’entraînement RL, le modèle gpt-oss surpasse largement l’original à 2048, et un entraînement plus long améliorerait encore les résultats.
Vous pouvez voir Unsloth présenté à OpenAI DevDay 2025 ici.
gpt-oss entraîné avec RL surpasse systématiquement les autres à 2048.
### ⚡ Tutoriel étape par étape
{% stepper %}
{% step %}
**Commencez avec l’image Docker Unsloth pour DGX Spark**
Commencez par créer l’image Docker à l’aide du Dockerfile DGX Spark qui peut être [trouvé ici](https://raw.githubusercontent.com/unslothai/notebooks/main/Dockerfile_DGX_Spark). Vous pouvez également exécuter ce qui suit dans un terminal sur le DGX Spark :
```bash
sudo apt update && sudo apt install -y wget
wget -O Dockerfile "https://raw.githubusercontent.com/unslothai/notebooks/main/Dockerfile_DGX_Spark"
```
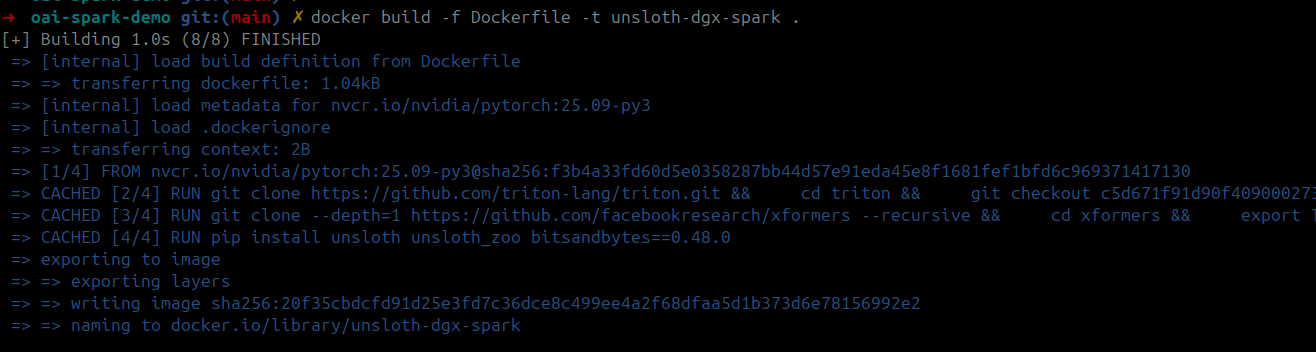
Ensuite, créez l’image Docker d’entraînement à l’aide du Dockerfile enregistré :
```bash
docker build -f Dockerfile -t unsloth-dgx-spark .
```
Vous pouvez également cliquer pour voir le Dockerfile DGX Spark complet
```python
FROM nvcr.io/nvidia/pytorch:25.09-py3
# Définir les variables d’environnement CUDA
ENV CUDA_HOME=/usr/local/cuda-13.0/
ENV CUDA_PATH=$CUDA_HOME
ENV PATH=$CUDA_HOME/bin:$PATH
ENV LD_LIBRARY_PATH=$CUDA_HOME/lib64:$LD_LIBRARY_PATH
ENV C_INCLUDE_PATH=$CUDA_HOME/include:$C_INCLUDE_PATH
ENV CPLUS_INCLUDE_PATH=$CUDA_HOME/include:$CPLUS_INCLUDE_PATH
# Installer triton depuis les sources pour la prise en charge de blackwell la plus récente
RUN git clone https://github.com/triton-lang/triton.git && \
cd triton && \
git checkout c5d671f91d90f40900027382f98b17a3e04045f6 && \
pip install -r python/requirements.txt && \
pip install . && \
cd ..
# Installer xformers depuis les sources pour la prise en charge de blackwell
RUN git clone --depth=1 https://github.com/facebookresearch/xformers --recursive && \
cd xformers && \
export TORCH_CUDA_ARCH_LIST="12.1" && \
python setup.py install && \
cd ..
# Installer unsloth et les autres dépendances
RUN pip install unsloth unsloth_zoo bitsandbytes==0.48.0 transformers==4.56.2 trl==0.22.2
# Lancer le shell
CMD ["/bin/bash"]
```
{% endstep %}
{% step %}
**Lancer le conteneur**
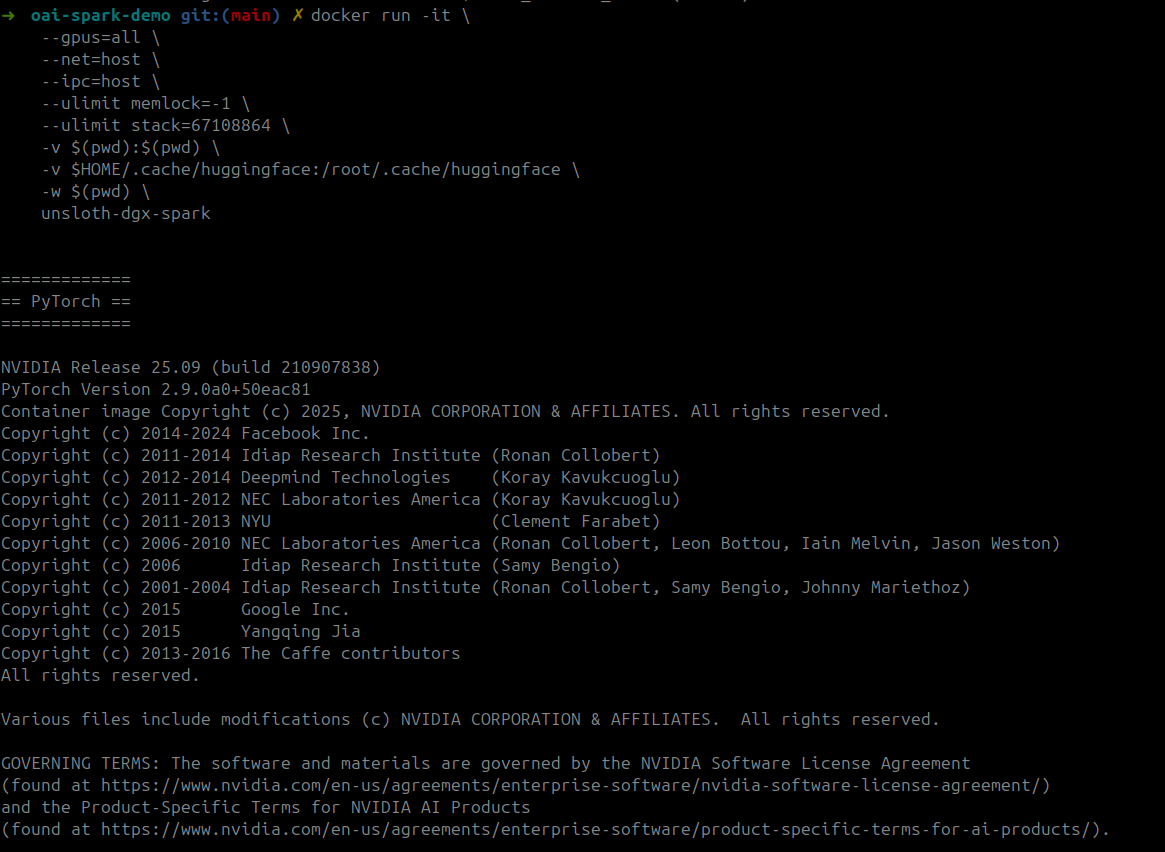
Lancez le conteneur d’entraînement avec accès au GPU et montages de volumes :
```bash
docker run -it \
--gpus=all \
--net=host \
--ipc=host \
--ulimit memlock=-1 \
--ulimit stack=67108864 \
-v $(pwd):$(pwd) \
-v $HOME/.cache/huggingface:/root/.cache/huggingface \
-w $(pwd) \
unsloth-dgx-spark
```
{% endstep %}
{% step %}
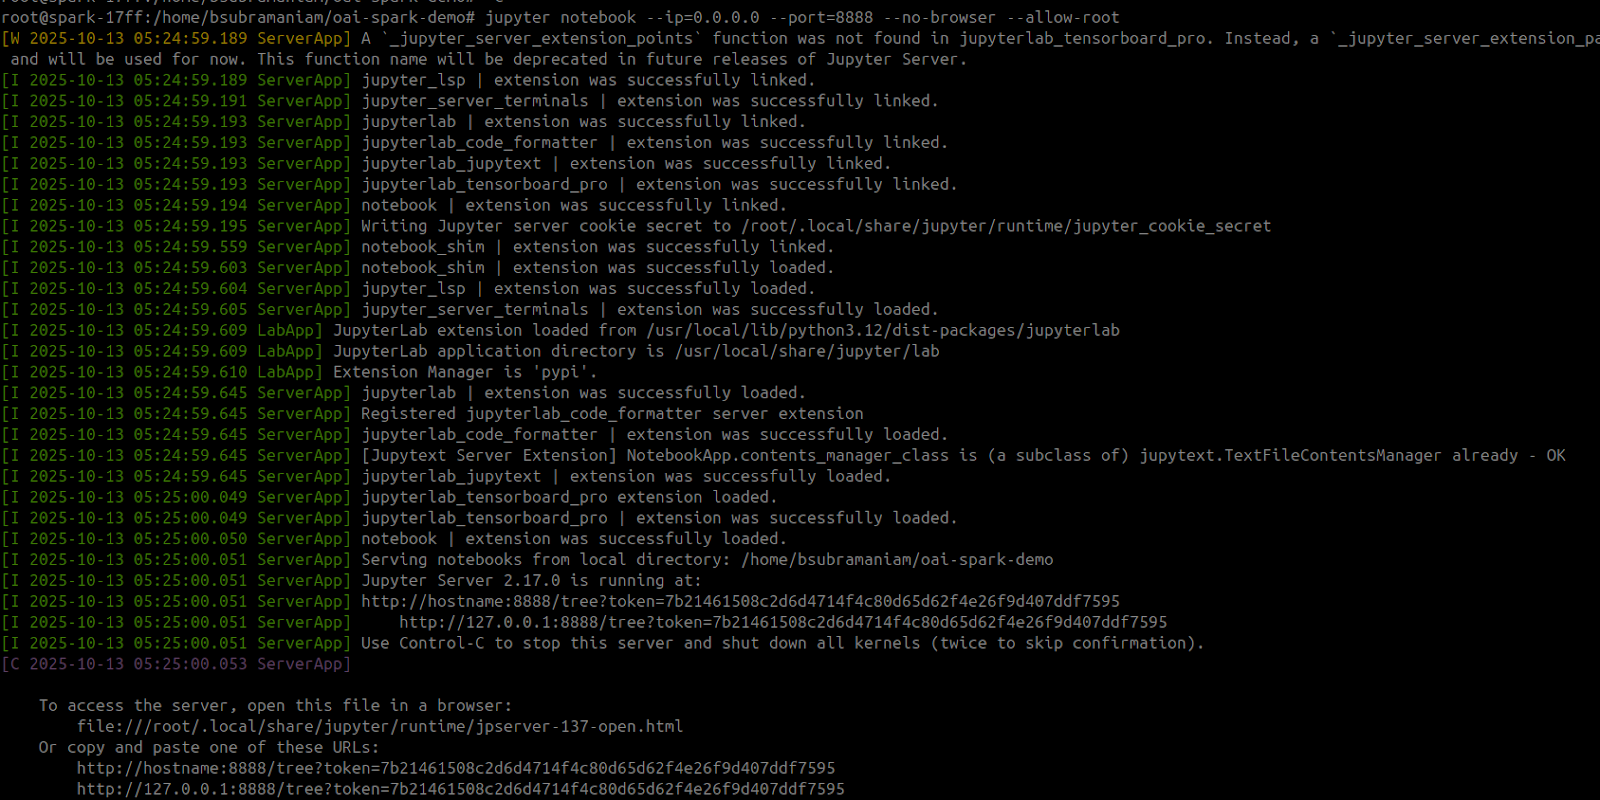
**Démarrer Jupyter et exécuter les notebooks**
Dans le conteneur, démarrez Jupyter et exécutez le notebook requis. Vous pouvez utiliser le Reinforcement Learning gpt-oss 20b pour gagner à 2048 [notebook ici](https://github.com/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_Reinforcement_Learning_2048_Game_DGX_Spark.ipynb). En fait, tous les [notebooks Unsloth](https://docs.unsloth.ai/get-started/unsloth-notebooks) fonctionnent sur DGX Spark, y compris le notebook **120b** ! Supprimez simplement les cellules d’installation.
Les commandes ci-dessous peuvent également être utilisées pour exécuter le notebook RL. Une fois Jupyter Notebook lancé, ouvrez le «`gpt_oss_20B_RL_2048_Game.ipynb` »
```bash
NOTEBOOK_URL="https://raw.githubusercontent.com/unslothai/notebooks/refs/heads/main/nb/gpt_oss_(20B)_Reinforcement_Learning_2048_Game_DGX_Spark.ipynb"
wget -O "gpt_oss_20B_RL_2048_Game.ipynb" "$NOTEBOOK_URL"
jupyter notebook --ip=0.0.0.0 --port=8888 --no-browser --allow-root
```
N’oubliez pas qu’Unsloth vous permet également de [enregistrer et exécuter](/docs/fr/notions-de-base/inference-and-deployment.md) vos modèles après l’ajustement fin afin de pouvoir les déployer localement directement sur votre DGX Spark par la suite.
{% endstep %}
{% endstepper %}
Un grand merci à [Lakshmi Ramesh](https://www.linkedin.com/in/rlakshmi24/) et [Barath Anandan](https://www.linkedin.com/in/barathsa/) de NVIDIA pour avoir aidé au lancement de DGX Spark d’Unsloth et à la création de l’image Docker.
### Utilisation de la mémoire unifiée
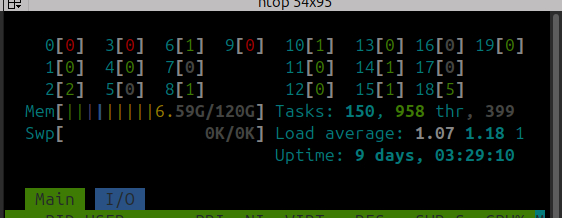
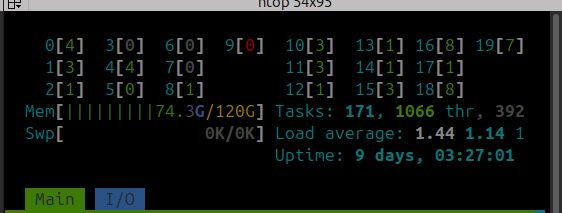
L’ajustement fin QLoRA 4 bits de gpt-oss-120b utilisera environ **68 Go** de mémoire unifiée. Voici à quoi devrait ressembler votre utilisation de la mémoire unifiée **avant** (à gauche) et **après** l’entraînement (à droite) :
Et voilà ! Amusez-vous à entraîner et à exécuter des LLM entièrement localement sur votre NVIDIA DGX Spark !
### Tutoriels vidéo
Merci à Tim de [AnythingLLM](https://github.com/Mintplex-Labs/anything-llm) pour avoir fourni un excellent tutoriel d’ajustement fin avec Unsloth sur DGX Spark :
{% embed url="" %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/blog/fine-tuning-llms-with-nvidia-dgx-spark-and-unsloth.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.