

💧Liquid LFM2.5 : comment l'exécuter et le fine-tuner
Exécutez et fine-tunez LFM2.5 Instruct et Vision localement sur votre appareil !
Liquid AI lance LFM2.5, y compris son instruct et vision modèle. LFM2.5-1.2B-Instruct est un modèle de raisonnement hybride de 1,17 milliard de paramètres entraîné sur 28T tokens et RL, offrant des performances de premier plan à l’échelle 1B pour le suivi d’instructions, l’utilisation d’outils et les tâches agentiques. Voir Hugging Face Jobs sur l’utilisation de Codex pour entraîner LFM !
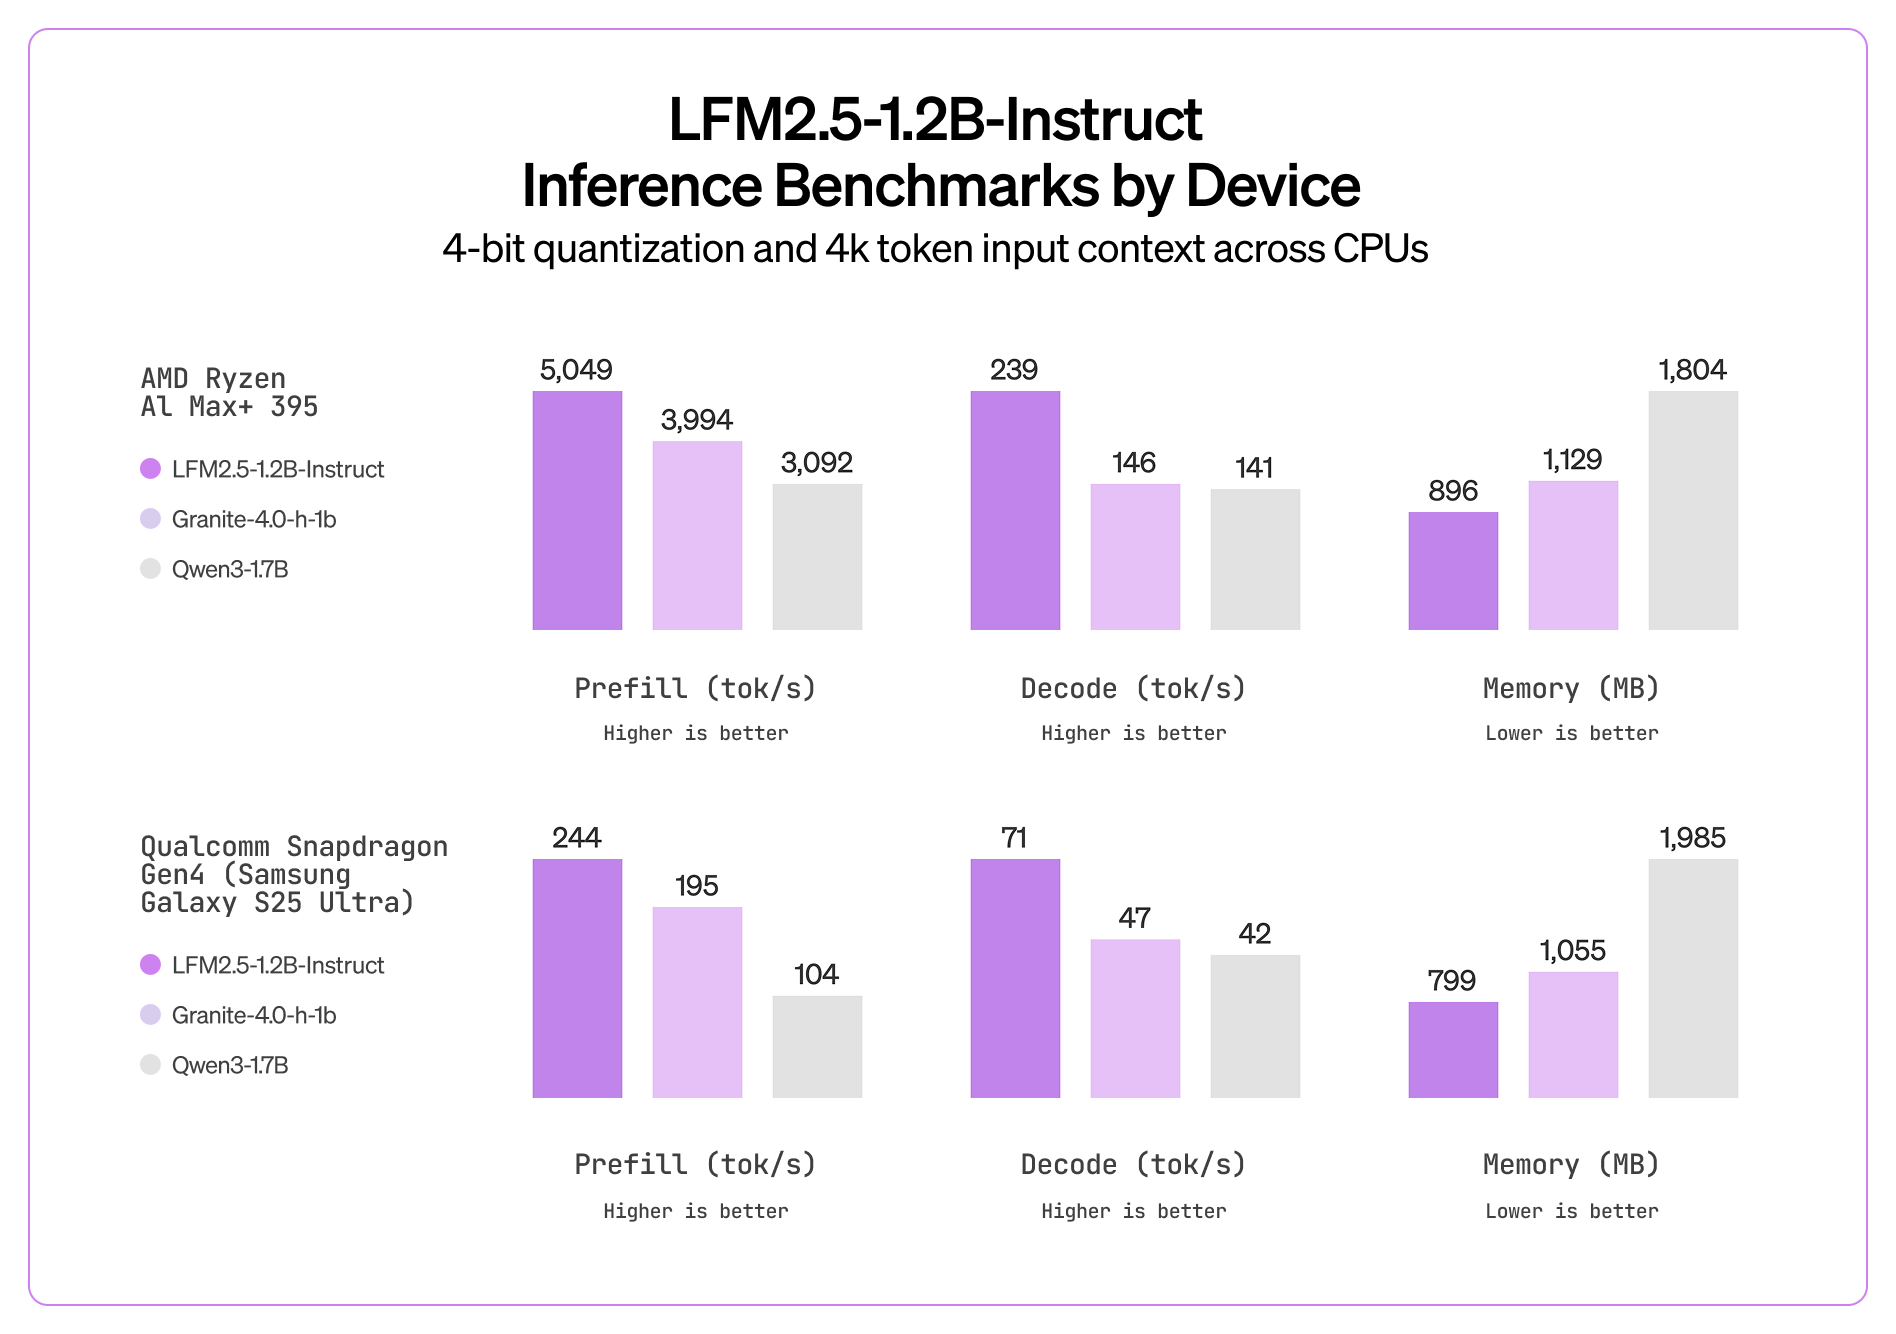
LFM2.5 fonctionne avec moins de 1 Go de RAM et atteint 239 tok/s de décodage sur CPU AMD. Vous pouvez aussi affiner le faire localement avec Unsloth.
Spécifications du modèle :
Paramètres: 1,17B
Architecture: 16 couches (10 blocs de convolution LIV à double porte + 6 blocs GQA)
Budget d’entraînement: 28T tokens
Longueur de contexte: 32 768 tokens
Taille du vocabulaire: 65,536
Langues: anglais, arabe, chinois, français, allemand, japonais, coréen, espagnol
⚙️ Guide d’utilisation
Liquid AI recommande ces paramètres pour l’inférence :
temperature = 0.1top_k = 50top_p = 0.1repetition_penalty = 1.05Longueur maximale du contexte :
32,768
Format du modèle de chat
LFM2.5 utilise un format de type ChatML :
Modèle de chat LFM2.5 :
Utilisation d’outils
LFM2.5 prend en charge l’appel de fonctions avec des jetons spéciaux <|tool_call_start|> et <|tool_call_end|>. Fournissez les outils sous forme d’objet JSON dans l’invite système :
🖥️ Exécuter LFM2.5-1.2B-Instruct
📖 Tutoriel llama.cpp (GGUF)
1. Compiler llama.cpp
Obtenez la dernière version llama.cpp de GitHub. Changez -DGGML_CUDA=ON en -DGGML_CUDA=OFF si vous n’avez pas de GPU. Pour les appareils Apple Mac / Metal, définissez -DGGML_CUDA=OFF puis continuez normalement - la prise en charge de Metal est activée par défaut.
2. Exécuter directement depuis Hugging Face
3. Ou téléchargez d’abord le modèle
4. Exécutez en mode conversation
🦥 Fine-tuning de LFM2.5 avec Unsloth
Unsloth prend en charge le fine-tuning des modèles LFM2.5. Le modèle 1,2B tient confortablement sur un GPU T4 Colab gratuit. L’entraînement est 2 fois plus rapide avec 50 % de VRAM en moins.
Notebook Colab gratuit :
LFM2.5 est recommandé pour les tâches agentiques, l’extraction de données, le RAG et l’utilisation d’outils. Il n’est pas recommandé pour les tâches à forte composante de connaissances ou la programmation.
Configuration Unsloth pour LFM2.5
Configuration d’entraînement
Enregistrement et export
🎉 Service et déploiement de llama-server
Pour déployer LFM2.5 en production avec une API compatible OpenAI :
Test avec le client OpenAI :
📊 Benchmarks
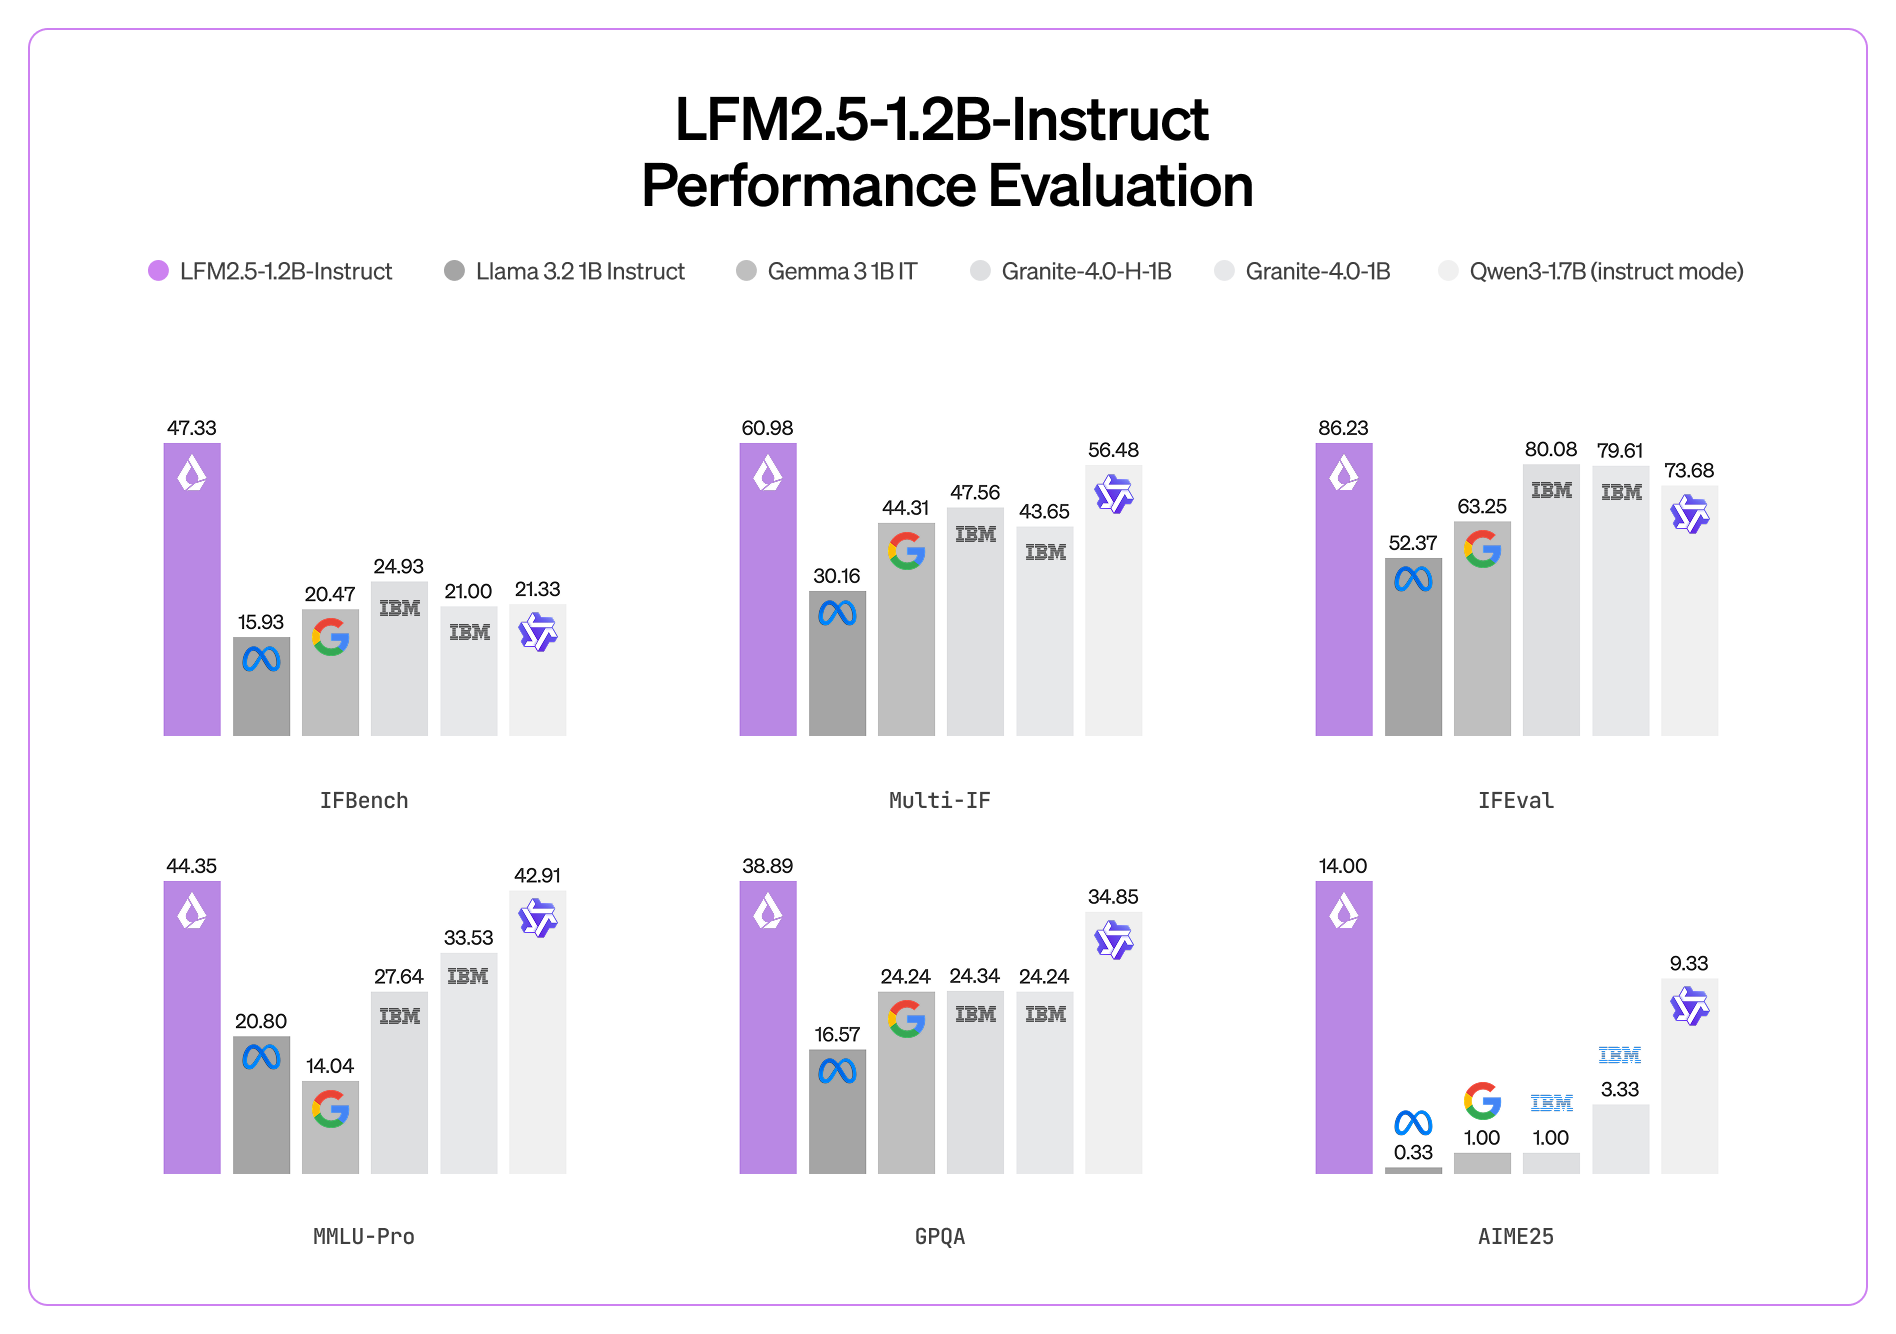
LFM2.5-1.2B-Instruct offre des performances de premier plan à l’échelle 1B et propose une inférence CPU rapide avec une faible consommation mémoire :
💧 Guide Liquid LFM2.5-1.2B-VL
LFM2.5-VL-1.6B est un LLM de vision construit au-dessus de LFM2.5-1.2B-Base et ajusté pour de meilleures performances réelles. Vous pouvez maintenant affiner le faire localement avec Unsloth.
Spécifications du modèle :
Backbone LM: LFM2.5-1.2B-Base
Encodeur de vision: SigLIP2 NaFlex optimisé pour les formes, 400M
Longueur de contexte: 32 768 tokens
Taille du vocabulaire: 65,536
Langues: anglais, arabe, chinois, français, allemand, japonais, coréen et espagnol
Traitement natif de la résolution: Gère des images jusqu’à 512×512 pixels sans mise à l’échelle et préserve les rapports d’aspect non standard sans distorsion
Stratégie de découpage en tuiles: Découpe les grandes images en patches non chevauchants de 512×512 et inclut un encodage miniature pour le contexte global
Flexibilité à l’inférence: Nombre maximal de jetons d’image et nombre de tuiles ajustables par l’utilisateur pour arbitrer entre vitesse et qualité sans réentraînement
⚙️ Guide d'utilisation
Liquid AI recommande ces paramètres pour l’inférence :
Texte:
temperature=0.1,min_p=0.15,repetition_penalty=1.05Vision: min_image_tokens=64, max_image_tokens=256, do_image_splitting=True
Format du modèle de chat
LFM2.5-VL utilise un format de type ChatML :
Modèle de chat LFM2.5-VL :
🖥️ Exécuter LFM2.5-VL-1.6B
📖 Tutoriel llama.cpp (GGUF)
1. Compiler llama.cpp
Obtenez la dernière version de llama.cpp depuis GitHub. Changez -DGGML_CUDA=ON en -DGGML_CUDA=OFF si vous n’avez pas de GPU.
2. Exécuter directement depuis Hugging Face
🦥 Fine-tuning de LFM2.5-VL avec Unsloth
Unsloth prend en charge le fine-tuning des modèles LFM2.5. Le modèle 1,6B tient confortablement sur un GPU T4 Colab gratuit. L’entraînement est 2 fois plus rapide avec 50 % de VRAM en moins.
Notebook Colab gratuit :
Configuration Unsloth pour LFM2.5
Configuration d’entraînement
Enregistrement et export
📊 Benchmarks
LFM2.5-VL-1.6B offre des performances de premier plan :
LFM2.5-VL-1.6B
50.67
52.29
48.82
62.71
41.44
64.84
40.56
76.96
65.90
LFM2-VL-1.6B
49.87
46.35
44.50
58.35
35.11
65.75
39.67
72.13
60.57
InternVL3.5-1B
50.27
36.17
44.19
60.99
33.53
57.12
41.89
68.93
58.32
FastVLM-1.5B
53.13
24.99
43.29
23.92
26.61
61.56
38.78
64.84
50.89
📚 Ressources
Mis à jour
Ce contenu vous a-t-il été utile ?