> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/blog/500k-context-length-fine-tuning.md).
# Fine-tuning avec une longueur de contexte de 500k
Découvrez comment activer le fine-tuning avec une fenêtre de contexte de plus de 500k tokens avec Unsloth.
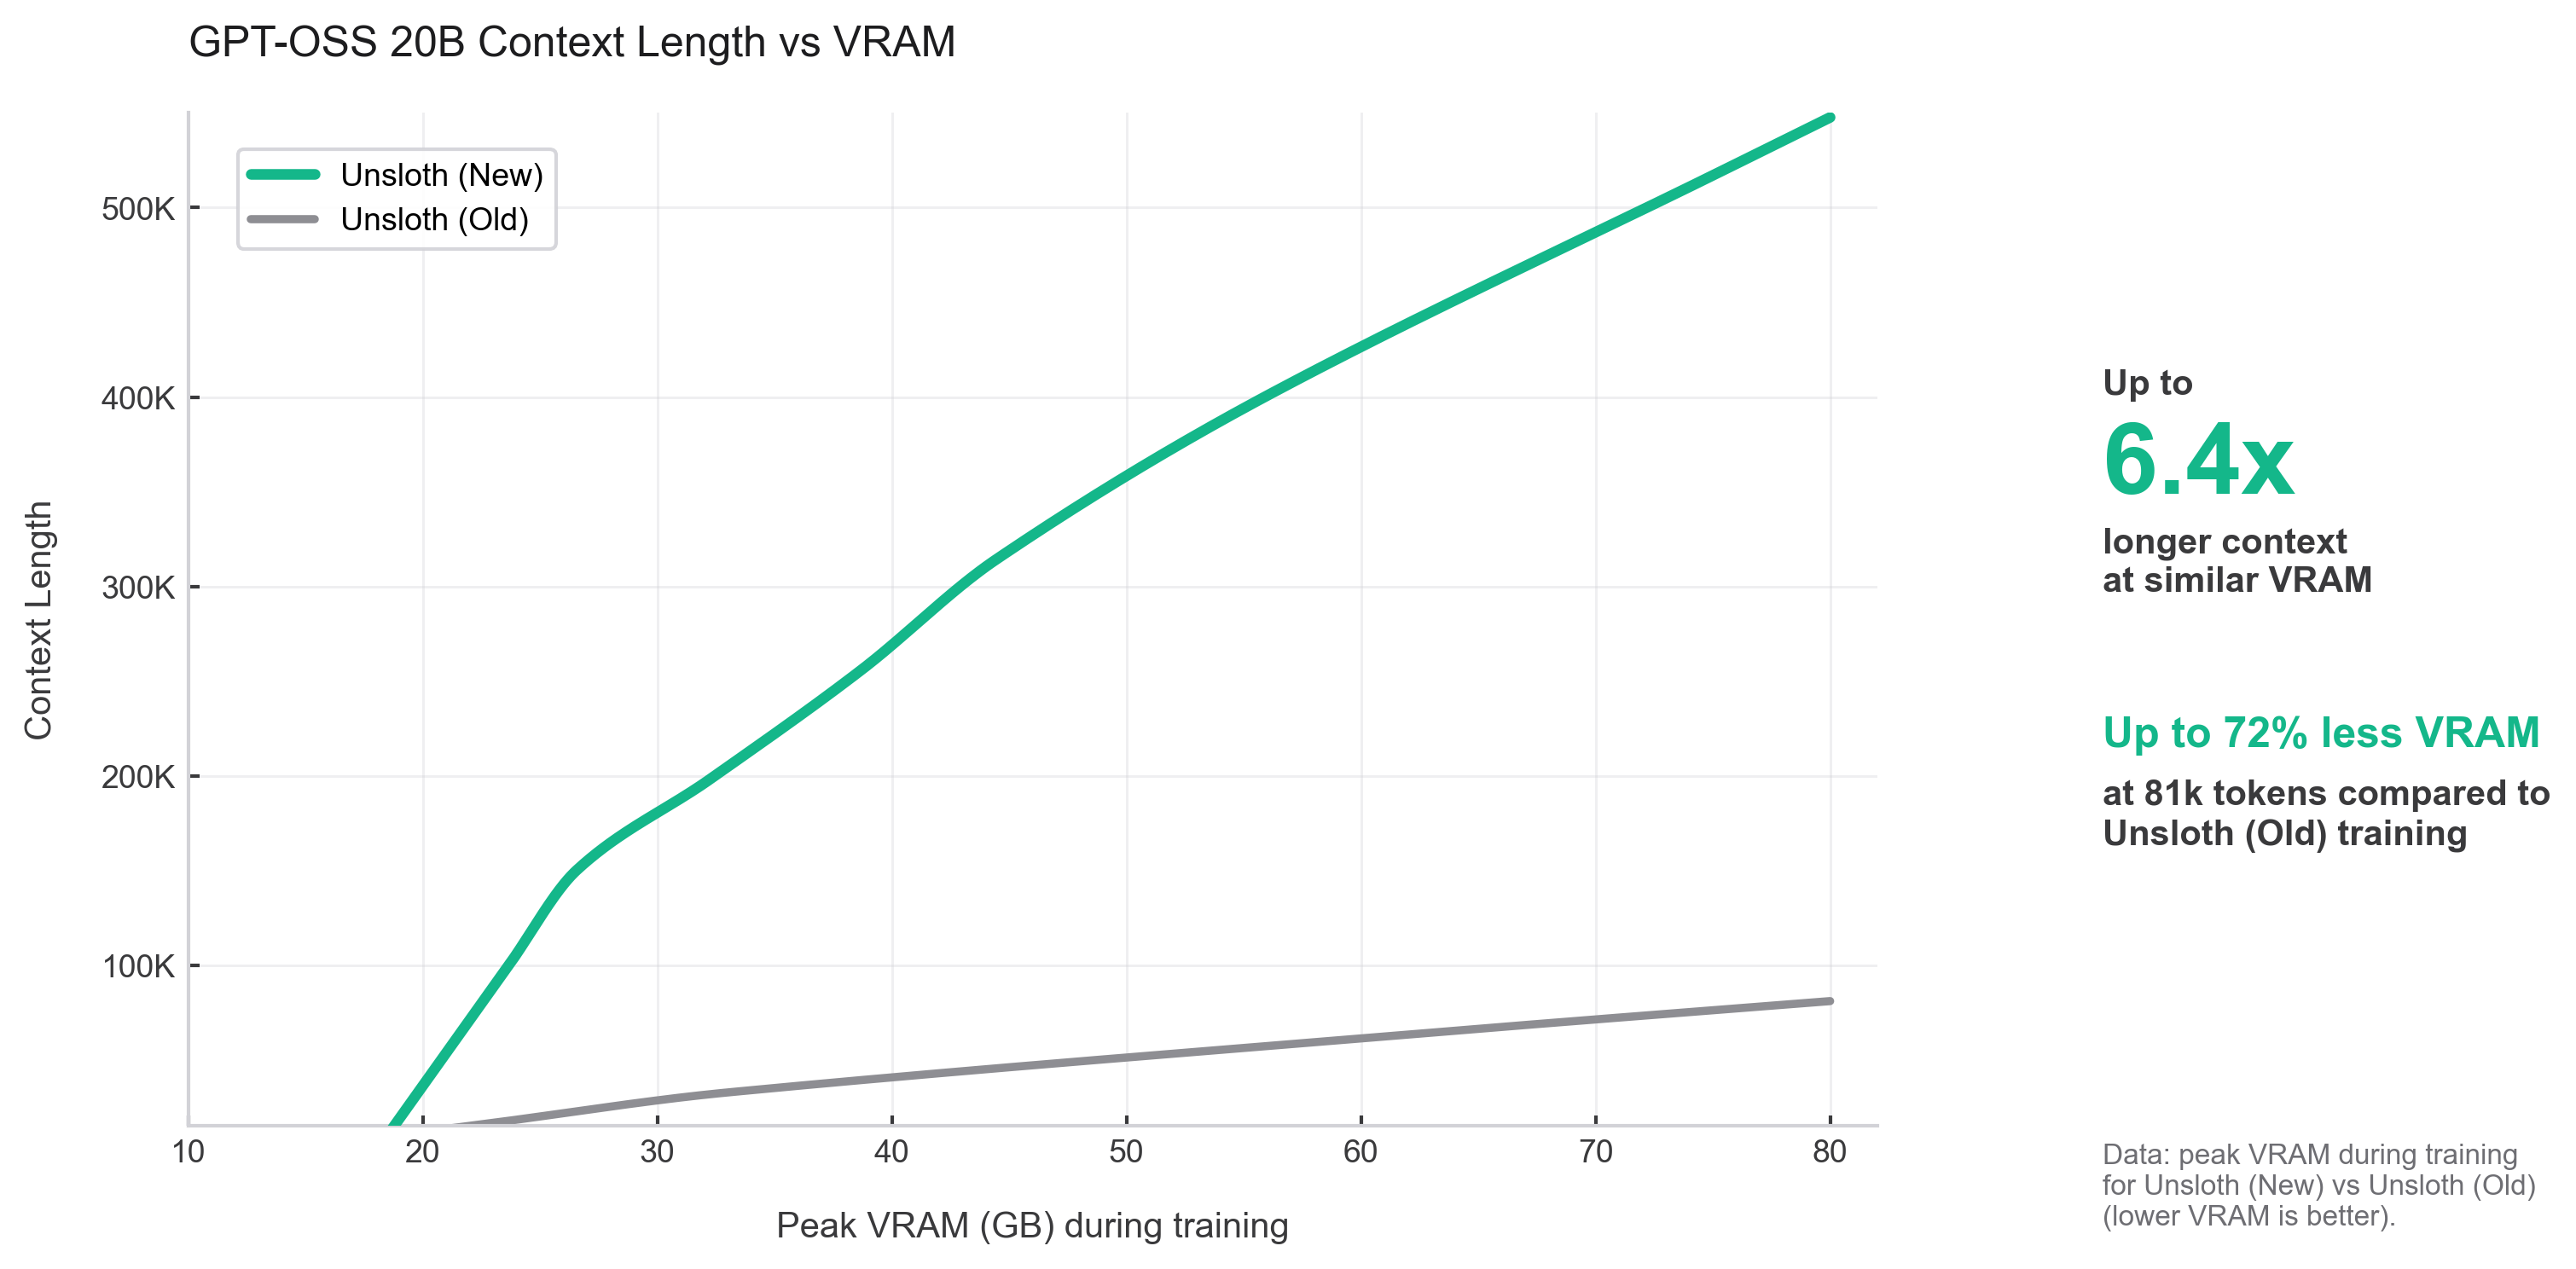
Nous introduisons de nouveaux algorithmes dans Unsloth qui repoussent les limites de l'entraînement à long contexte pour **tout LLM et VLM**. L'entraînement de LLMs comme gpt-oss-20b peut désormais atteindre **des longueurs de contexte de plus de 500K** sur un seul GPU H100 de 80 Go, contre 80K auparavant, sans dégradation de la précision.
Vous pouvez atteindre >**des fenêtres de contexte de 750K** sur un GPU B200 de 192 Go.
> **Essayez le fine-tuning de gpt-oss-20b avec contexte 500K sur notre** [**notebook Colab A100 de 80 Go**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
Nous avons considérablement amélioré la façon dont Unsloth gère les schémas d'utilisation de la mémoire, la vitesse et les longueurs de contexte :
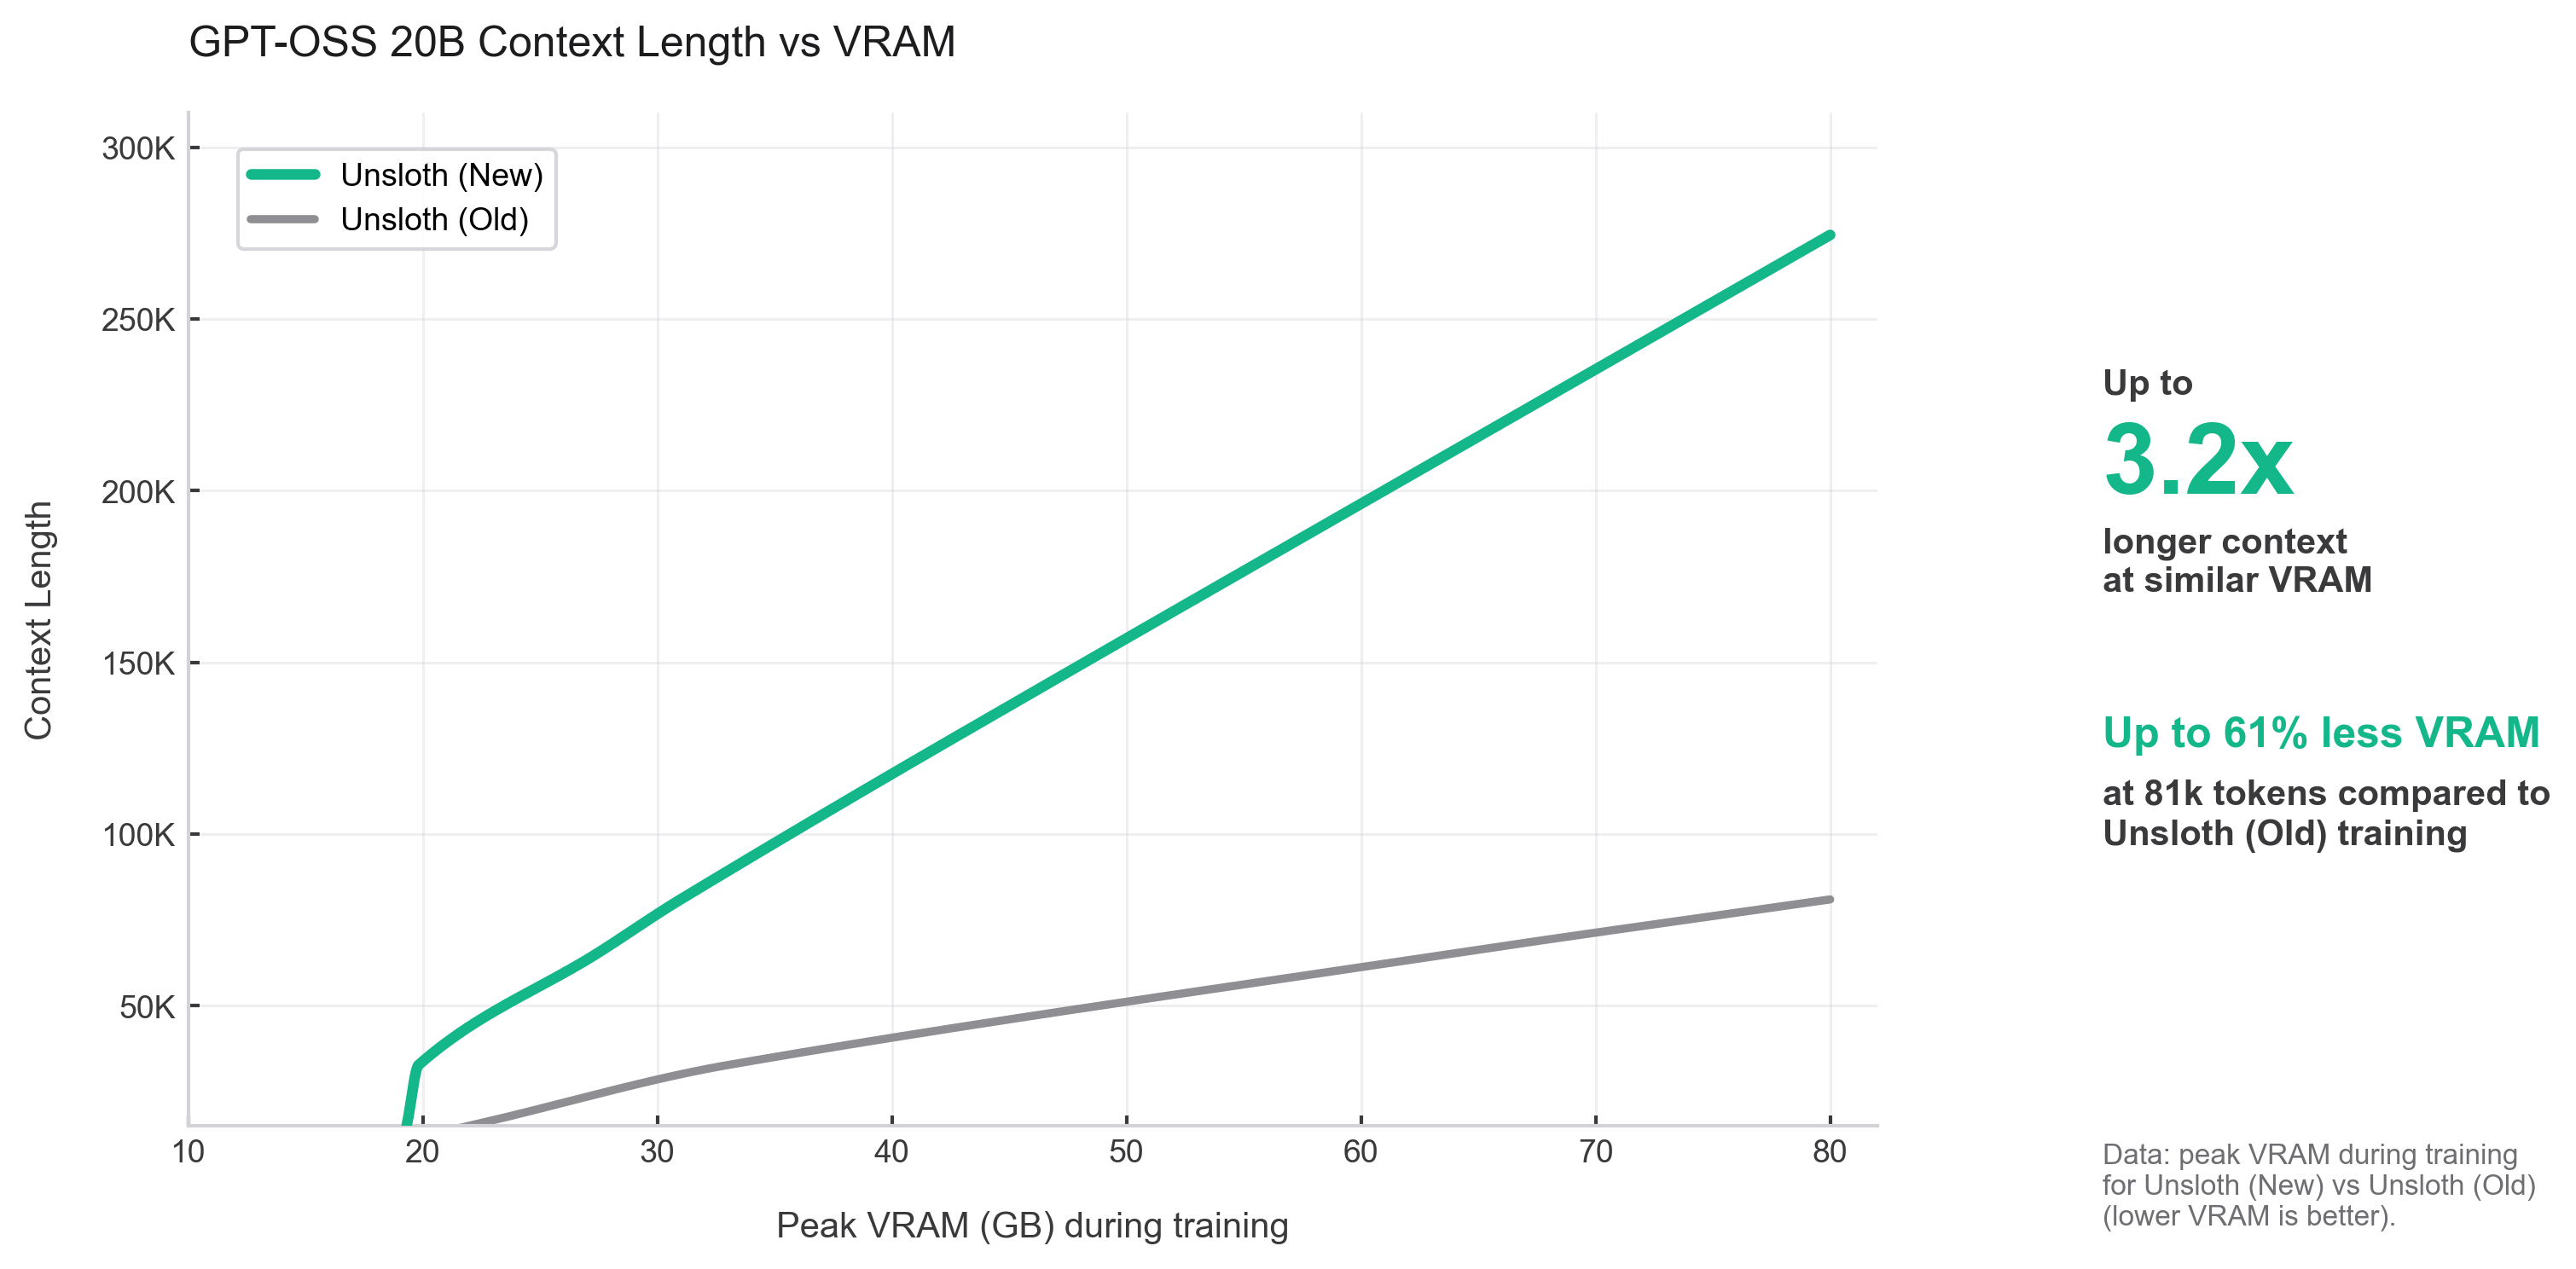
* **60 % de VRAM en moins** par **contexte 3,2× plus long** grâce au nouveau [cross-entropie fusionnée et découpée](#unsloth-loss-refactoring-chunk-and-fuse) perte, sans dégradation de la vitesse ni de la précision
* Déchargement des activations amélioré dans le [**Gradient Checkpointing**](#unsloth-gradient-checkpointing-enhanced)
* En collaboration avec Stas Bekman de Snowflake sur [Tiled MLP](#tiled-mlp-unlocking-500k), permettant 2× plus de contextes
Les algorithmes d’Unsloth permettent à gpt-oss-20b QLoRA (4 bits) avec un contexte de 290K possible sur un H100 sans perte de précision, et 500K+ avec Tiled MLP activé, offrant au total >**des longueurs de contexte 6,4× plus longues.**
### 📐 Refactorisation de la loss d’Unsloth : découper et fusionner
Notre nouvelle implémentation de loss fusionnée ajoute **le découpage dynamique des séquences**: au lieu de calculer les logits de la tête du modèle de langage et les cross-entropies sur toute la séquence en une seule fois, nous traitons des tranches gérables le long de la dimension aplatie de la séquence. Cela réduit le pic mémoire de plusieurs Go à des tailles de chunk plus petites. Chaque chunk exécute toujours une passe avant + arrière entièrement fusionnée via `torch.func.grad_and_value` , et conserve la précision en précision mixte en remontant en float32 si nécessaire. **Ces changements ne dégradent ni la vitesse d’entraînement ni la précision.**
L’innovation clé est que la **taille des chunks est choisie automatiquement à l’exécution** en fonction de la VRAM disponible.
* Si vous avez plus de VRAM libre, des chunks plus grands sont utilisés pour des exécutions plus rapides
* Si vous avez moins de VRAM, cela augmente le nombre de chunks pour éviter les débordements mémoire.
Cela **supprime le réglage manuel** et rend notre algorithme robuste sur les anciens et nouveaux GPU, les charges de travail et différentes longueurs de séquence.
{% hint style="success" %}
Grâce au réglage automatique, **les contextes plus petits utiliseront plus de VRAM** (moins de chunks) pour **éviter une surcharge inutile**. Pour les graphiques ci-dessus, nous ajustons le nombre de chunks de loss pour refléter des paliers réalistes de VRAM. Avec 80 Go de VRAM, cela donne des contextes >3,2× plus longs.
{% endhint %}
### 🏁 Améliorations du Gradient Checkpointing d’Unsloth
Notre [Le Gradient Checkpointing d’Unsloth](https://unsloth.ai/blog/long-context) algorithme, **introduit en avril 2024**, est rapidement devenu populaire et la norme dans l’industrie, après avoir été intégré dans la plupart des packages d’entraînement aujourd’hui. Il décharge les activations vers la RAM CPU, ce qui a permis des longueurs de contexte 10x plus longues. Nos nouvelles améliorations utilisent CUDA Streams et d’autres astuces pour ajouter au maximum **0.1%** de surcharge d’entraînement sans impact sur la précision. Auparavant, cela ajoutait 1 à 3 % de surcharge d’entraînement.
{% code expandable="true" %}
```python
# Version originale d’Unsloth publiée en avril 2024 - sous licence LGPLv3
class Unsloth_Offloaded_Gradient_Checkpointer(torch.autograd.Function):
@staticmethod
@torch_amp_custom_fwd
def forward(ctx, forward_function, hidden_states, *args):
ctx.device = hidden_states.device
saved_hidden_states = hidden_states.to("cpu", non_blocking = True)
with torch.no_grad():
output = forward_function(hidden_states, *args)
ctx.save_for_backward(saved_hidden_states)
ctx.forward_function, ctx.args = forward_function, args
return output
@staticmethod
@torch_amp_custom_bwd
def backward(ctx, dY):
(hidden_states,) = ctx.saved_tensors
hidden_states = hidden_states.to(ctx.device, non_blocking = True).detach()
hidden_states.requires_grad_(True)
with torch.enable_grad():
(output,) = ctx.forward_function(hidden_states, *ctx.args)
torch.autograd.backward(output, dY)
return (None, hidden_states.grad,) + (None,)*len(ctx.args)
```
{% endcode %}
En déchargeant les activations dès qu’elles sont produites, nous minimisons l’empreinte maximale des activations et libérons la mémoire GPU exactement quand elle est nécessaire. Cela réduit fortement la pression mémoire lors d’un entraînement à long contexte ou avec de grands batchs, où les activations d’une seule couche décodeur peuvent dépasser 2 Go.
> **Ainsi, les nouveaux algorithmes d’Unsloth et le Gradient Checkpointing contribuent à la majeure partie des améliorations (3,2x), permettant un fine-tuning QLoRA de GPT-OSS avec une longueur de contexte de 290k sur un seul H100.**
### 🔓 Tiled MLP : débloquer 500K+
Avec l’aide de [Stas Bekman](https://x.com/StasBekman) (Snowflake), nous avons intégré Tiled MLP à partir de l’entraînement Arctic Long Sequence de Snowflake [article](https://arxiv.org/abs/2506.13996) et de l’article de blog. TiledMLP réduit la mémoire d’activation et permet des longueurs de séquence beaucoup plus longues en mettant en tuiles les états cachés le long de la dimension de séquence avant les projections MLP lourdes.
**Nous présentons également quelques améliorations pratiques :**
Nous conservons l’état RNG entre les recalculs de forward découpés afin que le dropout et les autres opérations stochastiques soient cohérents entre les relectures forward et backward. Cela maintient les calculs checkpointés imbriqués stables et numériquement identiques.
{% hint style="success" %}
Notre implémentation corrige automatiquement tout module nommé ou typé comme `mlp`, donc **presque tous les modèles avec des modules MLP sont pris en charge nativement pour Tiled MLP.**
{% endhint %}
**Compromis à garder à l’esprit**
TiledMLP économise de la VRAM au prix de passes avant supplémentaires. Comme il se trouve à l’intérieur d’un bloc transformer checkpointé et qu’il est lui-même écrit selon un style checkpoint, il devient en pratique un checkpoint imbriqué : un **MLP effectue désormais \~3 passes avant et 1 passe arrière par étape**. En retour, nous pouvons supprimer presque toutes les activations intermédiaires du MLP de la VRAM tout en prenant en charge des séquences extrêmement longues.
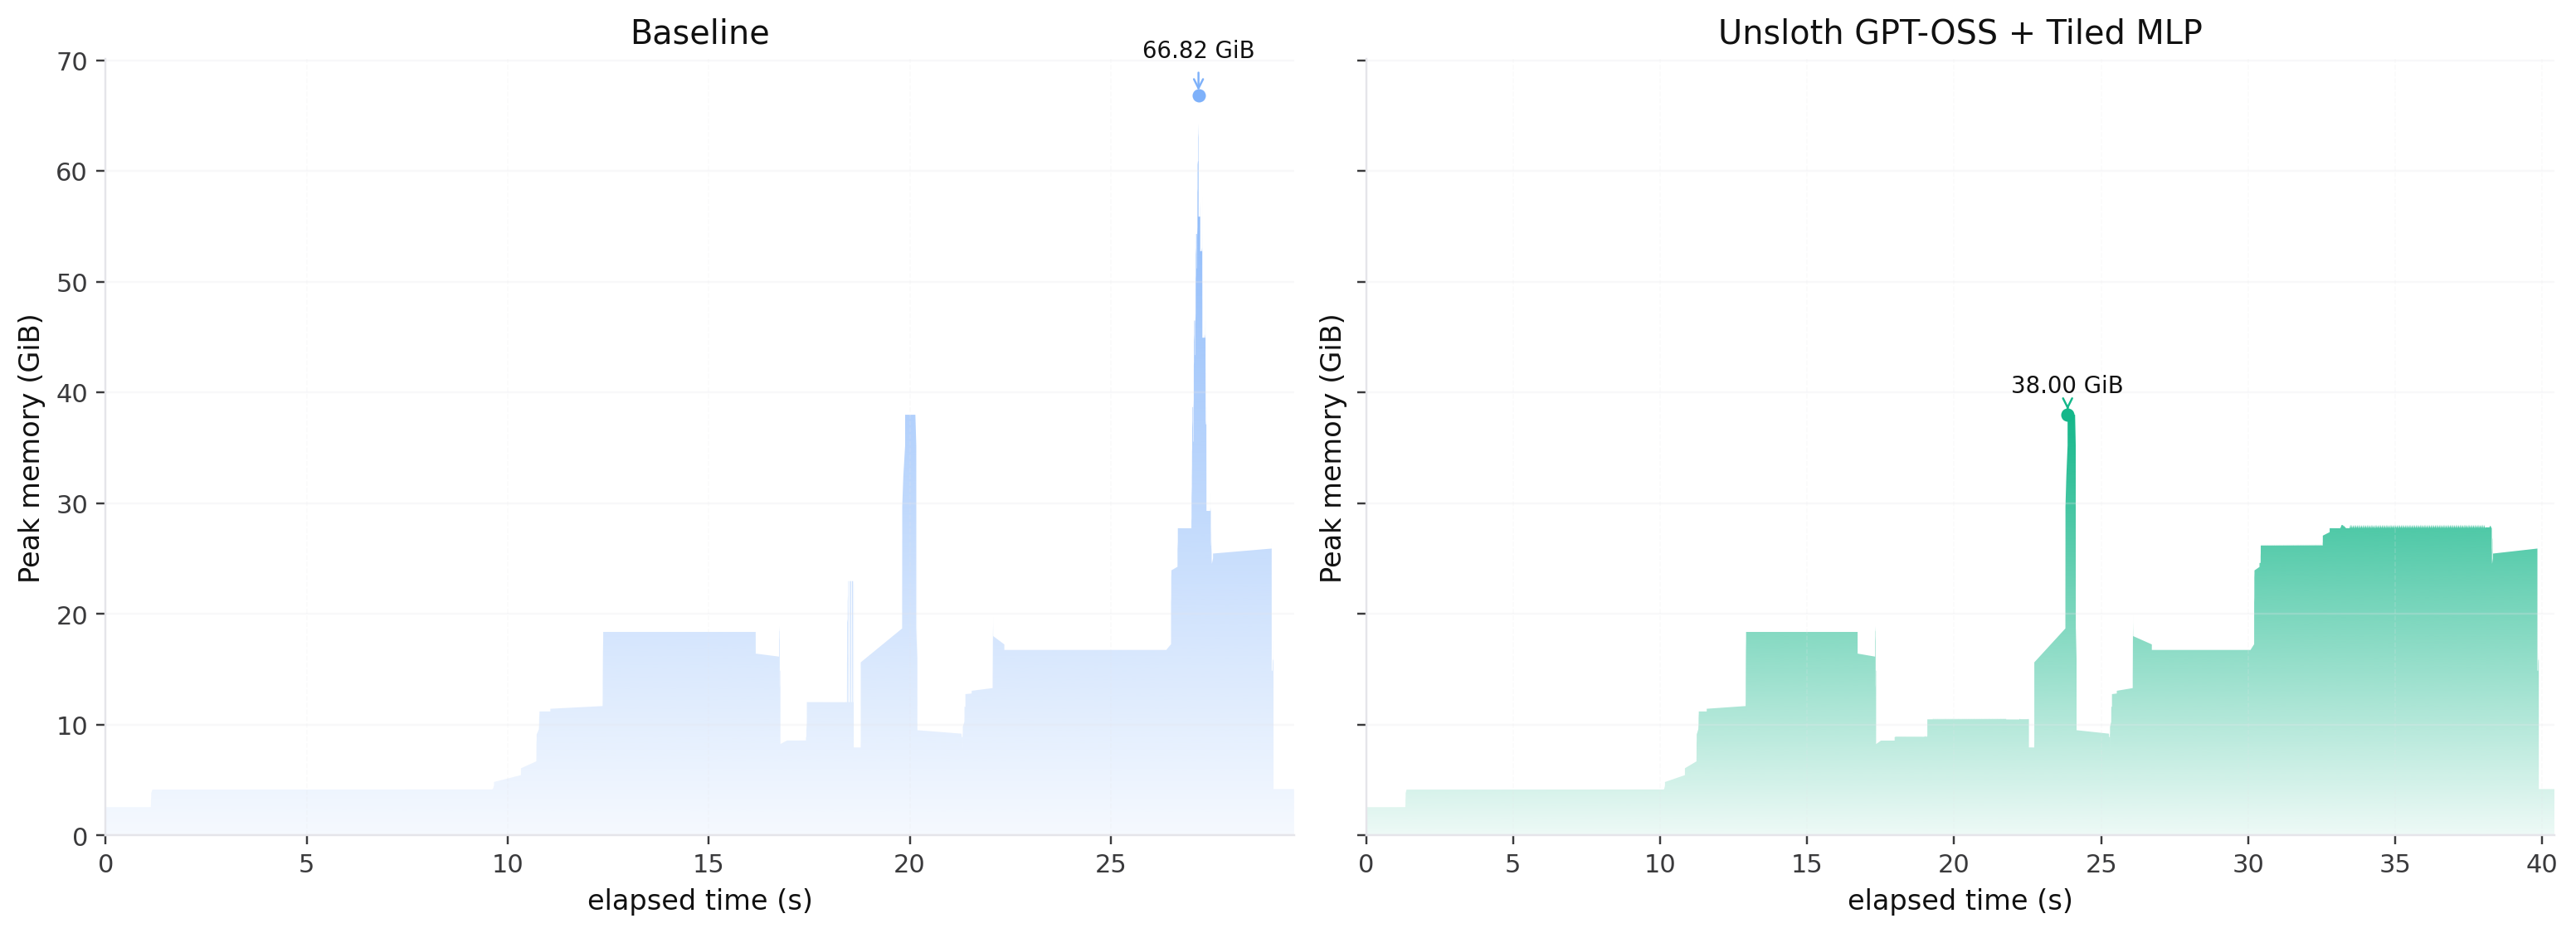
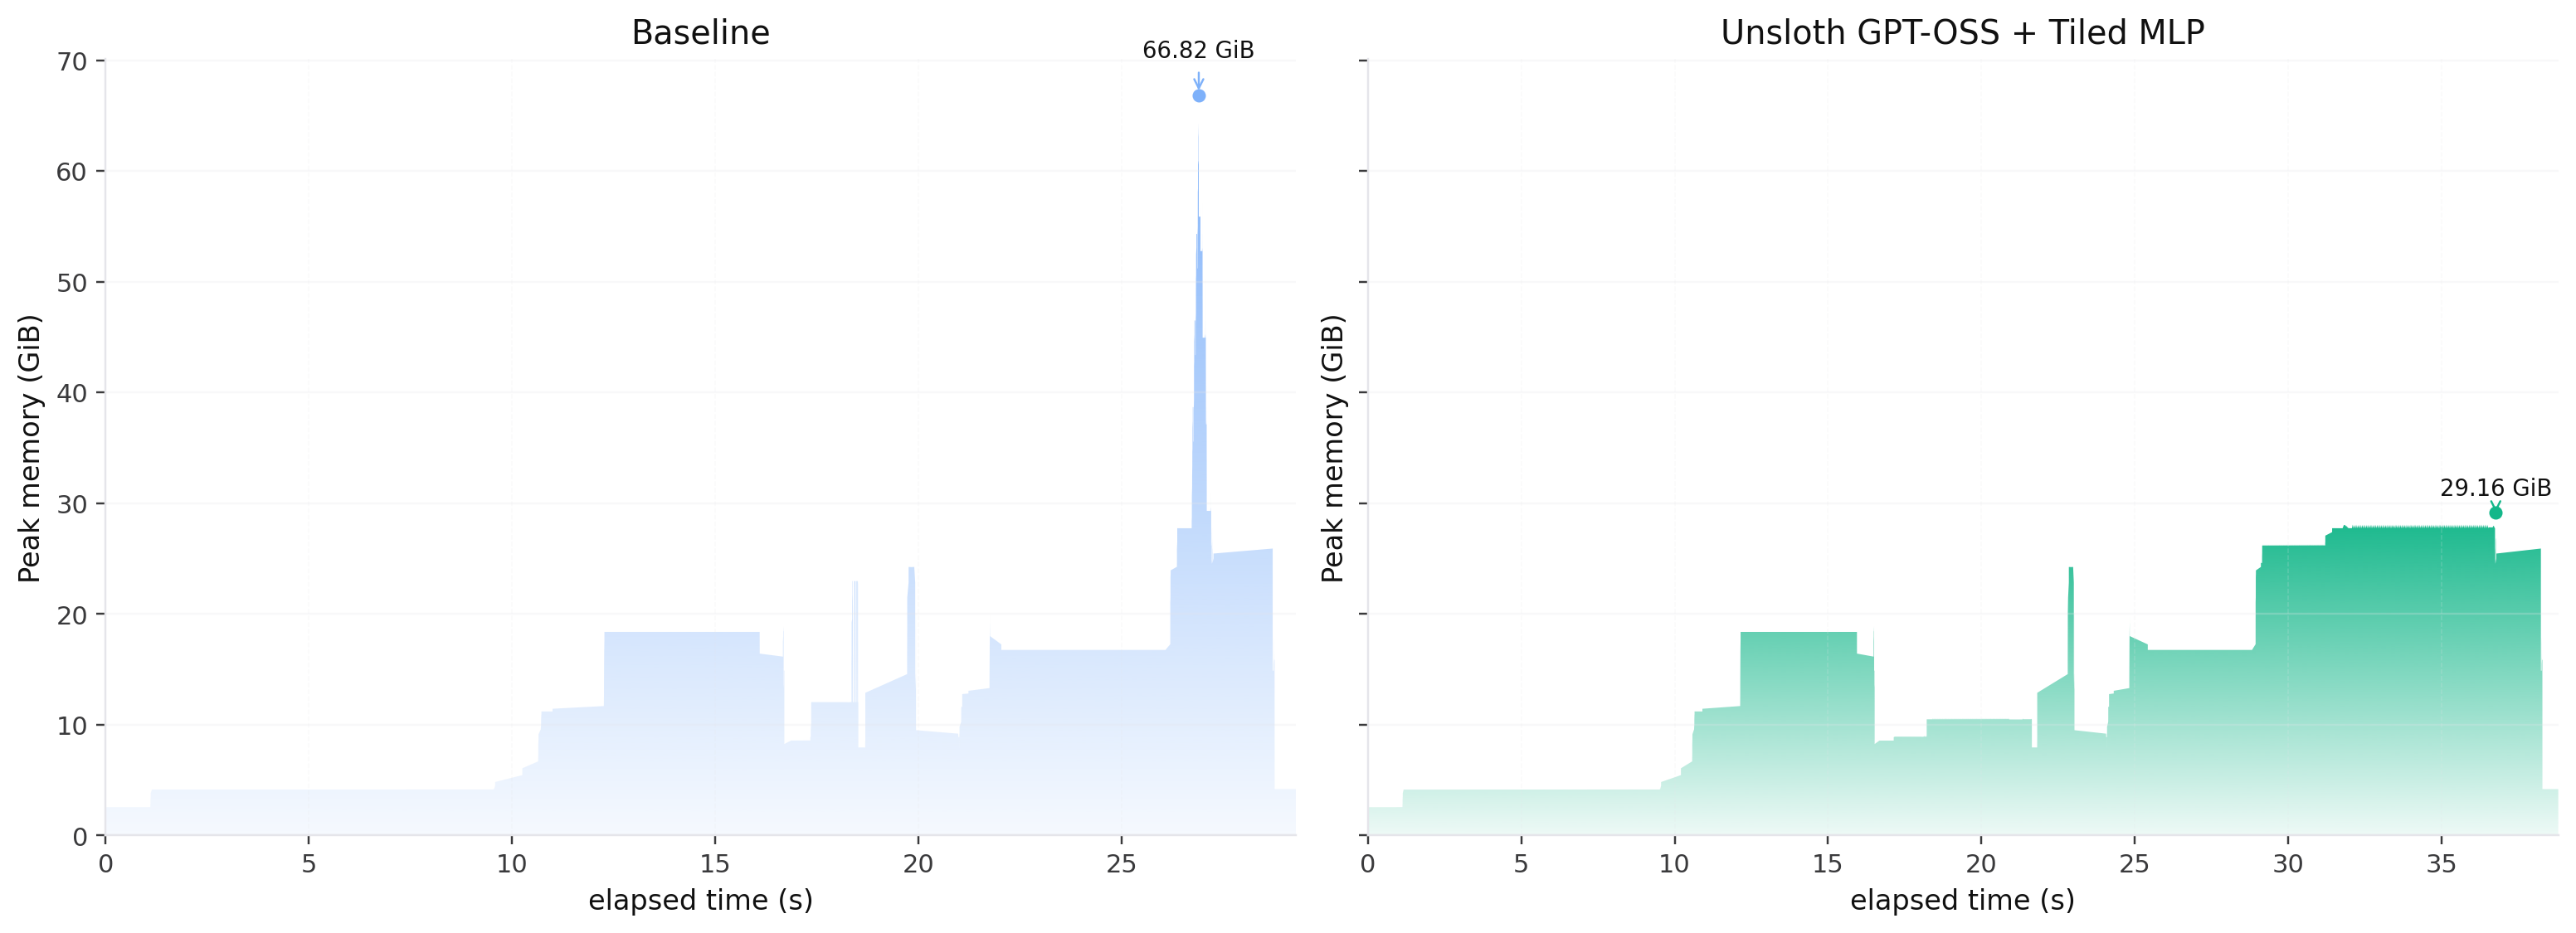
Les graphiques comparent les chronologies de mémoire active pour l’aller-retour d’une seule couche décodeur lors d’une étape d’entraînement à long contexte, sans Tiled MLP (à gauche) et avec (à droite). Sans Tiled MLP, le pic de VRAM se produit pendant la rétropropagation du MLP ; avec Tiled MLP, il se déplace vers le calcul de la loss fusionnée. Nous observons une utilisation de VRAM \~40 % plus faible, et comme la loss fusionnée se découpe automatiquement de façon dynamique selon la VRAM disponible, le pic avec Tiled MLP serait encore plus faible sur des GPU plus petits.
Pour montrer que la perte d’entropie croisée n’est pas le nouveau goulot d’étranglement, nous fixons sa taille de chunk au lieu de la choisir dynamiquement puis doublons le nombre de chunks. Cela réduit considérablement les pics mémoire liés à la loss. La mémoire maximale survient désormais pendant le backward dans les deux cas, et le timing global est similaire, bien que Tiled MLP ajoute une petite surcharge : une grande GEMM devient de nombreuses multiplications matricielles séquentielles, plus la passe avant supplémentaire mentionnée ci-dessus.
Dans l’ensemble, le compromis en vaut la peine : sans Tiled MLP, l’entraînement à long contexte peut nécessiter environ 2× plus de mémoire, tandis qu’avec **Tiled MLP, un seul GPU ne paie qu’une augmentation d’environ 1,3× du temps par étape pour la même longueur de contexte.**
**Activation de Tiled MLP dans Unsloth :**
```py
model, tokenizer = FastLanguageModel.from_pretrained(
...,
unsloth_tiled_mlp = True,
)
```
Il suffit de définir `unsloth_tiled_mlp = True` dans `from_pretrained` et Tiled MLP est activé. Nous suivons la même logique que l’article Arctic et choisissons `num_shards = ceil(seq_len/hidden_size)`. Chaque tuile opérera sur des longueurs de séquence de la même taille que la dimension cachée du modèle afin d’équilibrer le débit et les économies de mémoire.
Nous avons également discuté du fait que Tiled MLP effectue en pratique 3 passes avant et 1 arrière, par rapport au gradient checkpointing normal qui effectue 2 passes avant et 1 arrière, avec Stas Bekman et [DeepSpeed](https://github.com/deepspeedai/DeepSpeed/pull/7664) a fourni une mise à jour de la documentation pour Tiled MLP dans DeepSpeed.
{% hint style="success" %}
La prochaine fois que le fine-tuning manque de mémoire, essayez d’activer `unsloth_tiled_mlp = True`. Cela devrait économiser de la VRAM tant que la longueur de contexte est supérieure à la dimension cachée du LLM.
{% endhint %}
***
**Grâce à notre dernière mise à jour, il est désormais possible d’atteindre une longueur de contexte de 1M avec un modèle plus petit sur un seul GPU !**
**Essayez le fine-tuning de gpt-oss-20b avec contexte 500K sur notre** [**notebook Colab A100 de 80 Go**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
Si vous êtes arrivé jusqu’ici, nous publions un nouveau blog cette semaine sur nos dernières améliorations de la vitesse d’entraînement, alors restez à l’écoute en rejoignant notre [Reddit r/unsloth](https://www.reddit.com/r/unsloth/) ou nos Docs.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/blog/500k-context-length-fine-tuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.