> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/notions-de-base/claude-code.md).
# Comment exécuter des LLM locaux avec Claude Code
Guide pour utiliser des modèles ouverts avec Claude Code sur votre appareil local.
Ce guide étape par étape vous montre comment connecter des LLMs et des API ouverts à Claude Code entièrement en local, avec captures d’écran à l’appui. Exécutez-le à l’aide de n’importe quel modèle ouvert comme Qwen3.6, DeepSeek et Gemma.
{% columns %}
{% column width="58.333333333333336%" %}
Pour ce tutoriel, nous utiliserons les modèles ouverts : [Gemma 4](/docs/fr/modeles/gemma-4.md) et [Qwen3.5](/docs/fr/modeles/qwen3.5.md) qui sont de solides modèles agentiques et de codage (fonctionne sur un appareil avec 24 Go de RAM/mémoire unifiée).
Pour l’inférence, nous utiliserons [Unsloth Desktop](https://github.com/unslothai/unsloth) et [`llama.cpp`](https://github.com/ggml-org/llama.cpp) qui vous permet d’exécuter/déployer des LLMs sur macOS, Linux et Windows. Vous pouvez utiliser n’importe quel autre modèle. Pour les quantifications de modèle, nous utilisons Unsloth [Dynamic GGUFs](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour exécuter n’importe quel LLM quantifié, tout en conservant la précision.
{% endcolumn %}
{% column width="41.666666666666664%" %}
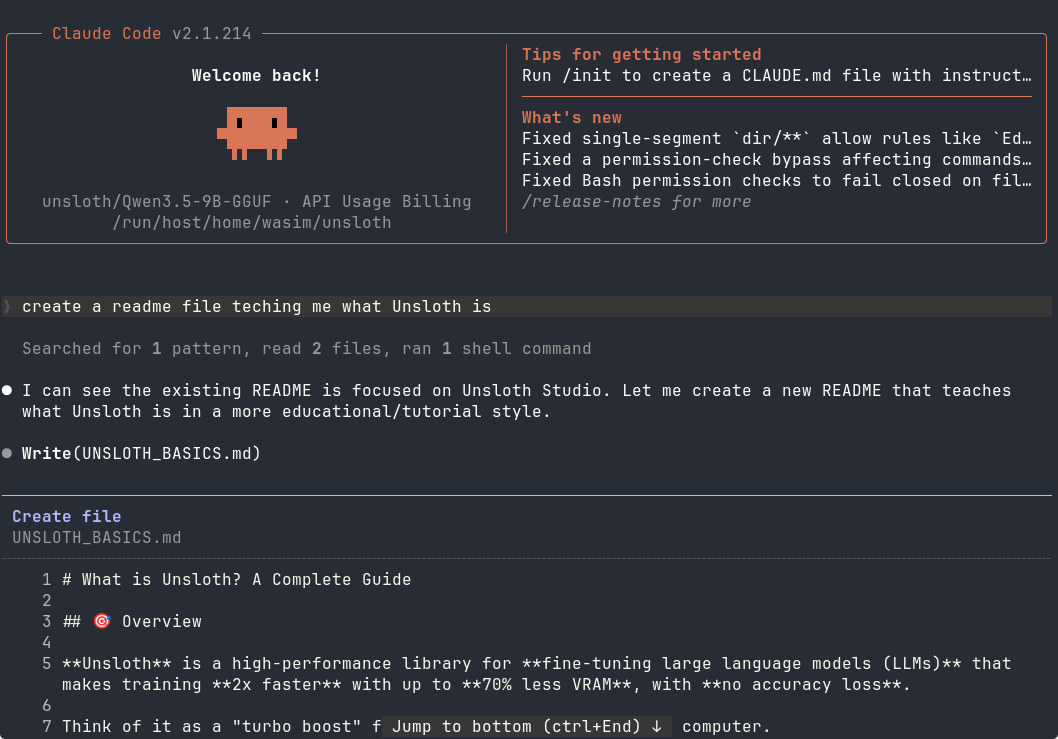
Claude Code exécuté localement avec Qwen3.5.
{% endcolumn %}
{% endcolumns %}
Configuration de Claude Code📖 Tutoriel de configuration du modèle local
## :claude: Configuration de Claude Code
Avant de configurer notre LLM local, nous devons installer Claude Code. Claude Code est un agent de codage basé sur le terminal qui comprend votre base de code et gère des workflows Git complexes en utilisant le langage naturel.
{% tabs %}
{% tab title="macOS, Linux, WSL" %}
#### **Installer Claude Code :**
Collez dans votre terminal pour installer Claude Code :
```bash
curl -fsSL https://claude.ai/install.sh | bash
```
Après l’installation, rendez-vous dans le dossier de votre projet. Puis tapez `claude` dans le `shell` pour commencer.
```bash
cd ~/projects/my-project
claude
```
{% endtab %}
{% tab title="Windows" %}
#### **Installer Claude Code :**
Entrez dans `PowerShell` pour installer Claude Code :
```powershell
irm https://claude.ai/install.ps1 | iex
```
Après l’installation, rendez-vous dans le dossier de votre projet. Puis tapez `claude` dans le `powershell` pour commencer.
cd /path/to/your/project
claude
{% endtab %}
{% endtabs %}
### :detective:Corriger une inférence 90 % plus lente dans Claude Code
{% hint style="warning" %}
Claude Code ajoute récemment en préfixe un en-tête d’attribution Claude Code, ce qui **invalide le cache KV, rendant l’inférence 90 % plus lente avec des modèles locaux**.
{% endhint %}
L’attribution est une ligne ajoutée au début de **début du prompt système** (`x-anthropic-billing-header: cc_version=...; cch=...;`) dont la valeur change à chaque requête, donc tout le préfixe du prompt rate le cache KV à chaque tour.
La solution la plus simple est de le désactiver en ligne de commande au lancement de Claude Code, afin qu’il n’y ait aucun fichier à modifier :
{% code overflow="wrap" %}
```bash
claude --settings '{"env":{"CLAUDE_CODE_ATTRIBUTION_HEADER":"0","CLAUDE_CODE_ENABLE_TELEMETRY":"0"}}' --model unsloth/gemma-4-26B-A4B-it-GGUF
```
{% endcode %}
{% hint style="info" %}
Les versions récentes de Claude Code prennent aussi en charge `export CLAUDE_CODE_ATTRIBUTION_HEADER=0`; les anciennes versions ignoraient la variable du shell, donc la `--settings` forme ci-dessus (ou le fichier de configuration ci-dessous) est le choix fiable.
{% endhint %}
Pour que ce soit permanent, ajoutez `CLAUDE_CODE_ATTRIBUTION_HEADER` défini à 0 dans `"env"` dans `~/.claude/settings.json`. Par exemple, faites `cat > ~/.claude/settings.json` puis ajoutez ce qui suit (une fois collé, appuyez sur ENTRÉE puis CTRL+D pour l’enregistrer). Si vous avez déjà un `~/.claude/settings.json` fichier, ajoutez simplement `"CLAUDE_CODE_ATTRIBUTION_HEADER" : "0"` dans la section "env", et laissez le reste du fichier de configuration inchangé.
## 📖 Tutoriels de démarrage rapide
{% columns %}
{% column %}
Avant de commencer, nous devons d’abord terminer la configuration du modèle spécifique que vous allez utiliser. Nous utilisons [avatar Unsloth](/docs/fr/nouveau/studio.md) (une interface web) et llama.cpp, qui sont des frameworks open source pour exécuter et servir des LLMs sur vos appareils Mac, Linux et Windows.
Unsloth dispose également d’une capacité unique d’auto-réparation [d’appel d’outils](/docs/fr/nouveau/studio/chat.md#auto-healing-tool-calling) et [la recherche web](/docs/fr/nouveau/studio/chat.md#code-execution) . Voir à droite Claude Code connecté à Unsloth :
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
Connecter Claude Code🦥 Tutoriel Unsloth Tutoriel llama.cpp
## 🦥 Tutoriel Unsloth
Pour ce tutoriel, nous allons servir/connecter des modèles locaux à Claude Code via une interface en utilisant [avatar Unsloth](https://github.com/unslothai/unsloth). Unsloth fonctionne sous Windows, WSL, Linux et MacOS.
{% columns %}
{% column %}
* Rechercher, télécharger, [exécuter des GGUFs](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** des appels d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **la recherche web**
* [**Exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) sélection des paramètres (temp, top-p, etc.)
* Inférence rapide CPU + GPU via llama.cpp
* [Entraîner des LLMs](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
Voir ci-dessous pour les instructions d’installation :
{% endcolumn %}
{% column %}
Exemple de Qwen3.6 2 bits exécuté dans Unsloth.
{% endcolumn %}
{% endcolumns %}
{% stepper %}
{% step %}
#### Télécharger Unsloth
La façon la plus simple de commencer est d'installer l' [Unsloth Desktop](/docs/fr/desktop.md) application. Elle prend en charge [MacOS](/docs/fr/commencer/install/mac.md), Linux, [Windows](/docs/fr/commencer/install/windows-installation.md), [NVIDIA](/docs/fr/commencer/install/pip-install.md), [AMD](/docs/fr/commencer/install/amd.md), Intel et les configurations CPU.
Télécharger Unsloth
* :apple: [Télécharger pour macOS](https://unsloth.ai/download/mac)
* :windows: [Télécharger pour Windows](https://unsloth.ai/download/windows)
* :linux: [Télécharger pour Linux](https://unsloth.ai/download/linux)
Ou, si vous préférez une installation manuelle :
**MacOS, Linux, WSL :**
```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```
**Windows PowerShell :**
```bash
irm https://unsloth.ai/install.ps1 | iex
```
{% endstep %}
{% step %}
#### Installer
1. Ouvrez l’installateur Unsloth (`.dmg`, `.exe` fichiers)
2. Faites glisser Unsloth vers Applications sur Mac ou terminez l’installation sur Windows.
3. Lancez l’application et attendez la fin de l’installation
{% endstep %}
{% step %}
#### Choisir un modèle
Ouvrez le menu déroulant « Select model » en haut ou l’onglet « Model hub », choisissez un modèle et une quantification adaptés à votre appareil, puis téléchargez-le. Une fois terminé, commencez à discuter - aucune configuration requise.
{% endstep %}
{% step %}
#### Unsloth est maintenant prêt
Pour commencer à discuter, tapez un message et appuyez sur Entrée.
* **Connecter les outils :** [Claude Code](/docs/fr/notions-de-base/claude-code.md), [Codex](/docs/fr/notions-de-base/codex.md), recherche web, [MCP](/docs/fr/notions-de-base/mcp.md) et plus encore
* **Entraîner des modèles :** Affiner du texte, de la diffusion, des embeddings, et plus encore
* **Générer des médias :** Créer et entraîner localement des images, des vidéos, du TTS
{% endstep %}
{% endstepper %}
### Guide de chargement du modèle + API
{% stepper %}
{% step %}
#### Sélectionner un modèle
Avant d’utiliser l’API, chargez un modèle depuis le menu déroulant **Select model** dans le coin supérieur gauche de la page Chat.
Dans ce guide, nous utiliserons : `unsloth/gemma-4-26B-A4B-it-GGUF` avec la quantification recommandée `UD-Q4_K_XL` .
{% endstep %}
{% step %}
#### Tester le modèle
Avant d’utiliser le client, envoyez un court message :
{% hint style="info" %}
Cela confirme que le modèle s’est chargé correctement et qu’il est prêt à répondre.
{% endhint %}
{% endstep %}
{% step %}
#### **clé API Unsloth**
Dans Unsloth, ouvrez **Paramètres → API** pour afficher ou créer votre clé API.
Considérez votre clé API comme un mot de passe et évitez de l’exposer dans des captures d’écran ou des dépôts.
{% endstep %}
{% endstepper %}
## ⚙️ Connecter Claude Code
Maintenant que nous avons configuré le LLM local pour Claude Code, nous allons configurer Claude Code pour fonctionner avec votre outil. Vous pouvez soit vous connecter facilement avec `unsloth start` ci-dessous ou le faire [manuellement](#connect-manually).
### ⚡ Exécuter Claude Code avec `unsloth start`
Pour lancer Claude directement avec un modèle, exécutez :
```bash
unsloth start claude \
--model unsloth/Qwen3.8-27B-GGUF-GGUF:UD-Q4_K_XL
--temp 1.0 \\
--top-p 0.95 \\
--top-k 20 \\
--min-p 0.0 \\
--reasoning-effort medium
```
{% hint style="success" %}
S'il n'y a aucun paramètre/drapeau d'échantillonnage défini, Unsloth sélectionne automatiquement les meilleurs paramètres recommandés pour le modèle, notamment la longueur de contexte, la température, etc.
{% endhint %}
Avec un modèle chargé dans Unsloth Studio, ouvrez le dossier de votre projet et exécutez :
```bash
unsloth start claude
```
Claude Code s’exécutant sur le modèle chargé dans Unsloth Studio.
Unsloth définit pour ce lancement le point de terminaison local, la clé API, le modèle et la longueur du contexte. Votre configuration Claude Code habituelle n’est pas modifiée.
Claude Code conserve déjà les conversations dans son stockage de session normal, donc `--persist` n’est pas nécessaire. Reprenez votre dernière session avec :
```bash
unsloth start claude --continue
```
Consultez la `unsloth start` référence pour charger un modèle depuis la ligne de commande, les serveurs Unsloth distants et les options avancées.
Le reste de ce guide couvre la configuration `llama.cpp` manuelle.
#### 🔌 Connexion manuelle
Si vous préférez la configurer manuellement, vous pouvez commencer par définir les variables d’environnement suivantes. Par défaut, ces variables ne persisteront pas entre les sessions.
{% tabs %}
{% tab title="MacOS, Linux, WSL" %}
**Configuration :** Définir l’URL locale de l’API :
```bash
export ANTHROPIC_BASE_URL="http://localhost:8888"
```
Copiez votre clé depuis Unsloth Studio → Settings → API (ou depuis la console lorsque vous le lancez avec `unsloth run`, où elle est affichée comme `sk-unsloth-...`), puis définissez-la.
{% code overflow="wrap" %}
```bash
export ANTHROPIC_AUTH_TOKEN="sk-unsloth-xxxxxxxxxxxx"
```
{% endcode %}
Définissez aussi un `ANTHROPIC_API_KEY` vide afin que Claude Code ne demande pas de clé cloud :
```bash
export ANTHROPIC_API_KEY=""
```
Optionnel : utilisez le nom du modèle actuellement chargé dans Unsloth comme valeur par défaut.
```bash
export ANTHROPIC_MODEL="unsloth/gemma-4-26B-A4B-it-GGUF"
```
Utilisez l’identifiant complet du modèle exactement comme il apparaît dans `GET http://localhost:8888/v1/models` (la même chaîne que celle que vous passez à `claude --model`).
{% endtab %}
{% tab title="Windows" %}
**Configuration :** Définissez l’URL locale de l’API dans Powershell :
```powershell
$env:ANTHROPIC_BASE_URL = "http://localhost:8888"
```
Copiez votre clé depuis **Unsloth Studio → Settings → API**, puis définissez-la :
```powershell
$env:ANTHROPIC_AUTH_TOKEN = "sk-unsloth-xxxxxxxxxxxx"
```
**Optionnel :** Utilisez le nom du modèle actuellement chargé dans Unsloth comme valeur par défaut.
```powershell
$env:ANTHROPIC_MODEL = "gemma-4-26B-A4B-it-GGUF"
```
{% hint style="info" %}
Le nom du modèle doit être celui actuellement chargé dans Unsloth Studio.
{% endhint %}
{% endtab %}
{% endtabs %}
### Démarrer Claude Code
Démarrer Claude Code avec le modèle actuellement chargé dans Unsloth.
Nous utiliserons `gemma-4-26B-A4B-it-GGUF`, mais vous pouvez utiliser n’importe quel modèle compatible avec Unsloth.
```shellscript
claude --model unsloth/gemma-4-26B-A4B-it-GGUF
```
{% hint style="info" %}
Pour un gain de vitesse supplémentaire sur les modèles locaux, vous pouvez aussi lancer avec `--bare --exclude-dynamic-system-prompt-sections`. Voir ci-dessous : Optionnel : réduire le prompt système.
{% endhint %}
Claude Code devrait s’ouvrir et afficher le modèle sélectionné.
{% hint style="warning" %}
Voir [#fixing-90-slower-inference-in-claude-code](#fixing-90-slower-inference-in-claude-code "mention") d’abord pour corriger le fait que les modèles ouverts soient 90 % plus lents à cause de l’invalidation du cache KV.
{% endhint %}
Essayez ce prompt pour rechercher et classer des jeux de données SFT de haute qualité :
{% code overflow="wrap" %}
```
Vous pouvez travailler uniquement dans project/. Ne recherchez pas CLAUDE.md — c’est celui-ci. Utilisez la recherche web pour trouver 10 véritables jeux de données d’instructions/chat/SFT sur Hugging Face, résumez brièvement vos découvertes et expliquez pourquoi chaque jeu de données est pertinent pour le SFT au fur et à mesure de votre recherche, puis créez sft_report.md comme un rapport markdown soigné contenant le classement, le nom du jeu de données, le créateur, 3 à 5 tags pertinents, un court résumé en langage simple, et pourquoi il est utile pour le SFT. Gardez tout concis et lisible, sans énormes dumps de métadonnées, sans descriptions brutes collées, sans longues listes de tags, ni jeux de données hors sujet. La tâche est terminée une fois que sft_report.md contient 10 entrées de jeu de données propres et bien rédigées, et terminez par : “Successfully finetuned a model with Unsloth!
```
{% endcode %}
Après avoir envoyé le prompt, l’agent recherchera sur le web, évaluera les résultats et rédigera le rapport final. Cela peut prendre quelques minutes.
Certains workflows peuvent nécessiter que vous approuviez des actions ou que vous répondiez à des invites de suivi.
{% hint style="info" %}
Certains workflows peuvent nécessiter que vous approuviez des actions ou que vous répondiez à des invites de suivi.
{% endhint %}
Une fois terminé, le fichier généré `sft_report.md` ressemblera à ceci.
{% hint style="warning" %}
Si vous voyez `Impossible de se connecter à l’API (ConnectionRefused)` , n’oubliez pas de désactiver `ANTHROPIC_BASE_URL` via `unset ANTHROPIC_BASE_URL`
Si vous trouvez que les modèles ouverts sont 90 % plus lents, [voyez d’abord ici](#fixing-90-slower-inference-in-claude-code) pour corriger l’invalidation du cache KV.
{% endhint %}
### Optionnel : réduire le prompt système
Claude Code a été conçu pour les modèles hébergés d’Anthropic, donc son prompt système par défaut est volumineux. Sur les modèles locaux, vous pouvez le réduire pour obtenir des réponses plus rapides et une meilleure réutilisation du cache KV en ajoutant deux drapeaux au lancement :
{% code overflow="wrap" %}
```shellscript
claude --model unsloth/gemma-4-26B-A4B-it-GGUF --bare --exclude-dynamic-system-prompt-sections
```
{% endcode %}
{% hint style="info" %}
`--bare` saute la découverte automatique des hooks, compétences, plugins, serveurs MCP et CLAUDE.md (Claude conserve Bash et la lecture/modification de fichiers), et `--exclude-dynamic-system-prompt-sections` déplace les sections par machine hors du préfixe du prompt. Les deux réduisent le prompt et améliorent la réutilisation du cache KV, ce qui rend les modèles locaux sensiblement plus rapides. Ils sont facultatifs et ne modifient pas la configuration de connexion ci-dessus.
{% endhint %}
### Facultatif : ajustez le serveur Unsloth
Claude Code utilise le modèle exécuté dans Unsloth. Vous pouvez personnaliser le comportement du serveur au démarrage.
```bash
# Servir pour un agent de codage : --disable-tools transmet les propres outils de l’agent
unsloth run \\
--model unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_XL \\
--disable-tools \
--reasoning off \
-p 8888
```
{% hint style="warning" %}
Utilisez `--disable-tools` lorsqu’il pilote Claude Code (ou tout autre agent de codage externe). Par défaut, Unsloth Studio exécute ses propres outils côté serveur, ce qui intercepte les appels d’outils de l’agent ; Claude Code répond alors mais ne modifie jamais les fichiers. `--disable-tools` bascule en mode passthrough, afin que les outils Write/Edit/Bash de Claude Code soient utilisés.
{% endhint %}
Utilisez `--reasoning off` pour désactiver le raisonnement, ou `--reasoning on` pour l’activer pour les modèles qui prennent en charge le raisonnement.
```bash
# Exposer l'API sur votre réseau local
unsloth run \\
--model unsloth/gemma-4-26B-A4B-it-GGUF:UD-Q4_K_XL \\
-H 0.0.0.0 \\
-p 8888
```
Cela démarre le serveur sur `0.0.0.0:8888`, permettant aux autres appareils de votre réseau local de se connecter.
Utilisez `-p` pour changer le port sur lequel le serveur s’exécute. Utilisez `-H 0.0.0.0` si vous voulez que des téléphones, ordinateurs portables ou autres appareils de votre réseau puissent se connecter.
Pour une configuration d’exécution plus avancée, consultez la section principale [Ajustement de l’API](https://unsloth.ai/docs/basics/api#unsloth-run-command) .
## 🦙 Tutoriel Llama.cpp
Avant de commencer, nous devons d’abord terminer la configuration du modèle spécifique que vous allez utiliser. Nous utilisons `llama.cpp` qui est un framework open source pour exécuter des LLMs sur vos appareils Mac, Linux, Windows, etc. Llama.cpp contient `llama-server` qui vous permet de servir et de déployer des LLMs efficacement. Le modèle sera servi sur le port 8001, avec tous les outils d’agent routés via un point de terminaison unique compatible OpenAI.
#### Tutoriel Qwen3.5
Nous utiliserons [Qwen3.5](/docs/fr/modeles/qwen3.5.md)-35B-A3B et des réglages spécifiques pour des tâches de codage rapides et précises. Si vous n’avez pas assez de VRAM et que vous voulez un **plus intelligent** modèle, **Qwen3.5-27B** est un excellent choix, mais il sera environ 2x plus lent, ou vous pouvez utiliser d’autres variantes de Qwen3.5 comme 9B, 4B ou 2B.
{% hint style="info" %}
Utilisez Qwen3.5-27B si vous voulez un **plus intelligent** modèle ou si vous n’avez pas assez de VRAM. Cependant, il sera environ 2x plus lent que 35B-A3B. Ou vous pouvez utiliser [**Qwen3-Coder-Next**](/docs/fr/modeles/qwen3-coder-next.md) qui est fantastique si vous avez assez de VRAM.
{% endhint %}
{% stepper %}
{% step %}
#### Installer llama.cpp
Nous devons installer `llama.cpp` pour déployer/servir des LLMs locaux à utiliser dans Claude Code, etc. Nous suivons les instructions de compilation officielles pour obtenir les liaisons GPU correctes et les performances maximales. Changez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n’avez pas de GPU ou si vous voulez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d’habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev git-all -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
#### Télécharger et utiliser des modèles en local
Téléchargez le modèle via `huggingface_hub` en Python (après installation via `pip install huggingface_hub hf_transfer`). Nous utilisons la **UD-Q4\_K\_XL** quantification pour le meilleur équilibre taille/précision. Vous pouvez trouver tous les uploads GGUF d’Unsloth dans notre [Collection ici](/docs/fr/commencer/unsloth-model-catalog.md). Si les téléchargements se bloquent, voir [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)
```bash
hf download unsloth/Qwen3.5-35B-A3B-GGUF \
--local-dir unsloth/Qwen3.5-35B-A3B-GGUF \
--include "*UD-Q4_K_XL*" # Utilisez "*UD-Q2_K_XL*" pour le 2 bits dynamique
```
{% hint style="success" %}
Nous avons utilisé `unsloth/Qwen3.5-35B-A3B-GGUF` , mais vous pouvez utiliser une autre variante comme 27B ou un autre modèle comme `unsloth/`[`Qwen3-Coder-Next`](/docs/fr/modeles/qwen3-coder-next.md)`-GGUF`.
{% endhint %}
{% endstep %}
{% step %}
#### Démarrer le Llama-server
Pour déployer Qwen3.5 pour des charges de travail agentiques, nous utilisons `llama-server`. Nous appliquons [les paramètres d’échantillonnage recommandés par Qwen](/docs/fr/modeles/qwen3.5.md#recommended-settings) pour le mode de réflexion : `temp 0.6`, `top_p 0.95` , `top-k 20`. Gardez à l’esprit que ces valeurs changent si vous utilisez un mode sans réflexion ou d’autres tâches.
Exécutez cette commande dans un nouveau terminal (utilisez `tmux` ou ouvrez un nouveau terminal). Ce qui suit devrait **tenir parfaitement dans un GPU 24 Go (RTX 4090) (utilise 23 Go)** `--fit sur` effectuera aussi un déchargement automatique, mais si vous observez de mauvaises performances, réduisez `--ctx-size` .
{% hint style="info" %}
Nous avons utilisé `--cache-type-k q8_0 --cache-type-v q8_0` pour la quantification du cache KV afin de réduire l’utilisation de VRAM. Pour la pleine précision, utilisez `--cache-type-k bf16 --cache-type-v bf16` .Notez que le cache KV bf16 peut être légèrement plus lent sur certaines machines.
{% endhint %}
```bash
./llama.cpp/llama-server \
--model unsloth/Qwen3.5-35B-A3B-GGUF/Qwen3.5-35B-A3B-UD-Q4_K_XL.gguf \
--alias "unsloth/Qwen3.5-35B-A3B" \
--temp 0.6 \\
--top-p 0.95 \\
--top-k 20 \\
--min-p 0.00 \
--port 8001 \
--kv-unified \
--cache-type-k q8_0 --cache-type-v q8_0
```
{% hint style="success" %}
Vous pouvez aussi désactiver la réflexion pour Qwen3.5, ce qui peut améliorer les performances pour les tâches de codage agentiques. Pour désactiver la réflexion avec llama.cpp, ajoutez ceci à la commande llama-server :
`--chat-template-kwargs "{\"enable_thinking\": false}"`
{% endhint %}
{% endstep %}
{% endstepper %}
### Démarrer Claude Code avec llama-server
{% hint style="success" %}
Nous avons utilisé `unsloth/GLM-4.7-Flash-GGUF` , mais vous pouvez utiliser n’importe quoi comme `unsloth/Qwen3.6-27B-GGUF`.
{% endhint %}
{% hint style="warning" %}
Voir [#fixing-90-slower-inference-in-claude-code](#fixing-90-slower-inference-in-claude-code "mention") d’abord pour corriger le fait que les modèles ouverts soient 90 % plus lents à cause de l’invalidation du cache KV.
{% endhint %}
Rendez-vous dans le dossier de votre projet (`mkdir project ; cd project`) et exécutez :
```bash
claude --model unsloth/GLM-4.7-Flash
```
Pour utiliser Qwen3.6-35B-A3B, changez-le simplement en :
```bash
claude --model unsloth/Qwen3.6-35B-A3B
```
Pour configurer Claude Code afin d’exécuter des commandes sans aucune approbation, faites **(ATTENTION : cela fera exécuter à Claude Code du code comme bon lui semble, sans aucune approbation ! )**
{% code overflow="wrap" %}
```bash
claude --model unsloth/GLM-4.7-Flash --dangerously-skip-permissions
```
{% endcode %}
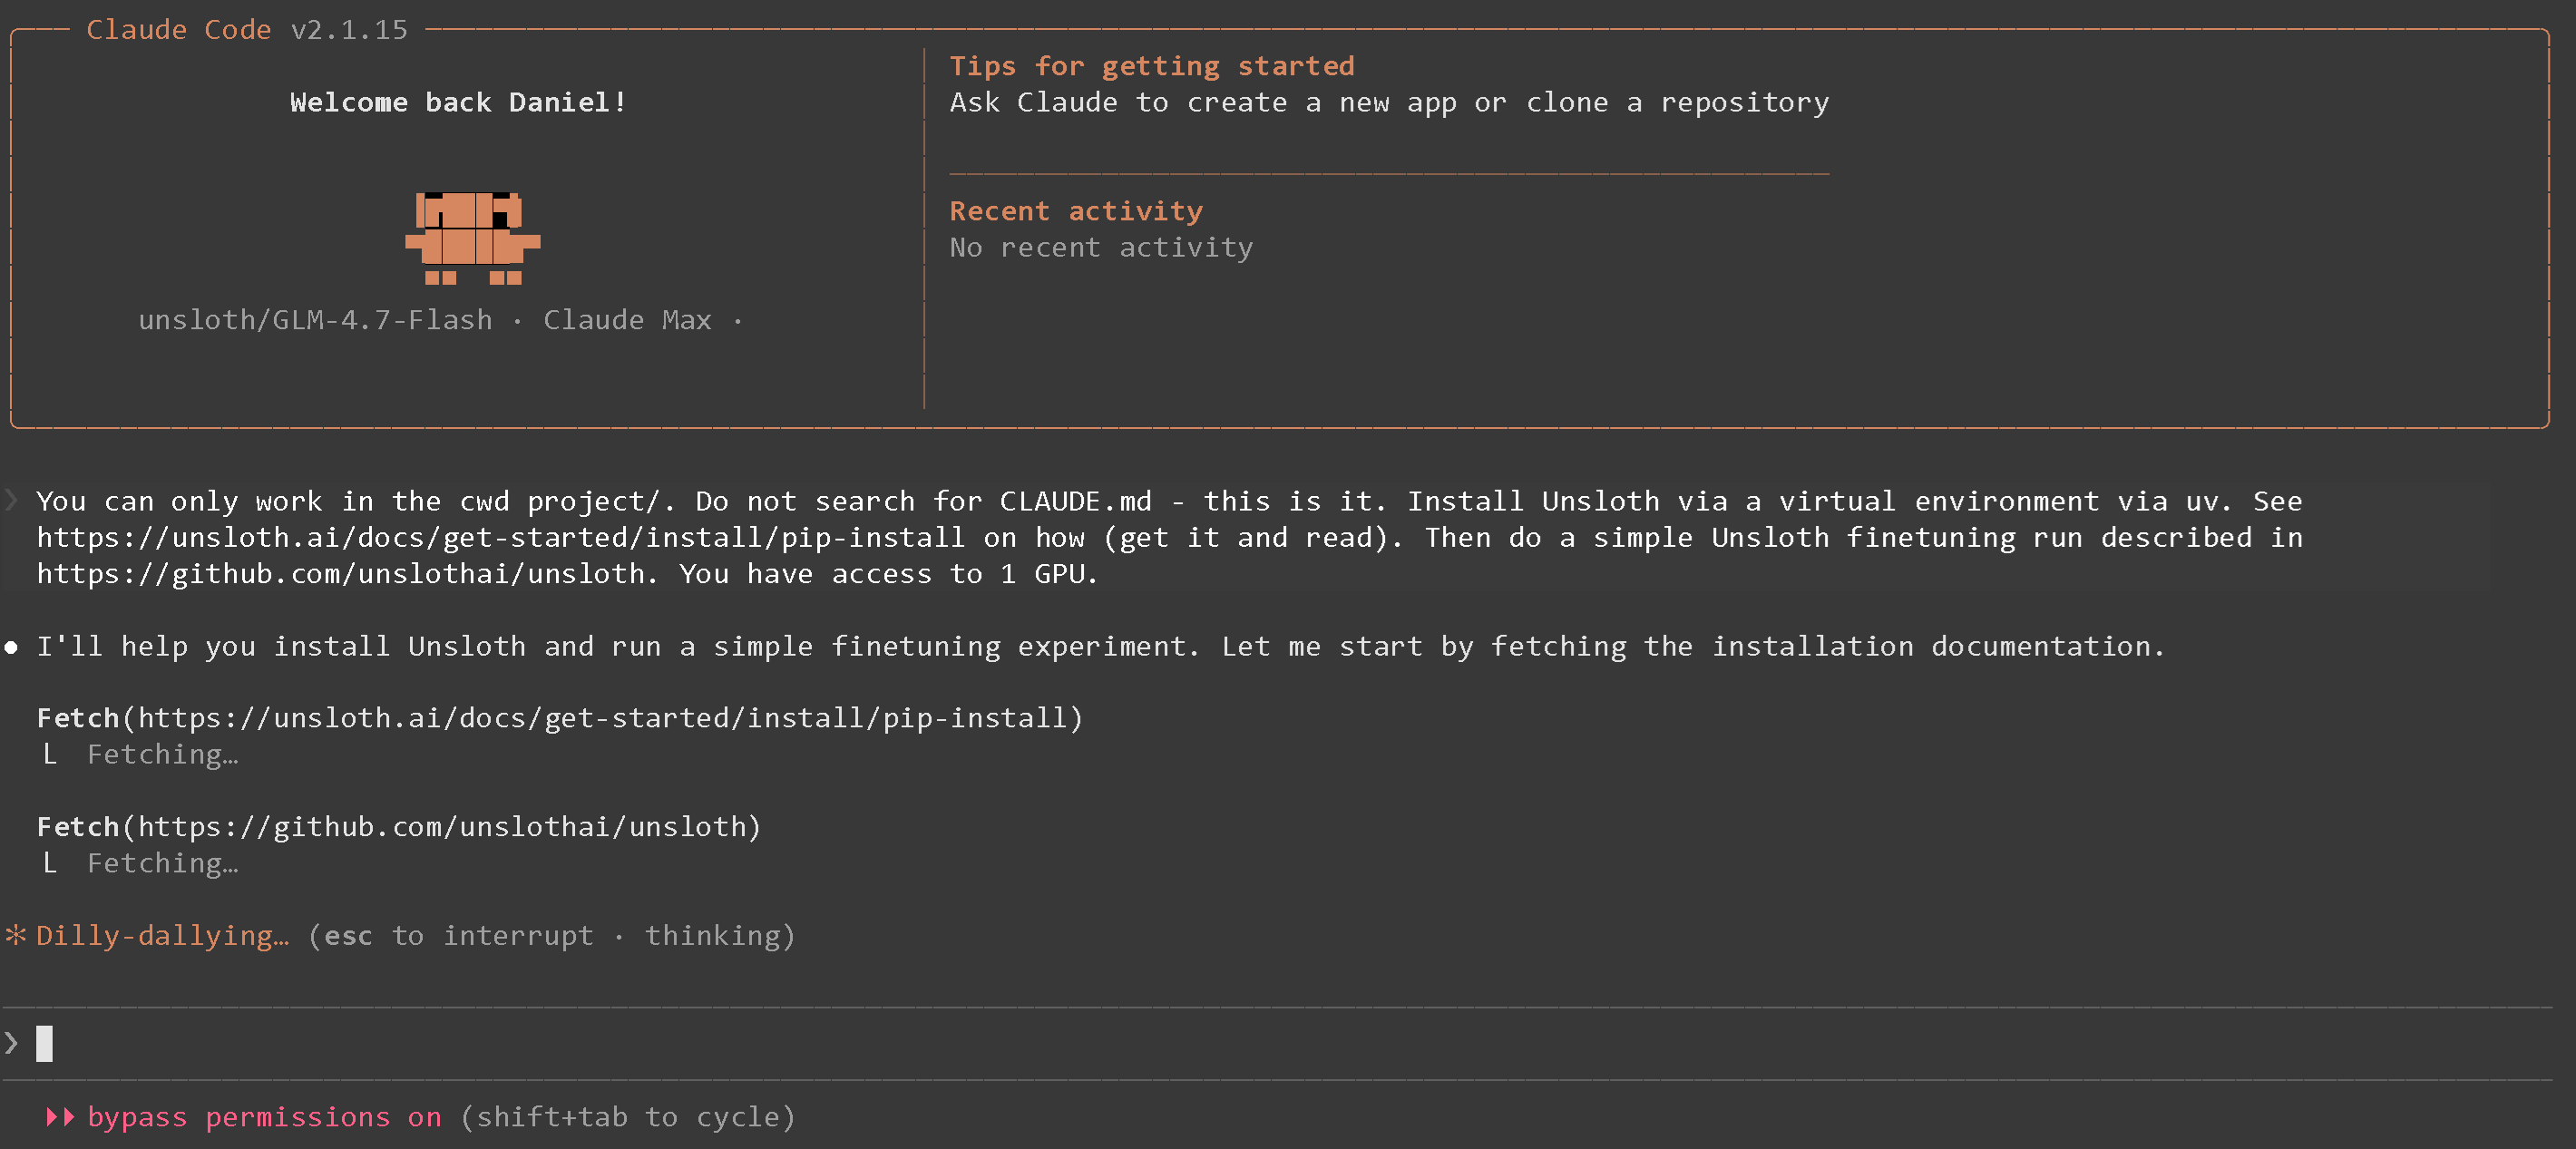
Essayez ce prompt pour installer et exécuter un simple fine-tuning Unsloth :
{% code overflow="wrap" %}
```
Vous pouvez travailler uniquement dans le cwd project/. Ne recherchez pas CLAUDE.md - c’est celui-ci. Installez Unsloth via un environnement virtuel avec uv. Utilisez `python -m venv unsloth_env` puis `source unsloth_env/bin/activate` si possible. Voir https://unsloth.ai/docs/get-started/install/pip-install pour savoir comment faire (récupérez-le et lisez-le). Ensuite, effectuez une exécution simple de fine-tuning Unsloth décrite dans https://github.com/unslothai/unsloth. Vous avez accès à 1 GPU.
```
{% endcode %}
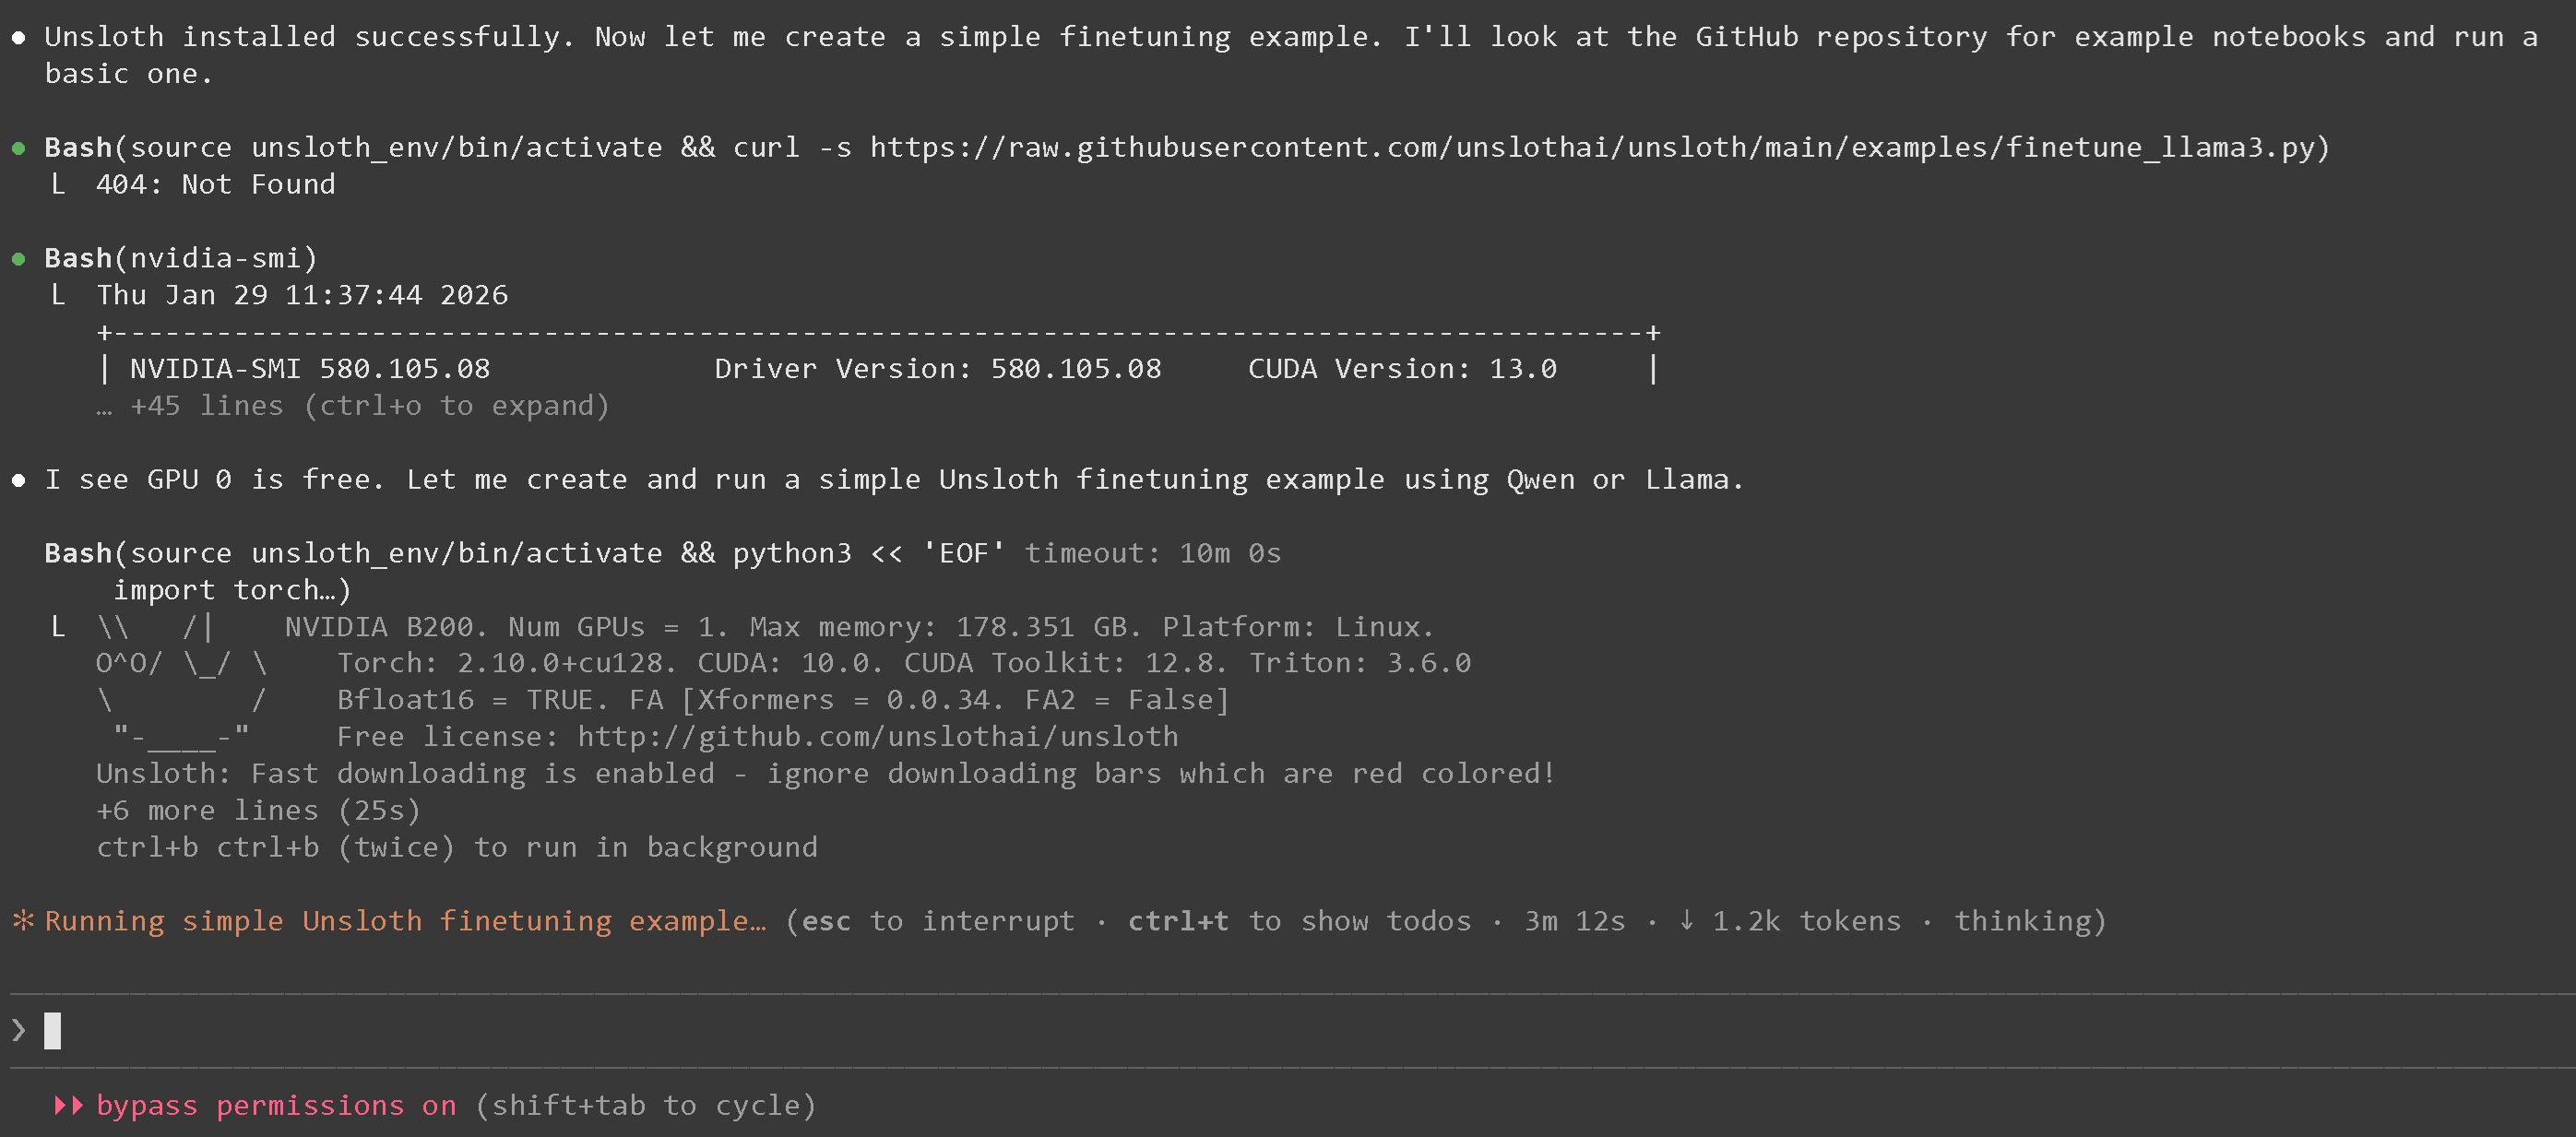
Après avoir attendu un peu, Unsloth sera installé dans un venv via uv, et chargé :
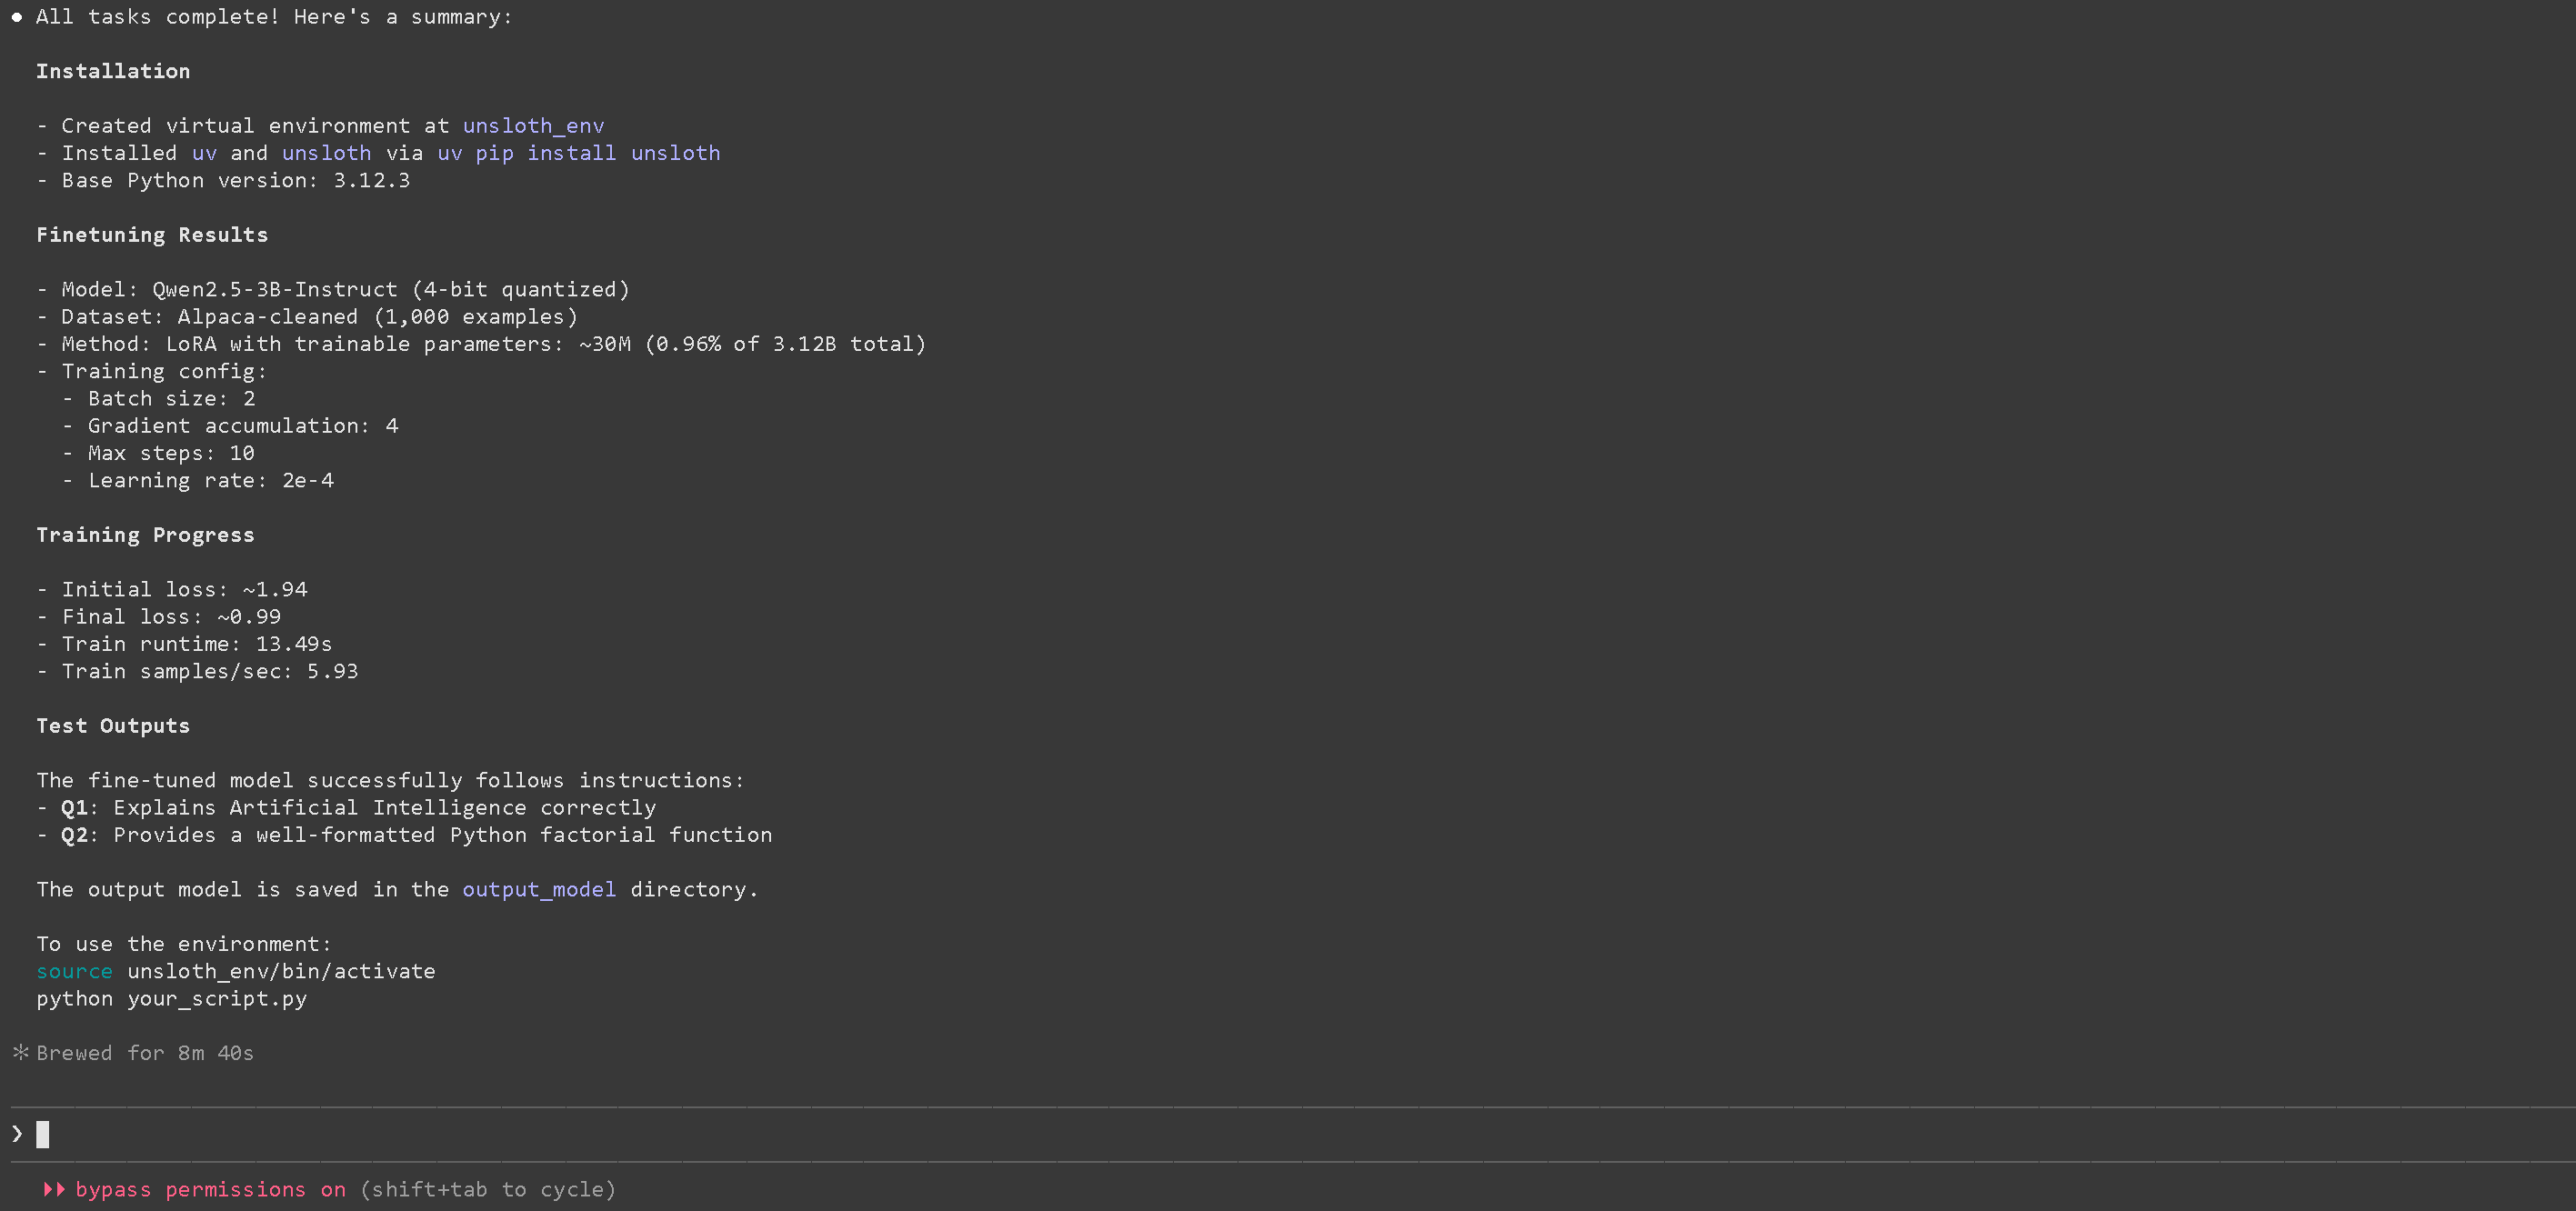
et enfin vous verrez un modèle finement ajusté avec succès avec Unsloth !
{% hint style="warning" %}
Si vous voyez `Impossible de se connecter à l’API (ConnectionRefused)` , n’oubliez pas de désactiver `ANTHROPIC_BASE_URL` via `unset ANTHROPIC_BASE_URL`
Si vous trouvez que les modèles ouverts sont 90 % plus lents, [voyez d’abord ici](#fixing-90-slower-inference-in-claude-code) pour corriger l’invalidation du cache KV.
{% endhint %}
[^1]: À utiliser obligatoirement !
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/notions-de-base/claude-code.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.



 {% endhint %}
{% endstep %}
{% endstepper %}
### Démarrer Claude Code avec llama-server
{% hint style="success" %}
Nous avons utilisé `unsloth/GLM-4.7-Flash-GGUF` , mais vous pouvez utiliser n’importe quoi comme `unsloth/Qwen3.6-27B-GGUF`.
{% endhint %}
{% hint style="warning" %}
Voir [#fixing-90-slower-inference-in-claude-code](#fixing-90-slower-inference-in-claude-code "mention") d’abord pour corriger le fait que les modèles ouverts soient 90 % plus lents à cause de l’invalidation du cache KV.
{% endhint %}
Rendez-vous dans le dossier de votre projet (`mkdir project ; cd project`) et exécutez :
```bash
claude --model unsloth/GLM-4.7-Flash
```
Pour utiliser Qwen3.6-35B-A3B, changez-le simplement en :
```bash
claude --model unsloth/Qwen3.6-35B-A3B
```