> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-ocr-how-to-run-and-fine-tune.md).
# DeepSeek-OCR : comment l'exécuter et le fine-tuner
Guide pour exécuter et fine-tuner DeepSeek-OCR localement.
**DeepSeek-OCR** est un modèle de vision de 3 milliards de paramètres pour l'OCR et la compréhension de documents. Il utilise *la compression optique contextuelle* pour convertir des mises en page 2D en jetons visuels, permettant un traitement efficace à long contexte.
Capable de gérer les tableaux, les documents et l'écriture manuscrite, DeepSeek-OCR atteint 97 % de précision tout en utilisant 10× moins de jetons visuels que de jetons textuels - ce qui le rend 10× plus efficace que les LLM basés sur le texte.
Vous pouvez affiner DeepSeek-OCR pour améliorer ses performances de vision ou de langage. Dans notre Unsloth [**notebook d’affinage gratuit**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\).ipynb), nous avons démontré une [amélioration de 88.26 %](#fine-tuning-deepseek-ocr) pour la compréhension du langage.
Exécution de DeepSeek-OCRFine-tuning de DeepSeek-OCR
> **Notre mise en ligne du modèle qui permet le fine-tuning et davantage de prise en charge de l'inférence :** [**DeepSeek-OCR**](https://huggingface.co/unsloth/DeepSeek-OCR)
## 🖥️ **Exécution de DeepSeek-OCR**
Pour exécuter le modèle dans [vLLM](#vllm-run-deepseek-ocr-tutorial) ou [Unsloth](#unsloth-run-deepseek-ocr-tutorial), voici les paramètres recommandés :
### :gear: Paramètres recommandés
DeepSeek recommande ces paramètres :
* **Température = 0,0**
* `max_tokens = 8192`
* `ngram_size = 30`
* `window_size = 90`
### 📖 vLLM : tutoriel pour exécuter DeepSeek-OCR
1. Obtenez la dernière version `vLLM` par :
```bash
uv venv
source .venv/bin/activate
# Jusqu'à la version v0.11.1, vous devez installer vLLM à partir de la build nightly
uv pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly
```
2. Exécutez ensuite le code suivant :
{% code overflow="wrap" %}
```python
from vllm import LLM, SamplingParams
from vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor
from PIL import Image
# Créer une instance du modèle
llm = LLM(
model="unsloth/DeepSeek-OCR",
enable_prefix_caching=False,
mm_processor_cache_gb=0,
logits_processors=[NGramPerReqLogitsProcessor]
)
# Préparer l'entrée par lots avec votre fichier image
image_1 = Image.open("path/to/your/image_1.png").convert("RGB")
image_2 = Image.open("path/to/your/image_2.png").convert("RGB")
prompt = "\nOCR libre."
model_input = [
{
"prompt": prompt,
"multi_modal_data": {"image": image_1}
},
{
"prompt": prompt,
"multi_modal_data": {"image": image_2}
}
]
sampling_param = SamplingParams(
temperature=0.0,
max_tokens=8192,
# Arguments du processeur de logits n-gram
extra_args=dict(
ngram_size=30,
window_size=90,
whitelist_token_ids={128821, 128822}, # liste blanche :
,
),
skip_special_tokens=False,
)
# Générer la sortie
model_outputs = llm.generate(model_input, sampling_param)
# Afficher la sortie
for output in model_outputs:
print(output.outputs[0].text)
```
{% endcode %}
### 🦥 Unsloth : tutoriel pour exécuter DeepSeek-OCR
1. Obtenez la dernière version `unsloth` via `pip install --upgrade unsloth` . Si vous avez déjà Unsloth, mettez-le à jour via `pip install --upgrade --force-reinstall --no-deps --no-cache-dir unsloth unsloth_zoo`
2. Utilisez ensuite le code ci-dessous pour exécuter DeepSeek-OCR :
{% code overflow="wrap" %}
```python
from unsloth import FastVisionModel
import torch
from transformers import AutoModel
import os
os.environ["UNSLOTH_WARN_UNINITIALIZED"] = '0'
from huggingface_hub import snapshot_download
snapshot_download("unsloth/DeepSeek-OCR", local_dir = "deepseek_ocr")
model, tokenizer = FastVisionModel.from_pretrained(
"./deepseek_ocr",
load_in_4bit = False, # Utilisez le 4 bits pour réduire l’utilisation de la mémoire. False pour LoRA 16 bits.
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth", # True ou "unsloth" pour les contextes longs
)
prompt = "\nOCR libre. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(tokenizer, prompt=prompt, image_file=image_file, output_path = output_path, base_size = 1024, image_size = 640, crop_mode=True, save_results = True, test_compress = False)
```
{% endcode %}
## 🦥 **Fine-tuning de DeepSeek-OCR**
Unsloth prend en charge le fine-tuning de DeepSeek-OCR. Comme le modèle par défaut ne peut pas être exécuté sur la dernière `transformers` version, nous avons ajouté des modifications provenant de l' [Stranger Vision HF](https://huggingface.co/strangervisionhf) équipe, afin de permettre ensuite l'inférence. Comme d'habitude, Unsloth entraîne DeepSeek-OCR 1.4x plus vite avec 40 % de VRAM en moins et des longueurs de contexte 5x plus longues - sans dégradation de la précision.\
\
Nous avons créé deux notebooks Colab gratuits pour DeepSeek-OCR (avec et sans évaluation) :
* DeepSeek-OCR : [Notebook réservé à l’affinage](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\).ipynb)
* DeepSeek-OCR : [Bloc-notes de fine-tuning + évaluation](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\)-Eval.ipynb) (A100)
Le fine-tuning de DeepSeek-OCR sur un jeu de données persan de 200K échantillons a entraîné des gains substantiels dans la détection et la compréhension du texte persan. Nous avons évalué le modèle de base par rapport à notre version affinée sur 200 échantillons de transcription persane, observant une **amélioration absolue de 88.26 %** du taux d'erreur de caractères (CER). Après seulement 60 étapes d'entraînement (taille de lot = 8), le CER moyen est passé de **149.07%** à une moyenne de **60.81%**. Cela signifie que le modèle affiné est **57%** plus précis pour comprendre le persan.
Vous pouvez remplacer le jeu de données persan par le vôtre pour améliorer DeepSeek-OCR pour d'autres cas d'usage.\
\
Pour les résultats d'évaluation de replica-table, utilisez notre notebook d'évaluation ci-dessus. Pour les résultats d'évaluation détaillés, voir ci-dessous :
### Résultats d'évaluation du modèle affiné :
{% columns fullWidth="true" %}
{% column %}
**Version de base de DeepSeek-OCR**
Performance moyenne du modèle de base : 149.07 % de CER pour cet ensemble d'évaluation !
```
============================================================
Performance du modèle de base
============================================================
Nombre d'échantillons : 200
CER moyen : 149.07 %
CER médian : 80.00 %
Écart-type : 310.39 %
CER min. : 0.00 %
CER max. : 3500.00 %
============================================================
Meilleures prédictions (CER le plus faible) :
Échantillon 5024 (CER : 0.00 %)
Référence : چون هستی خیلی زیاد...
Prédiction : چون هستی خیلی زیاد...
Échantillon 3517 (CER : 0.00 %)
Référence : تو ایران هیچوقت از اینها وجود نخواهد داشت...
Prédiction : تو ایران هیچوقت از اینها وجود نخواهد داشت...
Échantillon 9949 (CER : 0.00 %)
Référence : کاش میدونستم هیچی بیخیال...
Prédiction : کاش میدونستم هیچی بیخیال...
Pires prédictions (CER le plus élevé) :
Échantillon 11155 (CER : 3500.00 %)
Référence : خسو...
Prédiction : \[ \text{CH}_3\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}...
Échantillon 13366 (CER : 1900.00 %)
Référence : مشو...
Prédiction : \[\begin{align*}\underline{\mathfrak{su}}_0\end{align*}\]...
Échantillon 10552 (CER : 1014.29 %)
Référence : هیییییچ...
Prédiction : e
```
{% endcolumn %}
{% column %}
**DeepSeek-OCR affiné**
Avec 60 étapes, nous avons réduit le CER de 149.07 % à 60.43 % (amélioration du CER de 89 %)
============================================================
Performance du modèle affiné
============================================================
Nombre d'échantillons : 200
CER moyen : 60.43 %
CER médian : 50.00 %
Écart-type : 80.63 %
CER min. : 0.00 %
CER max. : 916.67 %
============================================================

 Meilleures prédictions (CER le plus faible) :

Échantillon 301 (CER : 0.00 %)
Référence :  باشه بابا تو لاکچری، تو خاص، تو خفن...
Prédiction : باشه بابا تو لاکچری، تو خاص، تو خفن...

Échantillon 2512 (CER : 0.00 %)
Référence :  از شخص حاج عبدالله زنجبیلی میگیرنش...
Prédiction : از شخص حاج عبدالله زنجبیلی میگیرنش...

Échantillon 2713 (CER : 0.00 %)
Référence :  نمی دونم والا تحمل نقد ندارن ظاهرا...
Prédiction : نمی دونم والا تحمل نقد ندارن ظاهرا...

 Pires prédictions (CER le plus élevé) :

Échantillon 14270 (CER : 916.67 %)
Référence :  ۴۳۵۹۴۷۴۷۳۸۹۰...
Prédiction : پروپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپیپریپریپریپریپریپریپریپریپریپریپریپر...

Échantillon 3919 (CER : 380.00 %)
Référence :  ۷۵۵۰۷۱۰۶۵۹...
Prédiction : وادووووووووووووووووووووووووووووووووووو...

Échantillon 3718 (CER : 333.33 %)
Référence :  ۳۲۶۷۲۲۶۵۵۸۴۶...
Prédiction : پُپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُ...
{% endcolumn %}
{% endcolumns %}
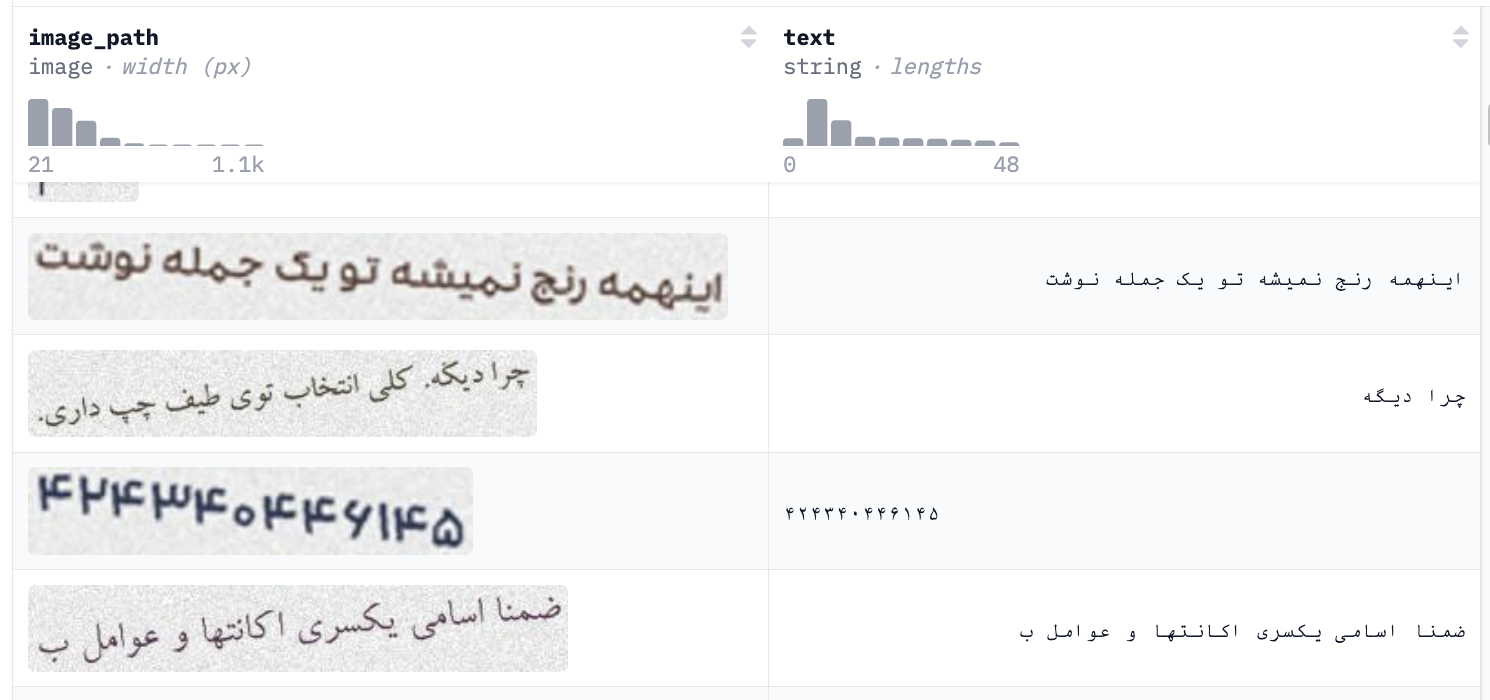
Un exemple tiré du jeu de données persan de 200K que nous avons utilisé (vous pouvez utiliser le vôtre), montrant l'image à gauche et le texte correspondant à droite.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-ocr-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.