> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/functiongemma.md).
# FunctionGemma : comment l'exécuter et le fine-tuner
Découvrez comment exécuter et fine-tuner FunctionGemma localement sur votre appareil et votre téléphone.
FunctionGemma est un nouveau modèle de 270 M de paramètres de Google, conçu pour l'appel de fonctions et le fine-tuning. Basé sur [Gemma 3](/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune.md) 270 M et entraîné spécifiquement pour l'appel d'outils en texte uniquement, sa petite taille le rend idéal à déployer sur votre propre téléphone.
Vous pouvez exécuter le modèle en pleine précision sur **550 Mo de RAM** (CPU) et vous pouvez maintenant **affiner** l'exécuter localement avec Unsloth. Merci à Google DeepMind de s'être associé à Unsloth pour la prise en charge dès le premier jour !
Tutoriel d’exécutionFine-tuning de FunctionGemma
* FunctionGemma GGUF à exécuter : [unsloth/functiongemma-270m-it-GGUF](https://huggingface.co/unsloth/functiongemma-270m-it-GGUF)
**Notebooks gratuits :**
* Fine-tuner pour **raisonner/penser avant les appels d'outils** en utilisant notre [notebook FunctionGemma](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
* Faites **l'appel d'outils multi-tours** dans un notebook gratuit [notebook d'appel d'outils multi-tours](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb)
* Fine-tuner pour **activer les actions mobiles** (calendrier, régler une minuterie) dans notre [notebook Actions mobiles](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
### ⚙️ Guide d’utilisation
Google recommande ces paramètres pour l'inférence :
* `top_k = 64`
* `top_p = 0.95`
* `température = 1.0`
* longueur maximale du contexte = `32,768`
Le format du modèle de conversation se retrouve lorsque nous utilisons ce qui suit :
{% code overflow="wrap" %}
```python
def get_today_date():
""" Obtient la date d'aujourd'hui """
return {"today_date": "18 décembre 2025"}
tokenizer.apply_chat_template(
[
{"role" : "user", "content" : "quelle est la date d'aujourd'hui ?"},
],
tools = [get_today_date], add_generation_prompt = True, tokenize = False,
)
```
{% endcode %}
#### Format du gabarit de chat FunctionGemma :
{% hint style="info" %}
FunctionGemma nécessite le message système ou **message développeur** comme `Vous êtes un modèle capable de faire de l'appel de fonctions avec les fonctions suivantes` Les versions d'Unsloth ont cela intégré par défaut si vous oubliez d'en passer une, alors veuillez utiliser [unsloth/functiongemma-270m-it](https://huggingface.co/unsloth/functiongemma-270m-it)
{% endhint %}
{% code overflow="wrap" lineNumbers="true" %}
```
developer\nVous êtes un modèle capable de faire de l'appel de fonctions avec les fonctions suivantesdeclaration:get_today_date{description:Obtient la date d'aujourd'hui,parameters:{type:OBJECT}}\nuser\nquelle est la date d'aujourd'hui ?\nmodel\n
```
{% endcode %}
## 🖥️ Exécuter FunctionGemma
Voir ci-dessous un guide pour bureau local ou vous pouvez consulter notre guide de déploiement sur téléphone.
#### Tutoriel Llama.cpp (GGUF) :
Instructions pour l'exécuter dans llama.cpp (notez que nous utiliserons du 4 bits pour s'adapter à la plupart des appareils) :
{% stepper %}
{% step %}
Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
{% endstep %}
{% step %}
Vous pouvez télécharger directement depuis Hugging Face. Comme le modèle est très petit, nous utiliserons la variante BF16 non quantifiée en pleine précision.
```bash
./llama.cpp/llama-cli \
-hf unsloth/functiongemma-270m-it-GGUF:BF16 \
--jinja -ngl 99 --ctx-size 32768 \
--top-k 64 --top-p 0.95 --temp 1.0
```
{% endstep %}
{% step %}
Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `BF16` ou d'autres versions quantifiées (bien qu'il ne soit pas recommandé de descendre sous 4 bits) en raison de la petite taille du modèle.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/functiongemma-270m-it-GGUF",
local_dir = "unsloth/functiongemma-270m-it-GGUF",
allow_patterns = ["*BF16*"],
)
```
{% endstep %}
{% step %}
Puis exécutez le modèle en mode conversation :
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/functiongemma-270m-it-GGUF/functiongemma-270m-it-BF16.gguf \
--ctx-size 32768 \\
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--top-k 64 \\
--top-p 0.95 \
--temp 1.0 \
--jinja
```
{% endcode %}
{% endstep %}
{% endstepper %}
## 📱 Déploiement sur téléphone
Vous pouvez également exécuter et déployer FunctionGemma sur votre téléphone grâce à sa petite taille. Nous avons collaboré avec PyTorch pour créer un flux de travail rationalisé utilisant l'entraînement sensible à la quantification ([QAT](/docs/fr/blog/quantization-aware-training-qat.md)) pour récupérer 70 % de précision, puis les déployer directement sur des appareils en périphérie.
* Déployez FunctionGemma localement sur **Pixel 8** et **iPhone 15 Pro** pour obtenir **des vitesses d'inférence d'environ 50 jetons/s**
* Obtenez la confidentialité d'abord, des réponses instantanées et des capacités hors ligne
* Utilisez notre [notebook Colab gratuit](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(0_6B\)-Phone_Deployment.ipynb) pour fine-tuner Qwen3 0.6B et l'exporter pour un déploiement sur téléphone - changez simplement en Gemma3, et suivez les [docs Gemma 3 Executorch](https://github.com/pytorch/executorch/tree/main/examples/models/gemma3).
{% content-ref url="/pages/feb774ec9526706cf5885edfba3f100fbb320ea6" %}
[Run LLMs on your Phone](/docs/fr/notions-de-base/inference-and-deployment/deploy-llms-phone.md)
{% endcontent-ref %}
Consultez nos tutoriels iOS et Android pour le déploiement sur votre téléphone :
Tutoriel iOSTutoriel Android
## 🦥 Fine-tuning de FunctionGemma
Google a indiqué que **FunctionGemma est destiné à être fine-tuné** pour votre tâche spécifique d'appel de fonctions, y compris les cas d'utilisation multi-tours. Unsloth prend désormais en charge le fine-tuning de FunctionGemma. Nous avons créé 2 notebooks de fine-tuning, qui montrent comment vous pouvez entraîner le modèle via **un fine-tuning complet ou LoRA gratuitement via un notebook Colab :**
{% columns %}
{% column %}
[**notebook de fine-tuning Raisonner avant l'appel d'outils**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[**notebook de fine-tuning Actions mobiles**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
Dans le [**notebook de fine-tuning Raisonner avant l'appel d'outils**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb), nous allons **le fine-tuner pour « penser/raisonner » avant l'appel de fonctions**. Le raisonnement en chaîne de pensée devient de plus en plus important pour améliorer les capacités d'utilisation des outils.
FunctionGemma est un petit modèle spécialisé dans l'appel de fonctions. Il utilise son propre gabarit de chat distinct. Lorsqu'on lui fournit des définitions d'outils et une invite utilisateur, il génère une sortie structurée. Nous pouvons ensuite analyser cette sortie pour exécuter l'outil, récupérer les résultats et les utiliser pour générer la réponse finale.
| Type de tour | Contenu |
| --------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Prompt développeur** |
\developer
Vous pouvez faire de l'appel de fonctions avec les fonctions suivantes :
|
| **Déclaration de fonction** |
\declaration:get\_weather{
description: "Obtenir la météo pour une ville",
parameters: { city: STRING }
}
\
\
|
| **Tour utilisateur** |
\user
Quel temps fait-il à Paris ?
\
|
| **Appel de fonction** |
\model
\call:get\_weather{
city: "paris"
}
\
|
| **Réponse de fonction** |
\response:get\_weather{temperature:26}
\
|
| **Clôture de l'assistant** |
Il fait 26 degrés Celsius à Paris.
\
|
Ici, nous implémentons une version simplifiée utilisant un seul bloc de réflexion (plutôt qu'un raisonnement entrelacé) via ``. Par conséquent, l'interaction avec notre modèle ressemble à ceci :
| **Réflexion** + **Appel de fonction** |
\model
\
L'utilisateur veut la météo pour Paris. J'ai l'outil get\_weather. Je devrais l'appeler avec l'argument city.
\
\call:get\_weather{
city: "paris"
}
\
|
| ------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
## :accordion:Fine-tuning de FunctionGemma pour les actions mobiles
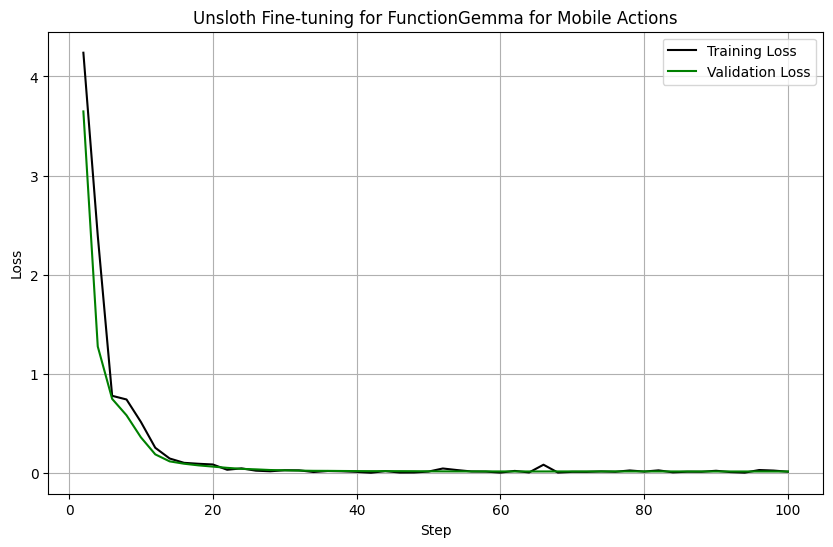
Nous avons également créé un notebook pour montrer comment vous pouvez faire effectuer des actions mobiles à FunctionGemma. Dans le [**notebook de fine-tuning Actions mobiles**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb), nous avons également activé l'évaluation, et montrons comment le fine-tuning pour les actions sur appareil fonctionne bien, comme on peut le voir avec la diminution de la perte d'évaluation :
Par exemple, avec une invite `Veuillez définir un rappel pour une « réunion de synchronisation d'équipe » ce vendredi 6 juin 2025 à 14 h.`
{% code overflow="wrap" %}
```python
[{'role': 'developer',
'content': 'Date et heure actuelles données au format AAAA-MM-JJTHH:MM:SS : 2025-06-04T15:29:23\nLe jour de la semaine est mercredi\nVous êtes un modèle capable de faire de l'appel de fonctions avec les fonctions suivantes\n',
'tool_calls': None},
{'role': 'user',
'content': 'Veuillez définir un rappel pour une « réunion de synchronisation d'équipe » ce vendredi 6 juin 2025 à 14 h.',
'tool_calls': None}]
```
{% endcode %}
Nous avons fine-tuné le modèle pour qu'il puisse produire :
{% code overflow="wrap" %}
```
user
Veuillez définir un rappel pour une « réunion de synchronisation d'équipe » ce vendredi 6 juin 2025 à 14 h.model
call:create_calendar_event{body:None,datetime:2025-06-06 14:00:00,email:None,first_name:None,last_name:None,phone_number:None,query:None,subject:None,title:Réunion de synchronisation d'équipe,to:None}
```
{% endcode %}
## :man\_running:Appel d'outils multi-tours avec FunctionGemma
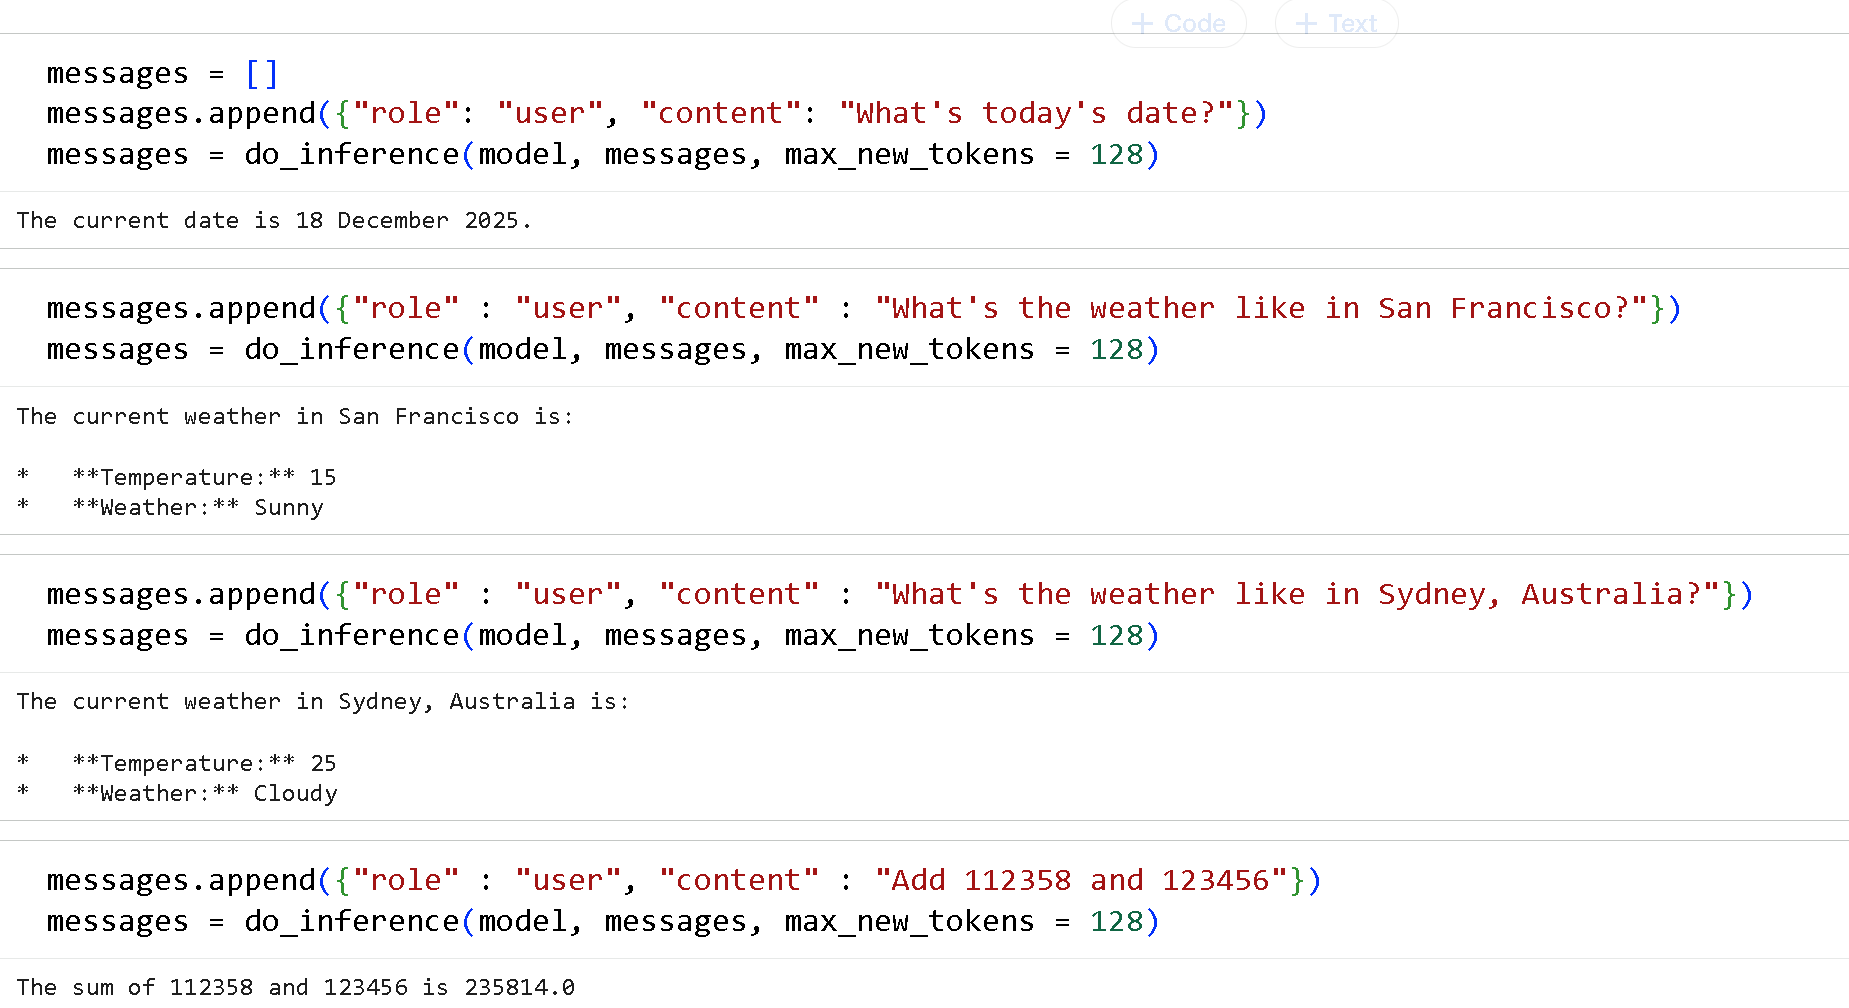
Nous avons également créé un notebook pour montrer comment vous pouvez faire effectuer des appels d'outils multi-tours à FunctionGemma. Dans le [**notebook d'appel d'outils multi-tours**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb), nous montrons comment FunctionGemma est capable d'appeler des outils dans un long changement de message, par exemple voir ci-dessous :
Vous devez d'abord spécifier vos outils comme ci-dessous :
{% code expandable="true" %}
```python
def get_today_date():
"""
Obtient la date d'aujourd'hui
Renvoie :
today_date : date d'aujourd'hui au format 18 décembre 2025
"""
from datetime import datetime
today_date = datetime.today().strftime("%d %B %Y")
return {"today_date": today_date}
def get_current_weather(location: str, unit: str = "celsius"):
"""
Obtient la météo actuelle à un emplacement donné.
Arguments :
location : La ville et l'État, par ex. « San Francisco, CA, USA » ou « Sydney, Australia »
unit : L'unité dans laquelle renvoyer la température. (choix : ["celsius", "fahrenheit"])
Renvoie :
temperature : Température actuelle à l'emplacement donné
weather : Météo actuelle à l'emplacement donné
"""
if "San Francisco" in location.title():
return {"temperature": 15, "weather": "ensoleillé"}
elif "Sydney" in location.title():
return {"temperature": 25, "weather": "nuageux"}
else:
return {"temperature": 30, "weather": "pluvieux"}
def add_numbers(x: float | str, y: float | str):
"""
Additionne 2 nombres
Arguments :
x : Premier nombre
y : Deuxième nombre
Renvoie :
result : x + y
"""
return {"result" : float(x) + float(y)}
def multiply_numbers(x: float | str, y: float | str):
"""
Multiplie 2 nombres
Arguments :
x : Premier nombre
y : Deuxième nombre
Renvoie :
result : x * y
"""
return {"result" : float(x) * float(y)}
```
{% endcode %}
Nous créons ensuite un mappage pour tous les outils :
```python
FUNCTION_MAPPING = {
"get_today_date" : get_today_date,
"get_current_weather" : get_current_weather,
"add_numbers": add_numbers,
"multiply_numbers": multiply_numbers,
}
TOOLS = list(FUNCTION_MAPPING.values())
```
Nous avons également besoin de code d'appel et d'analyse des outils :
{% code expandable="true" %}
```python
#@title Code d'analyse FunctionGemma (extensible)
import re
def extract_tool_calls(text):
def cast(v):
try: return int(v)
except:
try: return float(v)
except: return {'true': True, 'false': False}.get(v.lower(), v.strip("'\""))
return [{
"name": name,
"arguments": {
k: cast((v1 or v2).strip())
for k, v1, v2 in re.findall(r"(\w+):(?:(.*?)|([^,}]*))", args)
}
} for name, args in re.findall(r"call:(\w+)\{(.*?)\}", text, re.DOTALL)]
def process_tool_calls(output, messages):
calls = extract_tool_calls(output)
if not calls: return messages
messages.append({
"role": "assistant",
"tool_calls": [{"type": "function", "function": call} for call in calls]
})
results = [
{"name": c['name'], "response": FUNCTION_MAPPING[c['name']](**c['arguments'])}
for c in calls
]
messages.append({ "role": "tool", "content": results })
return messages
def _do_inference(model, messages, max_new_tokens = 128):
inputs = tokenizer.apply_chat_template(
messages, tools = TOOLS, add_generation_prompt = True, return_dict = True, return_tensors = "pt",
)
output = tokenizer.decode(inputs["input_ids"][0], skip_special_tokens = False)
out = model.generate(**inputs.to(model.device), max_new_tokens = max_new_tokens,
top_p = 0.95, top_k = 64, temperature = 1.0,)
generated_tokens = out[0][len(inputs["input_ids"][0]):]
return tokenizer.decode(generated_tokens, skip_special_tokens = True)
def do_inference(model, messages, print_assistant = True, max_new_tokens = 128):
output = _do_inference(model, messages, max_new_tokens = max_new_tokens)
messages = process_tool_calls(output, messages)
if messages[-1]["role"] == "tool":
output = _do_inference(model, messages, max_new_tokens = max_new_tokens)
messages.append({"role": "assistant", "content": output})
if print_assistant: print(output)
return messages
```
{% endcode %}
Et maintenant nous pouvons appeler le modèle !
```python
from unsloth import FastLanguageModel
import torch
max_seq_length = 4096 # Peut choisir n'importe quelle longueur de séquence !
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/functiongemma-270m-it",
max_seq_length = max_seq_length, # Choisissez n'importe quelle valeur pour un long contexte !
load_in_4bit = False, # Quantification 4 bits pour réduire la mémoire
load_in_8bit = False, # [NOUVEAU !] Un peu plus précis, utilise 2x plus de mémoire
load_in_16bit = True, # [NOUVEAU !] Active le LoRA 16 bits
full_finetuning = False, # [NOUVEAU !] Nous avons maintenant l'ajustement fin complet !
# token = "hf_...", # utilisez-en un si vous utilisez des modèles protégés
)
messages = []
messages.append({"role": "user", "content": "Quelle est la date d'aujourd'hui ?"})
messages = do_inference(model, messages, max_new_tokens = 128)
```
Essayez les 3 notebooks que nous avons créés pour FunctionGemma :
{% columns %}
{% column %}
[notebook de fine-tuning Raisonner avant l'appel d'outils](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[notebook de fine-tuning Actions mobiles](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[notebook d'appel d'outils multi-tours](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb)
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/functiongemma.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.