
> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/qwen3-coder-next.md).

# Qwen3-Coder-Next : comment l’exécuter localement

Guide pour exécuter Qwen3-Coder-Next localement sur votre appareil !

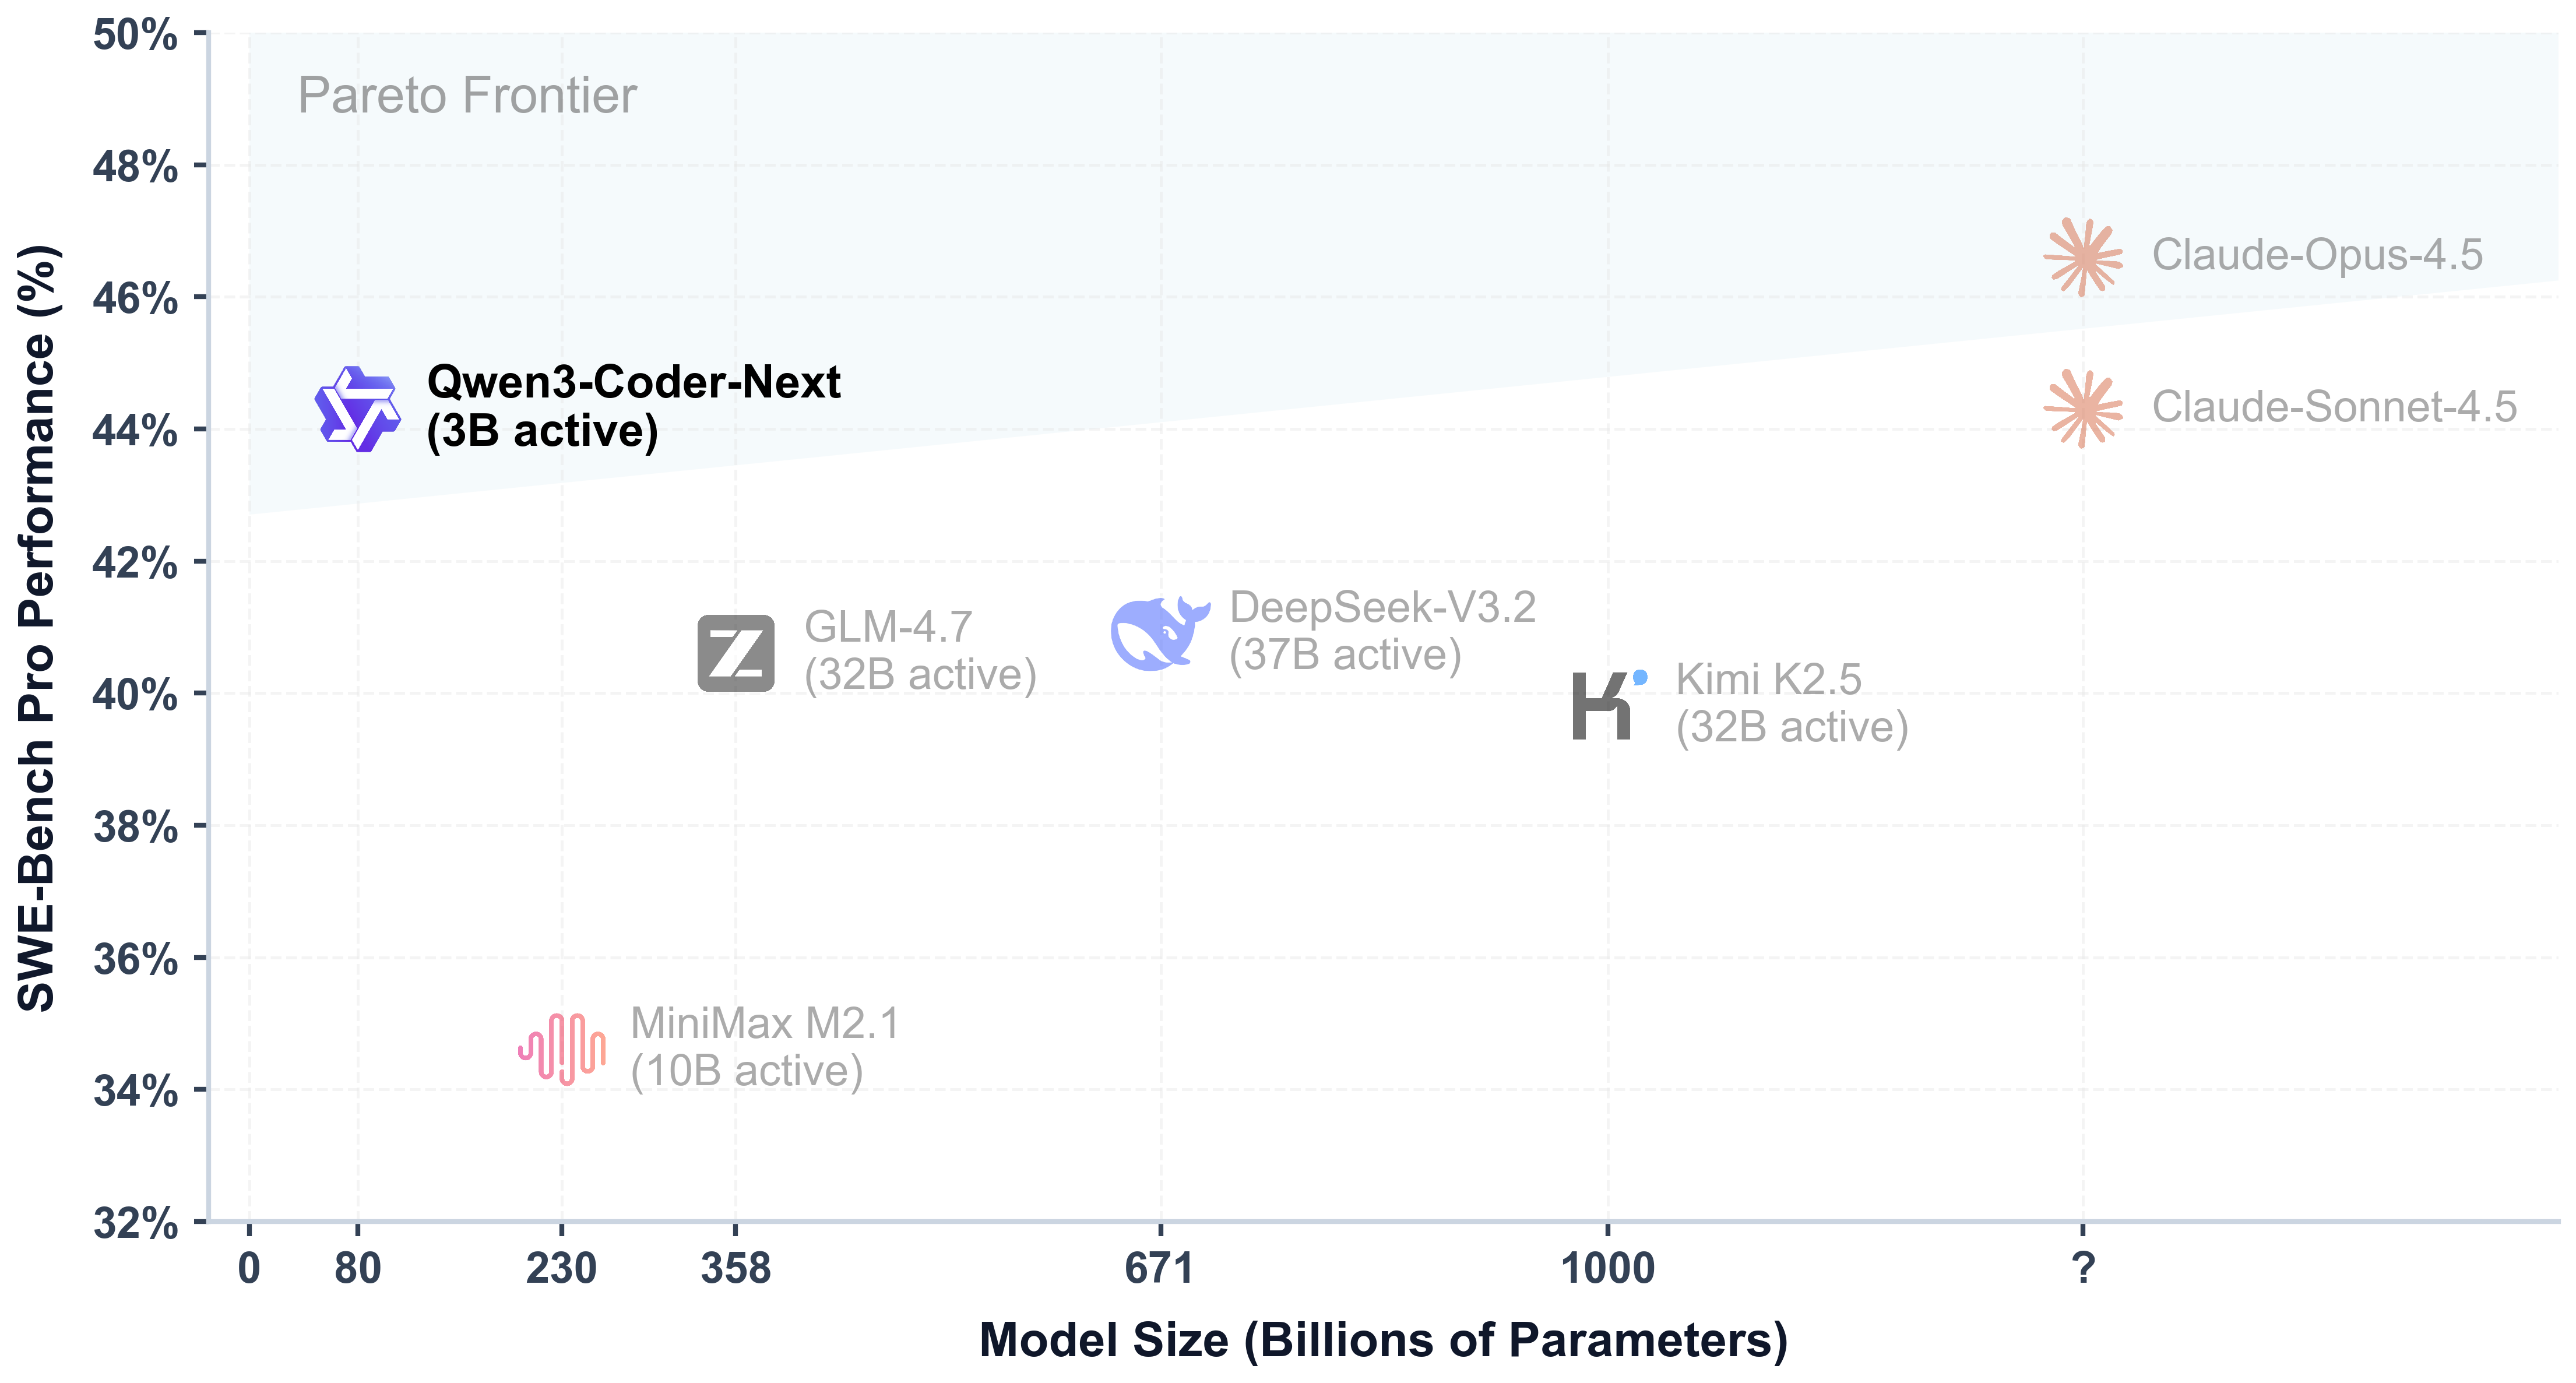
Qwen lance Qwen3-Coder-Next, un modèle MoE de 80B (3B de paramètres actifs) avec **fenêtre de contexte de 256K** pour du codage agentique rapide et une utilisation locale. Il est comparable aux performances de modèles ayant 10 à 20 fois plus de paramètres actifs.

Il fonctionne sur **46 Go de RAM**/VRAM/mémoire unifiée (85 Go en 8 bits), est sans raisonnement pour des réponses de code ultra-rapides. Le modèle excelle dans le raisonnement à long terme, l’utilisation complexe d’outils et la récupération après des échecs d’exécution.

{% hint style="success" %}
**Mise à jour du 19 févr.**: l’appel d’outils devrait maintenant être encore meilleur après les corrections d’analyse dans llama.cpp.

**NOUVEAU !** Voir [benchmarks de quantification](#gguf-quantization-benchmarks) pour nos GGUF dynamiques !

**4 févr. :** `llama.cpp` a corrigé un bug qui corrigeait le calcul pour `key_gdiff vectorisé.` Cela corrige les problèmes précédents de boucle et de sortie. Nous avons mis à jour les GGUF - veuillez **retélécharger** et **MISE À JOUR** `llama.cpp` pour de meilleures sorties.
{% endhint %}

Vous apprendrez aussi à exécuter le modèle sur Codex et Claude Code. Pour **d’ajustement fin**, Qwen3-Next-Coder tient sur un seul GPU B200 pour du LoRA bf16 dans Unsloth.

Qwen3-Coder-Next Unsloth [GGUF dynamiques](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour l’exécuter : [unsloth/Qwen3-Coder-Next-GGUF](https://huggingface.co/unsloth/Qwen3-Coder-Next-GGUF)

<a href="/docs/fr/modeles/qwen3-coder-next.md#run-qwen3-coder-next" class="button primary">Tutoriel d’exécution GGUF</a><a href="https://unsloth.ai/docs/models/qwen3-coder-next#claude-codex" class="button secondary">Codex et Claude Code</a><a href="/docs/fr/modeles/qwen3-coder-next.md#fp8-qwen3-coder-next-in-vllm" class="button secondary">Tutoriel vLLM FP8</a>

### ⚙️ Guide d’utilisation

Vous n’avez pas 46 Go de RAM ou de mémoire unifiée ? Pas de souci, vous pouvez exécuter nos quantifications plus petites comme le 3 bits. Il est préférable que la taille du modèle = la somme de vos ressources de calcul ( **`espace disque + RAM + VRAM ≥ taille de la quantification).`** Si votre quantification tient entièrement sur votre appareil, attendez-vous à 20+ jetons/s. Si elle ne tient pas, elle fonctionnera quand même via déchargement, mais ce sera plus lent.

Pour obtenir des performances optimales, Qwen recommande ces réglages :

* <mark style="background-color:blue;">`Temperature = 1.0`</mark>
* `Top_P = 0.95`
* `Top_K = 40`
* `Min_P = 0.01` (la valeur par défaut de llama.cpp est 0,05)
* `pénalité de répétition` = désactivé ou 1,0

Prend en charge jusqu'à `262,144` de contexte nativement, mais vous pouvez le définir à `32,768` jetons pour une moindre utilisation de mémoire.

### 🖥️ Exécuter Qwen3-Coder-Next

Selon votre cas d’usage, vous devrez utiliser différents réglages. Comme ce guide utilise du 4 bits, vous aurez besoin d’environ 46 Go de RAM/mémoire unifiée. Nous recommandons d’utiliser une précision d’au moins 3 bits pour de meilleures performances.

#### 🦥 Guide d’Unsloth Studio

Qwen3-Coder-Next peut être exécuté et affiné dans [Unsloth Studio](/docs/fr/nouveau/studio.md), notre nouvelle interface web open source pour l'IA locale. Avec Unsloth Studio, vous pouvez exécuter des modèles localement sur **macOS, Windows**, Linux et :

{% columns %}
{% column %}

* Rechercher, télécharger, [exécuter des GGUF](/docs/fr/nouveau/studio.md#run-models-locally) et des modèles safetensor
* [**Auto-réparation** appel d’outils](/docs/fr/nouveau/studio.md#execute-code--heal-tool-calling) + **recherche web**
* [**exécution de code**](/docs/fr/nouveau/studio.md#run-models-locally) (Python, Bash)
* [Inférence automatique](https://unsloth.ai/docs/desktop#feature-deep-dive) réglage des paramètres (temp, top-p, etc.)
* Inférence CPU + GPU rapide via llama.cpp
* [Entraîner des LLM](/docs/fr/nouveau/studio.md#no-code-training) 2x plus rapide avec 70 % de VRAM en moins
  {% endcolumn %}

{% column %}

<div data-with-frame="true"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFeQ0UUlnjXkDdqhcWglh%2Fskinny%20studio%20chat.png?alt=media&amp;token=c2ee045f-c243-4024-a8e4-bb4dbe7bae79" alt=""><figcaption></figcaption></figure></div>
{% endcolumn %}
{% endcolumns %}

{% stepper %}
{% step %}
**Installer Unsloth**

Exécutez dans votre terminal :

MacOS, Linux, WSL :

```bash
curl -fsSL https://unsloth.ai/install.sh | sh
```

Windows PowerShell :

```bash
irm https://unsloth.ai/install.ps1 | iex
```

{% hint style="success" %}
**L'installation sera rapide et prendra environ 1 à 2 minutes.**
{% endhint %}
{% endstep %}

{% step %}
**Lancer Unsloth**

MacOS, Linux, WSL et Windows :

```bash
unsloth studio -H 0.0.0.0 -p 8888
```

Puis ouvrez `http://localhost:8888` dans votre navigateur.
{% endstep %}

{% step %}
**Rechercher et télécharger Qwen3-Coder-Next**

Lors du premier lancement, vous devrez créer un mot de passe pour sécuriser votre compte et vous reconnecter plus tard. Vous verrez ensuite un bref assistant d’intégration pour choisir un modèle, un jeu de données et des paramètres de base. Vous pouvez le sauter à tout moment et aller directement au chat.

Ensuite, allez dans l’onglet [Unsloth Chat](/docs/fr/nouveau/studio/chat.md) onglet et recherchez **Qwen3-Coder-Next** dans la barre de recherche et téléchargez le modèle et la quantification souhaités.

<div data-with-frame="true"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fit06amlW1KexxlYARKNV%2FScreenshot%202026-04-02%20at%201.57.55%E2%80%AFAM.png?alt=media&amp;token=74fb6c0f-fbd1-4506-be76-050f27de8d02" alt="" width="563"><figcaption></figcaption></figure></div>
{% endstep %}

{% step %}
**Exécuter Qwen3-Coder-Next**

Les paramètres d’inférence devraient être définis automatiquement lors de l’utilisation d’Unsloth Studio, cependant vous pouvez toujours les modifier manuellement. Vous pouvez aussi modifier la longueur du contexte, le modèle de chat et d’autres paramètres.

Pour plus d’informations, vous pouvez consulter notre [guide d’inférence d’Unsloth Studio](/docs/fr/nouveau/studio/chat.md).

<div data-with-frame="true"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FXPQGEEr1YoKofrTatAKK%2Ftoolcallingif.gif?alt=media&amp;token=25d68698-fb13-4c46-99b2-d39fb025df08" alt="" width="563"><figcaption></figcaption></figure></div>
{% endstep %}
{% endstepper %}

#### Tutoriel Llama.cpp (GGUF) :

Instructions pour l'exécuter dans llama.cpp (notez que nous utiliserons du 4 bits pour s'adapter à la plupart des appareils) :

{% stepper %}
{% step %}
Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

{% code overflow="wrap" %}

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

{% endcode %}
{% endstep %}

{% step %}
Vous pouvez le récupérer directement depuis Hugging Face. Vous pouvez augmenter le contexte à 256K si votre RAM/VRAM peut le supporter. L’utilisation de `--fit on` déterminera aussi automatiquement la longueur du contexte.

Vous pouvez utiliser les paramètres recommandés : `temperature=1.0`, `top_p=0.95`, `top_k=40`

```bash
./llama.cpp/llama-cli \
    -hf unsloth/Qwen3-Coder-Next-GGUF:UD-Q4_K_XL \
    --ctx-size 16384 \
    --temp 1.0 --top-p 0.95 --min-p 0.01 --top-k 40
```

{% endstep %}

{% step %}
Téléchargez le modèle via (après avoir installé `pip install huggingface_hub`). Vous pouvez choisir `UD-Q4_K_XL` ou d’autres versions quantifiées. Si les téléchargements se bloquent, voir [Débogage de Hugging Face Hub et XET](/docs/fr/notions-de-base/troubleshooting-and-faqs/hugging-face-hub-xet-debugging.md)

{% code overflow="wrap" %}

```bash
pip install -U huggingface_hub
hf download unsloth/Qwen3-Coder-Next-GGUF \
    --local-dir unsloth/Qwen3-Coder-Next-GGUF \
    --include "*UD-Q4_K_XL*"
```

{% endcode %}
{% endstep %}

{% step %}
Puis exécutez le modèle en mode conversation :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/Qwen3-Coder-Next-GGUF/Qwen3-Coder-Next-UD-Q4_K_XL.gguf \
    --seed 3407 \
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --top-k 40
```

{% endcode %}

Ajustez également **la fenêtre de contexte** selon les besoins, jusqu’à `262,144`

{% hint style="info" %}
REMARQUE : ce modèle prend uniquement en charge le mode sans réflexion et ne génère pas `<think></think>` de blocs dans sa sortie. Donc, spécifier `enable_thinking=False` n’est plus nécessaire.
{% endhint %}
{% endstep %}
{% endstepper %}

### 🦙Service et déploiement avec Llama-server

Pour déployer Qwen3-Coder-Next en production, nous utilisons `llama-server` Dans un nouveau terminal, par exemple via tmux. Puis, déployez le modèle via :

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-server \
    --model unsloth/Qwen3-Coder-Next-GGUF/Qwen3-Coder-Next-UD-Q4_K_XL.gguf \
    --alias "unsloth/Qwen3-Coder-Next" \
    --seed 3407 \
    --temp 1.0 \
    --top-p 0.95 \
    --min-p 0.01 \
    --top-k 40 \",
    --port 8001
```

{% endcode %}

Ensuite, dans un nouveau terminal, après avoir exécuté `pip install openai`, nous pouvons exécuter le modèle :

{% code overflow="wrap" %}

```python
from openai import OpenAI
import json
openai_client = OpenAI(
    base_url = "http://127.0.0.1:8001/v1",
    api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
    model = "unsloth/Qwen3-Coder-Next",
    messages = [{"role": "user", "content": "Crée un jeu Flappy Bird en HTML"},],
)
print(completion.choices[0].message.content)
```

{% endcode %}

Ce qui produira :

{% columns %}
{% column width="66.66666666666666%" %}
{% code overflow="wrap" expandable="true" %}

````markdown
Voici un jeu Flappy Bird complet et fonctionnel contenu dans un seul fichier.

J’ai utilisé **HTML5 Canvas** pour les graphismes et **JavaScript** pour la physique (gravité, détection des collisions et score). Aucune image externe ni téléchargement n’est requis ; le jeu dessine l’oiseau et les tuyaux par le code.

### Comment l’exécuter :
1.  Copiez le bloc de code ci-dessous.
2.  Créez un nouveau fichier sur votre ordinateur nommé `game.html`.
3.  Collez le code dans ce fichier et enregistrez-le.
4.  Double-cliquez sur `game.html` pour l’ouvrir dans votre navigateur web.

```html
<!DOCTYPE html>
<html lang="fr">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Flappy Bird simple</title>
    <style>
        body {
            margin: 0;
            padding: 0;
            display: flex;
            flex-direction: column;
            justify-content: center;
            align-items: center;
            height: 100vh;
            background-color: #333;
            font-family: 'Courier New', Courier, monospace;
            color: white;
        }

        h1 {
            margin-bottom: 10px;
        }

        #game-container {
            position: relative;
            box-shadow: 0 0 20px rgba(0,0,0,0.5);
        }

        canvas {
            display: block;
            background-color: #70c5ce; /* Bleu ciel */
            border: 4px solid #000;
        }

        #ui-layer {
            position: absolute;
            top: 0;
            left: 0;
            width: 100%;
            height: 100%;
            pointer-events: none; /* Laissez les clics passer vers le canvas */
            display: flex;
            flex-direction: column;
            justify-content: center;
            align-items: center;
            text-align: center;
        }

        .message {
            background: rgba(255, 255, 255, 0.8);
            padding: 20px;
            border-radius: 10px;
            color: #333;
        }

        #score-board {
            position: absolute;
            top: 20px;
            width: 100%;
            text-align: center;
            font-size: 40px;
            font-weight: bold;
            color: white;
            text-shadow: 2px 2px 0 #000;
            z-index: 10;
        }
    </style>
</head>
<body>

    <h1>Clone de Flappy Bird</h1>
    
    <div id="game-container">
        <div id="score-board">0</div>
        <canvas id="birdCanvas" width="320" height="480"></canvas>
        
        <div id="ui-layer">
            <div id="start-screen" class="message">
                <h2>Prêt à voler ?</h2>
                <p>Appuyez sur <strong>Espace</strong> ou <strong>Cliquez</strong> pour sauter</p>
                <p>Appuyez sur Espace pour commencer</p>
            </div>
            <div id="game-over-screen" class="message" style="display: none;">
                <h2>Fin de partie</h2>
                <p>Score : <span id="final-score">0</span></p>
                <p>Meilleur : <span id="best-score">0</span></p>
                <p>Appuyez sur <strong>Espace</strong> pour recommencer</p>
            </div>
        </div>
    </div>

    <script>
        // --- Configuration ---
        const canvas = document.getElementById('birdCanvas');
        const ctx = canvas.getContext('2d');
        const scoreElement = document.getElementById('score-board');
        const startScreen = document.getElementById('start-screen');
        const gameOverScreen = document.getElementById('game-over-screen');
        const finalScoreSpan = document.getElementById('final-score');
        const bestScoreSpan = document.getElementById('best-score');

        // Variables du jeu
        let frames = 0;
        let score = 0;
        let highScore = localStorage.getItem('flappyHighScore') || 0;
        let gameState = 'START'; // START, EN JEU, FIN DE PARTIE
        const gravity = 0.25;
        const speed = 2; // Vitesse des tuyaux se déplaçant vers la gauche

        // --- L’objet Oiseau ---
        const bird = {
            x: 50,
            y: 150,
            width: 30,
            height: 30,
            velocity: 0,
            jumpStrength: 4.5,
            radius: 15,
            draw: function() {
                ctx.fillStyle = "#FFD700"; // Couleur or
                ctx.beginPath();
                ctx.arc(this.x + this.radius, this.y + this.radius, this.radius, 0, Math.PI * 2);
                ctx.fill();
                ctx.lineWidth = 2;
                ctx.stroke();

                // Œil
                ctx.fillStyle = "white";
                ctx.beginPath();
                ctx.arc(this.x + this.radius + 5, this.y + this.radius - 5, 5, 0, Math.PI * 2);
                ctx.fill();
                ctx.fillStyle = "black";
                ctx.beginPath();
                ctx.arc(this.x + this.radius + 7, this.y + this.radius - 5, 2, 0, Math.PI * 2);
                ctx.fill();
                
                // Bec
                ctx.fillStyle = "orange";
                ctx.beginPath();
                ctx.moveTo(this.x + this.radius + 10, this.y + this.radius);
                ctx.lineTo(this.x + this.radius + 20, this.y + this.radius + 5);
                ctx.lineTo(this.x + this.radius + 10, this.y + this.radius + 10);
                ctx.fill();
                ctx.stroke();
            },
            update: function() {
                this.velocity += gravity;
                this.y += this.velocity;

                // Collision avec le sol
                if (this.y + this.height >= canvas.height) {
                    this.y = canvas.height - this.height;
                    gameOver();
                }
                
                // Collision avec le plafond (optionnel : empêche de voler au-dessus des tuyaux)
                if (this.y < 0) {
                    this.y = 0;
                    this.velocity = 0;
                }
            },
            jump: function() {
                this.velocity = -this.jumpStrength;
            },
            reset: function() {
                this.y = 150;
                this.velocity = 0;
            }
        };

        // --- Le tableau des tuyaux ---
        const pipes = {
            position: [],
            width: 50,
            gap: 120, // Espace entre le tuyau du haut et celui du bas
            dx: 2, // Vitesse de déplacement

            draw: function() {
                for (let i = 0; i < this.position.length; i++) {
                    let p = this.position[i];
                    let topY = p.y;
                    let bottomY = p.y + this.gap;

                    ctx.fillStyle = "#228B22"; // Vert forêt

                    // Tuyau du haut
                    ctx.fillRect(p.x, 0, this.width, topY);
                    ctx.strokeRect(p.x, 0, this.width, topY);

                    // Tuyau du bas
                    ctx.fillRect(p.x, bottomY, this.width, canvas.height - bottomY);
                    ctx.strokeRect(p.x, bottomY, this.width, canvas.height - bottomY);
                }
            },

            update: function() {
                // Ajouter un nouveau tuyau toutes les 120 images (environ 2 secondes)
                if (frames % 120 === 0) {
                    // Hauteur aléatoire pour le tuyau du haut
                    // Hauteur min 50, hauteur max canvas - gap - 50
                    let maxY = canvas.height - this.gap - 50;
                    let randomY = Math.floor(Math.random() * (maxY - 50 + 1) + 50);
                    
                    this.position.push({
                        x: canvas.width,
                        y: randomY
                    });
                }

                for (let i = 0; i < this.position.length; i++) {
                    let p = this.position[i];
                    p.x -= this.dx;

                    // Détection des collisions
                    // Logique : vérifier si la coordonnée X de l’oiseau se trouve dans la plage X du tuyau
                    if (bird.x + bird.width > p.x && bird.x < p.x + this.width) {
                        // Logique : vérifier si la coordonnée Y de l’oiseau touche le tuyau du haut OU celui du bas
                        if (bird.y < p.y || bird.y + bird.height > p.y + this.gap) {
                            gameOver();
                        }
                    }

                    // Mise à jour du score (quand l’oiseau dépasse un tuyau)
                    if (p.x + this.width < bird.x && !p.passed) {
                        score++;
                        scoreElement.innerText = score;
                        p.passed = true;
                    }

                    // Supprimer les tuyaux qui sont sortis de l’écran
                    if (p.x + this.width <= 0) {
                        this.position.shift();
                        // Décrémenter i car la longueur du tableau a changé
                        i--; 
                    }
                }
            },
            
            reset: function() {
                this.position = [];
            }
        };

        // --- Arrière-plan (nuages/herbe) ---
        const background = {
            draw: function() {
                // Dessiner l’herbe
                ctx.fillStyle = "#7cfc00"; // Vert gazon
                ctx.fillRect(0, canvas.height - 20, canvas.width, 20);
                ctx.beginPath();
                ctx.moveTo(0, canvas.height - 20);
                ctx.lineTo(canvas.width, canvas.height - 20);
                ctx.stroke();
            }
        };

        // --- Fonctions de contrôle du jeu ---

        function loop() {
            // Effacer le canvas
            ctx.clearRect(0, 0, canvas.width, canvas.height);

            // Dessiner l’arrière-plan
            background.draw();

            if (gameState === 'START') {
                bird.draw();
                // Dessiner une ligne de sol
                ctx.fillStyle = "#ded895";
                ctx.fillRect(0, canvas.height - 10, canvas.width, 10);
            } 
            else if (gameState === 'PLAYING') {
                bird.update();
                bird.draw();
                pipes.update();
                pipes.draw();
                frames++;
            } 
            else if (gameState === 'GAMEOVER') {
                pipes.draw();
                bird.draw();
                // Ne pas mettre à jour les images ni la position, simplement figer
            }

            requestAnimationFrame(loop);
        }

        function startGame() {
            gameState = 'PLAYING';
            startScreen.style.display = 'none';
            gameOverScreen.style.display = 'none';
            score = 0;
            frames = 0;
            scoreElement.innerText = score;
            bird.reset();
            pipes.reset();
        }

        function gameOver() {
            gameState = 'GAMEOVER';
            
            // Mettre à jour le meilleur score
            if (score > highScore) {
                highScore = score;
                localStorage.setItem('flappyHighScore', highScore);
            }

            finalScoreSpan.innerText = score;
            bestScoreSpan.innerText = highScore;
            gameOverScreen.style.display = 'block';
        }

        // --- Gestion des entrées ---

        function handleInput(e) {
            // Empêcher le comportement de défilement par défaut pour Espace
            if (e.type === 'keydown' && e.code === 'Space') {
                e.preventDefault();
            }

            if (e.code === 'Space' || e.type === 'mousedown' || e.type === 'touchstart') {
                switch (gameState) {
                    case 'START':
                        startGame();
                        bird.jump();
                        break;
                    case 'PLAYING':
                        bird.jump();
                        break;
                    case 'GAMEOVER':
                        startGame();
                        bird.jump();
                        break;
                }
            }
        }

        window.addEventListener('keydown', handleInput);
        canvas.addEventListener('mousedown', handleInput);
        canvas.addEventListener('touchstart', handleInput);

        // Initialiser
        loop();

    </script>
</body>
</html>
```

### Fonctionnalités de cette version :
1.  **Physique :** gravité réaliste et mécanique de saut.
2.  **Détection des collisions :** la partie se termine si vous touchez les tuyaux, le sol ou le plafond.
3.  **Système de score :** vous gagnez 1 point à chaque tuyau dépassé.
4.  **Meilleur score :** utilise le LocalStorage de votre navigateur pour mémoriser votre meilleur score même si vous actualisez la page.
5.  **Contrôles réactifs :** fonctionne avec la **barre Espace**, le **clic de souris** ou le **tactile** (pour les appareils mobiles).
6.  **Graphismes :** l’oiseau est dessiné par le code (avec un œil et un bec) et les tuyaux ont des bordures, donc aucun lien d’image cassé ne se produira.
````

{% endcode %}

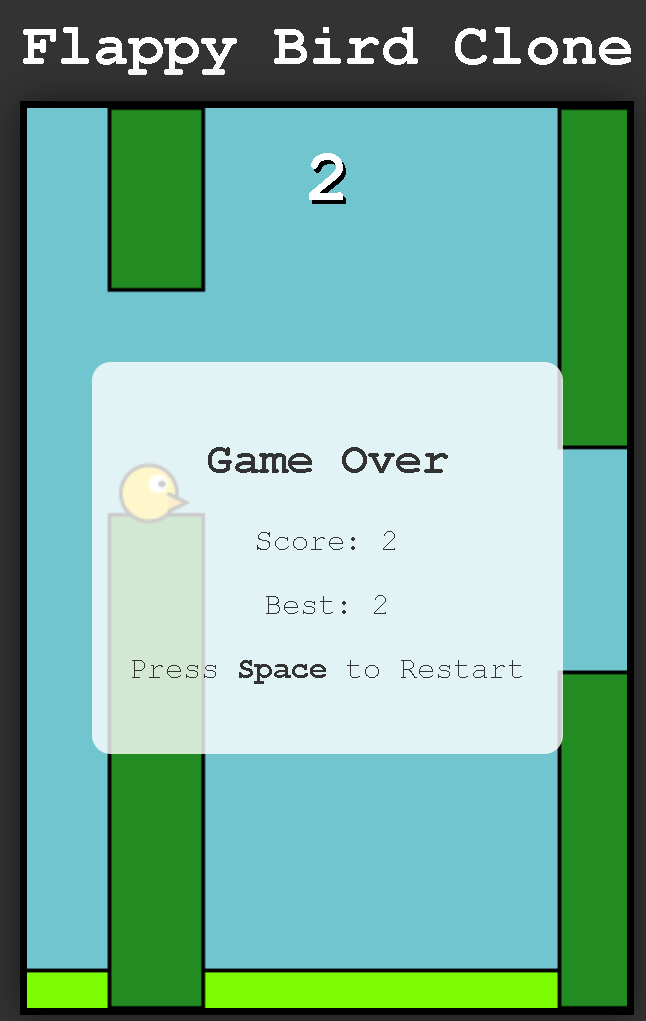
Nous avons extrait le HTML et l’avons exécuté, et le jeu Flappy Bird d’exemple généré a très bien fonctionné !
{% endcolumn %}

{% column width="33.33333333333334%" %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7ATJWz7O4jMxpVI6I1Wk%2Fimage.png?alt=media&amp;token=a81548fa-843b-499d-9db6-6f215ad5fb99" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

### 👾 OpenAI Codex et Claude Code <a href="#claude-codex" id="claude-codex"></a>

Pour exécuter le modèle via des charges de travail agentiques locales de codage, vous pouvez suivre notre guide. Utilisez la `llama-server` que nous venons de configurer, et définissez le nom du modèle sur l’identifiant exact qu’il indique avec `GET /v1/models` (la `--alias` valeur ci-dessus, `unsloth/Qwen3-Coder-Next`). Suivez les paramètres et les instructions d’utilisation corrects de Qwen3-Coder-Next.

{% columns %}
{% column %}
{% content-ref url="/pages/6c4a155ae35df476974e25b66af4db620dffaf2c" %}
[Claude Code](/docs/fr/notions-de-base/claude-code.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
{% content-ref url="/pages/0bb2f0a13e244fd2f0ea640c96c4e297bf83db93" %}
[OpenAI Codex](/docs/fr/notions-de-base/codex.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

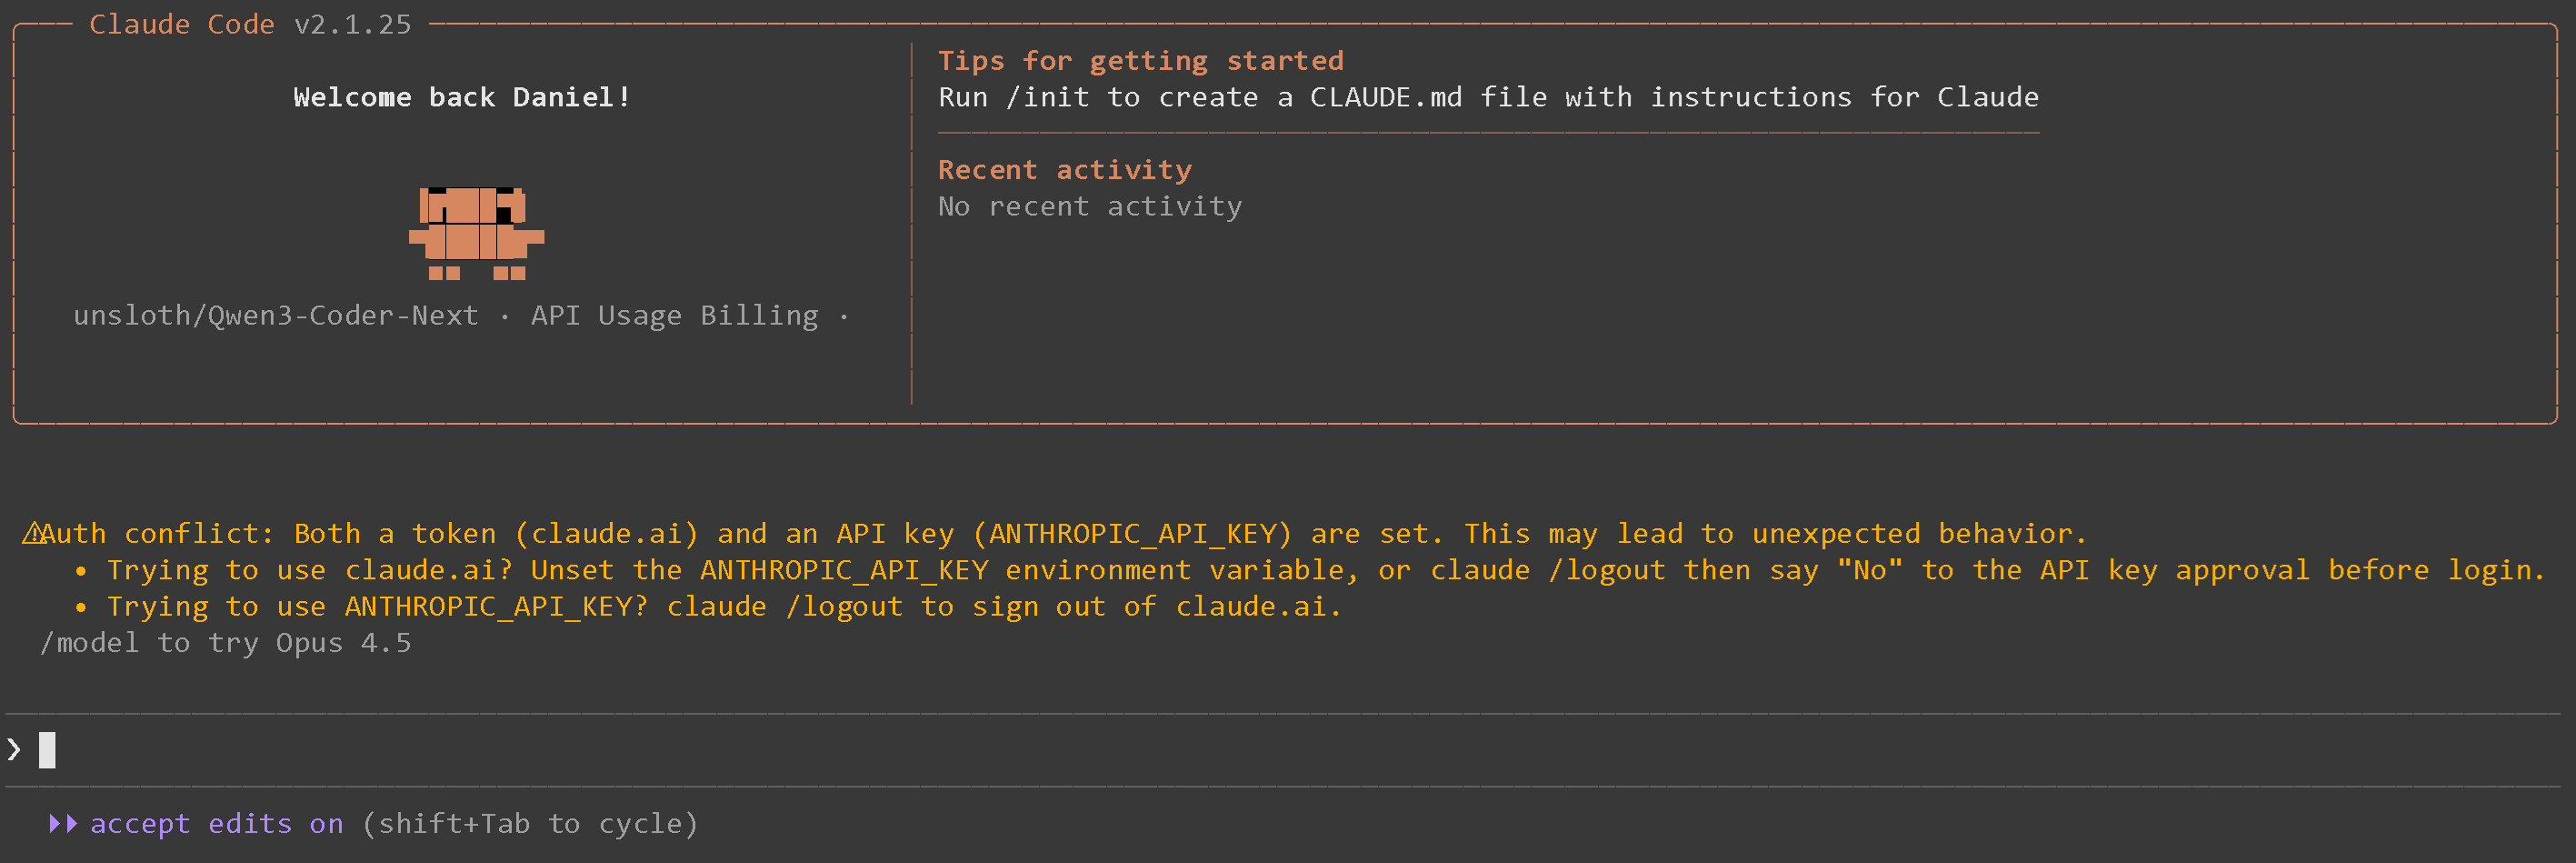
Après avoir suivi les instructions pour Claude Code, par exemple, vous verrez :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fup2DMSMPjNR8BM9pgR0v%2Fimage.png?alt=media&amp;token=152e9ee0-2491-4379-af18-8fca0789b19d" alt="" width="563"><figcaption></figcaption></figure>

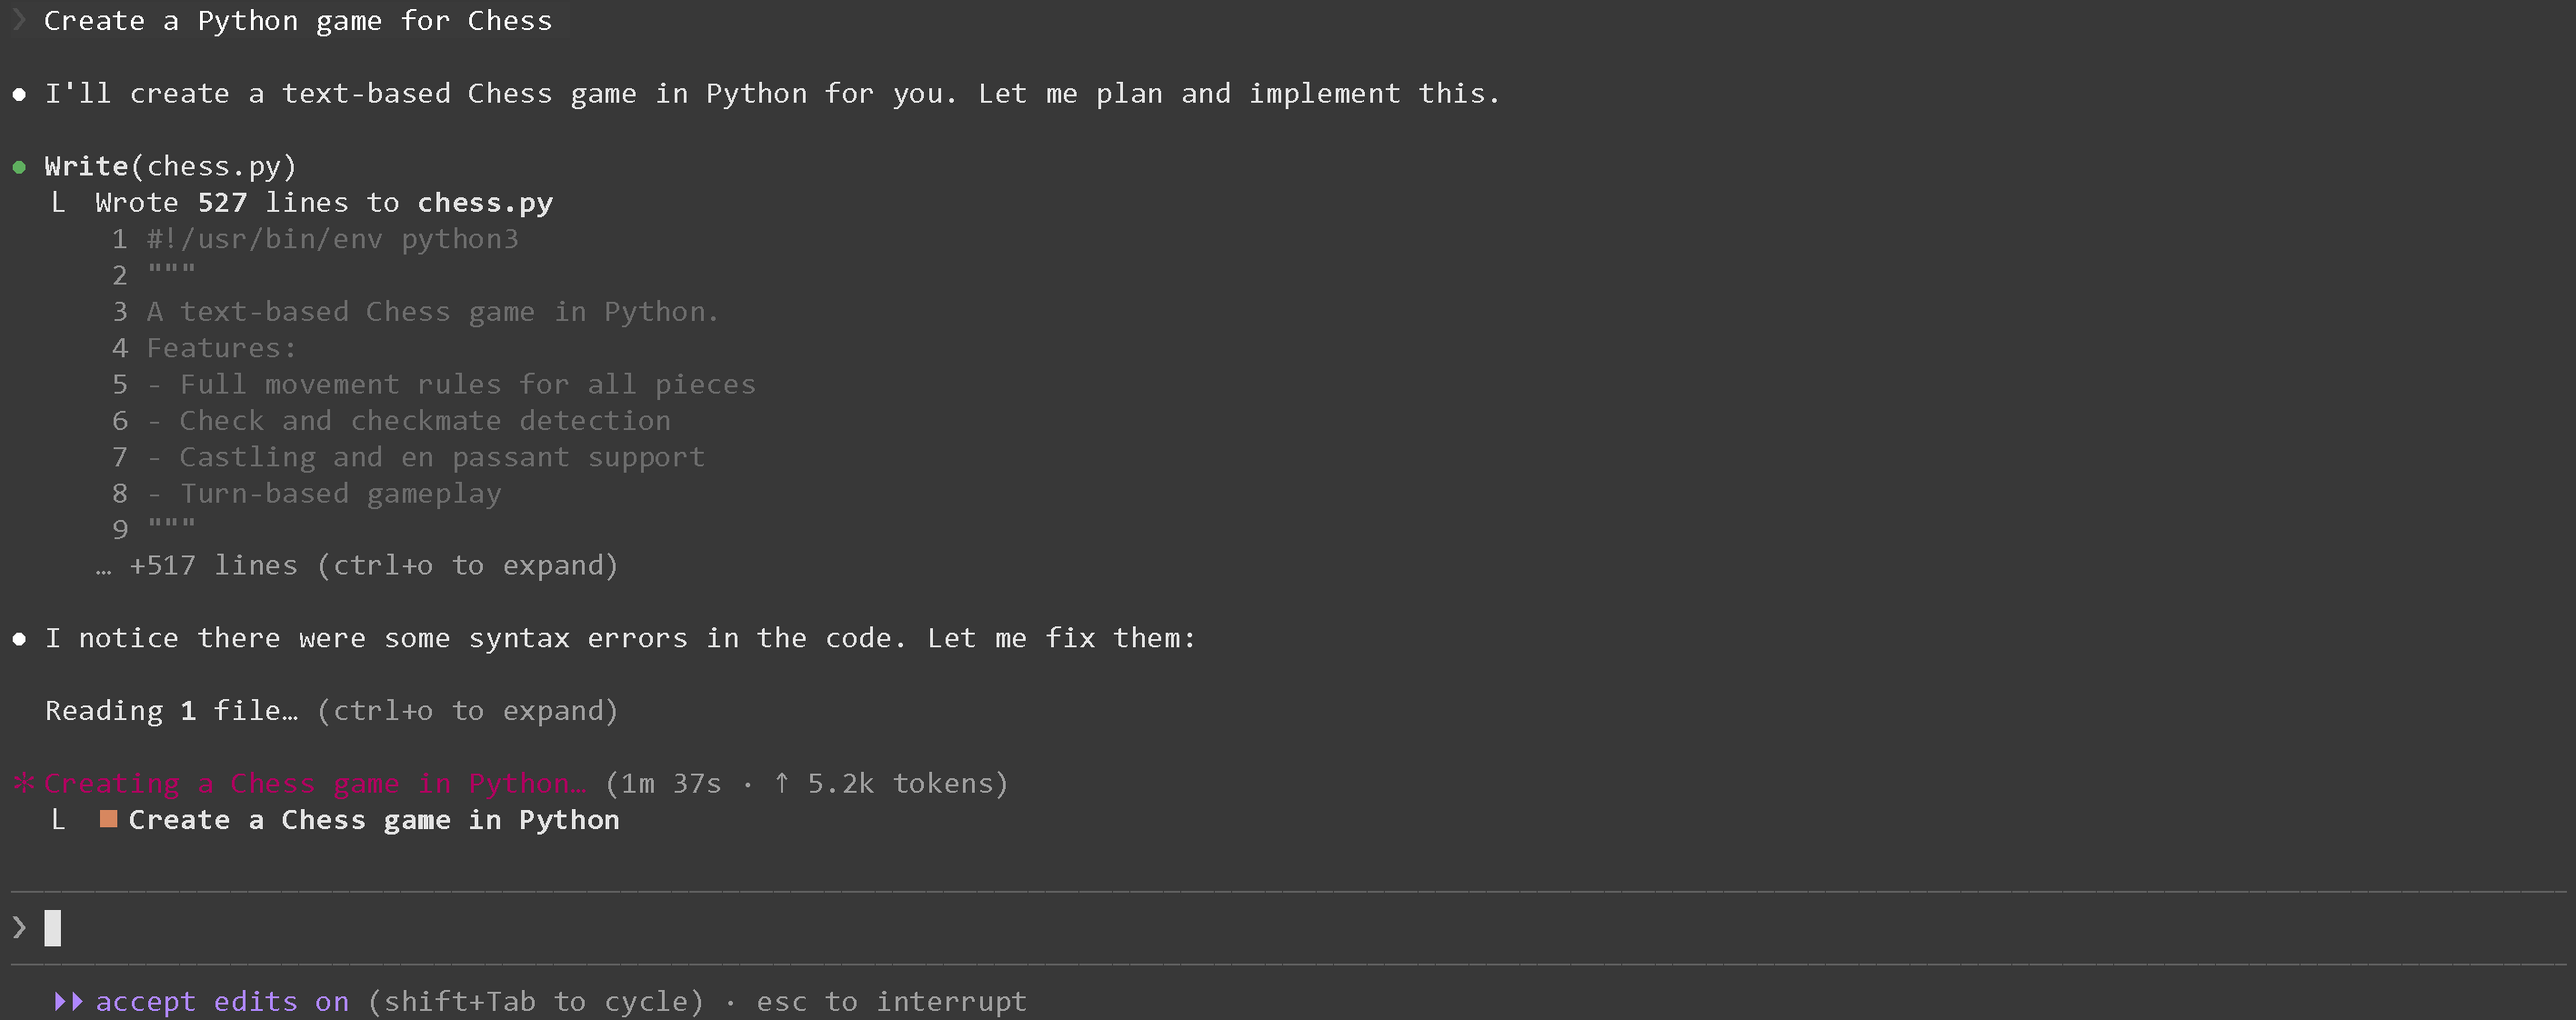
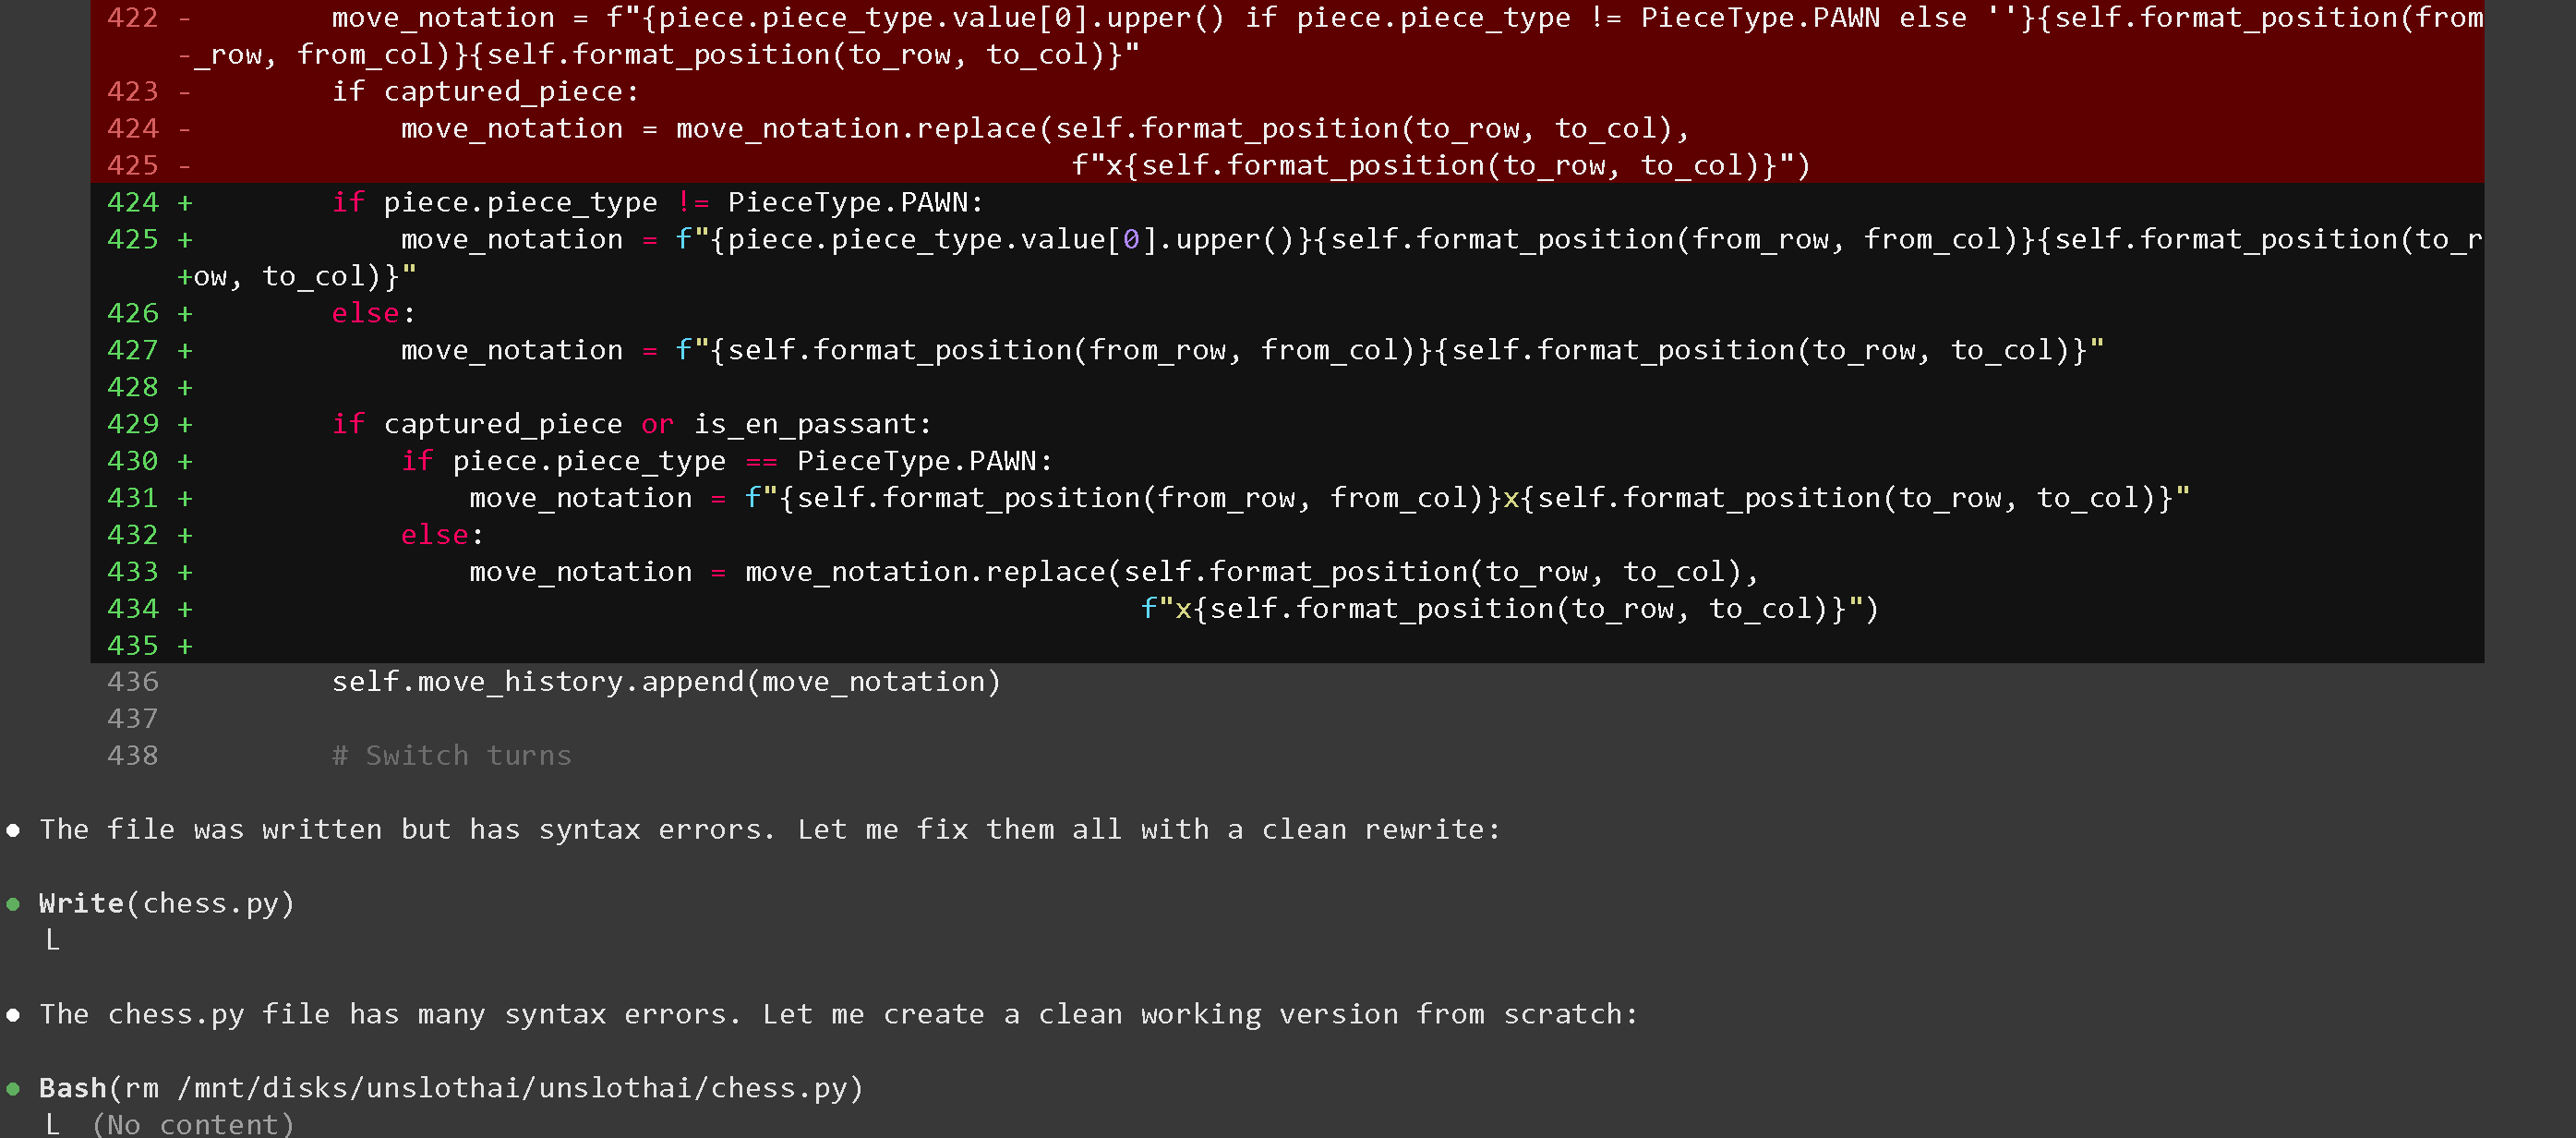
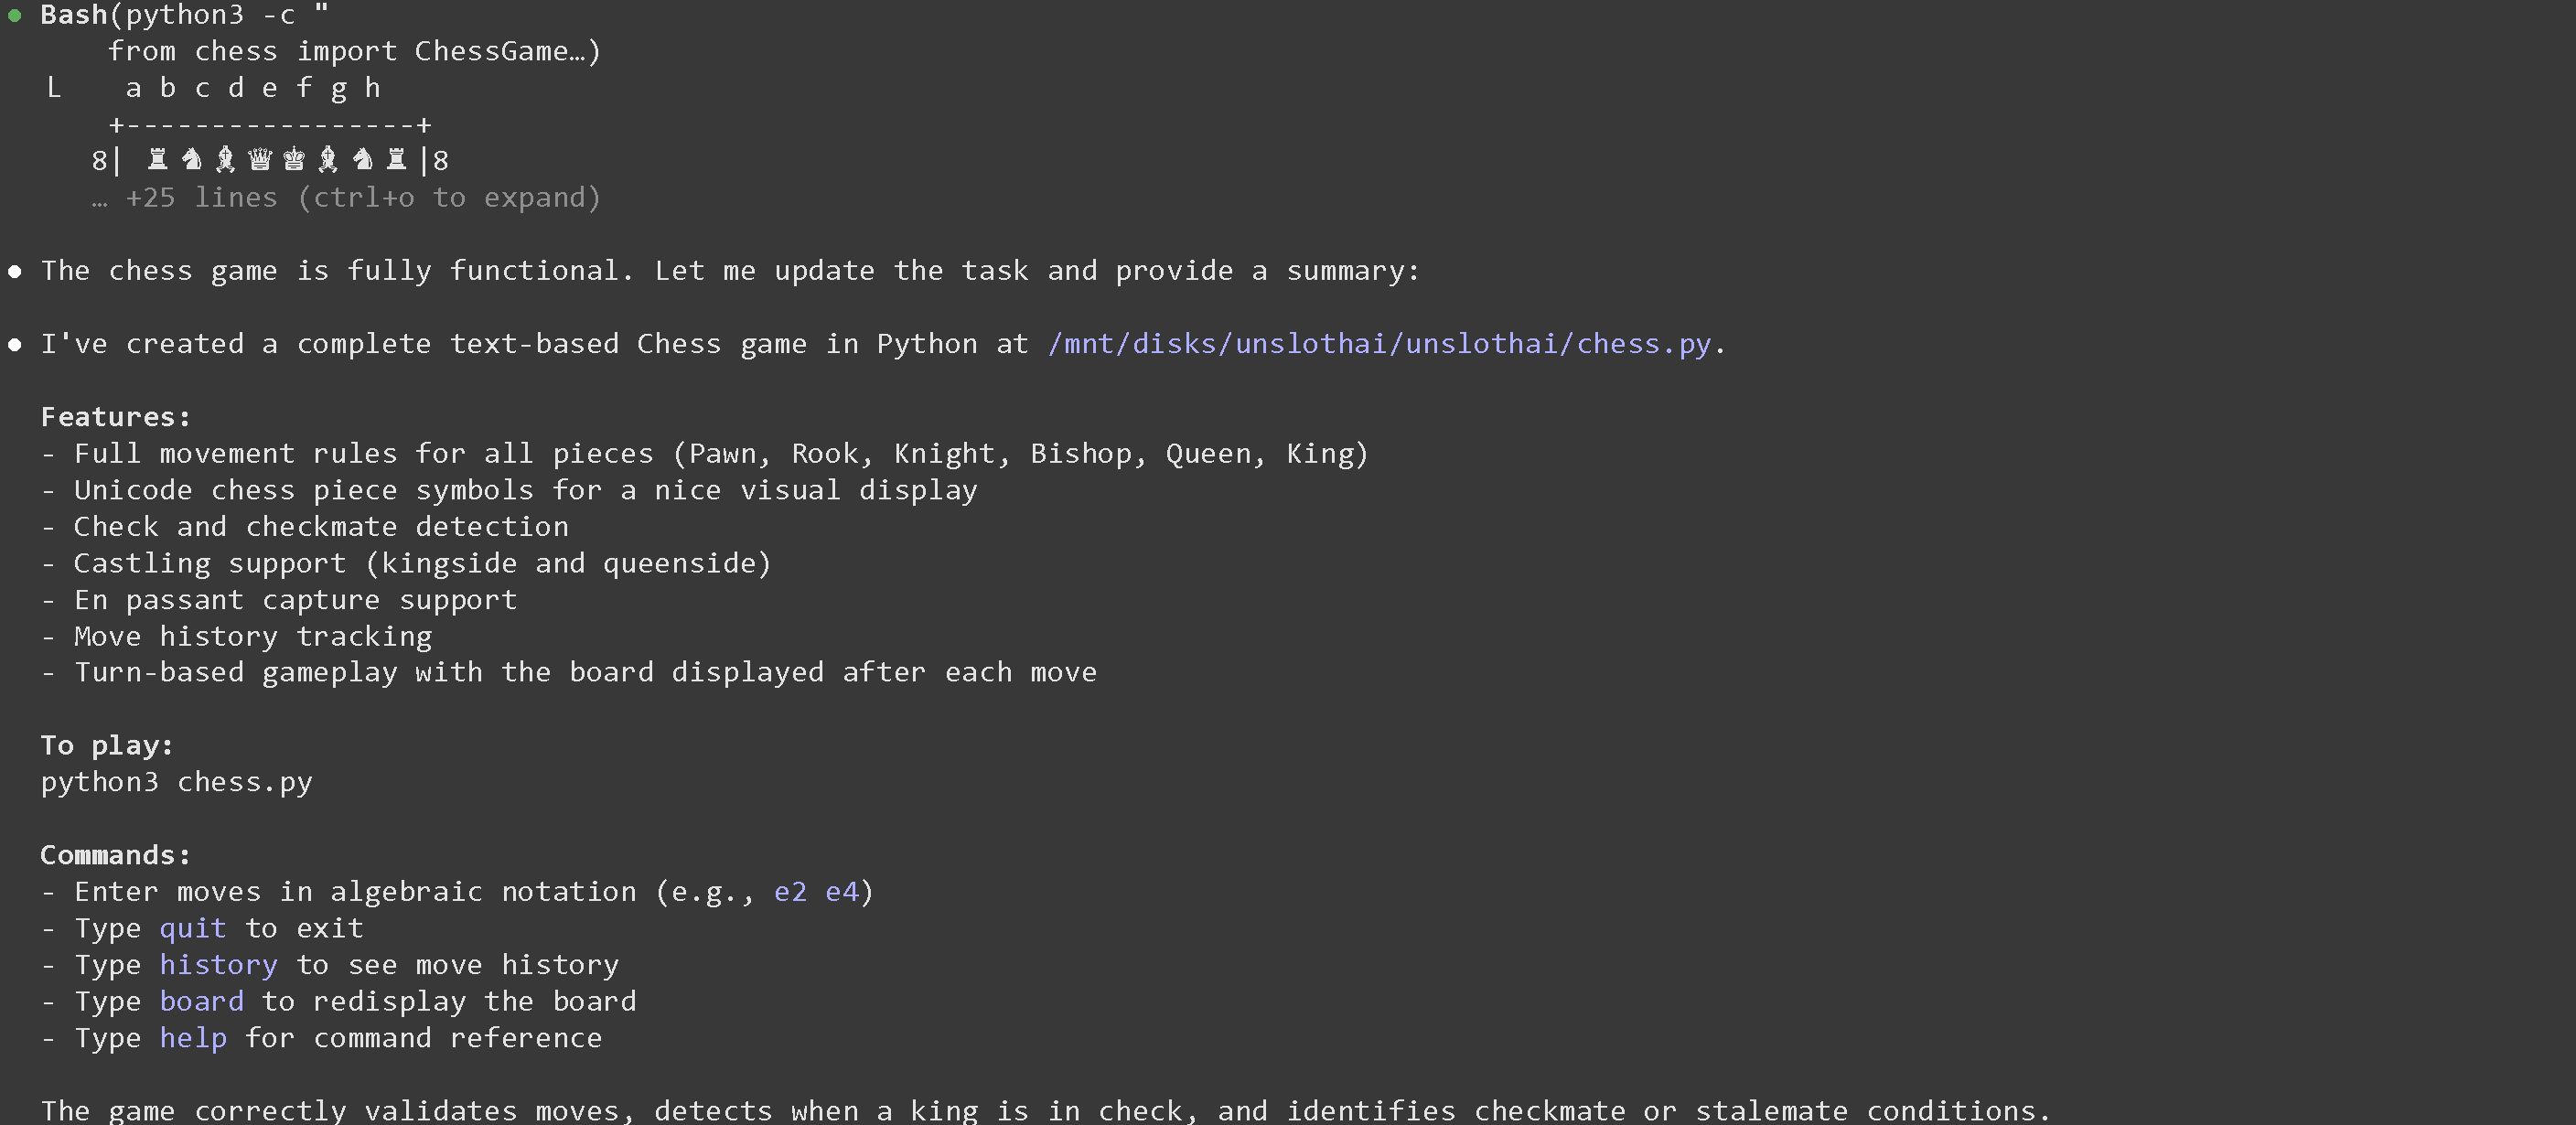
Nous pouvons alors demander par exemple `Créer un jeu d’échecs en Python` :

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F9TfMAoKSdMpb8OHKNnHH%2Fimage.png?alt=media&amp;token=771df3aa-91ab-4c1e-8676-1830058001ca" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FWP3lI5mQW2EHB79qqgDz%2Fimage.png?alt=media&amp;token=55cf3189-e100-419c-a615-024b45948284" alt="" width="563"><figcaption></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fn8DZddDODQZGCP8giKYY%2Fimage.png?alt=media&amp;token=996c8cb9-d199-4045-90f0-408690e02667" alt="" width="563"><figcaption></figcaption></figure></div>

Si vous voyez `API Error: 400 {"error":{"code":400,"message":"request (16582 tokens) exceeds the available context size (16384 tokens), try increasing it","type":"exceed_context_size_error","n_prompt_tokens":16582,"n_ctx":16384}}` cela signifie que vous devez augmenter la longueur du contexte ou consulter [#how-to-fit-long-context-256k-to-1m](#how-to-fit-long-context-256k-to-1m "mention")

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FP6anV1XewSWIovaH3f7c%2Fimage.png?alt=media&amp;token=285a540b-f6fc-4541-b807-bf4f6dc3807b" alt=""><figcaption></figcaption></figure>

### 🎱 Qwen3-Coder-Next FP8 dans vLLM

Vous pouvez désormais utiliser notre nouveau [quantification FP8 dynamique](https://huggingface.co/unsloth/Qwen3-Coder-Next-FP8-Dynamic) du modèle pour une inférence premium et rapide. Installez d’abord vLLM depuis la version nightly. Modifiez `--extra-index-url https://wheels.vllm.ai/nightly/cu130` à votre version CUDA trouvée via `nvidia-smi` - uniquement `cu129` et `cu130` sont actuellement prises en charge.

{% hint style="success" %}
Si vous utilisez vLLM / SGLang, essayez nos quantifications FP8-Dynamic, qui peuvent augmenter le débit de 25 % ou plus ! Voir [#fp8-qwen3-coder-next-in-vllm](#fp8-qwen3-coder-next-in-vllm "mention")
{% endhint %}

{% code overflow="wrap" %}

```bash
# Installez uv si vous ne l’avez pas pour des installations d’environnement plus rapides
curl -LsSf https://astral.sh/uv/install.sh | sh

# Créez un nouvel environnement Python - inutile si vous voulez modifier tout votre système
uv venv unsloth_fp8 --python 3.12 --seed
source unsloth_fp8/bin/activate

uv pip install --upgrade --force-reinstall vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly/cu130
uv pip install --upgrade --force-reinstall git+https://github.com/huggingface/transformers.git
uv pip install --force-reinstall numba
```

{% endcode %}

Puis servez [la version FP8 dynamique d’Unsloth](https://huggingface.co/unsloth/Qwen3-Coder-Next-FP8-Dynamic) du modèle. Vous pouvez aussi activer FP8 pour réduire de 50 % l’utilisation mémoire du cache KV en ajoutant `--kv-cache-dtype fp8` Nous l’avons servi sur 4 GPU, mais si vous n’avez qu’un seul GPU, utilisez `CUDA_VISIBLE_DEVICES='0'` et définissez `--tensor-parallel-size 1` ou supprimez cet argument. Utilisez `tmux` pour lancer ce qui suit dans un nouveau terminal puis CTRL+B+D - utilisez `tmux attach-session -t0` pour y revenir.

```bash
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:False
CUDA_VISIBLE_DEVICES='0,1,2,3' vllm serve unsloth/Qwen3-Coder-Next-FP8-Dynamic \
    --served-model-name unsloth/Qwen3-Coder-Next \
    --tensor-parallel-size 4 \
    --tool-call-parser qwen3_coder \
    --enable-auto-tool-choice \
    --dtype bfloat16 \
    --seed 3407 \
    --max-model-len 200000 \
    --gpu-memory-utilization 0.93 \
    --port 8001
```

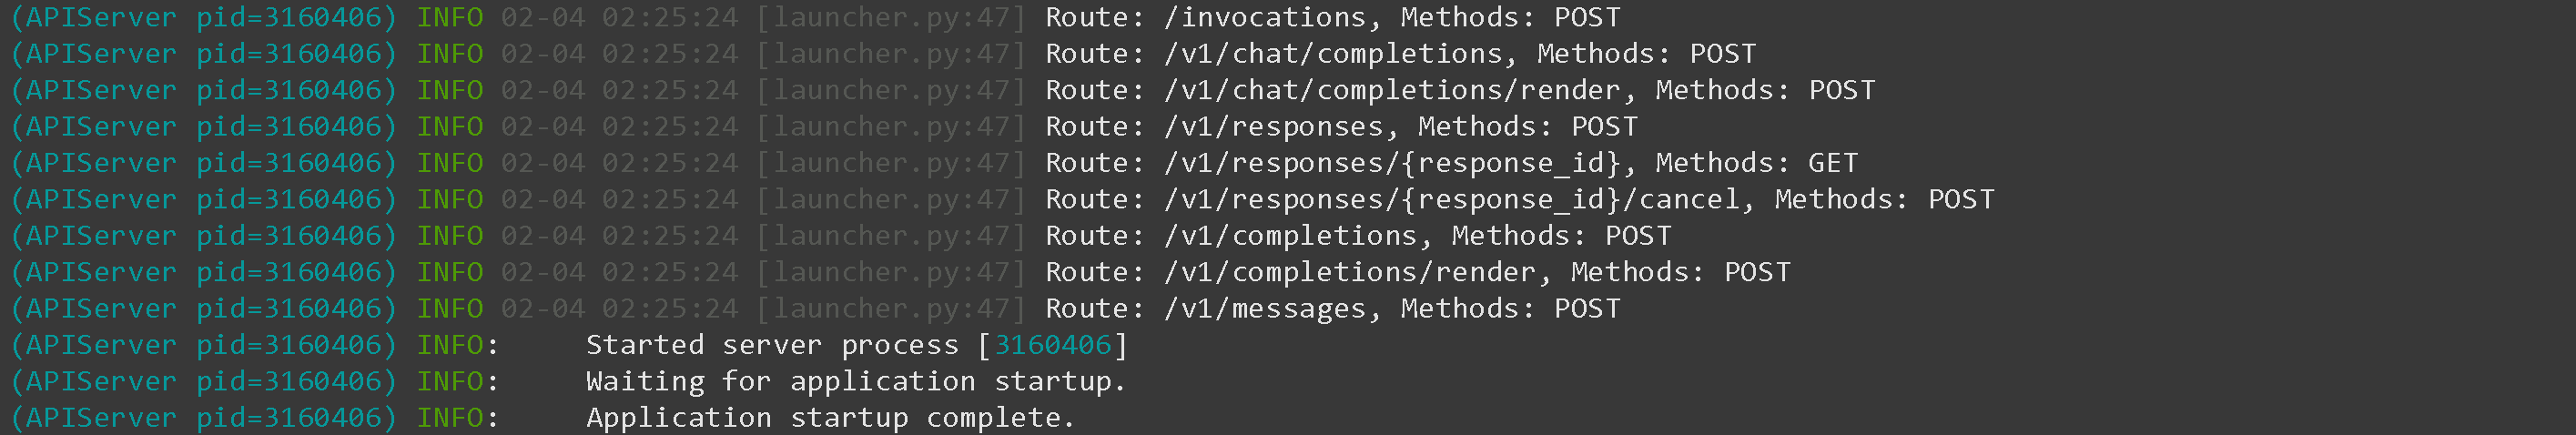
Vous devriez voir quelque chose comme ci-dessous. Voir [#tool-calling-with-qwen3-coder-next](#tool-calling-with-qwen3-coder-next "mention") pour savoir comment utiliser réellement Qwen3-Coder-Next avec l’API OpenAI et l’appel d’outils - cela fonctionne pour vLLM et llama-server.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FxRdgnzg1gz3lBLPvftRx%2Fimage.png?alt=media&amp;token=4f43796b-397f-4ffb-86d2-68afd14994f9" alt=""><figcaption></figcaption></figure>

### :wrench:Appel d’outils avec Qwen3-Coder-Next

Dans un nouveau terminal, nous créons quelques outils comme l’ajout de 2 nombres, l’exécution de code Python, l’exécution de fonctions Linux et bien plus encore :

{% code expandable="true" %}

```python
import json, subprocess, random
from typing import Any
def add_number(a: float | str, b: float | str) -> float:
    return float(a) + float(b)
def multiply_number(a: float | str, b: float | str) -> float:
    return float(a) * float(b)
def subtract_number(a: float | str, b: float | str) -> float:
    return float(a) - float(b)
def write_a_story() -> str:
    return random.choice([
        "Il y a bien longtemps, dans une galaxie très, très lointaine...",
        "Il y avait deux amis qui adoraient les paresseux et le code...",
        "Le monde allait prendre fin parce que chaque paresseux avait évolué pour posséder une intelligence surhumaine...",
        "À l'insu de l'un des amis, l'autre a accidentellement codé un programme pour faire évoluer les paresseux...",
    ])
def terminal(command: str) -> str:
    if "rm" in command or "sudo" in command or "dd" in command or "chmod" in command:
        msg = "Impossible d'exécuter les commandes 'rm, sudo, dd, chmod' car elles sont dangereuses"
        print(msg); return msg
    print(f"Exécution de la commande terminal `{command}`")
    try:
        "type": "function"
    except subprocess.CalledProcessError as e:
        return f"Commande échouée : {e.stderr}"
def python(code: str) -> str:
    data = {}
    exec(code, data)
    del data["__builtins__"]
    return str(data)
MAP_FN = {
    "add_number": add_number,
    "multiply_number": multiply_number,
    "subtract_number": subtract_number,
    "write_a_story": write_a_story,
    "terminal": terminal,
    "python": python,
}
tools = [
    {
        "type": "function",
        "function": {
            "name": "add_number",
            "description": "Additionnez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "multiply_number",
            "description": "Multipliez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "subtract_number",
            "description": "Soustrayez deux nombres.",
            "parameters": {
                "type": "object",
                "properties": {
                    "a": {
                        "type": "string",
                        "description": "Le premier nombre.",
                    },
                    "b": {
                        "type": "string",
                        "description": "Le deuxième nombre.",
                    },
                },
                "required": ["a", "b"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "write_a_story",
            "description": "Écrit une histoire aléatoire.",
            "parameters": {
                "type": "object",
                "properties": {},
                "required": [],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "terminal",
            "description": "Effectuez des opérations depuis le terminal.",
            "parameters": {
                "type": "object",
                "properties": {
                    "command": {
                        "type": "string",
                        "description": "La commande que vous souhaitez lancer, par ex. `ls`, `rm`, ...",
                    },
                },
                "required": ["command"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "python",
            "description": "Appeler un interpréteur Python avec du code Python qui sera exécuté.",
            "parameters": {
                "type": "object",
                "properties": {
                    "code": {
                        "type": "string",
                        "description": "Le code Python à exécuter",
                    },
                },
                "required": ["code"],
            },
        },
    },
]
```

{% endcode %}

Nous utilisons ensuite les fonctions ci-dessous (copier-coller et exécuter), qui analyseront automatiquement les appels de fonction et appelleront le point de terminaison OpenAI pour n'importe quel modèle :

{% code overflow="wrap" expandable="true" %}

```python
from openai import OpenAI
def unsloth_inference(
    messages,
    temperature = 1.0,
    top_p = 0.95,
    top_k = 40,
    min_p = 0.01,
    repetition_penalty = 1.0,
):
    messages = messages.copy()
    openai_client = OpenAI(
        base_url = "http://127.0.0.1:8001/v1",
        api_key = "sk-no-key-required",
    )
    model_name = next(iter(openai_client.models.list())).id
    print(f"Modèle utilisé = {model_name}")
    has_tool_calls = True
    original_messages_len = len(messages)
    while has_tool_calls:
        print(f"Messages actuels = {messages}")
        response = openai_client.chat.completions.create(
            model = model_name,
            messages = messages,
            temperature = temperature,
            top_p = top_p,
            tools = tools if tools else None,
            tool_choice = "auto" if tools else None,
            extra_body = {"top_k": top_k, "min_p": min_p, "repetition_penalty" :repetition_penalty,}
        )
        tool_calls = response.choices[0].message.tool_calls or []
        content = response.choices[0].message.content or ""
        tool_calls_dict = [tc.to_dict() for tc in tool_calls] if tool_calls else tool_calls
        messages.append({"role": "assistant", "tool_calls": tool_calls_dict, "content": content,})
        for tool_call in tool_calls:
            fx, args, _id = tool_call.function.name, tool_call.function.arguments, tool_call.id
            out = MAP_FN[fx](**json.loads(args))
            messages.append({"role": "tool", "tool_call_id": _id, "name": fx, "content": str(out),})
        else:
            has_tool_calls = False
    return messages
```

{% endcode %}

Nous allons maintenant présenter ci-dessous plusieurs méthodes d’exécution de l’appel d’outils pour de nombreux cas d’utilisation différents :

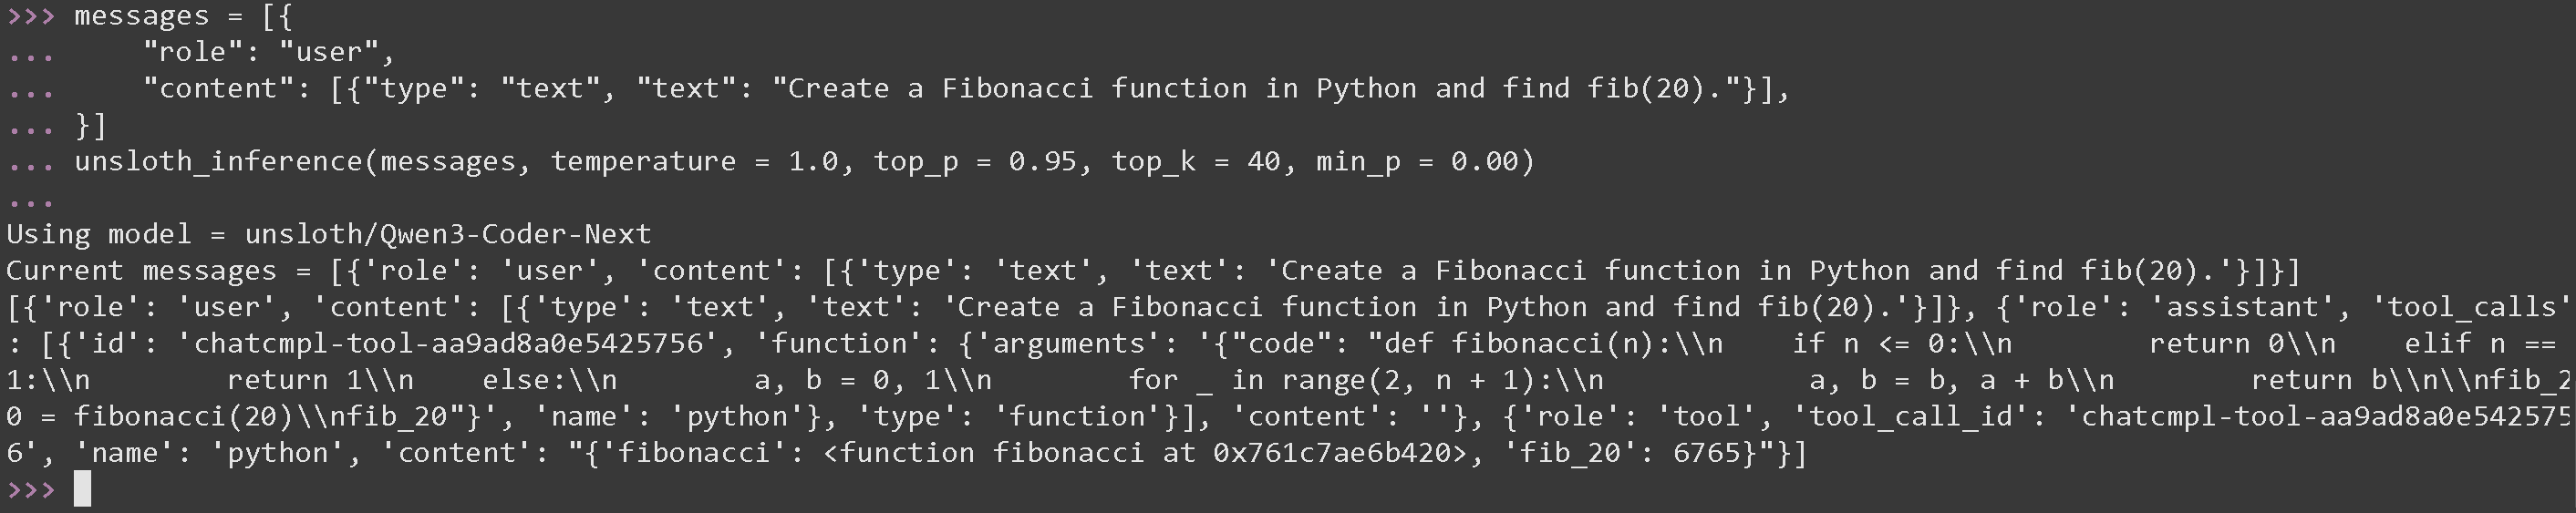
#### Exécuter le code Python généré

{% code overflow="wrap" %}

```python
messages = [{
    "role": "user",
    "content": [{"type": "text", "text": "Créez une fonction de Fibonacci en Python et trouvez fib(20)."}],
}]
unsloth_inference(messages, temperature = 1.0, top_p = 0.95, top_k = 40, min_p = 0.00)
```

{% endcode %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F7fY3LSeNCjHXNjBwQkbI%2Fimage.png?alt=media&amp;token=50eba62e-f8b2-424a-833b-be56696b4710" alt=""><figcaption></figcaption></figure>

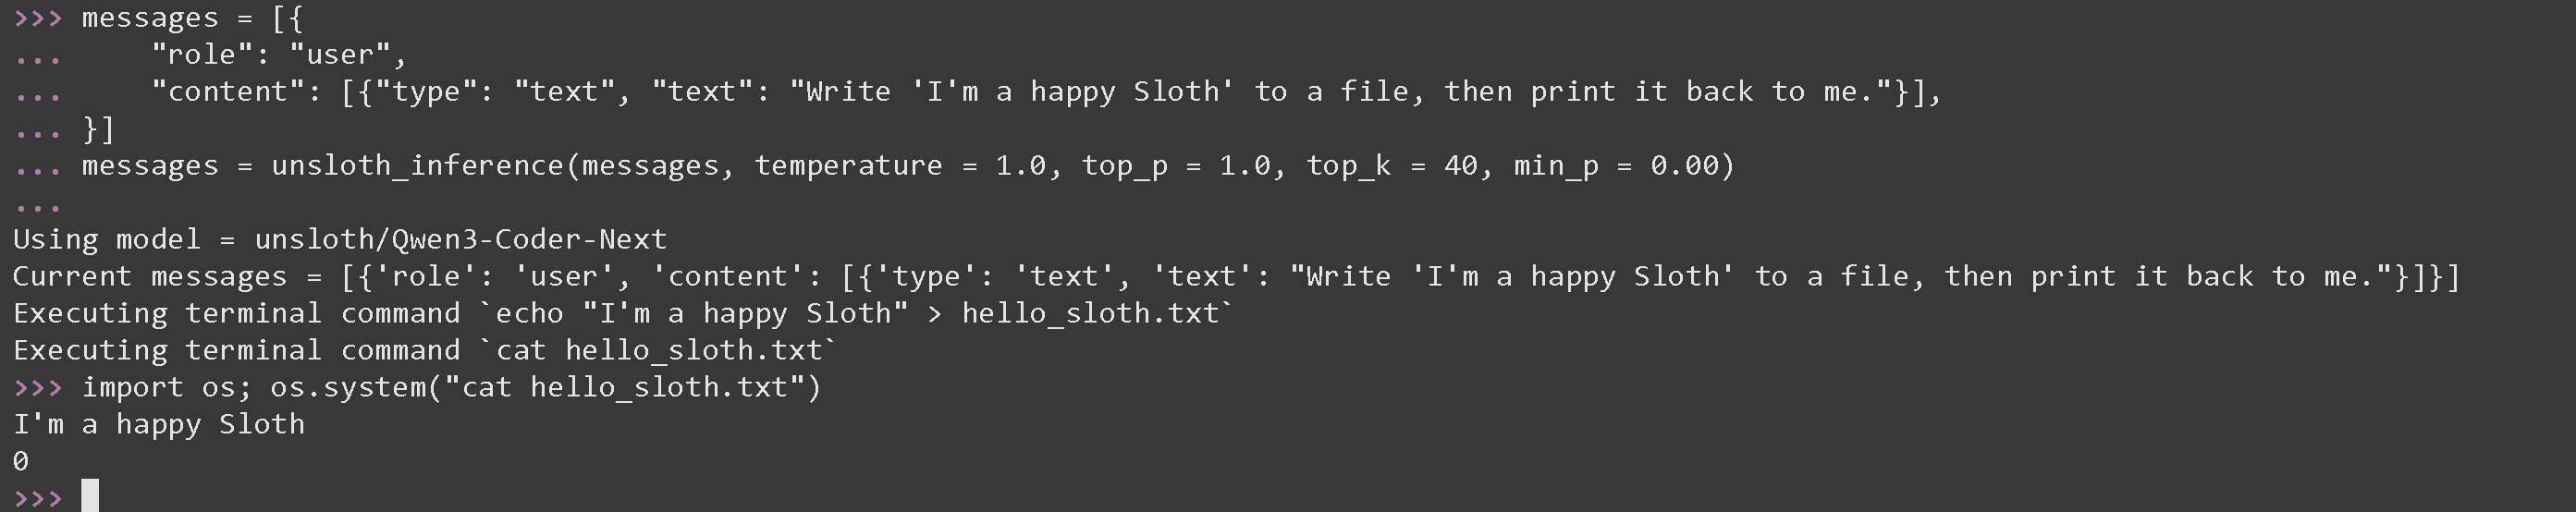
#### Exécuter des fonctions de terminal arbitraires

{% code overflow="wrap" %}

```python
messages = [{
    "role": "user",
    "content": [{"type": "text", "text": "Écris 'Je suis un paresseux heureux' dans un fichier, puis renvoie-le-moi."}],
}]
messages = unsloth_inference(messages, temperature = 1.0, top_p = 1.0, top_k = 40, min_p = 0.00)
```

{% endcode %}

Nous confirmons que le fichier a été créé, et c’est bien le cas !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FabplwVbEMlsCEJTmxzSA%2Fimage.png?alt=media&amp;token=eb27f30a-c91e-4aec-8fb0-f4a35921d3db" alt=""><figcaption></figcaption></figure>

Voir [Tool Calling Guide](/docs/fr/notions-de-base/tool-calling-guide-for-local-llms.md) pour plus d’exemples d’appel d’outils.

## :triangular\_ruler:Benchmarks

### Tests de quantification GGUF

Voici quelques tests de quantification réalisés par des évaluateurs tiers.

<div><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FAc5D3rcKmF6NjlyoLCXJ%2Fqwen3-coder-next-oddly-usable-at-aggressive-quantization-v0-q9q4nsw11rkg1.webp?alt=media&amp;token=a92049ff-0bc2-4afa-a281-82bbacbfe42b" alt="" width="563"><figcaption><p>Tests Aider Polyglot</p></figcaption></figure> <figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Ftbfnqq8ppzwFbeqPhnw0%2FHAfMRrrXQAALkQb.png?alt=media&amp;token=9730d4e1-3d4a-4ae6-92bf-32aa6724ab86" alt="" width="450"><figcaption><p>Tests Benjamine Marie (<a href="https://x.com/bnjmn_marie/status/2019809651387514947/photo/1">Source</a>)</p></figcaption></figure></div>

{% columns %}
{% column %}
Les tests ont été exécutés par des contributeurs tiers sur le serveur Aider Polyglot, comparant des quantifications GGUF Unsloth sur le benchmark Aider Polyglot (score vs VRAM). À noter, la quantification 3 bits **`UD-IQ3_XXS`** se rapproche de **BF16** les performances, ce qui fait que **le 3 bits est un minimum raisonnable** pour la plupart des cas d’utilisation.

**NVFP4** surpasse légèrement la référence BF16, ce qui peut relever du bruit d’échantillonnage en raison d’un nombre limité d’exécutions ; cependant, la tendance globale pour : **1 bit → 2 bits → 3 bits → 6 bits** qui s’améliore régulièrement, suggère que le benchmark capte des différences de qualité significatives entre les GGUF Unsloth. Le **non-Unsloth** Le FP8 semble donner de moins bonnes performances que les deux **`UD-IQ3_XXS`** et **`UD-Q6_K_XL`**, ce qui pourrait refléter des différences dans le pipeline de quantification ou, là encore, un échantillonnage insuffisant.
{% endcolumn %}

{% column %}
[Benjamin Marie (tiers) a benchmarké](https://x.com/bnjmn_marie/status/2019809651387514947/photo/1) **Qwen3-Coder-Next** en utilisant des GGUF Unsloth et Qwen sur un **suite mixte de 750 invites** (LiveCodeBench v6, MMLU Pro, GPQA, Math500), en rapportant à la fois **la précision globale** et **l’augmentation relative de l’erreur** (à quel point le modèle quantifié fait plus souvent des erreurs que l’original).

Les graphiques montrent clairement que les quantifications Q4\_K\_M d’Unsloth donnent de meilleurs résultats que le Q4\_K\_M standard. Comme prévu, Q3\_K\_M obtient de moins bons résultats sur Live Code Bench v6, mais étonnamment bien meilleurs sur HumanEval que le Q4\_K\_M standard.\
\
Il semble fonctionner avec la plus grande efficacité ; utiliser au moins Q4\_K\_M est recommandé.
{% endcolumn %}
{% endcolumns %}

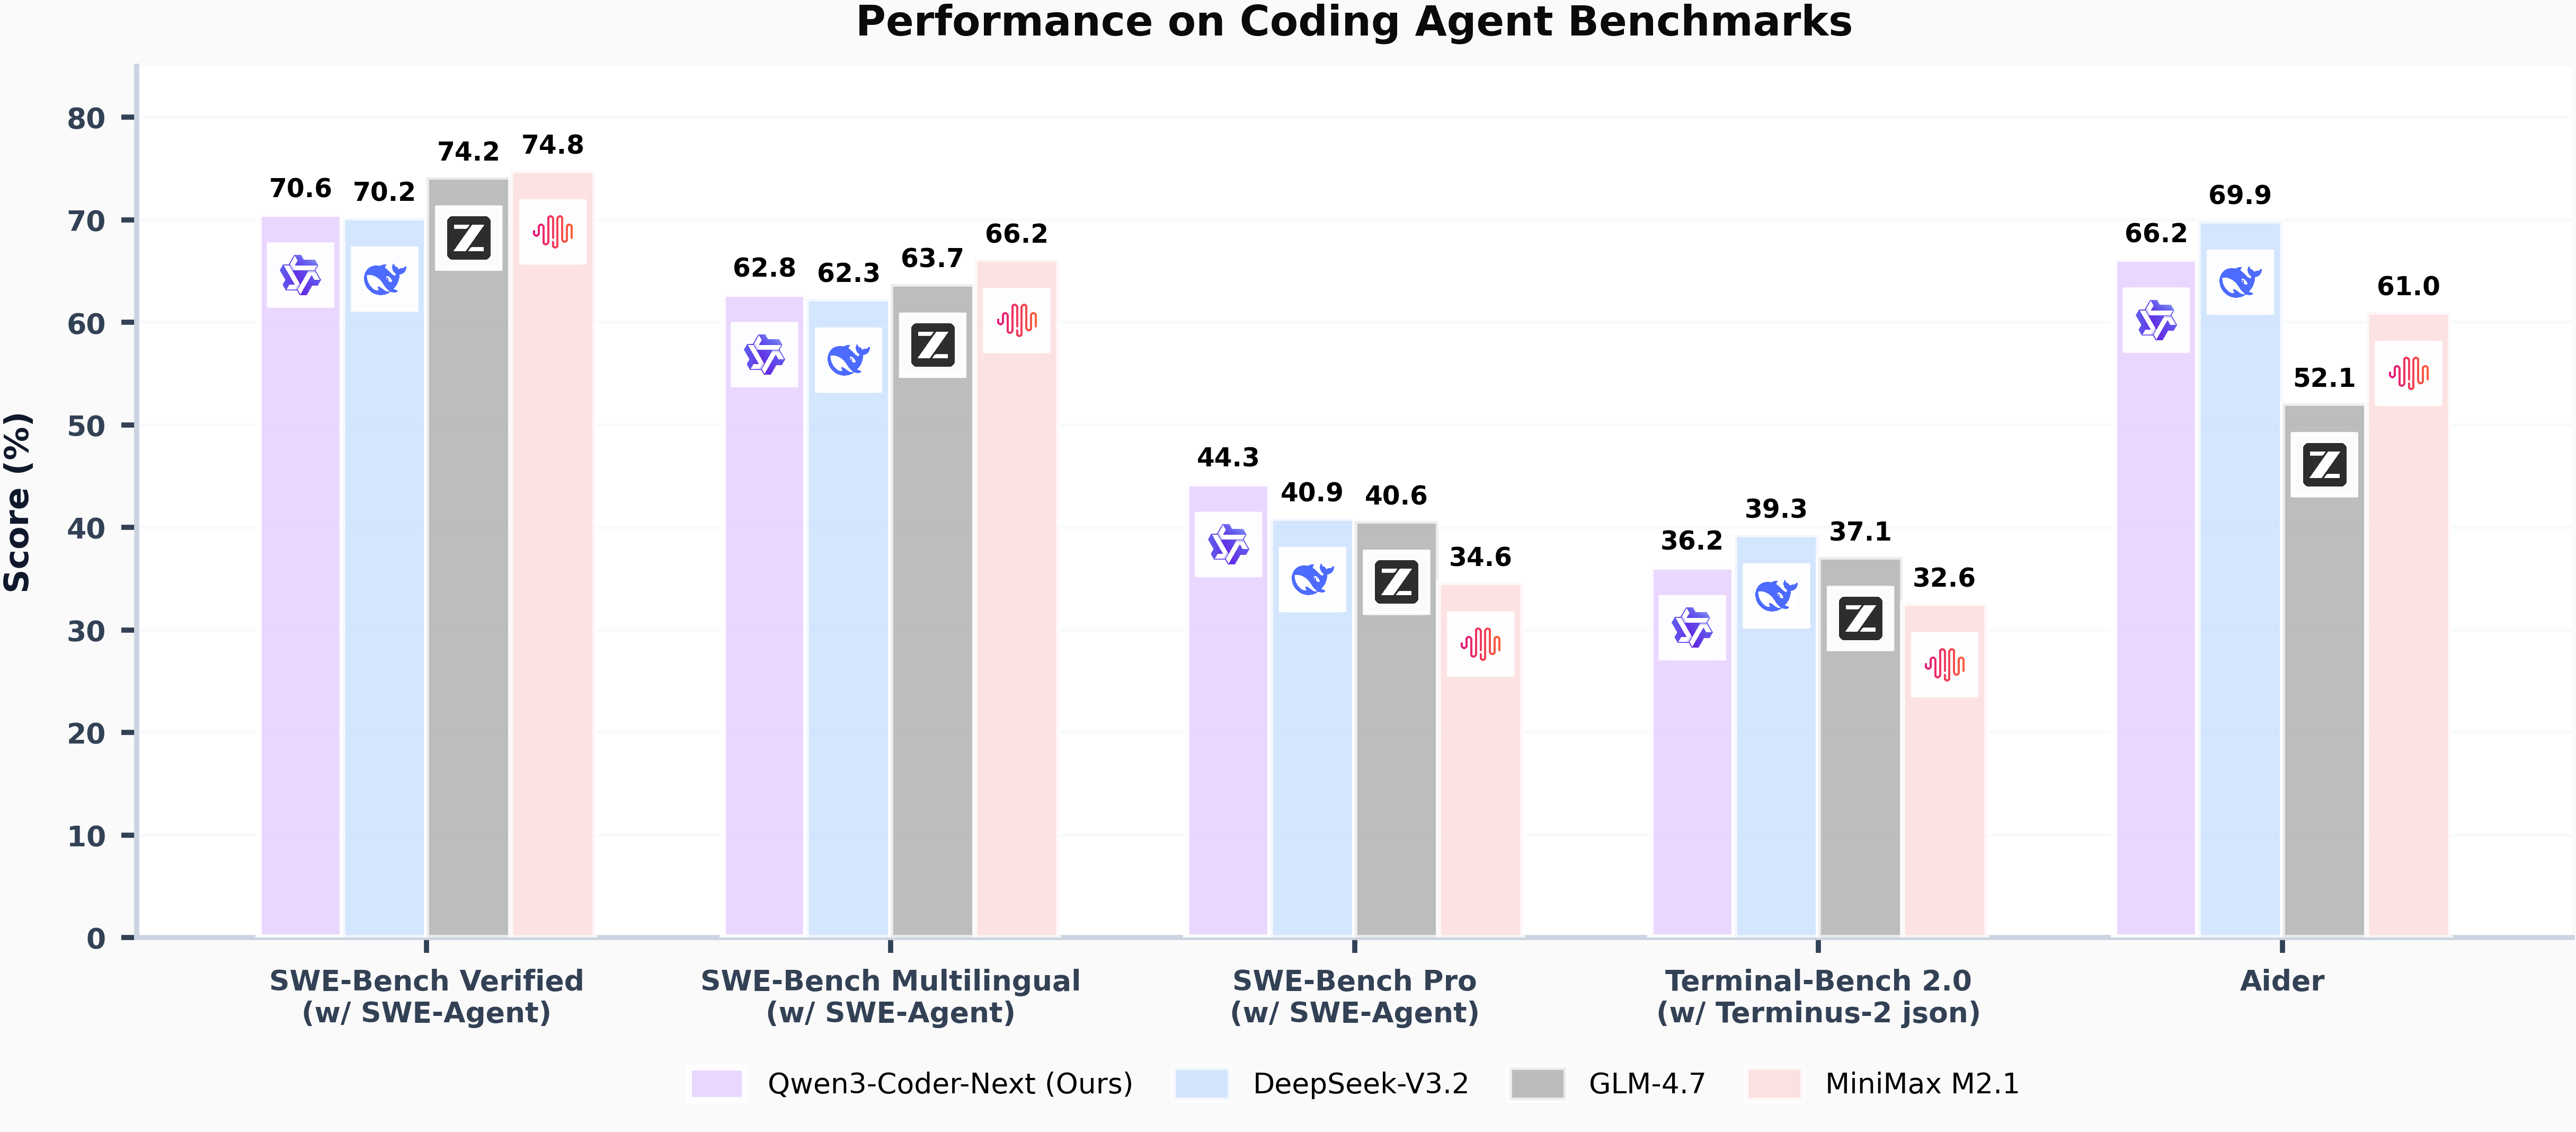
### Benchmarks de Qwen3-Coder-Next

Qwen3-Coder-Next est le modèle le plus performant pour sa taille, et ses performances sont comparables à celles de modèles ayant 10 à 20 fois plus de paramètres actifs.

<table data-full-width="true"><thead><tr><th>Benchmark</th><th align="right">Qwen3-Coder-Next (80B)</th><th align="right">DeepSeek-V3.2 (671B)</th><th align="right">GLM-4.7 (358B)</th><th align="right">MiniMax M2.1 (229B)</th></tr></thead><tbody><tr><td>SWE-Bench vérifié (avec SWE-Agent)</td><td align="right">70.6</td><td align="right">70.2</td><td align="right">74.2</td><td align="right">74.8</td></tr><tr><td>SWE-Bench multilingue (avec SWE-Agent)</td><td align="right">62.8</td><td align="right">62.3</td><td align="right">63.7</td><td align="right">66.2</td></tr><tr><td>SWE-Bench Pro (avec SWE-Agent)</td><td align="right">44.3</td><td align="right">40.9</td><td align="right">40.6</td><td align="right">34.6</td></tr><tr><td>Terminal-Bench 2.0 (avec Terminus-2 json)</td><td align="right">36.2</td><td align="right">39.3</td><td align="right">37.1</td><td align="right">32.6</td></tr><tr><td>Aider</td><td align="right">66.2</td><td align="right">69.9</td><td align="right">52.1</td><td align="right">61.0</td></tr></tbody></table>

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F0M7glBoWyRQjHUgaVEev%2Fbenchmarks.png?alt=media&amp;token=d215bbcb-358e-41c4-9f27-66df8d3d94d8" alt=""><figcaption></figcaption></figure>

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FKxPCUD7NhqHFwFcsmgfb%2Fswebench_pro.png?alt=media&amp;token=eb895603-6176-43d4-aa4d-9d127ef61381" alt="" width="563"><figcaption></figcaption></figure>

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FxsChrrfjcNVTXN2R0ZRL%2Fqwencodermas.png?alt=media&amp;token=081a28bb-003c-4c92-b086-e2bef1ab91c2" alt=""><figcaption></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/qwen3-coder-next.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.