> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune.md).
# Gemma 3 - guide d'exécution
Comment exécuter Gemma 3 efficacement avec nos GGUF sur llama.cpp, Ollama, Open WebUI et comment le fine-tuner avec Unsloth !
Google lance Gemma 3 avec un nouveau modèle 270M et les tailles précédentes 1B, 4B, 12B et 27B. Les modèles 270M et 1B sont uniquement textuels, tandis que les modèles plus grands gèrent à la fois le texte et la vision. Nous fournissons des GGUF, ainsi qu'un guide sur la façon de l'exécuter efficacement, et sur la façon de le fine-tuner et de faire [RL](/docs/fr/commencer/reinforcement-learning-rl-guide.md) avec Gemma 3 !
{% hint style="success" %}
**NOUVELLE mise à jour du 14 août 2025 :** Essayez notre fine-tuning [notebook Gemma 3 (270M)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(270M\).ipynb) et [des GGUF pour l'exécuter](https://huggingface.co/collections/unsloth/gemma-3-67d12b7e8816ec6efa7e4e5b).
Voir aussi notre [Guide Gemma 3n](/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md).
{% endhint %}
Tutoriel d’exécutionTutoriel d'affinage
**Unsloth est le seul framework qui fonctionne sur des machines float16 pour l'inférence et l'entraînement de Gemma 3.** Cela signifie que les notebooks Colab avec les GPU Tesla T4 gratuits fonctionnent aussi !
* Fine-tunez Gemma 3 (4B) avec prise en charge de la vision en utilisant notre [notebook Colab gratuit](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
{% hint style="info" %}
Selon l'équipe Gemma, la configuration optimale pour l'inférence est\
`temperature = 1.0, top_k = 64, top_p = 0.95, min_p = 0.0`
{% endhint %}
**Téléversements Unsloth Gemma 3 avec configurations optimales :**
| GGUF | Instruct dynamique 4 bits d'Unsloth | Instruct 16 bits |
| -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
|
|
## :gear: Paramètres d'inférence recommandés
Selon l'équipe Gemma, les paramètres officiels recommandés pour l'inférence sont :
* Température de 1,0
* Top\_K de 64
* Min\_P de 0,00 (facultatif, mais 0,01 fonctionne bien, la valeur par défaut de llama.cpp est 0,1)
* Top\_P de 0,95
* Pénalité de répétition de 1.0. (1.0 signifie désactivé dans llama.cpp et transformers)
* Modèle de conversation :
<bos><start_of_turn>user\nBonjour !<end_of_turn>\n<start_of_turn>model\nSalut !<end_of_turn>\n<start_of_turn>user\nQue fait 1+1 ?<end_of_turn>\n<start_of_turn>model\n
* Template de chat avec `\n`les nouvelles lignes rendues (sauf pour la dernière)
{% code overflow="wrap" %}
```
user
Bonjour !model
Salut !user
Que fait 1+1 ?model\n
```
{% endcode %}
{% hint style="danger" %}
llama.cpp et d'autres moteurs d'inférence ajoutent automatiquement un \ - N'ajoutez PAS DEUX jetons \ ! Vous devez ignorer le \ lorsque vous invitez le modèle !
{% endhint %}
### ✨Exécuter Gemma 3 sur votre téléphone
Pour exécuter les modèles sur votre téléphone, nous recommandons d'utiliser n'importe quelle application mobile capable d'exécuter localement des GGUF sur des appareils en périphérie comme les téléphones. Après fine-tuning, vous pouvez l'exporter en GGUF puis l'exécuter localement sur votre téléphone. Assurez-vous que votre téléphone dispose de suffisamment de RAM/de puissance pour traiter les modèles, car il peut surchauffer ; nous recommandons donc d'utiliser Gemma 3 270M ou les modèles Gemma 3n pour ce cas d'utilisation. Vous pouvez essayer le [du projet open source AnythingLLM](https://github.com/Mintplex-Labs/anything-llm) application mobile que vous pouvez télécharger sur [Android ici](https://play.google.com/store/apps/details?id=com.anythingllm) ou [ChatterUI](https://github.com/Vali-98/ChatterUI), qui sont d'excellentes applications pour exécuter des GGUF sur votre téléphone.
{% hint style="success" %}
N'oubliez pas, vous pouvez changer le nom du modèle 'gemma-3-27b-it-GGUF' en n'importe quel modèle Gemma comme 'gemma-3-270m-it-GGUF:Q8\_K\_XL' pour tous les tutoriels.
{% endhint %}
## :llama: Tutoriel : Comment exécuter Gemma 3 dans Ollama
1. Installez `ollama` si ce n'est pas déjà fait !
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. Exécutez le modèle ! Notez que vous pouvez appeler `ollama serve`dans un autre terminal si cela échoue ! Nous incluons toutes nos corrections et paramètres suggérés (température, etc.) dans `params` dans notre téléversement sur Hugging Face ! Vous pouvez changer le nom du modèle 'gemma-3-27b-it-GGUF' en n'importe quel modèle Gemma comme 'gemma-3-270m-it-GGUF:Q8\_K\_XL'.
```bash
ollama run hf.co/unsloth/gemma-3-27b-it-GGUF:Q4_K_XL
```
## 📖 Tutoriel : Comment exécuter Gemma 3 27B dans llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=ON -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Si vous souhaitez utiliser `llama.cpp` pour charger directement des modèles, vous pouvez faire ce qui suit : (:Q4\_K\_XL) est le type de quantification. Vous pouvez aussi télécharger via Hugging Face (point 3). C’est similaire à `ollama run`
```bash
./llama.cpp/llama-mtmd-cli \
-hf unsloth/gemma-3-4b-it-GGUF:Q4_K_XL
```
3. **OU** téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir Q4\_K\_M, ou d’autres versions quantifiées (comme la précision complète BF16). Plus de versions ici :
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/gemma-3-27b-it-GGUF",
local_dir = "unsloth/gemma-3-27b-it-GGUF",
allow_patterns = ["*Q4_K_XL*", "mmproj-BF16.gguf"], # Pour Q4_K_M
)
```
4. Exécutez le test Flappy Bird d'Unsloth
5. Modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 16384` pour la longueur de contexte (Gemma 3 prend en charge une longueur de contexte de 128K !), `--n-gpu-layers 99` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.
6. Pour le mode conversation :
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/gemma-3-27b-it-GGUF/gemma-3-27b-it-Q4_K_XL.gguf \
--mmproj unsloth/gemma-3-27b-it-GGUF/mmproj-BF16.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 1.0 \
--repeat-penalty 1.0 \\
--min-p 0.01 \
--top-k 64 \\
--top-p 0.95
```
7. Pour le mode sans conversation pour tester Flappy Bird :
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-3-27b-it-GGUF/gemma-3-27b-it-Q4_K_XL.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 1.0 \
--repeat-penalty 1.0 \\
--min-p 0.01 \
--top-k 64 \\
--top-p 0.95 \
-no-cnv \
--prompt "user\nCréez un jeu Flappy Bird en Python. Vous devez inclure ces éléments :\n1. Vous devez utiliser pygame.\n2. La couleur de fond doit être choisie aléatoirement et être une teinte claire. Commencez avec une couleur bleu clair.\n3. Appuyer plusieurs fois sur SPACE accélérera l'oiseau.\n4. La forme de l'oiseau doit être choisie aléatoirement parmi un carré, un cercle ou un triangle. La couleur doit être choisie aléatoirement et être une couleur sombre.\n5. Placez en bas un terrain coloré en marron foncé ou en jaune, choisi aléatoirement.\n6. Affichez un score en haut à droite. Il augmente si vous franchissez les tuyaux et ne les touchez pas.\n7. Créez des tuyaux espacés aléatoirement avec suffisamment d'espace. Coloriez-les aléatoirement en vert foncé, brun clair ou en gris foncé.\n8. Lorsque vous perdez, affichez le meilleur score. Faites apparaître le texte à l'intérieur de l'écran. Appuyer sur q ou Esc quittera le jeu. Redémarrer consiste à appuyer à nouveau sur SPACE.\nLe jeu final doit se trouver dans une section markdown en Python. Vérifiez votre code pour détecter les erreurs et corrigez-les avant la section markdown finale.\nmodel\n"
```
L'entrée complète de notre blog 1,58 bit est :
{% hint style="danger" %}
N'oubliez pas de supprimer \ puisque Gemma 3 ajoute automatiquement un \ !
{% endhint %}
{% code overflow="wrap" %}
```
user
Créez un jeu Flappy Bird en Python. Vous devez inclure les éléments suivants :
1. Vous devez utiliser pygame.
2. La couleur de fond doit être choisie aléatoirement et être d'une teinte claire. Commencez avec une couleur bleu clair.
3. Appuyer plusieurs fois sur ESPACE accélérera l'oiseau.
4. La forme de l'oiseau doit être choisie aléatoirement parmi un carré, un cercle ou un triangle. La couleur doit être choisie aléatoirement parmi des couleurs sombres.
5. Placez en bas un sol de couleur marron foncé ou jaune choisi aléatoirement.
6. Affichez un score en haut à droite. Augmentez-le si vous passez les tuyaux sans les heurter.
7. Créez des tuyaux espacés aléatoirement avec suffisamment d'espace. Coloriez-les aléatoirement en vert foncé, marron clair ou dans une nuance de gris foncé.
8. Quand vous perdez, affichez le meilleur score. Placez le texte à l'intérieur de l'écran. Appuyer sur q ou Échap quittera le jeu. Redémarrer se fait en appuyant à nouveau sur ESPACE.
Le jeu final doit se trouver dans une section markdown en Python. Vérifiez votre code pour détecter des erreurs
```
{% endcode %}
## :sloth: Fine-tuning de Gemma 3 dans Unsloth
**Unsloth est le seul framework qui fonctionne sur des machines float16 pour l'inférence et l'entraînement de Gemma 3.** Cela signifie que les notebooks Colab avec les GPU Tesla T4 gratuits fonctionnent aussi !
* Essayez notre nouveau [notebook Gemma 3 (270M)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(270M\).ipynb) qui rend le modèle de 270M paramètres très doué aux échecs et peut prédire le prochain coup aux échecs.
* Fine-tunez Gemma 3 (4B) en utilisant nos notebooks pour : [**Texte**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\).ipynb) ou [**Vision**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
* Ou fine-tunez [Gemma 3n (E4B)](/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md) par [Texte](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb) • [Vision](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Vision.ipynb) • [Audio](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Audio.ipynb)
{% hint style="warning" %}
Lorsque l'on essaie un fine-tune complet (FFT) de Gemma 3, toutes les couches passent par défaut en float32 sur les appareils float16. Unsloth s'attend à du float16 et effectue une conversion ascendante dynamiquement. Pour corriger cela, exécutez `model.to(torch.float16)` après le chargement, ou utilisez un GPU prenant en charge le bfloat16.
{% endhint %}
### Correctifs de fine-tuning Unsloth
Notre solution dans Unsloth se décline en 3 volets :
1. Conserver toutes les activations intermédiaires au format bfloat16 - elles peuvent être en float32, mais cela utilise 2x plus de VRAM ou de RAM (via le checkpointing asynchrone des gradients d'Unsloth)
2. Effectuer toutes les multiplications matricielles en float16 avec les cœurs tensoriels, mais en effectuant manuellement la conversion ascendante/descendante sans l'aide de l'autocast de précision mixte de Pytorch.
3. Convertir en float32 toutes les autres options qui n'ont pas besoin de multiplications matricielles (layer norms).
## 🤔 Analyse des correctifs de Gemma 3
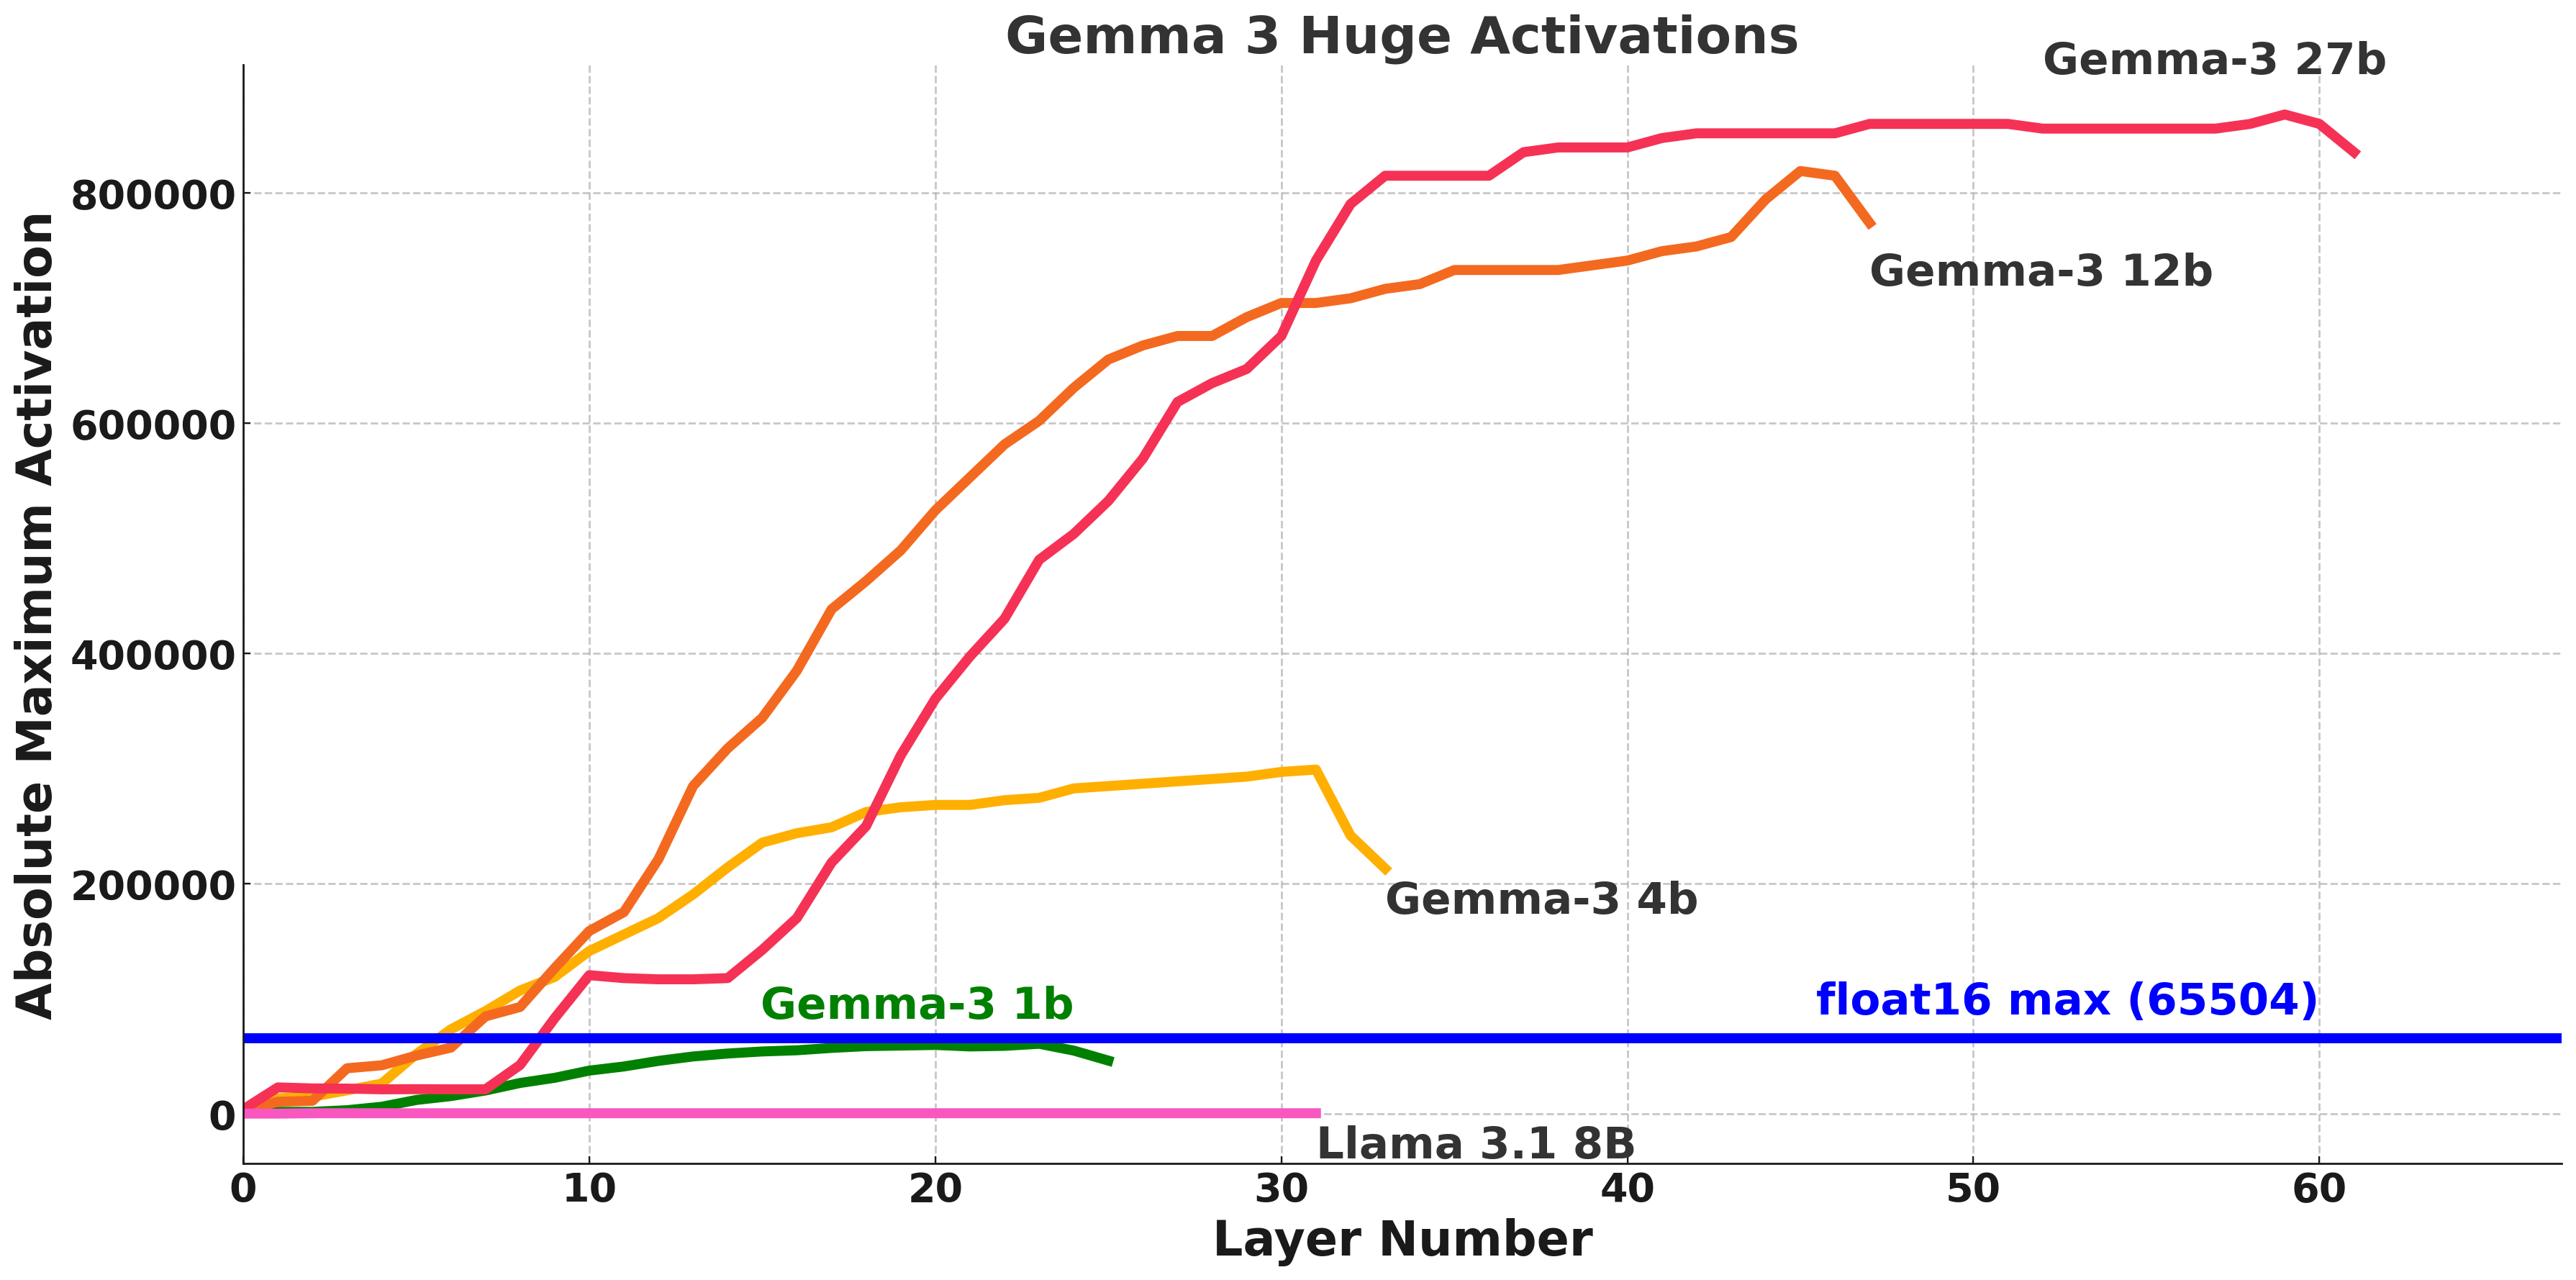
Les versions Gemma 3 de 1B à 27B dépassent le maximum du float16, qui est de 65504
D'abord, avant de fine-tuner ou d'exécuter Gemma 3, nous avons constaté qu'en utilisant la précision mixte float16, les gradients et **les activations deviennent infinis** malheureusement. Cela se produit sur les GPU T4, la série RTX 20x et les GPU V100, où ils disposent seulement de cœurs tensoriels float16.
Pour les GPU plus récents comme les RTX 30x ou supérieurs, les A100, H100, etc., ces GPU disposent de cœurs tensoriels bfloat16, donc ce problème ne se produit pas ! **Mais pourquoi ?**
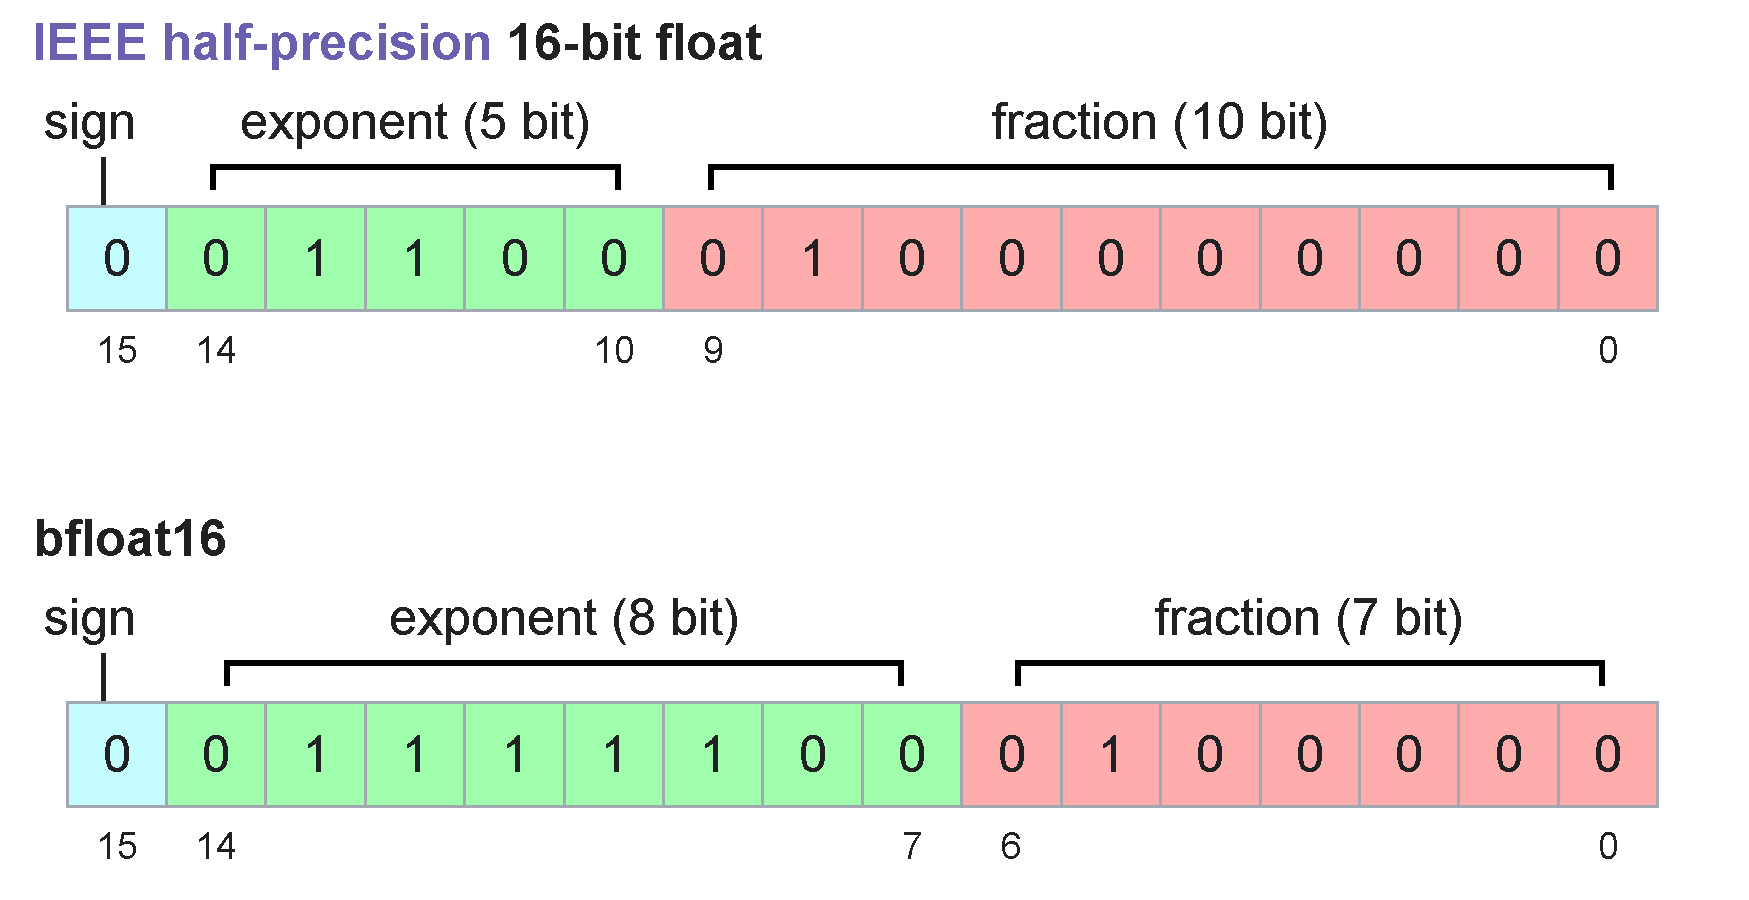
Le float16 ne peut représenter que des nombres jusqu'à **65504**, tandis que le bfloat16 peut représenter d'énormes nombres jusqu'à **10^38**! Mais remarquez que les deux formats de nombre n'utilisent que 16 bits ! C'est parce que le float16 alloue plus de bits pour mieux représenter les petits décimaux, tandis que le bfloat16 ne peut pas bien représenter les fractions.
Mais pourquoi le float16 ? Utilisons simplement le float32 ! Mais malheureusement, le float32 sur les GPU est très lent pour les multiplications matricielles - parfois 4 à 10 fois plus lent ! Donc nous ne pouvons pas faire cela.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.