> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/blog/quantization-aware-training-qat.md).
# Entraînement conscient de la quantification (QAT)
Quantifiez des modèles en 4 bits avec Unsloth et PyTorch pour récupérer de la précision.
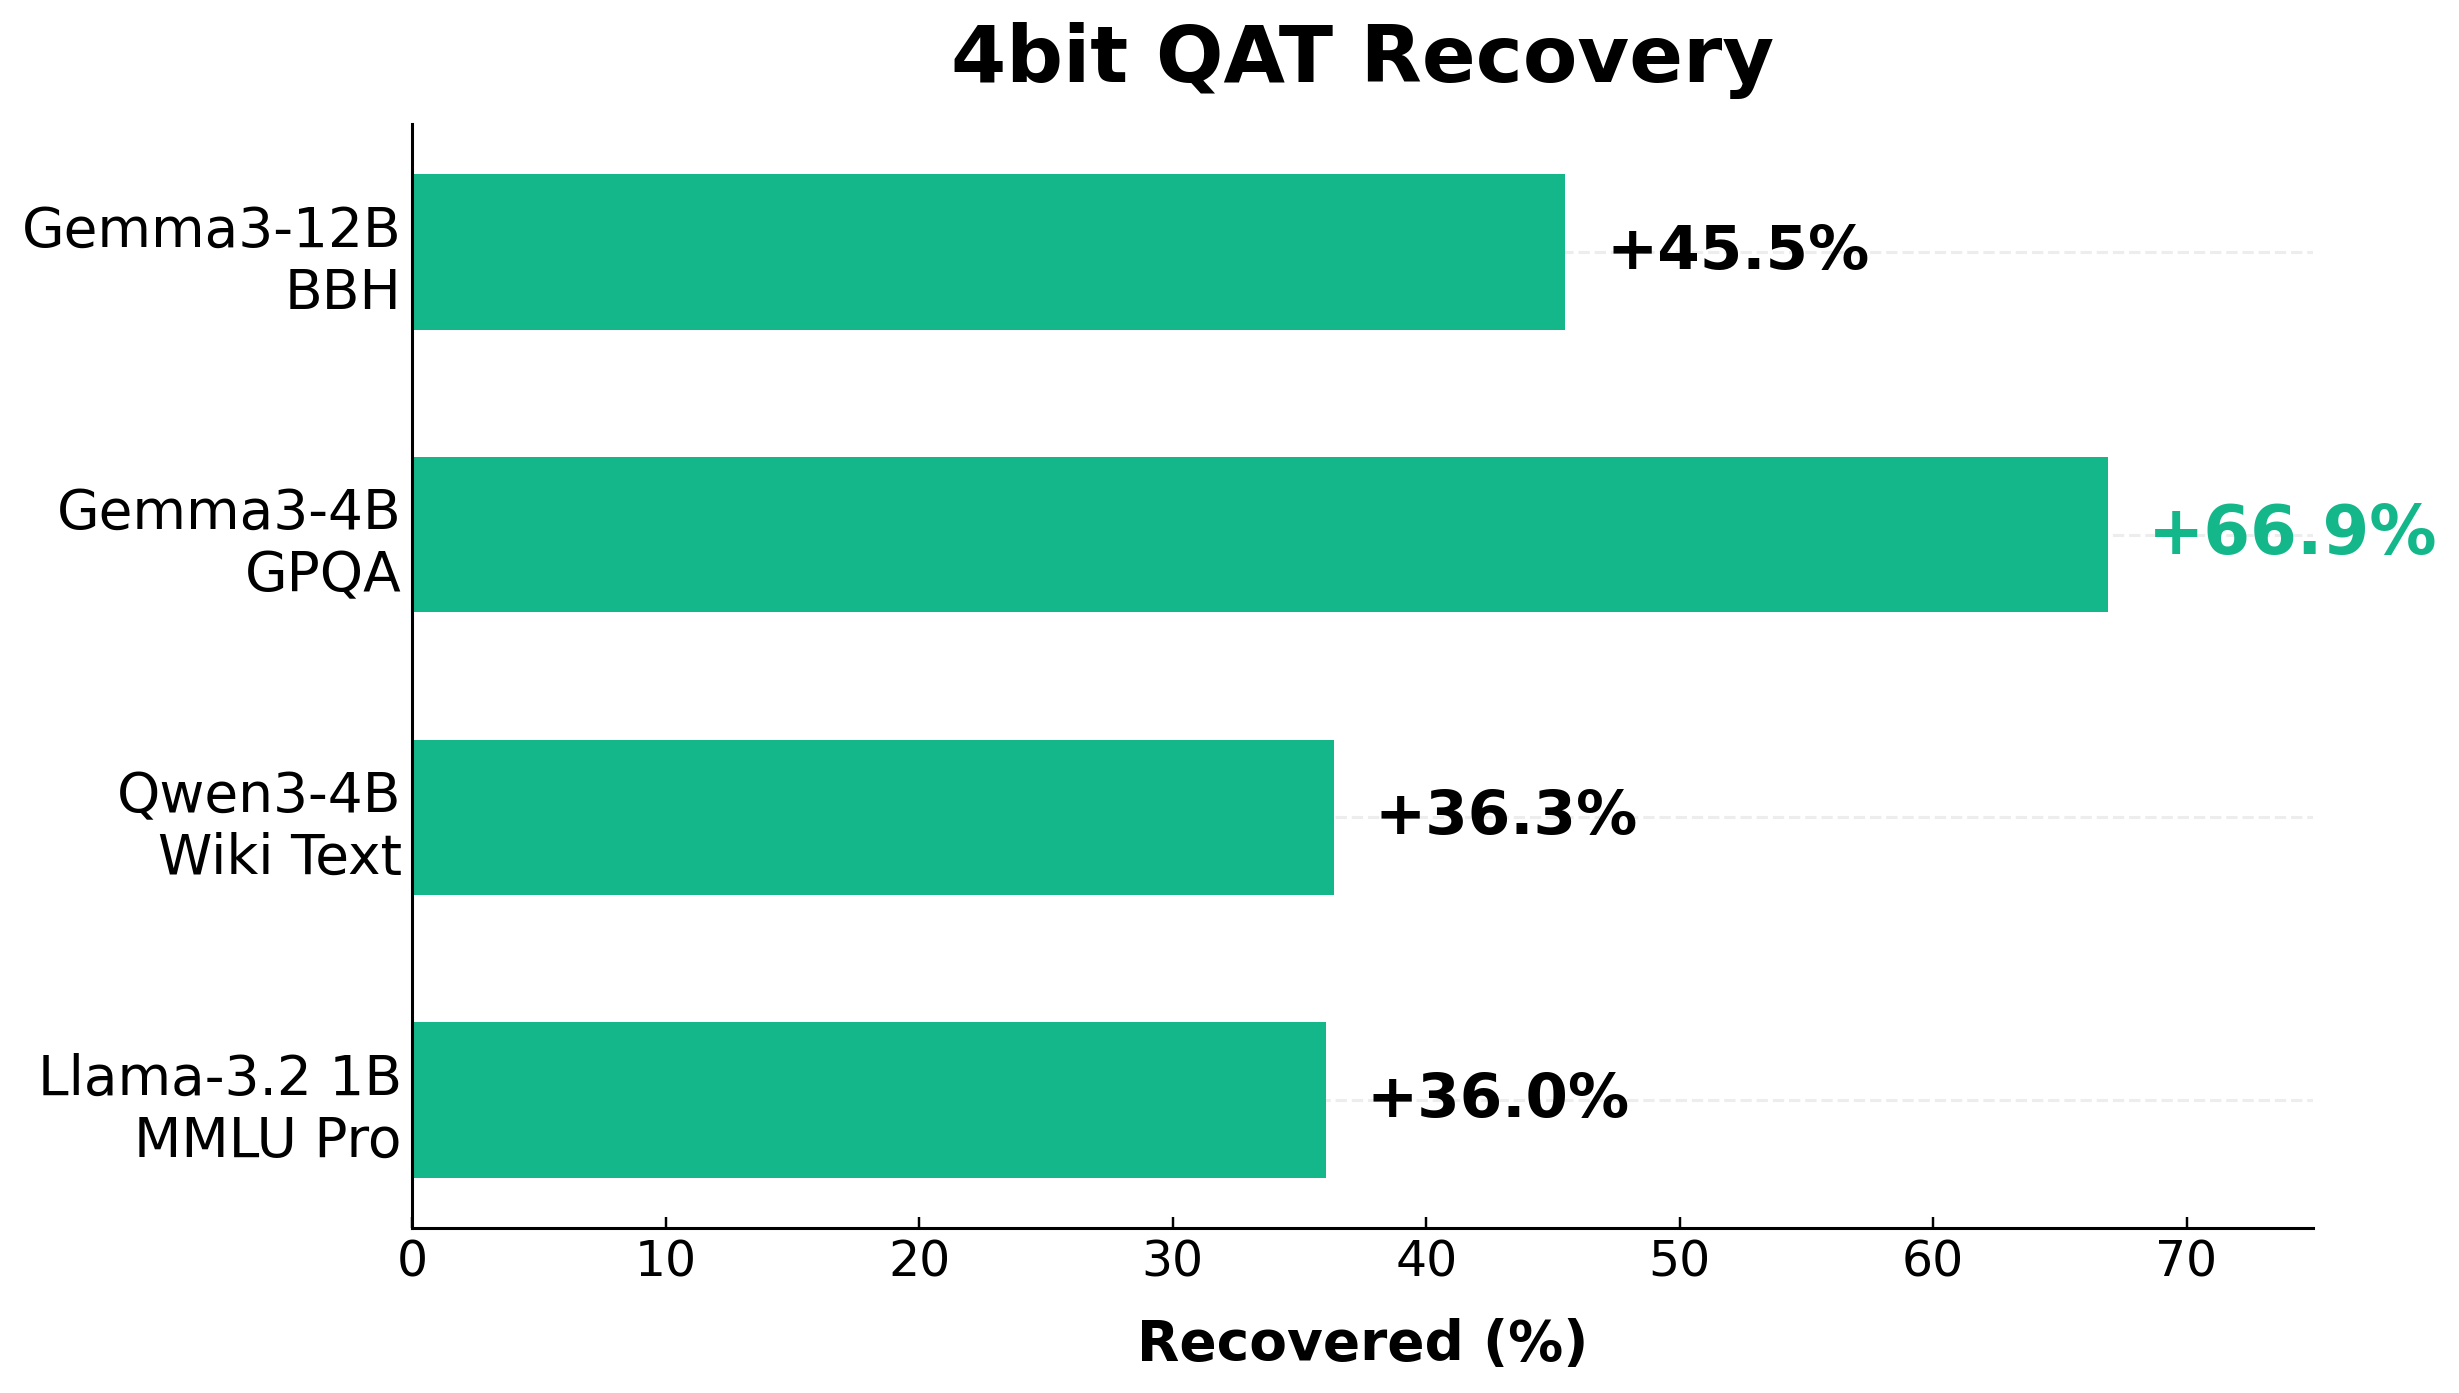
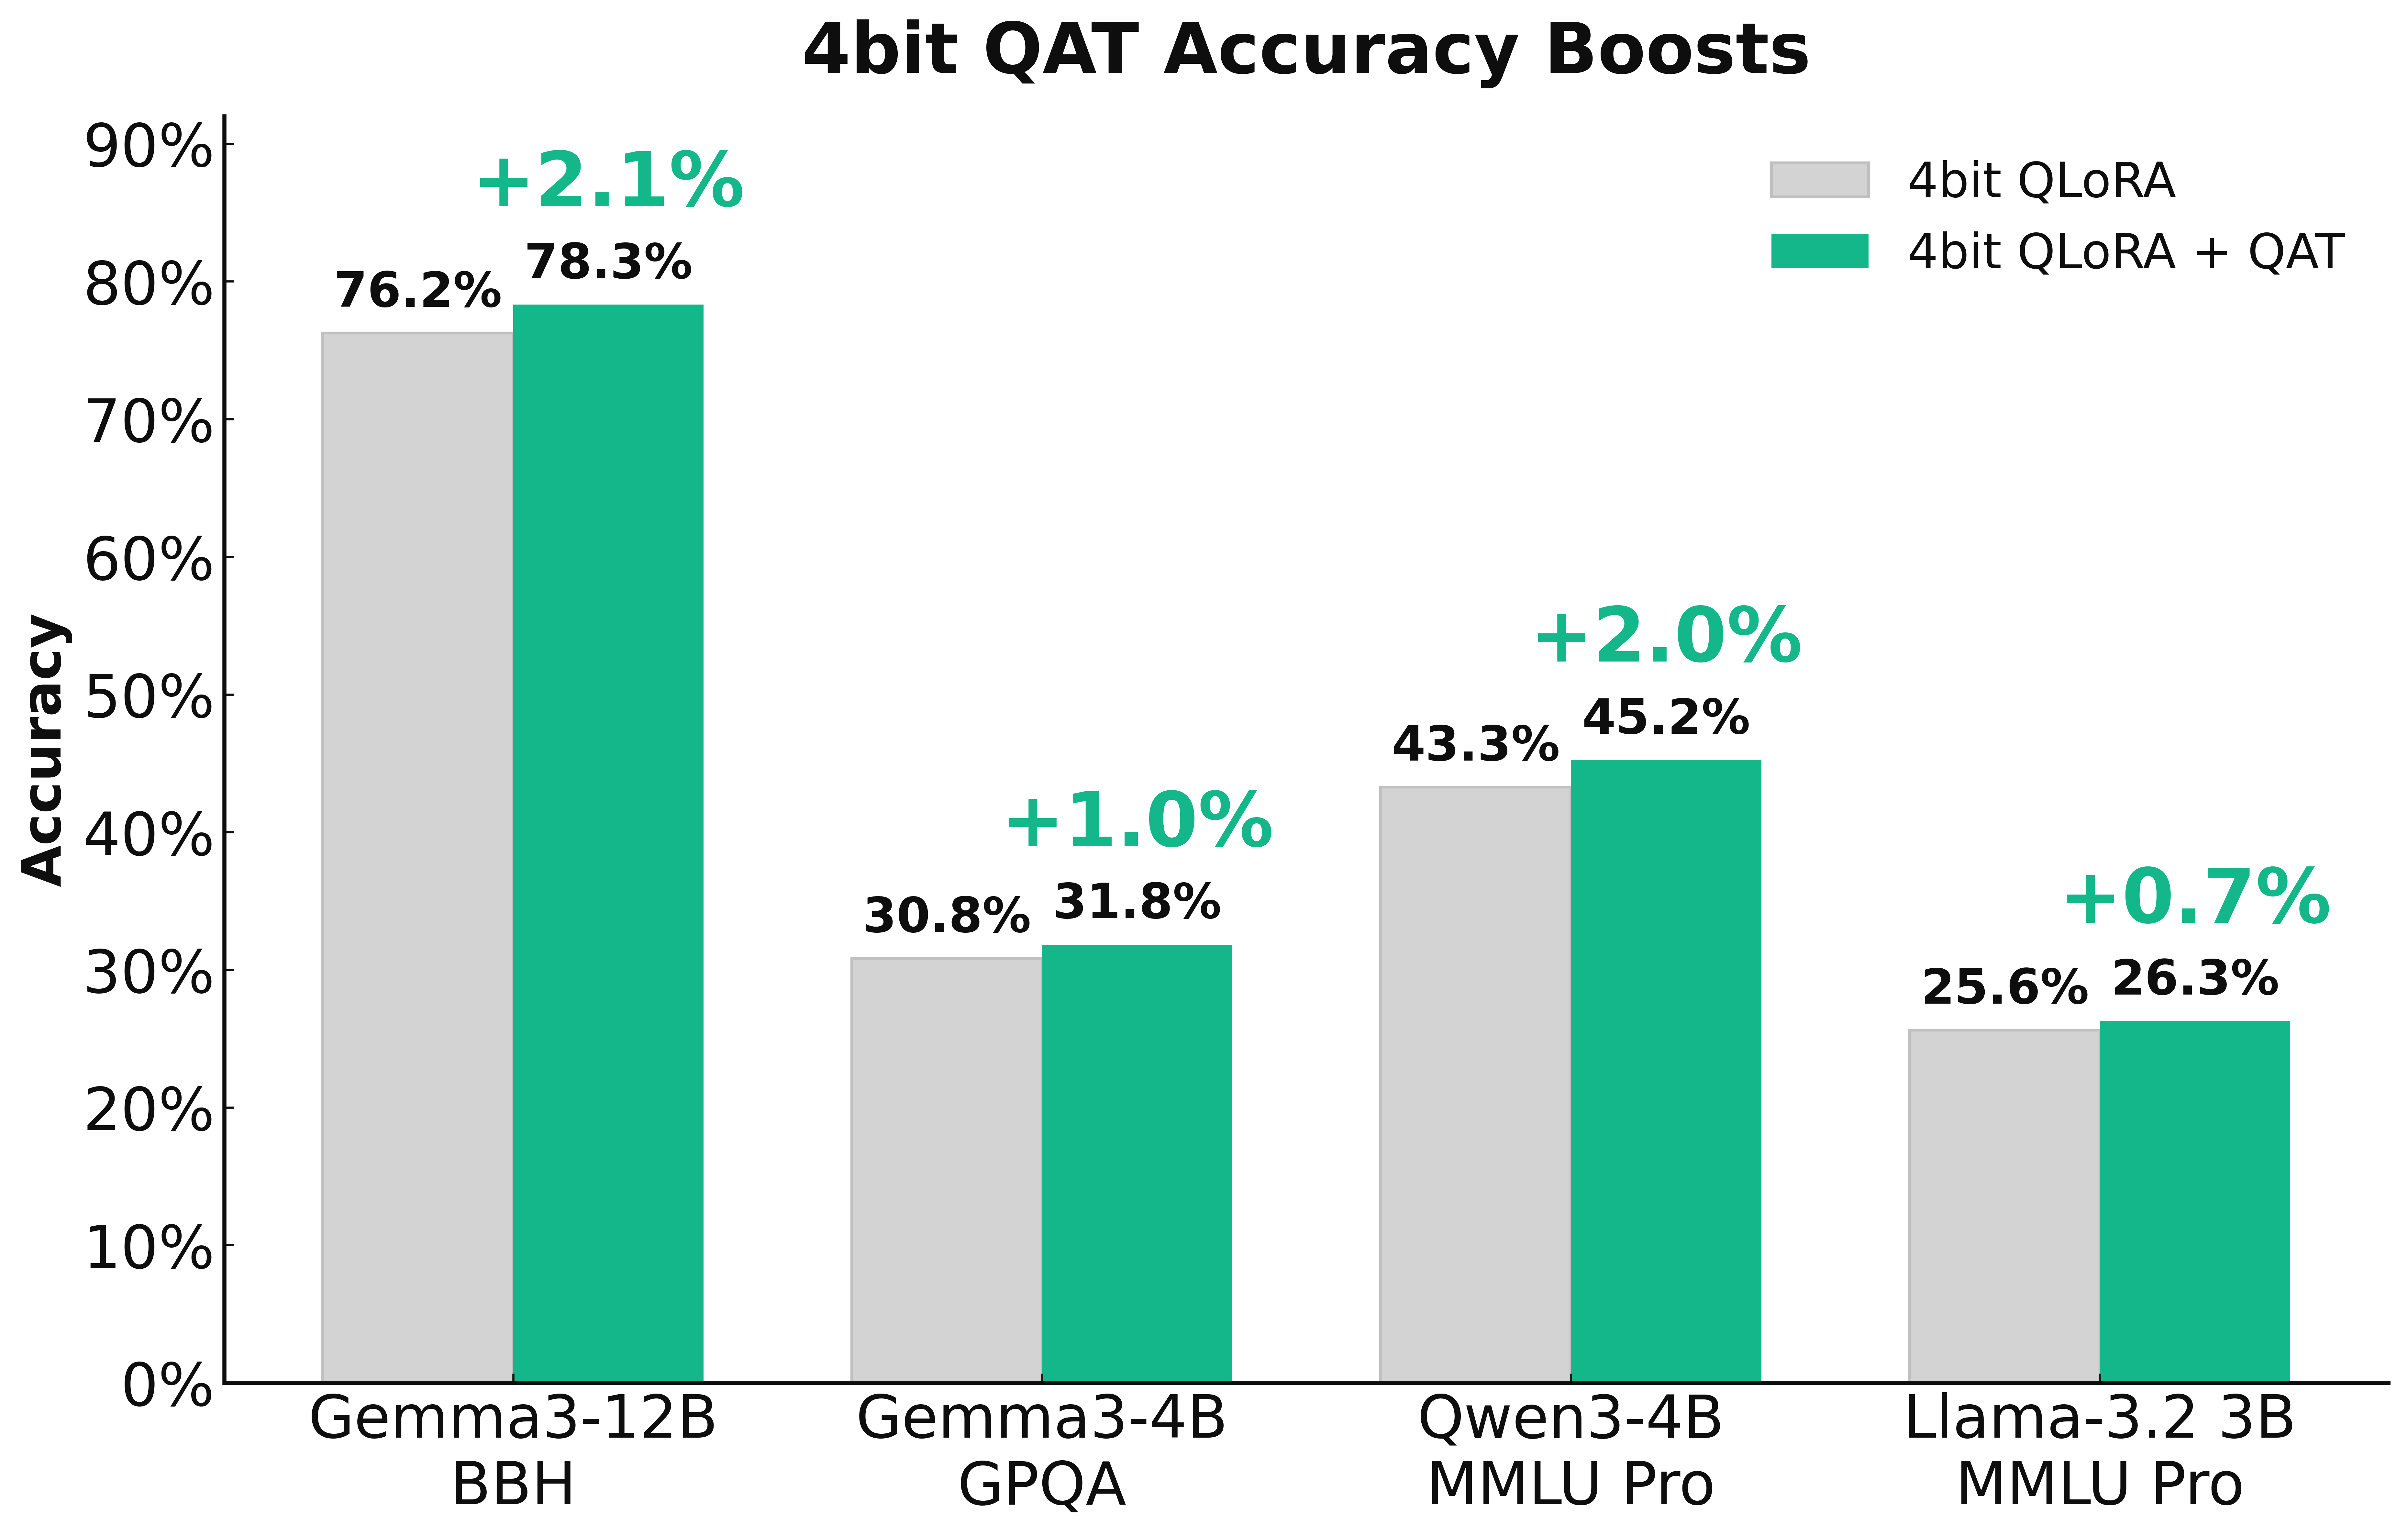
En collaboration avec PyTorch, nous introduisons QAT (Quantization-Aware Training) dans Unsloth pour permettre **la quantification entraînable** qui récupère autant de précision que possible. Cela se traduit par une qualité de modèle nettement meilleure par rapport à la quantification naïve standard en 4 bits. QAT peut récupérer jusqu'à **70 % de la précision perdue** et atteindre un **1–3 %** d'amélioration des performances du modèle sur des benchmarks tels que GPQA et MMLU Pro.
> **Essayez QAT avec notre notebook gratuit** [**notebook Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)_Instruct-QAT.ipynb)
### :books:Quantification
{% columns %}
{% column width="50%" %}
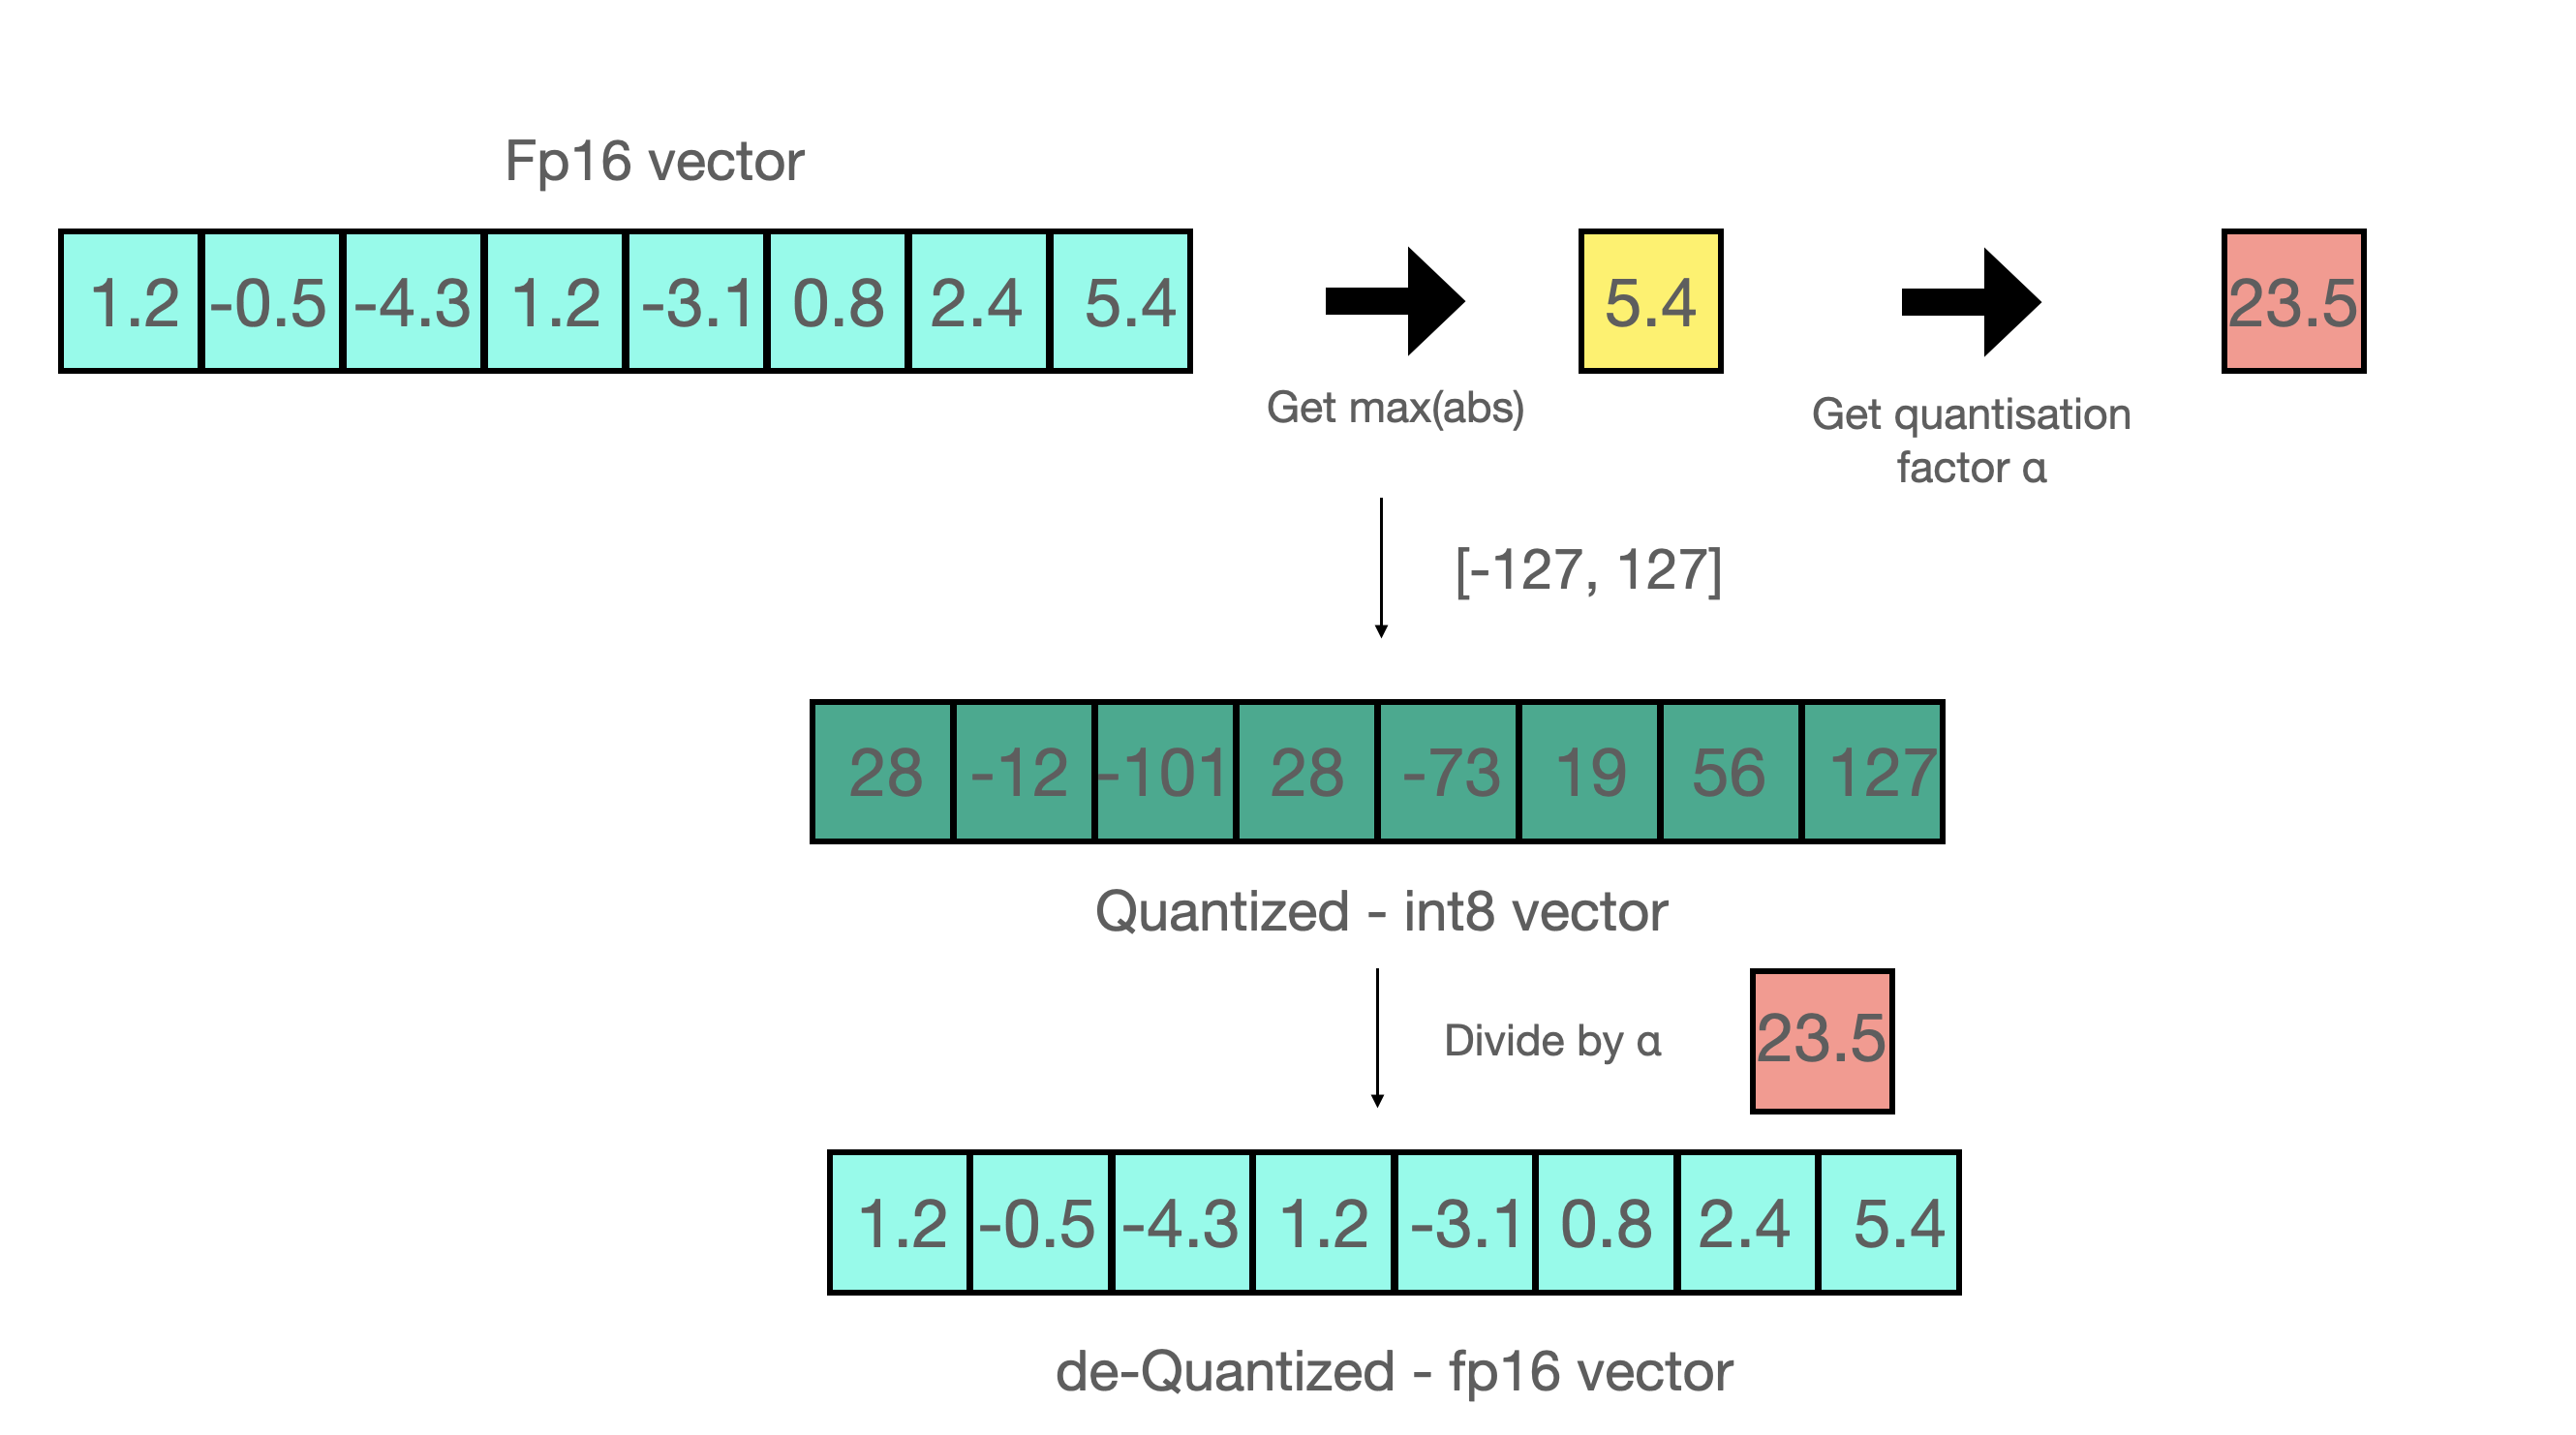
La quantification naïve d'un modèle s'appelle **quantification post-entraînement** (PTQ). Par exemple, supposons que nous voulions quantifier en entiers 8 bits :
1. Trouvez `max(abs(W))`
2. Trouvez `a = 127/max(abs(W))` où a est la plage maximale d'int8, qui est 127
3. Quantifier via `qW = int8(round(W * a))`
{% endcolumn %}
{% column width="50%" %}
{% endcolumn %}
{% endcolumns %}
La déquantification vers 16 bits se fait simplement en appliquant l'opération inverse : `float16(qW) / a` . La quantification post-entraînement (PTQ) peut réduire considérablement les coûts de stockage et d'inférence, mais dégrade assez souvent la précision lorsqu'on représente des valeurs de haute précision avec moins de bits - surtout en 4 bits ou moins. Une façon de résoudre cela consiste à utiliser nos [**quantifications GGUF dynamiques**](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md), qui utilisent un jeu de données de calibration pour modifier la procédure de quantification afin d'accorder plus d'importance aux poids importants. L'autre solution consiste à rendre la **quantification plus intelligente, en la rendant entraînable ou apprenable**!
### :fire:Quantification plus intelligente
Pour permettre une quantification plus intelligente, nous avons collaboré avec l'équipe [TorchAO](https://github.com/pytorch/ao) pour ajouter **l'entraînement conscient de la quantification (QAT)** directement dans Unsloth - ainsi, vous pouvez maintenant affiner des modèles dans Unsloth puis les exporter directement au format QAT 4 bits avec des améliorations de précision !
En fait, **QAT récupère 66,9 %** de Gemma3-4B sur GPQA, et augmente la précision brute de +1,0 %. Gemma3-12B sur BBH récupère 45,5 %, et **augmente la précision brute de +2,1 %**. QAT n'entraîne aucun surcoût supplémentaire pendant l'inférence, et utilise le même espace disque et la même mémoire qu'une quantification naïve normale ! Vous obtenez donc tous les avantages de la quantification à faible nombre de bits, mais avec une précision bien accrue !
### :mag:Entraînement conscient de la quantification
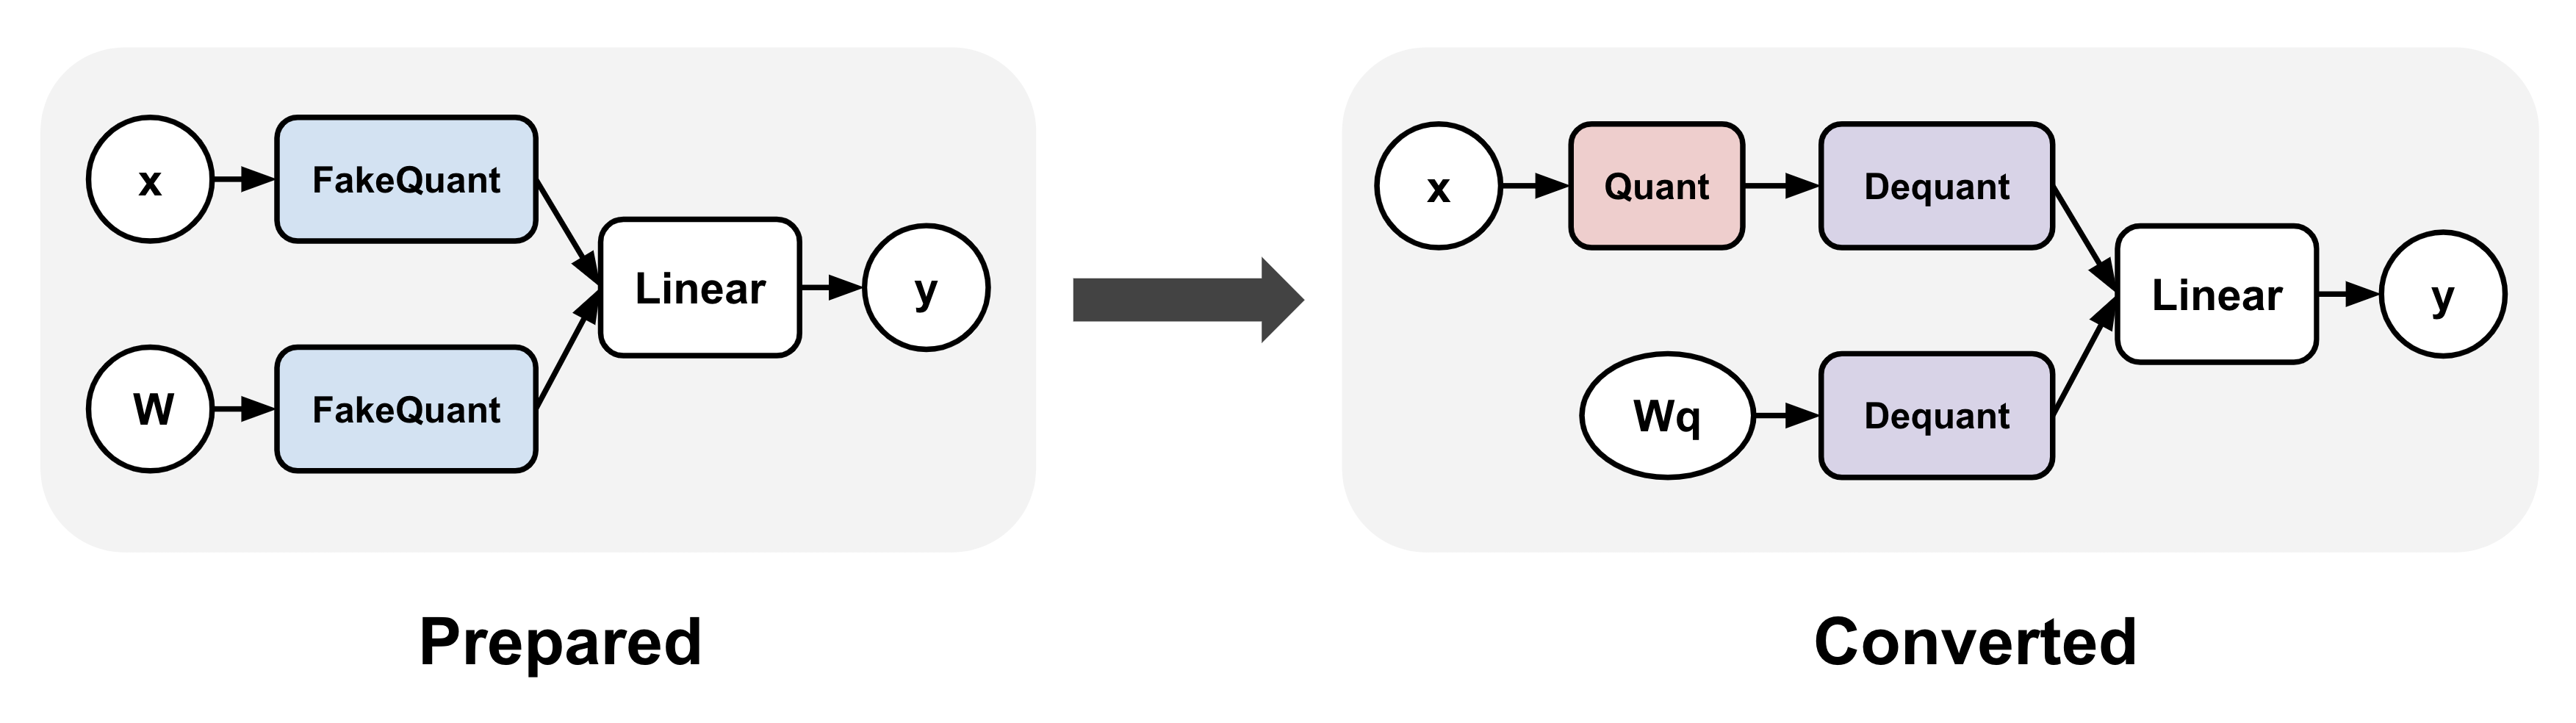
QAT simule le véritable processus de quantification en "**quantification fictive**" les poids et, en option, les activations pendant l'entraînement, ce qui signifie généralement arrondir les valeurs de haute précision vers des valeurs quantifiées (tout en restant dans un type de données haute précision, par exemple bfloat16), puis les déquantifier immédiatement.
TorchAO permet le QAT en (1) insérant d'abord des opérations de quantification fictive dans les couches linéaires, puis (2) en transformant les opérations de quantification fictive en véritables opérations de quantification et de déquantification après l'entraînement pour le rendre prêt pour l'inférence. L'étape 1 nous permet d'entraîner une représentation de quantification plus précise.
### :sparkles:QAT + ajustement fin LoRA
QAT dans Unsloth peut également être combiné avec un ajustement fin LoRA pour offrir les avantages des deux mondes : réduire considérablement les besoins en stockage et en calcul pendant l'entraînement tout en atténuant la dégradation due à la quantification ! Nous prenons en charge plusieurs méthodes via `qat_scheme` y compris `fp8-int4`, `fp8-fp8`, `int8-int4`, `int4` . Nous prévoyons également d'ajouter des définitions personnalisées pour QAT dans une prochaine version !
{% code overflow="wrap" %}
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Qwen3-4B-Instruct-2507",
max_seq_length = 2048,
load_in_16bit = True,
)
model = FastLanguageModel.get_peft_model(
model,
r = 16,
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",],
lora_alpha = 32,
# Nous prenons en charge fp8-int4, fp8-fp8, int8-int4, int4
qat_scheme = "int4",
)
```
{% endcode %}
### :teapot:Exportation des modèles QAT
Après l'ajustement fin dans Unsloth, vous pouvez appeler `model.save_pretrained_torchao` pour sauvegarder votre modèle entraîné au format PTQ de TorchAO. Vous pouvez aussi les téléverser sur le hub HuggingFace ! Nous prenons en charge n'importe quelle configuration, et nous prévoyons de rendre également les méthodes textuelles possibles, et de rendre le processus plus simple pour tout le monde ! Mais d'abord, nous devons préparer le modèle QAT pour l'étape finale de conversion via :
{% code overflow="wrap" %}
```python
from torchao.quantization import quantize_
from torchao.quantization.qat import QATConfig
quantize_(model, QATConfig(step = "convert"))
```
{% endcode %}
Et maintenant, nous pouvons sélectionner le style QAT que vous voulez :
{% code overflow="wrap" %}
```python
# Utilisez exactement la même configuration que QAT (fonction pratique)
model.save_pretrained_torchao(
model, "tokenizer",
torchao_config = model._torchao_config.base_config,
)
# QAT int4
from torchao.quantization import Int4WeightOnlyConfig
model.save_pretrained_torchao(
model, "tokenizer",
torchao_config = Int4WeightOnlyConfig(),
)
# QAT int8
from torchao.quantization import Int8DynamicActivationInt8WeightConfig
model.save_pretrained_torchao(
model, "tokenizer",
torchao_config = Int8DynamicActivationInt8WeightConfig(),
)
```
{% endcode %}
Vous pouvez ensuite exécuter le modèle fusionné QAT à plus faible précision dans vLLM, Unsloth et d'autres systèmes pour l'inférence ! Tout cela se trouve également dans le [notebook Colab QAT Qwen3-4B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)_Instruct-QAT.ipynb) que nous avons aussi !
### :teapot:Quantification des modèles sans entraînement
Vous pouvez également appeler `model.save_pretrained_torchao` directement, sans effectuer de QAT non plus ! Il s'agit simplement de PTQ ou de quantification native. Par exemple, l'enregistrement au format float8 dynamique est le suivant :
{% code overflow="wrap" %}
```python
# Float8
from torchao.quantization import PerRow
from torchao.quantization import Float8DynamicActivationFloat8WeightConfig
torchao_config = Float8DynamicActivationFloat8WeightConfig(granularity = PerRow())
model.save_pretrained_torchao(torchao_config = torchao_config)
```
{% endcode %}
### :mobile\_phone:ExecuTorch - QAT pour le déploiement mobile
{% columns %}
{% column %}
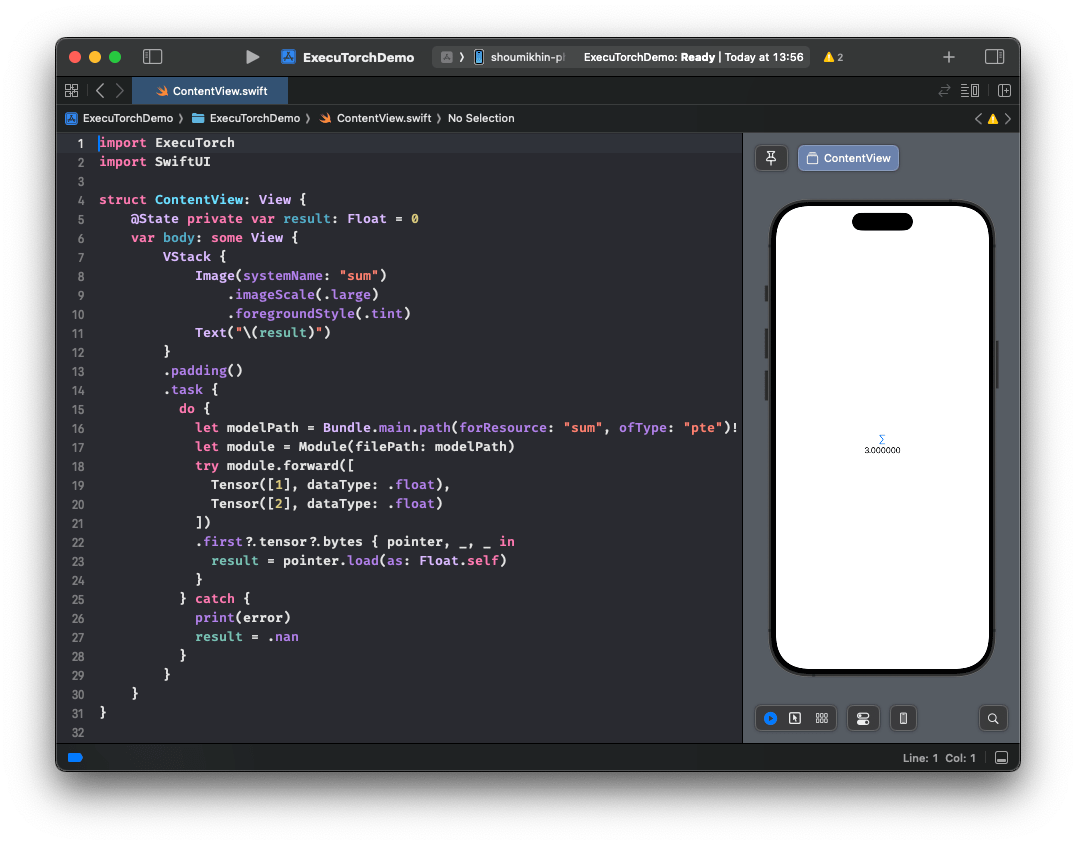
Avec la prise en charge de QAT par Unsloth et TorchAO, vous pouvez également affiner un modèle dans Unsloth et l'exporter de manière transparente vers [ExecuTorch](https://github.com/pytorch/executorch) (la solution de PyTorch pour l'inférence sur appareil) et le déployer directement sur mobile. Voir un exemple en action [ici](https://huggingface.co/metascroy/Qwen3-4B-int8-int4-unsloth) avec des workflows plus détaillés à venir !
**Annonce à venir bientôt !**
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
### :sunflower:Comment activer QAT
Mettez à jour Unsloth vers la dernière version, et installez aussi la dernière version de TorchAO !
Ensuite **essayez QAT avec notre gratuit** [**notebook Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)_Instruct-QAT.ipynb)
{% code overflow="wrap" %}
```bash
pip install --upgrade --no-cache-dir --force-reinstall unsloth unsloth_zoo
pip install torchao==0.14.0 fbgemm-gpu-genai==1.3.0
```
{% endcode %}
### :person\_tipping\_hand:Remerciements
Un immense merci à toute l'équipe PyTorch et TorchAO pour leur aide et leur collaboration ! Un merci tout particulier à Andrew Or, Jerry Zhang, Supriya Rao, Scott Roy et Mergen Nachin pour leur aide dans de nombreuses discussions sur QAT, ainsi que pour leur aide à l'intégrer dans Unsloth ! Merci également à l'équipe d'Executorch !
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/blog/quantization-aware-training-qat.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.