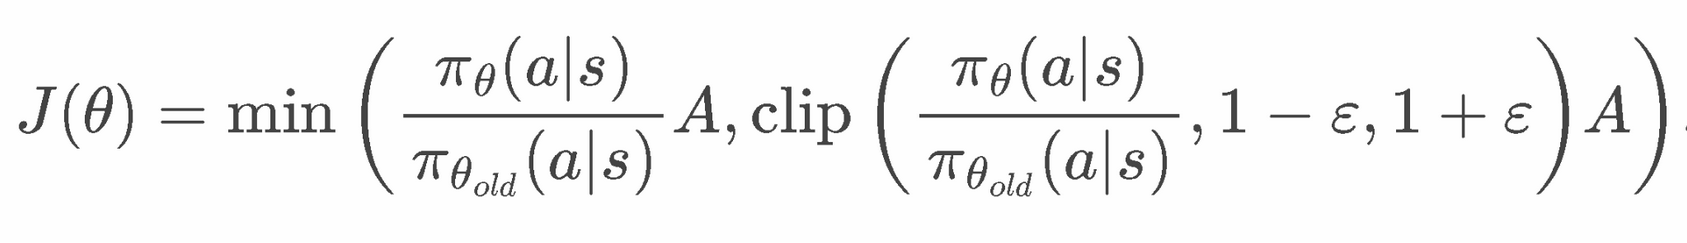> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide.md).
# Guide d'apprentissage par renforcement (RL)
Découvrez tout sur l'apprentissage par renforcement (RL) et comment entraîner votre propre modèle de raisonnement DeepSeek-R1 avec Unsloth en utilisant GRPO. Un guide complet du débutant à l'avancé.
L'apprentissage par renforcement est un domaine où un « agent » apprend à prendre des décisions en interagissant avec un environnement et en recevant **des retours** sous forme de **récompenses** ou **pénalités**.
* **Action :** Ce que le modèle génère (par ex. une phrase).
* **Récompense :** Un signal indiquant à quel point l'action du modèle était bonne ou mauvaise (par ex. la réponse a-t-elle suivi les instructions ? était-elle utile ?).
* **Environnement :** Le scénario ou la tâche sur laquelle le modèle travaille (par ex. répondre à la question d'un utilisateur).
### :sloth:Ce que vous allez apprendre
1. Qu'est-ce que le RL ? RLVR ? PPO ? GRPO ? RLHF ? RFT ? Est **« La chance est tout ce dont vous avez besoin ? »** pour le RL ?
2. Qu'est-ce qu'un environnement ? Un agent ? Une action ? Une fonction de récompense ? Des récompenses ?
Cet article couvre tout ce que vous devez savoir, du niveau débutant au niveau avancé, sur GRPO, l'apprentissage par renforcement (RL) et les fonctions de récompense, ainsi que des conseils et les bases de l'utilisation de GRPO avec [Unsloth](https://github.com/unslothai/unsloth). Si vous cherchez un tutoriel pas à pas pour utiliser GRPO, consultez notre guide [ici](/docs/fr/commencer/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
**Mise à jour du 15 janv. 2026 :** [Le RL à très long contexte](/docs/fr/commencer/reinforcement-learning-rl-guide/grpo-long-context.md) est là ! Entraînez gpt-oss avec une fenêtre de contexte de 380K.
**Mise à jour du 26 nov. 2025 :** Nous introduisons l'apprentissage par renforcement FP8 et GRPO dans Unsloth ! [Lire le blog](/docs/fr/commencer/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md)
{% endhint %}
## :question:Qu'est-ce que l'apprentissage par renforcement (RL) ?
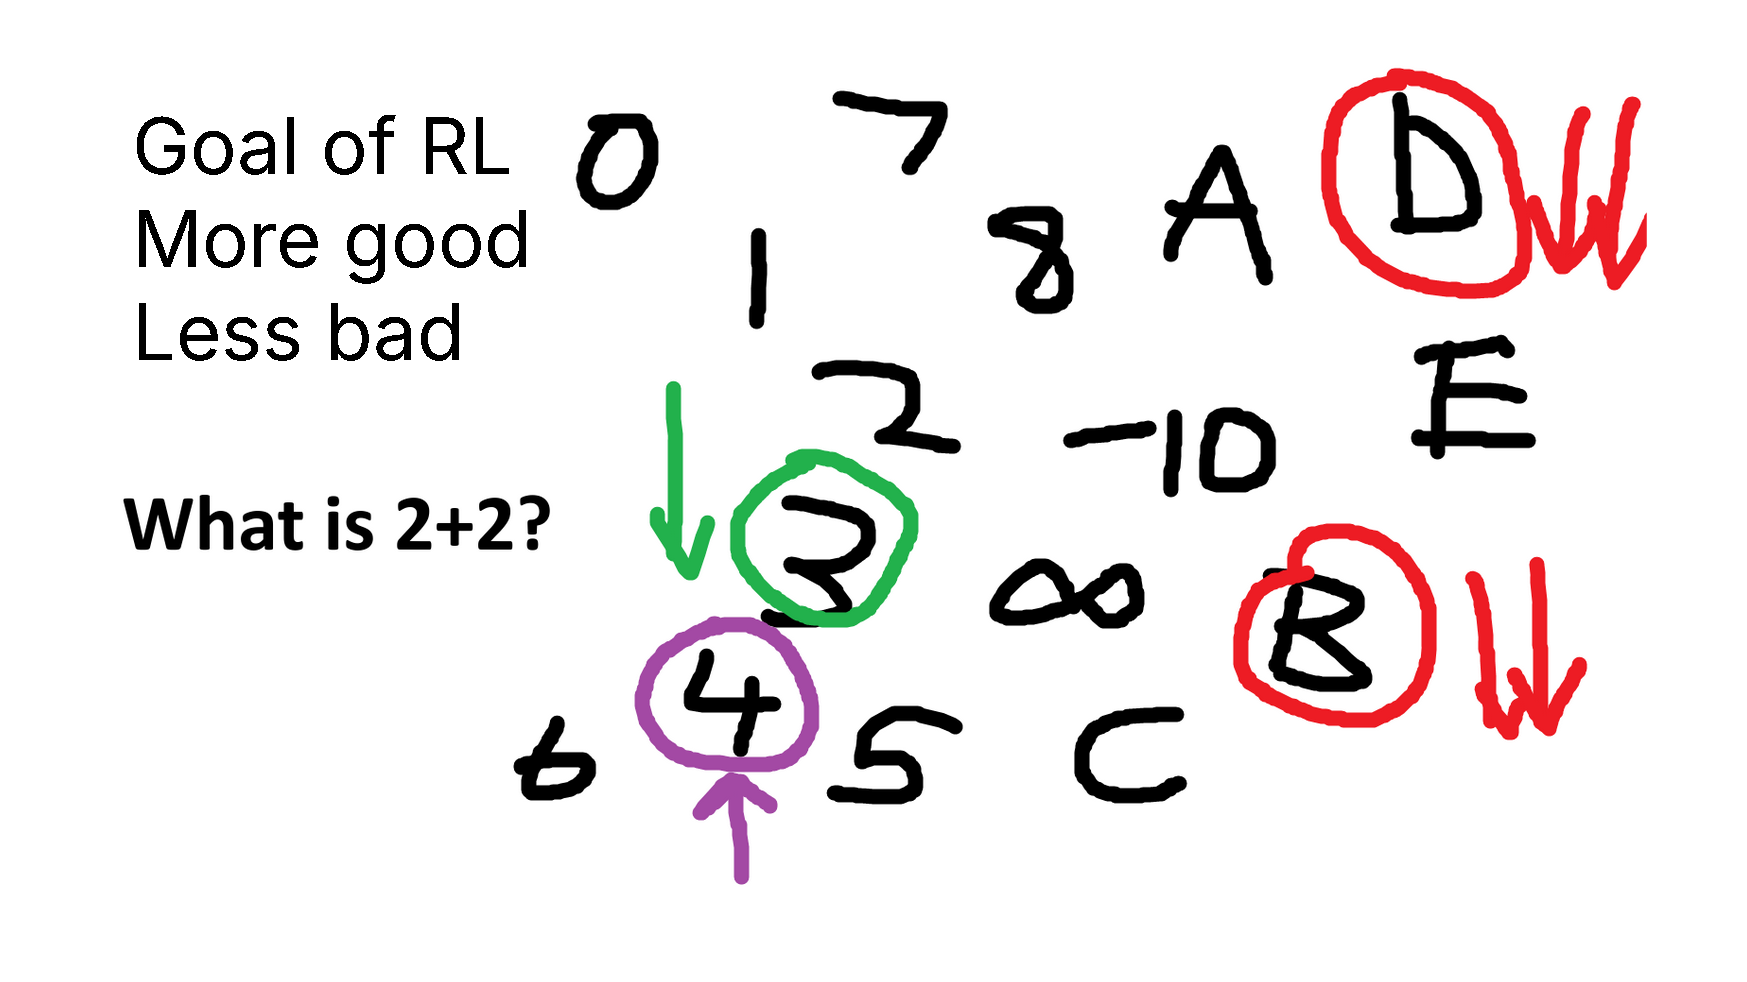
L'objectif du RL est de :
1. **Augmenter la probabilité d'observer ****des résultats « bons »**** .**
2. **Diminuer la probabilité d'observer ****des résultats « mauvais »**** .**
**. C'est tout !** Il existe des subtilités sur ce que signifient « bon » et « mauvais », ou sur la manière d'« augmenter » ou de « diminuer » cela, ou même sur ce que signifie « résultats ».
{% columns %}
{% column width="50%" %}
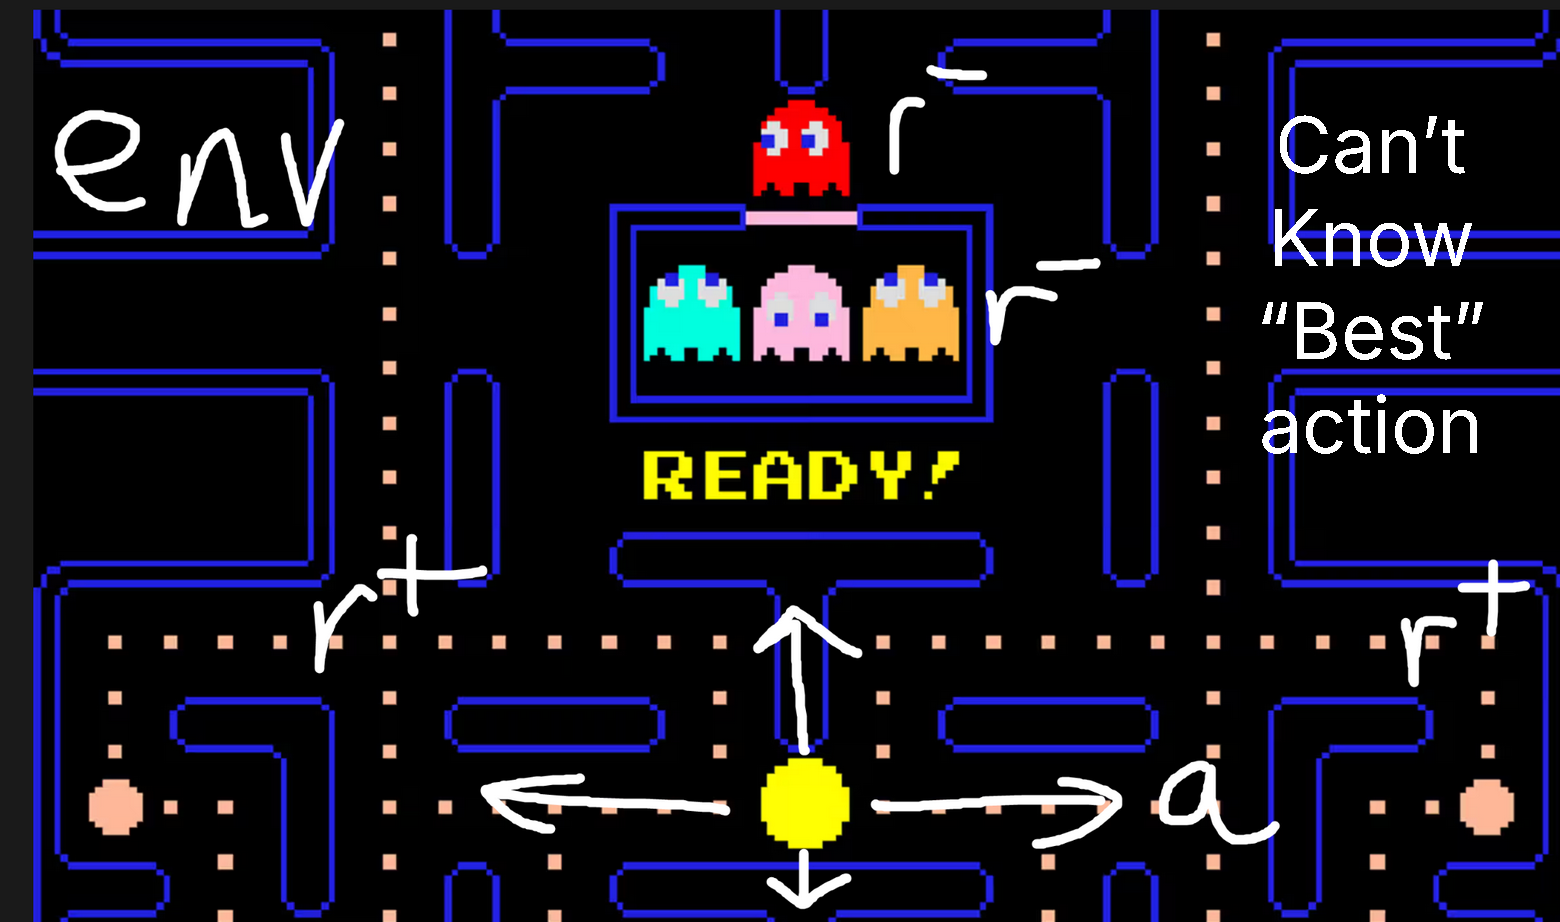
Par exemple, dans le **jeu Pacman**:
1. Le **l'environnement** est le monde du jeu.
2. Le **les actions** que vous pouvez effectuer sont HAUT, GAUCHE, DROITE et BAS.
3. Le **récompenses** sont bonnes si vous mangez un cookie, ou mauvaises si vous touchez l'un des ennemis ondulants.
4. En RL, vous ne pouvez pas connaître la « meilleure action » à effectuer, mais vous pouvez observer les étapes intermédiaires, ou l'état final du jeu (victoire ou défaite)
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column width="50%" %}
{% endcolumn %}
{% column %}
Un autre exemple est d'imaginer qu'on vous pose la question : **« Combien font 2 + 2 ? »** (4) Un modèle de langage non aligné crachera 3, 4, C, D, -10, littéralement n'importe quoi.
1. Les nombres sont mieux que C ou D, non ?
2. Obtenir 3 est mieux que, disons, 8, non ?
3. Obtenir 4 est clairement correct.
Nous venons de concevoir une **fonction de récompense**!
{% endcolumn %}
{% endcolumns %}
### :person\_running:De RLHF, PPO à GRPO et RLVR
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
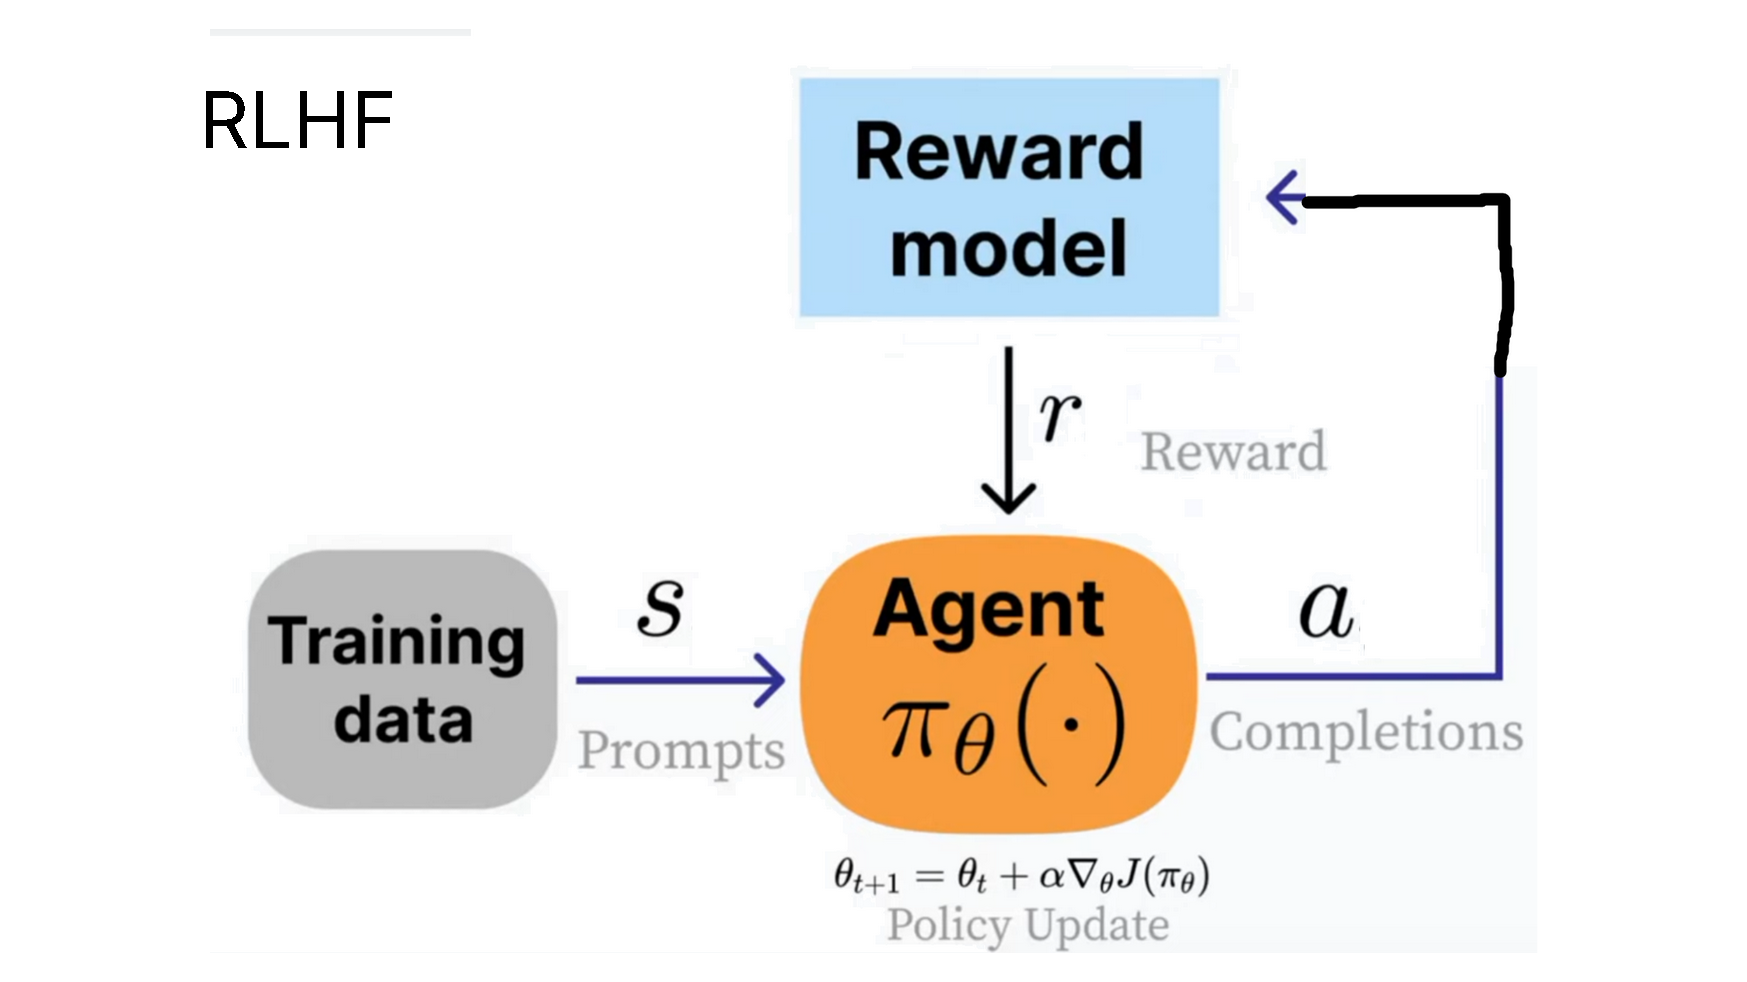
OpenAI a popularisé le concept de [RLHF](https://en.wikipedia.org/wiki/Reinforcement_learning_from_human_feedback) (l'apprentissage par renforcement à partir de retours humains), où nous entraînons un **« agent »** à produire des sorties pour une question (l' **état**) jugées plus utiles par les êtres humains.
Les pouces levés et baissés dans ChatGPT, par exemple, peuvent être utilisés dans le processus RLHF.
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
Formule du PPO
Le terme clip(..., 1-e, 1+e) est utilisé pour empêcher PPO d'effectuer des changements trop importants. Il y a aussi un terme KL avec beta fixé à > 0 pour empêcher le modèle de trop s'éloigner.
{% endcolumn %}
{% column %}
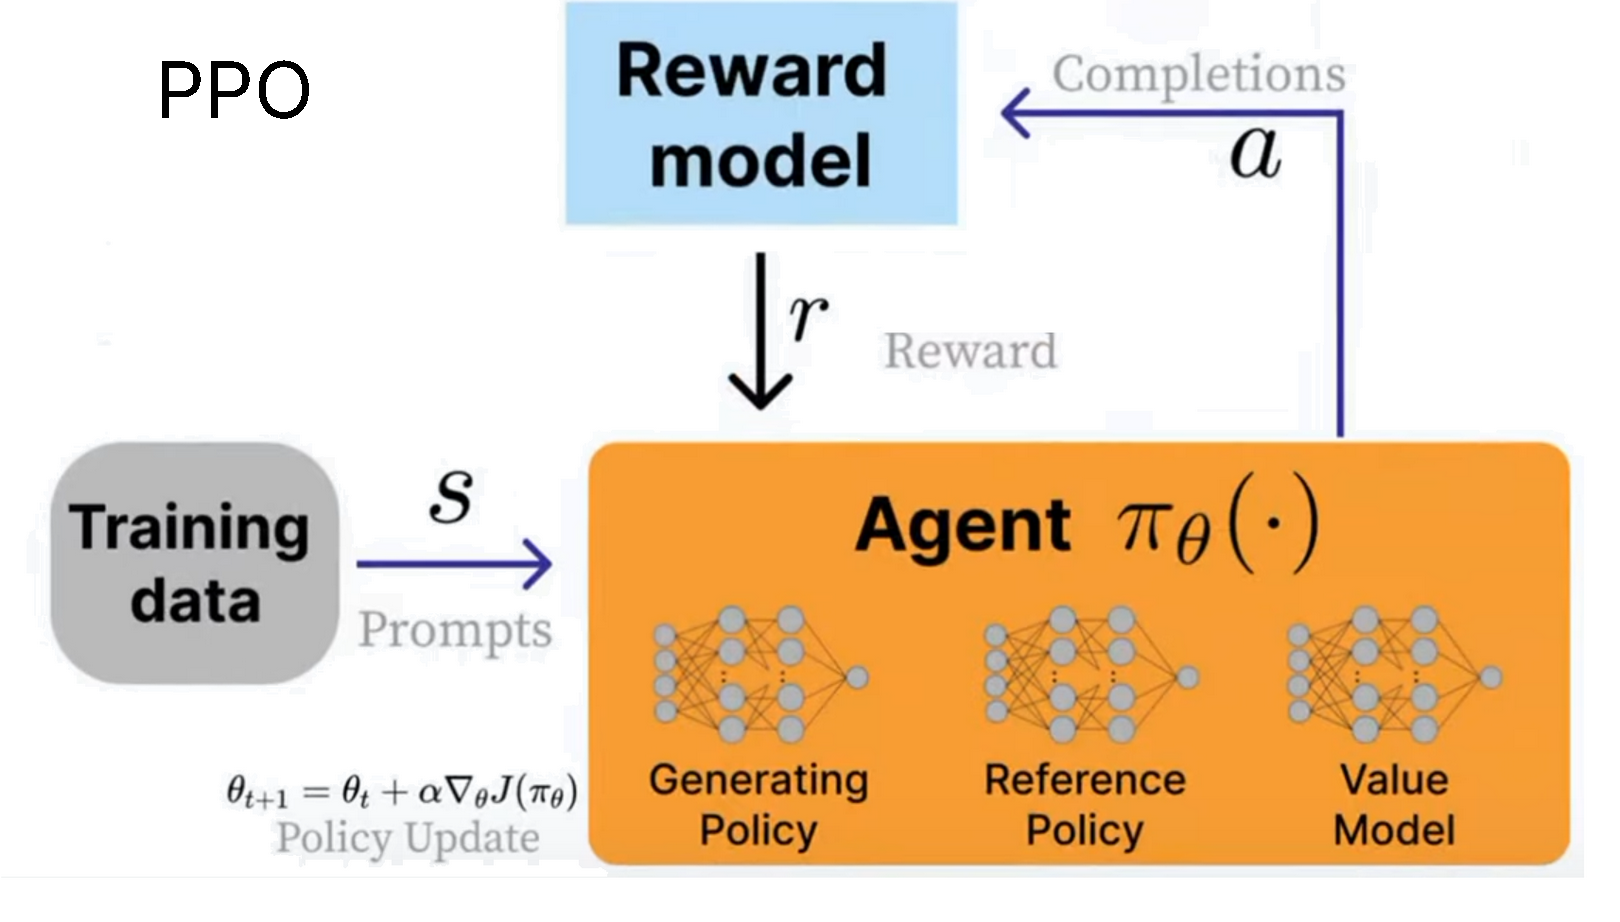
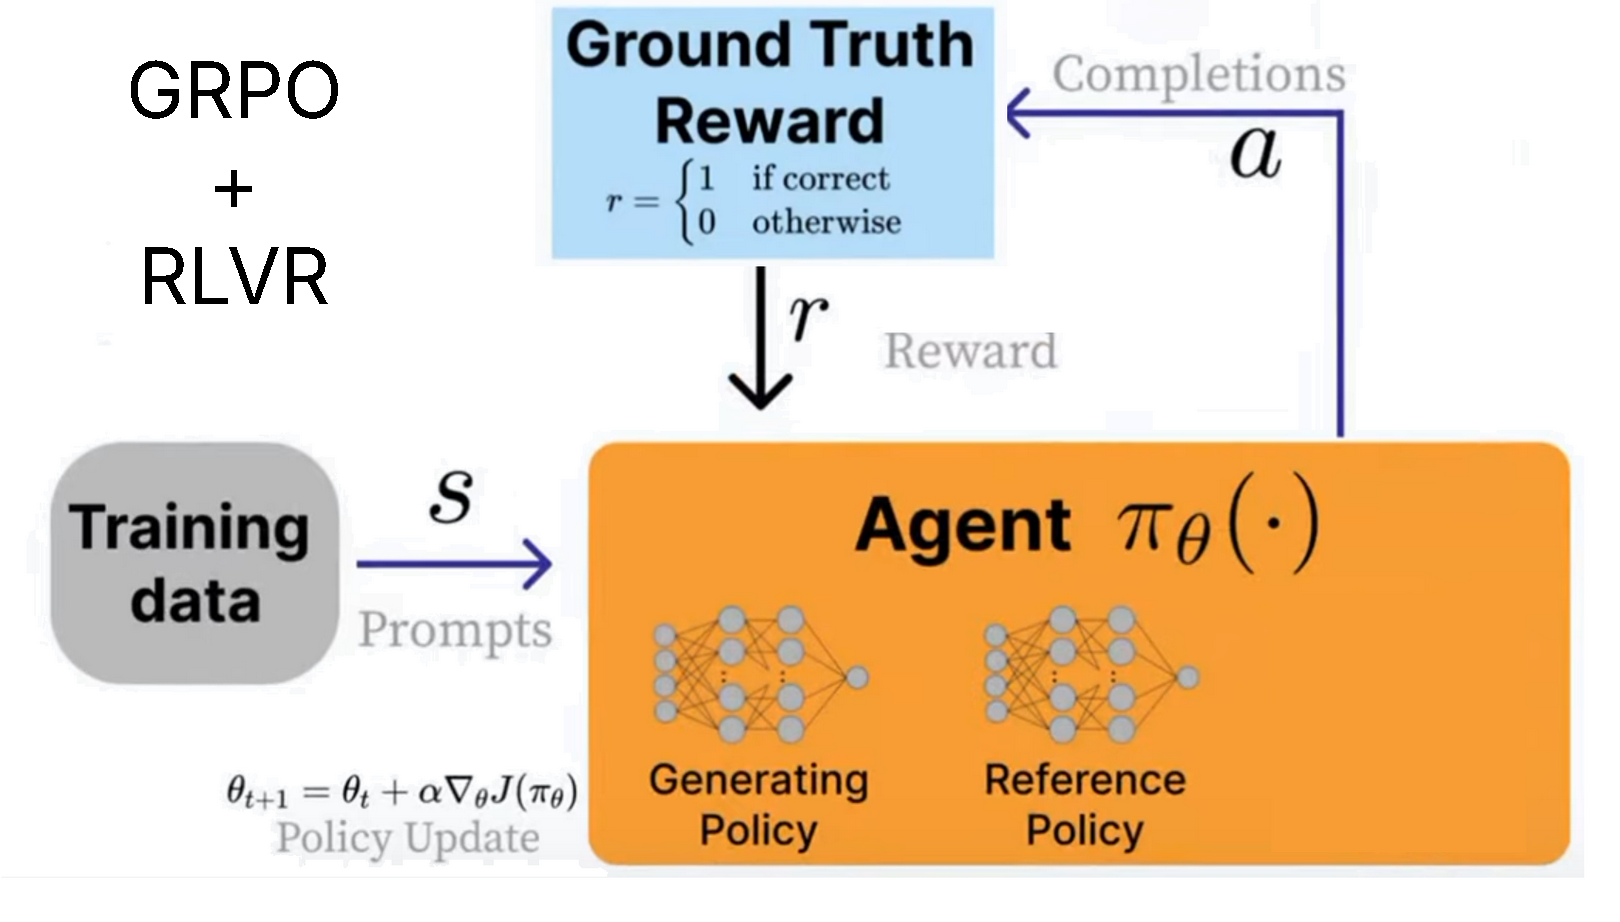
Afin de faire du RLHF, [**PPO**](https://en.wikipedia.org/wiki/Proximal_policy_optimization) (l'optimisation de politique proximale) a été développé. L' **agent** est le modèle de langage dans ce cas. En fait, il se compose de 3 systèmes :
1. Le **Politique génératrice (modèle actuellement entraîné)**
2. Le **Politique de référence (modèle original)**
3. Le **Modèle de valeur (estimateur de récompense moyenne)**
Nous utilisons le **Modèle de récompense** pour calculer la récompense pour l'environnement courant, et notre objectif est de **maximiser cela**!
La formule du PPO semble assez compliquée, car elle a été conçue pour être stable. Consultez notre [conférence AI Engineer](https://docs.unsloth.ai/ai-engineers-2025) que nous avons donnée en 2025 sur le RL pour des dérivations mathématiques plus approfondies du PPO.
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
DeepSeek a développé [**GRPO**](https://unsloth.ai/blog/grpo) (Optimisation de politique relative de groupe) pour entraîner leurs modèles de raisonnement R1. Les différences clés avec PPO sont :
1. Le **Le modèle de valeur est supprimé,** remplacé par des statistiques issues de l'appel au modèle de récompense plusieurs fois.
2. Le **Le modèle de récompense est supprimé** et remplacé simplement par une fonction de récompense personnalisée qui **RLVR** peut être utilisée.
{% endcolumn %}
{% endcolumns %}
Cela signifie que GRPO est extrêmement efficace. Auparavant, PPO nécessitait l'entraînement de plusieurs modèles - maintenant, avec la suppression du modèle de récompense et du modèle de valeur, nous pouvons économiser de la mémoire et accélérer tout le processus.
**RLVR (apprentissage par renforcement avec récompenses vérifiables)** nous permet de récompenser le modèle sur la base de tâches dont les solutions sont faciles à vérifier. Par exemple :
1. Les équations mathématiques peuvent être facilement vérifiées. Par ex. 2+2 = 4.
2. La sortie du code peut être vérifiée pour savoir si elle s'est exécutée correctement ou non.
3. Concevoir des fonctions de récompense vérifiables peut être difficile, donc la plupart des exemples concernent les maths ou le code.
4. Les cas d'utilisation de GRPO ne se limitent pas au code ou aux maths — son processus de raisonnement peut améliorer des tâches comme l'automatisation des e-mails, la recherche en base de données, le droit et la médecine, en améliorant considérablement la précision en fonction de votre ensemble de données et de votre fonction de récompense - l'astuce consiste à définir une **grille d'évaluation - c'est-à-dire une liste de récompenses vérifiables plus petites, et non une récompense finale unique et englobante.** OpenAI a popularisé cela dans son offre de [ajustement fin par apprentissage par renforcement (RFT)](https://platform.openai.com/docs/guides/reinforcement-fine-tuning) par exemple.
{% columns %}
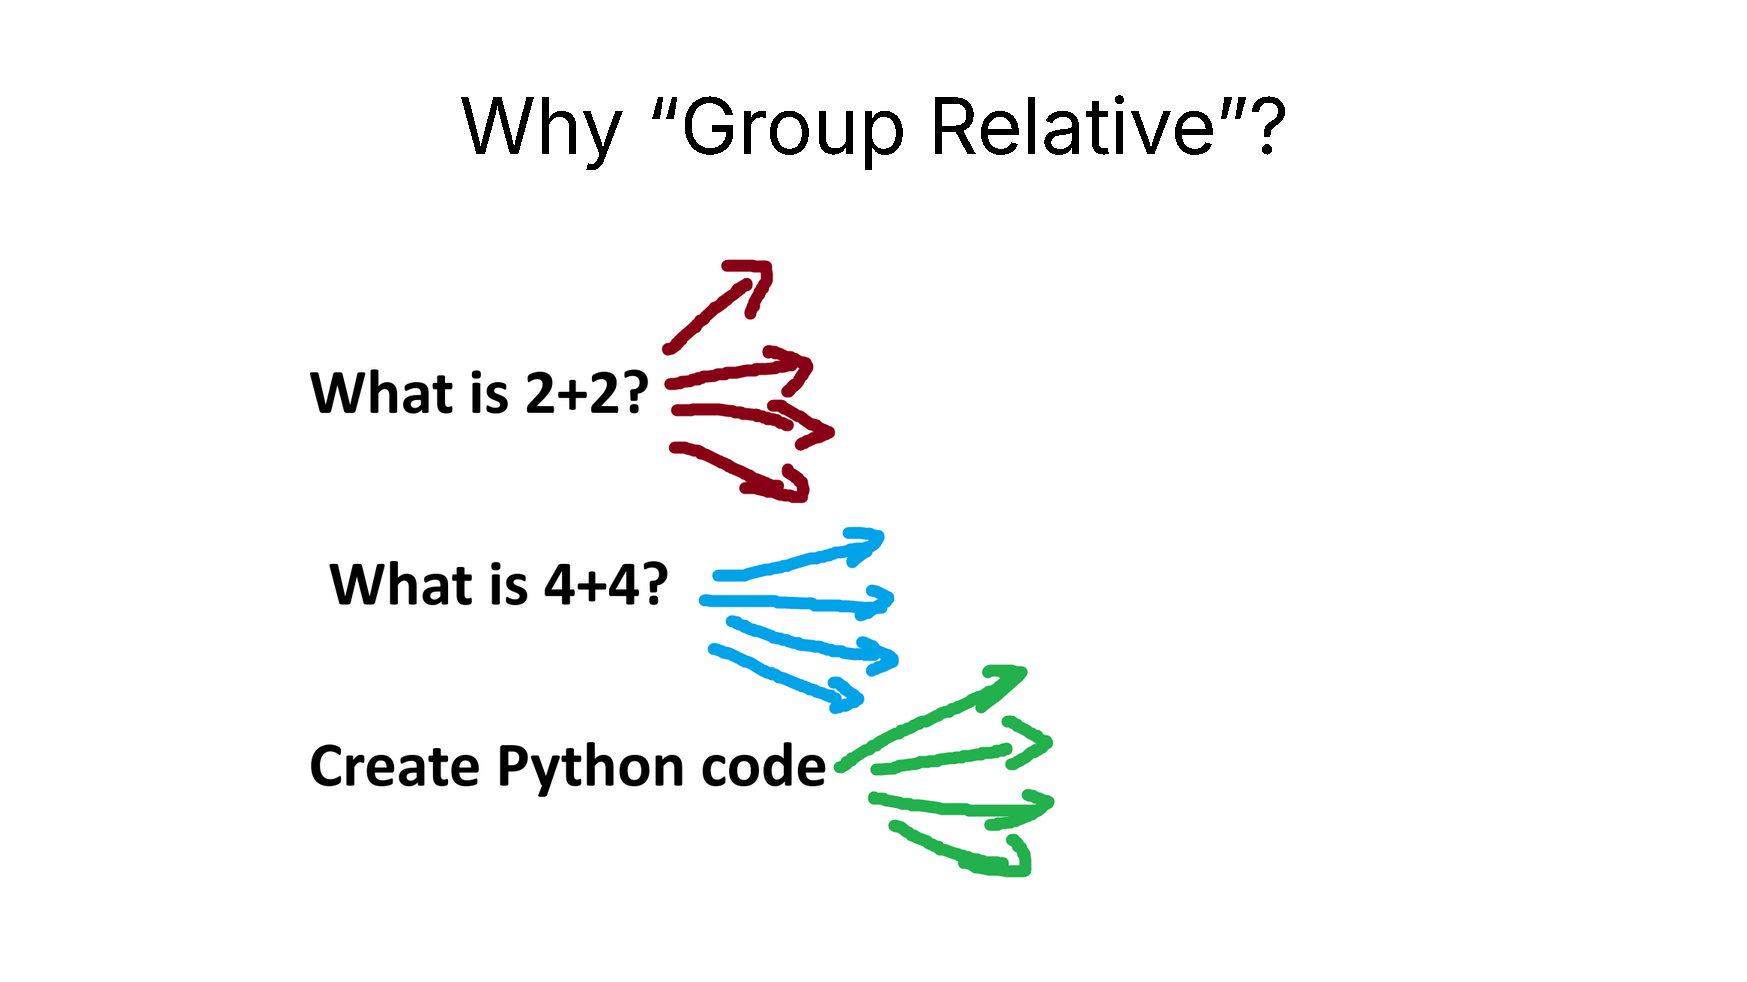
{% column %} **Pourquoi « Group Relative » ?**
GRPO supprime entièrement le modèle de valeur, mais nous devons toujours estimer la **« récompense moyenne »** donnée l'état courant.
Le **l'astuce consiste à échantillonner le LLM** ! Nous calculons ensuite la récompense moyenne grâce aux statistiques du processus d'échantillonnage sur plusieurs questions différentes.
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
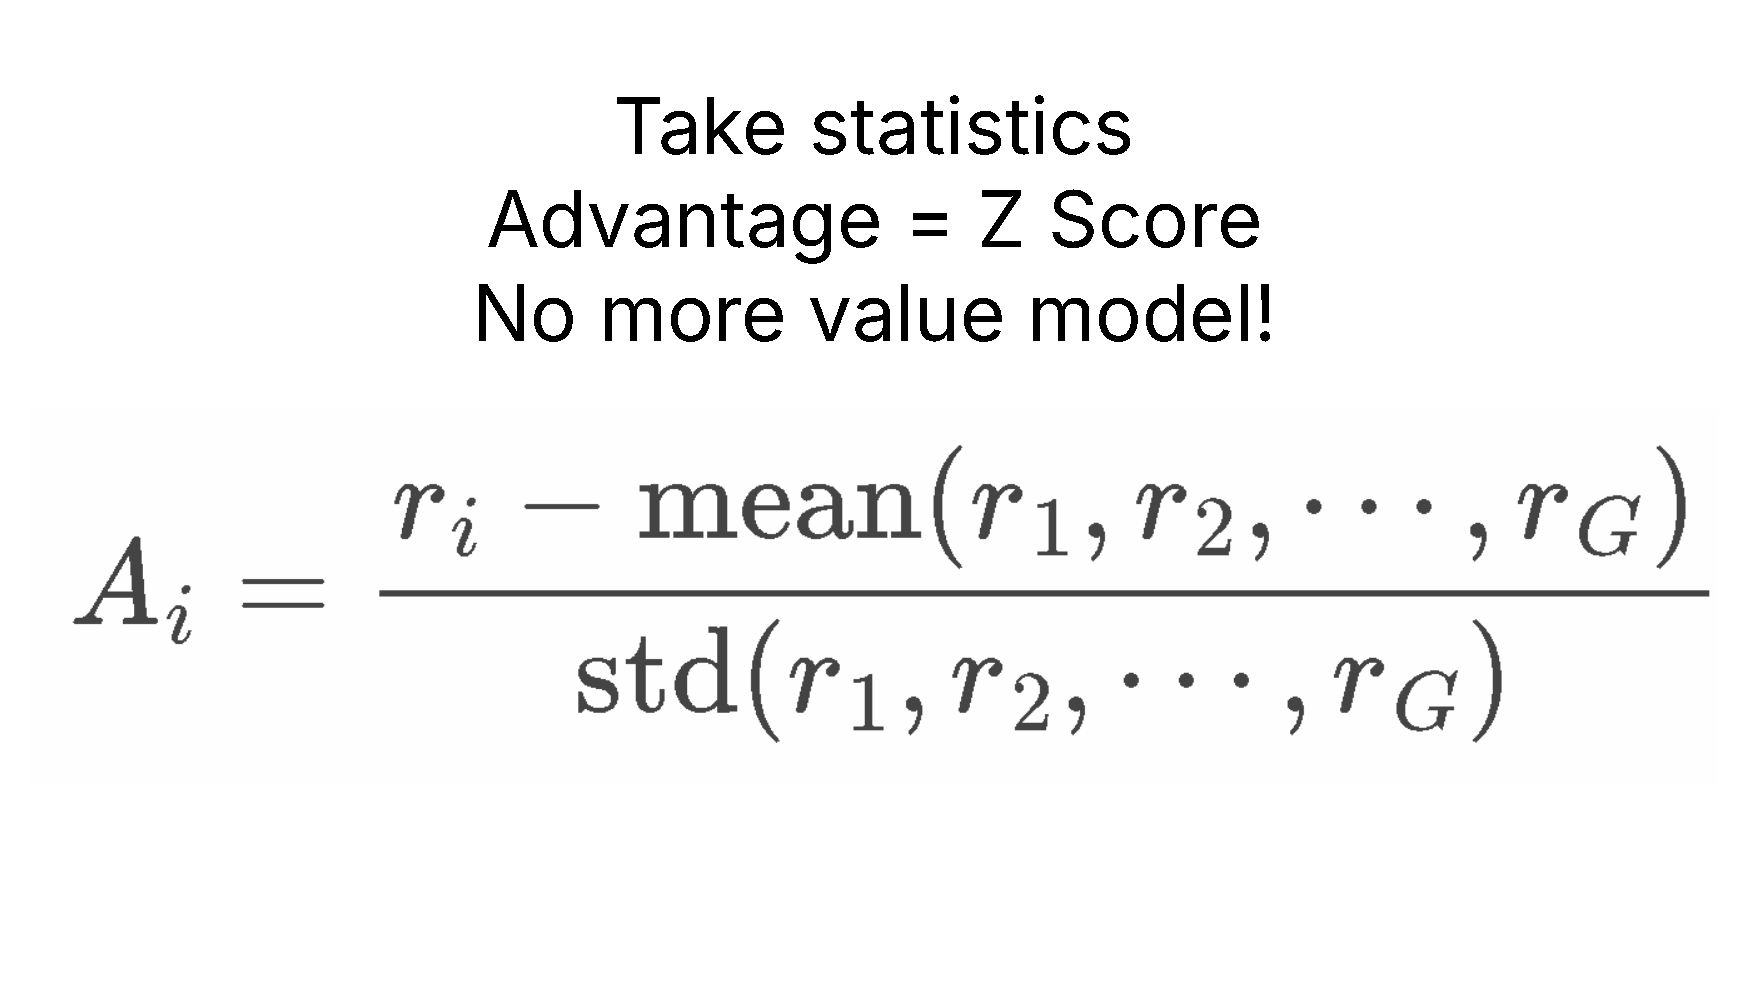
Par exemple, pour « Combien font 2+2 ? », nous échantillonnons 4 fois. Nous pourrions obtenir 4, 3, D, C. Nous calculons ensuite la récompense pour chacune de ces réponses, puis calculons la **récompense moyenne** et **écart-type**, puis **standardiser le score Z** ça !
Cela crée les **avantages A**, que nous utiliserons en remplacement du modèle de valeur. Cela permet d'économiser beaucoup de mémoire !
{% endcolumn %}
{% column %}
Calcul de l'avantage GRPO
{% endcolumn %}
{% endcolumns %}
### :fingers\_crossed:La chance (enfin, la patience) est tout ce dont vous avez besoin
L'astuce du RL est qu'il ne vous faut que 2 choses :
1. Une question ou une instruction, par ex. « Combien font 2+2 ? » « Créez un jeu Flappy Bird en Python »
2. Une fonction de récompense et un vérificateur pour vérifier si la sortie est bonne ou mauvaise.
Avec seulement ces 2 éléments, nous pouvons essentiellement **faire appel à un modèle de langage un nombre infini de fois** jusqu'à obtenir une bonne réponse. Par exemple pour « Combien font 2+2 ? », un mauvais modèle de langage non entraîné produira :
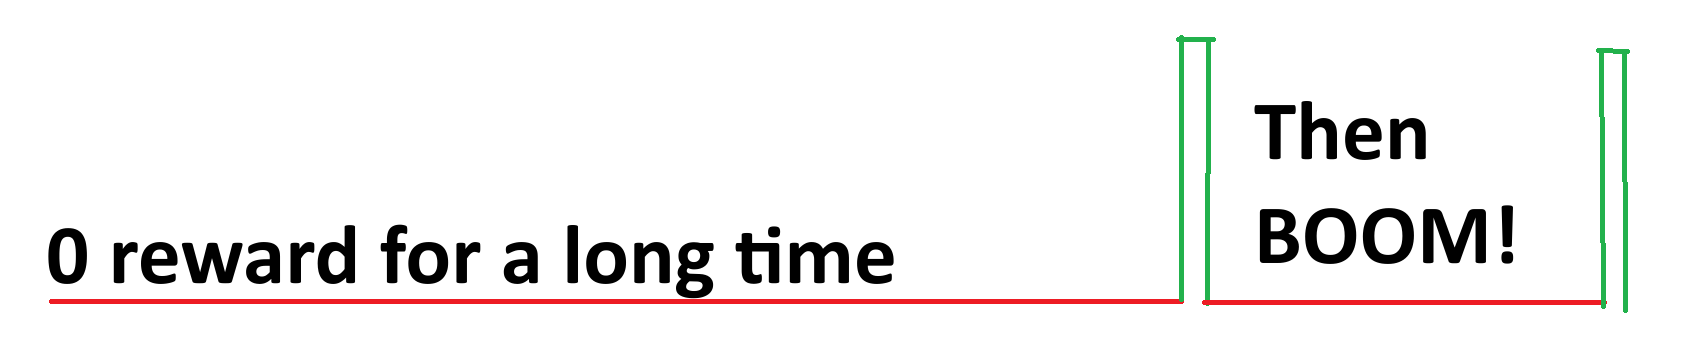
***0, chat, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****puis soudainement 4****.***
***Le signal de récompense était 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0\*\*\*\*\*\*\*\* ****puis soudainement 1.***
Ainsi, par chance et par hasard, le RL a réussi à trouver la bonne réponse à travers plusieurs **simulations**. Notre objectif est de voir la bonne réponse 4 plus souvent, et le reste (les mauvaises réponses) beaucoup moins.
**Ainsi, l'objectif du RL est d'être patient - à la limite, si la probabilité de la bonne réponse est au moins un petit nombre (non nul), ce n'est qu'une question d'attente - vous rencontrerez à 100 % la bonne réponse à la limite.**
**J'aime donc appeler cela « La chance est tout ce dont vous avez besoin » pour le RL.**
**Eh bien, une meilleure formule est « La patience est tout ce dont vous avez besoin » pour le RL.**
Le RL nous offre essentiellement une astuce - au lieu d'attendre simplement l'infini, nous obtenons bien des « signaux mauvais », c'est-à-dire de mauvaises réponses, et nous pouvons essentiellement « guider » le modèle pour qu'il essaie déjà de ne pas générer de mauvaises solutions. Cela signifie que même si vous avez attendu très longtemps qu'une « bonne » réponse apparaisse, le modèle a déjà été modifié pour essayer au mieux de ne pas produire de mauvaises réponses.
Dans l'exemple « Combien font 2+2 ? » - ***0, chat, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****puis soudainement 4****.***
Comme nous avons obtenu de mauvaises réponses, le RL influencera le modèle pour qu'il essaie de NE PAS produire de mauvaises réponses. Cela signifie qu'au fil du temps, nous « élaguons » soigneusement ou éloignons la distribution des sorties du modèle des mauvaises réponses. Cela signifie que le RL est **efficace**, puisque nous n'attendons PAS simplement l'infini, mais que nous essayons activement de « pousser » le modèle à aller autant que possible vers « l'espace des bonnes réponses ».
{% hint style="danger" %}
**Si la probabilité est toujours de 0, alors le RL ne fonctionnera jamais**. C'est aussi pourquoi les gens aiment faire du RL à partir d'un modèle déjà ajusté pour suivre des instructions, qui peut suivre les instructions de façon raisonnable - cela augmente probablement la probabilité au-dessus de 0.
{% endhint %}
## :sloth:Ce qu'Unsloth offre pour le RL
* Avec 15 Go de VRAM, Unsloth vous permet de transformer n'importe quel modèle jusqu'à 17 milliards de paramètres, comme Llama 3.1 (8B), Phi-4 (14B), Mistral (7B) ou Qwen2.5 (7B), en un modèle de raisonnement
* **Unsloth prend désormais en charge** [**le RL pour la vision / multimodal**](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) **!**
* **Exigence minimale :** Seulement 5 Go de VRAM suffisent pour entraîner localement votre propre modèle de raisonnement (pour tout modèle de 1,5 milliard de paramètres ou moins)
{% columns %}
{% column %}
{% content-ref url="/pages/3b308de419b284a6a192a8a4ada6d06eeb57ae12" %}
[Tutorial: GRPO Training](/docs/fr/commencer/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
{% content-ref url="/pages/828a94c1637e052b62bda4ce216caa066667b218" %}
[Vision RL](/docs/fr/commencer/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
{% hint style="info" %}
Pour **GRPO avancé** documentation sur les paramètres de batching, de génération et d’entraînement, [lisez notre guide !](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### Cahiers GRPO :
| [**Gemma 4 E2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma4_\(E2B\)_Reinforcement_Learning_Sudoku_Game.ipynb) - **nouvelle** | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - GRPO Vision | [Gemma 3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - GRPO Vision |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- |
| [**Qwen3.5 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - *****nouvelle*** | [gpt-oss-20b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) GSPO | [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Avancé |
| [Qwen3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Avancé | [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb) | [DeepSeek-R1-0528-Qwen3-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) |
| [Mistral v0.3 (7B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb) | [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb) | [Qwen3-8B - **FP8**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_8B_FP8_GRPO.ipynb) (L4) |
{% hint style="success" %}
Nous prenons en charge [**GSPO**](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation/gspo-reinforcement-learning.md) et la plupart des autres nouvelles techniques GRPO. Vous pouvez jouer avec les arguments suivants dans GRPOConfig pour activer :
```python
epsilon=0.2,
epsilon_high=0.28, # un seul côté
delta=1.5 # deux côtés
loss_type='gspo',
# ou :
loss_type='grpo',
# ou :
loss_type='dr_grpo',
mask_truncated_completions=True,
```
{% endhint %}
* Si vous n'obtenez aucun raisonnement, assurez-vous d'avoir suffisamment d'étapes d'entraînement et vérifiez que votre [fonction de récompense/vérificateur](#reward-functions-verifier) fonctionne. Nous fournissons des exemples de fonctions de récompense [ici](#reward-function-examples).
* Des démonstrations précédentes montrent que vous pouviez atteindre votre propre moment « aha » avec Qwen2.5 (3B) - mais cela nécessitait 2 GPU A100 (160 Go de VRAM). Maintenant, avec Unsloth, vous pouvez obtenir le même moment « aha » en utilisant seulement un seul GPU de 5 Go de VRAM.
* Auparavant, GRPO n'était pris en charge que pour le fine-tuning complet, mais nous l'avons fait fonctionner avec QLoRA et LoRA
* Sur [**des longueurs de contexte de 20K**](#grpo-requirement-guidelines) par exemple avec 8 générations par invite, Unsloth n'utilise que 54,3 Go de VRAM pour Llama 3.1 (8B), tandis que les implémentations standard (+ Flash Attention 2) prennent **510,8 Go (90 % de moins pour Unsloth)**.
* Veuillez noter qu'il ne s'agit pas de fine-tuner les modèles distillés R1 de DeepSeek ni d'utiliser des données distillées de R1 pour l'ajustement, ce qu'Unsloth prenait déjà en charge. Il s'agit de transformer un modèle standard en un véritable modèle de raisonnement à l'aide de GRPO.
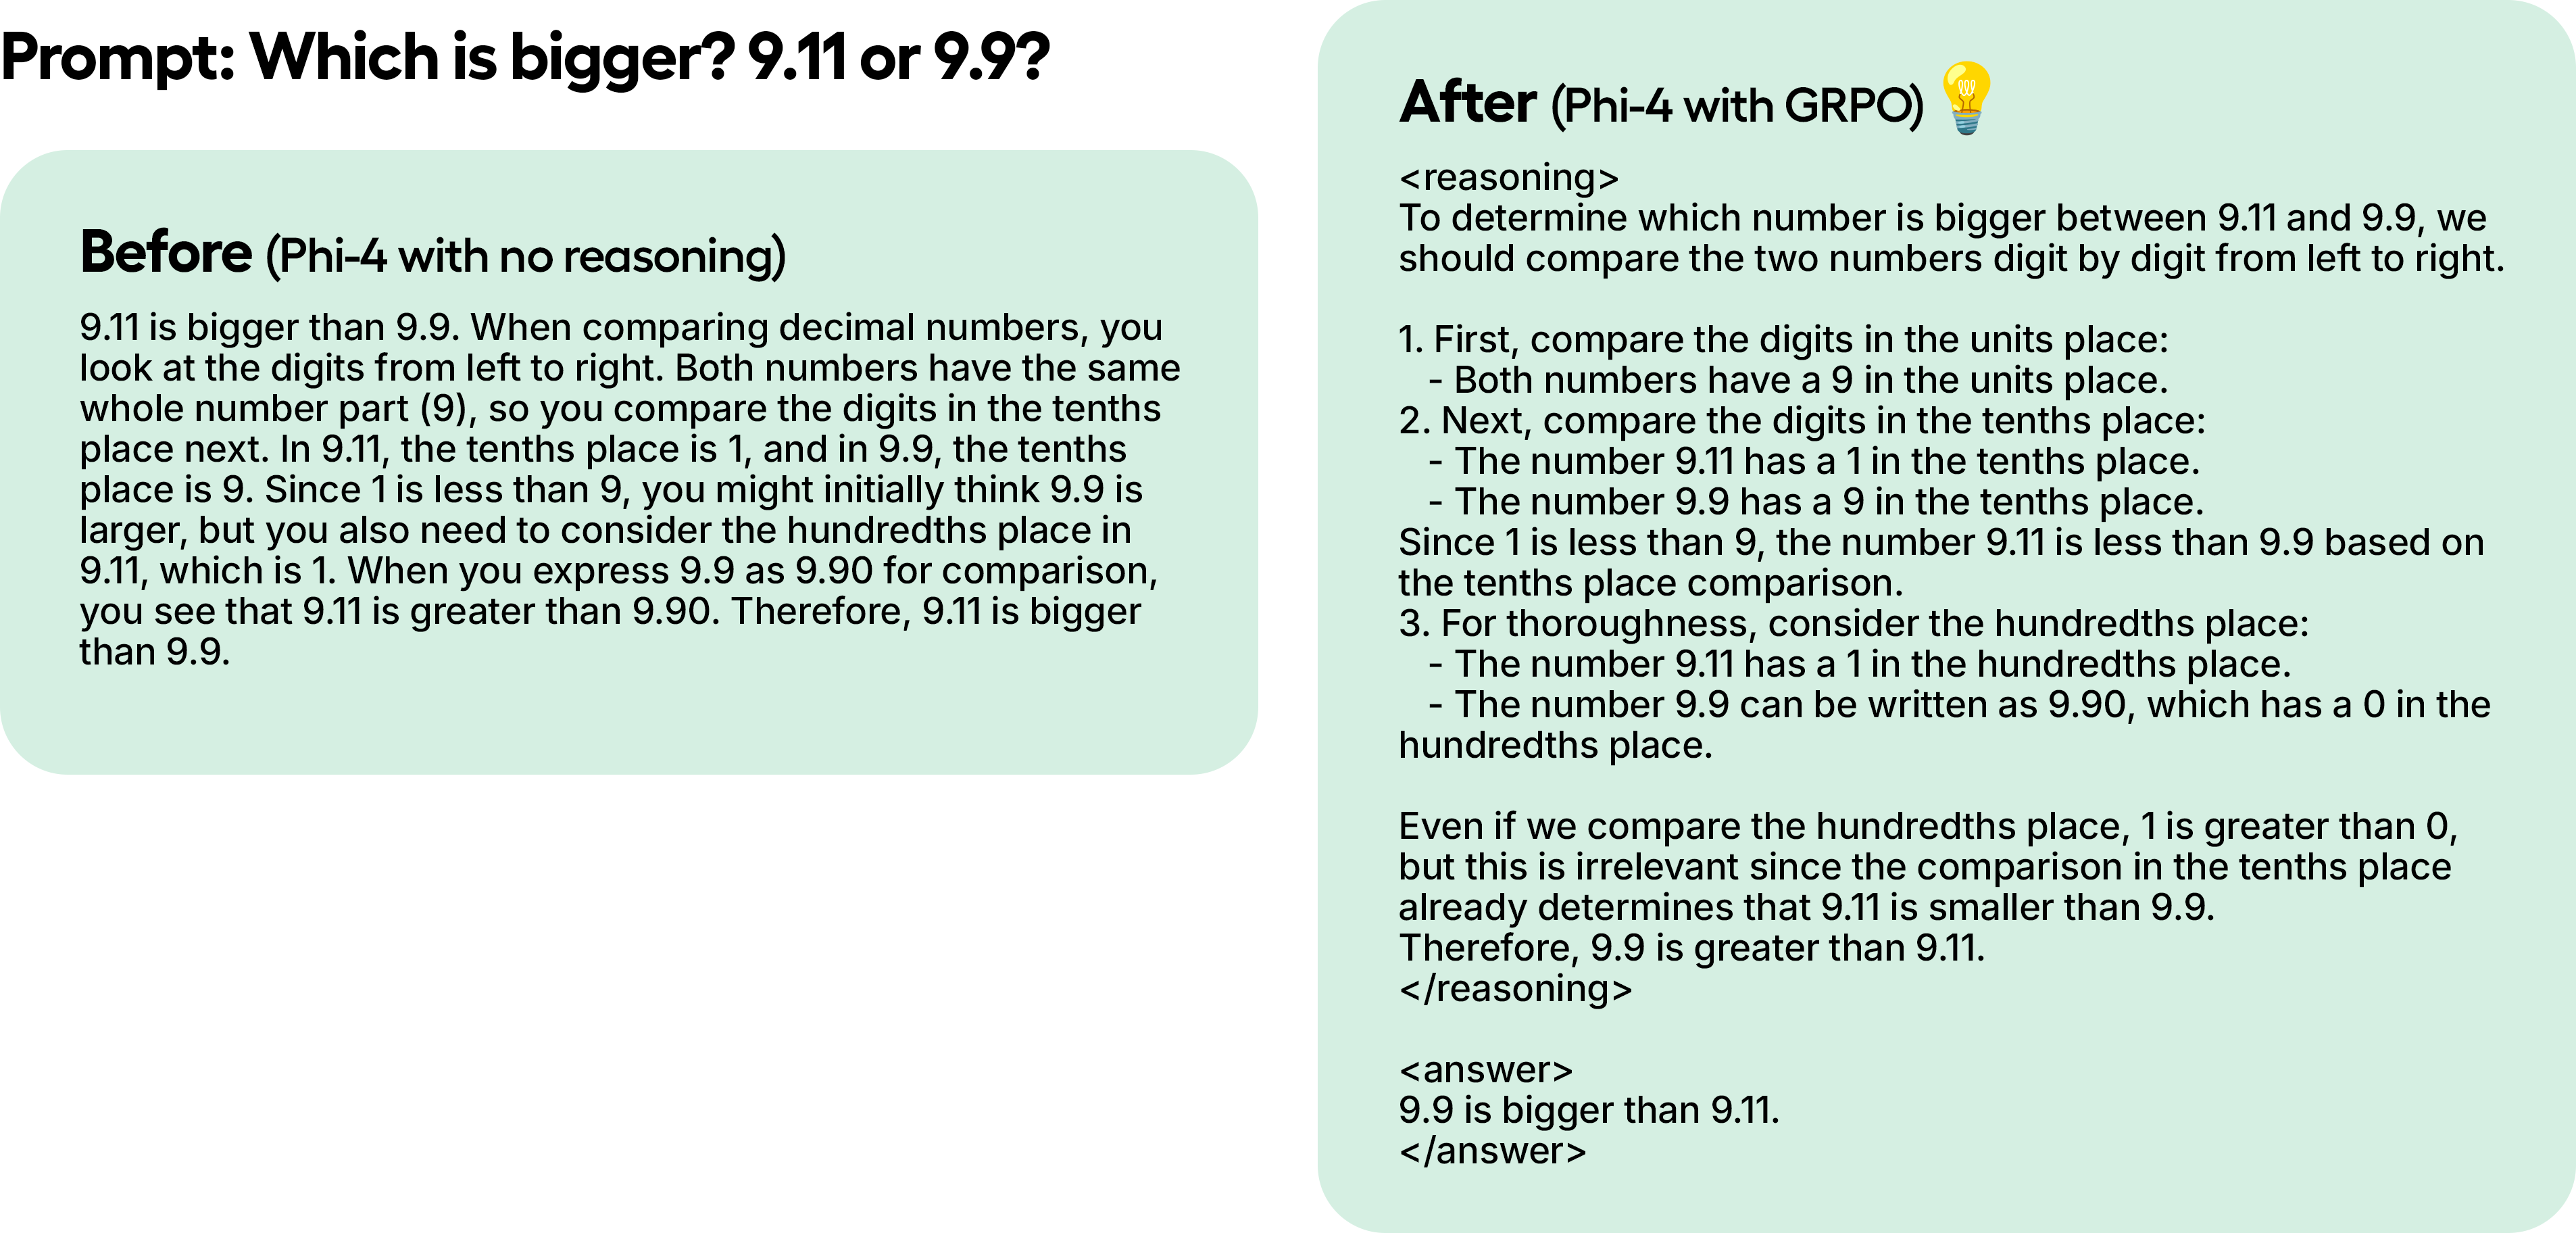
Dans un exemple de test, même si nous n'avons entraîné Phi-4 que pendant 100 étapes avec GRPO, les résultats sont déjà clairs. Le modèle sans GRPO n'a pas le jeton de réflexion, tandis que celui entraîné avec GRPO l'a et donne aussi la bonne réponse.
## :computer:Entraînement avec GRPO
Pour un tutoriel sur la manière de transformer n'importe quel LLM ouvert en modèle de raisonnement à l'aide d'Unsloth et de GRPO, [voir ici](/docs/fr/commencer/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
Pour **GRPO avancé** documentation sur les paramètres de batching, de génération et d’entraînement, [lisez notre guide !](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### **Comment GRPO entraîne un modèle**
1. Pour chaque paire question-réponse, le modèle génère plusieurs réponses possibles (par ex. 8 variantes).
2. Chaque réponse est évaluée à l'aide de fonctions de récompense.
3. Étapes d'entraînement :
* Si vous avez 300 lignes de données, cela fait 300 étapes d'entraînement (ou 900 étapes si l'entraînement dure 3 époques).
* Vous pouvez augmenter le nombre de réponses générées par question (par ex. de 8 à 16).
4. Le modèle apprend en mettant à jour ses poids à chaque étape.
{% hint style="warning" %}
Si vous avez des problèmes parce que votre modèle GRPO n’apprend pas, nous vous recommandons vivement d’utiliser nos [notebooks GRPO avancés](/docs/fr/commencer/unsloth-notebooks.md#grpo-reasoning-notebooks) car ils ont une fonction de récompense bien meilleure et vous devriez voir des résultats beaucoup plus rapidement et plus fréquemment.
{% endhint %}
### Bases / conseils
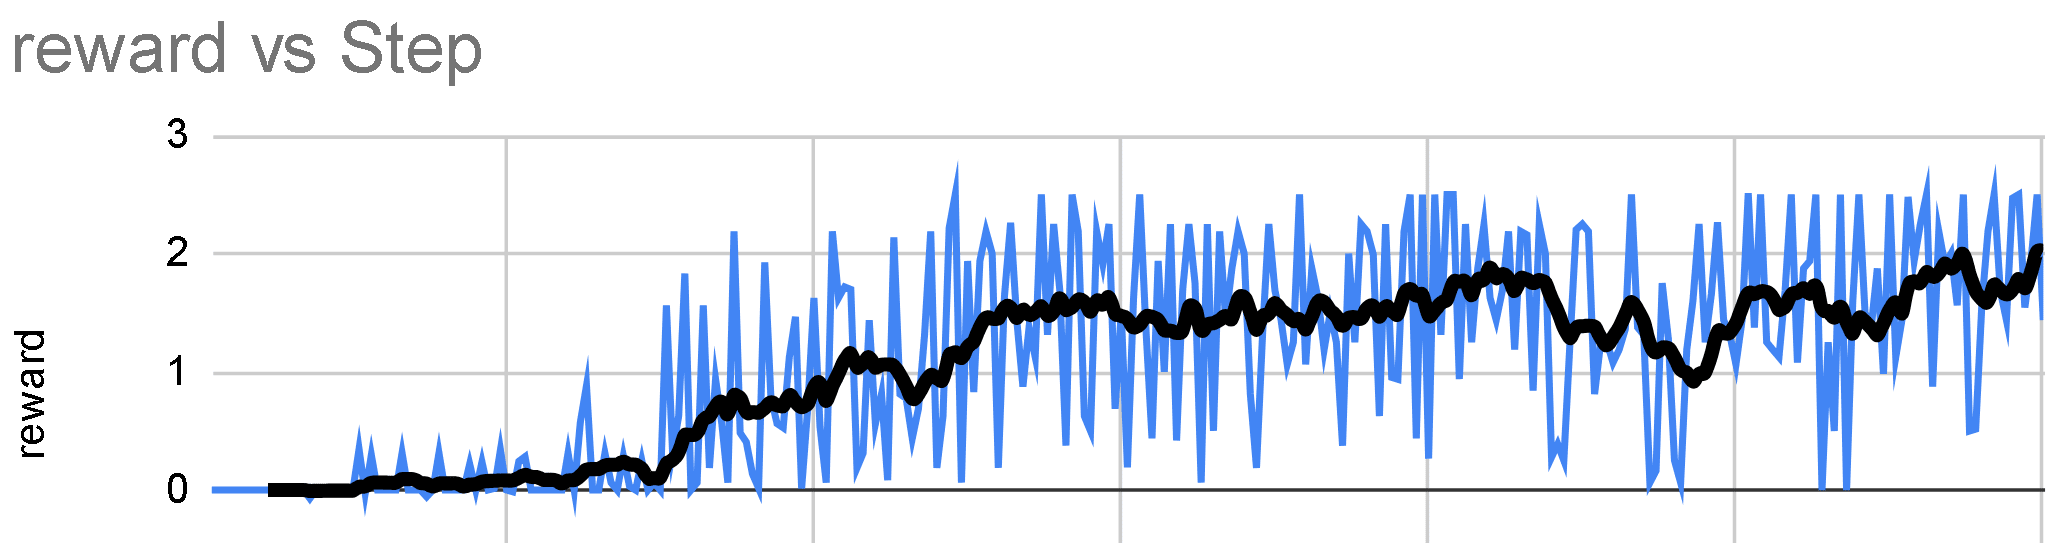
* Attendez au moins **300 étapes** pour que la récompense augmente réellement. Pour obtenir des résultats décents, vous devrez peut-être consacrer au minimum 12 heures (c'est ainsi que fonctionne GRPO), mais gardez à l'esprit que ce n'est pas obligatoire, car vous pouvez vous arrêter à tout moment.
* Pour des résultats optimaux, ayez au moins **500 lignes de données**. Vous pouvez essayer avec seulement 10 lignes de données, mais il vaut mieux en avoir davantage.
* Chaque exécution d'entraînement sera toujours différente selon votre modèle, vos données, votre fonction de récompense/vérificateur, etc. Donc, bien que 300 étapes soit ce que nous avons indiqué comme minimum, il peut parfois en falloir 1000 ou plus. Cela dépend donc de divers facteurs.
* Si vous utilisez GRPO avec Unsloth en local, veuillez aussi exécuter « pip install diffusers » si vous obtenez une erreur. Veuillez également utiliser la dernière version de vLLM.
* Il est conseillé d'appliquer GRPO à un modèle d'au moins **1,5 milliard de paramètres** pour générer correctement des jetons de réflexion, car les modèles plus petits ne le peuvent pas forcément.
* Pour les [**exigences en VRAM GPU**](#grpo-requirement-guidelines) **pour QLoRA 4 bits**, la règle générale est que les paramètres du modèle = la quantité de VRAM dont vous aurez besoin (vous pouvez utiliser moins de VRAM, mais c'est juste par prudence). Plus la longueur de contexte est grande, plus la VRAM nécessaire est élevée. LoRA 16 bits utilisera au minimum 4 fois plus de VRAM.
* **Le fine-tuning continu est** possible, et vous pouvez simplement laisser GRPO fonctionner en arrière-plan.
* Dans les cahiers d'exemples, nous utilisons le [**jeu de données GSM8K**](#gsm8k-reward-functions), le choix actuellement le plus populaire pour l'entraînement de type R1.
* Si vous utilisez un modèle de base, assurez-vous d'avoir un modèle de chat.
* Plus vous entraînez avec GRPO, mieux c'est. Le meilleur avec GRPO est que vous n'avez même pas besoin de tant de données. Tout ce qu'il vous faut, c'est une excellente fonction de récompense/vérificateur, et plus vous passez de temps à entraîner, plus votre modèle s'améliorera. Attendez-vous à ce que la récompense par étape augmente au fil du temps comme ceci :
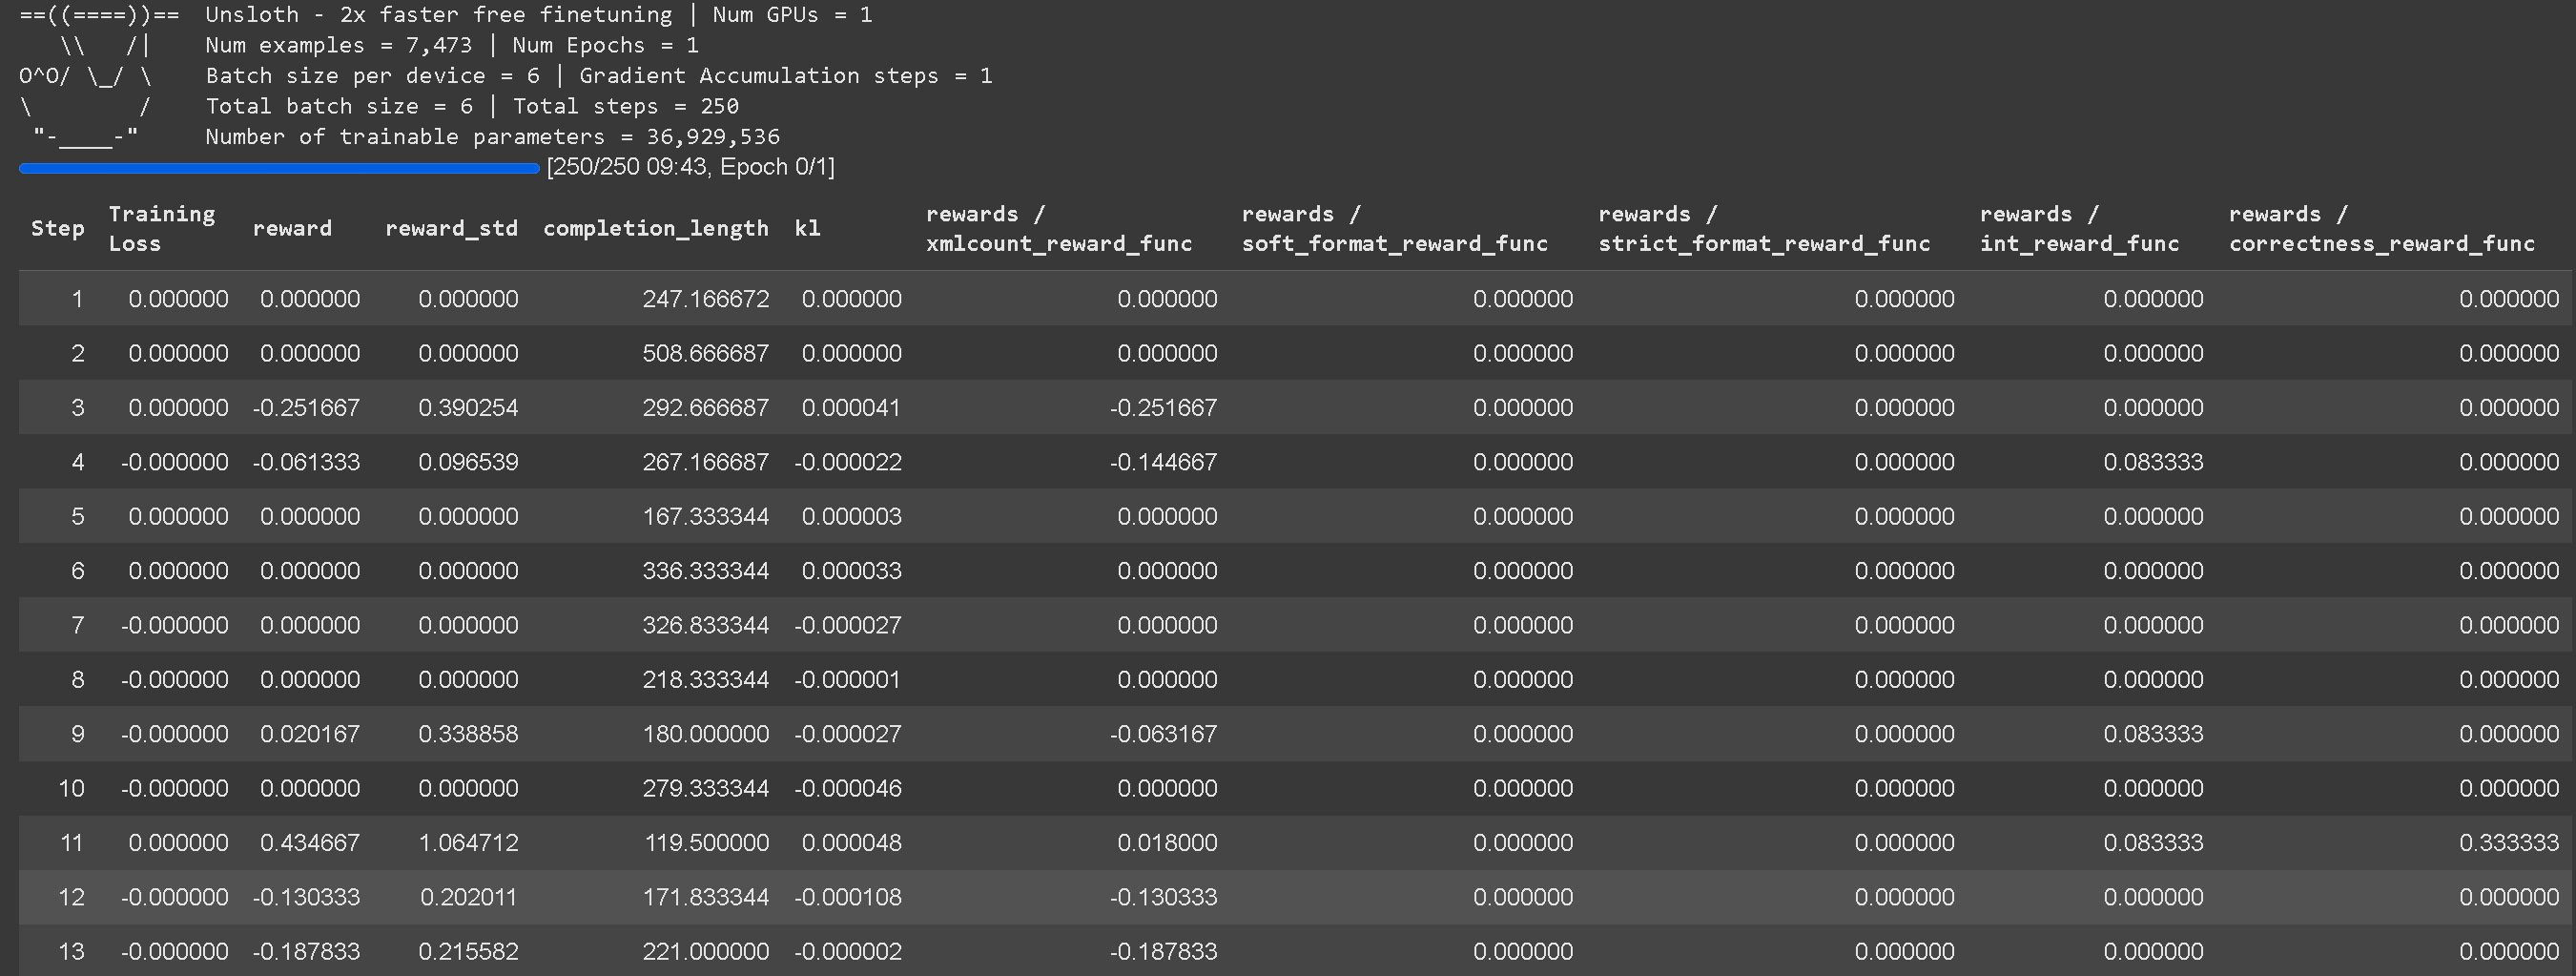
* Le suivi de la perte d'entraînement pour GRPO est désormais intégré directement à Unsloth, éliminant le besoin d'outils externes comme wandb, etc. Il contient désormais tous les détails de journalisation pour toutes les fonctions de récompense, y compris la fonction de récompense agrégée totale elle-même.
### RL sur des modèles non pris en charge :
Vous pouvez également exécuter du RL avec Unsloth sur des modèles qui ne sont pas pris en charge par vLLM, tels que [Qwen3.5](/docs/fr/modeles/qwen3.5/fine-tune.md). Définissez simplement `fast_inference=False` lors du chargement du modèle.
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Qwen3.5-4B",
fast_inference=False,
)
```
## :clipboard:Fonctions de récompense / Vérificateurs
En apprentissage par renforcement, une **fonction de récompense** et un **vérificateur** remplissent des rôles distincts dans l'évaluation de la sortie d'un modèle. En général, on peut les interpréter comme la même chose ; cependant, techniquement, ce n'est pas le cas, mais cela importe moins car ils sont généralement utilisés conjointement.
**vérificateur**:
* Détermine si la réponse générée est correcte ou incorrecte.
* Elle n'attribue pas de score numérique — elle vérifie simplement la correction.
* Exemple : si un modèle génère « 5 » pour « 2+2 », le vérificateur contrôle et le classe comme « faux » (puisque la bonne réponse est 4).
* Les vérificateurs peuvent aussi exécuter du code (par ex. en Python) pour valider la logique, la syntaxe et la correction sans évaluation manuelle.
**fonction de récompense**:
* Convertit les résultats de vérification (ou d'autres critères) en un score numérique.
* Exemple : si une réponse est fausse, elle peut attribuer une pénalité (-1, -2, etc.), tandis qu'une réponse correcte peut obtenir un score positif (+1, +2).
* Elle peut aussi pénaliser selon des critères au-delà de la correction, comme une longueur excessive ou une lisibilité médiocre.
**Différences clés**:
* Un **vérificateur** vérifie la correction mais ne note pas.
* Un **fonction de récompense** attribue un score mais ne vérifie pas nécessairement elle-même la correction.
* Une fonction de récompense *pouvez* utilise un vérificateur, mais ce n'est techniquement pas la même chose.
### **Comprendre les fonctions de récompense**
L'objectif principal de GRPO est de maximiser la récompense et d'apprendre comment une réponse a été obtenue, plutôt que de simplement mémoriser et reproduire les réponses de ses données d'entraînement.
* À chaque étape d'entraînement, GRPO **ajuste les poids du modèle** pour maximiser la récompense. Ce processus ajuste progressivement le modèle.
* **Le fine-tuning classique** (sans GRPO) ne fait que **maximiser la probabilité de prédiction du mot suivant** mais n'optimise pas une récompense. GRPO **optimise une fonction de récompense** plutôt que de simplement prédire le mot suivant.
* Vous pouvez **réutiliser les données** sur plusieurs époques.
* **Les fonctions de récompense par défaut** peuvent être prédéfinies pour être utilisées dans un large éventail de cas d'utilisation, ou vous pouvez demander à ChatGPT / à un modèle local de les générer pour vous.
* Il n'existe pas une seule manière correcte de concevoir des fonctions de récompense ou des vérificateurs — les possibilités sont infinies. Cependant, ils doivent être bien conçus et pertinents, car des récompenses mal élaborées peuvent dégrader involontairement les performances du modèle.
### :coin:Exemples de fonctions de récompense
Vous pouvez vous référer aux exemples ci-dessous. Vous pouvez entrer vos générations dans un LLM comme ChatGPT 4o ou Llama 3.1 (8B) et concevoir une fonction de récompense et un vérificateur pour l'évaluer. Par exemple, transmettez vos générations à un LLM de votre choix et définissez une règle : « Si la réponse semble trop robotique, retirez 3 points. » Cela aide à affiner les sorties selon des critères de qualité
#### **Exemple n°1 : tâche arithmétique simple**
* **Question :** `"2 + 2"`
* **Réponse :** `"4"`
* **Fonction de récompense 1 :**
* Si un nombre est détecté → **+1**
* Si aucun nombre n'est détecté → **-1**
* **Fonction de récompense 2 :**
* Si le nombre correspond à la bonne réponse → **+3**
* Si incorrect → **-3**
* **Récompense totale :** *Somme de toutes les fonctions de récompense*
#### **Exemple n°2 : tâche d'automatisation des e-mails**
* **Question :** E-mail entrant
* **Réponse :** E-mail sortant
* **Fonctions de récompense :**
* Si la réponse contient un mot-clé requis → **+1**
* Si la réponse correspond exactement à la réponse idéale → **+1**
* Si la réponse est trop longue → **-1**
* Si le nom du destinataire est inclus → **+1**
* Si un bloc de signature (téléphone, e-mail, adresse) est présent → **+1**
### Fonction de récompense basée sur la proximité d'Unsloth
Si vous avez consulté notre [**cahier Colab GRPO avancé**](#grpo-notebooks), vous remarquerez que nous avons créé une **fonction de récompense personnalisée basée sur la proximité** entièrement construite de zéro, conçue pour récompenser les réponses qui se rapprochent de la bonne. Cette fonction flexible peut être appliquée à un large éventail de tâches.
* Dans nos exemples, nous activons le raisonnement dans Qwen3 (Base) et le guidons vers des tâches spécifiques
* Appliquez des stratégies de pré-fine-tuning pour éviter la tendance par défaut de GRPO à n'apprendre que le formatage
* Améliorez la précision de l'évaluation avec une correspondance basée sur des expressions régulières
* Créez des modèles GRPO personnalisés au-delà des invites génériques comme `think`, par ex., ``
* Appliquez une notation basée sur la proximité — les modèles obtiennent plus de récompense pour des réponses plus proches (par ex., prédire 9 au lieu de 10 est mieux que 3) tandis que les valeurs aberrantes sont pénalisées
#### Fonctions de récompense GSM8K
Dans nos autres exemples, nous utilisons les fonctions de récompense GSM8K existantes de [@willccbb](https://x.com/willccbb) qui est populaire et s'est montré assez efficace :
* **correctness\_reward\_func** – Récompense les correspondances exactes avec l'étiquette.
* **int\_reward\_func** – Encourage les réponses composées uniquement d'entiers.
* **soft\_format\_reward\_func** – Vérifie la structure mais autorise de légers décalages de retour à la ligne.
* **strict\_format\_reward\_func** – Garantit que la structure de la réponse correspond à l'invite, y compris les retours à la ligne.
* **xmlcount\_reward\_func** – Garantit exactement un de chaque balise XML dans la réponse.
## :abacus:Utiliser vLLM
Vous pouvez désormais utiliser [vLLM](https://github.com/vllm-project/vllm/) directement dans votre pile de fine-tuning, ce qui permet un débit bien plus élevé et vous permet de fine-tuner et d'effectuer des inférences sur le modèle en même temps ! Sur 1x A100 40 Go, comptez environ 4000 tokens/s avec la quantification dynamique 4 bits d'Unsloth de Llama 3.2 3B Instruct. Sur un Tesla T4 16 Go (GPU Colab gratuit), vous pouvez obtenir 300 tokens/s.\
\
Nous avons aussi supprimé magiquement le double usage de mémoire lors du chargement conjoint de vLLM et Unsloth, ce qui permet d'économiser environ 5 Go pour Llama 3.1 8B et 3 Go pour Llama 3.2 3B. Unsloth pouvait à l'origine fine-tuner Llama 3.3 70B Instruct sur 1 GPU de 48 Go avec les poids de Llama 3.3 70B occupant 40 Go de VRAM. Si nous ne supprimons pas le double usage de mémoire, il nous faudra alors >= 80 Go de VRAM lors du chargement conjoint d'Unsloth et de vLLM.\
\
Mais avec Unsloth, vous pouvez toujours fine-tuner et bénéficier d'une inférence rapide dans un seul package avec moins de 48 Go de VRAM ! Pour utiliser l'inférence rapide, installez d'abord vllm, puis instanciez Unsloth avec fast\_inference :
```python
# pip install unsloth vllm
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Llama-3.2-3B-Instruct",
fast_inference = True,
)
```
## :white\_check\_mark:Consignes relatives aux exigences GRPO
Lorsque vous utilisez Unsloth pour faire du GRPO, nous réduisons intelligemment l'utilisation de la VRAM de plus de 90 % par rapport aux implémentations standard avec Flash Attention 2 en utilisant plusieurs astuces ! Sur des longueurs de contexte de 20K, par exemple avec 8 générations par invite, Unsloth n'utilise que **54,3 Go de VRAM pour Llama 3.1 8B**, tandis que les implémentations standard prennent **510,8 Go (90 % de moins pour Unsloth)**.
1. Pour les **Exigences en VRAM GPU pour QLoRA 4 bits**, la règle générale est que les paramètres du modèle = la quantité de VRAM dont vous aurez besoin (vous pouvez utiliser moins de VRAM, mais c'est juste par prudence). Plus la longueur de contexte est grande, plus la VRAM nécessaire est élevée. LoRA 16 bits utilisera au minimum 4 fois plus de VRAM.
2. Nos nouveaux noyaux linéaires économes en mémoire pour GRPO réduisent l'utilisation de la mémoire d'un facteur 8 ou plus. Cela permet d'économiser 68,5 Go de mémoire, tout en étant en réalité plus rapide grâce à torch.compile !
3. Nous exploitons notre [checkpointing des gradients Unsloth](https://unsloth.ai/blog/long-context) intelligent, un algorithme que nous avons publié il y a quelque temps. Il décharge intelligemment les activations intermédiaires vers la RAM système de manière asynchrone, tout en n'étant que 1 % plus lent. Cela permet d'économiser 52 Go de mémoire.
4. Unsloth utilise également le même espace mémoire GPU / CUDA que le moteur d'inférence sous-jacent (vLLM), contrairement aux implémentations d'autres packages. Cela permet d'économiser 16 Go de mémoire.
| Métriques | Unsloth | Standard + FA2 |
| -------------------------------------------------------------- | ------------------------ | -------------- |
| Coût mémoire d'entraînement (Go) | 42 Go | 414 Go |
| Coût mémoire GRPO (Go) | 9,8 Go | 78,3 Go |
| Coût de l'inférence (Go) | 0 Go | 16 Go |
| Cache KV d'inférence pour une longueur de contexte de 20K (Go) | 2,5 Go | 2,5 Go |
| Utilisation totale de la mémoire | 54,33 Go (90 % de moins) | 510,8 Go |
Dans les implémentations GRPO standard typiques, vous devez créer 2 logits de taille (8, 20K) pour calculer la perte GRPO. Cela prend 2 \* 2 octets \* 8 (nombre de générations) \* 20K (longueur de contexte) \* 128256 (taille du vocabulaire) = 78,3 Go de VRAM.
Unsloth réduit l'utilisation de la mémoire d'un facteur 8 pour le GRPO à long contexte, nous n'avons donc besoin que de 9,8 Go de VRAM supplémentaires pour des longueurs de contexte de 20K !
Nous devons également le faire à partir du cache KV en 16 bits. Llama 3.1 8B comporte 32 couches, et K et V ont tous deux une taille de 1024. Ainsi, l'utilisation de la mémoire pour une longueur de contexte de 20K = 2 \* 2 octets \* 32 couches \* 20K longueur de contexte \* 1024 = 2,5 Go par lot. Nous fixerions la taille de lot pour vLLM à 8, mais nous la laisserons à 1 pour nos calculs afin d'économiser la VRAM. Sinon, vous aurez besoin de 20 Go pour le cache KV.
## 🎥 Vidéo de l'atelier de 3 heures sur le RL avec Unsloth
{% embed url="" %}
## :mortar\_board:Pour aller plus loin
1. Le livre RLHF de Nathan Lambert est incontournable !
2. La vidéo YouTube de GRPO de Yannic Kilcher est aussi incontournable !
3. Nous avons organisé un atelier de 3 heures à l'AI Engineer World's Fair 2025. Les diapositives et autres documents sont à
4. Cahier GRPO avancé via Unsloth.
5. Notebook GRPO à partir d'un modèle de base :
## Tutoriels vidéo
Voici quelques tutoriels vidéo créés par d’incroyables YouTubeurs que nous trouvons fantastiques !
{% embed url="" %}
{% columns %}
{% column width="50%" %}
{% embed url="" %}
Excellent pour apprendre à préparer votre jeu de données et les explications derrière les bases de l’apprentissage par renforcement + GRPO
{% endembed %}
{% embed url="" %}
{% endcolumn %}
{% column width="50%" %}
{% embed url="" %}
{% embed url="" %}
GRPO local sur votre propre appareil
{% endembed %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.