> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md).
# Gemma 3n : comment l'exécuter et le fine-tuner
Exécutez localement le nouveau Gemma 3n de Google avec des GGUF dynamiques sur llama.cpp, Ollama, Open WebUI et fine-tunez-le avec Unsloth !
Le modèle multimodal Gemma 3n de Google gère les entrées image, audio, vidéo et texte. Disponible en tailles 2B et 4B, il prend en charge 140 langues pour les tâches de texte et multimodales. Vous pouvez maintenant exécuter et affiner **Gemma-3n-E4B** et **E2B** localement avec [Unsloth](https://github.com/unslothai/unsloth).
> **Affinez Gemma 3n avec notre** [**notebook Colab gratuit**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
Gemma 3n a **une longueur de contexte de 32K**, une entrée audio de 30 s, l’OCR, la reconnaissance vocale automatique (ASR) et la traduction vocale via des invites.
Tutoriel d’exécutionTutoriel d'affinageCorrectifs + analyse technique
**Les uploads Unsloth Gemma 3n (Instruct) avec des configurations optimales :**
**Voir tous nos uploads Gemma 3n, y compris les formats de base et d'autres formats dans** [**notre collection ici**](https://huggingface.co/collections/unsloth/gemma-3n-685d3874830e49e1c93f9339)**.**
## 🖥️ Exécuter Gemma 3n
Actuellement, Gemma 3n n'est pris en charge que dans **format texte** pour l'inférence.
{% hint style="info" %}
Nous avons [corrigé les problèmes](#fixes-for-gemma-3n) avec les GGUF qui ne fonctionnaient pas correctement uniquement dans Ollama. Veuillez retélécharger si vous utilisez Ollama.
{% endhint %}
### :gear: Paramètres officiels recommandés
Selon l'équipe Gemma, les paramètres officiels recommandés pour l'inférence :
`temperature = 1.0, top_k = 64, top_p = 0.95, min_p = 0.0`
* Température de 1,0
* Top\_K de 64
* Min\_P de 0,00 (facultatif, mais 0,01 fonctionne bien, la valeur par défaut de llama.cpp est 0,1)
* Top\_P de 0,95
* Pénalité de répétition de 1.0. (1.0 signifie désactivé dans llama.cpp et transformers)
* Modèle de conversation :
<bos><start_of_turn>user\nBonjour !<end_of_turn>\n<start_of_turn>model\nSalut !<end_of_turn>\n<start_of_turn>user\nQue fait 1+1 ?<end_of_turn>\n<start_of_turn>model\n
* Template de chat avec `\n`les nouvelles lignes rendues (sauf pour la dernière)
{% code overflow="wrap" %}
```
user
Bonjour !model
Salut !user
Que fait 1+1 ?model\n
```
{% endcode %}
{% hint style="danger" %}
llama.cpp et d'autres moteurs d'inférence ajoutent automatiquement un \ - N'ajoutez PAS DEUX jetons \ ! Vous devez ignorer le \ lorsque vous invitez le modèle !
{% endhint %}
### :llama: Tutoriel : comment exécuter Gemma 3n dans Ollama
{% hint style="success" %}
Veuillez retélécharger les quantifiés Gemma 3N ou supprimer les anciens via Ollama, car il y a quelques correctifs de bugs. Vous pouvez faire ce qui suit pour supprimer l'ancien fichier et le rafraîchir :
```
ollama rm hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
{% endhint %}
1. Installez `ollama` si ce n'est pas déjà fait !
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. Exécutez le modèle ! Notez que vous pouvez appeler `ollama serve`dans un autre terminal si cela échoue ! Nous incluons toutes nos corrections et paramètres suggérés (température, etc.) dans `params` dans notre téléversement Hugging Face !
```bash
ollama run hf.co/unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL
```
### 📖 Tutoriel : comment exécuter Gemma 3n dans llama.cpp
{% hint style="info" %}
Nous voudrions d'abord remercier [Xuan-Son Nguyen](https://x.com/ngxson) de Hugging Face, [Georgi Gerganov](https://x.com/ggerganov) de l'équipe llama.cpp pour avoir fait fonctionner Gemma 3N dans llama.cpp !
{% endhint %}
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=ON -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Si vous souhaitez utiliser `llama.cpp` pour charger directement des modèles, vous pouvez faire ce qui suit : (:Q4\_K\_XL) est le type de quantification. Vous pouvez aussi télécharger via Hugging Face (point 3). C’est similaire à `ollama run`
```bash
./llama.cpp/llama-cli -hf unsloth/gemma-3n-E4B-it-GGUF:UD-Q4_K_XL -ngl 99 --jinja
```
3. **OU** téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir Q4\_K\_M ou d'autres versions quantifiées (comme la précision complète BF16).
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/gemma-3n-E4B-it-GGUF",
local_dir = "unsloth/gemma-3n-E4B-it-GGUF",
allow_patterns = ["*UD-Q4_K_XL*", "mmproj-BF16.gguf"], # Pour Q4_K_XL
)
```
4. Exécutez le modèle.
5. Modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 32768` pour la longueur de contexte (Gemma 3 prend en charge une longueur de contexte de 32K !), `--n-gpu-layers 99` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.
6. Pour le mode conversation :
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \\
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \\
--ctx-size 32768 \\
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 1.0 \
--repeat-penalty 1.0 \\
--min-p 0.00 \\
--top-k 64 \\
--top-p 0.95
```
7. Pour le mode sans conversation pour tester Flappy Bird :
```bash
./llama.cpp/llama-cli \
--model unsloth/gemma-3n-E4B-it-GGUF/gemma-3n-E4B-it-UD-Q4_K_XL.gguf \\
--mmproj unsloth/gemma-3n-E4B-it-GGUF/mmproj-BF16.gguf \\
--ctx-size 32768 \\
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 1.0 \
--repeat-penalty 1.0 \\
--min-p 0.00 \\
--top-k 64 \\
--top-p 0.95 \
-no-cnv \
--prompt "user\nCréez un jeu Flappy Bird en Python. Vous devez inclure ces éléments :\n1. Vous devez utiliser pygame.\n2. La couleur de fond doit être choisie aléatoirement et être une teinte claire. Commencez avec une couleur bleu clair.\n3. Appuyer plusieurs fois sur SPACE accélérera l'oiseau.\n4. La forme de l'oiseau doit être choisie aléatoirement parmi un carré, un cercle ou un triangle. La couleur doit être choisie aléatoirement et être une couleur sombre.\n5. Placez en bas un terrain coloré en marron foncé ou en jaune, choisi aléatoirement.\n6. Affichez un score en haut à droite. Il augmente si vous franchissez les tuyaux et ne les touchez pas.\n7. Créez des tuyaux espacés aléatoirement avec suffisamment d'espace. Coloriez-les aléatoirement en vert foncé, brun clair ou en gris foncé.\n8. Lorsque vous perdez, affichez le meilleur score. Faites apparaître le texte à l'intérieur de l'écran. Appuyer sur q ou Esc quittera le jeu. Redémarrer consiste à appuyer à nouveau sur SPACE.\nLe jeu final doit se trouver dans une section markdown en Python. Vérifiez votre code pour détecter les erreurs et corrigez-les avant la section markdown finale.\nmodel\n"
```
{% hint style="danger" %}
N'oubliez pas de retirer \ puisque Gemma 3N ajoute automatiquement un \ !
{% endhint %}
## 🦥 Affinage de Gemma 3n avec Unsloth
Gemma 3n, comme [Gemma 3](/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune.md#unsloth-fine-tuning-fixes-for-gemma-3), avait des problèmes pour fonctionner sur **des GPU float16 tels que les Tesla T4 dans Colab**. Vous rencontrerez des NaN et des infinis si vous ne corrigez pas Gemma 3n pour l'inférence ou l'entraînement. [Plus d'informations ci-dessous](#infinities-and-nan-gradients-and-activations).
* Affinez Gemma 3n-E4B avec notre [notebook Colab gratuit](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
* **Audio :** Affinez Gemma 3n-E4B avec notre [**Notebook audio uniquement**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Audio.ipynb)
* **Vision**: Affinez Gemma 3n-E4B avec notre [**Notebook vision uniquement**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Vision.ipynb)
Nous avons également constaté que, comme l'architecture unique de Gemma 3n réutilise les états cachés dans l'encodeur de vision, elle présente une autre particularité intéressante avec [le Gradient Checkpointing décrit ci-dessous](#gradient-checkpointing-issues)
**Unsloth est le seul framework qui fonctionne sur des machines float16 pour l'inférence et l'entraînement de Gemma 3n.** Cela signifie que les notebooks Colab avec les Tesla T4 gratuites fonctionnent aussi ! Dans l'ensemble, Unsloth rend l'entraînement de Gemma 3n 1,5x plus rapide, consomme 50 % de VRAM en moins et permet des longueurs de contexte 4x plus longues.
Nos notebooks Colab gratuits Gemma 3n effectuent par défaut l'affinage des couches de texte. Si vous souhaitez aussi affiner les couches de vision ou d'audio, sachez que cela nécessitera beaucoup plus de VRAM - au-delà des 15 Go gratuits fournis par Colab ou Kaggle. Vous *pouvez* affinez toujours toutes les couches, y compris l'audio et la vision, et Unsloth vous permet également d'affiner uniquement des zones spécifiques, comme seulement la vision. Il suffit d'ajuster selon vos besoins :
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = False, # False si vous n'affinez pas les couches de vision
finetune_language_layers = True, # False si vous n'affinez pas les couches de langage
finetune_attention_modules = True, # False si vous n'affinez pas les couches d'attention
finetune_mlp_modules = True, # False si vous n'affinez pas les couches MLP
)
```
#### :trophy:Contenu bonus
Nous avons également entendu que vous vouliez un **Notebook Vision pour Gemma 3 (4B)** alors le voici :
* Affinez Gemma 3 (4B) avec support Vision en utilisant notre [notebook Colab gratuit](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
{% hint style="info" %}
Si vous adorez Kaggle, Google organise un concours où le meilleur modèle affiné avec Gemma 3n et Unsloth remportera un prix de 10 000 $ ! [Voir plus ici](https://www.kaggle.com/competitions/google-gemma-3n-hackathon).
{% endhint %}
## 🐛Correctifs pour Gemma 3n
### :sparkles:Problèmes et correctifs GGUF
Grâce aux discussions de [Michael](https://github.com/mxyng) de l'équipe Ollama et aussi [Xuan](https://x.com/ngxson) de Hugging Face, il y avait 2 problèmes que nous avons dû corriger spécifiquement pour les GGUF :
1. Le `add_shared_kv_layers` le paramètre a été encodé par erreur en `float32` ce qui est correct, mais devient légèrement compliqué à décoder du côté d'Ollama - une simple modification en `uint32` résout le problème. [Pull request](https://github.com/ggml-org/llama.cpp/pull/14450) traitant ce problème.
2. Le `per_layer_token_embd` la couche doit être en précision Q8\_0. Toute précision inférieure ne fonctionne pas correctement et génère une erreur dans le moteur Ollama - pour réduire les problèmes pour notre communauté, nous avons tout mis en Q8\_0 dans tous les quants - malheureusement, cela utilise plus d'espace.
1. En tant que [mettre à jour](https://huggingface.co/unsloth/gemma-3n-E4B-it-GGUF/discussions/4), [Matt](https://huggingface.co/WBB2500) mentionné, nous pouvons également utiliser Q4\_0, Q4\_1, Q5\_0, Q5\_1 pour les embeddings - et nous avons confirmé que cela fonctionne aussi dans Ollama ! Cela signifie qu'une fois encore, les quants plus petits en 2, 3 et 4 bits sont plus compacts et n'ont pas besoin de Q8\_0 !
## :infinity:Infinis et gradients et activations NaN
{% columns %}
{% column %}
Gemma 3n, tout comme Gemma 3, a des problèmes sur les GPU FP16 (par ex. les Tesla T4 dans Colab).
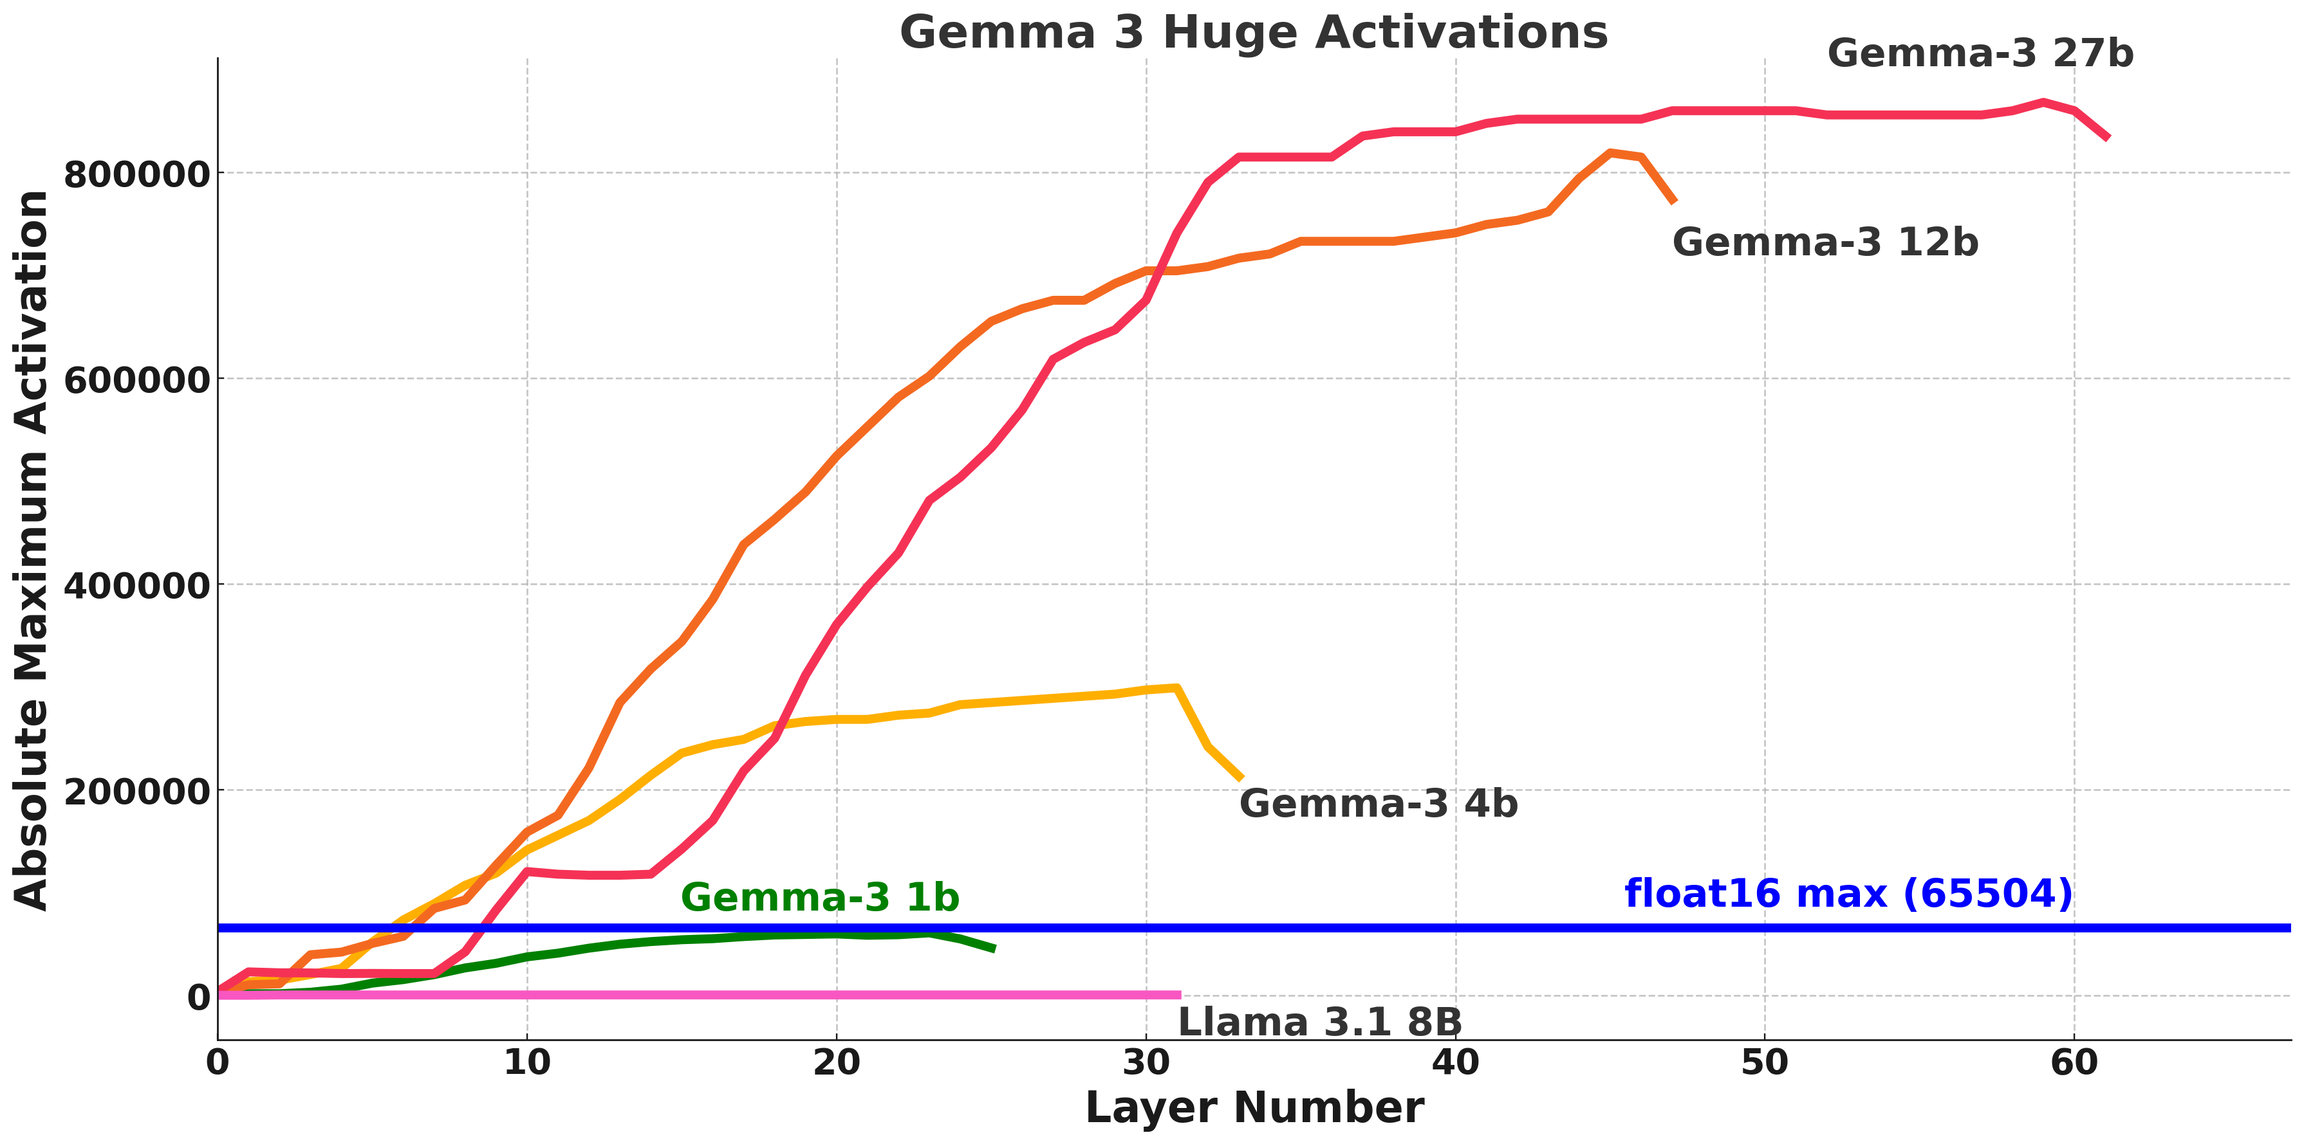
Nos correctifs précédents pour Gemma 3 sont [discutés ici](/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune.md). Pour Gemma 3, nous avons constaté que les activations dépassent la plage maximale du float16 de **65504.**
**Gemma 3N n'a pas ce problème d'activation, mais nous avons quand même réussi à rencontrer des infinis !**
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
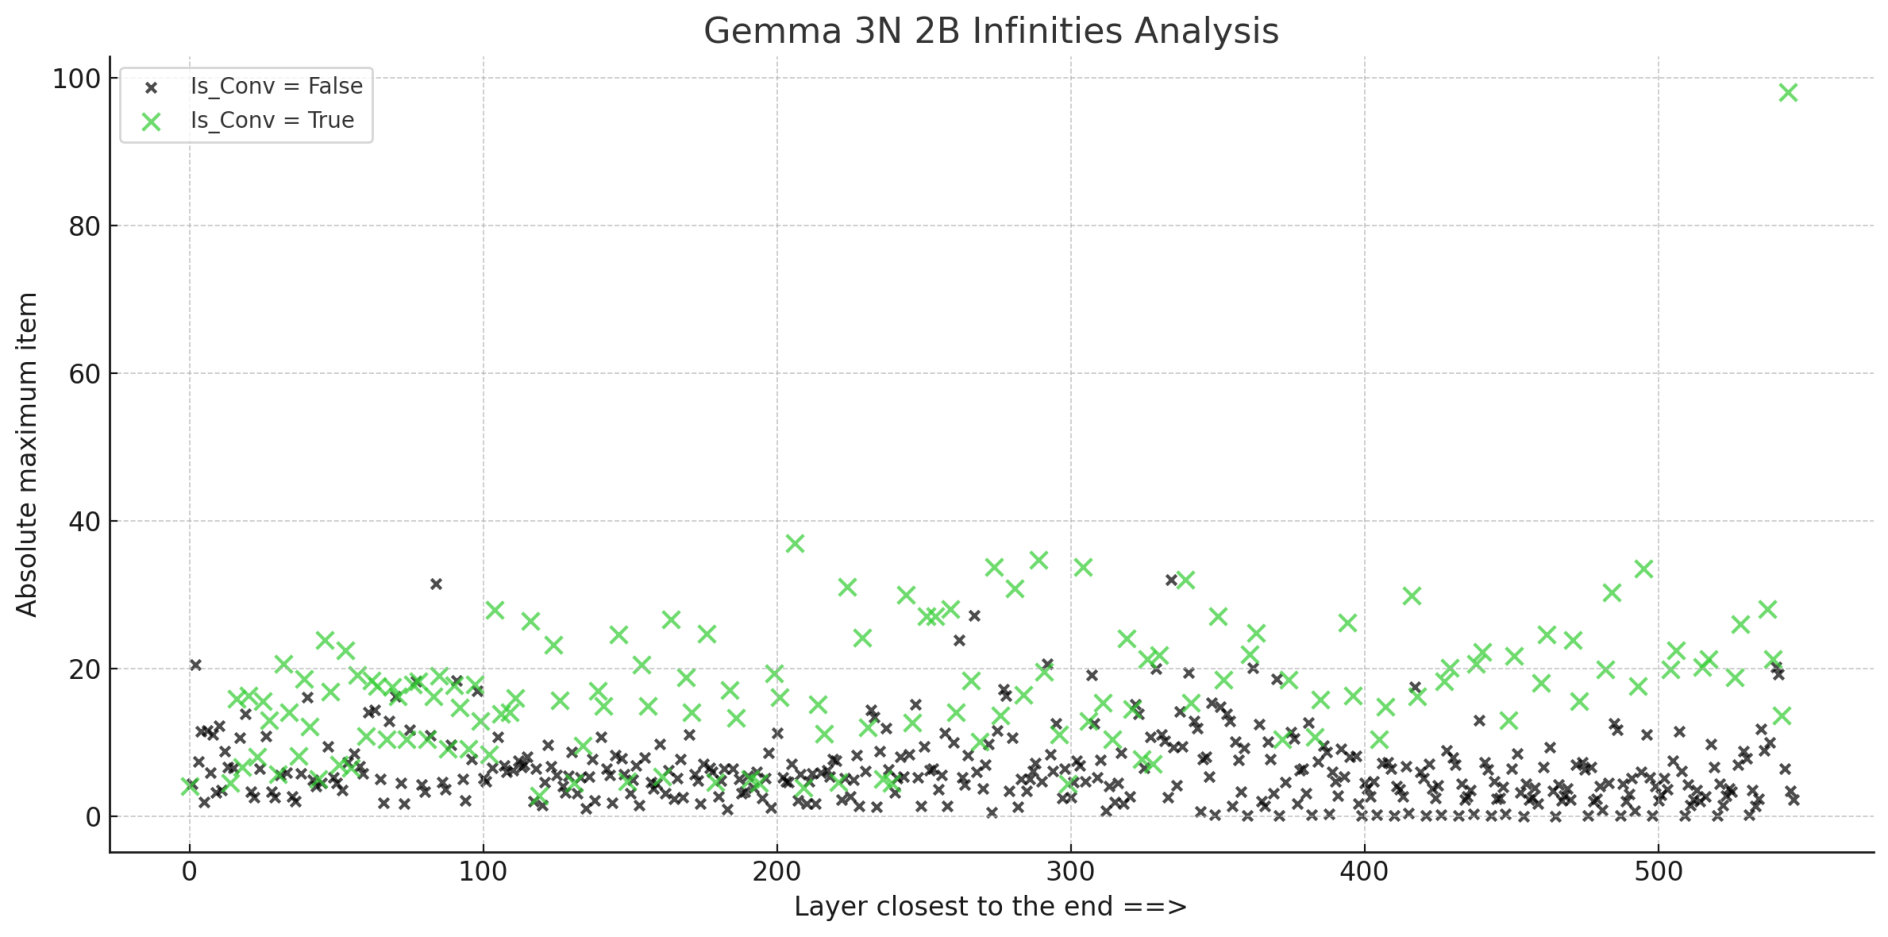
Pour aller au fond de ces infinis, nous avons tracé les entrées de poids absolues maximales pour Gemma 3N, et voici ce que nous voyons ci-dessous :
Nous constatons que les croix vertes sont les poids convolutionnels Conv2D. On peut voir que l'amplitude des couches Conv2D est en moyenne beaucoup plus grande.
Voici ci-dessous un tableau des poids Conv2D qui ont de grandes amplitudes. Notre hypothèse est que, lors d'une opération Conv2D, les grands poids se multiplient et s'additionnent, et **malheureusement, par hasard, dépassent la plage maximale de float16, soit 65504.** Le Bfloat16 convient, car sa plage maximale est de 10^38.
| Nom | Max |
| -------------------------------------- | --------- |
| msfa.ffn.pw\_proj.conv.weight | 98.000000 |
| blocks.2.21.attn.key.down\_conv.weight | 37.000000 |
| blocks.2.32.pw\_exp.conv.weight | 34.750000 |
| blocks.2.30.pw\_exp.conv.weight | 33.750000 |
| blocks.2.34.pw\_exp.conv.weight | 33.750000 |
### :sparkler:Solution aux infinis
La solution naïve consiste à `faire un upcast` tous les poids Conv2D vers float32 (si bfloat16 n'est pas disponible). Mais cela augmenterait l'utilisation de la VRAM. Pour y remédier, nous utilisons plutôt `autocast` à la volée pour faire monter les poids et les entrées en float32, et nous effectuons donc l'accumulation en float32 dans le cadre même de la multiplication matricielle, sans avoir à faire monter les poids.
{% hint style="success" %}
Unsloth est le seul framework qui permet l'inférence et l'entraînement de Gemma 3n sur des GPU float16, donc les notebooks Colab avec les Tesla T4 gratuites fonctionnent !
{% endhint %}
### :checkered\_flag:Problèmes de Gradient Checkpointing
Nous avons également trouvé l'encodeur de vision de Gemma 3N assez unique puisqu'il réutilise des états cachés. Cela limite malheureusement l'utilisation du [gradient checkpointing d'Unsloth](https://unsloth.ai/blog/long-context), ce qui aurait pu réduire considérablement l'utilisation de la VRAM. car il ne peut pas être appliqué à l'encodeur de vision.
Cependant, nous avons tout de même réussi à exploiter **le compilateur automatique d'Unsloth** pour optimiser Gemma 3N !
### :cactus:Grosses pertes pendant l'affinage
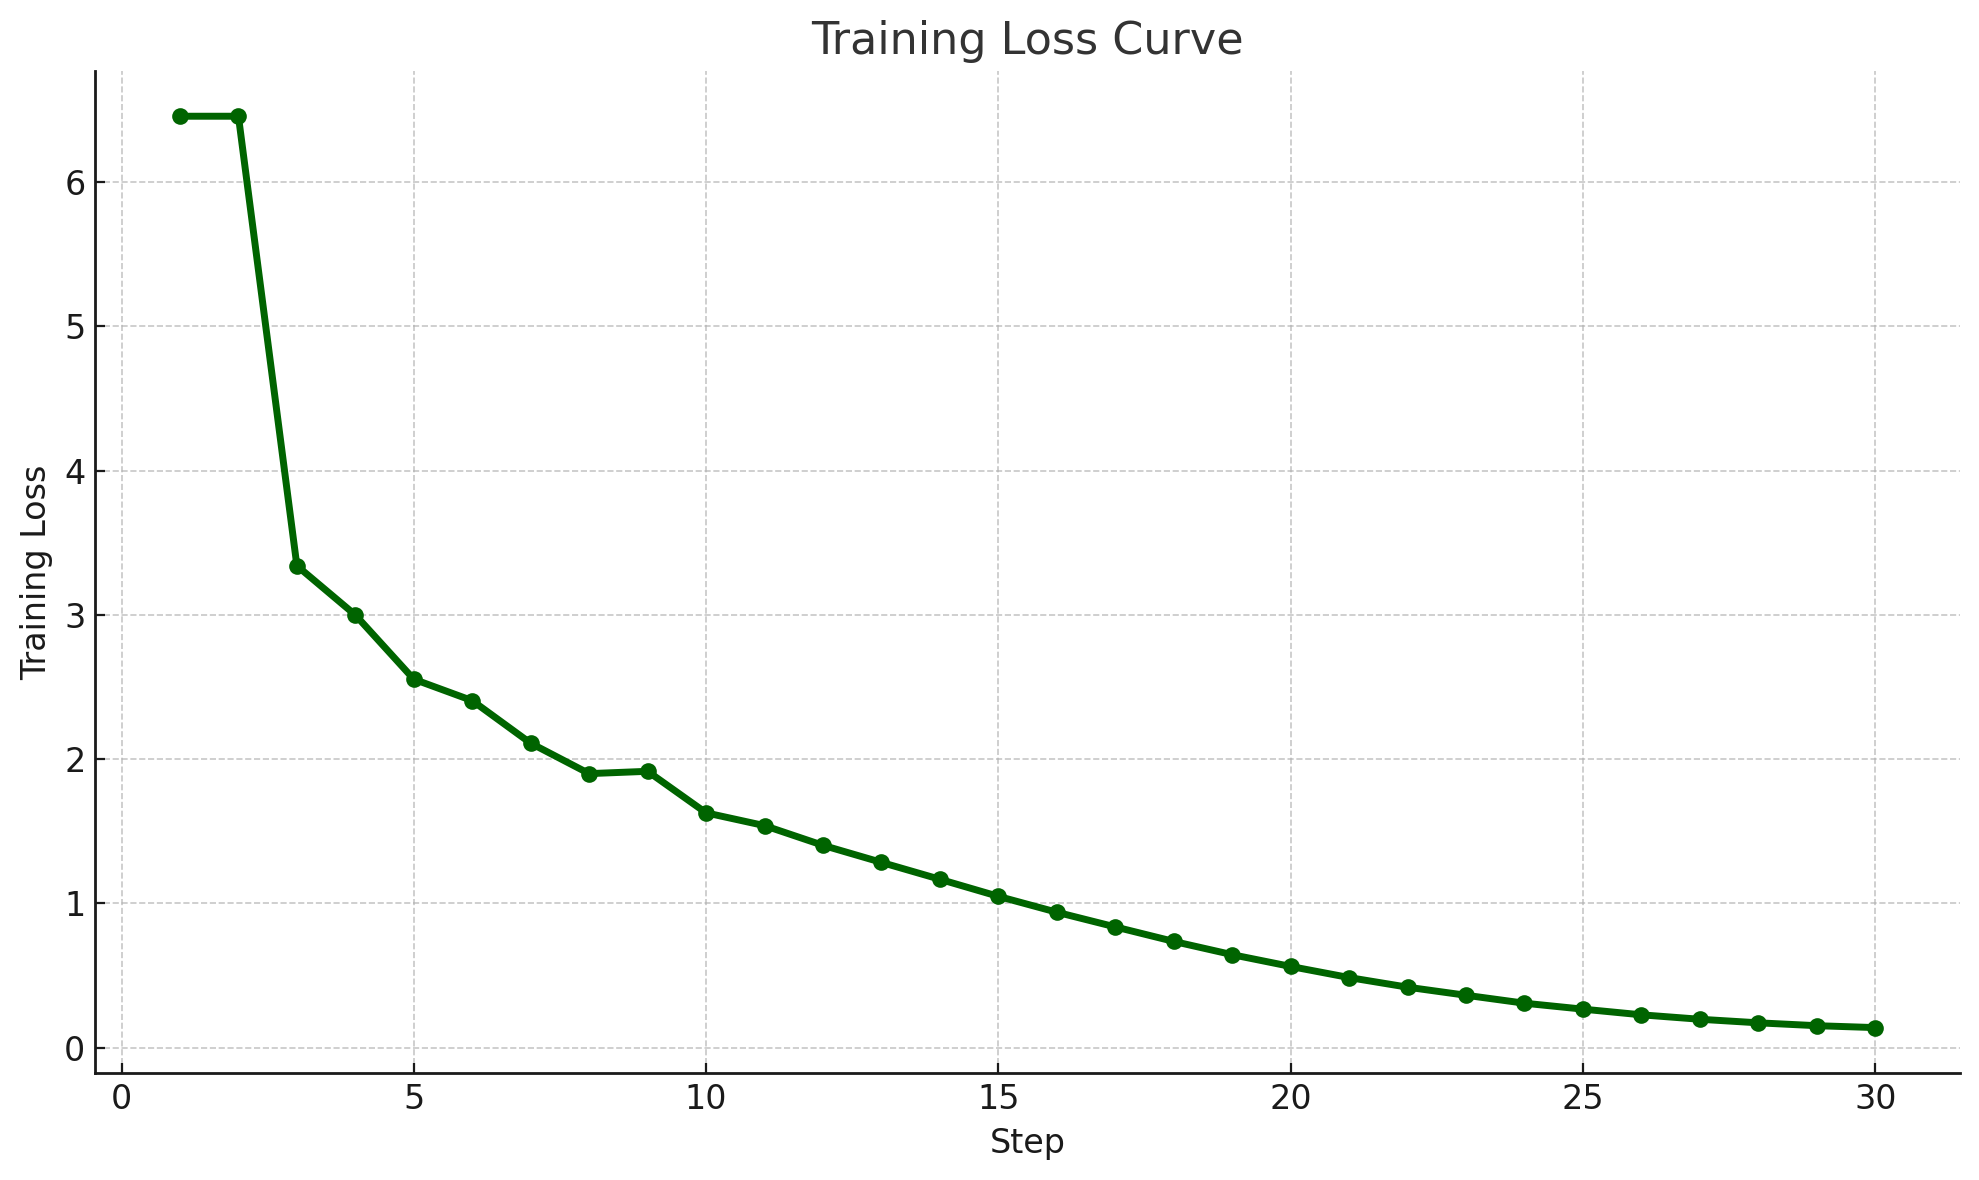
Nous avons également constaté que les pertes sont étonnamment très élevées au début de l'affinage - de l'ordre de 6 à 7, mais elles diminuent rapidement avec le temps. Nous pensons que cela s'explique par l'une des deux possibilités suivantes :
1. Il pourrait y avoir un problème d'implémentation, mais c'est peu probable puisque l'inférence semble fonctionner.
2. **Les modèles multimodaux semblent toujours présenter ce comportement** - nous avons constaté que la perte de Llama 3.2 Vision démarre à 3 ou 4, Pixtral à environ 8, et Qwen 2.5 VL aussi vers 4. Comme Gemma 3N inclut aussi l'audio, cela pourrait amplifier la perte initiale. Mais ce n'est qu'une hypothèse. Nous avons également constaté qu'en quantifiant Qwen 2.5 VL 72B Instruct, les scores de perplexité étaient extrêmement élevés, autour de 30 environ, mais le modèle fonctionne étonnamment bien.
{% hint style="success" %}
**Affinez Gemma 3n avec notre** [**notebook Colab gratuit**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
{% endhint %}
## 🛠️ Analyse technique
### Gemma 3n : MatFormer
Alors, qu'a donc de si spécial Gemma 3n, demandez-vous ? Il repose sur [Matryoshka Transformer ou MatFormer](https://arxiv.org/abs/2310.07707) une architecture qui signifie que chaque couche/bloc de transformeur intègre/niche des FFN de tailles progressivement plus petites. Pensez-y comme à des gobelets de plus en plus petits emboîtés les uns dans les autres. L'entraînement est effectué de sorte qu'au moment de l'inférence, vous puissiez choisir la taille voulue et tirer le meilleur parti des performances des plus grands modèles.
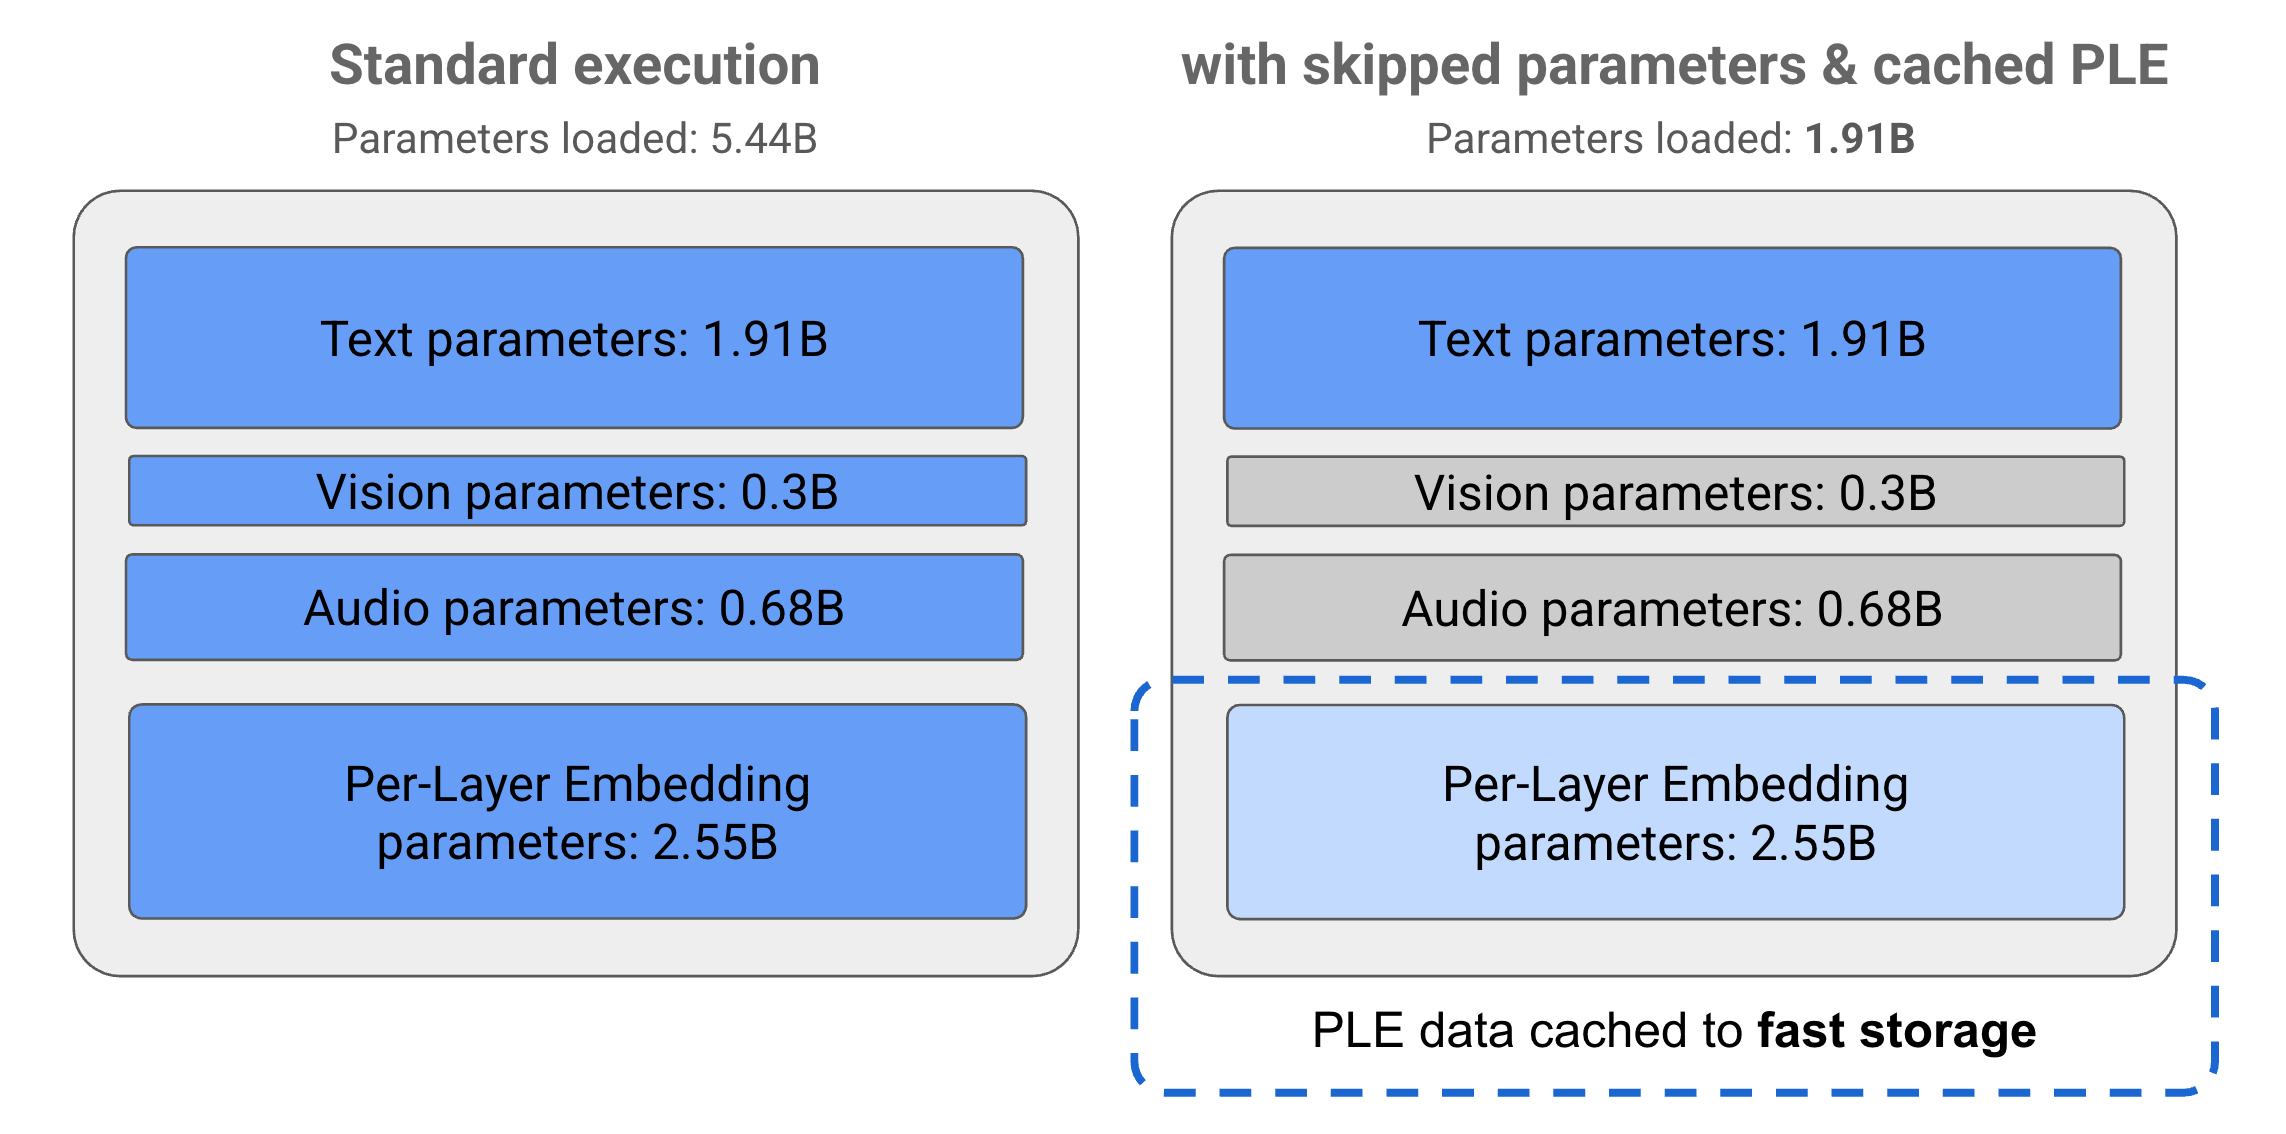
Il existe également un embedding par couche qui peut être mis en cache pour réduire l'utilisation de la mémoire au moment de l'inférence. Ainsi, le modèle 2B (E2B) est un sous-réseau à l'intérieur du modèle 4B (alias 5,44B), obtenu à la fois grâce à la mise en cache de l'embedding par couche et en sautant les composants audio et vision pour se concentrer uniquement sur le texte.
L'architecture MatFormer est généralement entraînée avec des sous-modèles espacés exponentiellement, c'est-à-dire de tailles `S`, `S/2, S/4, S/8` etc. dans chacune des couches. Ainsi, pendant l'entraînement, les entrées sont acheminées aléatoirement à travers l'un des sous-blocs mentionnés, donnant à chaque sous-bloc une chance égale d'apprendre. L'avantage est qu'au moment de l'inférence, si vous voulez que le modèle fasse un quart de sa taille d'origine, vous pouvez choisir `S/4` des sous-blocs de cette taille dans chaque couche.
Vous pouvez également choisir de **mélanger et assortir** où vous choisissez, par exemple, `S/4` sous-bloc de taille `S/2` d'une couche, et `S/8` sous-bloc de taille d'une autre couche. En fait, vous pouvez modifier les sous-modèles que vous choisissez en fonction de l'entrée elle-même si vous le souhaitez. En gros, c'est comme choisir votre propre type de structure à chaque couche. Ainsi, en entraînant simplement un modèle d'une taille particulière, vous créez un nombre exponentiel de modèles de tailles plus petites. Aucun apprentissage n'est perdu. Plutôt ingénieux, non.
{% hint style="info" %}
**Affinez et essayez l'inférence multimodale Gemma 3n avec notre** [**notebook Colab gratuit**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb)
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.