> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/devstral-2.md).
# Devstral 2 - guide d'exécution
Guide pour exécuter localement les modèles Mistral Devstral 2 : 123B-Instruct-2512 et Small-2-24B-Instruct-2512.
Devstral 2 sont les nouveaux LLM de codage et agents de Mistral pour le génie logiciel, disponibles en [24B](#devstral-small-2-24b) et [123B](#devstral-2-123b) tailles. Le modèle 123B atteint l'état de l'art sur SWE-bench, le codage, l'appel d'outils et les cas d'usage d'agents. Le modèle 24B tient dans 25 Go de RAM/VRAM et le 123B tient dans 128 Go.
{% hint style="success" %}
**Mise à jour du 13 décembre 2025**
**Nous avons résolu des problèmes dans le modèle de chat de Devstral, et les résultats devraient être nettement meilleurs. Les versions 24B et 123B ont été mises à jour. Installez également la dernière version de llama.cpp en date du 13 décembre 2025 !**
{% endhint %}
Devstral 2 prend en charge les capacités de vision, une fenêtre de contexte de 256k et utilise la même architecture que [Ministral 3](/docs/fr/modeles/tutorials/ministral-3.md). Vous pouvez désormais exécuter et **affiner** les deux modèles localement avec Unsloth.
Tous les téléversements de Devstral 2 utilisent notre méthodologie Unsloth [Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) , offrant les meilleures performances sur [Aider Polyglot](/docs/fr/notions-de-base/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md) et les benchmarks MMLU en 5 shots.
Devstral-Small-2-24BDevstral-2-123B
#### **Devstral 2 - Unsloth Dynamic** GGUFs :
| Devstral-Small-2-24B-Instruct-2512 | Devstral-2-123B-Instruct-2512 |
| --------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------- |
| [Devstral-Small-2-**24B**-Instruct-2512-GGUF](https://huggingface.co/unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF) | [Devstral-2-**123B**-Instruct-2512-GGUF](https://huggingface.co/unsloth/Devstral-2-123B-Instruct-2512-GGUF) |
## 🖥️ **Exécution de Devstral 2**
Consultez nos guides pas à pas pour exécuter [Devstral 24B](#devstral-small-2-24b) et le grand [Devstral 123B](#devstral-2-123b) modèles. Les deux modèles prennent en charge la vision, mais pour l'instant **la vision n'est pas prise en charge** dans llama.cpp
### :gear: Guide d’utilisation
Voici les paramètres recommandés pour l'inférence :
* **Température \~0.15**
* Min\_P de 0.01 (facultatif, mais 0.01 fonctionne bien, la valeur par défaut de llama.cpp est 0.1)
* **Utilisez `--jinja` pour activer l'invite système.**
* Longueur maximale du contexte = 262,144
* Contexte minimal recommandé : 16,384
* Installez la dernière version de llama.cpp, car une [pull request du 13 décembre 2025](https://github.com/ggml-org/llama.cpp/pull/17945) corrige des problèmes.
### :tophat:Devstral-Small-2-24B
Le GGUF complet (Q8) de Devstral-Small-2-24B tiendra dans 25 Go de RAM/VRAM. Texte uniquement pour l'instant.
#### ✨ Exécuter Devstral-Small-2-24B-Instruct-2512 dans llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
2. Si vous souhaitez utiliser `llama.cpp` pour charger directement des modèles, vous pouvez faire ce qui suit : (:`Q4_K_XL`) est le type de quantification. Vous pouvez également le récupérer directement depuis Hugging Face :
```bash
./llama.cpp/llama-cli \
-hf unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF:UD-Q4_K_XL \
--jinja -ngl 99 --ctx-size 16384 \
--temp 0.15
```
3. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `UD_Q4_K_XL` ou d'autres versions quantifiées.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF",
local_dir = "unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF",
allow_patterns = ["*UD-Q4_K_XL*", "*mmproj-F16*"], # Pour Q4_K_XL
)
```
4. Exécutez le modèle en mode conversation :
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/Devstral-Small-2-24B-Instruct-2512-UD-Q4_K_XL.gguf \
--mmproj unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/mmproj-F16.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 0.15 \
--jinja
```
{% endcode %}
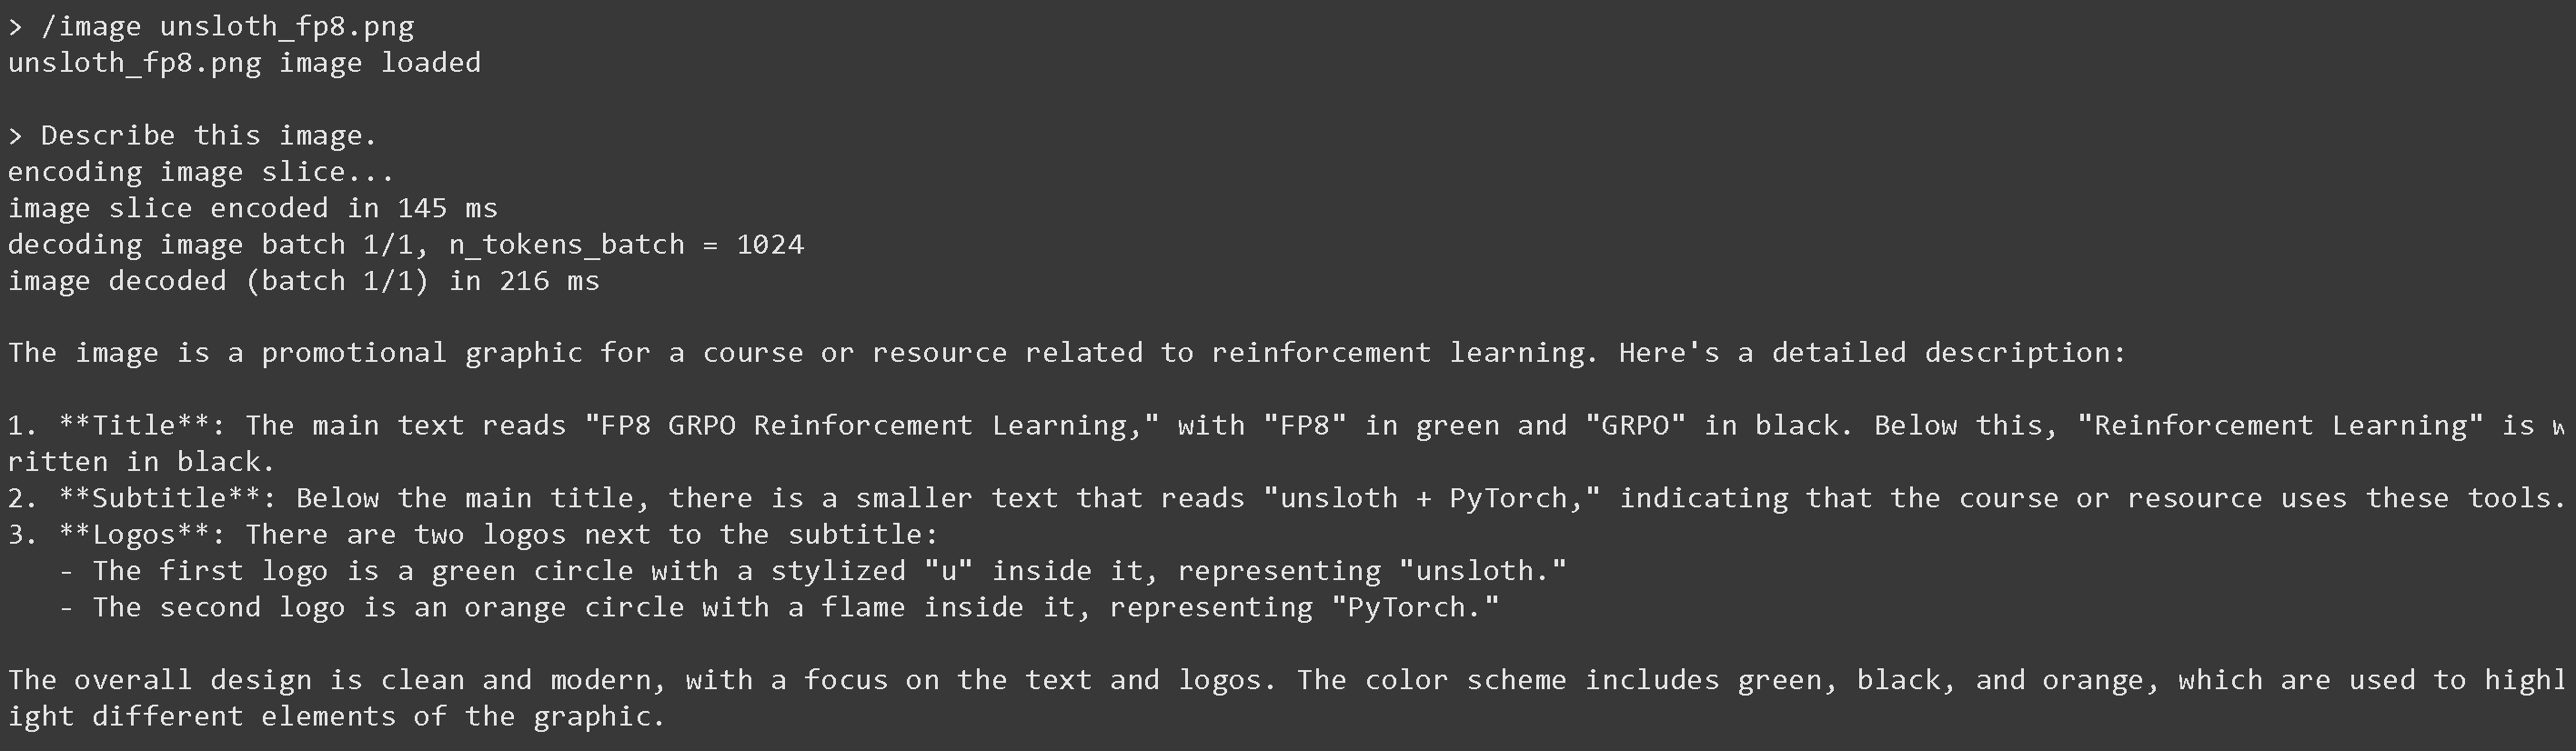
#### :eyes:Devstral et la vision
1. Pour tester les capacités d'image de Devstral, téléchargeons d'abord une image comme celle-ci [Apprentissage par renforcement FP8 avec Unsloth](https://unsloth.ai/cgi/image/fp8grpolarge_KharloZxEEaHAY2X97CEX.png?width=3840\&quality=80\&format=auto) ci-dessous :\

2. Nous récupérons l'image via `wget https://unsloth.ai/cgi/image/fp8grpolarge_KharloZxEEaHAY2X97CEX.png?width=3840%26quality=80%26format=auto -O unsloth_fp8.png` qui enregistrera l'image sous le nom "unsloth\_fp8.png"
3. Chargez ensuite l'image via `/image unsloth_fp8.png` une fois le modèle chargé, comme ci-dessous :\

4. Nous lui demandons ensuite `Décrivez cette image` et obtenons le résultat ci-dessous :
### :truck:Devstral-2-123B
Le GGUF complet (Q8) de Devstral-Small-2-123B tiendra dans 128 Go de RAM/VRAM. Texte uniquement pour l'instant.
#### :sparkles: Exécuter le tutoriel Devstral-2-123B-Instruct-2512
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
2. Vous pouvez directement récupérer depuis Hugging Face via :
```bash
./llama.cpp/llama-cli \
-hf unsloth/Devstral-2-123B-Instruct-2512-GGUF:UD-Q2_K_XL \
--jinja -ngl 99 --ctx-size 16384 \
--temp 0.15
```
2. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `UD_Q4_K_XL` ou d'autres versions quantifiées.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Devstral-2-123B-Instruct-2512-GGUF",
local_dir = "unsloth/Devstral-2-123B-Instruct-2512-GGUF",
allow_patterns = ["*UD-Q2_K_XL*", "*mmproj-F16*"],
)
```
3. Exécutez le modèle en mode conversation :
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \
--model unsloth/Devstral-2-123B-Instruct-2512-GGUF/Devstral-2-123B-Instruct-2512-UD-Q2_K_XL.gguf \
--mmproj unsloth/Devstral-2-123B-Instruct-2512-GGUF/mmproj-F16.gguf \
--ctx-size 16384 \
--n-gpu-layers 99 \
--seed 3407 \
--prio 2 \
--temp 0.15 \
--jinja
```
{% endcode %}
## 🦥 Fine-tuning de Devstral 2 avec Unsloth
Tout comme [Ministral 3](/docs/fr/modeles/tutorials/ministral-3.md), Unsloth prend en charge le fine-tuning de Devstral 2. L'entraînement est 2 fois plus rapide, utilise 70 % de VRAM en moins et prend en charge des longueurs de contexte 8 fois plus longues. Devstral 2 tient confortablement dans une GPU L4 avec 24 Go de VRAM.
Malheureusement, Devstral 2 dépasse légèrement les limites mémoire d'une VRAM de 16 Go, donc il n'est pas possible de le fine-tuner gratuitement sur Google Colab pour l'instant. Cependant, vous *pouvez* affiner le modèle gratuitement à l'aide de notre [notebook Kaggle](https://www.kaggle.com/notebooks/welcome?src=https://github.com/unslothai/notebooks/blob/main/nb/Kaggle-Magistral_\(24B\)-Reasoning-Conversational.ipynb\&accelerator=nvidiaTeslaT4), qui offre l'accès à deux GPU. Il suffit de remplacer le nom du modèle Magistral dans le notebook par `unsloth/Devstral-Small-2-24B-Instruct-2512` le modèle.
{% hint style="success" %}
Nous avons créé des notebooks Unsloth gratuits pour fine-tuner Ministral 3, et ils prennent directement en charge Devstral 2, puisqu'ils partagent la même architecture ! Changez le nom pour utiliser le modèle souhaité.
{% endhint %}
* Ministral-3B-Instruct [Notebook vision](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Ministral_3_VL_\(3B\)_Vision.ipynb) (vision) (Changez le nom du modèle en Devstral 2)
* Ministral-3B-Instruct [Notebook GRPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Ministral_3_\(3B\)_Reinforcement_Learning_Sudoku_Game.ipynb) (Changez le nom du modèle en Devstral 2)
{% columns %}
{% column %}
Notebook de fine-tuning vision Devstral
{% embed url="" %}
{% endcolumn %}
{% column %}
Notebook GRPO RL Devstral Sudoku
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
### :sunglasses:Service et déploiement de llama-server
Pour déployer Devstral 2 en production, nous utilisons `llama-server` Dans un nouveau terminal, par exemple via tmux, déployez le modèle avec :
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-server \
--model unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/Devstral-Small-2-24B-Instruct-2512-UD-Q4_K_XL.gguf \
--mmproj unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/mmproj-F16.gguf \
--alias "unsloth/Devstral-Small-2-24B-Instruct-2512" \
--n-gpu-layers 999 \
--prio 3 \
--min-p 0.01 \
--ctx-size 16384 \
--port 8001 \
--jinja
```
{% endcode %}
Lorsque vous exécutez la commande ci-dessus, vous obtiendrez :
Ensuite, dans un nouveau terminal, après avoir exécuté `pip install openai`, faites :
{% code overflow="wrap" %}
```python
from openai import OpenAI
import json
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
model = "unsloth/Devstral-Small-2-24B-Instruct-2512",
messages = [{"role": "user", "content": "Combien font 2+2 ?"},],
)
print(completion.choices[0].message.content)
```
{% endcode %}
Ce qui affichera simplement 4.
### :toolbox:Tutoriel d'appel d'outils avec Devstral 2
Après avoir suivi [#llama-server-serving-and-deployment](#llama-server-serving-and-deployment "mention") nous pouvons ensuite charger quelques outils et voir Devstral à l'œuvre ! Créons quelques outils - copiez-les, collez-les et exécutez-les en Python.
{% code expandable="true" %}
```python
import json, subprocess, random
from typing import Any
def add_number(a: float | str, b: float | str) -> float:
return float(a) + float(b)
def multiply_number(a: float | str, b: float | str) -> float:
return float(a) * float(b)
def subtract_number(a: float | str, b: float | str) -> float:
return float(a) - float(b)
def write_a_story() -> str:
return random.choice([
"Il y a bien longtemps, dans une galaxie très, très lointaine...",
"Il y avait deux amis qui adoraient les paresseux et le code...",
"Le monde allait prendre fin parce que chaque paresseux avait évolué pour posséder une intelligence surhumaine...",
"À l'insu de l'un des amis, l'autre a accidentellement codé un programme pour faire évoluer les paresseux...",
])
def terminal(command: str) -> str:
if "rm" in command or "sudo" in command or "dd" in command or "chmod" in command:
msg = "Impossible d'exécuter les commandes 'rm, sudo, dd, chmod' car elles sont dangereuses"
print(msg); return msg
print(f"Exécution de la commande terminal `{command}`")
try:
"type": "function"
except subprocess.CalledProcessError as e:
return f"Commande échouée : {e.stderr}"
def python(code: str) -> str:
data = {}
exec(code, data)
del data["__builtins__"]
return str(data)
MAP_FN = {
"add_number": add_number,
"multiply_number": multiply_number,
"subtract_number": subtract_number,
"write_a_story": write_a_story,
"terminal": terminal,
"python": python,
}
tools = [
{
"type": "function",
"function": {
"name": "add_number",
"description": "Additionnez deux nombres.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Le premier nombre.",
},
"b": {
"type": "string",
"description": "Le deuxième nombre.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "multiply_number",
"description": "Multipliez deux nombres.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Le premier nombre.",
},
"b": {
"type": "string",
"description": "Le deuxième nombre.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "subtract_number",
"description": "Soustrayez deux nombres.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Le premier nombre.",
},
"b": {
"type": "string",
"description": "Le deuxième nombre.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "write_a_story",
"description": "Écrit une histoire aléatoire.",
"parameters": {
"type": "object",
"properties": {},
"required": [],
},
},
},
{
"type": "function",
"function": {
"name": "terminal",
"description": "Effectuez des opérations depuis le terminal.",
"parameters": {
"type": "object",
"properties": {
"command": {
"type": "string",
"description": "La commande que vous souhaitez lancer, par ex. `ls`, `rm`, ...",
},
},
"required": ["command"],
},
},
},
{
"type": "function",
"function": {
"name": "python",
"description": "Appeler un interpréteur Python avec du code Python qui sera exécuté.",
"parameters": {
"type": "object",
"properties": {
"code": {
"type": "string",
"description": "Le code Python à exécuter",
},
},
"required": ["code"],
},
},
},
]
```
{% endcode %}
Nous posons ensuite une question simple tirée d'une liste aléatoire de messages possibles pour tester le modèle :
{% code overflow="wrap" %}
```python
import random
messages = [{
"role": "user",
"content": [random.choice([
{"type": "text", "text": "Pourriez-vous m'écrire une histoire ?"},
{"type": "text", "text": "Quelle est la date d'aujourd'hui plus 3 jours ?"},
{"type": "text", "text": "Obtenez l'heure actuelle en nanosecondes."},
{"type": "text", "text": "Créez une fonction de Fibonacci en Python et calculez fib(20)."},
])],
}]
```
{% endcode %}
Nous utilisons ensuite les fonctions ci-dessous (copiez, collez et exécutez) qui analyseront automatiquement les appels de fonctions - Devstral 2 peut en effectuer plusieurs en parallèle !
```python
temperature = 0.15
from openai import OpenAI
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
model_name = next(iter(openai_client.models.list())).id
print(f"Modèle utilisé = {model_name}")
has_tool_calls = True
original_messages_len = len(messages)
while has_tool_calls:
print(f"Messages actuels = {messages}")
response = openai_client.chat.completions.create(
model = model_name,
messages = messages,
temperature = temperature,
tools = tools if tools else None,
tool_choice = "auto" if tools else None,
)
tool_calls = response.choices[0].message.tool_calls or []
content = response.choices[0].message.content or ""
tool_calls_dict = [tc.to_dict() for tc in tool_calls] if tool_calls else tool_calls
messages.append({"role": "assistant", "tool_calls": tool_calls_dict, "content": content,})
for tool_call in tool_calls:
fx, args, _id = tool_call.function.name, tool_call.function.arguments, tool_call.id
out = MAP_FN[fx](**json.loads(args))
messages.append({"role": "tool", "tool_call_id": _id, "name": fx, "content": str(out),})
else:
has_tool_calls = False
print(json.dumps(messages[original_messages_len:], indent = 2))
```
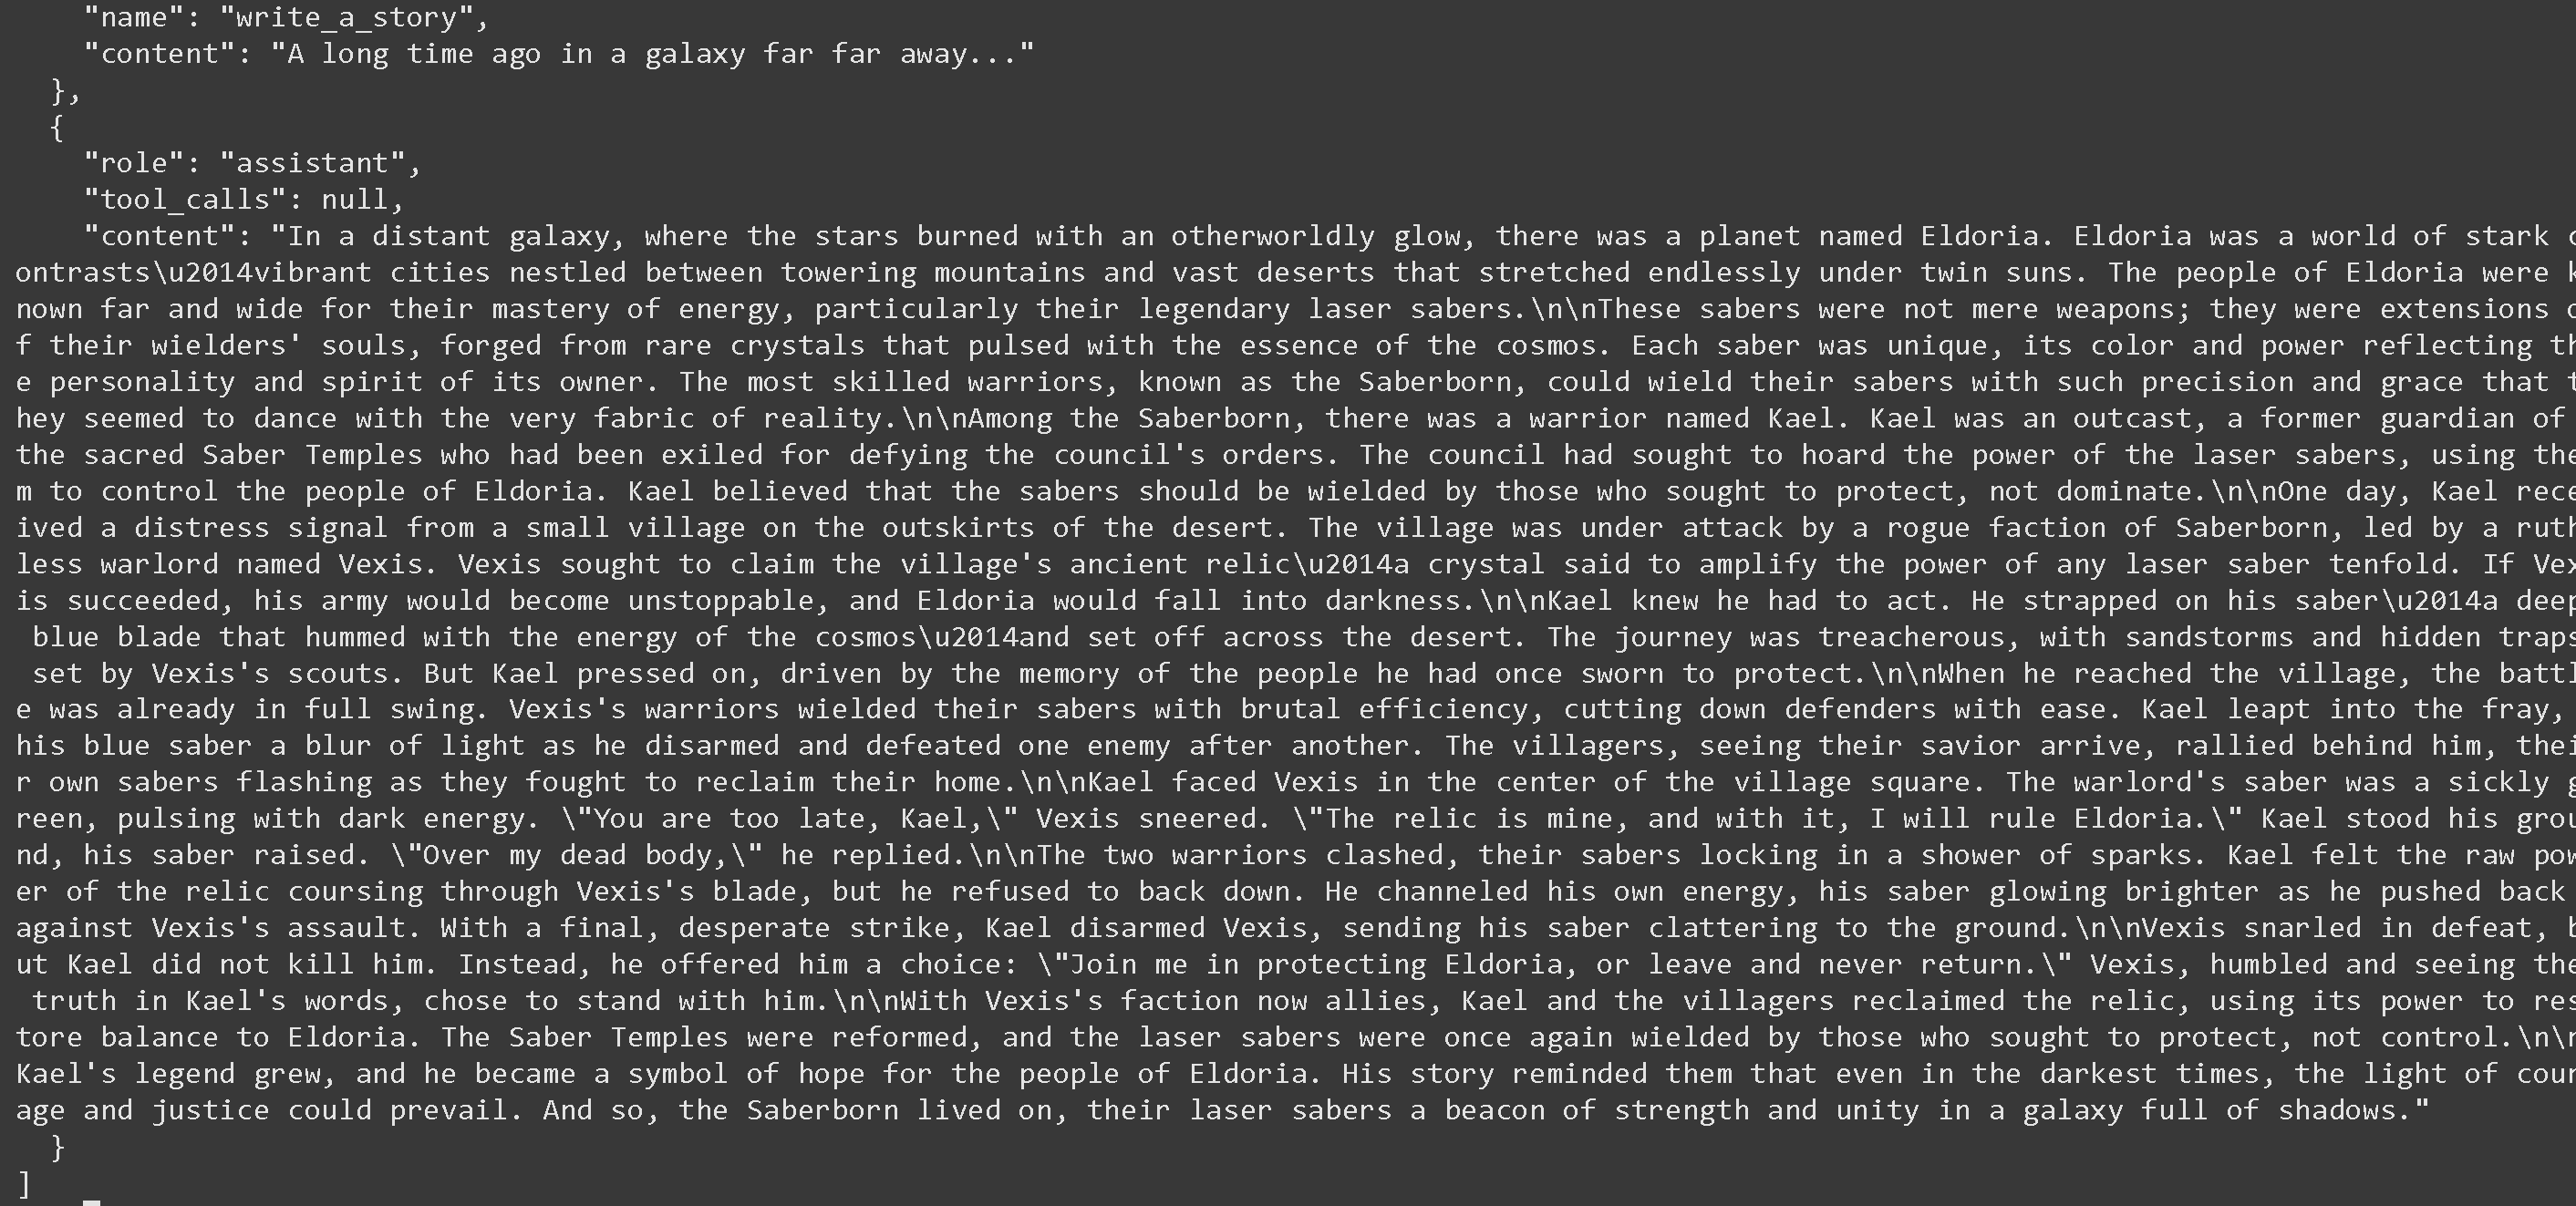
Et après 1 minute, nous obtenons :
Ou sous forme JSON :
```json
[
{
"role": "assistant",
"tool_calls": [
{
"id": "JviLK0wUveWguuKQHgZdFdYI2adu85jy",
"function": {
"arguments": "{}",
"name": "write_a_story"
},
"type": "function"
}
],
"content": null
},
{
"role": "tool",
"tool_call_id": "JviLK0wUveWguuKQHgZdFdYI2adu85jy",
"name": "write_a_story",
"content": "Il y a bien longtemps, dans une galaxie très, très lointaine..."
},
{
"role": "assistant",
"tool_calls": null,
"content": "Dans une galaxie lointaine, où les étoiles brûlaient d'une lueur surnaturelle, se trouvait une planète nommée Eldoria. Eldoria était un monde de contrastes saisissants — des villes vibrantes nichées entre de hautes montagnes et de vastes déserts qui s'étendaient à perte de vue sous deux soleils. Les habitants d'Eldoria étaient connus dans toute la galaxie pour leur maîtrise de l'énergie, en particulier de leurs légendaires sabres laser.\n\nCes sabres n'étaient pas de simples armes ; ils étaient le prolongement de l'âme de leurs porteurs, forgés à partir de cristaux rares qui pulsaient au rythme de l'essence du cosmos. Chaque sabre était unique, sa couleur et sa puissance reflétant la personnalité et l'esprit de son propriétaire. Les guerriers les plus habiles, connus sous le nom de Nés-du-Sabre, pouvaient manier leurs sabres avec une précision et une grâce telles qu'ils semblaient danser avec le tissu même de la réalité.\n\nParmi les Nés-du-Sabre se trouvait un guerrier nommé Kael. Kael était un paria, un ancien gardien des sacrés Temples du Sabre qui avait été exilé pour avoir défié les ordres du conseil. Le conseil avait cherché à accaparer le pouvoir des sabres laser pour s'en servir afin de contrôler les habitants d'Eldoria. Kael croyait que les sabres devaient être maniés par ceux qui cherchaient à protéger, et non à dominer.\n\nUn jour, Kael reçut un signal de détresse provenant d'un petit village à la lisière du désert. Le village était attaqué par une faction rebelle de Nés-du-Sabre, menée par un seigneur de guerre impitoyable nommé Vexis. Vexis cherchait à s'emparer de l'ancienne relique du village — un cristal censé amplifier par dix la puissance de n'importe quel sabre laser. Si Vexis réussissait, son armée deviendrait invincible, et Eldoria sombrerait dans les ténèbres.\n\nKael savait qu'il devait agir. Il attacha son sabre — une lame d'un bleu profond qui bourdonnait de l'énergie du cosmos — et traversa le désert. Le voyage était périlleux, avec des tempêtes de sable et des pièges dissimulés tendus par les éclaireurs de Vexis. Mais Kael continua, porté par le souvenir des gens qu'il avait autrefois juré de protéger.\n\nLorsqu'il atteignit le village, la bataille battait déjà son plein. Les guerriers de Vexis maniaient leurs sabres avec une efficacité brutale, fauchant les défenseurs avec aisance. Kael se jeta dans la mêlée, son sabre bleu n'étant plus qu'un flou de lumière tandis qu'il désarmait et mettait hors de combat un ennemi après l'autre. Les villageois, voyant leur sauveur arriver, se rallièrent derrière lui, leurs propres sabres brillant tandis qu'ils se battaient pour reprendre leur foyer.\n\nKael affronta Vexis au centre de la place du village. Le sabre du seigneur de guerre était d'un vert maladif, pulsant d'une énergie sombre. \"Tu arrives trop tard, Kael,\" ricana Vexis. \"La relique est à moi, et avec elle, je règnerai sur Eldoria.\" Kael tint sa position, sabre levé. \"Il faudra me passer sur le corps,\" répondit-il.\n\nLes deux guerriers s'affrontèrent, leurs sabres verrouillés dans une pluie d'étincelles. Kael sentit la puissance brute de la relique courir dans la lame de Vexis, mais il refusa de céder. Il canalisa sa propre énergie, son sabre brillant de plus en plus fort tandis qu'il repoussait l'assaut de Vexis. D'un dernier coup désespéré, Kael désarma Vexis, envoyant son sabre s'écraser au sol.\n\nVexis gronda de défaite, mais Kael ne le tua pas. À la place, il lui offrit un choix : \"Rejoins-moi pour protéger Eldoria, ou pars et ne reviens jamais.\" Vexis, humilié et voyant la vérité dans les paroles de Kael, choisit de se ranger à ses côtés.\n\nLa faction de Vexis étant désormais alliée, Kael et les villageois récupérèrent la relique, utilisant son pouvoir pour rétablir l'équilibre à Eldoria. Les Temples du Sabre furent réformés, et les sabres laser furent de nouveau maniés par ceux qui cherchaient à protéger, et non à contrôler.\n\nLa légende de Kael grandit, et il devint un symbole d'espoir pour le peuple d'Eldoria. Son histoire leur rappelait que, même dans les temps les plus sombres, la lumière du courage et de la justice pouvait triompher. Et ainsi, les Nés-du-Sabre continuèrent de vivre, leurs sabres laser étant un phare de force et d'unité dans une galaxie pleine d'ombres.\"
}
]
```
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/tutorials/devstral-2.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.