> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-r1-0528-how-to-run-locally.md).

# DeepSeek-R1-0528 : comment l'exécuter localement

Un guide pour exécuter DeepSeek-R1-0528, y compris Qwen3, sur votre propre appareil local !

DeepSeek-R1-0528 est la nouvelle mise à jour de DeepSeek de son modèle de raisonnement R1. Le modèle complet de 671 milliards de paramètres nécessite 715 Go d'espace disque. La dynamique quantifiée **1,66 bits** utilise 162 Go (-80 % de réduction de taille). GGUF : [DeepSeek-R1-0528-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF)

DeepSeek a également publié une version distillée R1-0528 en affinant Qwen3 (8B). La distillation atteint des performances similaires à celles de Qwen3 (235B). ***Vous pouvez également*** [***affiner Qwen3 Distill***](#fine-tuning-deepseek-r1-0528-with-unsloth) ***avec Unsloth***. Qwen3 GGUF : [DeepSeek-R1-0528-Qwen3-8B-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF)

Tous les téléversements utilisent Unsloth [Dynamic 2.0](/docs/fr/notions-de-base/dynamic-3.0-ggufs.md) pour des performances de pointe sur MMLU en 5-shot et sur la divergence KL, ce qui signifie que vous pouvez exécuter et affiner des LLM DeepSeek quantifiés avec une perte de précision minimale.

**Navigation des tutoriels :**

<a href="#run-qwen3-distilled-r1-in-llama.cpp" class="button secondary">Exécuter dans llama.cpp</a><a href="#run-in-ollama-open-webui" class="button secondary">Exécuter dans Ollama/Open WebUI</a><a href="#fine-tuning-deepseek-r1-0528-with-unsloth" class="button secondary">Affinage de R1-0528</a>

{% hint style="success" %}
NOUVEAU : énormes améliorations de l'appel d'outils et correctifs du gabarit de chat.\
\
Nouveau [quantification dynamique TQ1\_0 1,66 bits](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF?show_file_info=DeepSeek-R1-0528-UD-TQ1_0.gguf) - 162 Go de taille. Idéal pour 192 Go de RAM (y compris sur Mac) et les utilisateurs d'Ollama. Essayez : `ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0`
{% endhint %}

## :gear: Paramètres recommandés

Pour DeepSeek-R1-0528-Qwen3-8B, le modèle peut pratiquement tenir dans n'importe quelle configuration, même celles avec aussi peu que 20 Go de RAM. Aucune préparation préalable n'est nécessaire.\
\
Cependant, pour le modèle complet R1-0528, qui pèse 715 Go, vous aurez besoin de préparations supplémentaires. La quantification 1,78 bits (IQ1\_S) tiendra sur un GPU de 24 Go (avec toutes les couches déchargées). Attendez-vous à environ 5 jetons/s avec cette configuration si vous disposez aussi de 128 Go de RAM supplémentaires.

Il est recommandé d'avoir au moins 64 Go de RAM pour exécuter cette quantification (vous obtiendrez 1 jeton/s sans GPU). Pour des performances optimales, vous aurez besoin d'au moins **180 Go de mémoire unifiée ou 180 Go de RAM+VRAM combinées** pour 5+ jetons/s.

Nous vous suggérons d'utiliser notre quantification de 2,7 bits (Q2\_K\_XL) ou de 2,4 bits (IQ2\_XXS) pour équilibrer taille et précision ! La version 2,4 bits fonctionne également bien.

{% hint style="success" %}
Bien que ce ne soit pas nécessaire, pour les meilleures performances, faites en sorte que votre VRAM + RAM combinées = la taille de la quantification que vous téléchargez.
{% endhint %}

### 🐳 Paramètres officiels recommandés :

Selon [DeepSeek](https://huggingface.co/deepseek-ai/DeepSeek-R1-0528), voici les paramètres recommandés pour l'inférence de R1 (R1-0528 et le distillat Qwen3 doivent utiliser les mêmes paramètres) :

* Réglez la <mark style="background-color:green;">**température à 0,6**</mark> pour réduire les répétitions et l’incohérence.
* Définissez <mark style="background-color:green;">**top\_p à 0,95**</mark> (recommandé)
* Exécutez plusieurs tests et faites la moyenne des résultats pour une évaluation fiable.

### :1234: Format du modèle de chat / du prompt

R1-0528 utilise le même gabarit de chat que le modèle R1 d'origine. Vous n'avez pas besoin de forcer `<think>\n` , mais vous pouvez quand même l'ajouter !

```
<｜begin▁of▁sentence｜><｜User｜>Combien font 1+1 ?<｜Assistant｜>Cela fait 2.<｜end▁of▁sentence｜><｜User｜>Explique davantage !<｜Assistant｜>
```

Un BOS est ajouté de force, et un EOS sépare chaque interaction. Pour contrer les doubles jetons BOS pendant l’inférence, vous ne devez appeler que `tokenizer.encode(..., add_special_tokens = False)` puisque le gabarit de chat ajoute également automatiquement un jeton BOS.\
Pour l'inférence llama.cpp / GGUF, vous devez ignorer le BOS puisqu'il l'ajoutera automatiquement :

```
<｜User｜>Combien font 1+1 ?<｜Assistant｜>
```

Le `<think>` et `</think>` les jetons ont leurs propres jetons dédiés.

## Téléversements des modèles

**TOUTES nos mises en ligne** - y compris celles qui ne sont pas basées sur imatrix ni dynamiques - utilisent notre ensemble de données de calibration, spécialement optimisé pour les tâches conversationnelles, de codage et de langue.

* Distillat Qwen3 (8B) : [DeepSeek-R1-0528-Qwen3-8B-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF)
* Téléversements complets du modèle DeepSeek-R1-0528 ci-dessous :

Nous avons également téléversé [IQ4\_NL](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/IQ4_NL) et [Q4\_1](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/Q4_1) des quantifications qui s’exécutent spécifiquement plus vite sur les appareils ARM et Apple, respectivement.

<table data-full-width="false"><thead><tr><th>Bits MoE</th><th>Type + lien</th><th>Taille sur disque</th><th>Détails</th></tr></thead><tbody><tr><td>1,66 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF?show_file_info=DeepSeek-R1-0528-UD-TQ1_0.gguf">TQ1_0</a></td><td><strong>162 Go</strong></td><td>1,92/1,56 bit</td></tr><tr><td>1,78 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ1_S">IQ1_S</a></td><td><strong>185 Go</strong></td><td>2,06/1,56 bit</td></tr><tr><td>1,93 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ1_M">IQ1_M</a></td><td><strong>200 Go</strong></td><td>2.5/2.06/1.56</td></tr><tr><td>2,42 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ2_XXS">IQ2_XXS</a></td><td><strong>216 Go</strong></td><td>2,5/2,06 bit</td></tr><tr><td>2,71 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q2_K_XL">Q2_K_XL</a></td><td><strong>251 Go</strong></td><td>3,5/2,5 bit</td></tr><tr><td>3,12 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ3_XXS">IQ3_XXS</a></td><td><strong>273 Go</strong></td><td>3,5/2,06 bit</td></tr><tr><td>3,5 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q3_K_XL">Q3_K_XL</a></td><td><strong>296 Go</strong></td><td>4,5/3,5 bit</td></tr><tr><td>4,5 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q4_K_XL">Q4_K_XL</a></td><td><strong>384 Go</strong></td><td>5,5/4,5 bit</td></tr><tr><td>5,5 bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q5_K_XL">Q5_K_XL</a></td><td><strong>481 Go</strong></td><td>6,5/5,5 bit</td></tr></tbody></table>

Nous avons également téléversé des versions au format [BF16](https://huggingface.co/unsloth/DeepSeek-R1-0528-BF16), et l’original [format FP8 (float8)](https://huggingface.co/unsloth/DeepSeek-R1-0528).

## Lancer les tutoriels DeepSeek-R1-0528 :

### :llama: Exécuter dans Ollama/Open WebUI

1. Installez `ollama` si ce n'est pas déjà fait ! Vous ne pouvez exécuter que des modèles jusqu'à 32B. Pour exécuter le modèle complet R1-0528 de 720 Go, [voir ici](#run-full-r1-0528-on-ollama-open-webui).

```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```

2. Exécutez le modèle ! Notez que vous pouvez appeler `ollama serve`dans un autre terminal si cela échoue ! Nous incluons toutes nos corrections et paramètres suggérés (température, etc.) dans `params` dans notre téléversement Hugging Face !

```bash
ollama run hf.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF:Q4_K_XL
```

3. <mark style="color:vert;background-color:yellow;">**(NOUVEAU) Pour exécuter le modèle complet R1-0528 dans Ollama, vous pouvez utiliser notre TQ1\_0 (quantification de 162 Go) :**</mark>

```bash
OLLAMA_MODELS=unsloth_downloaded_models ollama serve &

ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0
```

### :llama: Exécuter le R1-0528 complet sur Ollama/Open WebUI

Open WebUI a réalisé ici un tutoriel étape par étape sur la façon d'exécuter R1, et pour R1-0528, il vous suffira de remplacer R1 par la nouvelle quantification 0528 : <https://docs.openwebui.com/tutorials/integrations/llm-providers/deepseekr1-dynamic>

<mark style="background-color:green;">**(NOUVEAU) Pour exécuter le modèle complet R1-0528 dans Ollama, vous pouvez utiliser notre TQ1\_0 (quantification de 162 Go) :**</mark>

```bash
OLLAMA_MODELS=unsloth_downloaded_models ollama serve &

ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0
```

Si vous voulez utiliser l'une des quantifications plus grandes que TQ1\_0 (162 Go) sur Ollama, vous devez d'abord fusionner les 3 fichiers GGUF découpés en 1, comme dans le code ci-dessous. Ensuite, vous devrez exécuter le modèle localement.

```bash
./llama.cpp/llama-gguf-split --merge \
  DeepSeek-R1-0528-GGUF/DeepSeek-R1-0528-UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00003.gguf \\
	merged_file.gguf
```

### ✨ Exécuter le R1 distillé Qwen3 dans llama.cpp

1. <mark style="background-color:yellow;">**Pour exécuter le modèle complet R1-0528 de 720 Go,**</mark> [<mark style="background-color:yellow;">**voir ici**</mark>](#run-full-r1-0528-on-llama.cpp)<mark style="background-color:yellow;">**.**</mark> Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

2. Utilisez ensuite directement llama.cpp pour télécharger le modèle :

```bash
./llama.cpp/llama-cli -hf unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF:Q4_K_XL --jinja
```

### ✨ Exécuter le R1-0528 complet sur llama.cpp

1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU. **Pour les appareils Apple Mac / Metal**, définissez `-DGGML_CUDA=OFF` puis continuez comme d'habitude - la prise en charge de Metal est activée par défaut.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```

2. Si vous souhaitez utiliser `llama.cpp` pour charger directement les modèles, vous pouvez faire ce qui suit : (:IQ1\_S) est le type de quantification. Vous pouvez aussi télécharger via Hugging Face (point 3). C'est similaire à `ollama run` . Utilisez `export LLAMA_CACHE="folder"` pour forcer `llama.cpp` pour enregistrer à un emplacement spécifique.

{% hint style="success" %}
Essayez `-ot ".ffn_.*_exps.=CPU"` pour décharger toutes les couches MoE sur le CPU ! Cela vous permet en pratique de faire tenir toutes les couches non-MoE sur 1 GPU, améliorant ainsi les vitesses de génération. Vous pouvez personnaliser l'expression regex pour faire tenir davantage de couches si vous disposez de plus de capacité GPU.

Si vous avez un peu plus de mémoire GPU, essayez `-ot ".ffn_(up|down)_exps.=CPU"` Cela décharge les couches MoE de projection ascendante et descendante.

Essayez `-ot ".ffn_(up)_exps.=CPU"` si vous avez encore plus de mémoire GPU. Cela décharge uniquement les couches MoE de projection ascendante.

Et enfin, déchargez toutes les couches via `-ot ".ffn_.*_exps.=CPU"` Cela utilise le moins de VRAM.

Vous pouvez aussi personnaliser l'expression regex, par exemple `-ot "\.(6|7|8|9|[0-9][0-9]|[0-9][0-9][0-9])\.ffn_(gate|up|down)_exps.=CPU"` signifie décharger les couches MoE gate, up et down, mais seulement à partir de la 6e couche.
{% endhint %}

```bash
export LLAMA_CACHE="unsloth/DeepSeek-R1-0528-GGUF"
./llama.cpp/llama-cli \
    -hf unsloth/DeepSeek-R1-0528-GGUF:IQ1_S \\
    --cache-type-k q4_0 \
    --threads -1 \\
    --n-gpu-layers 99 \
    --prio 3 \
    --temp 0.6 \
    --top-p 0.95 \
    --min-p 0.01 \
    --ctx-size 16384 \
    --seed 3407 \
    -ot ".ffn_.*_exps.=CPU"
```

3. Téléchargez le modèle via (après avoir installé `pip install huggingface_hub hf_transfer` ). Vous pouvez choisir `UD-IQ1_S`(quantification dynamique 1,78 bit) ou d'autres versions quantifiées comme `Q4_K_M` . Nous <mark style="background-color:green;">**recommandons d'utiliser notre quantification dynamique 2,7 bits**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`UD-Q2_K_XL`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**pour équilibrer taille et précision**</mark>. Plus de versions sur : <https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF>

{% code overflow="wrap" %}

```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0" # Peut parfois subir une limitation de débit, donc définissez-le à 0 pour le désactiver
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/DeepSeek-R1-0528-GGUF",
    local_dir = "unsloth/DeepSeek-R1-0528-GGUF",
    allow_patterns = ["*UD-IQ1_S*"], # 1 bit dynamique (168 Go) Utilisez "*UD-Q2_K_XL*" pour la 2 bits dynamique (251 Go)
)
```

{% endcode %}

4. Exécutez le test Flappy Bird d'Unsloth comme décrit dans notre quantification dynamique 1,58 bit pour DeepSeek R1.
5. Modifier `--threads 32` pour le nombre de threads CPU, `--ctx-size 16384` pour la longueur de contexte, `--n-gpu-layers 2` pour le déchargement GPU de combien de couches. Essayez de l'ajuster si votre GPU manque de mémoire. Supprimez-le aussi si vous faites une inférence uniquement CPU.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/DeepSeek-R1-0528-GGUF/UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00004.gguf \\
    --cache-type-k q4_0 \
    --threads -1 \\
    --n-gpu-layers 99 \
    --prio 3 \
    --temp 0.6 \
    --top-p 0.95 \
    --min-p 0.01 \
    --ctx-size 16384 \
    --seed 3407 \
    -ot ".ffn_.*_exps.=CPU" \\
    -no-cnv \
    --prompt "<｜User｜>Crée un jeu Flappy Bird en Python. Tu dois inclure les éléments suivants :\n1. Tu dois utiliser pygame.\n2. La couleur d’arrière-plan doit être choisie aléatoirement et être une teinte claire. Commence par une couleur bleu clair.\n3. Appuyer plusieurs fois sur ESPACE accélérera l’oiseau.\n4. La forme de l’oiseau doit être choisie aléatoirement parmi un carré, un cercle ou un triangle. La couleur doit être choisie aléatoirement parmi des couleurs foncées.\n5. Place en bas un sol coloré en brun foncé ou en jaune, choisi aléatoirement.\n6. Affiche un score en haut à droite. Incrémente-le si tu passes les tuyaux sans les heurter.\n7. Crée des tuyaux espacés aléatoirement avec suffisamment d’espace. Colore-les aléatoirement en vert foncé, brun clair ou dans une teinte de gris foncé.\n8. Lorsque tu perds, affiche le meilleur score. Le texte doit se trouver à l’intérieur de l’écran. Appuyer sur q ou Échap quittera le jeu. Pour redémarrer, appuie à nouveau sur ESPACE.\nLe jeu final doit se trouver dans une section markdown en Python. Vérifie ton code pour détecter les erreurs et corrige-les avant la section markdown finale.<｜Assistant｜>"
```

{% endcode %}

## :8ball: Test du heptagone

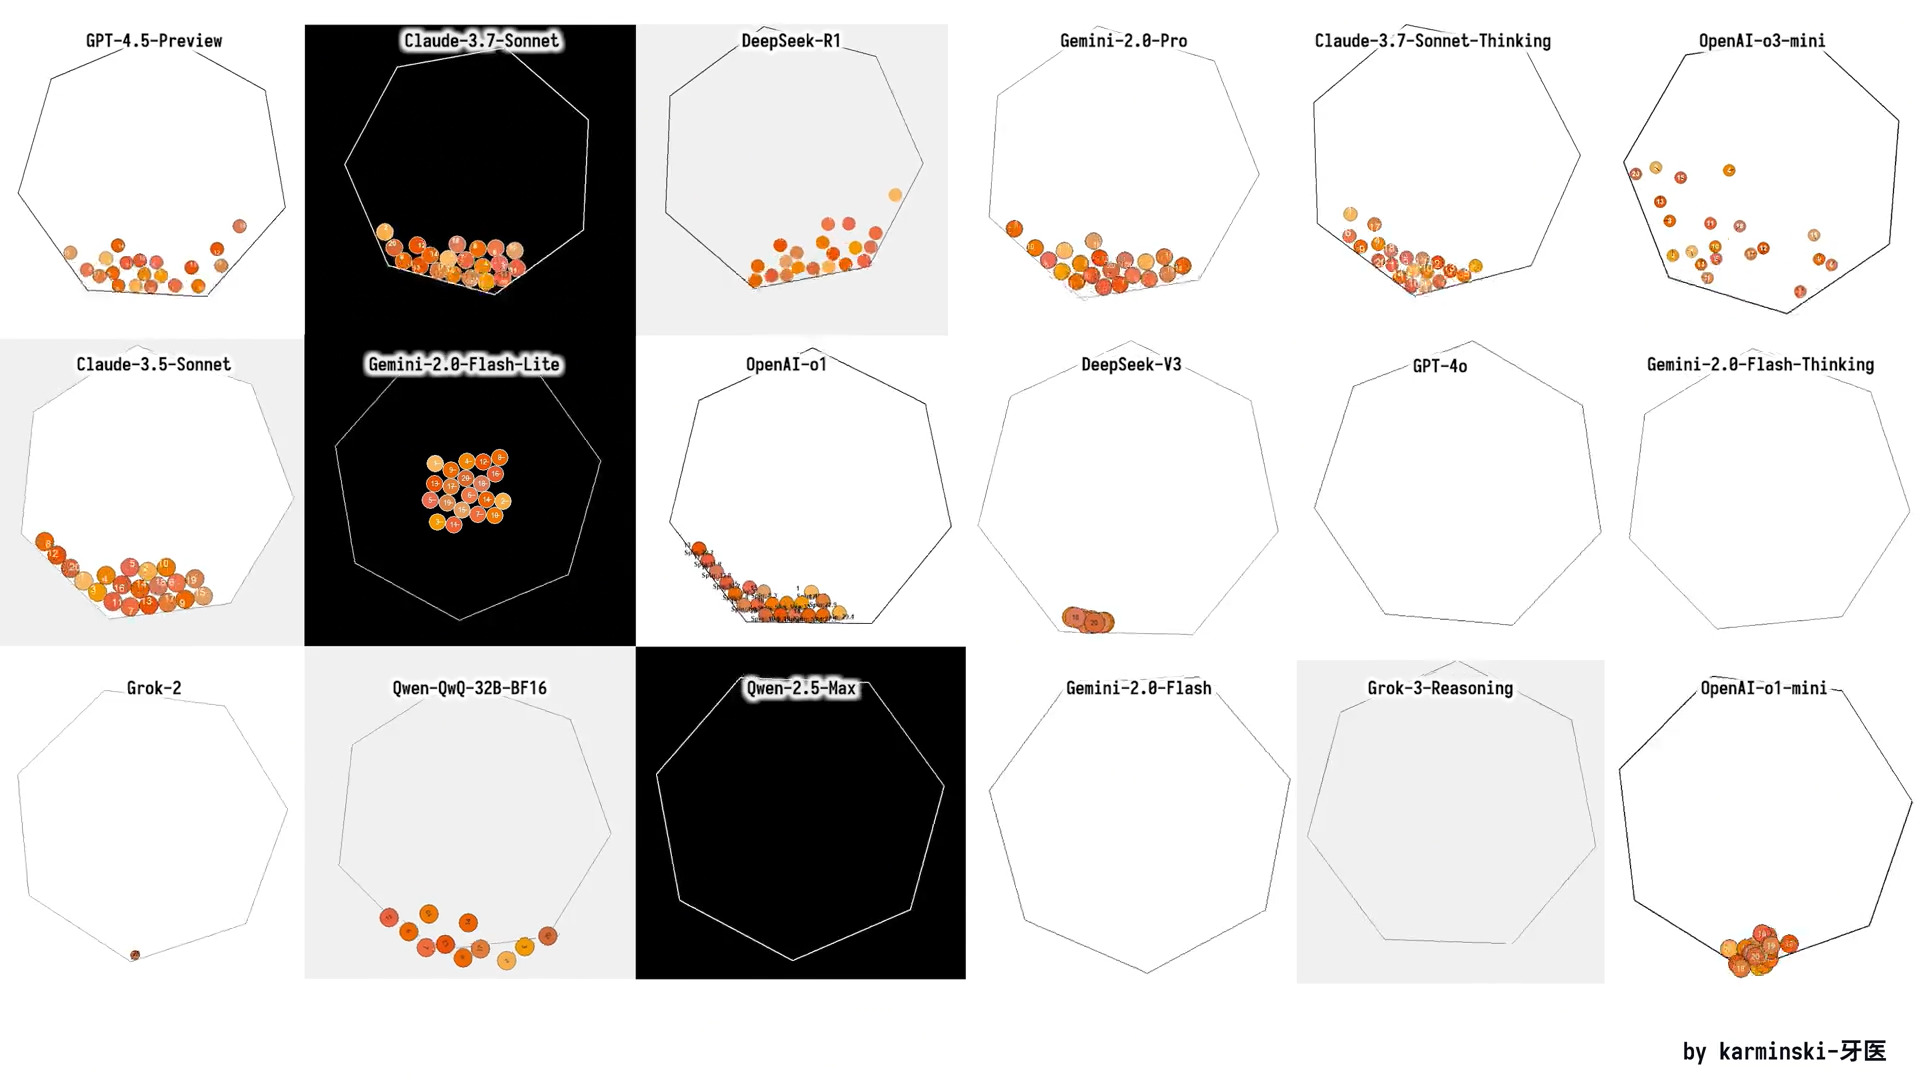
Vous pouvez également tester nos quantifications dynamiques via [r/Localllama](https://www.reddit.com/r/LocalLLaMA/comments/1j7r47l/i_just_made_an_animation_of_a_ball_bouncing/) qui teste le modèle sur la création d'un moteur physique de base simulant des balles tournant dans un heptagone fermé en mouvement.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1371de5a93c6c5b0e43e8bb51980d84554b199f4%2Fsnapshot.jpg?alt=media" alt="" width="563"><figcaption><p>Le but est de faire tourner l'heptagone, et les balles à l'intérieur de l'heptagone doivent bouger.</p></figcaption></figure>

<details>

<summary>Invite complète pour exécuter le modèle</summary>

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \
    --model unsloth/DeepSeek-R1-0528-GGUF/UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00004.gguf \\
    --cache-type-k q4_0 \
    --threads -1 \\
    --n-gpu-layers 99 \
    --prio 3 \
    --temp 0.6 \
    --top_p 0.95 \\
    --min_p 0.01 \\
    --ctx-size 16384 \
    --seed 3407 \
    -ot ".ffn_.*_exps.=CPU" \\
    -no-cnv \
    <｜User｜>Écrivez un programme Python qui montre 20 balles rebondissant à l'intérieur d'un heptagone en rotation :\n- Toutes les balles ont le même rayon.\n- Toutes les balles portent un numéro de 1 à 20.\n- Toutes les balles tombent depuis le centre de l'heptagone au démarrage.\n- Les couleurs sont : #f8b862, #f6ad49, #f39800, #f08300, #ec6d51, #ee7948, #ed6d3d, #ec6800, #ec6800, #ee7800, #eb6238, #ea5506, #ea5506, #eb6101, #e49e61, #e45e32, #e17b34, #dd7a56, #db8449, #d66a35\n- Les balles doivent être soumises à la gravité et au frottement, et elles doivent rebondir de manière réaliste sur les parois en rotation. Il doit également y avoir des collisions entre les balles.\n- Le matériau de toutes les balles fait que la hauteur de rebond à l'impact ne dépassera pas le rayon de l'heptagone, mais sera supérieure au rayon de la balle.\n- Toutes les balles tournent avec du frottement, les numéros sur la balle peuvent servir à indiquer sa rotation.\n- L'heptagone tourne autour de son centre, et sa vitesse de rotation est de 360 degrés toutes les 5 secondes.\n- La taille de l'heptagone doit être suffisamment grande pour contenir toutes les balles.\n- N'utilisez pas la bibliothèque pygame ; implémentez vous-même les algorithmes de détection de collision et de réponse aux collisions, etc. Les bibliothèques Python suivantes sont autorisées : tkinter, math, numpy, dataclasses, typing, sys.\n- Tout le code doit être placé dans un seul fichier Python.<｜Assistant｜>
```

{% endcode %}

</details>

## 🦥 Affinage de DeepSeek-R1-0528 avec Unsloth

Pour affiner **DeepSeek-R1-0528-Qwen3-8B** avec Unsloth, nous avons créé un nouveau carnet GRPO avec une fonction de récompense personnalisée conçue pour améliorer considérablement la sortie multilingue - en augmentant plus de 40 % le taux de réponses dans la langue souhaitée (dans notre exemple, nous utilisons l'indonésien, mais vous pouvez en utiliser n'importe quelle).

* [**carnet DeepSeek-R1-0528-Qwen3-8B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) **- nouveau**

Bien que de nombreux LLM de raisonnement aient des capacités multilingues, ils produisent souvent des sorties dans plusieurs langues dans leurs traces de raisonnement, en mélangeant l'anglais avec la langue cible. Notre fonction de récompense atténue efficacement ce problème en encourageant fortement les sorties dans la langue souhaitée, ce qui entraîne une amélioration substantielle de la cohérence linguistique.

Cette fonction de récompense est également entièrement personnalisable, ce qui vous permet de l'adapter à d'autres langues ou de l'affiner pour des domaines ou des cas d'utilisation spécifiques.

{% hint style="success" %}
La meilleure partie de cette fonction de récompense et de ce carnet est que vous n'avez PAS besoin d'un jeu de données linguistique pour forcer votre modèle à apprendre une langue spécifique. Le carnet ne contient aucun jeu de données indonésien.
{% endhint %}

Unsloth rend l'affinage du distillat R1-Qwen3 2× plus rapide, utilise 70 % de VRAM en moins et prend en charge des longueurs de contexte 8× plus longues.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-r1-0528-how-to-run-locally.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.