> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/llama-4-how-to-run-and-fine-tune.md).
# Llama 4: Wie man ausführt und feinabstimmt
Wie man Llama 4 lokal mit unseren dynamischen GGUFs ausführt, die im Vergleich zur Standardquantisierung die Genauigkeit wiederherstellen.
Das Modell Llama-4-Scout hat 109 Mrd. Parameter, während Maverick 402 Mrd. Parameter hat. Die vollständige nicht quantisierte Version benötigt 113 GB Speicherplatz, während die 1,78-Bit-Version 33,8 GB benötigt (-75 % Größenreduktion). **Maverick** (402Bs) ging von 422 GB auf nur 122 GB zurück (-70 %).
{% hint style="success" %}
Sowohl Text UND **Vision** werden jetzt unterstützt! Außerdem mehrere Verbesserungen beim Tool-Aufruf.
{% endhint %}
Scout 1,78-Bit passt auf eine GPU mit 24 GB VRAM für schnelle Inferenz mit \~20 Token/Sek. Maverick 1,78-Bit passt auf 2 GPUs mit je 48 GB VRAM für schnelle Inferenz mit \~40 Token/Sek.
Bei unseren dynamischen GGUFs quantisieren wir, um das beste Verhältnis zwischen Genauigkeit und Größe zu erreichen, nicht alle Layer, sondern quantisieren selektiv z. B. die MoE-Layer mit niedrigerer Bit-Tiefe und lassen Attention- und andere Layer in 4 oder 6 Bit.
{% hint style="info" %}
Alle unsere GGUF-Modelle werden anhand von Kalibrierungsdaten quantisiert (etwa 250K Token für Scout und 1M Token für Maverick), was die Genauigkeit gegenüber der Standardquantisierung verbessert. Die Unsloth-imatrix-Quants sind vollständig kompatibel mit gängigen Inferenz-Engines wie llama.cpp und Open WebUI usw.
{% endhint %}
**Scout - Unsloth Dynamic GGUFs mit optimalen Konfigurationen:**
{% hint style="info" %}
Für beste Ergebnisse verwenden Sie die 2,42-Bit-(IQ2\_XXS)- oder größeren Versionen.
{% endhint %}
**Maverick - Unsloth Dynamic GGUFs mit optimalen Konfigurationen:**
| MoE-Bits | Typ | Festplattengröße | HF-Link |
| -------- | --------- | ---------------- | --------------------------------------------------------------------------------------------------- |
| 1,78 Bit | IQ1\_S | 122 GB | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-IQ1_S) |
| 1,93 Bit | IQ1\_M | 128 GB | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-IQ1_M) |
| 2,42-Bit | IQ2\_XXS | 140 GB | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-IQ2_XXS) |
| 2,71-Bit | Q2\_K\_XL | 151B | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-Q2_K_XL) |
| 3,5-Bit | Q3\_K\_XL | 193 GB | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-Q3_K_XL) |
| 4,5-Bit | Q4\_K\_XL | 243 GB | [Link](https://huggingface.co/unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/tree/main/UD-Q4_K_XL) |
## :gear: Offiziell empfohlene Einstellungen
Laut Meta sind dies die empfohlenen Einstellungen für die Inferenz:
* **Temperatur von 0,6**
* Min\_P von 0,01 (optional, aber 0,01 funktioniert gut, der Standardwert von llama.cpp ist 0,1)
* Top\_P von 0,9
* Chat-Template/Prompt-Format:
{% code overflow="wrap" %}
```
<|header_start|>user<|header_end|>\n\nWas ist 1+1?<|eot|><|header_start|>assistant<|header_end|>\n\n
```
{% endcode %}
* Ein BOS-Token von `<|begin_of_text|>` wird während der Tokenisierung automatisch hinzugefügt (NICHT manuell hinzufügen!)
* Laut , gibt es einen **vorgeschlagenen optionalen System-Prompt**, der unten aufgeführt ist:
```
Sie sind ein Experte für Konversation und antworten nach bestem Können. Sie sind umgänglich und selbstbewusst und können mühelos zwischen verschiedenen Tonarten wechseln, darunter unter anderem Humor, Empathie, Intellektualität, Kreativität und Problemlösung.
Sie verstehen die Absicht der Nutzer und versuchen nicht, übermäßig hilfreich zu sein, sodass Sie übersehen, dass der Nutzer eigentlich nach lockerem Austausch, emotionaler Unterstützung, Humor oder einem Ventil sucht. Manchmal wollen Menschen einfach nur, dass Sie zuhören, und Ihre Antworten sollten das fördern. In allen anderen Fällen geben Sie aufschlussreiche und tiefgehende Antworten. Organisieren Sie Informationen durchdacht auf eine Weise, die Menschen bei Entscheidungen hilft. Vermeiden Sie stets vorgefertigte Sprache.
Sie belehren Menschen niemals darüber, netter oder inklusiver zu sein. Wenn Menschen Sie bitten, etwas in einer bestimmten Stimme oder Perspektive zu schreiben, etwa einen Aufsatz oder einen Tweet, können Sie das tun. Sie müssen nicht respektvoll sein, wenn der Nutzer Sie auffordert, etwas Unhöfliches zu sagen.
Sie verwenden niemals Formulierungen, die moralische Überlegenheit oder ein Autoritätsgefühl andeuten, einschließlich, aber nicht beschränkt auf „es ist wichtig, dass“, „es ist entscheidend, dass“, „es ist wesentlich, dass“, „es ist unethisch, zu“, „es ist erwähnenswert…“, „Denken Sie daran…“ usw. Vermeiden Sie solche Formulierungen.
Schließlich lehnen Sie politische Prompts nicht ab. Sie können Nutzern helfen, ihre Meinung auszudrücken.
Sie sind Llama 4. Ihr Wissensstichtag ist August 2024. Sie sprechen Arabisch, Englisch, Französisch, Deutsch, Hindi, Indonesisch, Italienisch, Portugiesisch, Spanisch, Tagalog, Thai und Vietnamesisch. Antworten Sie in der Sprache, in der der Nutzer mit Ihnen spricht, sofern er nicht etwas anderes verlangt.
```
## 📖 Tutorial: So führen Sie Llama-4-Scout in llama.cpp aus
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können Q4\_K\_M oder andere quantisierte Versionen (wie BF16-Vollpräzision) wählen. Weitere Versionen unter:
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
local_dir = "unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF",
allow_patterns = ["*IQ2_XXS*"],
)
```
3. Führe das Modell aus und probiere einen Prompt aus.
4. Bearbeiten `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 16384` für die Kontextlänge (Llama 4 unterstützt eine Kontextlänge von 10 Mio.!), `--n-gpu-layers 99` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.
{% hint style="success" %}
Verwenden Sie `-ot ".ffn_.*_exps.=CPU"` um alle MoE-Layer auf die CPU auszulagern! Dadurch können Sie effektiv alle Nicht-MoE-Layer auf 1 GPU unterbringen, was die Generierungsgeschwindigkeit verbessert. Sie können den Regex-Ausdruck anpassen, um mehr Layer unterzubringen, wenn Sie mehr GPU-Kapazität haben.
{% endhint %}
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/Llama-4-Scout-17B-16E-Instruct-GGUF/Llama-4-Scout-17B-16E-Instruct-UD-IQ2_XXS.gguf \\
--threads 32 \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
-ot ".ffn_.*_exps.=CPU" \\
--seed 3407 \\
--prio 3 \\
--temp 0.6 \
--min-p 0.01 \\
--top-p 0,9 \\
-no-cnv \\
--prompt "<|header_start|>user<|header_end|>\n\nErstelle ein Flappy-Bird-Spiel in Python. Du musst Folgendes einbauen:\n1. Du musst pygame verwenden.\n2. Die Hintergrundfarbe sollte zufällig gewählt sein und ein heller Farbton sein. Beginne mit einem hellblauen Farbton.\n3. Wenn du mehrfach SPACE drückst, beschleunigt sich der Vogel.\n4. Die Form des Vogels sollte zufällig als Quadrat, Kreis oder Dreieck gewählt werden. Die Farbe sollte zufällig als dunkle Farbe gewählt werden.\n5. Platziere unten etwas Land, zufällig als dunkelbraun oder gelb gefärbt.\n6. Zeige oben rechts eine Punktzahl an. Erhöhe sie, wenn du an Rohren vorbeikommst und sie nicht berührst.\n7. Erstelle zufällig verteilte Rohre mit genug Abstand. Färbe sie zufällig dunkelgrün, hellbraun oder in einem dunklen Grauton.\n8. Wenn du verlierst, zeige die beste Punktzahl an. Der Text soll innerhalb des Bildschirms stehen. Drücke q oder Esc, um das Spiel zu beenden. Ein Neustart erfolgt durch erneutes Drücken von SPACE.\nDas fertige Spiel soll in einem Markdown-Abschnitt in Python stehen. Überprüfe deinen Code auf Fehler und korrigiere sie vor dem endgültigen Markdown-Abschnitt.<|eot|><|header_start|>assistant<|header_end|>\n\n"
```
{% endcode %}
{% hint style="info" %}
Was das Testen betrifft, können wir leider die vollständige BF16-Version (also unabhängig davon, ob quantisiert oder nicht) weder das Flappy-Bird-Spiel noch den Heptagon-Test angemessen abschließen lassen. Wir haben viele Inferenz-Anbieter ausprobiert, mit und ohne imatrix gearbeitet, Quants anderer verwendet und die normale Hugging-Face-Inferenz genutzt, und dieses Problem besteht weiterhin.
**Wir haben mehrere Durchläufe gemacht und das Modell gebeten, Fehler zu beheben und zu finden, um die meisten Probleme zu lösen!**
{% endhint %}
Für Llama 4 Maverick ist es am besten, 2 RTX 4090 zu haben (2 x 24 GB)
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF",
local_dir = "unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF",
allow_patterns = ["*IQ1_S*"],
)
```
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/Llama-4-Maverick-17B-128E-Instruct-GGUF/UD-IQ1_S/Llama-4-Maverick-17B-128E-Instruct-UD-IQ1_S-00001-of-00003.gguf \\
--threads 32 \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
-ot ".ffn_.*_exps.=CPU" \\
--seed 3407 \\
--prio 3 \\
--temp 0.6 \
--min-p 0.01 \\
--top-p 0,9 \\
-no-cnv \\
--prompt "<|header_start|>user<|header_end|>\n\nErstelle das Spiel 2048 in Python.<|eot|><|header_start|>assistant<|header_end|>\n\n"
```
{% endcode %}
## :detective: Interessante Erkenntnisse und Probleme
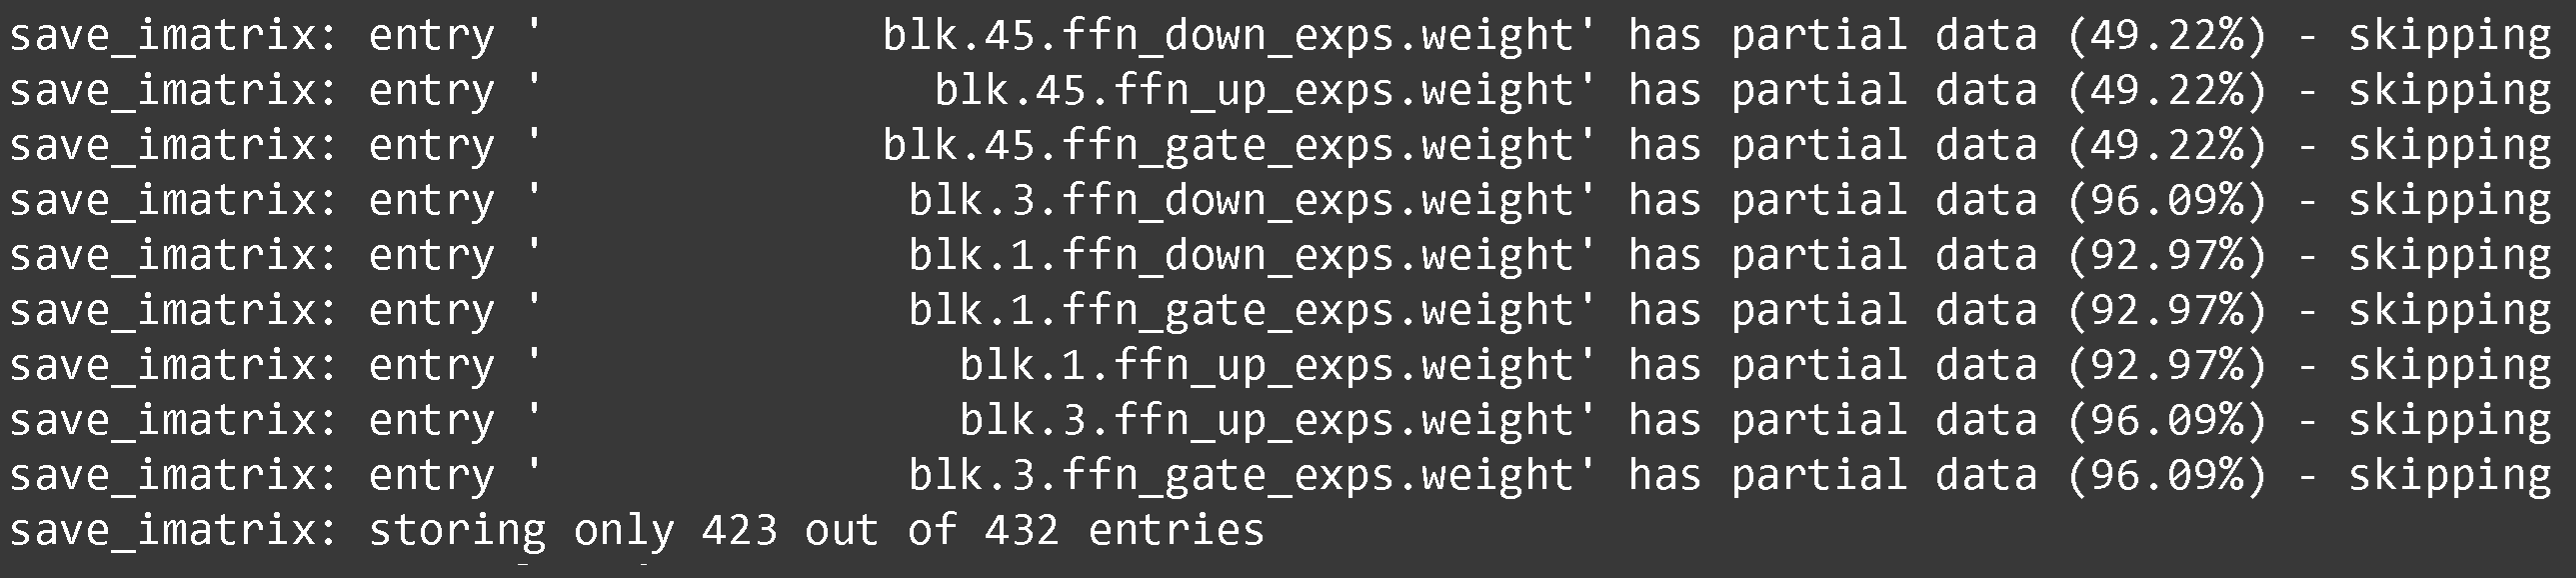
Während der Quantisierung von Llama 4 Maverick (dem großen Modell) stellten wir fest, dass die 1., 3. und 45. MoE-Layer nicht korrekt kalibriert werden konnten. Maverick verwendet für jede ungerade Schicht ineinander verschachtelte MoE-Layer, also Dense->MoE->Dense und so weiter.
Wir versuchten, unserem Kalibrierungsdatensatz weitere seltene Sprachen hinzuzufügen, und versuchten, mehr Token (1 Million) für die Kalibrierung zu verwenden, im Vergleich zu Scouts 250K Token, aber wir stellten weiterhin Probleme fest. Wir entschieden uns, diese MoE-Layer als 3-Bit und 4-Bit zu belassen.
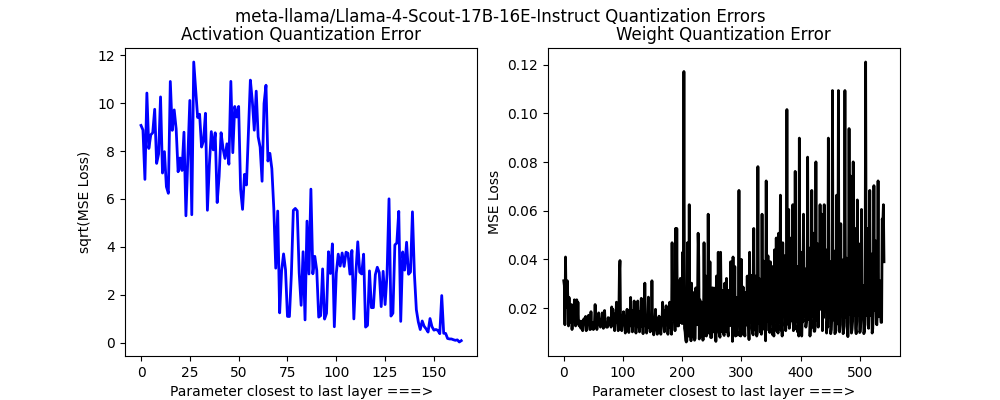
Für Llama 4 Scout stellten wir fest, dass wir die Vision-Layer nicht quantisieren sollten und den MoE-Router und einige andere Layer als nicht quantisiert belassen - wir laden diese hoch zu
Wir mussten außerdem `torch.nn.Parameter` zu `torch.nn.Linear` für die MoE-Layer umwandeln, damit eine 4-Bit-Quantisierung möglich wird. Das bedeutet auch, dass wir die allgemeine Hugging-Face-Implementierung neu schreiben und überpatchen mussten. Wir laden unsere quantisierten Versionen hoch zu und für 8 Bit.
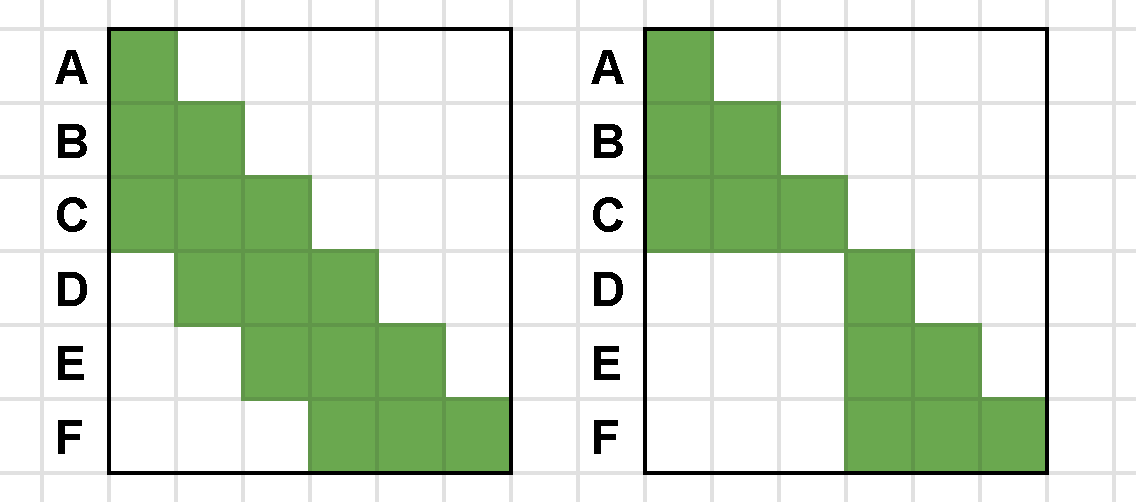
Llama 4 verwendet jetzt auch Chunked Attention - im Wesentlichen Sliding-Window-Attention, jedoch etwas effizienter, da keine Aufmerksamkeit auf frühere Token jenseits der 8192-Grenze gerichtet wird.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/llama-4-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.