> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/deepseek-ocr-how-to-run-and-fine-tune.md).
# DeepSeek-OCR: Wie man ausführt und feinabstimmt
Leitfaden zum lokalen Ausführen und Feinabstimmen von DeepSeek-OCR.
**DeepSeek-OCR** ist ein Vision-Modell mit 3B Parametern für OCR und Dokumentenverständnis. Es verwendet *kontextuelle optische Kompression* um 2D-Layouts in Vision-Token umzuwandeln und so eine effiziente Verarbeitung langer Kontexte zu ermöglichen.
Es kann Tabellen, Dokumente und Handschrift verarbeiten. DeepSeek-OCR erreicht 97 % Genauigkeit und verwendet dabei 10× weniger Vision-Token als Text-Token – und ist damit 10× effizienter als textbasierte LLMs.
Sie können DeepSeek-OCR feinabstimmen, um seine Vision- oder Sprachleistung zu verbessern. In unserem Unsloth [**kostenloses Fine-Tuning-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\).ipynb), haben wir eine [88,26 %ige Verbesserung](#fine-tuning-deepseek-ocr) für das Sprachverständnis.
DeepSeek-OCR ausführenDeepSeek-OCR feinabstimmen
> **Unser Modell-Upload, der Feinabstimmung + mehr Inferenzunterstützung ermöglicht:** [**DeepSeek-OCR**](https://huggingface.co/unsloth/DeepSeek-OCR)
## 🖥️ **DeepSeek-OCR ausführen**
Um das Modell in [vLLM](#vllm-run-deepseek-ocr-tutorial) oder [Unsloth](#unsloth-run-deepseek-ocr-tutorial), hier sind die empfohlenen Einstellungen:
### :gear: Empfohlene Einstellungen
DeepSeek empfiehlt diese Einstellungen:
* **Temperatur = 0.0**
* `max_tokens = 8192`
* `ngram_size = 30`
* `window_size = 90`
### 📖 vLLM: DeepSeek-OCR-Tutorial ausführen
1. Holen Sie sich die neueste `vLLM` über:
```bash
uv venv
source .venv/bin/activate
# Bis zur Veröffentlichung von v0.11.1 müssen Sie vLLM aus dem Nightly Build installieren
uv pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly
```
2. Führen Sie dann den folgenden Code aus:
{% code overflow="wrap" %}
```python
from vllm import LLM, SamplingParams
from vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor
from PIL import Image
# Modellinstanz erstellen
llm = LLM(
model="unsloth/DeepSeek-OCR",
enable_prefix_caching=False,
mm_processor_cache_gb=0,
logits_processors=[NGramPerReqLogitsProcessor]
)
# Eingaben im Batch mit Ihrer Bilddatei vorbereiten
image_1 = Image.open("path/to/your/image_1.png").convert("RGB")
image_2 = Image.open("path/to/your/image_2.png").convert("RGB")
prompt = "\nFree OCR."
model_input = [
{
"prompt": prompt,
"multi_modal_data": {"image": image_1}
},
{
"prompt": prompt,
"multi_modal_data": {"image": image_2}
}
]
sampling_param = SamplingParams(
temperature=0.0,
max_tokens=8192,
# Argumente des N-Gramm-Logit-Processors
extra_args=dict(
ngram_size=30,
window_size=90,
whitelist_token_ids={128821, 128822}, # Whitelist:
,
),
skip_special_tokens=False,
)
# Ausgabe generieren
model_outputs = llm.generate(model_input, sampling_param)
# Ausgabe ausgeben
for output in model_outputs:
print(output.outputs[0].text)
```
{% endcode %}
### 🦥 Unsloth: DeepSeek-OCR-Tutorial ausführen
1. Holen Sie sich die neueste `unsloth` über `pip install --upgrade unsloth` . Wenn Sie Unsloth bereits haben, aktualisieren Sie es über `pip install --upgrade --force-reinstall --no-deps --no-cache-dir unsloth unsloth_zoo`
2. Verwenden Sie dann den folgenden Code, um DeepSeek-OCR auszuführen:
{% code overflow="wrap" %}
```python
from unsloth import FastVisionModel
import torch
from transformers import AutoModel
import os
os.environ["UNSLOTH_WARN_UNINITIALIZED"] = '0'
from huggingface_hub import snapshot_download
snapshot_download("unsloth/DeepSeek-OCR", local_dir = "deepseek_ocr")
model, tokenizer = FastVisionModel.from_pretrained(
"./deepseek_ocr",
load_in_4bit = False, # Verwenden Sie 4-Bit, um den Speicherverbrauch zu reduzieren. False für 16-Bit LoRA.
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth", # True oder "unsloth" für langen Kontext
)
prompt = "\nFreie OCR. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(tokenizer, prompt=prompt, image_file=image_file, output_path = output_path, base_size = 1024, image_size = 640, crop_mode=True, save_results = True, test_compress = False)
```
{% endcode %}
## 🦥 **DeepSeek-OCR feinabstimmen**
Unsloth unterstützt die Feinabstimmung von DeepSeek-OCR. Da das Standardmodell in der neuesten `transformers` Version nicht ausführbar ist, haben wir Änderungen vom [Stranger Vision HF](https://huggingface.co/strangervisionhf) Team übernommen, um dann die Inferenz zu ermöglichen. Wie üblich trainiert Unsloth DeepSeek-OCR 1,4× schneller mit 40 % weniger VRAM und 5× längeren Kontextlängen – ohne Genauigkeitsverlust.\
\
Wir haben zwei kostenlose DeepSeek-OCR-Colab-Notebooks erstellt (mit und ohne Eval):
* DeepSeek-OCR: [Nur-Feinabstimmung-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\).ipynb)
* DeepSeek-OCR: [Notebook für Feinabstimmung + Auswertung](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Deepseek_OCR_\(3B\)-Eval.ipynb) (A100)
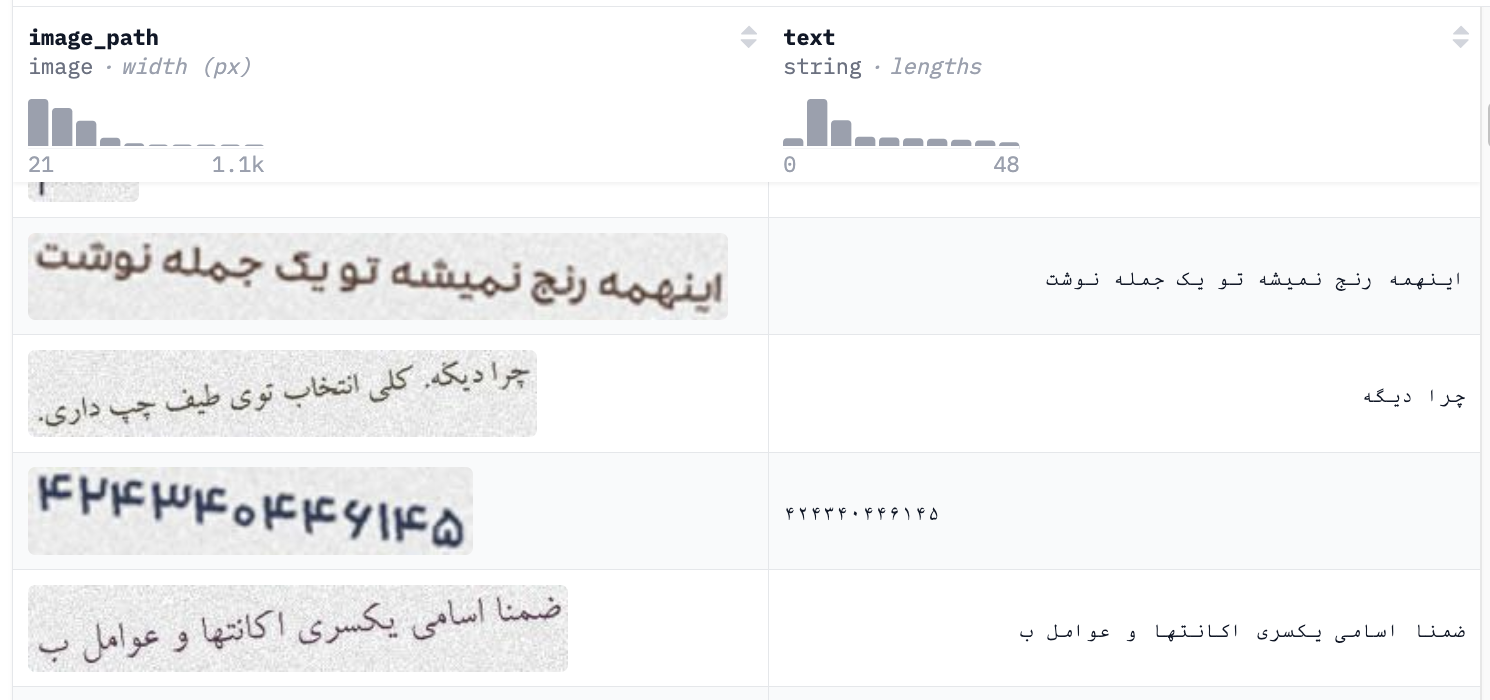
Die Feinabstimmung von DeepSeek-OCR auf einem persischen Datensatz mit 200K Beispielen führte zu erheblichen Verbesserungen bei der Erkennung und dem Verständnis persischer Texte. Wir haben das Basismodell mit unserer feinabgestimmten Version auf 200 persischen Transkript-Beispielen evaluiert und beobachteten eine **88,26 %ige absolute Verbesserung** bei der Character Error Rate (CER). Nach nur 60 Trainingsschritten (Batch-Größe = 8) sank die mittlere CER von **149.07%** auf einen Mittelwert von **60.81%**. Das bedeutet, dass das feinabgestimmte Modell **57%** genauer beim Verstehen von Persisch ist.
Sie können den persischen Datensatz durch Ihren eigenen ersetzen, um DeepSeek-OCR für andere Anwendungsfälle zu verbessern.\
\
Für Eval-Ergebnisse der Replikat-Tabelle verwenden Sie unser obiges Eval-Notebook. Detaillierte Eval-Ergebnisse finden Sie unten:
### Ergebnisse der feinabgestimmten Auswertung:
{% columns fullWidth="true" %}
{% column %}
**DeepSeek-OCR-Basismodell**
Durchschnittliche Leistung des Basismodells: 149,07 % CER für dieses Eval-Set!
```
============================================================
Leistung des Basismodells
============================================================
Anzahl der Beispiele: 200
Mittlere CER: 149,07 %
Median-CER: 80,00 %
Standardabweichung: 310,39 %
Min. CER: 0,00 %
Max. CER: 3500,00 %
============================================================
Beste Vorhersagen (niedrigste CER):
Beispiel 5024 (CER: 0,00 %)
Referenz: چون هستی خیلی زیاد...
Vorhersage: چون هستی خیلی زیاد...
Beispiel 3517 (CER: 0,00 %)
Referenz: تو ایران هیچوقت از اینها وجود نخواهد داشت...
Vorhersage: تو ایران هیچوقت از اینها وجود نخواهد داشت...
Beispiel 9949 (CER: 0,00 %)
Referenz: کاش میدونستم هیچی بیخیال...
Vorhersage: کاش میدونستم هیچی بیخیال...
Schlechteste Vorhersagen (höchste CER):
Beispiel 11155 (CER: 3500,00 %)
Referenz: خسو...
Vorhersage: \[ \text{CH}_3\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}_2\text{CH}...
Beispiel 13366 (CER: 1900,00 %)
Referenz: مشو...
Vorhersage: \[\begin{align*}\underline{\mathfrak{su}}_0\end{align*}\]...
Beispiel 10552 (CER: 1014,29 %)
Referenz: هیییییچ...
Vorhersage: e
```
{% endcolumn %}
{% column %}
**DeepSeek-OCR feinabgestimmt**
Mit 60 Schritten haben wir die CER von 149,07 % auf 60,43 % reduziert (89 % CER-Verbesserung)
============================================================
Leistung des feinabgestimmten Modells
============================================================
Anzahl der Beispiele: 200
Mittlere CER: 60,43 %
Median-CER: 50,00 %
Standardabweichung: 80,63 %
Min. CER: 0,00 %
Max. CER: 916,67 %
============================================================

 Beste Vorhersagen (niedrigste CER):

Beispiel 301 (CER: 0,00 %)
Referenz:  باشه بابا تو لاکچری، تو خاص، تو خفن...
Vorhersage: باشه بابا تو لاکچری، تو خاص، تو خفن...

Beispiel 2512 (CER: 0,00 %)
Referenz:  از شخص حاج عبدالله زنجبیلی میگیرنش...
Vorhersage: از شخص حاج عبدالله زنجبیلی میگیرنش...

Beispiel 2713 (CER: 0,00 %)
Referenz:  نمی دونم والا تحمل نقد ندارن ظاهرا...
Vorhersage: نمی دونم والا تحمل نقد ندارن ظاهرا...

 Schlechteste Vorhersagen (höchste CER):

Beispiel 14270 (CER: 916,67 %)
Referenz:  ۴۳۵۹۴۷۴۷۳۸۹۰...
Vorhersage: پروپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپریپیپریپریپریپریپریپریپریپریپریپریپریپریپریپر...

Beispiel 3919 (CER: 380,00 %)
Referenz:  ۷۵۵۰۷۱۰۶۵۹...
Vorhersage: وادووووووووووووووووووووووووووووووووووو...

Beispiel 3718 (CER: 333,33 %)
Referenz:  ۳۲۶۷۲۲۶۵۵۸۴۶...
Vorhersage: پُپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُسوپُ...
{% endcolumn %}
{% endcolumns %}
Ein Beispiel aus dem von uns verwendeten persischen 200K-Datensatz (Sie können Ihren eigenen verwenden), das das Bild links und den entsprechenden Text rechts zeigt.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/deepseek-ocr-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.