> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/functiongemma.md).
# FunctionGemma: Wie man ausführt und feinabstimmt
Erfahre, wie du FunctionGemma lokal auf deinem Gerät und Telefon ausführst und feinabstimmst.
FunctionGemma ist ein neues Modell mit 270 Mio. Parametern von Google, das für Funktionsaufrufe und Feinabstimmung entwickelt wurde. Basierend auf [Gemma 3](/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune.md) 270M und speziell für textbasiertes Tool-Calling trainiert, macht seine geringe Größe es ideal für die Bereitstellung auf deinem eigenen Telefon.
Du kannst das Modell mit voller Präzision auf **550 MB RAM** (CPU) ausführen, und du kannst jetzt **feinabstimmen** es lokal mit Unsloth ausführen. Vielen Dank an Google DeepMind für die Partnerschaft mit Unsloth und die Unterstützung vom ersten Tag an!
Ausführungs-TutorialFunctionGemma feinabstimmen
* FunctionGemma GGUF zum Ausführen: [unsloth/functiongemma-270m-it-GGUF](https://huggingface.co/unsloth/functiongemma-270m-it-GGUF)
**Kostenlose Notebooks:**
* Feinabstimmen, um **vor Tool-Aufrufen zu denken/begründen** mit unserem [FunctionGemma-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
* Mache **mehrstufiges Tool-Calling** in einem kostenlosen [Notebook für mehrstufiges Tool-Calling](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb)
* Feinabstimmen, um **mobile Aktionen ermöglichen** (Kalender, Timer stellen) in unserem [Notebook für mobile Aktionen](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
### ⚙️ Gebrauchsanleitung
Google empfiehlt diese Einstellungen für die Inferenz:
* `top_k = 64`
* `top_p = 0.95`
* `temperature = 1.0`
* maximale Kontextlänge = `32,768`
Das Chat-Template-Format ergibt sich, wenn wir das folgende verwenden:
{% code overflow="wrap" %}
```python
def get_today_date():
""" Gibt das heutige Datum zurück """
return {"today_date": "18. Dezember 2025"}
tokenizer.apply_chat_template(
[
{"role" : "user", "content" : "Wie lautet das heutige Datum?"},
],
tools = [get_today_date], add_generation_prompt = True, tokenize = False,
)
```
{% endcode %}
#### FunctionGemma-Chatvorlagenformat:
{% hint style="info" %}
FunctionGemma erfordert die System- oder **Entwicklernachricht** als `Du bist ein Modell, das Funktionsaufrufe mit den folgenden Funktionen ausführen kann` Unsloth-Versionen haben dies bereits integriert, falls du vergisst, eine zu übergeben, also verwende bitte [unsloth/functiongemma-270m-it](https://huggingface.co/unsloth/functiongemma-270m-it)
{% endhint %}
{% code overflow="wrap" lineNumbers="true" %}
```
developer\nDu bist ein Modell, das Funktionsaufrufe mit den folgenden Funktionen ausführen kanndeclaration:get_today_date{description:Gibt das heutige Datum zurück,parameters:{type:OBJECT}}\nuser\nWie lautet das heutige Datum?\nmodel\n
```
{% endcode %}
## 🖥️ FunctionGemma ausführen
Siehe unten für eine lokale Desktop-Anleitung oder sieh dir unseren Leitfaden zur Smartphone-Bereitstellung an.
#### Llama.cpp-Tutorial (GGUF):
Anweisungen zur Ausführung in llama.cpp (beachten Sie, dass wir 4-Bit verwenden werden, damit es auf die meisten Geräte passt):
{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
{% endstep %}
{% step %}
Du kannst direkt von Hugging Face ziehen. Da das Modell so klein ist, verwenden wir die unquantisierte BF16-Variante mit voller Präzision.
```bash
./llama.cpp/llama-cli \\
-hf unsloth/functiongemma-270m-it-GGUF:BF16 \
--jinja -ngl 99 --ctx-size 32768 \\
--top-k 64 --top-p 0.95 --temp 1.0
```
{% endstep %}
{% step %}
Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `BF16` oder andere quantisierte Versionen (obwohl es wegen der geringen Modellgröße nicht empfohlen wird, unter 4 Bit zu gehen).
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/functiongemma-270m-it-GGUF",
local_dir = "unsloth/functiongemma-270m-it-GGUF",
allow_patterns = ["*BF16*"],
)
```
{% endstep %}
{% step %}
Führen Sie das Modell dann im Konversationsmodus aus:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/functiongemma-270m-it-GGUF/functiongemma-270m-it-BF16.gguf \
--ctx-size 32768 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--top-k 64 \\
--top-p 0.95 \\
--temp 1.0 \\
--jinja
```
{% endcode %}
{% endstep %}
{% endstepper %}
## 📱 Telefonbereitstellung
Du kannst FunctionGemma aufgrund seiner geringen Größe auch auf deinem Telefon ausführen und bereitstellen. Wir haben mit PyTorch zusammengearbeitet, um einen optimierten Workflow mithilfe von quantisierungsbewusstem Training ([QAT](/docs/de/blog/quantization-aware-training-qat.md)) zu erstellen, um 70 % Genauigkeit wiederherzustellen und sie dann direkt auf Edge-Geräten bereitzustellen.
* Stelle FunctionGemma lokal auf **Pixel 8** und **iPhone 15 Pro** um **Inferenzgeschwindigkeiten von etwa 50 Tokens/s**
* Erhalte datenschutzfreundliche, sofortige Antworten und Offline-Funktionen
* Verwenden Sie unseren [kostenloses Colab-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(0_6B\)-Phone_Deployment.ipynb) um Qwen3 0.6B feinabzustimmen und für die Bereitstellung auf dem Telefon zu exportieren – ändere es einfach zu Gemma3 und folge den [Gemma-3-Executorch-Dokumentation](https://github.com/pytorch/executorch/tree/main/examples/models/gemma3).
{% content-ref url="/pages/86b6f77ee96e4edb00c776189ff1bf5032a3aaeb" %}
[Run LLMs on your Phone](/docs/de/grundlagen/inference-and-deployment/deploy-llms-phone.md)
{% endcontent-ref %}
Sieh dir unsere iOS- und Android-Tutorials an, um sie auf deinem Telefon bereitzustellen:
iOS-TutorialAndroid-Tutorial
## 🦥 FunctionGemma feinabstimmen
Google merkte an, dass **FunctionGemma für Feinabstimmung vorgesehen ist** für deine spezifische Funktionsaufruf-Aufgabe, einschließlich mehrstufiger Anwendungsfälle. Unsloth unterstützt nun das Feinabstimmen von FunctionGemma. Wir haben 2 Feinabstimmungs-Notebooks erstellt, die zeigen, wie du das Modell trainieren kannst über **vollständiges Fine-Tuning oder LoRA kostenlos über ein Colab-Notebook:**
{% columns %}
{% column %}
[**Feinabstimmungs-Notebook für Denken vor Tool-Aufrufen**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[**Feinabstimmungs-Notebook für mobile Aktionen**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
Im [**Feinabstimmungs-Notebook für Denken vor Tool-Aufrufen**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb), werden wir **es so feinabstimmen, dass es vor Funktionsaufrufen „denkt/begründet“**. Chain-of-thought-Reasoning wird zunehmend wichtiger, um die Fähigkeiten zur Tool-Nutzung zu verbessern.
FunctionGemma ist ein kleines Modell, das auf Funktionsaufrufe spezialisiert ist. Es verwendet eine eigene, separate Chat-Vorlage. Wenn ihm Tool-Definitionen und ein Benutzer-Prompt gegeben werden, erzeugt es eine strukturierte Ausgabe. Diese Ausgabe können wir dann parsen, um das Tool auszuführen, die Ergebnisse abzurufen und sie zu verwenden, um die endgültige Antwort zu generieren.
| Turn-Typ | Inhalt |
| ----------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Entwickler-Prompt** |
\developer
Du kannst Funktionsaufrufe mit den folgenden Funktionen ausführen:
|
| **Funktionsdeklaration** |
\declaration:get\_weather{
description: "Wetter für Stadt abrufen",
parameters: { city: STRING }
}
\
\
|
| **Benutzerzug** |
\user
Wie ist das Wetter in Paris?
\
|
| **Funktionsaufruf** |
\model
\call:get\_weather{
city: "paris"
}
\
|
| **Funktionsantwort** |
\response:get\_weather{temperature:26}
\
|
| **Abschluss des Assistenten** |
Das Wetter in Paris liegt bei 26 Grad Celsius.
\
|
Hier implementieren wir mithilfe von ``. Folglich sieht unsere Modellinteraktion so aus:
| **Nachdenken** + **Funktionsaufruf** |
\model
\
Der Benutzer möchte das Wetter für Paris. Ich habe das Tool get\_weather. Ich sollte es mit dem Argument city aufrufen.
\
\call:get\_weather{
city: "paris"
}
\
|
| ------------------------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
## :accordion:FunctionGemma für mobile Aktionen feinabstimmen
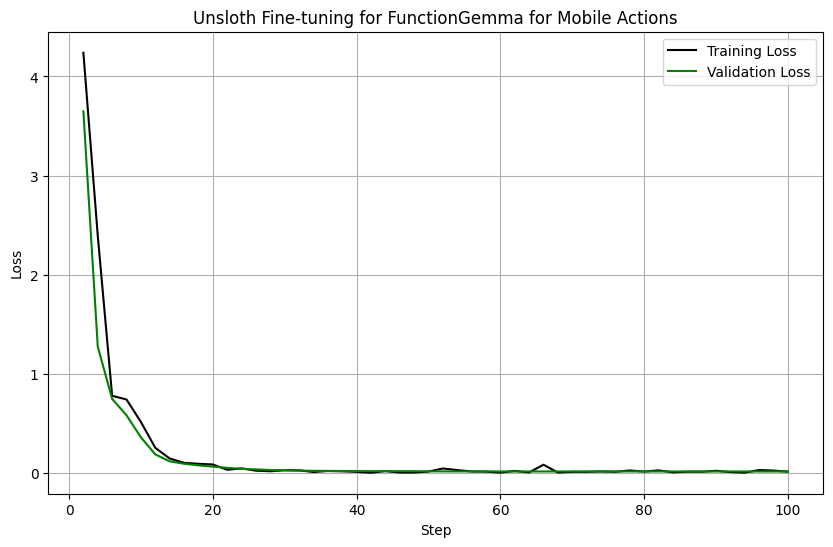
Wir haben auch ein Notebook erstellt, um zu zeigen, wie du FunctionGemma mobile Aktionen ausführen lassen kannst. Im [**Feinabstimmungs-Notebook für mobile Aktionen**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb), haben wir auch die Evaluierung aktiviert und zeigen, wie das Feinabstimmen für On-Device-Aktionen gut funktioniert, wie man daran sieht, dass der Evaluierungsverlust sinkt:
Zum Beispiel bei einem Prompt `Bitte setze eine Erinnerung für ein "Team Sync Meeting" diesen Freitag, den 6. Juni 2025, um 14 Uhr.`
{% code overflow="wrap" %}
```python
[{'role': 'developer',
'content': 'Aktuelles Datum und Uhrzeit im Format YYYY-MM-DDTHH:MM:SS angegeben: 2025-06-04T15:29:23\nWochentag ist Mittwoch\nDu bist ein Modell, das Funktionsaufrufe mit den folgenden Funktionen ausführen kann\n',
'tool_calls': None},
{'role': 'user',
'content': 'Bitte setze eine Erinnerung für ein "Team Sync Meeting" diesen Freitag, den 6. Juni 2025, um 14 Uhr.',
'tool_calls': None}]
```
{% endcode %}
Wir haben das Modell feinabgestimmt, damit es Folgendes ausgeben kann:
{% code overflow="wrap" %}
```
user
Bitte setze eine Erinnerung für ein "Team Sync Meeting" diesen Freitag, den 6. Juni 2025, um 14 Uhr.model
call:create_calendar_event{body:None,datetime:2025-06-06 14:00:00,email:None,first_name:None,last_name:None,phone_number:None,query:None,subject:None,title:Team Sync Meeting,to:None}
```
{% endcode %}
## :man\_running:Mehrstufiges Tool-Calling mit FunctionGemma
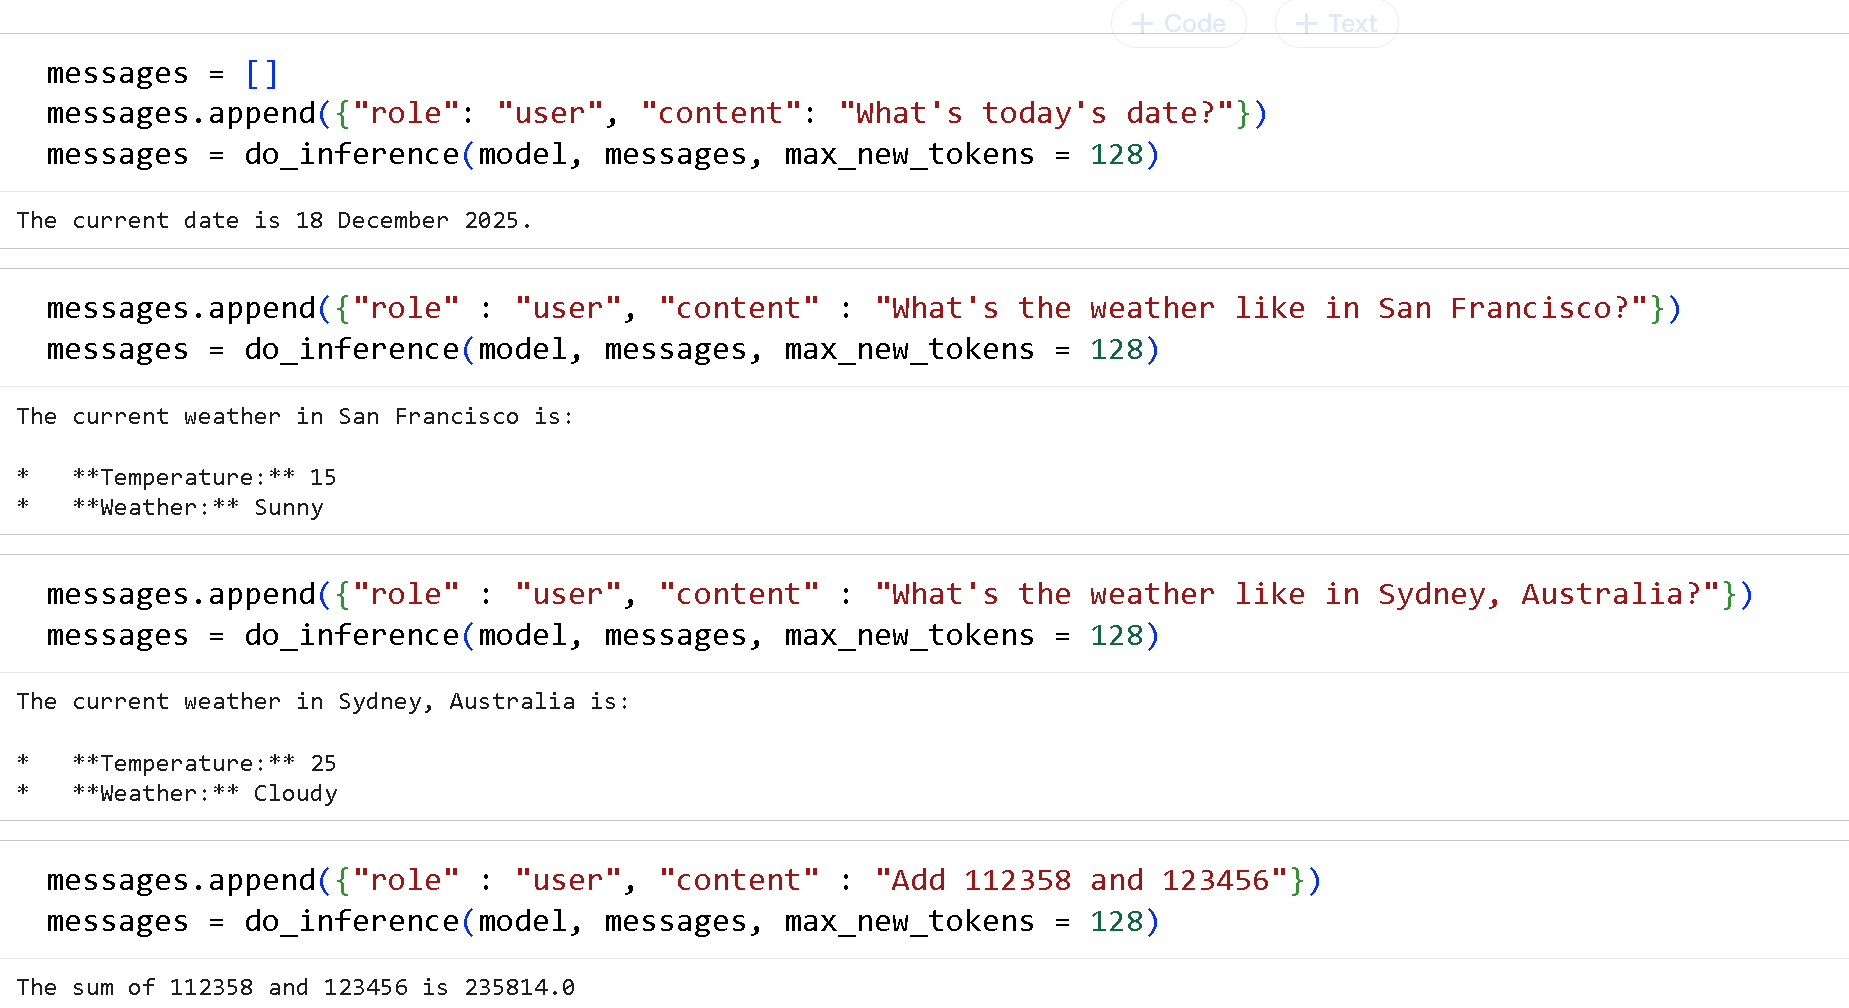
Wir haben auch ein Notebook erstellt, um zu zeigen, wie du FunctionGemma mehrstufige Tool-Aufrufe ausführen lassen kannst. Im [**Notebook für mehrstufiges Tool-Calling**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb), zeigen wir, wie FunctionGemma in einer langen Nachrichtenfolge Tools aufrufen kann, siehe zum Beispiel unten:
Zuerst musst du deine Tools wie unten angeben:
{% code expandable="true" %}
```python
def get_today_date():
"""
Gibt das heutige Datum zurück
Gibt zurück:
today_date: Heutiges Datum im Format 18. Dezember 2025
"""
from datetime import datetime
today_date = datetime.today().strftime("%d %B %Y")
return {"today_date": today_date}
def get_current_weather(location: str, unit: str = "celsius"):
"""
Gibt das aktuelle Wetter an einem gegebenen Ort zurück.
Argumente:
location: Die Stadt und der Staat, z. B. "San Francisco, CA, USA" oder "Sydney, Australien"
unit: Die Einheit, in der die Temperatur zurückgegeben werden soll. (Auswahl: ["celsius", "fahrenheit"] )
Gibt zurück:
temperature: Die aktuelle Temperatur am angegebenen Ort
weather: Das aktuelle Wetter am angegebenen Ort
"""
if "San Francisco" in location.title():
return {"temperature": 15, "weather": "sonnig"}
elif "Sydney" in location.title():
return {"temperature": 25, "weather": "bewölkt"}
else:
return {"temperature": 30, "weather": "regnerisch"}
def add_numbers(x: float | str, y: float | str):
"""
Addiert 2 Zahlen
Argumente:
x: Erste Zahl
y: Zweite Zahl
Gibt zurück:
Ergebnis: x + y
"""
return {"result" : float(x) + float(y)}
def multiply_numbers(x: float | str, y: float | str):
"""
Multipliziert 2 Zahlen miteinander
Argumente:
x: Erste Zahl
y: Zweite Zahl
Gibt zurück:
Ergebnis: x * y
"""
return {"result" : float(x) * float(y)}
```
{% endcode %}
Dann erstellen wir eine Zuordnung für alle Tools:
```python
FUNCTION_MAPPING = {
"get_today_date" : get_today_date,
"get_current_weather" : get_current_weather,
"add_numbers": add_numbers,
"multiply_numbers": multiply_numbers,
}
TOOLS = list(FUNCTION_MAPPING.values())
```
Wir benötigen außerdem etwas Code zum Aufrufen und Parsen der Tools:
{% code expandable="true" %}
```python
#@title FunctionGemma-Parsing-Code (erweiterbar)
import re
def extract_tool_calls(text):
def cast(v):
try: return int(v)
except:
try: return float(v)
except: return {'true': True, 'false': False}.get(v.lower(), v.strip("'\""))
return [{
"name": name,
"arguments": {
k: cast((v1 or v2).strip())
for k, v1, v2 in re.findall(r"(\w+):(?:(.*?)|([^,}]*))", args)
}
} for name, args in re.findall(r"call:(\w+)\{(.*?)\}", text, re.DOTALL)]
def process_tool_calls(output, messages):
calls = extract_tool_calls(output)
if not calls: return messages
messages.append({
"role": "assistant",
"tool_calls": [{"type": "function", "function": call} for call in calls]
})
results = [
{"name": c['name'], "response": FUNCTION_MAPPING[c['name']](**c['arguments'])}
for c in calls
]
messages.append({ "role": "tool", "content": results })
return messages
def _do_inference(model, messages, max_new_tokens = 128):
inputs = tokenizer.apply_chat_template(
messages, tools = TOOLS, add_generation_prompt = True, return_dict = True, return_tensors = "pt",
)
output = tokenizer.decode(inputs["input_ids"][0], skip_special_tokens = False)
out = model.generate(**inputs.to(model.device), max_new_tokens = max_new_tokens,
top_p = 0.95, top_k = 64, temperature = 1.0,)
generated_tokens = out[0][len(inputs["input_ids"][0]):]
return tokenizer.decode(generated_tokens, skip_special_tokens = True)
def do_inference(model, messages, print_assistant = True, max_new_tokens = 128):
output = _do_inference(model, messages, max_new_tokens = max_new_tokens)
messages = process_tool_calls(output, messages)
if messages[-1]["role"] == "tool":
output = _do_inference(model, messages, max_new_tokens = max_new_tokens)
messages.append({"role": "assistant", "content": output})
if print_assistant: print(output)
return messages
```
{% endcode %}
Und jetzt können wir das Modell aufrufen!
```python
from unsloth import FastLanguageModel
import torch
max_seq_length = 4096 # Kann jede beliebige Sequenzlänge wählen!
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/functiongemma-270m-it",
max_seq_length = max_seq_length, # Wähle irgendetwas für langen Kontext!
load_in_4bit = False, # 4-Bit-Quantisierung, um den Speicherverbrauch zu reduzieren
load_in_8bit = False, # [NEU!] Etwas genauer, benötigt doppelt so viel Speicher
load_in_16bit = True, # [NEU!] Aktiviert 16-Bit-LoRA
full_finetuning = False, # [NEW!] We have full finetuning now!
# token = "hf_...", # verwende einen, wenn du gesperrte Modelle nutzt
)
messages = []
messages.append({"role": "user", "content": "Wie lautet das heutige Datum?"})
messages = do_inference(model, messages, max_new_tokens = 128)
```
Probiere die 3 Notebooks aus, die wir für FunctionGemma erstellt haben:
{% columns %}
{% column %}
[Feinabstimmungs-Notebook für Denken vor Tool-Aufrufen](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\).ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[Feinabstimmungs-Notebook für mobile Aktionen](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Mobile-Actions.ipynb)
{% embed url="" %}
{% endcolumn %}
{% column %}
[Notebook für mehrstufiges Tool-Calling](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/FunctionGemma_\(270M\)-Multi-Turn-Tool-Calling.ipynb)
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/functiongemma.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.