> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide.md).
# Leitfaden zur Feinabstimmung von LLMs
Lerne alle Grundlagen und Best Practices des Fine-Tuning. Anfängerfreundlich.
## 1. Was ist Fine-Tuning?
Fine-Tuning / Training / Nachtraining von Modellen individualisiert ihr Verhalten, erweitert und injiziert Wissen und optimiert die Leistung für Domänen und spezifische Aufgaben. Zum Beispiel:
* OpenAIs **GPT-5** wurde nachtrainiert, um das Befolgen von Anweisungen und hilfreiches Chat-Verhalten zu verbessern.
* Die Standardmethode des Nachtrainings heißt Supervised Fine-Tuning (SFT). Andere Methoden umfassen Präferenzoptimierung (DPO, ORPO), Destillation und [Reinforcement Learning (RL)](/docs/de/loslegen/reinforcement-learning-rl-guide.md) (GRPO, GSPO), bei denen ein „Agent“ lernt, Entscheidungen zu treffen, indem er mit einer Umgebung interagiert und **Feedback** in Form von **Belohnungen** oder **Strafen**.
Mit [Unsloth](https://github.com/unslothai/unsloth), Sie können auf Colab, Kaggle oder lokal mit nur 3 GB VRAM kostenlos Feinabstimmung oder RL durchführen, indem Sie unser [Notebooks](https://docs.unsloth.ai/get-started/unsloth-notebooks). Durch das Feinabstimmen eines vortrainierten Modells auf einem Datensatz können Sie:
* **Neue Kenntnisse aktualisieren und lernen**: Neue domänenspezifische Informationen einbringen und lernen.
* **Verhalten anpassen**: Den Ton, die Persönlichkeit oder den Antwortstil des Modells anpassen.
* **Für Aufgaben optimieren**: Die Genauigkeit und Relevanz für bestimmte Anwendungsfälle verbessern.
**Beispiel-Anwendungsfälle für Fine-Tuning oder RL**:
* Ermöglicht LLMs vorherzusagen, ob eine Schlagzeile ein Unternehmen positiv oder negativ beeinflusst.
* Kann historische Kundeninteraktionen für genauere und individuellere Antworten nutzen.
* LLM auf juristischen Texten für Vertragsanalyse, Rechtsprechungsrecherche und Compliance feinabstimmen.
Sie können sich ein feinabgestimmtes Modell als einen spezialisierten Agenten vorstellen, der entwickelt wurde, um bestimmte Aufgaben effektiver und effizienter zu erledigen. **Fine-Tuning kann alle Funktionen von RAG nachbilden**, aber nicht umgekehrt.
{% columns %}
{% column %}
#### :question:Was ist LoRA/QLoRA?
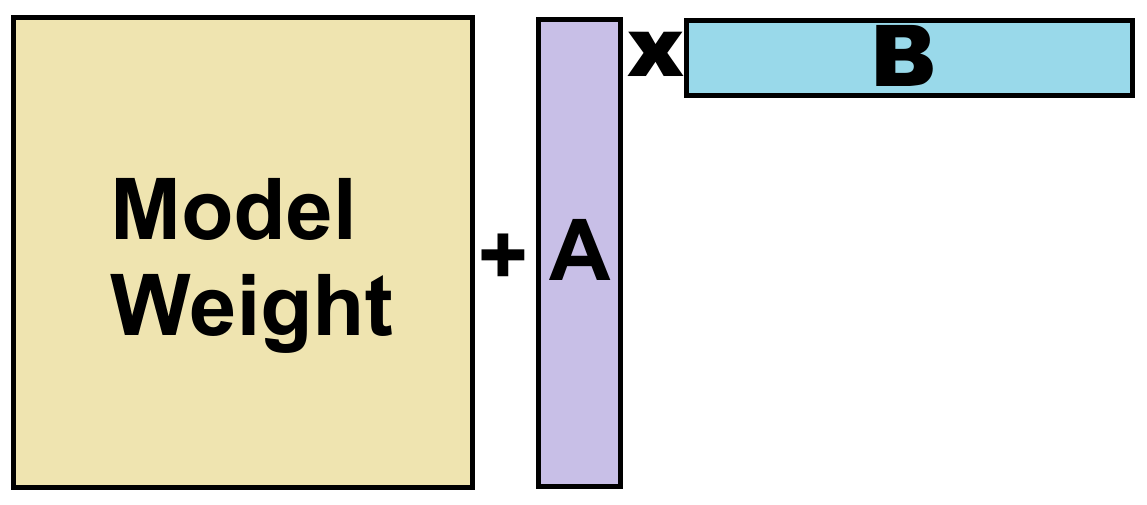
Bei LLMs haben wir Modellgewichte. Llama 70B hat 70 Milliarden Zahlen. Anstatt alle 70 Milliarden Zahlen zu ändern, fügen wir stattdessen jedem Gewicht dünne Matrizen A und B hinzu und optimieren diese. Das bedeutet, dass wir nur 1 % der Gewichte optimieren. LoRA bedeutet, dass das ursprüngliche Modell 16-Bit und nicht quantisiert ist, während QLoRA auf 4-Bit quantisiert, um 75 % Speicher zu sparen.
{% endcolumn %}
{% column %}
Anstatt Modellgewichte (gelb) zu optimieren, optimieren wir 2 dünne Matrizen A und B.
{% endcolumn %}
{% endcolumns %}
#### Missverständnisse beim Fine-Tuning:
Vielleicht haben Sie gehört, dass Fine-Tuning ein Modell kein neues Wissen lernen lässt oder dass RAG besser als Fine-Tuning abschneidet. Das ist **false**nicht der Fall. Sie können mit Fine-Tuning und RL ein spezialisiertes Codierungsmodell trainieren, während RAG die Gewichte des Modells nicht ändern kann und nur das ergänzt, was das Modell zur Inferenzzeit sieht. Lesen Sie mehr zu FAQ + Missverständnissen [hier](https://unsloth.ai/docs/de/loslegen/pages/247e762fc931f96d3998ecfa1a4402cf524e9e97#fine-tuning-vs.-rag-whats-the-difference):
{% content-ref url="/pages/247e762fc931f96d3998ecfa1a4402cf524e9e97" %}
[FAQ + Ist Fine-Tuning das Richtige für mich?](/docs/de/loslegen/fine-tuning-for-beginners/faq-+-is-fine-tuning-right-for-me.md)
{% endcontent-ref %}
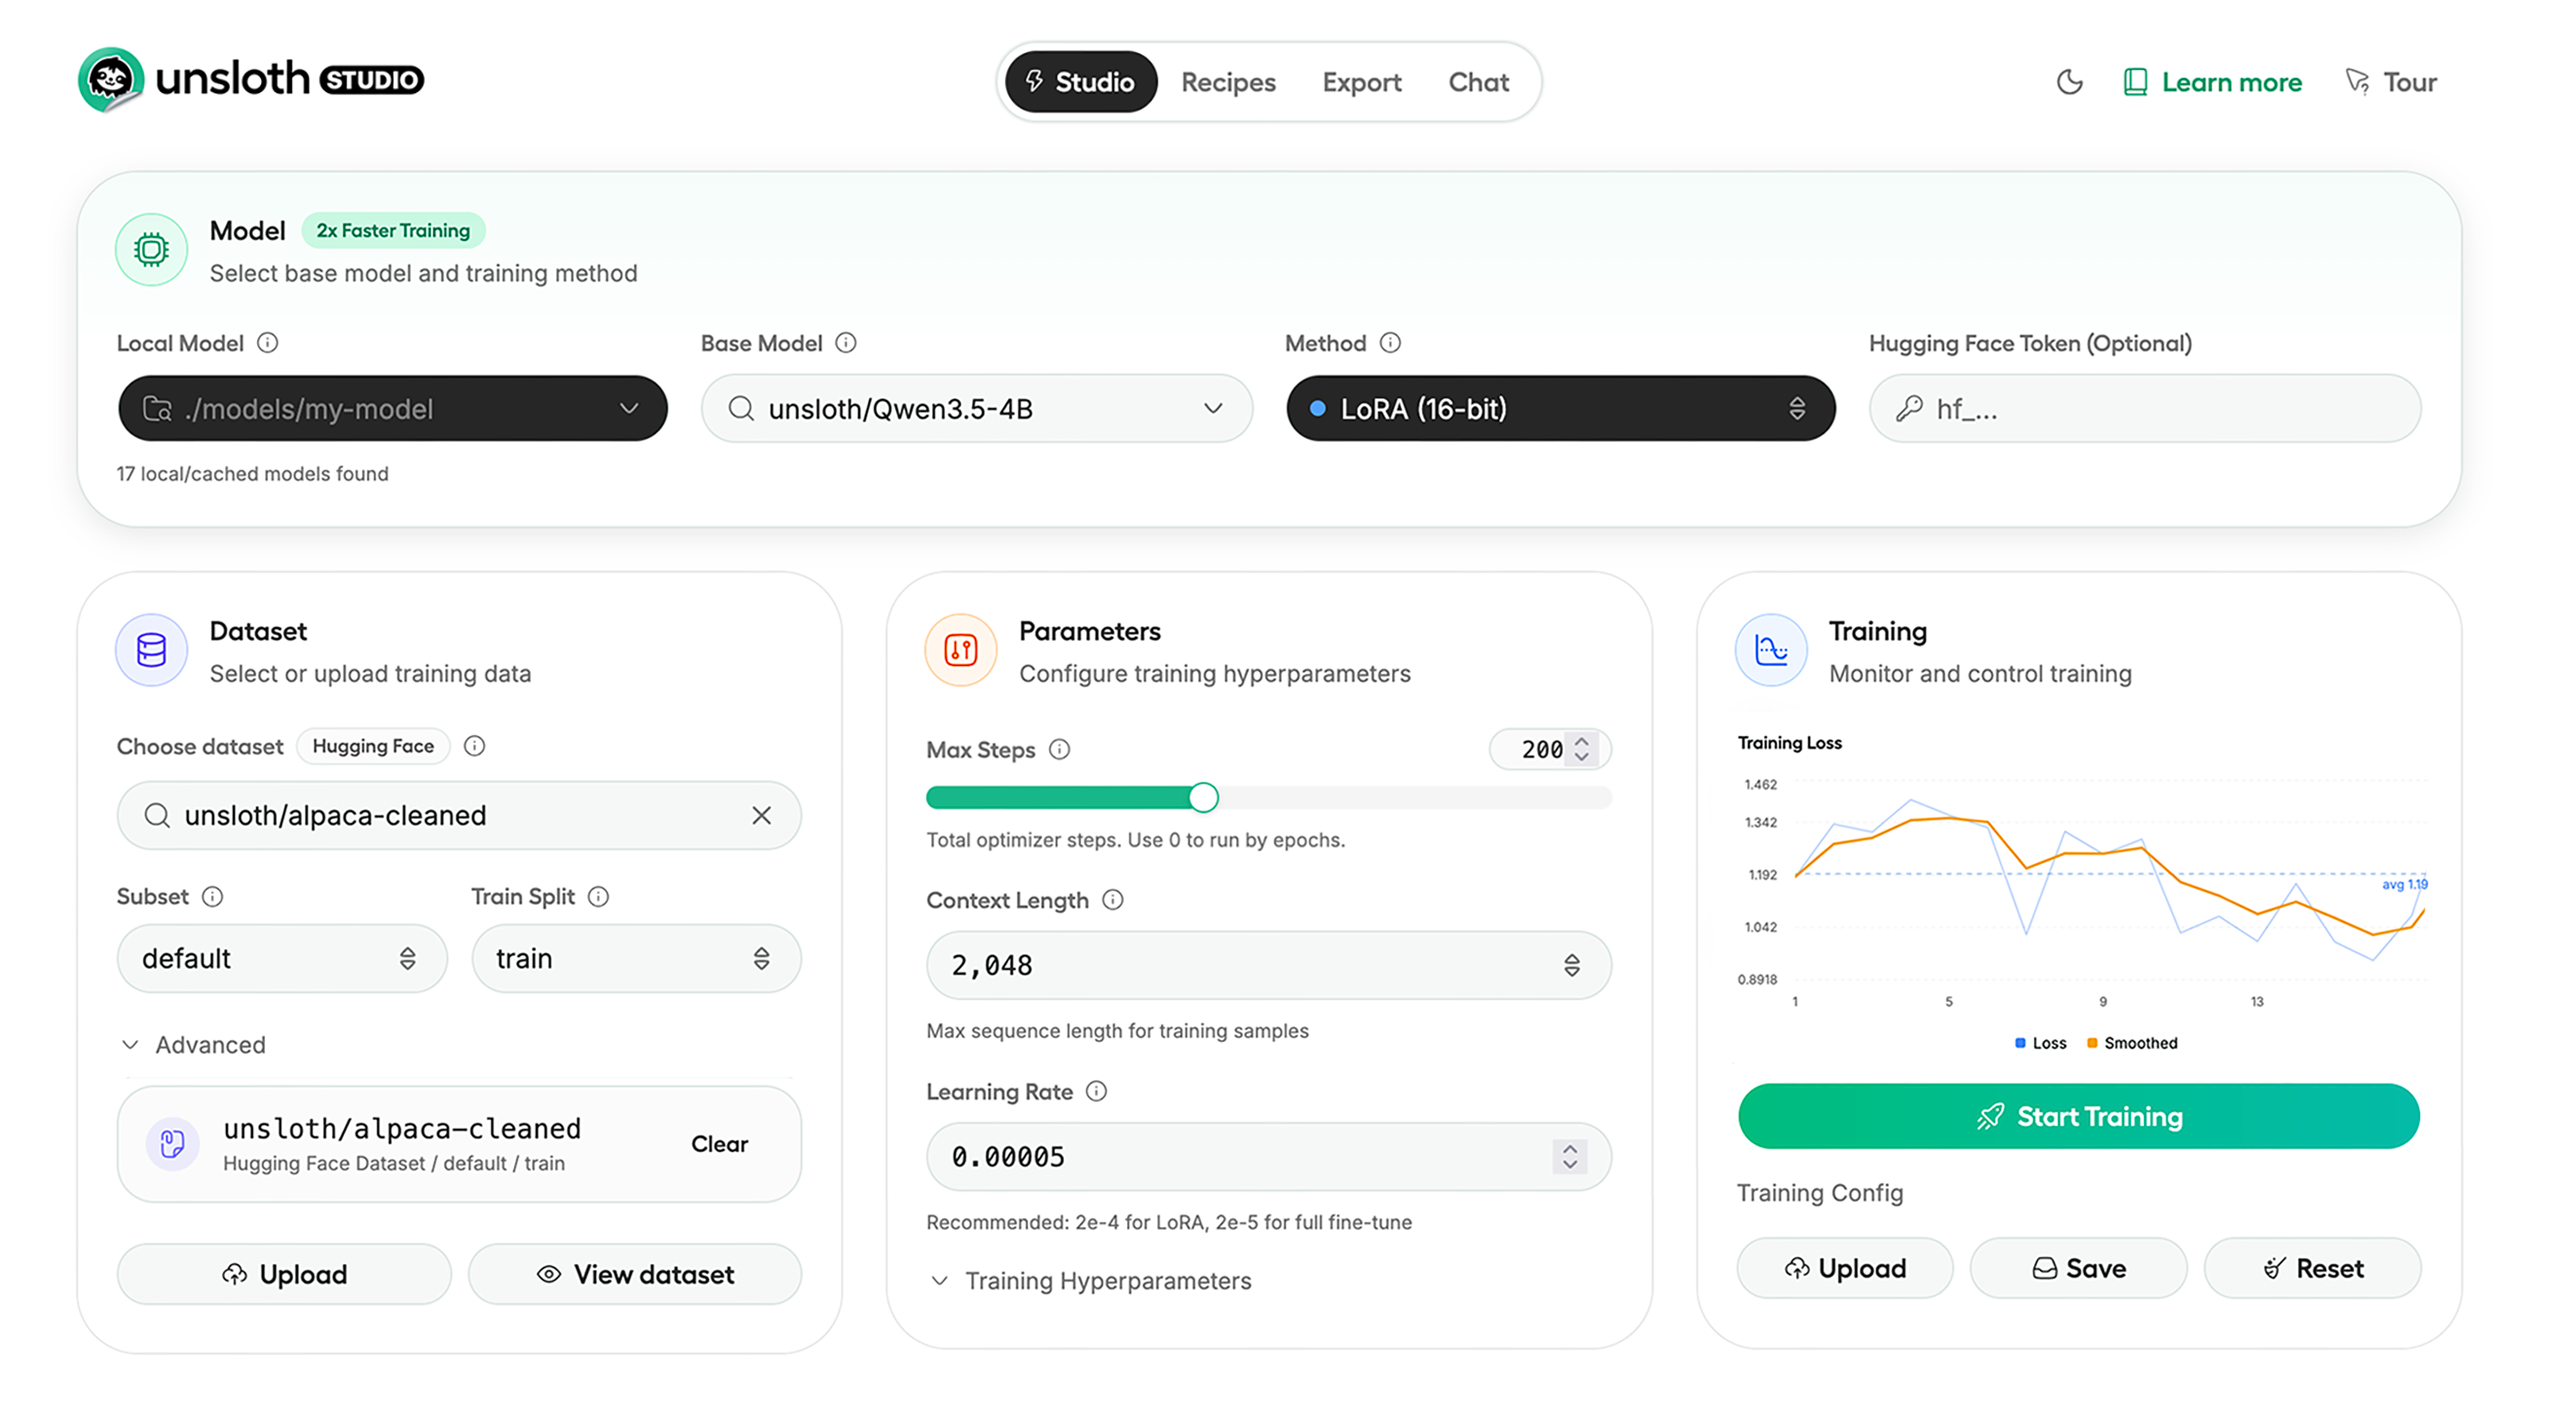
> [**Wir stellen Unsloth Studio vor:** ](/docs/de/neu/studio.md) Unsere neue Open-Source-Weboberfläche zum Trainieren und Ausführen von Modellen. Das bedeutet, dass Sie Modelle jetzt per No-Code feinabstimmen können und über Beobachtbarkeit sowie automatische Funktionen zur Datensatz-Erstellung verfügen.
## 2. Wählen Sie das richtige Modell + die richtige Methode
Wenn Sie Anfänger sind, ist es am besten, mit einem kleinen Instruct-Modell wie Llama 3.1 (8B) zu beginnen und von dort aus zu experimentieren. Sie müssen außerdem zwischen normalem Fine-Tuning, RL, QLoRA- oder LoRA-Training entscheiden:
* **Reinforcement Learning (RL)** wird verwendet, wenn Sie ein Modell dazu benötigen, bei einem bestimmten Verhalten (z. B. Tool-Calling) mithilfe einer Umgebung und einer Belohnungsfunktion statt gelabelter Daten zu überzeugen. Wir haben mehrere [Notebook-Beispiele](/docs/de/loslegen/unsloth-notebooks.md#grpo-reasoning-rl-notebooks), aber für die meisten Anwendungsfälle reicht standardmäßiges SFT aus.
* **LoRA** ist eine parameter-effiziente Trainingsmethode, die typischerweise die Gewichte des Basismodells einfriert und eine kleine Menge hinzugefügter Low-Rank-Adaptergewichte trainiert (in 16-Bit-Präzision).
* **QLoRA** kombiniert LoRA mit 4-Bit-Präzision, um sehr große Modelle mit minimalen Ressourcen zu verarbeiten.
* Unsloth unterstützt außerdem Full Fine-Tuning (FFT) und Pretraining, die deutlich mehr Ressourcen erfordern, aber FFT ist meist unnötig. Bei korrekter Anwendung kann LoRA FFT erreichen.
* Unsloth **alle Modelltypen**: [Text-to-Speech](/docs/de/grundlagen/text-to-speech-tts-fine-tuning.md), [Embedding](/docs/de/grundlagen/embedding-finetuning.md), GRPO, RL, [Vision](/docs/de/grundlagen/vision-fine-tuning.md), multimodal und mehr.
{% hint style="info" %}
Die Forschung zeigt, dass **Training und Bereitstellung in derselben Präzision** dazu beiträgt, die Genauigkeit zu erhalten. Das bedeutet: Wenn Sie in 4-Bit bereitstellen möchten, trainieren Sie in 4-Bit und umgekehrt.
{% endhint %}
Wir empfehlen, mit QLoRA zu beginnen, da es eine der zugänglichsten und effektivsten Methoden zum Training von Modellen ist. Unsere [dynamischen 4-Bit](https://unsloth.ai/blog/dynamic-4bit) Quantisierungen haben den Genauigkeitsverlust von QLoRA im Vergleich zu LoRA inzwischen weitgehend ausgeglichen.
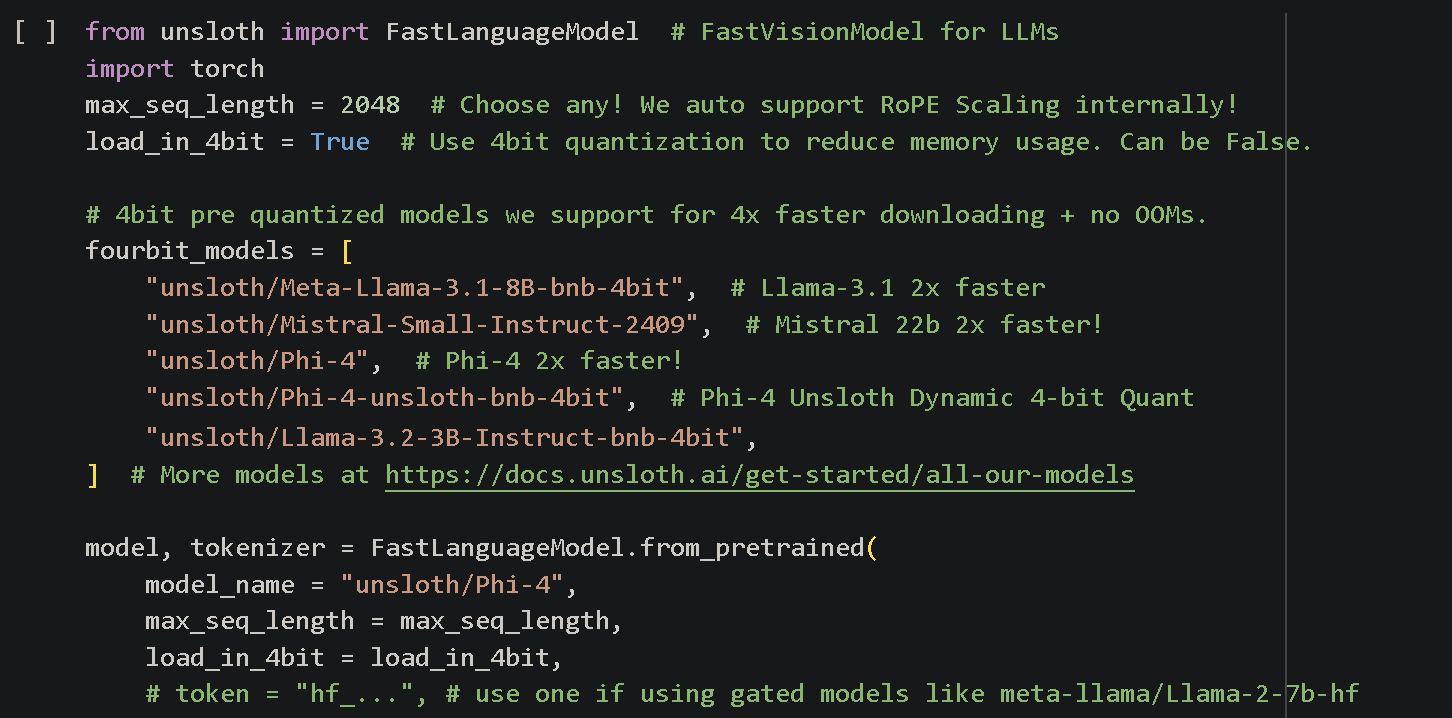
Sie können den Modellnamen in jeden gewünschten Modellnamen ändern, indem Sie ihn mit dem Modellnamen auf Hugging Face abgleichen, z. B. „`unsloth/llama-3.1-8b-unsloth-bnb-4bit`'.
Wir empfehlen, mit **Instruct-Modellen**zu beginnen, da sie ein direktes Fine-Tuning mithilfe dialogorientierter Chat-Vorlagen (ChatML, ShareGPT usw.) ermöglichen und im Vergleich zu **Base-Modellen** (die Alpaca, Vicuna usw. verwenden) weniger Daten benötigen. Erfahren Sie hier mehr über die Unterschiede zwischen [Instruct- und Base-Modellen](/docs/de/loslegen/fine-tuning-llms-guide/what-model-should-i-use.md#instruct-or-base-model).
* Modellnamen, die auf **`unsloth-bnb-4bit`** enden, zeigen an, dass es sich um [**Unsloth-dynamische 4-Bit-**](https://unsloth.ai/blog/dynamic-4bit) **Quantisierungen**handelt. Diese Modelle verbrauchen etwas mehr VRAM als standardmäßige BitsAndBytes-4-Bit-Modelle, bieten jedoch eine deutlich höhere Genauigkeit.
* Wenn ein Modellname nur mit **`bnb-4bit`**endet, ohne „unsloth“, bezieht sich das auf eine standardmäßige BitsAndBytes-4-Bit-Quantisierung.
* Modelle mit **keinem Suffix** liegen in ihrem ursprünglichen **16-Bit- oder 8-Bit-Formaten**vor. Obwohl es sich um die ursprünglichen Modelle der offiziellen Modellentwickler handelt, fügen wir manchmal wichtige Korrekturen hinzu – etwa für die Chat-Vorlage oder den Tokenizer. Daher wird empfohlen, unsere Versionen zu verwenden, wenn sie verfügbar sind.
Es gibt weitere Einstellungen, die Sie umschalten können:
* **`max_seq_length = 2048`** – Steuert die Kontextlänge. Während Llama-3 8192 unterstützt, empfehlen wir zum Testen 2048. Unsloth ermöglicht Fine-Tuning mit 4× längerem Kontext.
* **`dtype = None`** – Standardmäßig None; verwenden Sie `torch.float16` oder `torch.bfloat16` für neuere GPUs.
* **`load_in_4bit = True`** – Aktiviert 4-Bit-Quantisierung und reduziert den Speicherverbrauch für Fine-Tuning um das Vierfache. Das Deaktivieren ermöglicht LoRA-Feinabstimmung in 16-Bit. Sie können 16-Bit-LoRA auch mit `load_in_16bit = True`
* Um vollständiges Fine-Tuning (FFT) zu aktivieren, setzen Sie `full_finetuning = True`. Für 8-Bit-Fine-Tuning setzen Sie `load_in_8bit = True`.
* **Hinweis:** Es kann jeweils nur eine Trainingsmethode auf `Wahr` gesetzt werden.
{% hint style="info" %}
Ein häufiger Fehler ist es, direkt mit Full Fine-Tuning (FFT) zu beginnen, was rechenintensiv ist. Testen Sie zunächst LoRA oder QLoRA; wenn es dort nicht funktioniert, wird es mit FFT mit ziemlicher Sicherheit auch nicht funktionieren. Und wenn LoRA scheitert, gehen Sie nicht davon aus, dass FFT es magisch behebt.
{% endhint %}
Sie können auch [Text-to-Speech (TTS)](/docs/de/grundlagen/text-to-speech-tts-fine-tuning.md), [Reasoning (GRPO)](/docs/de/loslegen/reinforcement-learning-rl-guide.md), [Vision](/docs/de/grundlagen/vision-fine-tuning.md), [RL](/docs/de/loslegen/reinforcement-learning-rl-guide/preference-dpo-orpo-and-kto.md) (GRPO, DPO), [kontinuierliches Pretraining](/docs/de/grundlagen/continued-pretraining.md), Textvervollständigung und andere Trainingsmethoden mit Unsloth durchführen.
{% columns %}
{% column %}
Lesen Sie unseren Leitfaden zur Modellauswahl:
{% content-ref url="/pages/e74e48e68b0d725224ca82d9e12183f70ec3dd62" %}
[What Model Should I Use?](/docs/de/loslegen/fine-tuning-llms-guide/what-model-should-i-use.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
Für einzelne Tutorials zu Modellen:
{% content-ref url="/pages/9b29615ab338f1d1924174468718cfeab406f641" %}
[Complete LLM Directory](/docs/de/modelle/tutorials.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
## 3. Ihr Datensatz
Für LLMs sind Datensätze Sammlungen von Daten, die zum Trainieren unserer Modelle verwendet werden können. Damit Textdaten für das Training nützlich sind, müssen sie in einem Format vorliegen, das tokenisiert werden kann.
* Sie müssen in der Regel einen Datensatz mit 2 Spalten erstellen – Frage und Antwort. Qualität und Umfang spiegeln das Endergebnis Ihrer Feinabstimmung weitgehend wider, daher ist es unerlässlich, diesen Teil richtig zu machen.
* Sie können [synthetisch Daten erzeugen](/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md#synthetic-data-generation) und Ihren Datensatz (in QA-Paare) mithilfe von ChatGPT oder lokalen LLMs strukturieren.
* Sie können auch unser neues Notebook für synthetische Datensätze verwenden, das automatisch Dokumente (PDFs, Videos usw.) analysiert, QA-Paare erzeugt und Daten mit lokalen Modellen wie Llama 3.2 automatisch bereinigt. [Greifen Sie hier auf das Notebook zu.](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Meta_Synthetic_Data_Llama3_2_\(3B\).ipynb)
* Fine-Tuning kann aus einem vorhandenen Dokumentenbestand lernen und seine Wissensbasis kontinuierlich erweitern, aber einfach nur Daten hineinzukippen funktioniert nicht so gut. Für optimale Ergebnisse erstellen Sie einen gut strukturierten Datensatz, idealerweise als Frage-Antwort-Paare. Das verbessert Lernen, Verständnis und Antwortgenauigkeit.
* Aber das ist nicht immer der Fall, z. B. wenn Sie ein LLM für Code feinabstimmen, kann es tatsächlich große Leistungsverbesserungen ermöglichen, wenn Sie einfach alle Ihre Codedaten hineinkippen, selbst ohne strukturierte Formatierung. Es hängt also wirklich von Ihrem Anwendungsfall ab.
***Lesen Sie mehr darüber, wie Sie Ihren Datensatz erstellen:***
{% content-ref url="/pages/079b6ad30e8c25b4a6caae0d2dc5378a166d54c9" %}
[Datensatz-Leitfaden](/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md)
{% endcontent-ref %}
Für die meisten unserer Notebook-Beispiele verwenden wir den [Alpaca-Datensatz](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset) allerdings verwenden andere Notebooks wie Vision unterschiedliche Datensätze, die möglicherweise auch Bilder in der Antwortausgabe benötigen.
### 4. Trainings-Hyperparameter verstehen
Lernen Sie, wie Sie die richtigen [Hyperparameter](/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md) mithilfe bewährter Verfahren aus Forschung und Praxistests auswählen – und verstehen Sie, wie sich jeder einzelne auf die Leistung Ihres Modells auswirkt.
**Für eine vollständige Anleitung dazu, wie Hyperparameter das Training beeinflussen, siehe:**
{% content-ref url="/pages/ce825bbf83c91ef73a7fc71d696bd3d1ecc78590" %}
[Hyperparameters Guide](/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md)
{% endcontent-ref %}
## 5. Installation + Anforderungen
Sie können Unsloth auf zwei Hauptarten verwenden: über unsere kostenlosen Notebooks oder lokal.
### Unsloth Notebooks
Wir empfehlen Anfängern, unsere vorgefertigten [Notebooks](/docs/de/loslegen/unsloth-notebooks.md) zuerst zu nutzen, da dies der einfachste Weg ist, mit geführten Schritten zu starten. Sie können die Notebooks später exportieren, um sie lokal zu verwenden.
Unsloth hat Schritt-für-Schritt-Notebooks für [Text-to-Speech](/docs/de/grundlagen/text-to-speech-tts-fine-tuning.md), [Embedding](/docs/de/grundlagen/embedding-finetuning.md), GRPO, RL, [Vision](/docs/de/grundlagen/vision-fine-tuning.md), multimodal, verschiedene Anwendungsfälle und mehr.
### Lokale Installation
Sie können Unsloth auch lokal installieren über [Docker](/docs/de/loslegen/install/docker.md) oder `installieren.` (mit Linux, WSL oder [Windows](/docs/de/loslegen/install/windows-installation.md)). Außerdem benötigen Sie je nach verwendetem Modell ausreichend VRAM und Ressourcen.
Die Installation von Unsloth erfordert ein Windows- oder Linux-Gerät. Sobald Sie Unsloth installiert haben, können Sie unsere Notebooks kopieren und einfügen und sie in Ihrer eigenen lokalen Umgebung verwenden. Siehe:
{% columns %}
{% column %}
{% content-ref url="/pages/53df1382354c7ace1c37120c4af6ed50511854dd" %}
[Unsloth-Anforderungen](/docs/de/loslegen/fine-tuning-for-beginners/unsloth-requirements.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
{% content-ref url="/pages/fd362a47f0e8cc55190dad52421d6fe66df3a5cb" %}
[Installation](/docs/de/loslegen/install.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
## 6. Training + Evaluierung
Sobald alles eingerichtet ist, ist es Zeit zu trainieren! Wenn etwas nicht funktioniert, denken Sie daran, dass Sie jederzeit Hyperparameter, Ihren Datensatz usw. ändern können.
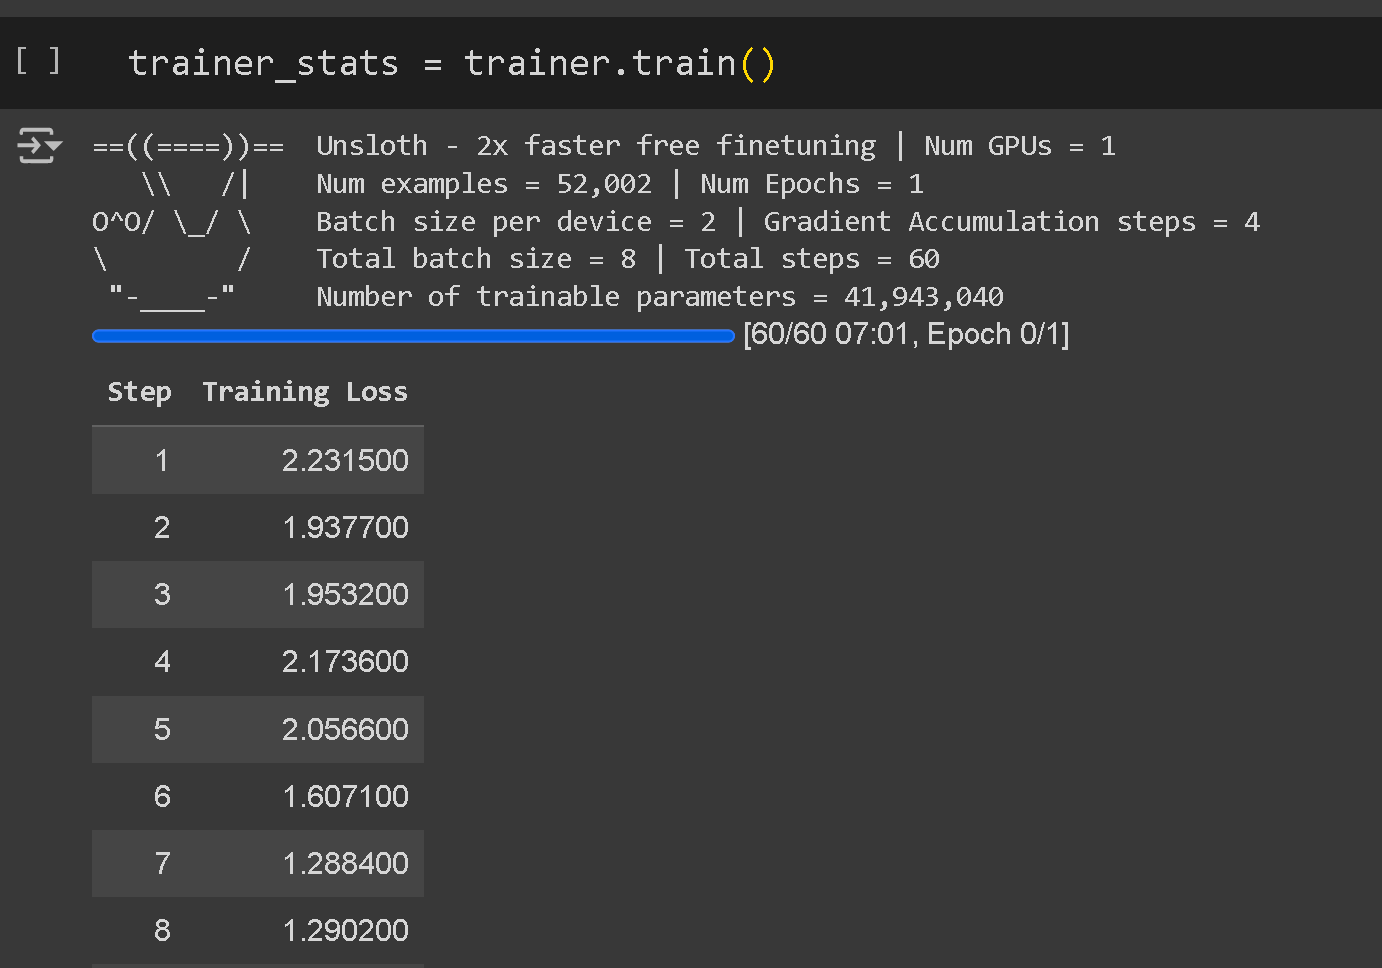
Während des Trainings siehst du ein Protokoll mit Zahlen. Das ist der Trainingsverlust, der zeigt, wie gut das Modell aus deinem Datensatz lernt. In vielen Fällen ist ein Verlust von etwa 0,5 bis 1,0 ein gutes Zeichen, aber das hängt von deinem Datensatz und deiner Aufgabe ab. Wenn der Verlust nicht sinkt, musst du vielleicht deine Einstellungen anpassen. Wenn der Verlust auf 0 geht, könnte das auf Overfitting hindeuten, daher ist es wichtig, auch die Validierung zu prüfen.
Der Trainingsverlust wird als Zahlen angezeigt
Wir empfehlen generell, die Standardeinstellungen beizubehalten, sofern Sie kein längeres Training oder größere Batchgrößen benötigen.
* **`per_device_train_batch_size = 2`** – Für eine bessere GPU-Auslastung erhöhen, aber Vorsicht vor langsamerem Training aufgrund von Padding. Erhöhen Sie stattdessen `gradient_accumulation_steps` für ein reibungsloseres Training.
* **`gradient_accumulation_steps = 4`** – Simuliert eine größere Batchgröße, ohne den Speicherverbrauch zu erhöhen.
* **`max_steps = 60`** – Beschleunigt das Training. Für vollständige Durchläufe ersetzen durch `num_train_epochs = 1` (1–3 Epochen empfohlen, um Überanpassung zu vermeiden).
* **`learning_rate = 2e-4`** – Niedriger für langsameres, aber präziseres Fine-Tuning. Probieren Sie Werte wie `1e-4`, `5e-5`, oder `2e-5`.
#### Evaluierung
Zur Evaluierung können Sie eine manuelle Bewertung durchführen, indem Sie einfach mit dem Modell chatten und sehen, ob es Ihnen gefällt. Sie können die Evaluierung auch für Unsloth aktivieren, aber beachten Sie, dass dies je nach Datensatzgröße zeitaufwendig sein kann. Um die Evaluierung zu beschleunigen, können Sie: die Größe des Evaluierungsdatensatzes reduzieren oder setzen `evaluation_steps = 100`.
Zum Testen können Sie auch 20 % Ihrer Trainingsdaten nehmen und diese zum Testen verwenden. Wenn Sie bereits alle Trainingsdaten verwendet haben, müssen Sie es manuell evaluieren. Sie können auch automatische Eval-Tools verwenden, aber beachten Sie, dass automatisierte Tools möglicherweise nicht perfekt mit Ihren Evaluierungskriterien übereinstimmen.
## 7. Ausführen + Bereitstellen des Modells
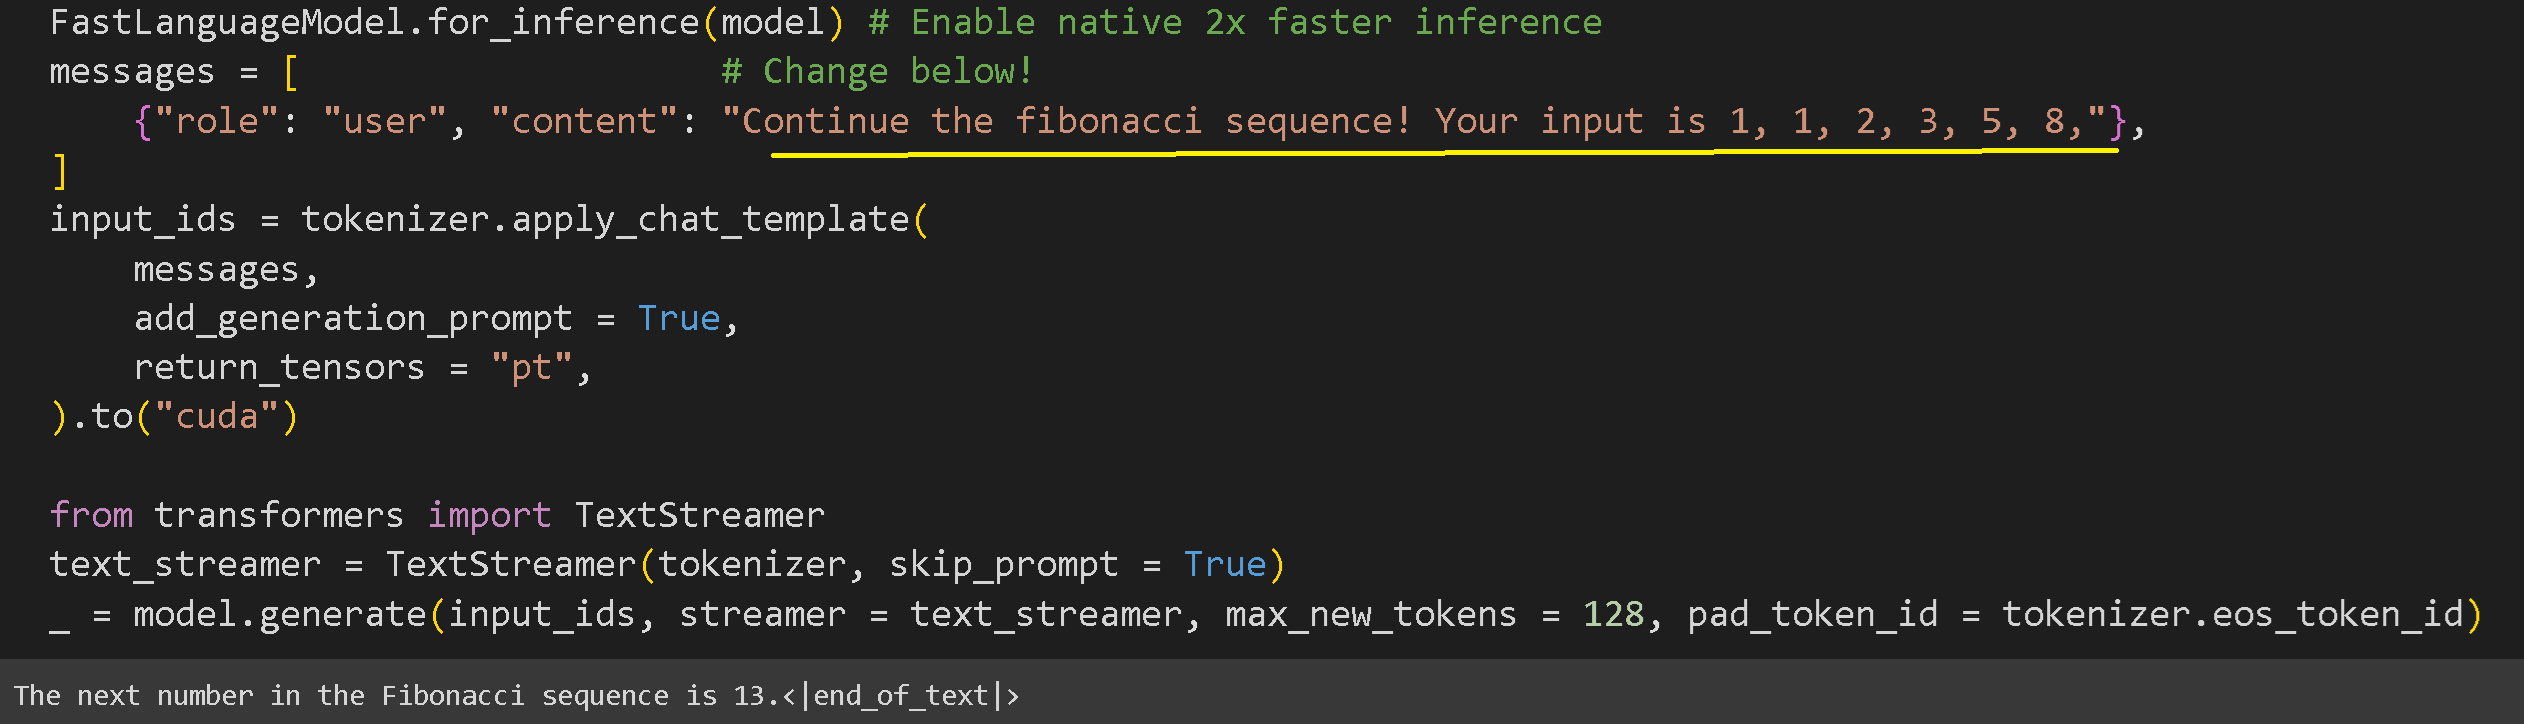
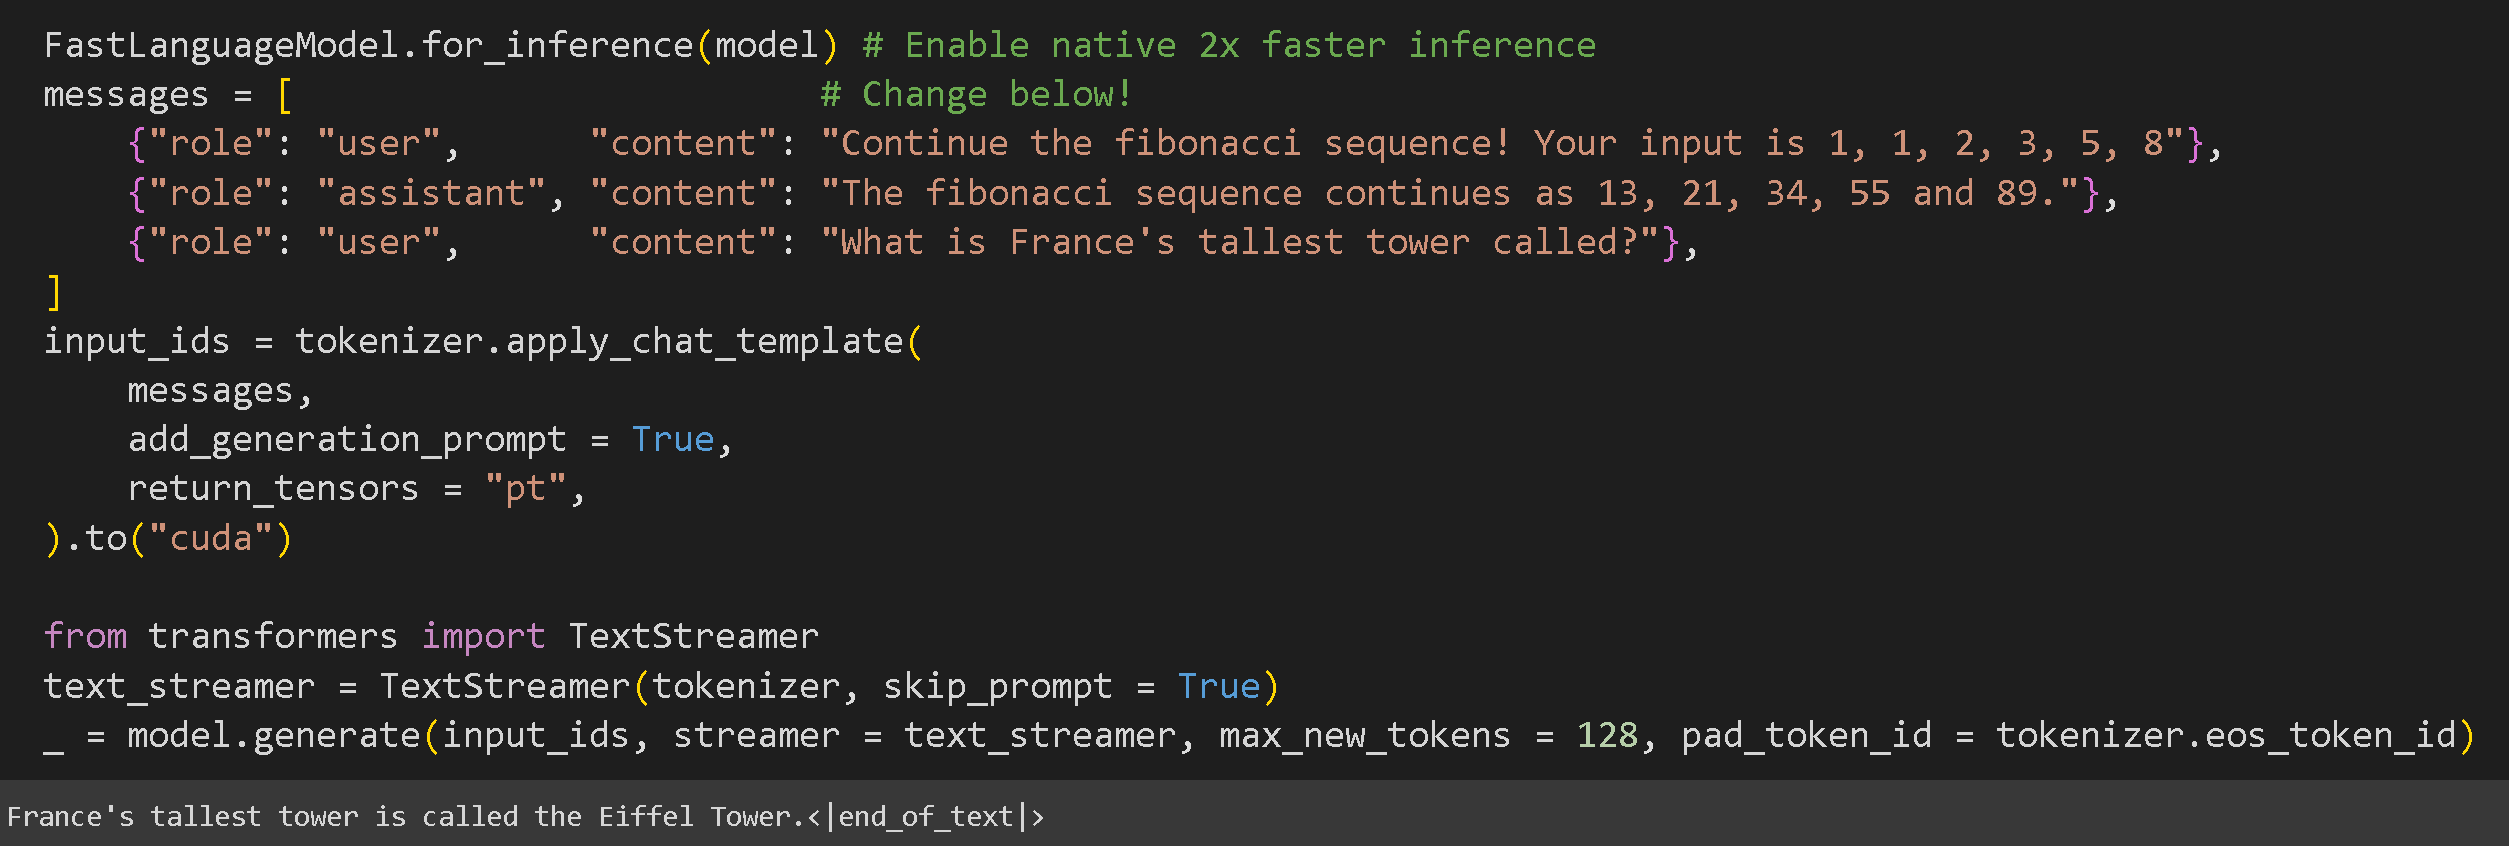
Lass uns jetzt das Modell ausführen, nachdem wir den Trainingsprozess abgeschlossen haben! Du kannst den gelb unterstrichenen Teil bearbeiten! Da wir tatsächlich einen Mehrturnus-Chatbot erstellt haben, können wir das Modell jetzt auch so aufrufen, als hätte es einige Konversationen in der Vergangenheit gesehen, wie unten:
Zur Erinnerung: Unsloth bietet selbst **2x schnellere Inferenz** nativ ebenfalls an, also vergiss nie, aufzurufen `FastLanguageModel.for_inference(model)`. Wenn du möchtest, dass das Modell längere Antworten ausgibt, setze `max_new_tokens = 128` auf eine größere Zahl wie 256 oder 1024. Beachte, dass du dann auch länger auf das Ergebnis warten musst!
### Speichern + Bereitstellung
Um Ihr Modell in gewünschten Inferenz-Engines wie Ollama, vLLM oder Open WebUI zu speichern und bereitzustellen, müssen Sie den LoRA-Adapter zusätzlich zum Basismodell verwenden. Wir haben spezielle Anleitungen für jedes Framework:
{% content-ref url="/pages/03532de69dfe0230fe5114e809721d8b7dd74ca6" %}
[Inferenz & Bereitstellung](/docs/de/grundlagen/inference-and-deployment.md)
{% endcontent-ref %}
{% columns %}
{% column %}
Wenn Sie Inferenz auf einem einzelnen Gerät (wie einem Laptop oder Mac) ausführen, verwenden Sie llama.cpp, um in das GGUF-Format zu konvertieren und es in Ollama, llama.cpp, LM Studio usw. zu nutzen:
{% content-ref url="/pages/9cfeafb2cc359999e3a7f6ba6ffa5468e4752653" %}
[GGUF & llama.cpp](/docs/de/grundlagen/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
Wenn Sie ein LLM für Enterprise- oder Multi-User-Inferenz für FP8, AWQ bereitstellen, verwenden Sie vLLM:
{% content-ref url="/pages/af094159d1c157db0d9afc00bd98b849fcdb8f0c" %}
[vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
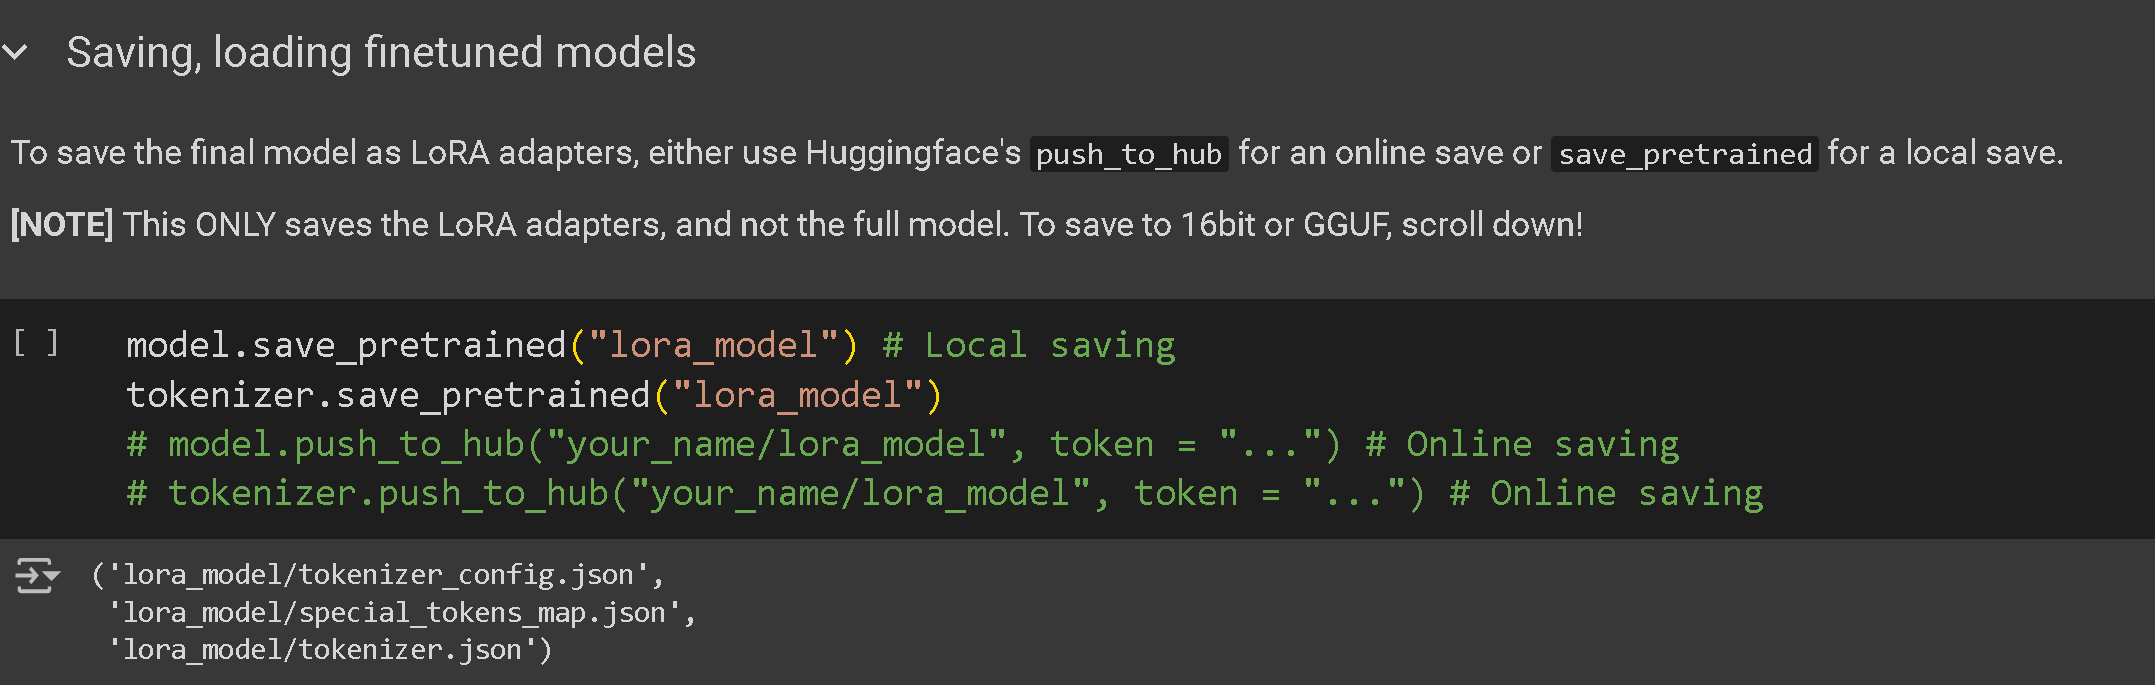
Wir können das feinabgestimmte Modell jetzt als kleine 100-MB-Datei namens LoRA-Adapter speichern, wie unten gezeigt. Sie können es stattdessen auch auf den Hugging-Face-Hub hochladen, wenn Sie Ihr Modell hochladen möchten! Denken Sie daran, ein Hugging Face [Token](https://huggingface.co/settings/tokens) und fügen Sie Ihren Token hinzu!
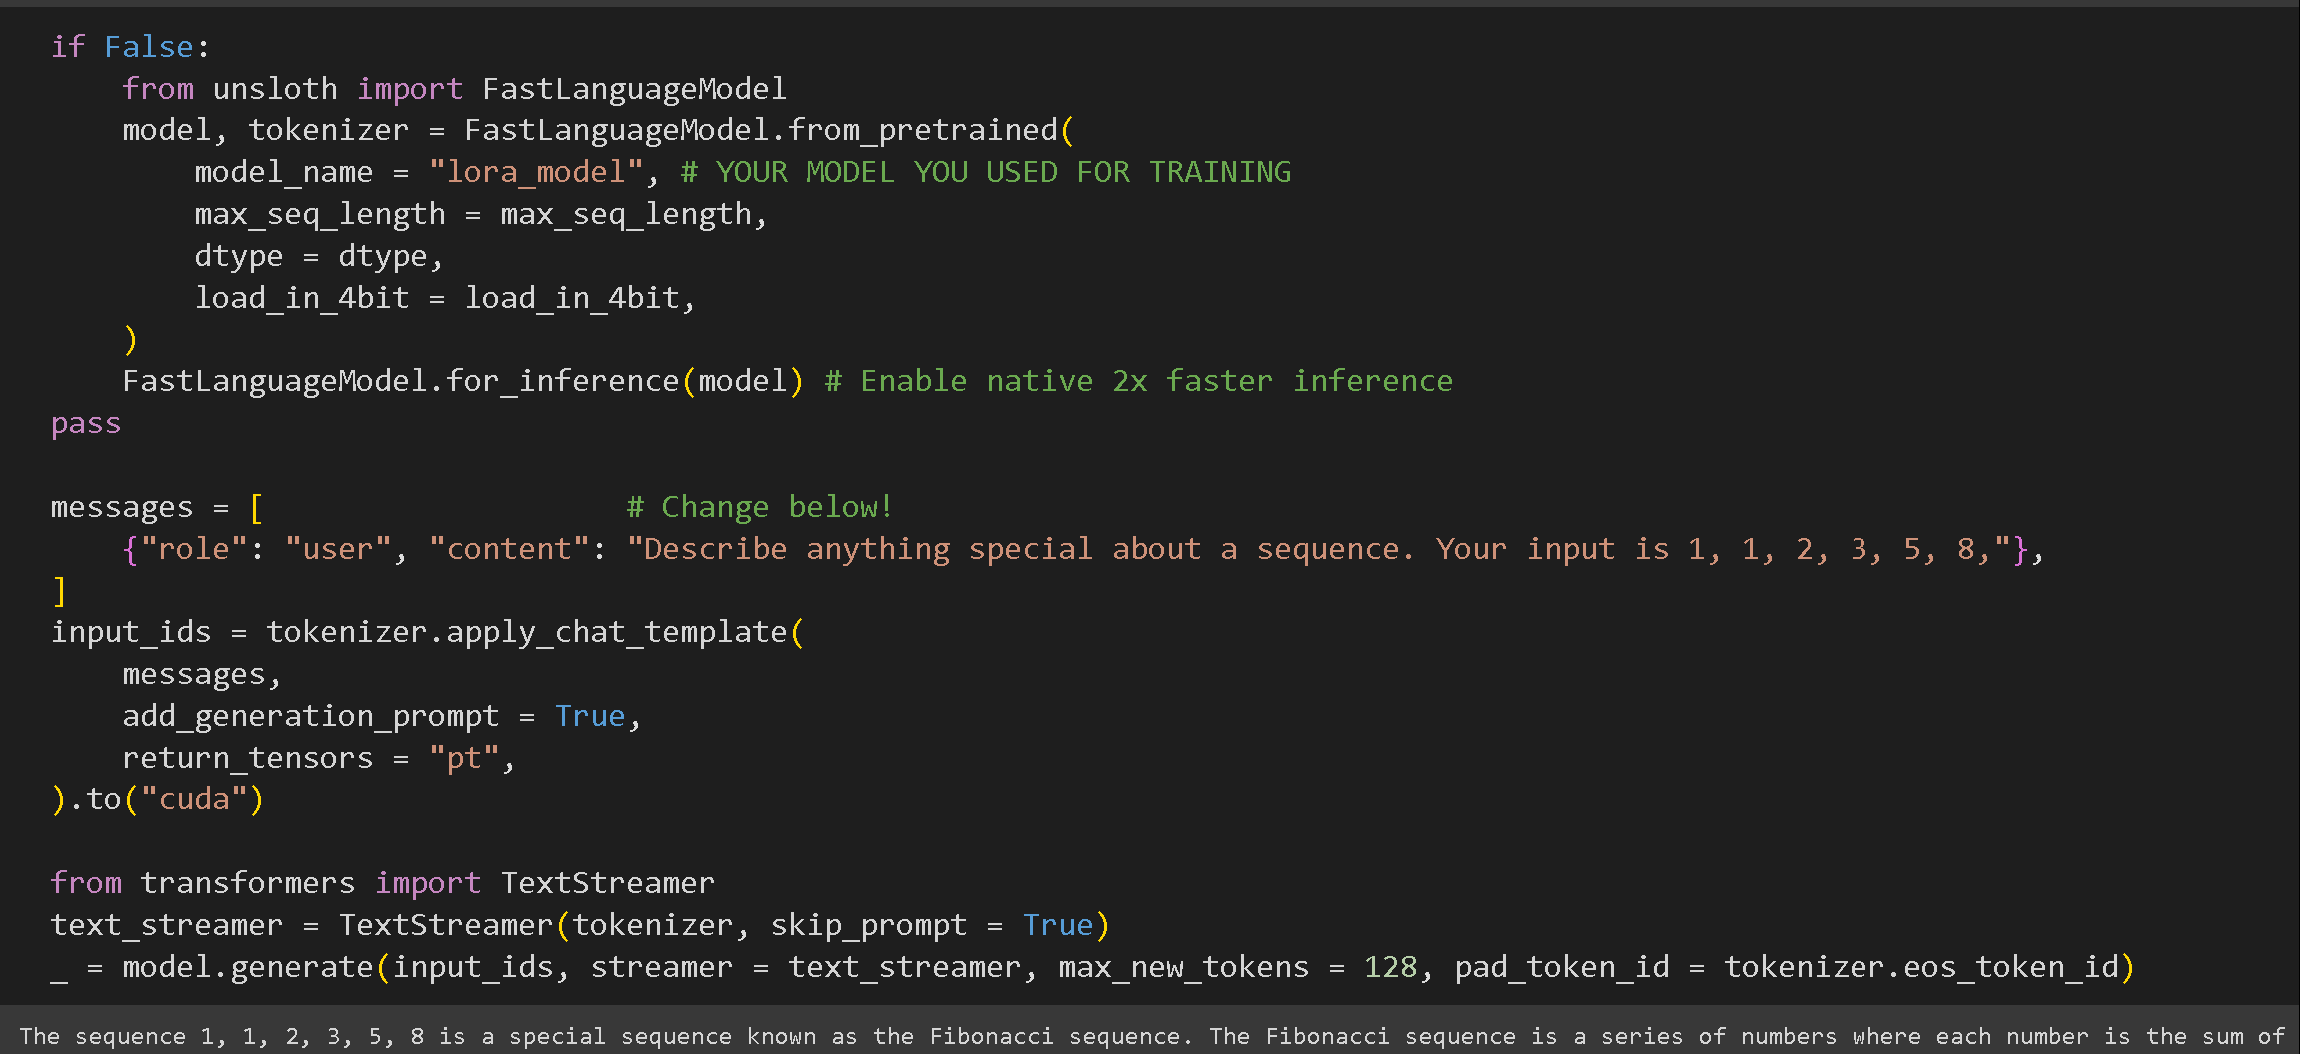
Nachdem das Modell gespeichert wurde, können wir Unsloth erneut verwenden, um das Modell selbst auszuführen! Verwenden Sie `FastLanguageModel` noch einmal, um es für die Inferenz aufzurufen!
## 8. Wir sind fertig!
Sie haben erfolgreich ein Sprachmodell feinabgestimmt und es mit Unsloth in die gewünschte Inferenz-Engine exportiert!
Um mehr über Tipps und Tricks zum Fine-Tuning zu erfahren, besuchen Sie unsere Blogs, die einen enormen und lehrreichen Mehrwert bieten:
Wenn Sie Hilfe beim Fine-Tuning benötigen, können Sie auch unserem Discord-Server beitreten [hier](https://discord.gg/unsloth) oder [Reddit r/unsloth](https://www.reddit.com/r/unsloth/). Vielen Dank fürs Lesen und hoffentlich war das hilfreich!
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.