> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/glm-4.6-how-to-run-locally.md).
# GLM-4.6: Leitfaden zum lokalen Ausführen
Ein Leitfaden, wie du das Z.ai GLM-4.6- und GLM-4.6V-Flash-Modell auf deinem eigenen lokalen Gerät ausführst!
GLM-4.6 und **GLM-4.6V-Flash** sind die neuesten Reasoning-Modelle von **Z.ai**, die bei Coding- und Agent-Benchmarks eine SOTA-Leistung erzielen und gleichzeitig verbesserte Gesprächsunterhaltungen bieten. [**GLM-4.6V-Flash**](#glm-4.6v-flash) **das kleinere 9B-Modell wurde im Dezember 2025 veröffentlicht und du kannst es jetzt auch ausführen.**
Das vollständige Modell mit 355B Parametern benötigt **400 GB** Speicherplatz auf der Festplatte, während das Unsloth Dynamic 2-bit GGUF die Größe auf **135GB** (-**75%)**. [**GLM-4.6-GGUF**](https://huggingface.co/unsloth/GLM-4.6-GGUF)
{% hint style="success" %}
Für die beste Leistung stellen Sie sicher, dass Ihr insgesamt verfügbarer Speicher (VRAM + Systemspeicher) die Größe der quantisierten Modelldatei, die Sie herunterladen, übersteigt. Wenn nicht, kann llama.cpp immer noch über SSD/HDD-Offloading ausgeführt werden, aber die Inferenz wird langsamer.
{% endhint %}
Alle Uploads verwenden Unsloth [Dynamic 2.0](/docs/de/grundlagen/dynamic-3.0-ggufs.md) für SOTA-Leistung bei 5-Shot MMLU und Aider, was bedeutet, dass Sie quantisierte GLM-LLMs mit minimalem Genauigkeitsverlust ausführen und feinabstimmen können.
**Tutorial-Navigation:**
GLM-4.6V-Flash ausführenGLM-4.6 ausführen
### :bug:Unsloth-Chat-Template & Fehlerbehebungen
Eine der bedeutenden Fehlerbehebungen, die wir vorgenommen haben, betrifft ein Problem beim Prompting von GGUFs, bei dem der zweite Prompt nicht funktionierte. Wir haben dieses Problem behoben, allerdings besteht es bei GGUFs ohne unsere Fixes weiterhin. Wenn du zum Beispiel ein beliebiges Nicht-Unsloth-GLM-4.6-GGUF verwendest, funktioniert die erste Unterhaltung einwandfrei, aber die zweite bricht ab.
Wir haben das in unserem Chat-Template behoben, sodass bei Verwendung unserer Version Unterhaltungen über die zweite hinaus (dritte, vierte usw.) ohne Fehler funktionieren. Es gibt weiterhin einige Probleme mit Tool-Calling, die wir aufgrund von Bandbreitenbeschränkungen noch nicht vollständig untersucht haben. Wir haben das GLM-Team bereits über diese verbleibenden Probleme informiert.
### :mag\_right:Eigenheiten und Fehlerbehebungen von GLM 4.6V Flash
{% hint style="info" %}
GLM-4.6V-Flash kann auf Chinesisch denken und ausgeben. Das ist nicht einzigartig für unsere Quants, sondern eine Eigenheit des Modells. Verwende einen System-Prompt von "Antworte auf Englisch und denke auf Englisch", um Denken und Ausgaben auf Englisch zu erzwingen!
{% endhint %}
Wir haben die BF16- und Q8\_0-Quants anderer Quant-Anbieter getestet, und alle scheinen auf Chinesisch zu denken. Zum Beispiel zeigen 2 separate Quants mit Seed 3407 und demselben Prompt "Erstelle ein Flappy-Bird-Spiel in Python" das Denken auf Chinesisch:
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
Durch die Verwendung eines System-Prompts von "Denke auf Englisch" über `--system-prompt "Antworte auf Englisch"` in llama.cpp, also etwa wie unten:
```bash
./llama.cpp/llama-cli -hf unsloth/GLM-4.6V-Flash-GGUF:BF16 \
--jinja --temp 0.8 --top-p 0.6 --top-k 2 --repeat-penalty 1.1 --min-p 0.0 --seed 3407 \
--prompt "Erstelle ein Flappy-Bird-Spiel in Python" --system-prompt "Antworte auf Englisch"
```
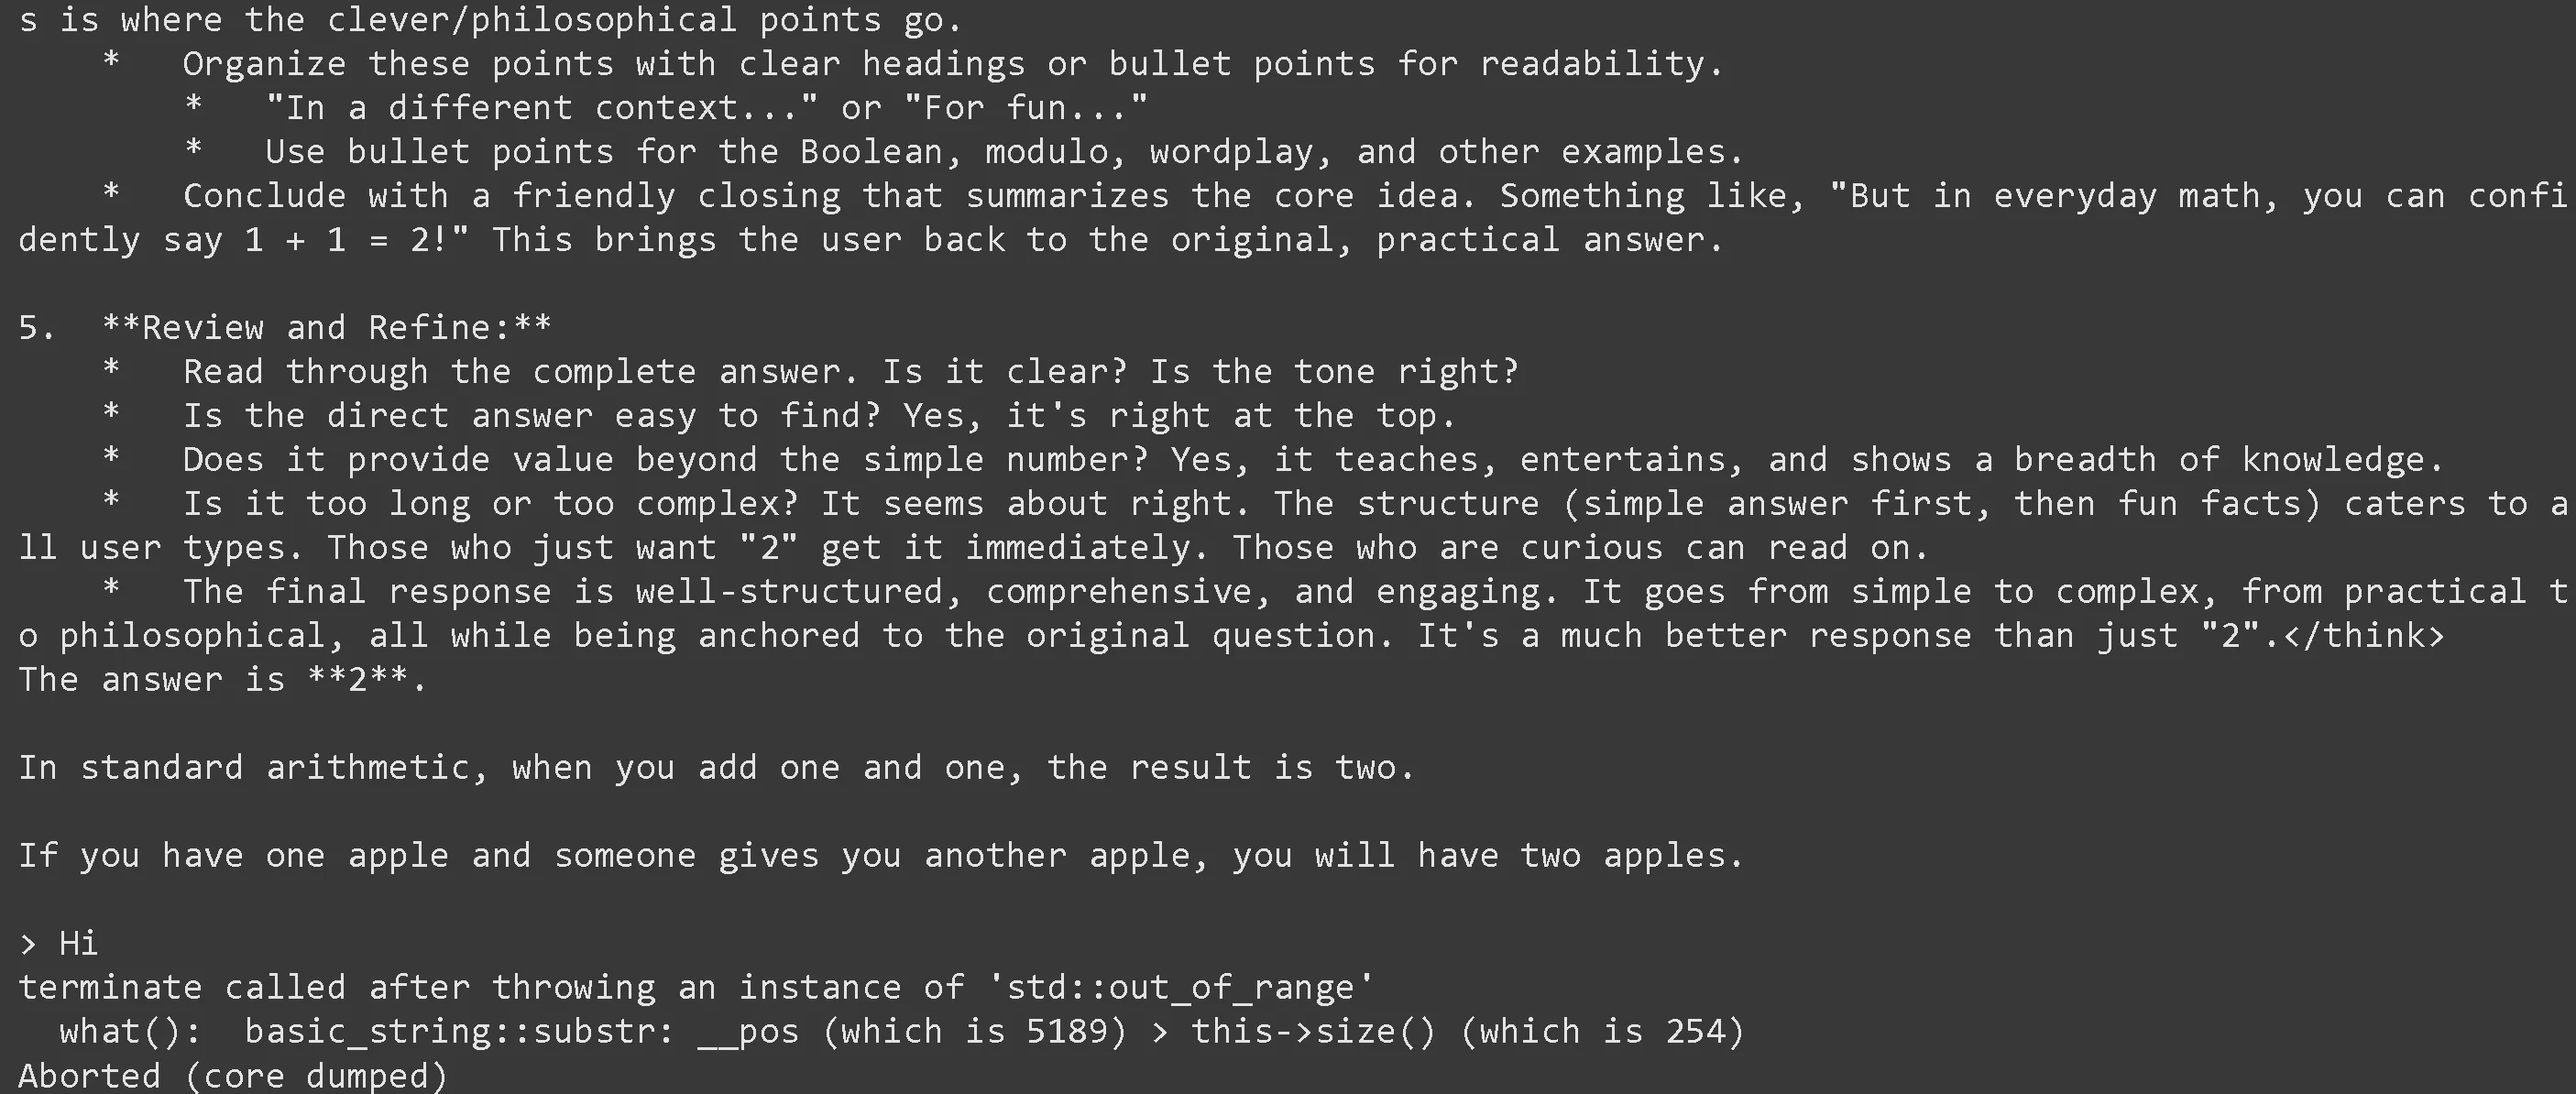
Wir erhalten das Denken auf Chinesisch, aber Ausgaben auf Englisch. Wir stellen außerdem eine Anschlussfrage von "Was ist 1+1" und erhalten nur Englisch:
Und schließlich, durch die Verwendung eines System-Prompts von "Antworte auf Englisch und denke auf Englisch" über `--system-prompt "Antworte auf Englisch und denke auf Englisch"` in llama.cpp, also etwa wie unten:
```bash
./llama.cpp/llama-cli -hf unsloth/GLM-4.6V-Flash-GGUF:BF16 \
--jinja --temp 0.8 --top-p 0.6 --top-k 2 --repeat-penalty 1.1 --min-p 0.0 --seed 3407 \
--prompt "Erstelle ein Flappy-Bird-Spiel in Python" \
--system-prompt "Antworte auf Englisch und denke auf Englisch"
```
Wir erhalten das Denken auf Englisch und Ausgaben auf Englisch! Wir stellen außerdem eine Anschlussfrage von "Was ist 1+1" und erhalten nur Englisch:
## :gear: Nutzungsleitfaden
Das 2-Bit-dynamische Quant UD-Q2\_K\_XL benötigt 135 GB Festplattenspeicher – das funktioniert gut in einer **1x24GB-Karte und 128GB RAM** mit MoE-Offloading. Das 1-Bit-UD-TQ1-GGUF funktioniert auch **nativ in Ollama**!
{% hint style="info" %}
Sie müssen `--jinja` für llama.cpp-Quants verwenden – das nutzt unsere [festen Chat-Vorlagen](#chat-template-bug-fixes) und aktiviert die richtige Vorlage! Sie könnten falsche Ergebnisse erhalten, wenn Sie `--jinja`
{% endhint %}
Die 4-Bit-Quants passen auf eine 1x40GB-GPU (mit MoE-Layern, die in den RAM ausgelagert werden). Erwarten Sie mit diesem Setup etwa 5 Token/s, wenn Sie außerdem 165GB RAM zusätzlich haben. Es wird empfohlen, mindestens 205GB RAM zu haben, um dieses 4-Bit-Modell auszuführen. Für optimale Leistung benötigen Sie mindestens 205GB gemeinsamen Speicher oder 205GB kombinierte RAM+VRAM für 5+ Token/s. Um zu erfahren, wie Sie die Generierungsgeschwindigkeit erhöhen und längere Kontexte unterbringen können, [lesen Sie hier](#improving-generation-speed).
{% hint style="success" %}
Obwohl nicht zwingend erforderlich, erzielen Sie die beste Leistung, wenn Ihr VRAM + RAM zusammen der Größe der Quantisierung entspricht, die Sie herunterladen. Falls nicht, funktioniert Auslagerung auf Festplatte/SSD mit llama.cpp; nur die Inferenz wird langsamer sein.
{% endhint %}
### Empfohlene Einstellungen
Laut Z.ai gibt es unterschiedliche Einstellungen für die Inferenz von GLM-4.6V-Flash und GLM-4.6:
| GLM-4.6V-Flash | GLM-4.6 |
| ------------------------------------------------------------------------- | -------------------------------------------------------------------------------------- |
| **temperature = 0.8** | **temperature = 1.0** |
| **top\_p = 0.6** (empfohlen) | **top\_p = 0.95** (empfohlen fürs Coding) |
| **top\_k = 2** (empfohlen) | **top\_k = 40** (empfohlen fürs Coding) |
| **128K Kontextlänge** oder weniger | **200K Kontextlänge** oder weniger |
| **repeat\_penalty = 1.1** | |
| **max\_generate\_tokens = 16,384** | **max\_generate\_tokens = 16,384** |
* Verwenden Sie `--jinja` für llama.cpp-Varianten – wir **haben auch einige Probleme mit Chat-Vorlagen behoben!**
## GLM-4.6-Tutorials ausführen:
Sieh dir unsere Schritt-für-Schritt-Anleitungen zum Ausführen von [GLM-4.6V-Flash](#glm-4.6v-flash) und dem großen [GLM-4.6](#glm-4.6) Modelle.
### GLM-4.6V-Flash
{% hint style="success" %}
**NEU ab dem 16. Dez. 2025: GLM-4.6-V wurde jetzt mit Vision-Unterstützung aktualisiert!**
{% endhint %}
#### ✨ In llama.cpp ausführen
{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` auf [GitHub](https://github.com/ggml-org/llama.cpp). Du kannst auch die unten stehenden Build-Anweisungen verwenden. Ändere `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Wenn Sie `llama.cpp` direkt zum Laden von Modellen kannst du Folgendes tun: (:Q8\_K\_XL) ist der Quantisierungstyp. Du kannst auch über Hugging Face herunterladen (Punkt 3). Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` um an einem bestimmten Ort zu speichern. Denken Sie daran, dass das Modell nur eine maximale Kontextlänge von 128K hat.
```bash
export LLAMA_CACHE="unsloth/GLM-4.6V-Flash-GGUF"
./llama.cpp/llama-cli \\
-hf unsloth/GLM-4.6V-Flash-GGUF:UD-Q8_K_XL \
--n-gpu-layers 99 \\
--jinja \
--ctx-size 16384 \\
--flash-attn on \
--temp 0.8 \
--top-p 0.6 \
--top-k 2 \
--repeat-penalty 1.1 \
-ot ".ffn_.*_exps.=CPU"
```
{% endstep %}
{% step %}
Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD-`Q4\_K\_XL (dynamische 4-Bit-Quantisierung) oder andere quantisierte Versionen wie `Q8_K_XL` .
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0" # Kann manchmal zu Rate-Limits führen, daher auf 0 setzen, um zu deaktivieren
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/GLM-4.6V-Flash-GGUF",
local_dir = "unsloth/GLM-4.6V-Flash-GGUF",
allow_patterns = ["*UD-Q8_K_XL*"],
)
```
{% endstep %}
{% endstepper %}
### GLM-4.6
#### :llama: In Ollama ausführen
{% stepper %}
{% step %}
Installieren `ollama` falls Sie es noch nicht getan haben! Um weitere Varianten des Modells auszuführen, [sehen Sie hier](https://unsloth.ai/docs/de/modelle/tutorials/pages/42aa6b132b83bbca34de4b7a6d3d2074272827c3#run-in-llama.cpp).
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
{% endstep %}
{% step %}
Führen Sie das Modell aus! Beachten Sie, dass Sie `ollama serve`in einem anderen Terminal aufrufen können, falls es fehlschlägt! Wir enthalten alle unsere Korrekturen und empfohlenen Parameter (Temperatur usw.) in `params` in unserem Hugging-Face-Upload!
```
OLLAMA_MODELS=unsloth ollama serve &
OLLAMA_MODELS=unsloth ollama run hf.co/unsloth/GLM-4.6-GGUF:TQ1_0
```
{% endstep %}
{% step %}
Um andere Quants auszuführen, müssen Sie zuerst die gesplitteten GGUF-Dateien zu einer einzigen zusammenführen, wie im folgenden Code. Danach müssen Sie das Modell lokal ausführen.
```bash
./llama.cpp/llama-gguf-split --merge \
GLM-4.6-GGUF/GLM-4.6-UD-Q2_K_XL/GLM-4.6-UD-Q2_K_XL-00001-of-00003.gguf \
merged_file.gguf
```
```bash
OLLAMA_MODELS=unsloth ollama serve &
OLLAMA_MODELS=unsloth ollama run merged_file.gguf
```
{% endstep %}
{% endstepper %}
#### ✨ In llama.cpp ausführen
{% stepper %}
{% step %}
Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli llama-server
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endstep %}
{% step %}
Wenn Sie `llama.cpp` direkt zum Laden von Modellen verwenden können, können Sie Folgendes tun: (:Q2\_K\_XL) ist der Quantisierungstyp. Sie können auch über Hugging Face herunterladen (Punkt 3). Dies ähnelt `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` um an einem bestimmten Ort zu speichern. Denken Sie daran, dass das Modell nur eine maximale Kontextlänge von 128K hat.
{% hint style="success" %}
Bitte probieren Sie `-ot ".ffn_.*_exps.=CPU"` um alle MoE-Layer auf die CPU auszulagern! Dadurch können Sie effektiv alle Nicht-MoE-Layer auf 1 GPU unterbringen, was die Generierungsgeschwindigkeit verbessert. Sie können den Regex-Ausdruck anpassen, um mehr Layer unterzubringen, wenn Sie mehr GPU-Kapazität haben.
Wenn Sie etwas mehr GPU-Speicher haben, versuchen Sie `-ot ".ffn_(up|down)_exps.=CPU"` Dadurch werden Up- und Down-Projektions-MoE-Layer ausgelagert.
Versuchen Sie `-ot ".ffn_(up)_exps.=CPU"` wenn Sie noch mehr GPU-Speicher haben. Dadurch werden nur Up-Projektions-MoE-Layer ausgelagert.
Und schließlich alle Layer auslagern über `-ot ".ffn_.*_exps.=CPU"` Dies verwendet am wenigsten VRAM.
Sie können den Regex auch anpassen, zum Beispiel `-ot "\.(6|7|8|9|[0-9][0-9]|[0-9][0-9][0-9])\.ffn_(gate|up|down)_exps.=CPU"` bedeutet, Gate-, Up- und Down-MoE-Layer auszulagern, aber nur ab dem 6. Layer aufwärts.
{% endhint %}
```bash
export LLAMA_CACHE="unsloth/GLM-4.6-GGUF"
./llama.cpp/llama-cli \\
--model GLM-4.6-GGUF/UD-Q2_K_XL/GLM-4.6-UD-Q2_K_XL-00001-of-00003.gguf \
--n-gpu-layers 99 \\
--jinja \
--ctx-size 16384 \\
--flash-attn on \
--temp 1.0 \\
--top-p 0.95 \\
--top-k 40 \
-ot ".ffn_.*_exps.=CPU"
```
{% endstep %}
{% step %}
Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD-`Q2\_K\_XL (dynamische 2-Bit-Quantisierung) oder andere quantisierte Versionen wie `Q4_K_XL` . Wir **empfehlen unsere dynamische 2,7-Bit-Quantisierung**** ****`UD-Q2_K_XL`**** ****zu verwenden, um Größe und Genauigkeit auszubalancieren**.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0" # Kann manchmal zu Rate-Limits führen, daher auf 0 setzen, um zu deaktivieren
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/GLM-4.6-GGUF",
local_dir = "unsloth/GLM-4.6-GGUF",
allow_patterns = ["*UD-Q2_K_XL*"], # Dynamische 2-Bit-Version. Verwende "*UD-TQ1_0*" für dynamische 1-Bit-Version
)
```
{% endstep %}
{% step %}
Du kannst `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 16384` für die Kontextlänge, `--n-gpu-layers 2` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/GLM-4.6-GGUF/UD-Q2_K_XL/GLM-4.6-UD-Q2_K_XL-00001-of-00003.gguf \
--jinja \
--n-gpu-layers 99 \\
--temp 1.0 \\
--top-p 0.95 \\
--top-k 40 \
--ctx-size 16384 \\
--seed 3407 \\
-ot ".ffn_.*_exps.=CPU"
```
{% endcode %}
{% endstep %}
{% endstepper %}
### ✨ Bereitstellen mit llama-server und der Completion-Bibliothek von OpenAI
Um llama-server für die Bereitstellung zu verwenden, nutzen Sie den folgenden Befehl:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-server \\
--model unsloth/GLM-4.6-GGUF/UD-Q2_K_XL/GLM-4.6-UD-Q2_K_XL-00001-of-00003.gguf \
--alias "unsloth/GLM-4.6" \
--n-gpu-layers 999 \\
-ot ".ffn_.*_exps.=CPU" \\
--prio 3 \\
--temp 1.0 \\
--top-p 0.95 \\
--top-k 40 \
--ctx-size 16384 \\
--port 8001 \
--jinja
```
{% endcode %}
Verwenden Sie dann die Python-Bibliothek von OpenAI `pip install openai` :
```python
from openai import OpenAI
import json
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
model = "unsloth/GLM-4.6",
messages = [{"role": "user", "content": "Was ist 2+2?"},],
)
print(completion.choices[0].message.content)
```
### :minidisc:Modell-Uploads
**ALLE unsere Uploads** - einschließlich derer, die nicht auf imatrix basieren oder dynamisch sind, nutzen unseren Kalibrierungsdatensatz, der speziell für Gesprächs-, Coding- und Sprachaufgaben optimiert ist.
* Vollständige GLM-4.6-Modell-Uploads unten:
Wir haben außerdem [IQ4\_NL](https://huggingface.co/unsloth/GLM-4.6-GGUF/tree/main/IQ4_NL) und [Q4\_1](https://huggingface.co/unsloth/GLM-4.6-GGUF/tree/main/Q4_1) Quants hochgeladen, die speziell auf ARM- bzw. Apple-Geräten schneller laufen.
### :snowboarder: Die Generierungsgeschwindigkeit verbessern
Wenn Sie mehr VRAM haben, können Sie versuchen, mehr MoE-Layer oder ganze Layer selbst auszulagern.
Normalerweise `-ot ".ffn_.*_exps.=CPU"` lagert alle MoE-Layer auf die CPU aus! Dadurch können Sie effektiv alle Nicht-MoE-Layer auf 1 GPU unterbringen, was die Generierungsgeschwindigkeit verbessert. Sie können den Regex-Ausdruck anpassen, um mehr Layer unterzubringen, wenn Sie mehr GPU-Kapazität haben.
Wenn Sie etwas mehr GPU-Speicher haben, versuchen Sie `-ot ".ffn_(up|down)_exps.=CPU"` Dadurch werden Up- und Down-Projektions-MoE-Layer ausgelagert.
Versuchen Sie `-ot ".ffn_(up)_exps.=CPU"` wenn Sie noch mehr GPU-Speicher haben. Dadurch werden nur Up-Projektions-MoE-Layer ausgelagert.
Sie können den Regex auch anpassen, zum Beispiel `-ot "\.(6|7|8|9|[0-9][0-9]|[0-9][0-9][0-9])\.ffn_(gate|up|down)_exps.=CPU"` bedeutet, Gate-, Up- und Down-MoE-Layer auszulagern, aber nur ab dem 6. Layer aufwärts.
Llama.cpp führt außerdem den High-Throughput-Modus ein. Verwenden Sie `llama-parallel`. Lesen Sie mehr darüber [hier](https://github.com/ggml-org/llama.cpp/tree/master/examples/parallel). Sie können auch **den KV-Cache auf 4 Bit quantisieren** zum Beispiel, um VRAM-/RAM-Bewegungen zu reduzieren, was den Generierungsprozess ebenfalls beschleunigen kann.
### 📐Wie man langen Kontext unterbringt (vollständige 200K)
Um längeren Kontext unterzubringen, können Sie **KV-Cache-Quantisierung** verwenden, um die K- und V-Caches auf niedrigere Bits zu quantisieren. Dies kann auch die Generierungsgeschwindigkeit erhöhen, da weniger RAM-/VRAM-Datenbewegung nötig ist. Die erlaubten Optionen für die K-Quantisierung (Standard ist `f16`) sind die folgenden.
`--cache-type-k f32, f16, bf16, q8_0, q4_0, q4_1, iq4_nl, q5_0, q5_1`
Sie sollten die `_1` Varianten für etwas höhere Genauigkeit verwenden, obwohl sie etwas langsamer ist. Zum Beispiel `q4_1, q5_1`
Sie können auch den V-Cache quantisieren, aber dafür müssen Sie **llama.cpp mit Flash-Attention-Unterstützung kompilieren** über `-DGGML_CUDA_FA_ALL_QUANTS=ON`, und `--flash-attn` verwenden, um es zu aktivieren. Dann können Sie es zusammen mit `--cache-type-k` :
`--cache-type-v f32, f16, bf16, q8_0, q4_0, q4_1, iq4_nl, q5_0, q5_1`
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/glm-4.6-how-to-run-locally.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.