> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/deepseek-r1-0528-how-to-run-locally.md).

# DeepSeek-R1-0528: Wie man lokal ausführt

Ein Leitfaden, wie du DeepSeek-R1-0528 einschließlich Qwen3 auf deinem eigenen lokalen Gerät ausführst!

DeepSeek-R1-0528 ist DeepSeeks neues Update für ihr R1-Reasoning-Modell. Das vollständige Modell mit 671B Parametern benötigt 715 GB Festplattenspeicher. Die quantisierte dynamische **1,66-Bit** Version benötigt 162 GB (-80 % Größenreduktion). GGUF: [DeepSeek-R1-0528-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF)

DeepSeek hat außerdem eine destillierte R1-0528-Version durch Fine-Tuning von Qwen3 (8B) veröffentlicht. Das Destillat erreicht eine ähnliche Leistung wie Qwen3 (235B). ***Du kannst auch*** [***Qwen3 Distill feinabstimmen***](#fine-tuning-deepseek-r1-0528-with-unsloth) ***mit Unsloth***. Qwen3 GGUF: [DeepSeek-R1-0528-Qwen3-8B-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF)

Alle Uploads verwenden Unsloth [Dynamic 2.0](/docs/de/grundlagen/dynamic-3.0-ggufs.md) für SOTA-5-Shot-MMLU- und KL-Divergenz-Leistung, sodass Sie quantisierte DeepSeek-LLMs mit minimalem Genauigkeitsverlust ausführen und feinabstimmen können.

**Tutorial-Navigation:**

<a href="#run-qwen3-distilled-r1-in-llama.cpp" class="button secondary">In llama.cpp ausführen</a><a href="#run-in-ollama-open-webui" class="button secondary">In Ollama/Open WebUI ausführen</a><a href="#fine-tuning-deepseek-r1-0528-with-unsloth" class="button secondary">R1-0528 feinabstimmen</a>

{% hint style="success" %}
NEU: Enorme Verbesserungen beim Tool-Calling und Korrekturen am Chat-Template.\
\
Neu [TQ1\_0 dynamische 1,66-Bit-Quantisierung](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF?show_file_info=DeepSeek-R1-0528-UD-TQ1_0.gguf) - 162 GB groß. Ideal für 192 GB RAM (einschließlich Mac) und Ollama-Nutzer. Probiere: `ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0`
{% endhint %}

## :gear: Empfohlene Einstellungen

Für DeepSeek-R1-0528-Qwen3-8B passt das Modell in praktisch jedes Setup, sogar in solche mit nur 20 GB RAM. Es ist keinerlei Vorbereitung im Vorfeld nötig.\
\
Für das vollständige R1-0528-Modell mit einer Größe von 715 GB ist jedoch zusätzliche Vorbereitung erforderlich. Die 1,78-Bit-(IQ1\_S)-Quantisierung passt auf eine 1x-24-GB-GPU (mit vollständig ausgelagerten Layern). Mit diesem Setup und zusätzlich 128 GB RAM kannst du mit etwa 5 Token/s rechnen.

Es wird empfohlen, mindestens 64 GB RAM zu haben, um diese Quantisierung auszuführen (ohne GPU erhältst du 1 Token/s). Für optimale Leistung benötigst du mindestens **180 GB Unified Memory oder 180 GB kombinierten RAM+VRAM** für 5+ Token/s.

Wir empfehlen unsere 2,7-Bit-(Q2\_K\_XL)- oder 2,4-Bit-(IQ2\_XXS)-Quantisierung, um Größe und Genauigkeit auszubalancieren! Die 2,4-Bit-Version funktioniert ebenfalls gut.

{% hint style="success" %}
Auch wenn es nicht nötig ist: Für die beste Leistung sollte dein VRAM + RAM zusammen der Größe der Quantisierung entsprechen, die du herunterlädst.
{% endhint %}

### 🐳 Offizielle empfohlene Einstellungen:

Laut [DeepSeek](https://huggingface.co/deepseek-ai/DeepSeek-R1-0528), dies sind die empfohlenen Einstellungen für die Inferenz von R1 (R1-0528 und Qwen3-Distill sollten dieselben Einstellungen verwenden):

* Stellen Sie <mark style="background-color:green;">**Temperatur 0,6**</mark> ein, um Wiederholungen und Inkohärenz zu reduzieren.
* Setzen Sie <mark style="background-color:green;">**top\_p auf 0,95**</mark> (empfohlen)
* Führe mehrere Tests aus und bilde den Durchschnitt der Ergebnisse für eine zuverlässige Bewertung.

### :1234: Chat-Template-/Prompt-Format

R1-0528 verwendet dasselbe Chat-Template wie das ursprüngliche R1-Modell. Du musst nicht zwingend `<think>\n` , aber du kannst es trotzdem hinzufügen!

```
<｜begin▁of▁sentence｜><｜User｜>Was ist 1+1?<｜Assistant｜>Es ist 2.<｜end▁of▁sentence｜><｜User｜>Erklär mehr!<｜Assistant｜>
```

Ein BOS wird zwangsweise hinzugefügt, und ein EOS trennt jede Interaktion. Um doppelte BOS-Tokens während der Inferenz zu vermeiden, sollten Sie nur aufrufen `tokenizer.encode(..., add_special_tokens = False)` da das Chat-Template automatisch auch ein BOS-Token hinzufügt.\
Für die Inferenz mit llama.cpp / GGUF solltest du das BOS überspringen, da es automatisch hinzugefügt wird:

```
<｜User｜>Was ist 1+1?<｜Assistant｜>
```

Der `<think>` und `</think>` Token erhalten ihre eigenen vorgesehenen Token.

## Modell-Uploads

**ALLE unsere Uploads** - einschließlich derer, die nicht auf imatrix basieren oder dynamisch sind, nutzen unseren Kalibrierungsdatensatz, der speziell für Gesprächs-, Coding- und Sprachaufgaben optimiert ist.

* Qwen3-(8B)-Distill: [DeepSeek-R1-0528-Qwen3-8B-GGUF](https://huggingface.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF)
* Vollständige DeepSeek-R1-0528-Modell-Uploads unten:

Wir haben außerdem [IQ4\_NL](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/IQ4_NL) und [Q4\_1](https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/Q4_1) Quants hochgeladen, die speziell auf ARM- bzw. Apple-Geräten schneller laufen.

<table data-full-width="false"><thead><tr><th>MoE-Bits</th><th>Typ + Link</th><th>Festplattengröße</th><th>Details</th></tr></thead><tbody><tr><td>1,66 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF?show_file_info=DeepSeek-R1-0528-UD-TQ1_0.gguf">TQ1_0</a></td><td><strong>162 GB</strong></td><td>1,92/1,56 Bit</td></tr><tr><td>1,78 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ1_S">IQ1_S</a></td><td><strong>185 GB</strong></td><td>2,06/1,56 Bit</td></tr><tr><td>1,93 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ1_M">IQ1_M</a></td><td><strong>200 GB</strong></td><td>2.5/2.06/1.56</td></tr><tr><td>2,42 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ2_XXS">IQ2_XXS</a></td><td><strong>216 GB</strong></td><td>2,5/2,06 Bit</td></tr><tr><td>2,71 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q2_K_XL">Q2_K_XL</a></td><td><strong>251 GB</strong></td><td>3,5/2,5 Bit</td></tr><tr><td>3,12 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-IQ3_XXS">IQ3_XXS</a></td><td><strong>273 GB</strong></td><td>3,5/2,06 Bit</td></tr><tr><td>3,5 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q3_K_XL">Q3_K_XL</a></td><td><strong>296 GB</strong></td><td>4,5/3,5 Bit</td></tr><tr><td>4,5 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q4_K_XL">Q4_K_XL</a></td><td><strong>384 GB</strong></td><td>5,5/4,5 Bit</td></tr><tr><td>5,5 Bit</td><td><a href="https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF/tree/main/UD-Q5_K_XL">Q5_K_XL</a></td><td><strong>481 GB</strong></td><td>6,5/5,5 Bit</td></tr></tbody></table>

Wir haben auch Versionen in [BF16-Format](https://huggingface.co/unsloth/DeepSeek-R1-0528-BF16), sowie das originale [FP8-(float8)-Format](https://huggingface.co/unsloth/DeepSeek-R1-0528).

## DeepSeek-R1-0528-Tutorials ausführen:

### :llama: In Ollama/Open WebUI ausführen

1. Installieren `ollama` falls du es nicht schon getan hast! Du kannst nur Modelle bis zu einer Größe von 32B ausführen. Um das vollständige 720GB-R1-0528-Modell auszuführen, [sehen Sie hier](#run-full-r1-0528-on-ollama-open-webui).

```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```

2. Führen Sie das Modell aus! Beachten Sie, dass Sie `ollama serve`in einem anderen Terminal aufrufen können, falls es fehlschlägt! Wir enthalten alle unsere Korrekturen und empfohlenen Parameter (Temperatur usw.) in `params` in unserem Hugging-Face-Upload!

```bash
ollama run hf.co/unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF:Q4_K_XL
```

3. <mark style="color:grün;background-color:yellow;">**(NEU) Um das vollständige R1-0528-Modell in Ollama auszuführen, kannst du unsere TQ1\_0-Quantisierung (162 GB) verwenden:**</mark>

```bash
OLLAMA_MODELS=unsloth_downloaded_models ollama serve &

ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0
```

### :llama: Vollständiges R1-0528 auf Ollama/Open WebUI ausführen

Open WebUI hat hier ein Schritt-für-Schritt-Tutorial zum Ausführen von R1 erstellt, und für R1-0528 musst du lediglich R1 durch die neue 0528-Quantisierung ersetzen: <https://docs.openwebui.com/tutorials/integrations/llm-providers/deepseekr1-dynamic>

<mark style="background-color:green;">**(NEU) Um das vollständige R1-0528-Modell in Ollama auszuführen, kannst du unsere TQ1\_0-Quantisierung (162 GB) verwenden:**</mark>

```bash
OLLAMA_MODELS=unsloth_downloaded_models ollama serve &

ollama run hf.co/unsloth/DeepSeek-R1-0528-GGUF:TQ1_0
```

Wenn du unter Ollama eine der Quantisierungen verwenden möchtest, die größer als TQ1\_0 (162 GB) sind, musst du zuerst die 3 GGUF-Split-Dateien zu einer einzigen zusammenführen, wie im folgenden Code. Dann musst du das Modell lokal ausführen.

```bash
./llama.cpp/llama-gguf-split --merge \
  DeepSeek-R1-0528-GGUF/DeepSeek-R1-0528-UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00003.gguf \
	merged_file.gguf
```

### ✨ Qwen3-destilliertes R1 in llama.cpp ausführen

1. <mark style="background-color:yellow;">**Um das vollständige 720GB-R1-0528-Modell auszuführen,**</mark> [<mark style="background-color:yellow;">**sehen Sie hier**</mark>](#run-full-r1-0528-on-llama.cpp)<mark style="background-color:yellow;">**.**</mark> Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```

2. Verwende dann direkt llama.cpp, um das Modell herunterzuladen:

```bash
./llama.cpp/llama-cli -hf unsloth/DeepSeek-R1-0528-Qwen3-8B-GGUF:Q4_K_XL --jinja
```

### ✨ Vollständiges R1-0528 in llama.cpp ausführen

1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.

```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
    -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```

2. Wenn Sie `llama.cpp` um Modelle direkt zu laden, können Sie Folgendes tun: (:IQ1\_S) ist der Quantisierungstyp. Sie können auch über Hugging Face herunterladen (Punkt 3). Das ist ähnlich wie `ollama run` . Verwenden Sie `export LLAMA_CACHE="folder"` um zu erzwingen `llama.cpp` um an einem bestimmten Speicherort zu speichern.

{% hint style="success" %}
Bitte probieren Sie `-ot ".ffn_.*_exps.=CPU"` um alle MoE-Layer auf die CPU auszulagern! Dadurch können Sie effektiv alle Nicht-MoE-Layer auf 1 GPU unterbringen, was die Generierungsgeschwindigkeit verbessert. Sie können den Regex-Ausdruck anpassen, um mehr Layer unterzubringen, wenn Sie mehr GPU-Kapazität haben.

Wenn Sie etwas mehr GPU-Speicher haben, versuchen Sie `-ot ".ffn_(up|down)_exps.=CPU"` Dadurch werden Up- und Down-Projektions-MoE-Layer ausgelagert.

Versuchen Sie `-ot ".ffn_(up)_exps.=CPU"` wenn Sie noch mehr GPU-Speicher haben. Dadurch werden nur Up-Projektions-MoE-Layer ausgelagert.

Und schließlich alle Layer auslagern über `-ot ".ffn_.*_exps.=CPU"` Dies verwendet am wenigsten VRAM.

Sie können den Regex auch anpassen, zum Beispiel `-ot "\.(6|7|8|9|[0-9][0-9]|[0-9][0-9][0-9])\.ffn_(gate|up|down)_exps.=CPU"` bedeutet, Gate-, Up- und Down-MoE-Layer auszulagern, aber nur ab dem 6. Layer aufwärts.
{% endhint %}

```bash
export LLAMA_CACHE="unsloth/DeepSeek-R1-0528-GGUF"
./llama.cpp/llama-cli \\
    -hf unsloth/DeepSeek-R1-0528-GGUF:IQ1_S \
    --cache-type-k q4_0 \\
    --threads -1 \\
    --n-gpu-layers 99 \\
    --prio 3 \\
    --temp 0.6 \
    --top-p 0.95 \\
    --min-p 0.01 \\
    --ctx-size 16384 \\
    --seed 3407 \\
    -ot ".ffn_.*_exps.=CPU"
```

3. Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD-IQ1_S`(dynamische 1,78-Bit-Quantisierung) oder andere quantisierte Versionen wie `Q4_K_M` . Wir <mark style="background-color:green;">**empfehlen unsere dynamische 2,7-Bit-Quantisierung**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`UD-Q2_K_XL`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**zu verwenden, um Größe und Genauigkeit auszubalancieren**</mark>. Weitere Versionen unter: <https://huggingface.co/unsloth/DeepSeek-R1-0528-GGUF>

{% code overflow="wrap" %}

```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0" # Kann manchmal zu Rate-Limits führen, daher auf 0 setzen, um zu deaktivieren
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/DeepSeek-R1-0528-GGUF",
    local_dir = "unsloth/DeepSeek-R1-0528-GGUF",
    allow_patterns = ["*UD-IQ1_S*"], # Dynamische 1-Bit (168 GB) Verwenden Sie "*UD-Q2_K_XL*" für dynamische 2-Bit (251 GB)
)
```

{% endcode %}

4. Führe den Flappy-Bird-Test von Unsloth aus, wie in unserer 1,58-Bit-dynamischen Quantisierung für DeepSeek R1 beschrieben.
5. Bearbeiten `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 16384` für die Kontextlänge, `--n-gpu-layers 2` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \\
    --model unsloth/DeepSeek-R1-0528-GGUF/UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00004.gguf \
    --cache-type-k q4_0 \\
    --threads -1 \\
    --n-gpu-layers 99 \\
    --prio 3 \\
    --temp 0.6 \
    --top-p 0.95 \\
    --min-p 0.01 \\
    --ctx-size 16384 \\
    --seed 3407 \\
    -ot ".ffn_.*_exps.=CPU" \\
    -no-cnv \\
    --prompt "<｜User｜>Erstellen Sie ein Flappy-Bird-Spiel in Python. Sie müssen Folgendes einbauen:\n1. Sie müssen pygame verwenden.\n2. Die Hintergrundfarbe sollte zufällig gewählt werden und hell sein. Beginnen Sie mit einer hellblauen Farbe.\n3. Wenn die LEERTASTE mehrmals gedrückt wird, beschleunigt sich der Vogel.\n4. Die Form des Vogels sollte zufällig als Quadrat, Kreis oder Dreieck gewählt werden. Die Farbe sollte zufällig als dunkle Farbe gewählt werden.\n5. Platzieren Sie unten etwas Land, das zufällig dunkelbraun oder gelb gefärbt ist.\n6. Zeigen Sie oben rechts einen Punktestand an. Erhöhen Sie ihn, wenn Sie Rohre passieren und sie nicht berühren.\n7. Erstellen Sie zufällig verteilte Rohre mit genügend Abstand. Färben Sie sie zufällig dunkelgrün, hellbraun oder in einem dunklen Grauton.\n8. Wenn Sie verlieren, zeigen Sie den Bestwert an. Platzieren Sie den Text innerhalb des Bildschirms. Mit q oder Esc wird das Spiel beendet. Ein Neustart erfolgt durch erneutes Drücken von LEERTASTE.\nDas fertige Spiel sollte sich innerhalb eines Markdown-Abschnitts in Python befinden. Überprüfen Sie Ihren Code vor dem finalen Markdown-Abschnitt auf Fehler und beheben Sie diese.<｜Assistant｜>"
```

{% endcode %}

## :8ball: Heptagon-Test

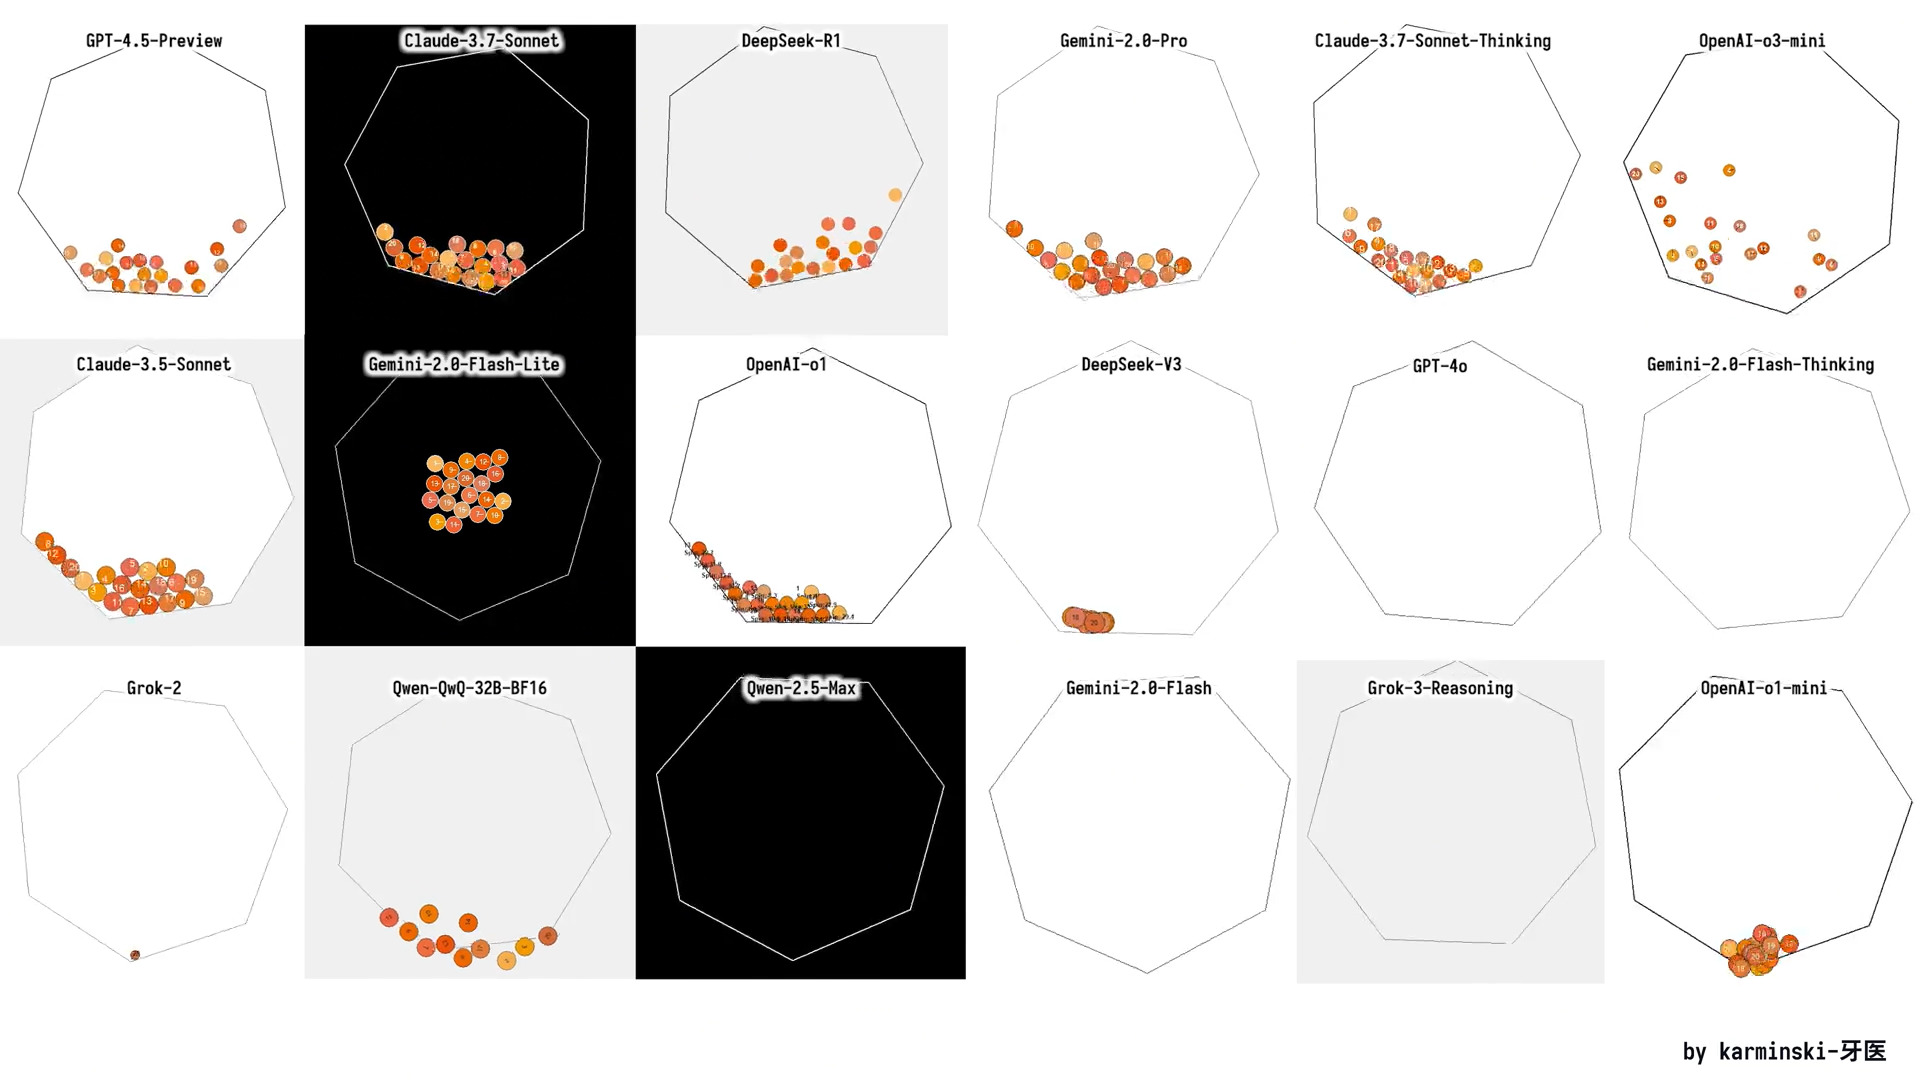
Du kannst auch unsere dynamischen Quantisierungen über [r/Localllama](https://www.reddit.com/r/LocalLLaMA/comments/1j7r47l/i_just_made_an_animation_of_a_ball_bouncing/) das das Modell darauf testet, eine einfache Physik-Engine zu erstellen, um Bälle zu simulieren, die in einer sich bewegenden, geschlossenen Heptagonform rotieren.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1371de5a93c6c5b0e43e8bb51980d84554b199f4%2Fsnapshot.jpg?alt=media" alt="" width="563"><figcaption><p>Das Ziel ist, das Heptagon rotieren zu lassen, und die Bälle im Heptagon sollten sich bewegen.</p></figcaption></figure>

<details>

<summary>Vollständiger Prompt zum Ausführen des Modells</summary>

{% code overflow="wrap" %}

```bash
./llama.cpp/llama-cli \\
    --model unsloth/DeepSeek-R1-0528-GGUF/UD-IQ1_S/DeepSeek-R1-0528-UD-IQ1_S-00001-of-00004.gguf \
    --cache-type-k q4_0 \\
    --threads -1 \\
    --n-gpu-layers 99 \\
    --prio 3 \\
    --temp 0.6 \
    --top_p 0.95 \
    --min_p 0.01 \
    --ctx-size 16384 \\
    --seed 3407 \\
    -ot ".ffn_.*_exps.=CPU" \\
    -no-cnv \\
    --prompt "<｜User｜>Schreibe ein Python-Programm, das 20 Bälle zeigt, die in einem rotierenden Heptagon herumhüpfen:\n- Alle Bälle haben den gleichen Radius.\n- Alle Bälle haben eine Nummer von 1 bis 20 darauf.\n- Alle Bälle fallen beim Start aus dem Zentrum des Heptagons heraus.\n- Die Farben sind: #f8b862, #f6ad49, #f39800, #f08300, #ec6d51, #ee7948, #ed6d3d, #ec6800, #ec6800, #ee7800, #eb6238, #ea5506, #ea5506, #eb6101, #e49e61, #e45e32, #e17b34, #dd7a56, #db8449, #d66a35\n- Die Bälle sollen von Schwerkraft und Reibung beeinflusst werden und sie müssen realistisch von den rotierenden Wänden abprallen. Es sollte auch Kollisionen zwischen den Bällen geben.\n- Das Material aller Bälle bestimmt, dass ihre Aufprallhöhe nicht den Radius des Heptagons überschreitet, aber höher als der Ballradius ist.\n- Alle Bälle rotieren mit Reibung, die Zahlen auf den Bällen können verwendet werden, um den Spin des Balls anzuzeigen.\n- Das Heptagon rotiert um sein Zentrum, und die Rotationsgeschwindigkeit beträgt 360 Grad pro 5 Sekunden.\n- Die Größe des Heptagons sollte groß genug sein, um alle Bälle aufzunehmen.\n- Verwende nicht die pygame-Bibliothek; implementiere Kollisionsdetektionsalgorithmen und Kollisionsreaktion usw. selbst. Die folgenden Python-Bibliotheken sind erlaubt: tkinter, math, numpy, dataclasses, typing, sys.\n- Der gesamte Code sollte in eine einzige Python-Datei gelegt werden.<｜Assistant｜>"
```

{% endcode %}

</details>

## 🦥 DeepSeek-R1-0528 mit Unsloth feinabstimmen

Um **DeepSeek-R1-0528-Qwen3-8B** mit Unsloth haben wir ein neues GRPO-Notebook erstellt, das eine benutzerdefinierte Belohnungsfunktion enthält, die darauf ausgelegt ist, die mehrsprachige Ausgabe erheblich zu verbessern - insbesondere die Rate der Antworten in der gewünschten Sprache (in unserem Beispiel verwenden wir Indonesisch, aber du kannst jede beliebige Sprache verwenden) um mehr als 40 % zu erhöhen.

* [**DeepSeek-R1-0528-Qwen3-8B-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) **- neu**

Während viele Reasoning-LLMs mehrsprachige Fähigkeiten haben, erzeugen sie in ihren Reasoning-Traces oft gemischtsprachige Ausgaben, indem sie Englisch mit der Zielsprache kombinieren. Unsere Belohnungsfunktion mildert dieses Problem wirksam, indem sie Ausgaben in der gewünschten Sprache stark fördert, was zu einer deutlichen Verbesserung der Sprachkonsistenz führt.

Diese Belohnungsfunktion ist außerdem vollständig anpassbar, sodass du sie an andere Sprachen anpassen oder für bestimmte Domänen oder Anwendungsfälle feinabstimmen kannst.

{% hint style="success" %}
Das Beste an dieser gesamten Belohnungsfunktion und dem Notebook ist, dass du KEINEN Sprachdatensatz brauchst, um dein Modell dazu zu bringen, eine bestimmte Sprache zu lernen. Das Notebook enthält keinen indonesischen Datensatz.
{% endhint %}

Unsloth macht das Fine-Tuning des R1-Qwen3-Distills 2× schneller, nutzt 70 % weniger VRAM und unterstützt 8× längere Kontextlängen.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/modelle/tutorials/deepseek-r1-0528-how-to-run-locally.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.