> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/grundlagen/vision-fine-tuning.md).
# Vision-Feinabstimmung
Erfahren Sie, wie Sie Vision-/multimodale LLMs mit Unsloth feinabstimmen
Das Fine-Tuning von Vision-Modellen ermöglicht es dem Modell, bei bestimmten Aufgaben zu glänzen, bei denen normale LLMs nicht so gut sind, wie z. B. Objekterkennung/Bewegungserkennung. **Sie können auch trainieren** [**VLMs mit RL**](/docs/de/loslegen/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md)**.** Wir haben viele kostenlose Notebooks für Vision-Fine-Tuning:
* [**Qwen3-VL**](/docs/de/modelle/tutorials/qwen3-how-to-run-and-fine-tune/qwen3-vl-how-to-run-and-fine-tune.md) **(8B) Vision:** [**Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision.ipynb)
* [**Ministral 3**](/docs/de/modelle/tutorials/ministral-3.md): Vision-Fine-Tuning für allgemeine Fragen und Antworten: [Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Pixtral_\(12B\)-Vision.ipynb)\
Man kann allgemeine Q\&A-Datensätze mit nischigeren Datensätzen kombinieren, damit das Fine-Tuning die Fähigkeiten des Basismodells nicht vergisst.
* **Gemma 3 (4B) Vision:** [Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
* **Llama 3.2 Vision** Fine-Tuning für Radiographie: [Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb)\
Wie können wir medizinisches Fachpersonal dabei unterstützen, Röntgenbilder, CT-Scans und Ultraschallbilder schneller zu analysieren.
* **Qwen2.5 VL** Fine-Tuning zur Umwandlung von Handschrift in LaTeX: [Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen2.5_VL_\(7B\)-Vision.ipynb)\
Dadurch können komplexe mathematische Formeln leicht als LaTeX transkribiert werden, ohne sie manuell zu schreiben.
{% hint style="info" %}
Am besten stellen Sie sicher, dass Ihr Datensatz Bilder alle in derselben Größe/Abmessung enthält. Verwenden Sie Abmessungen von 300–1000 px, damit Ihr Training nicht zu lange dauert oder zu viele Ressourcen verbraucht.
{% endhint %}
### Deaktivieren von Vision / reinem Text-Fine-Tuning
Um Vision-Modelle feinzujustieren, können Sie jetzt auswählen, welche Teile des Modells feinzujustieren sind. Sie können wählen, nur die Vision-Schichten, nur die Sprachschichten oder die Attention-/MLP-Schichten feinzujustieren! Standardmäßig aktivieren wir alle!
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True, # False, wenn die Vision-Schichten nicht fine-getunt werden sollen
finetune_language_layers = True, # False, wenn die Sprachschichten nicht fine-getunt werden sollen
finetune_attention_modules = True, # False, wenn die Attention-Schichten nicht fine-getunt werden sollen
finetune_mlp_modules = True, # False, wenn die MLP-Schichten nicht fine-getunt werden sollen
r = 16, # Je größer, desto höher die Genauigkeit, aber möglicherweise Overfitting
lora_alpha = 16, # Empfohlen: alpha == r, mindestens
lora_dropout = 0,
bias = "none",
random_state = 3407,
use_rslora = False, # Wir unterstützen rank-stabilisiertes LoRA
loftq_config = None, # Und LoftQ
target_modules = "all-linear", # Jetzt optional! Kann bei Bedarf eine Liste angegeben werden
modules_to_save=[
"lm_head",
"embed_tokens",
],
)
```
### Vision-Daten-Collator
Wir haben einen speziellen Data-Collator nur für Vision-Datensätze:
{% code overflow="wrap" %}
```python
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
data_collator = UnslothVisionDataCollator(model, tokenizer),
train_dataset = dataset,
args = SFTConfig(...),
)
```
{% endcode %}
Und die Argumente für den Data-Collator sind:
{% code expandable="true" %}
```python
class UnslothVisionDataCollator:
def __init__(
self,
model,
processor,
max_seq_length = None, # [Optional] Wir ermitteln dies automatisch aus `FastVisionModel.from_pretrained(max_seq_length = ...)
formatting_func = None, # Funktion zum Transformieren des Texts
resize = "min", # Kann (10, 10) oder "min" sein, um die Größe an die Standard-`image_size` des Modells oder "max" anzupassen
# für keine Größenänderung und das Bild unverändert lassen
ignore_index = -100, # [Optional] Standard ist -100
# from unsloth.chat_templates import train_on_responses_only
# trainer = train_on_responses_only(
# trainer,
# instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
# response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
# )
train_on_responses_only = False, # ENTSPRICHT train_on_responses_only für LLMs
instruction_part = None, # ENTSPRICHT train_on_responses_only(instruction_part = ...)
response_part = None, # ENTSPRICHT train_on_responses_only(response_part = ...)
force_match = True, # Auch Zeilenumbrüche abgleichen!
num_proc = None, # [Optional] Wird automatisch die Anzahl der GPUs auswählen
completion_only_loss = True, # [Optional] Ignoriert Padding-Vision-Tokens - sollte immer True sein!
pad_to_multiple_of = None, # [Optional] Für das Padding des Data-Collators
resize_dimension = 0, # kann 0, 1, 'max' oder 'min' sein
# (max skaliert anhand des Maximums von Höhe/Breite, min anhand der kleinsten Größe, 0 der ersten Dimension usw.)
snap_to_patch_size = False, # [Optional] Bild auf ein Vielfaches der Patch-Größe erzwingen
)
```
{% endcode %}
### Training mit mehreren Bildern
Um Modelle mit mehreren Bildern feinzujustieren oder zu trainieren, ist die naheliegendste Änderung, Folgendes zu ersetzen:
```python
ds_converted = ds.map(
convert_to_conversation,
)
```
mit:
```python
ds_converted = [convert_to_conversation(sample) for sample in dataset]
```
Die Verwendung von map aktiviert Standardisierungs- und Arrow-Verarbeitungsregeln für Datensätze, die streng und schwieriger zu definieren sein können.
### Datensatz für Vision-Fine-Tuning
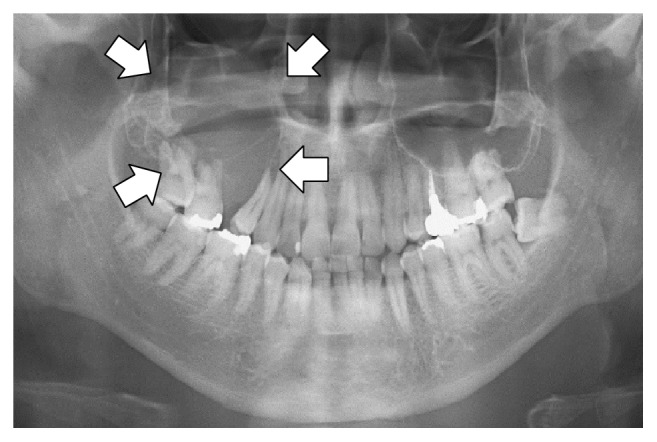
Der Datensatz für das Fine-Tuning eines Vision- oder multimodalen Modells ähnelt einem normalen Frage-Antwort-Paar [datasets ](/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md), aber diesmal enthält er auch Bildeingaben. Zum Beispiel: [Llama 3.2 Vision Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX) einen radiologischen Fall, um zu zeigen, wie KI medizinischem Fachpersonal helfen kann, Röntgenaufnahmen, CT-Scans und Ultraschalluntersuchungen effizienter zu analysieren.
Wir verwenden eine Stichprobe des ROCO-Radiologiedatensatzes. Du kannst auf den Datensatz zugreifen [hier](https://www.google.com/url?q=https%3A%2F%2Fhuggingface.co%2Fdatasets%2Funsloth%2FRadiology_mini). Der Datensatz enthält Röntgenaufnahmen, CT-Scans und Ultraschallaufnahmen, die medizinische Zustände und Krankheiten zeigen. Jedes Bild hat eine von Experten verfasste Bildbeschreibung. Das Ziel ist es, ein VLM feinabzustimmen, damit es ein nützliches Analysewerkzeug für medizinisches Fachpersonal wird.
Sehen wir uns den Datensatz an und prüfen wir, was das 1. Beispiel zeigt:
```
Datensatz({
features: ['image', 'image_id', 'caption', 'cui'],
num_rows: 1978
})
```
| Bild | Beschriftung |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- |
|
| Die panoramische Radiografie zeigt eine osteolytische Läsion im rechten hinteren Oberkiefer mit Resorption des Bodens der Kieferhöhle (Pfeile). |
Um den Datensatz zu formatieren, sollten alle Vision-Fine-Tuning-Aufgaben wie folgt formatiert werden:
```python
[
{ "role": "user",
"content": [{"type": "text", "text": instruction}, {"type": "image", "image": image} ]
},
{ "role": "assistant",
"content": [{"type": "text", "text": answer} ]
},
]
```
Wir werden eine benutzerdefinierte Anweisung formulieren, die das VLM auffordert, ein Experte für Radiografie zu sein. Beachte auch, dass du statt nur 1 Anweisung mehrere Gesprächsrunden hinzufügen kannst, um daraus eine dynamische Konversation zu machen.
{% code expandable="true" %}
```notebook-python
instruction = "Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst."
def convert_to_conversation(sample):
conversation = [
{ "role": "user",
"content" : [
{"type" : "text", "text" : instruction},
{"type" : "image", "image" : sample["image"]} ]
},
{ "role" : "assistant",
"content" : [
{"type" : "text", "text" : sample["caption"]} ]
},
]
return { "messages" : conversation }
pass
```
{% endcode %}
Lass uns den Datensatz für das Fine-Tuning in das „richtige“ Format umwandeln:
```notebook-python
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
Das erste Beispiel ist jetzt wie unten strukturiert:
```notebook-python
converted_dataset[0]
```
{% code overflow="wrap" %}
```
{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': 'Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst.'},
{'type': 'image',
'image': }]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'Die panoramische Radiografie zeigt eine osteolytische Läsion im rechten hinteren Oberkiefer mit Resorption des Bodens der Kieferhöhle (Pfeile).'}]}]}
```
{% endcode %}
Bevor wir irgendein Fine-Tuning durchführen, weiß das Vision-Modell vielleicht bereits, wie man die Bilder analysiert? Prüfen wir, ob das der Fall ist!
{% code expandable="true" %}
```notebook-python
FastVisionModel.for_inference(model) # Für die Inferenz aktivieren!
image = dataset[0]["image"]
instruction = "Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst."
messages = [
{"role": "user", "content": [
{"type": "image"},
{"type": "text", "text": instruction}
]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt = True)
inputs = tokenizer(
image,
input_text,
add_special_tokens = False,
return_tensors = "pt",
).to("cuda")
from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 128,
use_cache = True, temperature = 1.5, min_p = 0.1)
```
{% endcode %}
Und das Ergebnis:
```
Diese Röntgenaufnahme scheint eine Panoramaansicht des oberen und unteren Gebisses zu sein, insbesondere ein Orthopantomogramm (OPG).
* Die panoramische Röntgenaufnahme zeigt normale Zahnstrukturen.
* Es gibt einen abnormalen Bereich oben rechts, dargestellt durch einen Bereich strahlentransparenter Knochen, der dem Antrum entspricht.
**Wichtige Beobachtungen**
* Der Knochen zwischen den linken oberen Zähnen ist relativ strahlenundurchlässig.
* Über dem Bild befinden sich zwei große Pfeile, was auf die Notwendigkeit einer genaueren Untersuchung dieses Bereichs hindeutet. Einer der Pfeile befindet sich links, der andere rechts. Allerdings nur
```
Weitere Details findest du in unserem Datenabschnitt im [Notebook hier](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX).
### :mag\_right:Training auf Assistentenantworten nur für Vision-Modelle, VLMs
Für Sprachmodelle können wir `from unsloth.chat_templates import train_on_responses_only` wie zuvor beschrieben verwenden. Für Vision-Modelle verwende die zusätzlichen Argumente als Teil von `UnslothVisionDataCollator` genau wie zuvor! Siehe [#vision-data-collator](#vision-data-collator "mention") für weitere Details zur Verwendung des Vision-Daten-Collators.
{% code overflow="wrap" %}
```python
class UnslothVisionDataCollator:
def __init__(
self,
...
# from unsloth.chat_templates import train_on_responses_only
# trainer = train_on_responses_only(
# trainer,
# instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
# response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
# )
train_on_responses_only = False, # ENTSPRICHT train_on_responses_only für LLMs
instruction_part = None, # ENTSPRICHT train_on_responses_only(instruction_part = ...)
response_part = None, # ENTSPRICHT train_on_responses_only(response_part = ...)
force_match = True, # Auch Zeilenumbrüche abgleichen!
)
```
{% endcode %}
Zum Beispiel für Llama 3.2 Vision:
```python
UnslothVisionDataCollator(
model, tokenizer,
...
train_on_responses_only = True,
instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
...
)
```
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/grundlagen/vision-fine-tuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.