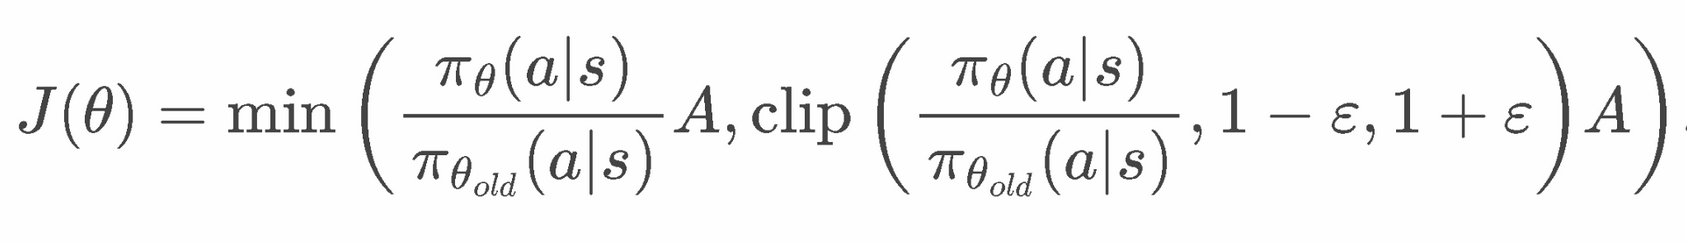> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide.md).
# Leitfaden zu Reinforcement Learning (RL)
Erfahre alles über Reinforcement Learning (RL) und wie du mit Unsloth und GRPO dein eigenes DeepSeek-R1-Reasoning-Modell trainierst. Ein vollständiger Leitfaden von Einsteiger bis Fortgeschrittene.
Reinforcement Learning ist, wenn ein „Agent“ lernt, Entscheidungen zu treffen, indem er mit einer Umgebung interagiert und **Feedback** in Form von **Belohnungen** oder **Strafen**.
* **Aktion:** Was das Modell erzeugt (z. B. einen Satz).
* **Belohnung:** Ein Signal, das angibt, wie gut oder schlecht die Aktion des Modells war (z. B. ob die Antwort den Anweisungen gefolgt ist? War sie hilfreich?).
* **Umgebung:** Das Szenario oder die Aufgabe, an der das Modell arbeitet (z. B. die Frage eines Nutzers beantworten).
### :sloth:Was Sie lernen werden
1. Was ist RL? RLVR? PPO? GRPO? RLHF? RFT? Ist **„Glück ist alles, was du brauchst?“** für RL?
2. Was ist eine Umgebung? Ein Agent? Eine Aktion? Eine Belohnungsfunktion? Belohnungen?
Dieser Artikel behandelt alles (vom Einsteiger- bis zum Fortgeschrittenenniveau), was Sie über GRPO, Reinforcement Learning (RL) und Belohnungsfunktionen wissen müssen, zusammen mit Tipps und den Grundlagen zur Verwendung von GRPO mit [Unsloth](https://github.com/unslothai/unsloth). Wenn Sie nach einer Schritt-für-Schritt-Anleitung zur Verwendung von GRPO suchen, sehen Sie sich unseren Leitfaden an [hier](/docs/de/loslegen/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
**Aktualisierung vom 15. Jan. 2026:** [Ultra-Langkontext-RL](/docs/de/loslegen/reinforcement-learning-rl-guide/grpo-long-context.md) ist da! Trainieren Sie gpt-oss mit einem Kontextfenster von 380K.
**Aktualisierung vom 26. Nov. 2025:** Wir führen FP8-Präzisions-RL und GRPO in Unsloth ein! [Blog lesen](/docs/de/loslegen/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md)
{% endhint %}
## :question:Was ist Reinforcement Learning (RL)?
Das Ziel von RL ist es:
1. **Die Wahrscheinlichkeit erhöhen, ****„gute“**** Ergebnisse zu sehen.**
2. **Die Wahrscheinlichkeit verringern, ****„schlechte“**** Ergebnisse zu sehen.**
**Das war's!** Es gibt Feinheiten dabei, was „gut“ und „schlecht“ bedeutet, oder wie wir vorgehen, um es „zu erhöhen“ oder „zu verringern“, oder was „Ergebnisse“ überhaupt bedeutet.
{% columns %}
{% column width="50%" %}
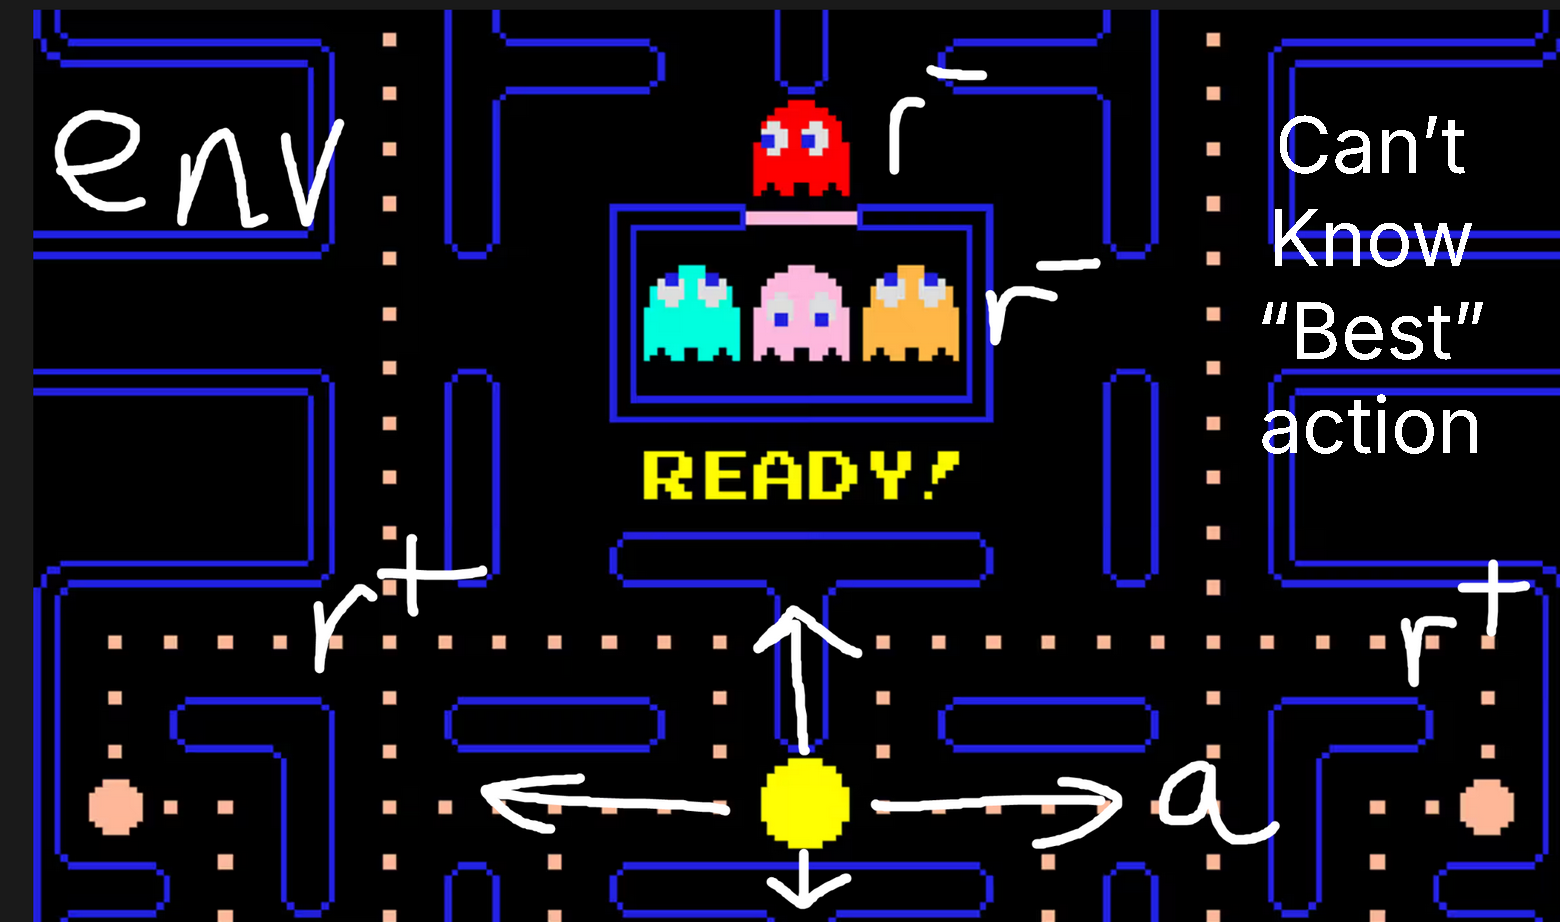
Zum Beispiel ist im **Pacman-Spiel**:
1. Der **die Umgebung** die Spielwelt.
2. Der **Die** Aktionen, die Sie ausführen können, sind OBEN, LINKS, RECHTS und UNTEN.
3. Der **Belohnungen** sind gut, wenn Sie einen Keks essen, oder schlecht, wenn Sie einen der schlängelnden Feinde berühren.
4. Bei RL können Sie die „beste Aktion“, die Sie ausführen können, nicht kennen, aber Sie können Zwischenschritte oder den endgültigen Spielzustand beobachten (Sieg oder Niederlage)
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column width="50%" %}
{% endcolumn %}
{% column %}
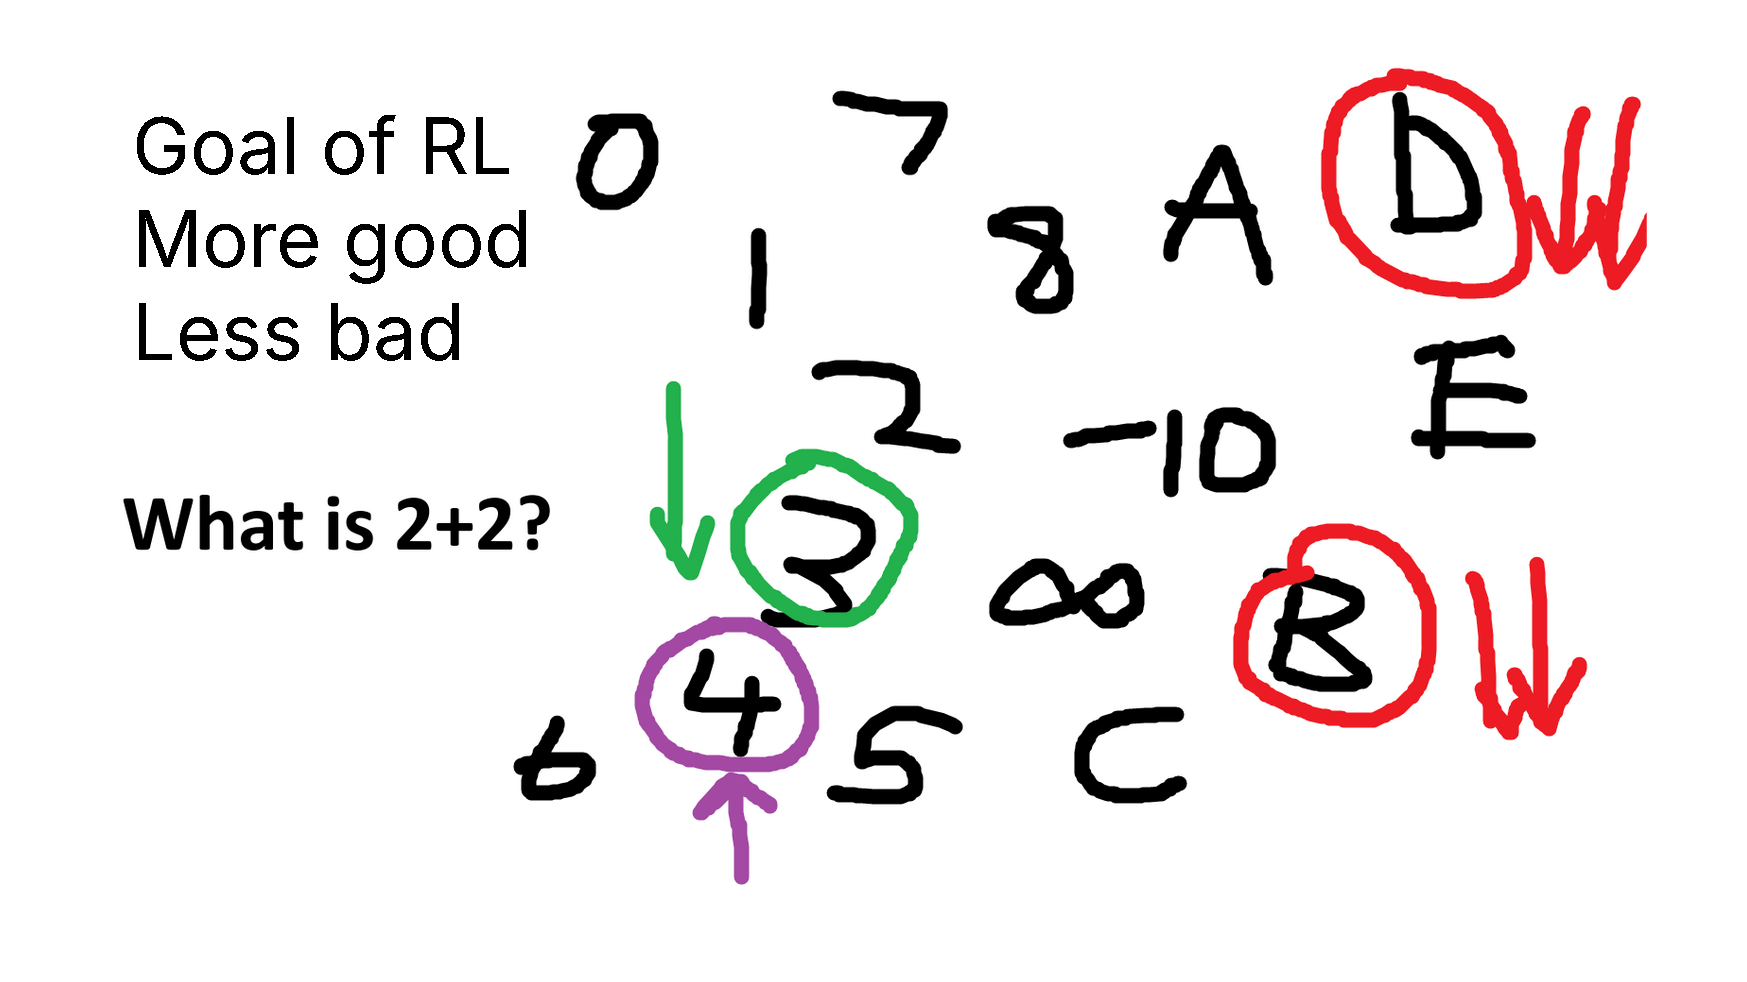
Ein weiteres Beispiel: Stellen Sie sich vor, Sie bekommen die Frage: **„Was ist 2 + 2?“** (4) Ein nicht ausgerichtetes Sprachmodell würde 3, 4, C, D, -10 ausspucken, buchstäblich alles.
1. Zahlen sind besser als C oder D, oder?
2. 3 zu bekommen ist besser als sagen wir 8, oder?
3. 4 zu bekommen ist eindeutig korrekt.
Wir haben gerade eine **Belohnungsfunktion**!
{% endcolumn %}
{% endcolumns %}
### :person\_running:Von RLHF, PPO bis GRPO und RLVR
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
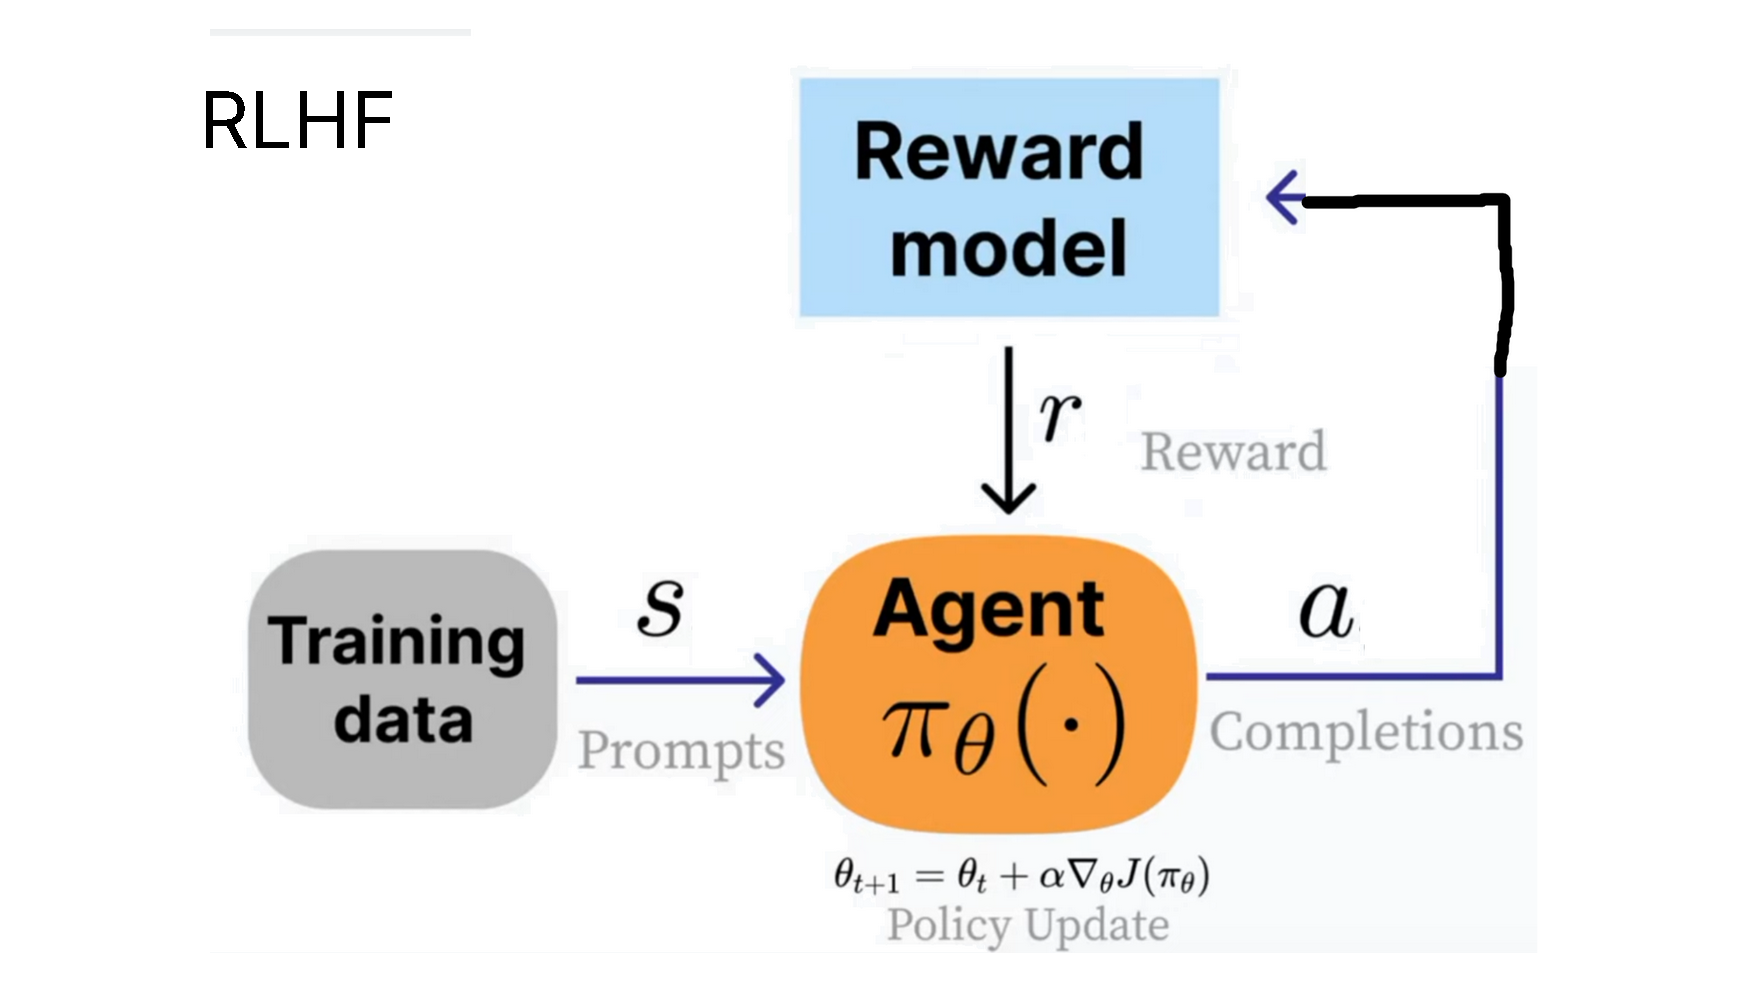
OpenAI machte das Konzept von [RLHF](https://en.wikipedia.org/wiki/Reinforcement_learning_from_human_feedback) (Reinforcement Learning from Human Feedback) populär, bei dem wir einen **„Agenten“** trainieren, Ausgaben zu einer Frage (dem **Zustand**) zu erzeugen, die von Menschen als hilfreicher bewertet werden.
Der Daumen hoch und runter in ChatGPT kann zum Beispiel im RLHF-Prozess verwendet werden.
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
PPO-Formel
Der Term clip(..., 1-e, 1+e) wird verwendet, um PPO zu zwingen, keine zu großen Änderungen vorzunehmen. Außerdem gibt es einen KL-Term mit beta > 0, um das Modell zu zwingen, nicht zu weit abzuweichen.
{% endcolumn %}
{% column %}
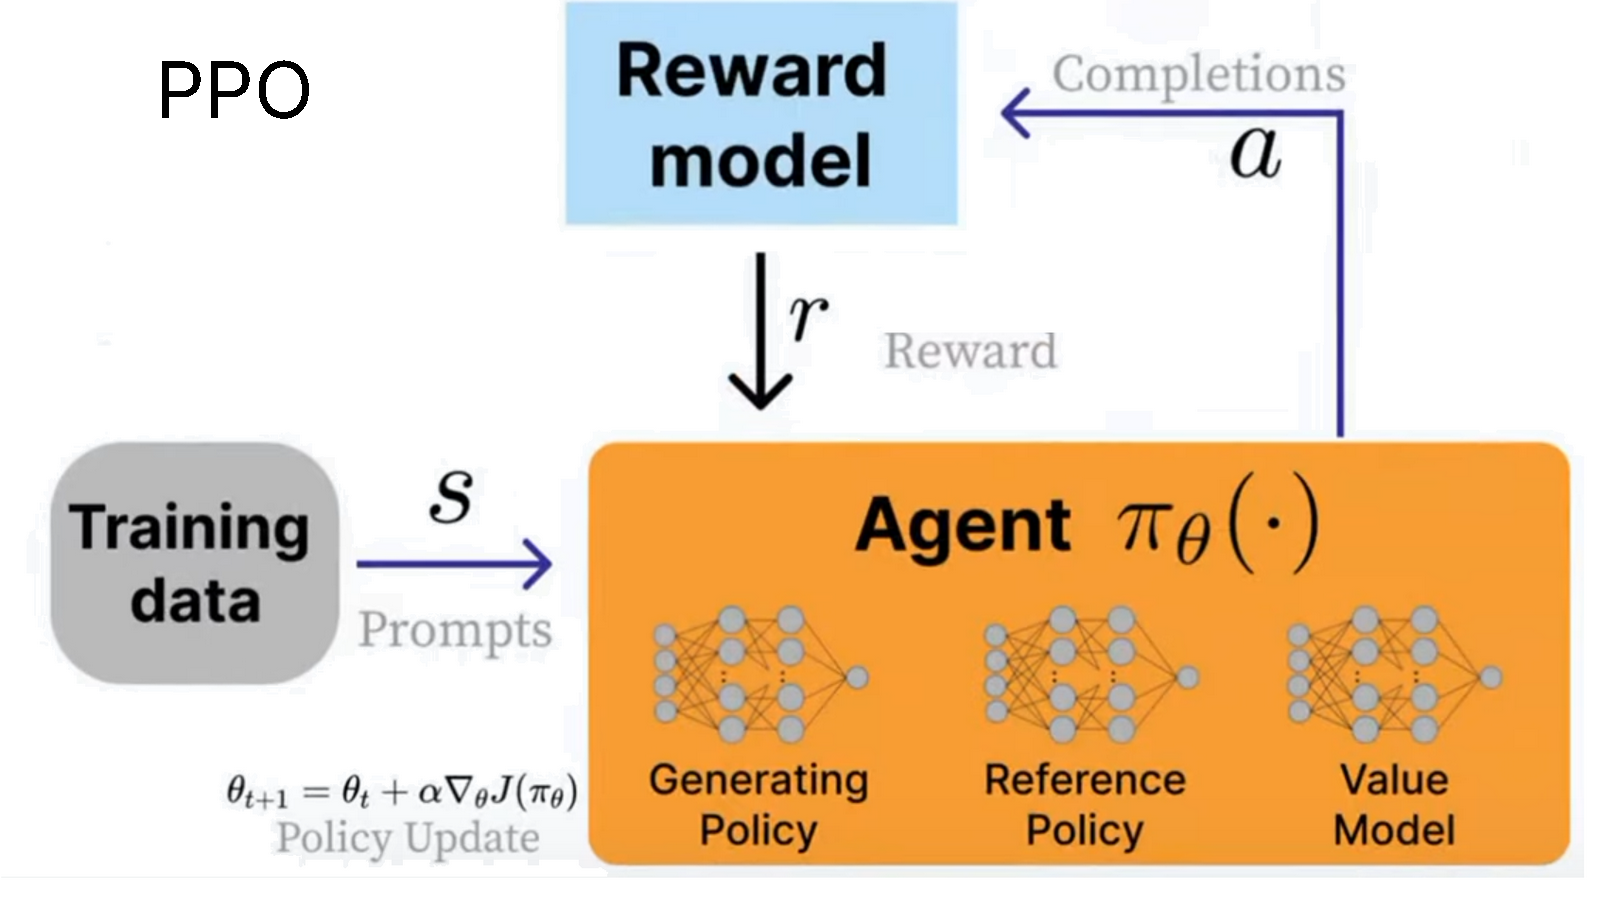
Um RLHF durchzuführen, [**PPO**](https://en.wikipedia.org/wiki/Proximal_policy_optimization) (Proximal Policy Optimization) wurde entwickelt. Der **Agent** ist in diesem Fall das Sprachmodell. Tatsächlich besteht es aus 3 Systemen:
1. Der **Erzeugende Policy (aktuell trainiertes Modell)**
2. Der **Referenz-Policy (ursprüngliches Modell)**
3. Der **Wertmodell (durchschnittlicher Belohnungsschätzer)**
Wir verwenden das **Belohnungsmodell** um die Belohnung für die aktuelle Umgebung zu berechnen, und unser Ziel ist es, **diese zu maximieren**!
Die Formel für PPO sieht ziemlich kompliziert aus, weil sie so entworfen wurde, dass sie stabil ist. Besuchen Sie unseren [AI Engineer-Vortrag](https://docs.unsloth.ai/ai-engineers-2025) den wir 2025 über RL gehalten haben, für ausführlichere mathematische Herleitungen zu PPO.
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
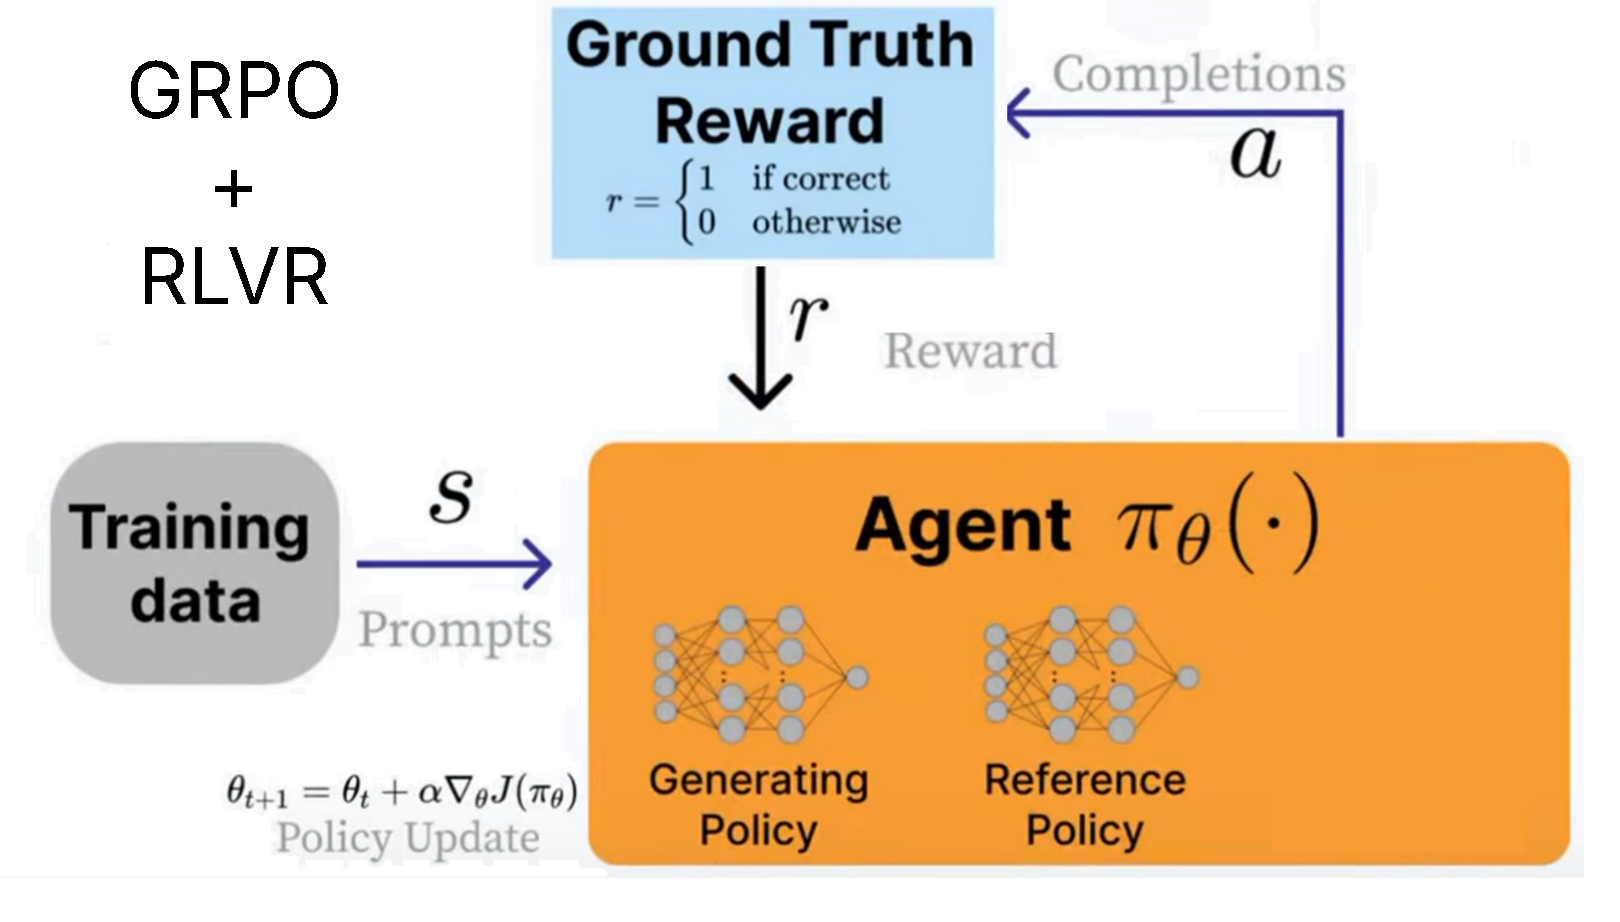
DeepSeek entwickelte [**GRPO**](https://unsloth.ai/blog/grpo) (Group Relative Policy Optimization), um ihre R1-Reasoning-Modelle zu trainieren. Die wichtigsten Unterschiede zu PPO sind:
1. Der **Das Wertmodell wird entfernt,** ersetzt durch Statistiken aus dem mehrfachen Aufrufen des Belohnungsmodells.
2. Der **Das Belohnungsmodell wird entfernt** und ersetzt durch nur eine benutzerdefinierte Belohnungsfunktion, die **RLVR** verwendet werden kann.
{% endcolumn %}
{% endcolumns %}
Das bedeutet, dass GRPO extrem effizient ist. Früher musste PPO mehrere Modelle trainieren – jetzt, da das Belohnungsmodell und das Wertmodell entfernt wurden, können wir Speicher sparen und alles beschleunigen.
**RLVR (Reinforcement Learning with Verifiable Rewards)** ermöglicht es uns, das Modell anhand von Aufgaben mit leicht überprüfbaren Lösungen zu belohnen. Zum Beispiel:
1. Mathematikgleichungen können leicht verifiziert werden. Z. B. 2+2 = 4.
2. Code-Ausgaben können darauf überprüft werden, ob sie korrekt ausgeführt wurden oder nicht.
3. Die Entwicklung überprüfbarer Belohnungsfunktionen kann schwierig sein, daher sind die meisten Beispiele Mathematik oder Code.
4. Anwendungsfälle für GRPO beschränken sich nicht nur auf Code oder Mathematik – sein Denkprozess kann Aufgaben wie E-Mail-Automatisierung, Datenbankabfrage, Recht und Medizin verbessern und die Genauigkeit basierend auf Ihrem Datensatz und Ihrer Belohnungsfunktion erheblich steigern - der Trick besteht darin, eine **Bewertungsrubrik zu definieren – also eine Liste kleinerer überprüfbarer Belohnungen, und nicht eine einzige alles verzehrende Endbelohnung.** OpenAI machte dies in ihrem [Angebot zum Reinforcement-Learning-Finetuning (RFT)](https://platform.openai.com/docs/guides/reinforcement-fine-tuning) zum Beispiel populär.
{% columns %}
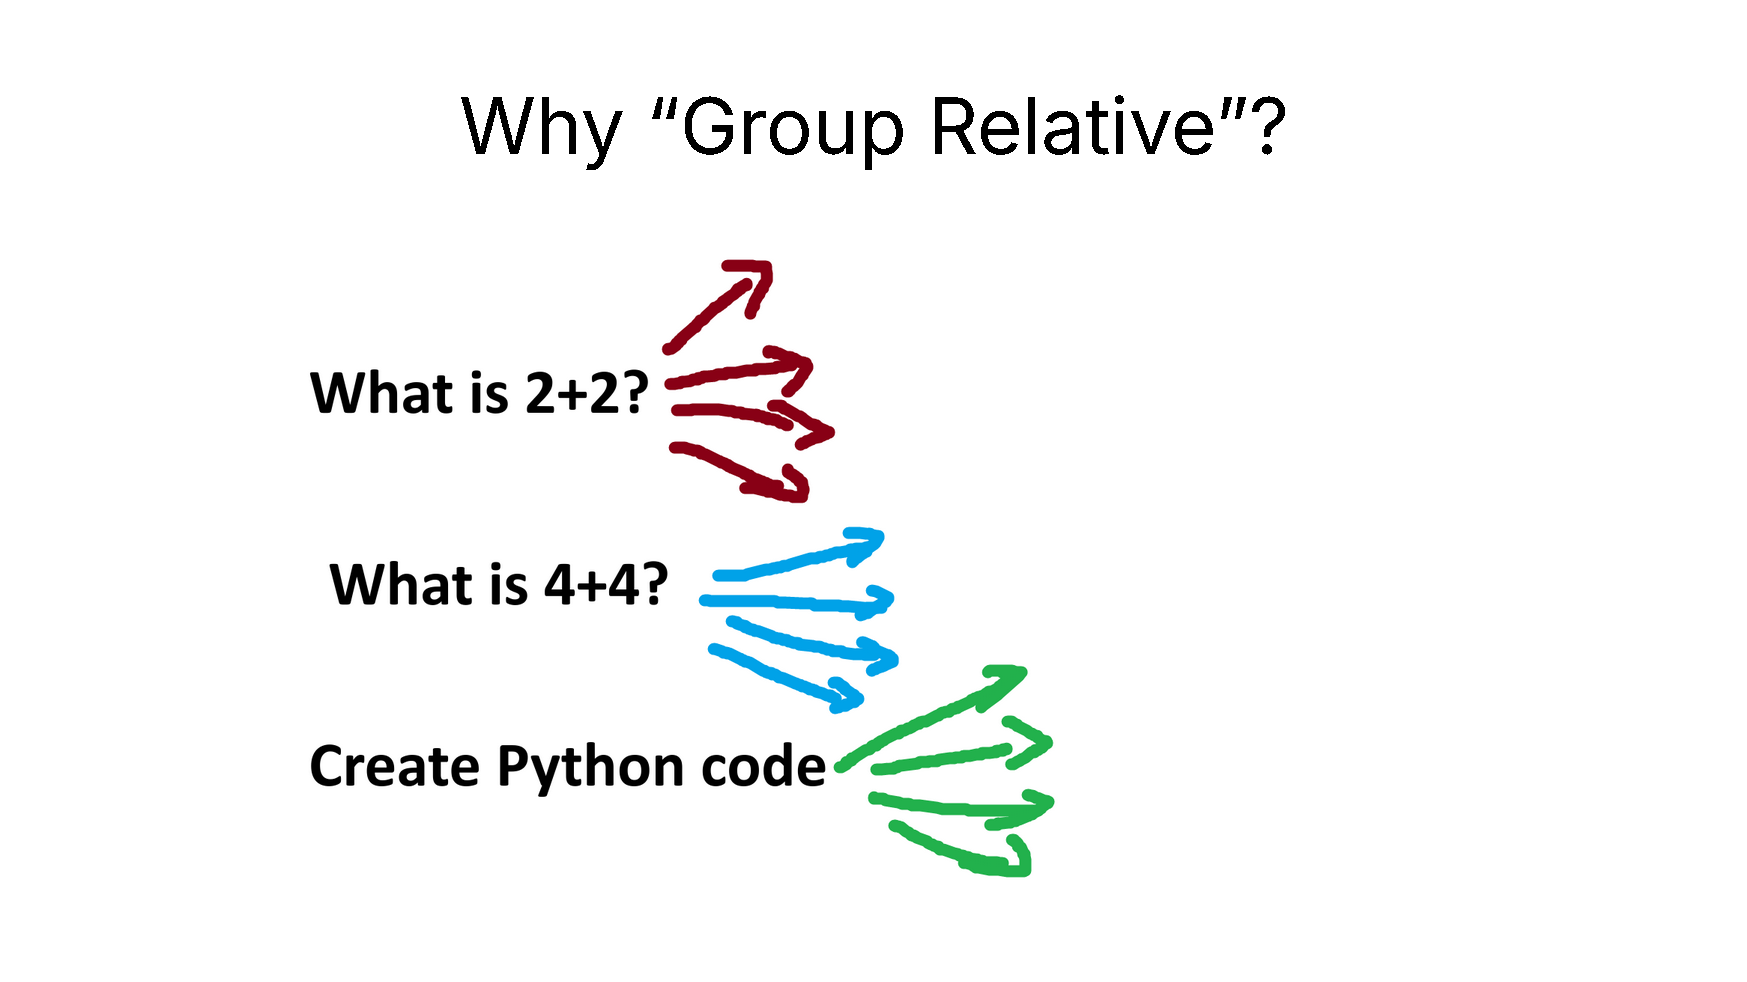
{% column %} **Warum „Group Relative“?**
GRPO entfernt das Wertmodell vollständig, aber wir müssen weiterhin die **„durchschnittliche Belohnung“** für den aktuellen Zustand schätzen.
Der **Der Trick besteht darin, das LLM zu sampeln**! Wir berechnen dann die durchschnittliche Belohnung über Statistiken des Sampling-Prozesses über mehrere verschiedene Fragen hinweg.
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
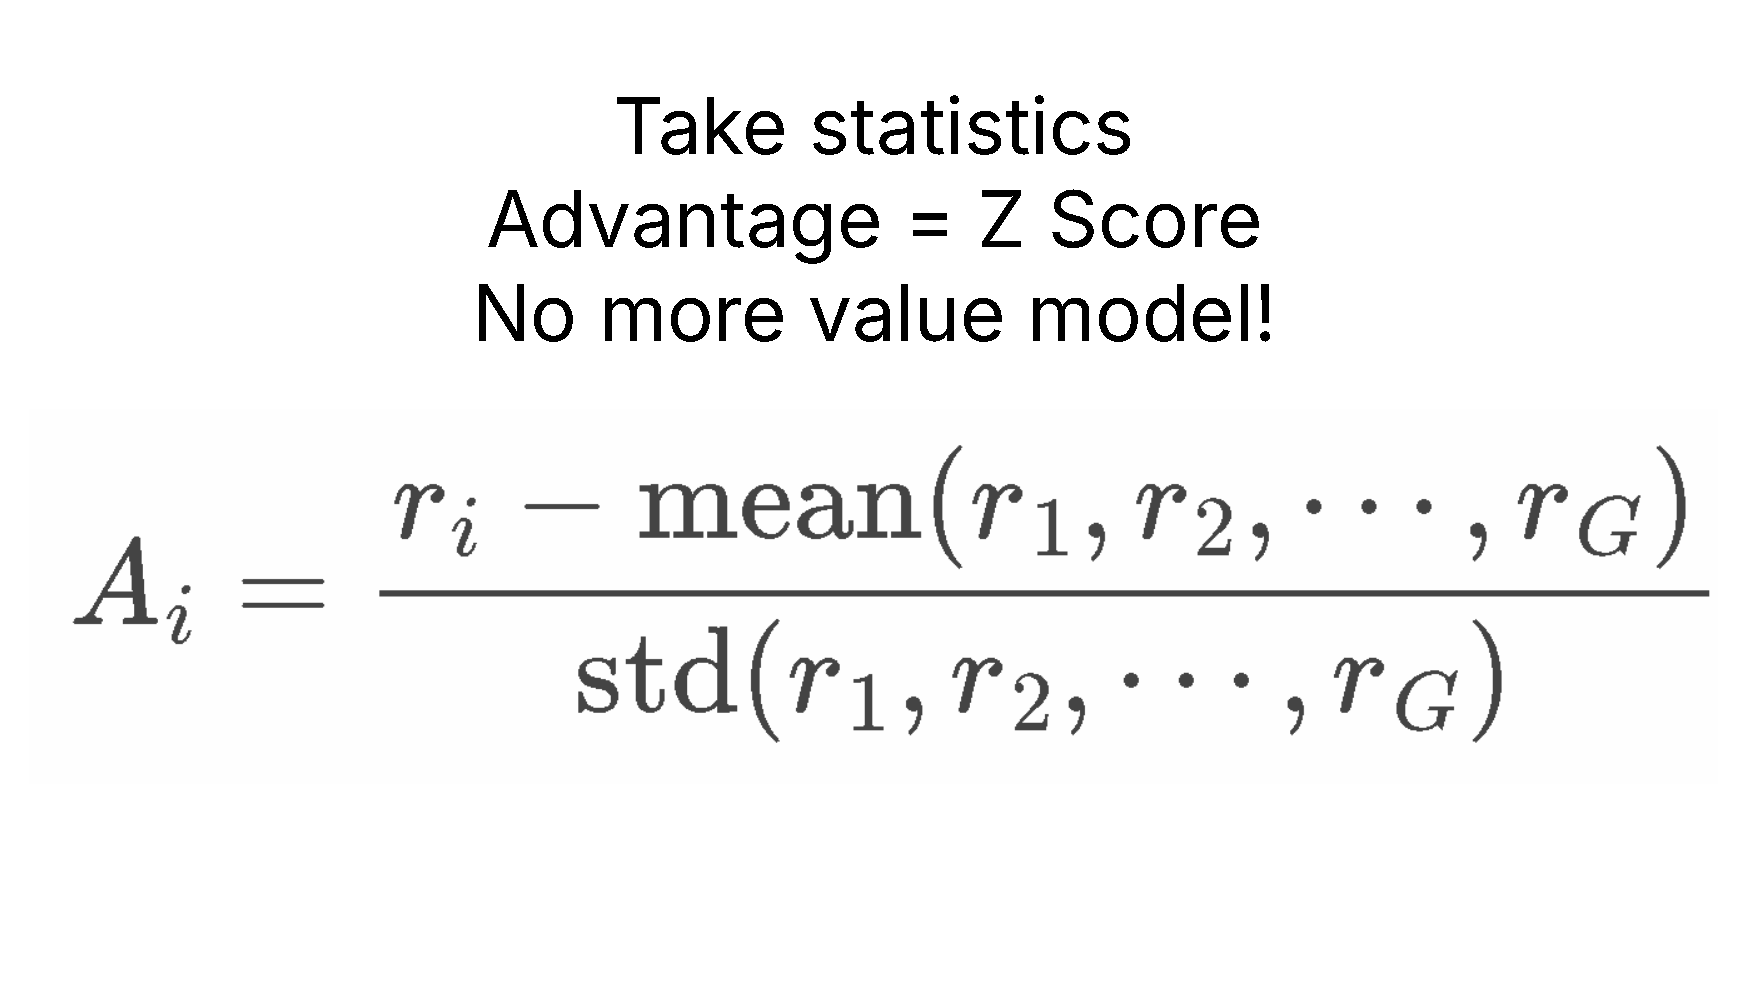
Zum Beispiel sampeln wir für „Was ist 2+2?“ 4-mal. Wir könnten 4, 3, D, C erhalten. Wir berechnen dann die Belohnung für jede dieser Antworten und anschließend die **durchschnittliche Belohnung** und **Standardabweichung**, dann **Z-Score standardisieren** das!
Dies erzeugt die **Vorteile A**, die wir anstelle des Wertmodells verwenden werden. Das spart viel Speicher!
{% endcolumn %}
{% column %}
GRPO-Vorteilsberechnung
{% endcolumn %}
{% endcolumns %}
### :fingers\_crossed:Glück (nun, Geduld) ist alles, was du brauchst
Der Trick von RL ist, dass Sie nur 2 Dinge brauchen:
1. Eine Frage oder Anweisung, z. B. „Was ist 2+2?“ „Erstelle ein Flappy-Bird-Spiel in Python“
2. Eine Belohnungsfunktion und einen Verifier, um zu prüfen, ob die Ausgabe gut oder schlecht ist.
Mit nur diesen 2 können wir im Wesentlichen **ein Sprachmodell unendlich oft aufrufen** bis wir eine gute Antwort erhalten. Zum Beispiel würde ein untrainiertes schlechtes Sprachmodell für „Was ist 2+2?“ Folgendes ausgeben:
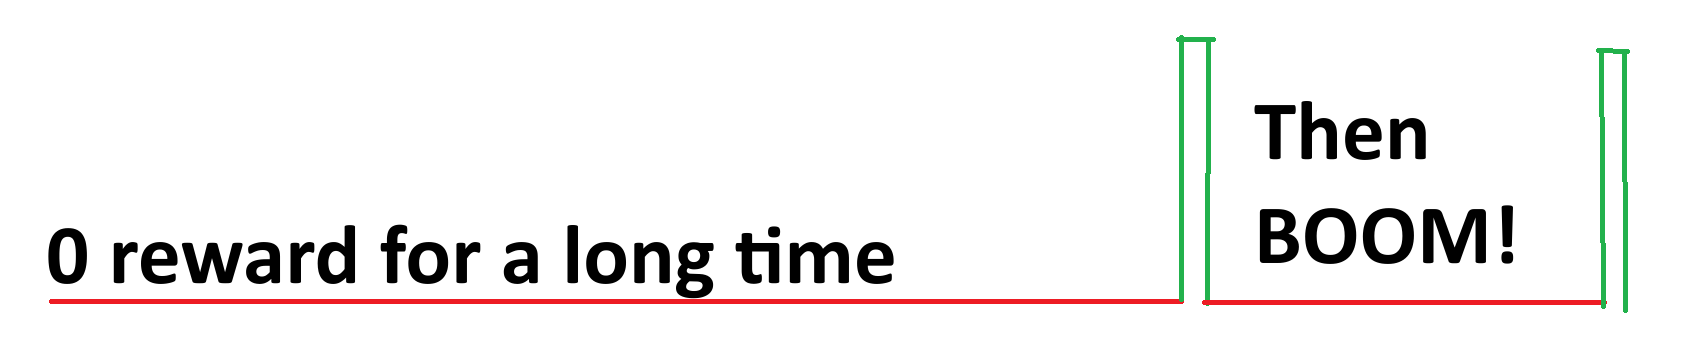
***0, Katze, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****dann plötzlich 4****.***
***Das Belohnungssignal war 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0\*\*\*\*\*\*\*\* ****dann plötzlich 1.***
Also hat RL durch Glück und Zufall über mehrere **Rollouts**die richtige Antwort gefunden. Unser Ziel ist es, dass wir die gute Antwort 4 öfter sehen und den Rest (die schlechten Antworten) viel seltener.
**Das Ziel von RL ist also, geduldig zu sein – im Grenzfall, wenn die Wahrscheinlichkeit der korrekten Antwort mindestens eine kleine Zahl ist (nicht null), ist es nur ein Wartespiel – Sie werden die korrekte Antwort im Grenzfall zu 100 % sicher antreffen.**
**Deshalb nenne ich es bei RL gerne „Glück ist alles, was du brauchst“.**
**Nun, eine bessere Formulierung ist „Geduld ist alles, was du brauchst“ für RL.**
RL gibt uns im Wesentlichen einen Trick – statt einfach bis ins Unendliche zu warten, erhalten wir „schlechte Signale“, also schlechte Antworten, und können das Modell im Wesentlichen „anleiten“, bereits zu versuchen, keine schlechten Lösungen zu erzeugen. Das bedeutet: Obwohl Sie sehr lange auf eine „gute“ Antwort gewartet haben, wurde das Modell bereits so verändert, dass es sein Bestes gibt, keine schlechten Antworten auszugeben.
Im Beispiel „Was ist 2+2?“ – ***0, Katze, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****dann plötzlich 4****.***
Da wir schlechte Antworten erhalten haben, wird RL das Modell beeinflussen, zu versuchen, KEINE schlechten Antworten auszugeben. Das bedeutet, dass wir im Laufe der Zeit die Ausgabeverteilung des Modells vorsichtig „beschnittener“ machen oder von schlechten Antworten weg verschieben. Das bedeutet, RL ist **effizient**, da wir NICHT einfach bis ins Unendliche warten, sondern aktiv versuchen, das Modell so weit wie möglich in den „Bereich der korrekten Antworten“ zu „schieben“.
{% hint style="danger" %}
**Wenn die Wahrscheinlichkeit immer 0 ist, wird RL niemals funktionieren**. Deshalb machen Leute gerne RL von einem bereits instruktions-feinabgestimmten Modell aus, das Anweisungen teilweise ziemlich gut befolgen kann – dadurch steigt die Wahrscheinlichkeit meist über 0.
{% endhint %}
## :sloth:Was Unsloth für RL bietet
* Mit 15 GB VRAM ermöglicht Unsloth, jedes Modell mit bis zu 17B Parametern wie Llama 3.1 (8B), Phi-4 (14B), Mistral (7B) oder Qwen2.5 (7B) in ein Reasoning-Modell zu verwandeln
* **Unsloth unterstützt jetzt** [**RL für Vision/Multimodal-**](/docs/de/loslegen/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) **Modelle!**
* **Mindestanforderung:** Nur 5 GB VRAM reichen aus, um Ihr eigenes Reasoning-Modell lokal zu trainieren (für jedes Modell mit 1,5B Parametern oder weniger)
{% columns %}
{% column %}
{% content-ref url="/pages/2b7904fd5422b954809fd2460ec92281ba56a6fa" %}
[Tutorial: GRPO Training](/docs/de/loslegen/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
{% content-ref url="/pages/b6b5ca32e463fa09c0f26919da403e22381129bc" %}
[Vision RL](/docs/de/loslegen/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
{% hint style="info" %}
Für **fortgeschrittenes GRPO** Dokumentation zu Batching-, Generierungs- und Trainingsparametern, [lesen Sie unseren Leitfaden!](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### GRPO-Notebooks:
| [**Gemma 4 E2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma4_\(E2B\)_Reinforcement_Learning_Sudoku_Game.ipynb) - **neue** | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - Vision GSPO | [Gemma 3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - Vision GSPO |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------ |
| [**Qwen3.5 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - *****neue*** | [gpt-oss-20b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) GSPO | [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Erweitert |
| [Qwen3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Erweitert | [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb) | [DeepSeek-R1-0528-Qwen3-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) |
| [Mistral v0.3 (7B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb) | [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb) | [Qwen3-8B - **FP8**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_8B_FP8_GRPO.ipynb) (L4) |
{% hint style="success" %}
Wir unterstützen [**GSPO**](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation/gspo-reinforcement-learning.md) und die meisten anderen neuen GRPO-Techniken. Sie können mit den folgenden Argumenten in GRPOConfig spielen, um zu aktivieren:
```python
epsilon=0.2,
epsilon_high=0.28, # einseitig
delta=1.5 # zweiseitig
loss_type='gspo',
# oder:
loss_type='grpo',
# oder:
loss_type='dr_grpo',
mask_truncated_completions=True,
```
{% endhint %}
* Wenn Sie kein Reasoning erhalten, stellen Sie sicher, dass Sie genügend Trainingsschritte haben und dass Ihre [Belohnungsfunktion/Verifier](#reward-functions-verifier) funktioniert. Wir stellen Beispiele für Belohnungsfunktionen bereit [hier](#reward-function-examples).
* Frühere Demonstrationen zeigen, dass Sie Ihren eigenen „Aha“-Moment mit Qwen2.5 (3B) erreichen konnten – dafür waren jedoch 2xA100-GPUs (160GB VRAM) nötig. Jetzt können Sie mit Unsloth denselben „Aha“-Moment mit nur einer einzelnen 5GB-VRAM-GPU erreichen.
* Früher wurde GRPO nur für Full Fine-Tuning unterstützt, aber wir haben es mit QLoRA und LoRA zum Laufen gebracht
* Auf [**20K Kontextlängen**](#grpo-requirement-guidelines) zum Beispiel mit 8 Generierungen pro Prompt benötigt Unsloth nur 54,3GB VRAM für Llama 3.1 (8B), während Standardimplementierungen (+ Flash Attention 2) **510,8GB benötigen (90 % weniger für Unsloth)**.
* Bitte beachten Sie, dass dies nicht das Fine-Tuning von DeepSeeks R1-Distilled-Modellen oder die Verwendung von distillierten Daten aus R1 für das Tuning ist, was Unsloth bereits unterstützt hat. Dies ist die Umwandlung eines Standardmodells in ein vollwertiges Reasoning-Modell mit GRPO.
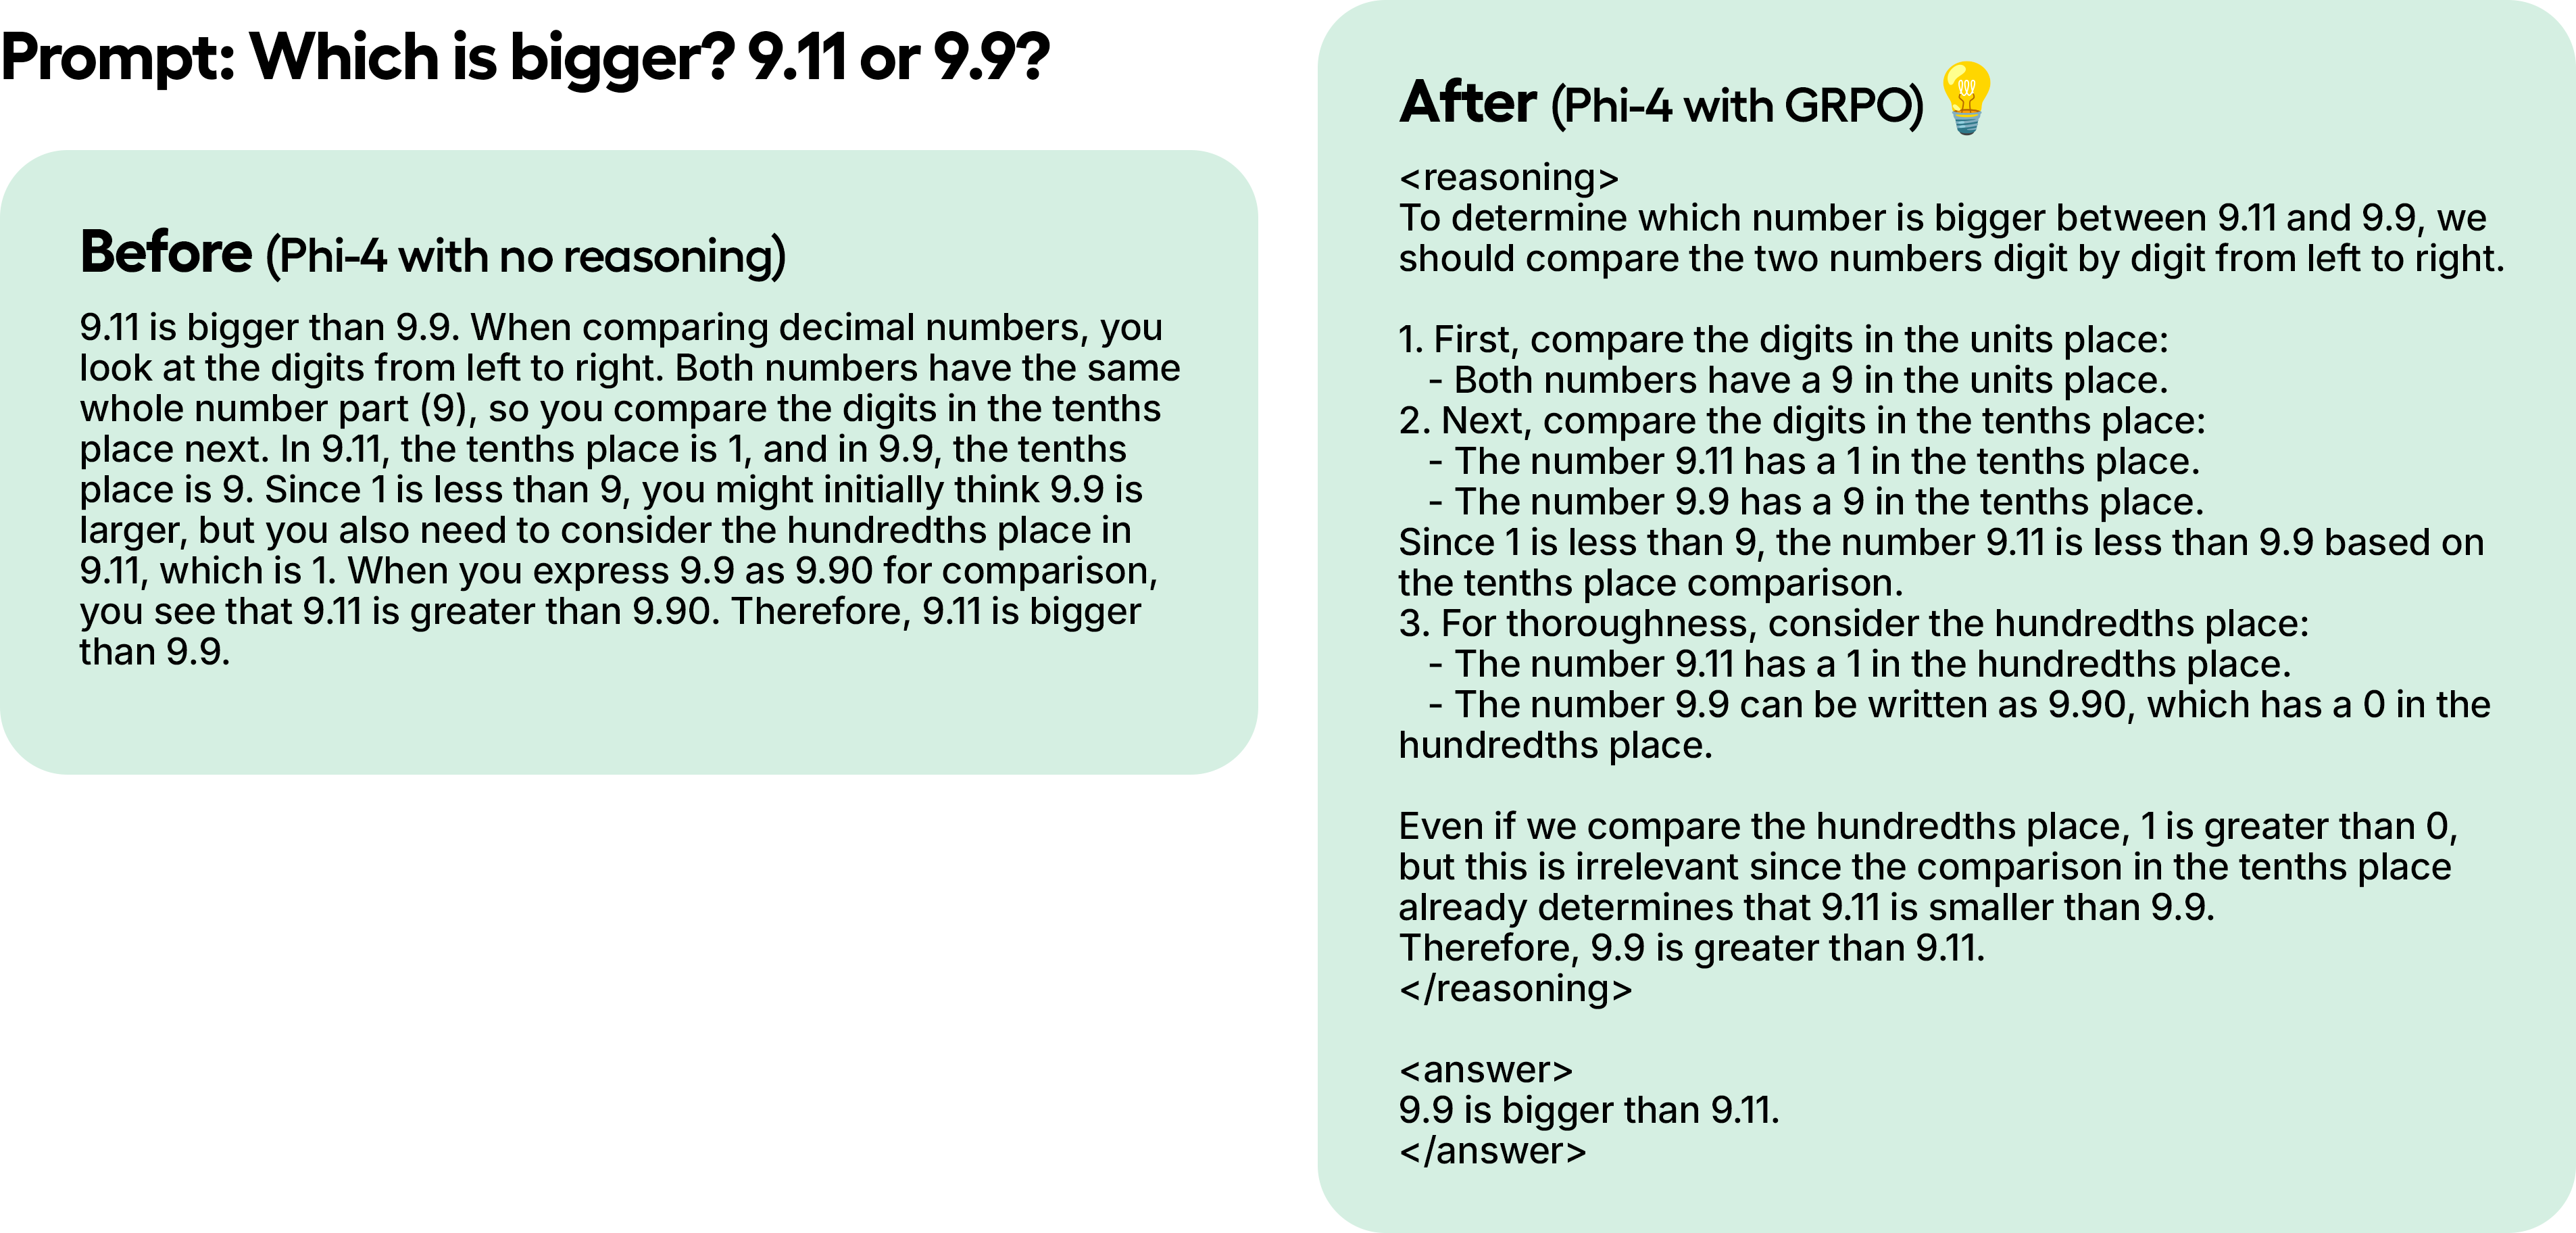
In einem Testbeispiel sind die Ergebnisse bereits klar, obwohl wir Phi-4 nur mit 100 Schritten unter Verwendung von GRPO trainiert haben. Das Modell ohne GRPO hat das Denk-Token nicht, während das mit GRPO trainierte es hat und außerdem die richtige Antwort liefert.
## :computer:Training mit GRPO
Für ein Tutorial dazu, wie man mit Unsloth & GRPO jedes offene LLM in ein Reasoning-Modell verwandelt, [sehen Sie hier](/docs/de/loslegen/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
Für **fortgeschrittenes GRPO** Dokumentation zu Batching-, Generierungs- und Trainingsparametern, [lesen Sie unseren Leitfaden!](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### **Wie GRPO ein Modell trainiert**
1. Für jedes Frage-Antwort-Paar erzeugt das Modell mehrere mögliche Antworten (z. B. 8 Varianten).
2. Jede Antwort wird mithilfe von Belohnungsfunktionen bewertet.
3. Trainingsschritte:
* Wenn Sie 300 Datenzeilen haben, sind das 300 Trainingsschritte (oder 900 Schritte bei 3 Epochen).
* Sie können die Anzahl der generierten Antworten pro Frage erhöhen (z. B. von 8 auf 16).
4. Das Modell lernt, indem es bei jedem Schritt seine Gewichte aktualisiert.
{% hint style="warning" %}
Wenn Sie Probleme damit haben, dass Ihr GRPO-Modell nicht lernt, empfehlen wir Ihnen dringend, unsere [Fortgeschrittenen GRPO-Notebooks](/docs/de/loslegen/unsloth-notebooks.md#grpo-reasoning-notebooks) zu verwenden, da es eine deutlich bessere Belohnungsfunktion hat und Sie schneller und häufiger Ergebnisse sehen sollten.
{% endhint %}
### Grundlagen/Tipps
* Warten Sie mindestens **300 Schritte** darauf, dass die Belohnung tatsächlich steigt. Um anständige Ergebnisse zu erzielen, müssen Sie möglicherweise mindestens 12 Stunden investieren (so funktioniert GRPO), aber beachten Sie, dass dies nicht zwingend ist, da Sie jederzeit aufhören können.
* Für optimale Ergebnisse haben Sie mindestens **500 Datenzeilen**. Sie können es sogar mit 10 Datenzeilen versuchen, aber mehr ist besser.
* Jeder Trainingslauf ist je nach Modell, Daten, Belohnungsfunktion/Verifier usw. immer anders. Auch wenn wir 300 Schritte als Minimum angegeben haben, kann es manchmal 1000 Schritte oder mehr sein. Es hängt also von verschiedenen Faktoren ab.
* Wenn Sie GRPO lokal mit Unsloth verwenden und einen Fehler erhalten, installieren Sie bitte auch „pip install diffusers“. Bitte verwenden Sie außerdem die neueste Version von vLLM.
* Es wird empfohlen, GRPO auf ein Modell mit mindestens **1,5B Parametern** anzuwenden, damit es Denk-Tokens korrekt erzeugen kann, da kleinere Modelle das möglicherweise nicht tun.
* Für GRPOs [**GPU-VRAM-Anforderungen**](#grpo-requirement-guidelines) **für QLoRA 4-Bit**, gilt die allgemeine Regel: Die Modellparameter entsprechen der Menge an VRAM, die Sie benötigen werden (Sie können weniger VRAM verwenden, aber das ist nur zur Sicherheit). Je mehr Kontextlänge Sie einstellen, desto mehr VRAM. LoRA 16-Bit benötigt mindestens 4x mehr VRAM.
* **Kontinuierliches Fine-Tuning ist** möglich, und Sie können GRPO einfach im Hintergrund laufen lassen.
* In den Beispiel-Notebooks verwenden wir das [**GSM8K-Dataset**](#gsm8k-reward-functions), die derzeit beliebteste Wahl für R1-ähnliches Training.
* Wenn Sie ein Basismodell verwenden, stellen Sie sicher, dass Sie eine Chatvorlage haben.
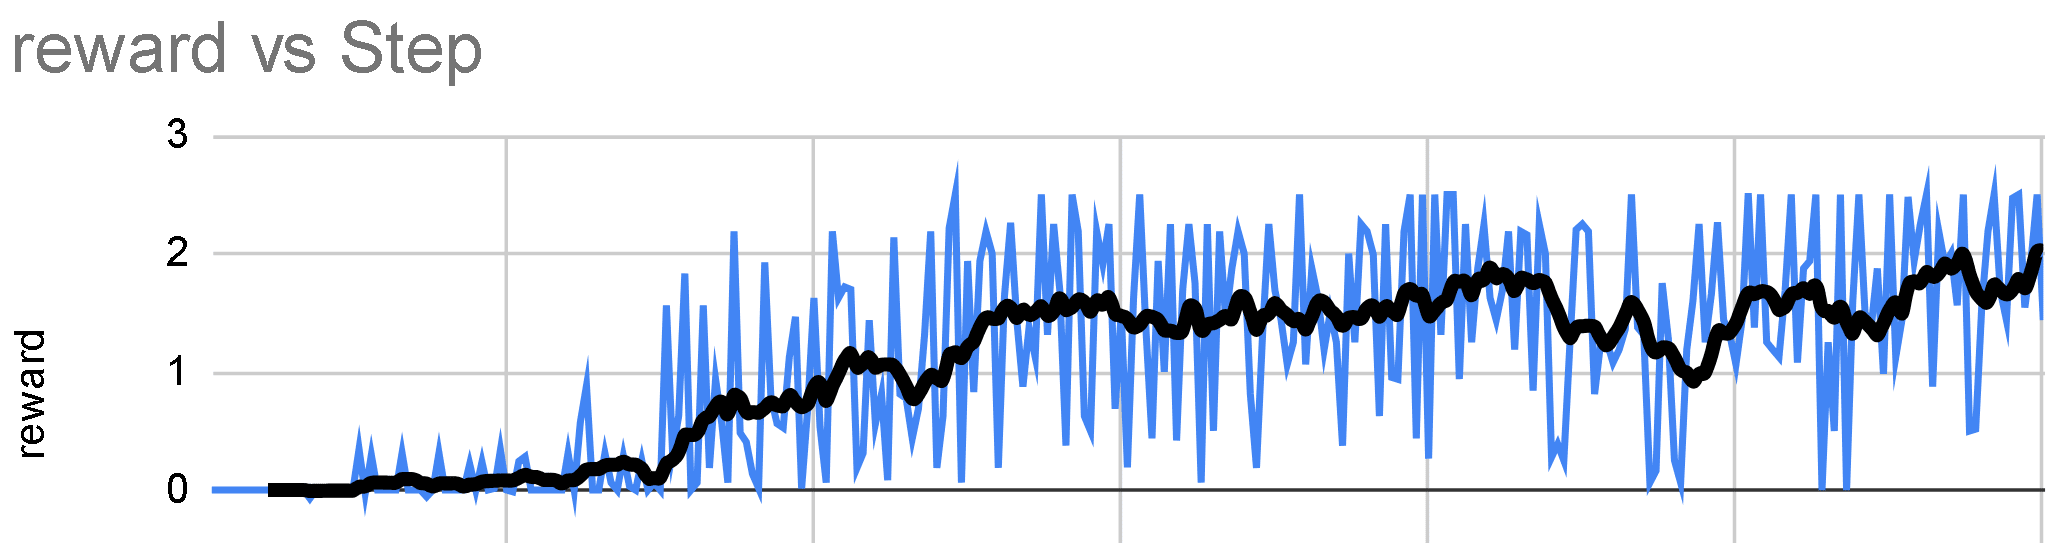
* Je mehr Sie mit GRPO trainieren, desto besser. Das Beste an GRPO ist, dass Sie gar nicht so viele Daten benötigen. Alles, was Sie brauchen, ist eine großartige Belohnungsfunktion/ein Verifier, und je mehr Zeit Sie mit Training verbringen, desto besser wird Ihr Modell. Erwarten Sie, dass Ihre Belohnung gegenüber den Schritten mit der Zeit so ansteigt:
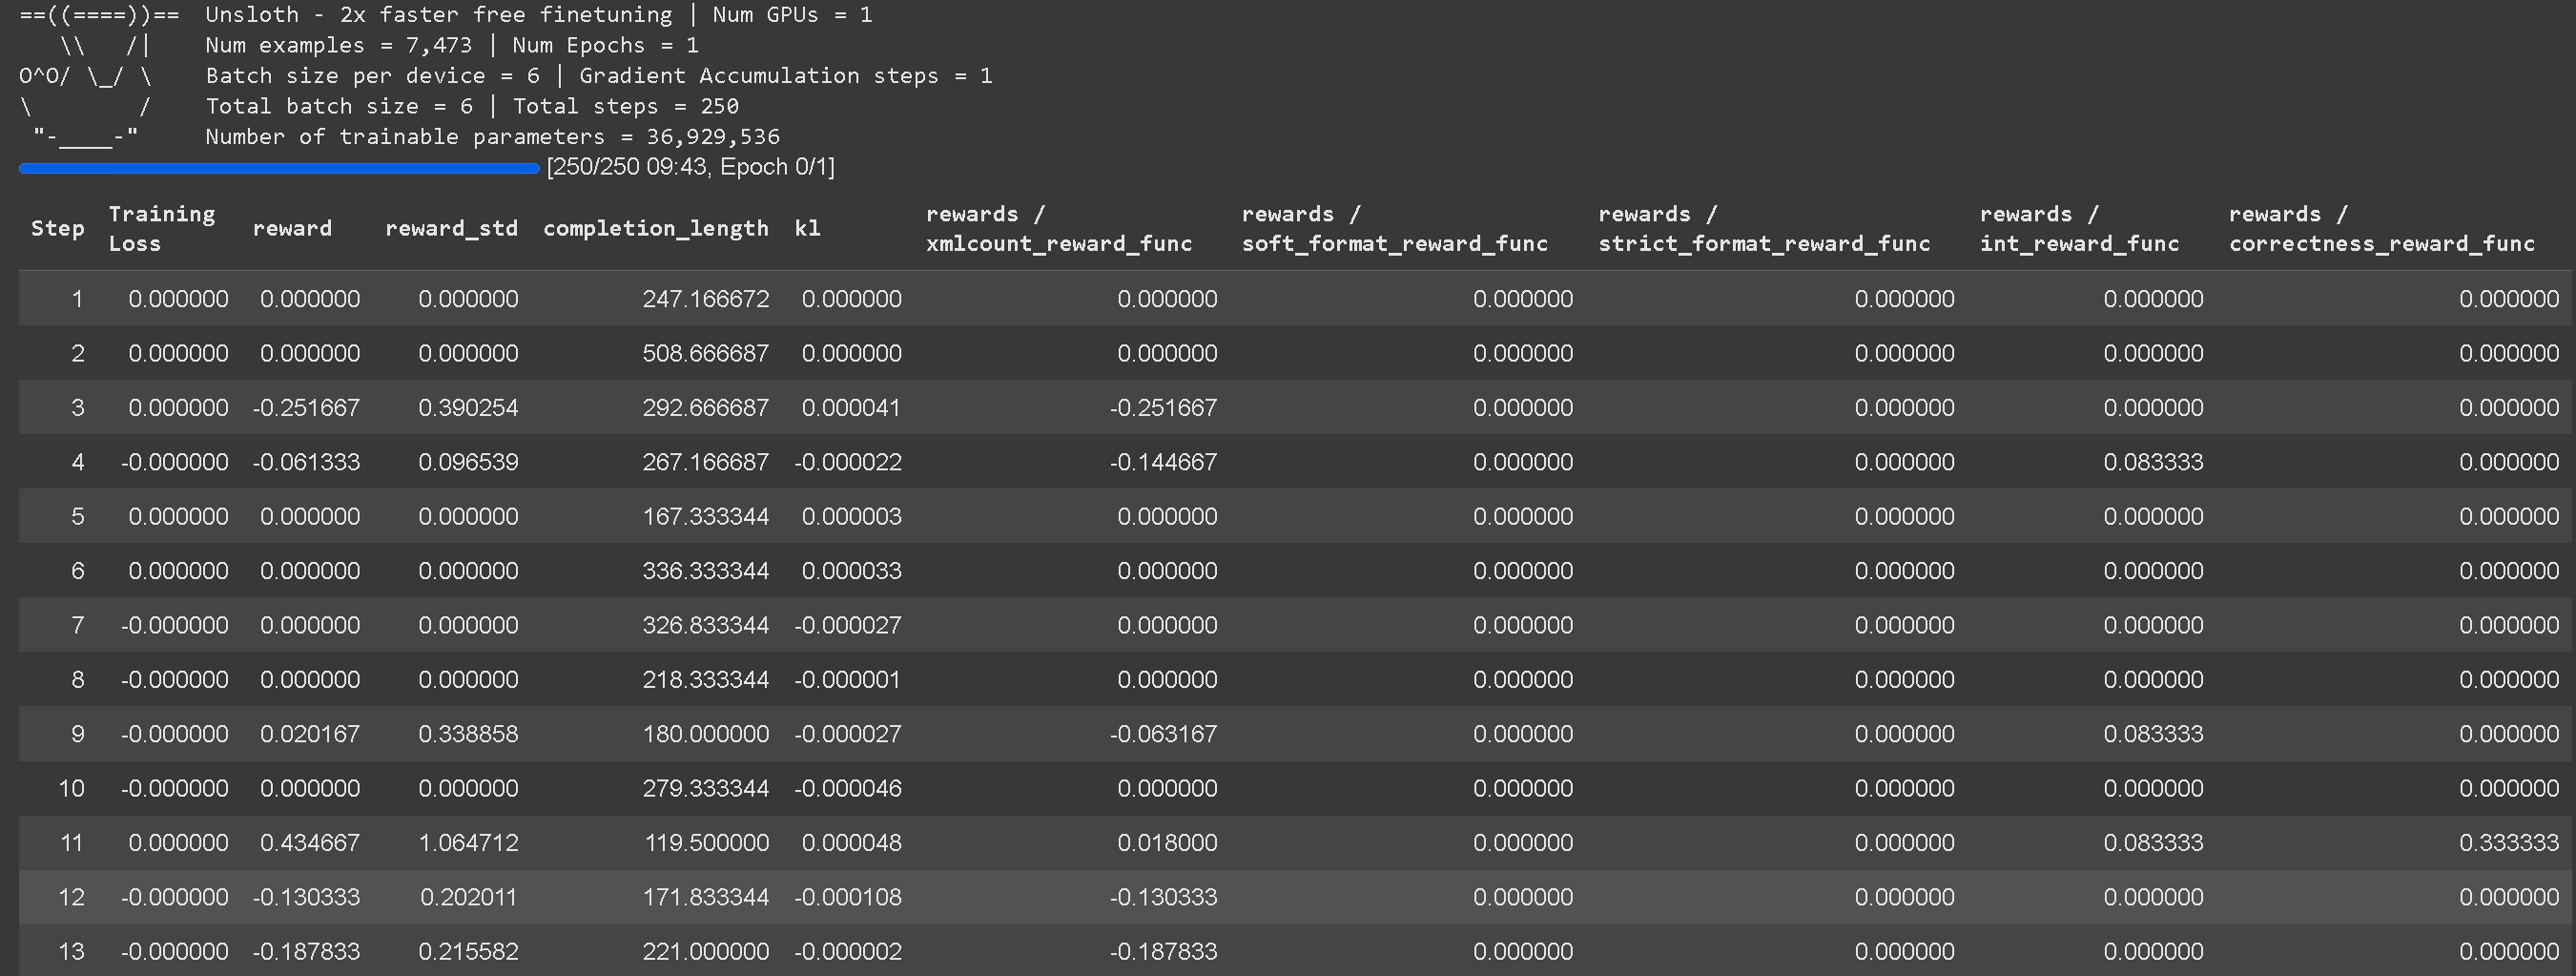
* Das Tracking des Trainingsverlusts für GRPO ist jetzt direkt in Unsloth integriert, wodurch externe Tools wie wandb usw. nicht mehr benötigt werden. Es enthält jetzt vollständige Protokolle für alle Belohnungsfunktionen, einschließlich der gesamten aggregierten Belohnungsfunktion selbst.
### RL auf nicht unterstützten Modellen:
Sie können RL mit Unsloth auch auf Modellen ausführen, die von vLLM nicht unterstützt werden, wie z. B. [Qwen3.5](/docs/de/modelle/qwen3.5/fine-tune.md). Setzen Sie einfach `fast_inference=False` beim Laden des Modells.
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Qwen3.5-4B",
fast_inference=False,
)
```
## :clipboard:Belohnungsfunktionen / Verifier
Beim Reinforcement Learning dient eine **Belohnungsfunktion** und ein **Verifier** unterschiedlichen Rollen bei der Bewertung der Ausgabe eines Modells. Im Allgemeinen könnte man sie als dasselbe interpretieren, technisch gesehen sind sie es jedoch nicht, aber das ist nicht so wichtig, da sie normalerweise zusammen verwendet werden.
**Verifier**:
* Bestimmt, ob die erzeugte Antwort korrekt oder inkorrekt ist.
* Sie vergibt keine numerische Punktzahl – sie überprüft lediglich die Richtigkeit.
* Beispiel: Wenn ein Modell für „2+2“ „5“ erzeugt, prüft der Verifier dies und kennzeichnet es als „falsch“ (da die richtige Antwort 4 ist).
* Verifier können auch Code ausführen (z. B. in Python), um Logik, Syntax und Korrektheit zu validieren, ohne manuelle Bewertung zu benötigen.
**Belohnungsfunktion**:
* Wandelt Verifikationsergebnisse (oder andere Kriterien) in eine numerische Punktzahl um.
* Beispiel: Wenn eine Antwort falsch ist, kann sie eine Strafe vergeben (-1, -2 usw.), während eine korrekte Antwort eine positive Punktzahl erhalten könnte (+1, +2).
* Sie kann auch auf Basis von Kriterien bestrafen, die über die Korrektheit hinausgehen, wie etwa übermäßige Länge oder schlechte Lesbarkeit.
**Wichtige Unterschiede**:
* Ein **Verifier** prüft die Korrektheit, vergibt aber keine Punktzahl.
* Ein **Belohnungsfunktion** vergibt eine Punktzahl, überprüft aber nicht notwendigerweise selbst die Korrektheit.
* Eine Belohnungsfunktion *kannst* verwendet einen Verifier, aber sie sind technisch nicht dasselbe.
### **Belohnungsfunktionen verstehen**
Das Hauptziel von GRPO ist es, die Belohnung zu maximieren und zu lernen, wie eine Antwort zustande kam, anstatt einfach Antworten aus den Trainingsdaten auswendig zu lernen und wiederzugeben.
* Mit jedem Trainingsschritt **passt GRPO die Modellgewichte an** um die Belohnung zu maximieren. Dieser Prozess verfeinert das Modell schrittweise.
* **Normales Fine-Tuning** (ohne GRPO) **maximiert nur die Wahrscheinlichkeit der nächsten Wortvorhersage** optimiert aber nicht auf eine Belohnung. GRPO **optimiert für eine Belohnungsfunktion** anstatt nur das nächste Wort vorherzusagen.
* Sie können **Daten wiederverwenden** über mehrere Epochen hinweg.
* **Standard-Belohnungsfunktionen** können vordefiniert werden, um in einer Vielzahl von Anwendungsfällen verwendet zu werden, oder Sie können ChatGPT/ein lokales Modell bitten, sie für Sie zu erzeugen.
* Es gibt nicht die eine richtige Art, Belohnungsfunktionen oder Verifier zu entwerfen – die Möglichkeiten sind endlos. Sie müssen jedoch gut gestaltet und sinnvoll sein, da schlecht konzipierte Belohnungen die Modellleistung unbeabsichtigt verschlechtern können.
### :coin:Beispiele für Belohnungsfunktionen
Sie können sich auf die folgenden Beispiele beziehen. Sie können Ihre Generierungen in ein LLM wie ChatGPT 4o oder Llama 3.1 (8B) eingeben und eine Belohnungsfunktion sowie einen Verifier entwerfen, um sie zu bewerten. Füttern Sie zum Beispiel Ihre Generierungen in ein LLM Ihrer Wahl und legen Sie eine Regel fest: „Wenn die Antwort zu roboterhaft klingt, ziehe 3 Punkte ab.“ Das hilft, Ausgaben anhand von Qualitätskriterien zu verfeinern
#### **Beispiel #1: Einfache Arithmetikaufgabe**
* **Frage:** `"2 + 2"`
* **Antwort:** `"4"`
* **Belohnungsfunktion 1:**
* Wenn eine Zahl erkannt wird → **+1**
* Wenn keine Zahl erkannt wird → **-1**
* **Belohnungsfunktion 2:**
* Wenn die Zahl mit der richtigen Antwort übereinstimmt → **+3**
* Wenn falsch → **-3**
* **Gesamtbelohnung:** *Summe aller Belohnungsfunktionen*
#### **Beispiel #2: Aufgabe zur E-Mail-Automatisierung**
* **Frage:** Eingehende E-Mail
* **Antwort:** Ausgehende E-Mail
* **Belohnungsfunktionen:**
* Wenn die Antwort ein erforderliches Schlüsselwort enthält → **+1**
* Wenn die Antwort genau mit der idealen Antwort übereinstimmt → **+1**
* Wenn die Antwort zu lang ist → **-1**
* Wenn der Name des Empfängers enthalten ist → **+1**
* Wenn ein Signaturblock (Telefon, E-Mail, Adresse) vorhanden ist → **+1**
### Unsloth-Näherungsbasierte Belohnungsfunktion
Wenn Sie sich unser [**fortgeschrittenes GRPO-Colab-Notebook**](#grpo-notebooks)angesehen haben, werden Sie bemerken, dass wir eine **benutzerdefinierte nähebasierte Belohnungsfunktion** von Grund auf komplett neu entwickelt haben, die darauf ausgelegt ist, Antworten zu belohnen, die näher an der korrekten liegen. Diese flexible Funktion kann auf eine breite Palette von Aufgaben angewendet werden.
* In unseren Beispielen aktivieren wir Reasoning in Qwen3 (Base) und lenken es auf bestimmte Aufgaben
* Wenden Sie Pre-Finetuning-Strategien an, um die Standardtendenz von GRPO zu vermeiden, nur Formatierung zu lernen
* Steigern Sie die Bewertungsgenauigkeit mit regex-basiertem Matching
* Erstellen Sie benutzerdefinierte GRPO-Vorlagen jenseits generischer Prompts wie `think`, z. B., ``
* Wenden Sie nähebasierte Bewertung an — Modelle erhalten mehr Belohnung für nähere Antworten (z. B. ist das Vorhersagen von 9 statt 10 besser als 3), während Ausreißer bestraft werden
#### GSM8K-Belohnungsfunktionen
In unseren anderen Beispielen verwenden wir bestehende GSM8K-Belohnungsfunktionen von [@willccbb](https://x.com/willccbb) die beliebt sind und sich als recht effektiv erwiesen haben:
* **correctness\_reward\_func** – Belohnt exakte Übereinstimmungen mit dem Label.
* **int\_reward\_func** – Fördert Antworten nur mit Ganzzahlen.
* **soft\_format\_reward\_func** – Prüft die Struktur, erlaubt aber kleine Abweichungen bei Zeilenumbrüchen.
* **strict\_format\_reward\_func** – Stellt sicher, dass die Antwortstruktur zum Prompt passt, einschließlich Zeilenumbrüchen.
* **xmlcount\_reward\_func** – Stellt sicher, dass jedes XML-Tag in der Antwort genau einmal vorkommt.
## :abacus:vLLM
Du kannst jetzt [vLLM](https://github.com/vllm-project/vllm/) direkt in Ihrem Finetuning-Stack zu verwenden, was deutlich mehr Durchsatz ermöglicht und es erlaubt, das Modell gleichzeitig zu feinabstimmen und Inferenz darauf auszuführen! Auf 1x A100 40GB erwarten Sie ungefähr 4000 Tokens/s mit Unsloths dynamischer 4-Bit-Quantisierung von Llama 3.2 3B Instruct. Auf einer 16GB Tesla T4 (kostenlose Colab-GPU) können Sie 300 Tokens/s erreichen.\
\
Wir haben außerdem auf magische Weise die doppelte Speichernutzung beim gemeinsamen Laden von vLLM und Unsloth entfernt, was Einsparungen von etwa 5GB für Llama 3.1 8B und 3GB für Llama 3.2 3B ermöglicht. Unsloth konnte ursprünglich Llama 3.3 70B Instruct auf einer 1x 48GB-GPU feinabstimmen, wobei die Gewichte von Llama 3.3 70B 40GB VRAM belegten. Wenn wir die doppelte Speichernutzung nicht entfernen, benötigen wir >= 80GB VRAM, wenn Unsloth und vLLM zusammen geladen werden.\
\
Aber mit Unsloth können Sie weiterhin feinabstimmen und die Vorteile schneller Inferenz in einem Paket unter 48GB VRAM erhalten! Um schnelle Inferenz zu verwenden, installieren Sie zuerst vllm und instanziieren Sie Unsloth mit fast\_inference:
```python
# pip install unsloth vllm
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Llama-3.2-3B-Instruct",
fast_inference = True,
)
```
## :white\_check\_mark:GRPO-Anforderungsrichtlinien
Wenn Sie Unsloth für GRPO verwenden, reduzieren wir den VRAM-Verbrauch auf smarte Weise um mehr als 90 % im Vergleich zu Standardimplementierungen mit Flash Attention 2, indem wir mehrere Tricks verwenden! Bei 20K-Kontextlängen zum Beispiel mit 8 Generierungen pro Prompt verwendet Unsloth nur **54,3GB VRAM für Llama 3.1 8B**, während Standardimplementierungen **510,8GB benötigen (90 % weniger für Unsloth)**.
1. Für GRPOs **GPU-VRAM-Anforderungen für QLoRA 4-Bit**, gilt die allgemeine Regel: Die Modellparameter entsprechen der Menge an VRAM, die Sie benötigen werden (Sie können weniger VRAM verwenden, aber das ist nur zur Sicherheit). Je mehr Kontextlänge Sie einstellen, desto mehr VRAM. LoRA 16-Bit benötigt mindestens 4x mehr VRAM.
2. Unsere neuen speichereffizienten linearen Kernel für GRPO senken den Speicherverbrauch um das 8-Fache oder mehr. Dadurch werden 68,5GB Speicher eingespart, und das sogar schneller dank torch.compile!
3. Wir nutzen unser intelligentes [Unsloth-Gradienten-Checkpointing](https://unsloth.ai/blog/long-context) -Algorithmus, den wir vor einiger Zeit veröffentlicht haben. Er lagert Zwischenaktivierungen intelligent und asynchron in den System-RAM aus, bei nur 1 % langsamerer Ausführung. Dadurch werden 52GB Speicher eingespart.
4. Unsloth verwendet außerdem denselben GPU-/CUDA-Speicherbereich wie die zugrunde liegende Inferenz-Engine (vLLM), anders als Implementierungen in anderen Paketen. Dadurch werden 16GB Speicher eingespart.
| Metriken | Unsloth | Standard + FA2 |
| ------------------------------------------- | ---------------------- | -------------- |
| Trainingsspeicherverbrauch (GB) | 42GB | 414GB |
| GRPO-Speicherverbrauch (GB) | 9,8GB | 78,3GB |
| Inferenzkosten (GB) | 0GB | 16GB |
| Inferenz-KV-Cache für 20K Kontextlänge (GB) | 2,5 GB | 2,5 GB |
| Gesamtspeicherverbrauch | 54,33GB (90 % weniger) | 510,8GB |
Bei typischen Standard-GRPO-Implementierungen müssen Sie 2 Logits der Größe (8. 20K) erstellen, um den GRPO-Loss zu berechnen. Das benötigt 2 \* 2 Bytes \* 8 (Anzahl Generierungen) \* 20K (Kontextlänge) \* 128256 (Vokabulargröße) = 78,3GB VRAM.
Unsloth senkt den Speicherverbrauch für langkontextiges GRPO um das 8-Fache, sodass wir bei 20K-Kontextlängen nur zusätzliche 9,8GB VRAM benötigen!
Wir müssen außerdem aus dem KV-Cache in 16 Bit arbeiten. Llama 3.1 8B hat 32 Schichten, und sowohl K als auch V haben eine Größe von 1024. Daher beträgt der Speicherverbrauch für 20K Kontextlänge = 2 \* 2 Bytes \* 32 Schichten \* 20K Kontextlänge \* 1024 = 2,5GB pro Batch. Wir würden die Batch-Größe für vLLM auf 8 setzen, lassen sie für unsere Berechnungen jedoch bei 1, um VRAM zu sparen. Andernfalls benötigen Sie 20GB für den KV-Cache.
## 🎥 Unsloth RL 3-Stunden-Workshop-Video
{% embed url="" %}
## :mortar\_board:Weiterführende Lektüre
1. Nathan Lamberts RLHF-Buch ist ein Muss!
2. Yannic Kilchers GRPO-YouTube-Video ist ebenfalls ein Muss!
3. Wir haben 2025 auf der AI Engineer World's Fair einen 3-stündigen Workshop gehalten. Folien und anderes Material finden Sie unter
4. Fortgeschrittenes GRPO-Notebook via Unsloth.
5. GRPO aus einem Basismodell-Notebook:
## Video-Tutorials
Hier sind einige Video-Tutorials von großartigen YouTubern, die wir fantastisch finden!
{% embed url="" %}
{% columns %}
{% column width="50%" %}
{% embed url="" %}
Großartig, um zu lernen, wie Sie Ihren Datensatz vorbereiten, und für Erklärungen zu den Grundlagen von Reinforcement Learning + GRPO
{% endembed %}
{% embed url="" %}
{% endcolumn %}
{% column width="50%" %}
{% embed url="" %}
{% embed url="" %}
Lokales GRPO auf Ihrem eigenen Gerät
{% endembed %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.