

💧Liquid LFM2.5: Wie man ausführt & feinabstimmt
Führe LFM2.5 Instruct und Vision lokal auf deinem Gerät aus und feinabstimme sie!
Liquid AI veröffentlicht LFM2.5, einschließlich ihres Anweisungs- und Vision- Modells. LFM2.5-1.2B-Instruct ist ein hybrides Reasoning-Modell mit 1,17 Milliarden Parametern, trainiert auf 28T Tokens und RL und liefert best-in-class Leistung im 1B-Maßstab für Instruktionsbefolgung, Tool-Nutzung und agentische Aufgaben. Siehe Hugging Face Jobs zur Verwendung von Codex zum Trainieren von LFM!
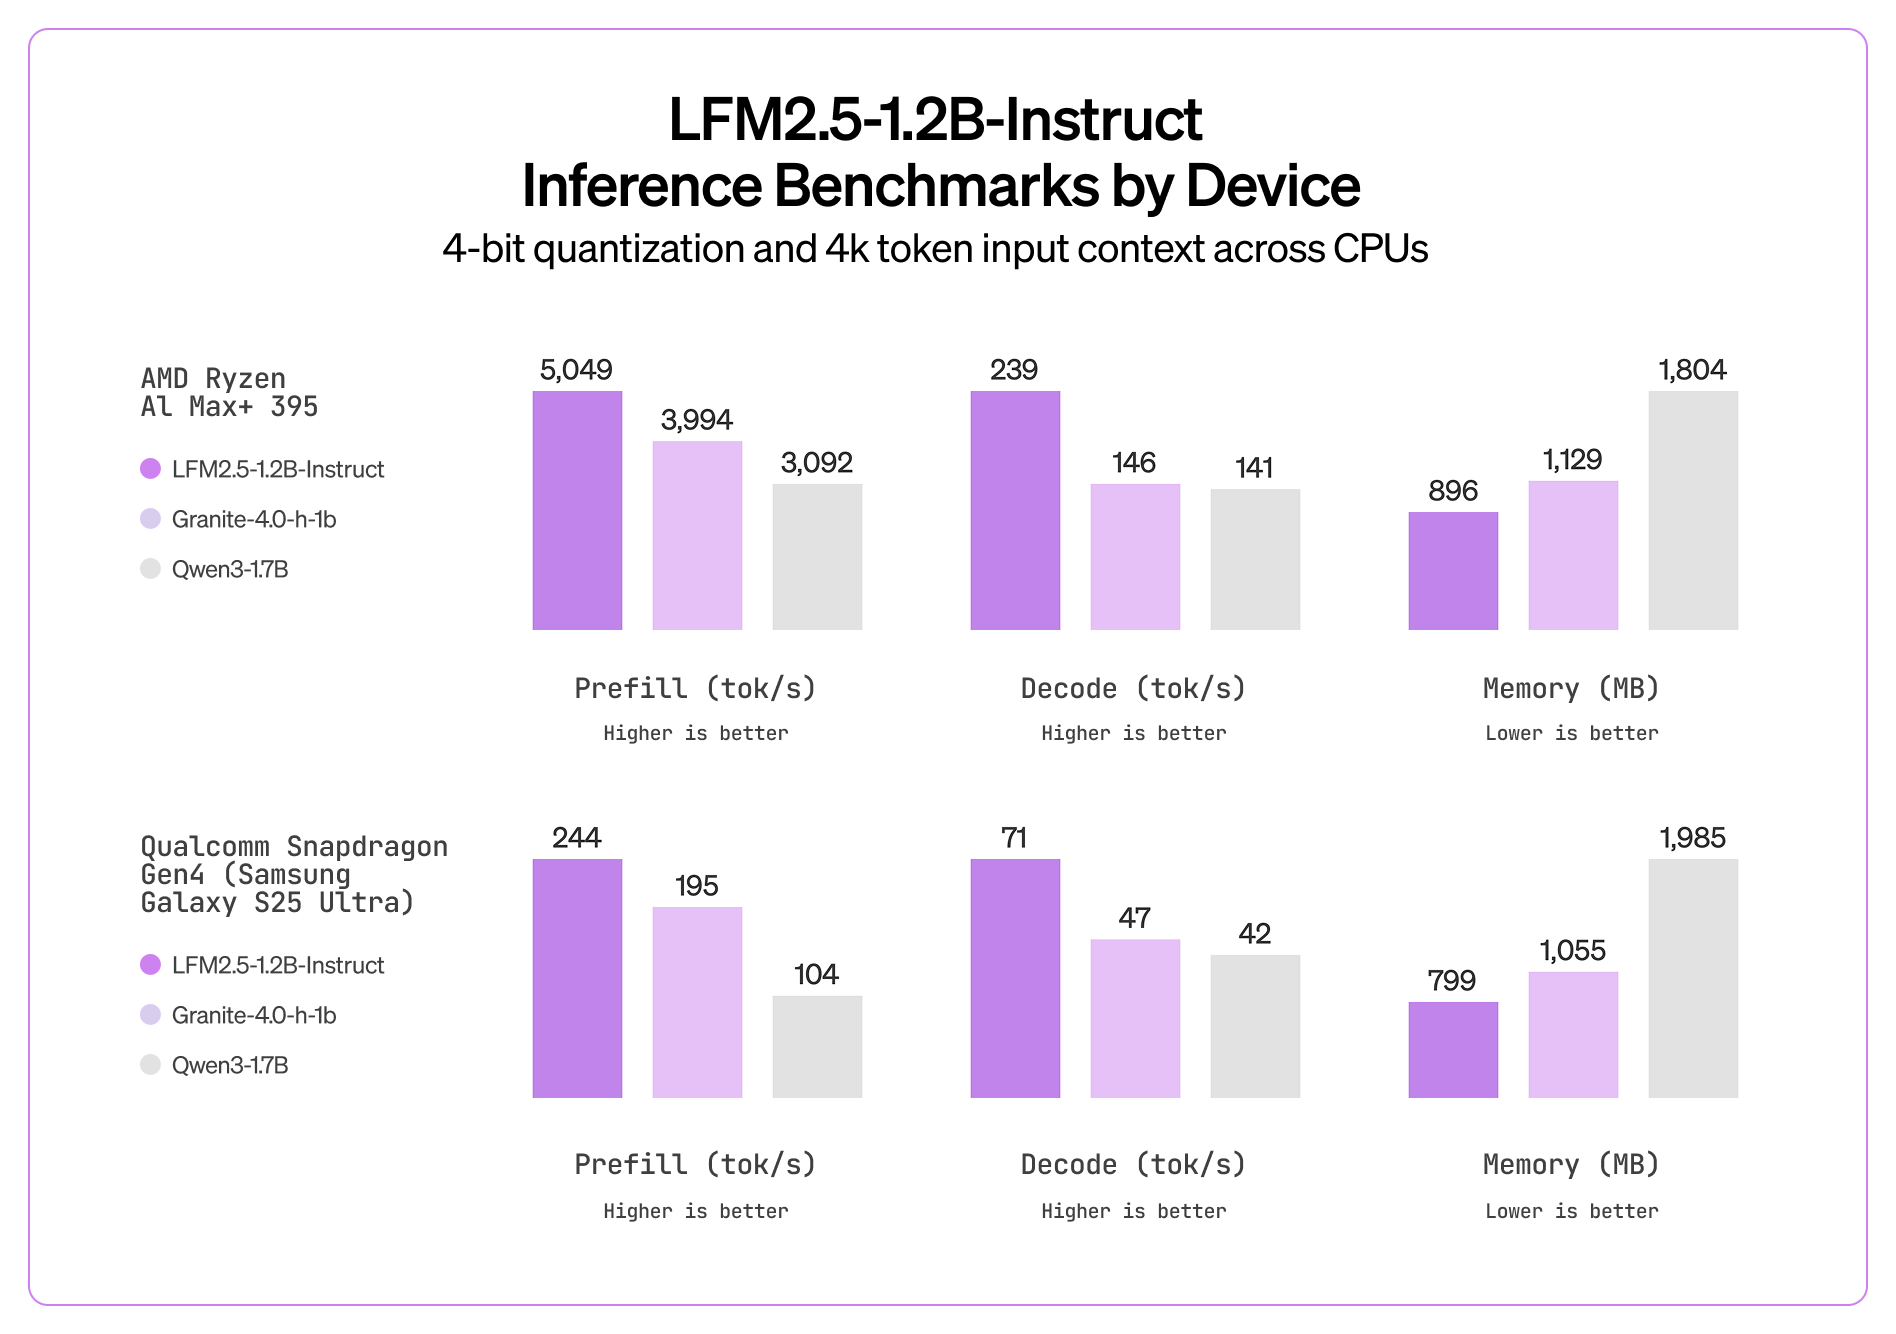
LFM2.5 läuft mit weniger als 1 GB RAM und erreicht 239 Tok/s Dekodierung auf AMD-CPU. Sie können es auch feinabstimmen lokal ausführen mit Unsloth.
Modellspezifikationen:
Parameter: 1,17B
Architektur: 16 Schichten (10 doppelt gegatete LIV-Faltungsblöcke + 6 GQA-Blöcke)
Trainingsbudget: 28T Tokens
Kontextlänge: 32.768 Tokens
Vokabulargröße: 65,536
Sprachen: Englisch, Arabisch, Chinesisch, Französisch, Deutsch, Japanisch, Koreanisch, Spanisch
⚙️ Nutzungsanleitung
Liquid AI empfiehlt für die Inferenz diese Einstellungen:
temperature = 0.1top_k = 50top_p = 0.1repetition_penalty = 1.05Maximale Kontextlänge:
32,768
Chat-Template-Format
LFM2.5 verwendet ein ChatML-ähnliches Format:
LFM2.5-Chat-Template:
Tool-Nutzung
LFM2.5 unterstützt Funktionsaufrufe mit speziellen Tokens <|tool_call_start|> und <|tool_call_end|>. Stellen Sie die Tools als JSON-Objekt im System-Prompt bereit:
🖥️ LFM2.5-1.2B-Instruct ausführen
📖 llama.cpp-Tutorial (GGUF)
1. llama.cpp bauen
Hole dir die neueste llama.cpp von GitHub. Ändern -DGGML_CUDA=ON zu -DGGML_CUDA=OFF wenn Sie keine GPU haben. Für Apple Mac / Metal-Geräte, setze -DGGML_CUDA=OFF und fahre dann wie gewohnt fort - Metal-Unterstützung ist standardmäßig aktiviert.
2. Direkt von Hugging Face ausführen
3. Oder laden Sie das Modell zuerst herunter
4. Im Konversationsmodus ausführen
🦥 LFM2.5 mit Unsloth feinabstimmen
Unsloth unterstützt das Feinabstimmen von LFM2.5-Modellen. Das 1.2B-Modell passt problemlos auf eine kostenlose Colab-T4-GPU. Das Training ist 2x schneller bei 50 % weniger VRAM.
Kostenloses Colab-Notebook:
LFM2.5 wird für agentische Aufgaben, Datenextraktion, RAG und Tool-Nutzung empfohlen. Es wird nicht für wissensintensive Aufgaben oder Programmierung empfohlen.
Unsloth-Konfiguration für LFM2.5
Trainings-Setup
Speichern und Exportieren
🎉 llama-server Bereitstellung & Deployment
Um LFM2.5 produktiv mit einer OpenAI-kompatiblen API bereitzustellen:
Mit OpenAI-Client testen:
📊 Benchmarks
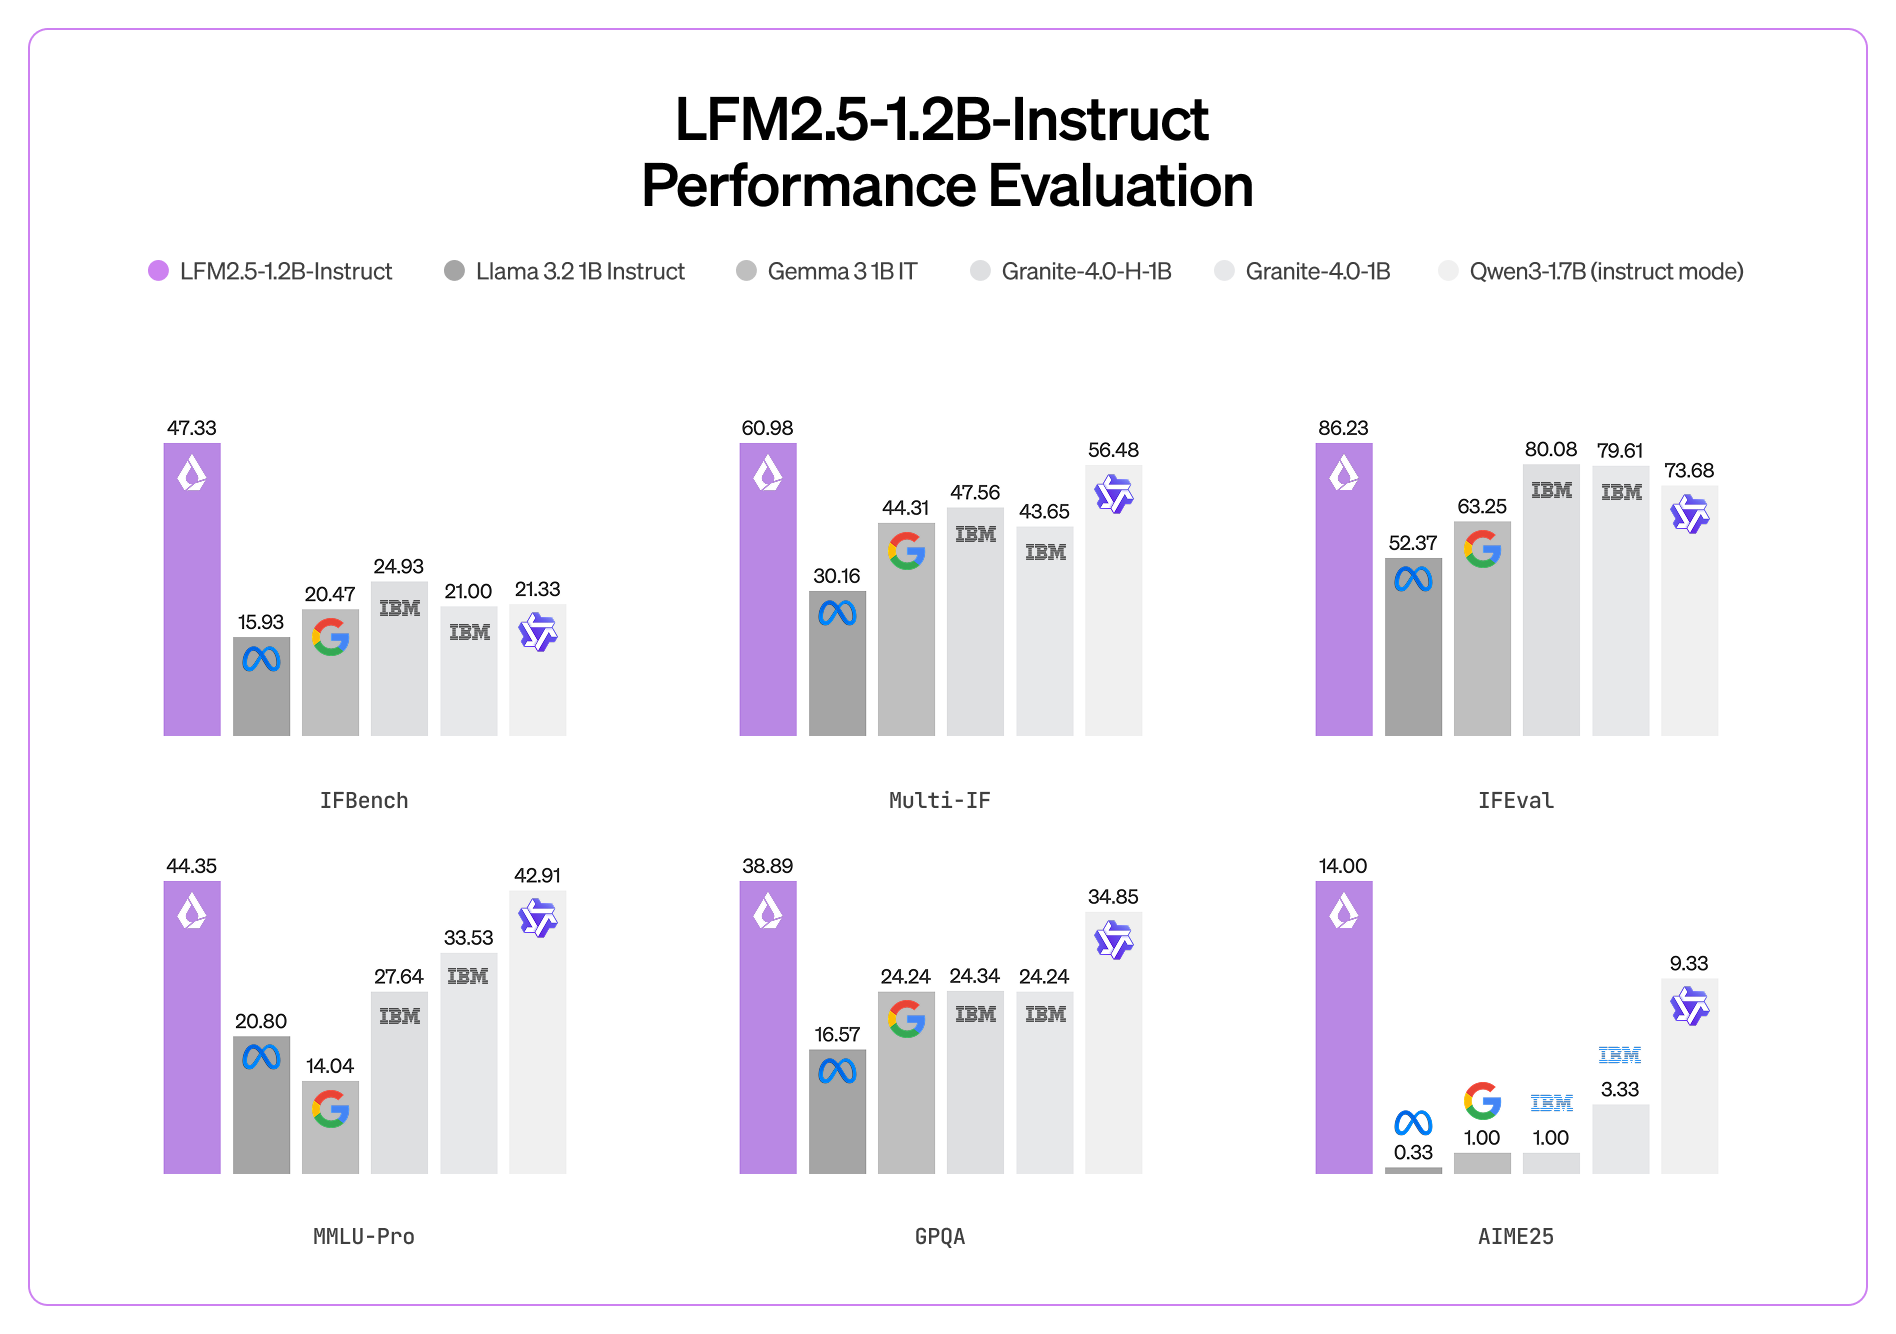
LFM2.5-1.2B-Instruct liefert best-in-class Leistung im 1B-Maßstab und bietet schnelle CPU-Inferenz bei geringem Speicherverbrauch:
💧 Liquid LFM2.5-1.2B-VL Leitfaden
LFM2.5-VL-1.6B ist ein Vision-LLM, aufgebaut auf LFM2.5-1.2B-Base und auf stärkere Praxisleistung abgestimmt. Sie können es jetzt feinabstimmen lokal mit Unsloth ausführen.
Modellspezifikationen:
LM-Backbone: LFM2.5-1.2B-Base
Vision-Encoder: SigLIP2 NaFlex, formoptimiert, 400M
Kontextlänge: 32.768 Tokens
Vokabulargröße: 65,536
Sprachen: Englisch, Arabisch, Chinesisch, Französisch, Deutsch, Japanisch, Koreanisch und Spanisch
Native Auflösungsverarbeitung: Verarbeitet Bilder bis zu 512×512 Pixel ohne Hochskalierung und bewahrt nicht standardisierte Seitenverhältnisse ohne Verzerrung
Kachelstrategie: Teilt große Bilder in nicht überlappende 512×512-Patches auf und umfasst Thumbnail-Codierung für globalen Kontext
Flexibilität zur Inferenzzeit: Vom Benutzer einstellbare maximale Bild-Tokens und Kachelanzahl für den Kompromiss zwischen Geschwindigkeit und Qualität ohne erneutes Training
⚙️ Verwendungsleitfaden
Liquid AI empfiehlt für die Inferenz diese Einstellungen:
Text:
temperature=0.1,min_p=0.15,repetition_penalty=1.05Vision: min_image_tokens=64, max_image_tokens=256, do_image_splitting=True
Chat-Template-Format
LFM2.5-VL verwendet ein ChatML-ähnliches Format:
LFM2.5-VL-Chat-Template:
🖥️ LFM2.5-VL-1.6B ausführen
📖 llama.cpp-Tutorial (GGUF)
1. llama.cpp bauen
Holen Sie sich die neueste llama.cpp von GitHub. Ändern -DGGML_CUDA=ON zu -DGGML_CUDA=OFF wenn Sie keine GPU haben.
2. Direkt von Hugging Face ausführen
🦥 LFM2.5-VL mit Unsloth feinabstimmen
Unsloth unterstützt das Feinabstimmen von LFM2.5-Modellen. Das 1.6B-Modell passt problemlos auf eine kostenlose Colab-T4-GPU. Das Training ist 2x schneller bei 50 % weniger VRAM.
Kostenloses Colab-Notebook:
Unsloth-Konfiguration für LFM2.5
Trainings-Setup
Speichern und Exportieren
📊 Benchmarks
LFM2.5-VL-1.6B liefert best-in-class Leistung:
LFM2.5-VL-1.6B
50.67
52.29
48.82
62.71
41.44
64.84
40.56
76.96
65.90
LFM2-VL-1.6B
49.87
46.35
44.50
58.35
35.11
65.75
39.67
72.13
60.57
InternVL3.5-1B
50.27
36.17
44.19
60.99
33.53
57.12
41.89
68.93
58.32
FastVLM-1.5B
53.13
24.99
43.29
23.92
26.61
61.56
38.78
64.84
50.89
📚 Ressourcen
Zuletzt aktualisiert
War das hilfreich?