> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/devstral-2.md).
# Devstral 2 – Leitfaden zum Ausführen
Leitfaden zum lokalen Ausführen der Mistral-Devstral-2-Modelle: 123B-Instruct-2512 und Small-2-24B-Instruct-2512.
Devstral 2 sind Mistrals neue Coding- und agentische LLMs für Softwareentwicklung, verfügbar in [24B](#devstral-small-2-24b) und [123B](#devstral-2-123b) Größen. Das 123B-Modell erreicht SOTA bei SWE-bench, Coding, Tool-Aufruf und Agenten-Anwendungsfällen. Das 24B-Modell passt in 25 GB RAM/VRAM und das 123B-Modell passt in 128 GB.
{% hint style="success" %}
**Aktualisierung vom 13. Dezember 2025**
**Wir haben Probleme in Devstrals Chat-Template behoben, und die Ergebnisse sollten deutlich besser sein. Das 24B- und das 123B-Modell wurden aktualisiert. Installiert außerdem die neueste llama.cpp-Version vom 13. Dez. 2025!**
{% endhint %}
Devstral 2 unterstützt Vision-Fähigkeiten, ein Kontextfenster von 256k und verwendet dieselbe Architektur wie [Ministral 3](/docs/de/modelle/tutorials/ministral-3.md). Du kannst jetzt beide Modelle lokal mit Unsloth ausführen und **feinabstimmen** beide Modelle lokal mit Unsloth.
Alle Devstral-2-Uploads verwenden unsere Unsloth [Dynamic 2.0](/docs/de/grundlagen/dynamic-3.0-ggufs.md) Methodik und liefern die beste Leistung bei [Aider Polyglot](/docs/de/grundlagen/dynamic-3.0-ggufs/unsloth-dynamic-ggufs-on-aider-polyglot.md) und 5-Shot-MMLU-Benchmarks.
Devstral-Small-2-24BDevstral-2-123B
#### **Devstral 2 - Unsloth Dynamic** GGUFs:
| Devstral-Small-2-24B-Instruct-2512 | Devstral-2-123B-Instruct-2512 |
| --------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------- |
| [Devstral-Small-2-**24B**-Instruct-2512-GGUF](https://huggingface.co/unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF) | [Devstral-2-**123B**-Instruct-2512-GGUF](https://huggingface.co/unsloth/Devstral-2-123B-Instruct-2512-GGUF) |
## 🖥️ **Devstral 2 ausführen**
Sieh dir unsere Schritt-für-Schritt-Anleitungen zum Ausführen von [Devstral 24B](#devstral-small-2-24b) und dem großen [Devstral 123B](#devstral-2-123b) Modell an. Beide Modelle unterstützen Vision, aber derzeit wird **Vision nicht unterstützt** in llama.cpp
### :gear: Nutzungsleitfaden
Hier sind die empfohlenen Einstellungen für die Inferenz:
* **Temperatur \~0,15**
* Min\_P von 0,01 (optional, aber 0,01 funktioniert gut, der Standardwert von llama.cpp ist 0,1)
* **Verwenden Sie `--jinja` um den System-Prompt zu aktivieren.**
* Maximale Kontextlänge = 262.144
* Empfohlener Mindestkontext: 16.384
* Installiere die neueste llama.cpp-Version, da ein [Pull Request vom 13. Dezember 2025](https://github.com/ggml-org/llama.cpp/pull/17945) Probleme behebt.
### :tophat:Devstral-Small-2-24B
Das vollständige Präzisions-GGUF (Q8) von Devstral-Small-2-24B passt in 25 GB RAM/VRAM. Vorerst nur Text.
#### ✨ Devstral-Small-2-24B-Instruct-2512 in llama.cpp ausführen
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
2. Wenn Sie `llama.cpp` um Modelle direkt zu laden, kannst du Folgendes tun: (:`Q4_K_XL`) ist der Quantisierungstyp. Du kannst auch direkt von Hugging Face ziehen:
```bash
./llama.cpp/llama-cli \\
-hf unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF:UD-Q4_K_XL \\
--jinja -ngl 99 --ctx-size 16384 \\
--temp 0,15
```
3. Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD_Q4_K_XL` oder anderen quantisierten Versionen.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF",
local_dir = "unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF",
allow_patterns = ["*UD-Q4_K_XL*", "*mmproj-F16*"], # Für Q4_K_XL
)
```
4. Führe das Modell im Konversationsmodus aus:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/Devstral-Small-2-24B-Instruct-2512-UD-Q4_K_XL.gguf \\
--mmproj unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/mmproj-F16.gguf \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 0.15 \\
--jinja
```
{% endcode %}
#### :eyes:Devstral und Vision
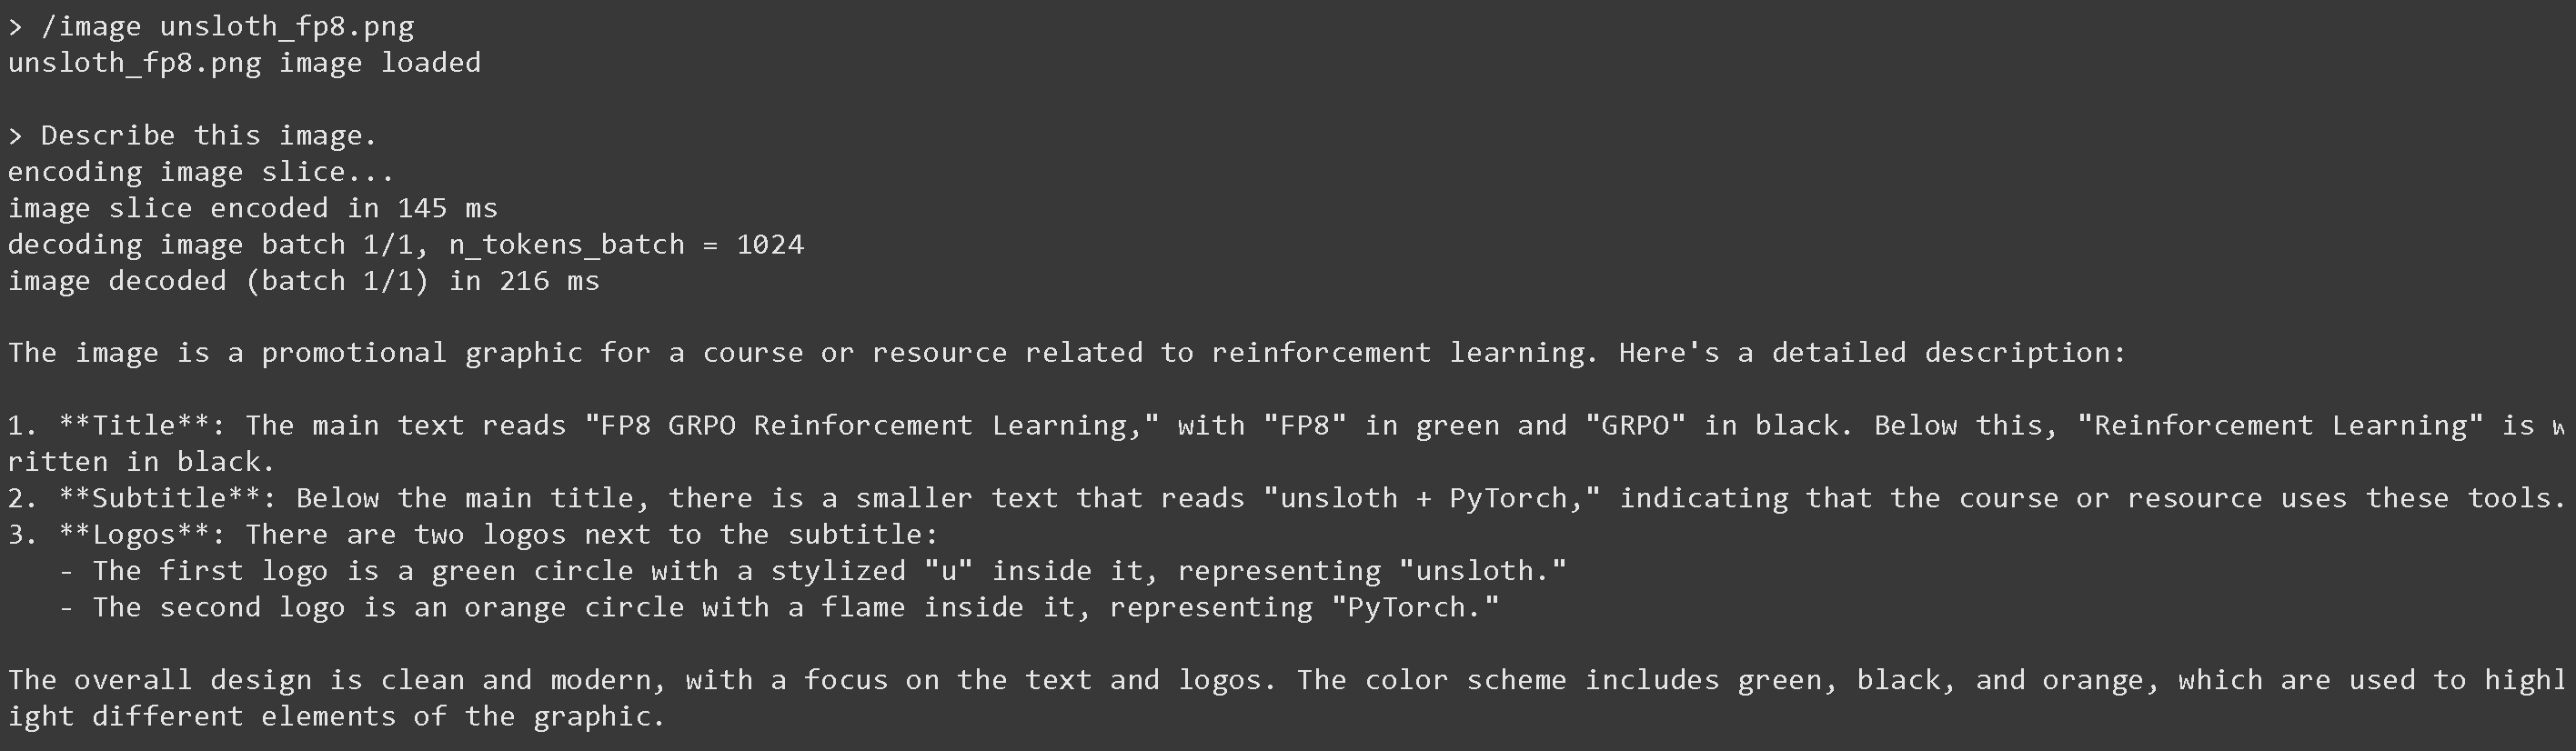
1. Um mit Devstrals Bildfunktionen zu spielen, laden wir zuerst ein Bild wie dieses herunter [FP8 Reinforcement Learning mit Unsloth](https://unsloth.ai/cgi/image/fp8grpolarge_KharloZxEEaHAY2X97CEX.png?width=3840\&quality=80\&format=auto) unten:\

2. Wir erhalten das Bild über `wget https://unsloth.ai/cgi/image/fp8grpolarge_KharloZxEEaHAY2X97CEX.png?width=3840%26quality=80%26format=auto -O unsloth_fp8.png` wodurch das Bild als "unsloth\_fp8.png" gespeichert wird
3. Dann lade das Bild mit `/image unsloth_fp8.png` nachdem das Modell wie unten gezeigt geladen wurde:\

4. Dann fordern wir es auf `Beschreibe dieses Bild` und erhalten Folgendes:
### :truck:Devstral-2-123B
Das vollständige Präzisions-GGUF (Q8) von Devstral-Small-2-123B passt in 128 GB RAM/VRAM. Vorerst nur Text.
#### :sparkles: Tutorial zum Ausführen von Devstral-2-123B-Instruct-2512
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten.
{% code overflow="wrap" %}
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
{% endcode %}
2. Du kannst direkt von HuggingFace ziehen über:
```bash
./llama.cpp/llama-cli \\
-hf unsloth/Devstral-2-123B-Instruct-2512-GGUF:UD-Q2_K_XL \\
--jinja -ngl 99 --ctx-size 16384 \\
--temp 0,15
```
2. Lade das Modell über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können `UD_Q4_K_XL` oder anderen quantisierten Versionen.
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/Devstral-2-123B-Instruct-2512-GGUF",
local_dir = "unsloth/Devstral-2-123B-Instruct-2512-GGUF",
allow_patterns = ["*UD-Q2_K_XL*", "*mmproj-F16*"],
)
```
3. Führe das Modell im Konversationsmodus aus:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-cli \\
--model unsloth/Devstral-2-123B-Instruct-2512-GGUF/Devstral-2-123B-Instruct-2512-UD-Q2_K_XL.gguf \\
--mmproj unsloth/Devstral-2-123B-Instruct-2512-GGUF/mmproj-F16.gguf \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 0.15 \\
--jinja
```
{% endcode %}
## 🦥 Devstral 2 mit Unsloth feinabstimmen
Genauso wie [Ministral 3](/docs/de/modelle/tutorials/ministral-3.md), unterstützt Unsloth das Feintuning von Devstral 2. Das Training ist 2x schneller, verwendet 70 % weniger VRAM und unterstützt 8x längere Kontextlängen. Devstral 2 passt bequem auf eine 24GB-VRAM-L4-GPU.
Leider überschreitet Devstral 2 die Speichergrenzen von 16 GB VRAM geringfügig, daher ist ein kostenloses Feintuning auf Google Colab vorerst nicht möglich. Allerdings kannst du *kannst* das Modell kostenlos feinabstimmen mit unserem [Kaggle-Notebook](https://www.kaggle.com/notebooks/welcome?src=https://github.com/unslothai/notebooks/blob/main/nb/Kaggle-Magistral_\(24B\)-Reasoning-Conversational.ipynb\&accelerator=nvidiaTeslaT4), das Zugriff auf zwei GPUs bietet. Ändere einfach im Notebook den Magistral-Modellnamen in den `unsloth/Devstral-Small-2-24B-Instruct-2512` Modellnamen.
{% hint style="success" %}
Wir haben kostenlose Unsloth-Notebooks erstellt, um Ministral 3 feinabzustimmen, und sie unterstützen Devstral 2 direkt, da sie dieselbe Architektur teilen! Ändere den Namen, um das gewünschte Modell zu verwenden.
{% endhint %}
* Ministral-3B-Instruct [Vision-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Ministral_3_VL_\(3B\)_Vision.ipynb) (Vision) (Modellnamen zu Devstral 2 ändern)
* Ministral-3B-Instruct [GRPO-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Ministral_3_\(3B\)_Reinforcement_Learning_Sudoku_Game.ipynb) (Modellnamen zu Devstral 2 ändern)
{% columns %}
{% column %}
Devstral Vision-Feintuning-Notebook
{% embed url="" %}
{% endcolumn %}
{% column %}
Devstral Sudoku GRPO RL-Notebook
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
### :sunglasses:Llama-Server-Bereitstellung & Deployment
Um Devstral 2 produktiv bereitzustellen, verwenden wir `llama-server` In einem neuen Terminal, z. B. über tmux, stelle das Modell mit Folgendem bereit:
{% code overflow="wrap" %}
```bash
./llama.cpp/llama-server \\
--model unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/Devstral-Small-2-24B-Instruct-2512-UD-Q4_K_XL.gguf \\
--mmproj unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF/mmproj-F16.gguf \\
--alias "unsloth/Devstral-Small-2-24B-Instruct-2512" \\
--n-gpu-layers 999 \\
--prio 3 \\
--min-p 0.01 \\
--ctx-size 16384 \\
--port 8001 \
--jinja
```
{% endcode %}
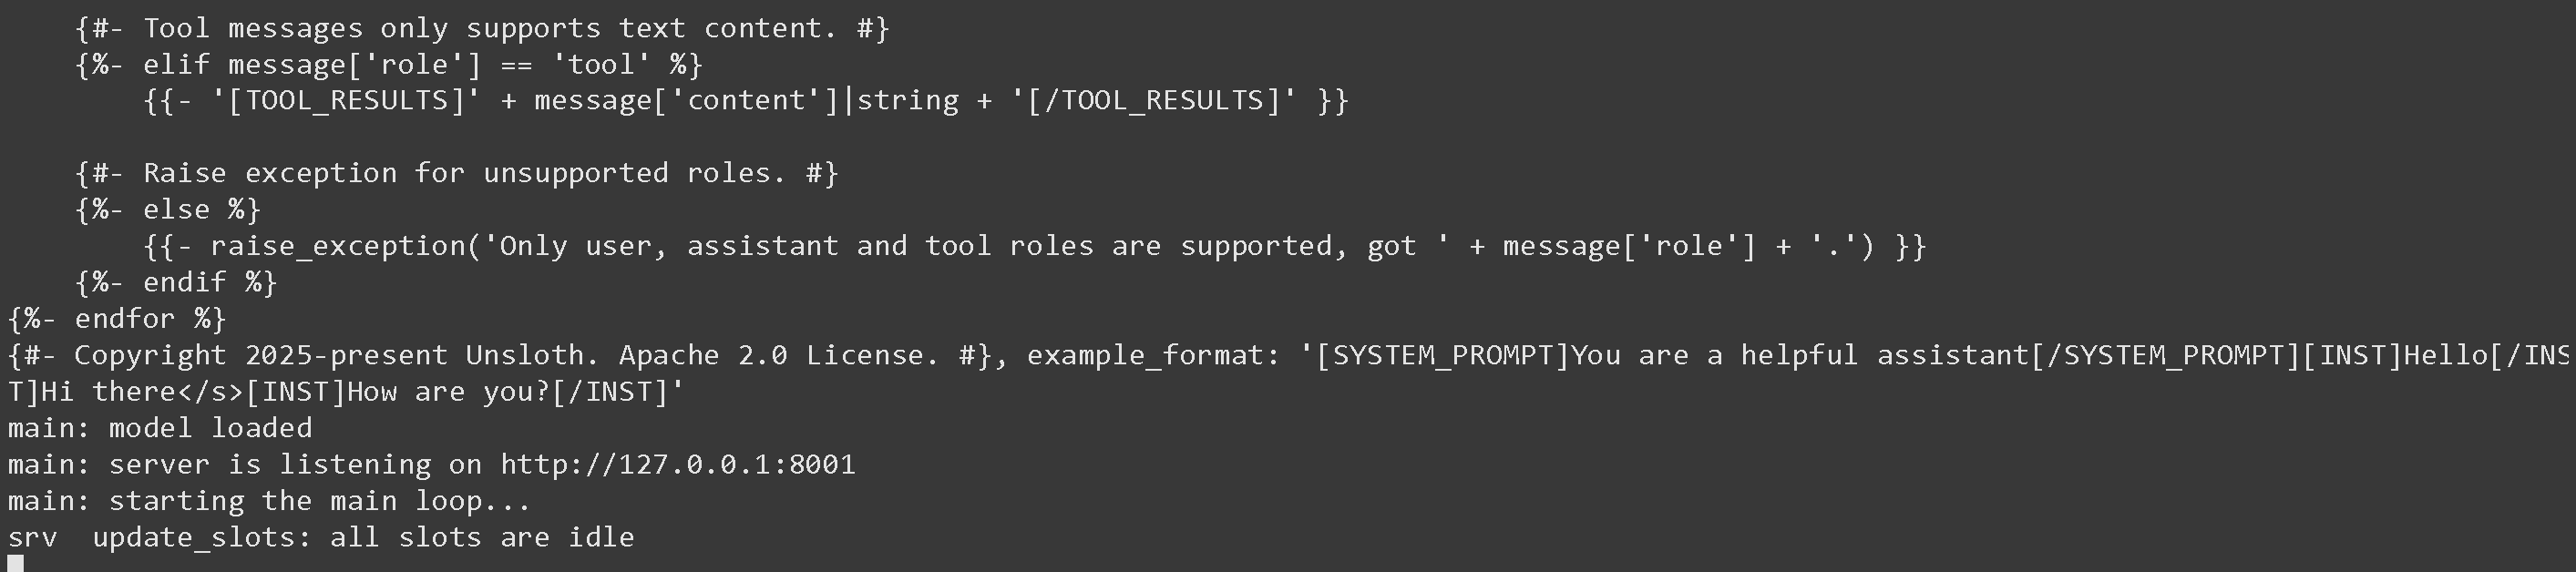
Wenn du das oben ausführst, erhältst du:
Dann in einem neuen Terminal, nachdem du `pip install openai`, mache Folgendes:
{% code overflow="wrap" %}
```python
from openai import OpenAI
import json
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
completion = openai_client.chat.completions.create(
model = "unsloth/Devstral-Small-2-24B-Instruct-2512",
messages = [{"role": "user", "content": "Was ist 2+2?"},],
)
print(completion.choices[0].message.content)
```
{% endcode %}
Das wird einfach 4 ausgeben.
### :toolbox:Tutorial zum Tool-Aufruf mit Devstral 2
Nach dem Folgen von [#llama-server-serving-and-deployment](#llama-server-serving-and-deployment "mention") können wir dann einige Tools laden und Devstral in Aktion sehen! Lass uns ein paar Tools erstellen - kopiere sie, füge sie ein und führe sie in Python aus.
{% code expandable="true" %}
```python
import json, subprocess, random
from typing import Any
def add_number(a: float | str, b: float | str) -> float:
return float(a) + float(b)
def multiply_number(a: float | str, b: float | str) -> float:
return float(a) * float(b)
def subtract_number(a: float | str, b: float | str) -> float:
return float(a) - float(b)
def write_a_story() -> str:
return random.choice([
"Vor langer Zeit in einer weit, weit entfernten Galaxie...",
"Es gab 2 Freunde, die Faultiere und Code liebten...",
"Die Welt ging unter, weil sich jedes Faultier zu übermenschlicher Intelligenz entwickelte...",
"Ohne es einander zu wissen, programmierte ein Freund versehentlich ein Programm, das Faultiere weiterentwickelte...",
])
def terminal(command: str) -> str:
if "rm" in command or "sudo" in command or "dd" in command or "chmod" in command:
msg = "Befehle 'rm, sudo, dd, chmod' können nicht ausgeführt werden, da sie gefährlich sind"
print(msg); return msg
print(f"Führe Terminalbefehl `{command}` aus")
try:
return str(subprocess.run(command, capture_output = True, text = True, shell = True, check = True).stdout)
except subprocess.CalledProcessError as e:
return f"Befehl fehlgeschlagen: {e.stderr}"
def python(code: str) -> str:
data = {}
exec(code, data)
del data["__builtins__"]
return str(data)
MAP_FN = {
"add_number": add_number,
"multiply_number": multiply_number,
"subtract_number": subtract_number,
"write_a_story": write_a_story,
"terminal": terminal,
"python": python,
}
tools = [
{
"type": "function",
"function": {
"name": "add_number",
"description": "Addiere zwei Zahlen.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Die erste Zahl.",
},
"b": {
"type": "string",
"description": "Die zweite Zahl.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "multiply_number",
"description": "Multipliziere zwei Zahlen.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Die erste Zahl.",
},
"b": {
"type": "string",
"description": "Die zweite Zahl.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "subtract_number",
"description": "Subtrahiere zwei Zahlen.",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "string",
"description": "Die erste Zahl.",
},
"b": {
"type": "string",
"description": "Die zweite Zahl.",
},
},
"required": ["a", "b"],
},
},
},
{
"type": "function",
"function": {
"name": "write_a_story",
"description": "Schreibt eine zufällige Geschichte.",
"parameters": {
"type": "object",
"properties": {},
"required": [],
},
},
},
{
"type": "function",
"function": {
"name": "terminal",
"description": "Führe Operationen im Terminal aus.",
"parameters": {
"type": "object",
"properties": {
"command": {
"type": "string",
"description": "Der Befehl, den du ausführen möchtest, z. B. `ls`, `rm`, ...",
},
},
"required": ["command"],
},
},
},
{
"type": "function",
"function": {
"name": "python",
"description": "Rufe einen Python-Interpreter mit etwas Python-Code auf, der ausgeführt wird.",
"parameters": {
"type": "object",
"properties": {
"code": {
"type": "string",
"description": "Der auszuführende Python-Code",
},
},
"required": ["code"],
},
},
},
]
```
{% endcode %}
Dann stellen wir dem Modell zum Testen eine einfache Frage aus einer zufälligen Liste möglicher Nachrichten:
{% code overflow="wrap" %}
```python
import random
messages = [{
"role": "user",
"content": [random.choice([
{"type": "text", "text": "Könntest du mir eine Geschichte schreiben?"},
{"type": "text", "text": "Wie lautet das heutige Datum plus 3 Tage?"},
{"type": "text", "text": "Gib die aktuelle Zeit in Nanosekunden aus."},
{"type": "text", "text": "Erstelle in Python eine Fibonacci-Funktion und berechne fib(20)."},
])],
}]
```
{% endcode %}
Dann verwenden wir die untenstehenden Funktionen (kopieren, einfügen und ausführen), die die Funktionsaufrufe automatisch parsen — Devstral 2 könnte mehrere gleichzeitig machen!
```python
temperature = 0.15
from openai import OpenAI
openai_client = OpenAI(
base_url = "http://127.0.0.1:8001/v1",
api_key = "sk-no-key-required",
)
model_name = next(iter(openai_client.models.list())).id
print(f"Verwendetes Modell = {model_name}")
has_tool_calls = True
original_messages_len = len(messages)
while has_tool_calls:
print(f"Aktuelle Nachrichten = {messages}")
response = openai_client.chat.completions.create(
model = model_name,
messages = messages,
temperature = temperature,
tools = tools if tools else None,
tool_choice = "auto" if tools else None,
)
tool_calls = response.choices[0].message.tool_calls or []
content = response.choices[0].message.content or ""
tool_calls_dict = [tc.to_dict() for tc in tool_calls] if tool_calls else tool_calls
messages.append({"role": "assistant", "tool_calls": tool_calls_dict, "content": content,})
for tool_call in tool_calls:
fx, args, _id = tool_call.function.name, tool_call.function.arguments, tool_call.id
out = MAP_FN[fx](**json.loads(args))
messages.append({"role": "tool", "tool_call_id": _id, "name": fx, "content": str(out),})
else:
has_tool_calls = False
print(json.dumps(messages[original_messages_len:], indent = 2))
```
Und nach 1 Minute erhalten wir:
Oder in JSON-Form:
```json
[
{
"role": "assistant",
"tool_calls": [
{
"id": "JviLK0wUveWguuKQHgZdFdYI2adu85jy",
"function": {
"arguments": "{}",
"name": "write_a_story"
},
"type": "function"
}
],
"content": null
},
{
"role": "tool",
"tool_call_id": "JviLK0wUveWguuKQHgZdFdYI2adu85jy",
"name": "write_a_story",
"content": "Vor langer Zeit in einer weit, weit entfernten Galaxie..."
},
{
"role": "assistant",
"tool_calls": null,
In einer fernen Galaxie, in der die Sterne mit überirdischem Glanz brannten, gab es einen Planeten namens Eldoria. Eldoria war eine Welt starker Kontraste — lebendige Städte zwischen aufragenden Bergen und weiten Wüsten, die sich unter Zwillingssonnen endlos erstreckten. Die Menschen von Eldoria waren weithin für ihre Beherrschung der Energie bekannt, insbesondere für ihre legendären Laserschwerter.
Diese Schwerter waren nicht bloß Waffen; sie waren Verlängerungen der Seelen ihrer Träger, geschmiedet aus seltenen Kristallen, die mit der Essenz des Kosmos pulsierten. Jedes Schwert war einzigartig, seine Farbe und seine Kraft spiegelten die Persönlichkeit und den Geist seines Besitzers wider. Die geschicktesten Krieger, bekannt als die Saberborn, konnten ihre Schwerter mit solcher Präzision und Anmut führen, dass sie mit dem Gewebe der Wirklichkeit selbst zu tanzen schienen.
Unter den Saberborn gab es einen Krieger namens Kael. Kael war ein Außenseiter, ein ehemaliger Wächter der heiligen Saber-Tempel, der verbannt worden war, weil er die Befehle des Rates missachtet hatte. Der Rat hatte versucht, die Macht der Laserschwerter zu horten und sie zu nutzen, um die Menschen von Eldoria zu kontrollieren. Kael glaubte, dass die Schwerter von jenen geführt werden sollten, die schützen wollten, nicht dominieren.
Eines Tages erhielt Kael ein Notsignal von einem kleinen Dorf am Rand der Wüste. Das Dorf wurde von einer abtrünnigen Fraktion der Saberborn angegriffen, angeführt von einem skrupellosen Kriegsherrn namens Vexis. Vexis wollte sich das uralte Relikt des Dorfes sichern — einen Kristall, von dem gesagt wurde, er könne die Kraft jedes Laserschwerts verzehnfachen. Sollte Vexis Erfolg haben, würde seine Armee unaufhaltsam werden, und Eldoria würde in Dunkelheit versinken.
Kael wusste, dass er handeln musste. Er schnallte sich sein Schwert um — eine tiefblaue Klinge, die mit der Energie des Kosmos summte — und machte sich auf den Weg durch die Wüste. Die Reise war gefährlich, mit Sandstürmen und versteckten Fallen, die Vexis' Späher ausgelegt hatten. Doch Kael ging weiter, angetrieben von der Erinnerung an die Menschen, die er einst zu schützen geschworen hatte.
Als er das Dorf erreichte, tobte die Schlacht bereits mit voller Wucht. Vexis' Krieger führten ihre Schwerter mit brutaler Effizienz und machten die Verteidiger mühelos nieder. Kael sprang ins Getümmel, sein blaues Schwert ein Lichtschweif, während er einen Feind nach dem anderen entwaffnete und besiegte. Als die Dorfbewohner ihren Retter eintreffen sahen, scharten sie sich hinter ihn; ihre eigenen Schwerter blitzten auf, während sie darum kämpften, ihr Zuhause zurückzuerobern.
Kael stellte sich Vexis in der Mitte des Dorfplatzes. Das Schwert des Kriegsherrn war ein kränkliches Grün und pulsierte mit dunkler Energie. „Du bist zu spät, Kael“, höhnte Vexis. „Das Relikt gehört mir, und mit ihm werde ich Eldoria beherrschen.“ Kael blieb standhaft, sein Schwert erhoben. „Über meine Leiche“, erwiderte er.
Die beiden Krieger prallten aufeinander, ihre Schwerter verhakten sich in einem Funkenregen. Kael spürte die rohe Macht des Relikts, die durch Vexis' Klinge strömte, doch er weigerte sich zurückzuweichen. Er bündelte seine eigene Energie, und sein Schwert leuchtete heller, während er Vexis' Angriff zurückdrängte. Mit einem letzten verzweifelten Hieb entwaffnete Kael Vexis und schleuderte dessen Schwert klirrend zu Boden.
Vexis fletschte in der Niederlage die Zähne, doch Kael tötete ihn nicht. Stattdessen bot er ihm eine Wahl an: „Schließ dich mir an und schütze Eldoria, oder geh und kehre niemals zurück.“ Vexis, gedemütigt und die Wahrheit in Kaels Worten erkennend, entschied sich, an seiner Seite zu stehen.
Da Vexis' Fraktion nun Verbündete war, gewannen Kael und die Dorfbewohner das Relikt zurück und nutzten seine Kraft, um das Gleichgewicht in Eldoria wiederherzustellen. Die Saber-Tempel wurden wiederaufgebaut, und die Laserschwerter wurden erneut von jenen geführt, die schützen wollten, nicht kontrollieren.
Kaels Legende wuchs, und er wurde zu einem Symbol der Hoffnung für die Menschen von Eldoria. Seine Geschichte erinnerte sie daran, dass selbst in den dunkelsten Zeiten das Licht von Mut und Gerechtigkeit siegen kann. Und so lebten die Saberborn weiter, ihre Laserschwerter ein Leuchtfeuer der Stärke und Einheit in einer Galaxie voller Schatten.
}
]
```
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/devstral-2.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.