> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/blog/500k-context-length-fine-tuning.md).
# Feinabstimmung mit 500K Kontextlänge
Erfahren Sie, wie Sie mit Unsloth eine Feinabstimmung mit einem Kontextfenster von >500K Token aktivieren.
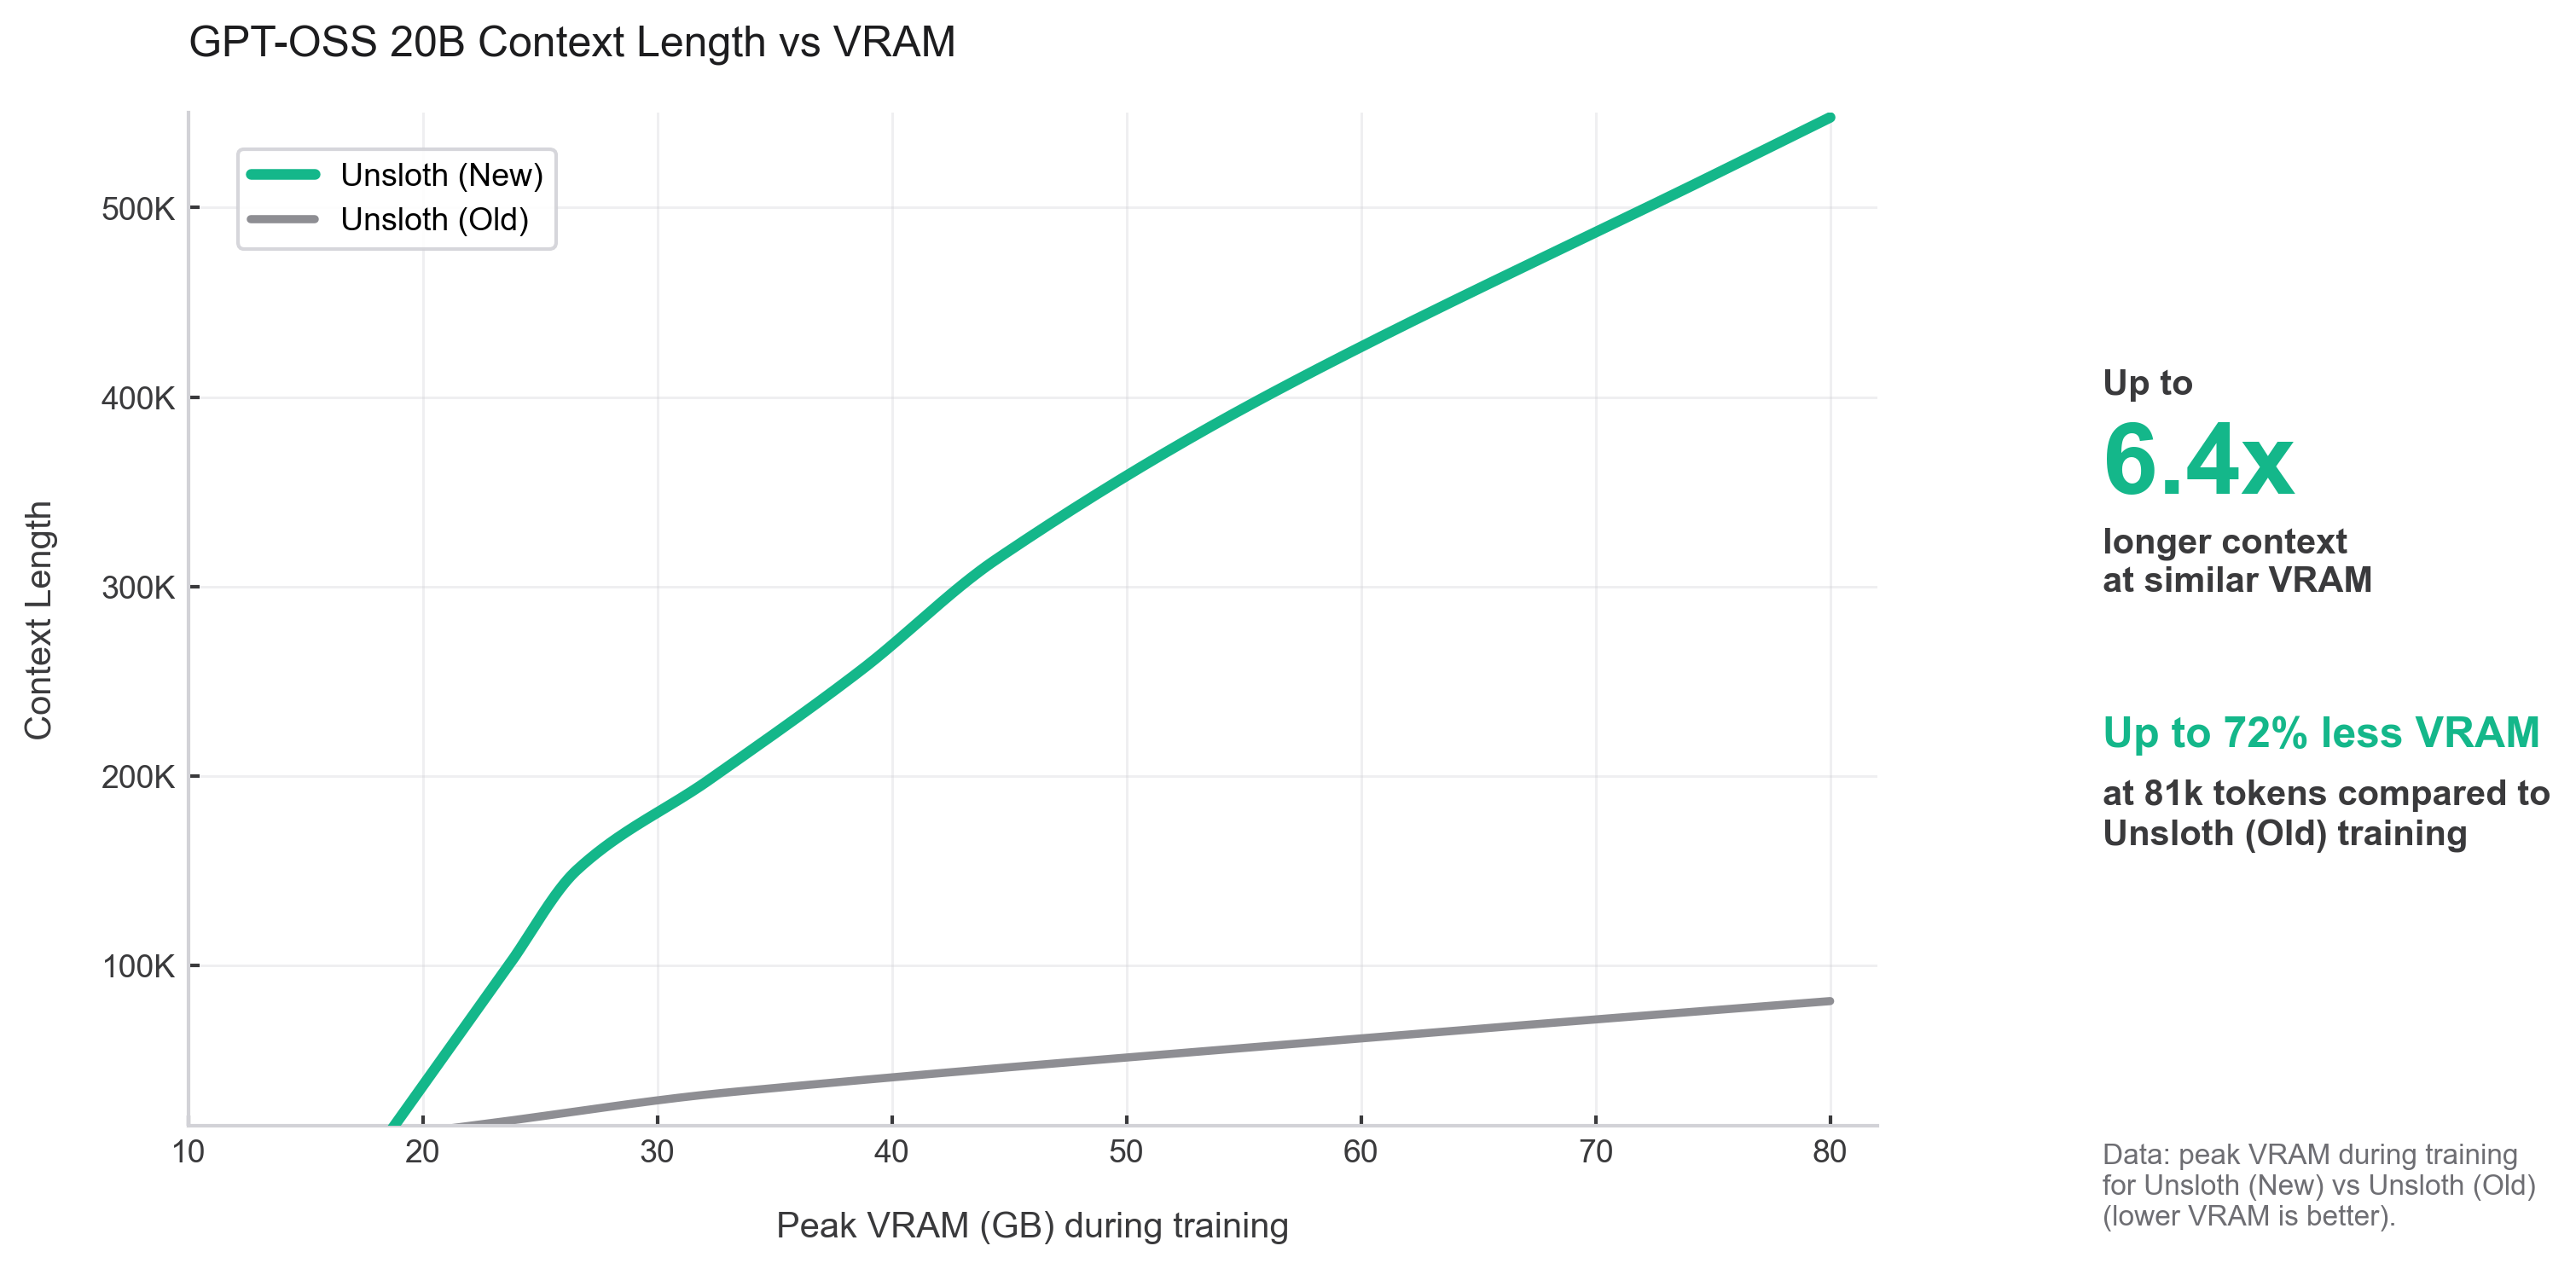
Wir führen in Unsloth neue Algorithmen ein, die die Grenzen des Long-Context-Trainings für **jedes LLM und VLM**. Das Trainieren von LLMs wie gpt-oss-20b kann jetzt **Kontextlängen von 500K+** auf einer einzelnen 80GB H100 GPU erreichen, gegenüber zuvor 80K ohne Genauigkeitsverlust.
Ihr könnt >**750K-Kontextfenster** auf einer B200-192GB-GPU erreichen.
> **Probiert das Fine-Tuning von gpt-oss-20b mit 500K Kontext auf unserem** [**80GB A100 Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
Wir haben deutlich verbessert, wie Unsloth mit Speicherauslastung, Geschwindigkeit und Kontextlängen umgeht:
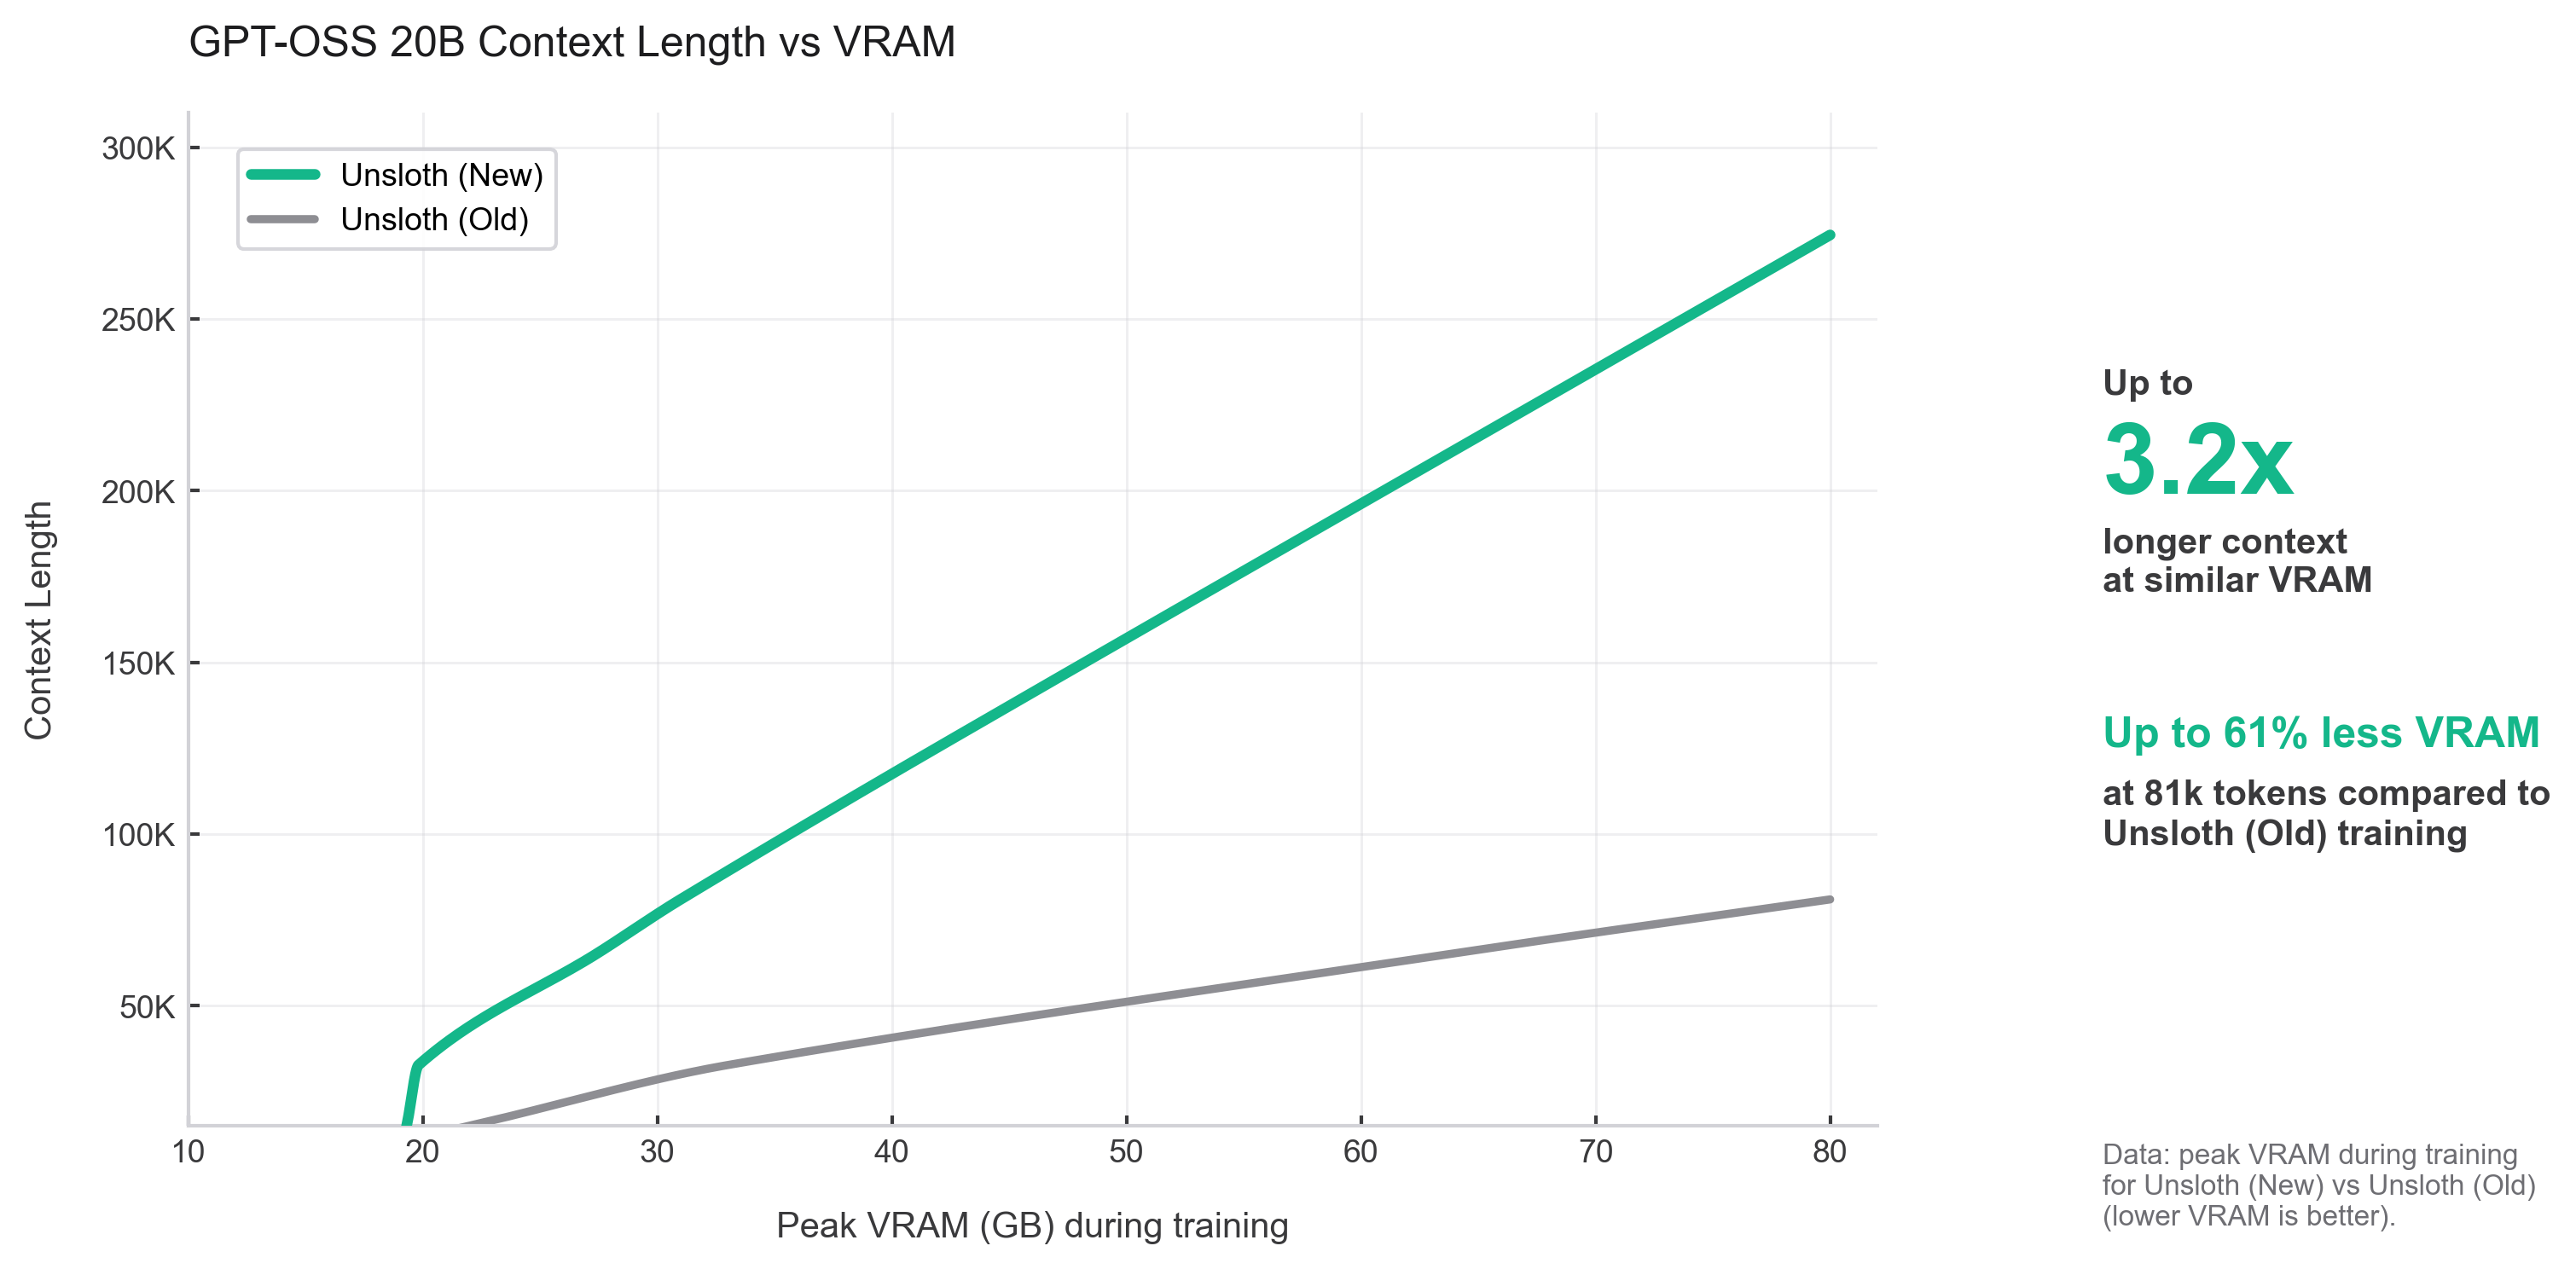
* **60 % weniger VRAM-Verbrauch** mit **3,2× längerer Kontext** über Unsloths neue [fused und chunked Cross-Entropy](#unsloth-loss-refactoring-chunk-and-fuse) Loss, ohne Einbußen bei Geschwindigkeit oder Genauigkeit
* Verbessertes Activation Offloading in Unsloths [**Gradient Checkpointing**](#unsloth-gradient-checkpointing-enhanced)
* Zusammenarbeit mit Stas Bekman von Snowflake an [Tiled MLP](#tiled-mlp-unlocking-500k), wodurch 2× mehr Kontexte ermöglicht werden
Unsloths Algorithmen ermöglichen gpt-oss-20b QLoRA (4bit) mit 290K Kontext auf einer H100 ohne Genauigkeitsverlust und 500K+ mit aktiviertem Tiled MLP, was insgesamt >**6,4× längere Kontextlängen liefert.**
### 📐 Unsloth Loss Refactoring: Chunk & Fuse
Unsere neue fused Loss-Implementierung fügt **dynamisches Sequenz-Chunking**hinzu: Statt die Logits des Language-Model-Heads und die Cross-Entropies über die gesamte Sequenz auf einmal zu berechnen, verarbeiten wir handhabbare Slices entlang der abgeflachten Sequenzdimension. Dadurch sinkt der Peak-Speicher von GBs auf kleinere Chunk-Größen. Jeder Chunk führt weiterhin einen vollständig fusionierten Forward- + Backward-Pass über `torch.func.grad_and_value` aus und behält die Genauigkeit bei gemischter Präzision bei, indem bei Bedarf auf float32 hochgestuft wird. **Diese Änderungen verschlechtern weder Trainingsgeschwindigkeit noch Genauigkeit.**
Die wichtigste Innovation ist, dass die **Chunk-Größe zur Laufzeit automatisch gewählt wird** basierend auf dem verfügbaren VRAM.
* Wenn ihr mehr freien VRAM habt, werden größere Chunks für schnellere Läufe verwendet
* Wenn ihr weniger VRAM habt, wird die Anzahl der Chunks erhöht, um Speicherüberläufe zu vermeiden.
Dies **entfernt manuelles Tuning** und hält unseren Algorithmus robust über alte und neue GPUs, Workloads und unterschiedliche Sequenzlängen hinweg.
{% hint style="success" %}
Durch das automatische Tuning **verwenden kleinere Kontexte mehr VRAM** (weniger Chunks), um **unnötigen Overhead zu vermeiden**. Für die obigen Diagramme passen wir die Anzahl der Loss-Chunks an, um realistische VRAM-Stufen abzubilden. Mit 80GB VRAM führt das zu >3,2× längeren Kontexten.
{% endhint %}
### 🏁 Verbesserungen beim Unsloth Gradient Checkpointing
Unser [Unsloth Gradient Checkpointing](https://unsloth.ai/blog/long-context) Algorithmus, **im April 2024 eingeführt**, wurde schnell populär und zum Standard in der gesamten Branche, nachdem er inzwischen in die meisten Trainingspakete integriert wurde. Er lagert Aktivierungen in den CPU-RAM aus, was 10× längere Kontextlängen ermöglichte. Unsere neuen Verbesserungen nutzen CUDA Streams und andere Tricks, um höchstens **0.1%** Trainings-Overhead mit keinem Einfluss auf die Genauigkeit zu verursachen. Zuvor betrug der Overhead 1 bis 3 %.
{% code expandable="true" %}
```python
# Originale Unsloth-Version, veröffentlicht im April 2024 - unter LGPLv3 lizenziert
class Unsloth_Offloaded_Gradient_Checkpointer(torch.autograd.Function):
@staticmethod
@torch_amp_custom_fwd
def forward(ctx, forward_function, hidden_states, *args):
ctx.device = hidden_states.device
saved_hidden_states = hidden_states.to("cpu", non_blocking = True)
with torch.no_grad():
output = forward_function(hidden_states, *args)
ctx.save_for_backward(saved_hidden_states)
ctx.forward_function, ctx.args = forward_function, args
return output
@staticmethod
@torch_amp_custom_bwd
def backward(ctx, dY):
(hidden_states,) = ctx.saved_tensors
hidden_states = hidden_states.to(ctx.device, non_blocking = True).detach()
hidden_states.requires_grad_(True)
with torch.enable_grad():
(output,) = ctx.forward_function(hidden_states, *ctx.args)
torch.autograd.backward(output, dY)
return (None, hidden_states.grad,) + (None,)*len(ctx.args)
```
{% endcode %}
Durch das Offloading von Aktivierungen, sobald sie erzeugt werden, minimieren wir den Peak-Footprint der Aktivierungen und geben GPU-Speicher genau dann frei, wenn er benötigt wird. Das reduziert den Speicherdruck beim Training mit langen Kontexten oder großen Batches deutlich, wo die Aktivierungen einer einzelnen Decoder-Schicht 2 GB überschreiten können.
> **Damit tragen Unsloths neue Algorithmen und Gradient Checkpointing zu den meisten Verbesserungen (3,2×) bei und ermöglichen das Fine-Tuning von QLoRA GPT-OSS mit 290k Kontextlänge auf einer einzelnen H100.**
### 🔓 Tiled MLP: 500K+ freischalten
Mit Hilfe von [Stas Bekman](https://x.com/StasBekman) (Snowflake) haben wir Tiled MLP aus Snowflakes Arctic Long Sequence Training integriert [Paper](https://arxiv.org/abs/2506.13996) und dem Blogbeitrag. TiledMLP reduziert den Aktivierungsspeicher und ermöglicht deutlich längere Sequenzlängen, indem die Hidden States entlang der Sequenzdimension vor den schweren MLP-Projektionen gekachelt werden.
**Wir führen außerdem einige Verbesserungen für die Benutzerfreundlichkeit ein:**
Wir bewahren den RNG-Status über gekachelte Forward-Recomputations hinweg, sodass Dropout und andere stochastische Operationen zwischen Forward- und Backward-Replays konsistent sind. Dadurch bleiben verschachtelte checkpointed Berechnungen stabil und numerisch identisch.
{% hint style="success" %}
Unsere Implementierung patcht automatisch jedes Modul, das benannt oder typisiert ist als `mlp`, daher **nahezu alle Modelle mit MLP-Modulen werden für Tiled MLP sofort unterstützt.**
{% endhint %}
**Zu beachtende Kompromisse**
TiledMLP spart VRAM auf Kosten zusätzlicher Forward-Pässe. Da es innerhalb eines checkpointed Transformer-Blocks lebt und selbst im Checkpoint-Stil geschrieben ist, wird es effektiv zu einem verschachtelten Checkpoint: ein **MLP führt jetzt pro Schritt \~3 Forward-Pässe und 1 Backward-Pass aus**. Im Gegenzug können wir fast alle Zwischenaktivierungen des MLP aus dem VRAM entfernen und trotzdem extrem lange Sequenzen unterstützen.
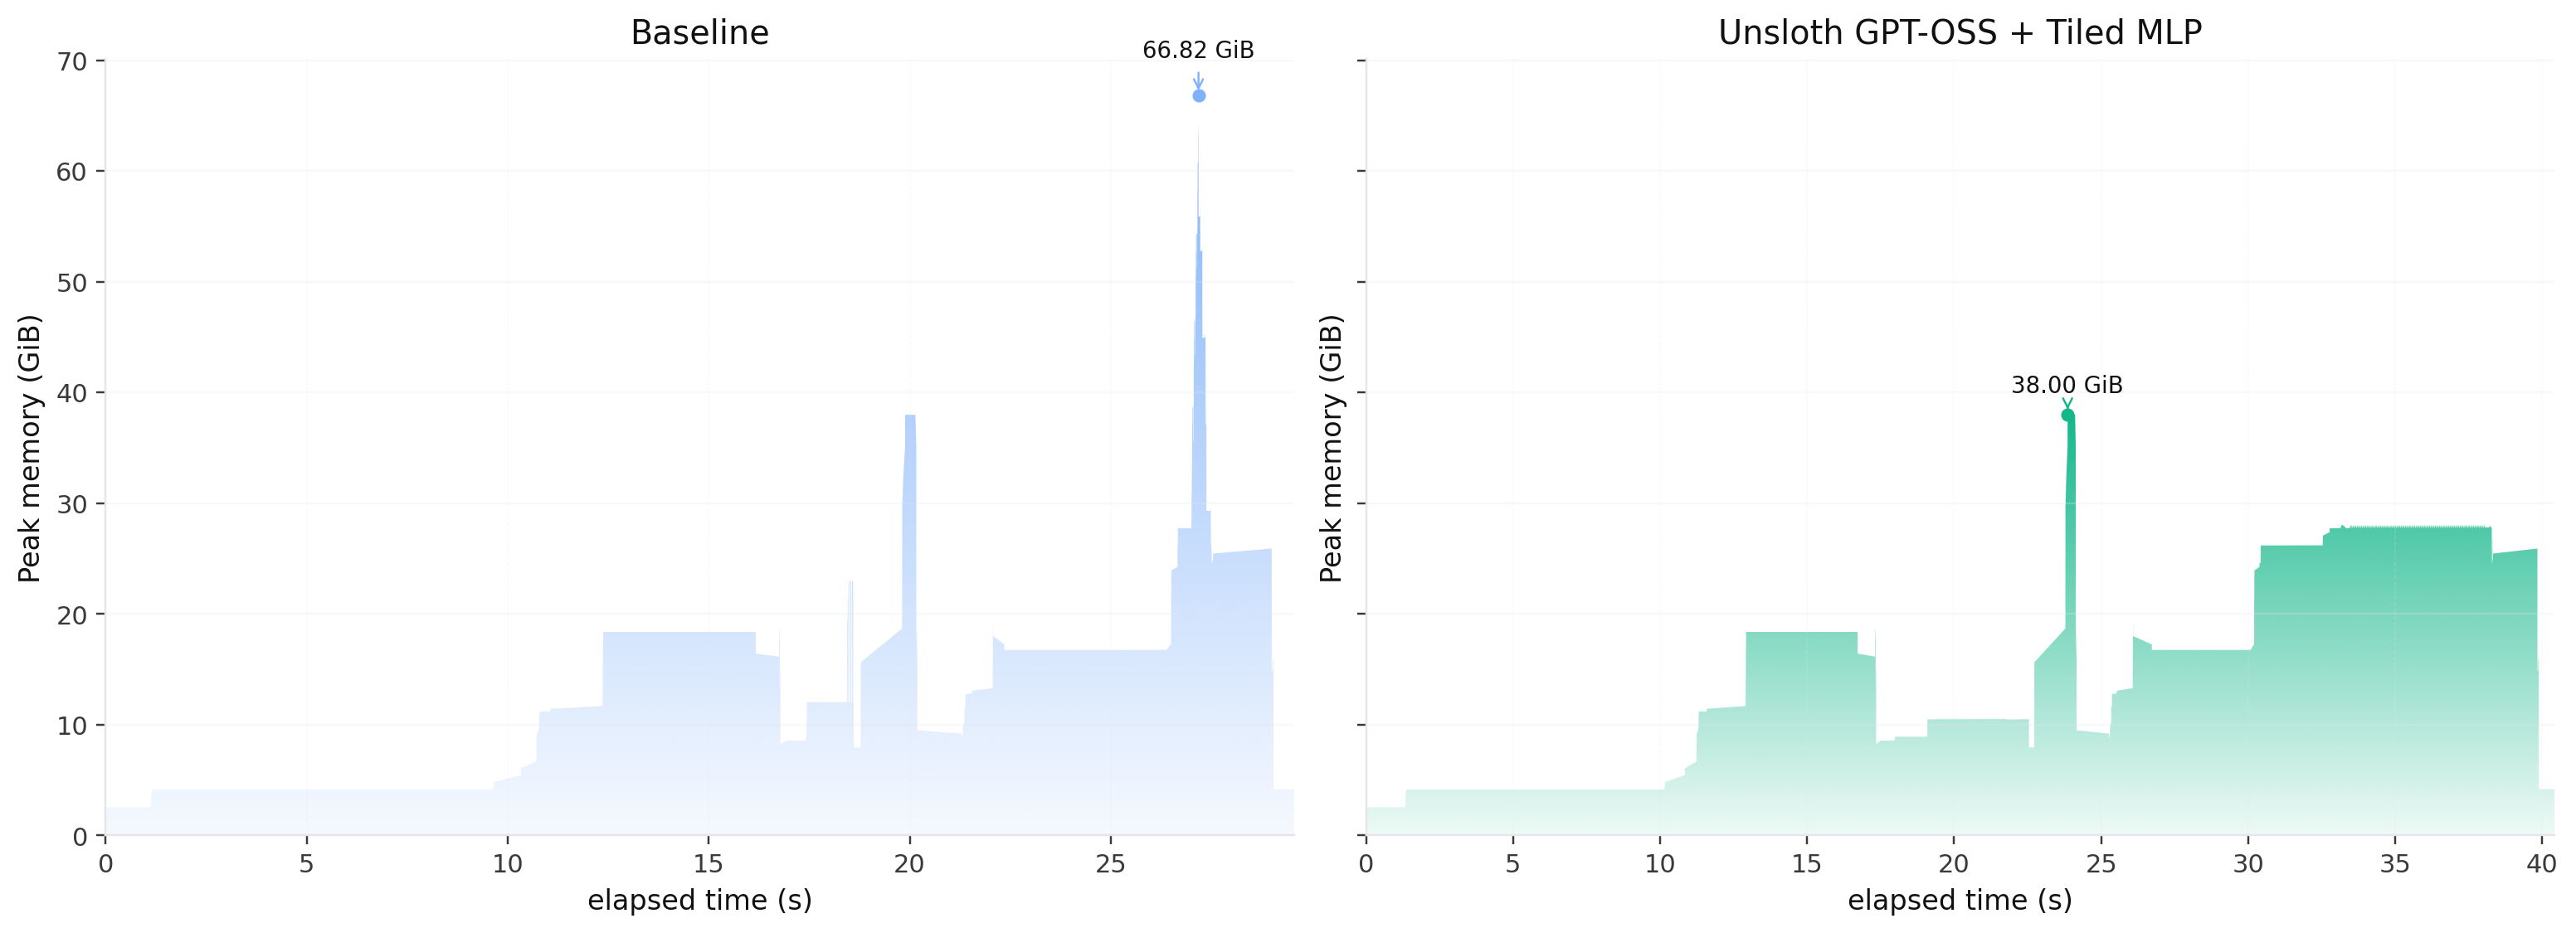
Die Diagramme vergleichen die aktiven Speicherverläufe für Forward und Backward einer einzelnen Decoder-Schicht während eines Long-Context-Trainingsschritts, ohne Tiled MLP (links) und mit Tiled MLP (rechts). Ohne Tiled MLP tritt der Peak-VRAM während des MLP-Backward auf; mit Tiled MLP verschiebt er sich zur fusionierten Loss-Berechnung. Wir sehen \~40 % weniger VRAM-Nutzung, und da der fusionierte Loss sich dynamisch basierend auf dem verfügbaren VRAM automatisch in Chunks aufteilt, wäre der Peak mit Tiled MLP auf kleineren GPUs sogar noch geringer.
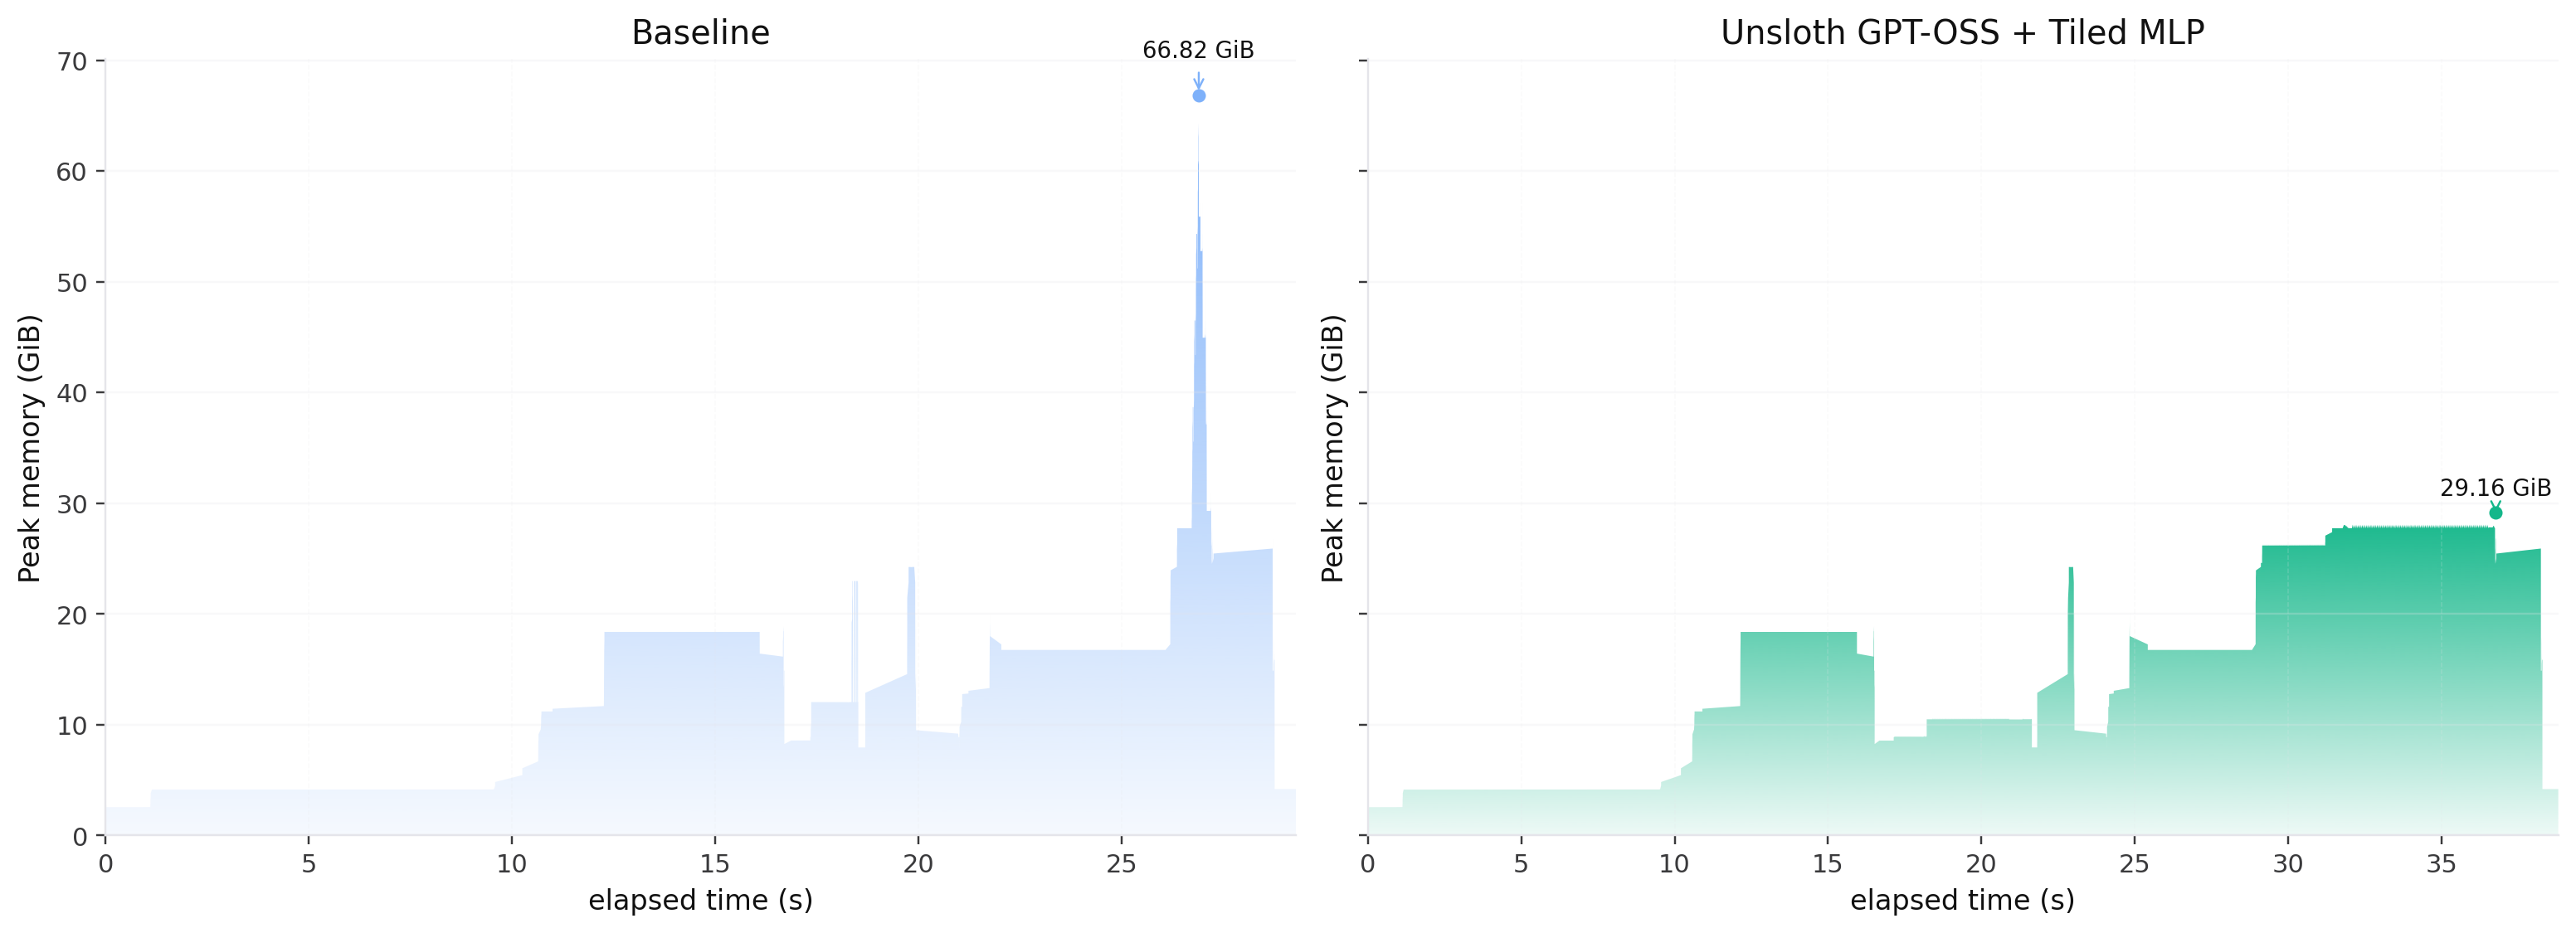
Um zu zeigen, dass der Cross-Entropy-Loss nicht der neue Engpass ist, fixieren wir seine Chunk-Größe statt sie dynamisch zu wählen und verdoppeln dann die Anzahl der Chunks. Dadurch werden die speicherbezogenen Peaks beim Loss erheblich reduziert. Der maximale Speicherverbrauch tritt nun in beiden Fällen während des Backward auf, und das Gesamttiming ist ähnlich, obwohl Tiled MLP einen kleinen Overhead mit sich bringt: Eine große GEMM wird zu vielen sequentiellen Matmuls, plus dem oben erwähnten zusätzlichen Forward-Pass.
Insgesamt lohnt sich der Kompromiss: Ohne Tiled MLP kann Long-Context-Training ungefähr 2× so viel Speicher benötigen, während mit **Tiled MLP eine einzelne GPU für dieselbe Kontextlänge nur etwa einen 1,3× Anstieg der Schrittzeit zahlt.**
**Tiled MLP in Unsloth aktivieren:**
```py
model, tokenizer = FastLanguageModel.from_pretrained(
...,
unsloth_tiled_mlp = True,
)
```
Setzt einfach `unsloth_tiled_mlp = True` in `from_pretrained` und Tiled MLP ist aktiviert. Wir folgen derselben Logik wie das Arctic Paper und wählen `num_shards = ceil(seq_len/hidden_size)`. Jeder Tile arbeitet mit Sequenzlängen, die genauso groß sind wie die Hidden-Dimension des Modells, um Durchsatz und Speichereinsparungen auszubalancieren.
Wir haben auch besprochen, wie Tiled MLP effektiv 3 Forward-Pässe und 1 Backward ausführt, verglichen mit normalem Gradient Checkpointing, das 2 Forward-Pässe und 1 Backward hat, zusammen mit Stas Bekman und [DeepSpeed](https://github.com/deepspeedai/DeepSpeed/pull/7664) hat ein Dokumentationsupdate für Tiled MLP innerhalb von DeepSpeed bereitgestellt.
{% hint style="success" %}
Wenn euch beim Fine-Tuning das VRAM ausgeht, versucht als Nächstes, `unsloth_tiled_mlp = True`zu aktivieren. Das sollte etwas VRAM sparen, solange die Kontextlänge länger ist als die Hidden-Dimension des LLM.
{% endhint %}
***
**Mit unserem neuesten Update ist es jetzt möglich, mit einem kleineren Modell auf einer einzelnen GPU eine Kontextlänge von 1 Mio. zu erreichen!**
**Probiert das Fine-Tuning von gpt-oss-20b mit 500K Kontext auf unserem** [**80GB A100 Colab-Notebook**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
Wenn ihr es bis hierher geschafft habt, veröffentlichen wir diese Woche einen neuen Blog zu unseren neuesten Verbesserungen der Trainingsgeschwindigkeit, also bleibt dran, indem ihr unserem [Reddit r/unsloth](https://www.reddit.com/r/unsloth/) oder unseren Docs beitretet.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/blog/500k-context-length-fine-tuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.