> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune.md).
# Gemma 3 – Leitfaden zum Ausführen
Wie man Gemma 3 effektiv mit unseren GGUFs auf llama.cpp, Ollama, Open WebUI ausführt und wie man mit Unsloth feinabstimmt!
Google veröffentlicht Gemma 3 mit einem neuen 270M-Modell und den bisherigen Größen 1B, 4B, 12B und 27B. 270M und 1B sind nur für Text, während die größeren Modelle sowohl Text als auch Vision verarbeiten. Wir stellen GGUFs bereit sowie einen Leitfaden, wie man es effektiv ausführt und wie man es feinabstimmt & [RL](/docs/de/loslegen/reinforcement-learning-rl-guide.md) mit Gemma 3!
{% hint style="success" %}
**NEU: Update vom 14. Aug. 2025:** Probiere unser Fine-Tuning [Gemma 3 (270M)-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(270M\).ipynb) und [GGUFs zum Ausführen](https://huggingface.co/collections/unsloth/gemma-3-67d12b7e8816ec6efa7e4e5b).
Siehe auch unseren [Gemma 3n-Leitfaden](/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md).
{% endhint %}
Ausführungs-TutorialAnleitung zur Feinabstimmung
**Unsloth ist das einzige Framework, das auf Float16-Maschinen für Gemma-3-Inferenz und -Training funktioniert.** Das bedeutet, dass auch Colab-Notebooks mit kostenlosen Tesla-T4-GPUs funktionieren!
* Feinabstimmen von Gemma 3 (4B) mit Vision-Unterstützung mit unserem [kostenloses Colab-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
{% hint style="info" %}
Laut dem Gemma-Team ist die optimale Konfiguration für die Inferenz\
`temperature = 1.0, top_k = 64, top_p = 0.95, min_p = 0.0`
{% endhint %}
**Unsloth-Gemma-3-Uploads mit optimalen Konfigurationen:**
| GGUF | Unsloth Dynamic 4-Bit Instruct | 16-Bit Instruct |
| -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
|
|
## :gear: Empfohlene Inferenz-Einstellungen
Laut dem Gemma-Team sind die offiziell empfohlenen Einstellungen für die Inferenz:
* Temperatur von 1.0
* Top\_K von 64
* Min\_P von 0,00 (optional, aber 0,01 funktioniert gut, der Standard von llama.cpp ist 0,1)
* Top\_P von 0.95
* Wiederholungsstrafe von 1.0. (1.0 bedeutet in llama.cpp und transformers deaktiviert)
* Chat-Vorlage:
<bos><start_of_turn>user\nHallo!<end_of_turn>\n<start_of_turn>model\nHey!<end_of_turn>\n<start_of_turn>user\nWas ist 1+1?<end_of_turn>\n<start_of_turn>model\n
* Chatvorlage mit `\n`gerenderten Zeilenumbrüchen (außer dem letzten)
{% code overflow="wrap" %}
```
user
Hallo!model
Hey!user
Was ist 1+1?model\n
```
{% endcode %}
{% hint style="danger" %}
llama.cpp und andere Inferenz-Engines fügen automatisch ein \ hinzu - fügen Sie NICHT ZWEI \-Tokens hinzu! Sie sollten das \ beim Prompting des Modells ignorieren!
{% endhint %}
### ✨Gemma 3 auf deinem Handy ausführen
Um die Modelle auf deinem Handy auszuführen, empfehlen wir die Verwendung einer beliebigen mobilen App, die GGUFs lokal auf Edge-Geräten wie Handys ausführen kann. Nach dem Fine-Tuning kannst du es nach GGUF exportieren und dann lokal auf deinem Handy ausführen. Stelle sicher, dass dein Handy genügend RAM/Leistung hat, um die Modelle zu verarbeiten, da es überhitzen kann; daher empfehlen wir für diesen Anwendungsfall Gemma 3 270M oder die Gemma-3n-Modelle. Du kannst die [Open-Source-Projekt von AnythingLLM](https://github.com/Mintplex-Labs/anything-llm) Mobile-App, die du herunterladen kannst auf [Android hier](https://play.google.com/store/apps/details?id=com.anythingllm) oder [ChatterUI](https://github.com/Vali-98/ChatterUI), die großartige Apps zum Ausführen von GGUFs auf deinem Handy sind.
{% hint style="success" %}
Denk daran, dass du den Modellnamen 'gemma-3-27b-it-GGUF' in allen Tutorials in jeden Gemma-Modellnamen ändern kannst, etwa 'gemma-3-270m-it-GGUF:Q8\_K\_XL'.
{% endhint %}
## :llama: Tutorial: So führst du Gemma 3 in Ollama aus
1. Installieren `ollama` falls du das noch nicht getan hast!
```bash
apt-get update
apt-get install pciutils -y
curl -fsSL https://ollama.com/install.sh | sh
```
2. Führen Sie das Modell aus! Beachten Sie, dass Sie `ollama serve`in einem anderen Terminal aufrufen können, falls es fehlschlägt! Wir enthalten alle unsere Korrekturen und empfohlenen Parameter (Temperatur usw.) in `params` in unserem Hugging-Face-Upload! Du kannst den Modellnamen 'gemma-3-27b-it-GGUF' in jeden Gemma-Modellnamen ändern, etwa 'gemma-3-270m-it-GGUF:Q8\_K\_XL'.
```bash
ollama run hf.co/unsloth/gemma-3-27b-it-GGUF:Q4_K_XL
```
## 📖 Tutorial: So führst du Gemma 3 27B in llama.cpp aus
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten. **Für Apple-Mac-/Metal-Geräte**, setzen Sie `-DGGML_CUDA=OFF` und fahren Sie dann wie gewohnt fort – Metal-Unterstützung ist standardmäßig aktiviert.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=ON -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Wenn Sie `llama.cpp` direkt zum Laden von Modellen kannst du Folgendes tun: (:Q4\_K\_XL) ist der Quantisierungstyp. Du kannst auch über Hugging Face (Punkt 3) herunterladen. Das ist ähnlich wie `ollama run`
```bash
./llama.cpp/llama-mtmd-cli \
-hf unsloth/gemma-3-4b-it-GGUF:Q4_K_XL
```
3. **ODER** lade das Modell herunter über (nach der Installation von `pip install huggingface_hub hf_transfer` ). Sie können Q4\_K\_M oder andere quantisierte Versionen (wie BF16-Vollpräzision) wählen. Weitere Versionen unter:
```python
# !pip install huggingface_hub hf_transfer
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
from huggingface_hub import snapshot_download
snapshot_download(
repo_id = "unsloth/gemma-3-27b-it-GGUF",
local_dir = "unsloth/gemma-3-27b-it-GGUF",
allow_patterns = ["*Q4_K_XL*", "mmproj-BF16.gguf"], # Für Q4_K_M
)
```
4. Führe Unsloths Flappy-Bird-Test aus
5. Bearbeiten `--threads 32` für die Anzahl der CPU-Threads, `--ctx-size 16384` für die Kontextlänge (Gemma 3 unterstützt eine Kontextlänge von 128K!), `--n-gpu-layers 99` für GPU-Offloading auf wie viele Layer. Versuche, ihn anzupassen, wenn deiner GPU der Speicher ausgeht. Entferne ihn auch, wenn du nur CPU-Inferenz hast.
6. Für den Gesprächsmodus:
```bash
./llama.cpp/llama-mtmd-cli \
--model unsloth/gemma-3-27b-it-GGUF/gemma-3-27b-it-Q4_K_XL.gguf \\
--mmproj unsloth/gemma-3-27b-it-GGUF/mmproj-BF16.gguf \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.01 \\
--top-k 64 \\
--top-p 0.95
```
7. Für den Nicht-Dialogmodus, um Flappy Bird zu testen:
```bash
./llama.cpp/llama-cli \\
--model unsloth/gemma-3-27b-it-GGUF/gemma-3-27b-it-Q4_K_XL.gguf \\
--ctx-size 16384 \\
--n-gpu-layers 99 \\
--seed 3407 \\
--prio 2 \\
--temp 1.0 \\
--repeat-penalty 1.0 \
--min-p 0.01 \\
--top-k 64 \\
--top-p 0.95 \\
-no-cnv \\
--prompt "user\nErstelle ein Flappy-Bird-Spiel in Python. Du musst diese Dinge einbeziehen:\n1. Du musst pygame verwenden.\n2. Die Hintergrundfarbe sollte zufällig gewählt werden und ein heller Farbton sein. Beginne mit einem hellblauen Farbton.\n3. Mehrfaches Drücken von LEERTASTE beschleunigt den Vogel.\n4. Die Form des Vogels sollte zufällig als Quadrat, Kreis oder Dreieck gewählt werden. Die Farbe sollte zufällig als dunkle Farbe gewählt werden.\n5. Platziere unten etwas Boden, der zufällig dunkelbraun oder gelb gefärbt ist.\n6. Zeige oben rechts eine Punktzahl an. Erhöhe sie, wenn du Rohre passierst und sie nicht berührst.\n7. Erzeuge zufällig verteilte Rohre mit ausreichend Platz. Färbe sie zufällig dunkelgrün oder hellbraun oder einem dunklen Grauton.\n8. Wenn du verlierst, zeige die beste Punktzahl an. Platziere den Text innerhalb des Bildschirms. Drücken von q oder Esc beendet das Spiel. Ein Neustart erfolgt durch erneutes Drücken von LEERTASTE.\nDas fertige Spiel sollte in einem Markdown-Abschnitt in Python enthalten sein. Prüfe deinen Code auf Fehler und behebe sie vor dem endgültigen Markdown-Abschnitt.\nmodel\n"
```
Die vollständige Eingabe aus unserem 1,58-Bit-Blog lautet:
{% hint style="danger" %}
Denk daran, \ zu entfernen, da Gemma 3 \ automatisch hinzufügt!
{% endhint %}
{% code overflow="wrap" %}
```
user
Erstelle ein Flappy-Bird-Spiel in Python. Du musst die folgenden Dinge einbauen:
1. Du musst pygame verwenden.
2. Die Hintergrundfarbe sollte zufällig gewählt werden und hell sein. Beginne mit einer hellblauen Farbe.
3. Wenn du die LEERTASTE mehrfach drückst, beschleunigt sich der Vogel.
4. Die Form des Vogels sollte zufällig als Quadrat, Kreis oder Dreieck gewählt werden. Die Farbe sollte zufällig als dunkle Farbe gewählt werden.
5. Platziere am unteren Rand etwas Land, das zufällig dunkelbraun oder gelb gefärbt ist.
6. Zeige oben rechts einen Punktestand an. Erhöhe ihn, wenn du an Rohren vorbeikommst und sie nicht berührst.
7. Erzeuge zufällig verteilte Rohre mit genügend Abstand. Färbe sie zufällig dunkelgrün, hellbraun oder in einem dunklen Grauton.
8. Wenn du verlierst, zeige den Bestwert an. Der Text soll sich innerhalb des Bildschirms befinden. Drücken von q oder Esc beendet das Spiel. Neustart erfolgt durch erneutes Drücken der LEERTASTE.
Das fertige Spiel sollte sich in einem Markdown-Abschnitt in Python befinden. Überprüfe deinen Code auf Fehler
```
{% endcode %}
## :sloth: Fine-Tuning von Gemma 3 in Unsloth
**Unsloth ist das einzige Framework, das auf Float16-Maschinen für Gemma-3-Inferenz und -Training funktioniert.** Das bedeutet, dass auch Colab-Notebooks mit kostenlosen Tesla-T4-GPUs funktionieren!
* Probiere unser neues [Gemma 3 (270M)-Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(270M\).ipynb) das das 270M-Parameter-Modell beim Schachspielen sehr klug macht und den nächsten Schachzug vorhersagen kann.
* Feinabstimme Gemma 3 (4B) mit unseren Notebooks für: [**Text**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\).ipynb) oder [**Vision**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision.ipynb)
* Oder feinabstimmen [Gemma 3n (E4B)](/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune/gemma-3n-how-to-run-and-fine-tune.md) mit [Text](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Conversational.ipynb) • [Vision](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Vision.ipynb) • [Audio](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3N_\(4B\)-Audio.ipynb)
{% hint style="warning" %}
Beim Versuch eines vollständigen Fine-Tunings (FFT) von Gemma 3 werden auf Float16-Geräten standardmäßig alle Schichten auf Float32 gesetzt. Unsloth erwartet Float16 und führt dynamisches Upcasting durch. Um das zu beheben, führe `model.to(torch.float16)` nach dem Laden aus oder verwende eine GPU mit bfloat16-Unterstützung.
{% endhint %}
### Unsloth-Fixes fürs Fine-Tuning
Unsere Lösung in Unsloth ist dreigeteilt:
1. Alle Zwischenschichtaktivierungen im bfloat16-Format behalten – kann float32 sein, verwendet aber 2x mehr VRAM oder RAM (über Unsloths asynchrones Gradient-Checkpointing)
2. Alle Matrixmultiplikationen in float16 mit Tensor Cores durchführen, aber manuell upcasten/downcasten ohne die Hilfe von Pytorchs Mixed-Precision-Autocast.
3. Alle anderen Optionen, die keine Matrixmultiplikationen benötigen (Layernorms), auf float32 hochstufen.
## 🤔 Analyse der Gemma-3-Fixes
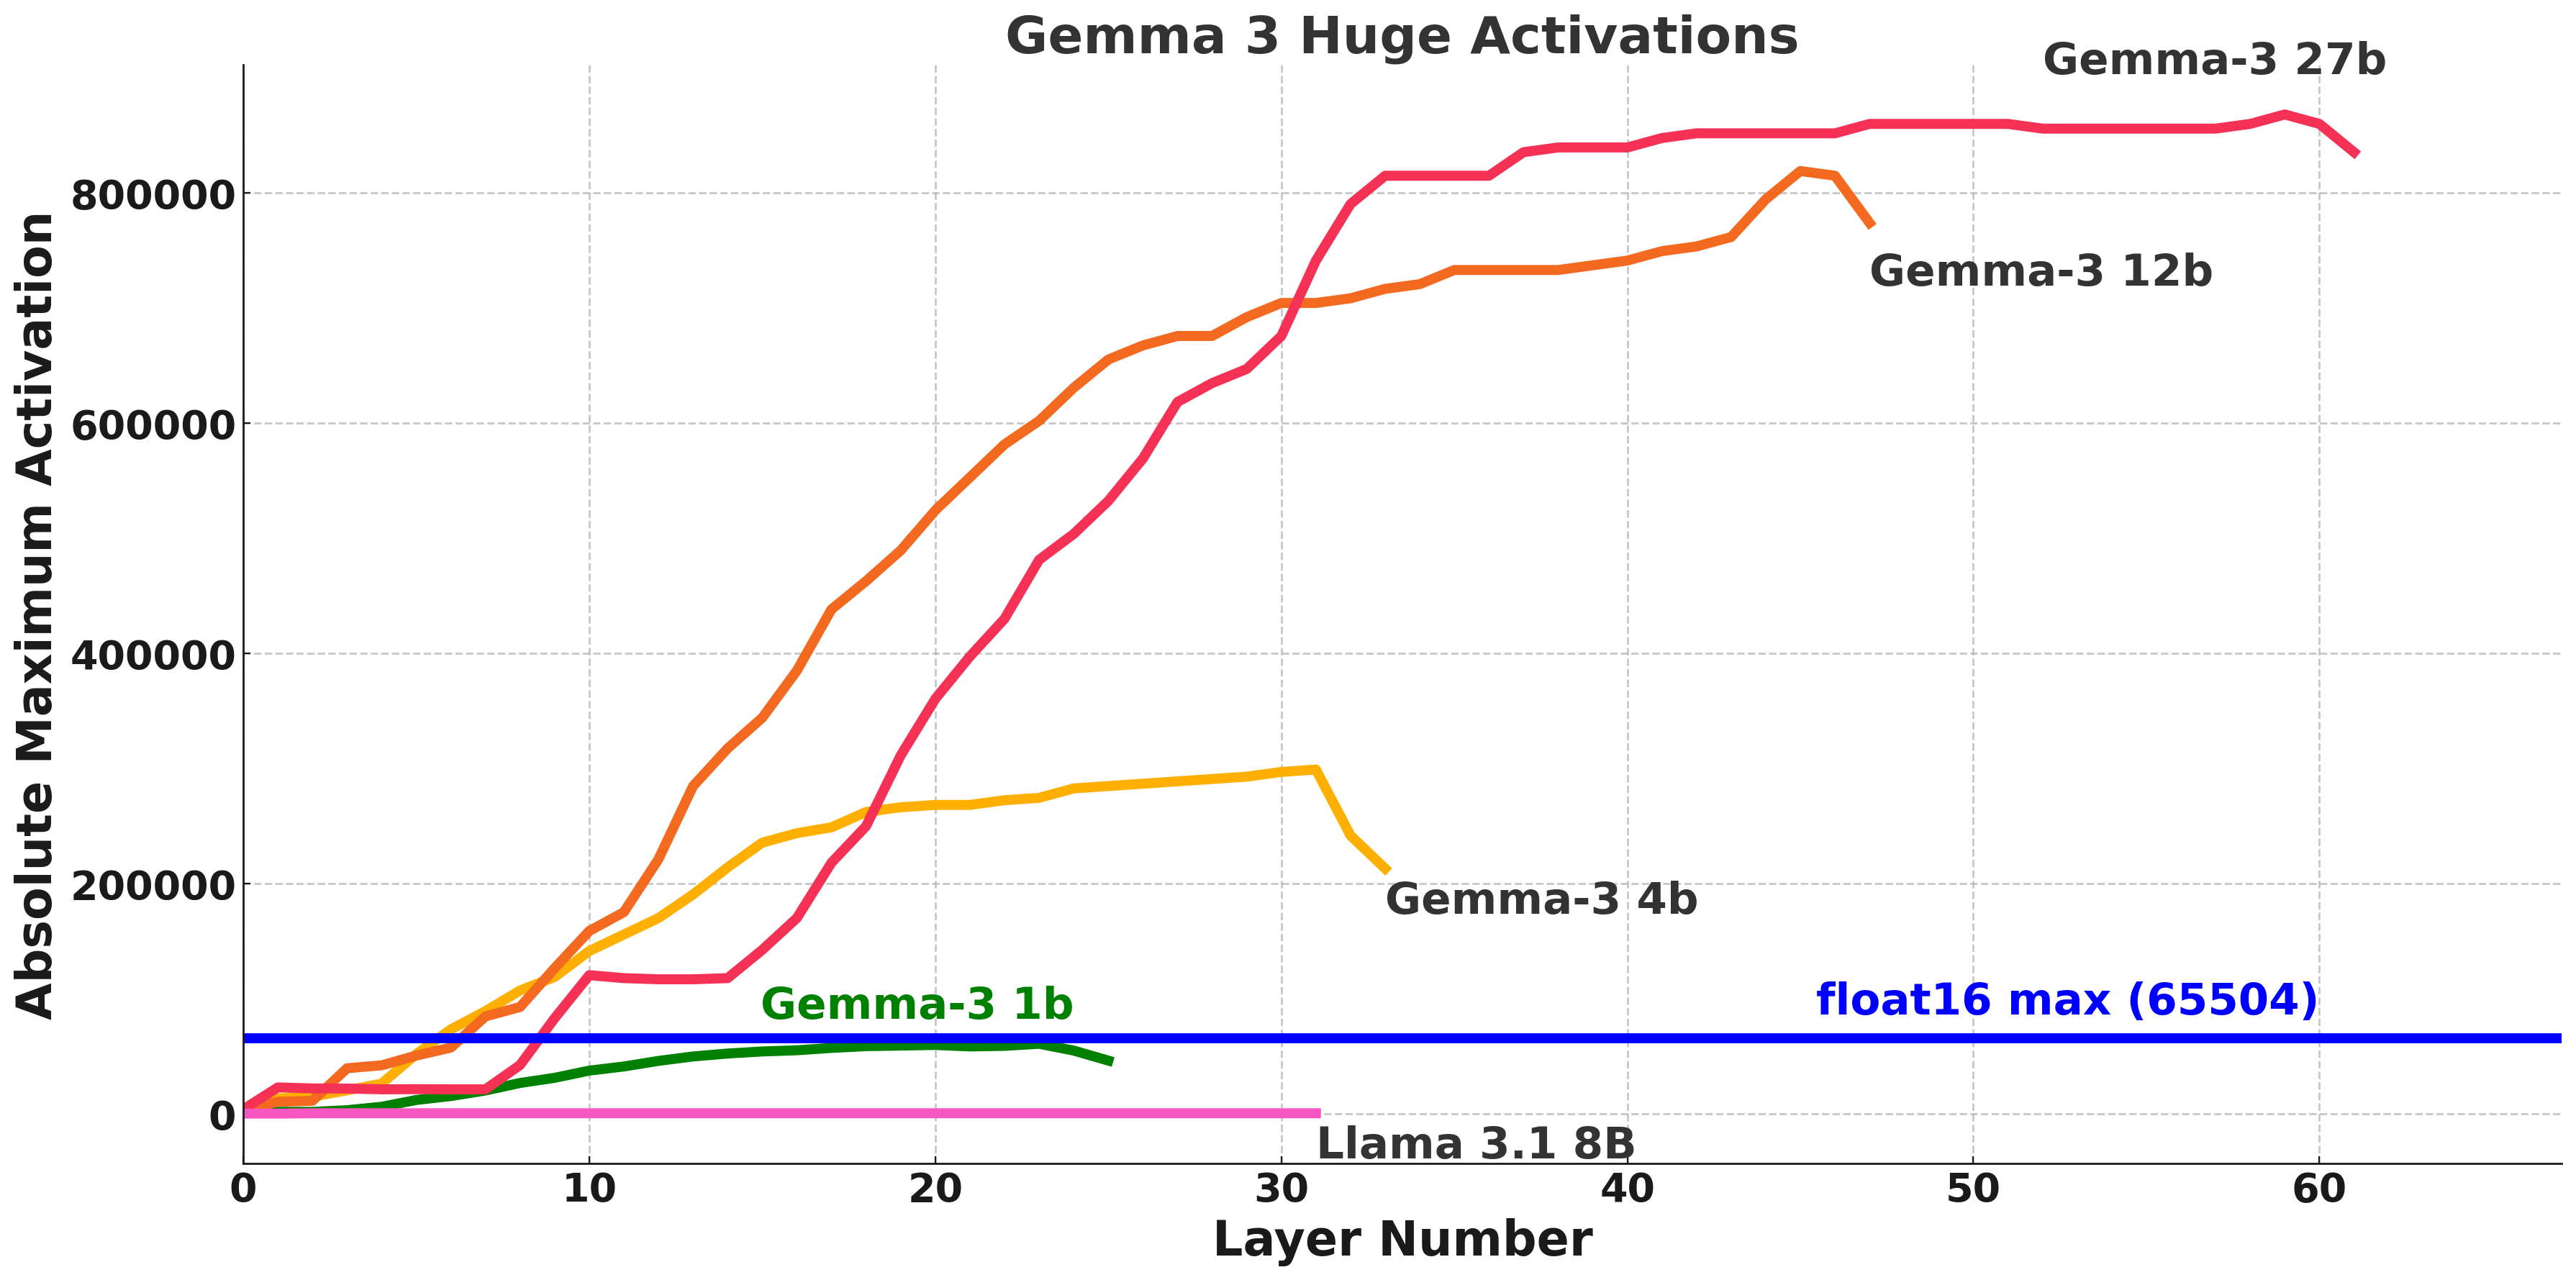
Gemma 3 1B bis 27B überschreiten das Float16-Maximum von 65504
Zuerst haben wir festgestellt, dass beim Fine-Tuning oder Ausführen von Gemma 3 bei Verwendung von Float16-Mixed-Precision die Gradienten und **Aktivierungen unendlich werden** leider. Das passiert auf T4-GPUs, RTX-20x-Serien und V100-GPUs, bei denen es nur Float16-Tensor-Cores gibt.
Für neuere GPUs wie RTX 30x oder höher, A100s, H100s usw. haben diese GPUs bfloat16-Tensor-Cores, daher tritt dieses Problem nicht auf! **Aber warum?**
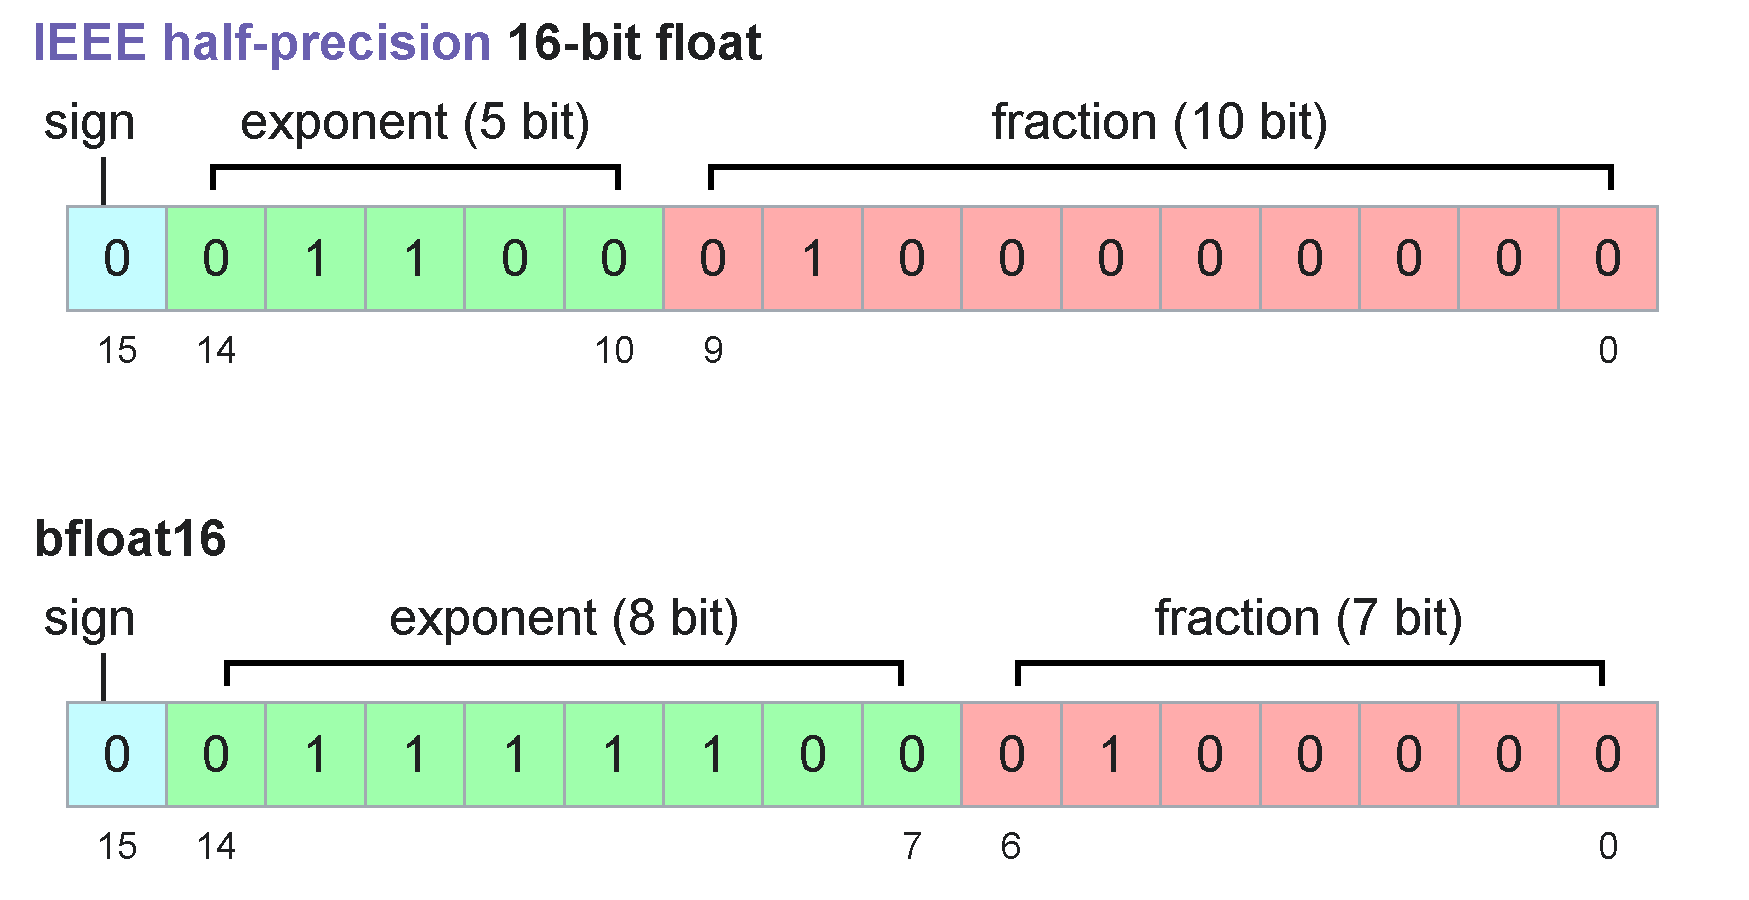
Float16 kann nur Zahlen bis zu **65504**, während bfloat16 riesige Zahlen bis zu **10^38**darstellen kann! Aber beachte: Beide Zahlenformate verwenden nur 16 Bit! Das liegt daran, dass float16 mehr Bits für kleinere Dezimalzahlen reserviert, während bfloat16 Brüche nicht gut darstellen kann.
Aber warum float16? Dann nehmen wir doch einfach float32! Aber leider ist float32 auf GPUs bei Matrixmultiplikationen sehr langsam – manchmal 4- bis 10-mal langsamer! Also können wir das nicht tun.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/tutorials/gemma-3-how-to-run-and-fine-tune.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.