> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/moderu/tutorials/how-to-run-llms-with-docker.md).

# DockerでローカルLLMを実行する方法: ステップバイステップガイド

DockerとUnslothを使って自分のデバイスで大規模言語モデル（LLM）を実行する方法を学びましょう。

Unsloth を含むあらゆるモデルを今すぐ実行できます [Dynamic GGUF](/docs/jp/ji-chu/dynamic-3.0-ggufs.md)、Mac、Windows、Linux 上で、コード1行、または **コード不要** まったく必要ありません。Docker と協力してモデルのデプロイを簡単にし、今では Unsloth が Docker 上のほとんどの GGUF モデルを支えています。

始める前に、必ず次を確認してください： [ハードウェア要件](#hardware-info--performance) そして [パフォーマンス最適化のヒント](#hardware-info--performance) お使いのデバイスで LLM を実行するときのパフォーマンス最適化に役立ちます。

<a href="/docs/jp/moderu/tutorials/how-to-run-llms-with-docker.md#method-1-docker-terminal" class="button primary">Docker ターミナルチュートリアル</a><a href="#method-2-docker-desktop-no-code" class="button primary">Docker ノーコードチュートリアル</a>

開始するには、OpenAI を実行します [gpt-oss](/docs/jp/moderu/gpt-oss-how-to-run-and-fine-tune.md) 1つのコマンドで：

```bash
docker model run ai/gpt-oss:20B
```

または、特定の [Unsloth モデル](/docs/jp/meru/unsloth-model-catalog.md)  / Hugging Face の量子化を実行するには：

```bash
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:F16
```

{% hint style="success" %}
Docker Desktop は不要です。モデルの実行には Docker CE で十分です。
{% endhint %}

#### **なぜ Unsloth + Docker なのか？**

Google Gemma のようなモデル研究チームと協力して、モデルのバグを修正し、精度を向上させています。私たちの Dynamic GGUF は一貫して他の量子化手法を上回り、高精度で効率的な推論を実現します。

Docker を使えば、セットアップ不要でモデルをすぐに実行できます。Docker が使用するのは [Docker Model Runner](https://github.com/docker/model-runner) （DMR）で、依存関係の問題なしにコンテナと同じくらい簡単に LLM を実行できます。DMR は Unsloth のモデルと `llama.cpp` 内部で使い、高速・効率的・最新の推論を実現します。

## :gear: ハードウェア情報 + パフォーマンス

最高のパフォーマンスを得るには、VRAM + RAM の合計が、ダウンロードする量子化モデルのサイズと少なくとも同じになるようにしてください。これより少ない場合でもモデルは動作しますが、かなり遅くなります。

モデルを保存するのに十分なディスク容量があることも確認してください。モデルがメモリにぎりぎり収まる程度なら、モデルサイズにもよりますが、約 \~5 tokens/s 程度を想定してください。

余分な RAM/VRAM があると推論速度が向上し、追加の VRAM があれば最も大きな性能向上が得られます（モデル全体が収まる場合）。

{% hint style="info" %}
**例:** gpt-oss-20b（F16）をダウンロードし、モデルが 13.8 GB の場合は、ディスク容量と RAM + VRAM が 13.8 GB を超えていることを確認してください。
{% endhint %}

**量子化の推奨：**

* 30B パラメータ未満のモデルでは、少なくとも 4-bit（Q4）を使用してください。
* 70B パラメータ以上のモデルでは、少なくとも 2-bit 量子化（例：UD\_Q2\_K\_XL）を使用してください。

## ⚡ ステップごとのチュートリアル

以下は **2つの方法** Docker でモデルを実行する方法です：1つは [ターミナル](#method-1-docker-terminal)、もう1つは [Docker Desktop](#method-2-docker-desktop-no-code) を使うコード不要の方法です：

### 方法 #1：Docker ターミナル

{% stepper %}
{% step %}

#### Docker をインストールする

Docker Model Runner はすでに **両方** [Docker Desktop](https://docs.docker.com/ai/model-runner/get-started/#docker-desktop) そして [**Docker CE**](https://docs.docker.com/ai/model-runner/get-started/#docker-engine)**.**
{% endstep %}

{% step %}

#### モデルを実行する

実行するモデルを決めたら、ターミナルからコマンドを実行します。

* 次の場所で利用できる、検証済みの信頼できるモデルカタログを閲覧してください： [Docker Hub](https://hub.docker.com/r/ai) または [Unsloth の Hugging Face](https://huggingface.co/unsloth) ページ。
* コマンドを実行するにはターミナルへ移動してください。 `docker` がインストールされているか確認するには、'docker' と入力して Enter を押します。
* Docker Hub では既定で Unsloth Dynamic 4-bit が実行されますが、独自の量子化レベルを選択できます（手順 #3 を参照）。

たとえば、OpenAI を実行するには `gpt-oss-20b` 1つのコマンドで：

```bash
docker model run ai/gpt-oss:20B
```

または、特定の [Unsloth](/docs/jp/meru/unsloth-model-catalog.md) Hugging Face の gpt-oss 量子化：

```bash
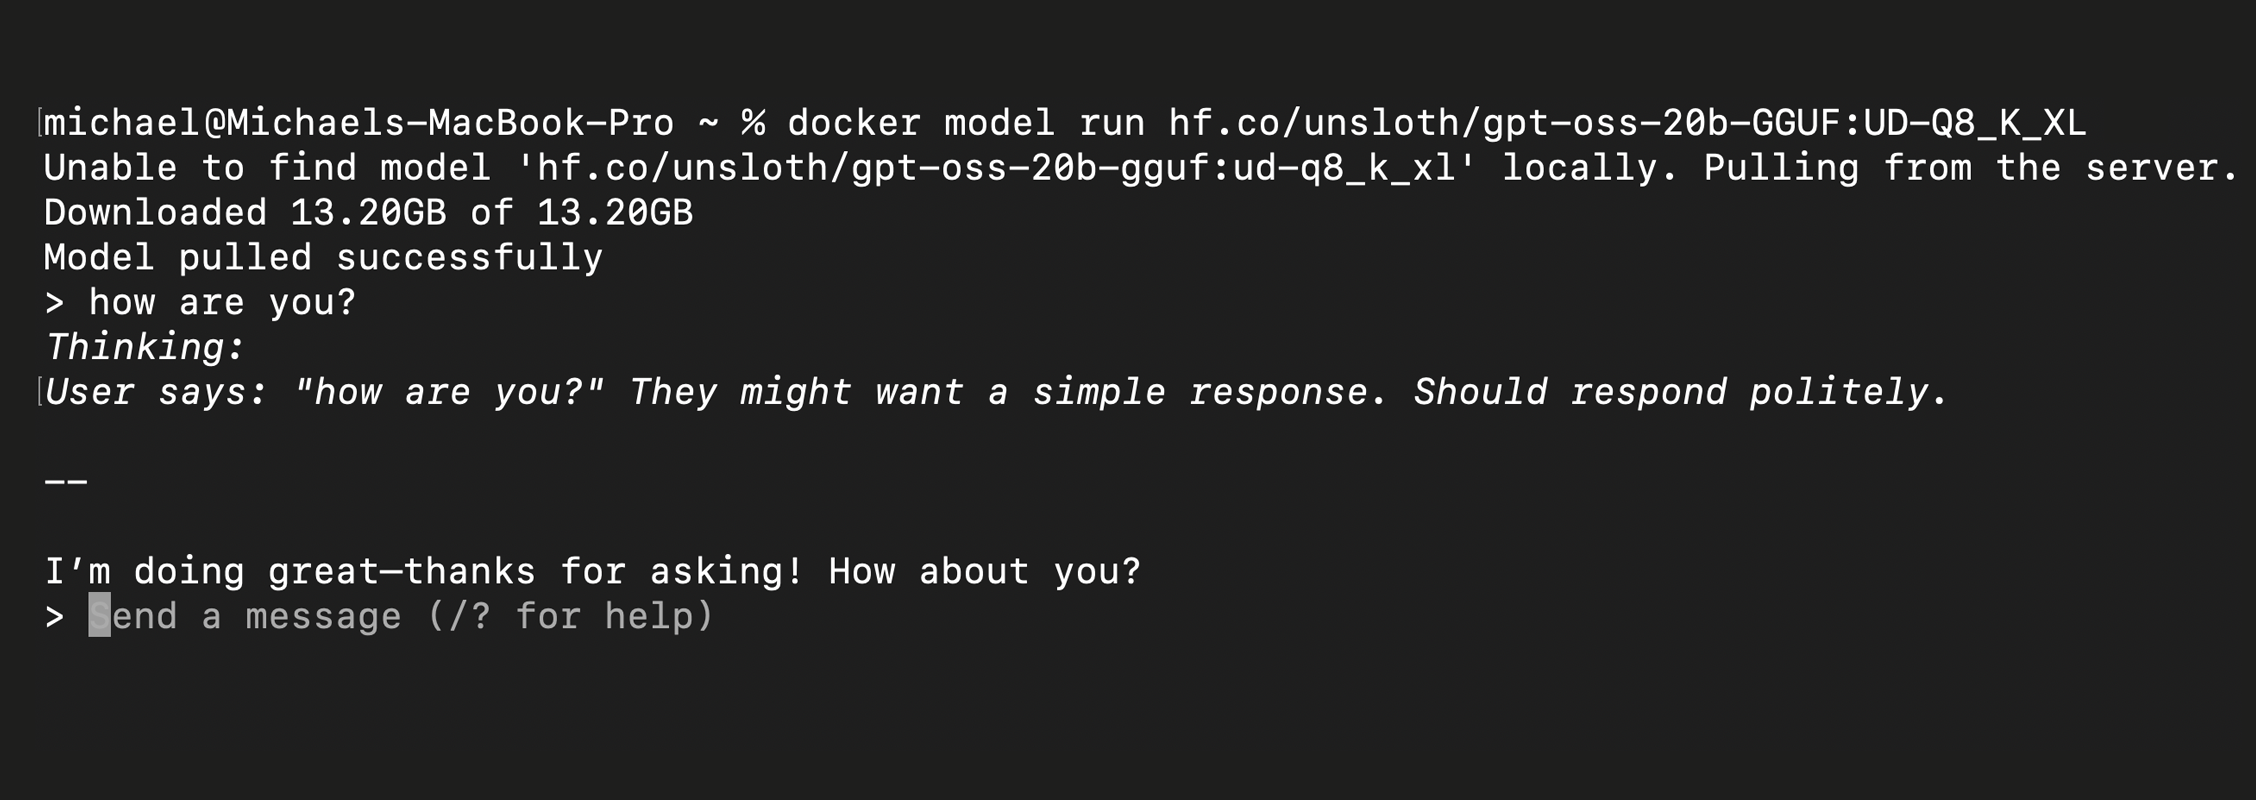
docker model run hf.co/unsloth/gpt-oss-20b-GGUF:UD-Q8_K_XL
```

**CLI で gpt-oss-20b を実行すると、次のようになります：**

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FNQQGqQfLuX2a40i07Es1%2Funknown.png?alt=media&amp;token=6006e370-a298-4e5f-af9f-5c4e8c4a0fc8" alt="" width="563"><figcaption><p>Docker Hub の gpt-oss-20b</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFtzowkLonKo4N2LzEnhe%2Fgptoss%20ud8kxl.png?alt=media&amp;token=08eb6244-0626-4ad8-adbe-f5c4e5aa6d72" alt="" width="563"><figcaption><p>Unsloth の UD-Q8_K_XL 量子化を使った gpt-oss-20b</p></figcaption></figure></div>
{% endstep %}

{% step %}

#### 特定の量子化レベルを実行するには：

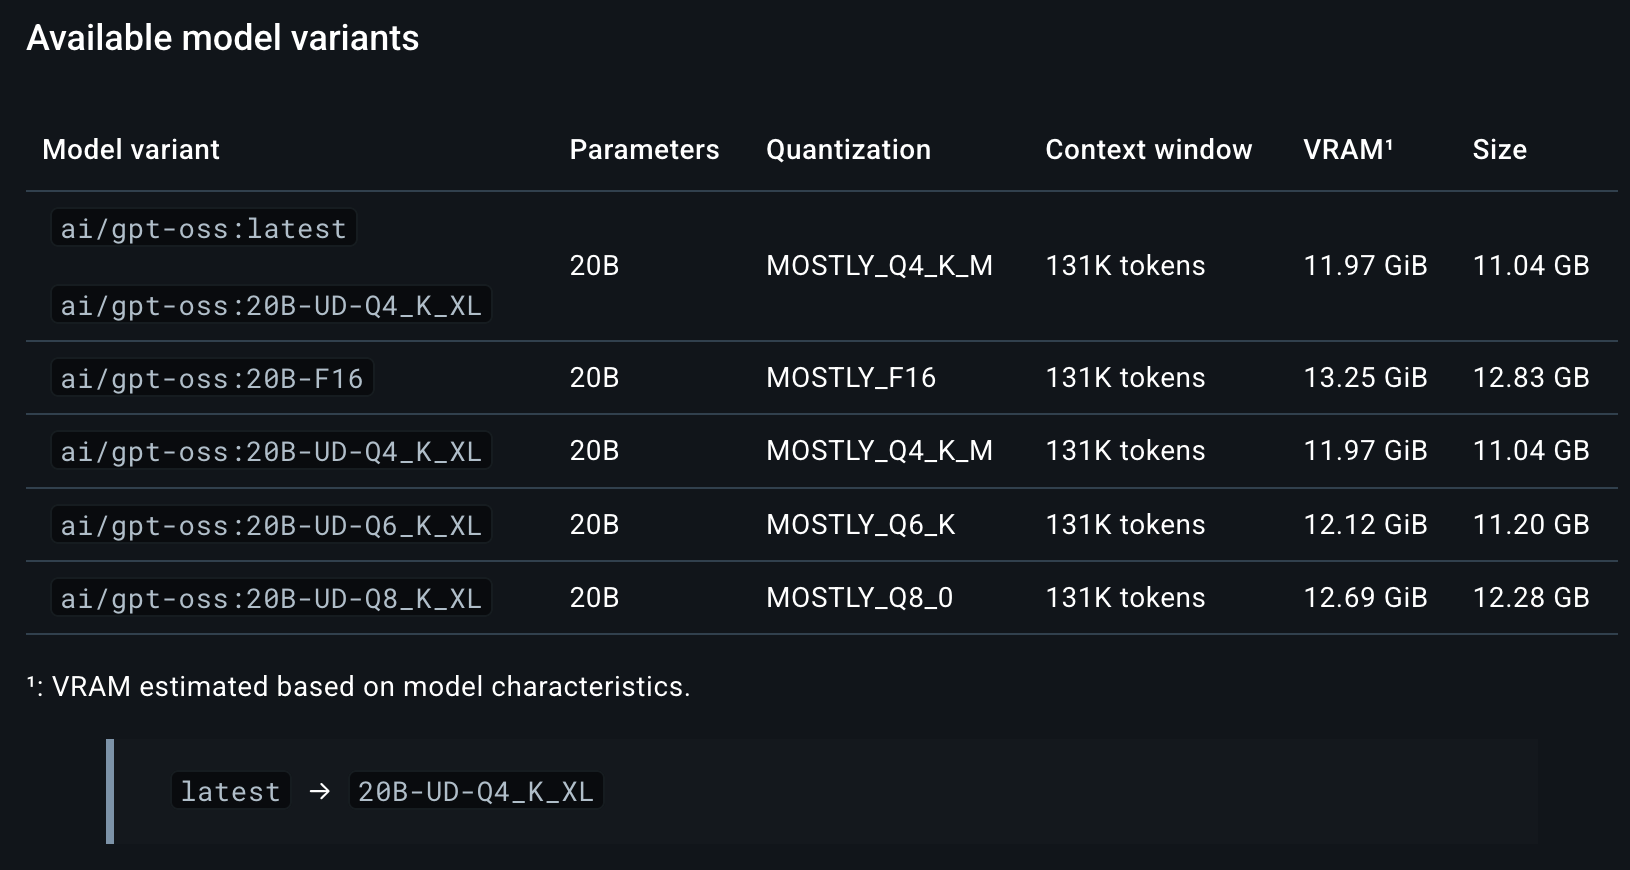
モデルの特定の量子化を実行したい場合は、末尾に `:` と量子化名を追加します（例： `Q4` Docker 用なら `UD-Q4_K_XL`）。各モデルの Docker Hub ページで利用可能なすべての量子化を確認できます。たとえば、gpt-oss に一覧表示されている量子化を参照してください [ここ](https://hub.docker.com/r/ai/gpt-oss#gptoss).

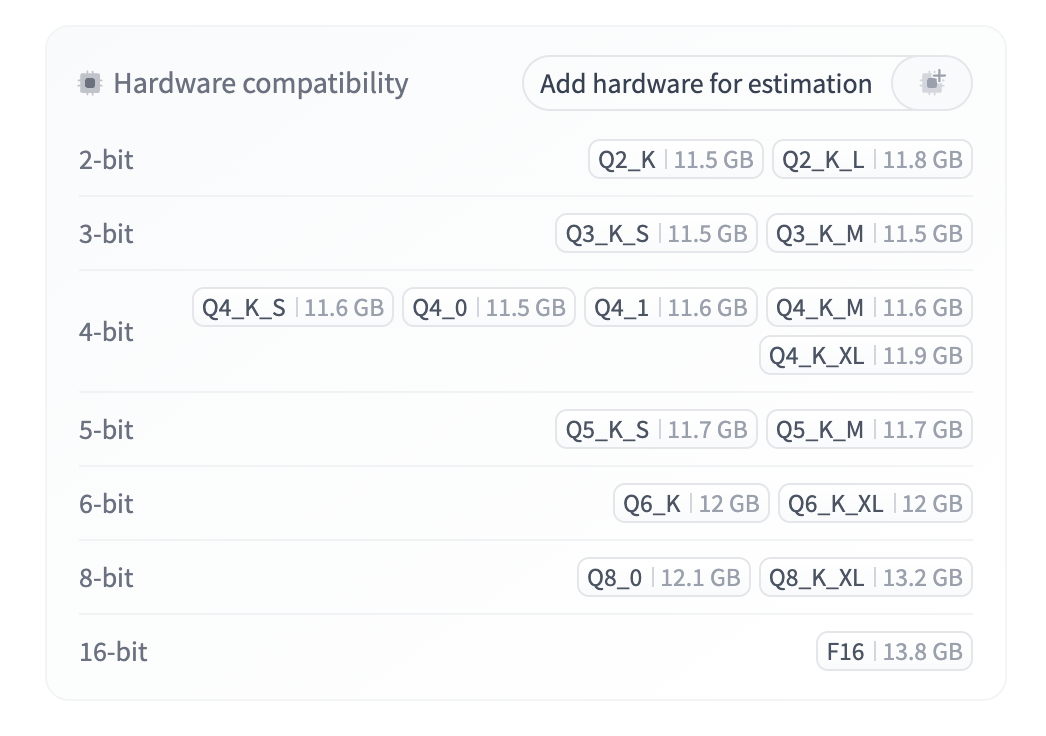
同様に、Hugging Face 上の Unsloth の量子化にも適用されます。次を開いてください： [モデルの HF ページ](https://huggingface.co/unsloth/gpt-oss-20b-GGUF?show_file_info=gpt-oss-20b-Q2_K_L.gguf)で量子化を選び、次のようなコマンドを実行します： `docker model run hf.co/unsloth/gpt-oss-20b-GGUF:Q2_K_L`

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FI7MrphUugkU8eZ1f7lJz%2FScreenshot%202025-11-16%20at%2010.52.25%E2%80%AFPM.png?alt=media&amp;token=ae777fdb-258e-46d0-b06e-b68434f7fa58" alt="" width="563"><figcaption><p>gpt-oss の量子化レベル： <a href="https://hub.docker.com/r/ai/gpt-oss#gptoss">Docker Hub</a></p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F73UWIs9VAZ6Iz1omgZSm%2FScreenshot%202025-11-16%20at%2010.54.53%E2%80%AFPM.png?alt=media&amp;token=e8dee7f3-1b8b-4dda-a455-26df58102d16" alt="" width="563"><figcaption><p>Unsloth gpt-oss の量子化レベル：<a href="https://huggingface.co/unsloth/gpt-oss-20b-GGUF"> Hugging Face</a></p></figcaption></figure></div>
{% endstep %}
{% endstepper %}

### 方法 #2：Docker Desktop（コード不要）

{% stepper %}
{% step %}

#### Docker Desktop をインストールする

Docker Model Runner はすでに [Docker Desktop](https://docs.docker.com/ai/model-runner/get-started/#docker-desktop).

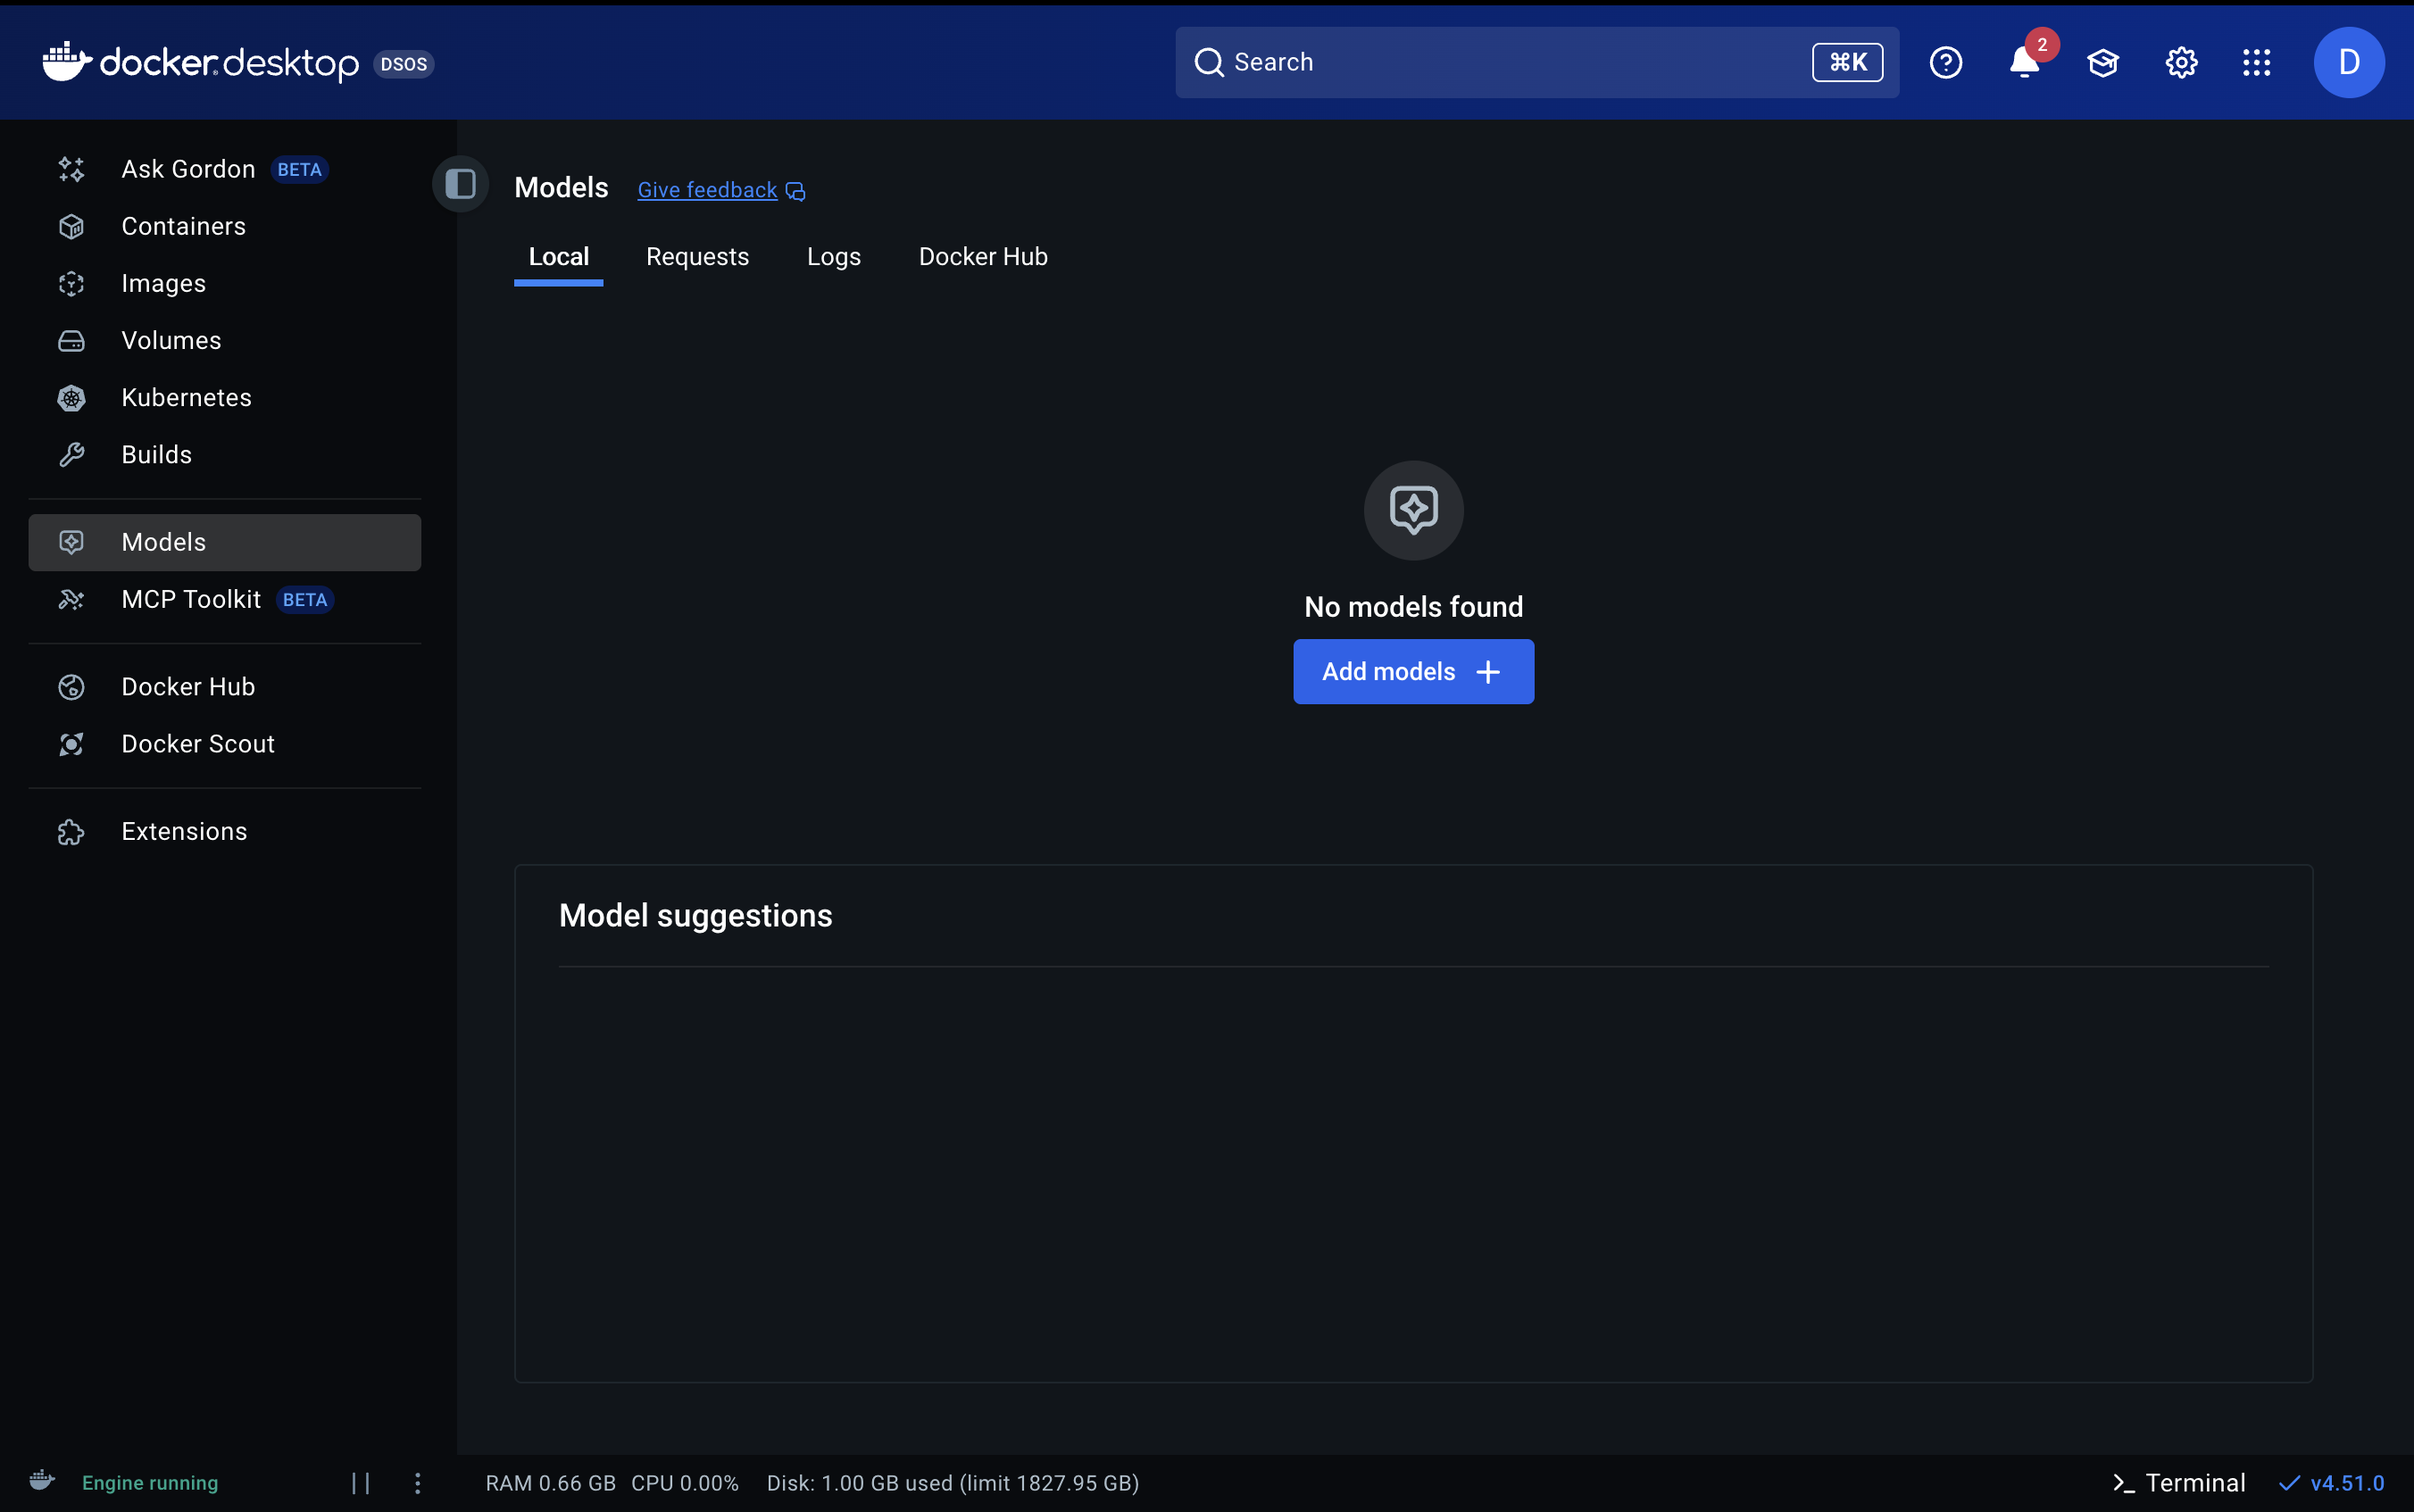
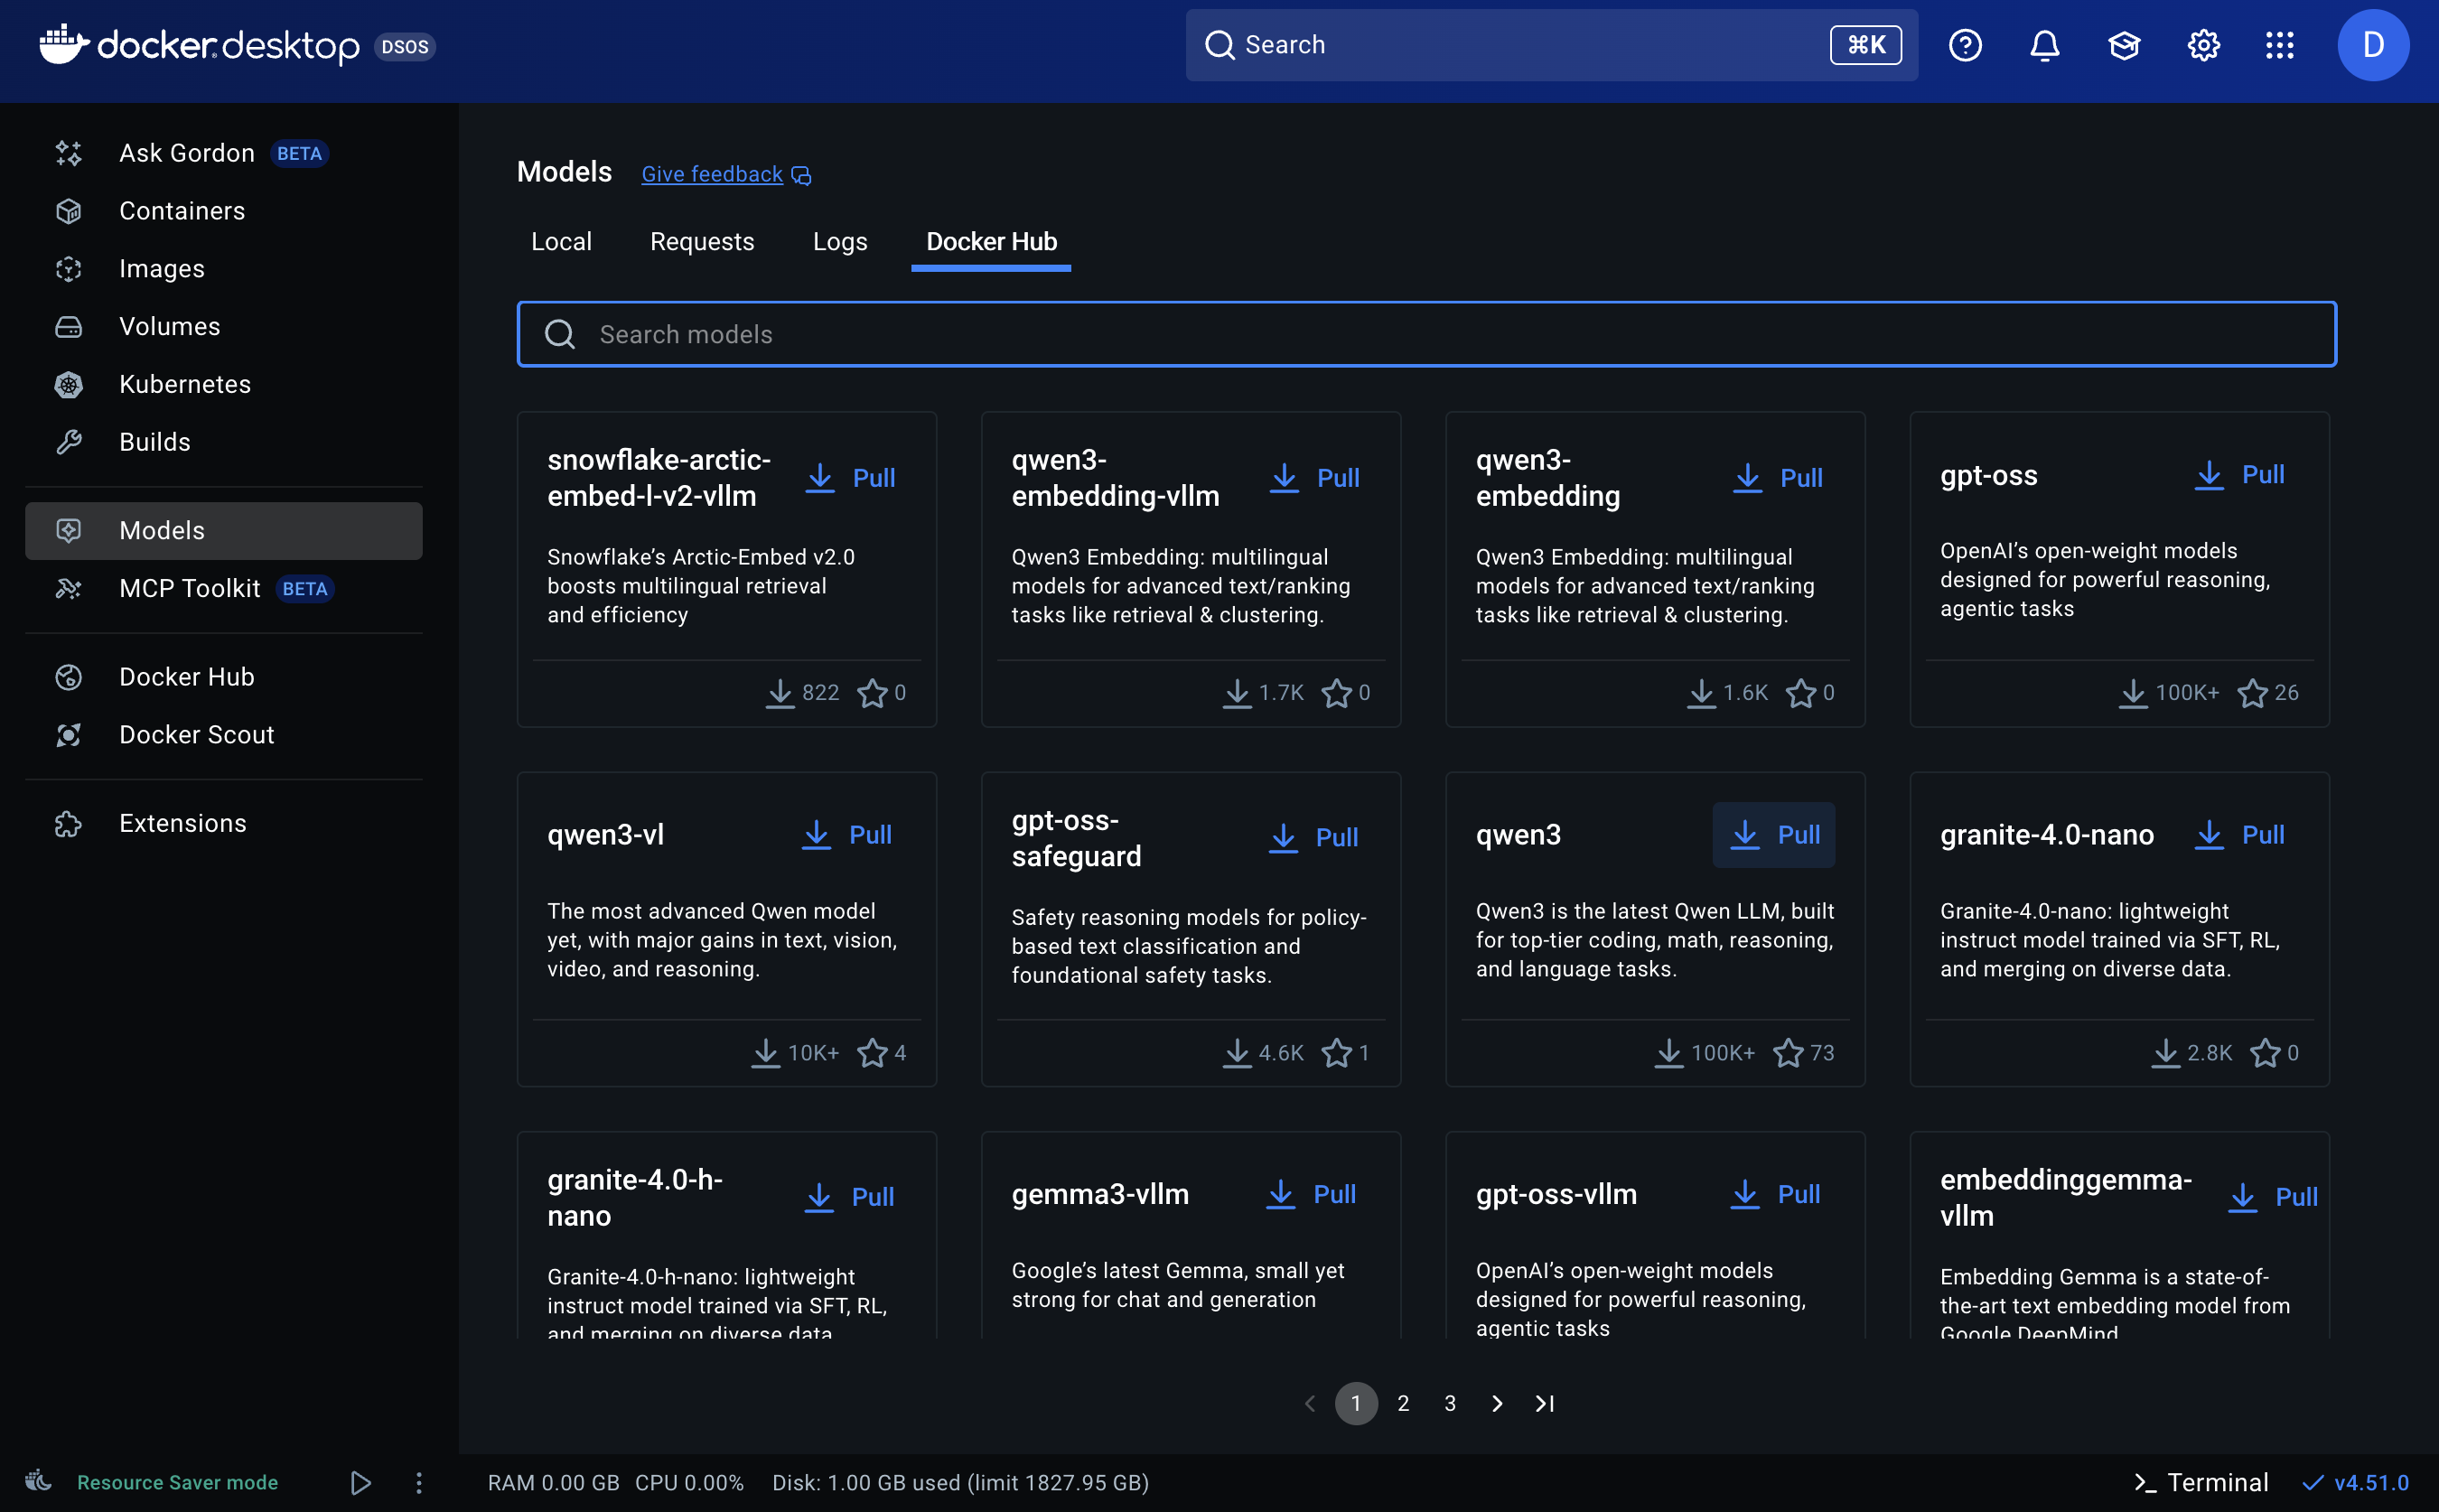
1. 実行するモデルを決めたら、Docker Desktop を開き、Models タブをクリックします。
2. 'Add models +' か Docker Hub をクリックし、モデルを検索します。

次の場所で利用できる、検証済みのモデルカタログを閲覧してください： [Docker Hub](https://hub.docker.com/r/ai).

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F6R8uxbedMklVHsriLgpZ%2FScreenshot%202025-11-16%20at%206.36.49%E2%80%AFAM.png?alt=media&amp;token=0fb849f5-bc72-4883-9b25-1a756334ab4b" alt=""><figcaption><p>#1. 'Models' タブをクリックし、次に 'Add models +' をクリックします</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fj7I69xgxDeHXkvVbjemq%2FScreenshot%202025-11-16%20at%206.46.47%E2%80%AFAM.png?alt=media&amp;token=3e25d495-f34b-47d6-9185-f145610eed10" alt=""><figcaption><p>#2. 目的のモデルを検索します。</p></figcaption></figure></div>
{% endstep %}

{% step %}

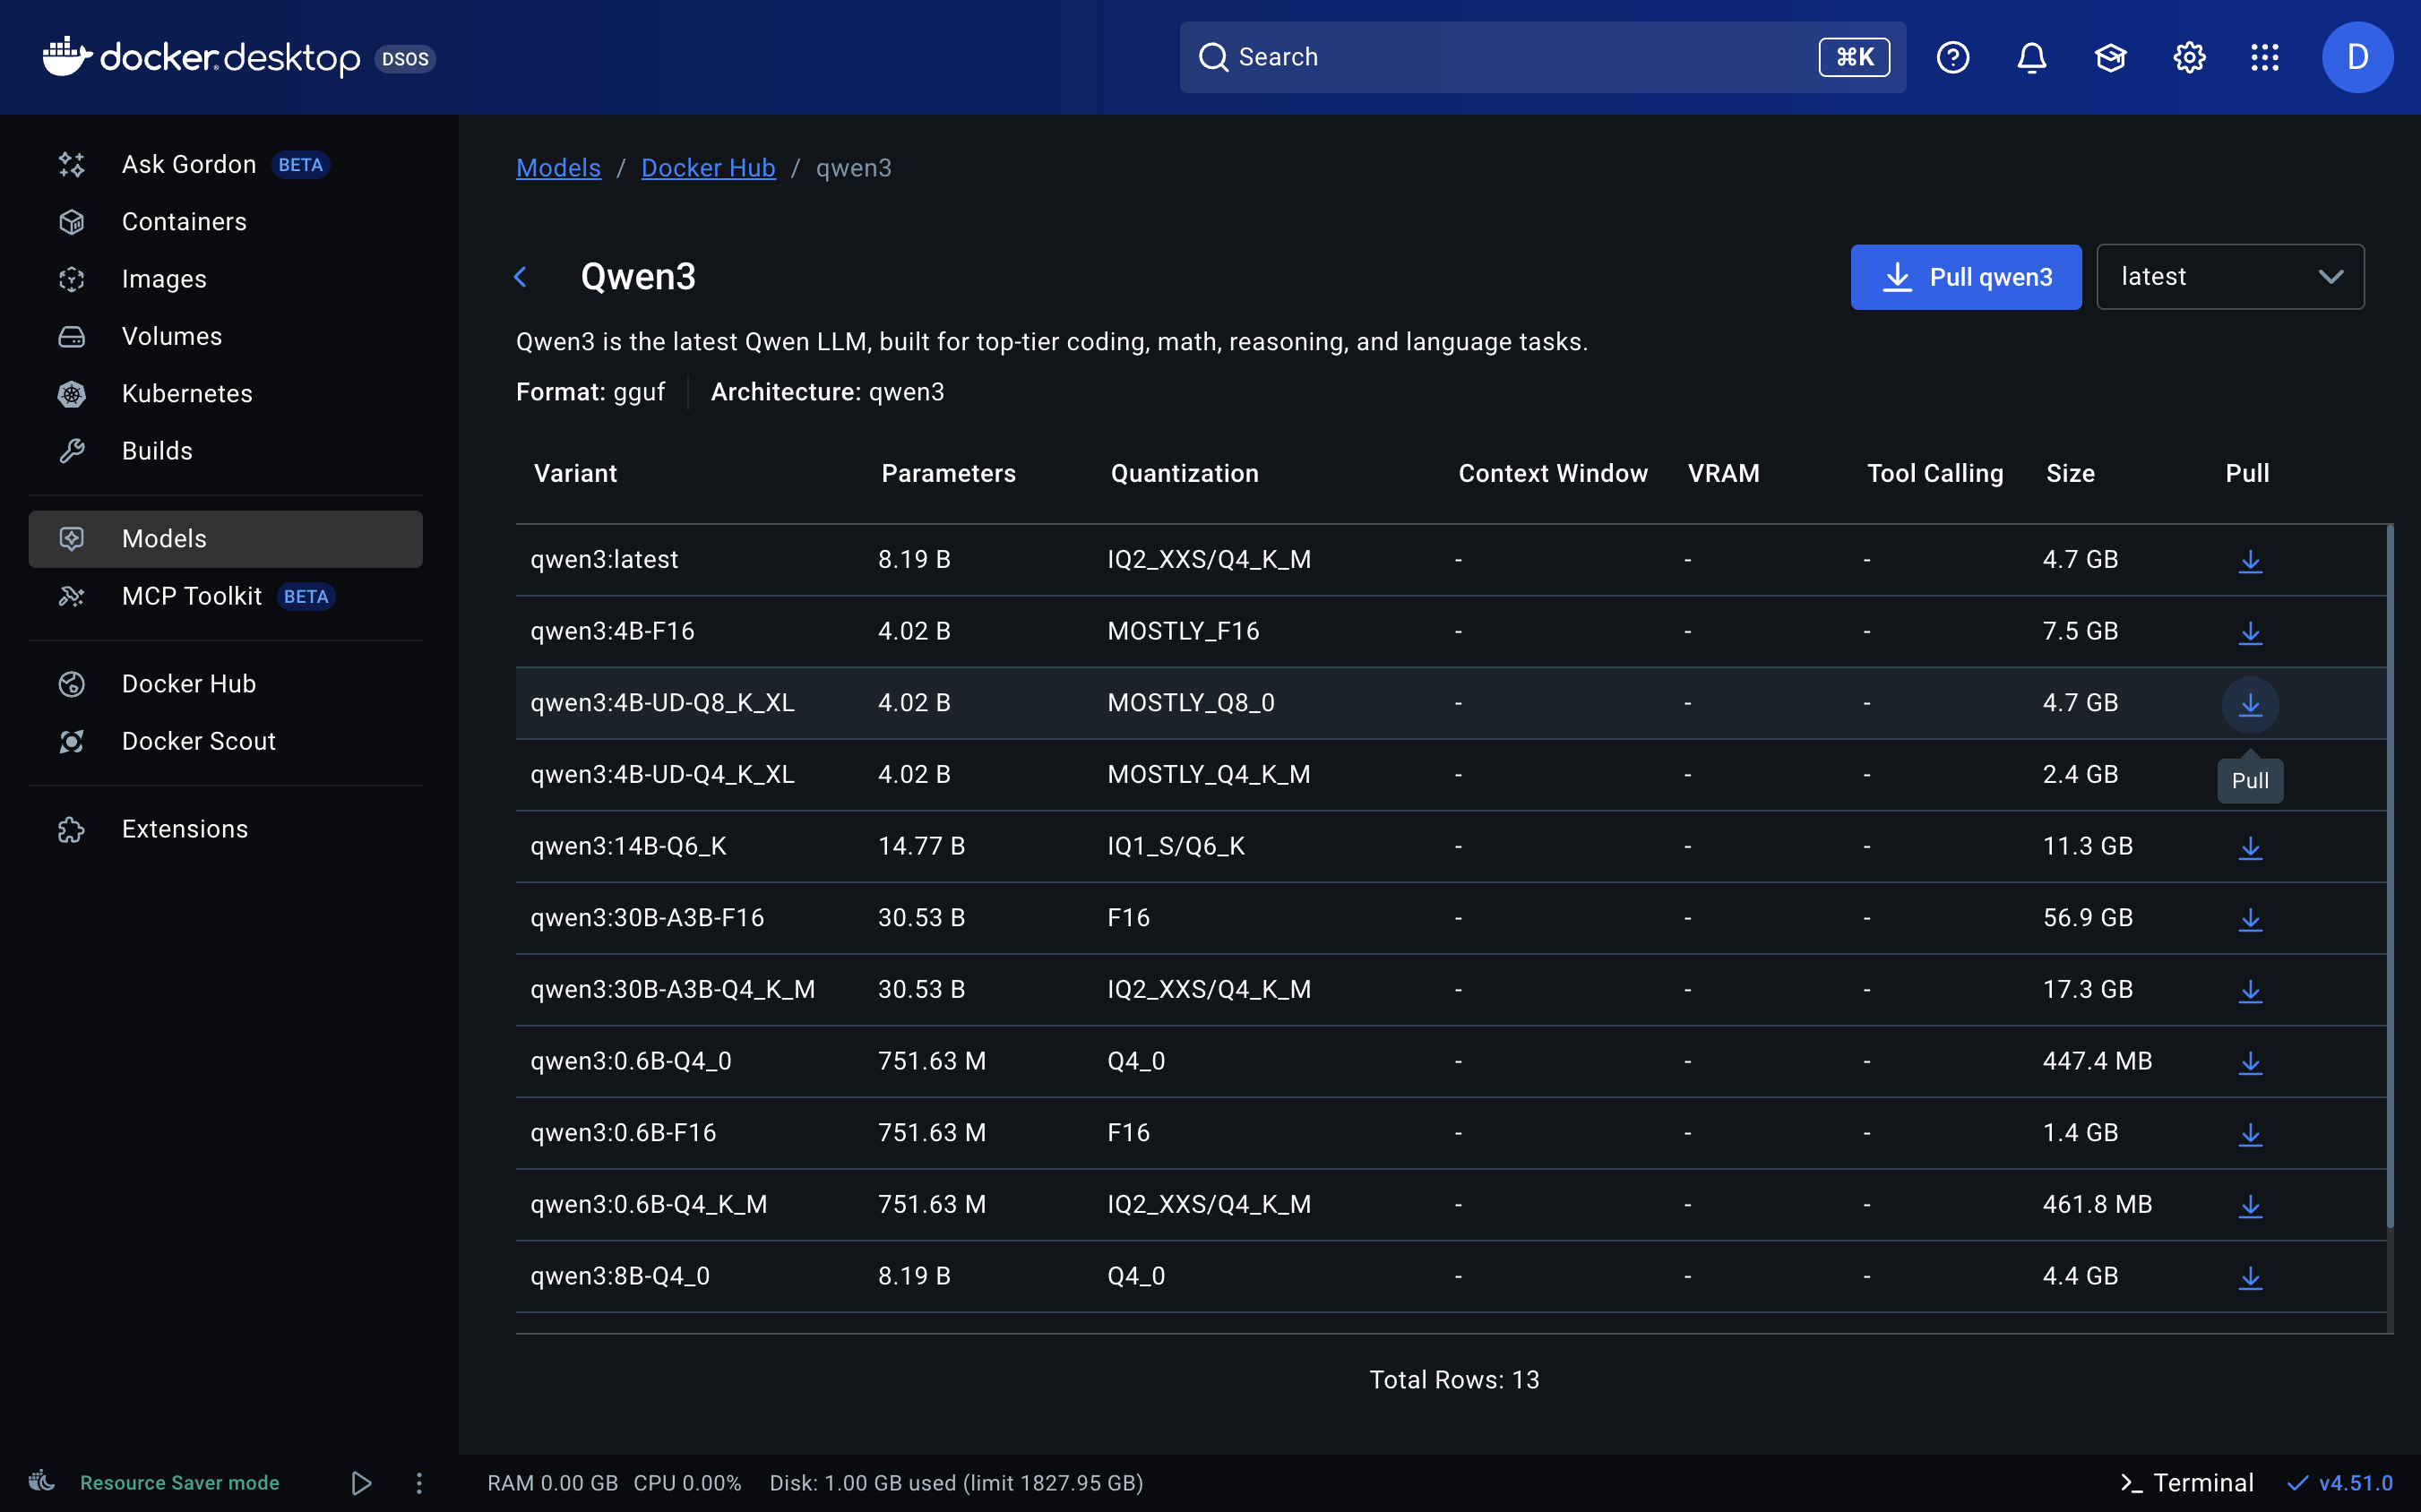
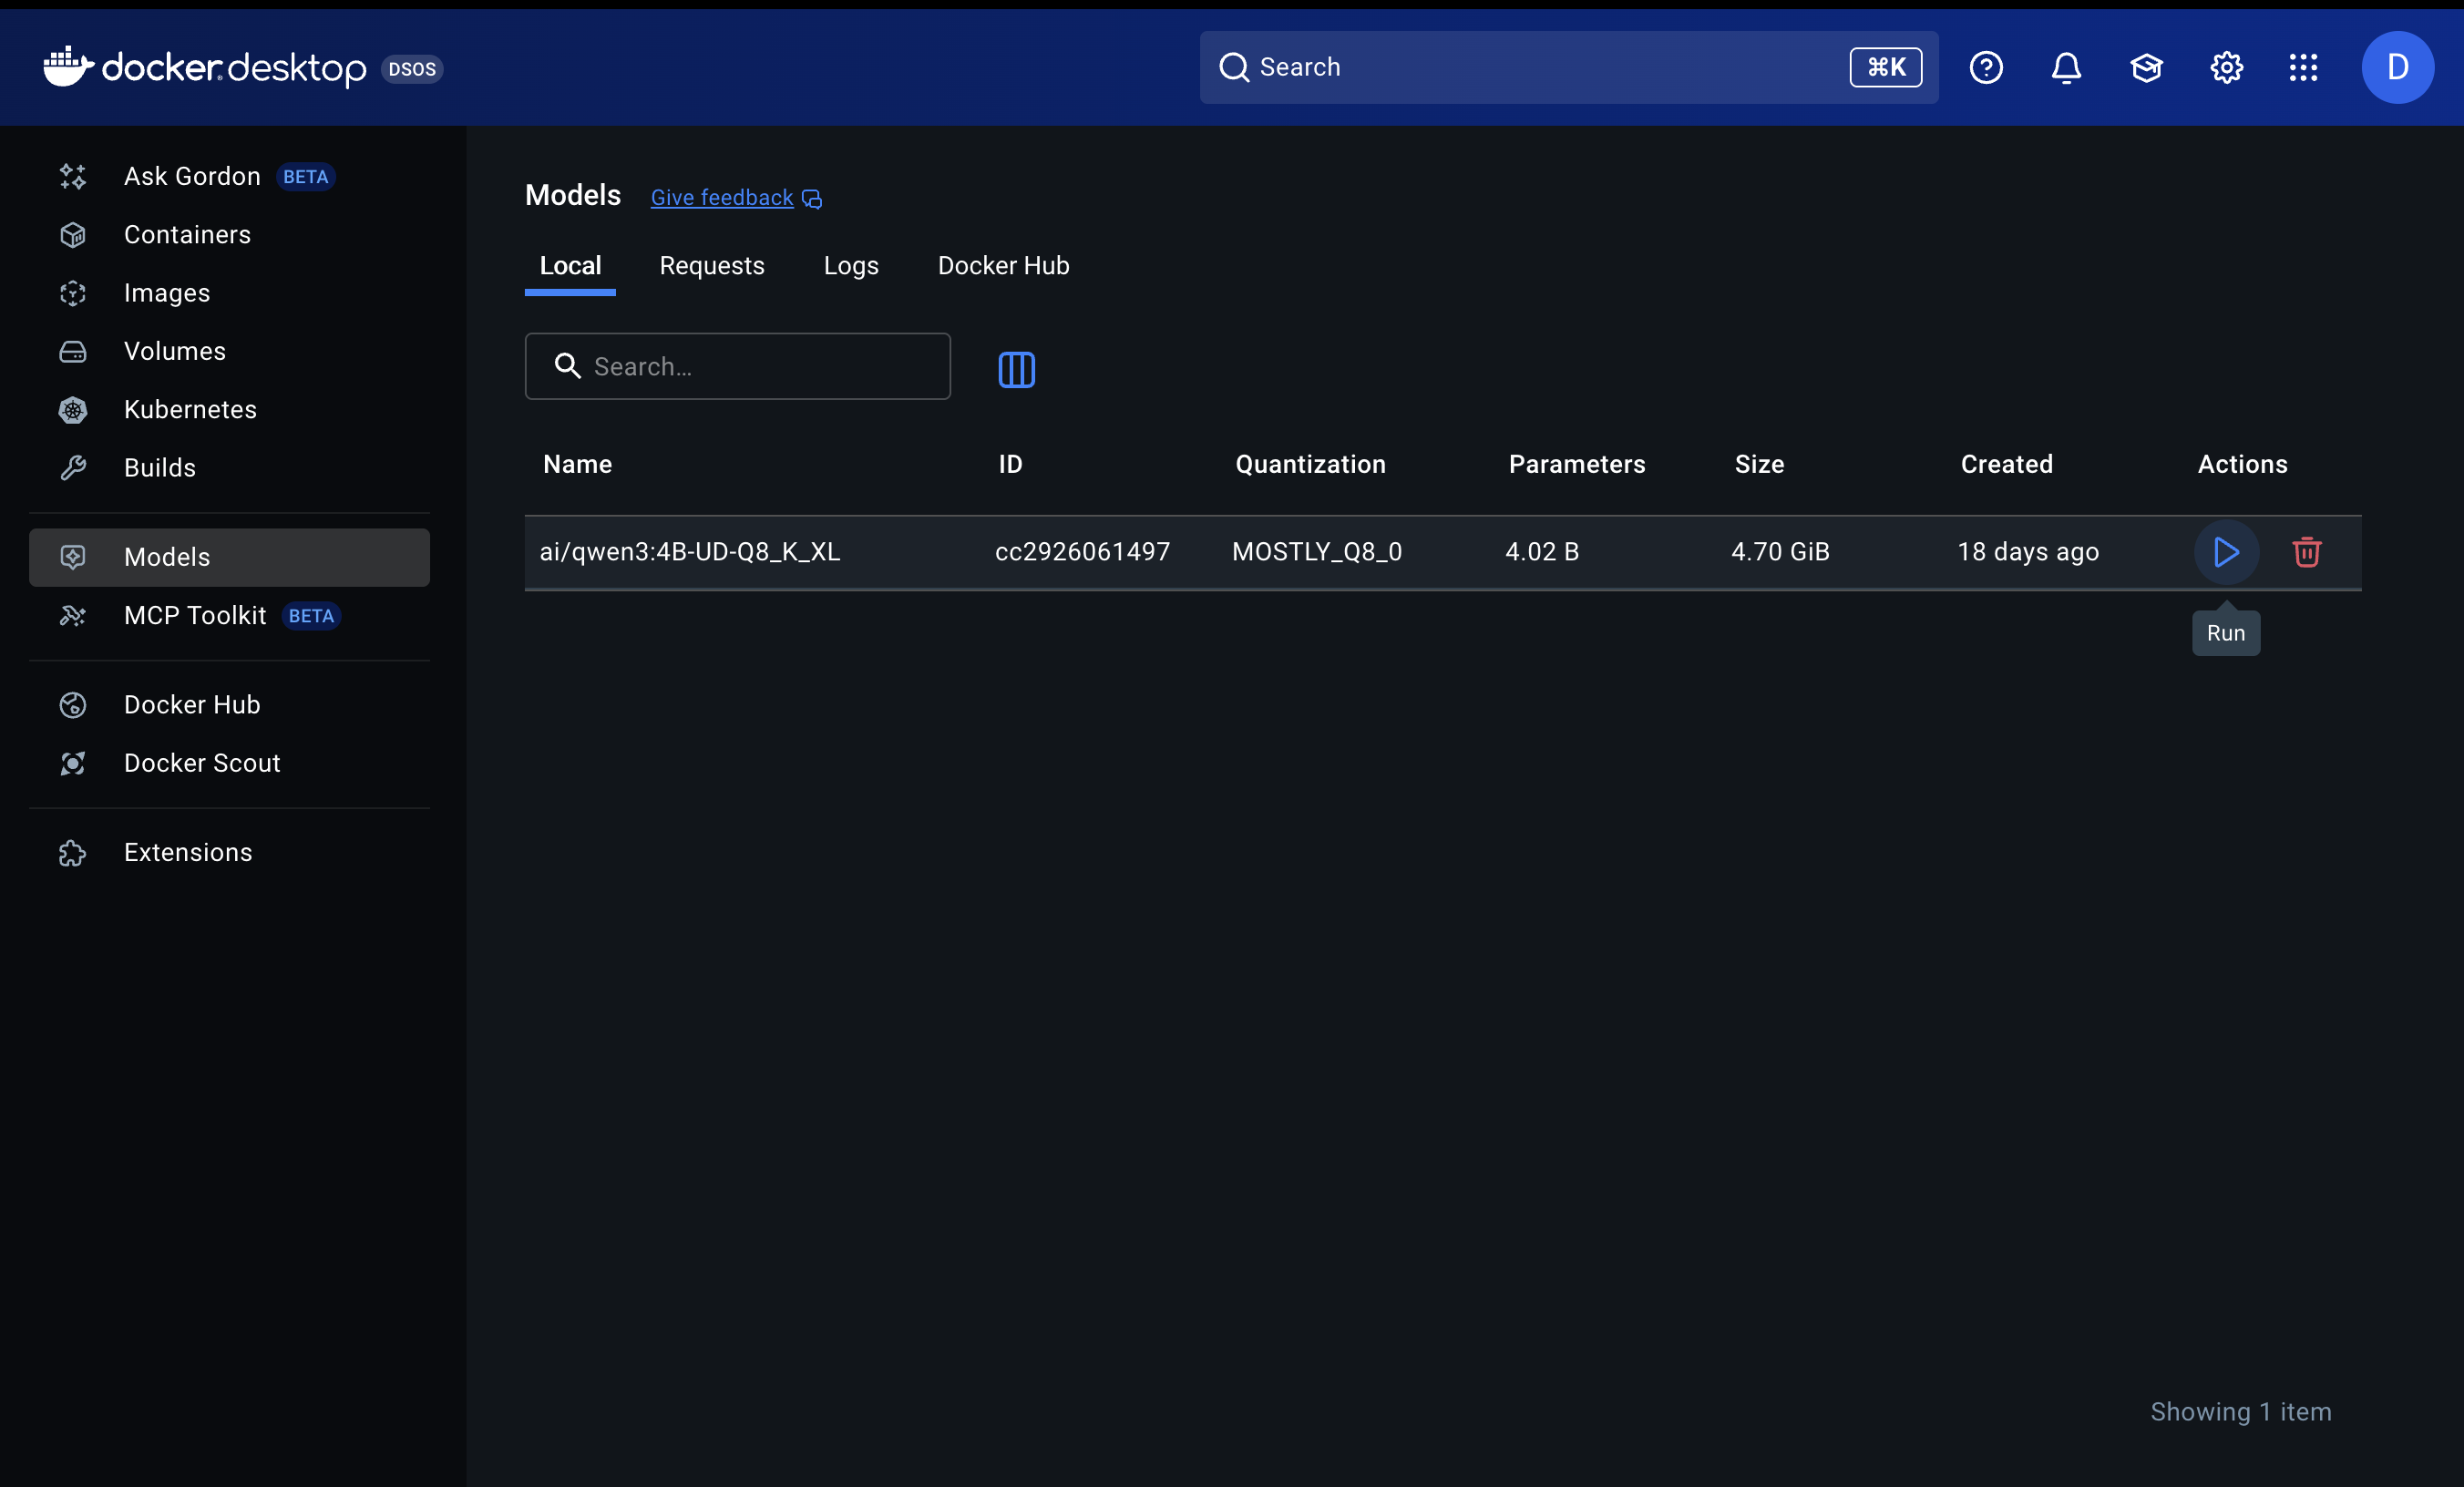
#### モデルを取得する

実行したいモデルをクリックして、利用可能な量子化を確認します。

* 量子化は 1〜16 bit です。30B パラメータ未満のモデルでは、少なくとも 4-bit（`Q4`).
* ハードウェアに合ったサイズを選んでください。理想的には、統合メモリ、RAM、または VRAM の合計がモデルサイズと同じかそれ以上であるべきです。たとえば、11GB のモデルは 12GB の統合メモリで快適に動作します。

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FdQnwVwsMhYtWTzAGFih3%2FScreenshot%202025-11-16%20at%206.47.26%E2%80%AFAM.png?alt=media&amp;token=b1f0e29a-b3de-4d96-b79a-931441744565" alt=""><figcaption><p>#3. 取得したい量子化を選択します。</p></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FFGMZEXgQjBdVqP0vFTX3%2FScreenshot%202025-11-16%20at%206.54.09%E2%80%AFAM.png?alt=media&amp;token=b7f0c0d8-ebef-4e7e-99a9-c44c4c5f0844" alt=""><figcaption><p>#4. モデルのダウンロード完了を待ってから、実行します。</p></figcaption></figure></div>
{% endstep %}

{% step %}

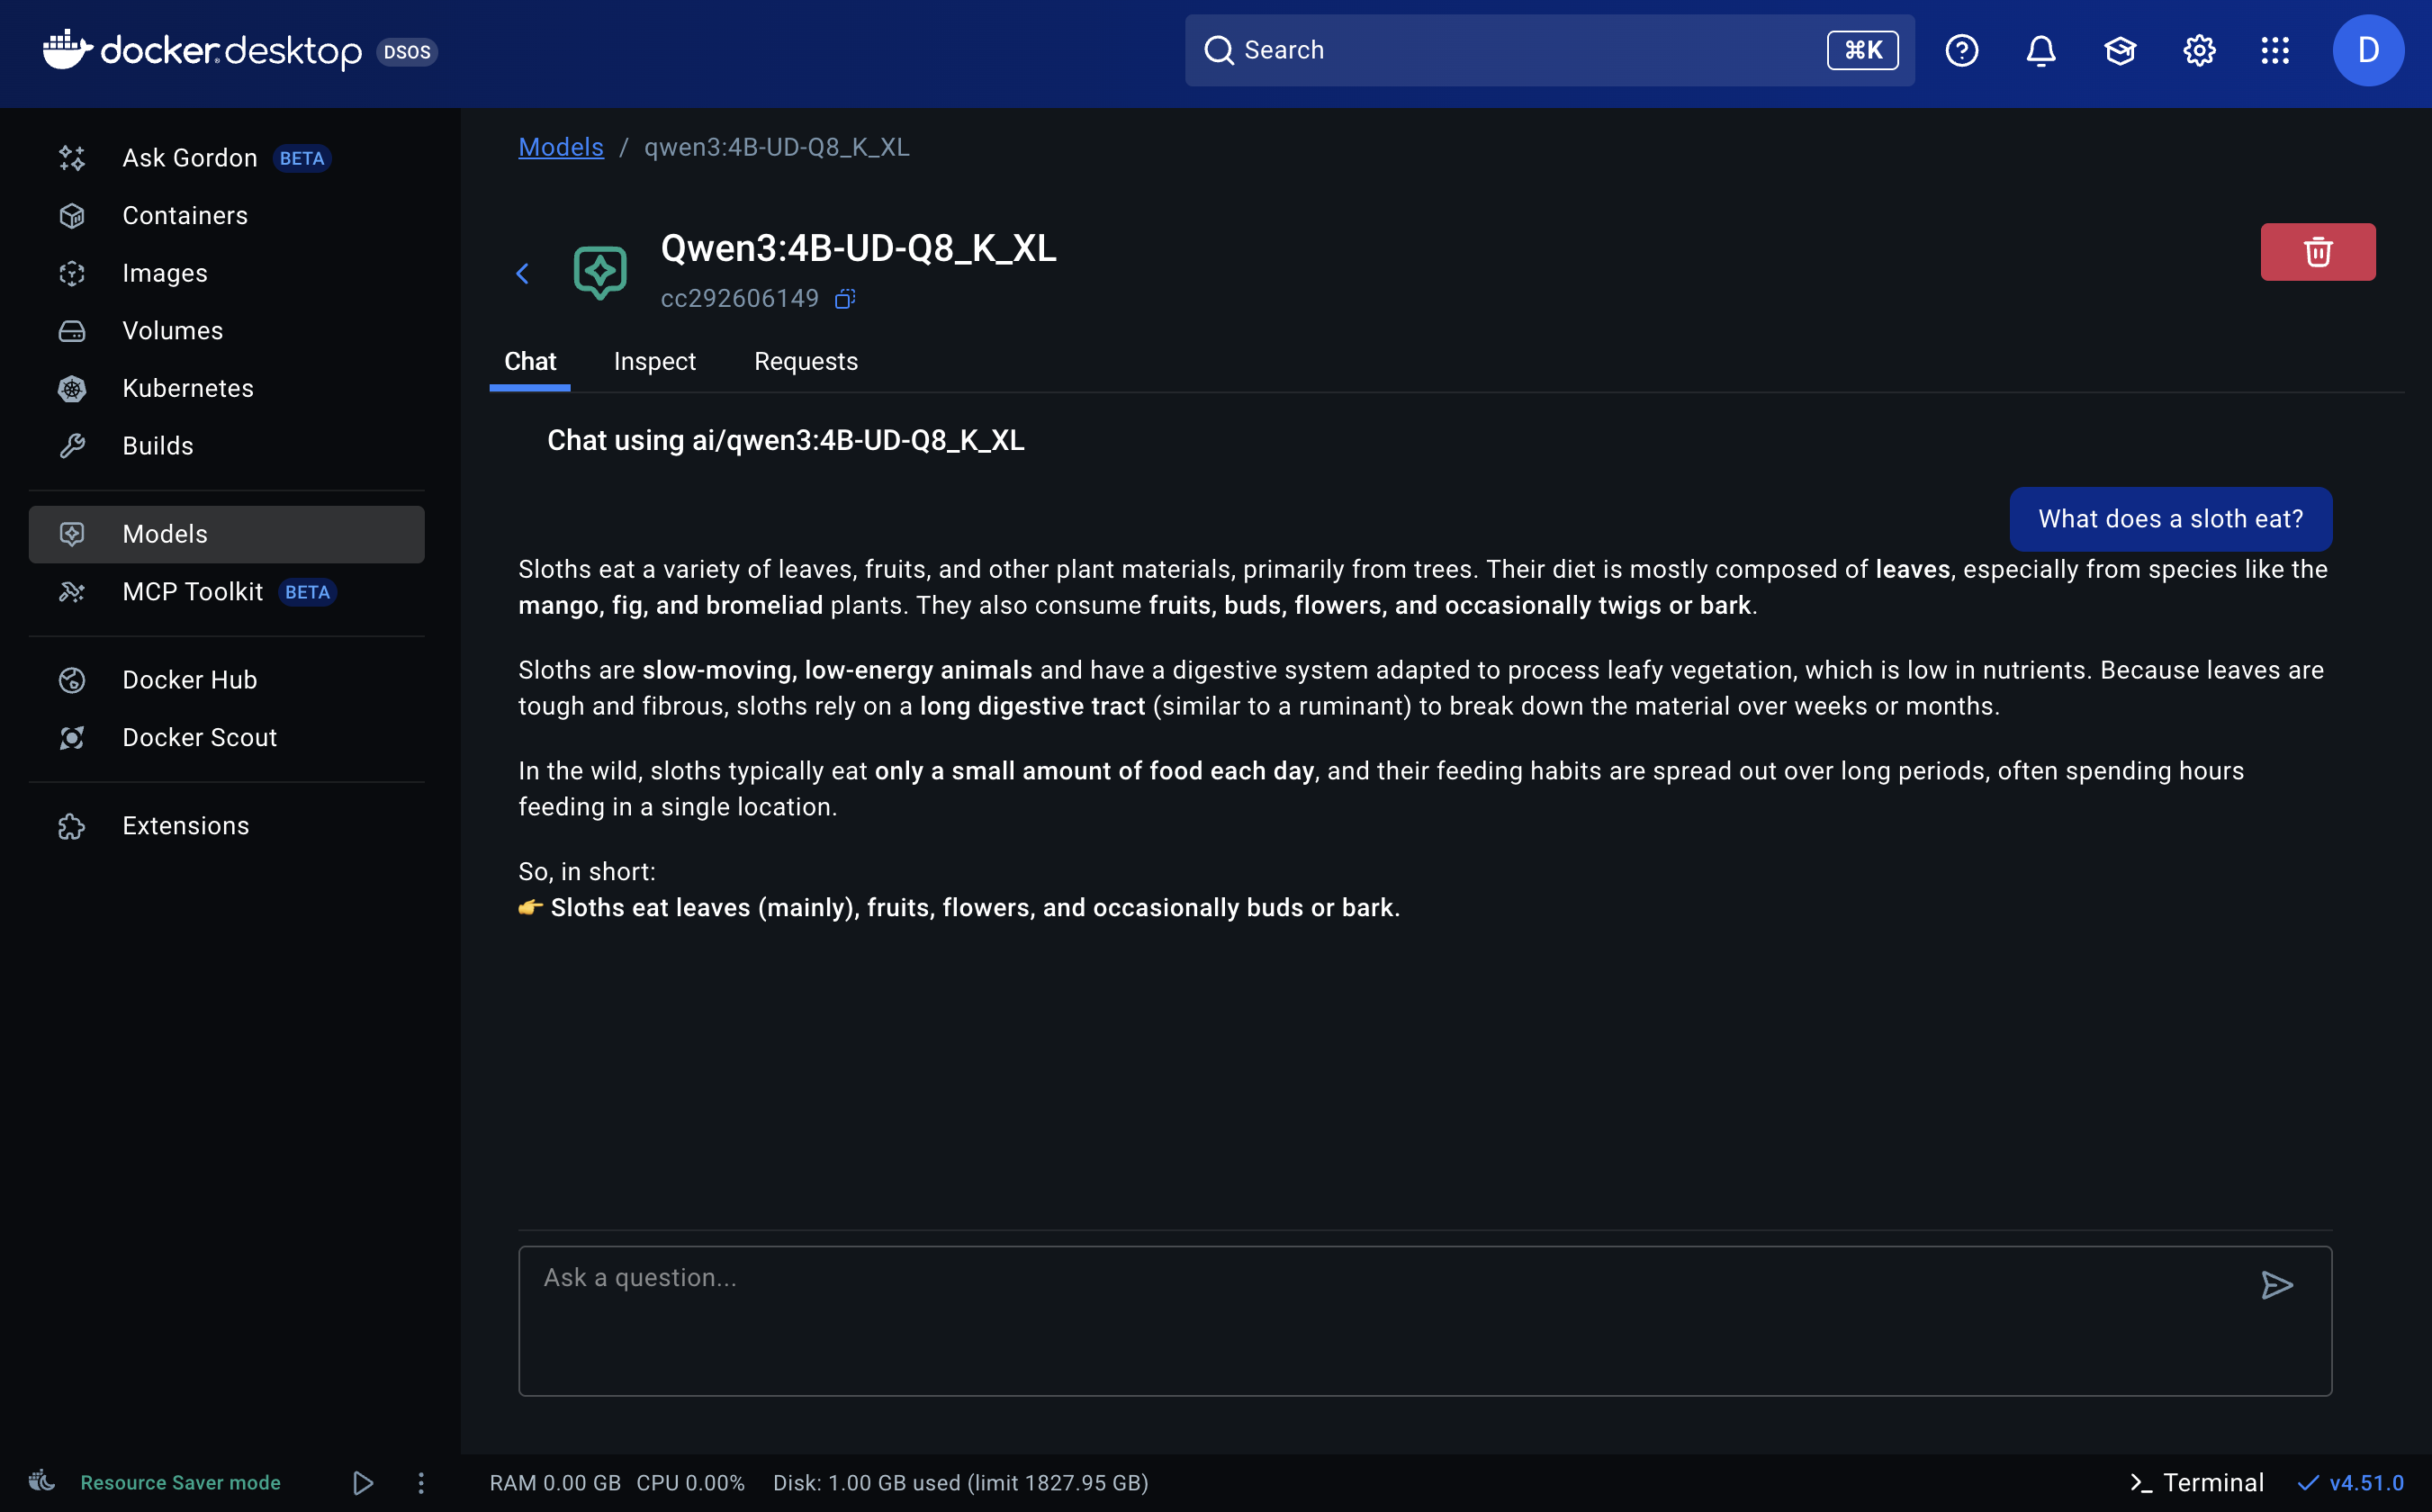
#### モデルを実行する

「Ask a question」ボックスに任意のプロンプトを入力し、ChatGPT を使うように LLM を使ってください。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2F9nVjWcVsYK9CeT8gk3nQ%2FScreenshot%202025-11-16%20at%206.54.50%E2%80%AFAM.png?alt=media&amp;token=d7e5b63d-9c3e-42b0-882c-de046bbcfc9a" alt="" width="563"><figcaption><p>Qwen3-4B を実行する例 <code>UD-Q8_K_XL</code></p></figcaption></figure>
{% endstep %}
{% endstepper %}

#### **最新モデルを実行するには：**

サポートされている限り、Docker で新しいモデルを実行できます： `llama.cpp` または `vllm` さらに Docker Hub で利用可能であること。

### Docker Model Runner とは？

Docker Model Runner（DMR）は、コンテナを実行するのと同じくらい簡単に AI モデルを取得・実行できるオープンソースツールです。GitHub： <https://github.com/docker/model-runner>

Docker がアプリのデプロイを標準化したのと同様に、モデル向けの一貫したランタイムを提供します。内部では、最適化されたバックエンド（ `llama.cpp`など）を使って、マシン上で滑らかかつハードウェア効率の高い推論を実現します。

研究者、開発者、趣味で使う人のいずれであっても、今では次のことができます：

* オープンモデルを数秒でローカル実行。
* 依存関係の地獄を避け、すべてを Docker で処理。
* モデル構成を簡単に共有し、再現できます。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/moderu/tutorials/how-to-run-llms-with-docker.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.