> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/burogu/500k-context-length-fine-tuning.md).
# 50 万コンテキスト長のファインチューニング
Unsloth で 50 万トークン超のコンテキストウィンドウのファインチューニングを有効にする方法を学びます。
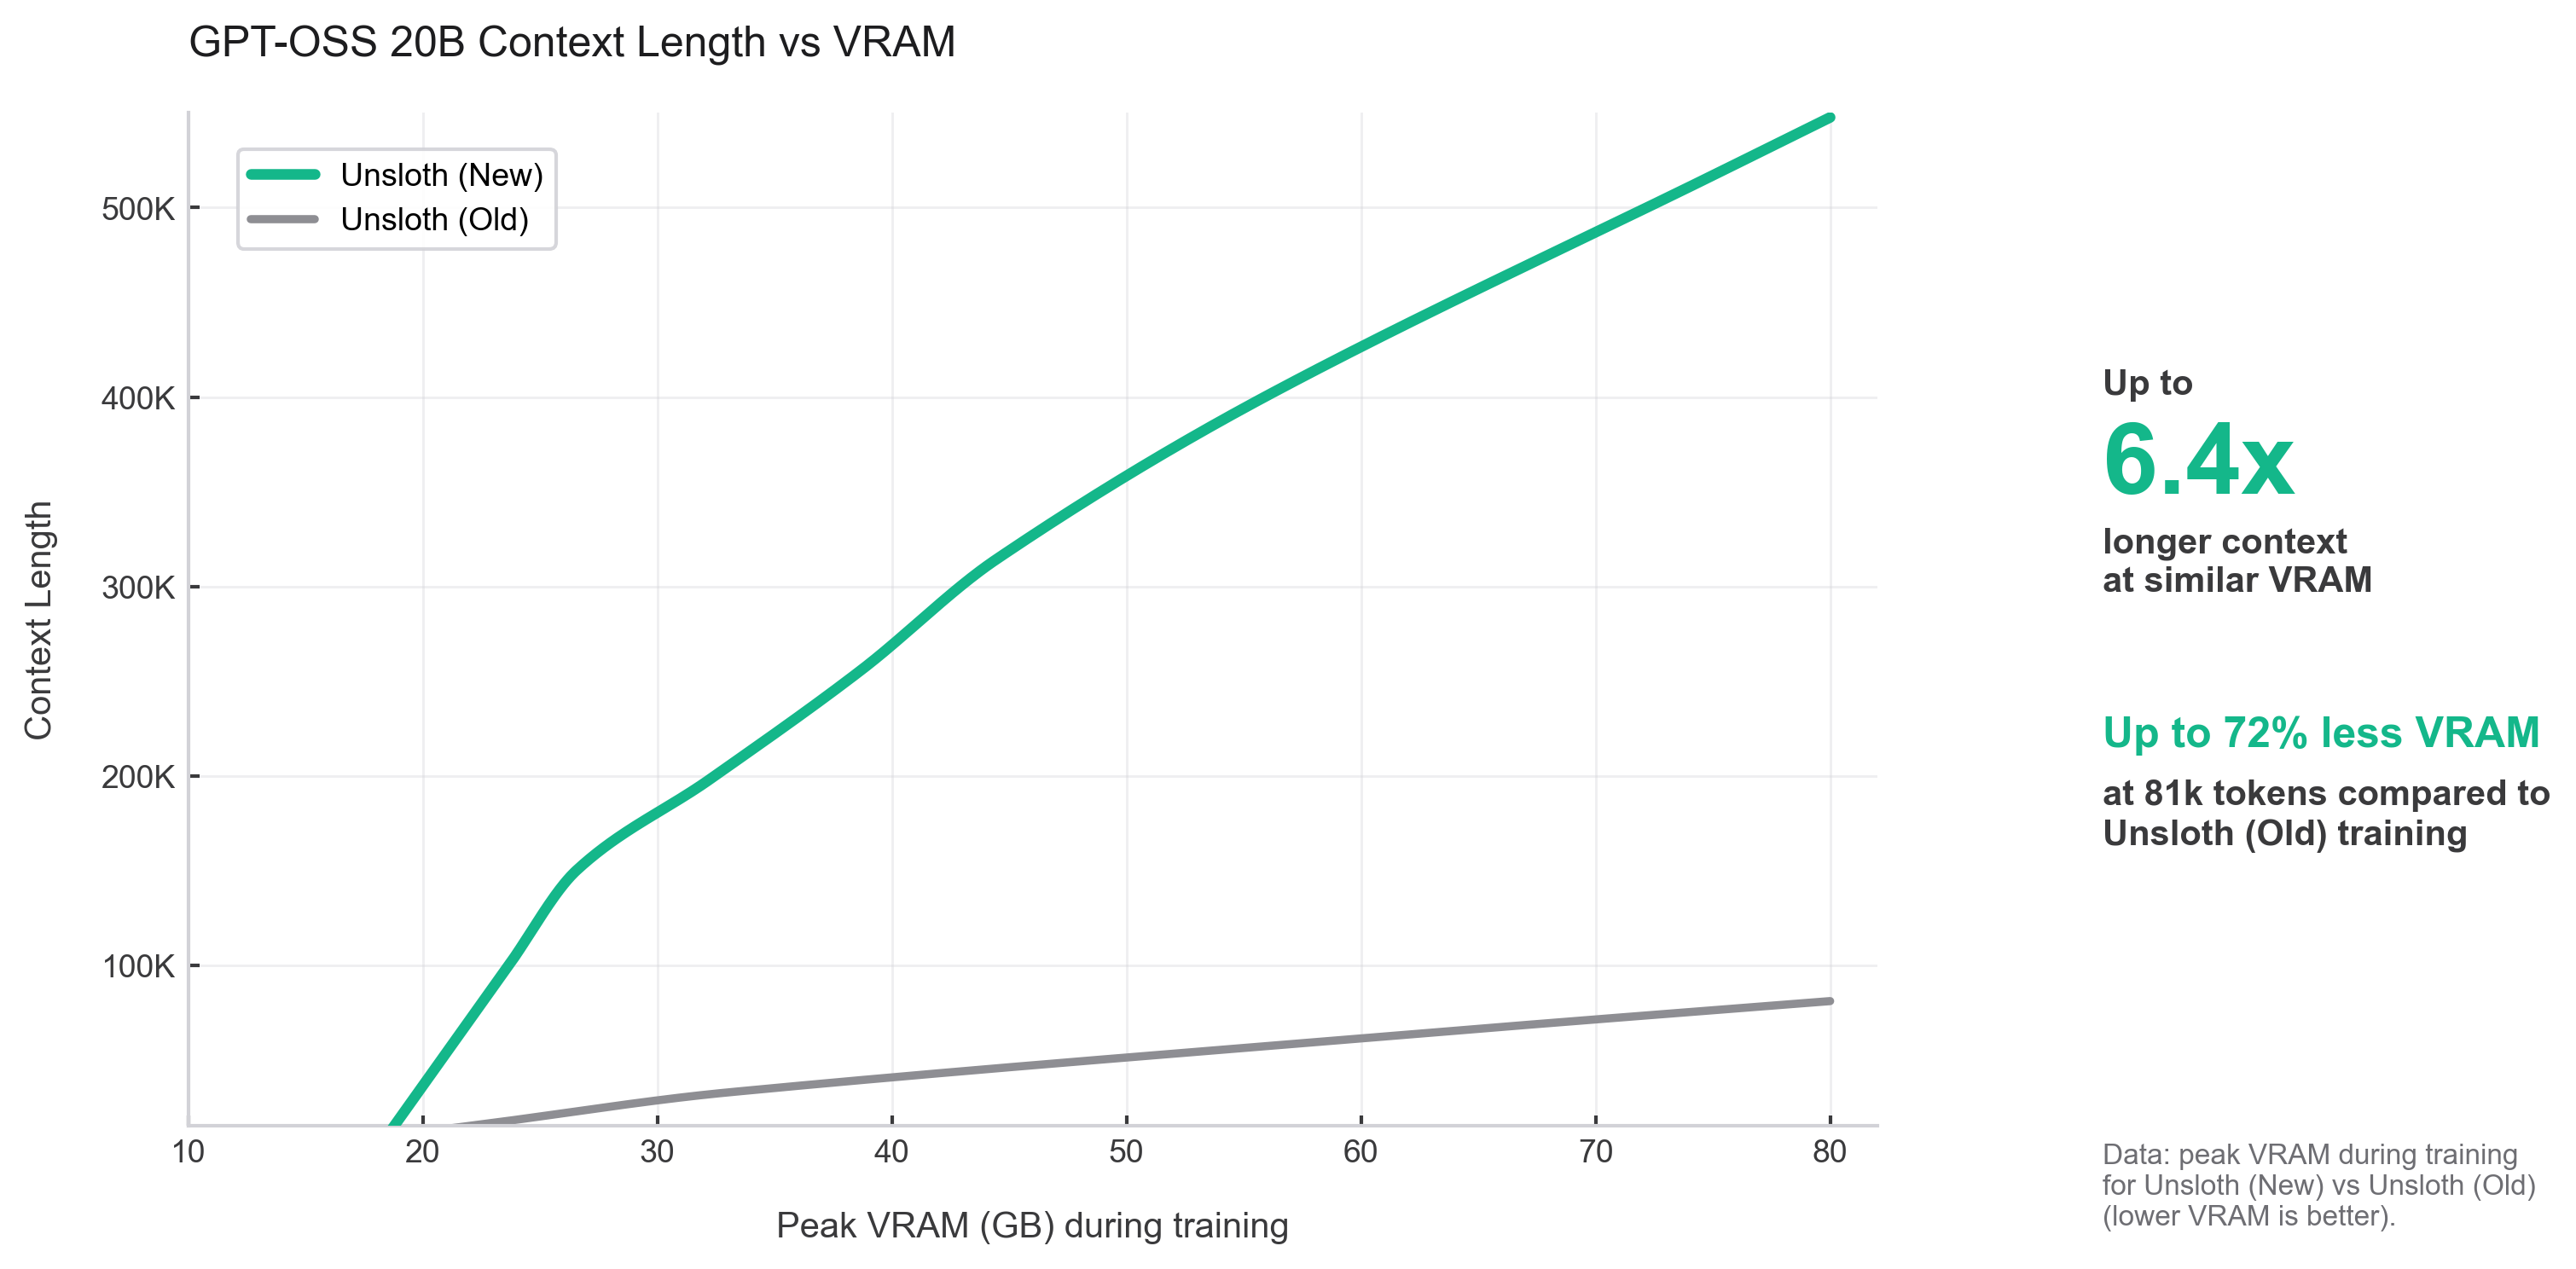
Unsloth では、長文コンテキスト学習の限界を押し広げる新しいアルゴリズムを **あらゆる LLM と VLM に対して**導入しています。gpt-oss-20b のような LLM の学習は、今では **50万超のコンテキスト長** に到達でき、しかも精度劣化なしで、以前の8万から大幅に向上しました。
\>**75万のコンテキストウィンドウ** を B200 192GB GPU 上で実現できます。
> **私たちの** [**80GB A100 Colab ノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
Unsloth がメモリ使用パターン、速度、コンテキスト長を扱う方法を大幅に改善しました:
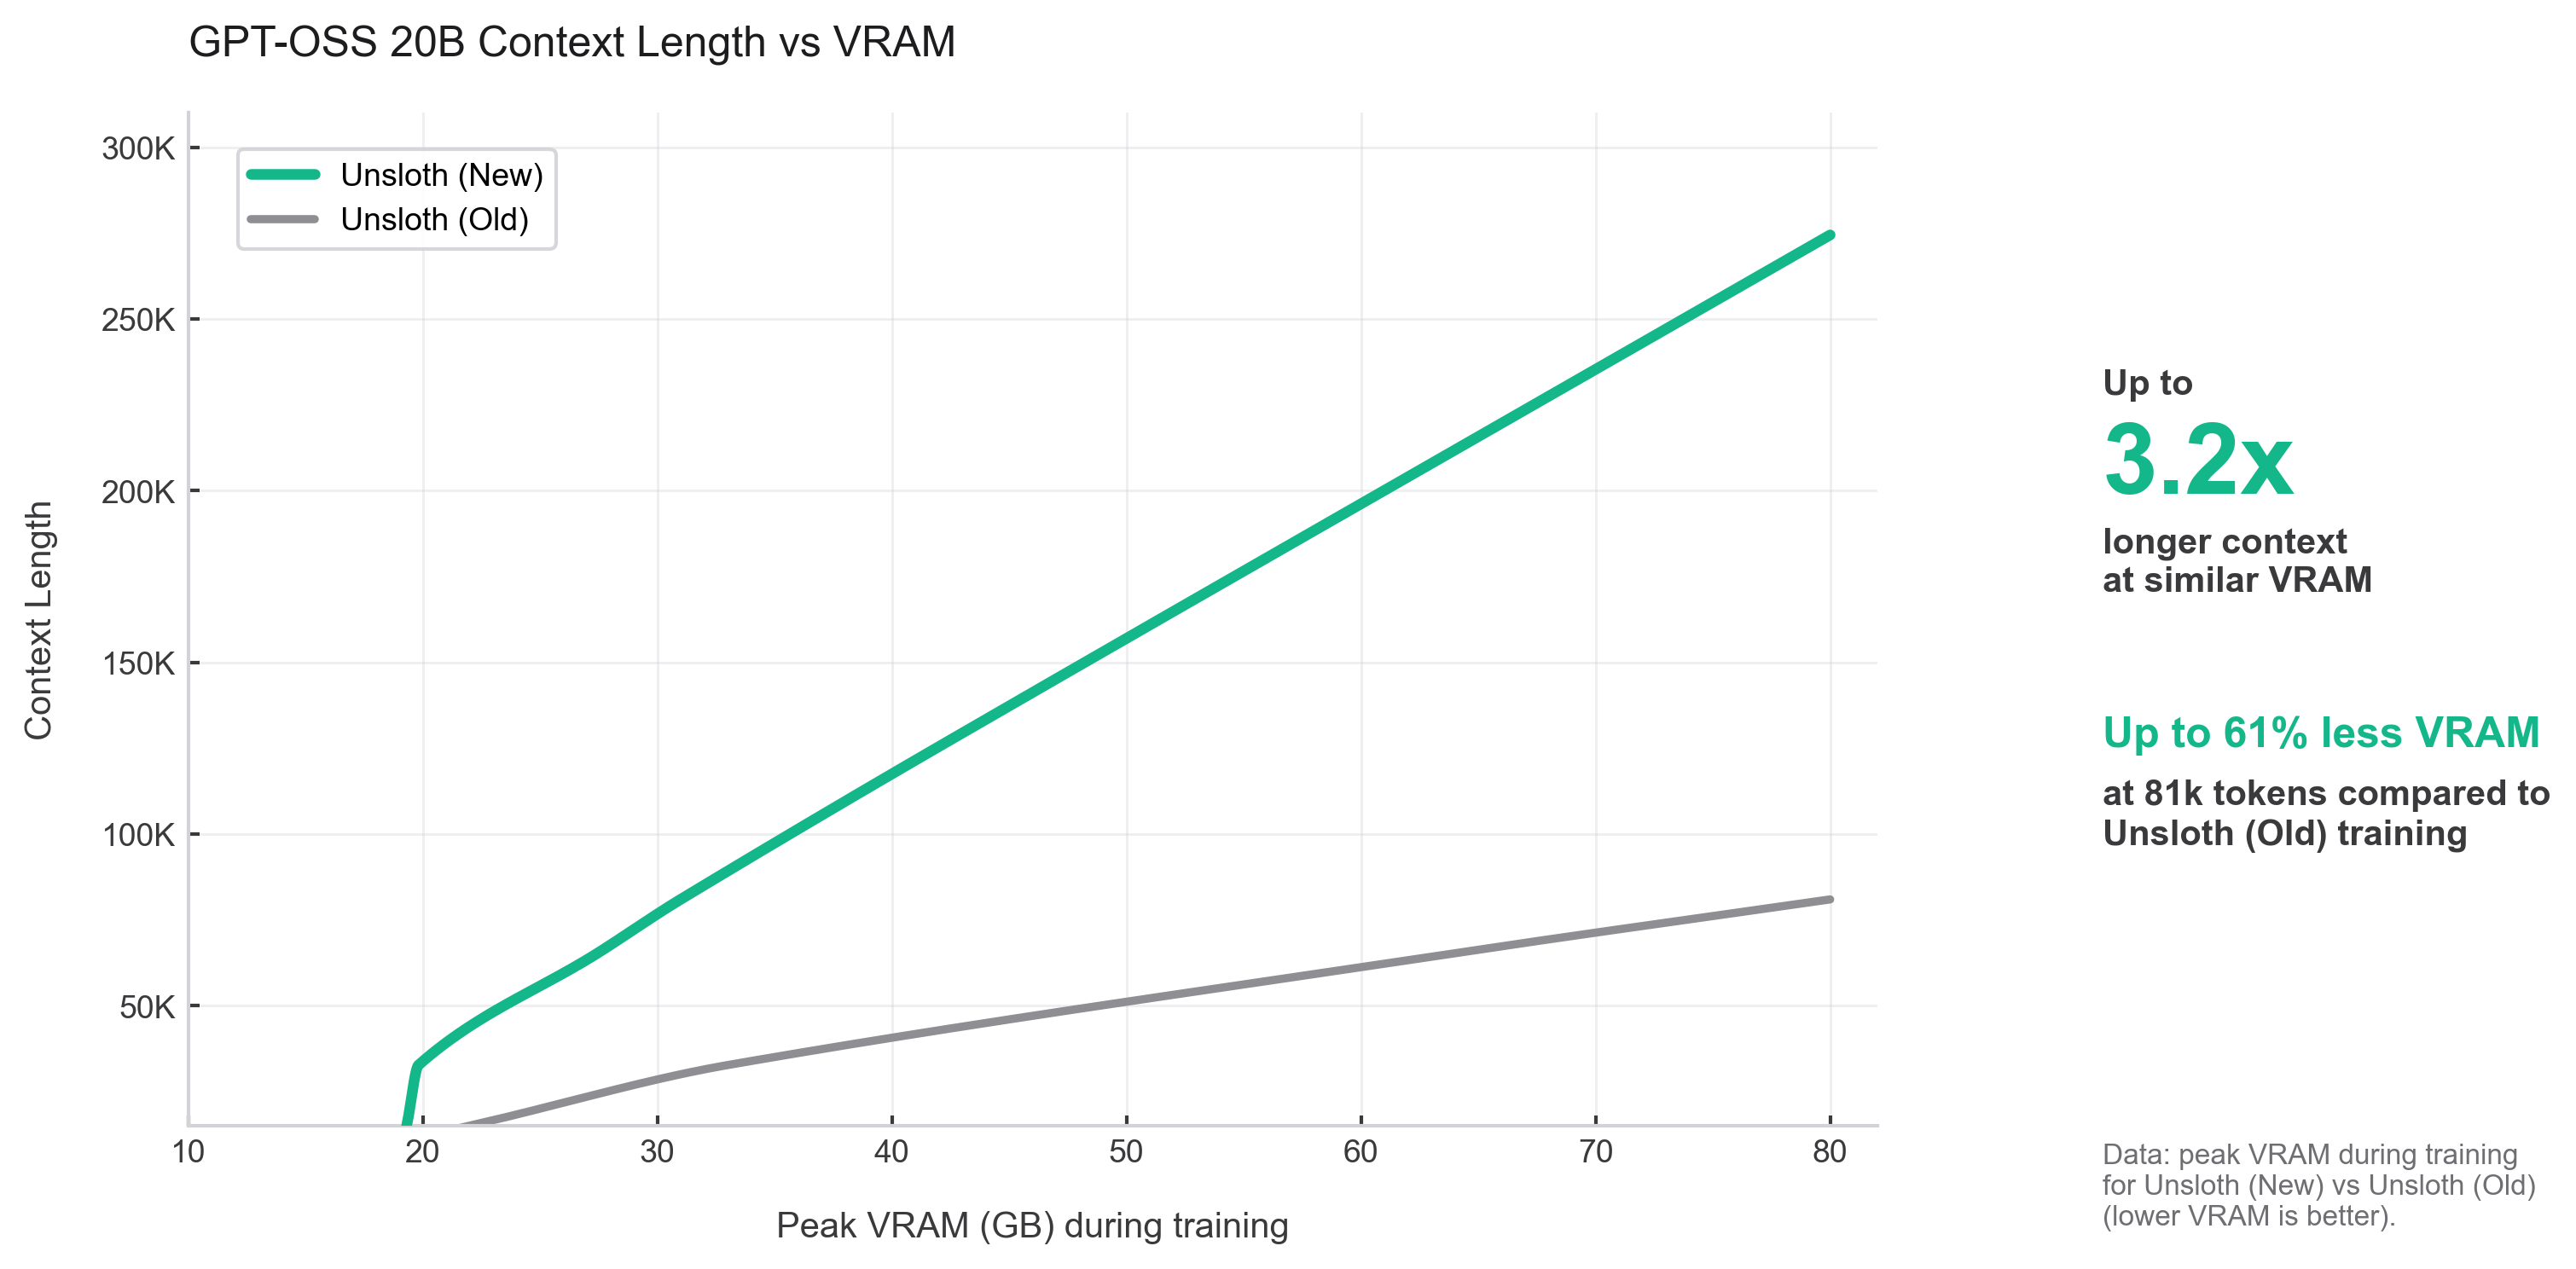
* **VRAM 使用量を60%削減** を **3.2倍長いコンテキスト** Unsloth の新しい [融合・分割済みクロスエントロピー](#unsloth-loss-refactoring-chunk-and-fuse) loss により、速度や精度を落とすことなく実現
* Unsloth の [**Gradient Checkpointing**](#unsloth-gradient-checkpointing-enhanced)
* Snowflake の Stas Bekman と共同で [Tiled MLP](#tiled-mlp-unlocking-500k)に取り組み、2倍多くのコンテキストを可能にしました
Unsloth のアルゴリズムにより、gpt-oss-20b の QLoRA(4bit)は H100 上で 29万コンテキストを精度損失なしで実現でき、Tiled MLP を有効にすると 50万超まで可能です。合わせて >**6.4倍長いコンテキスト長**
### 📐 Unsloth Loss のリファクタリング: チャンク化 & 融合
新しい融合 loss 実装では **動的なシーケンス分割**を追加しました。つまり、言語モデルのヘッドの logits とクロスエントロピーをシーケンス全体に対して一度に計算する代わりに、平坦化されたシーケンス次元に沿って管理しやすいスライスとして処理します。これにより、ピークメモリは GB 単位からより小さなチャンクサイズへと削減されます。各チャンクは依然として、 `torch.func.grad_and_value` を介した完全な融合 forward + backward パスを実行し、必要なら float32 にアップキャストすることで混合精度の精度を維持します。 **これらの変更によって、学習速度や精度が低下することはありません。**
重要な革新点は、 **チャンクサイズが実行時に自動で選択される** ことです。空き VRAM に基づいて決まります。
* 空き VRAM が多い場合は、より大きなチャンクが使われ、より高速に実行されます。
* VRAM が少ない場合は、メモリ不足を避けるためにチャンク数を増やします。
これにより **手動調整が不要になり** 古い GPU と新しい GPU、さまざまなワークロード、異なるシーケンス長に対してもアルゴリズムの堅牢性が保たれます。
{% hint style="success" %}
自動チューニングにより、 **より短いコンテキストではより多くの VRAM を使い** (チャンク数が少なくなり)、 **不要なオーバーヘッドを避けます**。上の図では、現実的な VRAM 段階を反映するように loss チャンク数を調整しています。80GB VRAM では、これにより >3.2倍長いコンテキストが得られます。
{% endhint %}
### 🏁 Unsloth Gradient Checkpointing の強化
私たちの [Unsloth Gradient Checkpointing](https://unsloth.ai/blog/long-context) アルゴリズムは、 **2024年4月に導入され**、すぐに人気を集め、業界標準となり、現在ではほとんどの学習パッケージに統合されています。これは activation を CPU RAM にオフロードし、コンテキスト長を10倍に延ばすことを可能にしました。今回の新しい強化では、CUDA Streams などの工夫により、最大でも **0.1%** 精度に影響を与えることなく学習オーバーヘッドを追加します。以前は1〜3%の学習オーバーヘッドがありました。
{% code expandable="true" %}
```python
# 2024年4月にリリースされた元の Unsloth バージョン - LGPLv3 ライセンス
class Unsloth_Offloaded_Gradient_Checkpointer(torch.autograd.Function):
@staticmethod
@torch_amp_custom_fwd
def forward(ctx, forward_function, hidden_states, *args):
ctx.device = hidden_states.device
saved_hidden_states = hidden_states.to("cpu", non_blocking = True)
with torch.no_grad():
output = forward_function(hidden_states, *args)
ctx.save_for_backward(saved_hidden_states)
ctx.forward_function, ctx.args = forward_function, args
return output
@staticmethod
@torch_amp_custom_bwd
def backward(ctx, dY):
(hidden_states,) = ctx.saved_tensors
hidden_states = hidden_states.to(ctx.device, non_blocking = True).detach()
hidden_states.requires_grad_(True)
with torch.enable_grad():
(output,) = ctx.forward_function(hidden_states, *ctx.args)
torch.autograd.backward(output, dY)
return (None, hidden_states.grad,) + (None,)*len(ctx.args)
```
{% endcode %}
activation が生成され次第すぐにオフロードすることで、ピーク時の activation 使用量を最小化し、必要なタイミングで GPU メモリを正確に解放します。これにより、単一のデコーダ層の activation だけで 2 GB を超えうる長文コンテキストや大規模バッチ学習でのメモリ圧迫を大幅に軽減します。
> **したがって、Unsloth の新しいアルゴリズムと Gradient Checkpointing が改善の大半(3.2倍)をもたらし、単一の H100 で 29万コンテキスト長の QLoRA GPT-OSS ファインチューニングを可能にしています。**
### 🔓 Tiled MLP: 50万超を解放
協力のおかげで [Stas Bekman](https://x.com/StasBekman) (Snowflake)とともに、Snowflake の Arctic Long Sequence Training [論文](https://arxiv.org/abs/2506.13996) およびブログ記事から Tiled MLP を統合しました。TiledMLP は activation メモリを削減し、重い MLP 射影の前に hidden state をシーケンス次元に沿ってタイル化することで、はるかに長いシーケンス長を可能にします。
**さらに、いくつかの使い勝手向上も導入しています:**
タイル化された forward の再計算をまたいで RNG 状態を保持するため、dropout や他の確率的演算が forward と backward の再実行間で一貫します。これにより、ネストされた checkpoint 化された計算が安定し、数値的に同一に保たれます。
{% hint style="success" %}
私たちの実装は、名前または型が `mlp`、そのため **である任意のモジュールに自動でパッチを適用するため、ほぼすべての MLP モジュールを持つモデルが Tiled MLP をそのまま利用できます。**
{% endhint %}
**覚えておくべきトレードオフ**
TiledMLP は追加の forward パスを代償に VRAM を節約します。これは checkpoint 化された transformer ブロックの内部で動作し、自身も checkpoint 形式で書かれているため、実質的にネストされた checkpoint になります。つまり、1つの **MLP は 1 ステップあたり約3回の forward パスと1回の backward パスを実行します**。その代わり、極めて長いシーケンスをサポートしつつ、VRAM からほぼすべての中間 MLP activation を削除できます。
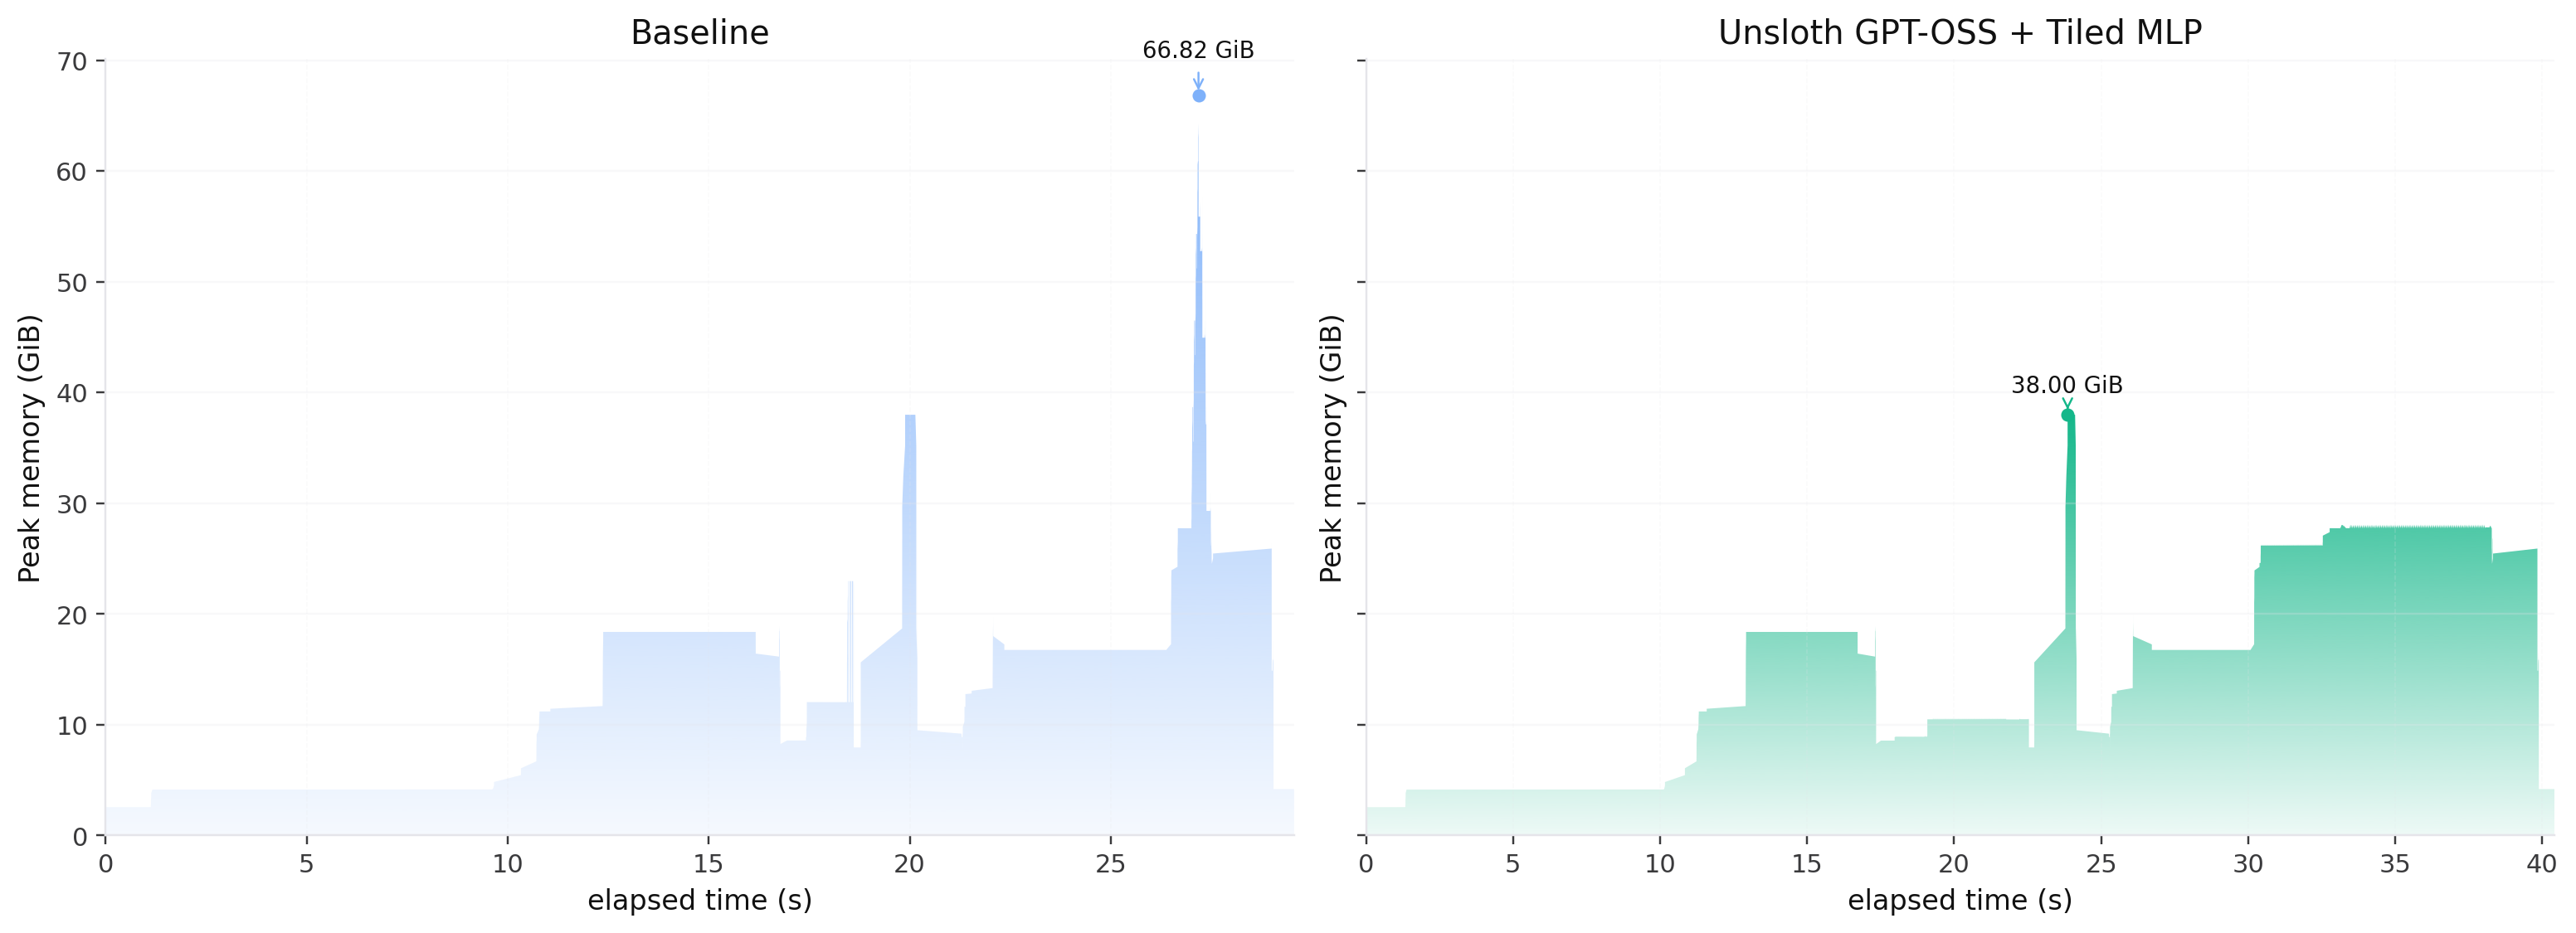
図は、Tiled MLP なし(左)とあり(右)で、長文コンテキスト学習ステップ中の単一デコーダ層の forward と backward におけるアクティブメモリの時間推移を比較しています。Tiled MLP がない場合、ピーク VRAM は MLP の backward 中に発生します。Tiled MLP がある場合は、融合 loss 計算に移ります。約40% の VRAM 使用量削減が見られ、さらに融合 loss は利用可能な VRAM に基づいて動的に自動チャンク化されるため、小さな GPU では Tiled MLP ありのピークはさらに小さくなるはずです。
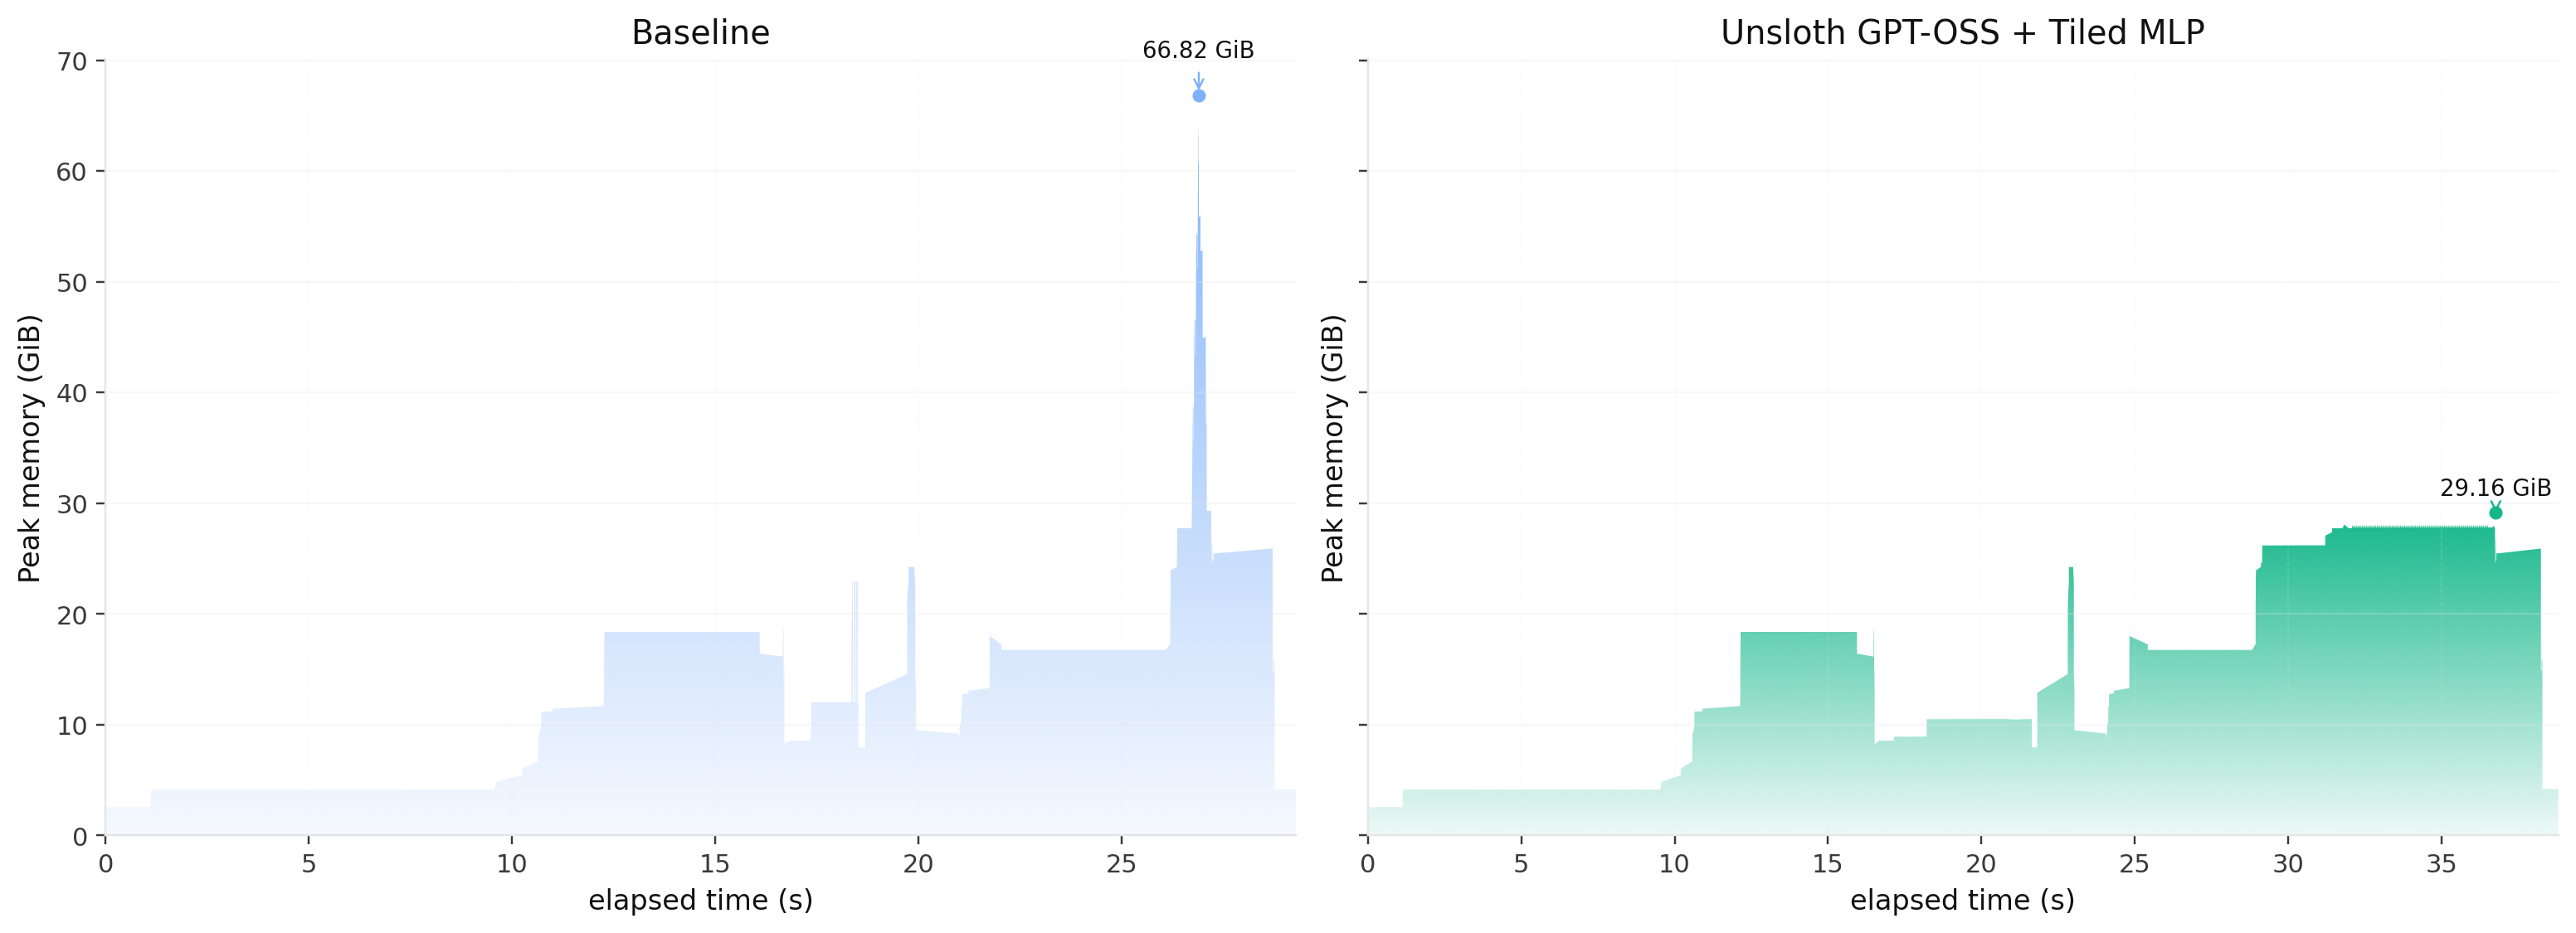
クロスエントロピー loss が新たなボトルネックではないことを示すために、動的に選ぶ代わりにそのチャンクサイズを固定し、そのうえでチャンク数を2倍にしています。これにより、loss に関連するメモリスパイクが大幅に減少します。最大メモリはどちらの場合も backward 中に発生し、全体の時間もほぼ同じですが、Tiled MLP ではわずかなオーバーヘッドが追加されます。1つの大きな GEMM が多数の連続した matmul に置き換わり、さらに上で述べた追加の forward パスもあるためです。
総じて、このトレードオフは価値があります。Tiled MLP がないと、長文コンテキスト学習ではおおよそ2倍のメモリ使用量が必要になる一方で、 **Tiled MLP があれば、単一 GPU では同じコンテキスト長に対してステップ時間は約1.3倍増にとどまります。**
**Unsloth で Tiled MLP を有効にするには:**
```py
model, tokenizer = FastLanguageModel.from_pretrained(
...,
unsloth_tiled_mlp = True,
)
```
次のように設定するだけです `unsloth_tiled_mlp = True` を `from_pretrained` で Tiled MLP が有効になります。Arctic 論文と同じロジックに従い、 `num_shards = ceil(seq_len/hidden_size)`を選びます。各タイルは、スループットとメモリ削減のバランスを取るため、モデルの hidden 次元と同じサイズのシーケンス長で動作します。
また、Tiled MLP が実質的に3回の forward と1回の backward を行う一方、通常の gradient checkpointing は2回の forward と1回の backward で済むことについて、Stas Bekman と [DeepSpeed](https://github.com/deepspeedai/DeepSpeed/pull/7664) とともに DeepSpeed 内の Tiled MLP に関するドキュメント更新も行いました。
{% hint style="success" %}
次にファインチューニングがメモリ不足になったら、 `unsloth_tiled_mlp = True`を有効にしてみてください。コンテキスト長が LLM の hidden 次元より長い限り、VRAM を節約できるはずです。
{% endhint %}
***
**最新のアップデートにより、今では単一 GPU 上で、より小さなモデルでも 100万コンテキスト長に到達できるようになりました!**
**私たちの** [**80GB A100 Colab ノートブック**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt_oss_\(20B\)_500K_Context_Fine_tuning.ipynb)**.**
ここまで読んでくれた方へ。今週、学習速度に関する最新の改善をまとめた新しいブログを公開しますので、ぜひ [Reddit r/unsloth](https://www.reddit.com/r/unsloth/) またはドキュメントをフォローしてください。
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/burogu/500k-context-length-fine-tuning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.