> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
# Tutorial: Trainiere dein eigenes Reasoning-Modell mit GRPO
Einsteigerleitfaden zur Umwandlung eines Modells wie Llama 3.1 (8B) in ein Reasoning-Modell mit Unsloth und GRPO.
DeepSeek entwickelte [GRPO](https://unsloth.ai/blog/grpo) (Group Relative Policy Optimization), um ihre R1-Reasoning-Modelle zu trainieren.
### Schnellstart
Diese Anweisungen gelten für unser vorgefertigtes Google Colab [Notebooks](/docs/de/loslegen/unsloth-notebooks.md). Wenn Sie Unsloth lokal installieren, können Sie unsere Notebooks auch in Ihren bevorzugten Code-Editor kopieren. Wir werden eines dieser Notebooks verwenden:
| [**Qwen3.5 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - neu** | [**gpt-oss-20b**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) **-** GSPO | [Gemma 3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - Vision GSPO |
| ------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------ |
| [**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Erweitert | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - Vision GSPO | [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Erweitert |
{% stepper %}
{% step %}
#### Unsloth installieren
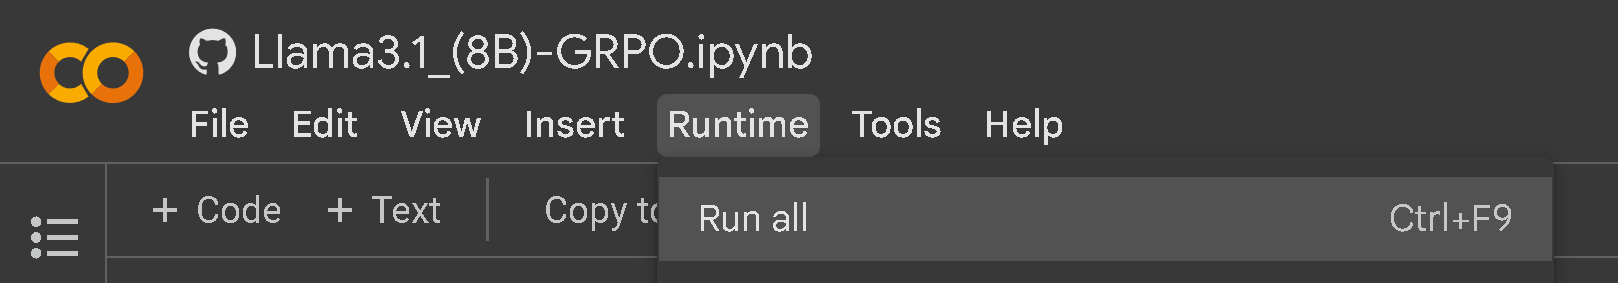
Wenn Sie unser Colab-Notebook verwenden, klicken Sie auf **Runtime > Alle ausführen**. Wir würden Ihnen dringend empfehlen, sich unsere [Anleitung zum Fine-Tuning](/docs/de/loslegen/fine-tuning-llms-guide.md) anzusehen, bevor Sie beginnen.
Wenn Sie lokal installieren, stellen Sie sicher, dass Sie die richtigen [Anforderungen](/docs/de/loslegen/fine-tuning-for-beginners/unsloth-requirements.md) und verwenden Sie `installieren.` unter Linux oder folgen Sie unserer [Windows-Installation ](/docs/de/loslegen/install/windows-installation.md)Anweisungen.
{% endstep %}
{% step %}
#### Erfahren Sie mehr über GRPO & Belohnungsfunktionen
Bevor wir beginnen, empfiehlt es sich, mehr über GRPO, Belohnungsfunktionen und deren Funktionsweise zu erfahren. Lesen Sie mehr darüber, einschließlich [Tipps & Tricks](/docs/de/loslegen/reinforcement-learning-rl-guide.md#basics-tips)[ hier](/docs/de/loslegen/reinforcement-learning-rl-guide.md#basics-tips).
Sie benötigen außerdem genügend VRAM. Im Allgemeinen gilt: Modellparameter = die Menge an VRAM, die Sie benötigen. In Colab verwenden wir die kostenlosen 16-GB-VRAM-GPUs, mit denen sich jedes Modell bis zu 16B Parametern trainieren lässt.
{% endstep %}
{% step %}
#### Gewünschte Einstellungen konfigurieren
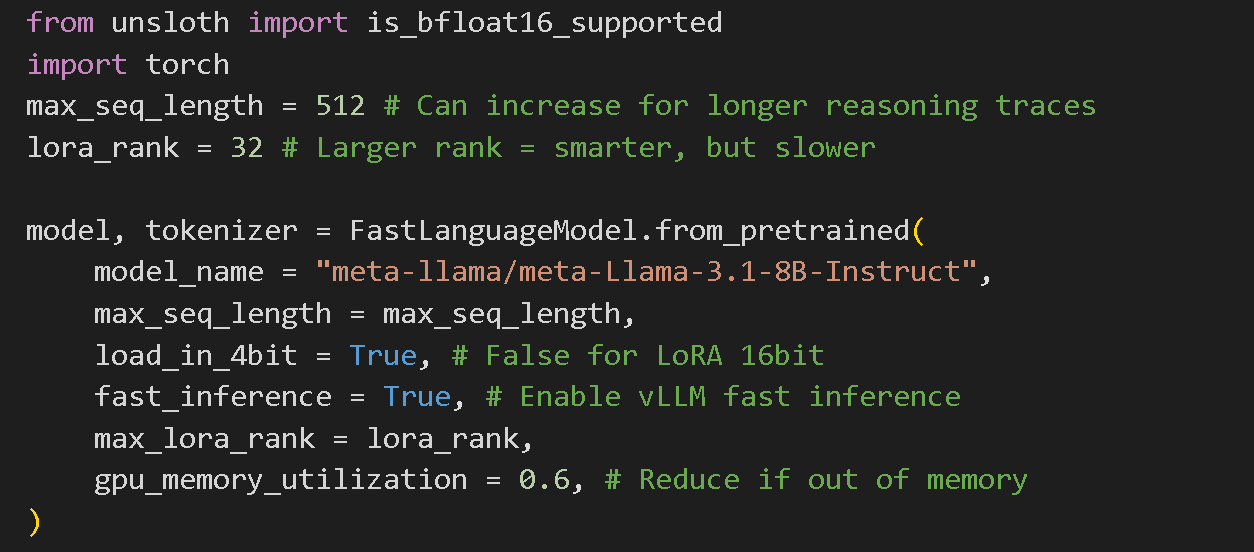
Wir haben bereits optimale Einstellungen für die besten Ergebnisse für Sie vorausgewählt, und Sie können das Modell auf eines der in unserer [unterstützten Modelle](/docs/de/loslegen/unsloth-model-catalog.md). Wir würden nicht empfehlen, andere Einstellungen zu ändern, wenn Sie Anfänger sind.
{% hint style="success" %}
Für **fortgeschrittenes GRPO** Dokumentation zu Batching-, Generierungs- und Trainingsparametern, [lesen Sie unseren Leitfaden!](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
{% endstep %}
{% step %}
#### Datenvorbereitung
Wir haben OpenAIs [GSM8K](https://huggingface.co/datasets/openai/gsm8k) Datensatz vorausgewählt, der Mathematikaufgaben für die Grundschule enthält, aber Sie könnten ihn durch Ihren eigenen oder einen beliebigen öffentlichen Datensatz auf Hugging Face ersetzen. Mehr dazu können Sie hier lesen: [Datensätze hier](/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md).
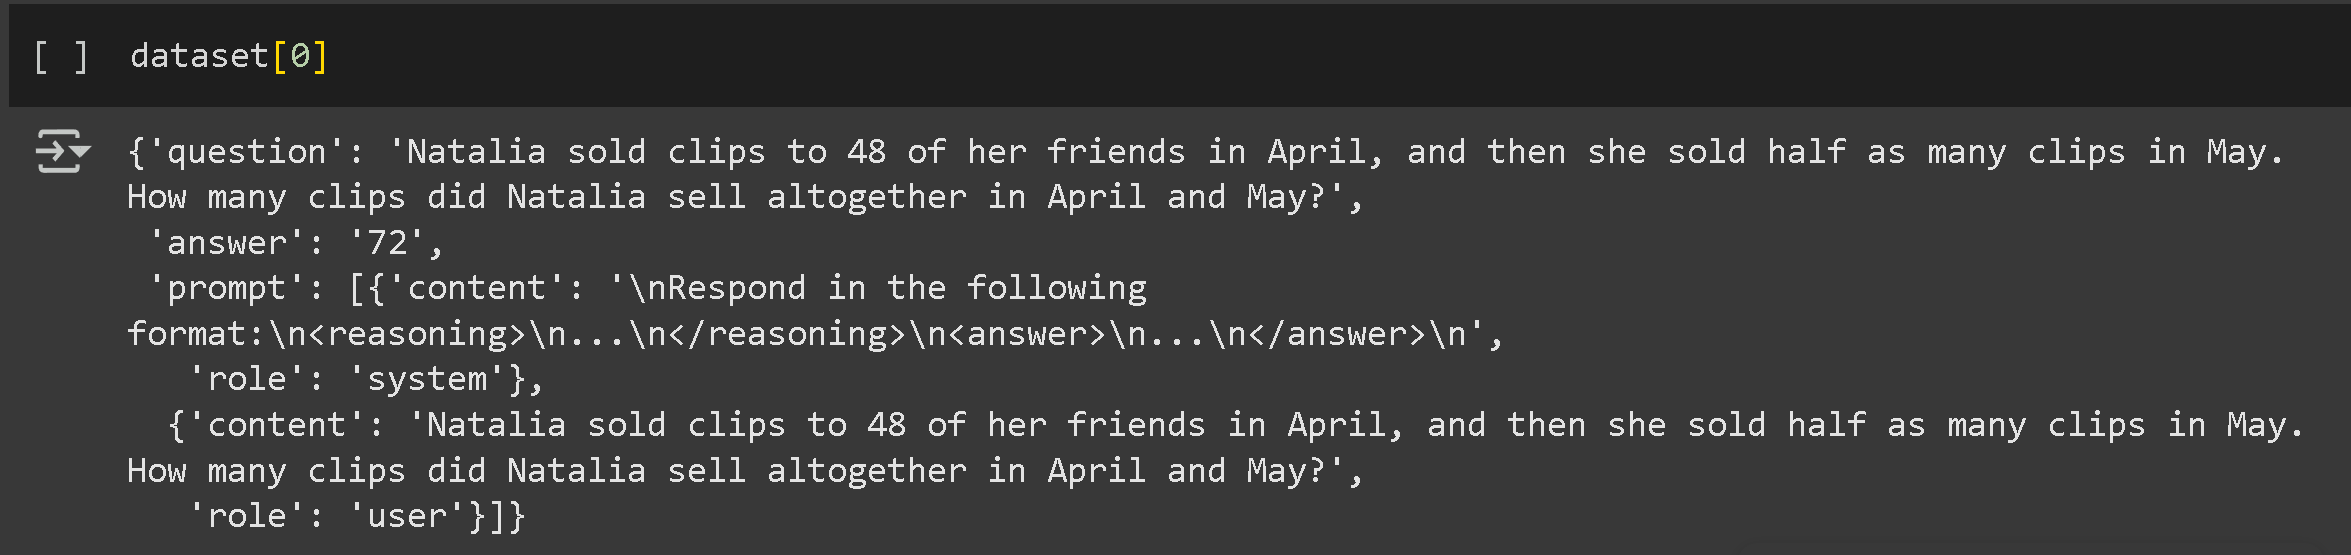
Ihr Datensatz sollte dennoch mindestens 2 Spalten für Frage-und-Antwort-Paare haben. Die Antwort darf jedoch nicht offenlegen, wie sie die Antwort aus der Frage hergeleitet hat. Ein Beispiel finden Sie unten:
Wir strukturieren die Daten so, dass das Modell dazu angeregt wird, seine Überlegungen vor der Antwort darzulegen. Zunächst legen wir ein klares Format für Prompts und Antworten fest.
```
# Definieren Sie den System-Prompt, der das Modell anweist, ein bestimmtes Format zu verwenden
SYSTEM_PROMPT = """
Antworten Sie im folgenden Format:
...
...
"""
XML_COT_FORMAT = """\
{reasoning}
{answer}
"""
```
Nun, um den Datensatz vorzubereiten:
```
import re
from datasets import load_dataset, Dataset
# Hilfsfunktionen zum Extrahieren von Antworten aus verschiedenen Formaten
def extract_xml_answer(text: str) -> str:
answer = text.split("")[-1]
answer = answer.split("")[0]
return answer.strip()
def extract_hash_answer(text: str) -> str | None:
if "####" not in text:
return None
return text.split("####")[1].strip()
# Funktion zum Vorbereiten des GSM8K-Datensatzes
def get_gsm8k_questions(split="train") -> Dataset:
data = load_dataset("openai/gsm8k", "main")[split]
data = data.map(
lambda x: {
"prompt": [
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": x["question"]},
],
"answer": extract_hash_answer(x["answer"]),
}
)
return data
dataset = get_gsm8k_questions()
```
Der Datensatz wird vorbereitet, indem die Antworten extrahiert und als strukturierte Zeichenfolgen formatiert werden.
{% endstep %}
{% step %}
#### Belohnungsfunktionen/Verifizierer
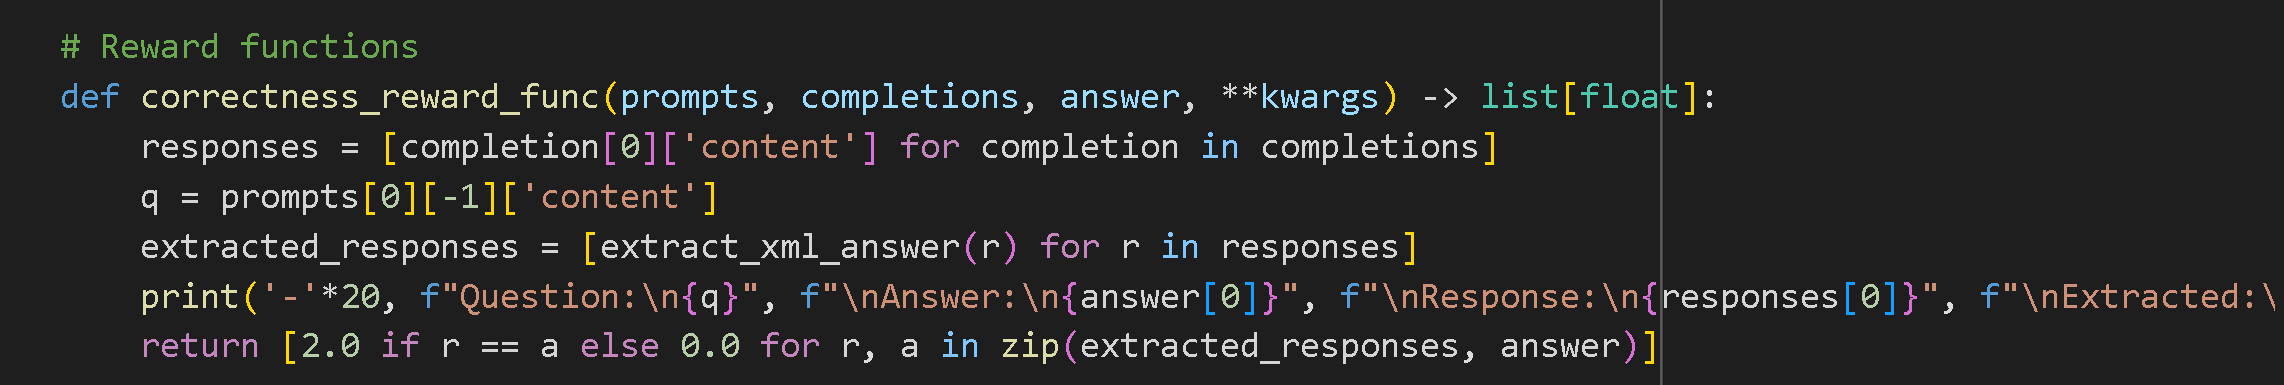
[Belohnungsfunktionen/Verifizierer](/docs/de/loslegen/reinforcement-learning-rl-guide.md#reward-functions-verifier) lässt uns wissen, ob das Modell anhand des von Ihnen bereitgestellten Datensatzes gut abschneidet oder nicht. Jeder Generierungsdurchlauf wird danach bewertet, wie er im Vergleich zum Durchschnitt der übrigen Generierungen abschneidet. Sie können Ihre eigenen Belohnungsfunktionen erstellen, jedoch haben wir sie bereits für Sie vorausgewählt mit [Wills GSM8K](/docs/de/loslegen/reinforcement-learning-rl-guide.md#gsm8k-reward-functions) Belohnungsfunktionen. Damit haben wir 5 verschiedene Möglichkeiten, jede Generierung zu belohnen.
Sie können Ihre Generierungen in ein LLM wie ChatGPT 4o oder Llama 3.1 (8B) eingeben und eine Belohnungsfunktion sowie einen Verifizierer entwerfen, um sie zu bewerten. Geben Sie zum Beispiel Ihre Generierungen in ein LLM Ihrer Wahl ein und legen Sie eine Regel fest: „Wenn die Antwort zu roboterhaft klingt, ziehe 3 Punkte ab.“ Das hilft, Ausgaben anhand von Qualitätskriterien zu verfeinern. **Beispiele ansehen** wie sie aussehen können [hier](/docs/de/loslegen/reinforcement-learning-rl-guide.md#reward-function-examples).
**Beispiel für eine Belohnungsfunktion für eine E-Mail-Automatisierungsaufgabe:**
* **Frage:** Eingehende E-Mail
* **Antwort:** Ausgehende E-Mail
* **Belohnungsfunktionen:**
* Wenn die Antwort ein erforderliches Schlüsselwort enthält → **+1**
* Wenn die Antwort genau mit der idealen Antwort übereinstimmt → **+1**
* Wenn die Antwort zu lang ist → **-1**
* Wenn der Name des Empfängers enthalten ist → **+1**
* Wenn ein Signaturblock (Telefon, E-Mail, Adresse) vorhanden ist → **+1**
{% endstep %}
{% step %}
#### Trainiere dein Modell
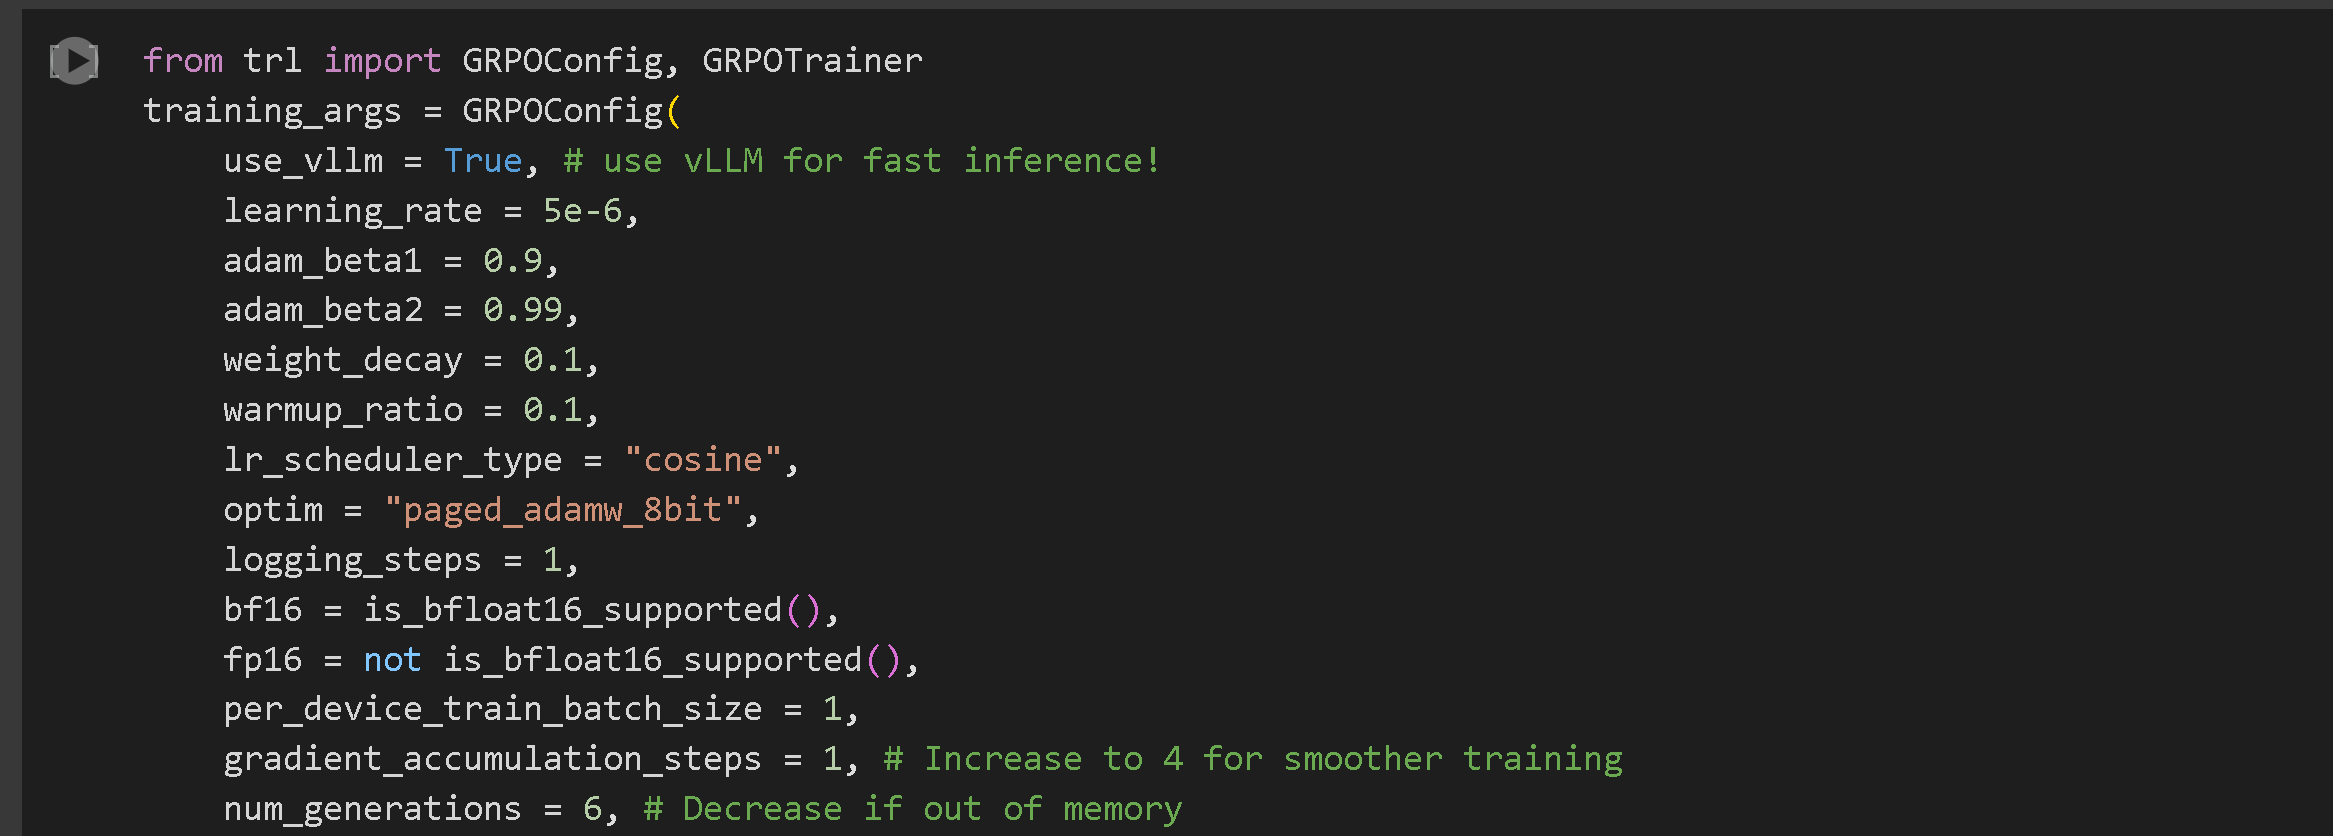
Wir haben die Hyperparameter für die optimalsten Ergebnisse bereits vorausgewählt, Sie können sie jedoch ändern. Lesen Sie alles über [Parameter hier](/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md). Für **fortgeschrittenes GRPO** Dokumentation zu Batching-, Generierungs- und Trainingsparametern, [lesen Sie unseren Leitfaden!](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
Der **GRPOConfig** definiert wichtige Hyperparameter für das Training:
* `use_vllm`: Aktiviert schnelle Inferenz mit vLLM.
* `learning_rate`: Bestimmt die Lernrate des Modells.
* `num_generations`: Legt die Anzahl der pro Prompt erzeugten Vervollständigungen fest.
* `max_steps`: Legt die Gesamtzahl der Trainingsschritte fest.
{% hint style="success" %}
**NEU!** Wir unterstützen jetzt DAPO, Dr. GRPO und die meisten anderen neuen GRPO-Techniken. Sie können mit den folgenden Argumenten in GRPOConfig experimentieren, um Folgendes zu aktivieren:
```python
epsilon=0.2,
epsilon_high=0.28, # einseitig
delta=1.5 # zweiseitig
loss_type='bnpo',
# oder:
loss_type='grpo',
# oder:
loss_type='dr_grpo',
# oder:
loss_type='dapo',
mask_truncated_completions=True,
```
{% endhint %}
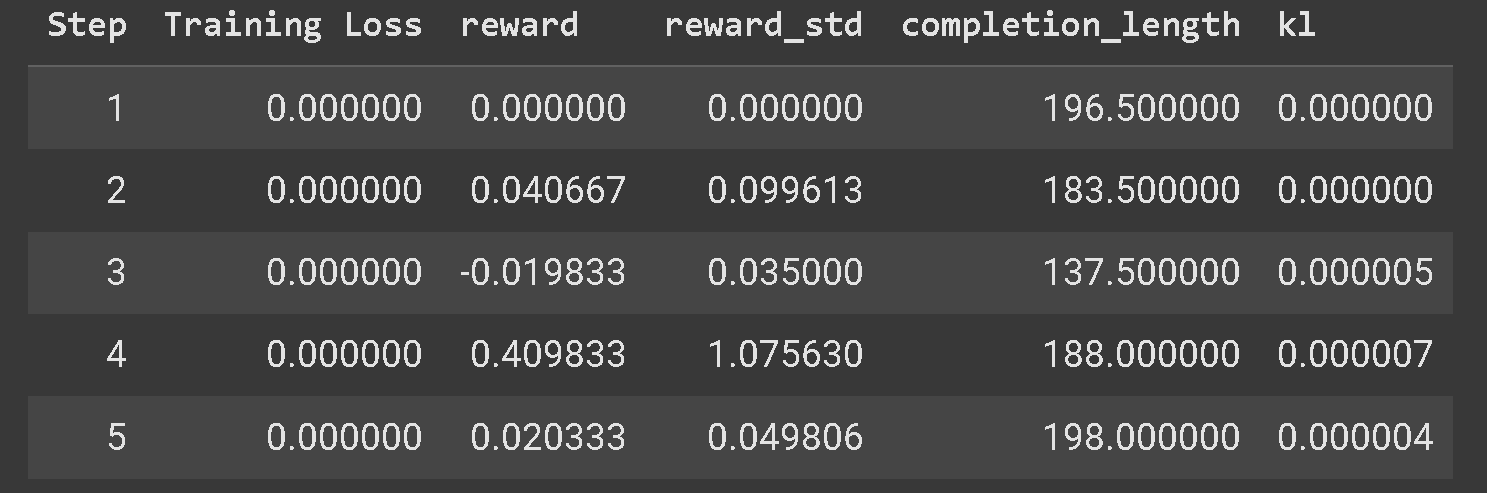
Sie sollten sehen, dass die Belohnung im Laufe der Zeit steigt. Wir würden empfehlen, mindestens 300 Schritte zu trainieren, was jedoch 30 Minuten dauern kann; für optimale Ergebnisse sollten Sie länger trainieren.
{% hint style="warning" %}
Wenn Sie Probleme damit haben, dass Ihr GRPO-Modell nicht lernt, empfehlen wir Ihnen dringend, unsere [Fortgeschrittenen GRPO-Notebooks](/docs/de/loslegen/unsloth-notebooks.md#grpo-reasoning-notebooks) zu verwenden, da es eine deutlich bessere Belohnungsfunktion hat und Sie schneller und häufiger Ergebnisse sehen sollten.
{% endhint %}
Außerdem sehen Sie Beispielantworten, die Ihnen zeigen, wie das Modell lernt. Manche haben Schritte, XML-Tags, Versuche usw., und die Idee ist, dass es beim Trainieren immer besser wird, weil es immer höher bewertet wird, bis wir die gewünschten Ausgaben mit langen Denkketten von Antworten erhalten.
{% endstep %}
{% step %}
#### Führen Sie Ihr Modell aus und bewerten Sie es
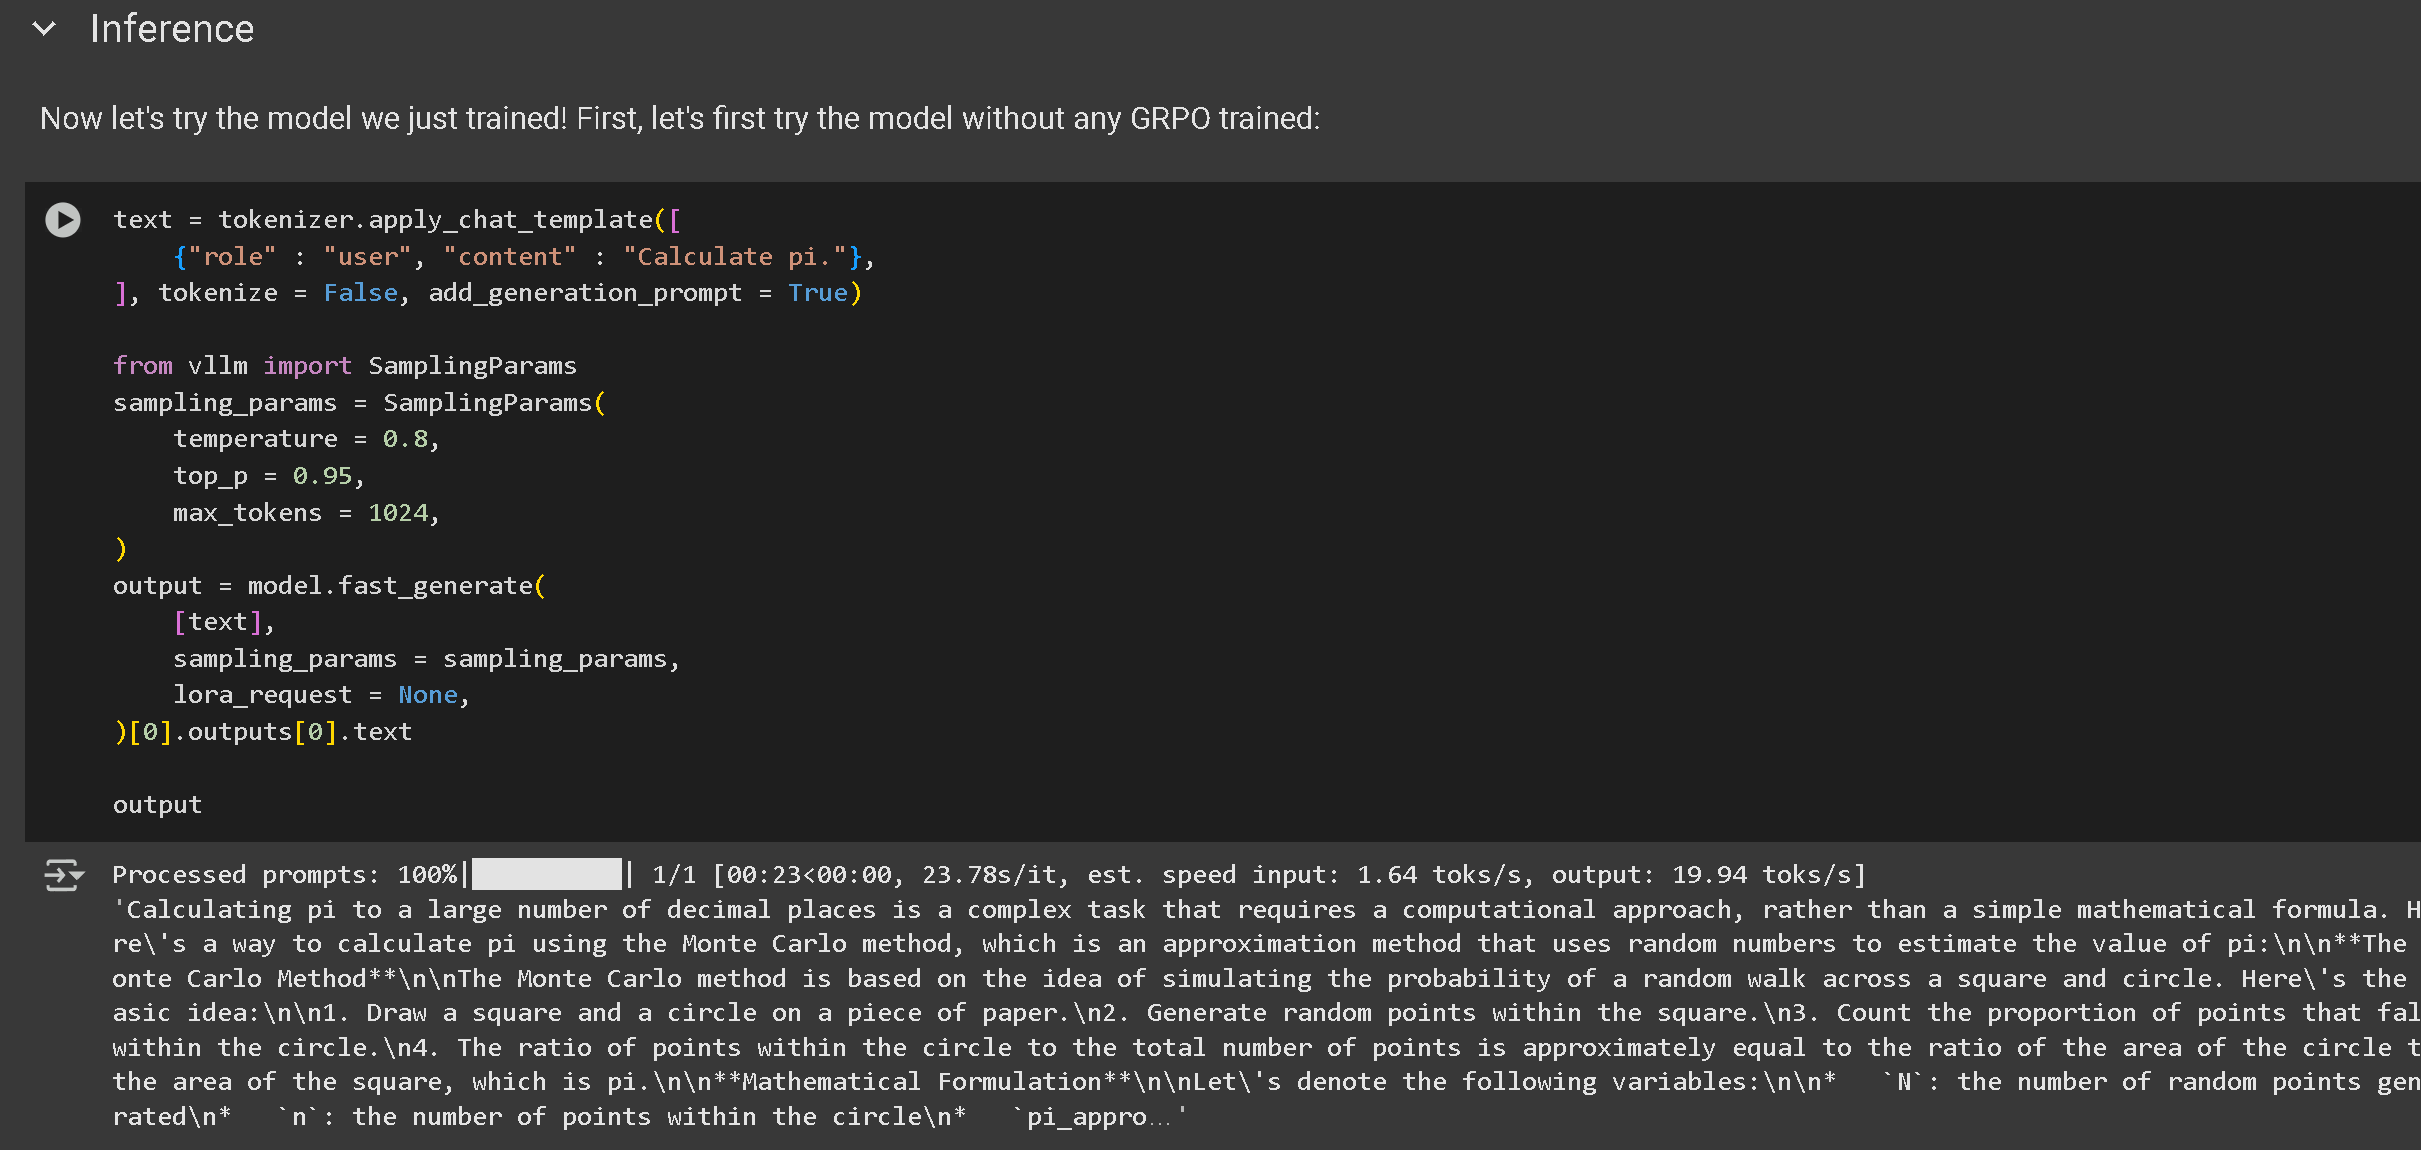
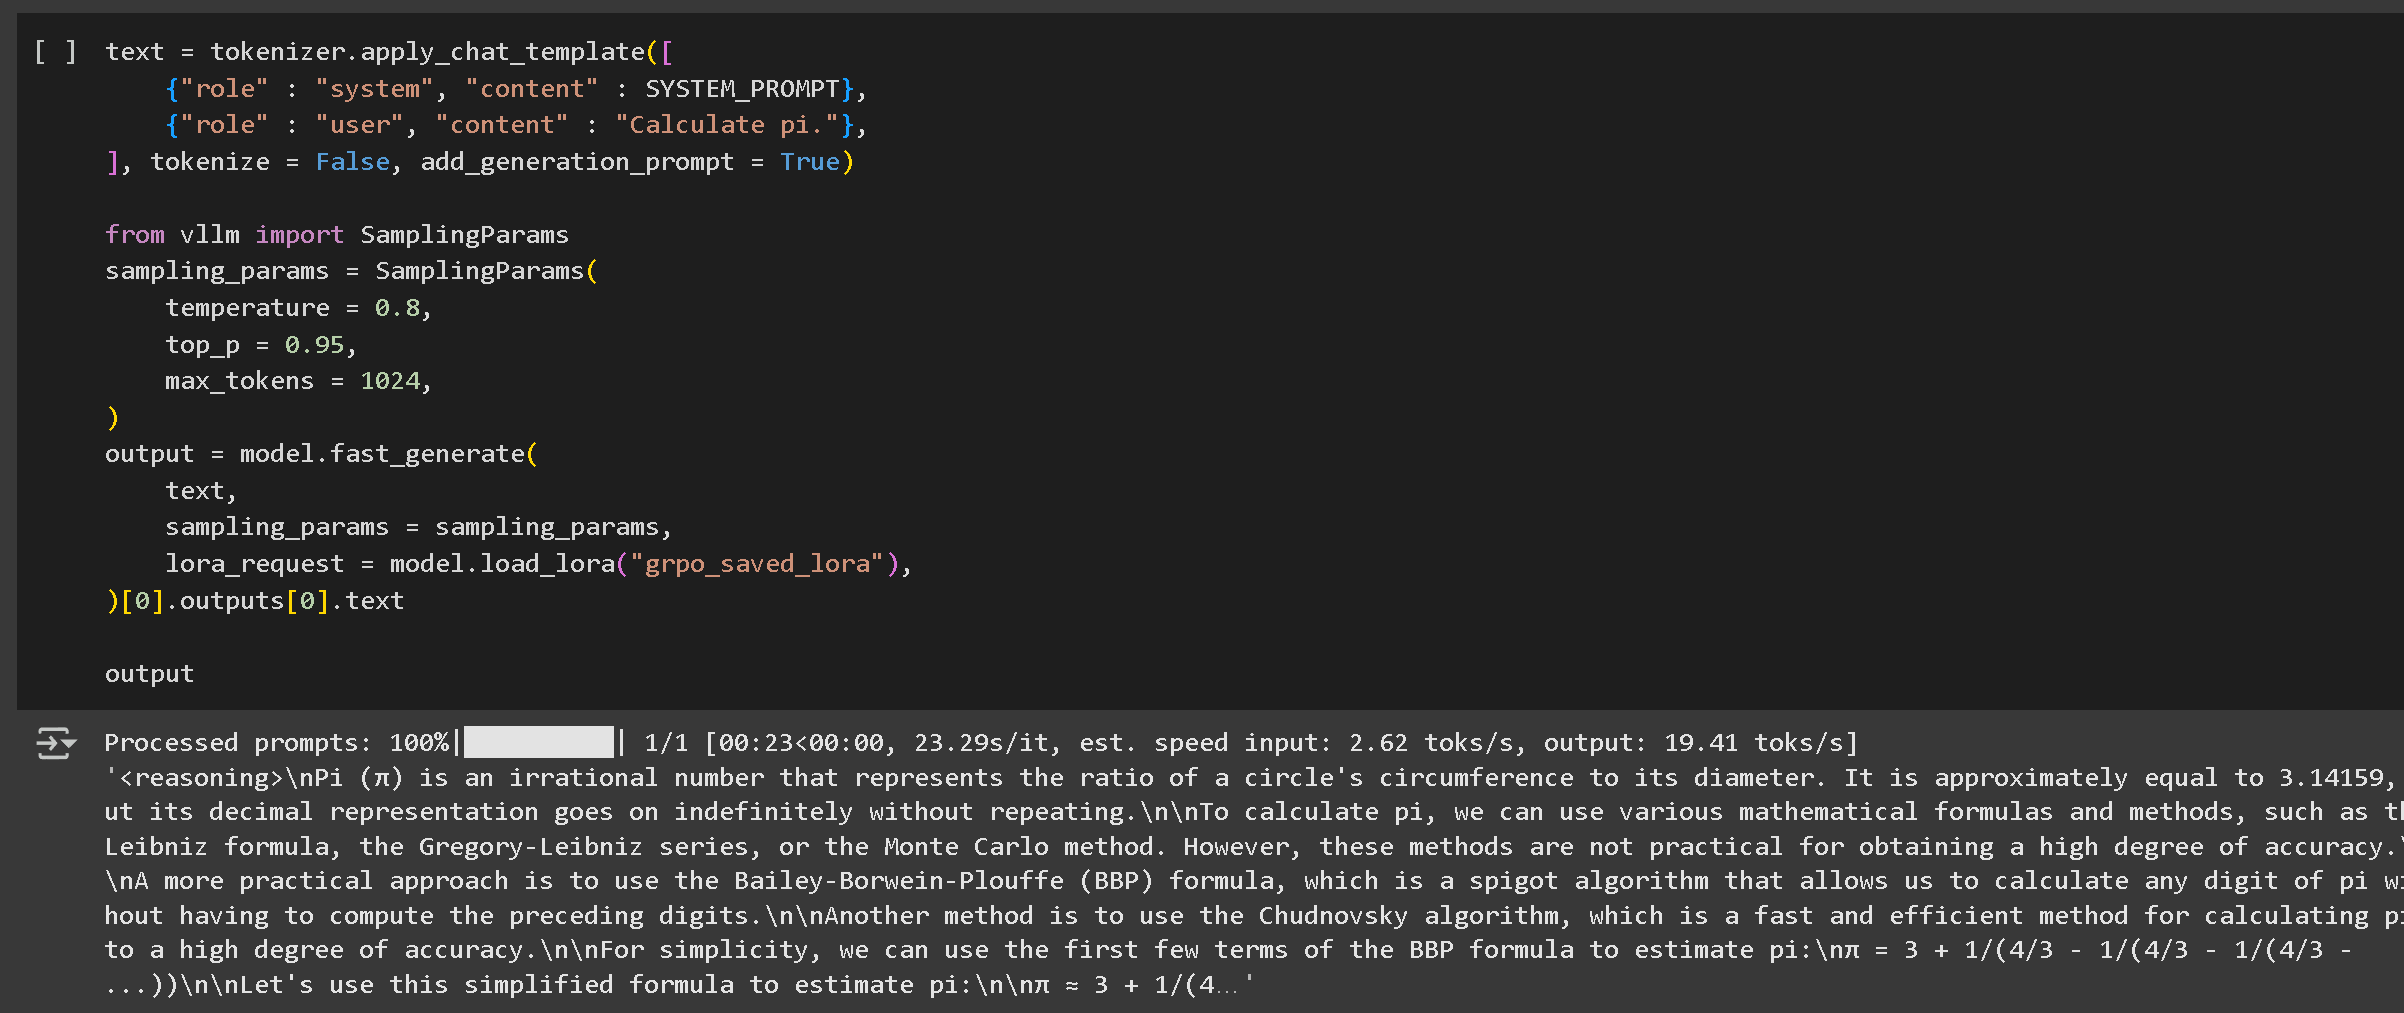
Führen Sie Ihr Modell aus, indem Sie auf die Wiedergabetaste klicken. Im ersten Beispiel gibt es normalerweise keine Begründung in der Antwort, und um die Begründung zu sehen, müssen wir zuerst die gerade mit GRPO trainierten LoRA-Gewichte speichern, und zwar mit:
model.save_lora("grpo_saved_lora")
Der erste Inferenz-Beispiel-Durchlauf enthält keine Begründung. Sie müssen die LoRA laden und testen, um die Begründung sichtbar zu machen.
Dann laden wir die LoRA und testen sie. Unser Reasoning-Modell ist viel besser - es ist nicht immer korrekt, da wir es nur etwa eine Stunde lang trainiert haben - es wird besser, wenn wir die Sequenzlänge verlängern und länger trainieren!
Sie können Ihr Modell dann gemäß unserer [Anleitung hier](https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/pages/44aed34263310d67280841ab6b72ea1e5648761f#id-7.-running--saving-the-model).
Wenn Sie immer noch keine Begründung erhalten, haben Sie möglicherweise entweder zu wenige Schritte trainiert oder Ihre Belohnungsfunktion/Ihr Verifizierer war nicht optimal.
{% endstep %}
{% step %}
#### Speichern Sie Ihr Modell
Wir haben mehrere Optionen zum Speichern Ihres feinabgestimmten Modells, konzentrieren uns aber auf die einfachsten und beliebtesten Ansätze, über die Sie mehr lesen können [hier](/docs/de/grundlagen/inference-and-deployment.md)
**Speichern in 16-Bit-Präzision**
Sie können das Modell mit 16-Bit-Präzision mit dem folgenden Befehl speichern:
```python
# In 16-Bit-Präzision speichern
model.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")
```
**Auf den Hugging Face Hub hochladen**
Um Ihr Modell zu teilen, laden wir es mit der `push_to_hub_merged` Methode auf den Hugging Face Hub hoch. Dies ermöglicht das Speichern des Modells in mehreren Quantisierungsformaten.
```python
# Auf den Hugging Face Hub hochladen (erfordert ein Token)
model.push_to_hub_merged(
"your-username/model-name", tokenizer, save_method="merged_16bit", token="your-token"
)
```
**Speichern im GGUF-Format für llama.cpp**
Unsloth unterstützt auch das Speichern in **das GGUF-Format**, wodurch es kompatibel ist mit **llama.cpp** und **Ollama**.
```python
model.push_to_hub_gguf(
"your-username/model-name",
tokenizer,
quantization_method=["q4_k_m", "q8_0", "q5_k_m"],
token="your-token",
)
```
Einmal im GGUF-Format gespeichert, kann das Modell in schlanken Umgebungen problemlos mit **llama.cpp** oder in anderen Inferenz-Engines verwendet werden.
{% endstep %}
{% endstepper %}
## Video-Tutorials
Hier sind einige Video-Tutorials von großartigen YouTubern, die wir fantastisch finden!
{% embed url="" %}
{% columns %}
{% column width="50%" %}
{% embed url="" %}
Großartig, um zu lernen, wie Sie Ihren Datensatz vorbereiten, und für Erklärungen zu den Grundlagen von Reinforcement Learning + GRPO
{% endembed %}
{% embed url="" %}
{% endcolumn %}
{% column width="50%" %}
{% embed url="" %}
{% embed url="" %}
Lokales GRPO auf Ihrem eigenen Gerät
{% endembed %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.