> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md).

# Speichereffizientes RL

Wir freuen uns, effizienteres Reinforcement Learning (RL) in Unsloth mit mehreren algorithmischen Verbesserungen vorzustellen:

* **1,2- bis 1,7-fach größere Kontextlängen** ohne Verlangsamung und ohne zusätzlichen Speicherverbrauch!
* **10 % schnellere RL-Trainingsläufe** mit überarbeiteten Kernels und asynchronen Datenbewegungen
* **2x schneller `torch.compile` Mal** während des Modellladens

Unsloth **bereits** erhöht RL-Trainingsgeschwindigkeit, Kontextfenster und reduziert den VRAM-Verbrauch um 50–90 % gegenüber allen anderen Setups mit FA2, aber jetzt [**Unsloths Standby**](#unsloth-standby) verbessert das noch weiter. Unsere Standby-Funktion begrenzt den Geschwindigkeitsverlust im Vergleich zu anderen Implementierungen einzigartig und macht das Training manchmal sogar schneller!

Jetzt kann Qwen3-32B LoRA 16-bit Kontextlängen von 6.144 erreichen statt zuvor 3.600 (**1,7x länger**) auf einer 1xH100-80GB-GPU. Llama-3.1-8B QLoRA 4bit kann 47.500 Längen erreichen statt zuvor 42.000 (1,13x länger).

Wir haben RL-Läufe durch verschiedene Kernel-Optimierungen um 10 % beschleunigt und den LoRA-Kommunikationskanal zwischen CPU und GPU entfernt, wenn vom Trainings- in den Inferenzmodus gewechselt wird. Schließlich haben wir benutzerdefinierte `torch.compile` Flags verwendet, um vLLMs Rollout um 10 % zu beschleunigen, und die Kompilierungszeit um das 2-Fache reduziert.

## :sparkles:So aktivierst du Optimierungen

Um zu aktivieren **Unsloths Standby** Funktion, setze die Umgebungsvariable `UNSLOTH_VLLM_STANDBY` vor jedem Unsloth-Import. Dann setze `gpu_memory_utilization = 0.95` und das ist alles!

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1" # Unsloth-Standby spart 30%+ Speicher für RL

from unsloth import FastLanguageModel
import torch
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B-Base",
    max_seq_length = 2048, # Kann für längere Reasoning-Traces erhöht werden
    load_in_4bit = False, # False für LoRA 16bit
    fast_inference = True,
    max_lora_rank = 32, # Größerer Rang = intelligenter, aber langsamer
    gpu_memory_utilization = 0.95,
)
```

## :mortar\_board:Nicht mehr `gpu_memory_utilization`!

Mit Unsloths neuen RL-Verbesserungen musst du dir NIE wieder Sorgen machen, `gpu_memory_utilization` gpu\_memory\_utilization festzulegen oder anzupassen. Setze es einfach auf 90 % oder 95 % der GPU-Auslastung - 100 % funktioniert leider nicht, da etwas Speicher für kleine Tensoren benötigt wird. Früher musste man es von 30 % bis 95 % feinjustieren - jetzt nicht mehr! Setze es auf das Maximum und Unsloth erledigt den Rest!

## :interrobang:Warum verbraucht RL so viel Speicher?

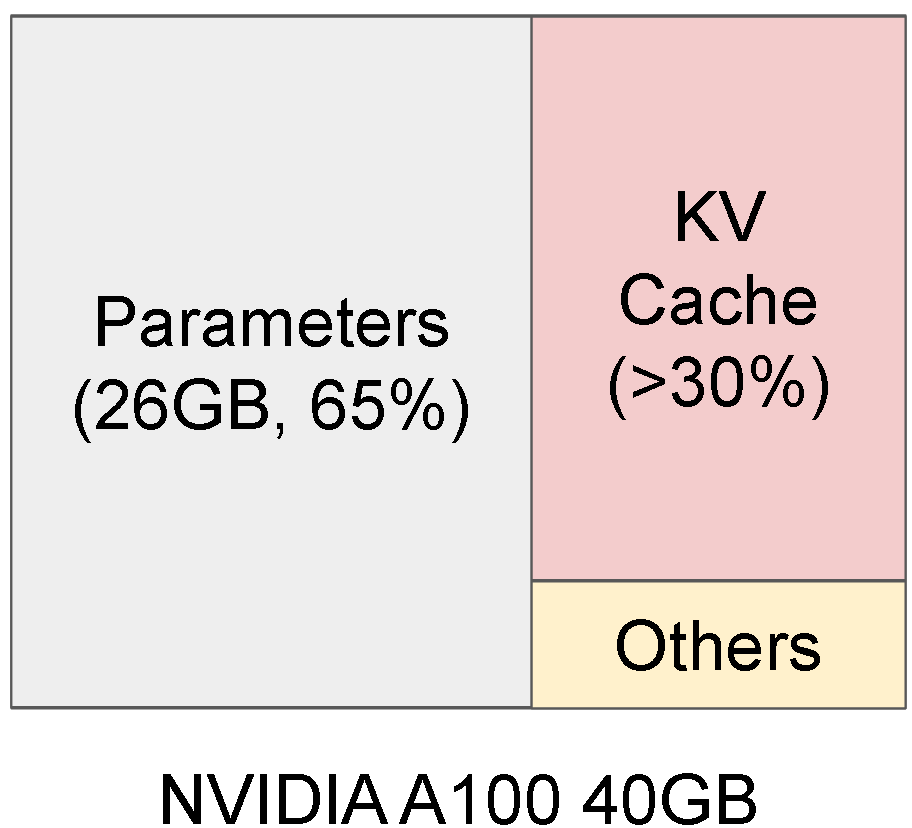
GRPO (und viele RL-Varianten) verlassen sich stark auf Generierung, die hauptsächlich von vLLM angetrieben wird. Das hat jedoch einen hohen Preis, da es ständigen **GPU-Speicher für Gewichte, Aktivierungen und den KV-Cache benötigt**.

{% columns %}
{% column %}
Inference benötigt viel VRAM

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e25501083081b201d59f6000219cafa535d2b2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
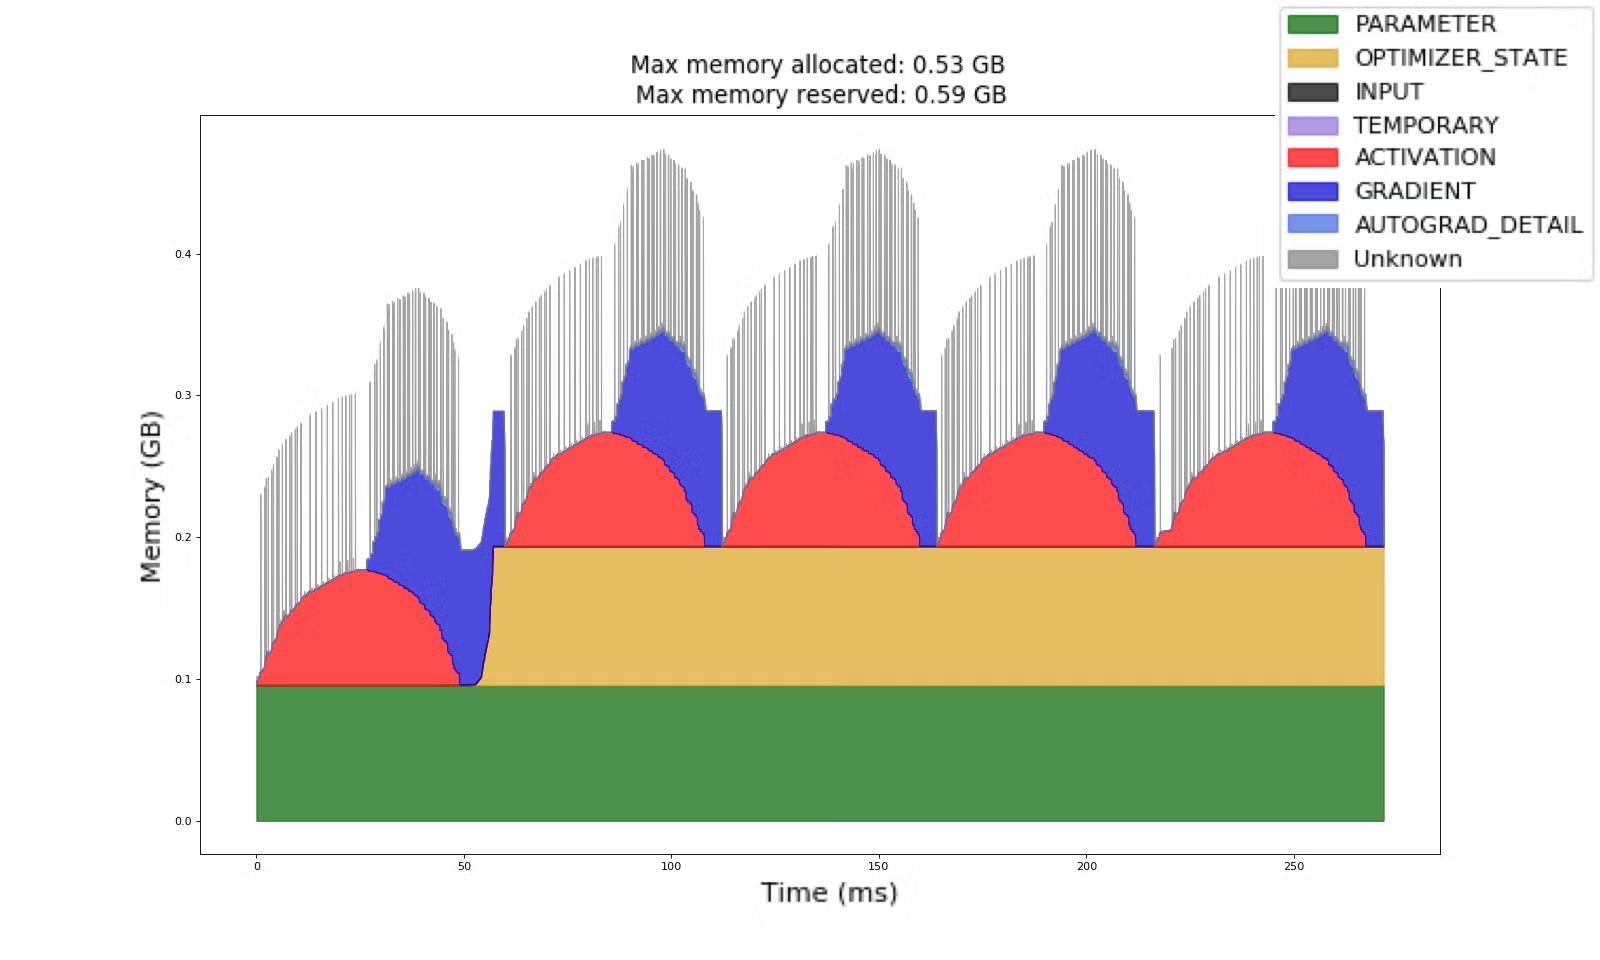
Während auch das Training VRAM nutzt!

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-189fd45a9e7a6fa1e98d1c9646b57bd0ec48481d%2Ffig6-2.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Das bedeutet, dass RL gleichzeitig 2 Sätze an VRAM / Speicher auf der GPU vorhalten muss:

1. Inference-Engine (enthält Modellgewichte, KV-Cache)
2. Trainings-Engine (enthält Modellgewichte, Aktivierungen, Gradienten, Optimizer-Zustände)

Aktuelle RL-Frameworks müssen auf einer 80-GB-GPU 50/50 aufteilen, also 50 % für Inference und 50 % für Training. Und das Verschieben der Gewichte vom Trainings- in den Inferenzmodus kann ziemlich viel Zeit in Anspruch nehmen.

<table><thead><tr><th width="251.51666259765625">80-GB-GPU</th><th>Inference-Engine (50 %)</th><th>Trainings-Engine (50 %)</th></tr></thead><tbody><tr><td>Modellgewichte</td><td>16GB</td><td>16GB</td></tr><tr><td>KV-Cache</td><td>24GB</td><td></td></tr><tr><td>Aktivierungen, Gradienten, Optimizer-Zustände</td><td></td><td>24GB</td></tr></tbody></table>

Frühere Unsloth-Versionen optimieren das oben Genannte bereits intelligent, da wir **vLLMs Gewichts-Speicherbereich direkt teilen, wodurch die doppelte Speichernutzung der Modellgewichte entfällt**. Dadurch werden zum Beispiel 16 GB Speicher frei, die verwendet werden können, um die Kontextlänge oder die Generierungsgeschwindigkeit zu erhöhen. Außerdem müssen wir keine Speicherbewegungen durchführen, was das Training schneller macht.

| 80-GB-GPU                                     | Inference-Engine (50 %) | Trainings-Engine (50 %) |
| --------------------------------------------- | ----------------------- | ----------------------- |
| Modellgewichte                                | **16 GB GETEILT**       | **<<< GETEILT**         |
| KV-Cache                                      | 24GB + 8GB= **32GB**    |                         |
| Aktivierungen, Gradienten, Optimizer-Zustände |                         | 24GB + 8GB=**32GB**     |

## 🦥Unsloth Standby

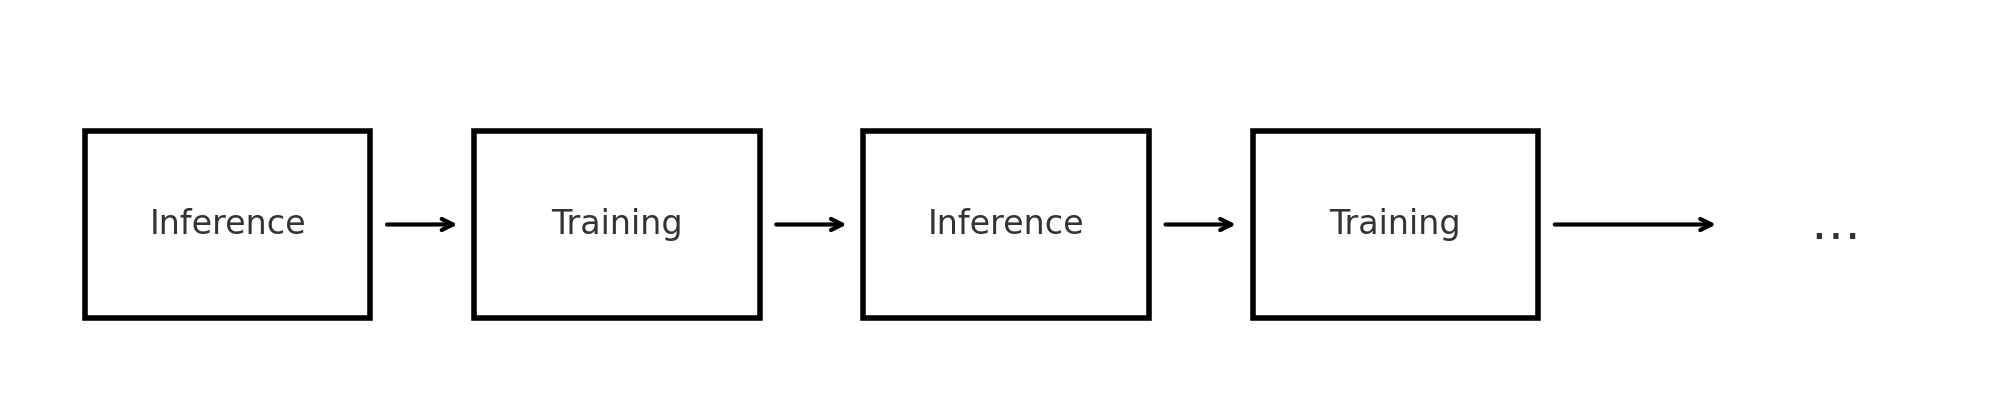
Aber wir können noch weiter gehen - zuerst stellen wir fest, dass RL erst Inference, dann Training, dann wieder Inference, dann wieder Training usw. durchführt.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-6e9b6a2f7381de84ed6eeb0feedc566cd443acf3%2F5b957843-eb58-4778-8b90-f25767c51495.png?alt=media" alt=""><figcaption></figcaption></figure>

Das bedeutet, dass der Speicherplatz für Inference und Training theoretisch wiederverwendet werden kann, da Inference und Training getrennte Modi sind - hier kommt [vLLMs Schlafmodus-Funktion](https://docs.vllm.ai/en/latest/features/sleep_mode.html#rlhf-weight-updates) ins Spiel, die 2 Optionen hat:

1. `level = 1` kopiert Gewichte auf die CPU und löscht den KV-Cache
2. `level = 2` löscht Gewichte und löscht den KV-Cache

Aber zur Erinnerung: In Unsloth teilen wir den Speicherplatz von vLLM für die Gewichte - das bedeutet, dass wir eine neue Methode brauchen, um den KV-Cache zu löschen und die Löschung der Gewichte zu ignorieren, und wir nennen das Unsloth Standby.

| 80-GB-GPU                                                                                                                                                                | Inferenz-Engine   | Trainings-Engine                              |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | ----------------- | --------------------------------------------- |
| Modellgewichte                                                                                                                                                           | **16 GB GETEILT** | **<<< GETEILT**                               |
| <p><mark style="background-color:purple;"><strong>Mehrzweck</strong></mark></p><p><mark style="background-color:purple;"><strong>64 GB Speicherplatz</strong></mark></p> | KV-Cache          | Aktivierungen, Gradienten, Optimizer-Zustände |

Um dies zu aktivieren, füge einfach Folgendes zu allen RL / GRPO-Trainingsläufen vor jedem Unsloth-Import hinzu:

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1" # Unsloth-Standby spart 30%+ Speicher für RL
```

## 🧪Leistungsexperimente

Hier erfährst du, wie wir die Speichernutzung und Kontextlänge für GRPO gebenchmarkt haben. Beachte, dass wir **2 Generierungen pro Prompt durchführen, denn damit GRPO funktioniert**, benötigen wir mindestens 2 Generierungen, für die wir den Stichprobenmittelwert und die Varianz berechnen können. **Ohne 2 Generierungen ist die Standardabweichung einer Stichprobe 0**. Dadurch werden die Vorteile, die dies verwenden, undefiniert: (reward - mean)/std **sein**.

$$
Z=\frac{r\_i - \mu}{\sqrt{\frac{1}{n}\sum(r\_i-\mu)^2}} \\
Z\_{n=1}=\frac{r\_1 - \mu}{\sqrt{\frac{1}{1}\sum(r\_1-\mu)^2}}=\frac{0}{0}=\text{undefined}
$$

Das bedeutet speziell für GRPO, dass eine maximale Kontextlänge von 6.144 für Qwen-3 32B tatsächlich 6.144 multipliziert mit 2 Generierungen, also 12.288 in der Länge, entspricht.

Wir zeigen unten Experimente für Llama-3.1 8B sowohl auf LoRA (16bit) als auch auf QLoRA (4bit):
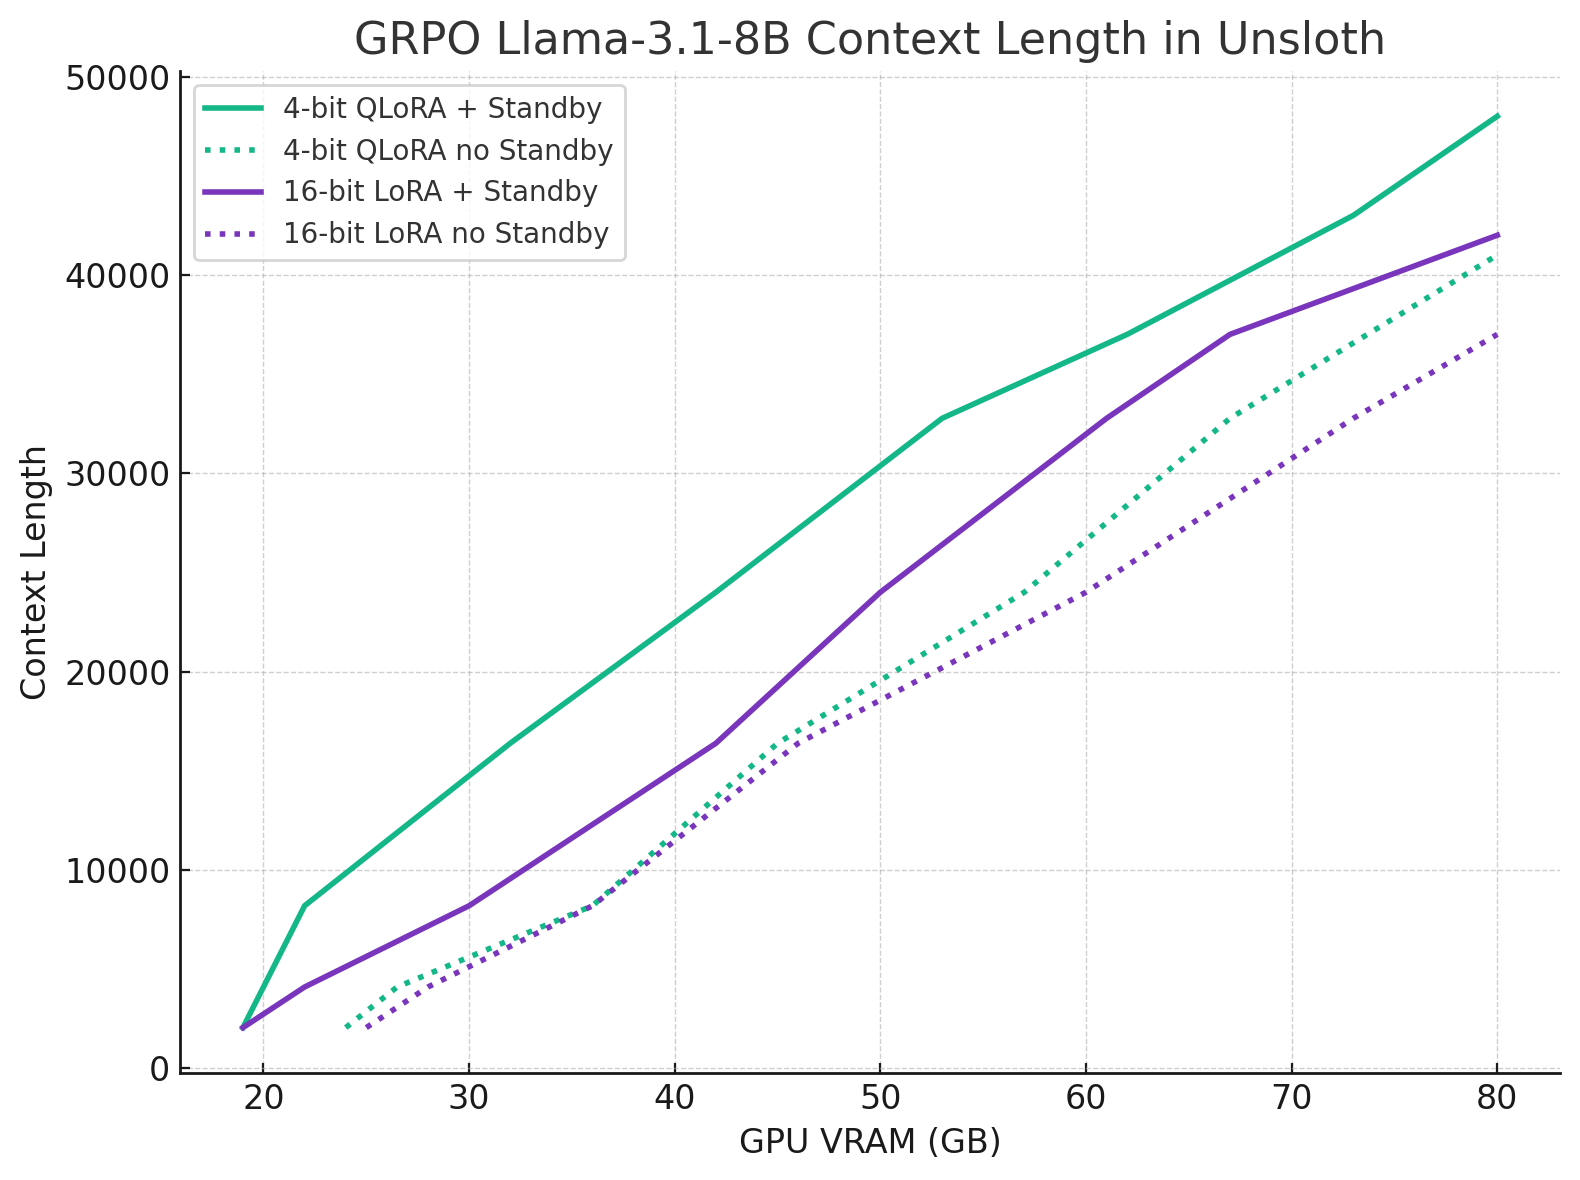
<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f83185e373186aa67bc2ce7d1814b2edb0f3ce6%2Foutput%20(10).png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

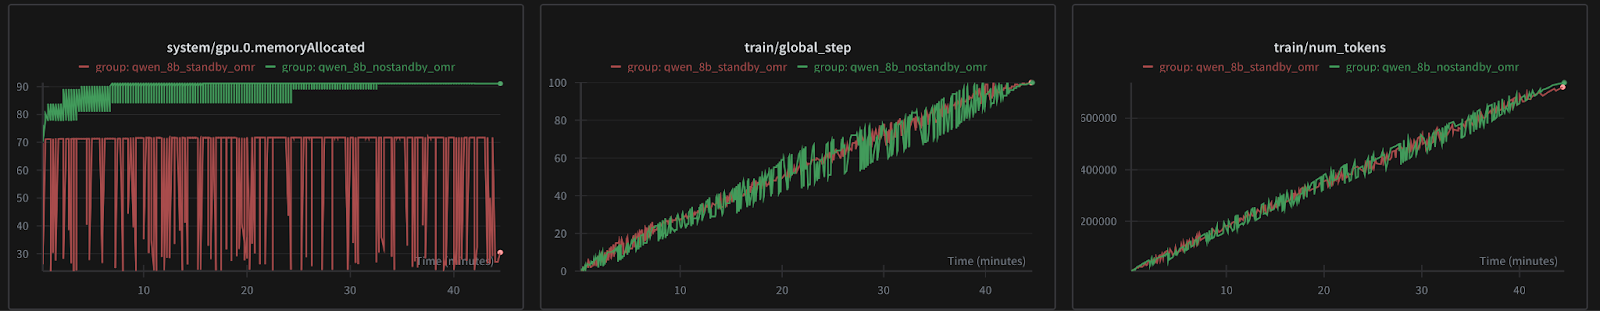
**Falls dir Unterschiede in der Trainingszeit auffallen, dann sind sie nicht groß**. In unserem direkten Vergleich bemerkten wir <1 % Verlangsamungen der Trainingszeit oder sogar Beschleunigungen, die auf Messungenauigkeiten zurückgeführt werden können.

Wir vermuten auch, dass Beschleunigungen durch den reduzierten Speicherdruck möglich sind, sodass es auf Seiten des CUDA-Speicherallokators weniger Speicherbereinigung geben könnte.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-db26f62f9080dba942add171880537c3f516f065%2Fgpu%20mem%20cofigure.png?alt=media" alt=""><figcaption></figcaption></figure>

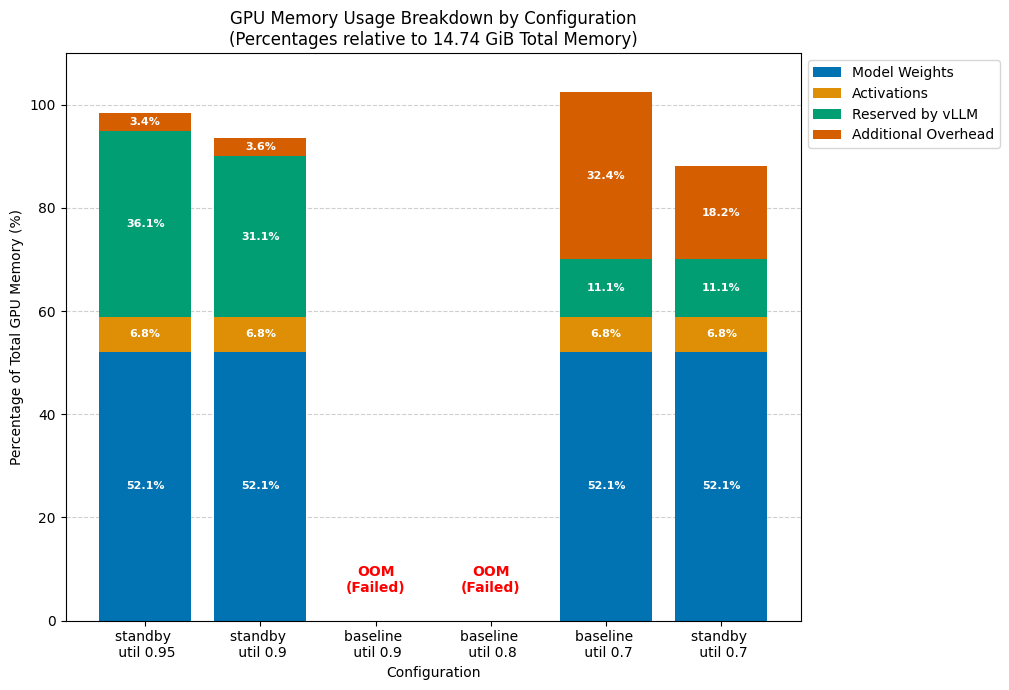
Im obigen Bild siehst du den Unterschied zwischen Baseline und Standby-Modus auf einer einzelnen T4-GPU für Qwen 3 4B. <mark style="background-color:green;">**Wir können vLLMs**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`gpu_memory_utilisation`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**bis zu 0.95 erhöhen, ohne uns Sorgen zu machen, dass es das Training beeinflusst**</mark>. Das bedeutet, dass du längere Sequenzen mit höherer Kontextlänge unterbringen kannst und mehr Sequenzen verarbeitet werden können. Im ersten Fall haben wir zum Beispiel genug Speicher, um 32K-lange Sequenzen unterzubringen und zu verarbeiten, sofern das Training es zulässt, während zuvor jede Eingabe länger als 2K potenziell nicht hineingepasst hätte und schließlich OOMs (out of memory) verursacht hätte.

<table data-full-width="true"><thead><tr><th>Experimente</th><th>Konfiguration</th><th>Status</th><th>GPU-Speichernutzung</th><th>Kommentare</th></tr></thead><tbody><tr><td><ol><li><a href="https://colab.research.google.com/drive/18CssBY5C0mStnLvu2Hlt4aFLoPugRG0K?usp=sharing">u0.95gen2ga1s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.95</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>Läuft 40 Schritte / 40 Minuten</td><td><p>14.5 GiB (gesetzt durch vllm_gpu_util)</p><p><br></p></td><td>Genug, um 32K KVCache mit Chunks von 2-4K oder z. B. 16K KVCache + 16K-Chunks unterzubringen</td></tr><tr><td><ol start="2"><li><a href="https://colab.research.google.com/drive/1q0TOUychygfreI2wKpg51sqnRhs5cYnX?usp=sharing">u9ge2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>Läuft 32 Schritte in 40 Min.</td><td>13.8 GiB (gesetzt durch…)</td><td>Ungefähr genug, um ~28K KVCache mit Chunks von 2-4K oder z. B. 15K KVCache + 15K-Chunks unterzubringen</td></tr><tr><td><ol start="3"><li><a href="https://colab.research.google.com/drive/12Uw8y5beLzPtx11mCWCYyh9Z_PEHHdId?usp=sharing">u9ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>Modell wird geladen, aber Training ist nicht möglich, weil nicht einmal Batchgröße 1 hineinpasst</td><td>OOM</td><td><br></td></tr><tr><td><ol start="4"><li><a href="https://colab.research.google.com/drive/1GwTlaP5CLsW-BcE1LqZWkz6S8VTWYdJ2?usp=sharing">u8ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.8</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>Modell wird geladen, aber Training ist nicht möglich, weil nicht einmal Batchgröße 1 hineinpasst</td><td>OOM</td><td><br></td></tr><tr><td><ol start="5"><li><a href="https://colab.research.google.com/drive/1IuSUNzEBTiURK-vbTQuRDuUl0Ya2pz2t?usp=sharing">u7ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>Trainiert problemlos</p><p>28 Schritte dauern 39 Min.</p></td><td>~15.1GiB</td><td>jede etwas längere Eingabe führt auf Colab zu OOM</td></tr><tr><td><ol start="6"><li><a href="https://colab.research.google.com/drive/1RY7HwpZ0luJT70OyLJ6zXKZQ2COdT9QJ?usp=sharing">u7gen2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>Trainiert problemlos</p><p>29 Schritte dauern 40 Min.</p></td><td>13GiB, aber die meiste Zeit etwa 10-11GB</td><td>Bei derselben Konfiguration sparen wir hier 2 GiB, also 15 % Speicher.<br>Kann bei längeren Sequenzen höher sein</td></tr></tbody></table>

### H100-Experimente

| Modell               | GPU                   | Seq.-Länge | Anzahl der Generierungen | Grad-Acc-Schritte |
| -------------------- | --------------------- | ---------- | ------------------------ | ----------------- |
| Qwen2.5-14B-Instruct | NVIDIA H100 80GB PCIe | 32,768     | 8                        | 4                 |

In unseren unten zusammenklappbaren Ergebnissen kannst du sehen, dass es einen Unterschied von 9 GiB im verwendeten Spitzenspeicher gibt (beachte, dass die GPU-Speichernutzung in unserem Fall 90 % der Zeit dem Spitzenspeicher entspricht). **Um das einzuordnen: Mit TRL und LoRA konnten wir höchstens nur ein 8B-Parameter-Modell mit einer Kontextlänge von 1024 feinabstimmen (32x weniger).** Alles mit höherer Sequenzlänge (bei ähnlicher Konfiguration) führt dazu, dass der Prozess mit OOM fehlschlägt.

<details>

<summary>Klicken für Benchmarks: Unsloth-Standby-Modus vs. kein Standby</summary>

```
Standby-Modus aktiviert:

|===========================================================================|
|                  PyTorch CUDA-Speicherzusammenfassung, Geräte-ID 0                 |
|---------------------------------------------------------------------------|
|            CUDA OOMs: 0            |        cudaMalloc-Wiederholungen: 0         |
|===========================================================================|
|        Metrik         | Akt. Nutzung | Spitzenverbrauch | Gesamt zugewiesen | Gesamt freigegeben |
|---------------------------------------------------------------------------|
| Zugewiesener Speicher |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       aus großem Pool |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       aus kleinem Pool |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| Aktiver Speicher      |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       aus großem Pool |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       aus kleinem Pool |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| Angeforderter Speicher |  32199 MiB |  42987 MiB | 128176 GiB | 128145 GiB |
|       aus großem Pool |  31364 MiB |  42110 MiB | 127047 GiB | 127016 GiB |
|       aus kleinem Pool |    834 MiB |   1184 MiB |   1129 GiB |   1128 GiB |
|---------------------------------------------------------------------------|
| Reservierter GPU-Speicher |  37644 MiB |  47504 MiB | 705806 MiB | 668162 MiB |
|       aus großem Pool |  36376 MiB |  46588 MiB | 682818 MiB | 646442 MiB |
|       aus kleinem Pool |   1268 MiB |   1284 MiB |  22988 MiB |  21720 MiB |
|---------------------------------------------------------------------------|
| Nicht freigebbarer Speicher | 713142 KiB |   4633 MiB | 103206 GiB | 103205 GiB |
|       aus großem Pool | 525312 KiB |   4594 MiB | 101923 GiB | 101922 GiB |
|       aus kleinem Pool | 187830 KiB |    250 MiB |   1283 GiB |   1283 GiB |
|---------------------------------------------------------------------------|
| Zuweisungen           |    3460    |    4809    |   15606 K  |   15603 K  |
|       aus großem Pool |     395    |     563    |    2812 K  |    2811 K  |
|       aus kleinem Pool |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| Aktive Zuweisungen    |    3460    |    4809    |   15606 K  |   15603 K  |
|       aus großem Pool |     395    |     563    |    2812 K  |    2811 K  |
|       aus kleinem Pool |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| Reservierte GPU-Segmente |     913    |     920    |   13260    |   12347    |
|       aus großem Pool |     279    |     305    |    1766    |    1487    |
|       aus kleinem Pool |     634    |     642    |   11494    |   10860    |
|---------------------------------------------------------------------------|
| Nicht freigebbare Zuweisungen |     422    |     628    |    4766 K  |    4765 K  |
|       aus großem Pool |      66    |      92    |    1290 K  |    1289 K  |
|       aus kleinem Pool |     356    |     555    |    3476 K  |    3475 K  |
|---------------------------------------------------------------------------|
| Übergroße Zuweisungen  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Übergroße GPU-Segmente |       0    |       0    |       0    |       0    |
|===========================================================================|


Ohne Standby:

|===========================================================================|
|                  PyTorch CUDA-Speicherzusammenfassung, Geräte-ID 0                 |
|---------------------------------------------------------------------------|
|            CUDA OOMs: 0            |        cudaMalloc-Wiederholungen: 0         |
|===========================================================================|
|        Metrik         | Akt. Nutzung | Spitzenverbrauch | Gesamt zugewiesen | Gesamt freigegeben |
|---------------------------------------------------------------------------|
| Zugewiesener Speicher |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       aus großem Pool |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       aus kleinem Pool |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| Aktiver Speicher      |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       aus großem Pool |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       aus kleinem Pool |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| Angeforderter Speicher |  32572 MiB |  51658 MiB | 141898 GiB | 141866 GiB |
|       aus großem Pool |  31738 MiB |  50780 MiB | 140644 GiB | 140613 GiB |
|       aus kleinem Pool |    833 MiB |   1184 MiB |   1253 GiB |   1252 GiB |
|---------------------------------------------------------------------------|
| Reservierter GPU-Speicher |  49552 MiB |  52188 MiB |  86354 MiB |  36802 MiB |
|       aus großem Pool |  48320 MiB |  51300 MiB |  84740 MiB |  36420 MiB |
|       aus kleinem Pool |   1232 MiB |   1232 MiB |   1614 MiB |    382 MiB |
|---------------------------------------------------------------------------|
| Nicht freigebbarer Speicher |      0 B   |      0 B   |      0 B   |      0 B   |
|       aus großem Pool |      0 B   |      0 B   |      0 B   |      0 B   |
|       aus kleinem Pool |      0 B   |      0 B   |      0 B   |      0 B   |
|---------------------------------------------------------------------------|
| Zuweisungen           |    3460    |    4809    |   17440 K  |   17437 K  |
|       aus großem Pool |     395    |     564    |    2742 K  |    2741 K  |
|       aus kleinem Pool |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| Aktive Zuweisungen    |    3460    |    4809    |   17440 K  |   17437 K  |
|       aus großem Pool |     395    |     564    |    2742 K  |    2741 K  |
|       aus kleinem Pool |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| Reservierte GPU-Segmente |       0    |       0    |       0    |       0    |
|       aus großem Pool |       0    |       0    |       0    |       0    |
|       aus kleinem Pool |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Nicht freigebbare Zuweisungen |       0    |       0    |       0    |       0    |
|       aus großem Pool |       0    |       0    |       0    |       0    |
|       aus kleinem Pool |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Übergroße Zuweisungen  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Übergroße GPU-Segmente |       0    |       0    |       0    |       0    |
|===========================================================================|
```

</details>

Das folgende Bild zeigt, wie Standby im Vergleich zum Training ohne Standby mit Unsloth abschneidet. Es ist über 3 Läufe gemittelt, um sicherzustellen, dass die Metriken nicht verrauscht sind. Tatsächlich würdest du bei genauerem Hineinzoomen sehen, dass das Aktivieren von Standby es ebenfalls schneller macht, wahrscheinlich wegen des geringeren Speicherdrucks, wie zuvor erläutert.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f285043ea8afa38d1082513e424662d8cd04b90%2Ftrainglobalstep.png?alt=media" alt=""><figcaption></figcaption></figure>

### Frühere A100-40GB-Experimente

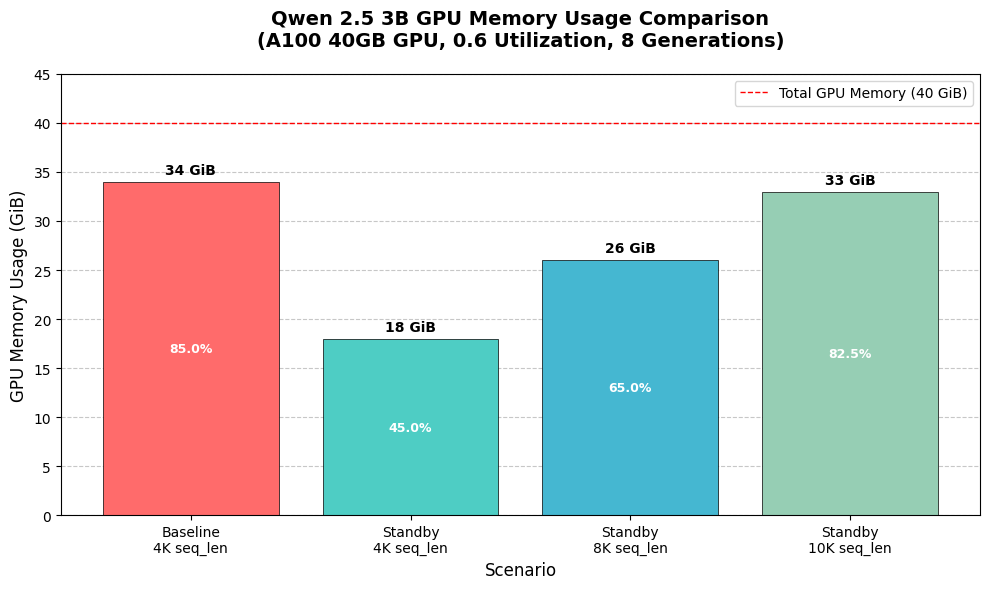
In unseren früheren Experimenten auf einer A100-40GB-GPU mit Qwen-2.5-3b-instruct und 8 Generierungen pro Sample stellten wir fest, dass wir ohne Standby beim GRPO-Training (Modell in 16bit geladen, LoRA, nur Gewichte trainierbar) nur Sequenzlängen von 6K unterbringen konnten. Mit unserer Standby-Funktion konnten wir 10K und mehr unterbringen! **Zum Vergleich: TRL kann dir bei gleicher Batchgröße nur Kontextlängen von bis zu 1K geben.**

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-c7cd807b5d513b04f5f3a6219bfcea0fb12e442a%2Fqwen3%20gpu%20mem.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

## :tada:Weitere Optimierungen

Wir wählen jetzt bessere Kompilierungsflags aus und reduzieren die Kompilierungszeiten um 50 % oder mehr. Außerdem konnten wir beliebige vLLM-Versionen dynamisch patchen, um `gc.collect` aus Gründen der Abwärtskompatibilität besser zu behandeln, inspiriert von diesem [vLLM-Pull-Request](https://github.com/vllm-project/vllm/pull/21146). Dies reduziert die Kompilierungszeit von 2 Minuten auf unter 40 Sekunden.

Wir haben auch `torch.compile` Flags optimiert und versucht, einige Flags zu aktivieren - leider `combo_kernels` und `multi_kernel` konnten auf vLLM 0.10 und Torch 2.8/2.9 Nightly nicht korrekt funktionieren und `coordinate_descent_tuning` machte das Autotuning aller Kernels dramatisch langsamer. Früher ließ es sich in unter einer Minute kompilieren, aber das Aktivieren dauerte über 13 Minuten und länger, bei minimalen Leistungsgewinnen.

## :books:GRPO-Notebooks

Alle unsere GRPO-Notebooks haben Unsloth Standby standardmäßig aktiviert und alle Optimierungen! Siehe <https://docs.unsloth.ai/get-started/unsloth-notebooks> für alle unsere GRPO-Notebooks, oder probiere die folgenden aus:

* [**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) **-** Fortgeschrittenes GRPO-LoRA
* [**DeepSeek-R1-0528-Qwen3 (8B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) (für mehrsprachige Anwendungsfälle)
* [Gemma 3 (1B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(1B\)-GRPO.ipynb)
* [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Fortgeschrittene GRPO-LoRA
* [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb)
* [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb)
* [Mistral v0.3 (7B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb)
* [Qwen2.5 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen2.5_\(3B\)-GRPO.ipynb)


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.