> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md).
# FP8-Reinforcement-Learning
Trainiere Reinforcement Learning (RL) und GRPO mit FP8-Präzision mit Unsloth.
Wir führen FP8-Präzisionstraining für RL ein, wodurch FP8 GRPO jetzt möglich ist auf **Consumer-GPUs** (RTX 40, 50 usw.). DeepSeek-R1 hat gezeigt, wie leistungsfähig FP8 sein kann, und mit Unsloth funktioniert Qwen3-1.7B FP8 GRPO jetzt schon auf nur **5 GB VRAM**.
Schnellere RL-Inferenz ist entscheidend, da dies die rechenintensivste Arbeitslast in RL ist. Wir haben uns mit [TorchAO](https://github.com/pytorch/ao) von PyTorch zusammengetan, um Leistungsgewinne ohne Genauigkeitsverlust zu ermöglichen.
* **ca. 1,4× schneller** RL-Inferenz über [vLLM](https://github.com/vllm-project/vllm) • 2x längerer Kontext als BF16 und FP16
* **60 % weniger VRAM** und **10× länger** Kontext als andere FP8-RL-Implementierungen
* Unsloth ist das **einzige Framework** um FP8-RL-LoRA auf Consumer-GPUs (z. B. NVIDIA GeForce RTX 40- und 50-Serie) zum Laufen zu bringen. Funktioniert auch auf H100, H200, B200 usw.
* Verwenden Sie `load_in_fp8 = True` innerhalb `FastLanguageModel` um FP8-RL zu aktivieren.
* Obwohl Qwen3-8B in 16 GB VRAM passt, unterstützen kostenlose Colab NVIDIA Tesla T4 GPUs **FP8 nicht**. Daher verwenden unsere Notebooks **24-GB-L4-GPUs, die Qwen3-14B aufnehmen**.
**Notebooks:** [Qwen3-8B FP8 GRPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_8B_FP8_GRPO.ipynb) und [Llama-3.2-1B FP8 GRPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama_FP8_GRPO.ipynb)
{% hint style="success" %}
Bonus: Ihnen wird auffallen, dass Unsloth jetzt deutlich weniger VRAM verwendet. Wir werden bald Details in einem neuen Blog teilen.
{% endhint %}
Unsere FP8-Unterstützung nutzt Unsloths [Gewichtsteilungsfunktion](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md), wodurch der VRAM-Verbrauch um weitere **50%**und ermöglicht **10× mehr** Kontext ohne Genauigkeitsverlust. Wir verwenden [vLLM](https://github.com/vllm-project/vllm) für schnelle Inferenz und unsere Techniken wie Unsloth [Standby](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md) und [Flex Attention](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) um den VRAM-Verbrauch weiter zu senken. TorchAO ermöglicht universelles FP8 on the fly, sodass Llama, Gemma, Mistral & mehr funktionieren. Wir haben außerdem [hochgeladen](#unsloth-fp8-uploads) die meisten FP8-Modelle (einschließlich Qwen3).
Das Reward-Plot zeigt, dass FP8 dem gleichen Trend wie BF16 folgt
### :sunflower:FP8- vs.-BF16-Training
Forschung zeigt, dass FP8-Training die BF16-Genauigkeit weitgehend erreichen kann, und wenn Sie Modelle in FP8 bereitstellen, **Training und Bereitstellung in derselben Präzision** hilft, die Genauigkeit zu erhalten. Außerdem ergibt FP8 gegenüber BF16 1,6x höheren Durchsatz auf H100s und hat 2x geringeren Speicherbedarf.
#### Gewichtsskalen & FP8-Typen
Quantisiertes Training speichert ein niederpräzises Gewicht (z. B. FP8) plus eine höherpräzise Skala (FP16/BF16/FP32). Sie können das ursprüngliche Gewicht ungefähr zurückgewinnen über: `original_weight ≈ quantized_weight * weight_scale`
Die Skala bildet den Bereich des Gewichts auf den darstellbaren Bereich von FP8 ab. Mehr Skalen verbessern in der Regel die Genauigkeit, kosten aber zusätzlichen hochpräzisen Speicher, also ist es ein Kompromiss. [DeepSeek R1](https://arxiv.org/abs/2501.12948), begünstigt zum Beispiel größtenteils die Blockquantisierung.
Es gibt 3 gängige FP8-Typen, wie von vLLMs [llm-compressor](https://github.com/vllm-project/llm-compressor). Wir haben Qwen3-8B auf allen 3 Typen gebenchmarkt und außerdem den Durchsatz, MMLU Pro und GQPA Diamond geprüft. Wir finden **FP8 blockweise oder pro Kanal (-FP8-Dynamic) ist das Beste** in Bezug auf Genauigkeit und Durchsatz.
Typ
Durchsatz
MMLU Pro
GQPA Diamond
Bfloat16-Baseline
11,367
62.04%
28.79%
Blockweise
Skalen pro Block (128x128)
12,041
62.37%
29.29%
Pro Kanal
1 Skala pro Zeile oder Spalte
12,963
61.89%
31.82%
Pro Tensor
1 Skala für den gesamten Tensor
13,681
61.83%
27.78%
### :zap:FP8-Leistungsbenchmarks
Unsloth FP8-RL-Inferenz über vLLM ist im Allgemeinen 1,4x schneller als BF16. Bei größeren Modellen sehen Sie möglicherweise sogar noch mehr Geschwindigkeitsverbesserungen!
#### Benchmarks für Genauigkeit und Trainingsverlust
Wir haben mehrere Modelle getestet, darunter Qwen3-4B, 8B, 14B, Llama 3.2 1B, 3B, Qwen3-VL-2B, Qwen3-VL 4B und viele mehr. Alle wurden sowohl in BF16 als auch in FP8 trainiert. Wie in den Plots zu sehen ist, die **Verlustkurven während des SFT für BF16 und FP8 verlaufen sehr ähnlich**. In Bezug auf den Trainingsverlust gibt es zwischen den beiden Datentypen kaum Unterschiede:
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
Insbesondere bei GRPO ist es aufgrund von Generierungsunterschieden das Ziel zu sehen, ob die Reward-Plots sich zumindest decken und nicht auseinanderlaufen (manchmal sind z. B. Läufe von Qwen3-14B möglicherweise nicht exakt gleich)
{% columns %}
{% column width="50%" %}
{% endcolumn %}
{% column width="50%" %}
{% endcolumn %}
{% endcolumns %}
### :shinto\_shrine:Inferenz = 96 % des RL-Trainings
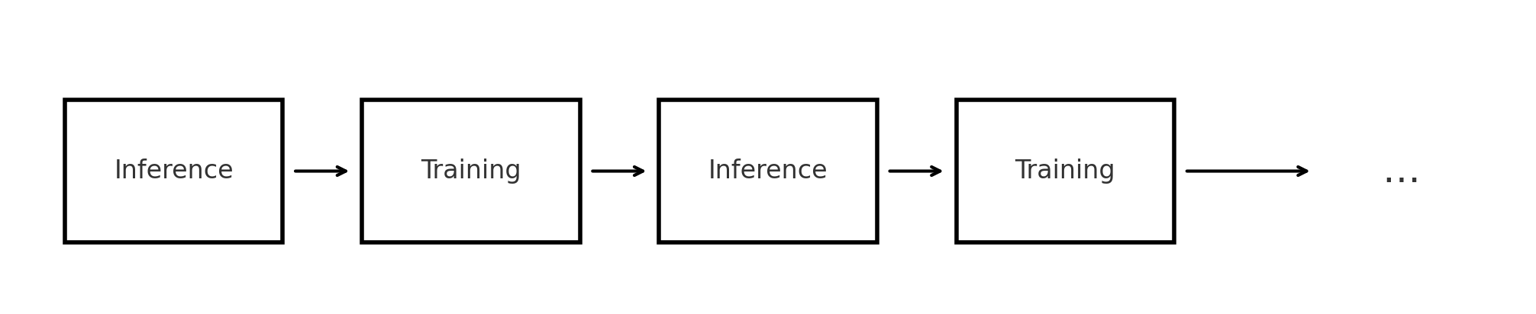
In RL müssen wir das LLM / VLM aufrufen, um einige mögliche Kandidatenlösungen für einen Lauf zu erzeugen, dann bewerten wir jede mögliche Lösung und **belohnen gute Lösungen und bestrafen schlechte Antworten**. Um maximale Effizienz zu erreichen, müssen wir die Inferenz nahezu 100 % des Trainingslaufs ausmachen lassen. In Unsloth haben wir **es geschafft, das Training auf weniger als 4 % des gesamten RL-Laufs zu beschränken, wobei 96 % rein vLLM-Inferenz sind.**
Zum Beispiel ist Qwen-3-8B bei kürzeren Sequenzlängen 1,15x schneller; der vLLM-FP8-Durchsatz bei der Inferenz selbst (ohne Training) ist ebenfalls 1,15x schneller. Wir sehen, dass unser RL-Lauf in Unsloth bei den verarbeiteten Tokens ebenfalls 1,15x schneller ist, was zeigt, wie **der Trainings-Overhead in Unsloth vernachlässigbar ist.**
### :1234:60 % weniger Speicherverbrauch
Theoretisch würde man erwarten, dass die Speichereinsparungen ungefähr **dem Gewichtspeicher des Modells entsprechen**, da: Optimizer-Zustände weiterhin in hoher Präzision gespeichert werden und Aktivierungen ebenfalls in hoher Präzision gespeichert werden (vorerst). Unsere Ergebnisse stimmen mit der Theorie überein. Für LoRA-Fine-Tuning beobachteten wir: **\~30 GB eingespart** für **Qwen3-32B, \~14 GB eingespart** für **Qwen2.5-14B** und **\~8 GB eingespart** für **Qwen3-8B**
Für **BF16-LoRA-Fine-Tuning auf** Qwen3-32B traten bei höheren Batchgrößen OOMs auf und wir mussten den Batch verkleinern. Die **FP8-Variante hatte solche Probleme nicht**, und wir konnten **größere Batchgrößen** ohne OOMs zu bekommen.
Außerdem zur Erinnerung: In Unsloth teilen wir den Speicherbereich von vLLM für die Gewichte, wie in [Speichereffizientes RL](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md) - wir haben diesen Trick in den FP8-Bereich übernommen!
| 80-GB-GPU | Inferenz-Engine | Trainings-Engine |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | --------------------- | --------------------------------------------- |
| Modellgewichte | **8GB GETEILTES FP8** | **<<< GETEILT** |
|
Mehrzweck
72 GB Speicherplatz
| KV-Cache | Aktivierungen, Gradienten, Optimizer-Zustände |
Um zu aktivieren [Unsloth Standby](/docs/de/loslegen/reinforcement-learning-rl-guide/memory-efficient-rl.md) für FP8- (oder BF16-) RL fügen Sie einfach das Folgende vor jedem Unsloth-Import zu allen RL-/GRPO-Trainingsläufen hinzu:
```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1" # Unsloth-Standby spart 30%+ Speicher für RL
```
### :question:Wie man FP8-RL benutzt / Installation
Aktualisieren Sie einfach Unsloth oder installieren Sie Unsloth in einer neuen virtuellen Umgebung für H100, L4, RTX 50x, RTX 40x, H200s, B200s und jede NVIDIA-GPU (Consumer- oder Rechenzentrums-Klasse), die nach der RTX 4090 veröffentlicht wurde.
Um Unsloth zu aktualisieren: `pip install --upgrade --force-reinstall --no-cache-dir --no-deps unsloth unsloth_zoo`Oder eine neue Umgebung erstellen:
{% code overflow="wrap" %}
```bash
python -m venv unsloth_env
source unsloth_env/bin/activate
pip install unsloth vllm
pip install --pre torchao --index-url https://download.pytorch.org/whl/nightly/cu128 --force-reinstall
pip install --pre fbgemm-gpu fbgemm-gpu-genai --index-url https://download.pytorch.org/whl/cu128 --force-reinstall
pip install --upgrade numba numpy
```
{% endcode %}
Dann verwenden Sie `load_in_fp8 = True` und schon kann’s losgehen! Wir ordnen den Modellnamen automatisch der Float8-Variante zu, oder wir konvertieren das Modell im laufenden Betrieb zu Float8!
import os
os.environ['UNSLOTH_VLLM_STANDBY'] = "1" # Unsloth-Standby spart 30%+ Speicher für RL
from unsloth import FastLanguageModel
import torch
max_seq_length = 2048 # Kann für längere Reasoning-Traces erhöht werden
lora_rank = 32 # Größere Rank = intelligenter, aber langsamer
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B",
    max_seq_length = max_seq_length,
    load_in_4bit = False, # False für LoRA 16bit
    fast_inference = True, # vLLM-Schnellinferenz aktivieren
    max_lora_rank = lora_rank,
    load_in_fp8 = True, # Float8-RL / GRPO!
)
Zum Beispiel auf einer RTX 5090 (Erinnerung: setzen Sie `os.environ["UNSLOTH_VLLM_STANDBY"] = "1" # Unsloth-Standby spart 30%+ Speicher für RL` )
Dann verwenden Sie unsere 2 FP8-Notebooks für RL:
{% columns %}
{% column %}
**Qwen3-8B FP8 RL Colab**
{% embed url="" %}
{% endcolumn %}
{% column %}
**Llama-3.2-1B-FP8 RL Colab**
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
### :cd:Implementierung von FP8-Training
Unser erster Referenzpunkt war `transformers`, das FP8 bereits auf einige Arten unterstützt. Eine davon ist eine blockquantisierte Matmul-Implementierung: Wenn eine Schicht 16-Bit-Aktivierungen empfängt, quantisiert sie diese und übergibt sie an einen benutzerdefinierten FP8-Matmul-Kernel. Nachdem wir dies eingebunden und auf einem NVIDIA H100 benchmarked hatten, sahen wir das Gegenteil von dem, was wir wollten: Das Fine-Tuning wurde etwa **4× langsamer** als das standardmäßige BF16-Fine-Tuning.
### 🔥TorchAO-Kollaboration
Also haben wir mit dem [TorchAO](https://github.com/pytorch/ao) Team zusammengearbeitet (großer Dank an[ Andrew](https://github.com/unslothai/unsloth/pull/3440)) um TorchAOs FP8-Unterstützung in unsere RL-Workloads zu integrieren und sahen etwa **1,4× höheren Durchsatz** und bis zu **60 % weniger Modellspeicherverbrauch**. Auf hoher Ebene:
* Wir speichern die eingefrorenen LoRA-Gewichte in FP8.
* Während des Forward-Passes wenden wir dynamische FP8-Quantisierung auf die Eingabeaktivierungen an, während die trainierbaren LoRA-Adapter in BF16 bleiben.
* Diese FP8-Gewichte teilen sich dieselben Puffer wie die vLLM-Modellgewichte, sodass zu jedem Zeitpunkt nur eine einzige FP8-Kopie des Modells im Speicher ist (kein Speicher-Overhead durch ein „doppeltes Modell“).
* Im Backward-Pass dequantisieren wir die LoRA-Gewichte, sodass die gesamte Gradientenberechnung für bessere Genauigkeit in BF16 erfolgt.
Dieses allgemeine Setup funktioniert über alle unterstützten RL-Algorithmen hinweg, einschließlich [GSPO](/docs/de/loslegen/reinforcement-learning-rl-guide/advanced-rl-documentation/gspo-reinforcement-learning.md), Dr. GRPO, PPO und DPO.
TorchAO bietet PyTorch-nativen FP8-Support für Training und Inferenz und bietet eine Vielzahl von Skalierungsgranularitäten, einschließlich tensorweise, zeilenweise und 128x128-blockweise (Prototyp). TorchAOs FP8-Support kann den Inferenzdurchsatz um bis zu [1,64x bei 27B-Skalierung](https://huggingface.co/pytorch/gemma-3-27b-it-FP8/blob/main/README.md#results-h100-machine) mit zeilenweiser Skalierungsgranularität verbessern. Weitere Details finden Sie im TorchAO [FP8-README](https://github.com/pytorch/ao/blob/main/torchao/float8/README.md).
#### TorchAOs blockquantisierte FP8-Matmul
Wir verwendeten die blockquantisierte FP8-Matmul-Implementierung von TorchAO, die Folgendes lieferte:
* **80 % des BF16-Durchsatzes**
* ohne Verschlechterung von Verlust oder Trainingsstabilität
Eine Zeit lang wurde dies also unser standardmäßiges FP8-Matmul-Backend, bis FBGEMM aufholte - wir verwenden jetzt standardmäßig die Implementierung von FBGEMM, wenn Ihre GPU sie unterstützt! Die aktuelle Version von Unsloth kann automatisch das beste Backend basierend auf dem Installierten auswählen. Wenn Sie die richtigen Pakete haben, müssen Sie keine Performance verschenken 🙂
PS: Wir haben auch mit DeepSeeks DeepGEMM experimentiert, konnten es aber nicht vollständig End-to-End integrieren, um saubere Vergleiche eins zu eins durchzuführen.
### :bird:FP8-Quantisierung on the fly von TorchAO
Großer Dank an [Andrew](https://github.com/unslothai/unsloth/pull/3440) von TorchAO ermöglicht Unsloth FP8 RL außerdem, das Modell beim Laden on the fly zu quantisieren, indem die Quantisierung innerhalb der Modellladezeit durchgeführt und an vLLM weitergegeben wird. Auf diese Weise müssen Sie das Modell nicht explizit selbst quantisieren (wir erledigen das für Sie). Sie können dies tun, indem Sie `load_in_fp8 = True` in den Modelllade-Argumenten setzen, und es führt Offline-FP8 durch, wenn wir keinen geeigneten vorquantisierten Checkpoint finden.
```python
from unsloth import FastLanguageModel
fp8_model = FastLanguageModel.from_pretrained(
"unsloth/Llama-3.3-70B-Instruct", # Kann jeder Modellname sein!
load_in_fp8 = True, # Kann "block" für Block-FP8 sein, True für Zeilen-FP8, False
)
```
### :tada:Unsloth-FP8-Uploads
Zur Bequemlichkeit haben wir FP8 Dynamic- und FP8 Block-Modelle auf Hugging Face hochgeladen. Sie können sie für FP8-Training oder auch effiziente & schnelle Bereitstellung/Deployment über [vLLM](/docs/de/grundlagen/inference-and-deployment/vllm-guide.md)/[SGLang](/docs/de/grundlagen/inference-and-deployment/sglang-guide.md) usw.
FP8 Dynamic bietet etwas schnelleres Training und geringeren VRAM-Verbrauch als FP8 Block, jedoch mit einem kleinen Genauigkeitskompromiss. [Hier ansehen](/docs/de/loslegen/unsloth-model-catalog.md#fp8) für unsere vollständige Liste der FP8-Quants, aber hier die beliebtesten:
| Modell | FP8-Uploads |
| --------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Qwen3 (2507)** |
|
### :person\_tipping\_hand:Danksagungen
Ein riesiges Dankeschön an das gesamte PyTorch- und TorchAO-Team für ihre Hilfe und Zusammenarbeit! Ein riesiges Dankeschön insbesondere an: Andrew Or, Jerry Zhang, Supriya Rao, Scott Roy und Mergen Nachin für die Hilfe bei vielen Diskussionen über FP8-RL und dabei, es in Unsloth zu integrieren! Auch danke an das Executorch-Team!
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/loslegen/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.