> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md).

# Leitfaden zu Hyperparametern für LoRA-Fine-Tuning

Lerne Schritt für Schritt die besten Einstellungen für das LLM-Fine-Tuning – LoRA-Rang und -Alpha, Epochen, Batchgröße + Gradientenakkumulation, QLoRA vs. LoRA, Zielmodule und mehr.

LoRA-Hyperparameter sind einstellbare Parameter, die steuern, wie Low-Rank Adaptation [feinabstimmt](/docs/de/loslegen/fine-tuning-llms-guide.md) LLMs. Bei vielen Auswahlmöglichkeiten (z. B. Lernrate und Epochen) und unzähligen Kombinationen ist die Wahl der richtigen Werte entscheidend für Genauigkeit, Stabilität, Qualität und weniger Halluzinationen. Gut umgesetzt, **kann LoRA die Leistung des vollständigen Fine-Tunings erreichen** und dabei 4× weniger VRAM verwenden.

Du lernst die Best Practices für diese Parameter kennen, basierend auf Erkenntnissen aus Hunderten von Forschungsarbeiten und Experimenten, und siehst, wie sie sich auf das Modell auswirken. **Auch wenn wir empfehlen, Unsloths Standardwerte zu verwenden**, wirst du durch das Verständnis dieser Konzepte die volle Kontrolle erhalten.\
\
Das Ziel ist es, Hyperparameter-Werte so zu ändern, dass die Genauigkeit steigt, während [**Überanpassung oder Unteranpassung**](#overfitting-poor-generalization-too-specialized)entgegengewirkt wird. Überanpassung tritt auf, wenn das Modell die Trainingsdaten auswendig lernt und dadurch seine Fähigkeit beeinträchtigt wird, auf neue, ungesehene Eingaben zu verallgemeinern. Das Ziel ist ein Modell, das gut verallgemeinert, nicht eines, das einfach nur auswendig lernt.

{% columns %}
{% column %}

#### :question:Aber was ist LoRA?

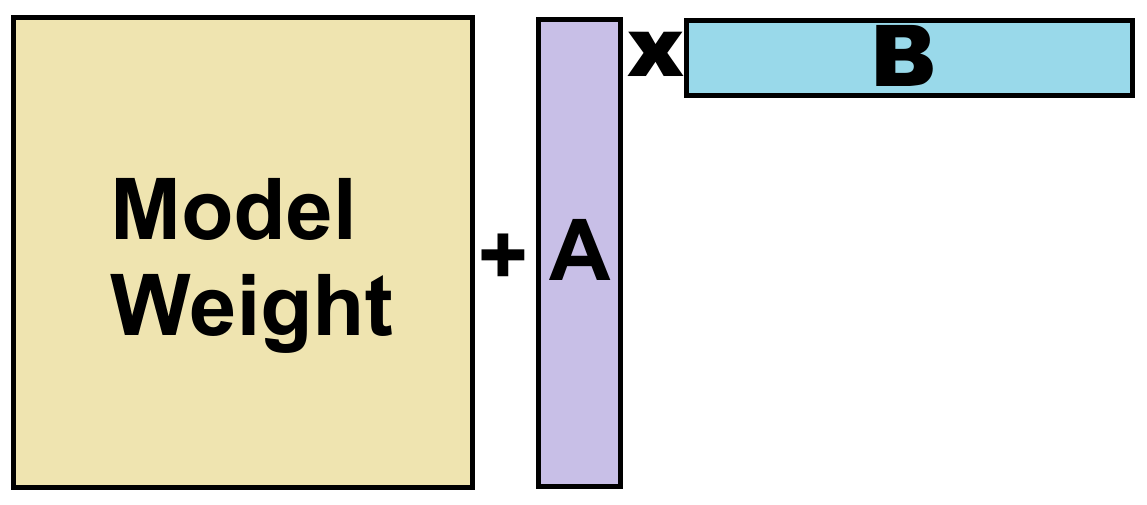
In LLMs haben wir Modellgewichte. Llama 70B hat 70 Milliarden Zahlen. Anstatt alle 70b Zahlen zu ändern, fügen wir stattdessen zu jedem Gewicht dünne Matrizen A und B hinzu und optimieren diese. Das bedeutet, dass wir nur 1 % der Gewichte optimieren.
{% endcolumn %}

{% column %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>Anstatt Modellgewichte (gelb) zu optimieren, optimieren wir 2 dünne Matrizen A und B.</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

## :1234: Wichtige Hyperparameter für das Fine-Tuning

### **Lernrate**

Legt fest, wie stark die Gewichte des Modells während jedes Trainingsschritts angepasst werden.

* **Höhere Lernraten**: Führen zu einer schnelleren anfänglichen Konvergenz, können aber dazu führen, dass das Training instabil wird oder kein optimales Minimum findet, wenn sie zu hoch eingestellt sind.
* **Niedrigere Lernraten**: Führen zu einem stabileren und präziseren Training, können aber mehr Epochen bis zur Konvergenz erfordern, was die gesamte Trainingszeit erhöht. Obwohl niedrige Lernraten oft als Ursache für Unteranpassung angesehen werden, können sie tatsächlich zu **Überanpassung** führen oder das Modell sogar daran hindern, zu lernen.
* **Typischer Bereich**: `2e-4` (0,0002) bis `5e-6` (0.000005).\
  :green\_square: ***Für normales LoRA/QLoRA-Fine-Tuning***, *empfehlen wir* **`2e-4`** *als Ausgangspunkt.*\
  :blue\_square: ***Für Reinforcement Learning** (DPO, GRPO usw.) empfehlen wir* **`5e-6` .**\
  :white\_large\_square: ***Für Full Fine-Tuning** sind niedrigere Lernraten im Allgemeinen angemessener.*

### **Epochen**

Die Anzahl der Male, die das Modell den vollständigen Trainingsdatensatz sieht.

* **Mehr Epochen:** Kann dem Modell helfen, besser zu lernen, aber eine hohe Anzahl kann dazu führen, dass es **die Trainingsdaten auswendig lernt**und dadurch seine Leistung bei neuen Aufgaben beeinträchtigt.
* **Weniger Epochen:** Verkürzt die Trainingszeit und kann Überanpassung verhindern, kann aber zu einem unzureichend trainierten Modell führen, wenn die Anzahl nicht ausreicht, damit das Modell die zugrunde liegenden Muster des Datensatzes lernt.
* **Empfohlen:** 1–3 Epochen. Für die meisten instruktionbasierten Datensätze bringt das Training über mehr als 3 Epochen nur noch abnehmenden Nutzen und erhöht das Risiko der Überanpassung.

### **LoRA oder QLoRA**

LoRA verwendet 16-Bit-Präzision, während QLoRA ein 4-Bit-Fine-Tuning-Verfahren ist.

* **LoRA:** 16-Bit-Fine-Tuning. Es ist etwas schneller und etwas genauer, verbraucht aber deutlich mehr VRAM (4× mehr als QLoRA). Empfohlen für 16-Bit-Umgebungen und Szenarien, in denen maximale Genauigkeit erforderlich ist.
* **QLoRA:** 4-Bit-Fine-Tuning. Etwas langsamer und geringfügig weniger genau, verwendet aber viel weniger VRAM (4× weniger).\
  :sloth: *70B LLaMA passt mit QLoRA in Unsloth in <48 GB VRAM -* [*mehr Details hier*](https://unsloth.ai/blog/llama3-3)*.*

### Hyperparameter & Empfehlungen:

<table><thead><tr><th width="154.39678955078125">Hyperparameter</th><th width="383.6192626953125">Funktion</th><th>Empfohlene Einstellungen</th></tr></thead><tbody><tr><td><strong>LoRA-Rang</strong> (<code>r</code>)</td><td>Steuert die Anzahl der trainierbaren Parameter in den LoRA-Adapter-Matrizen. Ein höherer Rang erhöht die Modellkapazität, verbraucht aber auch mehr Speicher.</td><td>8, 16, 32, 64, 128<br><br>Wähle 16 oder 32</td></tr><tr><td><strong>LoRA-Alpha</strong> (<code>lora_alpha</code>)</td><td>Skaliert die Stärke der feinabgestimmten Anpassungen im Verhältnis zum Rang (<code>r</code>).</td><td><code>r</code> (Standard) oder <code>r * 2</code> (gängige Heuristik). <a href="#lora-alpha-and-rank-relationship">Mehr Details hier</a>.</td></tr><tr><td><strong>LoRA-Dropout</strong></td><td>Eine Regularisierungstechnik, die während des Trainings zufällig einen Anteil der LoRA-Aktivierungen auf null setzt, um Überanpassung zu verhindern. <strong>Nicht besonders nützlich</strong>, deshalb setzen wir es standardmäßig auf 0.</td><td>0 (Standard) bis 0,1</td></tr><tr><td><strong>Gewichtsabfall</strong></td><td>Ein Regularisierungsterm, der große Gewichte bestraft, um Überanpassung zu verhindern und die Generalisierung zu verbessern. Verwende keine zu großen Zahlen!</td><td>0,01 (empfohlen) - 0,1</td></tr><tr><td><strong>Warmup-Schritte</strong></td><td>Erhöht die Lernrate zu Beginn des Trainings schrittweise.</td><td>5–10 % der Gesamtsteps</td></tr><tr><td><strong>Scheduler-Typ</strong></td><td>Passt die Lernrate während des Trainings dynamisch an.</td><td><code>linear</code> oder <code>cosine</code></td></tr><tr><td><strong>Seed (<code>random_state</code>)</strong></td><td>Eine feste Zahl, um die Reproduzierbarkeit der Ergebnisse sicherzustellen.</td><td>Beliebige ganze Zahl (z. B., <code>42</code>, <code>3407</code>)</td></tr><tr><td><strong>Zielmodule</strong></td><td><p>Gib an, auf welche Teile des Modells du LoRA-Adapter anwenden möchtest — entweder auf Attention, das MLP oder beides.</p><p><br>Attention: <code>q_proj, k_proj, v_proj, o_proj</code><br><br>MLP: <code>gate_proj, up_proj, down_proj</code></p></td><td>Empfohlen ist, alle wichtigen linearen Schichten anzusprechen: <code>q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj</code>.</td></tr></tbody></table>

## :deciduous\_tree: Äquivalenz von Gradient Accumulation und Batchgröße

### Effektive Batchgröße

Die korrekte Konfiguration deiner Batchgröße ist entscheidend, um Trainingsstabilität mit den VRAM-Grenzen deiner GPU auszubalancieren. Dies wird durch zwei Parameter gesteuert, deren Produkt die **Effektive Batchgröße**.\
\
**Effektive Batchgröße** = `batch_size * gradient_accumulation_steps`

* Ein **größere effektive Batchgröße** führt im Allgemeinen zu einem glatteren, stabileren Training.
* Ein **kleinere effektive Batchgröße** kann mehr Varianz einführen.

Auch wenn jede Aufgabe anders ist, bietet die folgende Konfiguration einen hervorragenden Ausgangspunkt für das Erreichen einer stabilen **Effektive Batchgröße** von 16, was für die meisten Fine-Tuning-Aufgaben auf modernen GPUs gut funktioniert.

| Parameter                                                   | Beschreibung                                                                                                                                                                                                                                                                                                                  | Empfohlene Einstellung                        |
| ----------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------- |
| **Batch-Größe** (`batch_size`)                              | <p>Die Anzahl der Beispiele, die in einem einzelnen Forward-/Backward-Pass auf einer GPU verarbeitet werden.<br><br><strong>Haupttreiber des VRAM-Verbrauchs</strong>. Höhere Werte können die Hardware-Auslastung verbessern und das Training beschleunigen, aber nur, wenn sie in den Speicher passen.</p>                  | 2                                             |
| **Gradienten-Akkumulation** (`gradient_accumulation_steps`) | <p>Die Anzahl der Micro-Batches, die verarbeitet werden, bevor ein einzelnes Update der Modellgewichte durchgeführt wird.<br><br><strong>Haupttreiber der Trainingszeit.</strong> Ermöglicht die Simulation einer größeren <code>batch\_size</code> um VRAM zu sparen. Höhere Werte erhöhen die Trainingszeit pro Epoche.</p> | 8                                             |
| **Effektive Batchgröße** (Berechnet)                        | Die tatsächliche Batchgröße, die für jedes Gradienten-Update verwendet wird. Sie beeinflusst direkt die Trainingsstabilität, Qualität und die endgültige Modellleistung.                                                                                                                                                      | <p>4 bis 16<br>Empfohlen: 16 (aus 2 \* 8)</p> |

### Der VRAM- & Leistungs-Kompromiss

Angenommen, du möchtest 32 Datenbeispiele pro Trainingsschritt. Dann kannst du eine der folgenden Konfigurationen verwenden:

* `batch_size = 32, gradient_accumulation_steps = 1`
* `batch_size = 16, gradient_accumulation_steps = 2`
* `batch_size = 8, gradient_accumulation_steps = 4`
* `batch_size = 4, gradient_accumulation_steps = 8`
* `batch_size = 2, gradient_accumulation_steps = 16`
* `batch_size = 1, gradient_accumulation_steps = 32`

Auch wenn all diese für die Gewichtsaktualisierungen des Modells gleichwertig sind, haben sie sehr unterschiedliche Hardware-Anforderungen.

Die erste Konfiguration (`batch_size = 32`) verwendet den **meisten VRAM** und wird auf den meisten GPUs wahrscheinlich fehlschlagen. Die letzte Konfiguration (`batch_size = 1`) verwendet den **am wenigsten VRAM,** aber auf Kosten eines etwas langsameren Training&#x73;**.** Um OOM-Fehler (Out of Memory) zu vermeiden, bevorzuge immer, eine kleinere `batch_size` zu setzen und `gradient_accumulation_steps` zu erhöhen, um dein Ziel zu erreichen **Effektive Batchgröße**.

### :sloth: Unsloth-Fix für Gradient Accumulation

Gradient Accumulation und Batchgrößen <mark style="color:grün;">**sind in Unsloth jetzt vollständig äquivalent**</mark> aufgrund unserer Bugfixes für Gradient Accumulation. Wir haben spezifische Bugfixes für Gradient Accumulation implementiert, die ein häufiges Problem beheben, bei dem die beiden Methoden nicht dieselben Ergebnisse lieferten. Dies war eine bekannte Herausforderung in der breiteren Community, aber für Unsloth-Nutzer sind die beiden Methoden jetzt austauschbar.

[Lies unseren Blogbeitrag](https://unsloth.ai/blog/gradient) für weitere Details.

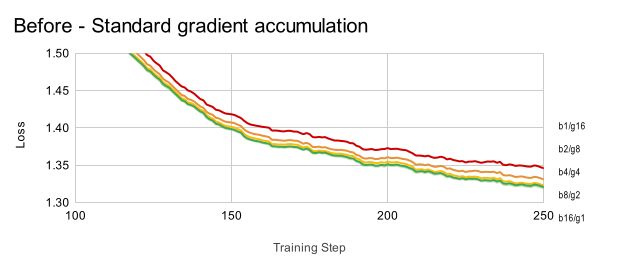
Vor unseren Fixes führten Kombinationen von `batch_size` und `gradient_accumulation_steps` die dasselbe **Effektive Batchgröße** (d. h., `batch_size × gradient_accumulation_steps = 16`) lieferten kein äquivalentes Trainingsverhalten. Zum Beispiel haben Konfigurationen wie `b1/g16`, `b2/g8`, `b4/g4`, `b8/g2`, und `b16/g1` alle eine **Effektive Batchgröße** von 16, aber wie im Diagramm gezeigt, stimmten die Loss-Kurven bei Verwendung von standardmäßiger Gradient Accumulation nicht überein:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-66eb907fd9ce38ab29dacef82794d0525057aeb4%2FBefore_-_Standard_gradient_accumulation_UQOFkUggudXuV9dzrh8MA.svg?alt=media" alt=""><figcaption><p>(Vorher - Standard-Gradient Accumulation)</p></figcaption></figure>

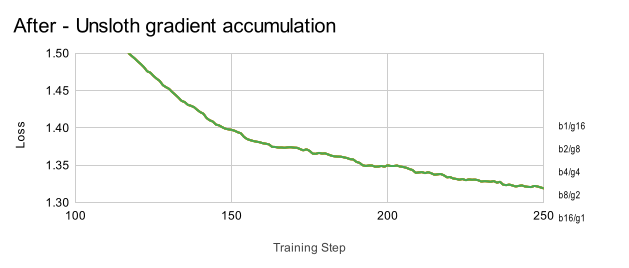
Nach Anwendung unserer Fixes stimmen die Loss-Kurven nun korrekt überein, unabhängig davon, wie die **Effektive Batchgröße** von 16 erreicht wird:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-61f7c60412a2a39584f75cce5dca41e3e35eb7f2%2FAfter_-_Unsloth_gradient_accumulation_6Y4pJdJF0vruzradUpymY.svg?alt=media" alt=""><figcaption><p>(Nachher - 🦥 <mark style="color:grün;">Unsloth Gradient Accumulation</mark>)</p></figcaption></figure>

## 🦥 **LoRA-Hyperparameter in Unsloth**

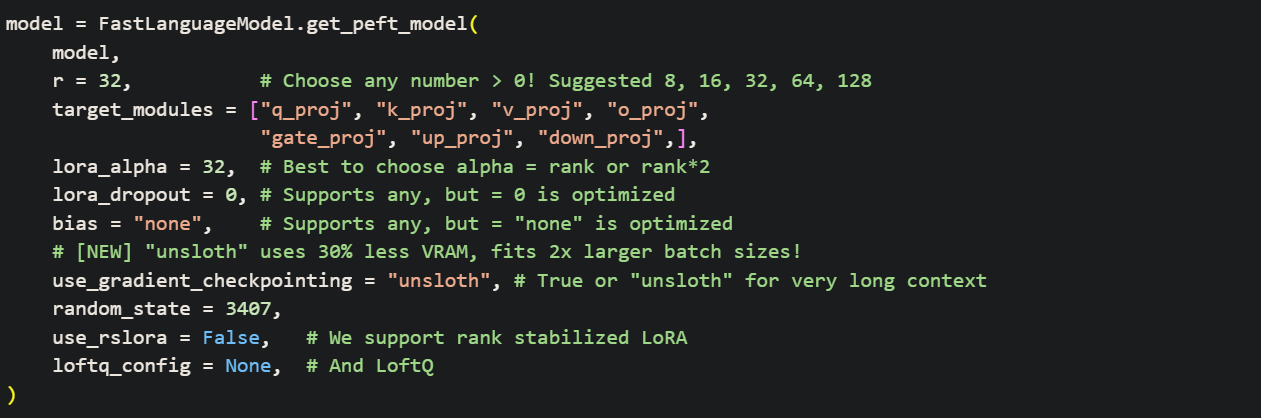
Das Folgende zeigt eine Standardkonfiguration. **Auch wenn Unsloth optimierte Standardwerte bereitstellt**, ist das Verständnis dieser Parameter entscheidend für die manuelle Feinabstimmung.

<div data-full-width="false"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9843f8cc26aac6445236250f5c32394186eace59%2Fnotebook_parameter_screenshott.png?alt=media" alt=""><figcaption></figcaption></figure></div>

1. ```python
   r = 16, # Wähle irgendeine Zahl > 0 ! Vorgeschlagen: 8, 16, 32, 64, 128
   ```

   Der Rang (`r`) des Fine-Tuning-Prozesses. Ein größerer Rang verbraucht mehr Speicher und ist langsamer, kann aber die Genauigkeit bei komplexen Aufgaben erhöhen. Wir empfehlen Ränge wie 8 oder 16 (für schnelle Fine-Tunes) und bis zu 128. Die Verwendung eines zu großen Rangs kann Überanpassung verursachen und die Qualität deines Modells beeinträchtigen.\\
2. ```python
   target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj",],
   ```

   Für optimale Leistung <mark style="background-color:blue;">**sollte LoRA auf alle wichtigen linearen Schichten angewendet werden**</mark>. [Die Forschung hat gezeigt](#lora-target-modules-and-qlora-vs-lora) dass das Ansprechen aller wichtigen Schichten entscheidend ist, um die Leistung des vollständigen Fine-Tunings zu erreichen. Auch wenn es möglich ist, Module zu entfernen, um den Speicherverbrauch zu verringern, raten wir davon dringend ab, um die maximale Qualität zu erhalten, da die Einsparungen minimal sind.\\
3. ```python
   lora_alpha = 16,
   ```

   Ein Skalierungsfaktor, der die Stärke der feinabgestimmten Anpassungen steuert. Ihn gleich dem Rang (`r`) zu setzen, ist eine zuverlässige Basis. Eine beliebte und effektive Heuristik ist, ihn auf das Doppelte des Rangs zu setzen (`r * 2`), wodurch das Modell aggressiver lernt, indem den LoRA-Updates mehr Gewicht gegeben wird. [Mehr Details hier](#lora-alpha-and-rank-relationship).\\
4. ```python
   lora_dropout = 0, # Unterstützt alles, aber = 0 ist optimiert
   ```

   Eine Regularisierungstechnik, die hilft, [Überanpassung zu verhindern](#overfitting-poor-generalization-too-specialized) indem bei jedem Trainingsschritt zufällig ein Anteil der LoRA-Aktivierungen auf null gesetzt wird. [Neuere Forschung legt nahe](https://arxiv.org/abs/2410.09692) dass für **die kurzen Trainingsläufe** die beim Fine-Tuning üblich sind, `lora_dropout` ein unzuverlässiger Regularisierer sein könnte.\
   🦥 *Der interne Code von Unsloth kann das Training optimieren, wenn* `lora_dropout = 0`*, wodurch es etwas schneller wird, aber wir empfehlen einen Wert ungleich null, wenn du Überanpassung vermutest.*\\\\
5. ```python
   bias = "none",    # Unterstützt alles, aber = "none" ist optimiert
   ```

   Lasse dies auf `"none"` für schnelleres Training und geringeren Speicherverbrauch. Diese Einstellung vermeidet das Training der Bias-Terme in den linearen Schichten, wodurch trainierbare Parameter mit wenig bis keinem praktischen Nutzen hinzugefügt werden.\\
6. ```python
   use_gradient_checkpointing = "unsloth", # True oder „unsloth“ für sehr langen Kontext
   ```

   Die Optionen sind `Wahr`, `Falsch`, und `"unsloth"`.\
   🦥 *Wir empfehlen* `"unsloth"` *da es den Speicherverbrauch um weitere 30 % reduziert und extrem lange Kontext-Fine-Tunes unterstützt. Mehr dazu findest du in* [*unserem Blogbeitrag zum Training mit langem Kontext*](https://unsloth.ai/blog/long-context)*.*\\\\
7. ```python
   random_state = 3407,
   ```

   Der Seed, um deterministische, reproduzierbare Läufe sicherzustellen. Training beinhaltet Zufallszahlen, daher ist das Setzen eines festen Seeds für konsistente Experimente unerlässlich.\\
8. ```python
   use_rslora = False,  # Wir unterstützen rank-stabilisiertes LoRA
   ```

   Eine erweiterte Funktion, die [**Rank-Stabilized LoRA**](https://arxiv.org/abs/2312.03732)implementiert. Wenn auf `Wahr`gesetzt wird, wird die effektive Skalierung zu `lora_alpha / sqrt(r)` anstelle des Standardwerts `lora_alpha / r`. Dies kann manchmal die Stabilität verbessern, insbesondere bei höheren Rängen. [Mehr Details hier](#lora-alpha-and-rank-relationship).\\
9. ```python
   loftq_config = None, # Und LoftQ
   ```

   Eine fortgeschrittene Technik, wie in [**LoftQ**](https://arxiv.org/abs/2310.08659)vorgeschlagen, initialisiert LoRA-Matrizen mit den obersten 'r' Singulärvektoren aus den vortrainierten Gewichten. Dies kann die Genauigkeit verbessern, kann aber zu einem erheblichen Speicheranstieg zu Beginn des Trainings führen.

### **Überprüfung der LoRA-Gewichtsaktualisierungen:**

Wenn du überprüfst, dass **LoRA** Adaptergewichte nach dem Fine-Tuning aktualisiert wurden, vermeide die Verwendung von **np.allclose()** für den Vergleich. Diese Methode kann subtile, aber bedeutende Änderungen übersehen, insbesondere in **LoRA A**, das mit kleinen Gauß-Werten initialisiert wird. Diese Änderungen werden bei großzügigen numerischen Toleranzen möglicherweise nicht als signifikant erkannt. Dank [der Mitwirkenden](https://github.com/unslothai/unsloth/issues/3035) für diesen Abschnitt.

Um Gewichtsaktualisierungen zuverlässig zu bestätigen, empfehlen wir:

* Die Verwendung von **Prüfsummen- oder Hash-Vergleiche** (z. B. MD5)
* Berechnung der **Summe der absoluten Differenzen** zwischen Tensoren
* Untersuchung von T**ensor-Statistiken** (z. B. Mittelwert, Varianz) manuell
* Oder Verwenden von **np.array\_equal()** wenn exakte Gleichheit erwartet wird

## :triangular\_ruler:Beziehung zwischen LoRA-Alpha und Rang

{% hint style="success" %}
Am besten setzt man `lora_alpha = 2 * lora_rank` oder `lora_alpha = lora_rank`
{% endhint %}

{% columns %}
{% column width="50%" %}
$$
\hat{W} = W + \frac{\alpha}{\text{rank}} \times AB
$$

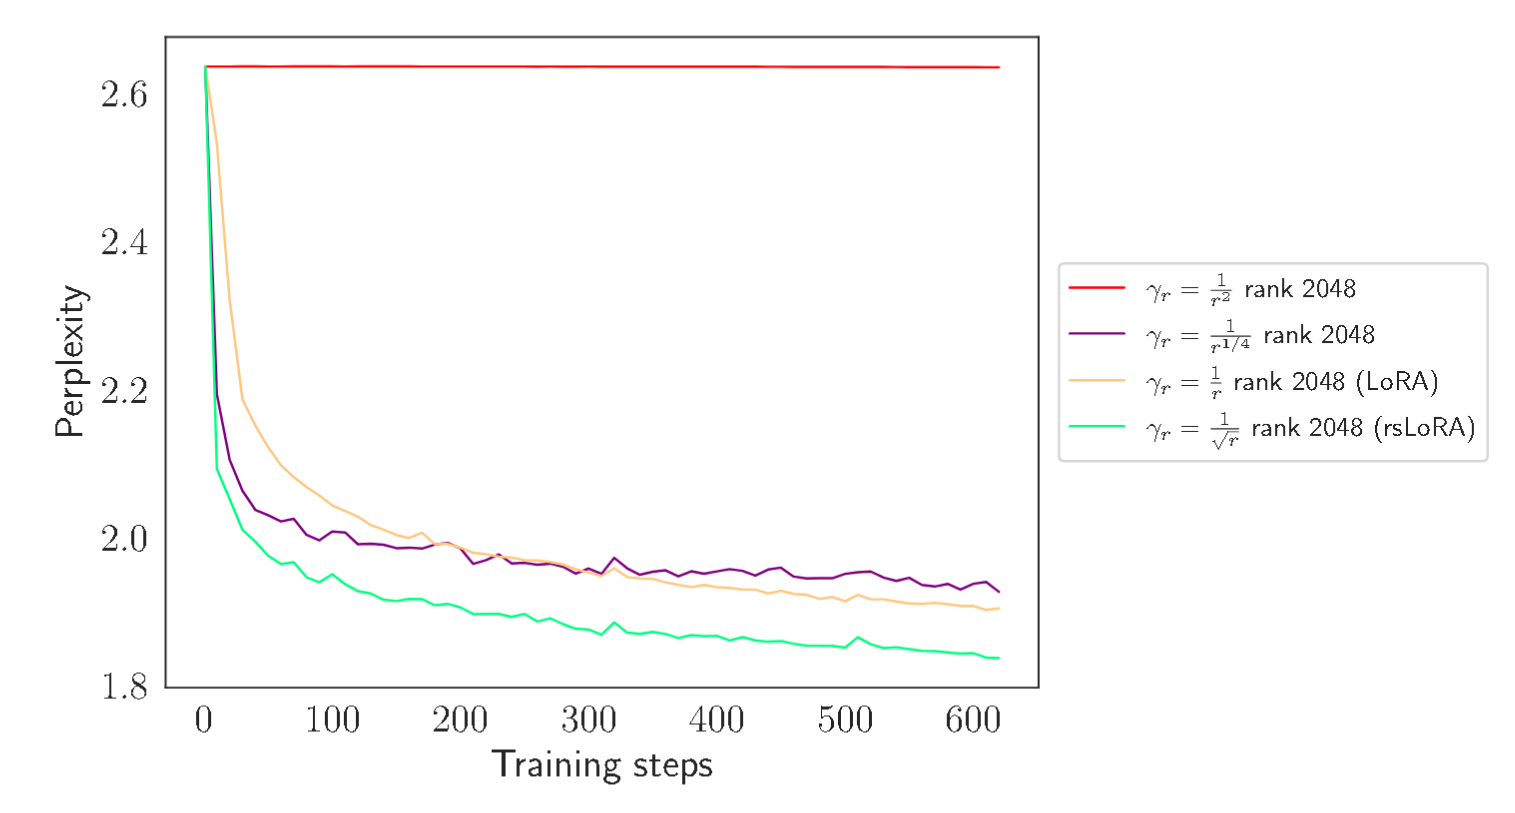
<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8e4f60c002f22e8ca9c534b48323e9e77e4b5ea6%2Fimage.png?alt=media" alt=""><figcaption><p>rsLoRA andere Skalierungsoptionen. sqrt(r) ist die beste.</p></figcaption></figure>

$$
\hat{W}\_{\text{rslora}} = W + \frac{\alpha}{\sqrt{\text{rank}}} \times AB
$$
{% endcolumn %}

{% column %}
Die Formel für LoRA steht links. Wir müssen die dünnen Matrizen A und B mit Alpha geteilt durch den Rang skalieren. <mark style="background-color:blue;">**Das bedeutet, dass wir alpha/rank mindestens = 1 halten sollten**</mark>.

Laut dem [rsLoRA-(Rank-Stabilized-LoRA-)Paper](https://arxiv.org/abs/2312.03732)sollten wir stattdessen Alpha mit der Quadratwurzel des Rangs skalieren. Andere Optionen existieren, aber theoretisch ist dies das Optimum. Das linke Diagramm zeigt andere Ränge und ihre Perplexities (niedriger ist besser). Um dies zu aktivieren, setze `use_rslora = True` in Unsloth.

Unsere Empfehlung ist, <mark style="background-color:green;">**alpha gleich dem Rang oder mindestens dem 2-fachen des Rangs zu setzen.**</mark> Das bedeutet alpha/rank = 1 oder 2.
{% endcolumn %}
{% endcolumns %}

## :dart: LoRA-Zielmodule und QLoRA vs. LoRA

{% hint style="success" %}
Verwende:\
`target_modules = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj",]` um sowohl **MLP** und **Attention** Schichten anzusprechen, um die Genauigkeit zu erhöhen.

**QLoRA verwendet 4-Bit-Präzision**, wodurch der VRAM-Verbrauch um über 75 % reduziert wird.

**LoRA (16-Bit)** ist etwas genauer und schneller.
{% endhint %}

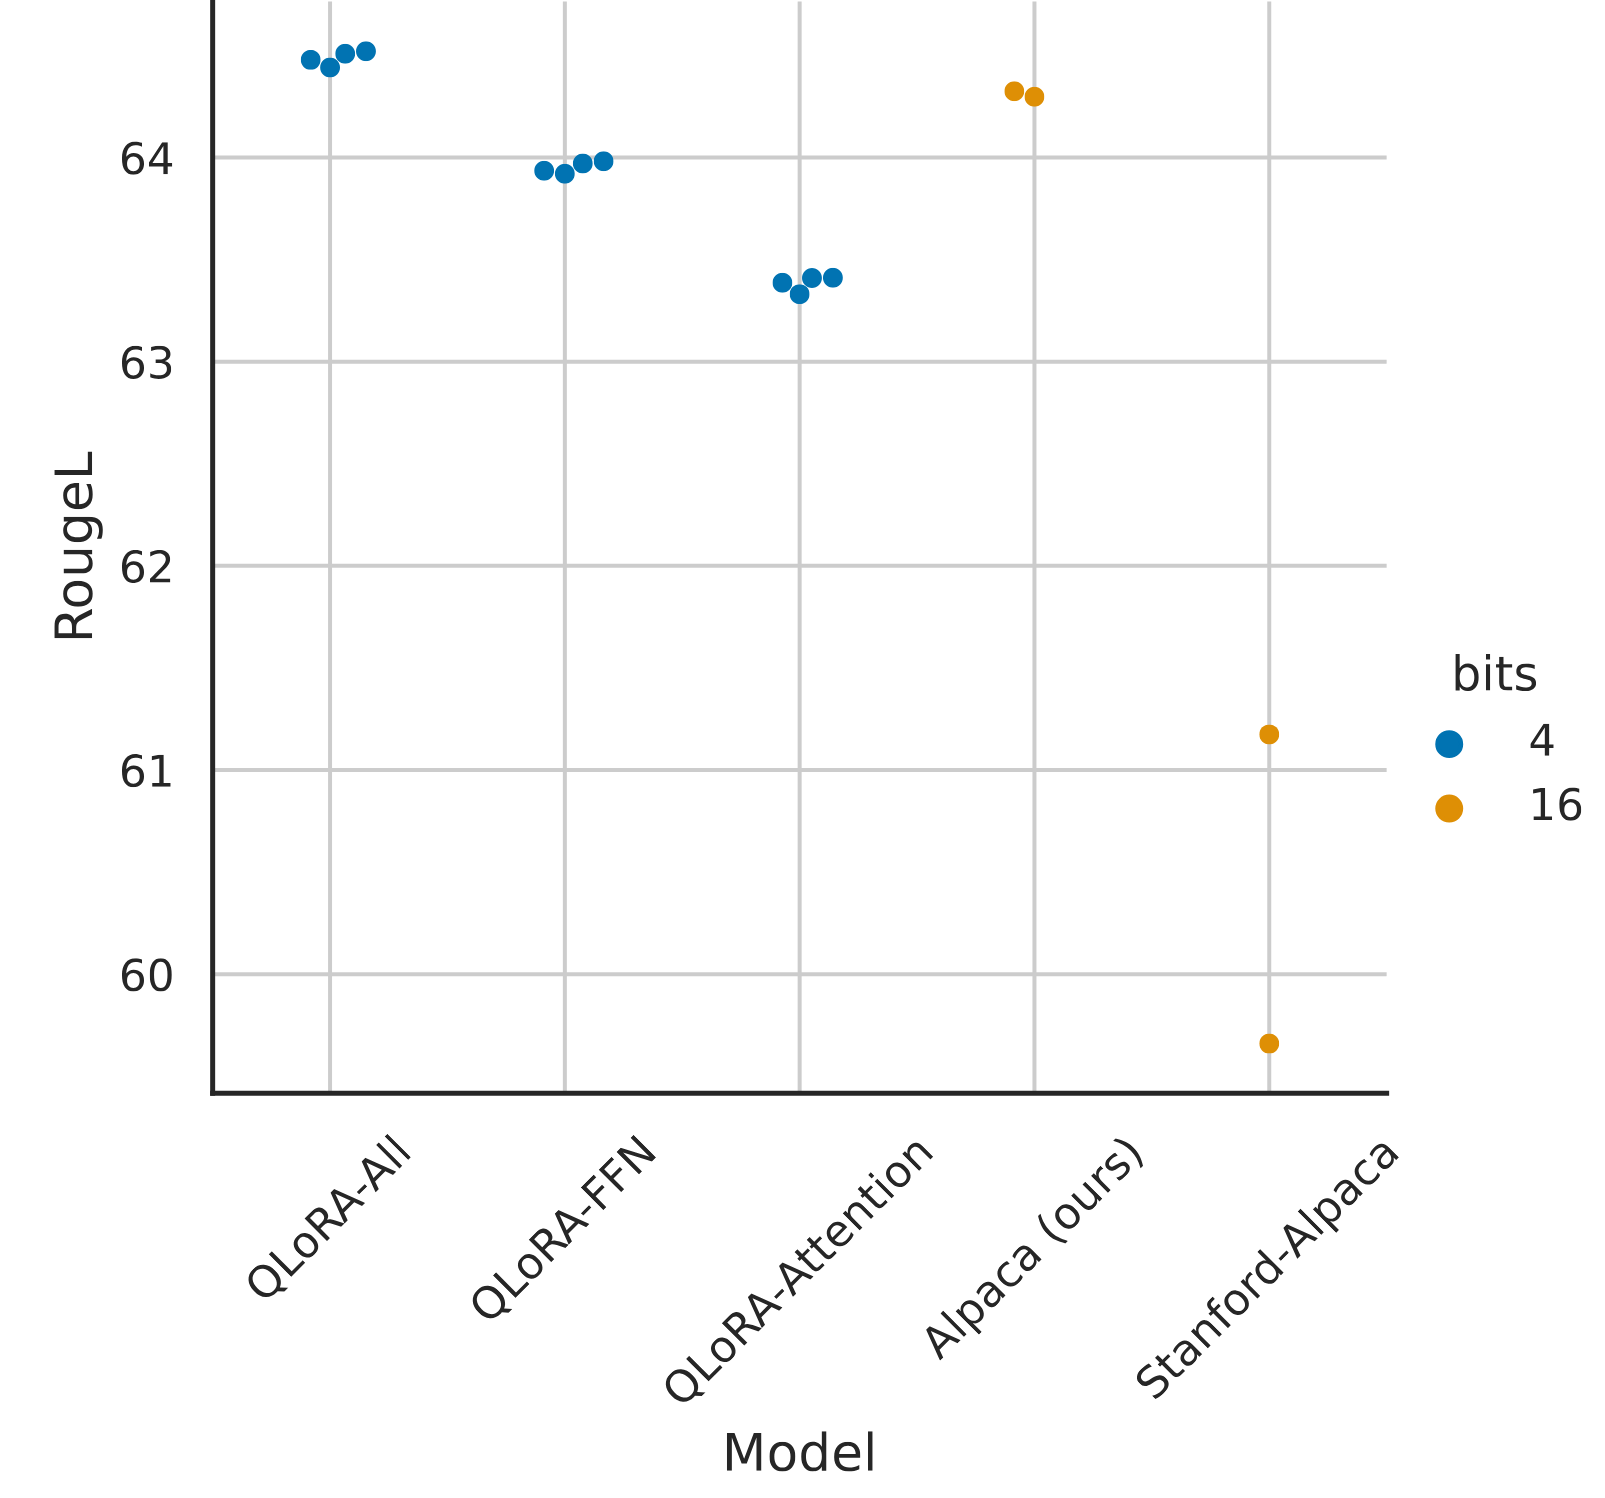
Laut empirischen Experimenten und Forschungsarbeiten wie dem ursprünglichen [QLoRA-Paper](https://arxiv.org/pdf/2305.14314)ist es am besten, LoRA sowohl auf Attention- als auch auf MLP-Schichten anzuwenden.

{% columns %}
{% column %}

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-16bef8165ccace21d0533f1941b8268a165c6a37%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
Das Diagramm zeigt RougeL-Werte (höher ist besser) für verschiedene Zielmodul-Konfigurationen und vergleicht LoRA mit QLoRA.

Die ersten 3 Punkte zeigen:

1. **QLoRA-All:** LoRA auf alle FFN/MLP- und Attention-Schichten angewendet.\
   :fire: *Dies schneidet insgesamt am besten ab.*
2. **QLoRA-FFN**: LoRA nur auf FFN.\
   Entspricht: `gate_proj`, `up_proj`, `down_proj.`
3. **QLoRA-Attention**: LoRA nur auf Attention-Schichten angewendet.\
   Entspricht: `q_proj`, `k_proj`, `v_proj`, `o_proj`.
   {% endcolumn %}
   {% endcolumns %}

## :sunglasses: Nur auf Abschlüssen trainieren, Eingaben maskieren

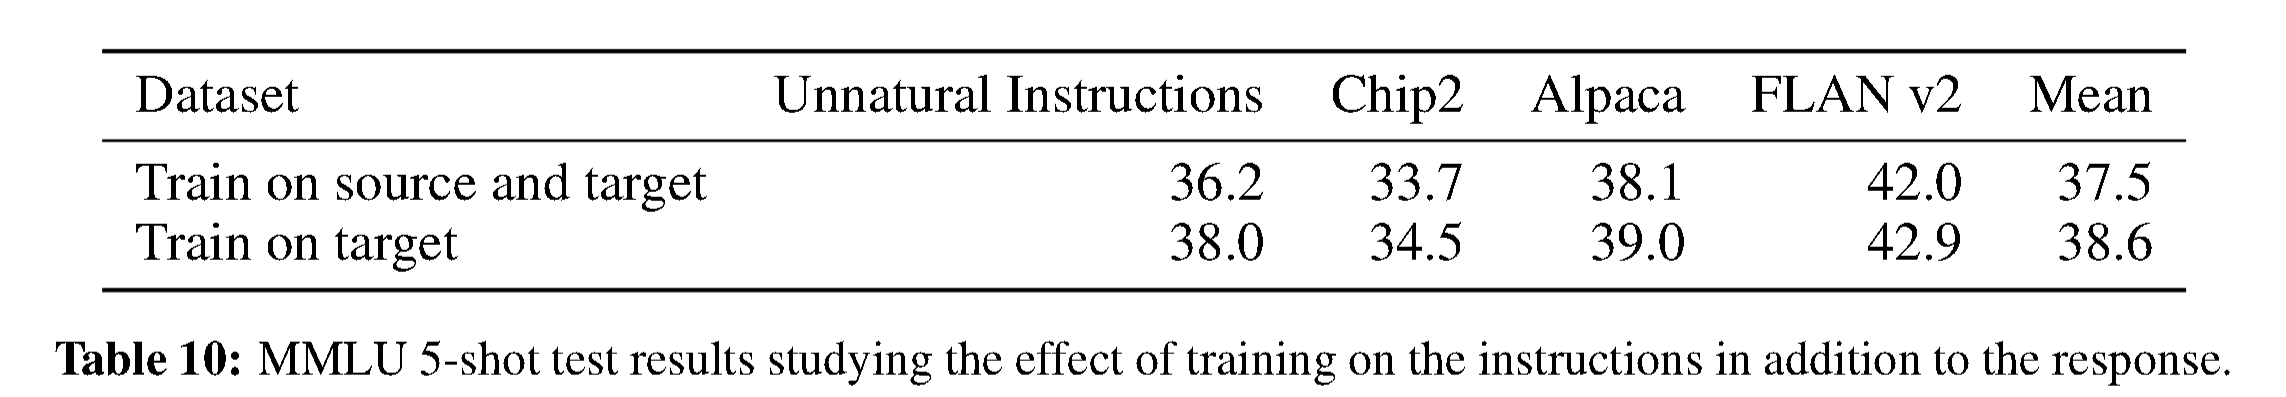
Der [QLoRA-Paper](https://arxiv.org/pdf/2305.14314) zeigt, dass das Maskieren von Eingaben und **das Training nur auf Abschlüssen** (Ausgaben oder Assistenten-Nachrichten) außerdem **die Genauigkeit erhöhen** um einige Prozentpunkte (*1%*). Unten wird gezeigt, wie das in Unsloth gemacht wird:

{% columns %}
{% column %}
**NICHT** Training nur auf Abschlüssen:

**BENUTZER:** <mark style="background-color:green;">Hallo, was ist 2+2?</mark>\
**ASSISTENT:** <mark style="background-color:green;">Die Antwort ist 4.</mark>\
**BENUTZER:** <mark style="background-color:green;">Hallo, was ist 3+3?</mark>\
**ASSISTENT:** <mark style="background-color:green;">Die Antwort ist 6.</mark>
{% endcolumn %}

{% column %}
**Training** nur auf Abschlüssen:

**BENUTZER:** ~~Hallo, was ist 2+2?~~\
**ASSISTENT:** <mark style="background-color:green;">Die Antwort ist 4.</mark>\
**BENUTZER:** ~~Hallo, was ist 3+3?~~\
**ASSISTENT:** <mark style="background-color:green;">Die Antwort ist 6</mark><mark style="background-color:green;">**.**</mark>
{% endcolumn %}
{% endcolumns %}

Das QLoRA-Paper besagt, dass **das Training nur auf Abschlüssen** die Genauigkeit erheblich erhöht, besonders bei mehrstufigen dialogbasierten Fine-Tunes! Wir tun dies in unseren [Konversations-Notebooks hier](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(1B_and_3B\)-Conversational.ipynb).

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e73b480d1db1dd3d52dd0d4a7e24caff6a54be0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Um zu aktivieren **Training auf Abschlüssen** in Unsloth musst du die Instruktions- und Assistententeile definieren. :sloth: *Wir planen, dies in Zukunft weiter für dich zu automatisieren!*

Für Llama-3-, 3.1-, 3.2-, 3.3- und 4-Modelle definierst du die Teile wie folgt:

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
)
```

Für Gemma-2-, 3-, 3n-Modelle definierst du die Teile wie folgt:

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<start_of_turn>user\n",
    response_part = "<start_of_turn>model\n",
)
```

## &#x20;:mag\_right:Training auf Assistentenantworten nur für Vision-Modelle, VLMs

Für Sprachmodelle können wir `from unsloth.chat_templates import train_on_responses_only` wie zuvor beschrieben verwenden. Für Vision-Modelle verwende die zusätzlichen Argumente als Teil von `UnslothVisionDataCollator` genauso wie zuvor!

{% code overflow="wrap" %}

```python
class UnslothVisionDataCollator:
def __init__(
    self,
    ...
    # from unsloth.chat_templates import train_on_responses_only
    # trainer = train_on_responses_only(
    #     trainer,
    #     instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    #     response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    # )
    train_on_responses_only = False, # ENTSPRICHT train_on_responses_only für LLMs
    instruction_part = None, # ENTSPRICHT train_on_responses_only(instruction_part = ...)
    response_part    = None, # ENTSPRICHT train_on_responses_only(response_part = ...)
    force_match      = True, # Auch Zeilenumbrüche abgleichen!
)
```

{% endcode %}

Zum Beispiel für Llama 3.2 Vision:

```python
UnslothVisionDataCollator(
    model, tokenizer,
    ...
    train_on_responses_only = True,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    ...
)
```

## :key: **Vermeidung von Overfitting & Underfitting**

### **Overfitting** (Schlechte Generalisierung / Zu spezialisiert)

Das Modell merkt sich die Trainingsdaten, einschließlich ihres statistischen Rauschens, und kann daher nicht auf unbekannte Daten verallgemeinern.

{% hint style="success" %}
Wenn dein Trainingsverlust unter 0.2 fällt, ist dein Modell wahrscheinlich **Überanpassung** — was bedeutet, dass es bei unbekannten Aufgaben schlecht abschneiden kann.

Ein einfacher Trick ist die LoRA-Alpha-Skalierung — multipliziere einfach den Alpha-Wert jeder LoRA-Matrix mit 0.5. Dadurch wird der Einfluss des Fine-Tunings effektiv verringert.

**Das steht in engem Zusammenhang mit dem Zusammenführen / Mitteln von Gewichten.**\
Du kannst das ursprüngliche Basis- (oder Instruct-) Modell nehmen, die LoRA-Gewichte hinzufügen und dann das Ergebnis durch 2 teilen. Das ergibt ein gemitteltes Modell — was funktional dem Reduzieren von `alpha` um die Hälfte entspricht.
{% endhint %}

**Lösung:**

* **Passe die Lernrate an:** Eine hohe Lernrate führt oft zu Overfitting, insbesondere bei kurzen Trainingsläufen. Für längeres Training kann eine höhere Lernrate besser funktionieren. Am besten experimentierst du mit beiden, um herauszufinden, was am besten funktioniert.
* **Reduziere die Anzahl der Trainings-Epochen**. Beende das Training nach 1, 2 oder 3 Epochen.
* **Erhöhe** `weight_decay`. Ein Wert von `0.01` oder `0.1` ist ein guter Ausgangspunkt.
* **Erhöhe** `lora_dropout`. Verwende einen Wert wie `0.1` um Regularisierung hinzuzufügen.
* **Erhöhe die Batch-Größe oder die Schritte der Gradientenakkumulation**.
* **Datenerweiterung** - mache deinen Datensatz größer, indem du Open-Source-Datensätze mit deinem Datensatz kombinierst oder verkettest. Wähle hochwertigere aus.
* **Frühes Stopping bei der Evaluation** - aktiviere die Evaluation und stoppe, wenn der Evaluationsverlust über einige Schritte ansteigt.
* **LoRA-Alpha-Skalierung** - skaliere alpha nach dem Training und während der Inferenz herunter - dadurch wird das Fine-Tuning weniger ausgeprägt.
* **Gewichtsmittelung** - füge buchstäblich das ursprüngliche Instruct-Modell und das Fine-Tuning zusammen und teile die Gewichte durch 2.

### **Unteranpassung** (Zu allgemein)

Das Modell schafft es nicht, die zugrunde liegenden Muster in den Trainingsdaten zu erfassen, oft aufgrund unzureichender Komplexität oder Trainingsdauer.

**Lösung:**

* **Passe die Lernrate an:** Wenn die aktuelle Rate zu niedrig ist, kann eine Erhöhung die Konvergenz beschleunigen, insbesondere bei kurzen Trainingsläufen. Für längere Läufe solltest du stattdessen versuchen, die Lernrate zu senken. Teste beide Ansätze, um zu sehen, welcher am besten funktioniert.
* **Erhöhe die Anzahl der Trainingsepochen:** Trainiere für mehr Epochen, aber überwache den Validierungsverlust, um Overfitting zu vermeiden.
* **Erhöhe den LoRA-Rang** (`r`) und alpha: Der Rang sollte mindestens der alpha-Zahl entsprechen, und der Rang sollte bei kleineren Modellen / komplexeren Datensätzen größer sein; er liegt normalerweise zwischen 4 und 64.
* **Verwende einen datensatzbezogeneren Datensatz**: Stelle sicher, dass die Trainingsdaten hochwertig und direkt relevant für die Zielaufgabe sind.
* **Verringere die Batch-Größe auf 1**. Dadurch wird das Modell stärkere Updates durchführen.

{% hint style="success" %}
Fine-Tuning hat keinen einzelnen „besten“ Ansatz, nur Best Practices. Experimentieren ist der Schlüssel, um herauszufinden, was für deine spezifischen Anforderungen funktioniert. Unsere Notebooks setzen automatisch optimale Parameter auf Basis vieler Paper, Forschung und unserer Experimente fest und geben dir damit einen großartigen Ausgangspunkt. Viel Spaß beim Fine-Tuning!
{% endhint %}

***Danksagungen:** Ein riesiges Dankeschön an* [*Eyera*](https://huggingface.co/Orenguteng) *für den Beitrag zu diesem Leitfaden!*


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.