> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md).

# Datensatz-Leitfaden

Erfahre, wie du einen Datensatz für das Fine-Tuning erstellst und vorbereitest.

## Was ist ein Datensatz?

Für LLMs sind Datensätze Sammlungen von Daten, die zum Trainieren unserer Modelle verwendet werden können. Damit sie für das Training nützlich sind, müssen Textdaten in einem Format vorliegen, das tokenisiert werden kann. Du wirst auch lernen, wie man [Datensätze in Unsloth verwendet](#applying-chat-templates-with-unsloth).

Einer der wichtigsten Teile beim Erstellen eines Datensatzes ist dein [Chatvorlagen-](/docs/de/grundlagen/chat-templates.md) und wie du ihn gestalten wirst. Auch die Tokenisierung ist wichtig, da sie Text in Tokens zerlegt, die Wörter, Wortteile oder Zeichen sein können, damit LLMs ihn effektiv verarbeiten können. Diese Tokens werden dann in Embeddings umgewandelt und angepasst, damit das Modell Bedeutung und Kontext versteht.

### Datenformat

Damit der Tokenisierungsprozess funktioniert, müssen Datensätze in einem Format vorliegen, das von einem Tokenizer gelesen werden kann.

<table data-full-width="false"><thead><tr><th>Format</th><th>Beschreibung</th><th>Trainingsart</th></tr></thead><tbody><tr><td>Rohkorpus</td><td>Rohtext aus einer Quelle wie einer Website, einem Buch oder einem Artikel.</td><td>Weiteres Vortraining (CPT)</td></tr><tr><td>Anweisung</td><td>Anweisungen, denen das Modell folgen soll, und ein Beispiel für die angestrebte Ausgabe.</td><td>Überwachtes Fine-Tuning (SFT)</td></tr><tr><td>Konversation</td><td>Mehrturniges Gespräch zwischen einem Benutzer und einem KI-Assistenten.</td><td>Überwachtes Fine-Tuning (SFT)</td></tr><tr><td>RLHF</td><td>Konversation zwischen einem Benutzer und einem KI-Assistenten, wobei die Antworten des Assistenten durch ein Skript, ein anderes Modell oder einen menschlichen Bewerter eingestuft werden.</td><td>Reinforcement Learning (RL)</td></tr></tbody></table>

{% hint style="info" %}
Es ist erwähnenswert, dass es für jeden dieser Typen verschiedene Formatstile gibt.
{% endhint %}

## Erste Schritte

Bevor wir unsere Daten formatieren, möchten wir Folgendes identifizieren:

{% stepper %}
{% step %} <mark style="color:grün;">Zweck des Datensatzes</mark>

Wenn wir den Zweck des Datensatzes kennen, können wir besser bestimmen, welche Daten wir brauchen und welches Format wir verwenden sollten.

Der Zweck könnte sein, ein Modell an eine neue Aufgabe wie Zusammenfassung anzupassen oder die Fähigkeit eines Modells zu verbessern, eine bestimmte Figur zu spielen. Zum Beispiel:

* Chat-basierte Dialoge (Q\&A, eine neue Sprache lernen, Kundensupport, Gespräche).
* Strukturierte Aufgaben ([Klassifizierung](https://colab.research.google.com/github/timothelaborie/text_classification_scripts/blob/main/unsloth_classification.ipynb)-, Zusammenfassungs- und Generierungsaufgaben).
* Fachspezifische Daten (Medizin, Finanzen, Technik).
  {% endstep %}

{% step %} <mark style="color:grün;">Ausgabestil</mark>

Der Ausgabestil sagt uns, welche Datenquellen wir verwenden werden, um unsere gewünschte Ausgabe zu erreichen.

Zum Beispiel könnte die Art der Ausgabe, die du erreichen möchtest, JSON, HTML, Text oder Code sein. Oder vielleicht soll sie Spanisch, Englisch oder Deutsch usw. sein.
{% endstep %}

{% step %} <mark style="color:grün;">Datenquelle</mark>

Wenn wir den Zweck und den Stil der benötigten Daten kennen, müssen wir die Qualität und [Menge](#how-big-should-my-dataset-be) der Daten analysieren. Hugging Face und Wikipedia sind großartige Quellen für Datensätze, und Wikipedia ist besonders nützlich, wenn du ein Modell so trainieren möchtest, dass es eine Sprache lernt.

Die Datenquelle kann eine CSV-Datei, ein PDF oder sogar eine Website sein. Du kannst auch [synthetisch generieren](#synthetic-data-generation) Daten, aber es ist besondere Sorgfalt erforderlich, um sicherzustellen, dass jedes Beispiel von hoher Qualität und relevant ist.
{% endstep %}
{% endstepper %}

{% hint style="success" %}
Eine der besten Möglichkeiten, einen besseren Datensatz zu erstellen, besteht darin, ihn mit einem allgemeinerem Datensatz von Hugging Face wie ShareGPT zu kombinieren, um dein Modell intelligenter und vielseitiger zu machen. Du könntest auch [synthetisch erzeugte Daten](#synthetic-data-generation).
{% endhint %}

## 🦥 Unsloth Data Recipes

[Unsloth-Datenrezepte](/docs/de/neu/studio/data-recipe.md) ermöglicht es Ihnen, Dokumente wie PDFs oder CSV-Dateien hochzuladen und sie in nutzbare Datensätze umzuwandeln. Erstellen und bearbeiten Sie Datensätze visuell über einen Graph-Node-Workflow.

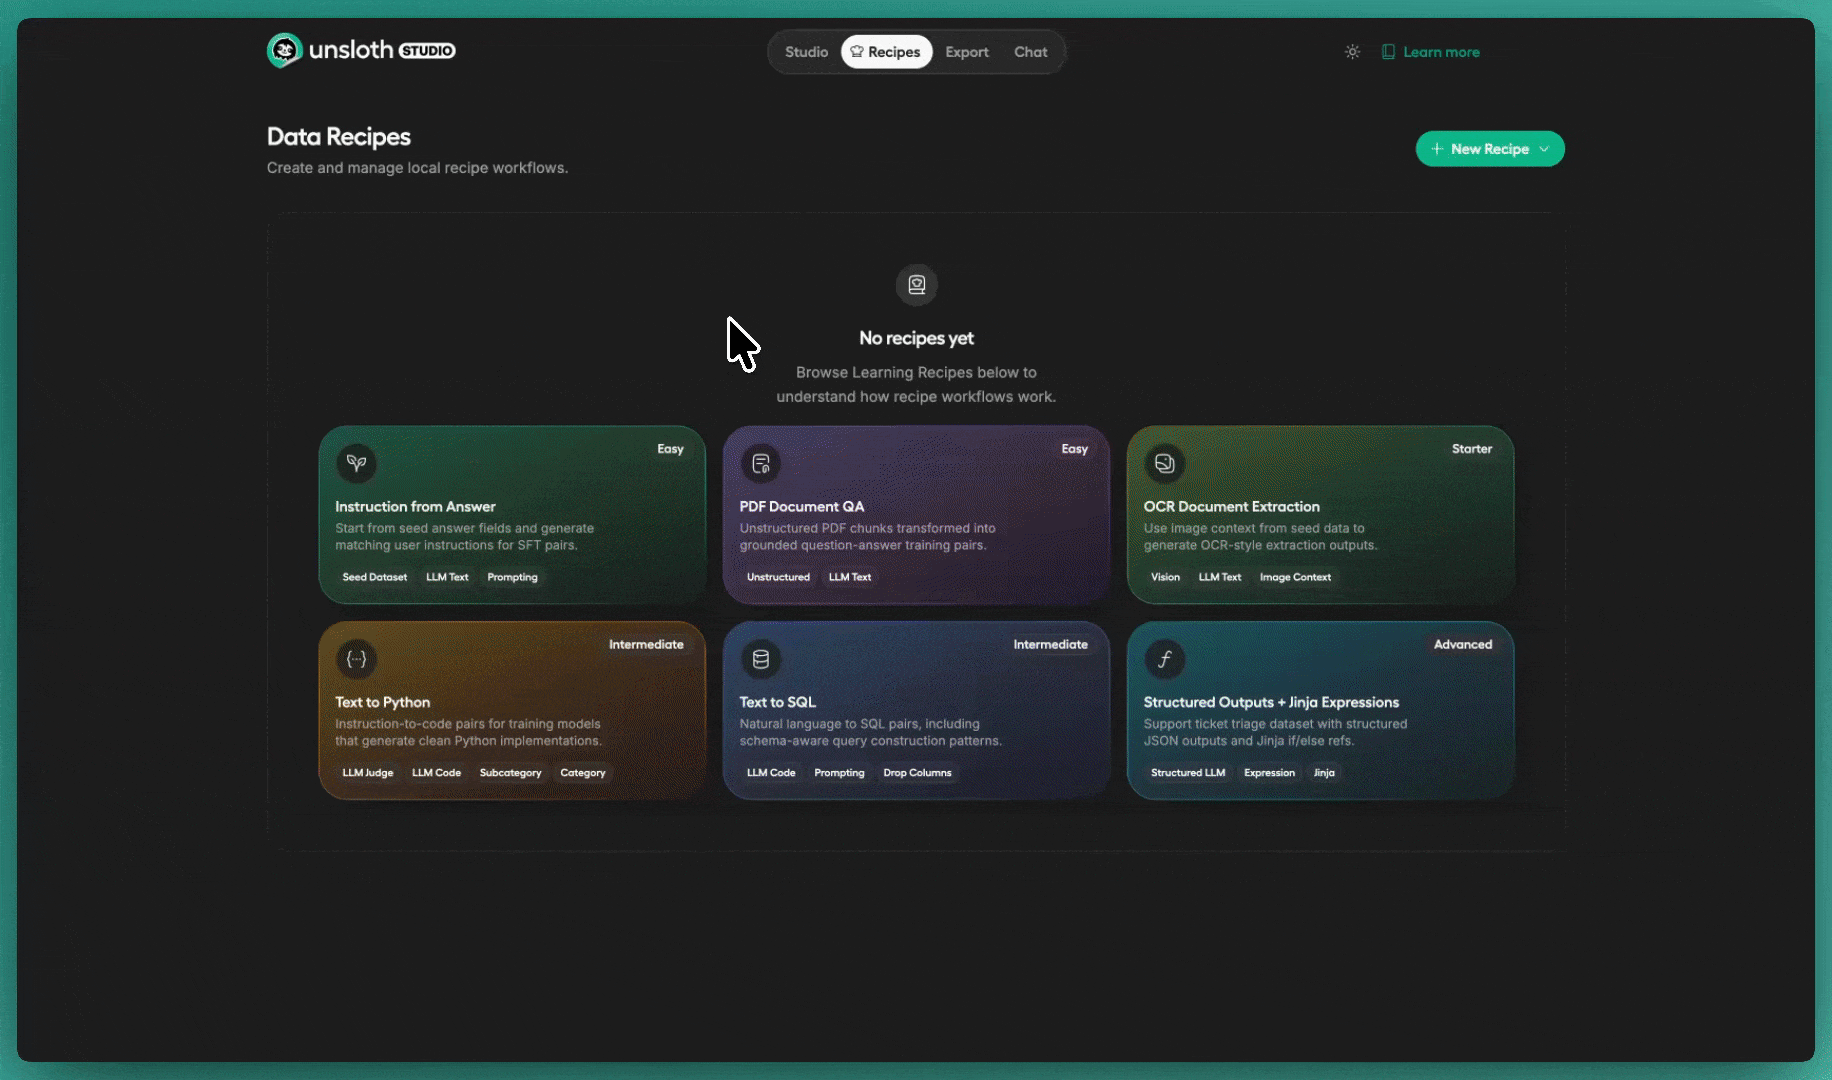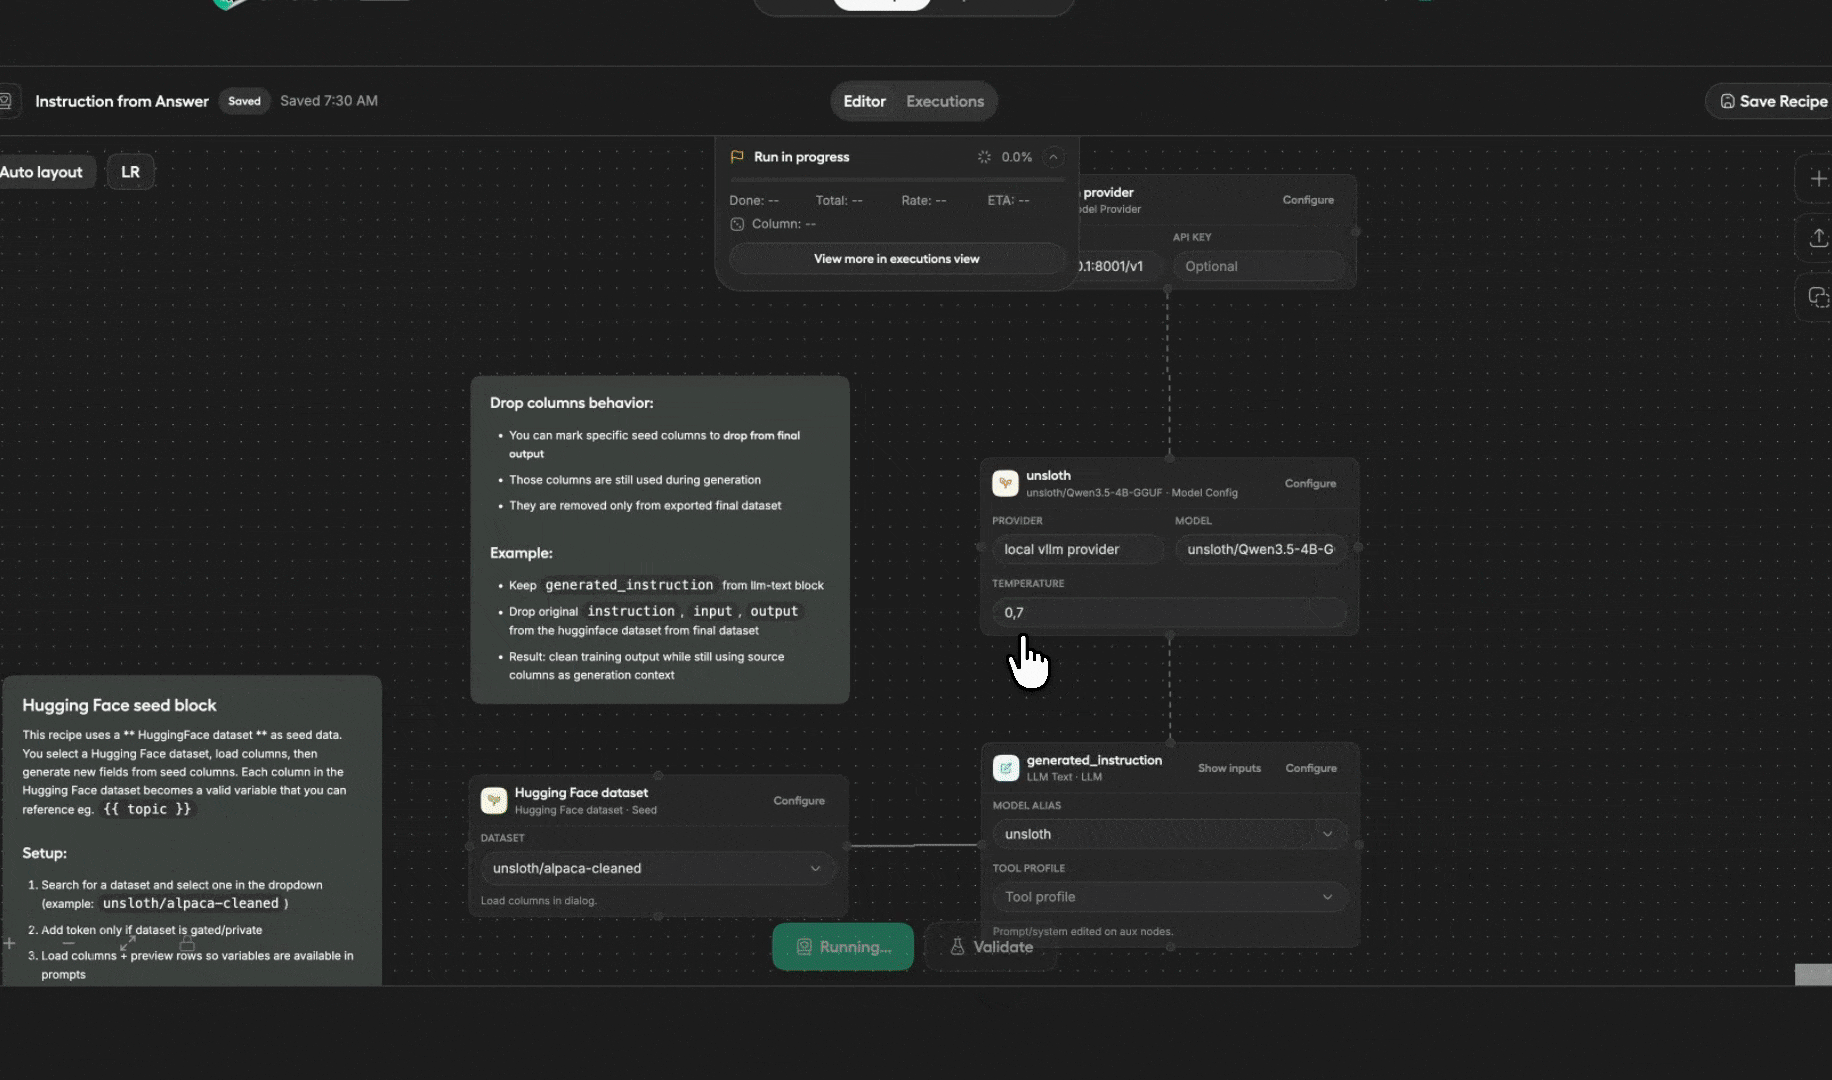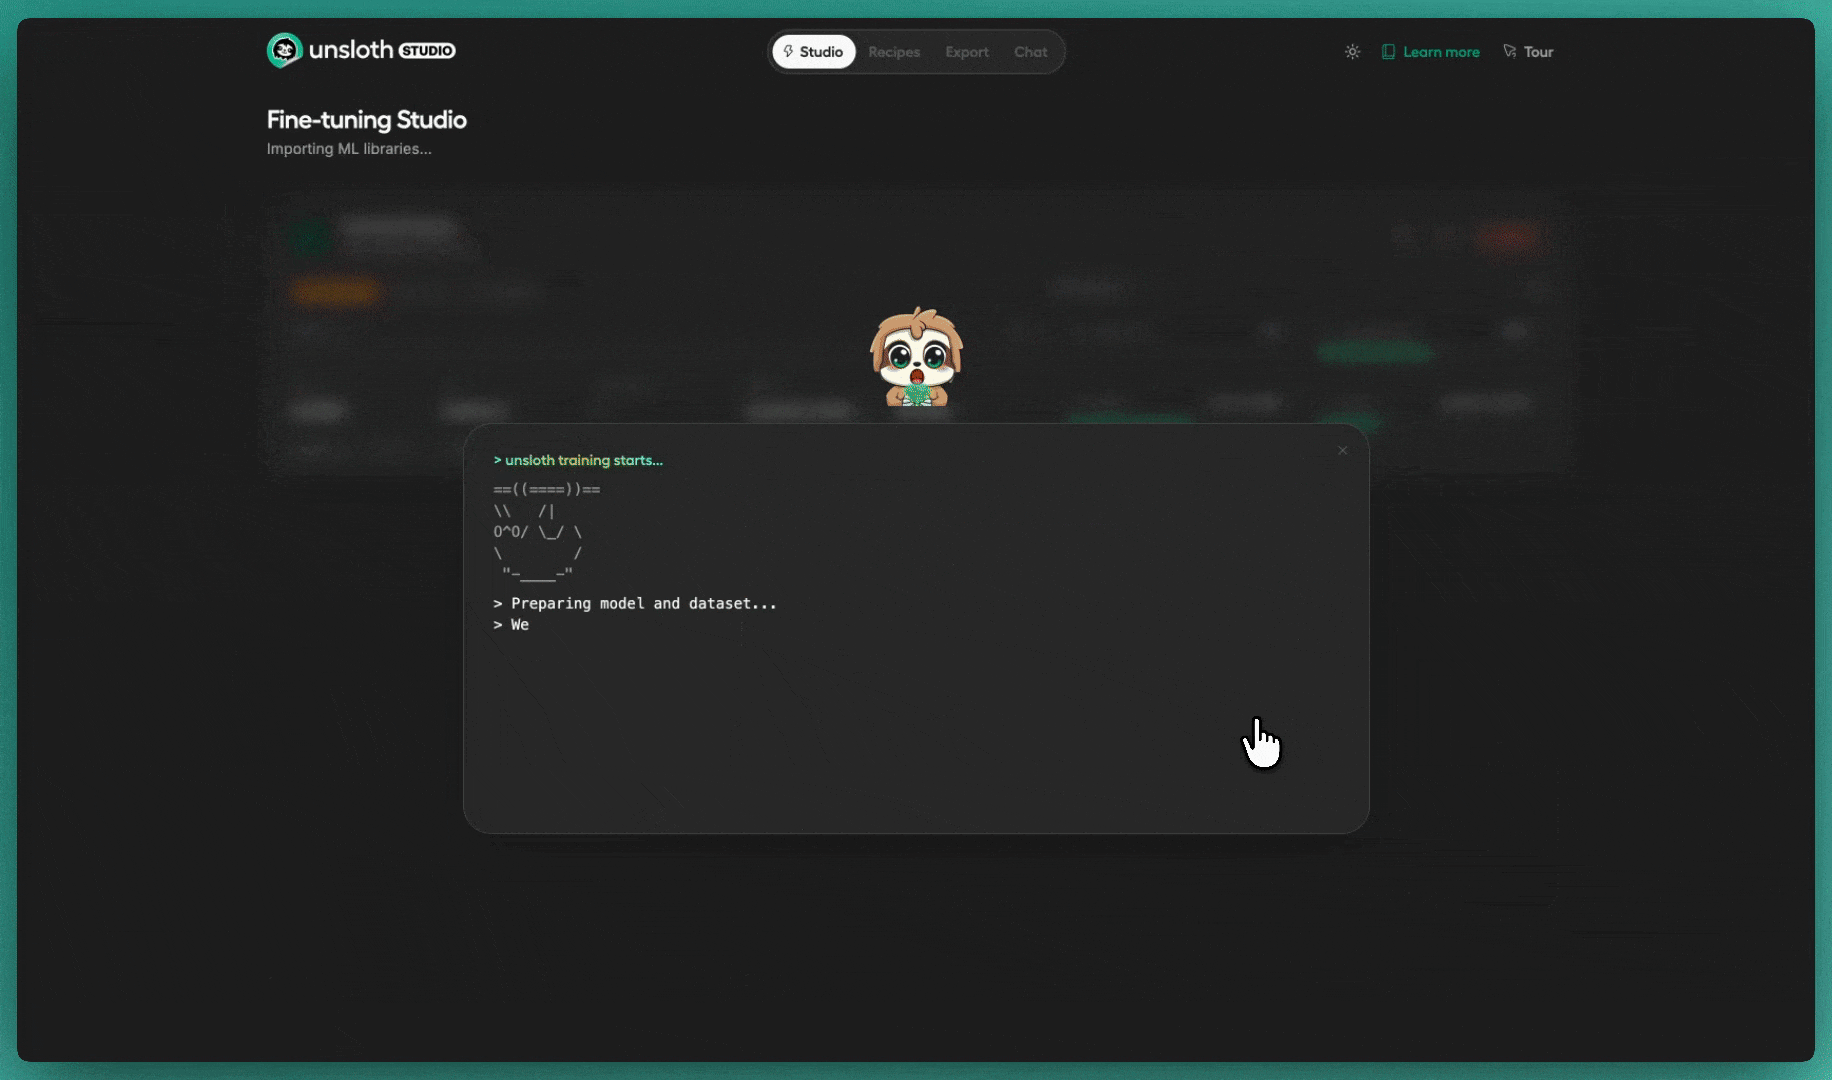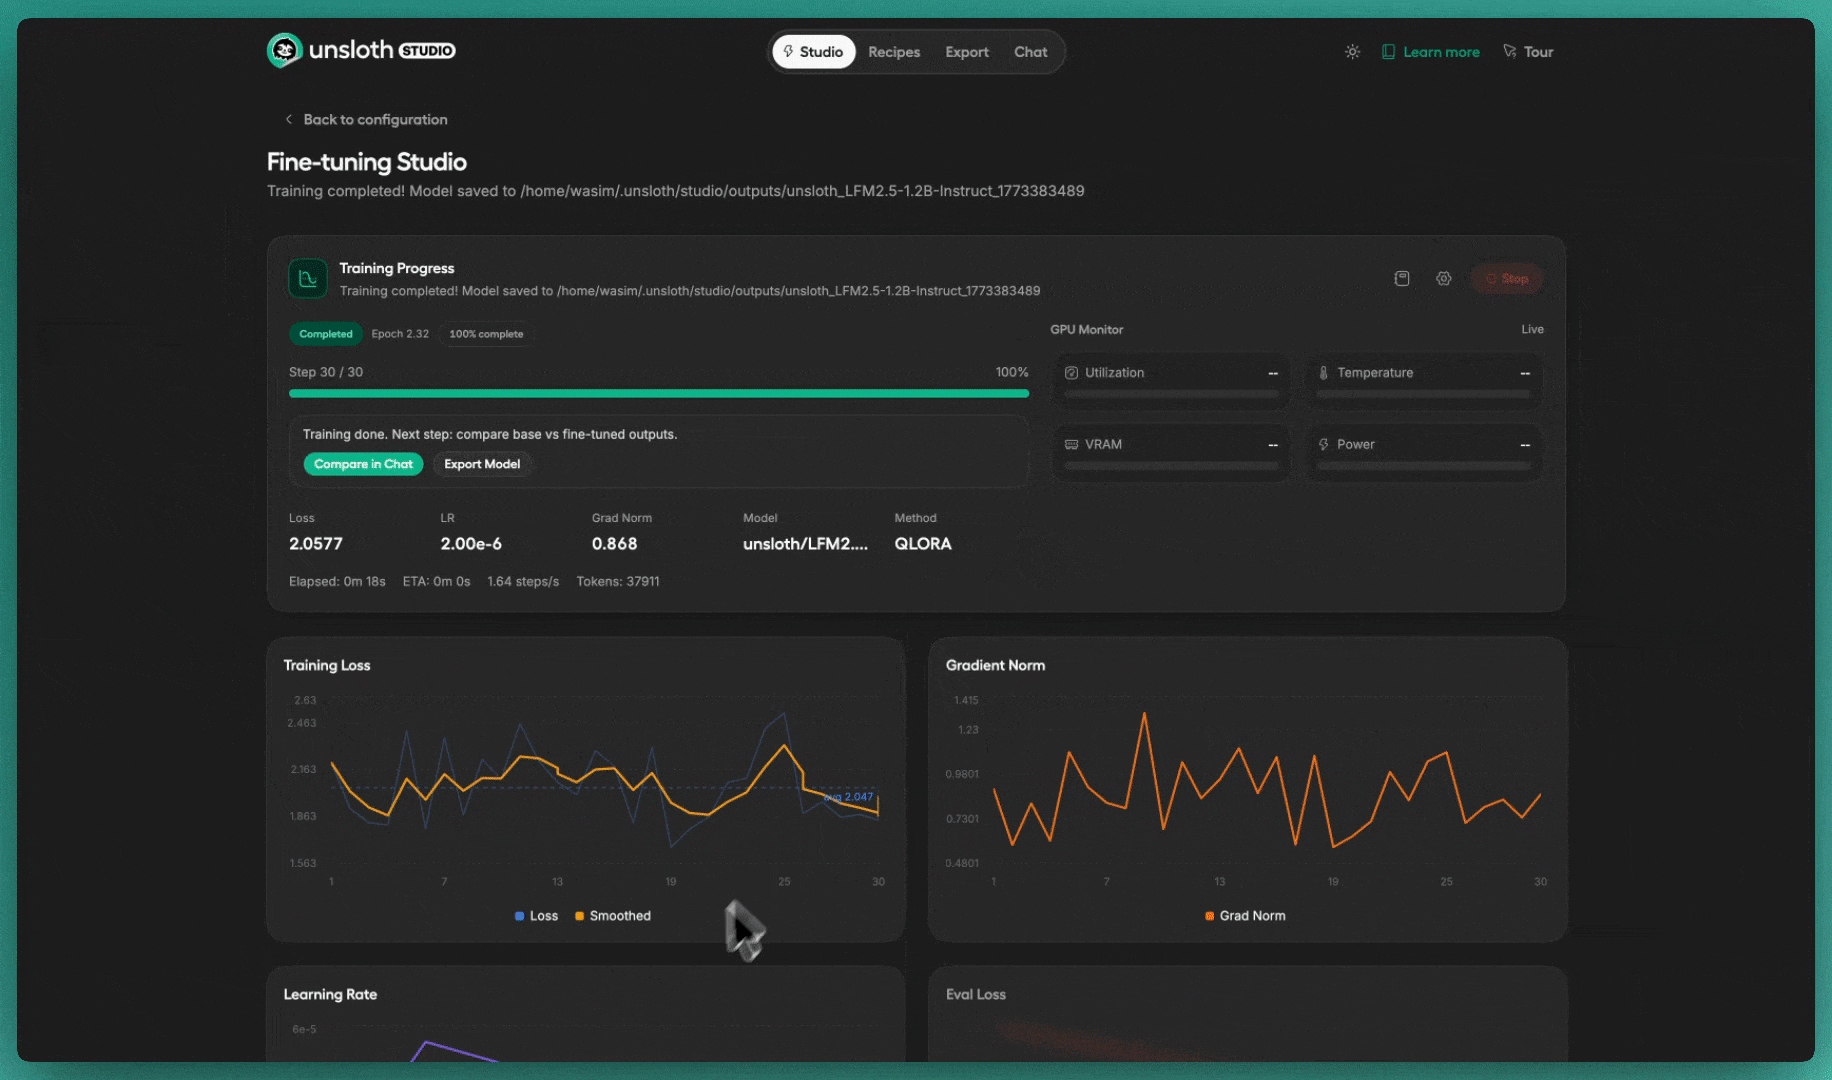
Die Rezepte-Seite ist der wichtigste Einstiegspunkt. Rezepte werden lokal im Browser gespeichert, sodass du später zu gespeicherten Arbeiten zurückkehren kannst. Von hier aus kannst du ein leeres Rezept erstellen oder ein geführtes Lernrezept öffnen.

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fc5m3JX1kUA3UwmdcJcxH%2FArea.gif?alt=media&amp;token=33bbd908-7d6c-456a-bc58-ce495c0adca1" alt=""><figcaption></figcaption></figure></div>

Data Recipes folgen demselben grundlegenden Ablauf. Du öffnest die Rezepte-Seite, erstellst oder wählst ein Rezept aus, baust den Workflow im Editor auf, validierst ihn, führst eine Vorschau aus und startest dann den vollständigen Datensatz, sobald die Ausgabe korrekt aussieht. Füge Seed-Daten und Generierungsblöcke hinzu, validiere den Workflow, sieh dir eine Beispielausgabe in der Vorschau an und führe dann einen vollständigen Datensatzaufbau aus.

Auf einen Blick sollte ein typischer Workflow so aussehen:

1. Öffne die Rezepte-Seite.
2. Erstelle ein neues Rezept oder öffne ein bestehendes.
3. Füge Blöcke hinzu, um deinen Datensatz-Workflow zu definieren.
4. Klicken Sie **Validieren** um Konfigurationsprobleme frühzeitig zu erkennen.
5. Führe eine Vorschau aus, um Beispielzeilen schnell zu prüfen.
6. Starte einen vollständigen Datensatzaufbau, wenn das Rezept fertig ist.
7. Überwache Fortschritt und Ausgabe live im Graphen oder in **Ausführungen** Ansicht für weitere Details.
8. Wähle den resultierenden Datensatz in Unsloth aus und feine-tune ein Modell. Mehr dazu:

{% content-ref url="/pages/dd9f9c69fff351709e4886e820d7d6facf3ec2b3" %}
[Data Recipes](/docs/de/neu/studio/data-recipe.md)
{% endcontent-ref %}

## Daten formatieren

Wenn wir die relevanten Kriterien identifiziert und die nötigen Daten gesammelt haben, können wir unsere Daten in ein maschinenlesbares Format bringen, das bereit für das Training ist.

### Gängige Datenformate für das LLM-Training

Für [**kontinuierliches Pretraining**](/docs/de/grundlagen/continued-pretraining.md)verwenden wir ein Rohtextformat ohne spezifische Struktur:

```json
  "text": "Pasta Carbonara ist ein traditionelles römisches Pastagericht. Die Sauce wird hergestellt, indem rohe Eier mit geriebenem Pecorino-Romano-Käse und schwarzem Pfeffer vermischt werden. Die heiße Pasta wird dann mit knusprigem Guanciale (gepökelte Schweinebacke) und der Eimischung vermengt, wodurch durch die Restwärme eine cremige Sauce entsteht. Entgegen der verbreiteten Meinung enthält echte Carbonara niemals Sahne oder Knoblauch. Das Gericht stammt vermutlich aus Rom aus der Mitte des 20. Jahrhunderts, obwohl seine genaue Herkunft umstritten ist..."
```

Dieses Format bewahrt den natürlichen Sprachfluss und ermöglicht es dem Modell, aus fortlaufendem Text zu lernen.

Wenn wir ein Modell an eine neue Aufgabe anpassen und möchten, dass das Modell in einem einzigen Durchgang auf Grundlage eines bestimmten Satzes von Anweisungen Text ausgibt, können wir **Anweisung** -Format im [Alpaca-Stil](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset)

```json
"Instruction": "Aufgabe, die das Modell ausführen soll."

"Input": "Optional, aber nützlich; im Wesentlichen wird es die Anfrage des Benutzers sein."

"Output": "Das erwartete Ergebnis der Aufgabe und die Ausgabe des Modells."
```

Wenn wir mehrere Gesprächsrunden möchten, können wir das ShareGPT-Format verwenden:

```json
{
  "conversations": [
    {
      "from": "human",
      "value": "Kannst du mir helfen, Pasta Carbonara zu machen?"
    },
    {
      "from": "gpt",
      "value": "Möchtest du das traditionelle römische Rezept oder eine einfachere Version?"
    },
    {
      "from": "human",
      "value": "Bitte die traditionelle Version"
    },
    {
      "from": "gpt",
      "value": "Die authentische römische Carbonara verwendet nur wenige Zutaten: Pasta, Guanciale, Eier, Pecorino Romano und schwarzen Pfeffer. Möchtest du das ausführliche Rezept?"
    }
  ]
}
```

Das Vorlagenformat verwendet die Attributschlüssel "from"/"value", und die Nachrichten wechseln zwischen `human`und `gpt`und ermöglichen so einen natürlichen Dialogfluss.

Das andere gängige Format ist OpenAIs ChatML-Format und ist der Standard bei Hugging Face. Es ist wahrscheinlich das am häufigsten verwendete Format und wechselt zwischen `Benutzer` und `Assistent`

```
{
  "messages": [
    {
      "role": "user",
      "content": "Was ist 1+1?"
    },
    {
      "role": "assistant",
      "content": "Es ist 2!"
    },
  ]
}
```

### Anwenden von Chat-Templates mit Unsloth

Bei Datensätzen, die normalerweise dem gängigen ChatML-Format folgen, besteht der Prozess der Vorbereitung des Datensatzes für das Training oder Finetuning aus vier einfachen Schritten:

* Prüfe die Chat-Templates, die Unsloth derzeit unterstützt:\\

  ```
  from unsloth.chat_templates import CHAT_TEMPLATES
  print(list(CHAT_TEMPLATES.keys()))
  ```

  \
  Dies gibt die Liste der derzeit von Unsloth unterstützten Templates aus. Hier ist ein Beispiel für die Ausgabe:\\

  ```
  ['unsloth', 'zephyr', 'chatml', 'mistral', 'llama', 'vicuna', 'vicuna_old', 'vicuna old', 'alpaca', 'gemma', 'gemma_chatml', 'gemma2', 'gemma2_chatml', 'llama-3', 'llama3', 'phi-3', 'phi-35', 'phi-3.5', 'llama-3.1', 'llama-31', 'llama-3.2', 'llama-3.3', 'llama-32', 'llama-33', 'qwen-2.5', 'qwen-25', 'qwen25', 'qwen2.5', 'phi-4', 'gemma-3', 'gemma3']
  ```

  \\\\
* Verwenden Sie `get_chat_template` um das richtige Chat-Template auf deinen Tokenizer anzuwenden:\\

  ```
  from unsloth.chat_templates import get_chat_template

  tokenizer = get_chat_template(
      tokenizer,
      chat_template = "gemma-3", # ändere dies in den richtigen chat_template-Namen
  )
  ```

  \\\\
* Definiere deine Formatierungsfunktion. Hier ist ein Beispiel:\\

  ```
  def formatting_prompts_func(examples):
     convos = examples["conversations"]
     texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
     return { "text" : texts, }
  ```

  \
  \
  Diese Funktion durchläuft deinen Datensatz und wendet das von dir definierte Chat-Template auf jedes Beispiel an.\\
* Schließlich laden wir den Datensatz und wenden die erforderlichen Änderungen auf unseren Datensatz an: \\

  ```
  # Datensatz importieren und laden
  from datasets import load_dataset
  dataset = load_dataset("repo_name/dataset_name", split = "train")

  # Wende die Formatierungsfunktion mit der map-Methode auf deinen Datensatz an
  dataset = dataset.map(formatting_prompts_func, batched = True,)
  ```

  \
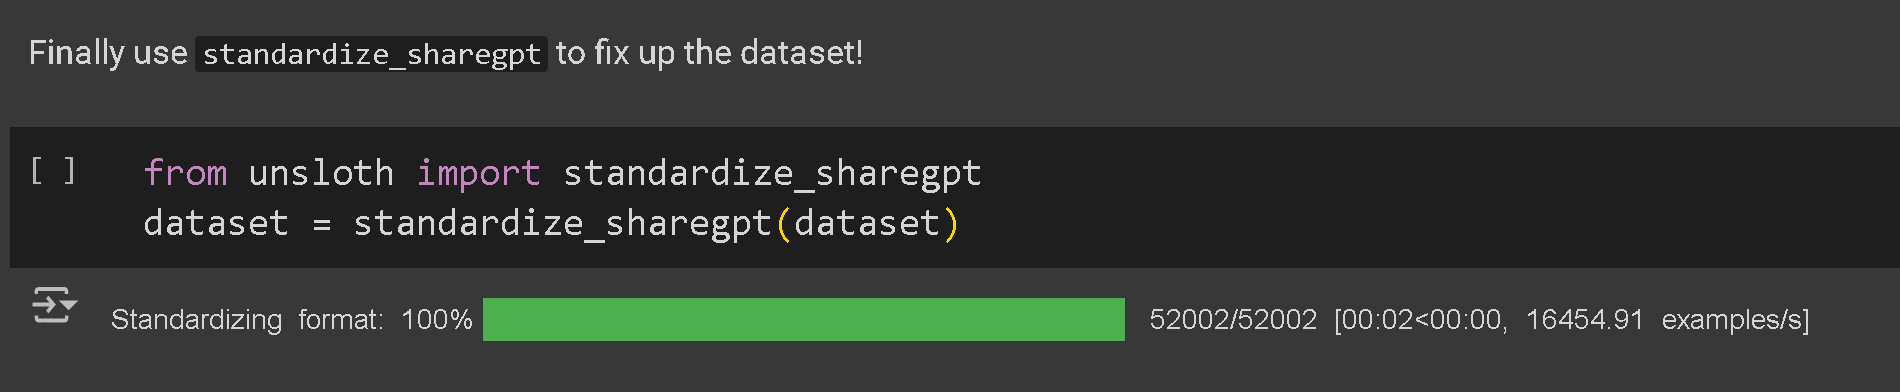
  Wenn dein Datensatz das ShareGPT-Format mit "from"/"value"-Schlüsseln statt des ChatML-Formats "role"/"content" verwendet, kannst du die `standardize_sharegpt` Funktion verwenden, um ihn zuerst zu konvertieren. Der überarbeitete Code sieht dann wie folgt aus:\
  \\

  ```
  # Datensatz importieren
  from datasets import load_dataset
  dataset = load_dataset("mlabonne/FineTome-100k", split = "train")

  # Konvertiere deinen Datensatz bei Bedarf in das "role"/"content"-Format
  from unsloth.chat_templates import standardize_sharegpt
  dataset = standardize_sharegpt(dataset)

  # Wende die Formatierungsfunktion mit der map-Methode auf deinen Datensatz an
  dataset = dataset.map(formatting_prompts_func, batched = True,)
  ```

### Daten formatieren Q\&A

<mark style="color:grün;">**F:**</mark> Wie kann ich das Alpaca-Instruct-Format verwenden?

<mark style="color:grün;">**A:**</mark> Wenn dein Datensatz bereits im Alpaca-Format vorliegt, befolge die Formatierungsschritte wie im Llama3.1 [Notebook ](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-Alpaca.ipynb#scrollTo=LjY75GoYUCB8). Wenn du deine Daten in das Alpaca-Format konvertieren musst, besteht ein Ansatz darin, ein Python-Skript zu erstellen, um deine Rohdaten zu verarbeiten. Wenn du an einer Zusammenfassungsaufgabe arbeitest, kannst du ein lokales LLM verwenden, um für jedes Beispiel Anweisungen und Ausgaben zu erzeugen.

<mark style="color:grün;">**F:**</mark> Sollte ich immer die Methode standardize\_sharegpt verwenden?

<mark style="color:grün;">**A:**</mark> Verwende die Methode standardize\_sharegpt nur, wenn dein Ziel-Datensatz im ShareGPT-Format vorliegt, dein Modell jedoch stattdessen ein ChatML-Format erwartet.

\ <mark style="color:grün;">**F:**</mark> Warum nicht die Funktion apply\_chat\_template verwenden, die mit dem Tokenizer mitgeliefert wird.

<mark style="color:grün;">**A:**</mark> Der `chat_template` Attribut, wenn ein Modell erstmals von den ursprünglichen Modellbesitzern hochgeladen wird, enthält manchmal Fehler und kann Zeit benötigen, um aktualisiert zu werden. Im Gegensatz dazu prüfen wir bei Unsloth gründlich und beheben alle Fehler in den `chat_template` für jedes Modell, wenn wir die quantisierten Versionen in unsere Repositories hochladen. Zusätzlich bieten unsere `get_chat_template` und `apply_chat_template` Methoden fortschrittliche Funktionen zur Datenmanipulation, die in unserer Dokumentation zu Chat-Vorlagen vollständig beschrieben sind [Seite](https://docs.unsloth.ai/basics/chat-templates).

<mark style="color:grün;">**F:**</mark> Was ist, wenn meine Vorlage derzeit nicht von Unsloth unterstützt wird?

<mark style="color:grün;">**A:**</mark> Reiche einen Feature-Wunsch im GitHub-Issues [Forum](https://github.com/unslothai/unsloth)ein. Als vorübergehende Lösung könntest du auch die eigene apply\_chat\_template-Funktion des Tokenizers verwenden, bis dein Feature-Wunsch genehmigt und zusammengeführt wurde.

## Generierung synthetischer Daten

Du kannst auch jedes lokale LLM wie Llama 3.3 (70B) oder OpenAIs GPT 4.5 verwenden, um synthetische Daten zu erzeugen. Allgemein ist es besser, ein größeres wie Llama 3.3 (70B) zu verwenden, um die qualitativ hochwertigsten Ausgaben sicherzustellen. Du kannst Inferenz-Engines wie vLLM, Ollama oder llama.cpp direkt verwenden, um synthetische Daten zu erzeugen, aber es erfordert etwas manuelle Arbeit, sie zu sammeln und mehr Daten anzufordern. Es gibt 3 Ziele für synthetische Daten:

* Vollständig neue Daten erzeugen – entweder von Grund auf oder ausgehend von deinem bestehenden Datensatz
* Diversifiziere deinen Datensatz, damit dein Modell nicht [überanpasst](/docs/de/loslegen/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting) und zu spezifisch wird
* Vorhandene Daten erweitern, z. B. deinen Datensatz automatisch in das korrekt gewählte Format strukturieren

### Unsloth für synthetische Daten verwenden

Du kannst problemlos beliebige unstrukturierte oder strukturierte Daten in Unsloth Studios [Datenrezepte](/docs/de/neu/studio/data-recipe.md) hochladen, und es wird sie automatisch in einen nutzbaren / synthetischen Datensatz umwandeln. Weitere Details in [unserem Leitfaden](/docs/de/neu/studio/data-recipe.md).

<div data-with-frame="true"><figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FQ6e19jESrJg0VjHnX58c%2Fdata%20recipes%20final.png?alt=media&amp;token=8d74e453-815d-4790-83d1-76d0bc80a3ce" alt="" width="563"><figcaption></figcaption></figure></div>

### Ein lokales LLM oder ChatGPT für synthetische Daten verwenden

Dein Ziel ist es, das Modell dazu aufzufordern, QA-Daten in dem von dir angegebenen Format zu erzeugen und zu verarbeiten. Das Modell muss die von dir bereitgestellte Struktur und auch den Kontext lernen, also stelle sicher, dass du mindestens 10 Beispiele der Daten bereits hast. Beispiel-Prompts:

* **Prompt zur Erzeugung weiterer Dialoge auf einem vorhandenen Datensatz**:

  <pre data-overflow="wrap"><code><strong>Verwende das von mir bereitgestellte Datensatzbeispiel, folge der Struktur und generiere Gespräche auf Grundlage der Beispiele.
  </strong></code></pre>
* **Prompt, falls du keinen Datensatz hast**:

  {% code overflow="wrap" %}

  ```
  Erstelle 10 Beispiele für Produktbewertungen für Coca-Cola, klassifiziert als positiv, negativ oder neutral.
  ```

  {% endcode %}
* **Prompt für einen Datensatz ohne Formatierung**:

  {% code overflow="wrap" %}

  ```
  Strukturiere meinen Datensatz so, dass er für das Fine-Tuning im QA-ChatML-Format vorliegt. Generiere dann 5 synthetische Datenbeispiele mit demselben Thema und Format.
  ```

  {% endcode %}

Es wird empfohlen, die Qualität der erzeugten Daten zu prüfen, um irrelevante oder qualitativ schlechte Antworten zu entfernen oder zu verbessern. Je nach Datensatz muss er möglicherweise auch in vielen Bereichen ausgeglichen werden, damit dein Modell nicht überanpasst. Du kannst diesen bereinigten Datensatz dann wieder in dein LLM einspeisen, um Daten erneut zu erzeugen, diesmal mit noch mehr Anleitung.

## Datensatz-FAQ + Tipps

### Wie groß sollte mein Datensatz sein?

Wir empfehlen im Allgemeinen als absolutes Minimum mindestens 100 Zeilen Daten für das Fine-Tuning, um vernünftige Ergebnisse zu erzielen. Für optimale Leistung ist ein Datensatz mit über 1.000 Zeilen vorzuziehen, und in diesem Fall führt mehr Daten in der Regel zu besseren Ergebnissen. Wenn dein Datensatz zu klein ist, kannst du auch synthetische Daten hinzufügen oder einen Datensatz von Hugging Face hinzufügen, um ihn zu diversifizieren. Die Wirksamkeit deines feinabgestimmten Modells hängt jedoch stark von der Qualität des Datensatzes ab. Stelle daher sicher, dass du deine Daten gründlich bereinigst und vorbereitest.

### Wie sollte ich meinen Datensatz strukturieren, wenn ich ein Reasoning-Modell feinabstimmen möchte?

Wenn du ein Modell feinabstimmen möchtest, das bereits über Schlussfolgerungsfähigkeiten verfügt, wie die destillierten Versionen von DeepSeek-R1 (z. B. DeepSeek-R1-Distill-Llama-8B), musst du dennoch Frage-/Aufgaben- und Antwortpaare verwenden. Für deine Antwort musst du jedoch die Antwort so ändern, dass sie den Reasoning-/Chain-of-Thought-Prozess und die Schritte enthält, die zur Ableitung der Antwort verwendet wurden.\
\
Für ein Modell, das kein Reasoning hat, und das du so trainieren möchtest, dass es später Schlussfolgerungsfähigkeiten umfasst, musst du einen Standarddatensatz verwenden, diesmal jedoch ohne Reasoning in den Antworten. Dieser Trainingsprozess ist bekannt als [Verstärkendes Lernen und GRPO](/docs/de/loslegen/reinforcement-learning-rl-guide.md).

### Mehrere Datensätze

Wenn du mehrere Datensätze zum Fine-Tuning hast, kannst du entweder:

* Das Format aller Datensätze standardisieren, sie zu einem einzigen Datensatz zusammenführen und auf diesem vereinheitlichten Datensatz feinabstimmen.
* Verwenden Sie die [Mehrere Datensätze](https://colab.research.google.com/drive/1njCCbE1YVal9xC83hjdo2hiGItpY_D6t?usp=sharing) Notebook, um direkt auf mehreren Datensätzen feinabzustimmen.

### Kann ich dasselbe Modell mehrfach feinabstimmen?

Du kannst ein bereits feinabgestimmtes Modell mehrfach feinabstimmen, aber es ist besser, stattdessen alle Datensätze zu kombinieren und das Fine-Tuning in einem einzigen Prozess durchzuführen. Das Training eines bereits feinabgestimmten Modells kann die Qualität und das Wissen, das während des vorherigen Fine-Tuning-Prozesses erworben wurde, potenziell verändern.

## Datensätze in Unsloth verwenden

### Alpaca-Datensatz

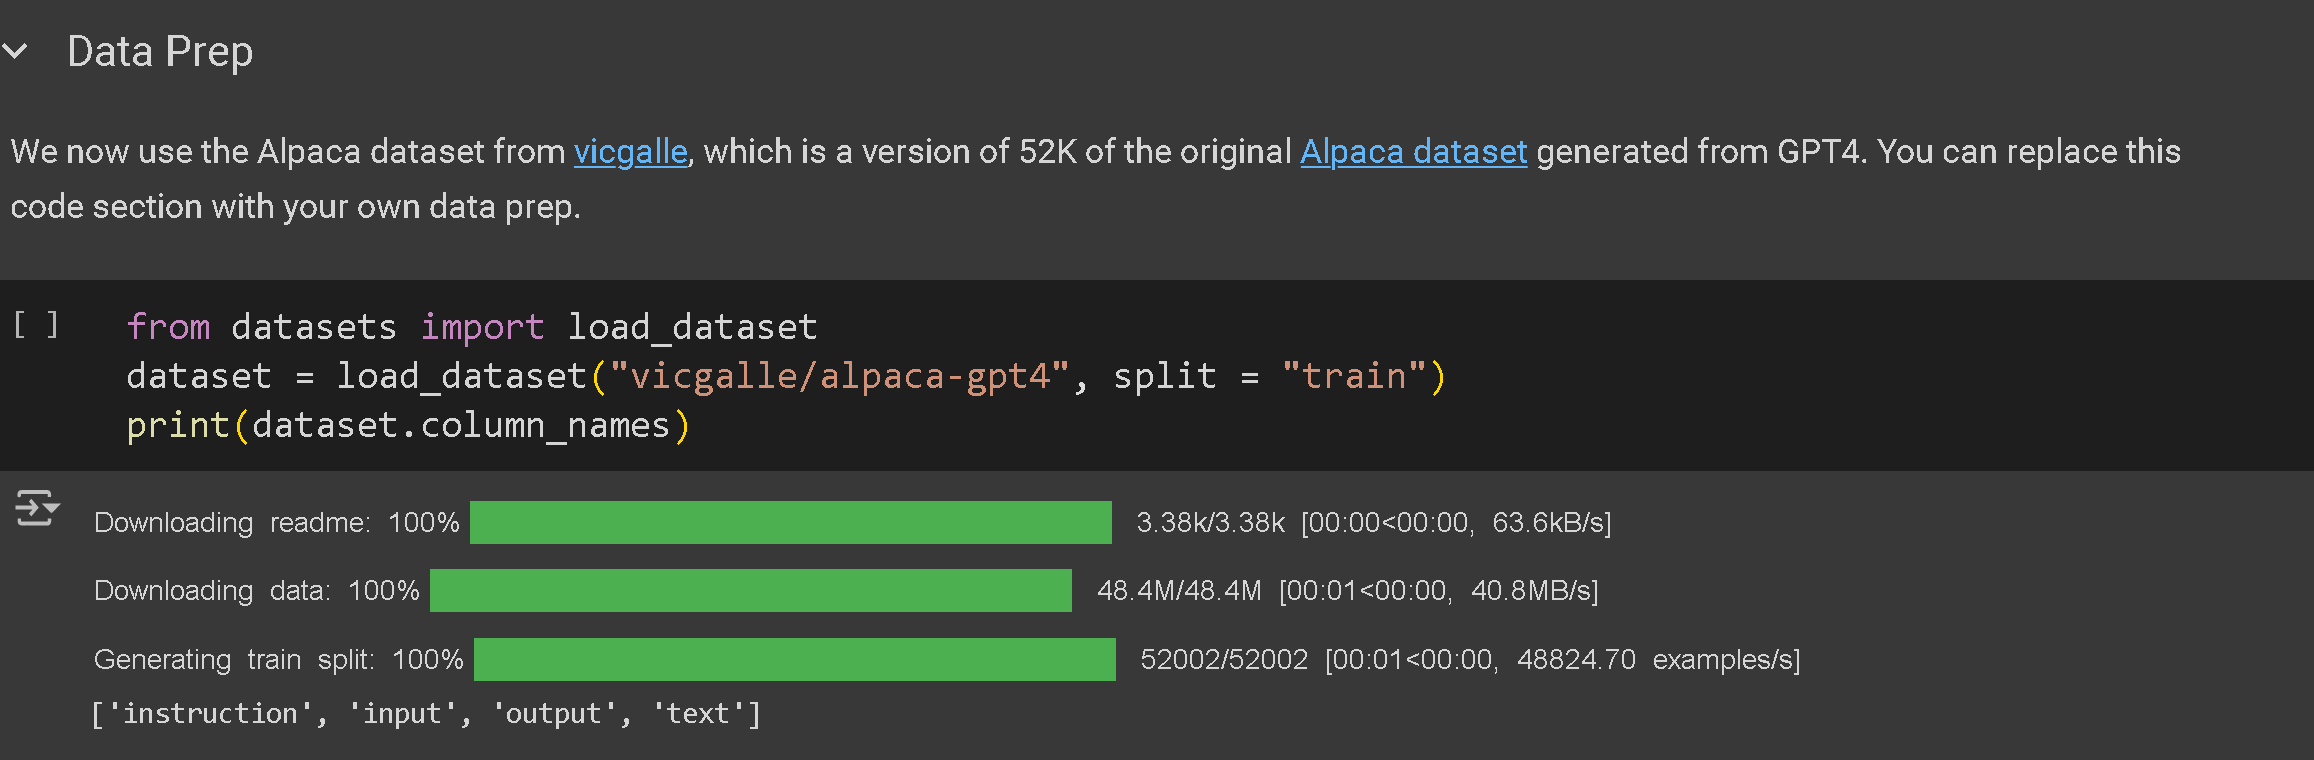
Sieh dir ein Beispiel an, wie der Alpaca-Datensatz in Unsloth auf Google Colab verwendet wird:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1d66d8714e44d90513dd87b9356eec67886ab3f7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Wir werden nun den Alpaca-Datensatz verwenden, der durch Aufruf von GPT-4 selbst erstellt wurde. Es handelt sich um eine Liste von 52.000 Anweisungen und Ausgaben, die sehr beliebt war, als Llama-1 veröffentlicht wurde, da sie das Fine-Tuning eines Basis-LLM mit ChatGPT selbst konkurrenzfähig machte.

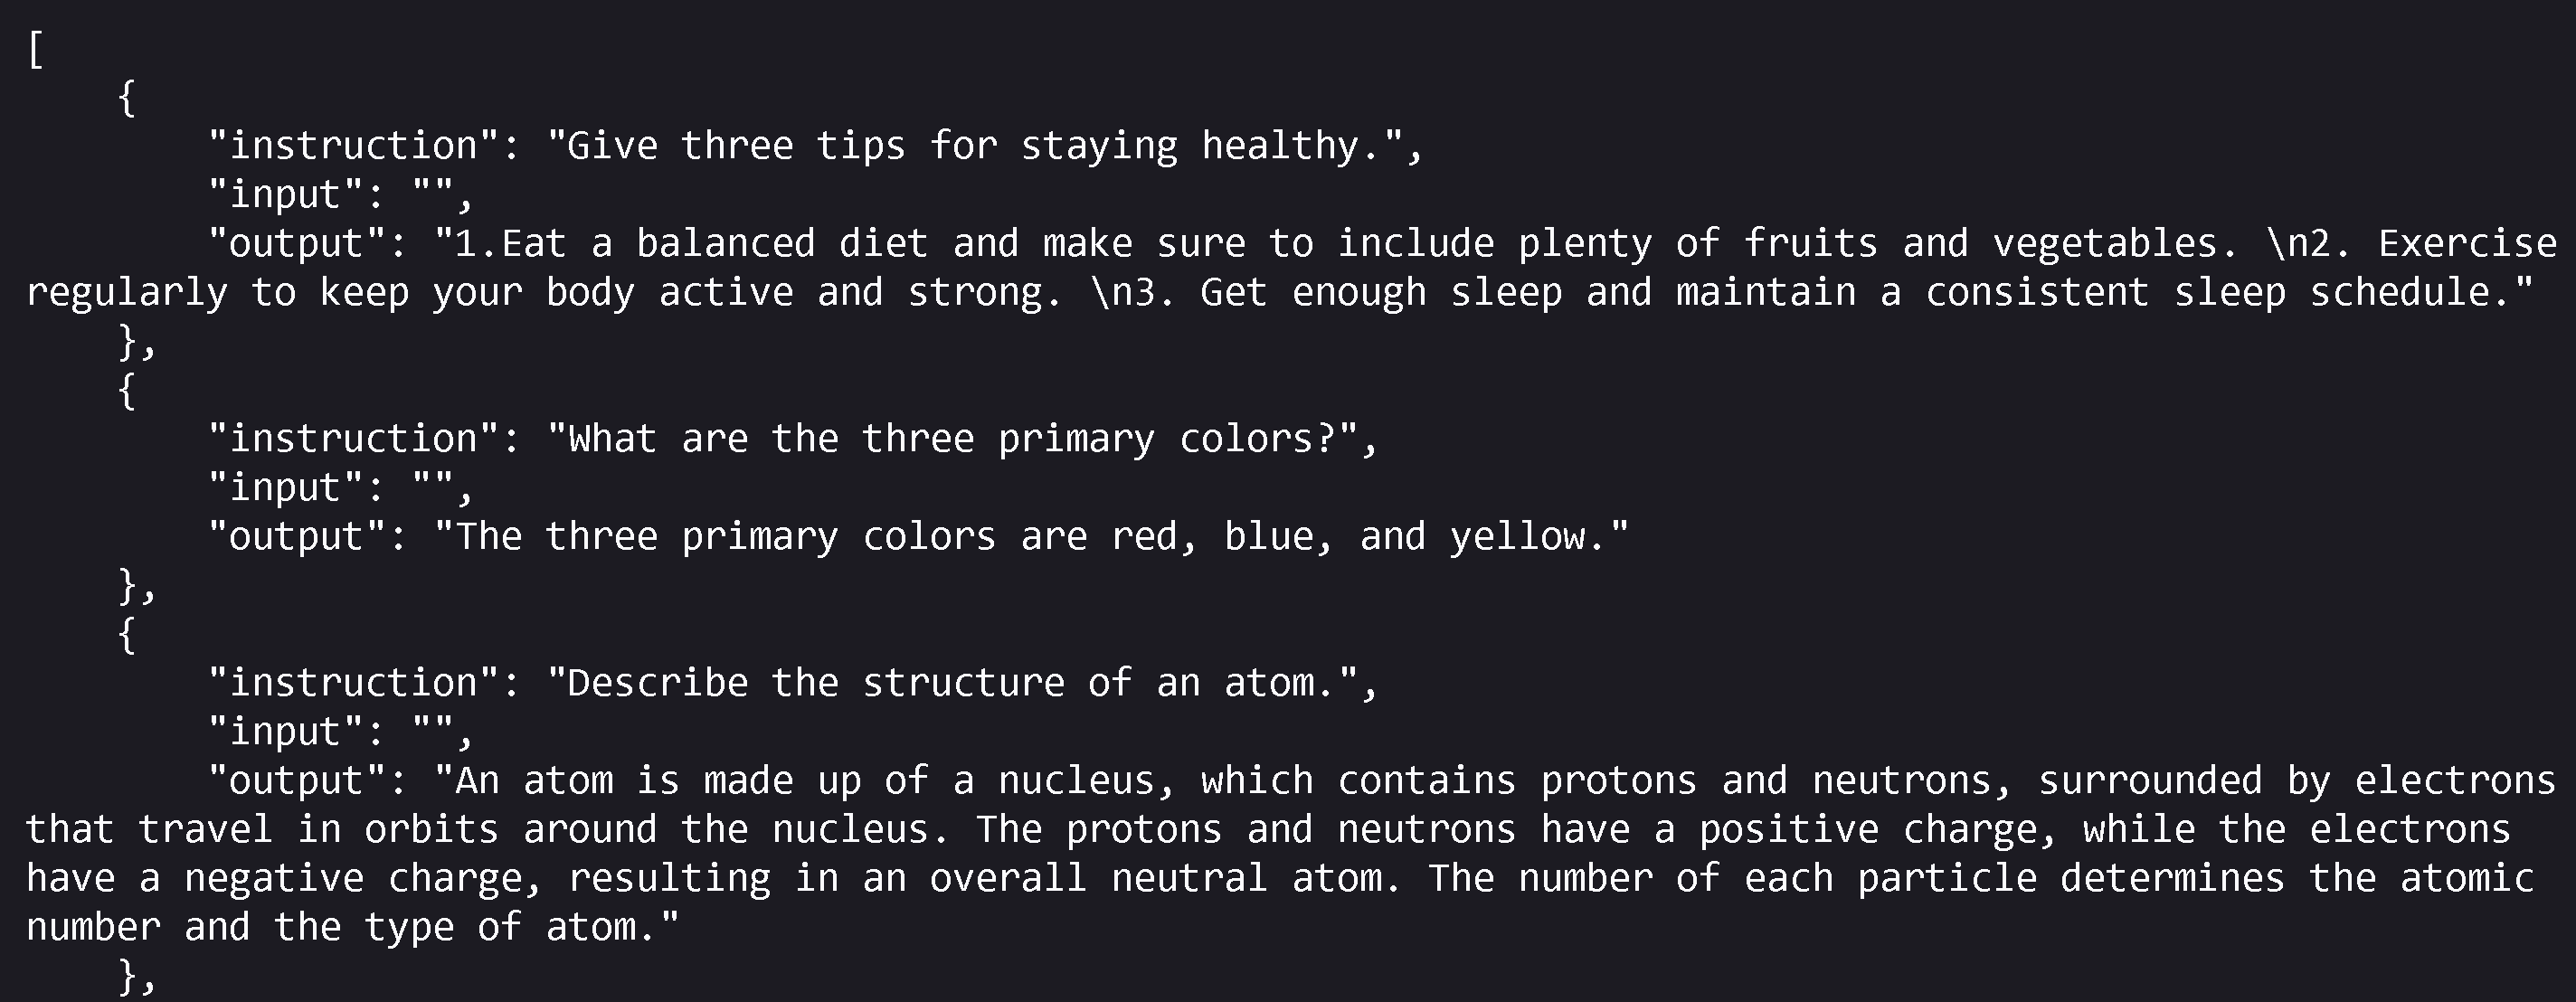
Du kannst auf die GPT4-Version des Alpaca-Datensatzes zugreifen [hier](https://huggingface.co/datasets/vicgalle/alpaca-gpt4.). Unten siehst du einige Beispiele des Datensatzes:

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-0dde50e386e7b245d3e8a57e10a4a81755b3769a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

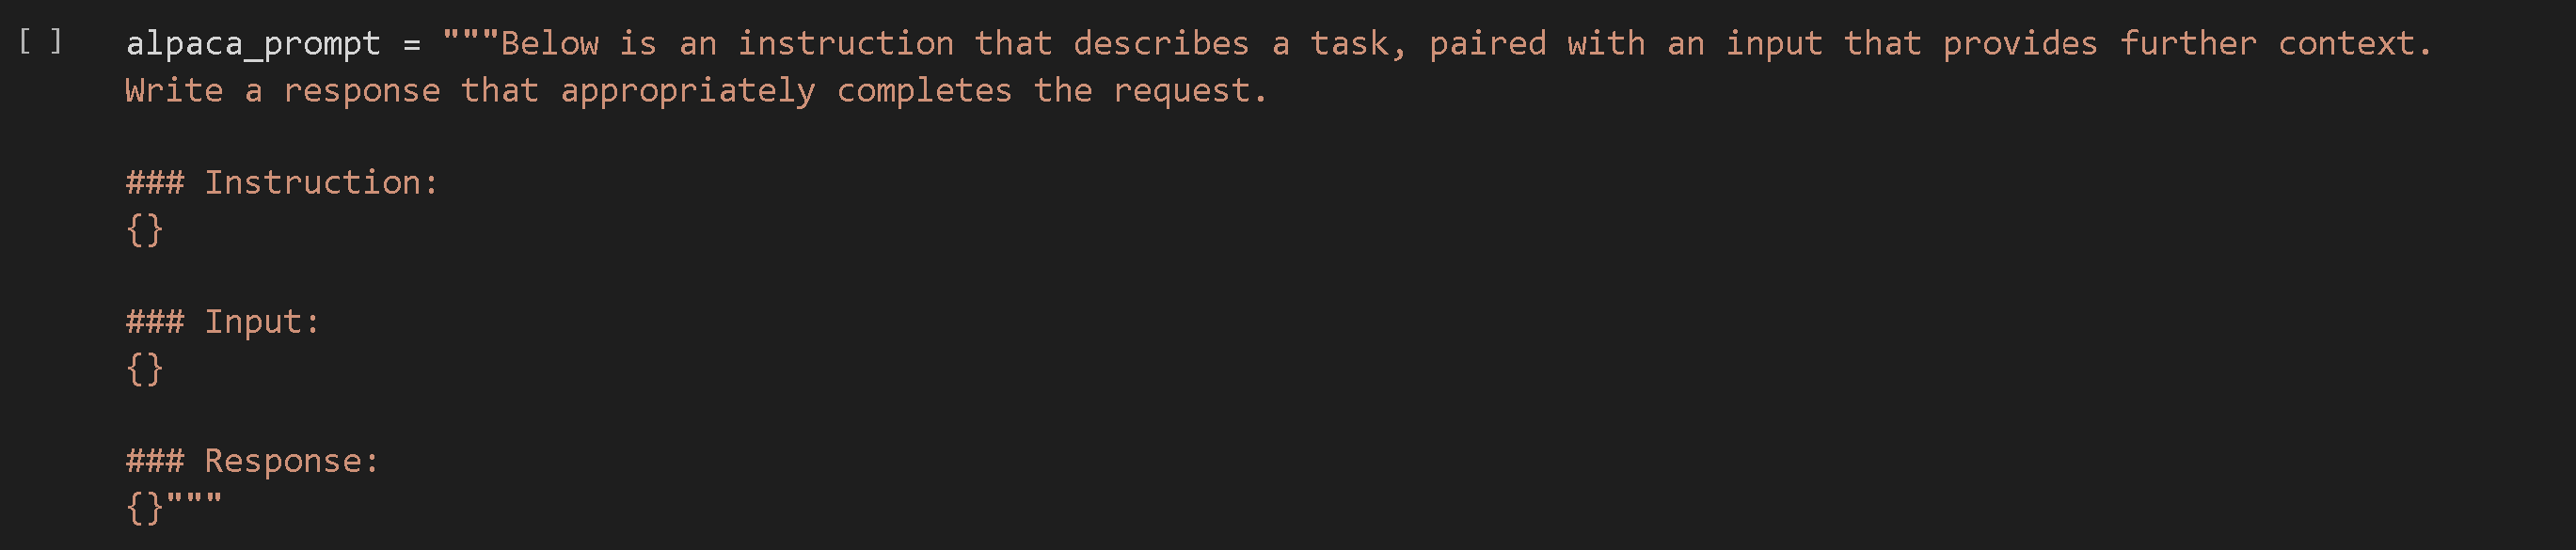
Du kannst sehen, dass es in jeder Zeile 3 Spalten gibt – eine Anweisung, einen Input und eine Ausgabe. Wir fassen im Wesentlichen jede Zeile zu einem großen Prompt zusammen, wie unten gezeigt. Dies verwenden wir dann, um das Sprachmodell feinabzustimmen, und dadurch wurde es ChatGPT sehr ähnlich. Diesen Prozess nennen wir **überwachtes Instruct-Fine-Tuning**.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8b3663c5d80adcb935ff77661500f08e13c9af2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### Mehrere Spalten für das Fine-Tuning

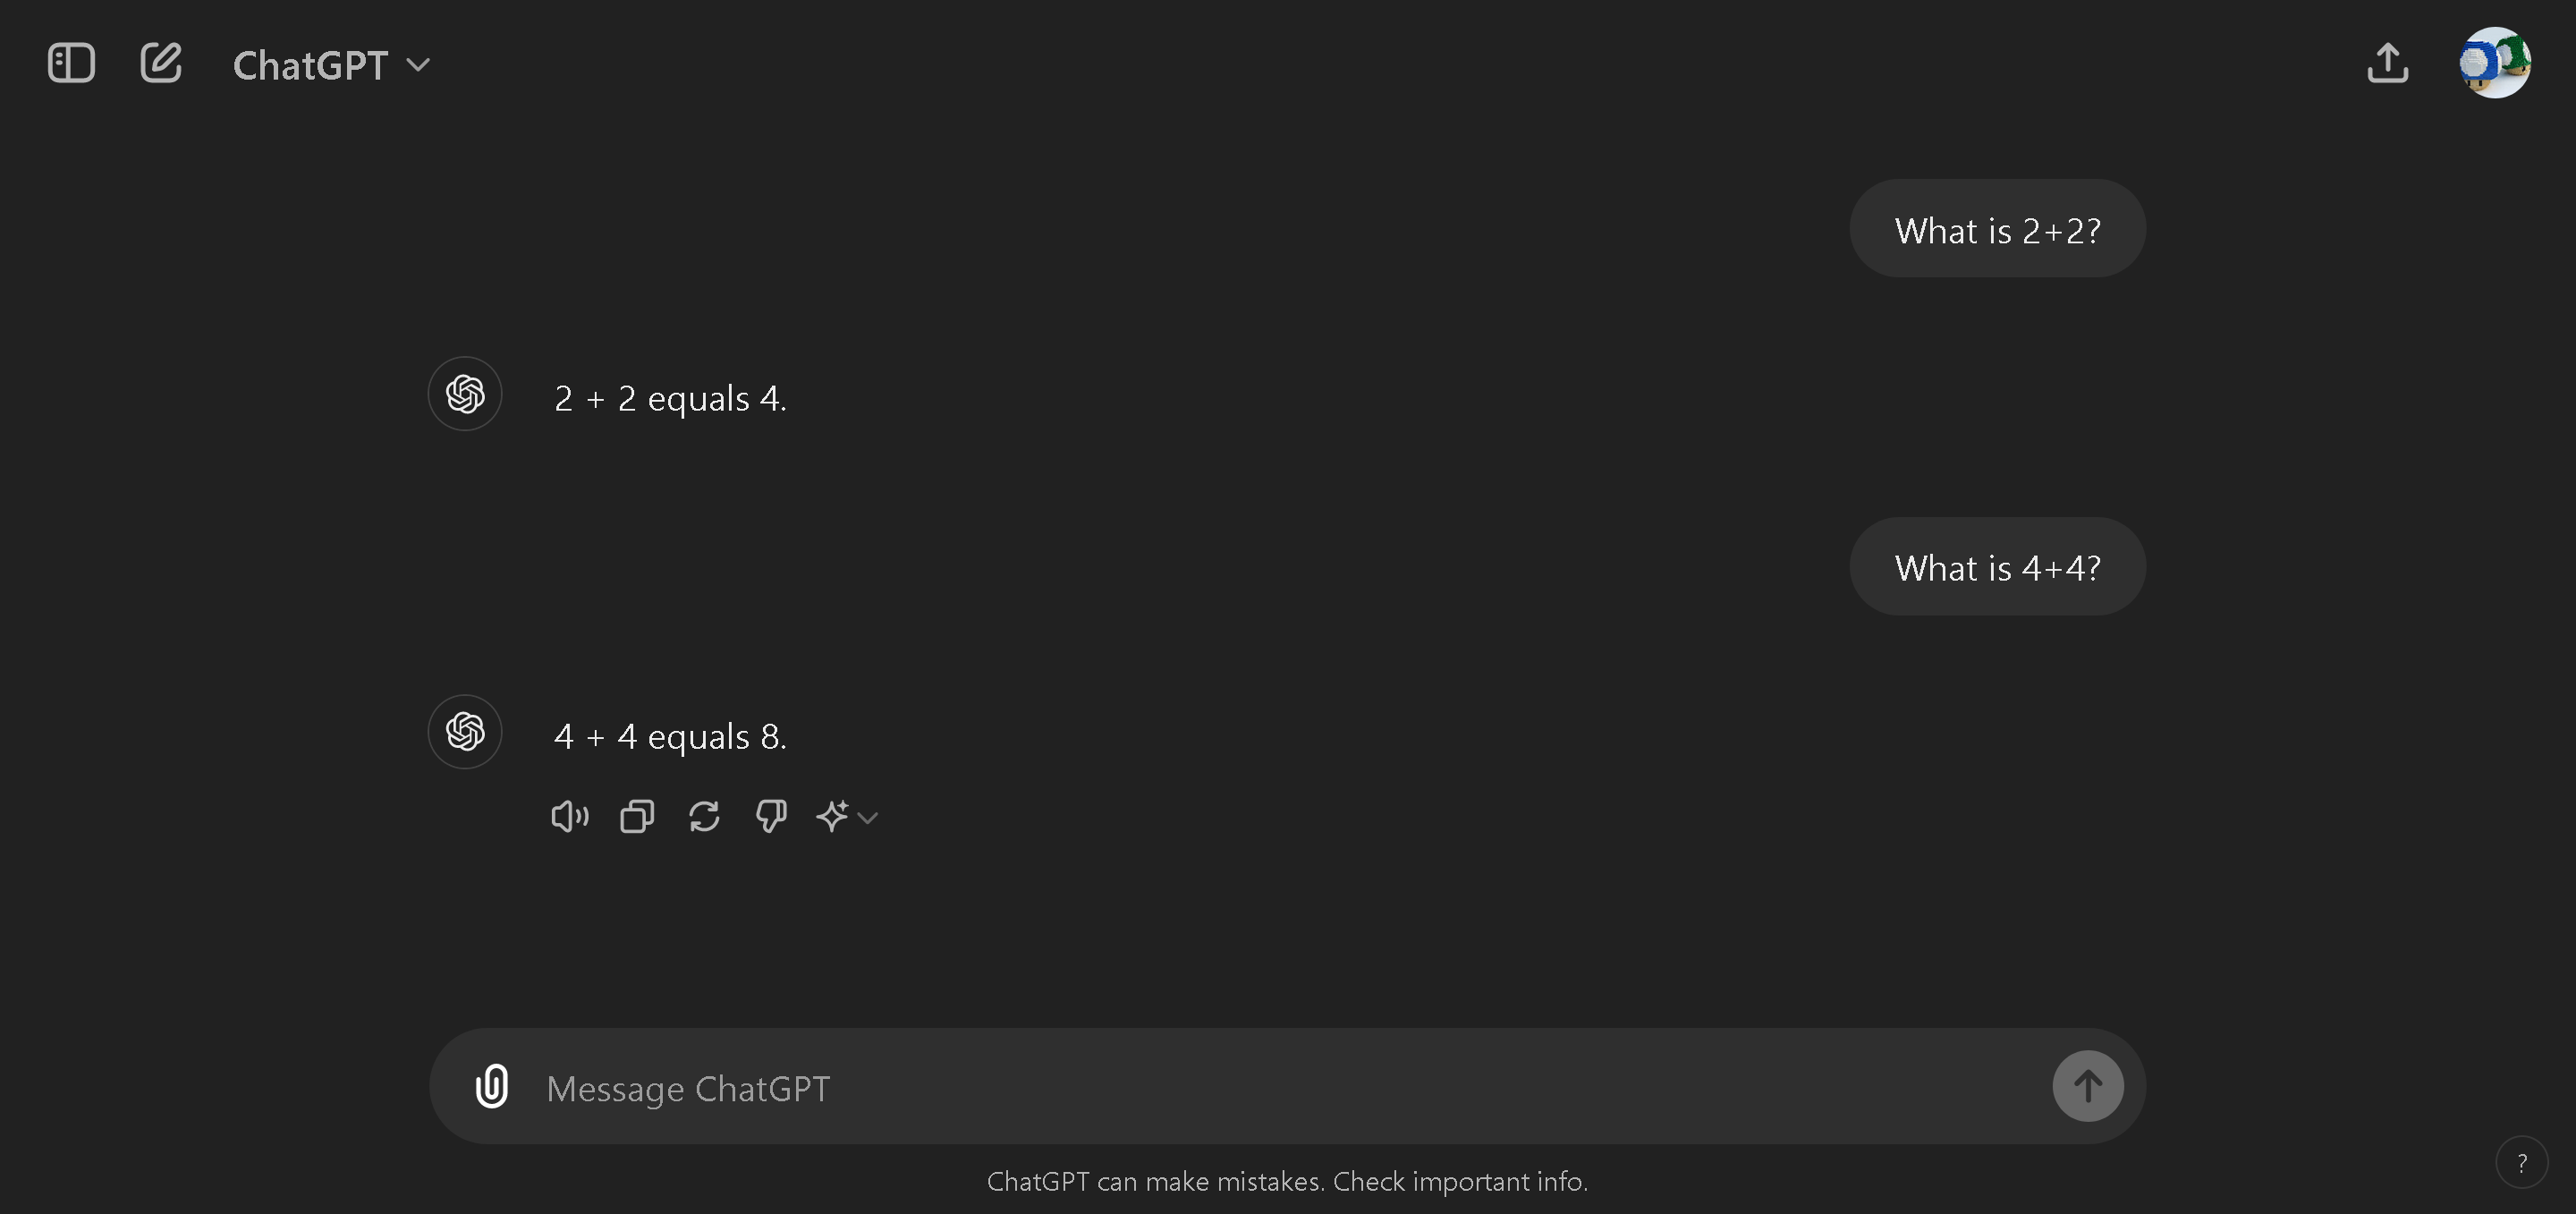
Ein großes Problem ist jedoch, dass wir bei ChatGPT-ähnlichen Assistenten nur 1 Anweisung / 1 Prompt zulassen und nicht mehrere Spalten / Inputs. In ChatGPT zum Beispiel kannst du sehen, dass wir 1 Prompt senden müssen und nicht mehrere Prompts.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-d90162c2685ced871f4151369aadcaee40a9c54f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

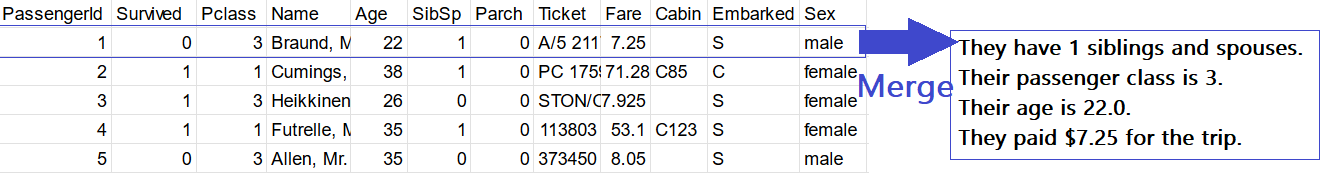
Das bedeutet im Wesentlichen, dass wir mehrere Spalten zu 1 großen Prompt „zusammenführen“ müssen, damit das Fine-Tuning tatsächlich funktioniert!

Zum Beispiel hat der sehr berühmte Titanic-Datensatz viele, viele Spalten. Deine Aufgabe war es, auf Grundlage von Alter, Passagierklasse, Fahrpreis usw. vorherzusagen, ob ein Passagier überlebt hat oder gestorben ist. Wir können das nicht einfach in ChatGPT einspeisen, sondern müssen diese Informationen zu 1 großen Prompt „zusammenführen“.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a2df04874bfc879182cb66c789341d49700227ea%2FMerge.png?alt=media" alt=""><figcaption></figcaption></figure>

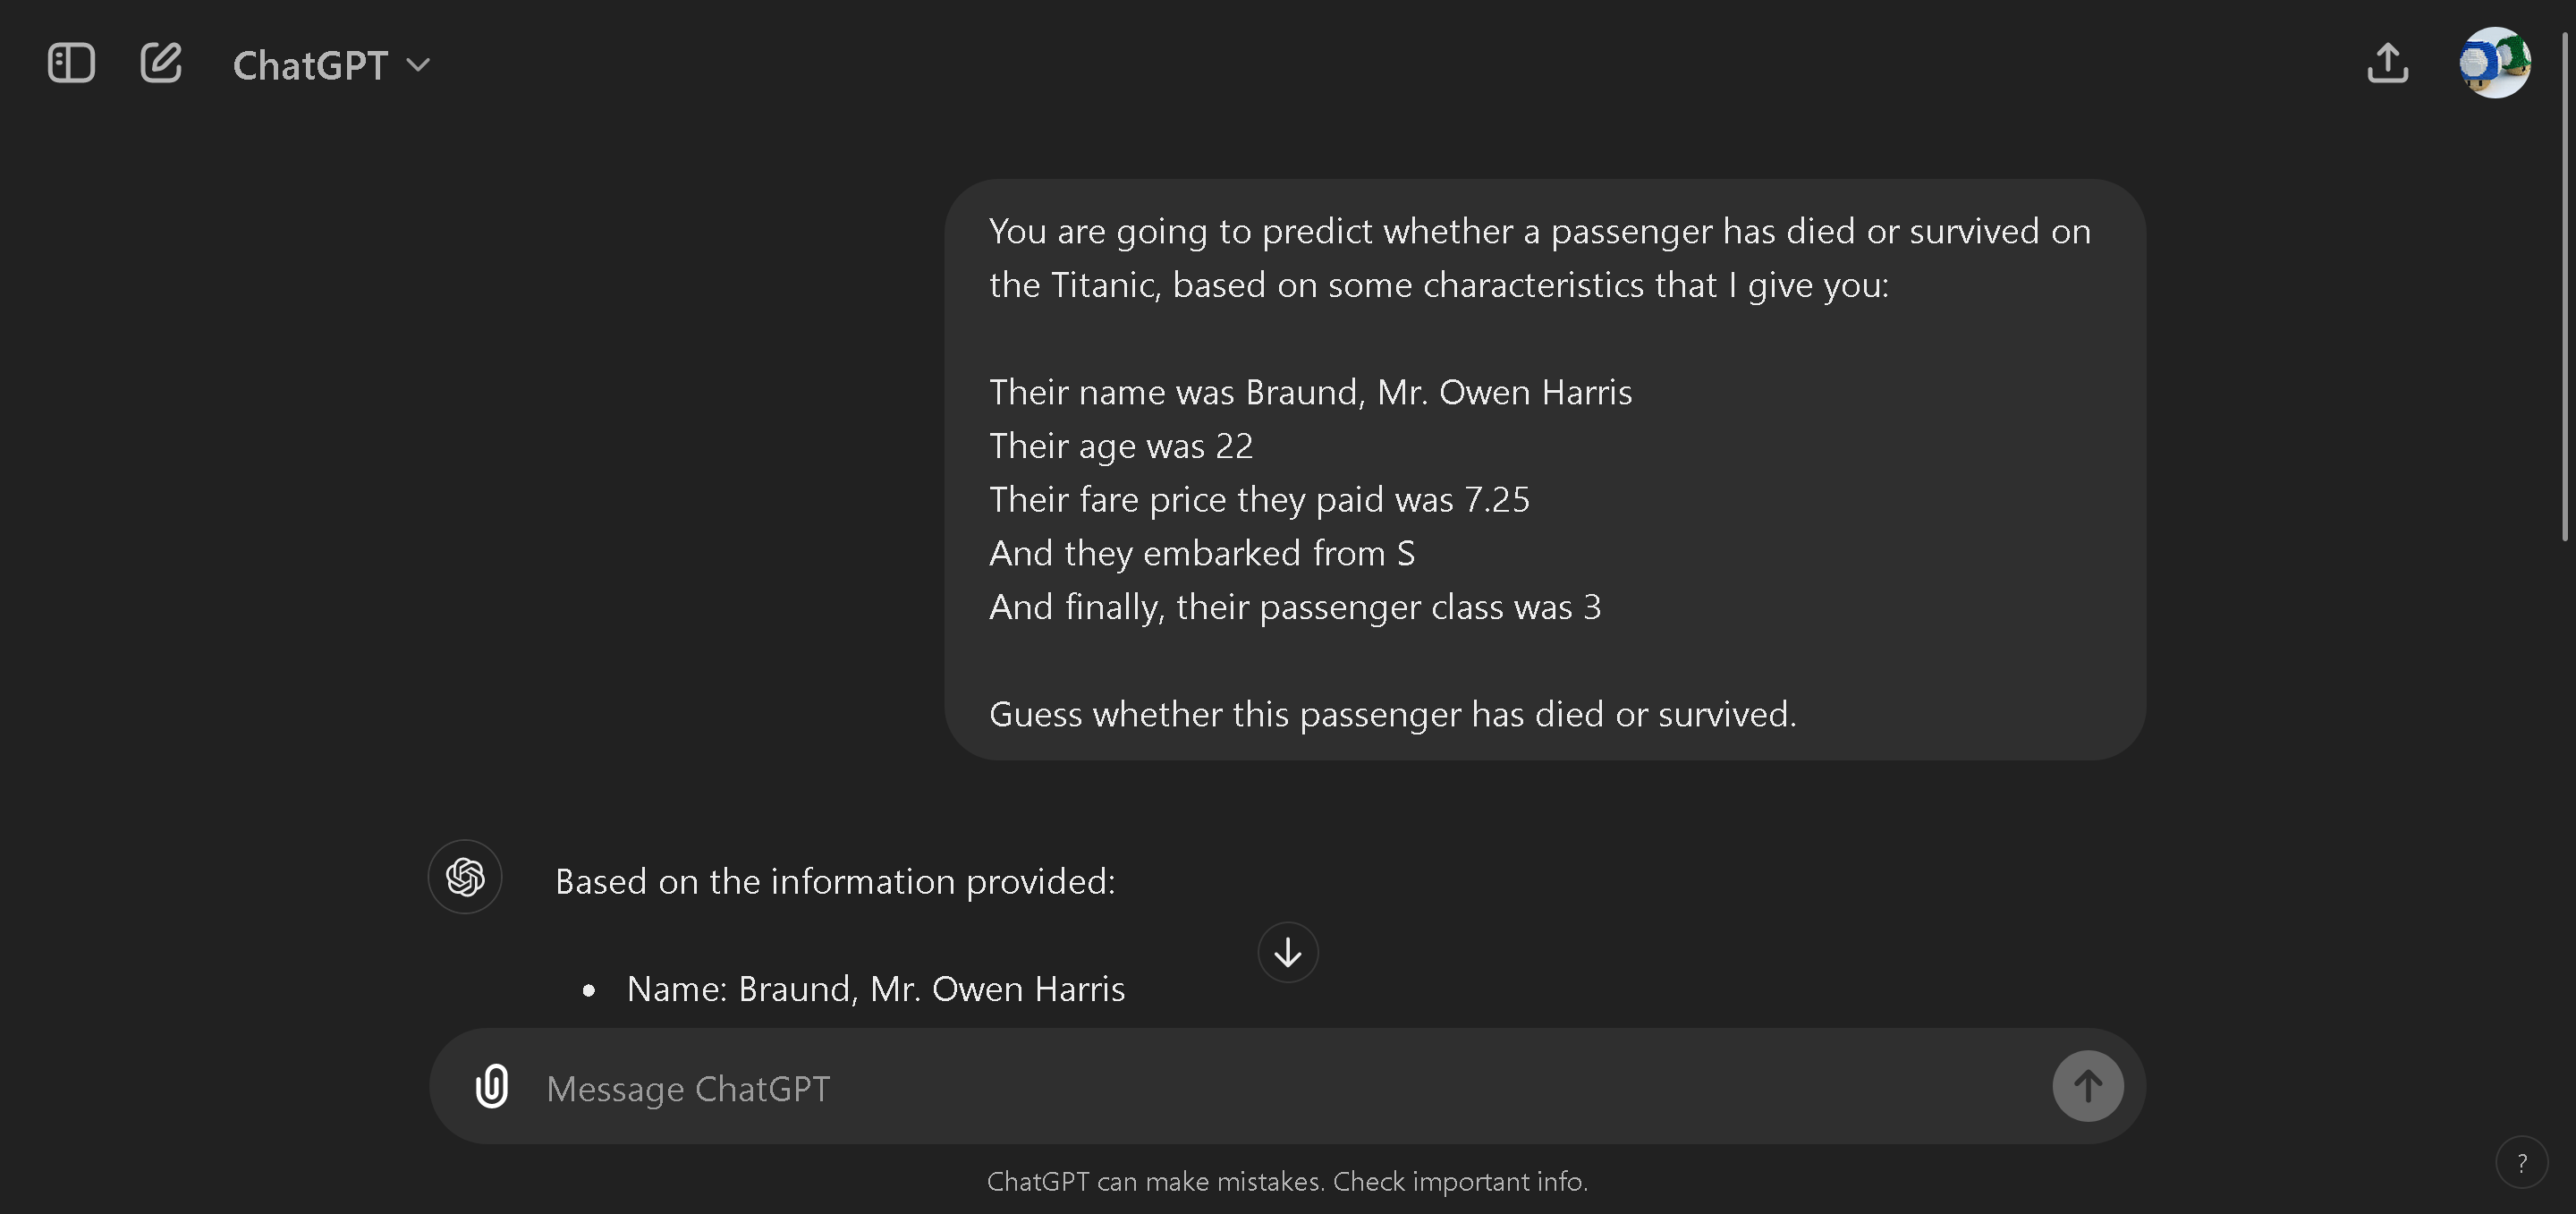
Wenn wir ChatGPT beispielsweise mit unserem „zusammengeführten“ einzelnen Prompt fragen, der alle Informationen zu diesem Passagier enthält, können wir es bitten zu raten oder vorherzusagen, ob der Passagier gestorben ist oder überlebt hat.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b3da2b36afe37469cd3962f37186e758871864a5%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

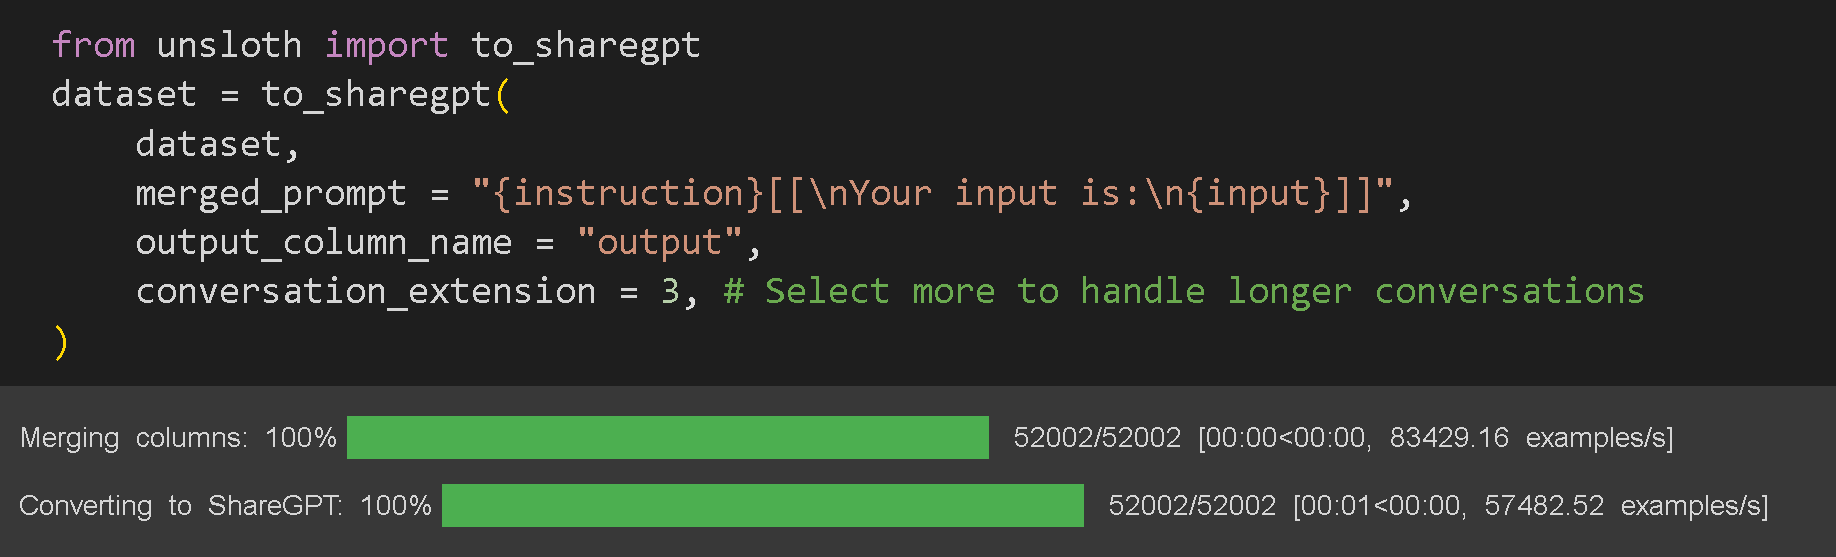
Andere Fine-Tuning-Bibliotheken verlangen, dass du deinen Datensatz für das Fine-Tuning manuell vorbereitest, indem du alle deine Spalten zu 1 Prompt zusammenführst. In Unsloth stellen wir einfach die Funktion bereit, die heißt `to_sharegpt` und das erledigt alles auf einmal!

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-62b94dc44f2e343020d31de575f52eb22be4b0fc%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Jetzt wird es etwas komplizierter, da wir viele Anpassungen erlauben, aber es gibt einige Punkte:

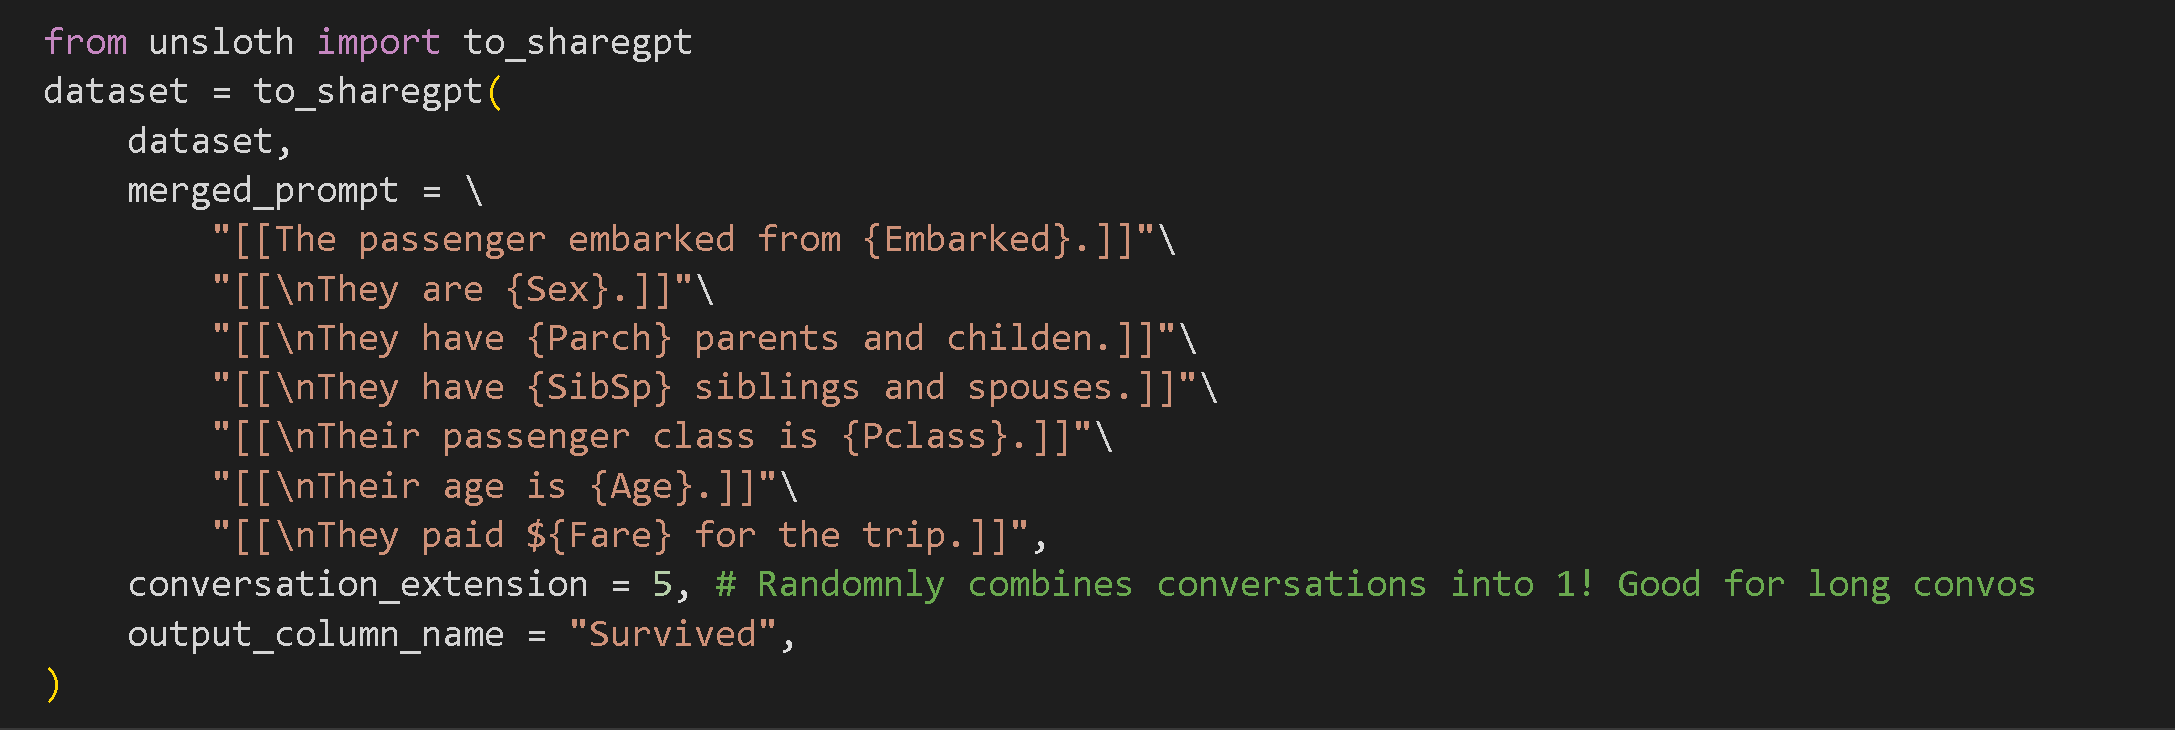
* Du musst alle Spalten in geschweifte Klammern einschließen `{}`. Das sind die Spaltennamen in der eigentlichen CSV-/Excel-Datei.
* Optionale Textkomponenten müssen in `[[]]`eingeschlossen werden. Wenn zum Beispiel die Spalte "input" leer ist, zeigt die Zusammenführungsfunktion den Text nicht an und überspringt ihn. Das ist nützlich für Datensätze mit fehlenden Werten.
* Wähle die Ausgabe- oder Ziel-/Vorhersagespalte in `output_column_name`. Für den Alpaca-Datensatz ist das `Ausgabe`.

Zum Beispiel können wir beim Titanic-Datensatz ein großes zusammengeführtes Prompt-Format wie unten erstellen, bei dem jede Spalte / jedes Textstück optional wird.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e6228cf6e5c0bb4e4b45e6f3e045910d567c33d2%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Angenommen, der Datensatz sieht mit vielen fehlenden Daten etwa so aus:

| Eingeschifft | Alter | Fahrpreis |
| ------------ | ----- | --------- |
| S            | 23    |           |
|              | 18    | 7.25      |

Dann möchten wir nicht, dass das Ergebnis lautet:

1. Der Passagier ging in S. an Bord. Sein Alter ist 23. Sein Fahrpreis ist **LEER**.
2. Der Passagier ging in **LEER**. an Bord. Sein Alter ist 18. Sein Fahrpreis beträgt 7,25 $.

Stattdessen können wir, indem wir Spalten optional mit `[[]]`einschließen, diese Informationen vollständig ausschließen.

1. \[\[Der Passagier ging in S. an Bord.]] \[\[Sein Alter ist 23.]] \[\[Sein Fahrpreis ist **LEER**.]]
2. \[\[Der Passagier ging in **LEER**. an Bord.]] \[\[Sein Alter ist 18.]] \[\[Sein Fahrpreis beträgt 7,25 $.]]

wird zu:

1. Der Passagier ging in S. an Bord. Sein Alter ist 23.
2. Sein Alter ist 18. Sein Fahrpreis beträgt 7,25 $.

### Gespräche mit mehreren Runden

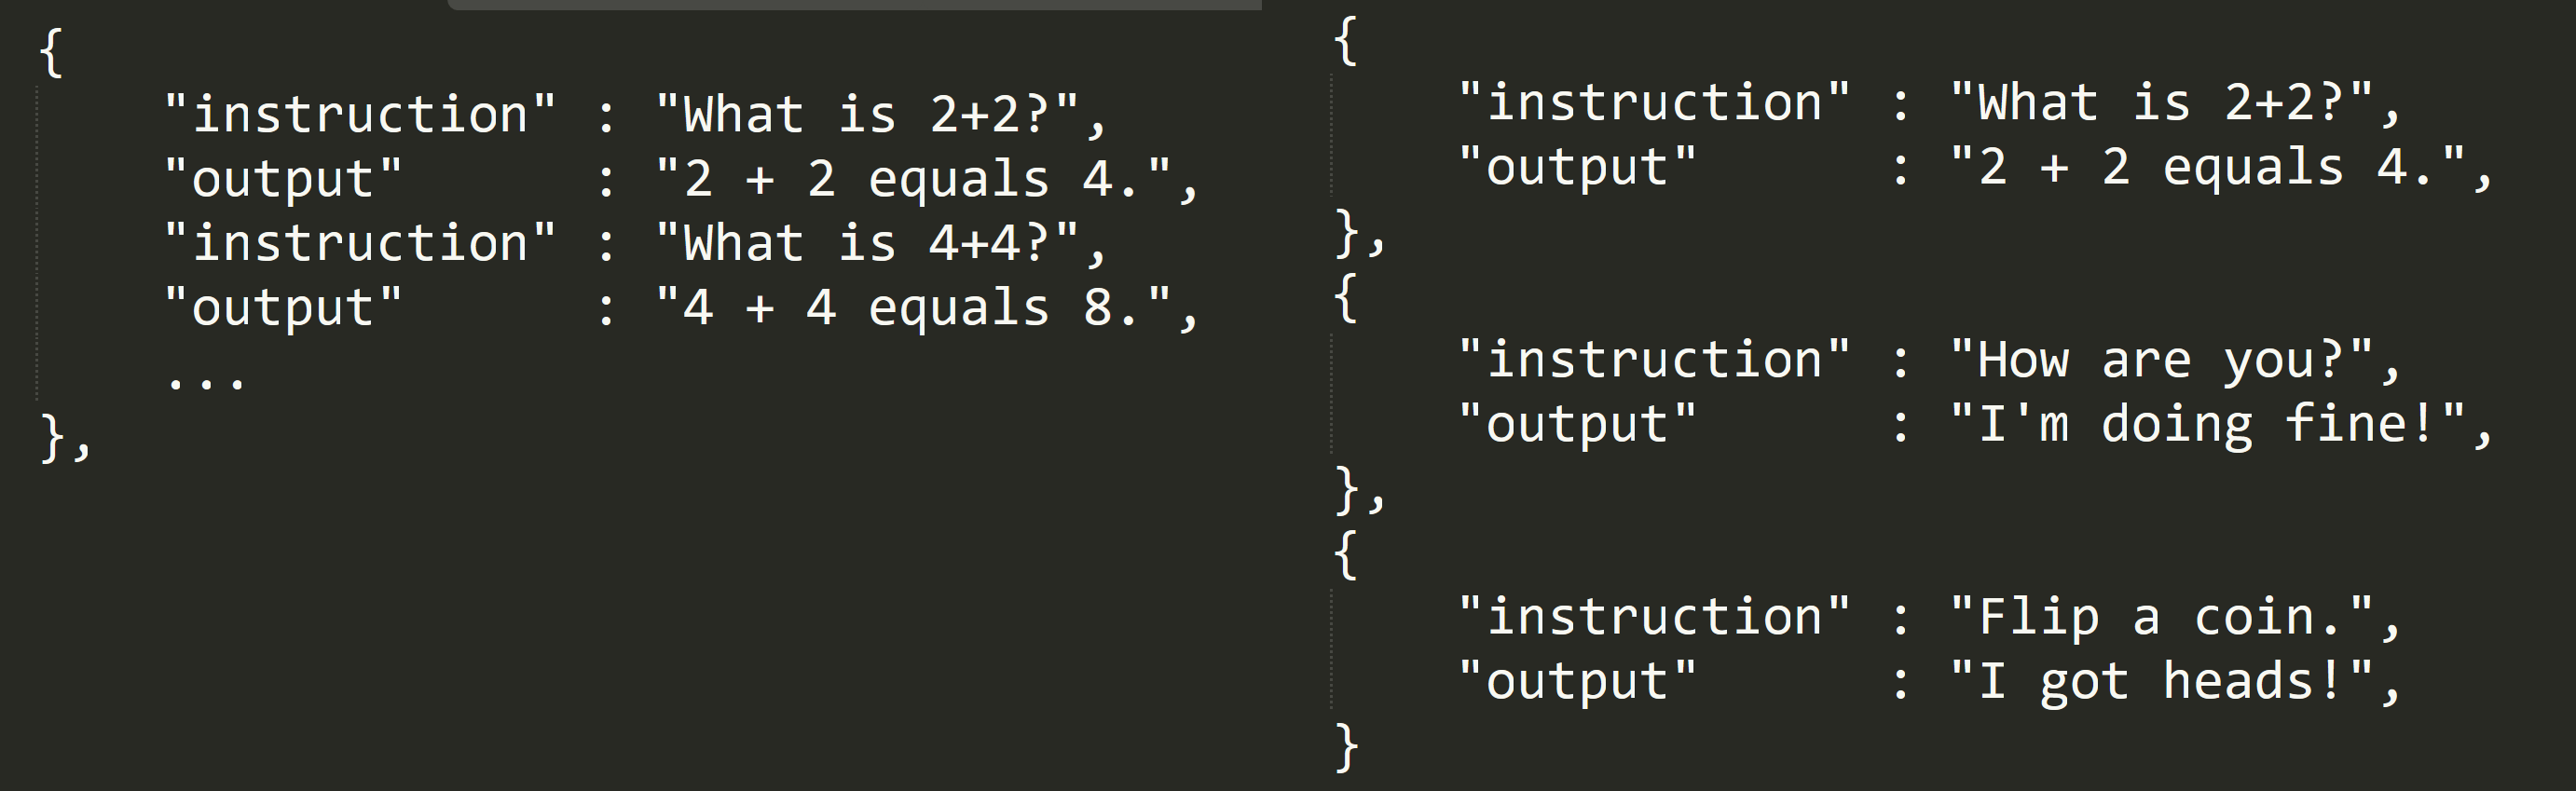
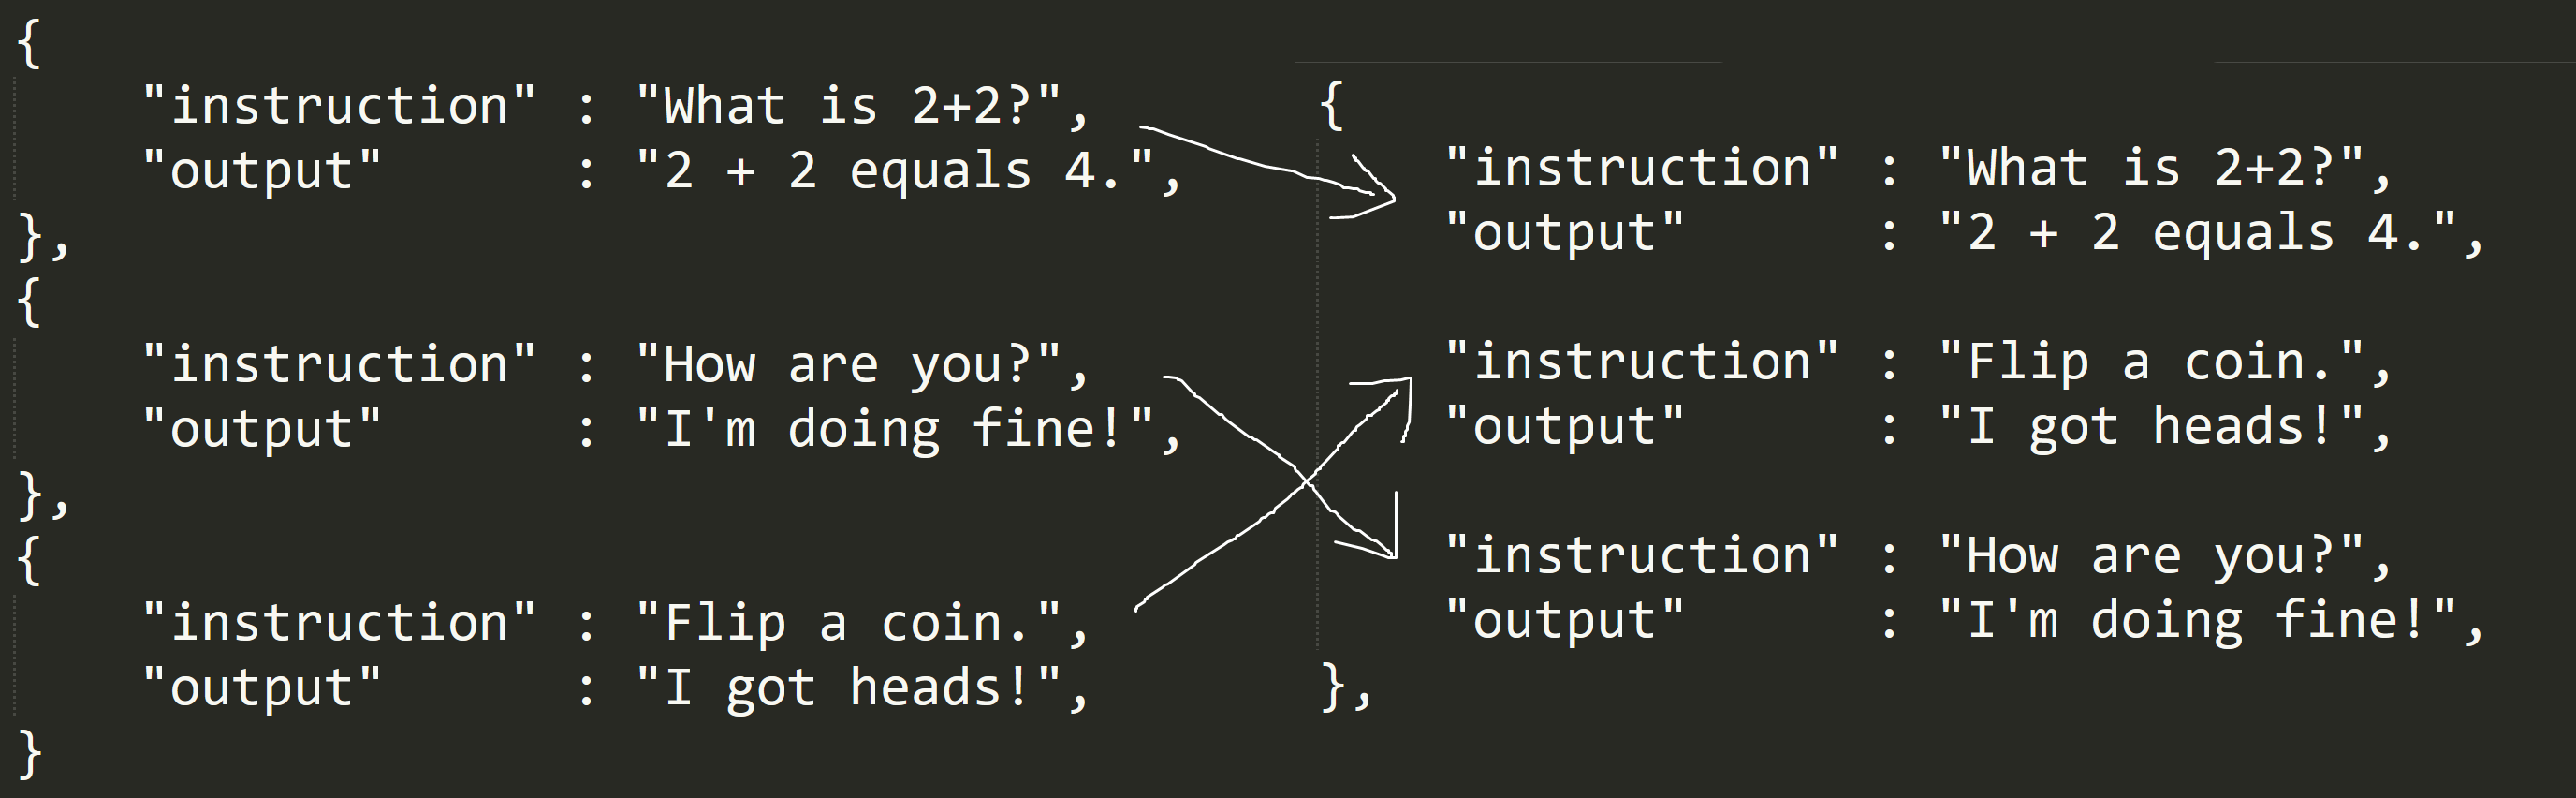
Ein Problem, falls dir das nicht aufgefallen ist: Der Alpaca-Datensatz ist einstufig, während ChatGPT interaktiv war und du in mehreren Runden mit ihm sprechen kannst. Links ist das, was wir wollen, rechts bietet der Alpaca-Datensatz jedoch nur einzelne Konversationen. Wir wollen, dass das feinabgestimmte Sprachmodell irgendwie lernt, Mehrturnus-Konversationen genau wie ChatGPT zu führen.

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2a65cd74ddd03a6bcbbc9827d9d034e4879a8e6a%2Fdiff.png?alt=media" alt=""><figcaption></figcaption></figure>

Daher haben wir `conversation_extension` Parameter eingeführt, der im Wesentlichen einige zufällige Zeilen in deinem einstufigen Datensatz auswählt und sie zu 1 Konversation zusammenführt! Wenn du ihn zum Beispiel auf 3 setzt, wählen wir zufällig 3 Zeilen aus und führen sie zu 1 zusammen! Zu lange Einstellungen können das Training verlangsamen, aber deinen Chatbot und das finale Fine-Tuning deutlich verbessern!

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2b1b3494b260f1102942d86143a885225c6a06f2%2Fcombine.png?alt=media" alt=""><figcaption></figcaption></figure>

Dann setze `output_column_name` zur Vorhersage- / Ausgabespalte. Beim Alpaca-Datensatz wäre das die Ausgabespalte.

Dann verwenden wir die `standardize_sharegpt` Funktion, um den Datensatz einfach in das richtige Format für das Fine-Tuning zu bringen! Immer aufrufen!

<figure><img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7bf83bf802191bda9e417bbe45afa181e7f24f38%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## Vision-Fine-Tuning

Der Datensatz für das Fine-Tuning eines Vision- oder Multimodalmodells enthält auch Bildeingaben. Zum Beispiel verwendet das [Llama 3.2 Vision Notebook](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX) einen radiologischen Fall, um zu zeigen, wie KI medizinischem Fachpersonal helfen kann, Röntgenaufnahmen, CT-Scans und Ultraschalluntersuchungen effizienter zu analysieren.

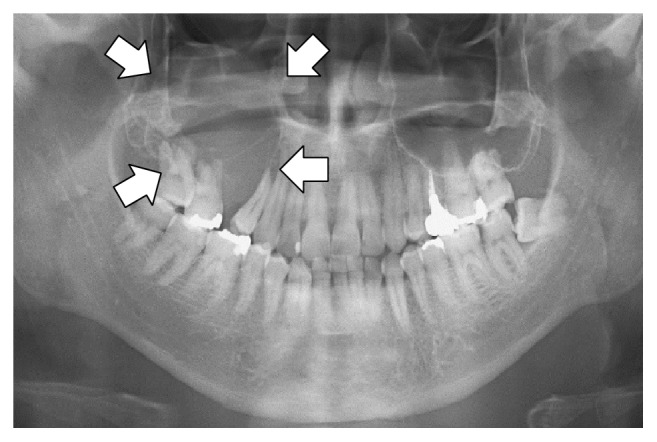
Wir verwenden eine Stichprobe des ROCO-Radiologiedatensatzes. Du kannst auf den Datensatz zugreifen [hier](https://www.google.com/url?q=https%3A%2F%2Fhuggingface.co%2Fdatasets%2Funsloth%2FRadiology_mini). Der Datensatz enthält Röntgenaufnahmen, CT-Scans und Ultraschallaufnahmen, die medizinische Zustände und Krankheiten zeigen. Jedes Bild hat eine von Experten verfasste Bildbeschreibung. Das Ziel ist es, ein VLM feinabzustimmen, damit es ein nützliches Analysewerkzeug für medizinisches Fachpersonal wird.

Sehen wir uns den Datensatz an und prüfen wir, was das 1. Beispiel zeigt:

```
Datensatz({
    features: ['image', 'image_id', 'caption', 'cui'],
    num_rows: 1978
})
```

| Bild                                                                                                                                                                                                                                  | Beschriftung                                                                                                                                    |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- |
| <img src="https://797013937-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-97d4489827403bd4795494f33d01a10979788c30%2Fxray.png?alt=media" alt="" data-size="original"> | Die panoramische Radiografie zeigt eine osteolytische Läsion im rechten hinteren Oberkiefer mit Resorption des Bodens der Kieferhöhle (Pfeile). |

Um den Datensatz zu formatieren, sollten alle Vision-Fine-Tuning-Aufgaben wie folgt formatiert werden:

```python
[
{ "role": "user",
  "content": [{"type": "text",  "text": instruction}, {"type": "image", "image": image} ]
},
{ "role": "assistant",
  "content": [{"type": "text",  "text": answer} ]
},
]
```

Wir werden eine benutzerdefinierte Anweisung formulieren, die das VLM auffordert, ein Experte für Radiografie zu sein. Beachte auch, dass du statt nur 1 Anweisung mehrere Gesprächsrunden hinzufügen kannst, um daraus eine dynamische Konversation zu machen.

```notebook-python
instruction = "Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst."

def convert_to_conversation(sample):
    conversation = [
        { "role": "user",
          "content" : [
            {"type" : "text",  "text"  : instruction},
            {"type" : "image", "image" : sample["image"]} ]
        },
        { "role" : "assistant",
          "content" : [
            {"type" : "text",  "text"  : sample["caption"]} ]
        },
    ]
    return { "messages" : conversation }
pass
```

Lass uns den Datensatz für das Fine-Tuning in das „richtige“ Format umwandeln:

```notebook-python
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```

Das erste Beispiel ist jetzt wie unten strukturiert:

```notebook-python
converted_dataset[0]
```

{% code overflow="wrap" %}

```
{'messages': [{'role': 'user',
   'content': [{'type': 'text',
     'text': 'Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst.'},
    {'type': 'image',
     'image': <PIL.PngImagePlugin.PngImageFile image mode=L size=657x442>}]},
  {'role': 'assistant',
   'content': [{'type': 'text',
     'text': 'Die panoramische Radiografie zeigt eine osteolytische Läsion im rechten hinteren Oberkiefer mit Resorption des Bodens der Kieferhöhle (Pfeile).'}]}]}
```

{% endcode %}

Bevor wir irgendein Fine-Tuning durchführen, weiß das Vision-Modell vielleicht bereits, wie man die Bilder analysiert? Prüfen wir, ob das der Fall ist!

```notebook-python
FastVisionModel.for_inference(model) # Für die Inferenz aktivieren!

image = dataset[0]["image"]
instruction = "Du bist ein Experte für Radiografie. Beschreibe genau, was du in diesem Bild siehst."

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": instruction}
    ]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt = True)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to("cuda")

from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 128,
                   use_cache = True, temperature = 1.5, min_p = 0.1)
```

Und das Ergebnis:

```
Diese Röntgenaufnahme scheint eine Panoramaansicht des oberen und unteren Gebisses zu sein, insbesondere ein Orthopantomogramm (OPG).

* Die panoramische Röntgenaufnahme zeigt normale Zahnstrukturen.
* Es gibt einen abnormalen Bereich oben rechts, dargestellt durch einen Bereich strahlentransparenter Knochen, der dem Antrum entspricht.

**Wichtige Beobachtungen**

* Der Knochen zwischen den linken oberen Zähnen ist relativ strahlenundurchlässig.
* Über dem Bild befinden sich zwei große Pfeile, was auf die Notwendigkeit einer genaueren Untersuchung dieses Bereichs hindeutet. Einer der Pfeile befindet sich links, der andere rechts. Allerdings nur
```

Weitere Details findest du in unserem Datenabschnitt im [Notebook hier](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX).


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/de/loslegen/fine-tuning-llms-guide/datasets-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.