> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).

# チュートリアル: GRPOで自分の推論モデルを学習する

UnslothとGRPOを使って、Llama 3.1（8B）のようなモデルを推論モデルへ変換する初心者向けガイド。

DeepSeekが開発した [GRPO](https://unsloth.ai/blog/grpo) （Group Relative Policy Optimization）を使って、R1推論モデルを学習させました。

### クイックスタート

これらの手順は、あらかじめ用意したGoogle Colab用です [ノートブック](/docs/jp/meru/unsloth-notebooks.md)。Unslothをローカルにインストールする場合は、お気に入りのコードエディタ内にノートブックをコピーすることもできます。以下のいずれかのノートブックを使用します:

| [**Qwen3.5（4B）**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - 新規** | [**gpt-oss-20b**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) **-** GSPO    | [Gemma 3（4B）](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - ビジョンGSPO            |
| ----------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------- |
| [**Qwen3（4B）**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Advanced                   | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - ビジョンGSPO | [Llama 3.2（3B）](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Advanced |

{% stepper %}
{% step %}

#### Unslothをインストール

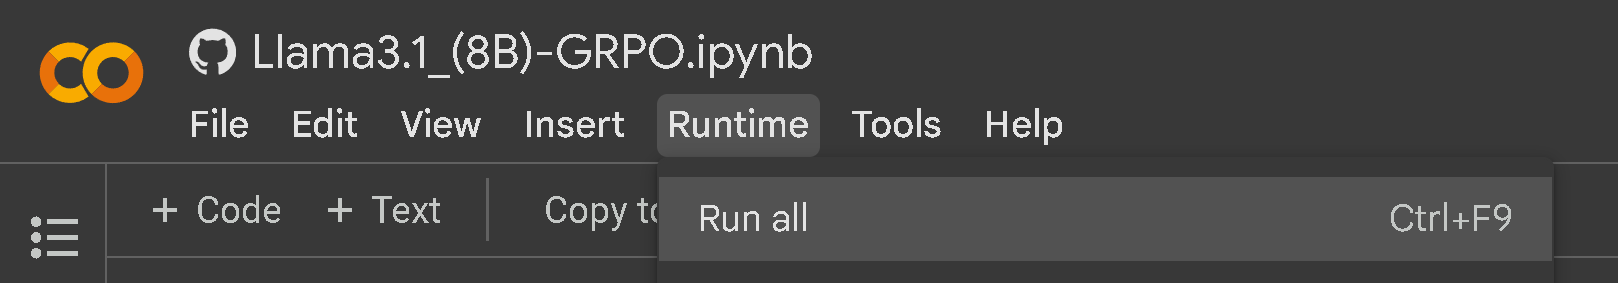
Colabノートブックを使用している場合は、次をクリックしてください **Runtime > Run all**。ぜひ次もご覧になることを強くおすすめします [ファインチューニングガイド](/docs/jp/meru/fine-tuning-llms-guide.md) 始める前に。

ローカルにインストールする場合は、適切な [要件](/docs/jp/meru/fine-tuning-for-beginners/unsloth-requirements.md) を確認し、 `pip install unsloth` Linuxでは次を使用するか、または次の [Windowsのインストール ](/docs/jp/meru/install/windows-installation.md)手順に従ってください。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-313fa39c229225ae9d39b7c7a0d05c9005ddb94c%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### GRPOと報酬関数について学ぶ

始める前に、GRPO、報酬関数、そしてそれらの仕組みについてもっと学ぶことをおすすめします。以下も含めて詳しく読む: [コツとテクニック](/docs/jp/meru/reinforcement-learning-rl-guide.md#basics-tips)[ ここ](/docs/jp/meru/reinforcement-learning-rl-guide.md#basics-tips).

十分なVRAMも必要です。一般的に、モデルのパラメータ数＝必要なVRAM量です。Colabでは、無料の16GB VRAM GPUを使用しており、最大16Bパラメータまでのどのモデルでも学習できます。
{% endstep %}

{% step %}

#### 希望する設定を構成する

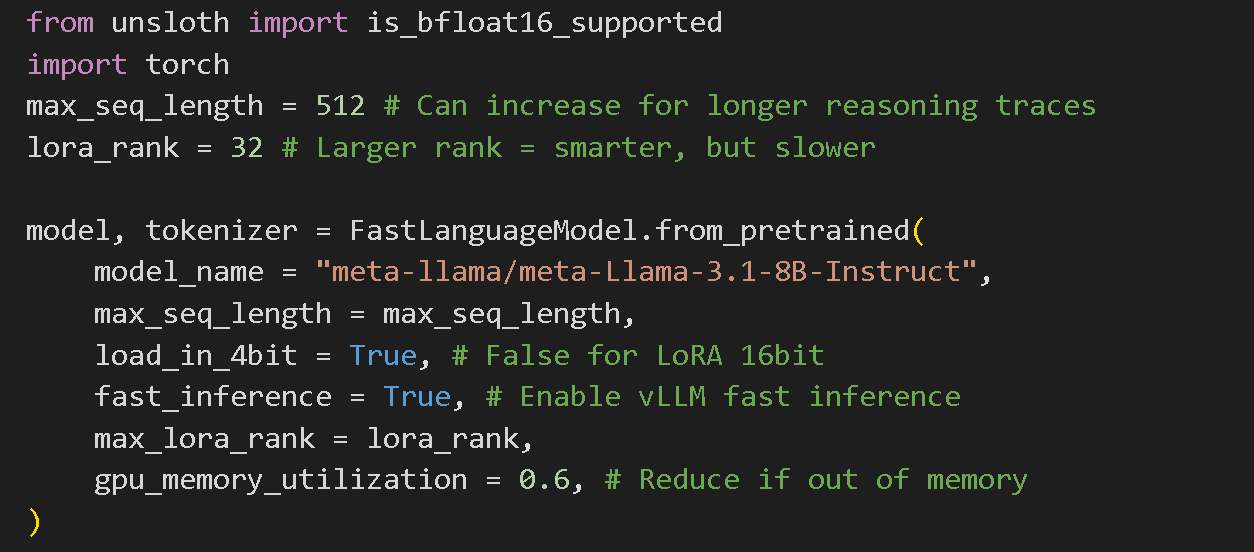
最高の結果が得られるよう最適な設定はすでに選択済みで、モデルは次の一覧にある任意のものに変更できます: [対応モデル](/docs/jp/meru/unsloth-model-catalog.md)。初心者であれば、他の設定を変更することはおすすめしません。

{% hint style="success" %}
以下では **高度なGRPO** バッチ処理、生成、学習パラメータに関するドキュメント、 [ガイドをお読みください！](/docs/jp/meru/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b1e9fac448706ac87dff7e7eff1298655dda456e%2Fimage.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### データ準備

OpenAIの [GSM8K](https://huggingface.co/datasets/openai/gsm8k) のデータセットを選択済みです。これは小学校レベルの数学問題を含んでいますが、あなた自身のものやHugging Face上の任意の公開データセットに変更できます。次についてさらに読むことができます: [データセットはこちら](/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md).

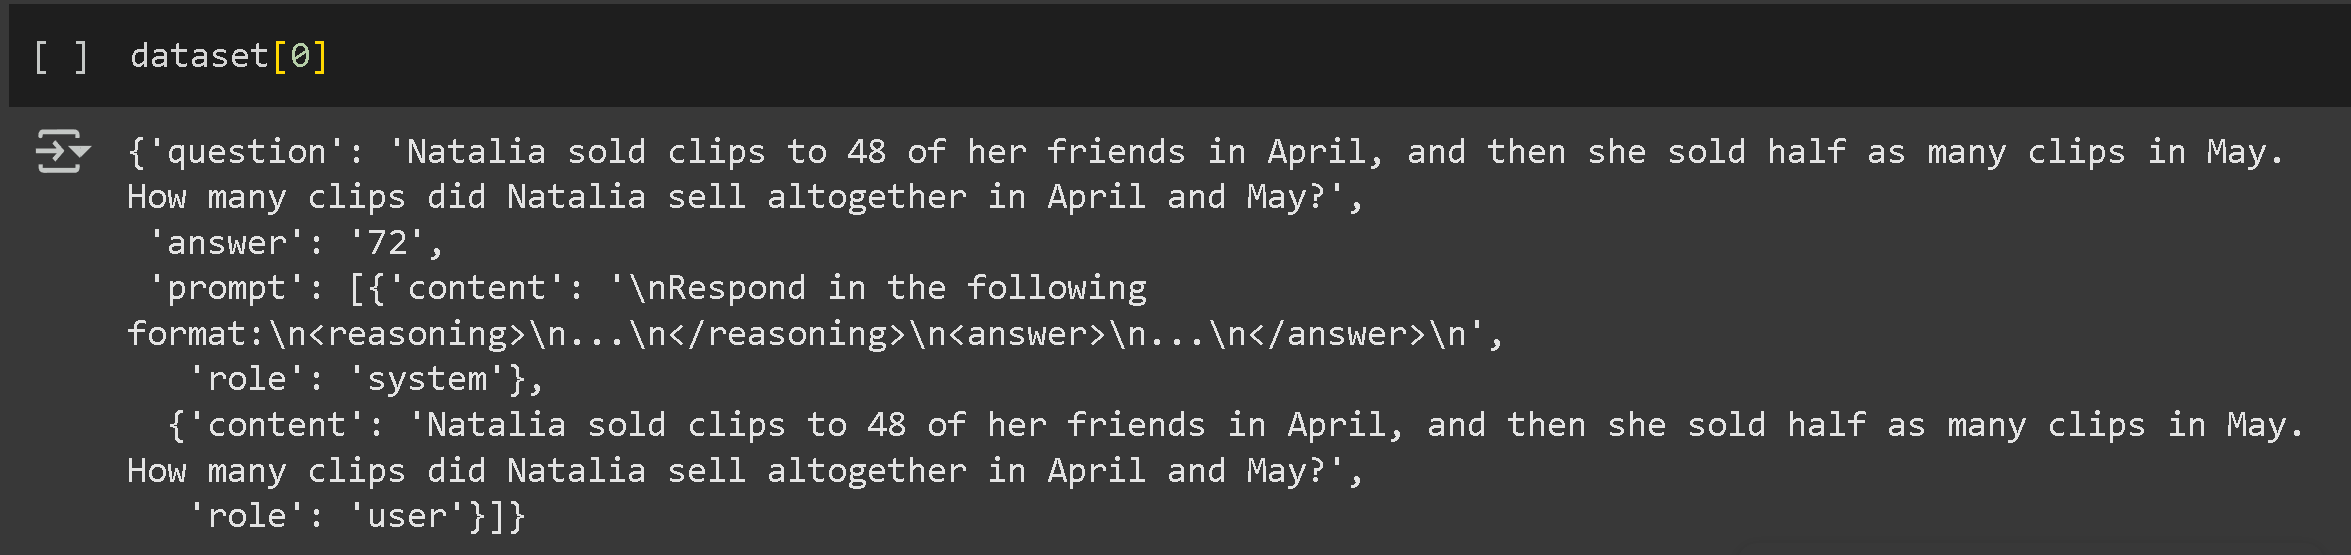
データセットには、質問と回答のペア用に少なくとも2列必要です。ただし、回答には、質問からどのように答えを導き出したかという推論を含めてはいけません。例は以下をご覧ください:

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-14a1ee796547f725abbd1097f2b0f9e4e6cc5976%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

データを構成して、モデルが答えを出す前に推論を明確に述べるよう促します。まず、プロンプトと応答の両方に明確な形式を定めます。

```
# モデルに特定の形式を使うよう指示するシステムプロンプトを定義する
SYSTEM_PROMPT = """
次の形式で応答してください:
<reasoning>
...
</reasoning>
<answer>
...
</answer>
"""

XML_COT_FORMAT = """\
<reasoning>
{reasoning}
</reasoning>
<answer>
{answer}
</answer>
"""
```

では、データセットを準備します:

```
import re
from datasets import load_dataset, Dataset


# さまざまな形式から答えを抽出するヘルパー関数
def extract_xml_answer(text: str) -> str:
    answer = text.split("<answer>")[-1]
    answer = answer.split("</answer>")[0]
    return answer.strip()


def extract_hash_answer(text: str) -> str | None:
    if "####" not in text:
        return None
    return text.split("####")[1].strip()


# GSM8Kデータセットを準備する関数
def get_gsm8k_questions(split="train") -> Dataset:
    data = load_dataset("openai/gsm8k", "main")[split]
    data = data.map(
        lambda x: {
            "prompt": [
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": x["question"]},
            ],
            "answer": extract_hash_answer(x["answer"]),
        }
    )
    return data


dataset = get_gsm8k_questions()
```

データセットは、答えを抽出し、構造化された文字列として整形することで準備されます。
{% endstep %}

{% step %}

#### 報酬関数/検証器

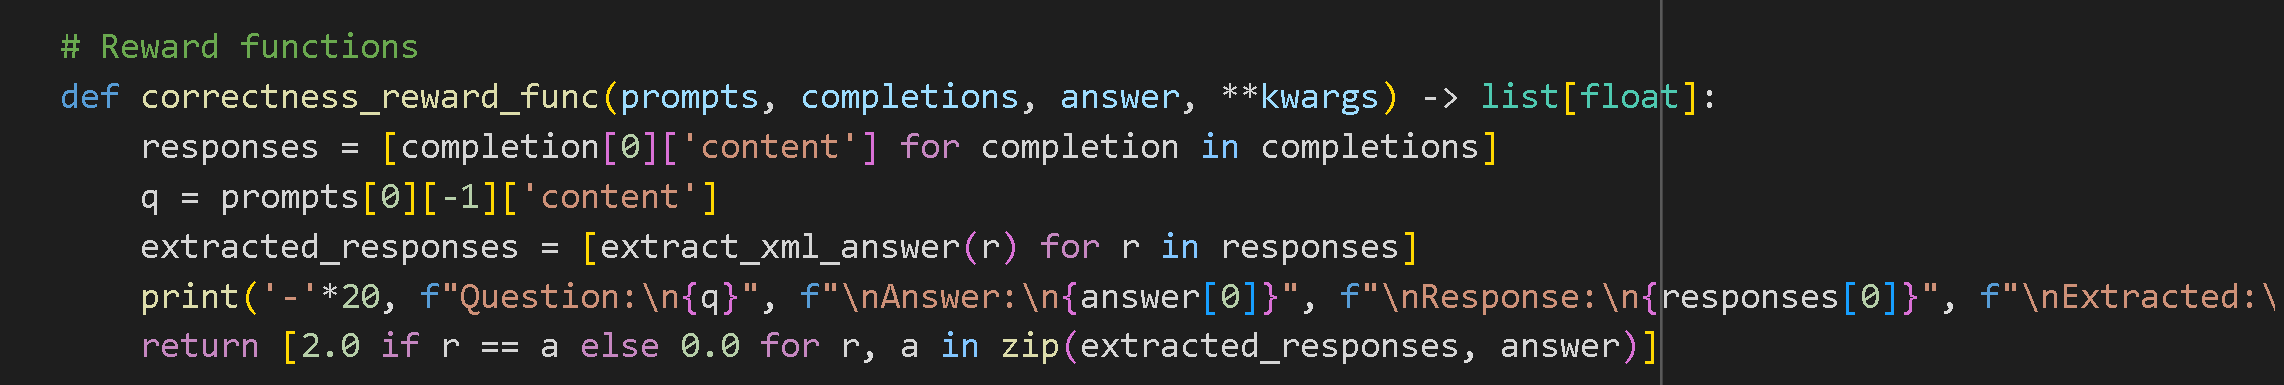
[報酬関数/検証器](/docs/jp/meru/reinforcement-learning-rl-guide.md#reward-functions-verifier) 提供されたデータセットに基づいて、モデルがうまく学習できているかどうかを判断できます。各生成実行は、他の生成の平均スコアに対してどれだけ良いかで評価されます。独自の報酬関数を作成することもできますが、私たちはすでに次であらかじめ選択しています: [WillのGSM8K](/docs/jp/meru/reinforcement-learning-rl-guide.md#gsm8k-reward-functions) 報酬関数。これにより、各生成に報酬を与える5つの異なる方法があります。

生成結果をChatGPT 4oやLlama 3.1 (8B)のようなLLMに入力して、評価用の報酬関数と検証器を設計できます。たとえば、生成結果を任意のLLMに入力し、「答えが機械的すぎると感じたら3点減点する」というルールを設定します。これにより、品質基準に基づいて出力を改善できます。 **例を見る** どのような見た目になるか [ここ](/docs/jp/meru/reinforcement-learning-rl-guide.md#reward-function-examples).

**メール自動化タスクの報酬関数の例:**

* **質問:** 受信メール
* **回答:** 送信メール
* **報酬関数:**
  * 答えに必須キーワードが含まれている場合 → **+1**
  * 答えが理想的な応答と完全に一致する場合 → **+1**
  * 応答が長すぎる場合 → **-1**
  * 受信者の名前が含まれている場合 → **+1**
  * 署名ブロック（電話番号、メール、住所）が含まれている場合 → **+1**

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-95cd00b6a52b8161b31a2399e25863ee0349920e%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### モデルを学習する

最高の結果のためのハイパーパラメータはあらかじめ選択済みですが、変更することもできます。詳しくは次をご覧ください: [パラメータはこちら](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md)。以下は **高度なGRPO** バッチ処理、生成、学習パラメータに関するドキュメント、 [ガイドをお読みください！](/docs/jp/meru/reinforcement-learning-rl-guide/advanced-rl-documentation.md)

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a22d3475d925d2d858c9fcc228f0e13893eff0f9%2Fimage.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

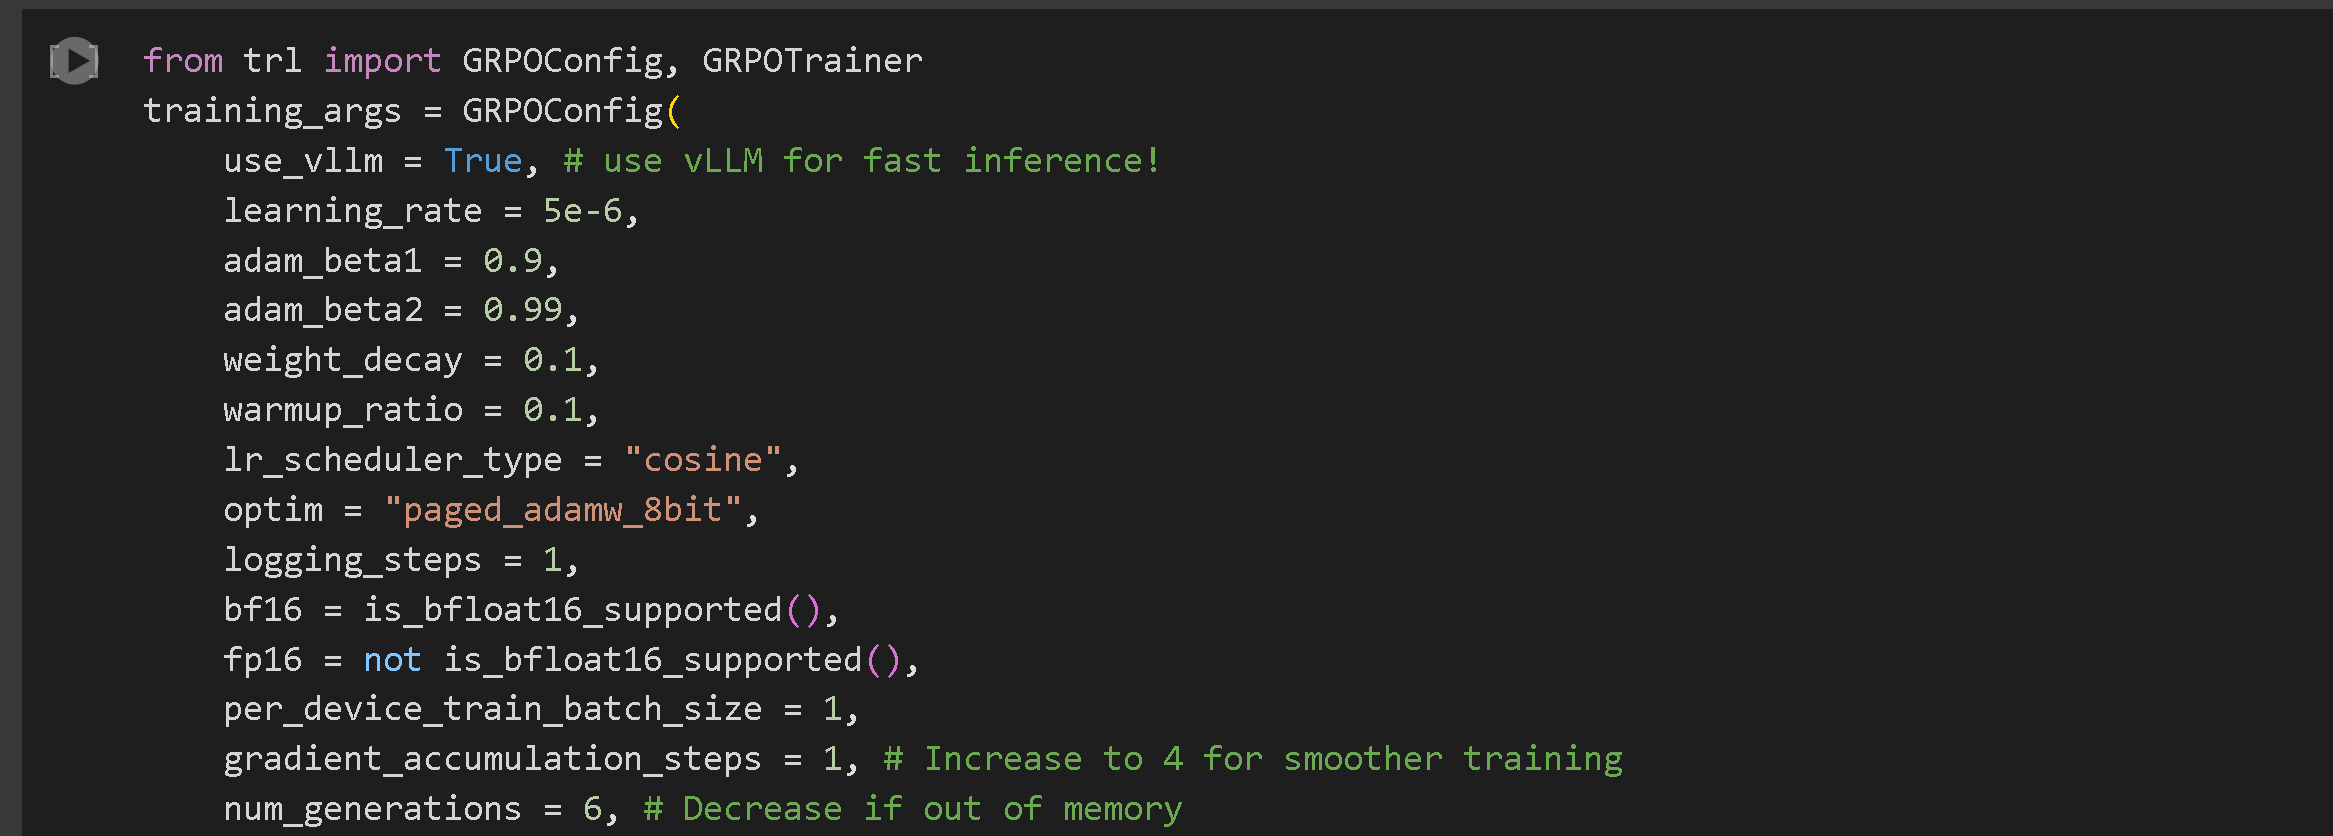
その **GRPOConfig** 学習の主要なハイパーパラメータを定義します:

* `use_vllm`: vLLMを使った高速推論を有効にします。
* `learning_rate`: モデルの学習速度を決定します。
* `num_generations`: 1つのプロンプトごとに生成される完了数を指定します。
* `max_steps`: 総学習ステップ数を設定します。

{% hint style="success" %}
**新登場！** 現在、DAPO、Dr. GRPO、およびその他ほとんどの新しいGRPO手法をサポートしています。GRPOConfigで次の引数を試して有効化できます:

```python
epsilon=0.2,
epsilon_high=0.28, # 片側
delta=1.5 # 両側

loss_type='bnpo',
# または:
loss_type='grpo',
# または:
loss_type='dr_grpo',
# または:
loss_type='dapo',

mask_truncated_completions=True,
```

{% endhint %}

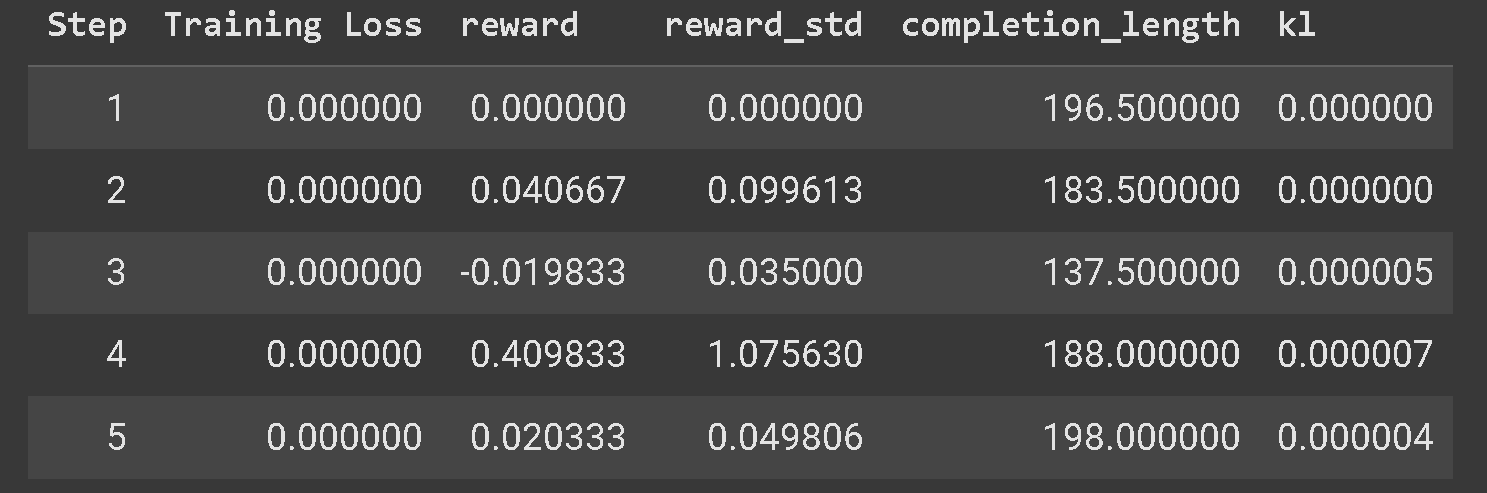
時間の経過とともに報酬が増えていくはずです。少なくとも300ステップは学習することをおすすめします。30分ほどかかる場合がありますが、最適な結果のためには、もっと長く学習してください。

{% hint style="warning" %}
GRPOモデルが学習しない問題がある場合は、ぜひ次を使うことを強くおすすめします: [高度なGRPOノートブック](/docs/jp/meru/unsloth-notebooks.md#grpo-reasoning-notebooks) より優れた報酬関数があるため、結果がより速く、より頻繁に得られるはずです。
{% endhint %}

サンプル回答も表示され、モデルがどのように学習しているかを確認できます。ステップ、XMLタグ、試行などが含まれる場合もあります。学習が進むにつれて、望む出力が得られるまで、長い推論連鎖を持つ回答としてスコアがどんどん高くなり、どんどん良くなっていくという考え方です。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-f33d6f494605ab9ca69a0b697ed5865dd3a30b18%2Fimage.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>
{% endstep %}

{% step %}

#### モデルを実行して評価する

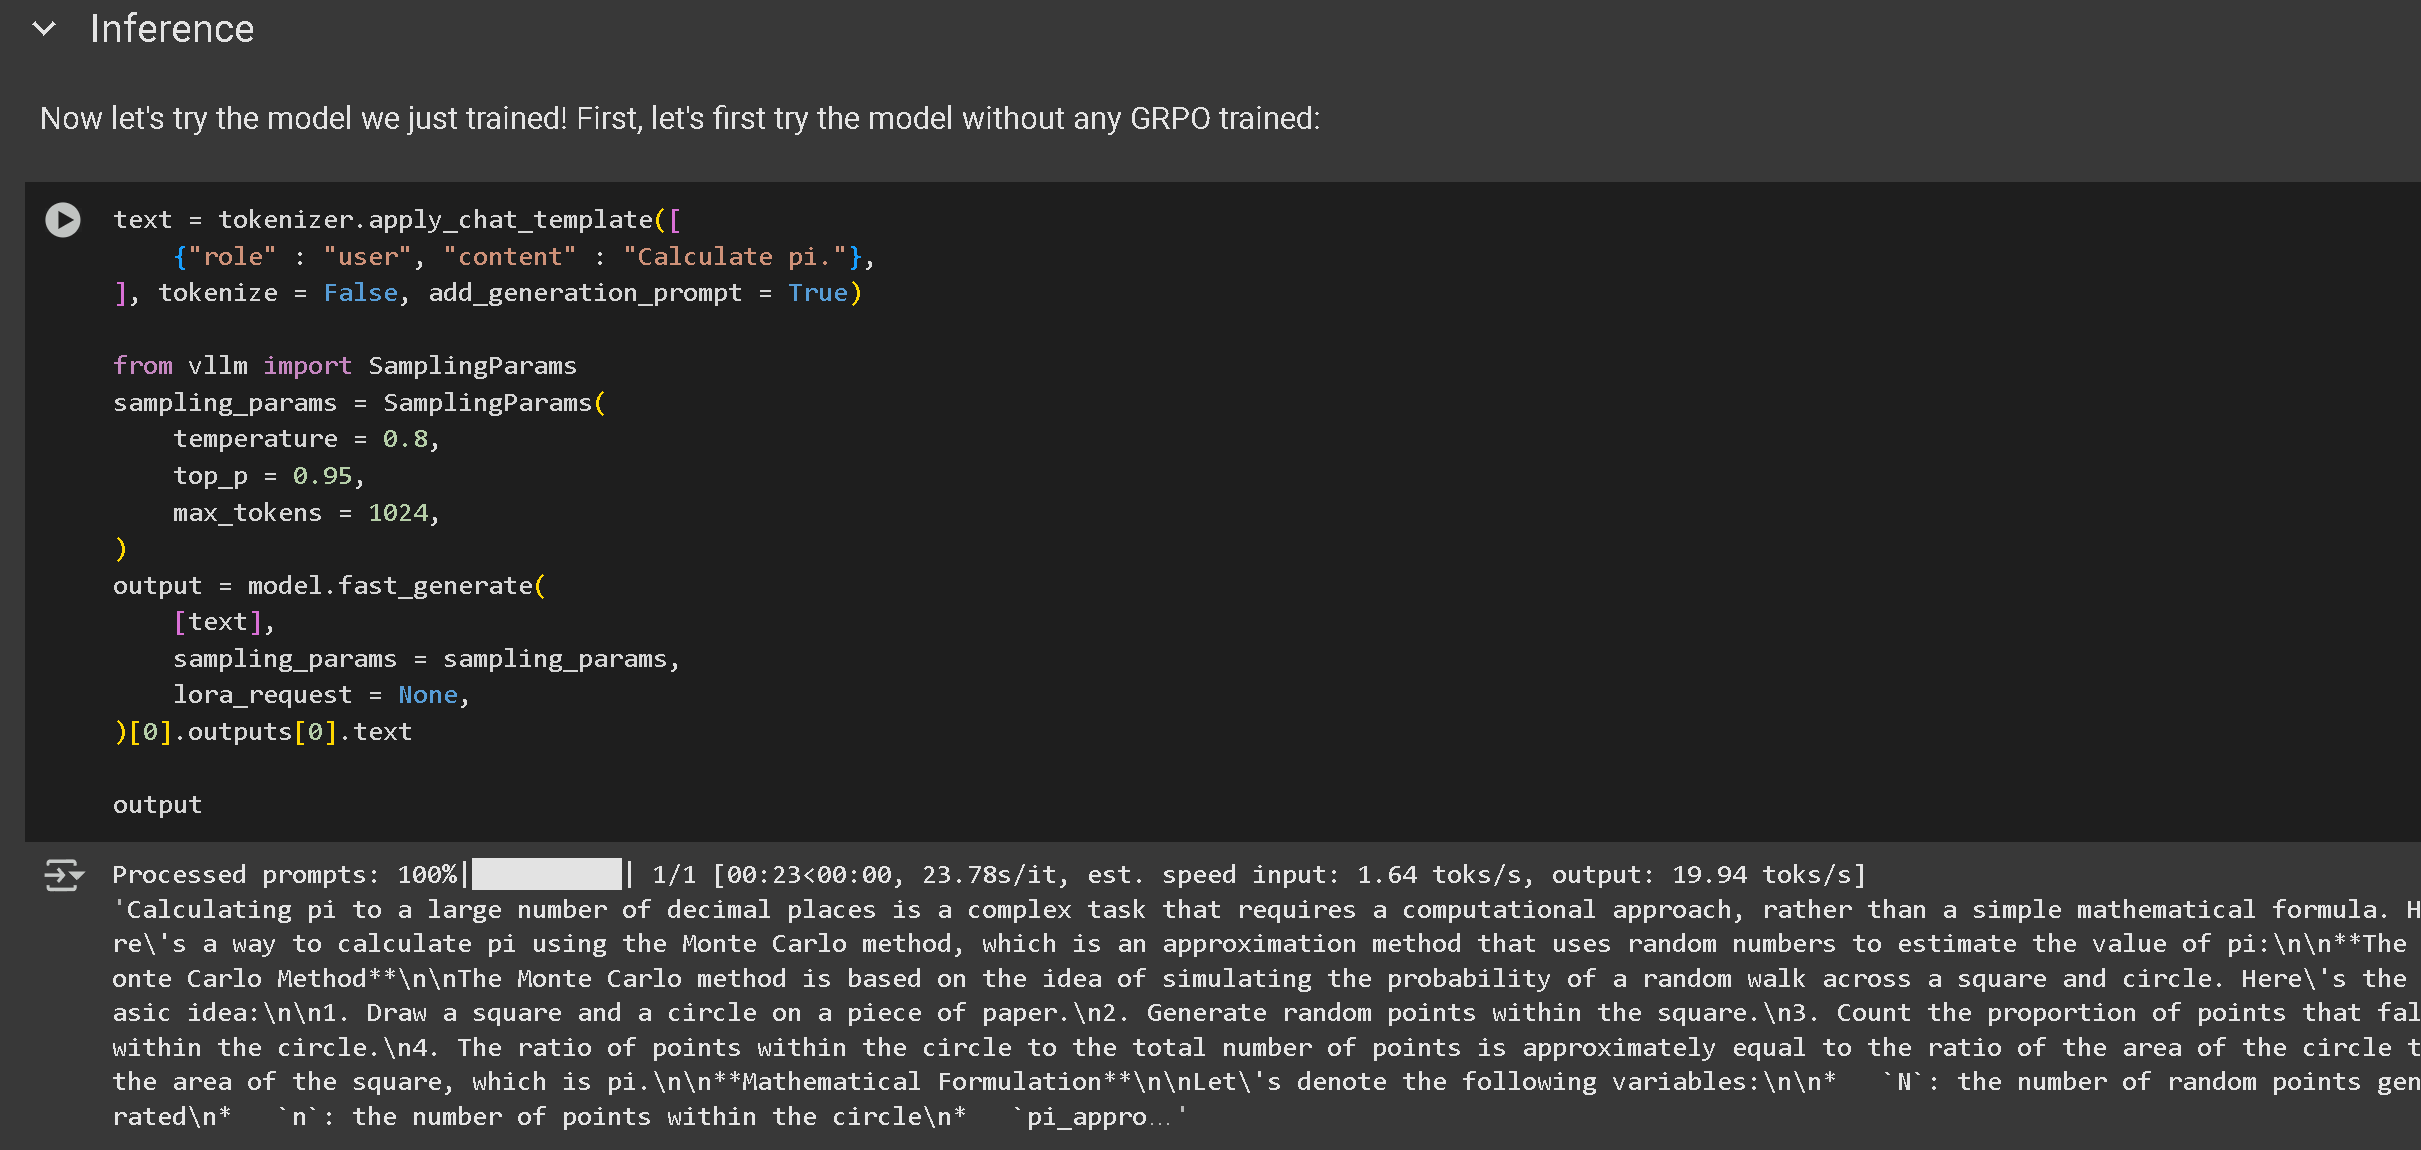
再生ボタンをクリックしてモデルを実行します。最初の例では、通常、回答に推論は含まれていません。推論を見るには、まずGRPOで学習したLoRA重みを次のように保存する必要があります:

<pre><code><strong>model.save_lora("grpo_saved_lora")
</strong></code></pre>

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1ab351622655983aeda4d9d6d217cf354cb280be%2Fimage%20(10)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>最初の推論例の実行では推論はありません。推論を表示するには、LoRAを読み込んでテストする必要があります。</p></figcaption></figure>

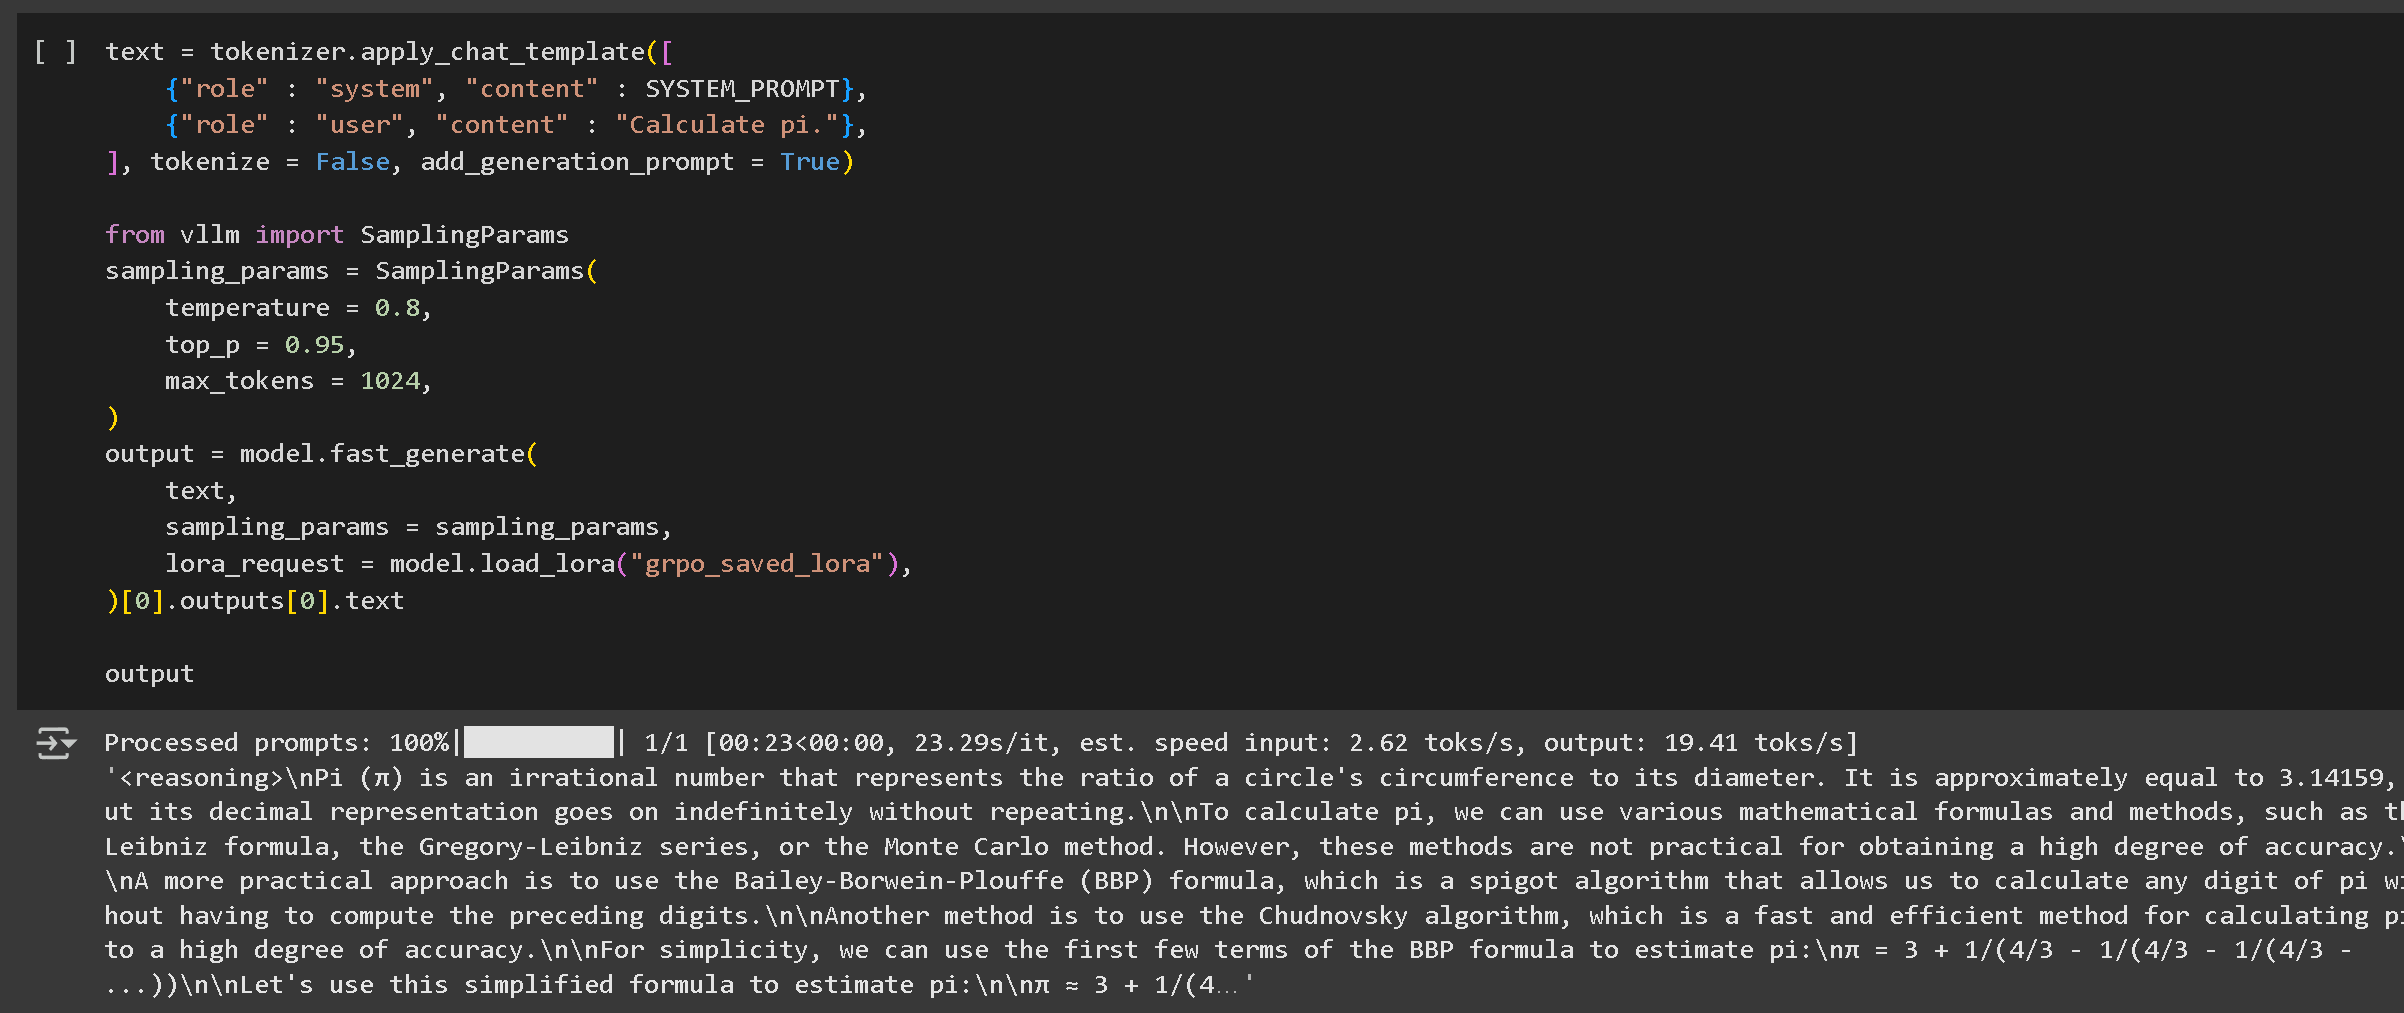
それからLoRAを読み込んでテストします。私たちの推論モデルはずっと優れています。とはいえ、1時間ほどしか学習していないので、常に正しいわけではありません。シーケンス長を延ばして、もっと長く学習すればさらに良くなります！

その後、次に従ってモデルをGGUF、Ollamaなどに保存できます: [こちらのガイド](https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide/pages/ae7926a0f371a1f594e3344d85571edf864a5259#id-7.-running--saving-the-model).

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-38fa0c97184487aaa6b259f5b23b7f27345871d8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

それでも推論が得られない場合は、学習ステップ数が少なすぎたか、報酬関数/検証器が最適でなかった可能性があります。
{% endstep %}

{% step %}

#### モデルを保存する

微調整済みモデルを保存する方法はいくつかありますが、ここでは最も簡単で人気のある方法に絞ります。詳細は次をご覧ください: [ここ](/docs/jp/ji-chu/inference-and-deployment.md)

**16ビット精度で保存**

次のコマンドでモデルを16ビット精度で保存できます:

```python
# 16ビット精度で保存
model.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")
```

**Hugging Face Hubへの公開**

モデルを共有するには、次を使ってHugging Face Hubへ公開します: `push_to_hub_merged` メソッド。これにより、複数の量子化形式でモデルを保存できます。

```python
# Hugging Face Hubへ公開（トークンが必要）
model.push_to_hub_merged(
    "your-username/model-name", tokenizer, save_method="merged_16bit", token="your-token"
)
```

**llama.cpp向けにGGUF形式で保存**

Unslothは次の形式での保存もサポートしています **GGUF 形式に**、これにより次と互換性があります **llama.cpp** そして **Ollama**.

```python
model.push_to_hub_gguf(
    "your-username/model-name",
    tokenizer,
    quantization_method=["q4_k_m", "q8_0", "q5_k_m"],
    token="your-token",
)
```

GGUF形式で保存すれば、モデルは次を使って軽量環境に簡単にデプロイできます **llama.cpp** または他の推論エンジンで使用できます。
{% endstep %}
{% endstepper %}

## 動画チュートリアル

私たちが素晴らしいと思う、すごいYouTuberたちが作成した動画チュートリアルをご紹介します！

{% embed url="<https://www.youtube.com/watch?v=9t-BAjzBWj8>" %}

{% columns %}
{% column width="50%" %}
{% embed url="<https://www.youtube.com/watch?t=3289s&v=bbFEYPx9Hpo>" %}
データセットの準備方法や、強化学習＋GRPOの基礎の背景説明を学ぶのに最適です
{% endembed %}

{% embed url="<https://www.youtube.com/watch?v=oF0_eMhzRaQ>" %}
{% endcolumn %}

{% column width="50%" %}
{% embed url="<https://www.youtube.com/watch?v=juOh1afy-IE>" %}

{% embed url="<https://www.youtube.com/watch?v=SoPE1cUz3Hs>" %}
自分のデバイスでローカルGRPO
{% endembed %}
{% endcolumn %}
{% endcolumns %}


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.