> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide.md).

# LLMファインチューニングガイド

ファインチューニングの基本とベストプラクティスをすべて学べます。初心者向けです。

## 1. ファインチューニングとは？

ファインチューニング／トレーニング／ポストトレーニングは、モデルの挙動をカスタマイズし、知識を強化・注入し、特定のドメインやタスク向けに性能を最適化します。たとえば：

* OpenAIの **GPT-5** は、指示追従と役立つチャット挙動を改善するためにポストトレーニングされました。
* ポストトレーニングの標準的な手法は、教師ありファインチューニング（SFT）と呼ばれます。その他の手法には、選好最適化（DPO、ORPO）、蒸留、そして [強化学習（RL）](/docs/jp/meru/reinforcement-learning-rl-guide.md) （GRPO、GSPO）があり、ここでは「エージェント」が環境とやり取りし、 **フィードバック** という形で **報酬** または **ペナルティ**.

〜を使えば [Unsloth](https://github.com/unslothai/unsloth)、当社の [ノートブック](https://docs.unsloth.ai/get-started/unsloth-notebooks). データセットで事前学習済みモデルをファインチューニングすることで、

* **更新 + 新しい知識を学習**：新しいドメイン固有の情報を注入し、学習します。
* **振る舞いをカスタマイズする**：モデルのトーン、個性、応答スタイルを調整します。
* **タスクに最適化する**：特定のユースケースにおける精度と関連性を向上させます。

**ファインチューニングまたはRLの使用例**:

* LLMが見出しが企業にポジティブかネガティブかを予測できるようにします。
* 過去の顧客とのやり取りを使って、より正確でカスタムな応答を生成できます。
* 契約分析、判例調査、コンプライアンスのために、法律文書でLLMをファインチューニングします。

ファインチューニングされたモデルは、特定のタスクをより効果的かつ効率的に実行するために設計された専門エージェントだと考えられます。 **ファインチューニングはRAGのすべての機能を再現できます**が、逆はできません。

{% columns %}
{% column %}

#### :question:LoRA/QLoRAとは？

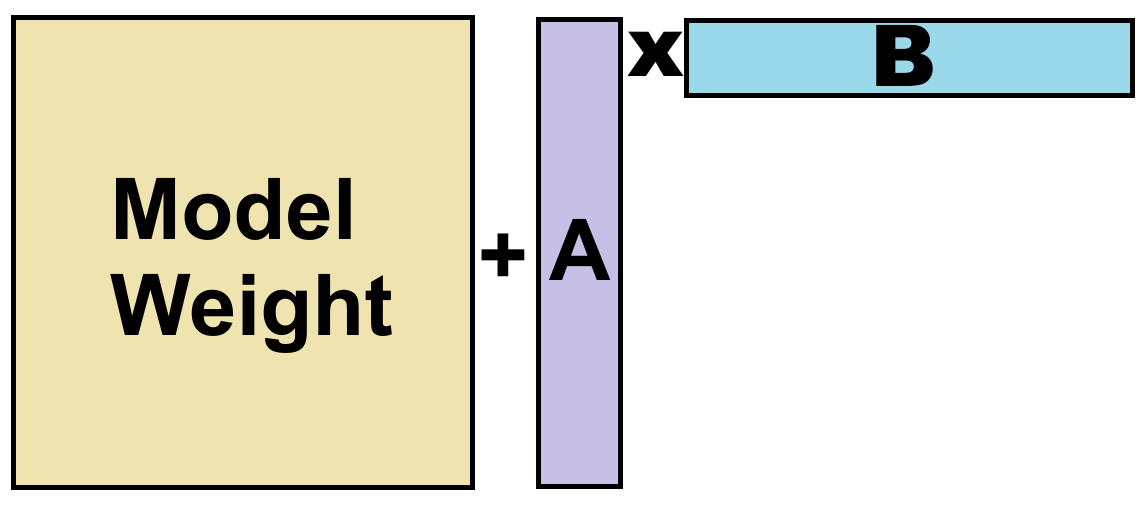
LLMにはモデルの重みがあります。Llama 70Bには700億個の数値があります。70Bすべての数値を変更する代わりに、各重みに対して薄い行列AとBを追加し、それらを最適化します。つまり、最適化する重みは1%だけです。LoRAは元のモデルが16ビットの非量子化であるのに対し、QLoRAはメモリを75%節約するために4ビットに量子化します。
{% endcolumn %}

{% column %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>モデルの重み（黄色）を最適化する代わりに、2つの薄い行列AとBを最適化します。</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

#### ファインチューニングに関する誤解：

ファインチューニングではモデルが新しい知識を学習できない、あるいはRAGのほうがファインチューニングより優れていると聞いたことがあるかもしれません。これは **false**。ファインチューニングとRLで特化したコーディングモデルを学習できますが、RAGはモデルの重みを変更できず、推論時にモデルが見る情報を補強するだけです。FAQ＋誤解についてもっと読む [ここ](https://unsloth.ai/docs/jp/meru/pages/fffb67e71b118ce93cf382a53722ac7a1a41dd7c#fine-tuning-vs.-rag-whats-the-difference):

{% content-ref url="/pages/fffb67e71b118ce93cf382a53722ac7a1a41dd7c" %}
[FAQ + ファインチューニングは自分に向いている？](/docs/jp/meru/fine-tuning-for-beginners/faq-+-is-fine-tuning-right-for-me.md)
{% endcontent-ref %}

> [**Unsloth Studioのご紹介：** ](/docs/jp/shii/studio.md) モデルの学習と実行のための新しいオープンソースWeb UIです。つまり、ノーコードでモデルをファインチューニングでき、可観測性と自動データセット作成機能を利用できます。

<div data-with-frame="true"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FxV1PO5DbF3ksB51nE2Tw%2Fmore%20cropped%20ui%20for%20homepage.png?alt=media&amp;token=f75942c9-3d8d-4b59-8ba2-1a4a38de1b86" alt="" width="563"><figcaption></figcaption></figure></div>

## 2. 適切なモデル＋手法を選ぶ

初心者なら、Llama 3.1（8B）のような小さなインストラクトモデルから始めて、そこから試していくのが最善です。また、通常のファインチューニング、RL、QLoRA、LoRAトレーニングのどれにするかも決める必要があります：

* **強化学習（RL）** は、ラベル付きデータではなく、環境と報酬関数を使って、特定の振る舞い（例：ツール呼び出し）に優れたモデルが必要なときに使われます。いくつかの [ノートブックの例](/docs/jp/meru/unsloth-notebooks.md#grpo-reasoning-rl-notebooks)がありますが、ほとんどのユースケースでは標準的なSFTで十分です。
* **LoRA** は、通常ベースモデルの重みを固定し、追加された少数の低ランク・アダプター重み（16ビット精度）だけを学習する、パラメータ効率の高い学習手法です。
* **QLoRA** LoRAを4ビット精度と組み合わせ、最小限のリソースで非常に大きなモデルを扱えるようにします。
* Unslothは、はるかに多くのリソースを必要とするフルファインチューニング（FFT）と事前学習もサポートしていますが、通常FFTは不要です。適切に行えば、LoRAはFFTに匹敵できます。
* Unsloth **あらゆる種類のモデル**: [音声合成](/docs/jp/ji-chu/text-to-speech-tts-fine-tuning.md), [埋め込み](/docs/jp/ji-chu/embedding-finetuning.md)、GRPO、RL、 [ビジョン](/docs/jp/ji-chu/vision-fine-tuning.md)、マルチモーダルなど。

{% hint style="info" %}
研究によると、 **学習と提供を同じ精度で行うことは** 精度の維持に役立ちます。つまり、4ビットで提供したいなら4ビットで学習し、その逆も同様です。
{% endhint %}

QLoRAから始めることをおすすめします。これはモデル学習のための最も手軽で効果的な手法の一つだからです。私たちの [動的4ビット](https://unsloth.ai/blog/dynamic-4bit) 量子化では、LoRAと比べたQLoRAの精度低下は、現在ではほぼ回復しています。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cfc51c261e6d24df3aa967d9b9a482313465cbc1%2Fmodel%20name%20change.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

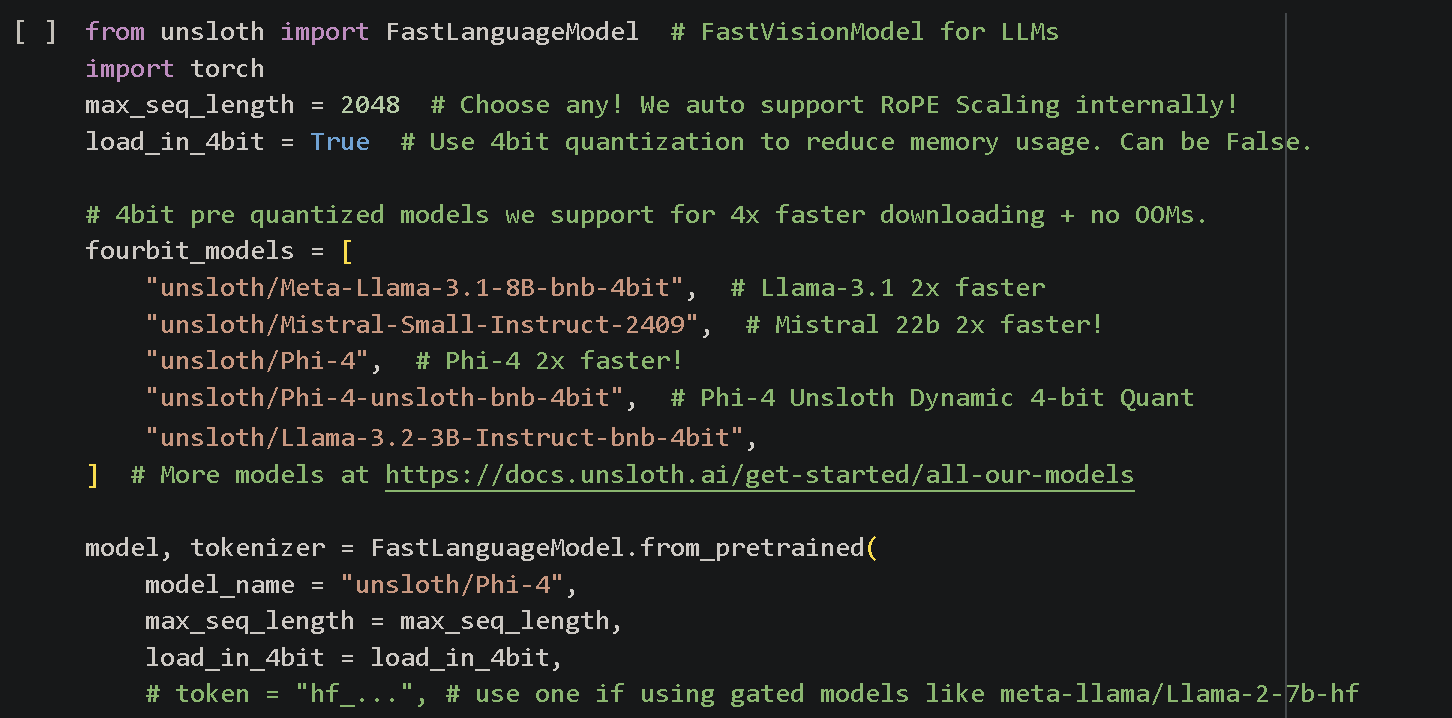
モデル名は、Hugging Face上のモデル名に合わせれば、好きなモデル名に変更できます。たとえば '`unsloth/llama-3.1-8b-unsloth-bnb-4bit`'.

まずは次から始めることをおすすめします **Instructモデル**。会話用チャットテンプレート（ChatML、ShareGPTなど）を使った直接のファインチューニングが可能で、 **Baseモデル** （Alpaca、Vicunaなどを使用）よりも必要なデータが少なくて済みます。次の違いについて詳しく学ぶ [InstructモデルとBaseモデルはこちら](/docs/jp/meru/fine-tuning-llms-guide/what-model-should-i-use.md#instruct-or-base-model).

* モデル名の末尾に **`unsloth-bnb-4bit`** が付いている場合、それらは [**Unslothの動的4ビット**](https://unsloth.ai/blog/dynamic-4bit) **量子化モデル**です。これらのモデルは標準のBitsAndBytes 4ビットモデルよりわずかに多くのVRAMを消費しますが、精度は大幅に高くなります。
* モデル名の末尾が単に **`bnb-4bit`**&#x3067;、"unsloth" が含まれていない場合は、標準のBitsAndBytes 4ビット量子化を指します。
* 次のサフィックスがない **モデルは** 元の **16ビットまたは8ビット形式です**。これらは公式モデル作成者による元のモデルですが、チャットテンプレートやトークナイザーの修正など、重要な修正を含めていることがあります。そのため、利用可能であれば当社版を使うことをおすすめします。

切り替え可能なその他の設定もあります：

* **`max_seq_length = 2048`** – コンテキスト長を制御します。Llama-3は8192をサポートしていますが、テストには2048を推奨します。Unslothでは4倍長いコンテキストでのファインチューニングが可能です。
* **`dtype = None`** – デフォルトはNoneです。 `torch.float16` または `torch.bfloat16` 新しいGPUではこれを使用してください。
* **`load_in_4bit = True`** – 4ビット量子化を有効にし、ファインチューニング時のメモリ使用量を4分の1に減らします。無効にすると、LoRAの16ビットファインチューニングが有効になります。16ビットLoRAも `load_in_16bit = True`
* フルファインチューニング（FFT）を有効にするには、 `full_finetuning = True`。8ビットのファインチューニングには、 `load_in_8bit = True`.
* **注：** 一度に設定できる学習手法は1つだけです。 `True` を同時に設定できます。

{% hint style="info" %}
よくある間違いは、計算負荷の高いフルファインチューニング（FFT）にいきなり飛び込むことです。まずLoRAかQLoRAで試し、それでうまくいかなければ、FFTでもほぼ確実にうまくいきません。LoRAが失敗したからといって、FFTが魔法のように解決してくれると考えないでください。
{% endhint %}

次のこともできます： [音声合成（TTS）](/docs/jp/ji-chu/text-to-speech-tts-fine-tuning.md), [推論（GRPO）](/docs/jp/meru/reinforcement-learning-rl-guide.md), [ビジョン](/docs/jp/ji-chu/vision-fine-tuning.md), [RL](/docs/jp/meru/reinforcement-learning-rl-guide/preference-dpo-orpo-and-kto.md) （GRPO、DPO）、 [継続事前学習](/docs/jp/ji-chu/continued-pretraining.md)、テキスト補完、その他の学習手法をUnslothで実行できます。

{% columns %}
{% column %}
モデルの選び方ガイドをお読みください：

{% content-ref url="/pages/b0eaf2528a8f433d814b471834923a39c77f801f" %}
[What Model Should I Use?](/docs/jp/meru/fine-tuning-llms-guide/what-model-should-i-use.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
モデルごとの個別チュートリアルは：

{% content-ref url="/pages/ea13ebdc099377f5b37a2e0895aeb9ede74953ed" %}
[Complete LLM Directory](/docs/jp/moderu/tutorials.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

## 3. あなたのデータセット

LLMにとって、データセットとはモデルの学習に使えるデータの集まりです。学習に役立つためには、テキストデータはトークン化できる形式である必要があります。

* 通常は、質問と回答の2列からなるデータセットを作成する必要があります。その品質と量がファインチューニングの最終結果に大きく反映されるため、この部分を正しく行うことが非常に重要です。
* 次のことができます： [合成データを生成する](/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md#synthetic-data-generation) そして、ChatGPTやローカルLLMを使ってデータセットを（QAペアに）構造化できます。
* また、新しいSynthetic Datasetノートブックも利用できます。これは文書（PDF、動画など）を自動で解析し、QAペアを生成し、Llama 3.2のようなローカルモデルを使ってデータを自動クレンジングします。 [ノートブックはこちらからアクセスできます。](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Meta_Synthetic_Data_Llama3_2_\(3B\).ipynb)
* ファインチューニングは、既存の文書リポジトリから学習して知識ベースを継続的に拡張できますが、単にデータを放り込むだけではうまくいきません。最適な結果を得るには、できれば質問-回答ペアとして、よく構成されたデータセットを整備してください。これにより、学習、理解、応答精度が向上します。
* ただし、常にそうとは限りません。たとえば、コード用にLLMをファインチューニングする場合、すべてのコードデータをそのまま投入するだけでも、構造化された形式がなくてもモデルの性能を大きく向上させることがあります。つまり、実際にはユースケース次第です。

***データセットの作成について詳しく読む：***

{% content-ref url="/pages/0169f16f28bd29579ad4805156b35641f23090aa" %}
[データセットガイド](/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md)
{% endcontent-ref %}

私たちのノートブック例のほとんどでは、 [Alpacaデータセット](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset) を利用しますが、Visionのような他のノートブックでは、回答出力に画像が必要な別のデータセットを使うことがあります。

### 4. 学習ハイパーパラメータを理解する

適切なものを選ぶ方法を学びましょう [ハイパーパラメータ](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md) 研究と実世界の実験に基づくベストプラクティスを使って、各ハイパーパラメータがモデルの性能にどう影響するかを理解しましょう。

**ハイパーパラメータが学習に与える影響の完全ガイドはこちら：**

{% content-ref url="/pages/dac5c97d7a208c227b8115ec72133012ad2d0113" %}
[Hyperparameters Guide](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md)
{% endcontent-ref %}

## 5. インストール＋要件

Unslothは主に2つの方法、無料ノートブックまたはローカル環境で利用できます。

### Unsloth Notebooks

初心者には、あらかじめ用意された [ノートブック](/docs/jp/meru/unsloth-notebooks.md) を最初に使うことをおすすめします。ガイド付きの手順で始める最も簡単な方法だからです。後でノートブックをエクスポートしてローカルで使うこともできます。

Unslothには、次のためのステップごとのノートブックがあります： [音声合成](/docs/jp/ji-chu/text-to-speech-tts-fine-tuning.md), [埋め込み](/docs/jp/ji-chu/embedding-finetuning.md)、GRPO、RL、 [ビジョン](/docs/jp/ji-chu/vision-fine-tuning.md)、マルチモーダル、さまざまなユースケースなど。

### ローカルインストール

Unslothは以下を使ってローカルにインストールすることもできます： [Docker](/docs/jp/meru/install/docker.md) または `pip install unsloth` （Linux、WSL、または [Windows](/docs/jp/meru/install/windows-installation.md)）。また、使用するモデルによっては、十分なVRAMとリソースが必要です。

UnslothのインストールにはWindowsまたはLinuxの端末が必要です。Unslothをインストールしたら、私たちのノートブックをコピー＆ペーストして、自分のローカル環境で使えます。詳しくは：

{% columns %}
{% column %}
{% content-ref url="/pages/6d173d71b33fc6bb9bbdbeb7a340a80132236305" %}
[Unslothの要件](/docs/jp/meru/fine-tuning-for-beginners/unsloth-requirements.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
{% content-ref url="/pages/78ed2140c0094b3caa1931c2127e336118049b42" %}
[Installation](/docs/jp/meru/install.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

## 6. 学習＋評価

すべて準備できたら、いよいよ学習です！何かうまくいかない場合は、ハイパーパラメータやデータセットなどをいつでも変更できることを忘れないでください。

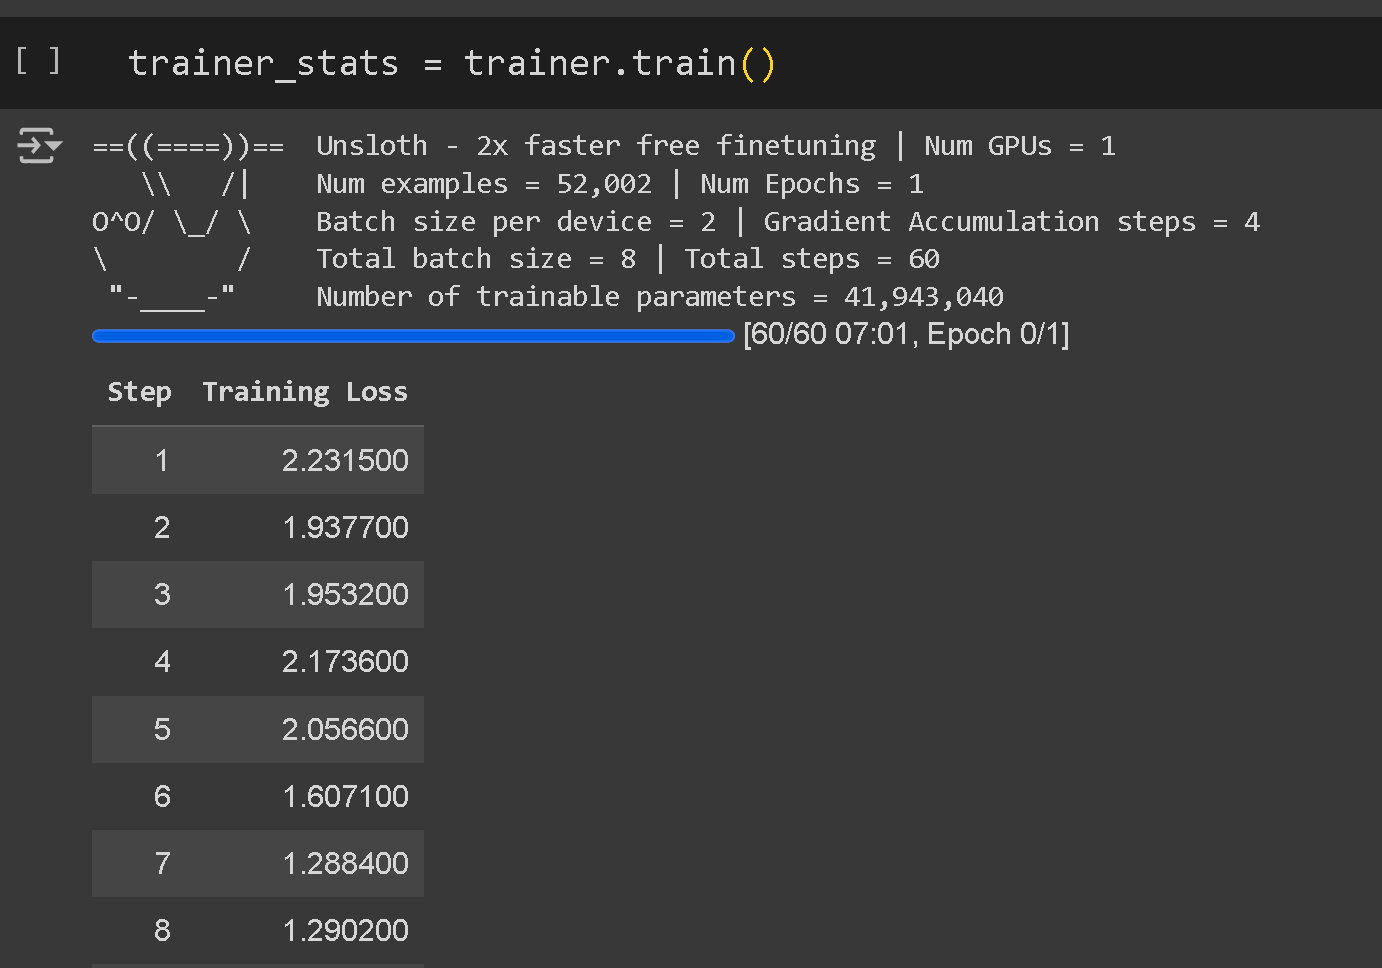
学習中に数値のログが表示されます。これは学習損失で、モデルがデータセットからどれだけうまく学んでいるかを示します。多くの場合、損失が0.5〜1.0あたりなら良い兆候ですが、データセットとタスクによって異なります。損失が下がらない場合は、設定を調整する必要があるかもしれません。損失が0になる場合は過学習の可能性があるので、検証も確認することが重要です。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-feb9b0f5763d41cecaec9a3a9cd227ad918f0ca7%2Fimage.png?alt=media" alt="" width="375"><figcaption><p>学習損失は数値として表示されます</p></figcaption></figure>

より長い学習や大きなバッチサイズが必要でない限り、通常はデフォルト設定のままにすることをおすすめします。

* **`per_device_train_batch_size = 2`** – GPUの利用率を高めるために増やせますが、パディングによって学習が遅くなることに注意してください。その代わりに `gradient_accumulation_steps` を増やすと、より安定した学習になります。
* **`gradient_accumulation_steps = 4`** – メモリ使用量を増やさずに、より大きなバッチサイズをシミュレートします。
* **`max_steps = 60`** – 学習を高速化します。完全な実行では、これを `num_train_epochs = 1` （過学習を避けるため、1〜3エポックを推奨）。
* **`learning_rate = 2e-4`** – 値を下げると、遅くなりますがより精密なファインチューニングになります。次のような値を試してください： `1e-4`, `5e-5`、または `2e-5`.

#### 評価

評価するには、モデルと会話してみて、好みに合うかを手動で評価できます。Unslothの評価も有効にできますが、データセットのサイズによっては時間がかかる場合があることに注意してください。評価を高速化するには、評価用データセットのサイズを減らすか、 `evaluation_steps = 100`.

テストには、学習データの20%を取り出してテストに使うこともできます。すでに学習データをすべて使っている場合は、手動で評価する必要があります。自動評価ツールも使えますが、自動化ツールがあなたの評価基準と完全には一致しない場合があることに注意してください。

## 7. モデルの実行＋デプロイ

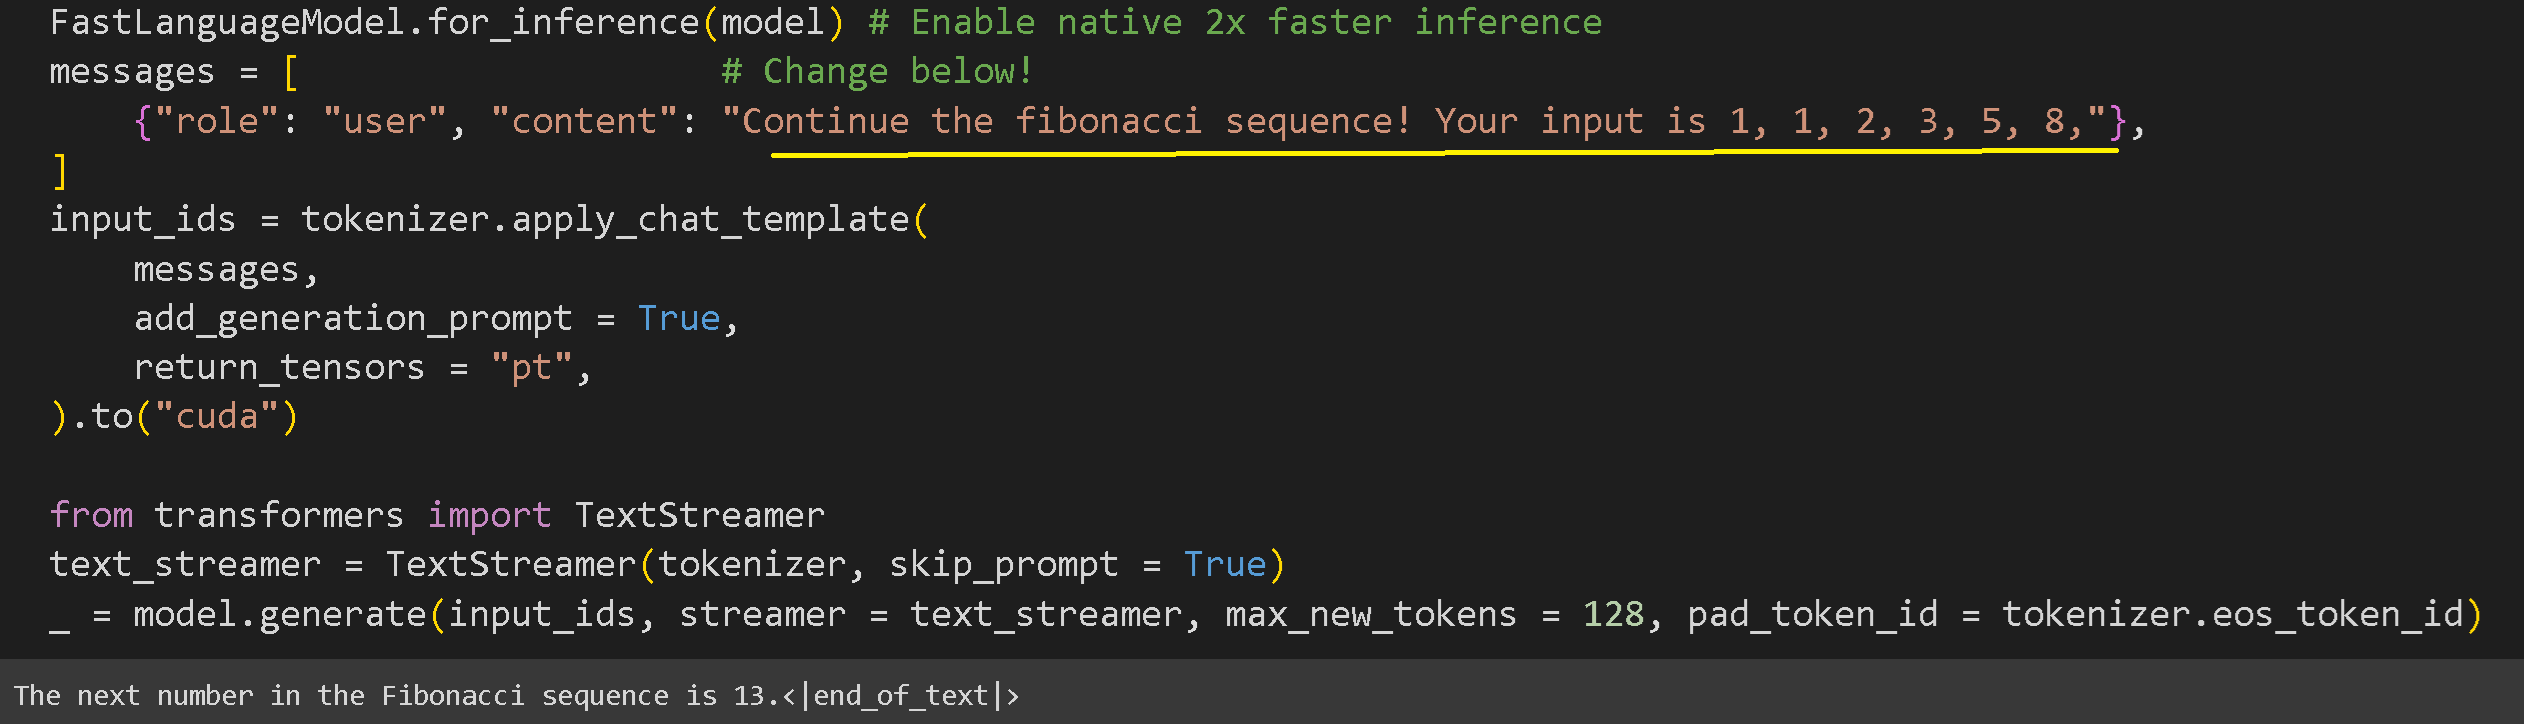
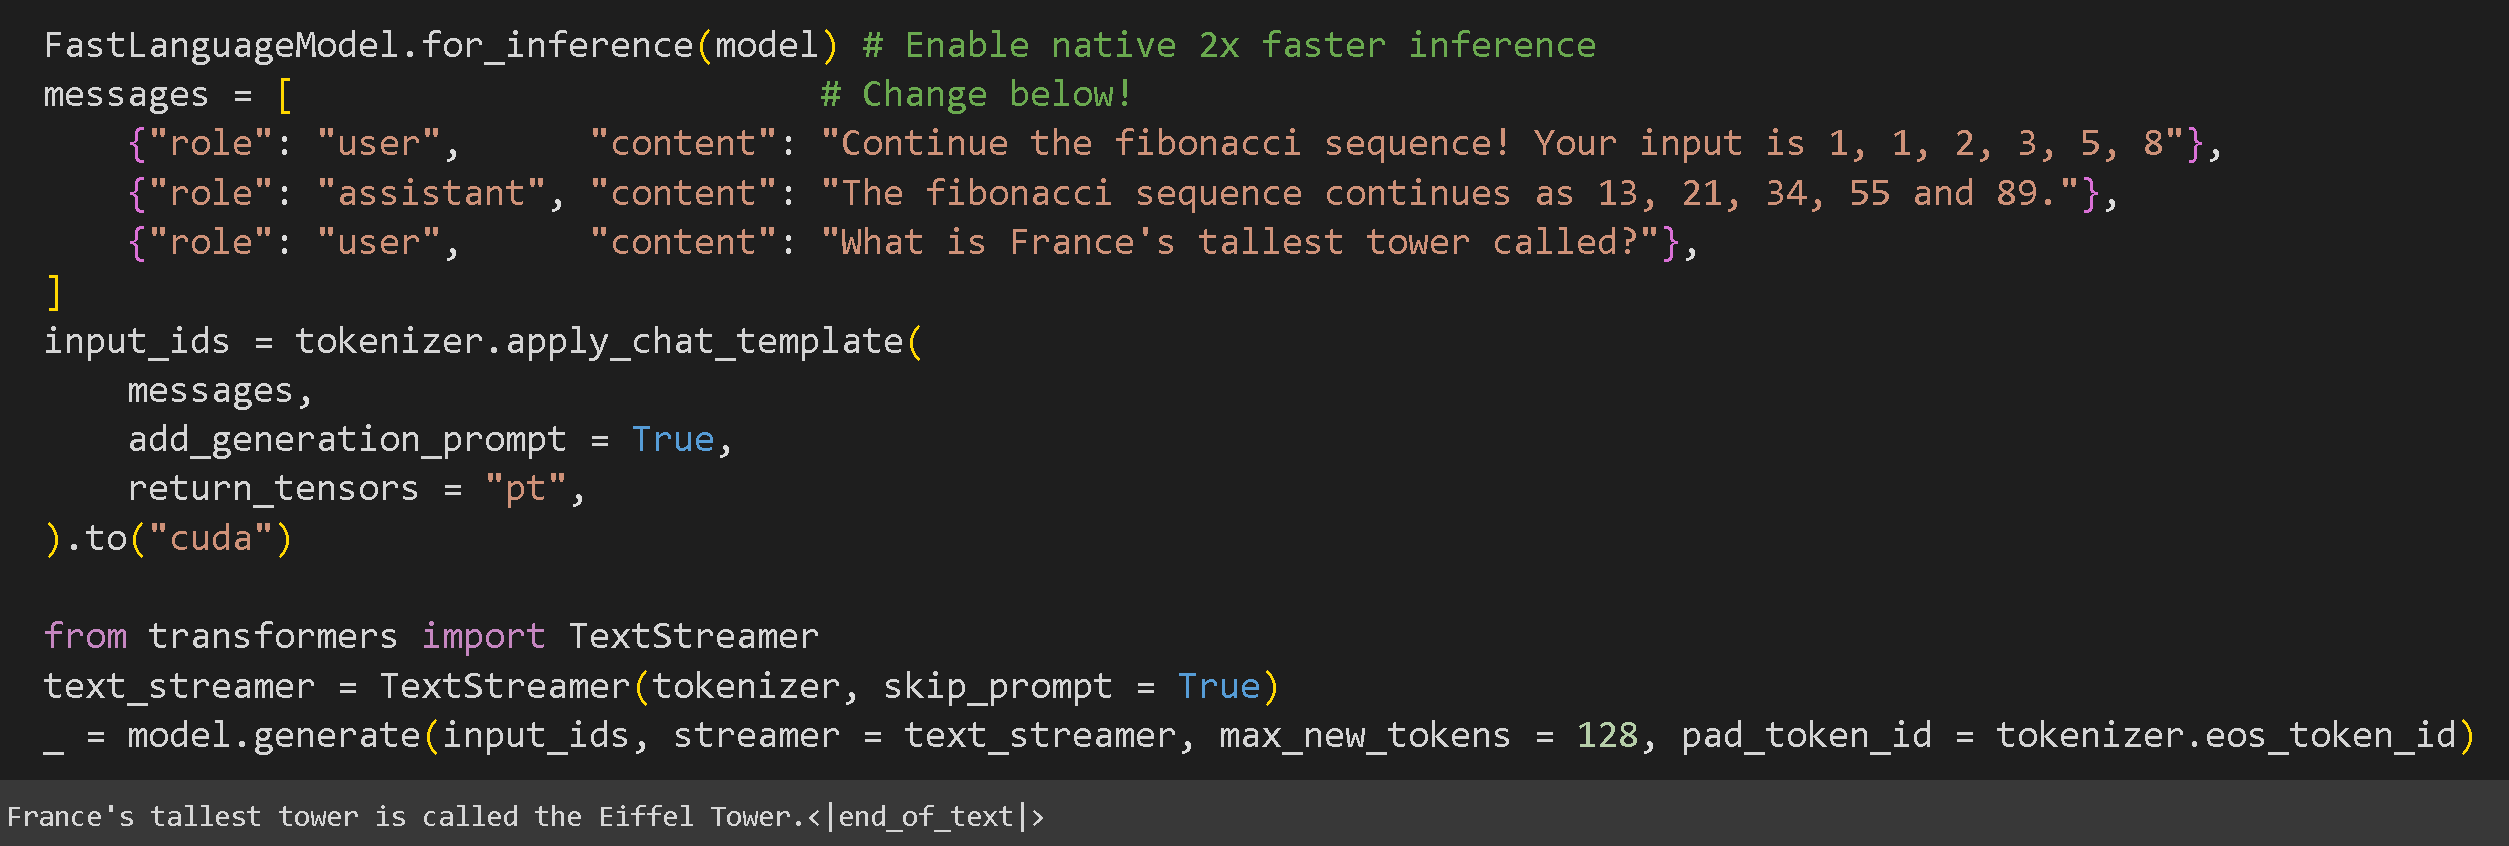
では、学習が完了した後にモデルを実行してみましょう！黄色の下線が引かれた部分は編集できます！実際、マルチターンチャットボットを作成したので、下のように過去の会話を見ていたかのようにモデルを呼び出すこともできます：

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-f2d5f23fa62ec89e06bf20fea433f9a1e42a2fe3%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-cdf5d779635901dce7793df92531dbf3caf0fb0a%2Fimage%20(47).png?alt=media" alt=""><figcaption></figcaption></figure></div>

Unsloth自体が **2倍高速な推論** もネイティブに提供しているので、 `FastLanguageModel.for_inference(model)`を呼び出すのを忘れないでください。より長い応答を出したい場合は、 `max_new_tokens = 128` を256や1024のようなより大きな数に設定してください。結果を待つ時間も長くなることに注意してください！

### 保存＋デプロイ

Ollama、vLLM、Open WebUIのような希望する推論エンジンにモデルを保存・デプロイするには、ベースモデルの上にLoRAアダプターを使う必要があります。各フレームワークごとの専用ガイドがあります：

{% content-ref url="/pages/d5ae43f1915ceda3d304ad7c413cb4efbe3d1a3f" %}
[推論とデプロイ](/docs/jp/ji-chu/inference-and-deployment.md)
{% endcontent-ref %}

{% columns %}
{% column %}
ラップトップやMacのような単一デバイスで推論を実行する場合は、llama.cppを使ってGGUF形式に変換し、Ollama、llama.cpp、LM Studioなどで使います：

{% content-ref url="/pages/9bfa988baa17c249340a58c332b8584f20d2537c" %}
[GGUF & llama.cpp](/docs/jp/ji-chu/inference-and-deployment/saving-to-gguf.md)
{% endcontent-ref %}
{% endcolumn %}

{% column %}
FP8やAWQ向けに、企業向けまたは複数ユーザー向けの推論としてLLMをデプロイする場合は、vLLMを使います：

{% content-ref url="/pages/0fde417d83989a8108b1d466ec2b53c46e9f4279" %}
[vLLM](/docs/jp/ji-chu/inference-and-deployment/vllm-guide.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}

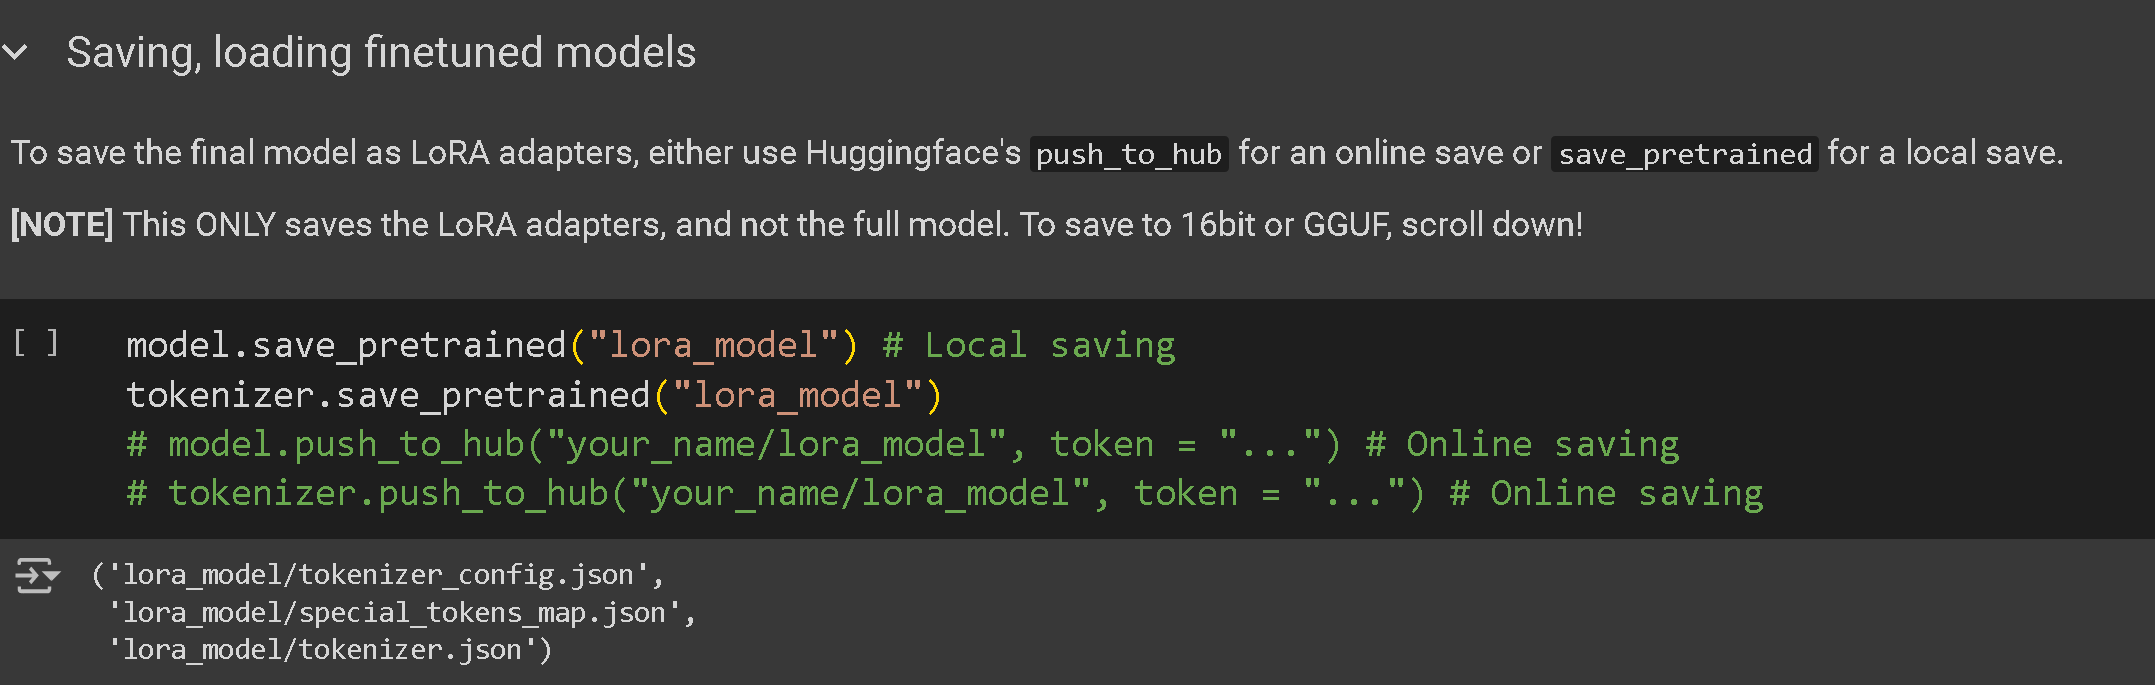
以下のように、ファインチューニング済みモデルをLoRAアダプターと呼ばれる100MBの小さなファイルとして保存できます。モデルをアップロードしたい場合は、代わりにHugging Face Hubへプッシュすることもできます！Hugging Faceの [トークン](https://huggingface.co/settings/tokens) そしてトークンを追加してください！

<div><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8c577103f7c4fe883cabaf35c8437307c6501686%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure> <figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1a1be852ca551240bdce47cf99e6ccd7d31c1326%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure></div>

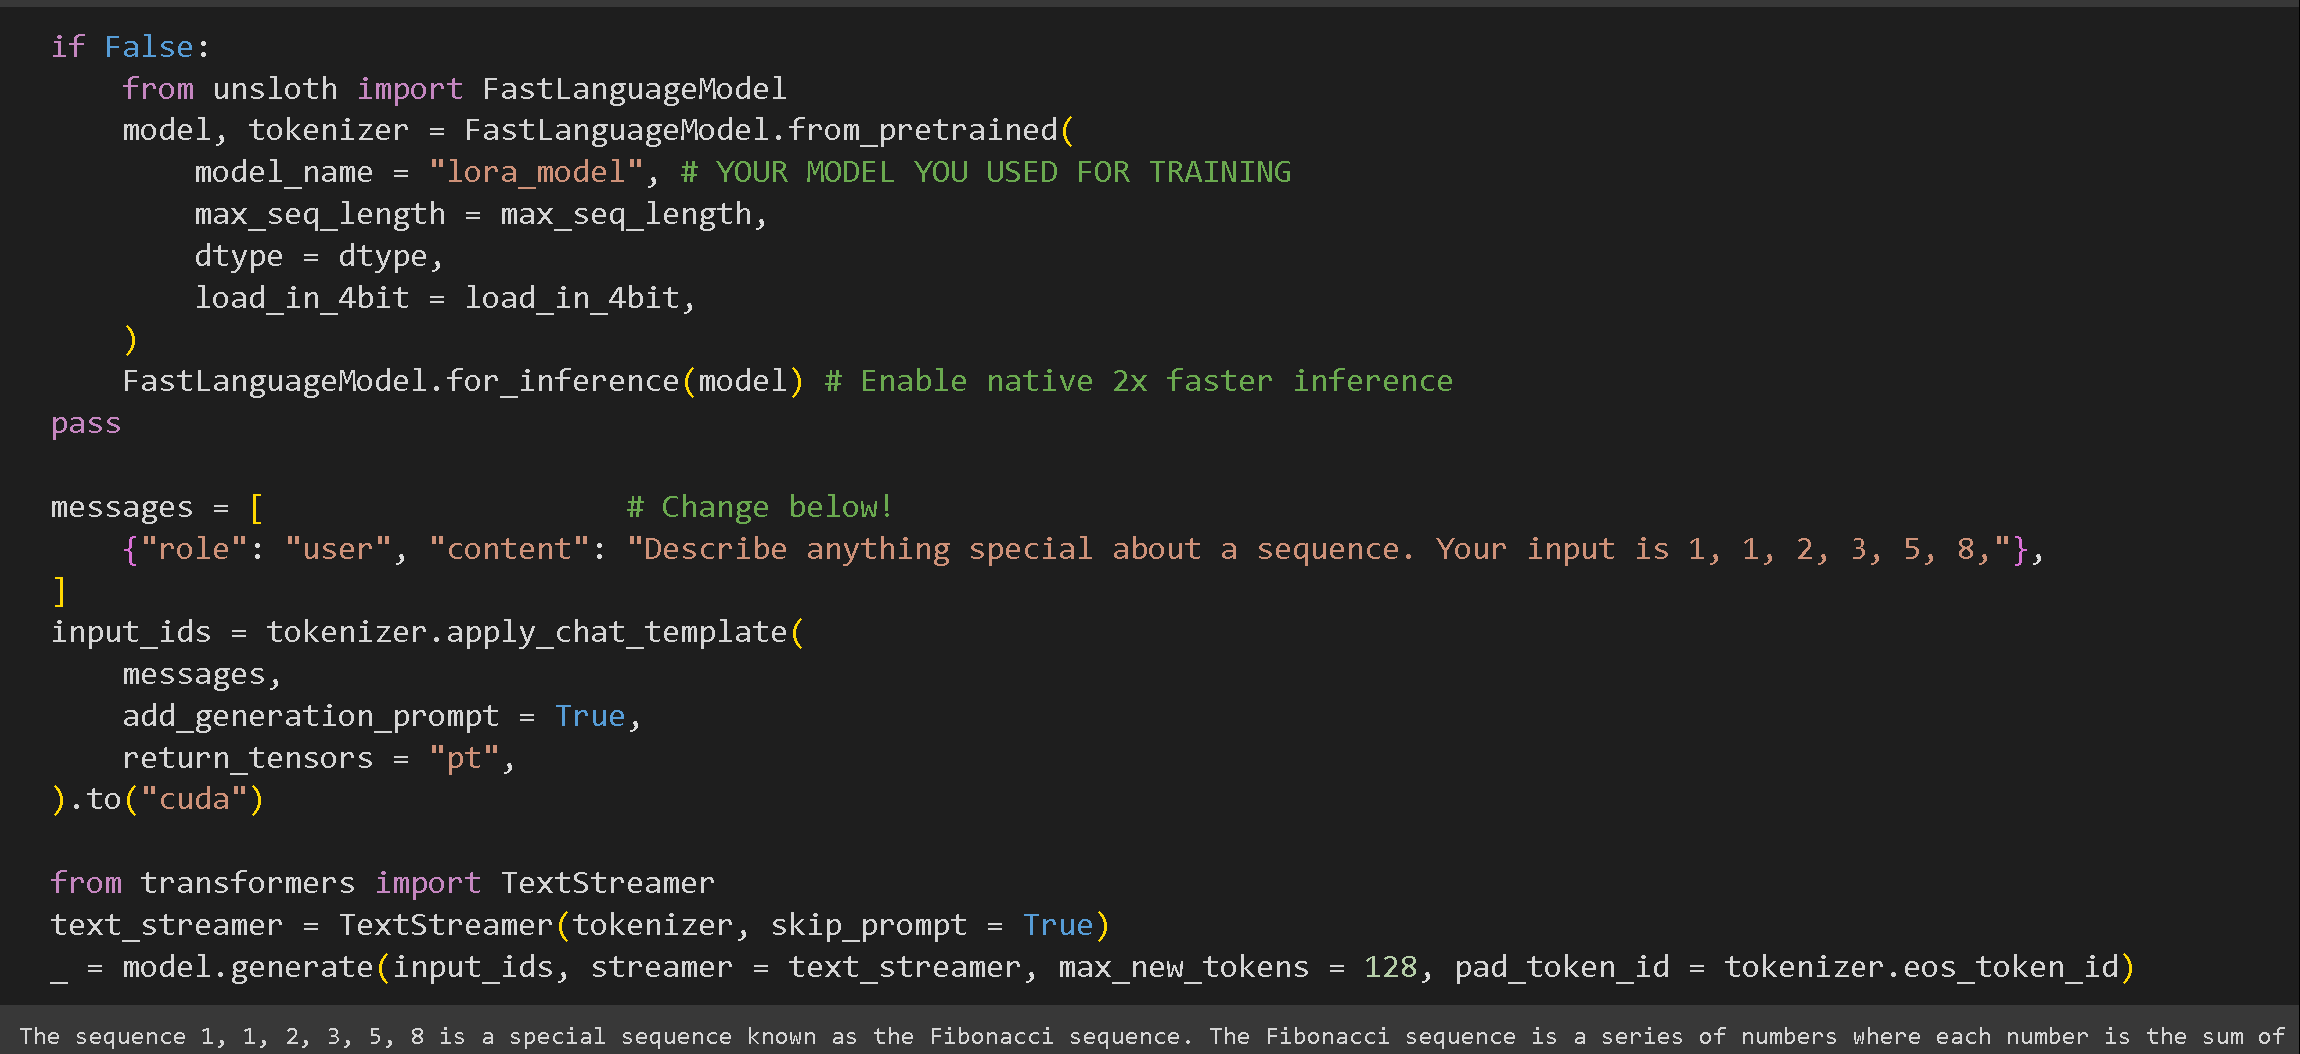
モデルを保存したあと、もう一度 Unsloth を使ってモデル自体を実行できます！ `FastLanguageModel` をもう一度使って推論を呼び出しましょう！

## 8. 完了です！

Unslothを使って、言語モデルのファインチューニングと希望の推論エンジンへのエクスポートに成功しました！

ファインチューニングのコツやテクニックについて詳しく知るには、非常に有益で教育的な内容を提供しているブログをご覧ください： <https://unsloth.ai/blog/>

ファインチューニングで助けが必要なら、Discordサーバーにも参加できます [ここ](https://discord.gg/unsloth) または [Reddit r/unsloth](https://www.reddit.com/r/unsloth/)。お読みいただきありがとうございました。お役に立てば幸いです！

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-69482ba90d417f7bf98dddaf83795cdd3eb20efc%2Fsloth%20sparkling%20square.png?alt=media" alt="" width="188"><figcaption></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.