> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md).

# LoRAファインチューニングのハイパーパラメータガイド

LLMの最適なファインチューニング設定を段階的に学びます。LoRAのrankとalpha、epoch、バッチサイズ＋勾配蓄積、QLoRA対LoRA、対象モジュールなど。

LoRAのハイパーパラメータは、Low-Rank Adaptationがどのように [ファインチューニングするかを制御する、調整可能な設定です](/docs/jp/meru/fine-tuning-llms-guide.md) LLMを。学習率やエポック数など多くの選択肢と無数の組み合わせがある中で、正しい値を選ぶことが、精度、安定性、品質、そして幻覚の減少において重要です。うまく設定すれば、 **LoRAはフルファインチューニングの性能に匹敵できます** しかもVRAM使用量は4分の1です。

何百もの研究論文と実験から得た知見に基づいて、これらのパラメータのベストプラクティスを学び、それらがモデルにどう影響するかを見ていきます。 **Unslothのデフォルト設定の使用をおすすめしますが、**&#x3053;れらの概念を理解すれば、完全にコントロールできるようになります。\
\
目的は、ハイパーパラメータの数値を変更して精度を高めつつ、 [**過学習または学習不足**](#overfitting-poor-generalization-too-specialized)に対処することです。過学習は、モデルが学習データを記憶してしまい、新しい未知の入力へ一般化する能力を損なうときに起こります。目標は、単に記憶するのではなく、うまく一般化するモデルです。

{% columns %}
{% column %}

#### :question:では、LoRAとは何でしょうか？

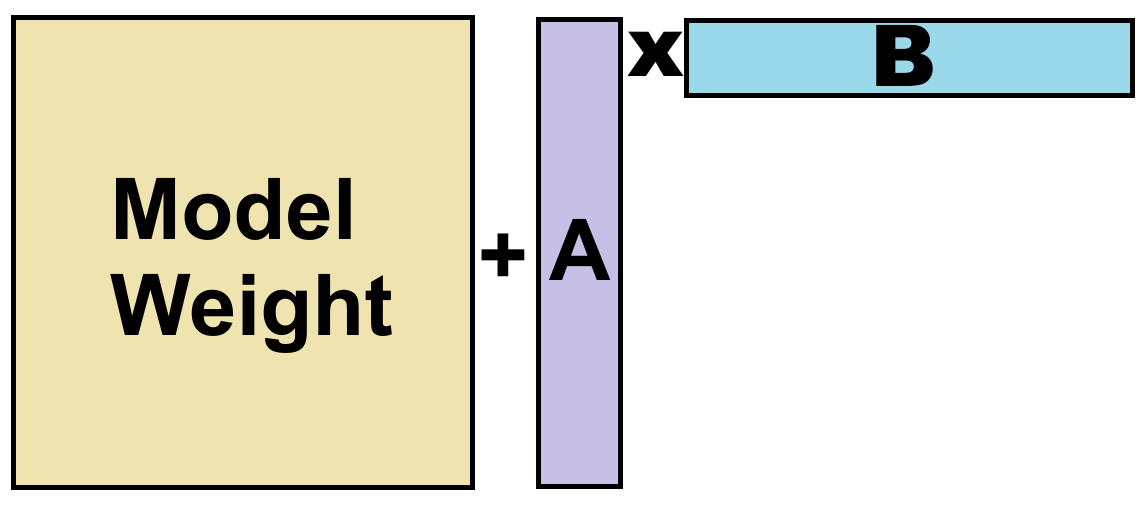
LLMではモデルの重みがあります。Llama 70Bには700億個の数値があります。すべての700億個を変更する代わりに、各重みに薄い行列AとBを追加して、それらを最適化します。つまり、最適化するのは重みの1%だけです。
{% endcolumn %}

{% column %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>モデルの重み（黄色）を最適化する代わりに、2つの薄い行列AとBを最適化します。</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

## :1234: 主要なファインチューニング・ハイパーパラメータ

### **学習率**

各学習ステップでモデルの重みがどの程度調整されるかを定義します。

* **高い学習率**: 初期の収束は速くなりますが、高すぎると学習が不安定になったり、最適な極小値を見つけられなかったりすることがあります。
* **低い学習率**: より安定して正確な学習になりますが、収束により多くのエポックが必要になるため、全体の学習時間が増えることがあります。低い学習率はしばしば学習不足を引き起こすと思われがちですが、実際には **過学習** を招いたり、モデルの学習自体を妨げたりすることもあります。
* **一般的な範囲**: `2e-4` (0.0002) から `5e-6` (0.000005).\
  :green\_square: ***通常のLoRA/QLoRAファインチューニングでは***, *次の値を出発点として推奨します* **`2e-4`** *。*\
  :blue\_square: ***強化学習では** (DPO、GRPOなど)、次の値を推奨します* **`5e-6` .**\
  :white\_large\_square: ***フルファインチューニングでは、** より低い学習率のほうが一般的に適しています。*

### **エポック数**

モデルが完全な学習データセットを見る回数。

* **エポック数が多いほど:** モデルの学習に役立ちますが、多すぎると **学習データを記憶してしまい**、新しいタスクでの性能を損なうことがあります。
* **エポック数が少ないほど:** 学習時間を短縮でき、過学習を防げますが、モデルがデータセットの根本的なパターンを学ぶのに十分でない場合は、学習不足のモデルになる可能性があります。
* **推奨:** 1〜3エポック。ほとんどの指示ベースのデータセットでは、3エポックを超える学習は効果が薄く、過学習のリスクが高まります。

### **LoRAまたはQLoRA**

LoRAは16ビット精度を使用し、QLoRAは4ビットのファインチューニング手法です。

* **LoRA:** 16ビットのファインチューニング。少し高速で、わずかに高精度ですが、VRAMを大幅に多く消費します（QLoRAの4倍）。16ビット環境や最大限の精度が必要な場面に推奨されます。
* **QLoRA:** 4ビットのファインチューニング。少し遅く、精度もわずかに低いですが、VRAM消費は大幅に少なくなります（4分の1）。\
  :sloth: *70BのLLaMAは、UnslothのQLoRAで<48GBのVRAMに収まります -* [*詳細はこちら*](https://unsloth.ai/blog/llama3-3)*.*

### ハイパーパラメータと推奨設定:

<table><thead><tr><th width="154.39678955078125">ハイパーパラメータ</th><th width="383.6192626953125">機能</th><th>推奨設定</th></tr></thead><tbody><tr><td><strong>LoRAランク</strong> (<code>r</code>)</td><td>LoRAアダプタ行列における学習可能パラメータ数を制御します。ランクが高いほどモデル容量は増えますが、メモリ使用量も増えます。</td><td>8, 16, 32, 64, 128<br><br>16または32を選択</td></tr><tr><td><strong>LoRA Alpha</strong> (<code>lora_alpha</code>)</td><td>ランクに対するファインチューニング調整の強さをスケーリングします（<code>r</code>).</td><td><code>r</code> （標準）または <code>r * 2</code> （一般的なヒューリスティック）。 <a href="#lora-alpha-and-rank-relationship">詳細はこちら</a>.</td></tr><tr><td><strong>LoRAドロップアウト</strong></td><td>過学習を防ぐため、学習中にLoRAの活性化の一部をランダムにゼロにする正則化手法です。 <strong>あまり有用ではないので、</strong>デフォルトでは0に設定します。</td><td>0（デフォルト）から0.1</td></tr><tr><td><strong>Weight Decay</strong></td><td>過学習を防ぎ、汎化性能を高めるために大きな重みにペナルティを与える正則化項です。大きすぎる値は使わないでください！</td><td>0.01（推奨）〜0.1</td></tr><tr><td><strong>ウォームアップステップ数</strong></td><td>学習の開始時に学習率を徐々に上げます。</td><td>全ステップの5〜10%</td></tr><tr><td><strong>スケジューラタイプ</strong></td><td>学習中に学習率を動的に調整します。</td><td><code>linear</code> または <code>cosine</code></td></tr><tr><td><strong>Seed（<code>random_state</code>)</strong></td><td>結果の再現性を確保するための固定値です。</td><td>任意の整数（例: <code>42</code>, <code>3407</code>)</td></tr><tr><td><strong>対象モジュール</strong></td><td><p>LoRAアダプタをモデルのどの部分に適用するかを指定します。注意機構、MLP、またはその両方です。</p><p><br>Attention: <code>q_proj, k_proj, v_proj, o_proj</code><br><br>MLP: <code>gate_proj, up_proj, down_proj</code></p></td><td>主要なすべての線形層を対象にすることを推奨: <code>q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj</code>.</td></tr></tbody></table>

## :deciduous\_tree: 勾配蓄積とバッチサイズの等価性

### 実効バッチサイズ

バッチサイズの適切な設定は、学習の安定性とGPUのVRAM制限のバランスを取るうえで重要です。これは、積が **実効バッチサイズ**.\
\
**実効バッチサイズ** = `batch_size * gradient_accumulation_steps`

* ある **より大きい実効バッチサイズ** は、一般的により滑らかで安定した学習につながります。
* ある **より小さい実効バッチサイズ** は、ばらつきを増やす可能性があります。

タスクごとに違いはありますが、次の設定は安定した **実効バッチサイズ** 16を実現するための優れた出発点になります。これは現代のGPUでのほとんどのファインチューニング作業に適しています。

| パラメータ                                    | 説明                                                                                                                                                    | 推奨設定                            |
| ---------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------- |
| **バッチサイズ** (`batch_size`)                | <p>1枚のGPUで1回の順伝播/逆伝播で処理されるサンプル数。<br><br><strong>VRAM使用量の主因</strong>。値が高いほどハードウェアの利用率と学習速度は向上しますが、メモリに収まる場合に限られます。</p>                                 | 2                               |
| **勾配蓄積** (`gradient_accumulation_steps`) | <p>1回のモデル重み更新の前に処理するマイクロバッチの数。<br><br><strong>学習時間の主因。</strong> より大きな <code>batch\_size</code> をVRAM節約のためにシミュレートできます。値が高いほど、1エポックあたりの学習時間は長くなります。</p> | 8                               |
| **実効バッチサイズ** （計算値）                       | 各勾配更新で使われる真のバッチサイズです。学習の安定性、品質、最終的なモデル性能に直接影響します。                                                                                                     | <p>4〜16<br>推奨: 16（2 \* 8から）</p> |

### VRAMと性能のトレードオフ

学習ステップごとに32サンプルのデータを使いたいとします。その場合、次のような構成が使えます:

* `batch_size = 32, gradient_accumulation_steps = 1`
* `batch_size = 16, gradient_accumulation_steps = 2`
* `batch_size = 8, gradient_accumulation_steps = 4`
* `batch_size = 4, gradient_accumulation_steps = 8`
* `batch_size = 2, gradient_accumulation_steps = 16`
* `batch_size = 1, gradient_accumulation_steps = 32`

これらはすべてモデルの重み更新に関しては等価ですが、必要なハードウェア要件は大きく異なります。

最初の構成（`batch_size = 32`）は **最も多くのVRAM** を使い、ほとんどのGPUでは失敗する可能性が高いです。最後の構成（`batch_size = 1`）は **最も少ないVRAM** を使いますが、その代わり学習はやや遅くなりま&#x3059;**.** OOM（メモリ不足）エラーを避けるには、常により小さい `batch_size` を設定し、 `gradient_accumulation_steps` を増やして目標の **実効バッチサイズ**.

### :sloth: Unslothの勾配蓄積修正

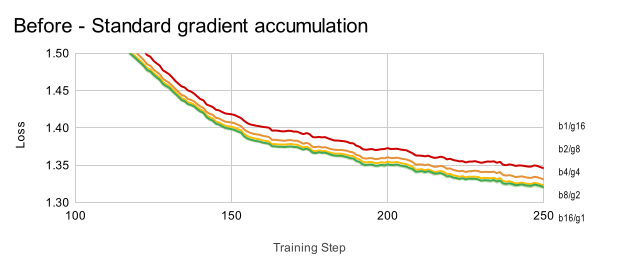
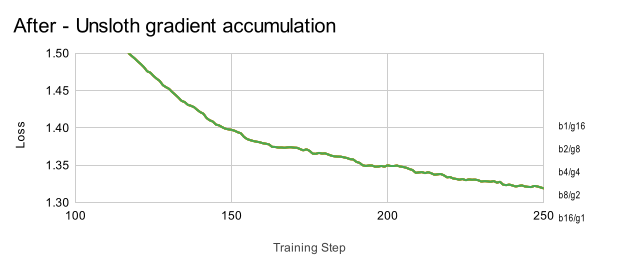
勾配蓄積とバッチサイズは <mark style="color:緑;">**Unslothでは完全に等価になりました**</mark> 。これは勾配蓄積に関するバグ修正によるものです。2つの方法が同じ結果を生まないという一般的な問題を解決するため、勾配蓄積に対して特定のバグ修正を実装しました。これはより広いコミュニティでは既知の課題でしたが、Unslothユーザーにとっては、今では両者は入れ替え可能です。

[ブログ記事を読む](https://unsloth.ai/blog/gradient) を参照してください。

修正前は、 `batch_size` そして `gradient_accumulation_steps` の組み合わせで同じ **実効バッチサイズ** （つまり、 `batch_size × gradient_accumulation_steps = 16`）になっても、学習挙動は等価になりませんでした。例えば、次のような構成です: `b1/g16`, `b2/g8`, `b4/g4`, `b8/g2`と `b16/g1` はすべて **実効バッチサイズ** 16の

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-66eb907fd9ce38ab29dacef82794d0525057aeb4%2FBefore_-_Standard_gradient_accumulation_UQOFkUggudXuV9dzrh8MA.svg?alt=media" alt=""><figcaption><p>を持ちますが、グラフに示すように、標準的な勾配蓄積では損失曲線は一致しませんでした:</p></figcaption></figure>

修正後は、どのように **実効バッチサイズ** 16を達成したかに関わらず、損失曲線が正しく一致するようになりました:

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-61f7c60412a2a39584f75cce5dca41e3e35eb7f2%2FAfter_-_Unsloth_gradient_accumulation_6Y4pJdJF0vruzradUpymY.svg?alt=media" alt=""><figcaption><p>（修正後 - 🦥 <mark style="color:緑;">Unslothの勾配蓄積</mark>)</p></figcaption></figure>

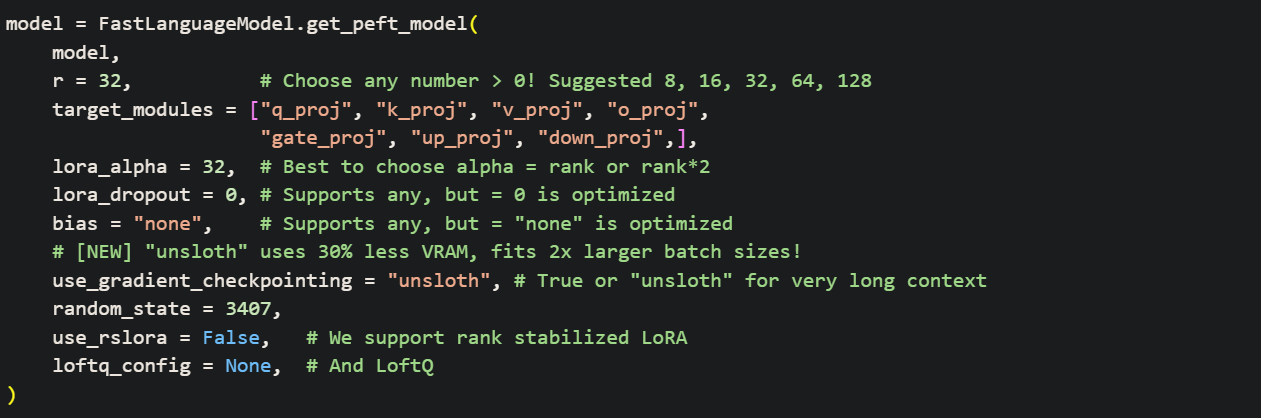
## 🦥 **UnslothにおけるLoRAハイパーパラメータ**

以下は標準的な設定を示しています。 **Unslothは最適化されたデフォルトを提供しますが**、これらのパラメータを理解することは手動調整の鍵です。

<div data-full-width="false"><figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9843f8cc26aac6445236250f5c32394186eace59%2Fnotebook_parameter_screenshott.png?alt=media" alt=""><figcaption></figcaption></figure></div>

1. ```python
   r = 16, # 0より大きい任意の数を選択！推奨: 8, 16, 32, 64, 128
   ```

   ランク（`r`）はファインチューニングの過程におけるものです。ランクが大きいほどメモリを多く使い、遅くなりますが、複雑なタスクで精度を高めることがあります。高速なファインチューニングには8や16、最大で128までのランクを推奨します。ランクが大きすぎると過学習を引き起こし、モデルの品質を損なう可能性があります。\\
2. ```python
   target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj",],
   ```

   最適な性能のために、 <mark style="background-color:blue;">**LoRAは主要なすべての線形層に適用すべきです**</mark>. [研究によって示されているのは](#lora-target-modules-and-qlora-vs-lora) 、主要なすべての層を対象にすることがフルファインチューニングの性能に匹敵するうえで重要だということです。メモリ使用量を減らすためにモジュールを削除することは可能ですが、節約効果は小さいため、最大限の品質を保つ観点から強くおすすめしません。\\
3. ```python
   lora_alpha = 16,
   ```

   ファインチューニングされた調整の強さを制御するスケーリング係数です。これをランク（`r`）と同じにするのは信頼できるベースラインです。人気があり効果的なヒューリスティックは、ランクの2倍（`r * 2`）に設定することで、LoRA更新により重みを与え、モデルをより積極的に学習させることです。 [詳細はこちら](#lora-alpha-and-rank-relationship)。\\
4. ```python
   lora_dropout = 0, # 何でもサポートしますが、= 0 が最適化されています
   ```

   正則化手法であり、 [過学習の防止に役立ちます](#overfitting-poor-generalization-too-specialized) 。各学習ステップでLoRAの活性化の一部をランダムにゼロにすることで実現します。 [最近の研究では](https://arxiv.org/abs/2410.09692) 、 **ファインチューニングで一般的な** 短い学習実行では、 `lora_dropout` は信頼性の低い正則化手法である可能性が示唆されています。\
   🦥 *Unslothの内部コードは、* `lora_dropout = 0`*の場合に学習を最適化でき、少し高速になりますが、過学習が疑われる場合はゼロでない値を推奨します。*\\\\
5. ```python
   bias = "none",    # 何でもサポートしますが、"none" が最適化されています
   ```

   これを `"none"` のままにしておくと、学習が高速になり、メモリ使用量も減ります。この設定では線形層のバイアス項を学習しないため、実用上の利得がほとんどないにもかかわらず学習可能パラメータが増えてしまうのを避けられます。\\
6. ```python
   use_gradient_checkpointing = "unsloth", # 非常に長いコンテキストでは True または "unsloth"
   ```

   選択肢は `True`, `False`と `"unsloth"`です。\
   🦥 *次を推奨します* `"unsloth"` *。これにより、メモリ使用量をさらに30%削減でき、非常に長いコンテキストのファインチューニングにも対応できます。詳しくは* [*長文コンテキスト学習に関するブログ記事*](https://unsloth.ai/blog/long-context)*.*\\\\
7. ```python
   random_state = 3407,
   ```

   を参照してください。決定論的で再現可能な実行を保証するためのシードです。学習にはランダム数が関わるため、一貫した実験には固定シードの設定が不可欠です。\\
8. ```python
   use_rslora = False,  # rank stabilized LoRA をサポートします
   ```

   を実装する高度な機能です [**Rank-Stabilized LoRA**](https://arxiv.org/abs/2312.03732)。 `True`に設定すると、実効スケーリングは `lora_alpha / sqrt(r)` となり、標準の `lora_alpha / r`の代わりになります。これは特に高いランクで安定性を向上させることがあります。 [詳細はこちら](#lora-alpha-and-rank-relationship)。\\
9. ```python
   loftq_config = None, # そして LoftQ
   ```

   で提案された高度な手法では、 [**LoftQ**](https://arxiv.org/abs/2310.08659)事前学習済み重みから上位'r'個の特異ベクトルでLoRA行列を初期化します。これにより精度が向上することがありますが、学習開始時に大きなメモリスパイクを引き起こす可能性があります。

### **LoRAの重み更新を確認する:**

ファインチューニング後に **LoRA** アダプタ重みが更新されたことを検証する際は、 **np.allclose()** を比較に使わないでください。この方法では、特に **LoRA A**で初期化された小さなガウス値のような、微妙だが意味のある変化を見逃すことがあります。こうした変化は、緩い数値許容範囲では有意と判定されないかもしれません。この節への [貢献者](https://github.com/unslothai/unsloth/issues/3035) に感謝します。

重み更新を確実に確認するには、次を推奨します:

* 使用すると **チェックサムまたはハッシュの比較** （例: MD5）
* 計算する **絶対差の合計** テンソル間の
* テンソル**統計量の確認** （例: 平均、分散）を手動で
* または使用する **np.array\_equal()** 完全一致が期待される場合

## :triangular\_ruler:LoRA Alphaとランクの関係

{% hint style="success" %}
次のように設定するのが最善です `lora_alpha = 2 * lora_rank` または `lora_alpha = lora_rank`
{% endhint %}

{% columns %}
{% column width="50%" %}
$$
\hat{W} = W + \frac{\alpha}{\text{rank}} \times AB
$$

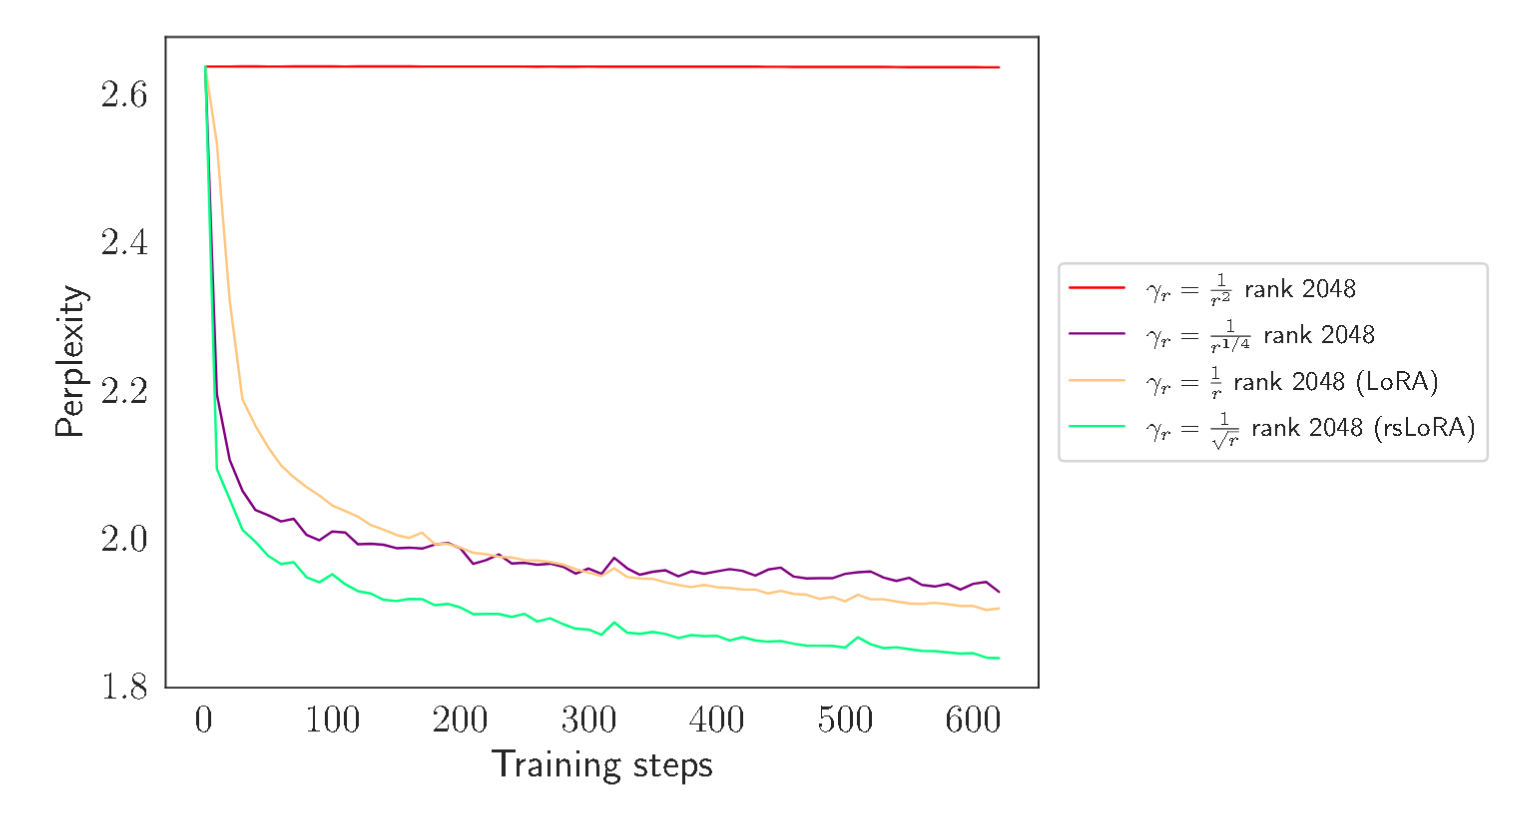
<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8e4f60c002f22e8ca9c534b48323e9e77e4b5ea6%2Fimage.png?alt=media" alt=""><figcaption><p>rsLoRAの他のスケーリング विकल्प。sqrt(r)が最良です。</p></figcaption></figure>

$$
\hat{W}\_{\text{rslora}} = W + \frac{\alpha}{\sqrt{\text{rank}}} \times AB
$$
{% endcolumn %}

{% column %}
LoRAの式は左側にあります。薄い行列AとBを、alphaをランクで割った値でスケールする必要があります。 <mark style="background-color:blue;">**つまり、alpha/rankは少なくとも1に保つべきです**</mark>.

によると [rsLoRA（rank stabilized lora）の論文](https://arxiv.org/abs/2312.03732)、代わりにalphaをランクの平方根でスケールすべきです。他の選択肢もありますが、理論的にはこれが最適です。左のプロットは他のランクとそのパープレキシティ（低いほど良い）を示しています。これを有効にするには、 `use_rslora = True` をUnslothに追加しました。

私たちの推奨は、 <mark style="background-color:green;">**alphaをランクと同じにするか、少なくともランクの2倍にすることです。**</mark> つまり alpha/rank = 1 または 2 です。
{% endcolumn %}
{% endcolumns %}

## :dart: LoRAの対象モジュールとQLoRA vs LoRA

{% hint style="success" %}
次を使います:\
`target_modules = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj",]` して両方を対象にします **MLP** そして **attention** 層を対象にして精度を高めます。

**QLoRAは4ビット精度を使用し**、VRAM使用量を75%以上削減します。

**LoRA（16ビット）** のほうが、わずかに高精度で高速です。
{% endhint %}

実験的な検証や、元の [QLoRA論文](https://arxiv.org/pdf/2305.14314)のような研究論文によれば、注意層とMLP層の両方にLoRAを適用するのが最善です。

{% columns %}
{% column %}

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-16bef8165ccace21d0533f1941b8268a165c6a37%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
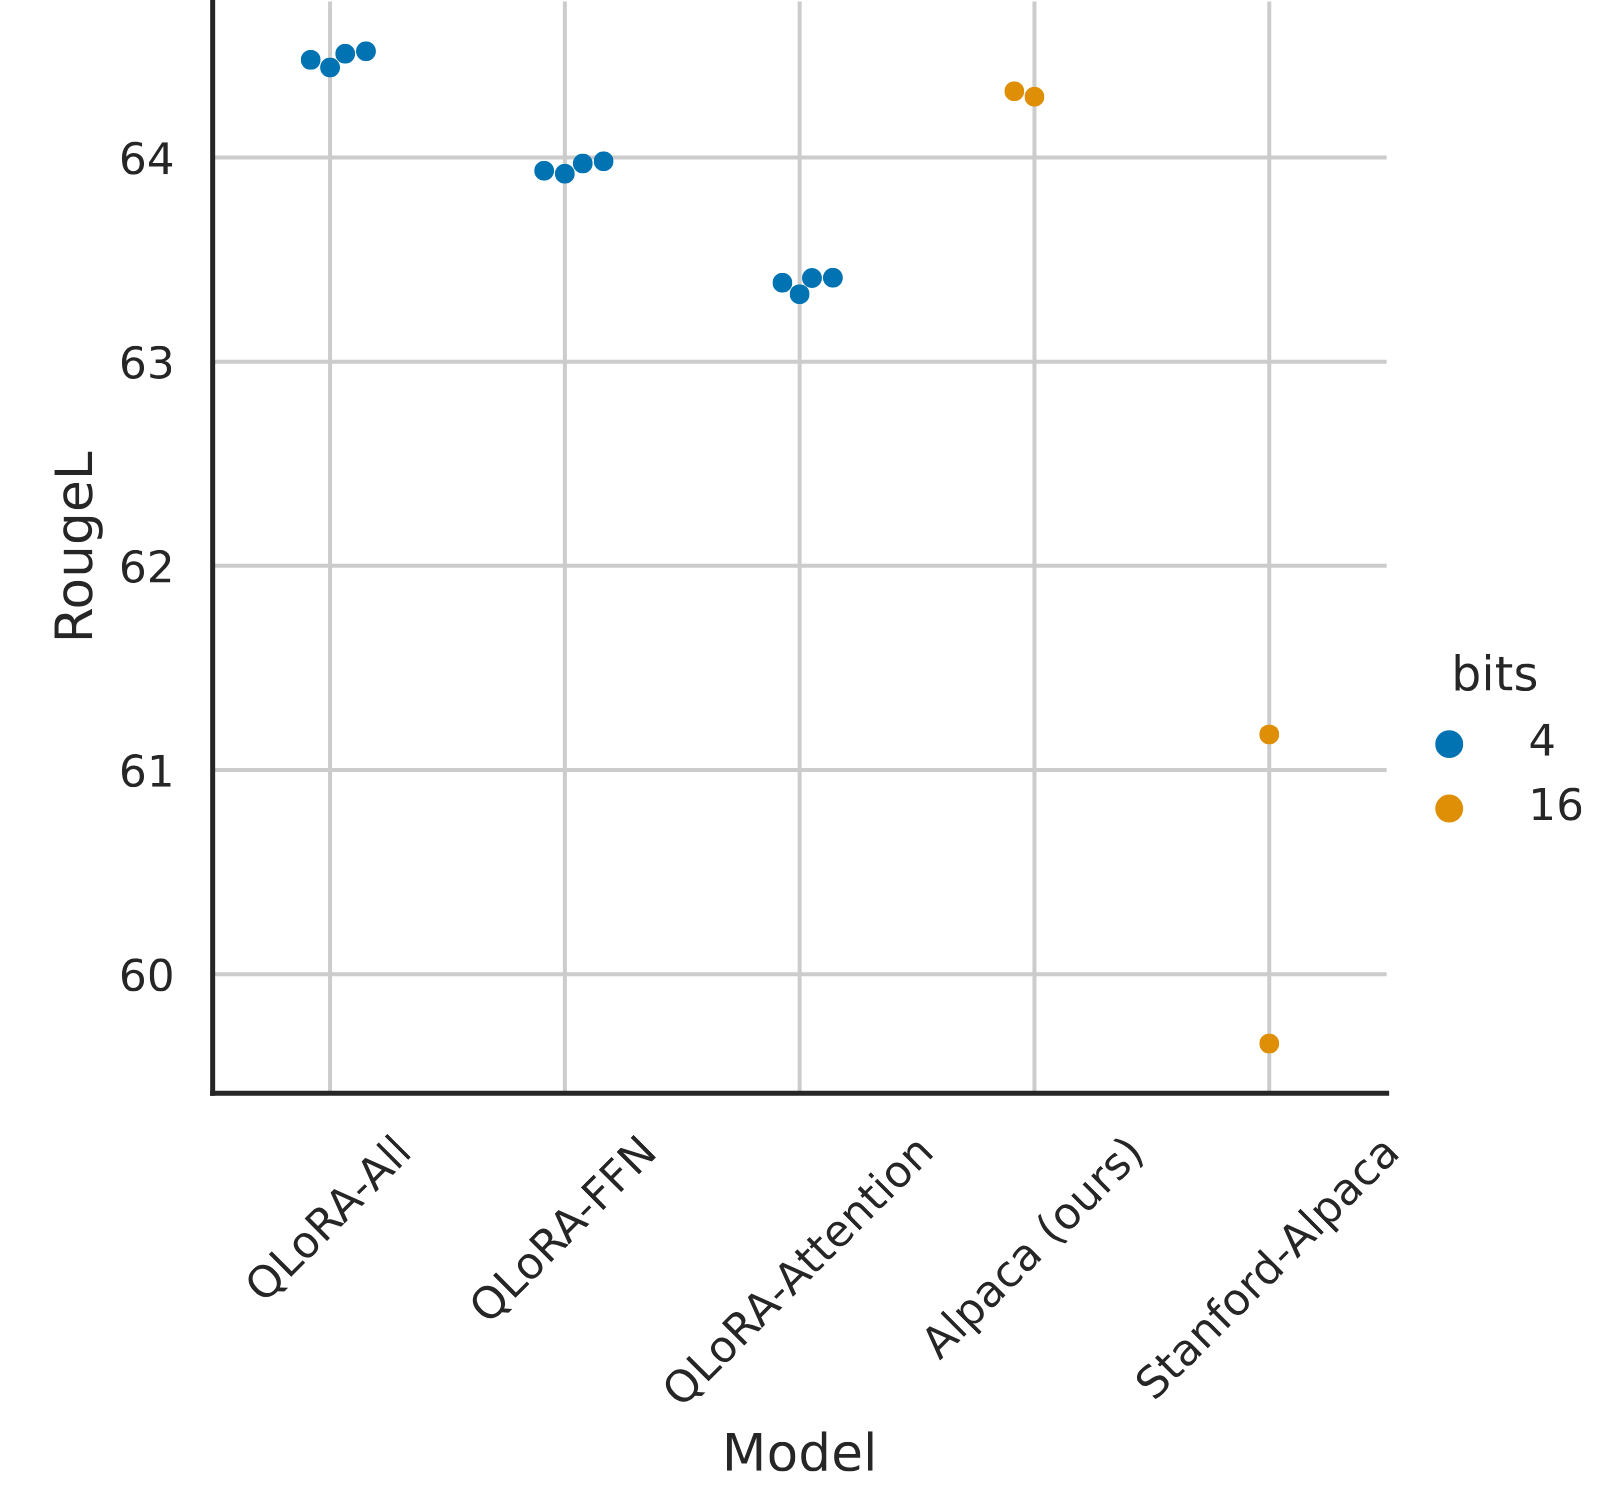
この図は、LoRAとQLoRAを比較した、異なる対象モジュール構成でのRougeLスコア（高いほど良い）を示しています。

最初の3点は次を示します:

1. **QLoRA-All:** すべてのFFN/MLPおよびAttention層にLoRAを適用。\
   :fire: *これが全体として最良の性能です。*
2. **QLoRA-FFN**: FFNのみにLoRAを適用。\
   次に相当します: `gate_proj`, `up_proj`, `down_proj。`
3. **QLoRA-Attention**: Attention層のみにLoRAを適用。\
   次に相当します: `q_proj`, `k_proj`, `v_proj`, `o_proj`.
   {% endcolumn %}
   {% endcolumns %}

## :sunglasses: 入力をマスクして、完了部分のみに学習する

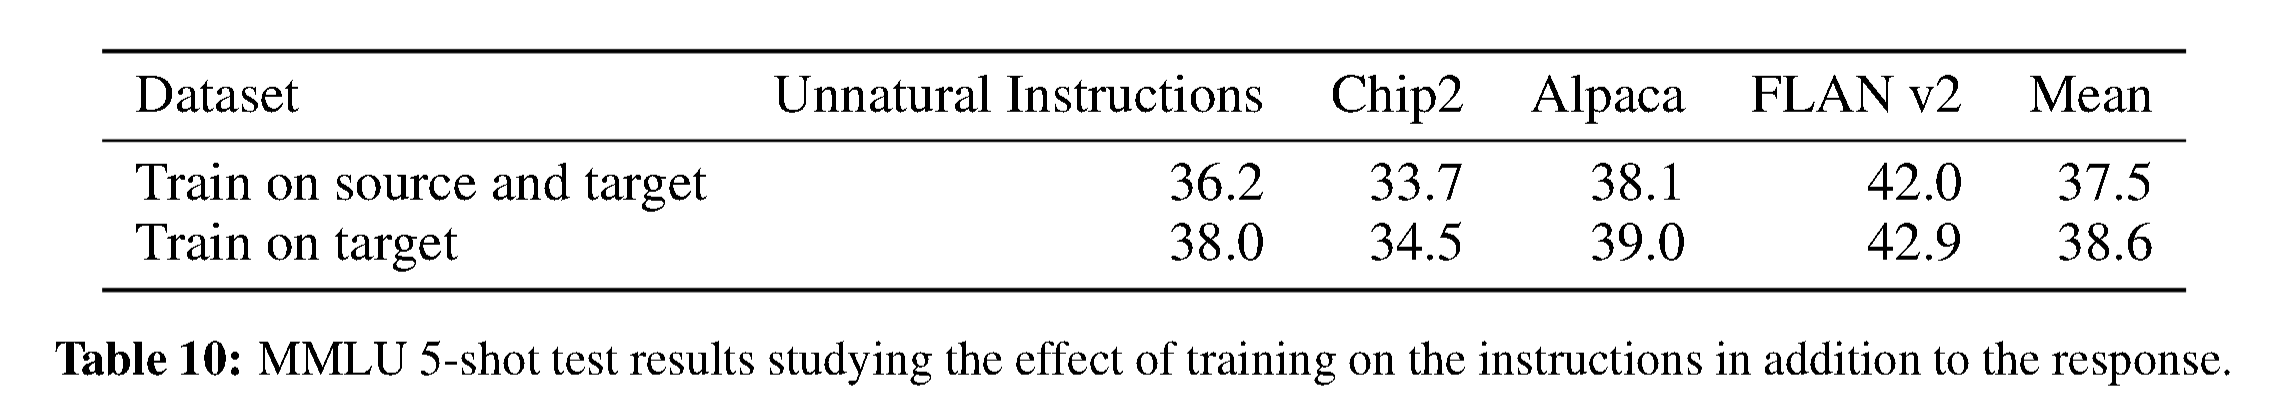
その [QLoRA論文](https://arxiv.org/pdf/2305.14314) 入力をマスクして **完了部分のみに学習する** （出力やアシスタントのメッセージ）ことでさらに **精度を向上させる** ことが、数パーセントポイント（*1%*）。以下では、Unslothでこれをどう行うかを示します:

{% columns %}
{% column %}
**決して** 完了部分のみに学習する:

**USER:** <mark style="background-color:green;">こんにちは、2+2は？</mark>\
**ASSISTANT:** <mark style="background-color:green;">答えは4です。</mark>\
**USER:** <mark style="background-color:green;">こんにちは、3+3は？</mark>\
**ASSISTANT:** <mark style="background-color:green;">答えは6です。</mark>
{% endcolumn %}

{% column %}
**学習** 完了部分のみに:

**USER:** ~~こんにちは、2+2は？~~\
**ASSISTANT:** <mark style="background-color:green;">答えは4です。</mark>\
**USER:** ~~こんにちは、3+3は？~~\
**ASSISTANT:** <mark style="background-color:green;">答えは6</mark><mark style="background-color:green;">**.**</mark>
{% endcolumn %}
{% endcolumns %}

QLoRA論文では、 **完了部分のみに学習することは** かなり精度を向上させると述べられており、特に複数ターンの対話ファインチューニングで効果的です！私たちはこれを [こちらの対話ノートブックで](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(1B_and_3B\)-Conversational.ipynb).

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e73b480d1db1dd3d52dd0d4a7e24caff6a54be0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

有効にするために **完了部分の学習** をUnslothで行うには、指示部分とアシスタント部分を定義する必要があります。 :sloth: *将来的には、これをさらに自動化する予定です！*

Llama 3、3.1、3.2、3.3、4のモデルでは、部分を次のように定義します:

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
)
```

Gemma 2、3、3nのモデルでは、部分を次のように定義します:

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<start_of_turn>user\n",
    response_part = "<start_of_turn>model\n",
)
```

## &#x20;:mag\_right:視覚モデル、VLMでアシスタント応答のみに学習する

言語モデルでは、 `from unsloth.chat_templates import train_on_responses_only` を前述のとおり使えます。視覚モデルでは、 `UnslothVisionDataCollator` の一部として追加引数を使ってください。

{% code overflow="wrap" %}

```python
class UnslothVisionDataCollator:
def __init__(
    self,
    ...
    # from unsloth.chat_templates import train_on_responses_only
    # trainer = train_on_responses_only(
    #     trainer,
    #     instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    #     response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    # )
    train_on_responses_only = False, # LLMではtrain_on_responses_onlyに相当
    instruction_part = None, # train_on_responses_only(instruction_part = ...)に相当
    response_part    = None, # train_on_responses_only(response_part = ...)に相当
    force_match      = True, # 改行も一致させる！
)
```

{% endcode %}

たとえば Llama 3.2 Vision の場合：

```python
UnslothVisionDataCollator(
    model, tokenizer,
    ...
    train_on_responses_only = True,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    ...
)
```

## :key: **過学習と学習不足の回避**

### **過学習** （汎用化が不十分／特化しすぎ）

モデルが、統計的ノイズを含む訓練データを記憶してしまい、その結果、未見のデータへ一般化できなくなります。

{% hint style="success" %}
訓練損失が 0.2 を下回ると、モデルはおそらく **過学習** — つまり、未見のタスクでは性能が低い可能性があります。

簡単な工夫のひとつは LoRA の alpha スケーリングです — 各 LoRA 行列の alpha 値を 0.5 倍するだけです。これにより、ファインチューニングの影響を効果的に弱められます。

**これは、重みのマージ／平均化と密接に関連しています。**\
元のベース（または instruct）モデルに LoRA 重みを加え、その結果を 2 で割ることができます。これにより平均化されたモデルが得られます — これは機能的には `alpha` を半分にするのと同等です。
{% endhint %}

**解決策：**

* **学習率を調整する：** 高い学習率は、特に短い学習では過学習につながりやすいです。長い学習では、より高い学習率のほうがうまくいく場合があります。どちらが最も良いかを確認するために、両方を試してみるのが最善です。
* **学習エポック数を減らす**。1、2、または 3 エポックで学習を停止します。
* **増やす** `weight_decay`。値として `0.01` または `0.1` は良い出発点です。
* **増やす** `lora_dropout`。正則化を加えるために、 `0.1` のような値を使います。
* **バッチサイズまたは勾配蓄積ステップを増やす**.
* **データセットの拡張** - オープンソースのデータセットをあなたのデータセットと組み合わせたり連結したりして、データセットを大きくします。より高品質なものを選びましょう。
* **評価による早期停止** - 評価を有効にし、評価損失が数ステップにわたって増加したら停止します。
* **LoRA Alpha スケーリング** - 学習後および推論時に alpha を下げます - これによりファインチューニングの効果が控えめになります。
* **重みの平均化** - 元の instruct モデルとファインチューニング結果を文字通り足し合わせ、重みを 2 で割ります。

### **学習不足** （汎用的すぎる）

モデルが訓練データに含まれる本質的なパターンを捉えられず、たいていはモデルの複雑さや学習時間が不足していることが原因です。

**解決策：**

* **学習率を調整する：** 現在の学習率が低すぎるなら、特に短い学習では上げることで収束を速められる場合があります。長い学習では、代わりに学習率を下げてみてください。どちらが最も効果的か、両方試してみましょう。
* **学習エポック数を増やす：** より多くのエポックで学習しますが、過学習を避けるために検証損失を監視してください。
* **LoRA のランクを上げる** (`r`）と alpha：ランクは少なくとも alpha の数と同じであるべきで、より小さなモデルやより複雑なデータセットではランクを大きくすべきです。通常は 4 から 64 の間です。
* **よりドメインに関連したデータセットを使う**：学習データが高品質で、対象タスクに直接関連していることを確認してください。
* **バッチサイズを 1 に下げる**。これにより、モデルの更新がより強く行われます。

{% hint style="success" %}
ファインチューニングに唯一の「最良」な方法はなく、あるのはベストプラクティスだけです。自分の用途に合うものを見つけるには試行錯誤が鍵です。私たちのノートブックは、多くの論文研究と私たち自身の実験に基づいて最適なパラメータを自動で設定するため、素晴らしい出発点になります。楽しくファインチューニングしましょう！
{% endhint %}

***謝辞：** 心より感謝を* [*Eyera*](https://huggingface.co/Orenguteng) *このガイドへのご貢献に！*


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.