> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide/memory-efficient-rl.md).

# メモリ効率の高いRL

Unslothで、複数のアルゴリズム改善により、より効率的な強化学習（RL）を導入できることを嬉しくお知らせします:

* **コンテキスト長が1.2倍から1.7倍に拡大** しかも速度低下も追加メモリ使用量もなし！
* **RL学習が10%高速化** 刷新されたカーネルと非同期データ移動により
* **2倍高速 `torch.compile` 倍** モデル読み込み中

Unsloth **すでに** はRL学習速度を向上させ、コンテキストウィンドウを拡大し、FA2を使った他のすべての構成と比べてVRAM使用量を50～90%削減しますが、今では [**UnslothのStandby**](#unsloth-standby) がこれをさらに改善します。Standby機能は、他の実装と比べて速度低下を独自に抑え、場合によっては学習をさらに速くします！

今では、Qwen3-32B LoRA 16-bitは6,144のコンテキスト長を達成でき、以前の3,600（**1.7倍長い**）と比べて、1xH100 80GB GPU上で達成できます。Llama-3.1-8B QLoRA 4bitは、以前の42,000に対して47,500の長さを達成できます（1.13倍長い）。

さまざまなカーネル最適化によりRLの実行を10%高速化し、学習モードから推論モードへ切り替える際のCPUとGPU間のLoRA通信チャネルを削除しました。最後に、独自の `torch.compile` フラグを使ってvLLMのロールアウトを10%高速化し、コンパイル時間を2倍短縮しました。

## :sparkles:最適化を有効にする方法

有効にするために **UnslothのStandby** 機能を有効にするには、環境変数 `UNSLOTH_VLLM_STANDBY` を、いずれかのUnslothインポートの前に設定してください。次に `gpu_memory_utilization = 0.95` を設定すれば完了です！

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1"

from unsloth import FastLanguageModel
import torch
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B-Base",
    max_seq_length = 2048, # より長い推論トレースのために増やせます
    load_in_4bit = False, # LoRA 16bitではFalse
    fast_inference = True,
    max_lora_rank = 32, # ランクが大きいほど賢いが、遅くなる
    gpu_memory_utilization = 0.95,
)
```

## :mortar\_board:もう `gpu_memory_utilization`!

Unslothの新しいRL改善により、 `gpu_memory_utilization` 今後はチューニングや設定について心配する必要はまったくありません。GPU使用率の90%または95%に設定するだけで十分です。残念ながら100%ではうまく動作しません。小さなテンソル用に少し空き領域が必要だからです。以前は30%から95%まで調整する必要がありましたが、もう不要です！最大値に設定すれば、あとはUnslothが処理します！

## :interrobang:なぜRLはこれほど多くのメモリを使うのですか？

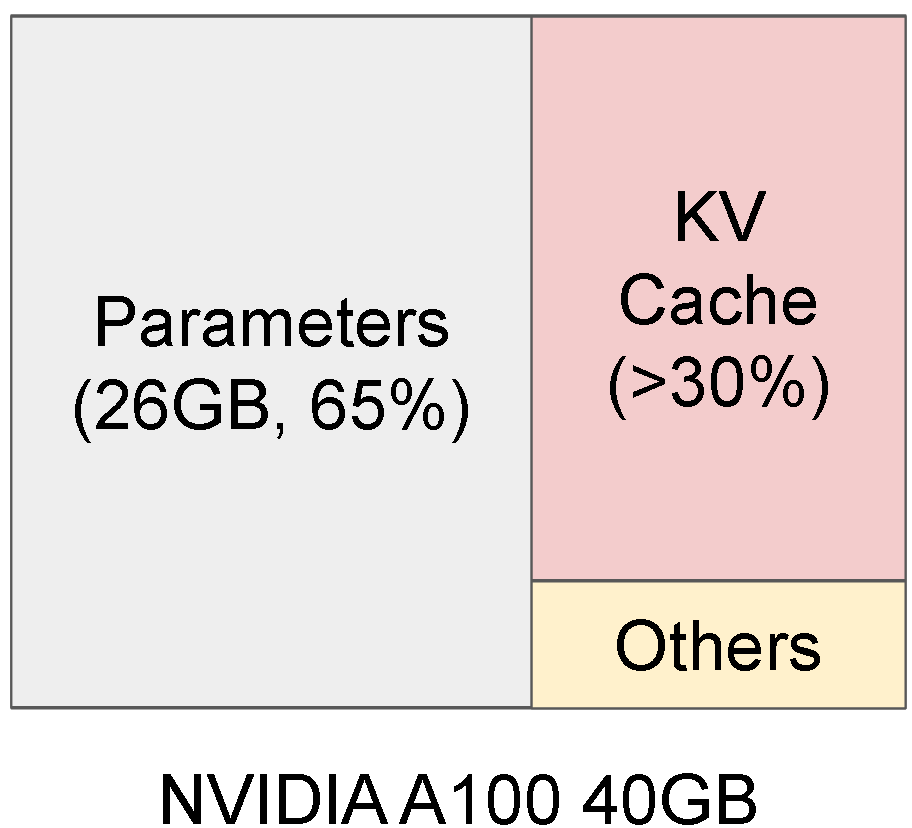
GRPO（および多くのRL派生手法）は生成に大きく依存しており、その主な駆動はvLLMです。しかしこれは大きなコストを伴います。なぜなら、 **重み、アクティベーション、KVキャッシュのためにGPUメモリを常時必要とするからです**.

{% columns %}
{% column %}
推論は大量のVRAMを消費します

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e25501083081b201d59f6000219cafa535d2b2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
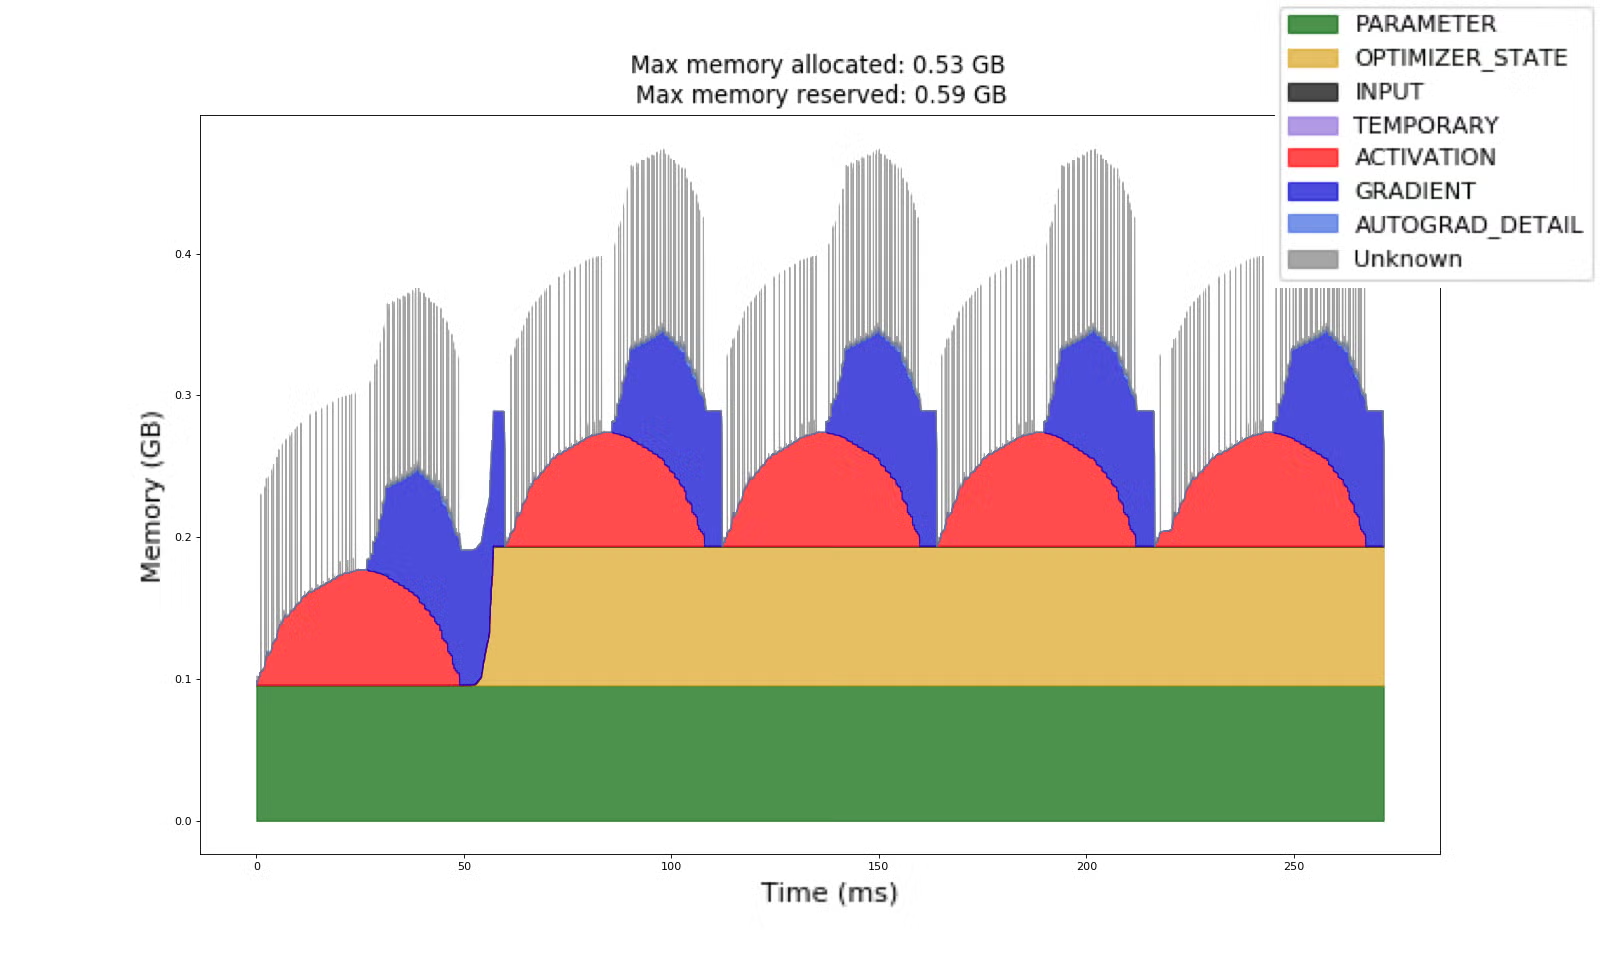
一方で学習もVRAMを使います！

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-189fd45a9e7a6fa1e98d1c9646b57bd0ec48481d%2Ffig6-2.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

つまり、RLではGPU上に2種類のVRAM/メモリを同時に保持する必要があります:

1. 推論エンジン（モデル重み、KVキャッシュを保持）
2. 学習エンジン（モデル重み、アクティベーション、勾配、オプティマイザ状態を保持）

現在のRLフレームワークでは、80GB GPUの場合、推論用50%、学習用50%に分割しなければなりません。また、学習モードから推論モードへ重みを移動するのにはかなり時間がかかることがあります。

<table><thead><tr><th width="251.51666259765625">80GB GPU</th><th>推論エンジン（50%）</th><th>学習エンジン（50%）</th></tr></thead><tbody><tr><td>モデルの重み</td><td>16GB</td><td>16GB</td></tr><tr><td>KVキャッシュ</td><td>24GB</td><td></td></tr><tr><td>活性化、勾配、最適化状態</td><td></td><td>24GB</td></tr></tbody></table>

前バージョンのUnslothでもすでに上記を賢く最適化していました。というのも、 **vLLMの重み領域を直接共有し、モデル重みの二重メモリ使用を解消しているからです**。これにより、たとえば16GBの空きが生まれ、コンテキスト長や生成速度の向上に使えます。また、メモリ移動が不要になるため、学習が速くなります。

| 80GB GPU     | 推論エンジン（50%）          | 学習エンジン（50%）         |
| ------------ | -------------------- | ------------------- |
| モデルの重み       | **16GB共有**           | **<<< 共有**          |
| KVキャッシュ      | 24GB + 8GB= **32GB** |                     |
| 活性化、勾配、最適化状態 |                      | 24GB + 8GB=**32GB** |

## 🦥Unsloth Standby

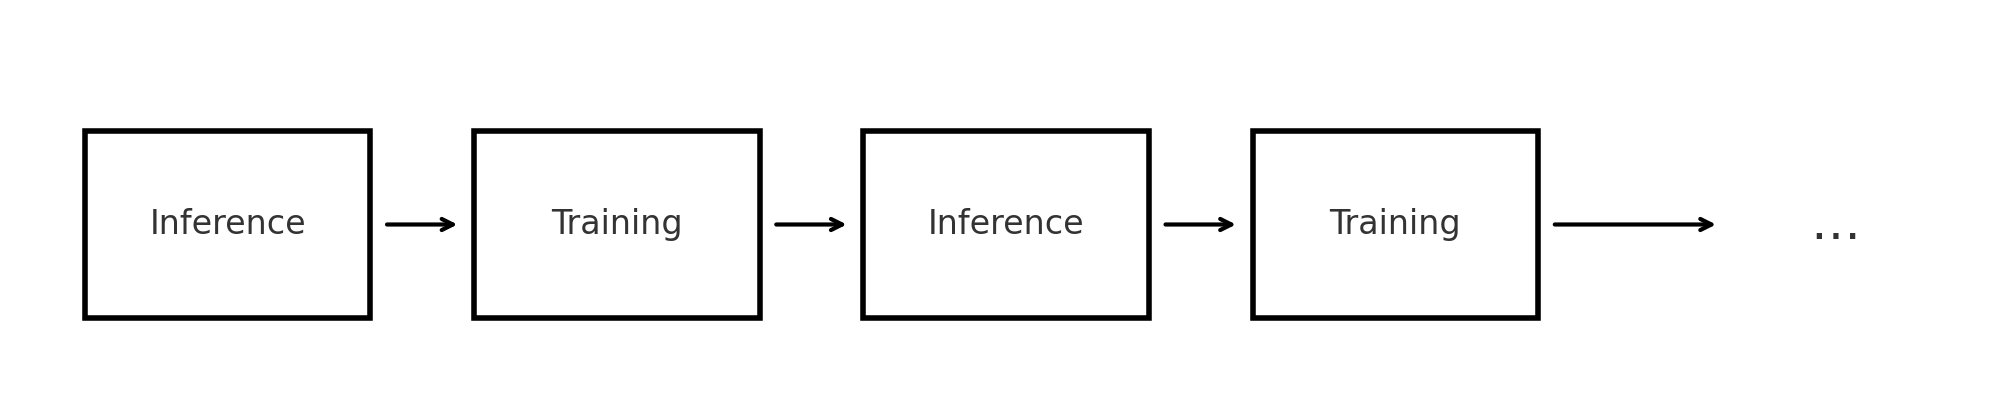
しかし、さらに先へ進めます。まずRLは推論→学習→推論→学習…と繰り返すことに注目します。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-6e9b6a2f7381de84ed6eeb0feedc566cd443acf3%2F5b957843-eb58-4778-8b90-f25767c51495.png?alt=media" alt=""><figcaption></figcaption></figure>

つまり、推論と学習は別モードなので、理論上はそれぞれのメモリ領域を再利用できます。ここで [vLLMのスリープモード機能](https://docs.vllm.ai/en/latest/features/sleep_mode.html#rlhf-weight-updates) が登場します。これには2つのオプションがあります:

1. `レベル=1` 重みをCPUにコピーし、KVキャッシュを削除する
2. `レベル=2` 重みを削除し、KVキャッシュを削除する

ただし、Unslothでは重みについてvLLMのメモリ空間を共有していることを忘れないでください。つまり、KVキャッシュを削除する新しい方法が必要で、重みの削除は無視する必要があります。これをUnsloth Standbyと呼びます。

| 80GB GPU                                                                                                                                                 | 推論エンジン     | 学習エンジン       |
| -------------------------------------------------------------------------------------------------------------------------------------------------------- | ---------- | ------------ |
| モデルの重み                                                                                                                                                   | **16GB共有** | **<<< 共有**   |
| <p><mark style="background-color:purple;"><strong>多目的</strong></mark></p><p><mark style="background-color:purple;"><strong>64GBの空き領域</strong></mark></p> | KVキャッシュ    | 活性化、勾配、最適化状態 |

これを有効にするには、いずれかのUnslothインポートの前に、すべてのRL / GRPO学習実行に以下を追加するだけです:

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1"
```

## 🧪性能実験

ここではGRPOのメモリ使用量とコンテキスト長をどのようにベンチマークしたかを紹介します。なお、私たちは **プロンプトごとに2回生成しています。GRPOが動作するには**、サンプル平均と分散を計算するために少なくとも2回の生成が必要だからです。 **2回の生成がなければ、1サンプルの標準偏差は0です**。そのため、これを使う優位度:（報酬 - 平均）/標準偏差 **は未定義になります**.

$$
Z=\frac{r\_i - \mu}{\sqrt{\frac{1}{n}\sum(r\_i-\mu)^2}} \\
Z\_{n=1}=\frac{r\_1 - \mu}{\sqrt{\frac{1}{1}\sum(r\_1-\mu)^2}}=\frac{0}{0}=\text{undefined}
$$

つまり、GRPOに限れば、Qwen-3 32Bの最大コンテキスト長6,144は、実際には6,144×2生成、つまり長さ12,288に相当します。

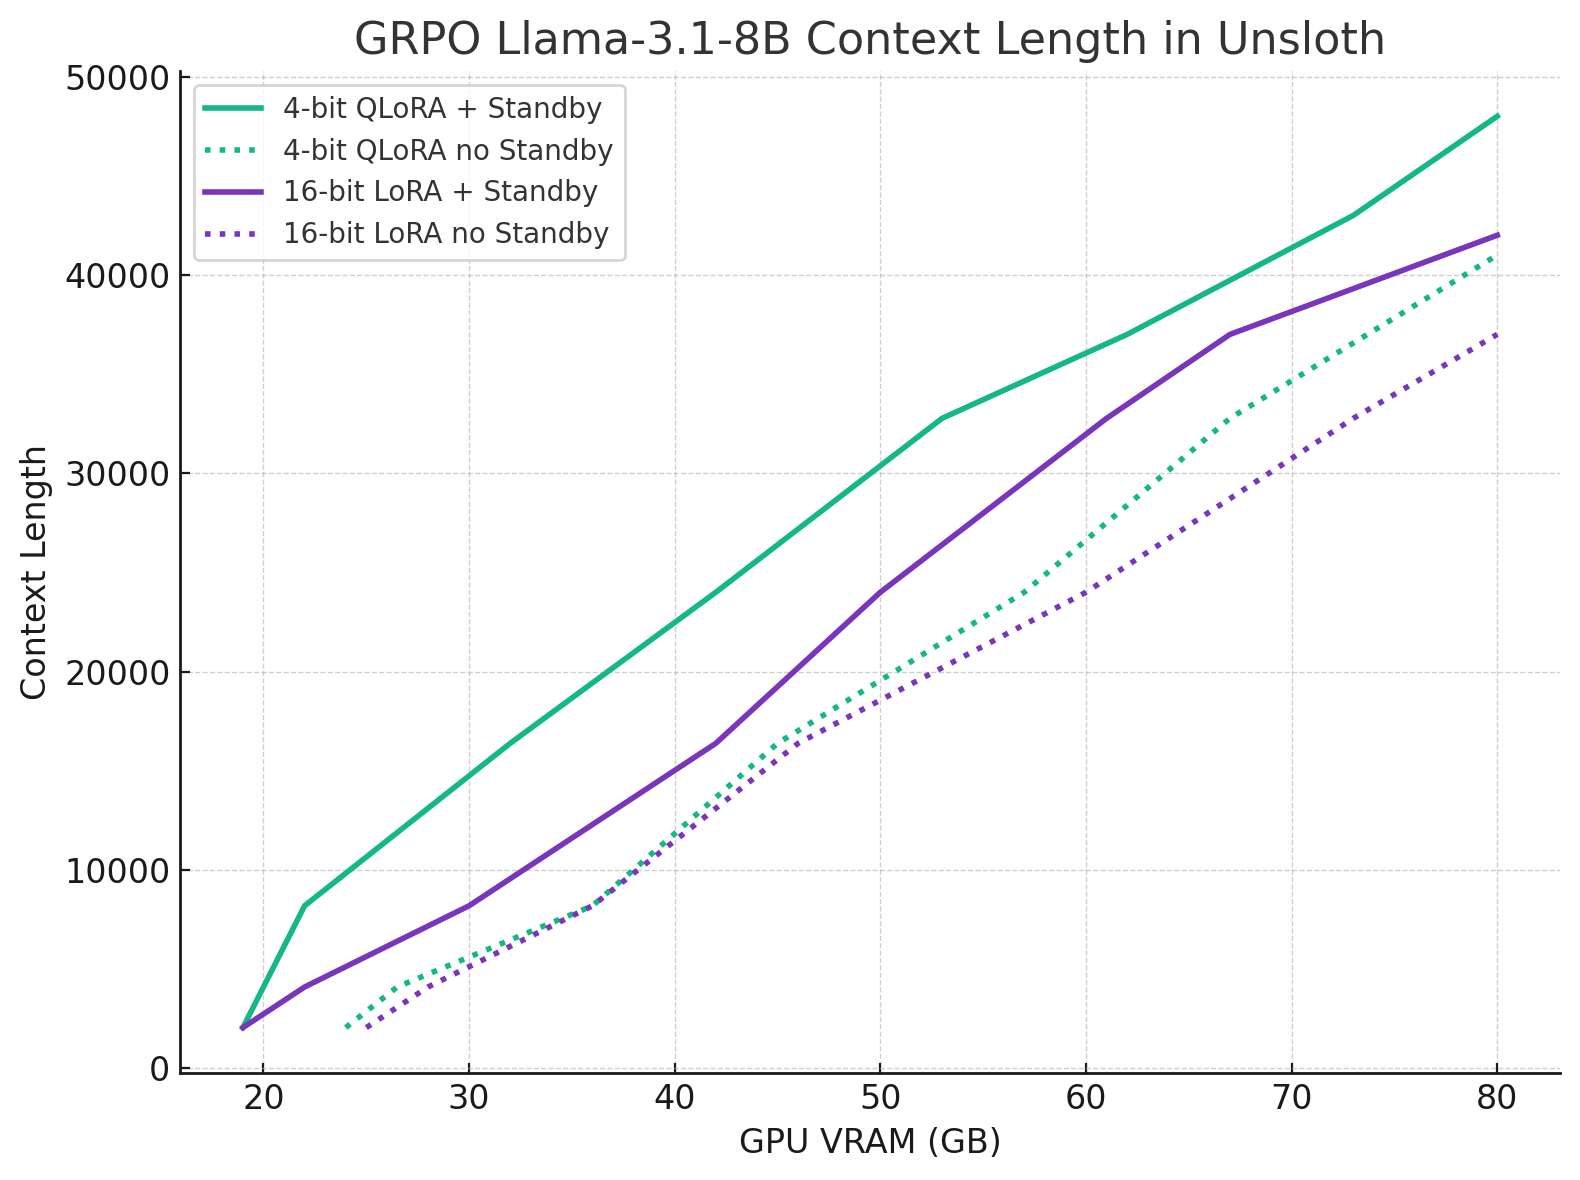
以下では、Llama-3.1 8Bについて、LoRA（16bit）とQLoRA（4bit）の両方の実験を示します:

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f83185e373186aa67bc2ce7d1814b2edb0f3ce6%2Foutput%20(10).png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

**学習時間に差が見られるとしても、それほど大きくはありません**。同条件での比較では、学習時間の低下は1%未満、あるいは高速化さえ見られましたが、これは誤差の範囲と考えられます。

また、メモリ圧力の低下により速度向上が起こり得ると考えており、そのためCUDAメモリ割り当て側でのメモリクリーンアップが少なくなる可能性があります。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-db26f62f9080dba942add171880537c3f516f065%2Fgpu%20mem%20cofigure.png?alt=media" alt=""><figcaption></figcaption></figure>

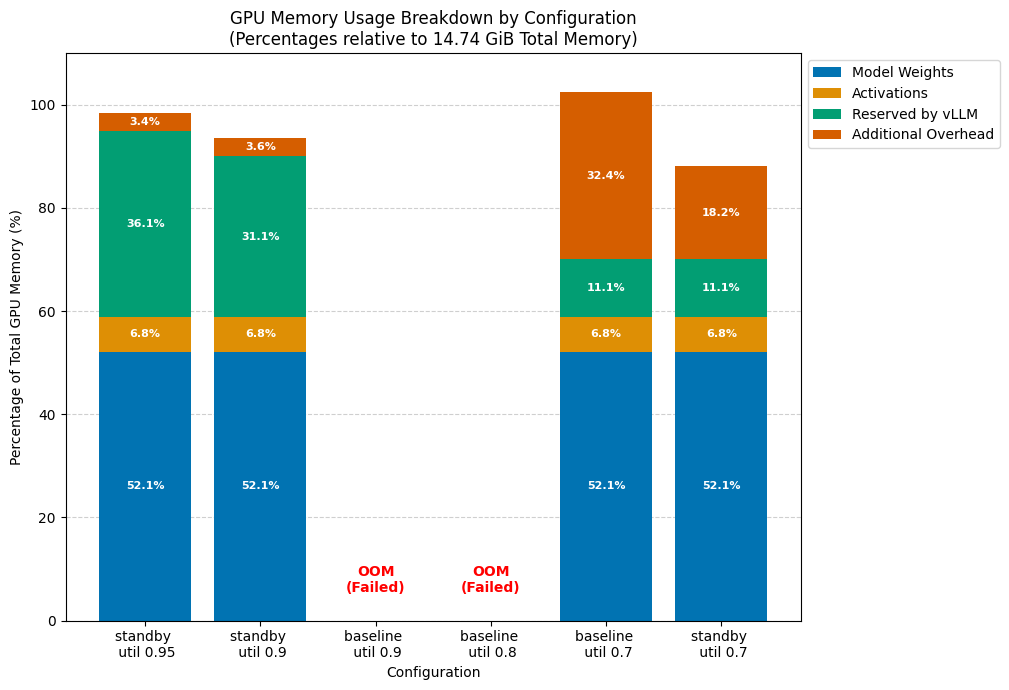
上の画像では、Qwen 3 4Bについて、単一のT4 GPU上でベースラインとスタンバイモードの違いが分かります。 <mark style="background-color:green;">**vllmの**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`gpu_memory_utilisation`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**を0.95まで上げても、学習に影響する心配はありません**</mark>。つまり、より長いコンテキスト長のシーケンスを収められ、より多くのシーケンスを処理できます。例えば最初のケースでは、学習が許すなら32K長のシーケンスを収めて処理するのに十分なメモリがありますが、以前は2Kを超える入力は収まらない可能性があり、OOM（メモリ不足）を引き起こしていました。

<table data-full-width="true"><thead><tr><th>実験</th><th>設定</th><th>状態</th><th>GPUメモリ使用量</th><th>コメント</th></tr></thead><tbody><tr><td><ol><li><a href="https://colab.research.google.com/drive/18CssBY5C0mStnLvu2Hlt4aFLoPugRG0K?usp=sharing">u0.95gen2ga1s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.95</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>40ステップ/40分間実行</td><td><p>14.5 GiB（vllm_gpu_utilで設定）</p><p><br></p></td><td>2～4Kのチャンクで32KのKVキャッシュを収められる十分な容量、あるいは16KのKVキャッシュ＋16Kチャンクなど</td></tr><tr><td><ol start="2"><li><a href="https://colab.research.google.com/drive/1q0TOUychygfreI2wKpg51sqnRhs5cYnX?usp=sharing">u9ge2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>40分で32ステップ実行</td><td>13.8 GiB（…で設定）</td><td>およそ2～4Kのチャンクで約28KのKVキャッシュを収められる十分な容量、あるいは15KのKVキャッシュ＋15Kチャンクなど</td></tr><tr><td><ol start="3"><li><a href="https://colab.research.google.com/drive/12Uw8y5beLzPtx11mCWCYyh9Z_PEHHdId?usp=sharing">u9ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>モデルは読み込めるが、バッチサイズ1でも収まらないため学習できない</td><td>OOM</td><td><br></td></tr><tr><td><ol start="4"><li><a href="https://colab.research.google.com/drive/1GwTlaP5CLsW-BcE1LqZWkz6S8VTWYdJ2?usp=sharing">u8ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.8</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>モデルは読み込めるが、バッチサイズ1でも収まらないため学習できない</td><td>OOM</td><td><br></td></tr><tr><td><ol start="5"><li><a href="https://colab.research.google.com/drive/1IuSUNzEBTiURK-vbTQuRDuUl0Ya2pz2t?usp=sharing">u7ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>問題なく学習する</p><p>28ステップに39分かかる</p></td><td>約15.1GiB</td><td>これより少し長い入力はColabでOOMになります</td></tr><tr><td><ol start="6"><li><a href="https://colab.research.google.com/drive/1RY7HwpZ0luJT70OyLJ6zXKZQ2COdT9QJ?usp=sharing">u7gen2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>問題なく学習する</p><p>29ステップに40分かかる</p></td><td>13GiBだが、ほとんどの時間は10-11GB程度</td><td>同じ設定で、ここでは2GiB、つまり15%のメモリを節約しています。<br>より長いシーケンスではさらに高くなる可能性があります</td></tr></tbody></table>

### H100実験

| モデル                  | GPU                   | シーケンス長 | 生成回数 | 勾配累積ステップ |
| -------------------- | --------------------- | ------ | ---- | -------- |
| Qwen2.5-14B-Instruct | NVIDIA H100 80GB PCIe | 32,768 | 8    | 4        |

以下の折りたたみ可能な結果では、ピーク時のメモリ使用量に9GiBの差があることが分かります（なお、私たちのケースでは90%の時間でGPUメモリ使用量はピーク値と同じです）。 **視点を変えると、TRLとLoRAを使った場合、同じバッチサイズを維持したまま、コンテキスト長1024の8Bパラメータモデルまでしか微調整できませんでした（最大でも32分の1）。** 同様の設定でシーケンス長がこれより長いものは、プロセスがOOMで失敗します。

<details>

<summary>Unsloth Standbyモード vs. 非Standbyベンチマークをクリック</summary>

```
Standbyモード有効:

|===========================================================================|
|                  PyTorch CUDAメモリ概要、デバイスID 0                 |
|---------------------------------------------------------------------------|
|            CUDA OOM: 0            |        cudaMalloc再試行: 0         |
|===========================================================================|
|        指標         | 現在の使用量 | ピーク使用量 | 総割り当て | 総解放 |
|---------------------------------------------------------------------------|
| 割り当てメモリ      |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       大きなプールから |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       小さなプールから |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| アクティブメモリ         |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       大きなプールから |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       小さなプールから |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| 要求メモリ      |  32199 MiB |  42987 MiB | 128176 GiB | 128145 GiB |
|       大きなプールから |  31364 MiB |  42110 MiB | 127047 GiB | 127016 GiB |
|       小さなプールから |    834 MiB |   1184 MiB |   1129 GiB |   1128 GiB |
|---------------------------------------------------------------------------|
| GPU予約メモリ   |  37644 MiB |  47504 MiB | 705806 MiB | 668162 MiB |
|       大きなプールから |  36376 MiB |  46588 MiB | 682818 MiB | 646442 MiB |
|       小さなプールから |   1268 MiB |   1284 MiB |  22988 MiB |  21720 MiB |
|---------------------------------------------------------------------------|
| 解放不可メモリ | 713142 KiB |   4633 MiB | 103206 GiB | 103205 GiB |
|       大きなプールから | 525312 KiB |   4594 MiB | 101923 GiB | 101922 GiB |
|       小さなプールから | 187830 KiB |    250 MiB |   1283 GiB |   1283 GiB |
|---------------------------------------------------------------------------|
| 割り当て数           |    3460    |    4809    |   15606 K  |   15603 K  |
|       大きなプールから |     395    |     563    |    2812 K  |    2811 K  |
|       小さなプールから |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| アクティブ割り当て         |    3460    |    4809    |   15606 K  |   15603 K  |
|       大きなプールから |     395    |     563    |    2812 K  |    2811 K  |
|       小さなプールから |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| GPU予約セグメント |     913    |     920    |   13260    |   12347    |
|       大きなプールから |     279    |     305    |    1766    |    1487    |
|       小さなプールから |     634    |     642    |   11494    |   10860    |
|---------------------------------------------------------------------------|
| 解放不可割り当て |     422    |     628    |    4766 K  |    4765 K  |
|       大きなプールから |      66    |      92    |    1290 K  |    1289 K  |
|       小さなプールから |     356    |     555    |    3476 K  |    3475 K  |
|---------------------------------------------------------------------------|
| オーバーサイズ割り当て  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| オーバーサイズGPUセグメント |       0    |       0    |       0    |       0    |
|===========================================================================|


Standbyなし:

|===========================================================================|
|                  PyTorch CUDAメモリ概要、デバイスID 0                 |
|---------------------------------------------------------------------------|
|            CUDA OOM: 0            |        cudaMalloc再試行: 0         |
|===========================================================================|
|        指標         | 現在の使用量 | ピーク使用量 | 総割り当て | 総解放 |
|---------------------------------------------------------------------------|
| 割り当てメモリ      |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       大きなプールから |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       小さなプールから |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| アクティブメモリ         |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       大きなプールから |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       小さなプールから |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| 要求メモリ      |  32572 MiB |  51658 MiB | 141898 GiB | 141866 GiB |
|       大きなプールから |  31738 MiB |  50780 MiB | 140644 GiB | 140613 GiB |
|       小さなプールから |    833 MiB |   1184 MiB |   1253 GiB |   1252 GiB |
|---------------------------------------------------------------------------|
| GPU予約メモリ   |  49552 MiB |  52188 MiB |  86354 MiB |  36802 MiB |
|       大きなプールから |  48320 MiB |  51300 MiB |  84740 MiB |  36420 MiB |
|       小さなプールから |   1232 MiB |   1232 MiB |   1614 MiB |    382 MiB |
|---------------------------------------------------------------------------|
| 解放不可メモリ |      0 B   |      0 B   |      0 B   |      0 B   |
|       大きなプールから |      0 B   |      0 B   |      0 B   |      0 B   |
|       小さなプールから |      0 B   |      0 B   |      0 B   |      0 B   |
|---------------------------------------------------------------------------|
| 割り当て数           |    3460    |    4809    |   17440 K  |   17437 K  |
|       大きなプールから |     395    |     564    |    2742 K  |    2741 K  |
|       小さなプールから |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| アクティブ割り当て         |    3460    |    4809    |   17440 K  |   17437 K  |
|       大きなプールから |     395    |     564    |    2742 K  |    2741 K  |
|       小さなプールから |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| GPU予約セグメント |       0    |       0    |       0    |       0    |
|       大きなプールから |       0    |       0    |       0    |       0    |
|       小さなプールから |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| 解放不可割り当て |       0    |       0    |       0    |       0    |
|       大きなプールから |       0    |       0    |       0    |       0    |
|       小さなプールから |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| オーバーサイズ割り当て  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| オーバーサイズGPUセグメント |       0    |       0    |       0    |       0    |
|===========================================================================|
```

</details>

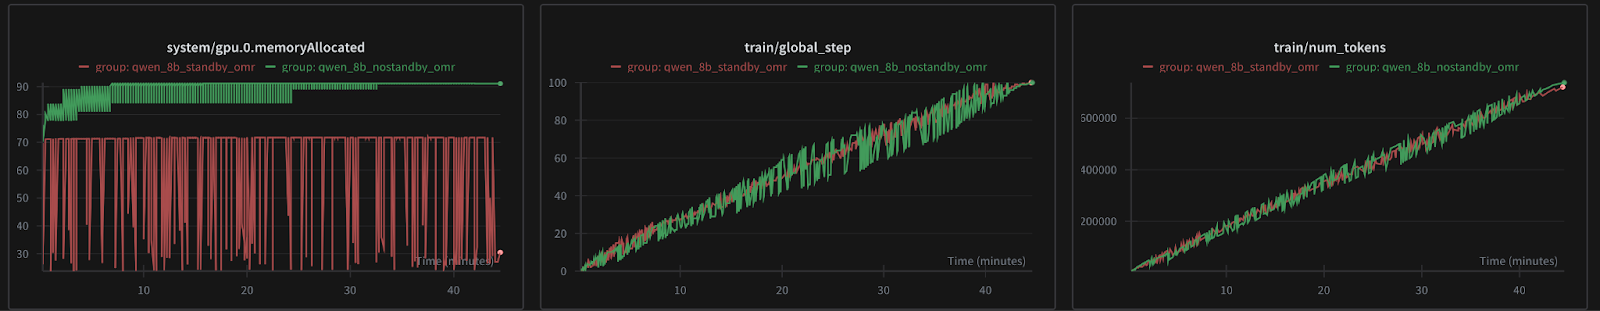
下の画像では、UnslothにおけるStandbyと非Standby学習の比較が示されています。指標がノイズを含まないよう、3回の実行の平均を取っています。実際、十分に拡大して見ると、Standbyを有効にするとさらに高速になることが分かるはずです。これは前述のとおり、メモリ圧力が下がるためだと思われます。

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f285043ea8afa38d1082513e424662d8cd04b90%2Ftrainglobalstep.png?alt=media" alt=""><figcaption></figcaption></figure>

### 以前のA100 40GB実験

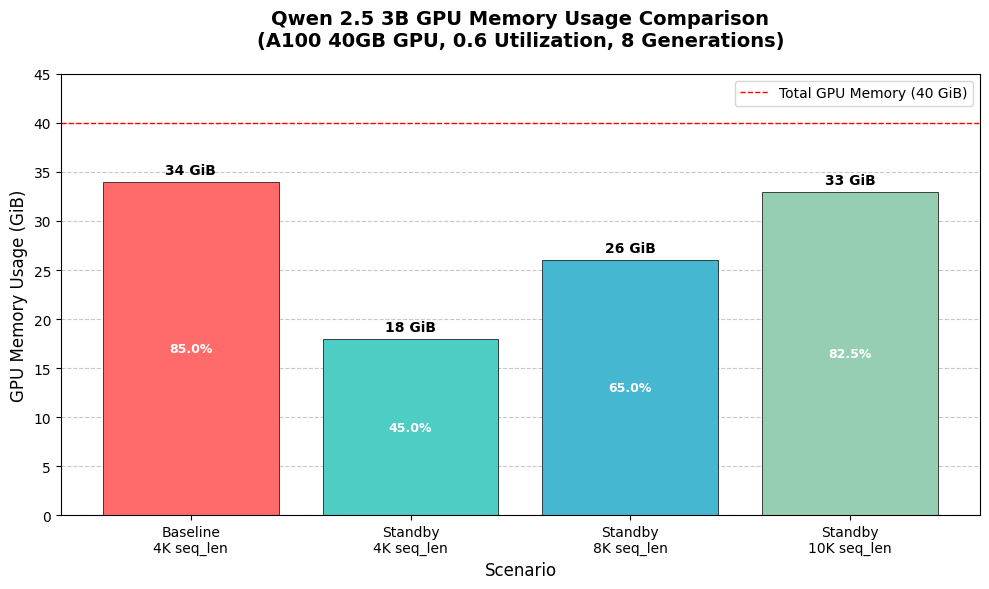
Qwen-2.5-3b-instructを使った以前のA100 40GB GPUでの実験では、サンプルあたり8回生成した場合、StandbyなしではGRPO学習（モデルは16bitで読み込み、LoRA、学習可能なのは重みのみ）で、最大でも6Kのシーケンス長しか収まりませんでした。Standby機能を使うと、10K以上を収められるようになりました！ **比較として、TRLでは同じバッチサイズを保ったまま、最大でも1Kのコンテキスト長しか得られません。**

<figure><img src="https://735611837-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-c7cd807b5d513b04f5f3a6219bfcea0fb12e442a%2Fqwen3%20gpu%20mem.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

## :tada:その他の最適化

現在はより良いコンパイルフラグを選択し、コンパイル時間を50%以上短縮しています。また、あらゆるvLLMバージョンに対して動的にパッチを当て、 `gc.collect` 後方互換性の理由からより適切に処理するようにしました。これは次の [vLLMのプルリクエスト](https://github.com/vllm-project/vllm/pull/21146)に着想を得ています。これにより、コンパイル時間は2分から40秒未満に短縮されます。

また、 `torch.compile` フラグも最適化し、いくつかのフラグを有効にすることを試しました。残念ながら `combo_kernels` そして `multi_kernel` はvLLM 0.10とTorch 2.8/2.9 nightlyでは正しく動作せず、 `coordinate_descent_tuning` すべてのカーネルの自動チューニングを劇的に遅くしてしまいました。以前は1分未満でコンパイルできましたが、有効にすると13分以上かかり、性能向上はわずかでした。

## :books:GRPOノートブック

すべてのGRPOノートブックでUnsloth Standbyがデフォルトで有効になっており、すべての最適化も適用されています！こちらを参照してください <https://docs.unsloth.ai/get-started/unsloth-notebooks> すべてのGRPOノートブックはこちら、または以下を試してください:

* [**Qwen3（4B）**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) **-** 高度なGRPO LoRA
* [**DeepSeek-R1-0528-Qwen3 (8B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) （多言語ユースケース向け）
* [Gemma 3 (1B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(1B\)-GRPO.ipynb)
* [Llama 3.2（3B）](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - 高度なGRPO LoRA
* [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb)
* [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb)
* [Mistral v0.3（7B）](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb)
* [Qwen2.5 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen2.5_\(3B\)-GRPO.ipynb)


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide/memory-efficient-rl.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.