> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide.md).
# 強化学習(RL)ガイド
強化学習(RL)のすべてと、GRPOを使ってUnslothで自分のDeepSeek-R1推論モデルを学習する方法を学びましょう。初心者から上級者までの完全ガイドです。
強化学習とは、"エージェント"が環境とやり取りしながら意思決定を学び、受け取る **フィードバック** という形で **報酬** または **ペナルティ**.
* **行動:** モデルが生成するもの(例: 文章)。
* **報酬:** モデルの行動がどれだけ良かったか、または悪かったかを示すシグナル(例: 応答が指示に従っていたか?役に立ったか?)。
* **環境:** モデルが取り組んでいる状況やタスク(例: ユーザーの質問に答えること)。
### :sloth:学べること
1. RLとは? RLVR? PPO? GRPO? RLHF? RFT? それは **「運だけで十分?」** RLにとって?
2. 環境とは? エージェント? 行動? 報酬関数? 報酬?
この記事では、GRPO、強化学習(RL)、報酬関数について知っておくべきことを、入門から上級まで、さらにヒントやGRPOを使うための基本とあわせてすべて解説します [Unsloth](https://github.com/unslothai/unsloth)。GRPOを使うためのステップごとのチュートリアルを探しているなら、こちらのガイドをご覧ください [ここ](/docs/jp/meru/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
**2026年1月15日更新:** [超長コンテキストRL](/docs/jp/meru/reinforcement-learning-rl-guide/grpo-long-context.md) が登場!380Kのコンテキストウィンドウでgpt-ossを学習できます。
**2025年11月26日更新:** UnslothにFP8精度のRLとGRPOを導入します! [ブログを読む](/docs/jp/meru/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md)
{% endhint %}
## :question:強化学習(RL)とは?
RLの目標は次のとおりです:
1. **「良い」 ****結果を**** 見る可能性を高めること。**
2. **「悪い」 ****結果を**** 見る可能性を高めること。**
**見る可能性を下げること。** 以上です!
{% columns %}
{% column width="50%" %}
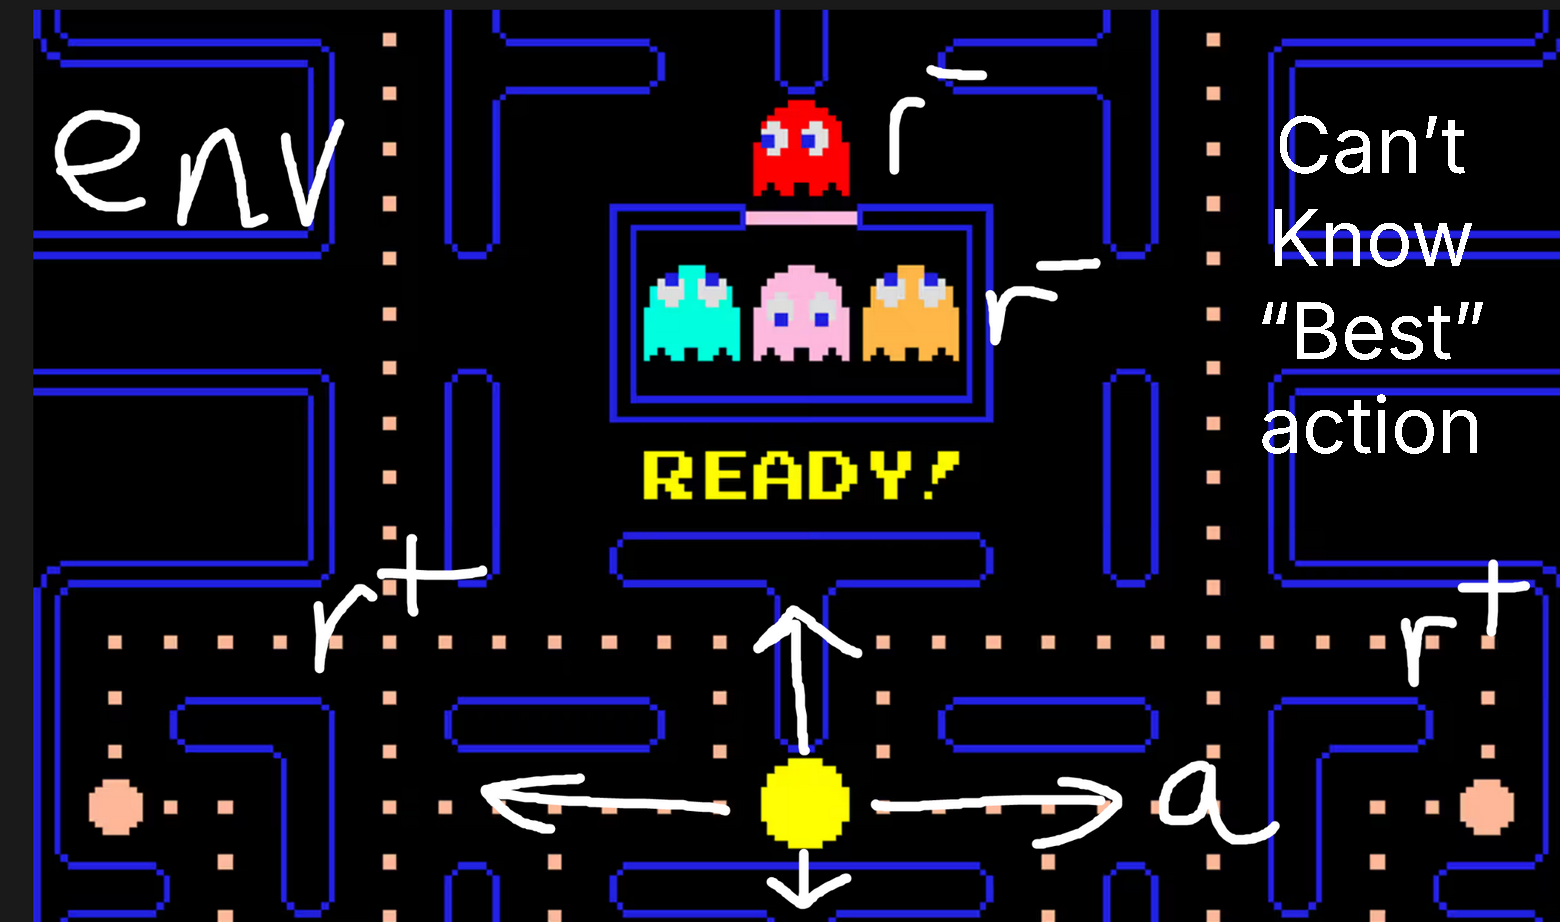
たとえば、 **パックマンゲーム**:
1. その **の環境は** ゲーム世界そのものです。
2. その **行動として** 選べるのは UP、LEFT、RIGHT、DOWN です。
3. その **報酬** クッキーを食べれば良いし、うねうねした敵の1体にぶつかれば悪い結果になります。
4. RLでは、自分が取れる「最善の行動」は分かりませんが、中間ステップや最終的なゲーム状態(勝ちか負けか)は観察できます
{% endcolumn %}
{% column %}
 {% endcolumn %}
{% endcolumns %}
{% columns %}
{% column width="50%" %}
 {% endcolumn %}
{% column %}
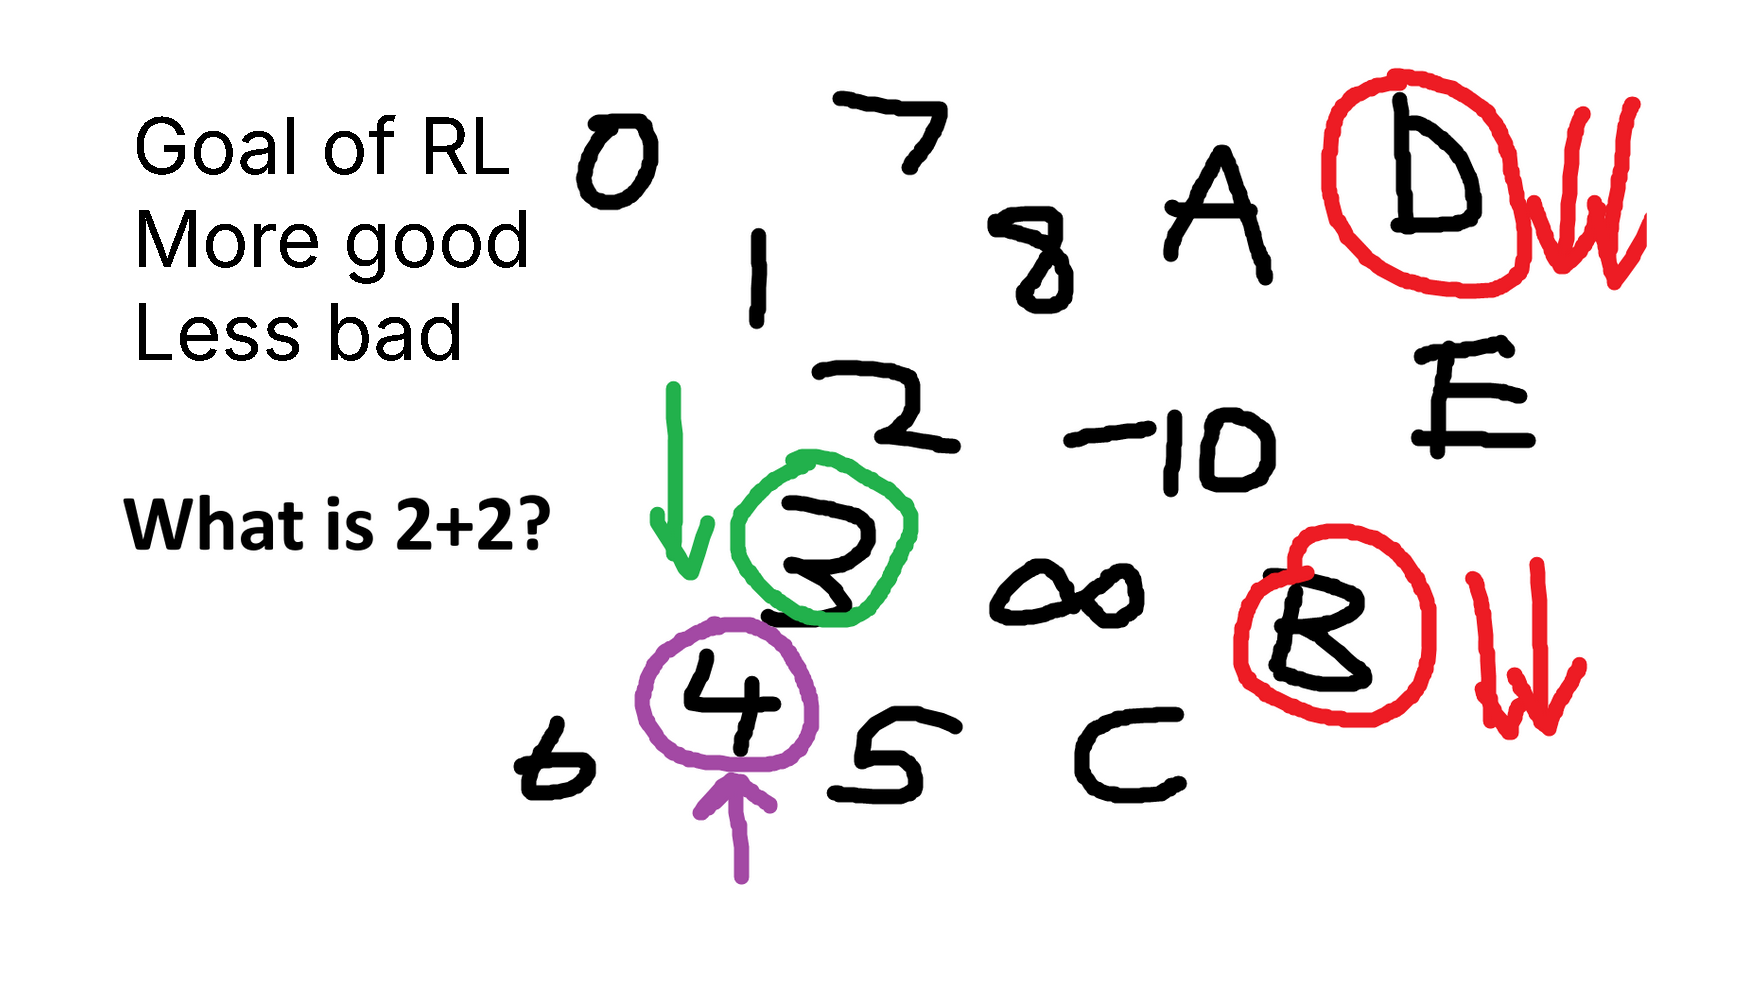
別の例として、次の質問が与えられたと想像してください: **「2 + 2 は?」** (4)整合していない言語モデルは 3、4、C、D、-10 など、文字どおり何でも出力してしまいます。
1. 数字のほうが C や D より良いですよね?
2. 3 が 8 より良いですよね?
3. 4 が間違いなく正解です。
つまり、私たちは **報酬関数**!
{% endcolumn %}
{% endcolumns %}
### :person\_running:を設計したことになります。RLHF、PPO から GRPO と RLVR まで
{% columns %}
{% column %}
 {% endcolumn %}
{% column %}
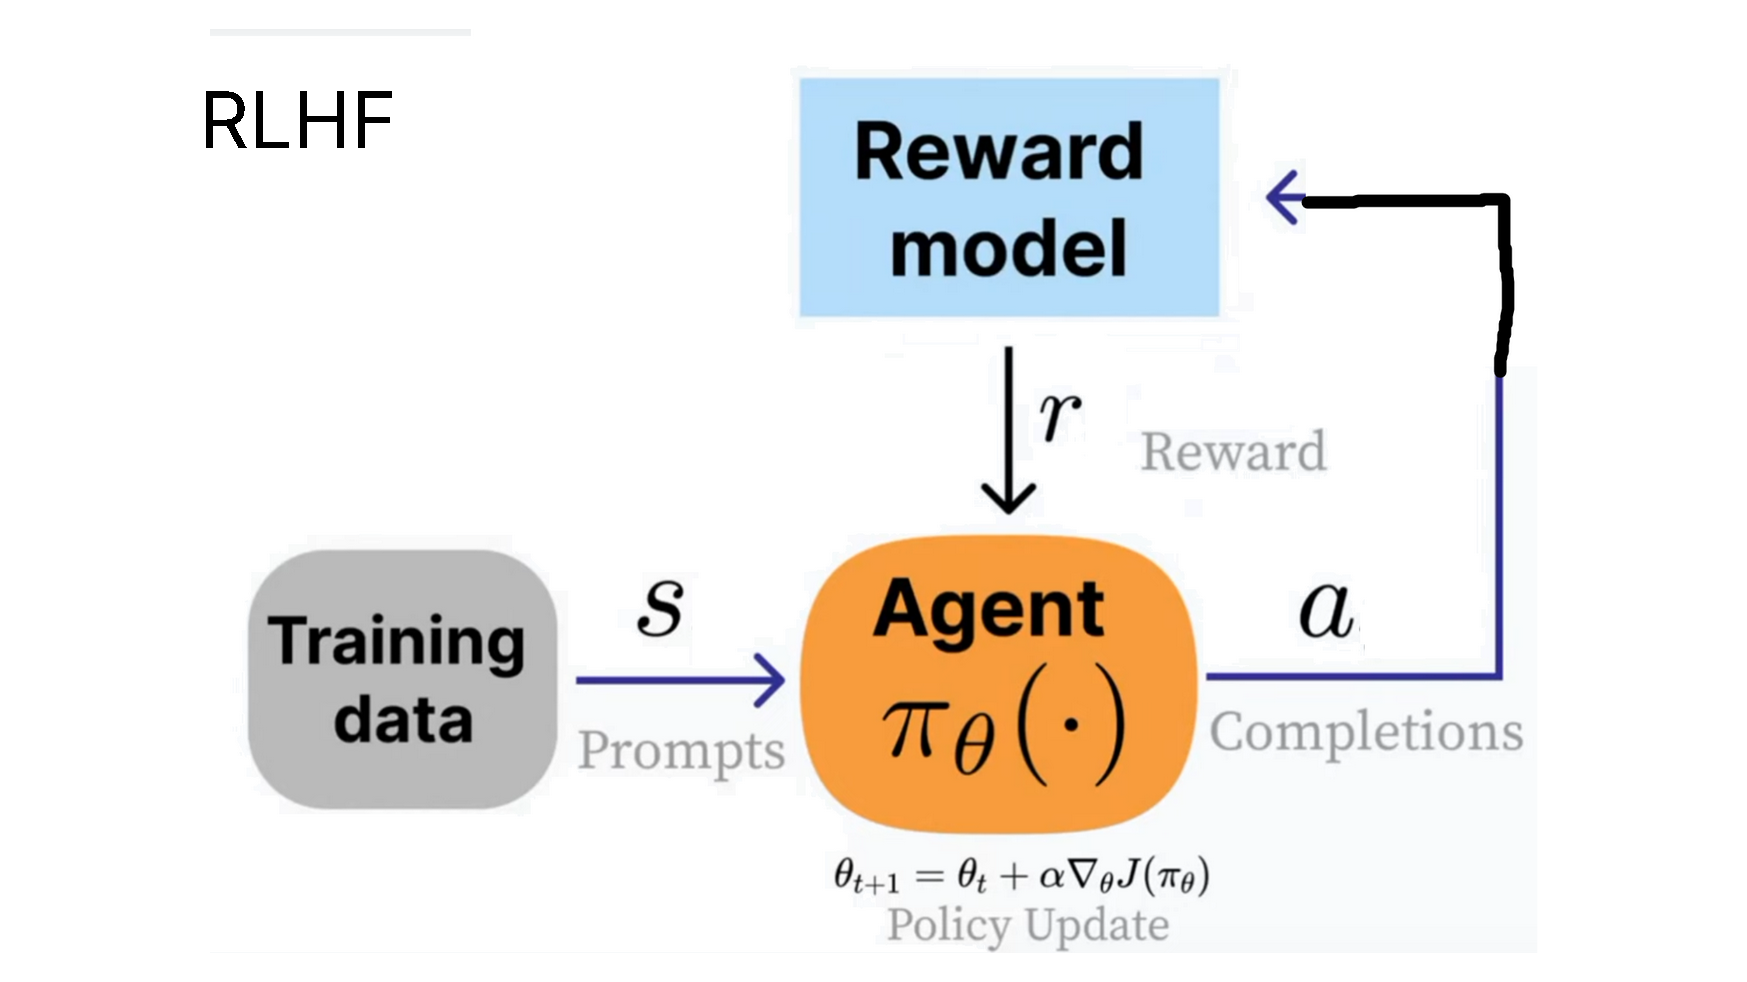
OpenAI は次の概念を広めました。 [RLHF](https://en.wikipedia.org/wiki/Reinforcement_learning_from_human_feedback) (人間フィードバックからの強化学習)では、 **「エージェント」** を学習させて、質問に対する出力( **状態**)のうち、人間によってより有用だと評価されるものを生成させます。
たとえば ChatGPT の高評価・低評価ボタンは、RLHF のプロセスで使えます。
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
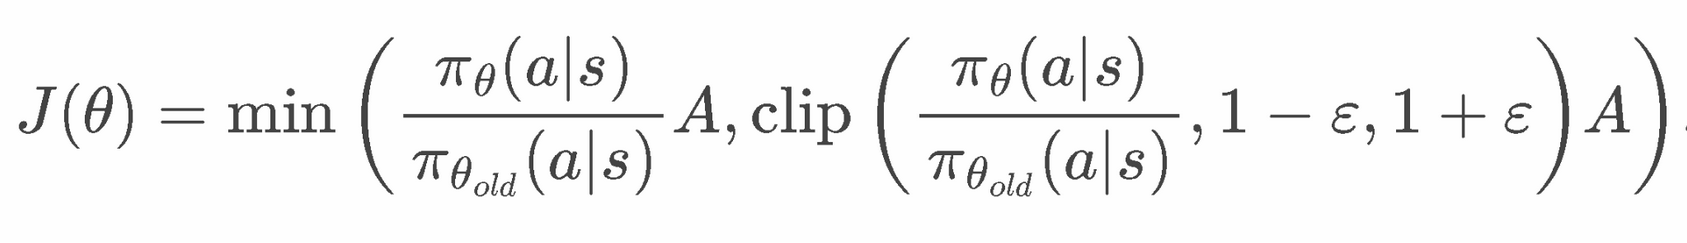
PPO の式
clip(..., 1-e, 1+e) 項は、PPO が大きすぎる変更を取らないようにするために使われます。また、beta を > 0 に設定した KL 項もあり、モデルがあまり逸脱しすぎないようにします。
{% endcolumn %}
{% column %}
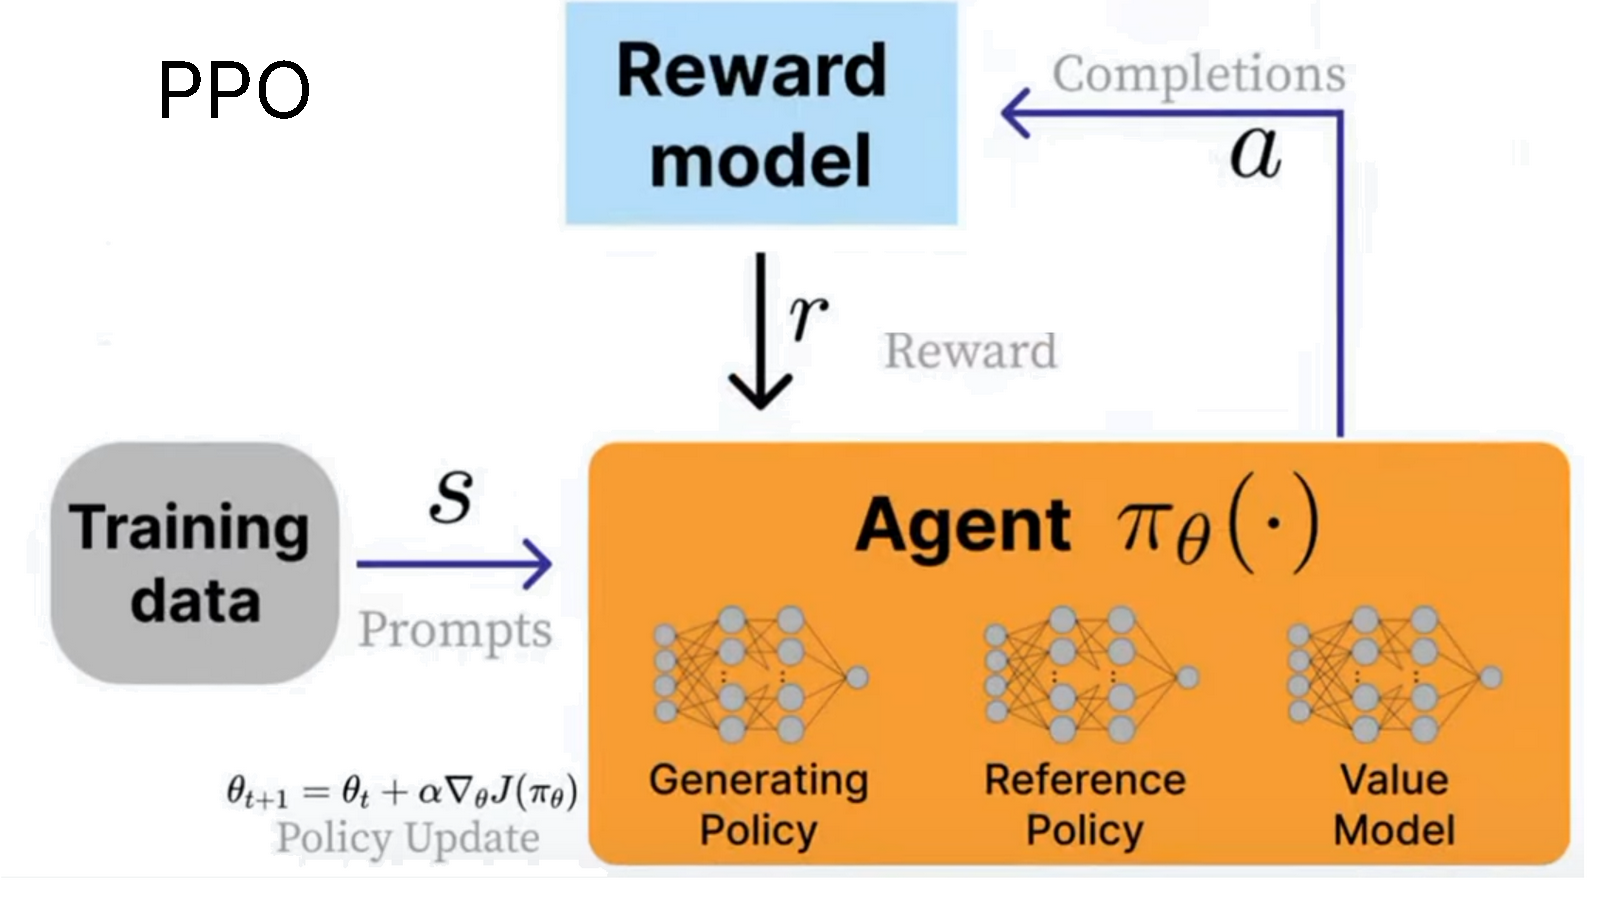
RLHF を行うために、 [**PPO**](https://en.wikipedia.org/wiki/Proximal_policy_optimization) (近接方策最適化)が開発されました。 **エージェント** はこの場合、言語モデルです。実際には 3 つのシステムで構成されています。
1. その **生成方策(現在学習中のモデル)**
2. その **参照方策(元のモデル)**
3. その **価値モデル(平均報酬推定器)**
私たちは **報酬モデル** を使って現在の環境に対する報酬を計算し、私たちの目標は **これを最大化することです**!
PPO の式はかなり複雑に見えますが、それは安定性を重視して設計されているためです。より詳しい PPO の数式導出については、私たちの [AI Engineer トーク](https://docs.unsloth.ai/ai-engineers-2025) をご覧ください。2025年に RL について講演したもので、PPO の数式導出をさらに詳しく解説しています。
{% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
 {% endcolumn %}
{% column %}
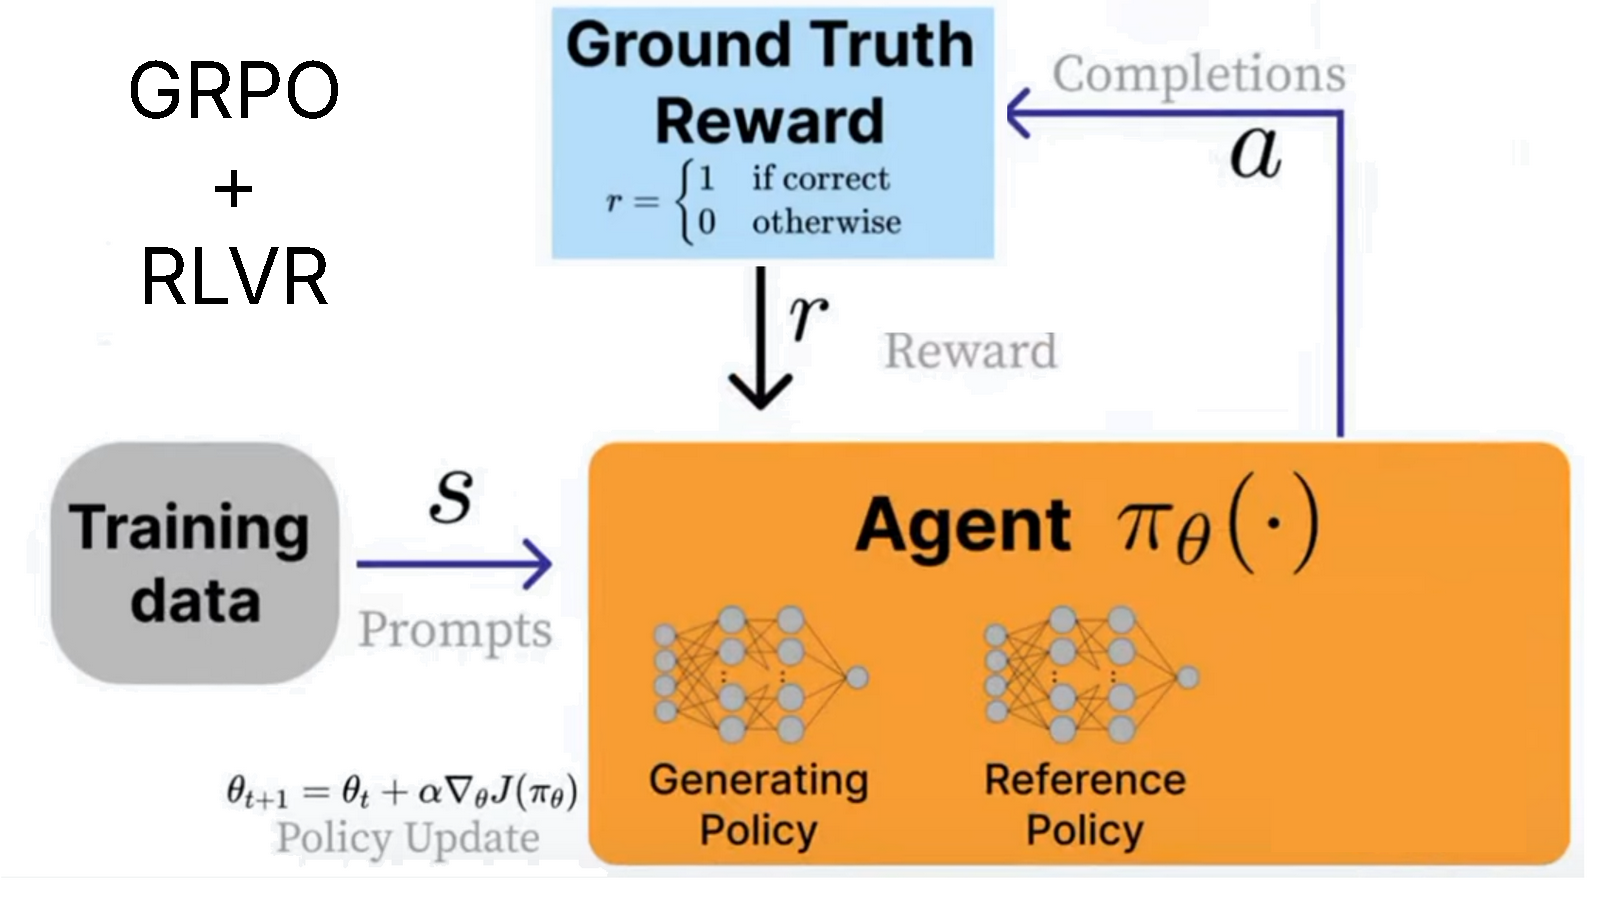
DeepSeekが開発した [**GRPO**](https://unsloth.ai/blog/grpo) (Group Relative Policy Optimization)は R1 の推論モデルを学習させるための手法です。PPO との主な違いは次のとおりです:
1. その **価値モデルが削除され、** 報酬モデルを複数回呼び出した統計に置き換えられます。
2. その **報酬モデルが削除され** 、代わりにカスタム報酬関数だけが使われます。 **RLVR** を使用できます。
{% endcolumn %}
{% endcolumns %}
つまり、GRPO は非常に効率的です。以前の PPO では複数のモデルを学習させる必要がありましたが、今では報酬モデルと価値モデルを削除したことで、メモリを節約し、すべてを高速化できます。
**RLVR(検証可能な報酬による強化学習)** では、解が簡単に検証できるタスクに基づいてモデルへ報酬を与えることができます。たとえば:
1. 数式は簡単に検証できます。例: 2+2 = 4。
2. コードの出力は、正しく実行されたかどうかを検証できます。
3. 検証可能な報酬関数を設計するのは難しいことが多く、そのため例の大半は数学かコードになります。
4. GRPO の用途はコードや数学だけではありません。その推論プロセスは、メール自動化、データベース検索、法律、医療などのタスクを強化でき、データセットと報酬関数に基づく精度を大きく向上させます。コツは、 **ルーブリック、つまり最終的なすべてを飲み込む単一の報酬ではなく、検証可能な小さな報酬のリストを定義することです。** OpenAI はこれを自社の [強化学習によるファインチューニング(RFT)](https://platform.openai.com/docs/guides/reinforcement-fine-tuning) 提供などで広めました。
{% columns %}
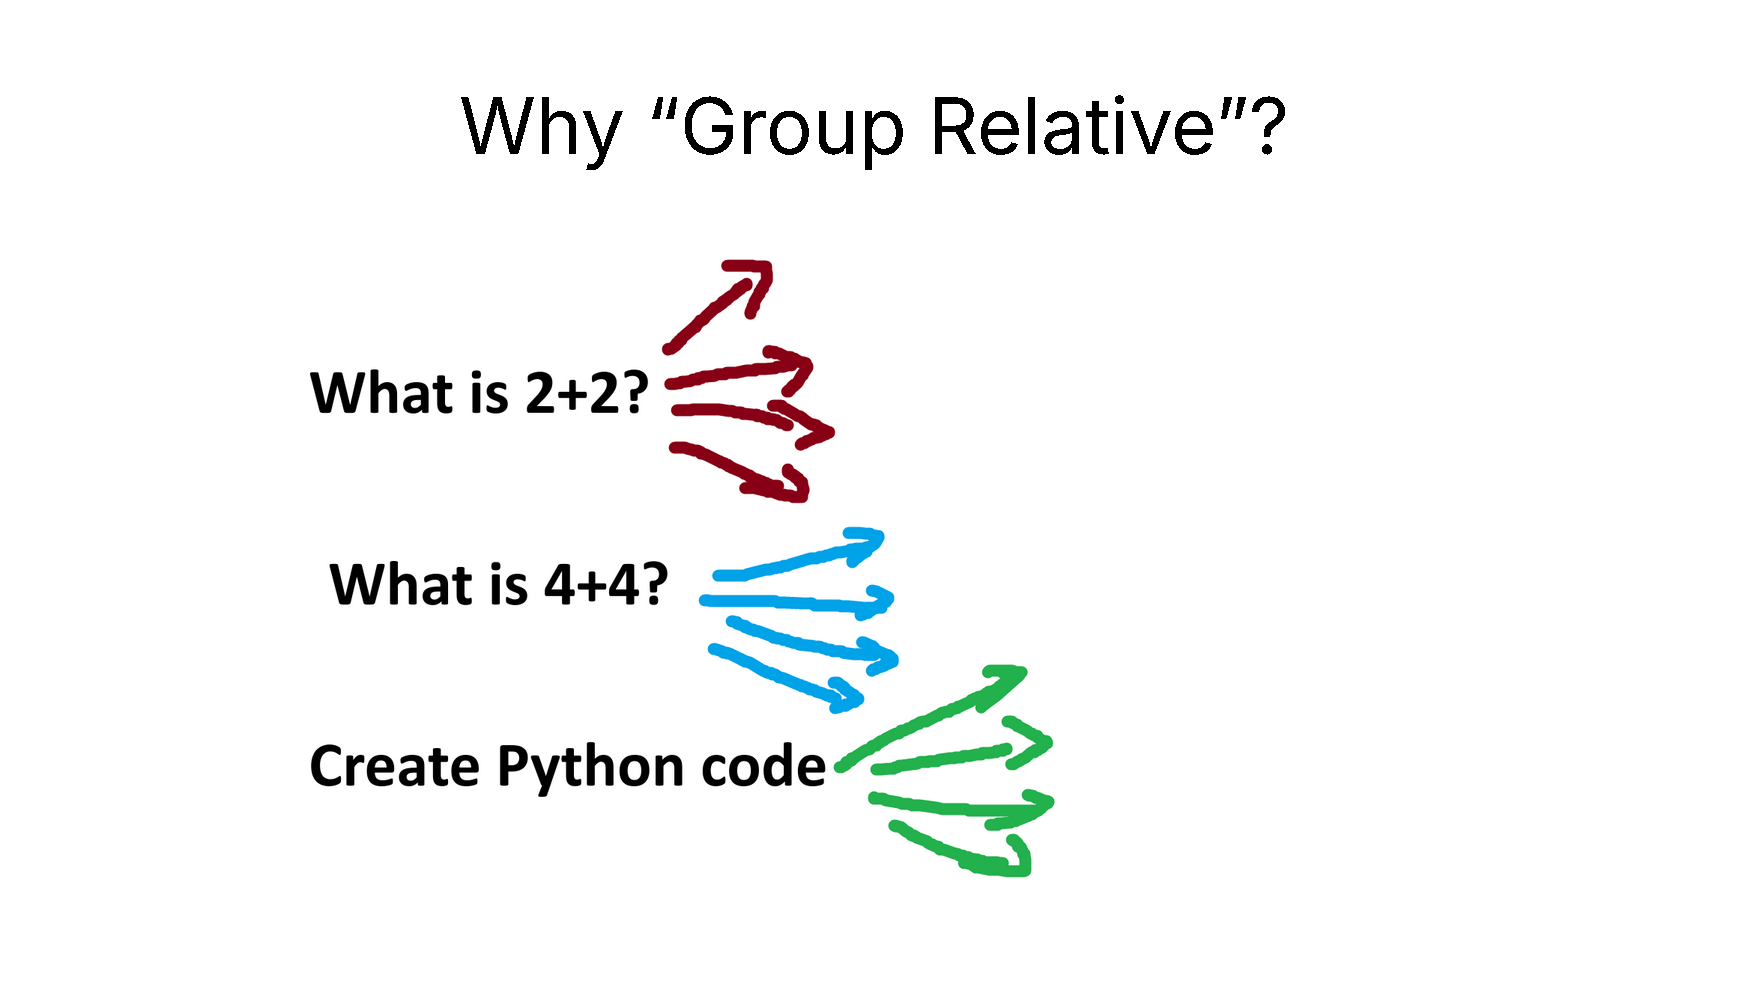
{% column %} **なぜ「Group Relative」なのか?**
GRPO は価値モデルを完全に取り除きますが、それでも現在の状態に対する **「平均報酬」** を推定する必要があります。
その **コツは LLM をサンプリングすること**!その後、複数の異なる質問にわたるサンプリング過程の統計から平均報酬を計算します。
{% endcolumn %}
{% column %}
 {% endcolumn %}
{% endcolumns %}
{% columns %}
{% column %}
たとえば「2+2 は?」では 4 回サンプルします。4、3、D、C が得られるかもしれません。次に、これら各回答の報酬を計算し、 **平均報酬** そして **標準偏差**を求め、さらに **Z スコアで標準化** します!
これによって **アドバンテージ A**が作られ、これを価値モデルの代わりに使います。これで大幅にメモリを節約できます!
{% endcolumn %}
{% column %}
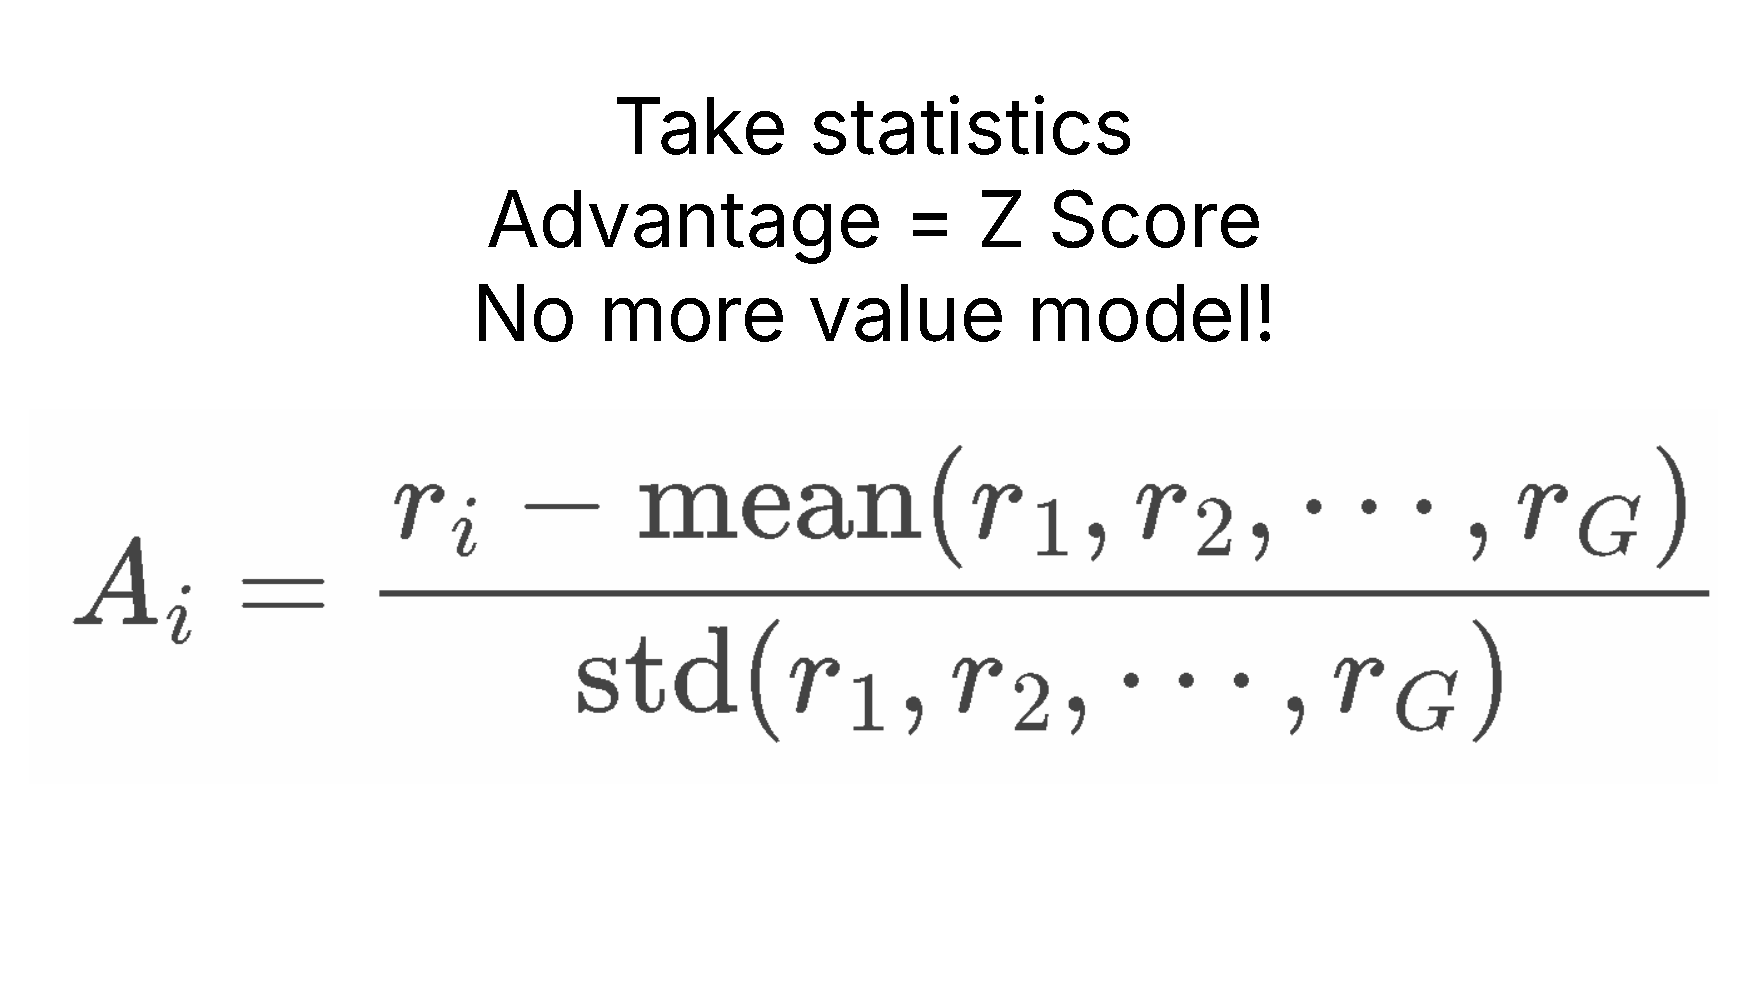
GRPO のアドバンテージ計算
{% endcolumn %}
{% endcolumns %}
### :fingers\_crossed:運(まあ、忍耐)がすべて
RL のコツは、必要なのはたった 2 つだけということです:
1. 質問または指示 例: 「2+2 は?」 「Python で Flappy Bird ゲームを作って」
2. 出力が良いか悪いかを判定するための報酬関数と検証器。
この 2 つだけで、本質的には **言語モデルを無限回呼び出して** 良い答えが出るまで待つことができます。たとえば「2+2 は?」では、学習していないダメな言語モデルは次のように出力します:
***0, cat, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****すると突然 4****.***
***報酬シグナルは 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0\*\*\*\*\*\*\*\* ****すると突然 1。***
こうして、運と偶然によって、RL は複数の **ロールアウト**の中から正解を見つけ出すことができました。私たちの目標は、良い答えである 4 をもっと見せ、残りの(悪い答えを)ずっと少なくすることです。
**つまり RL の目標は忍耐強くあることです。極限では、正解の確率がゼロでない小さな値でもあれば、それは待つゲームにすぎず、最終的には 100% 確実に正解に出会えます。**
**だから私は RL を「運こそすべて」と呼びたくなります。**
**まあ、より良い言い方は RL にとって「忍耐こそすべて」です。**
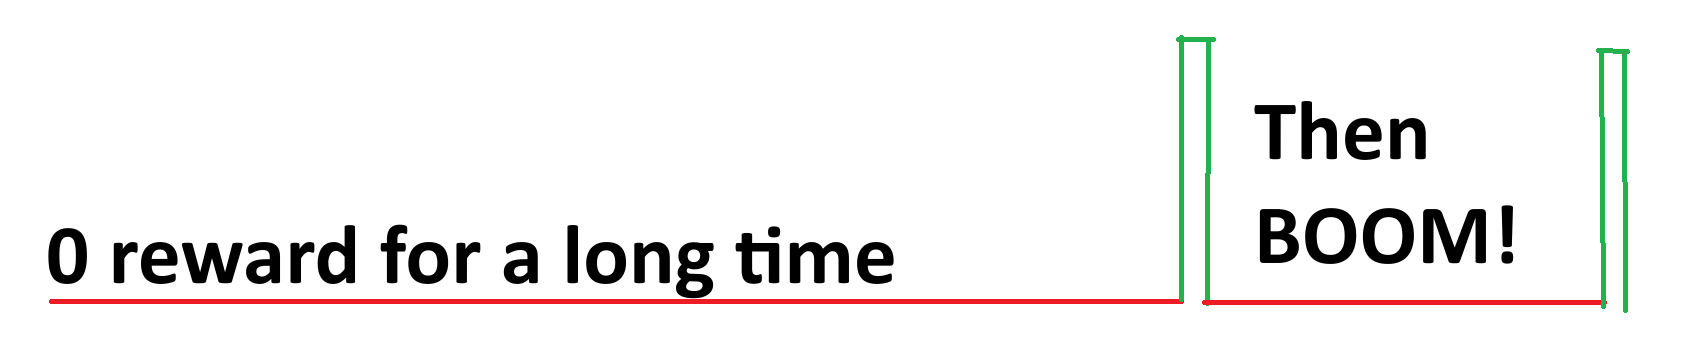 RL は本質的に私たちにコツを与えてくれます。単に無限に待つのではなく、「悪いシグナル」、つまり悪い回答を得ることで、モデルが悪い解を出さないようにすでに試みるよう「導く」ことができます。つまり、良い答えが現れるまで長く待ったとしても、その時点までにモデルは悪い答えを出さないよう最善を尽くす方向に変わっているのです。
「2+2 は?」の例では - ***0, cat, -10, 1928, 3, A, B, 122, 17, 182, 172, A, C, BAHS, %$, #, 9, -192, 12.31\*\*\*\*\*\*\*\* ****すると突然 4****.***
悪い答えが得られたので、RL はモデルに悪い答えを出さないよう促します。つまり、時間が経つにつれて、私たちは慎重にモデルの出力分布を悪い答えから遠ざける、あるいは「剪定」していくことになります。つまり RL は **効率的です**。なぜなら、単に無限に待つのではなく、モデルを可能な限り「正解の空間」へ押し込もうと積極的に働きかけているからです。
{% hint style="danger" %}
**確率が常に 0 なら、RL は決して機能しません**。そのため、すでに instruction fine-tuned 済みのモデルから RL を行うのが好まれます。こうしたモデルは指示にかなりうまく従えるため、確率を 0 よりかなり上に押し上げられるからです。
{% endhint %}
## :sloth:Unsloth が RL に提供するもの
* 15GB の VRAM で、Unsloth は Llama 3.1 (8B)、Phi-4 (14B)、Mistral (7B)、Qwen2.5 (7B) のような最大 17B パラメータまでの任意のモデルを推論モデルに変換できます
* **Unsloth は現在、** [**Vision/マルチモーダル向け RL**](/docs/jp/meru/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md) **モデルをサポートしています!**
* **最低要件:** たった 5GB の VRAM で、1.5B パラメータ以下の任意のモデルを自分のローカル環境で推論モデルとして学習できます
{% columns %}
{% column %}
{% content-ref url="/pages/db5a7a83b913f48723eb2d7a67636b192c105cd3" %}
[Tutorial: GRPO Training](/docs/jp/meru/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md)
{% endcontent-ref %}
{% endcolumn %}
{% column %}
{% content-ref url="/pages/01cdfed2f29f2821ff712fcb0ccb837f8ba4baf3" %}
[Vision RL](/docs/jp/meru/reinforcement-learning-rl-guide/vision-reinforcement-learning-vlm-rl.md)
{% endcontent-ref %}
{% endcolumn %}
{% endcolumns %}
{% hint style="info" %}
以下では **高度なGRPO** バッチ処理、生成、学習パラメータに関するドキュメント、 [ガイドをお読みください!](/docs/jp/meru/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### GRPO ノートブック:
| [**Gemma 4 E2B**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma4_\(E2B\)_Reinforcement_Learning_Sudoku_Game.ipynb) - **新しい** | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - ビジョンGSPO | [Gemma 3(4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - ビジョンGSPO |
| -------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- |
| [**Qwen3.5(4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - *****新しい*** | [gpt-oss-20b](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) GSPO | [Llama 3.2(3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Advanced |
| [Qwen3(4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Advanced | [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb) | [DeepSeek-R1-0528-Qwen3-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) |
| [Mistral v0.3(7B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb) | [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb) | [Qwen3-8B - **FP8**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_8B_FP8_GRPO.ipynb) (L4) |
{% hint style="success" %}
私たちは [**GSPO**](/docs/jp/meru/reinforcement-learning-rl-guide/advanced-rl-documentation/gspo-reinforcement-learning.md) および、その他ほとんどの新しい GRPO 手法をサポートしています。GRPOConfig の次の引数を使って有効化できます:
```python
epsilon=0.2,
epsilon_high=0.28, # 片側
delta=1.5 # 両側
loss_type='gspo',
# または:
loss_type='grpo',
# または:
loss_type='dr_grpo',
mask_truncated_completions=True,
```
{% endhint %}
* 推論が出てこない場合は、十分な学習ステップがあることを確認し、 [報酬関数/検証器](#reward-functions-verifier) が動作していることを確認してください。報酬関数の例も用意しています [ここ](#reward-function-examples).
* 以前のデモでは、Qwen2.5 (3B) で自分だけの「アハ体験」を得るには 2xA100 GPU(160GB VRAM)が必要でした。今では Unsloth を使えば、わずか 5GB VRAM の GPU 1 台で同じ「アハ体験」を実現できます。
* 以前は GRPO はフルファインチューニングでしかサポートされていませんでしたが、QLoRA と LoRA でも動作するようにしました
* オン [**20K のコンテキスト長で**](#grpo-requirement-guidelines) たとえばプロンプトごとに 8 個生成する設定では、Unsloth は Llama 3.1 (8B) に対して VRAM をわずか 54.3GB しか使いませんが、標準実装(+ Flash Attention 2)は **510.8GB(Unsloth は 90% 少ない)**.
* なお、これは DeepSeek の R1 蒸留モデルをファインチューニングすることや、R1 から蒸留されたデータを使ってチューニングすることではありません。Unsloth はすでにそれをサポートしていました。これは、GRPO を使って標準モデルを本格的な推論モデルへ変換するものです。
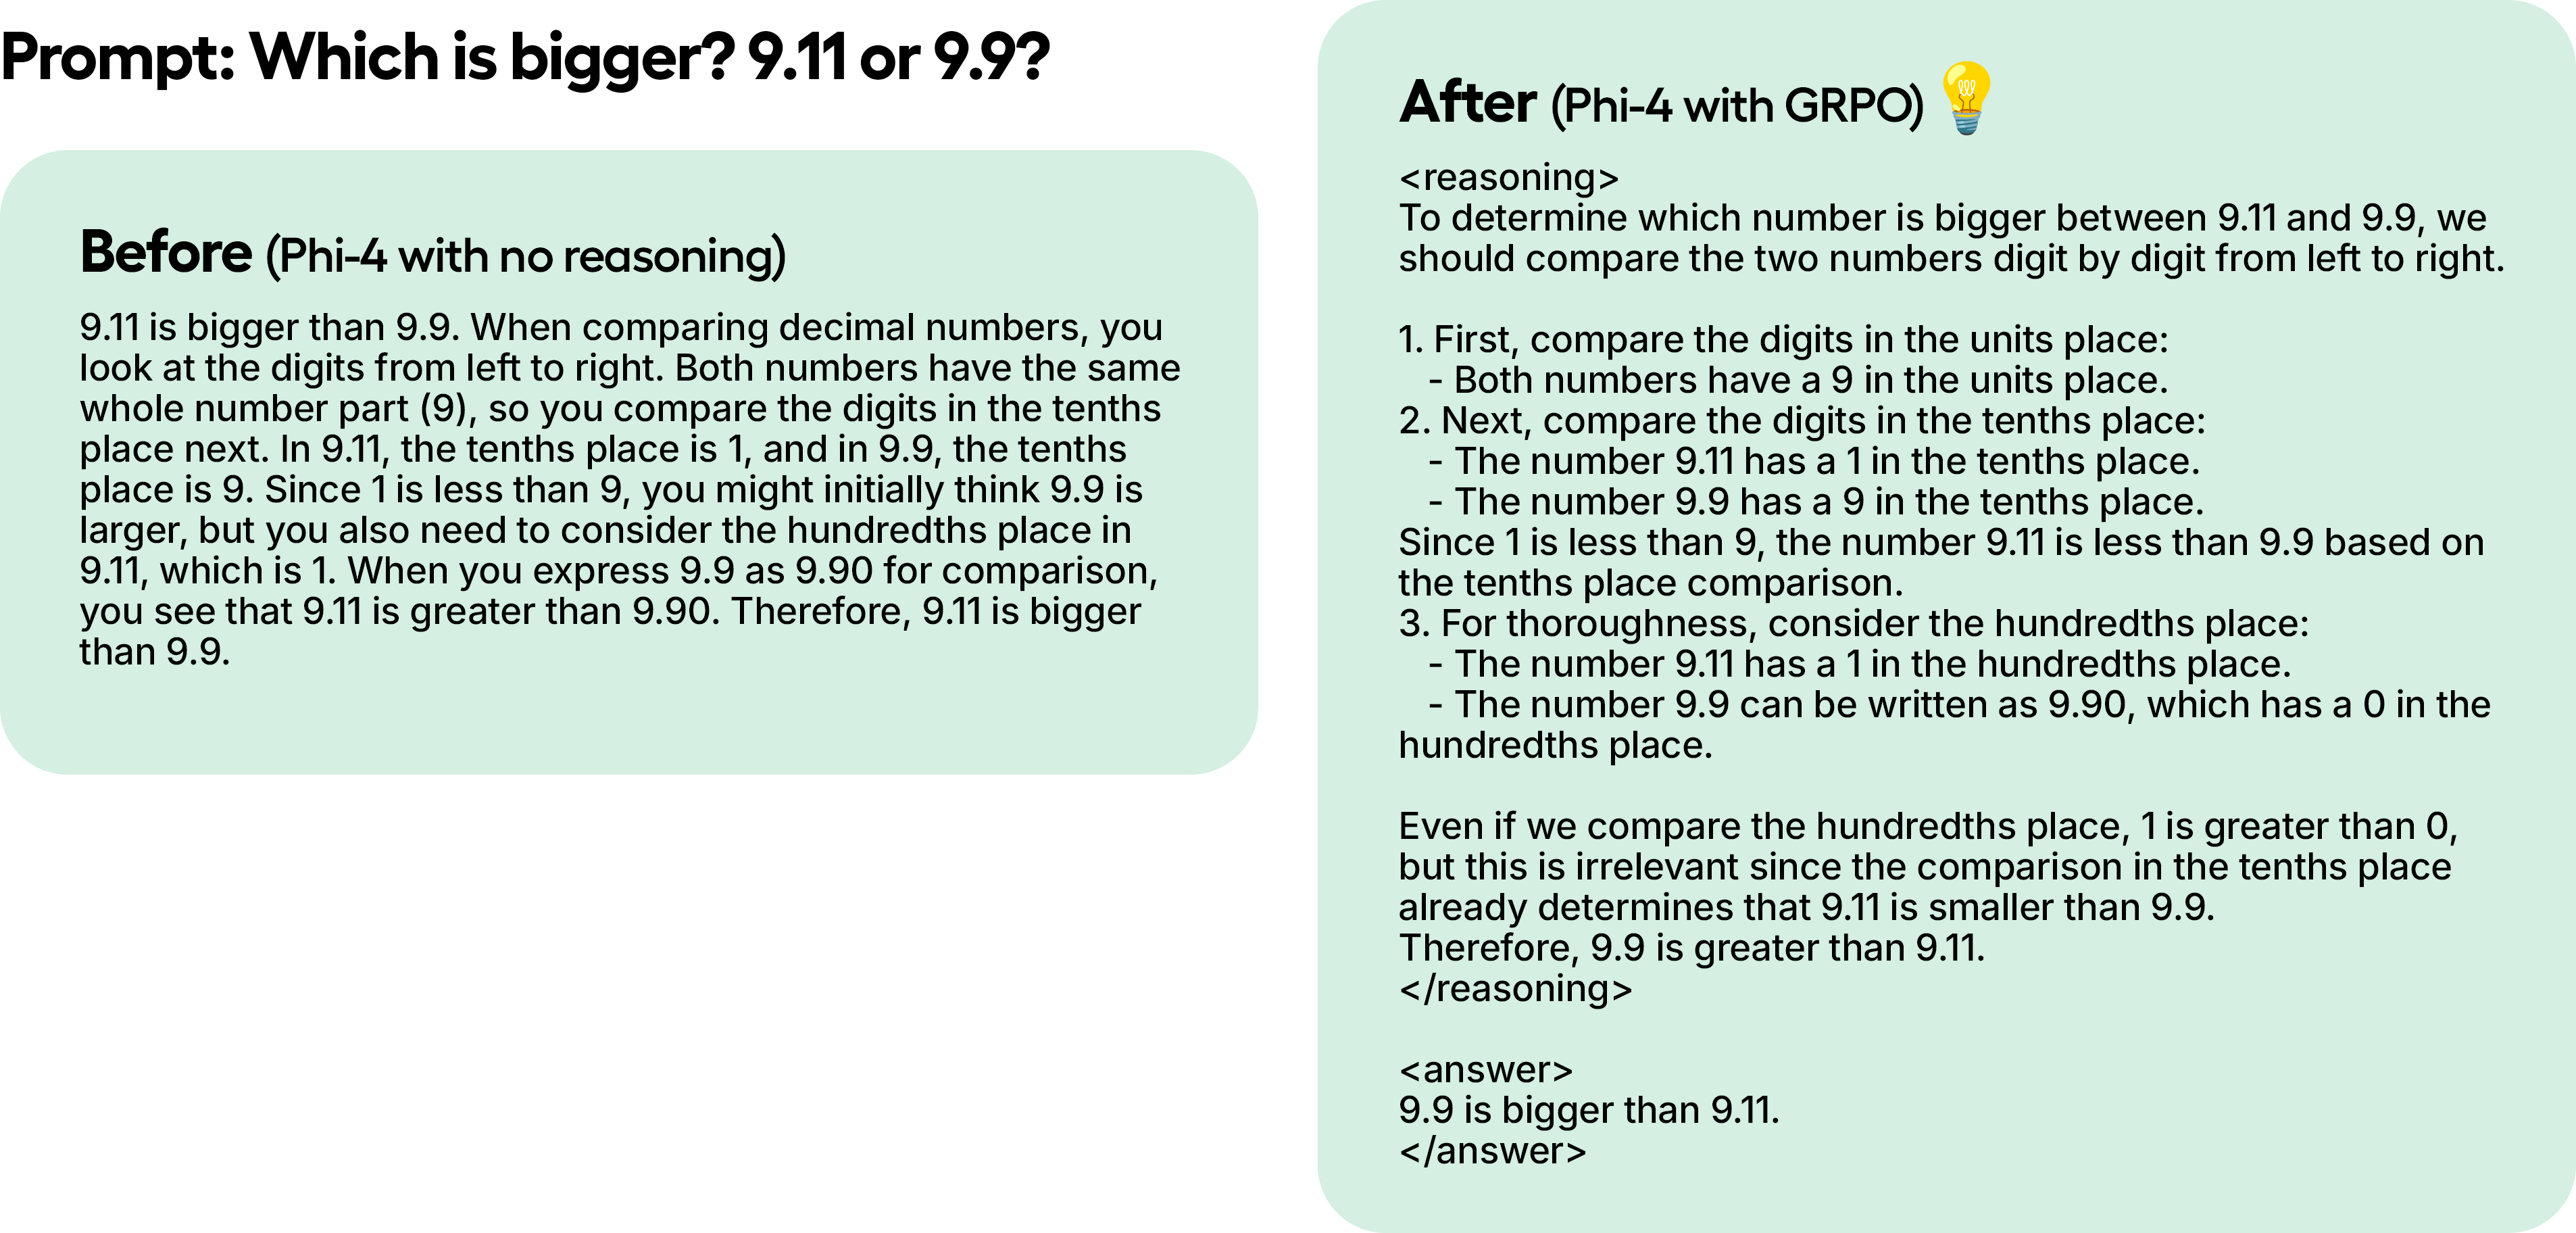
テスト例では、GRPO を使って Phi-4 を 100 ステップしか学習していないにもかかわらず、結果はすでに明確です。GRPO なしのモデルには思考トークンがありませんが、GRPO で学習したモデルにはあり、さらに正解も持っています。
 ## :computer:GRPO による学習
Unsloth と GRPO を使って任意のオープン LLM を推論モデルへ変換するチュートリアルは、 [こちらを参照](/docs/jp/meru/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
{% hint style="success" %}
以下では **高度なGRPO** バッチ処理、生成、学習パラメータに関するドキュメント、 [ガイドをお読みください!](/docs/jp/meru/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
### **GRPO がモデルを学習させる方法**
1. 各質問と回答のペアについて、モデルは複数の可能な応答(例: 8 通り)を生成します。
2. 各応答は報酬関数で評価されます。
3. 学習ステップ:
* データが 300 行あれば、それは 300 の学習ステップです(3 エポックなら 900 ステップ)。
* 質問ごとの生成応答数を増やすこともできます(例: 8 から 16 へ)。
4. モデルは各ステップで重みを更新することで学習します。
{% hint style="warning" %}
GRPOモデルが学習しない問題がある場合は、ぜひ次を使うことを強くおすすめします: [高度なGRPOノートブック](/docs/jp/meru/unsloth-notebooks.md#grpo-reasoning-notebooks) より優れた報酬関数があるため、結果がより速く、より頻繁に得られるはずです。
{% endhint %}
### 基本/ヒント
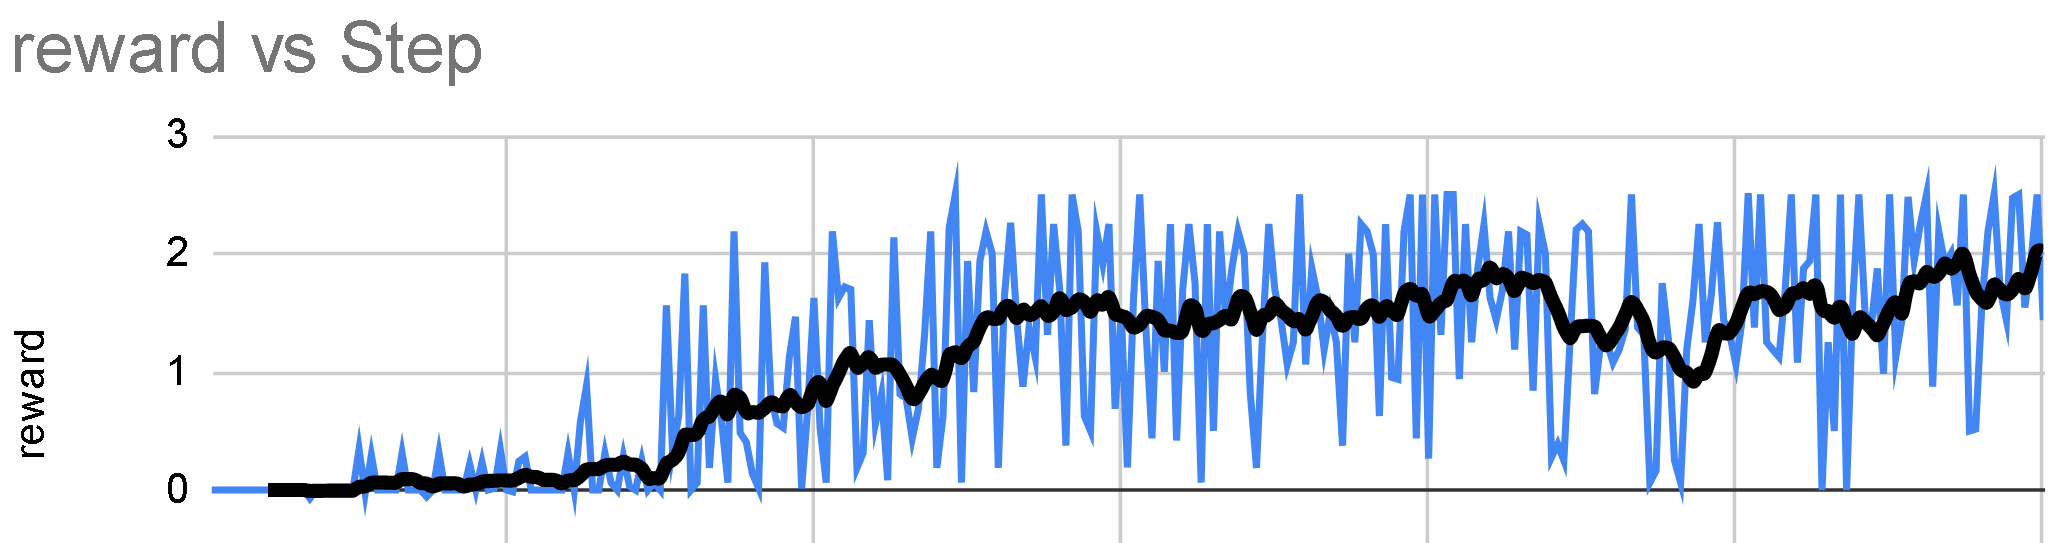
* 少なくとも **300 ステップ** は、報酬が実際に増えるまで待ってください。十分な結果を得るには、最低 12 時間ほど回す必要があるかもしれません(これが GRPO の仕組みです)が、いつでも停止できるので必須ではないことを覚えておいてください。
* 最適な結果のためには少なくとも **500 行のデータ**が必要です。10 行でも試せますが、より多いほうが良いです。
* 各学習実行は、モデル、データ、報酬関数/検証器などに応じて常に異なります。そのため、300 ステップを最小値として書いていますが、時には 1000 ステップ以上になることもあります。つまり、さまざまな要因によります。
* Unsloth をローカルで使って GRPO を行う場合、エラーが出たら "pip install diffusers" も実行してください。vLLM も最新バージョンを使ってください。
* GRPO を適用するなら、少なくとも **1.5B パラメータ** 以上のモデルにすることをおすすめします。そうしないと、思考トークンを正しく生成できないことがあります。
* GRPO の [**GPU VRAM 要件**](#grpo-requirement-guidelines) **QLoRA 4-bit では**、一般的な目安としてモデルのパラメータ数 = 必要な VRAM 容量です(より少ない VRAM でも使えますが、これは安全側に見た目安です)。設定するコンテキスト長が長いほど、必要な VRAM は増えます。LoRA 16-bit では少なくとも 4 倍多くの VRAM を使います。
* **継続的なファインチューニングは** 可能で、GRPO をバックグラウンドでそのまま動かしておけます。
* 例のノートブックでは、 [**GSM8K データセット**](#gsm8k-reward-functions)を使っています。これは現在、R1 スタイル学習で最も人気のある選択肢です。
* ベースモデルを使う場合は、チャットテンプレートがあることを確認してください。
* GRPO で学習すればするほど良くなります。GRPO の最も良い点は、そこまで大量のデータが不要なことです。必要なのは優れた報酬関数/検証器だけで、学習に時間をかけるほどモデルは良くなります。報酬とステップの推移は、時間とともに次のように増えていくはずです:
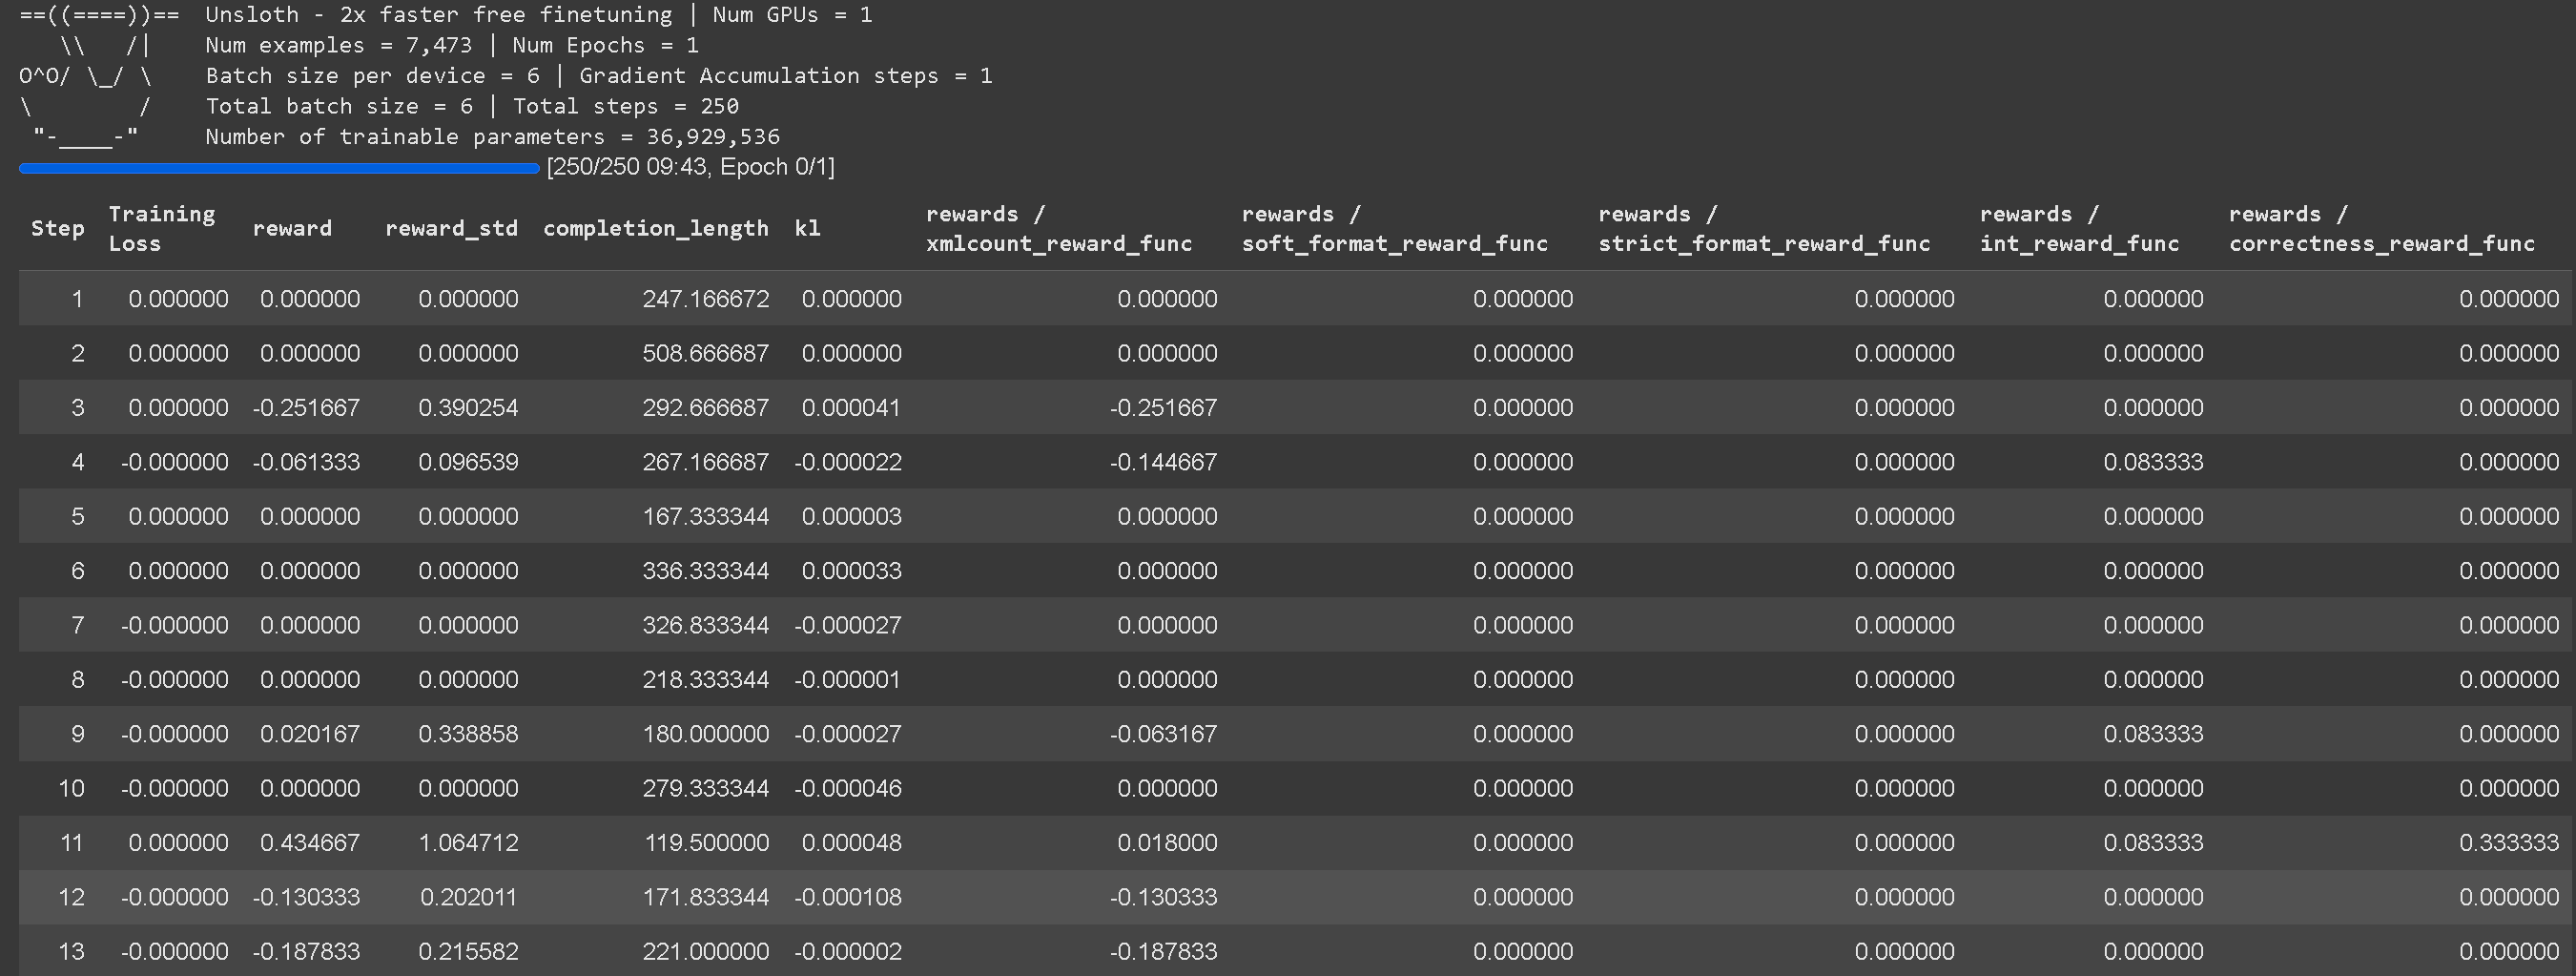
 * GRPO の学習損失の追跡が Unsloth に直接組み込まれ、wandb などの外部ツールが不要になりました。今では、合計で集約された報酬関数自体を含め、すべての報酬関数の完全なログが記録されます。
 ### 未対応モデルでの RL:
vLLM でサポートされていないモデルでも、Unsloth を使って RL を実行できます。例えば [Qwen3.5](/docs/jp/moderu/qwen3.5/fine-tune.md)などです。単に `fast_inference=False` をモデル読み込み時に設定してください。
```python
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Qwen3.5-4B",
fast_inference=False,
)
```
## :clipboard:報酬関数 / 検証器
強化学習では **報酬関数** と **検証器** は、モデルの出力を評価するうえで異なる役割を果たします。一般的には同じものとして解釈しても構いませんが、技術的には同一ではありません。ただし、通常は一緒に使うため、それほど問題にはなりません。
**検証器**:
* 生成された応答が正しいか間違っているかを判定します。
* 数値スコアは付けず、正しさを検証するだけです。
* 例: モデルが "2+2" に対して "5" を生成した場合、検証器はそれを確認し、"間違い" とラベル付けします(正解は 4 だからです)。
* 検証器は、手動評価なしでロジック、構文、正しさを検証するためにコード(例: Python)を実行することもできます。
**報酬関数**:
* 検証結果(またはその他の基準)を数値スコアに変換します。
* 例: 答えが間違っていればペナルティ(-1、-2 など)を与え、正解なら正のスコア(+1、+2)を与えることがあります。
* また、正しさ以外の基準、たとえば長すぎる、読みにくい、といった点にもペナルティを与えられます。
**主な違い**:
* ある **検証器** 正しさを確認するが、採点はしない。
* ある **報酬関数** スコアは付けるが、自身で正しさを必ずしも検証するわけではない。
* 報酬関数 *できます* は検証器を使うことがありますが、技術的には同じではありません。
### **報酬関数の理解**
GRPO の主な目的は、単に学習データからの応答を記憶して再現するのではなく、報酬を最大化し、答えがどのように導かれたかを学ぶことです。
* 各学習ステップごとに、GRPO は **モデルの重みを調整して** 報酬を最大化します。このプロセスによって、モデルは段階的にファインチューニングされます。
* **通常のファインチューニング** (GRPO なし)では **次の単語予測の確率を最大化するだけ** で、報酬の最適化は行いません。GRPO は **報酬関数を最適化し** 、単に次の単語を予測するだけではありません。
* 次のことができます: **データを再利用し** 、複数のエポックにわたって使えます。
* **デフォルトの報酬関数は** 多くの用途に対してあらかじめ定義しておけますし、ChatGPT やローカルモデルに生成させることもできます。
* 報酬関数や検証器の設計に唯一の正解はありません。可能性は無限ですが、設計は適切かつ意味のあるものでなければなりません。雑に作られた報酬は、意図せずモデル性能を低下させることがあります。
### :coin:報酬関数の例
以下の例を参照できます。生成結果を ChatGPT 4o や Llama 3.1 (8B) のような LLM に入力し、それを評価する報酬関数と検証器を設計できます。たとえば、生成結果を任意の LLM に与え、「答えが機械的すぎるなら 3 点減点する」というルールを設定します。これにより、品質基準に基づいて出力を改善できます
#### **例 #1: 単純な算術タスク**
* **質問:** `"2 + 2"`
* **回答:** `"4"`
* **報酬関数 1:**
* 数値が検出された場合 → **+1**
* 数値が検出されなかった場合 → **-1**
* **報酬関数 2:**
* 数値が正解と一致した場合 → **+3**
* 不正解の場合 → **-3**
* **総報酬:** *すべての報酬関数の合計*
#### **例 #2: メール自動化タスク**
* **質問:** 受信メール
* **回答:** 送信メール
* **報酬関数:**
* 答えに必須キーワードが含まれている場合 → **+1**
* 答えが理想的な応答と完全に一致する場合 → **+1**
* 応答が長すぎる場合 → **-1**
* 受信者の名前が含まれている場合 → **+1**
* 署名ブロック(電話番号、メール、住所)が含まれている場合 → **+1**
### Unsloth の近接ベース報酬関数
私たちの [**高度な GRPO Colab ノートブック**](#grpo-notebooks)を見たなら、 **カスタムの近接ベース報酬関数** をゼロから完全に作成していることが分かるはずです。これは、正解により近い答えに報酬を与えるよう設計されています。この柔軟な関数は、幅広いタスクに適用できます。
* 例では、Qwen3(ベース)で推論を有効にし、特定のタスクへ誘導しています
* GRPO のデフォルトの傾向である単なる書式の学習を避けるため、事前ファインチューニング戦略を適用する
* 正規表現ベースのマッチングで評価精度を向上させる
* 次のような一般的なプロンプトを超えて、カスタムの GRPO テンプレートを作成する `think`、たとえば ``
* 近接ベースのスコアリングを適用する — モデルは、より近い答えほど多くの報酬を得ます(例: 10 ではなく 9 を予測するほうが 3 より良い)一方、外れ値にはペナルティが与えられます
#### GSM8K 報酬関数
他の例では、 [@willccbb](https://x.com/willccbb) による既存の GSM8K 報酬関数を使っています。これは人気があり、かなり有効であることが示されています:
* **correctness\_reward\_func** – ラベルの完全一致に報酬を与えます。
* **int\_reward\_func** – 整数のみの回答を促します。
* **soft\_format\_reward\_func** – 構造は確認しますが、改行の多少の不一致は許容します。
* **strict\_format\_reward\_func** – 改行を含め、応答構造がプロンプトと一致することを保証します。
* **xmlcount\_reward\_func** – 応答内の各 XML タグがちょうど 1 つずつであることを保証します。
## :abacus:vLLM を使用すると
これから使えます [vLLM](https://github.com/vllm-project/vllm/) ファインチューニングのスタックに直接組み込めるため、スループットが大幅に向上し、同時にモデルのファインチューニングと推論ができます!1x A100 40GB では、Unsloth の Llama 3.2 3B Instruct の動的 4bit 量子化で、およそ 4000 tokens/s を期待できます。16GB Tesla T4(無料 Colab GPU)でも 300 tokens/s ほど出せます。\
\
さらに、vLLM と Unsloth を一緒に読み込む際の二重メモリ使用量も魔法のように解消し、Llama 3.1 8B では約 5GB、Llama 3.2 3B では 3GB の節約が可能になりました。Unsloth は当初、Llama 3.3 70B Instruct を 1x 48GB GPU でファインチューニングできましたが、その際 Llama 3.3 70B の重みだけで 40GB の VRAM を使っていました。二重メモリ使用量を解消しない場合、Unsloth と vLLM を同時に読み込むには 80GB 以上の VRAM が必要になります。\
\
しかし Unsloth なら、48GB 未満の VRAM でも、ファインチューニングと高速推論の両方の利点を 1 つのパッケージで得られます!高速推論を使うには、まず vllm をインストールし、fast\_inference を指定して Unsloth を初期化します:
```python
# pip install unsloth vllm
from unsloth import FastLanguageModel
model, tokenizer = FastLanguageModel.from_pretrained(
model_name = "unsloth/Llama-3.2-3B-Instruct",
fast_inference = True,
)
```
## :white\_check\_mark:GRPO 要件ガイドライン
Unsloth で GRPO を行う場合、複数の工夫により、Flash Attention 2 を使う標準実装と比べて VRAM 使用量を 90% 超削減できます!たとえば 20K コンテキスト長で、プロンプトごとに 8 生成する場合、Unsloth が使うのはわずか **Llama 3.1 8B の VRAM 54.3GB**である一方、標準実装では **510.8GB(Unsloth は 90% 少ない)**.
1. GRPO の **QLoRA 4-bit の GPU VRAM 要件**、一般的な目安としてモデルのパラメータ数 = 必要な VRAM 容量です(より少ない VRAM でも使えますが、これは安全側に見た目安です)。設定するコンテキスト長が長いほど、必要な VRAM は増えます。LoRA 16-bit では少なくとも 4 倍多くの VRAM を使います。
2. GRPO 向けの新しいメモリ効率の高い線形カーネルにより、メモリ使用量を 8 倍以上削減できます。torch.compile の助けもあり、実際には高速化しながら 68.5GB のメモリを削減します!
3. 私たちは賢い [Unsloth の勾配チェックポイント](https://unsloth.ai/blog/long-context) アルゴリズムを活用しています。これは少し前にリリースしたもので、中間アクティベーションを非同期でシステム RAM にオフロードしつつ、速度低下はわずか 1% です。これで 52GB のメモリを削減できます。
4. また Unsloth は、他のパッケージの実装とは異なり、基盤となる推論エンジン(vLLM)と同じ GPU / CUDA メモリ空間を使用します。これで 16GB のメモリを削減できます。
| 指標 | Unsloth | 標準 + FA2 |
| ---------------------------- | ---------------- | -------- |
| 学習時メモリコスト(GB) | 42GB | 414GB |
| GRPO メモリコスト(GB) | 9.8GB | 78.3GB |
| 推論コスト(GB) | 0GB | 16GB |
| 20K コンテキスト長向け推論 KV キャッシュ(GB) | 2.5GB | 2.5GB |
| 合計メモリ使用量 | 54.33GB(90% 少ない) | 510.8GB |
通常の標準的な GRPO 実装では、GRPO 損失を計算するためにサイズ (8. 20K) の logits を 2 つ作成する必要があります。これは 2 \* 2 bytes \* 8(生成数)\* 20K(コンテキスト長)\* 128256(語彙サイズ)= VRAM 78.3GB になります。
Unsloth は長文コンテキストの GRPO でメモリ使用量を 8 倍削減するので、20K コンテキスト長でも追加の VRAM はわずか 9.8GB で済みます!
また、KV キャッシュも 16bit で扱う必要があります。Llama 3.1 8B には 32 層あり、K と V はどちらもサイズ 1024 です。したがって、20K コンテキスト長でのメモリ使用量は 2 \* 2 bytes \* 32 layers \* 20K context length \* 1024 = バッチごとに 2.5GB です。VRAM を節約するため、vLLM のバッチサイズは 8 に設定しますが、ここでは計算のため 1 のままにしておきます。そうしないと、KV キャッシュに 20GB 必要になります。
## 🎥 Unsloth RL 3時間ワークショップ動画
{% embed url="" %}
## :mortar\_board:さらに読む
1. Nathan Lambert の RLHF 本は必読です!
2. Yannic Kilcher の GRPO YouTube 動画も必見です!
3. AI Engineer World's Fair 2025 で 3 時間のワークショップを行いました。スライドやその他の資料は以下にあります
4. Unsloth 経由の高度な GRPO ノートブック。
5. ベースモデルからの GRPO ノートブック:
## 動画チュートリアル
私たちが素晴らしいと思う、すごいYouTuberたちが作成した動画チュートリアルをご紹介します!
{% embed url="" %}
{% columns %}
{% column width="50%" %}
{% embed url="" %}
データセットの準備方法や、強化学習+GRPOの基礎の背景説明を学ぶのに最適です
{% endembed %}
{% embed url="" %}
{% endcolumn %}
{% column width="50%" %}
{% embed url="" %}
{% embed url="" %}
自分のデバイスでローカルGRPO
{% endembed %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/meru/reinforcement-learning-rl-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.