> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md).
# データセットガイド
ファインチューニング用データセットの作成と準備方法を学びましょう。
## データセットとは何ですか?
LLMにとって、データセットはモデルの学習に使えるデータの集合です。学習に役立てるには、テキストデータはトークン化できる形式である必要があります。さらに、 [Unsloth内でデータセットを使う方法](#applying-chat-templates-with-unsloth).
データセットを作成するうえで重要な要素の一つは、あなたの [チャットテンプレート](/docs/jp/ji-chu/chat-templates.md) そして、それをどのように設計するかです。トークン化も重要です。これはテキストをトークンに分割し、それは単語・サブワード・文字などになり得るため、LLMが効率的に処理できるようになります。これらのトークンはその後埋め込みに変換され、モデルが意味と文脈を理解するのを助けるよう調整されます。
### データ形式
トークン化のプロセスを可能にするため、データセットはトークナイザーで読み取れる形式である必要があります。
形式 説明 学習タイプ 生のコーパス Webサイト、本、記事などのソースからの生テキスト。 継続事前学習(CPT) インストラクト モデルが従うべき指示と、目指す出力の例。 教師ありファインチューニング(SFT) 会話 ユーザーとAIアシスタントの間の複数ターンの会話。 教師ありファインチューニング(SFT) RLHF ユーザーとAIアシスタントの会話で、アシスタントの応答がスクリプト、別のモデル、または人間の評価者によってランク付けされるもの。 強化学習(RL)
{% hint style="info" %}
これらの種類ごとに、さまざまな形式のスタイルが存在することに留意してください。
{% endhint %}
## はじめに
データの形式を整える前に、以下を特定したいです:
{% stepper %}
{% step %} データセットの目的
データセットの目的を知ることで、必要なデータと使用する形式を判断しやすくなります。
目的は、要約のような新しいタスクにモデルを適応させることや、特定のキャラクターになりきる能力を向上させることかもしれません。例えば:
* チャットベースの対話(Q\&A、新しい言語の学習、カスタマーサポート、会話)。
* 構造化タスク([分類](https://colab.research.google.com/github/timothelaborie/text_classification_scripts/blob/main/unsloth_classification.ipynb)、要約、生成タスク)。
* ドメイン固有データ(医療、金融、技術)。
{% endstep %}
{% step %} 出力のスタイル
出力のスタイルによって、望む出力を得るためにどのようなデータソースを使うべきかがわかります。
例えば、実現したい出力の種類はJSON、HTML、テキスト、コードなどです。または、スペイン語、英語、ドイツ語などにしたいかもしれません。
{% endstep %}
{% step %} データソース
必要なデータの目的とスタイルがわかったら、データの品質と [量](#how-big-should-my-dataset-be) を分析する必要があります。Hugging FaceやWikipediaはデータセットの優れたソースであり、特に言語を学習させるモデルを訓練したい場合はWikipediaが有用です。
データソースはCSVファイル、PDF、あるいはWebサイトでもかまいません。また、 [合成生成する](#synthetic-data-generation) こともできますが、各例が高品質で関連性があることを確実にするために、細心の注意が必要です。
{% endstep %}
{% endstepper %}
{% hint style="success" %}
より良いデータセットを作る最良の方法の一つは、ShareGPTのようなHugging Faceのより汎用的なデータセットと組み合わせて、モデルをより賢く多様にすることです。さらに [合成生成されたデータ](#synthetic-data-generation).
{% endhint %}
## 🦥 Unsloth データレシピ
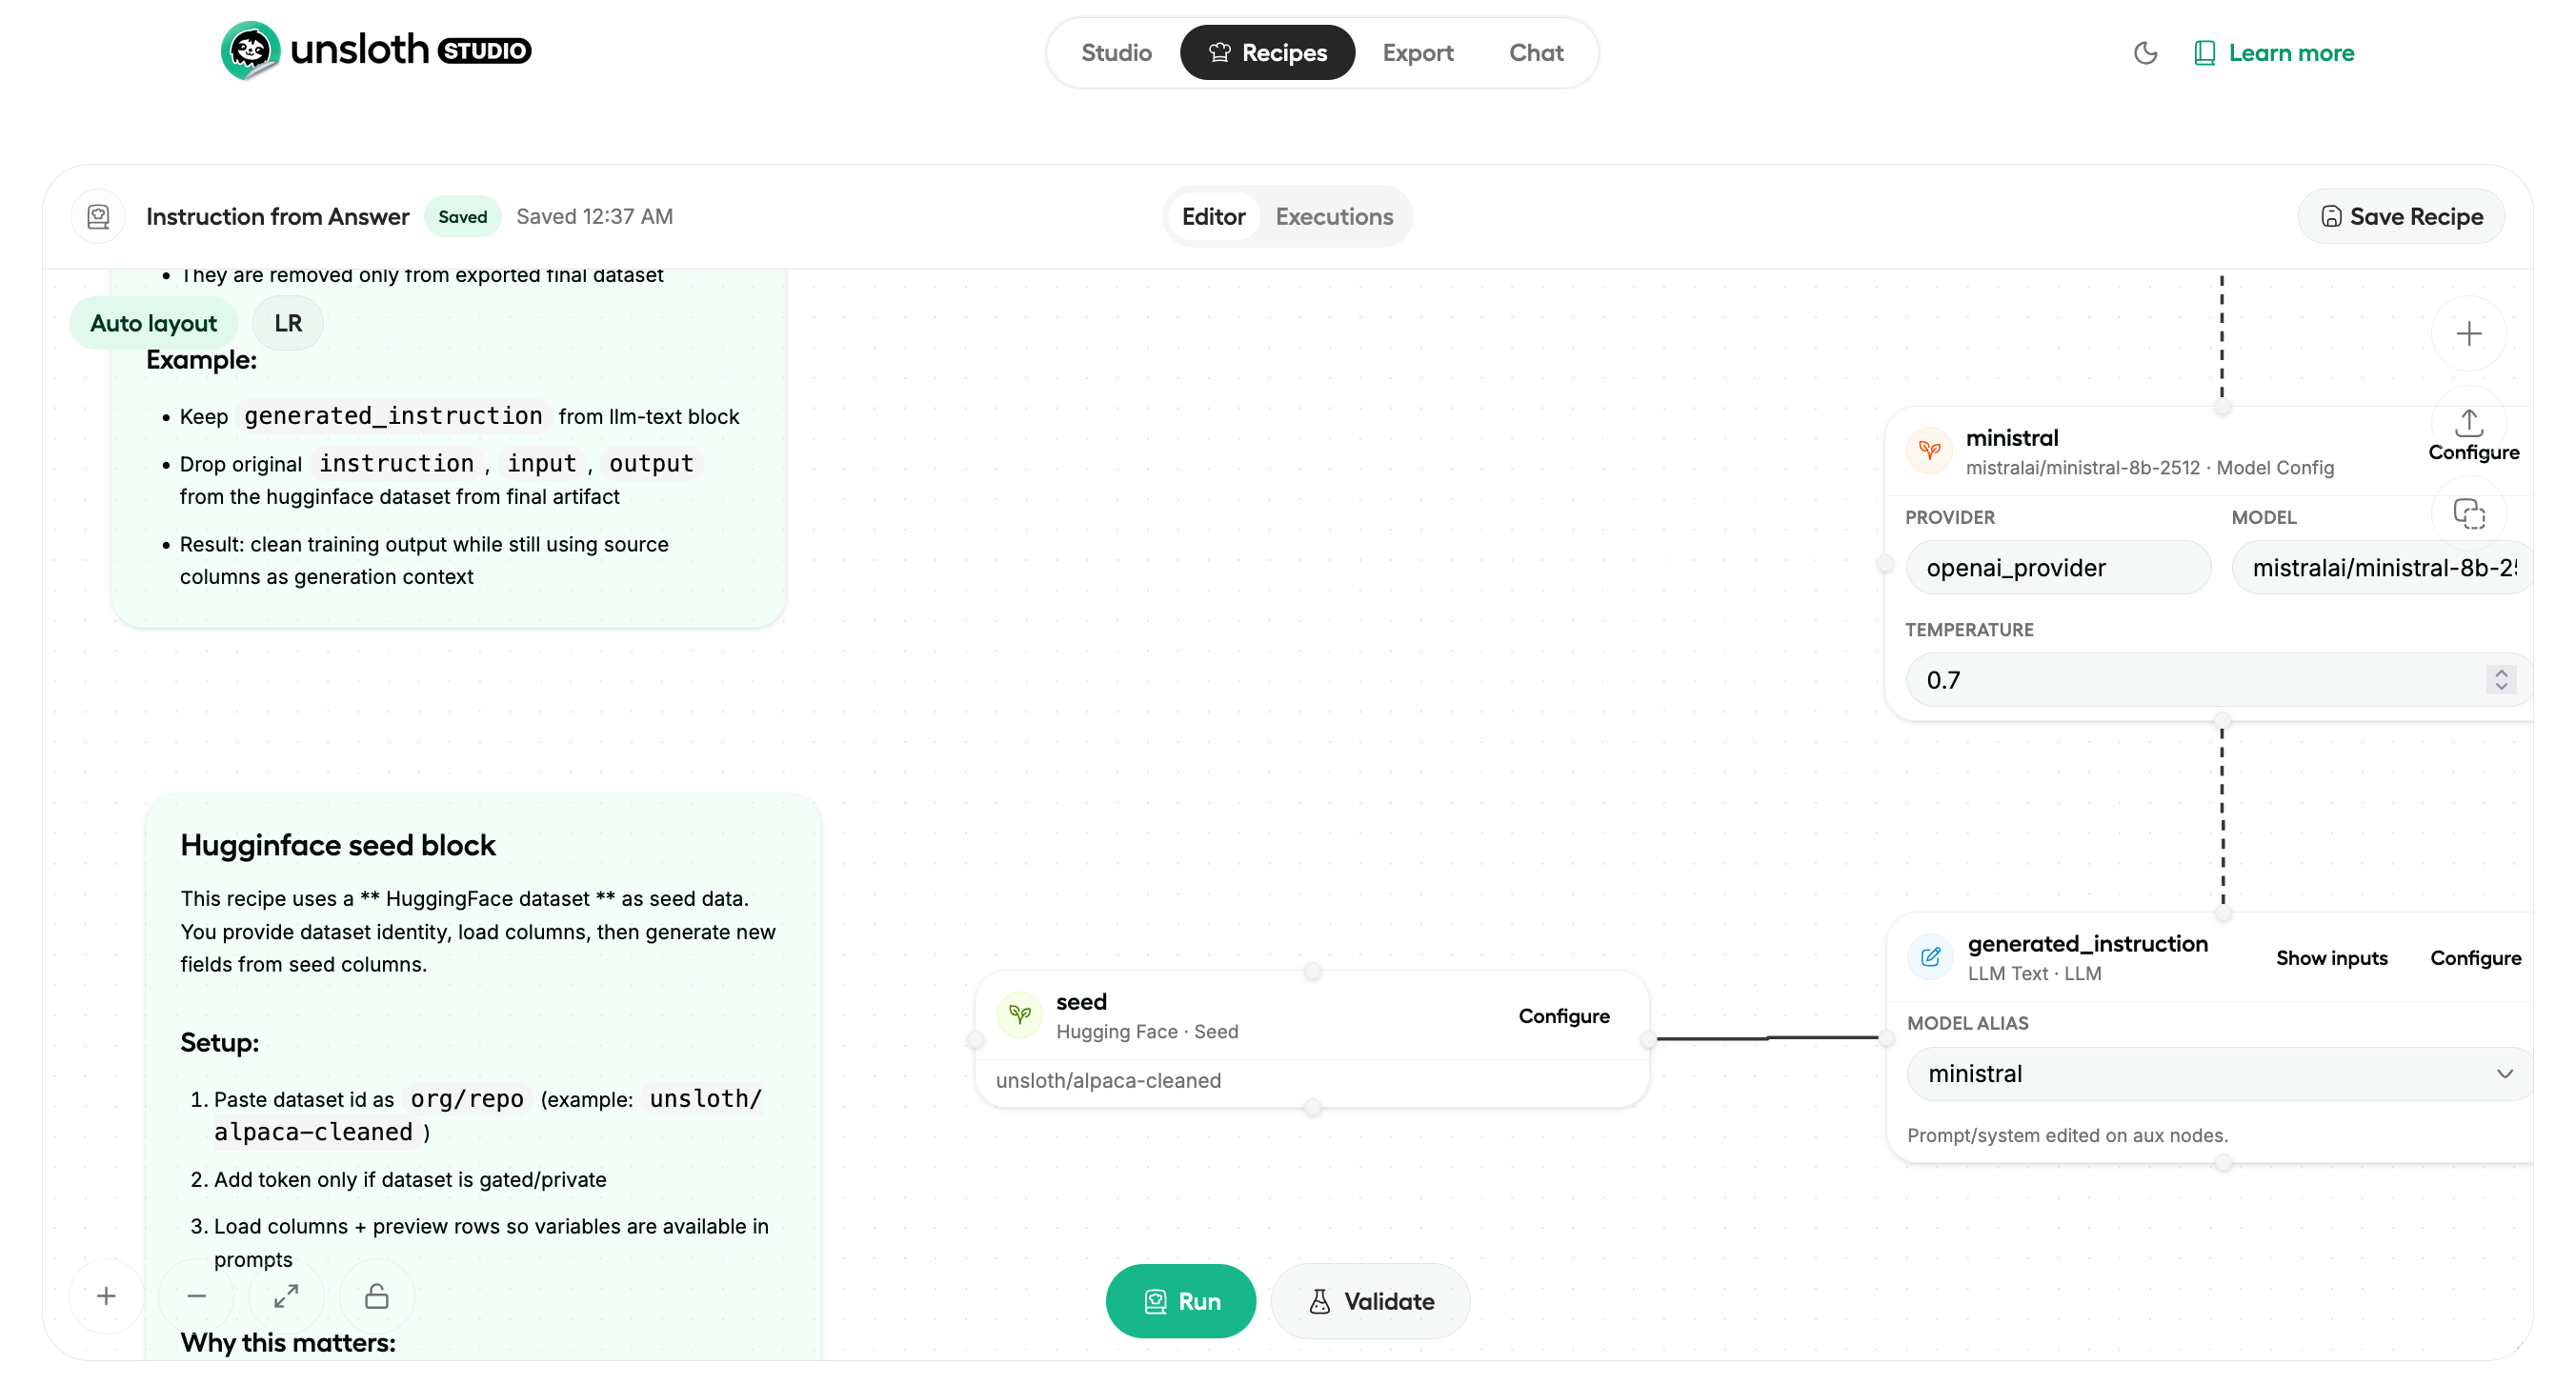
[Unsloth Data Recipes](/docs/jp/shii/studio/data-recipe.md) PDF や CSV などの文書をアップロードし、使用可能なデータセットに変換できます。グラフノードワークフローを通じて、視覚的にデータセットを作成・編集できます。
recipes ページが主な入口です。レシピはブラウザー内にローカル保存されるため、保存した作業に後から戻れます。ここから、空白のレシピを作成するか、ガイド付き学習レシピを開けます。
データレシピも同じ基本的な流れです。レシピページを開き、レシピを作成または選択し、エディタでワークフローを構築し、検証してプレビューを実行し、出力がよさそうなら完全なデータセットを実行します。シードデータと生成ブロックを追加し、ワークフローを検証してサンプル出力をプレビューし、その後で完全なデータセット生成を実行します。
一目で見る通常のワークフローは次のようになります:
1. recipes ページを開きます。
2. 新しいレシピを作成するか、既存のレシピを開きます。
3. ブロックを追加して、データセットのワークフローを定義します。
4. クリックします **検証して** 設定の問題を早期に検出します。
5. プレビューを実行して、サンプル行をすばやく確認します。
6. レシピの準備ができたら、フルデータセットの生成を実行します。
7. 進行状況と出力はグラフ上または **実行** ビューで詳細を確認できます。
8. 結果として得られたデータセットをUnslothで選択し、モデルをファインチューニングします。詳細はこちら:
{% content-ref url="/pages/1efc27ff794b527bf40ca1399ab10a6c28cc4b61" %}
[Data Recipes](/docs/jp/shii/studio/data-recipe.md)
{% endcontent-ref %}
## データの整形
関連する基準を特定し、必要なデータを収集したら、学習に使える機械可読な形式にデータを整形できます。
### LLM学習でよく使われるデータ形式
以下では [**継続事前学習**](/docs/jp/ji-chu/continued-pretraining.md)、特定の構造を持たない生テキスト形式を使います:
```json
"text": "パスタ・カルボナーラはローマの伝統的なパスタ料理です。ソースは、生卵を削ったペコリーノ・ロマーノチーズと黒こしょうで混ぜて作ります。熱いパスタにカリカリのグアンチャーレ(豚ほほ肉の塩漬け)と卵液を和えることで、残った熱でクリーミーなソースができます。一般に信じられていることとは異なり、本場のカルボナーラにクリームやニンニクは決して使われません。この料理はおそらく20世紀半ばのローマで生まれたと考えられていますが、その正確な起源については議論があります..."
```
この形式は自然な言語の流れを保ち、モデルが連続したテキストから学習できるようにします。
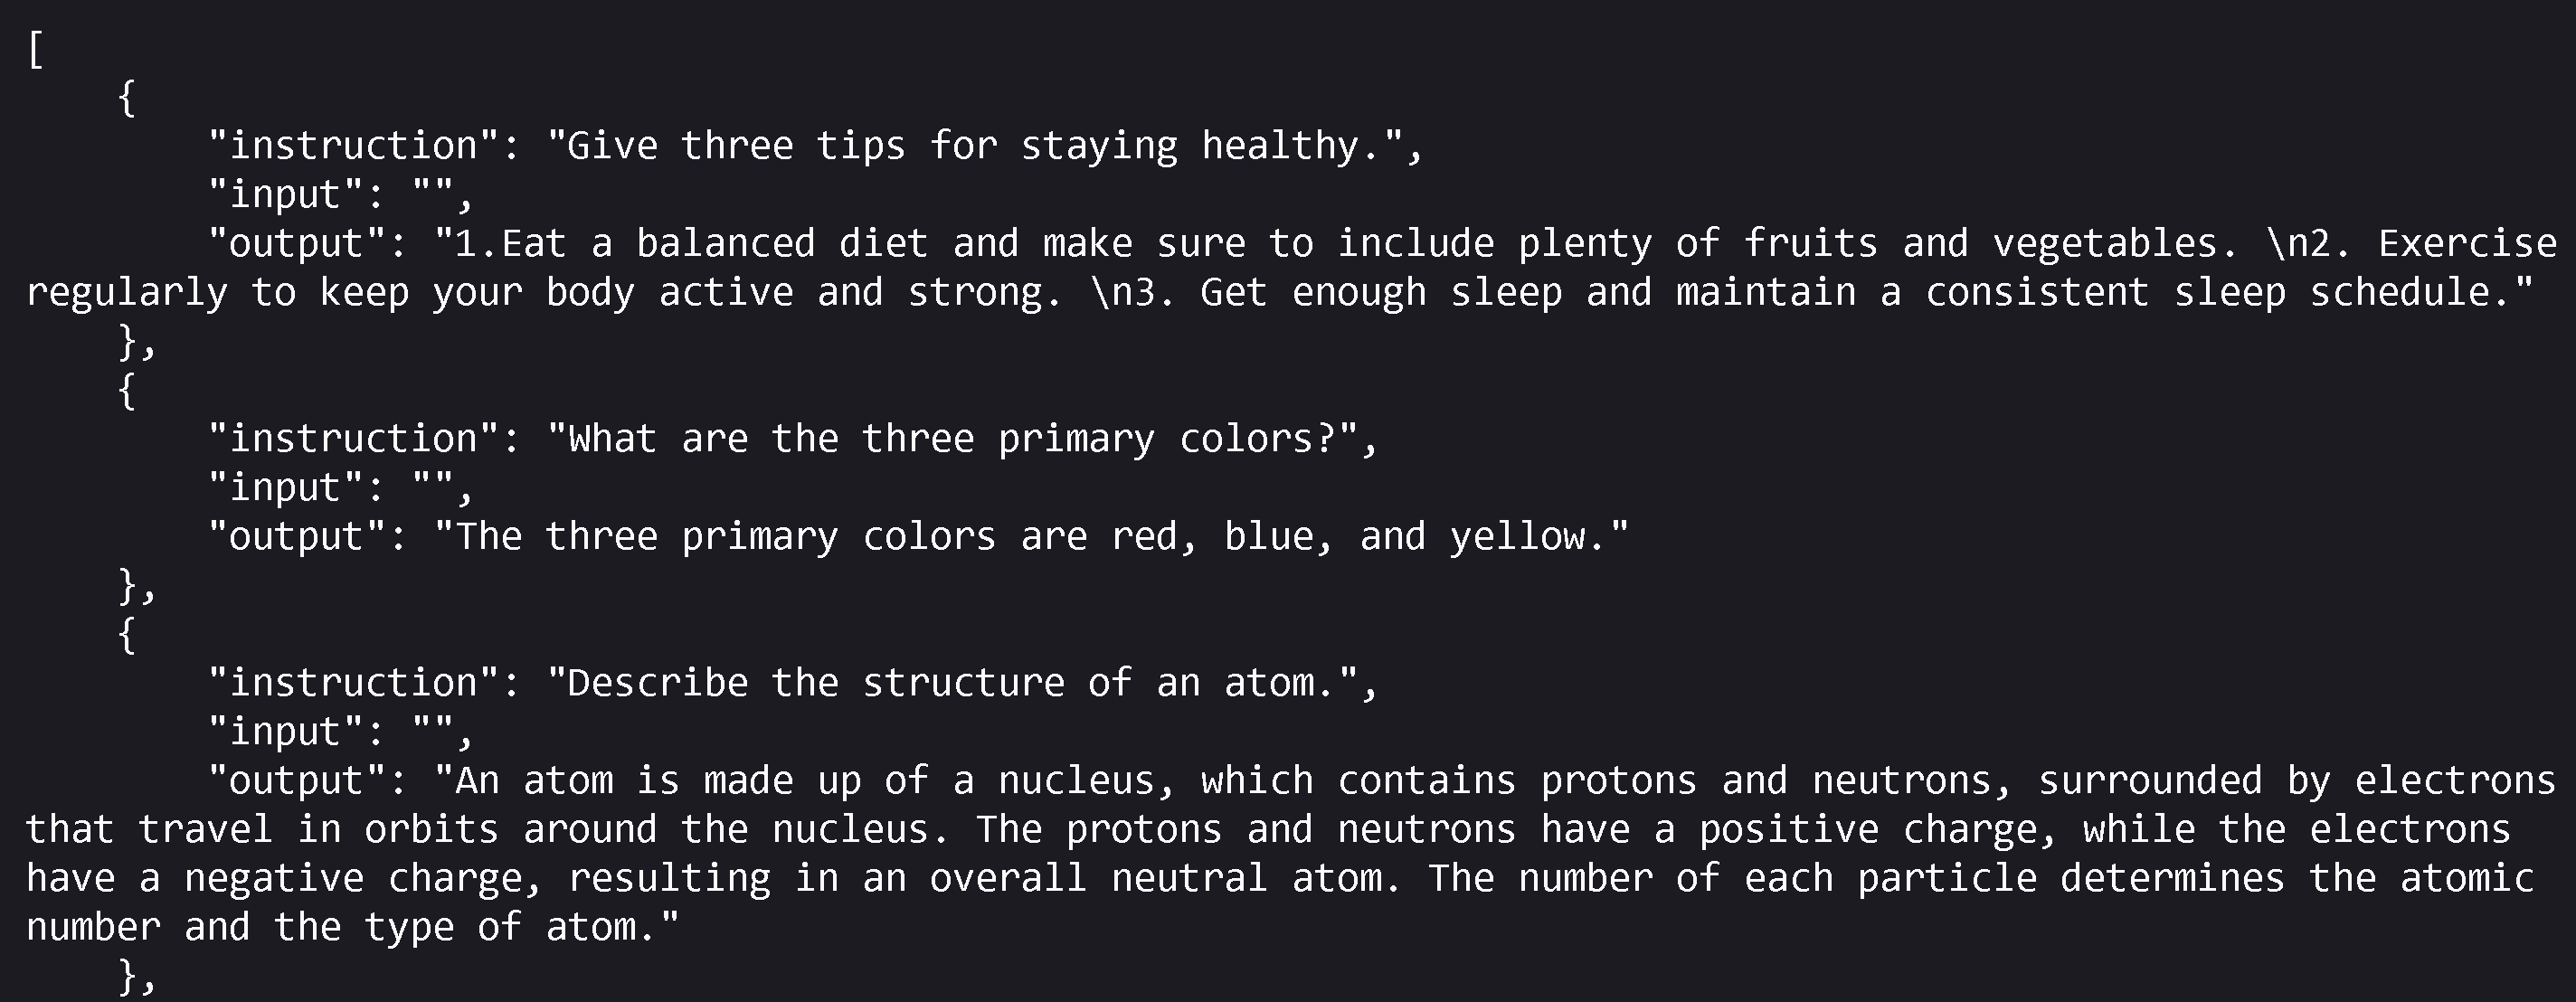
モデルを新しいタスクに適応させ、特定の指示セットに基づいて1ターンでテキストを出力させたい場合は、 **指示** 形式を [Alpacaスタイルで](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset)
```json
"Instruction": "モデルに実行させたいタスク。"
"Input": "任意ですが有用で、実質的にはユーザーのクエリになります。"
"Output": "タスクの期待される結果であり、モデルの出力です。"
```
複数ターンの会話を行いたい場合は、ShareGPT形式を使えます:
```json
{
"conversations": [
{
"from": "human",
"value": "パスタ・カルボナーラを作るのを手伝ってくれますか?"
},
{
"from": "gpt",
"value": "ローマの伝統的なレシピと、より簡単なバージョンのどちらがよいですか?"
},
{
"from": "human",
"value": "伝統的なバージョンでお願いします"
},
{
"from": "gpt",
"value": "本場のローマ風カルボナーラは、パスタ、グアンチャーレ、卵、ペコリーノ・ロマーノ、黒こしょうの数少ない材料だけを使います。詳しいレシピをご希望ですか?"
}
]
}
```
テンプレート形式では「from」/「value」属性キーを使い、メッセージは次の間で交互に `human`そして `gpt`を繰り返すため、自然な対話の流れになります。
もう一つの一般的な形式はOpenAIのChatML形式で、Hugging Faceのデフォルトでもあります。これはおそらく最もよく使われる形式で、次の間で交互に `user` そして `assistant`
```
{
"messages": [
{
"role": "user",
"content": "1+1は何ですか?"
},
{
"role": "assistant",
"content": "2です!"
},
]
}
```
### Unsloth を使ったチャットテンプレートの適用
通常 ChatML 形式に従うデータセットでは、トレーニングまたはファインチューニングのためにデータセットを準備する手順は、次の 4 つの簡単なステップで構成されます:
* Unsloth が現在サポートしているチャットテンプレートを確認します:\\
```
from unsloth.chat_templates import CHAT_TEMPLATES
print(list(CHAT_TEMPLATES.keys()))
```
\
これにより、Unsloth が現在サポートしているテンプレートの一覧が出力されます。出力例は次のとおりです:\\
```
['unsloth', 'zephyr', 'chatml', 'mistral', 'llama', 'vicuna', 'vicuna_old', 'vicuna old', 'alpaca', 'gemma', 'gemma_chatml', 'gemma2', 'gemma2_chatml', 'llama-3', 'llama3', 'phi-3', 'phi-35', 'phi-3.5', 'llama-3.1', 'llama-31', 'llama-3.2', 'llama-3.3', 'llama-32', 'llama-33', 'qwen-2.5', 'qwen-25', 'qwen25', 'qwen2.5', 'phi-4', 'gemma-3', 'gemma3']
```
\\\\
* 次を使います: `get_chat_template` トークナイザに正しいチャットテンプレートを適用するには:\\
```
from unsloth.chat_templates import get_chat_template
tokenizer = get_chat_template(
tokenizer,
chat_template = "gemma-3", # 正しい chat_template 名に変更してください
)
```
\\\\
* 書式設定関数を定義します。例は次のとおりです:\\
```
def formatting_prompts_func(examples):
convos = examples["conversations"]
texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
return { "text" : texts, }
```
\
\
この関数はデータセットをループし、定義したチャットテンプレートを各サンプルに適用します。\\
* 最後に、データセットを読み込み、必要な変更をデータセットに適用しましょう: \\
```
# データセットをインポートして読み込む
from datasets import load_dataset
dataset = load_dataset("repo_name/dataset_name", split = "train")
# map メソッドを使って、データセットに書式設定関数を適用する
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
\
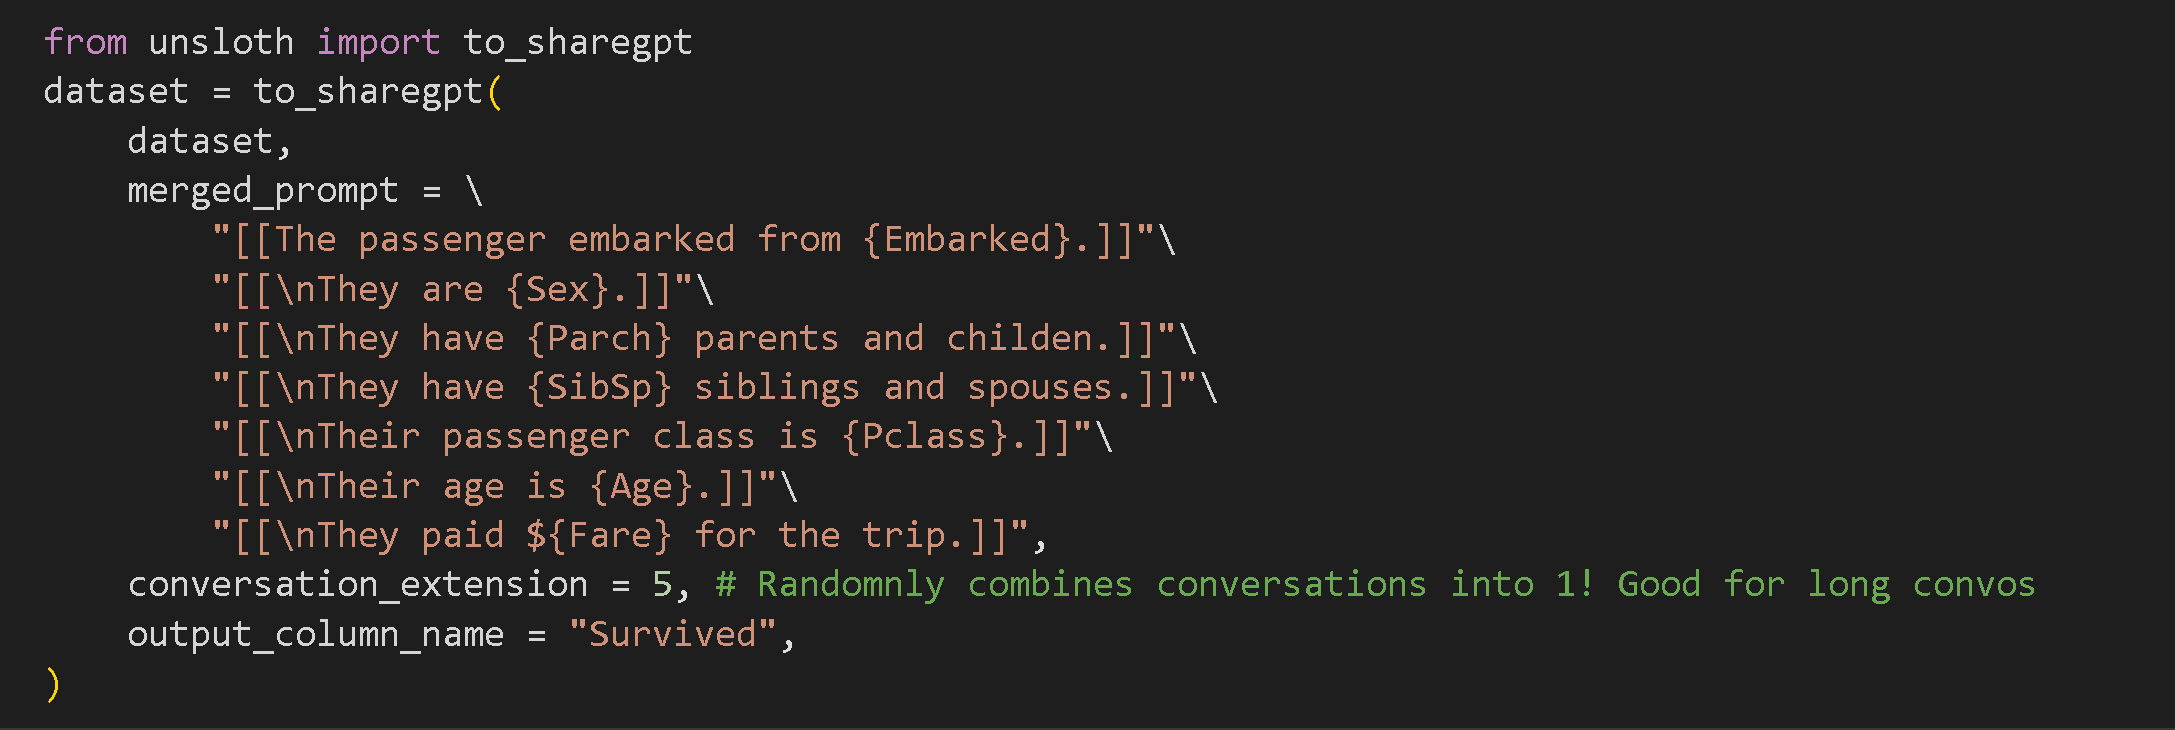
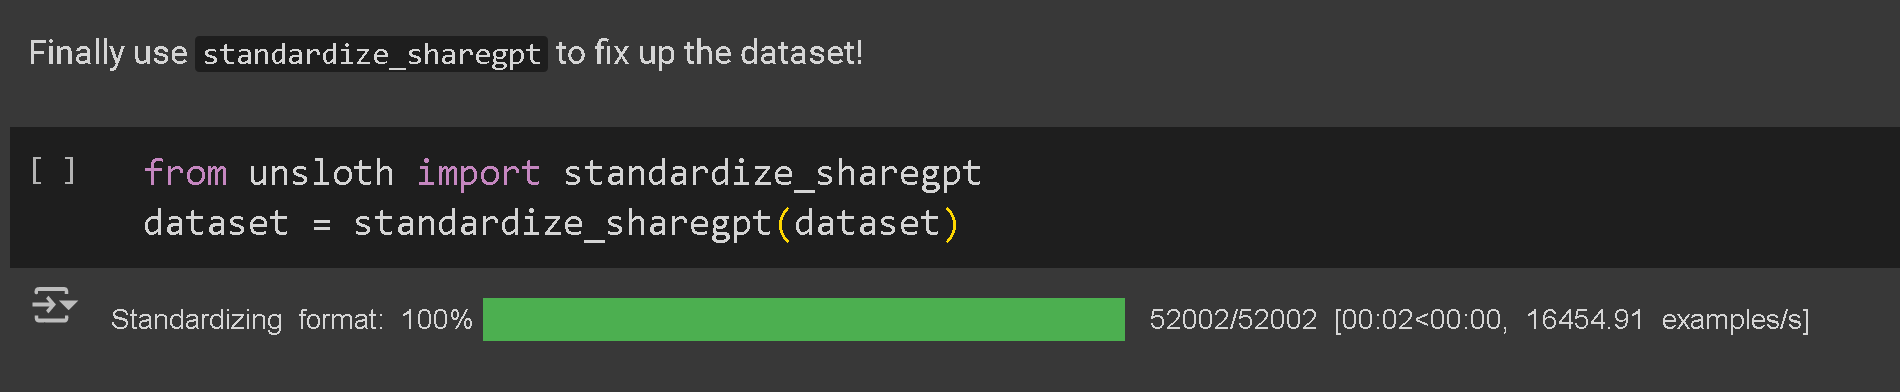
データセットが ChatML の "role"/"content" 形式ではなく、"from"/"value" キーを持つ ShareGPT 形式を使っている場合は、次を使えます: `standardize_sharegpt` 最初にそれを変換する関数を使えます。修正版のコードは次のようになります:\
\\
```
# データセットをインポートする
from datasets import load_dataset
dataset = load_dataset("mlabonne/FineTome-100k", split = "train")
# 必要なら、データセットを "role"/"content" 形式に変換する
from unsloth.chat_templates import standardize_sharegpt
dataset = standardize_sharegpt(dataset)
# map メソッドを使って、データセットに書式設定関数を適用する
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
### データのQ\&A形式整形
**Q:** Alpacaの指示形式はどう使えばいいですか?
**A:** データセットがすでにAlpaca形式で整形されている場合は、Llama3.1で示されているように整形手順に従ってください [ノートブック ](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-Alpaca.ipynb#scrollTo=LjY75GoYUCB8)。データをAlpaca形式に変換する必要がある場合は、1つの方法として、Pythonスクリプトを作成して生データを処理できます。要約タスクに取り組んでいるなら、ローカルLLMを使って各例の指示と出力を生成できます。
**Q:** standardize\_sharegptメソッドは常に使うべきですか?
**A:** standardize\_sharegptメソッドは、対象データセットがsharegpt形式で整形されているが、モデルが代わりにChatML形式を想定している場合にのみ使用してください。
\ **Q:** トークナイザーに付属するapply\_chat\_template関数を使わないのはなぜですか。
**A:** その `chat_template` モデルが最初に元のモデル提供者によってアップロードされる際の属性には、時にエラーが含まれており、更新に時間がかかることがあります。対照的に、Unslothでは、 `chat_template` 各モデルについて、量子化版をリポジトリにアップロードする際に徹底的に確認し、エラーを修正しています。さらに、当社の `get_chat_template` そして `apply_chat_template` メソッドは高度なデータ操作機能を備えており、Chat Templatesのドキュメントで完全に説明されています [ページ](https://docs.unsloth.ai/basics/chat-templates).
**Q:** 私のテンプレートが現在Unslothでサポートされていない場合は?
**A:** unslothのGitHub Issuesフォーラムで機能要望を送信してください [フォーラム](https://github.com/unslothai/unsloth)。一時的な回避策として、機能要望が承認されマージされるまで、トークナイザーのapply\_chat\_template関数を使うこともできます。
## 合成データ生成
Llama 3.3 (70B) やOpenAIのGPT 4.5のような任意のローカルLLMを使って合成データを生成することもできます。一般的には、最も高品質な出力を確保するために、Llama 3.3 (70B) のようなより大きなモデルを使うのが望ましいです。vLLM、Ollama、llama.cppのような推論エンジンを直接使って合成データを生成することもできますが、収集と追加データのプロンプト作成に手作業が必要になります。合成データの目的は3つあります:
* 新しいデータを完全に作成する - ゼロから、または既存のデータセットから
* データセットを多様化し、モデルが [過学習](/docs/jp/meru/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting) して特定化しすぎるのを防ぐ
* 既存データを拡張する。例:データセットを自動的に選択した正しい形式に構造化する
### 合成データにUnslothを使う
Unsloth Studioの [Data Recipes](/docs/jp/shii/studio/data-recipe.md) アップロード機能により、構造化されていないデータや構造化データを簡単にアップロードでき、自動的に利用可能な / 合成データセットに変換されます。詳細は [ガイドをご覧ください](/docs/jp/shii/studio/data-recipe.md).
### 合成データにローカルLLMまたはChatGPTを使う
目標は、モデルにプロンプトを与えて、指定した形式のQAデータを生成・処理させることです。モデルは、与えられた構造とコンテキストの両方を学ぶ必要があるため、少なくとも10例のデータを既に用意しておくようにしてください。プロンプト例:
* **既存データセット上でより多くの対話を生成するためのプロンプト**:
私が提供したデータセットの例を使って、構造に従い、例に基づいて会話を生成してください。
}]},
{'role': 'assistant',
'content': [{'type': 'text',
'text': 'パノラマX線写真は、右上顎後方部の骨溶解性病変と、上顎洞底の吸収を示しています(矢印)。'}]}]}
```
{% endcode %}
ファインチューニングを行う前に、もしかするとVisionモデルはすでに画像の分析方法を知っているかもしれません。これが当てはまるか確認しましょう!
```notebook-python
FastVisionModel.for_inference(model) # 推論を有効化!
image = dataset[0]["image"]
instruction = "あなたは放射線診断の専門家です。この画像に見えるものを正確に説明してください。"
messages = [
{"role": "user", "content": [
{"type": "image"},
{"type": "text", "text": instruction}
]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt = True)
inputs = tokenizer(
image,
input_text,
add_special_tokens = False,
return_tensors = "pt",
).to("cuda")
from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 128,
use_cache = True, temperature = 1.5, min_p = 0.1)
```
そして結果は:
```
このX線写真は、上顎と下顎の歯列全体のパノラマ画像、具体的にはオルソパントモグラム(OPG)と思われます。
* パノラマX線写真は正常な歯科構造を示しています。
* 右上に異常領域があり、これは透過像を示す骨領域として表され、上顎洞に対応しています。
**主な観察点**
* 左上の歯の間の骨は比較的X線不透過性です。
* 画像の上に2本の大きな矢印があり、この領域をより詳しく調べる必要があることを示唆しています。矢印の1本は左側に、もう1本は右側にあります。ただし、
```
詳細については、のデータセットセクションをご覧ください [ノートブックはこちら](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX).
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/jp/meru/fine-tuning-llms-guide/datasets-guide.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.

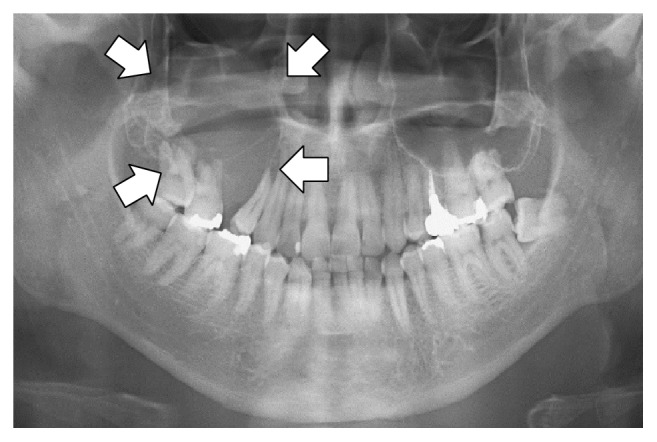 | パノラマX線写真は、右上顎後方部の骨溶解性病変と、上顎洞底の吸収を示しています(矢印)。 |
データセットを整形するには、すべてのVisionファインチューニングタスクを以下のように整形する必要があります:
```python
[
{ "role": "user",
"content": [{"type": "text", "text": instruction}, {"type": "image", "image": image} ]
},
{ "role": "assistant",
"content": [{"type": "text", "text": answer} ]
},
]
```
VLMが放射線診断の専門家であるようにするカスタム指示を作成します。1つの指示だけでなく、複数ターンを追加して動的な会話にできることにも注目してください。
```notebook-python
instruction = "あなたは放射線診断の専門家です。この画像に見えるものを正確に説明してください。"
def convert_to_conversation(sample):
conversation = [
{ "role": "user",
"content" : [
{"type" : "text", "text" : instruction},
{"type" : "image", "image" : sample["image"]} ]
},
{ "role" : "assistant",
"content" : [
{"type" : "text", "text" : sample["caption"]} ]
},
]
return { "messages" : conversation }
pass
```
データセットをファインチューニング用の「正しい」形式に変換しましょう:
```notebook-python
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
最初の例は次のように構造化されます:
```notebook-python
converted_dataset[0]
```
{% code overflow="wrap" %}
```
{'messages': [{'role': 'user',
'content': [{'type': 'text',
'text': 'あなたは放射線診断の専門家です。この画像に見えるものを正確に説明してください。'},
{'type': 'image',
'image':