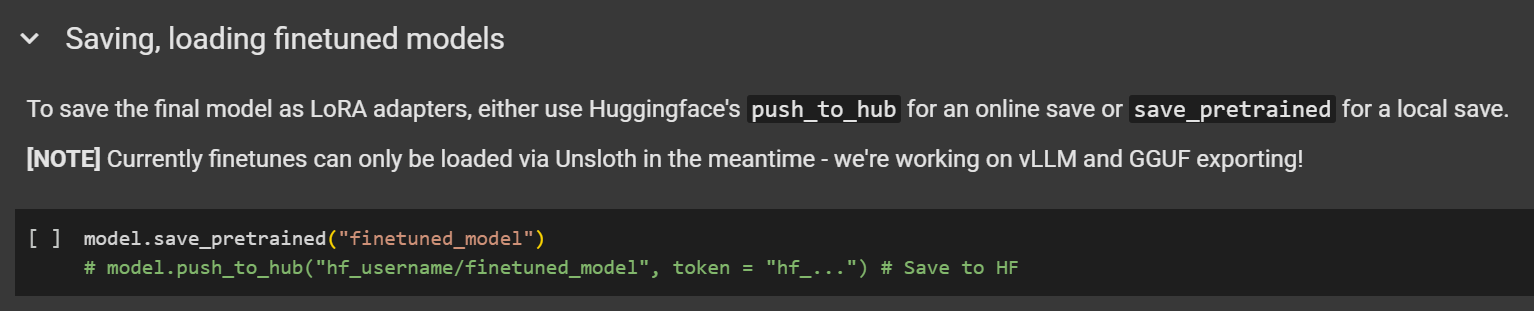
> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/tutorial-how-to-fine-tune-gpt-oss.md).
# Tutoriel : comment fine-tuner gpt-oss
Découvrez pas à pas comment entraîner OpenAI gpt-oss localement avec Unsloth.
Dans ce guide avec captures d'écran, vous apprendrez à affiner votre propre modèle gpt-oss personnalisé, soit [localement](#local-gpt-oss-fine-tuning) sur votre machine avec [Unsloth](https://github.com/unslothai/unsloth) ou gratuitement à l'aide de [Google Colab](#colab-gpt-oss-fine-tuning). Nous vous guiderons à travers tout le processus, de la configuration à l'exécution et à l'enregistrement de votre modèle entraîné.
{% hint style="success" %}
[**Mise à jour du 28 août**](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support)**:** Vous pouvez désormais exporter/enregistrer votre modèle gpt-oss affiné QLoRA vers llama.cpp, vLLM, HF, etc.
Nous avons également introduit [Unsloth Flex Attention](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support) qui permet **>8× plus longues longueurs de contexte**, **>50 % d'utilisation de VRAM en moins** et **>1,5× entraînement plus rapide** par rapport à toutes les implémentations. [En savoir plus ici](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support)
{% endhint %}
> **Démarrage rapide :** Affinez gratuitement gpt-oss-20b avec notre : [notebook Colab](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-Fine-tuning.ipynb)
L'affinage gpt-oss d'Unsloth, comparé à toutes les autres implémentations FA2, permet un entraînement 1,5× plus rapide, une réduction de 70 % de l'utilisation de VRAM et des longueurs de contexte 10x plus longues, sans perte de précision.
* **Exigences QLoRA :** gpt-oss-20b = 14 Go de VRAM • gpt-oss-120b = 65 Go de VRAM.
* **Exigences LoRA BF16 :** gpt-oss-20b = 44 Go de VRAM • gpt-oss-120b = 210 Go de VRAM.
Guide localGuide Colab
## 🌐 Affinage gpt-oss sur Colab
Cette section couvre l'affinage de gpt-oss à l'aide de nos [notebooks](/docs/fr/commencer/unsloth-notebooks.md). Vous pouvez également enregistrer et utiliser le notebook gpt-oss dans votre éditeur de code préféré et suivre notre [guide gpt-oss local](#local-gpt-oss-fine-tuning).
{% stepper %}
{% step %}
#### Installer Unsloth (dans Colab)
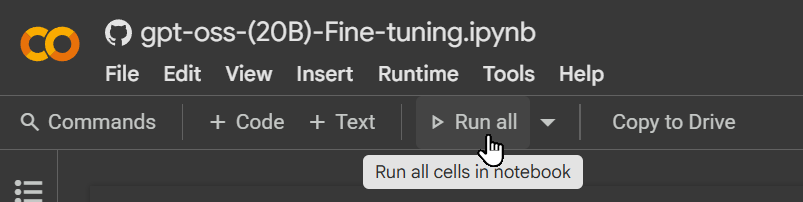
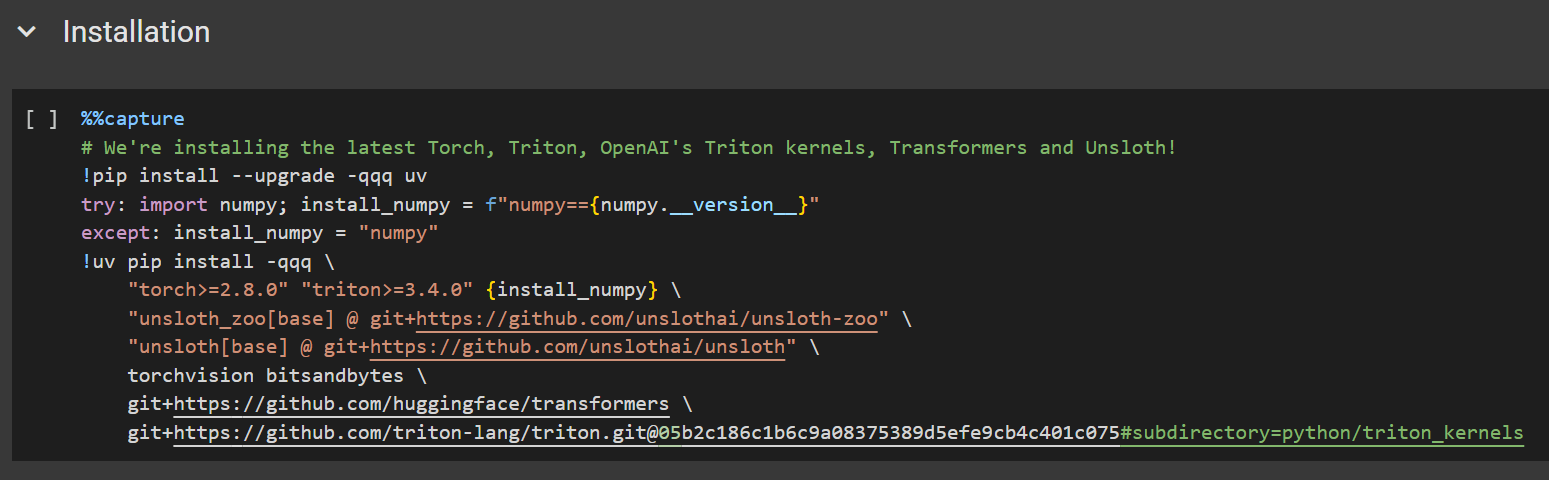
Dans Colab, exécutez les cellules **de haut en bas**. Utilisez **Tout exécuter** pour la première passe. La première cellule installe Unsloth (et les dépendances associées) et affiche les informations GPU/mémoire. Si une cellule renvoie une erreur, relancez-la simplement.
{% endstep %}
{% step %}
#### Configuration de gpt-oss et de l'effort de raisonnement
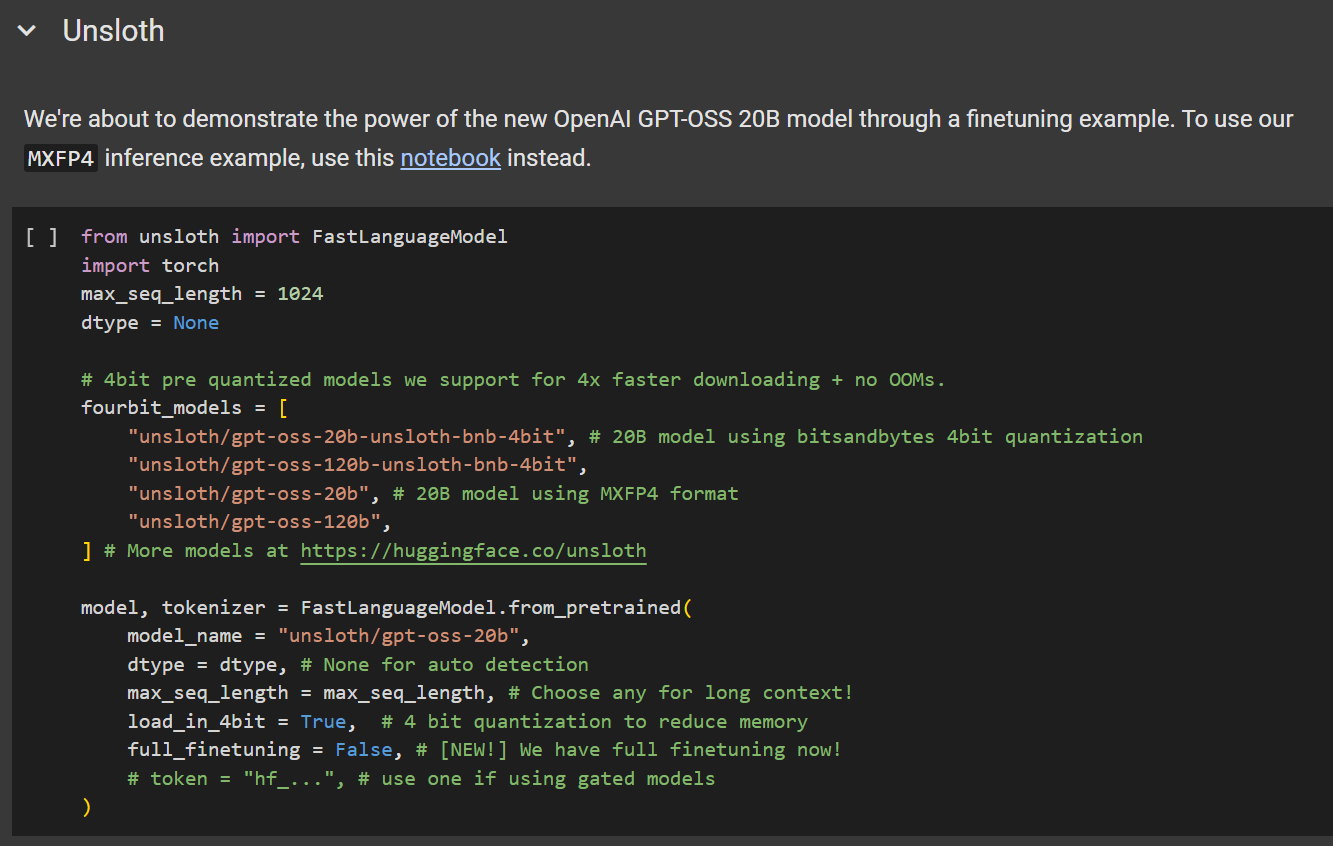
Nous allons charger **`gpt-oss-20b`** à l'aide de la version linéarisée d'Unsloth [linéarisée](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md#making-efficient-gpt-oss-fine-tuning-work) (car aucune autre version ne fonctionnera).
Configurez les paramètres suivants :
* `max_seq_length = 1024`
* Recommandé pour des tests rapides et des expériences initiales.
* `load_in_4bit = True`
* Utilisez `Faux` pour l'entraînement LoRA (remarque : le réglage à `Faux` nécessitera au moins 43 Go de VRAM). Vous ***DEVEZ*** également définir **`model_name = "unsloth/gpt-oss-20b-BF16"`**
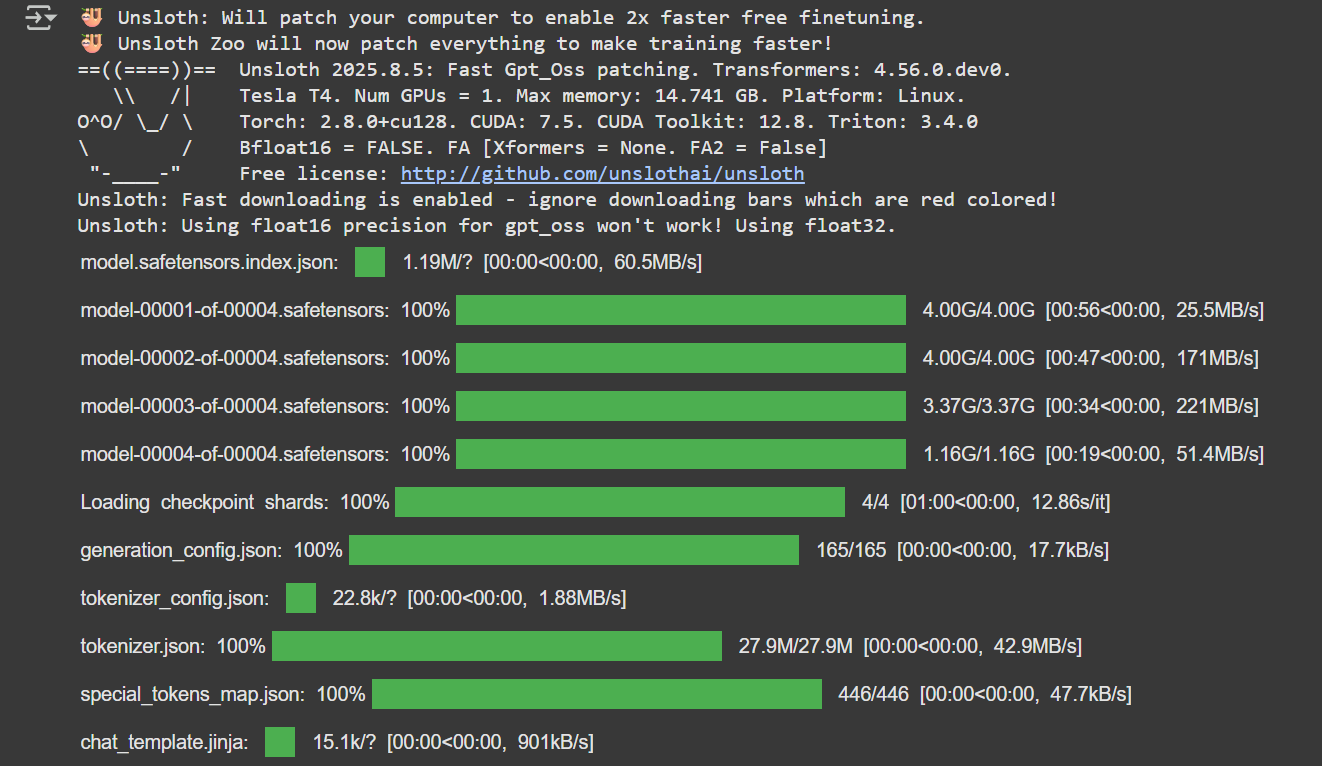
Vous devriez voir une sortie similaire à l'exemple ci-dessous. Remarque : nous modifions explicitement le `dtype` à `float32` afin de garantir un comportement d'entraînement correct.
{% endstep %}
{% step %}
#### Hyperparamètres d'affinage (LoRA)
Il est maintenant temps d'ajuster vos hyperparamètres d'entraînement. Pour aller plus loin sur comment, quand et quoi ajuster, consultez notre [guide détaillé des hyperparamètres](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
{% hint style="info" %}
Pour éviter le [surapprentissage](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting), surveillez votre perte d'entraînement et évitez de définir ces valeurs trop hautes.
{% endhint %}
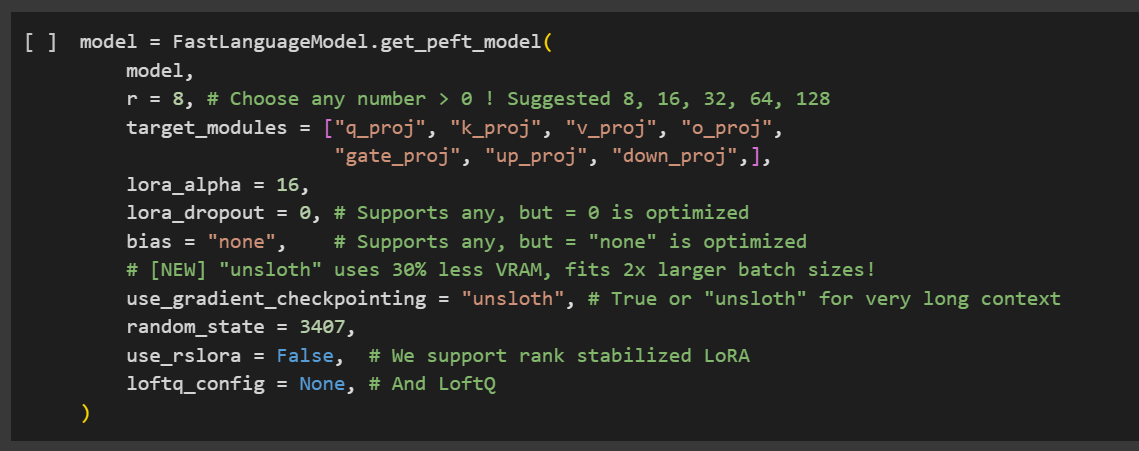
Cette étape ajoute des adaptateurs LoRA pour un affinage efficace en paramètres. Seuls environ 1 % des paramètres du modèle sont entraînés, ce qui rend le processus nettement plus efficace.
{% endstep %}
{% step %}
#### Tester l'inférence
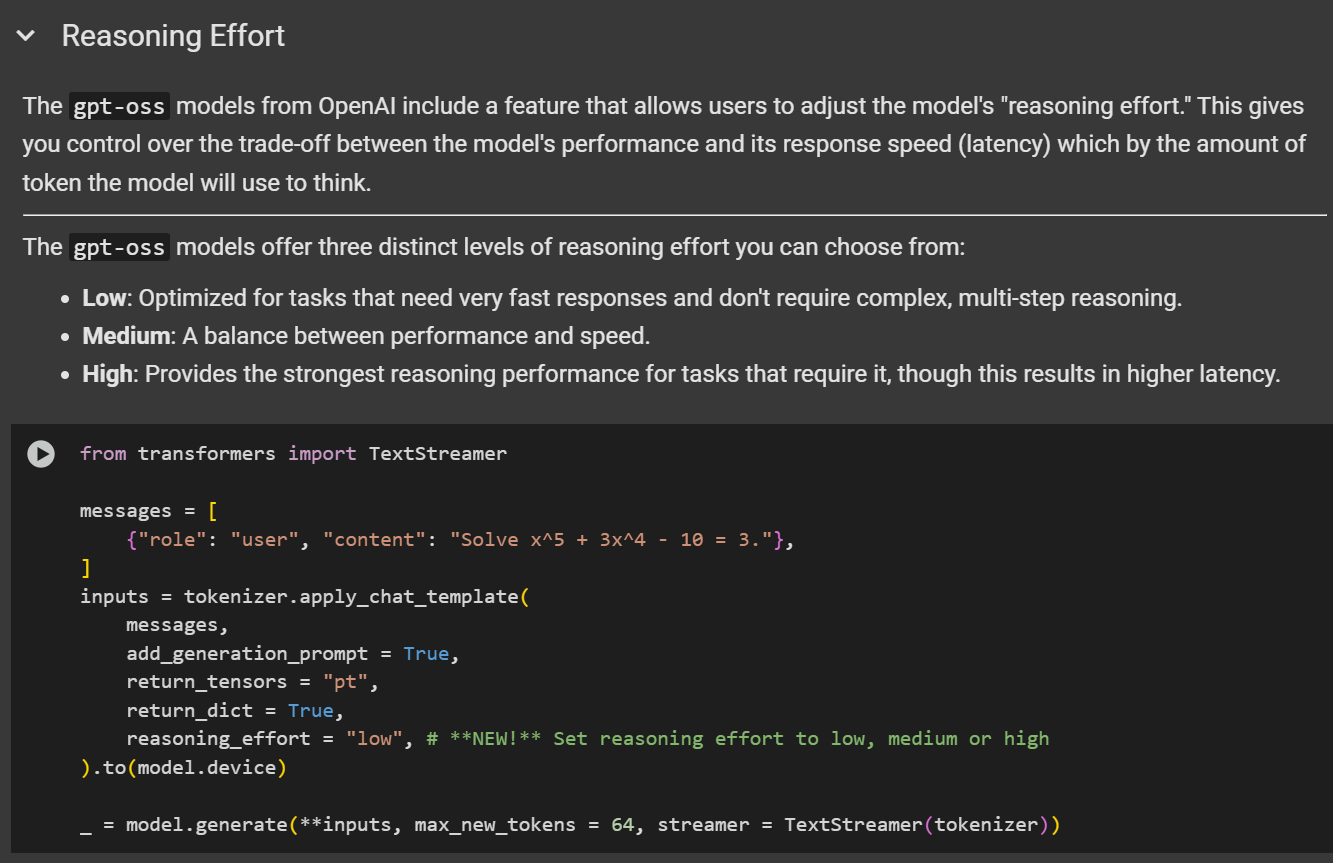
Dans le notebook, il y a une section appelée *"Effort de raisonnement"* qui montre l'exécution de l'inférence gpt-oss dans Colab. Vous pouvez ignorer cette étape, mais vous devrez quand même exécuter le modèle plus tard une fois l'affinage terminé.
{% endstep %}
{% step %}
#### Préparation des données
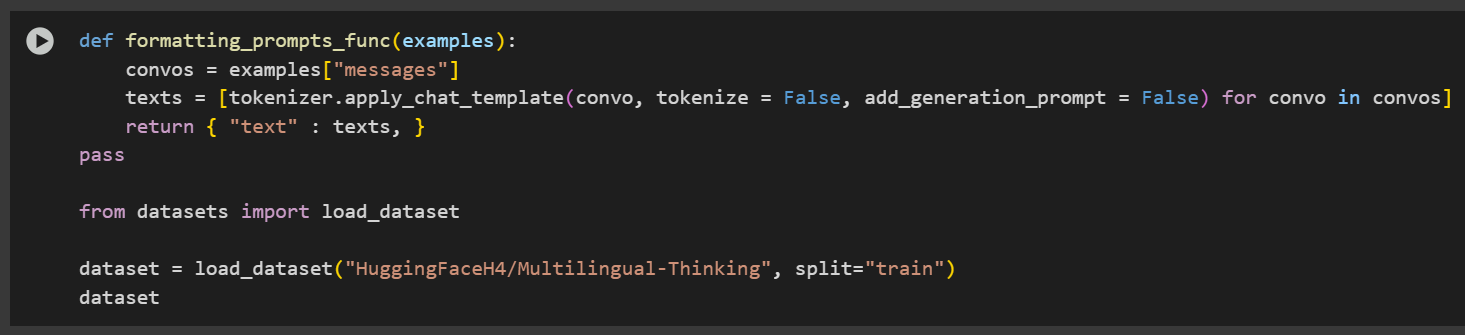
Pour cet exemple, nous utiliserons [`HuggingFaceH4/Multilingual-Thinking`](https://huggingface.co/datasets/HuggingFaceH4/Multilingual-Thinking). Cet ensemble de données contient des exemples de raisonnement en chaîne de pensée dérivés de questions d'utilisateurs traduites de l'anglais vers quatre autres langues.
C'est le même ensemble de données référencé dans le cookbook d'affinage d'OpenAI.
Le but d'utiliser un ensemble de données multilingue est d'aider le modèle à apprendre et à généraliser les schémas de raisonnement à travers plusieurs langues.
gpt-oss introduit un système d'effort de raisonnement qui contrôle le niveau de raisonnement effectué par le modèle. Par défaut, l'effort de raisonnement est défini sur `faible`, mais vous pouvez le modifier en définissant le `reasoning_effort` paramètre sur `faible`, `moyen` ou `élevé`.
Exemple :
```python
tokenizer.apply_chat_template(
text,
tokenize = False,
add_generation_prompt = False,
reasoning_effort = "medium",
)
```
Pour formater l'ensemble de données, nous appliquons une version personnalisée de l'invite gpt-oss :
```python
from unsloth.chat_templates import standardize_sharegpt
dataset = standardize_sharegpt(dataset)
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
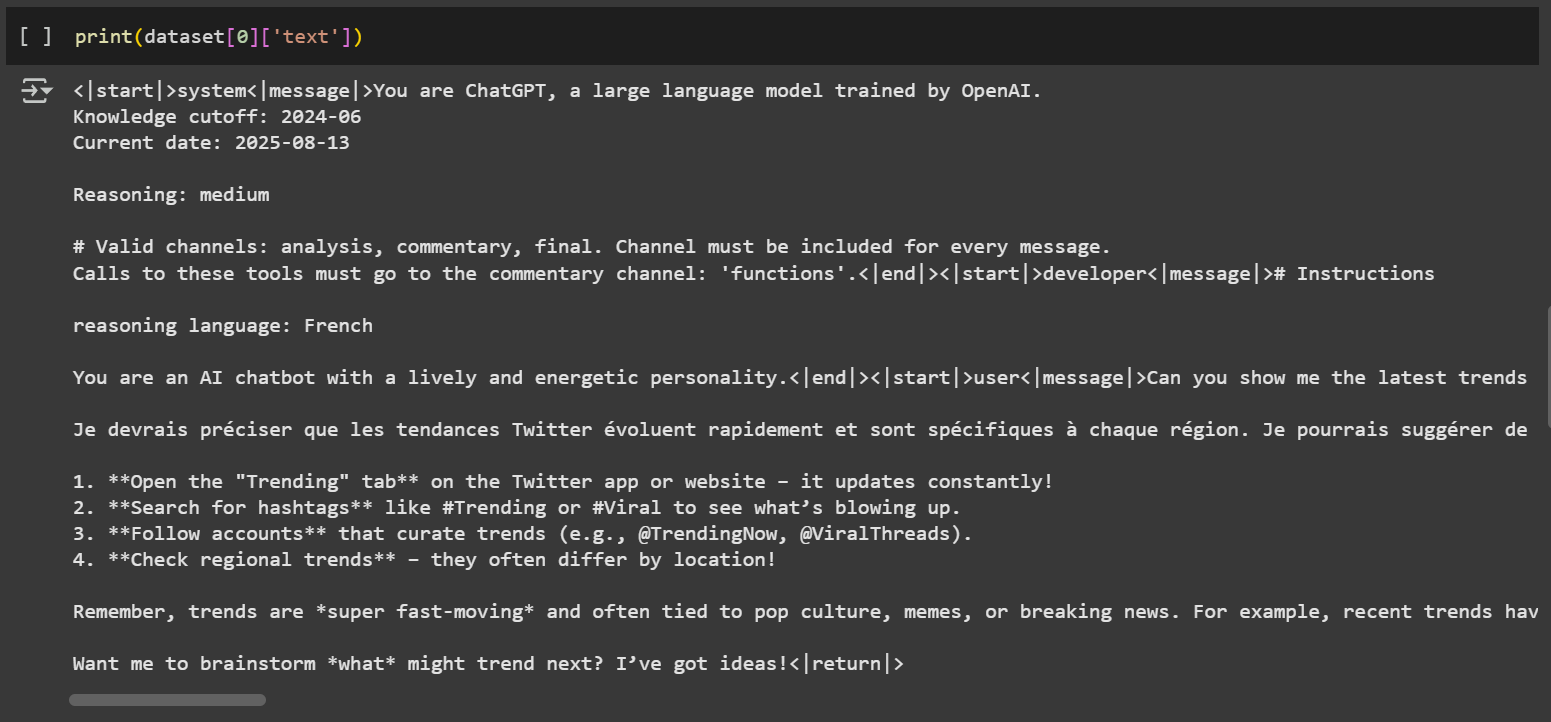
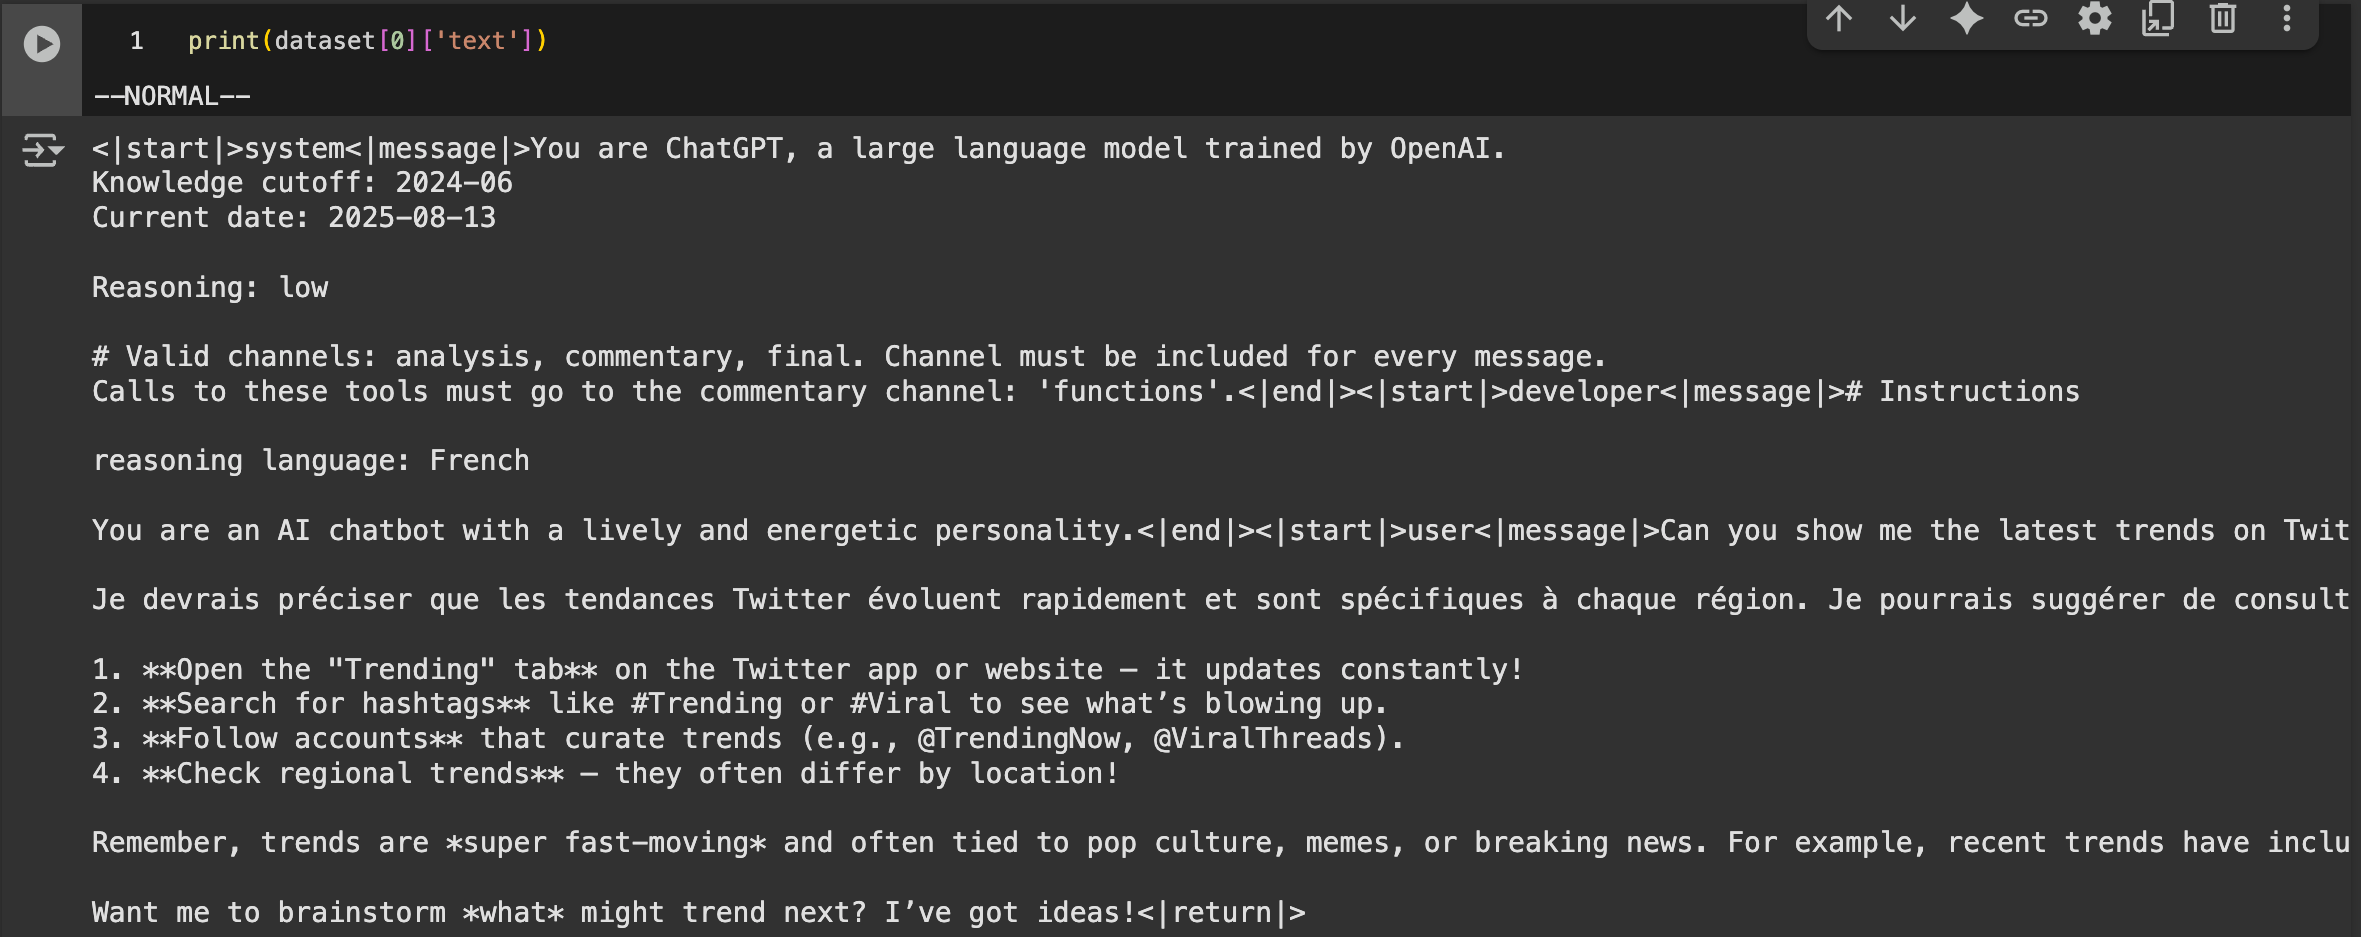
Inspectons l'ensemble de données en affichant le premier exemple :
```notebook-python
print(dataset[0]['text'])
```
Une caractéristique unique de gpt-oss est son utilisation du [**format OpenAI Harmony**](https://github.com/openai/harmony)**,** qui prend en charge les conversations structurées, les sorties de raisonnement et l'appel d'outils. Ce format inclut des balises telles que `<|start|>` , `<|message|>` et `<|return|>` .
{% hint style="info" %}
🦥 Unsloth corrige le modèle de chat pour garantir qu'il est correct. Voir ceci [tweet](https://x.com/danielhanchen/status/1953901104150065544) pour les détails techniques sur notre correction du modèle.
{% endhint %}
N'hésitez pas à adapter l'invite et la structure à votre propre ensemble de données ou cas d'utilisation. Pour plus de conseils, consultez notre [guide de jeu de données](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md).
{% endstep %}
{% step %}
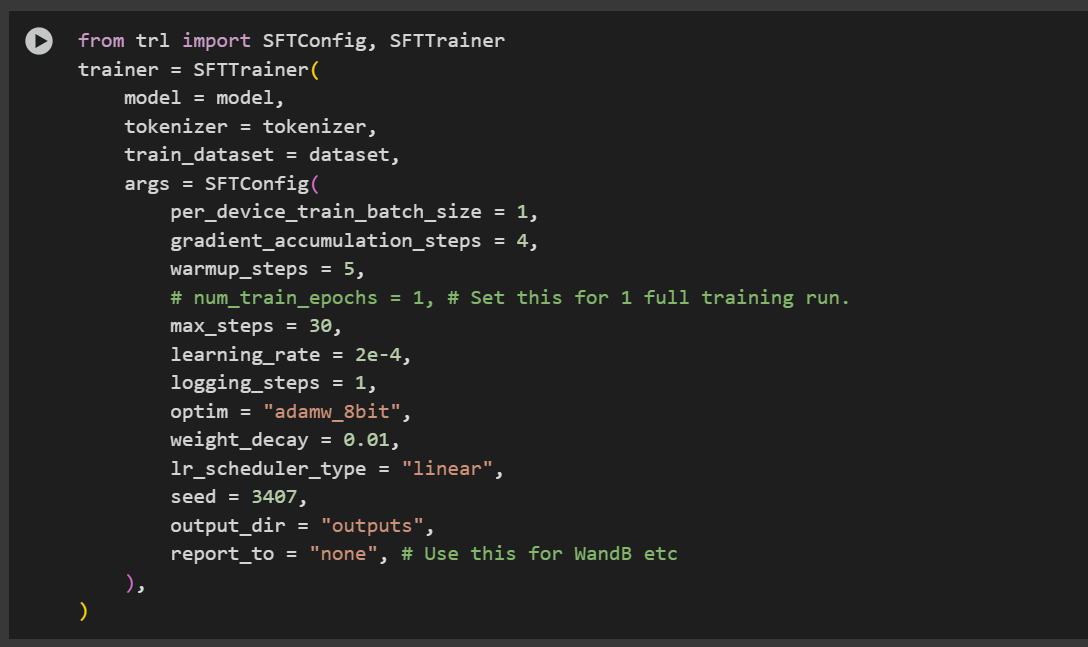
#### Entraîner le modèle
Nous avons présélectionné des hyperparamètres d'entraînement pour des résultats optimaux. Cependant, vous pouvez les modifier selon votre cas d'utilisation spécifique. Consultez notre [guide des hyperparamètres](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
Dans cet exemple, nous entraînons pendant 60 étapes pour accélérer le processus. Pour un entraînement complet, définissez `num_train_epochs=1` et désactivez la limitation des étapes en définissant `max_steps=None`.
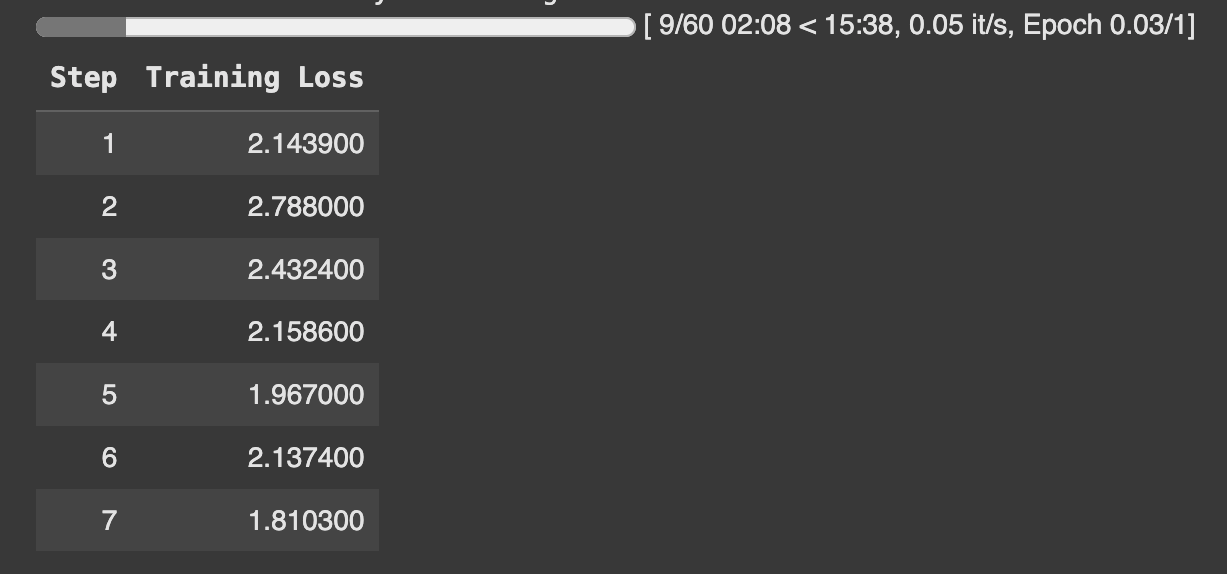
Pendant l'entraînement, surveillez la perte pour vous assurer qu'elle diminue au fil du temps. Cela confirme que le processus d'entraînement fonctionne correctement.
{% endstep %}
{% step %}
#### Inférence : exécutez votre modèle entraîné
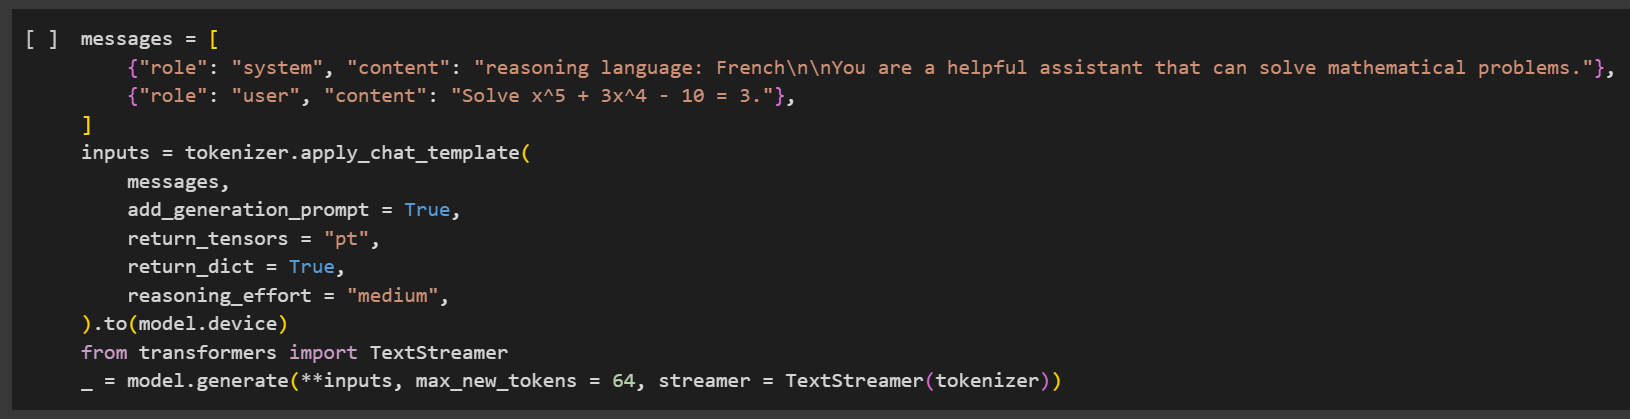
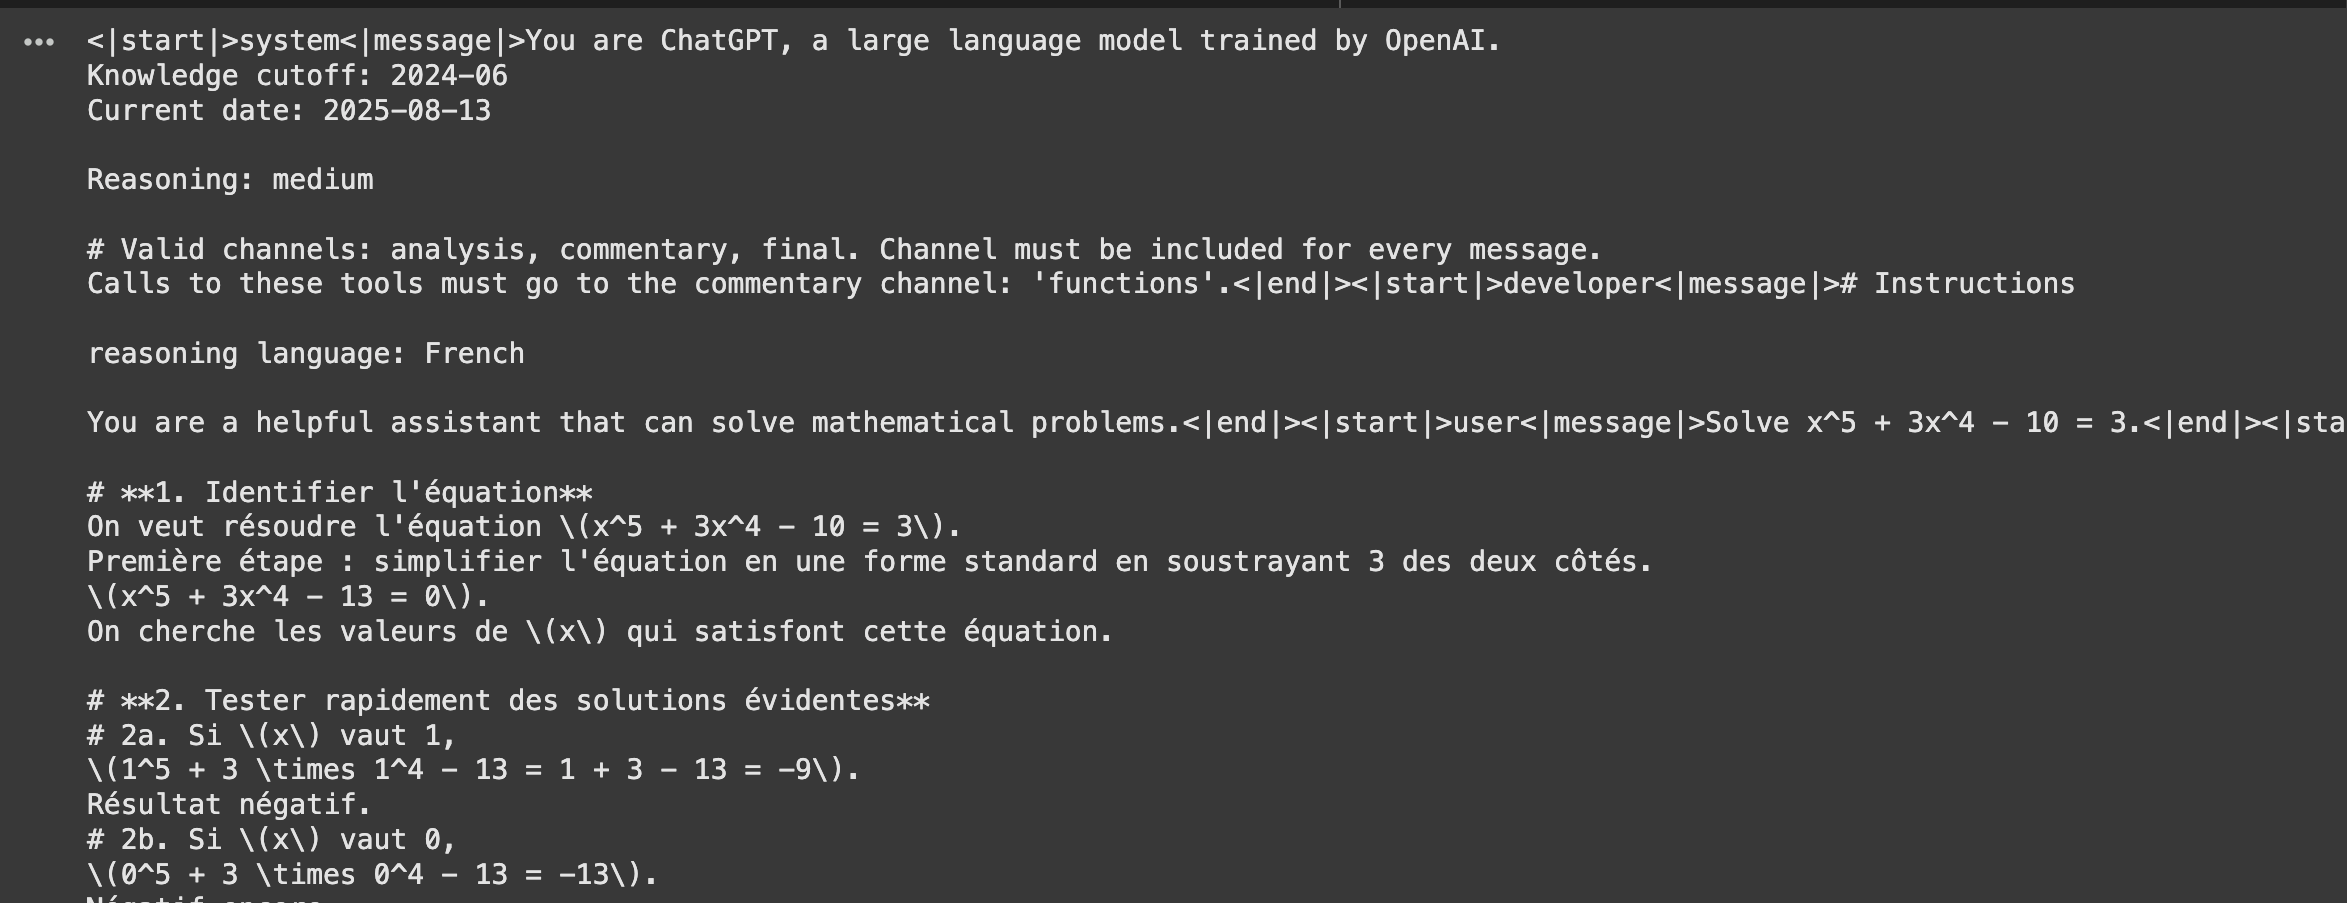
Il est maintenant temps d'exécuter l'inférence avec votre modèle affiné. Vous pouvez modifier l'instruction et l'entrée, mais laissez la sortie vide.
Dans cet exemple, nous testons la capacité du modèle à raisonner en français en ajoutant une instruction spécifique à l'invite système, en suivant la même structure que celle utilisée dans notre ensemble de données.
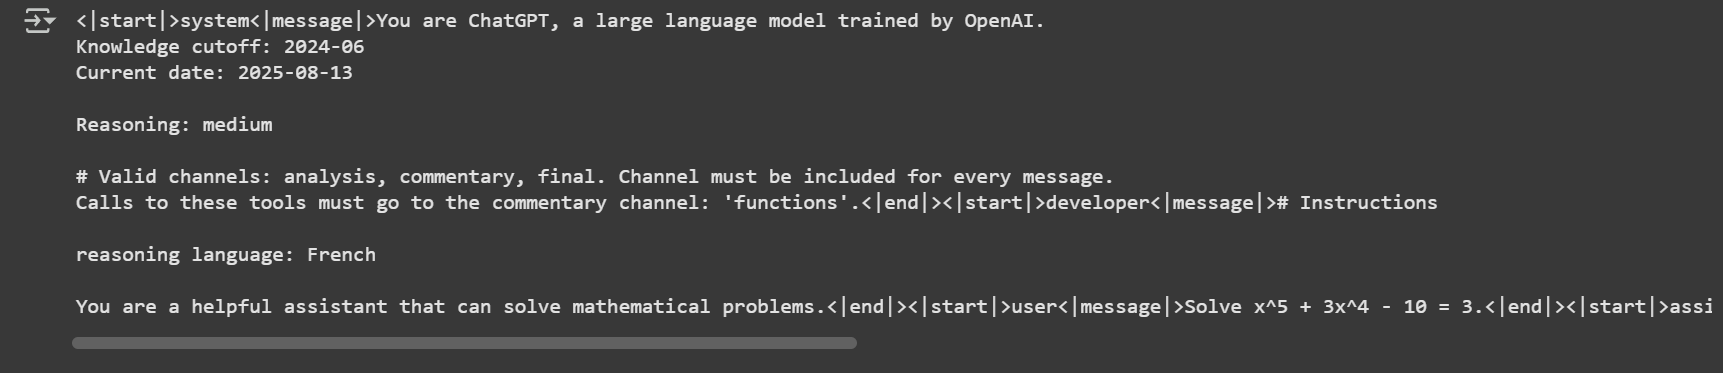
Cela devrait produire une sortie similaire à :
{% endstep %}
{% step %}
#### Enregistrer/exporter votre modèle
Pour enregistrer votre modèle affiné, vous pouvez l'exporter à la fois au format **bf16 ,** avec notre **déquantification à la demande de MXFP4** modèles de base en utilisant `save_method="merged_16bit"`ou au format natif **MXFP4** Safetensors en utilisant `save_method="mxfp4"` .
Le **MXFP4** Le format de fusion natif offre des améliorations de performance significatives par rapport au **bf16 format**: il utilise jusqu'à 75 % d'espace disque en moins, réduit la consommation de VRAM de 50 %, accélère la fusion de 5 à 10x et permet une conversion beaucoup plus rapide au format **GGUF** format.
{% hint style="success" %}
Nouveau : l'enregistrement ou la fusion de modèles QLoRA affinés vers GGUF est désormais pris en charge pour une utilisation dans d'autres frameworks (par ex. Hugging Face, llama.cpp avec GGUF).
{% endhint %}
Après l'affinage de votre modèle gpt-oss, vous pouvez le fusionner en **MXFP4** format avec :
```python
model.save_pretrained_merged(save_directory, tokenizer, save_method="mxfp4)
```
Si vous préférez fusionner le modèle et le pousser directement vers le hub Hugging Face :
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token= hf_token, save_method="mxfp4")
```
#### :sparkles: Enregistrement vers Llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Convertissez le **MXFP4** modèle fusionné :
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned-mxfp4.gguf
```
3. Exécutez l'inférence sur le modèle quantifié :
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-mxfp4.gguf \\
--jinja -ngl 99 --threads -1 --ctx-size 16384 \\
--temp 1.0 --top-p 1.0 --top-k 0 \\
-p "Le sens de la vie et de l'univers est"
```
{% endstep %}
{% endstepper %}
## 🖥️ Affinage local de gpt-oss
Ce chapitre couvre l'affinage de gpt-oss sur votre appareil local. Bien que **gpt-oss-20b** l'affinage puisse fonctionner avec seulement 14 Go de VRAM, nous recommandons d'avoir au moins 16 Go de VRAM disponibles pour garantir des exécutions d'entraînement stables et fiables.
{% hint style="info" %}
Nous recommandons de télécharger ou d'intégrer des éléments de notre Colab [notebooks](/docs/fr/commencer/unsloth-notebooks.md) dans votre configuration locale pour une utilisation plus facile.
{% endhint %}
{% stepper %}
{% step %}
#### Installer Unsloth localement
Assurez-vous que votre appareil est [compatible avec Unsloth](/docs/fr/commencer/fine-tuning-for-beginners/unsloth-requirements.md) et vous pouvez consulter notre détaillé [guide d'installation](/docs/fr/commencer/install.md).
**Vous pouvez également installer Unsloth en utilisant notre** [**image Docker**](https://unsloth.ai/docs/models/qwen3-coder-next)**.**
Notez que `pip install unsloth` ne fonctionnera pas pour cette configuration, car nous devons utiliser la dernière version de PyTorch, Triton et des packages associés. Installez Unsloth en utilisant cette commande spécifique :
```python
# Nous installons la dernière version de Torch, Triton, les kernels Triton d'OpenAI, Transformers et Unsloth !
!pip install --upgrade -qqq uv
try: import numpy; install_numpy = f"numpy=={numpy.__version__}"
except: install_numpy = "numpy"
!uv pip install -qqq \
"torch>=2.8.0" "triton>=3.4.0" {install_numpy} \\
"unsloth_zoo[base] @ git+https://github.com/unslothai/unsloth-zoo" \
"unsloth[base] @ git+https://github.com/unslothai/unsloth" \
torchvision bitsandbytes \\
git+https://github.com/huggingface/transformers \\
git+https://github.com/triton-lang/triton.git@05b2c186c1b6c9a08375389d5efe9cb4c401c075#subdirectory=python/triton_kernels
```
{% endstep %}
{% step %}
#### Configuration de gpt-oss et de l'effort de raisonnement
Nous allons charger **`gpt-oss-20b`** à l'aide de la version linéarisée d'Unsloth [linéarisée](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md#making-efficient-gpt-oss-fine-tuning-work) (car aucune autre version ne fonctionnera pour l'affinage QLoRA). Configurez les paramètres suivants :
* `max_seq_length = 2048`
* Recommandé pour des tests rapides et des expériences initiales.
* `load_in_4bit = True`
* Utilisez `Faux` pour l'entraînement LoRA (remarque : le réglage à `Faux` nécessitera au moins 43 Go de VRAM). Vous ***DEVEZ*** également définir **`model_name = "unsloth/gpt-oss-20b-BF16"`**
from unsloth import FastLanguageModel
import torch
max_seq_length = 1024
dtype = None

# Les modèles pré-quantifiés 4 bits que nous prenons en charge pour un téléchargement 4x plus rapide + aucune erreur OOM.
fourbit_models = [
    "unsloth/gpt-oss-20b-unsloth-bnb-4bit", # Modèle 20B utilisant la quantification bitsandbytes 4 bits
    "unsloth/gpt-oss-120b-unsloth-bnb-4bit",
    "unsloth/gpt-oss-20b", # Modèle 20B utilisant le format MXFP4
    "unsloth/gpt-oss-120b",
] # Plus de modèles sur https://huggingface.co/unsloth

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/gpt-oss-20b",
    dtype = dtype, # Aucun pour la détection automatique
    max_seq_length = max_seq_length, # Choisissez n'importe quelle valeur pour un long contexte !
    load_in_4bit = True,  # Quantification 4 bits pour réduire la mémoire
    full_finetuning = False, # [NOUVEAU !] Nous avons maintenant l'ajustement fin complet !
    # token = "hf_...", # utilisez-en un si vous utilisez des modèles protégés
)
Vous devriez voir une sortie similaire à l'exemple ci-dessous. Remarque : nous modifions explicitement le `dtype` à `float32` afin de garantir un comportement d'entraînement correct.
{% endstep %}
{% step %}
#### Hyperparamètres d'affinage (LoRA)
Il est maintenant temps d'ajuster vos hyperparamètres d'entraînement. Pour aller plus loin sur comment, quand et quoi ajuster, consultez notre [guide détaillé des hyperparamètres](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
{% hint style="info" %}
Pour éviter le [surapprentissage](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting), surveillez votre perte d'entraînement et évitez de définir ces valeurs trop hautes.
{% endhint %}
Cette étape ajoute des adaptateurs LoRA pour un affinage efficace en paramètres. Seuls environ 1 % des paramètres du modèle sont entraînés, ce qui rend le processus nettement plus efficace.
```python
model = FastLanguageModel.get_peft_model(
model,
r = 8, # Choisissez n'importe quel nombre > 0 ! Suggéré : 8, 16, 32, 64, 128
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj",],
lora_alpha = 16,
lora_dropout = 0, # Prend en charge n’importe quelle valeur, mais = 0 est optimisé
bias = "none", # Prend en charge n’importe quelle valeur, mais = "none" est optimisé
# [NOUVEAU] "unsloth" utilise 30 % de VRAM en moins, permet des tailles de lot 2x plus grandes !
use_gradient_checkpointing = "unsloth", # True ou "unsloth" pour un contexte très long
random_state = 3407,
use_rslora = False, # Nous prenons en charge LoRA avec stabilisation du rang
loftq_config = None, # Et LoftQ
)
```
{% endstep %}
{% step %}
#### Préparation des données
Pour cet exemple, nous utiliserons [`HuggingFaceH4/Multilingual-Thinking`](https://huggingface.co/datasets/HuggingFaceH4/Multilingual-Thinking). Cet ensemble de données contient des exemples de raisonnement en chaîne de pensée dérivés de questions d'utilisateurs traduites de l'anglais vers quatre autres langues.
C'est le même ensemble de données référencé dans le cookbook d'affinage d'OpenAI. Le but d'utiliser un ensemble de données multilingue est d'aider le modèle à apprendre et à généraliser les schémas de raisonnement à travers plusieurs langues.
```python
def formatting_prompts_func(examples):
convos = examples["messages"]
texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
return { "text" : texts, }
pass
from datasets import load_dataset
dataset = load_dataset("HuggingFaceH4/Multilingual-Thinking", split="train")
dataset
```
gpt-oss introduit un système d'effort de raisonnement qui contrôle le niveau de raisonnement effectué par le modèle. Par défaut, l'effort de raisonnement est défini sur `faible`, mais vous pouvez le modifier en définissant le `reasoning_effort` paramètre sur `faible`, `moyen` ou `élevé`.
Exemple :
```python
tokenizer.apply_chat_template(
text,
tokenize = False,
add_generation_prompt = False,
reasoning_effort = "medium",
)
```
Pour formater l'ensemble de données, nous appliquons une version personnalisée de l'invite gpt-oss :
```python
from unsloth.chat_templates import standardize_sharegpt
dataset = standardize_sharegpt(dataset)
dataset = dataset.map(formatting_prompts_func, batched = True,)
```
Inspectons l'ensemble de données en affichant le premier exemple :
```notebook-python
print(dataset[0]['text'])
```
Une caractéristique unique de gpt-oss est son utilisation du [**format OpenAI Harmony**](https://github.com/openai/harmony)**,** qui prend en charge les conversations structurées, les sorties de raisonnement et l'appel d'outils. Ce format inclut des balises telles que `<|start|>` , `<|message|>` et `<|return|>` .
{% hint style="info" %}
🦥 Unsloth corrige le modèle de chat pour garantir qu'il est correct. Voir ceci [tweet](https://x.com/danielhanchen/status/1953901104150065544) pour les détails techniques sur notre correction du modèle.
{% endhint %}
N'hésitez pas à adapter l'invite et la structure à votre propre ensemble de données ou cas d'utilisation. Pour plus de conseils, consultez notre [guide de jeu de données](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md).
{% endstep %}
{% step %}
#### Entraîner le modèle
Nous avons présélectionné des hyperparamètres d'entraînement pour des résultats optimaux. Cependant, vous pouvez les modifier selon votre cas d'utilisation spécifique. Consultez notre [guide des hyperparamètres](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md).
Dans cet exemple, nous entraînons pendant 60 étapes pour accélérer le processus. Pour un entraînement complet, définissez `num_train_epochs=1` et désactivez la limitation des étapes en définissant `max_steps=None`.
```python
from trl import SFTConfig, SFTTrainer
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
train_dataset = dataset,
args = SFTConfig(
per_device_train_batch_size = 1,
gradient_accumulation_steps = 4,
warmup_steps = 5,
# num_train_epochs = 1, # Définissez ceci pour un entraînement complet en une seule exécution.
max_steps = 30,
learning_rate = 2e-4,
logging_steps = 1,
optim = "adamw_8bit",
weight_decay = 0.01,
lr_scheduler_type = "linear",
seed = 3407,
output_dir = "outputs",
report_to = "none", # Utiliser cela pour WandB etc.
),
)
```
Pendant l'entraînement, surveillez la perte pour vous assurer qu'elle diminue au fil du temps. Cela confirme que le processus d'entraînement fonctionne correctement.
{% endstep %}
{% step %}
#### Inférence : exécutez votre modèle entraîné
Il est maintenant temps d'exécuter l'inférence avec votre modèle affiné. Vous pouvez modifier l'instruction et l'entrée, mais laissez la sortie vide.
Dans cet exemple, nous testons la capacité du modèle à raisonner en français en ajoutant une instruction spécifique à l'invite système, en suivant la même structure que celle utilisée dans notre ensemble de données.
```python
messages = [
{"role": "system", "content": "langage de raisonnement : français\n\nVous êtes un assistant utile qui peut résoudre des problèmes mathématiques."},
{"role": "user", "content": "Résolvez x^5 + 3x^4 - 10 = 3."},
]
inputs = tokenizer.apply_chat_template(
messages,
add_generation_prompt = True,
return_tensors = "pt",
return_dict = True,
reasoning_effort = "medium",
).to(model.device)
from transformers import TextStreamer
_ = model.generate(**inputs, max_new_tokens = 2048, streamer = TextStreamer(tokenizer))
```
Cela devrait produire une sortie similaire à :
{% endstep %}
{% step %}
#### Enregistrez et exportez votre modèle
Pour enregistrer votre modèle affiné, il peut être exporté au format Safetensors avec notre nouveau **déquantification à la demande de MXFP4** modèles de base (comme gpt-oss) pendant le processus de fusion LoRA. Cela rend possible **d'exporter votre modèle affiné au format bf16**.
{% hint style="success" %}
Nouveau : l'enregistrement ou la fusion de modèles QLoRA affinés vers GGUF est désormais pris en charge pour une utilisation dans d'autres frameworks (par ex. Hugging Face, llama.cpp avec GGUF).
{% endhint %}
Après l'affinage de votre modèle gpt-oss, vous pouvez le fusionner au format 16 bits avec :
```python
model.save_pretrained_merged(save_directory, tokenizer)
```
Si vous préférez fusionner le modèle et le pousser directement vers le hub Hugging Face :
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token= hf_token)
```
#### :sparkles: Enregistrement vers Llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cp
```
2. Convertissez et quantifiez le modèle fusionné :
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned.gguf
llama.cpp/llama-quantize gpt-oss-finetuned.gguf gpt-oss-finetuned-Q8_0.gguf Q8_0
```
3. Exécutez l'inférence sur le modèle quantifié :
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-Q8_0.gguf \\
--jinja -ngl 99 --threads -1 --ctx-size 16384 \\
--temp 1.0 --top-p 1.0 --top-k 0 \\
-p "Le sens de la vie et de l'univers est"
```
{% endstep %}
{% endstepper %}
### 🏁 Et voilà !
Vous avez affiné gpt-oss avec Unsloth. Nous travaillons actuellement sur des implémentations RL et GRPO, ainsi que sur une amélioration de l'enregistrement et de l'exécution des modèles, alors restez à l'écoute.
Comme toujours, n'hésitez pas à passer par notre [Discord](https://discord.com/invite/unsloth) ou [Reddit](https://www.reddit.com/r/unsloth/) si vous avez besoin d'aide.
## ❓FAQ (Foire aux questions)
#### 1. Puis-je exporter mon modèle pour l'utiliser plus tard dans Hugging Face, llama.cpp GGUF ou vLLM ?
Oui, vous pouvez désormais [enregistrer/exporter votre modèle gpt-oss affiné](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#new-saving-to-gguf-vllm-after-gpt-oss-training) avec la nouvelle mise à jour d'Unsloth !
#### 2. Puis-je effectuer un entraînement fp4 ou MXFP4 avec gpt-oss ?
Non, actuellement aucun framework ne prend en charge l'entraînement fp4 ou MXFP4. Unsloth est toutefois le seul framework à prendre en charge l'affinage QLoRA 4 bits pour ce modèle, permettant d'utiliser plus de 4x moins de VRAM.
#### 3. Puis-je exporter mon modèle au format MXFP4 après l'entraînement ?
Non, actuellement aucune bibliothèque ni framework ne prend en charge cela.
#### 4. Puis-je faire de l'apprentissage par renforcement (RL) ou GRPO avec gpt-oss ?
Oui ! Unsloth prend désormais en charge le RL pour gpt-oss avec GRPO/GSPO. Nous avons réussi à le faire fonctionner sur un notebook Kaggle gratuit et obtenu l'inférence la plus rapide pour le RL. [En savoir plus ici](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md)
***
***Remerciements :** Un immense merci à* [*Eyera*](https://huggingface.co/Orenguteng) *pour avoir contribué à ce guide !*
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/tutorial-how-to-fine-tune-gpt-oss.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.