> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md).

# Guide des hyperparamètres de fine-tuning LoRA

Apprenez pas à pas les meilleurs réglages pour le fine-tuning de LLM : rang LoRA et alpha, époques, taille de lot et accumulation de gradients, QLoRA vs LoRA, modules cibles, et plus encore.

Les hyperparamètres LoRA sont des réglages ajustables qui régissent la manière dont l'adaptation de bas rang [s'affine](/docs/fr/commencer/fine-tuning-llms-guide.md) les LLM. Avec de nombreux choix (p. ex., le taux d'apprentissage et les époques) et d'innombrables combinaisons, choisir les bonnes valeurs est essentiel pour la précision, la stabilité, la qualité et la réduction des hallucinations. Bien fait, **LoRA peut égaler les performances d'un affinage complet** tout en utilisant 4× moins de VRAM.

Vous apprendrez les bonnes pratiques pour ces paramètres, fondées sur des analyses de centaines d'articles de recherche et d'expériences, et verrez comment ils influencent le modèle. **Bien que nous recommandions d'utiliser les valeurs par défaut d'Unsloth**, comprendre ces concepts vous donnera un contrôle total.\
\
L'objectif est de modifier les nombres des hyperparamètres pour augmenter la précision tout en contrebalançant [**le surapprentissage ou le sous-apprentissage**](#overfitting-poor-generalization-too-specialized). Le surapprentissage se produit lorsque le modèle mémorise les données d'entraînement, nuisant à sa capacité à généraliser à de nouvelles entrées jamais vues. L'objectif est d'avoir un modèle qui généralise bien, et non un modèle qui mémorise simplement.

{% columns %}
{% column %}

#### :question:Mais qu'est-ce que LoRA ?

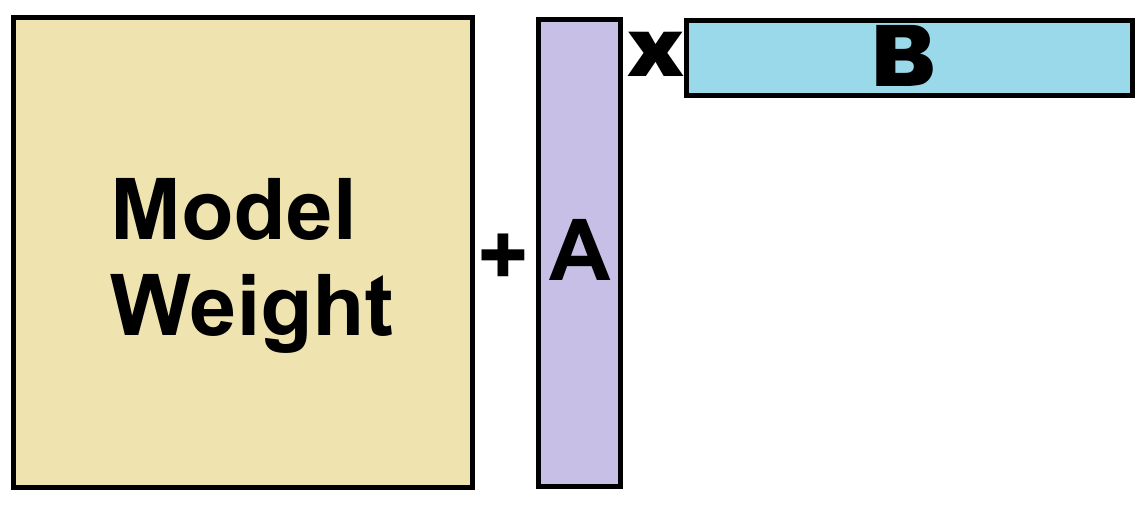
Dans les LLM, nous avons des poids de modèle. Llama 70B a 70 milliards de nombres. Au lieu de modifier les 70 milliards de nombres, nous ajoutons à chaque poids des matrices fines A et B, et nous les optimisons. Cela signifie que nous n'optimisons que 1 % des poids.
{% endcolumn %}

{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-715b6260aae497f160d7f9a1019bcfa472675dcf%2Fimage%20(7)%20(1)%20(1).png?alt=media" alt=""><figcaption><p>Au lieu d’optimiser les poids du modèle (jaune), nous optimisons 2 fines matrices A et B.</p></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

## :1234: Principaux hyperparamètres d'affinage

### **Taux d’apprentissage**

Définit dans quelle mesure les poids du modèle sont ajustés à chaque étape d'entraînement.

* **Taux d'apprentissage plus élevés**: Conduisent à une convergence initiale plus rapide, mais peuvent rendre l'entraînement instable ou l'empêcher de trouver un minimum optimal s'ils sont fixés trop haut.
* **Taux d'apprentissage plus faibles**: Donnent un entraînement plus stable et plus précis, mais peuvent nécessiter davantage d'époques pour converger, augmentant le temps d'entraînement global. Bien que les faibles taux d'apprentissage soient souvent considérés comme causant du sous-apprentissage, ils peuvent en réalité conduire à **un surapprentissage** ou même empêcher le modèle d'apprendre.
* **Plage typique**: `2e-4` (0,0002) à `5e-6` (0.000005).\
  :green\_square: ***Pour un affinage LoRA/QLoRA normal***, *nous recommandons* **`2e-4`** *comme point de départ.*\
  :blue\_square: ***Pour l'apprentissage par renforcement** (DPO, GRPO, etc.), nous recommandons* **`5e-6` .**\
  :white\_large\_square: ***Pour un affinage complet,** des taux d'apprentissage plus faibles sont généralement plus appropriés.*

### **Époques**

Le nombre de fois où le modèle voit l'ensemble complet des données d'entraînement.

* **Plus d'époques :** Peut aider le modèle à mieux apprendre, mais un nombre élevé peut l'amener à **mémoriser les données d'entraînement**, nuisant à ses performances sur de nouvelles tâches.
* **Moins d'époques :** Réduit le temps d'entraînement et peut empêcher le surapprentissage, mais peut produire un modèle insuffisamment entraîné si le nombre est insuffisant pour que le modèle apprenne les schémas sous-jacents du jeu de données.
* **Recommandé :** 1 à 3 époques. Pour la plupart des jeux de données basés sur des instructions, entraîner pendant plus de 3 époques offre des rendements décroissants et augmente le risque de surapprentissage.

### **LoRA ou QLoRA**

LoRA utilise une précision de 16 bits, tandis que QLoRA est une méthode d'affinage en 4 bits.

* **LoRA :** Affinage en 16 bits. C'est légèrement plus rapide et légèrement plus précis, mais consomme nettement plus de VRAM (4× plus que QLoRA). Recommandé pour les environnements 16 bits et les scénarios où une précision maximale est requise.
* **QLoRA :** Affinage en 4 bits. Légèrement plus lent et marginalement moins précis, mais utilise beaucoup moins de VRAM (4× moins).\
  :sloth: *Un LLaMA 70B tient dans <48 Go de VRAM avec QLoRA dans Unsloth -* [*plus de détails ici*](https://unsloth.ai/blog/llama3-3)*.*

### Hyperparamètres et recommandations :

<table><thead><tr><th width="154.39678955078125">Hyperparamètre</th><th width="383.6192626953125">Fonction</th><th>Paramètres recommandés</th></tr></thead><tbody><tr><td><strong>Rang LoRA</strong> (<code>r</code>)</td><td>Contrôle le nombre de paramètres entraînables dans les matrices adaptatrices LoRA. Un rang plus élevé augmente la capacité du modèle mais aussi l'utilisation mémoire.</td><td>8, 16, 32, 64, 128<br><br>Choisissez 16 ou 32</td></tr><tr><td><strong>Alpha LoRA</strong> (<code>lora_alpha</code>)</td><td>Met à l'échelle l'intensité des ajustements affinés par rapport au rang (<code>r</code>).</td><td><code>r</code> (standard) ou <code>r * 2</code> (heuristique courante). <a href="#lora-alpha-and-rank-relationship">Plus de détails ici</a>.</td></tr><tr><td><strong>Dropout LoRA</strong></td><td>Technique de régularisation qui met aléatoirement à zéro une fraction des activations LoRA pendant l'entraînement afin d'empêcher le surapprentissage. <strong>Pas très utile</strong>, donc nous le fixons par défaut à 0.</td><td>0 (par défaut) à 0,1</td></tr><tr><td><strong>Décroissance des poids</strong></td><td>Un terme de régularisation qui pénalise les grands poids afin d'empêcher le surapprentissage et d'améliorer la généralisation. N'utilisez pas des nombres trop élevés !</td><td>0,01 (recommandé) - 0,1</td></tr><tr><td><strong>Étapes de préchauffage</strong></td><td>Augmente progressivement le taux d'apprentissage au début de l'entraînement.</td><td>5 à 10 % du nombre total d'étapes</td></tr><tr><td><strong>Type de planificateur</strong></td><td>Ajuste dynamiquement le taux d'apprentissage pendant l'entraînement.</td><td><code>linéaire</code> ou <code>cosine</code></td></tr><tr><td><strong>Graine (<code>random_state</code>)</strong></td><td>Un nombre fixe pour garantir la reproductibilité des résultats.</td><td>N'importe quel entier (p. ex., <code>42</code>, <code>3407</code>)</td></tr><tr><td><strong>Modules cibles</strong></td><td><p>Spécifie quelles parties du modèle vous souhaitez adapter avec des adaptateurs LoRA — soit l'attention, soit le MLP, soit les deux.</p><p><br>Attention : <code>q_proj, k_proj, v_proj, o_proj</code><br><br>MLP : <code>gate_proj, up_proj, down_proj</code></p></td><td>Il est recommandé de cibler toutes les principales couches linéaires : <code>q_proj, k_proj, v_proj, o_proj, gate_proj, up_proj, down_proj</code>.</td></tr></tbody></table>

## :deciduous\_tree: Équivalence entre accumulation des gradients et taille de lot

### Taille de lot effective

Configurer correctement votre taille de lot est essentiel pour équilibrer la stabilité de l'entraînement avec les limites de VRAM de votre GPU. Cela est géré par deux paramètres dont le produit est **Taille de lot effective**.\
\
**Taille de lot effective** = `batch_size * gradient_accumulation_steps`

* Un **une plus grande taille de lot effective** conduit généralement à un entraînement plus fluide et plus stable.
* Un **une plus petite taille de lot effective** peut introduire davantage de variance.

Bien que chaque tâche soit différente, la configuration suivante constitue un excellent point de départ pour obtenir une **Taille de lot effective** de 16, ce qui fonctionne bien pour la plupart des tâches d'affinage sur les GPU modernes.

| Paramètre                                                     | Description                                                                                                                                                                                                                                                                                                                         | Réglage recommandé                                    |
| ------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------------------------------------------------- |
| **Taille de lot** (`batch_size`)                              | <p>Le nombre d'exemples traités lors d'un seul passage avant/arrière sur un seul GPU.<br><br><strong>Principal moteur de l'utilisation de la VRAM</strong>. Des valeurs plus élevées peuvent améliorer l'utilisation du matériel et accélérer l'entraînement, mais seulement si elles tiennent en mémoire.</p>                      | 2                                                     |
| **Accumulation de gradients** (`gradient_accumulation_steps`) | <p>Le nombre de micro-lots à traiter avant d'effectuer une seule mise à jour des poids du modèle.<br><br><strong>Principal moteur du temps d'entraînement.</strong> Permet de simuler une plus grande <code>batch\_size</code> pour économiser la VRAM. Des valeurs plus élevées augmentent le temps d'entraînement par époque.</p> | 8                                                     |
| **Taille de lot effective** (Calculé)                         | La vraie taille de lot utilisée pour chaque mise à jour des gradients. Elle influence directement la stabilité de l'entraînement, la qualité et les performances finales du modèle.                                                                                                                                                 | <p>4 à 16<br>Recommandé : 16 (à partir de 2 \* 8)</p> |

### Le compromis entre VRAM et performances

Supposons que vous vouliez 32 exemples de données par étape d'entraînement. Vous pouvez alors utiliser l'une des configurations suivantes :

* `batch_size = 32, gradient_accumulation_steps = 1`
* `batch_size = 16, gradient_accumulation_steps = 2`
* `batch_size = 8, gradient_accumulation_steps = 4`
* `batch_size = 4, gradient_accumulation_steps = 8`
* `batch_size = 2, gradient_accumulation_steps = 16`
* `batch_size = 1, gradient_accumulation_steps = 32`

Bien que toutes ces configurations soient équivalentes pour les mises à jour des poids du modèle, elles ont des exigences matérielles très différentes.

La première configuration (`batch_size = 32`) utilise le **plus de VRAM** et échouera probablement sur la plupart des GPU. La dernière configuration (`batch_size = 1`) utilise le **le moins de VRAM,** mais au prix d'un entraînement légèrement plus len&#x74;**.** Pour éviter les erreurs OOM (manque de mémoire), préférez toujours définir une `batch_size` plus petite et augmenter `gradient_accumulation_steps` pour atteindre votre **Taille de lot effective**.

### :sloth: Correctif d'accumulation des gradients d'Unsloth

L'accumulation des gradients et les tailles de lot <mark style="color:vert;">**sont désormais parfaitement équivalentes dans Unsloth**</mark> grâce à nos correctifs de bugs pour l'accumulation des gradients. Nous avons implémenté des correctifs spécifiques pour l'accumulation des gradients qui résolvent un problème courant où les deux méthodes ne produisaient pas les mêmes résultats. C'était un défi connu dans la communauté au sens large, mais pour les utilisateurs d'Unsloth, les deux méthodes sont désormais interchangeables.

[Lisez notre article de blog](https://unsloth.ai/blog/gradient) pour plus de détails.

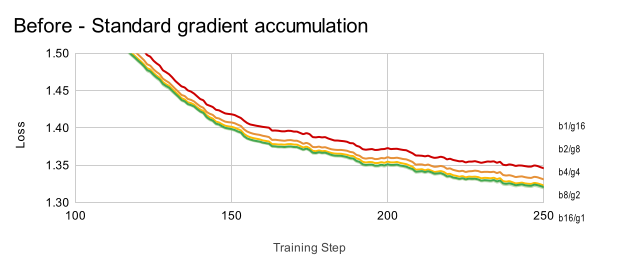
Avant nos correctifs, les combinaisons de `batch_size` et `gradient_accumulation_steps` qui donnaient le même **Taille de lot effective** (c.-à-d., `batch_size × gradient_accumulation_steps = 16`) ne produisaient pas un comportement d'entraînement équivalent. Par exemple, des configurations comme `b1/g16`, `b2/g8`, `b4/g4`, `b8/g2`et `b16/g1` ont toutes un **Taille de lot effective** de 16, mais comme le montre le graphique, les courbes de perte ne s'alignaient pas lors de l'utilisation de l'accumulation standard des gradients :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-66eb907fd9ce38ab29dacef82794d0525057aeb4%2FBefore_-_Standard_gradient_accumulation_UQOFkUggudXuV9dzrh8MA.svg?alt=media" alt=""><figcaption><p>(Avant - accumulation standard des gradients)</p></figcaption></figure>

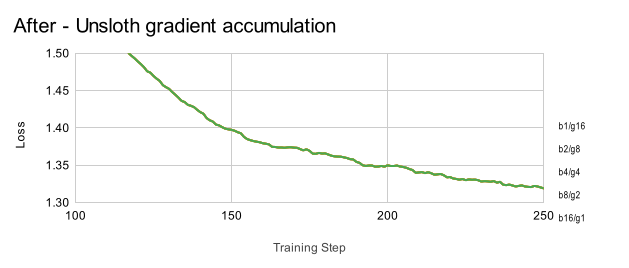
Après l'application de nos correctifs, les courbes de perte s'alignent maintenant correctement, quelle que soit la manière dont le **Taille de lot effective** de 16 est obtenu :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-61f7c60412a2a39584f75cce5dca41e3e35eb7f2%2FAfter_-_Unsloth_gradient_accumulation_6Y4pJdJF0vruzradUpymY.svg?alt=media" alt=""><figcaption><p>(Après - 🦥 <mark style="color:vert;">Accumulation des gradients d'Unsloth</mark>)</p></figcaption></figure>

## 🦥 **Hyperparamètres LoRA dans Unsloth**

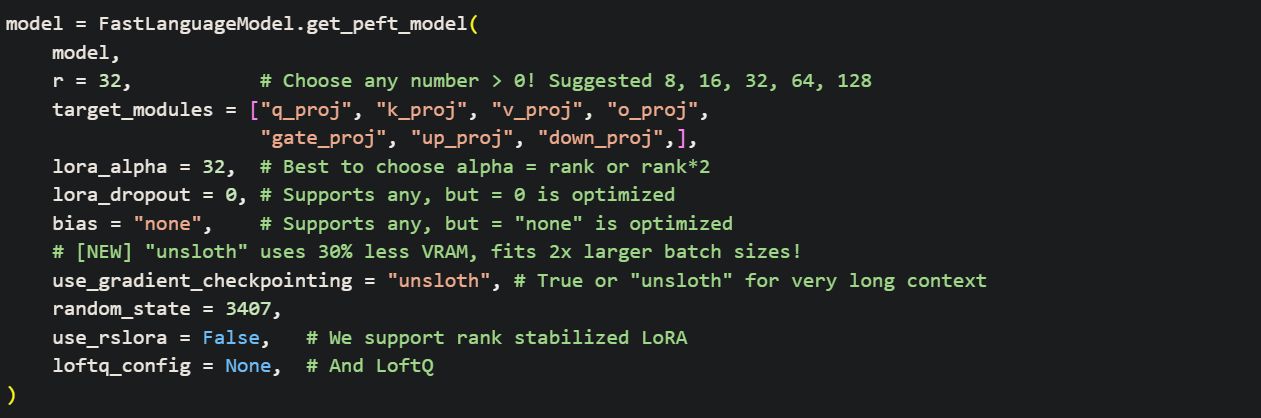
Ce qui suit montre une configuration standard. **Bien qu'Unsloth fournisse des valeurs par défaut optimisées**, comprendre ces paramètres est essentiel pour l'ajustement manuel.

<div data-full-width="false"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-9843f8cc26aac6445236250f5c32394186eace59%2Fnotebook_parameter_screenshott.png?alt=media" alt=""><figcaption></figcaption></figure></div>

1. ```python
   r = 16, # Choisissez n'importe quel nombre > 0 ! Valeurs suggérées : 8, 16, 32, 64, 128
   ```

   Le rang (`r`) du processus d'affinage. Un rang plus élevé utilise plus de mémoire et sera plus lent, mais peut augmenter la précision sur des tâches complexes. Nous suggérons des rangs comme 8 ou 16 (pour des affinages rapides) et jusqu'à 128. Utiliser un rang trop élevé peut provoquer du surapprentissage et nuire à la qualité de votre modèle.\\
2. ```python
   target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj",],
   ```

   Pour des performances optimales, <mark style="background-color:blue;">**LoRA doit être appliqué à toutes les principales couches linéaires**</mark>. [Des recherches ont montré](#lora-target-modules-and-qlora-vs-lora) que cibler toutes les principales couches est crucial pour égaler les performances d'un affinage complet. Bien qu'il soit possible de supprimer des modules pour réduire l'utilisation mémoire, nous le déconseillons fortement afin de préserver une qualité maximale, car les économies sont minimes.\\
3. ```python
   lora_alpha = 16,
   ```

   Un facteur d'échelle qui contrôle l'intensité des ajustements affinés. Le régler égal au rang (`r`) est une base fiable. Une heuristique populaire et efficace consiste à le régler au double du rang (`r * 2`), ce qui amène le modèle à apprendre plus agressivement en donnant plus de poids aux mises à jour LoRA. [Plus de détails ici](#lora-alpha-and-rank-relationship).\\
4. ```python
   lora_dropout = 0, # Prend en charge toutes les valeurs, mais = 0 est optimisé
   ```

   Technique de régularisation qui aide [à empêcher le surapprentissage](#overfitting-poor-generalization-too-specialized) en mettant aléatoirement à zéro une fraction des activations LoRA à chaque étape d'entraînement. [Des recherches récentes suggèrent](https://arxiv.org/abs/2410.09692) que pour **les courtes sessions d'entraînement** courantes dans les affinages, `lora_dropout` peut être un régularisateur peu fiable.\
   🦥 *Le code interne d'Unsloth peut optimiser l'entraînement lorsque* `lora_dropout = 0`*, ce qui le rend légèrement plus rapide, mais nous recommandons une valeur non nulle si vous suspectez du surapprentissage.*\\\\
5. ```python
   bias = "none",    # Prend en charge toutes les valeurs, mais = "none" est optimisé
   ```

   Laissez ceci à `"none"` pour un entraînement plus rapide et une utilisation mémoire réduite. Ce réglage évite d'entraîner les termes de biais dans les couches linéaires, ce qui ajoute des paramètres entraînables pour un gain pratique faible voire nul.\\
6. ```python
   use_gradient_checkpointing = "unsloth", # True ou "unsloth" pour un contexte très long
   ```

   Les options sont `Vrai`, `Faux`et `"unsloth"`.\
   🦥 *Nous recommandons* `"unsloth"` *car cela réduit encore l'utilisation mémoire de 30 % et prend en charge des affinages avec un contexte extrêmement long. Vous pouvez en savoir plus sur* [*notre article de blog sur l'entraînement à long contexte*](https://unsloth.ai/blog/long-context)*.*\\\\
7. ```python
   random_state = 3407,
   ```

   La graine pour garantir des exécutions déterministes et reproductibles. L'entraînement implique des nombres aléatoires, donc définir une graine fixe est essentiel pour des expériences cohérentes.\\
8. ```python
   use_rslora = False,  # Nous prenons en charge LoRA avec stabilisation du rang
   ```

   Fonctionnalité avancée qui implémente [**LoRA à rang stabilisé**](https://arxiv.org/abs/2312.03732). Si elle est définie sur `Vrai`, l'échelle effective devient `lora_alpha / sqrt(r)` au lieu du `lora_alpha / r`. Cela peut parfois améliorer la stabilité, en particulier pour les rangs élevés. [Plus de détails ici](#lora-alpha-and-rank-relationship).\\
9. ```python
   loftq_config = None, # Et LoftQ
   ```

   Technique avancée, telle que proposée dans [**LoftQ**](https://arxiv.org/abs/2310.08659), initialise les matrices LoRA avec les 'r' principaux vecteurs singuliers des poids préentraînés. Cela peut améliorer la précision, mais peut provoquer une hausse significative de la mémoire au début de l'entraînement.

### **Vérification des mises à jour des poids LoRA :**

Lors de la validation que **LoRA** les poids de l'adaptateur ont été mis à jour après l'affinage, évitez d'utiliser **np.allclose()** pour la comparaison. Cette méthode peut manquer des changements subtils mais significatifs, en particulier dans **LoRA A**, qui est initialisé avec de petites valeurs gaussiennes. Ces changements peuvent ne pas être considérés comme significatifs avec des tolérances numériques lâches. Merci à [contributeurs](https://github.com/unslothai/unsloth/issues/3035) pour cette section.

Pour confirmer de manière fiable les mises à jour des poids, nous recommandons :

* L'utilisation de **comparaisons de somme de contrôle ou de hachage** (p. ex., MD5)
* Le calcul de la **somme des différences absolues** entre les tenseurs
* L'inspection des statistiques des t**enseurs** (p. ex., moyenne, variance) manuellement
* Ou l'utilisation de **np.array\_equal()** si une égalité exacte est attendue

## :triangular\_ruler:Relation entre LoRA Alpha et le rang

{% hint style="success" %}
Il vaut mieux définir `lora_alpha = 2 * lora_rank` ou `lora_alpha = lora_rank`
{% endhint %}

{% columns %}
{% column width="50%" %}
$$
\hat{W} = W + \frac{\alpha}{\text{rank}} \times AB
$$

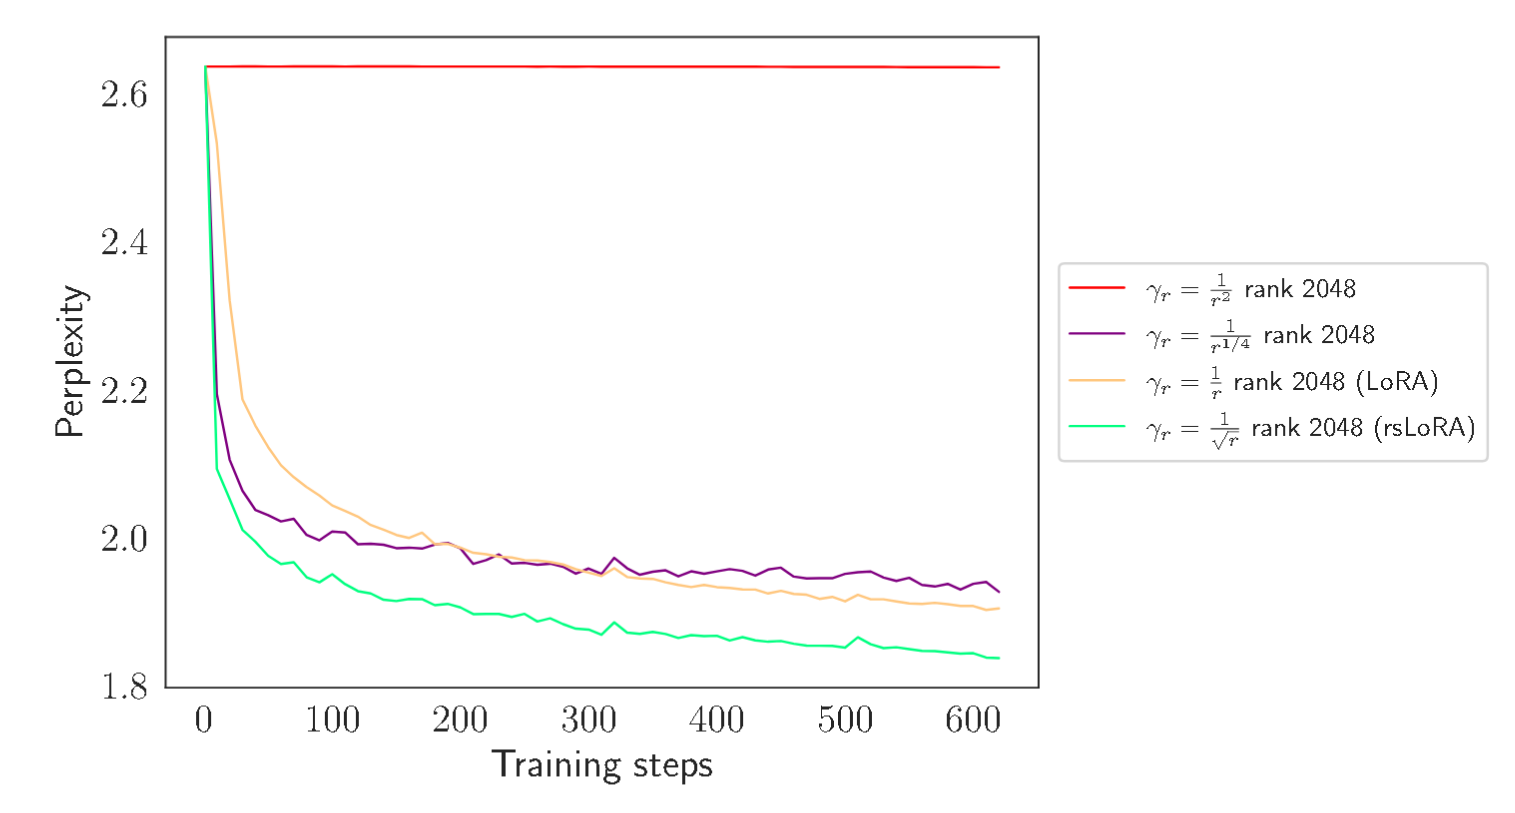
<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8e4f60c002f22e8ca9c534b48323e9e77e4b5ea6%2Fimage.png?alt=media" alt=""><figcaption><p>rsLoRA autres options d'échelle. sqrt(r) est la meilleure.</p></figcaption></figure>

$$
\hat{W}\_{\text{rslora}} = W + \frac{\alpha}{\sqrt{\text{rank}}} \times AB
$$
{% endcolumn %}

{% column %}
La formule de LoRA est à gauche. Nous devons mettre à l'échelle les matrices fines A et B par alpha divisé par le rang. <mark style="background-color:blue;">**Cela signifie que nous devrions garder alpha/rang au moins = 1**</mark>.

Selon le [article rsLoRA (LoRA à rang stabilisé)](https://arxiv.org/abs/2312.03732), nous devrions plutôt mettre alpha à l'échelle par la racine carrée du rang. D'autres options existent, mais théoriquement c'est l'optimum. Le graphique de gauche montre d'autres rangs et leurs perplexités (plus bas est mieux). Pour activer cela, définissez `use_rslora = True` dans Unsloth.

Nous recommandons de définir le <mark style="background-color:green;">**alpha égal au rang, ou au moins 2 fois le rang.**</mark> Cela signifie que alpha/rang = 1 ou 2.
{% endcolumn %}
{% endcolumns %}

## :dart: Modules cibles LoRA et QLoRA vs LoRA

{% hint style="success" %}
Utilisez :\
`target_modules = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj",]` pour cibler à la fois les couches **MLP** et **d'attention** afin d'augmenter la précision.

**QLoRA utilise une précision de 4 bits**, réduisant l'utilisation de la VRAM de plus de 75 %.

**LoRA (16 bits)** est légèrement plus précis et plus rapide.
{% endhint %}

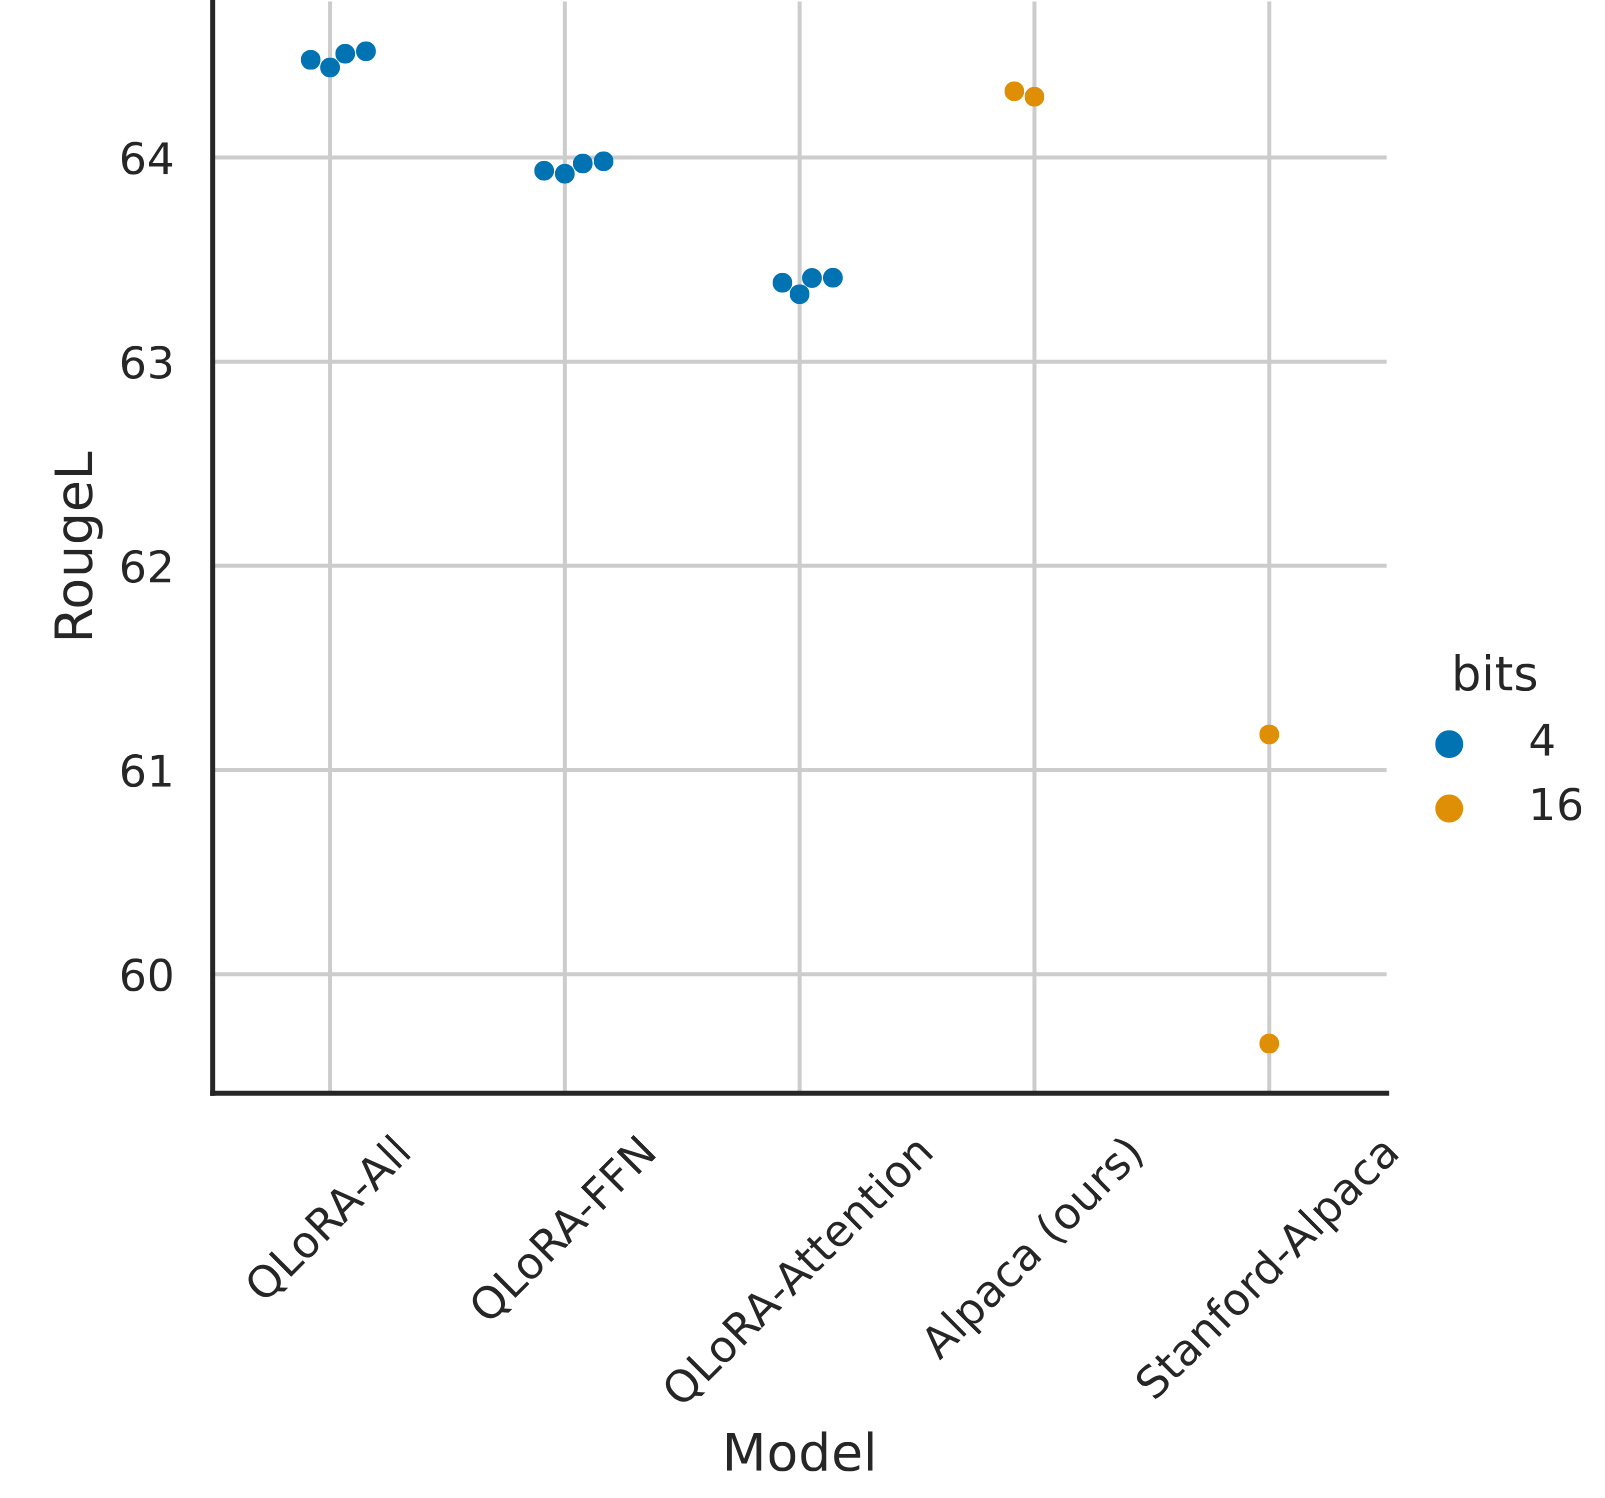
Selon des expériences empiriques et des articles de recherche comme le papier original [QLoRA](https://arxiv.org/pdf/2305.14314), il est préférable d'appliquer LoRA à la fois aux couches d'attention et de MLP.

{% columns %}
{% column %}

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-16bef8165ccace21d0533f1941b8268a165c6a37%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
Le graphique montre les scores RougeL (plus haut est mieux) pour différentes configurations de modules cibles, en comparant LoRA et QLoRA.

Les 3 premiers points montrent :

1. **QLoRA-All :** LoRA appliqué à toutes les couches FFN/MLP et d'attention.\
   :fire: *C'est ce qui donne les meilleures performances globales.*
2. **QLoRA-FFN**: LoRA uniquement sur FFN.\
   Équivalent à : `gate_proj`, `up_proj`, `down_proj.`
3. **QLoRA-Attention**: LoRA appliqué uniquement aux couches d'attention.\
   Équivalent à : `q_proj`, `k_proj`, `v_proj`, `o_proj`.
   {% endcolumn %}
   {% endcolumns %}

## :sunglasses: Entraînement uniquement sur les complétions, masquant les entrées

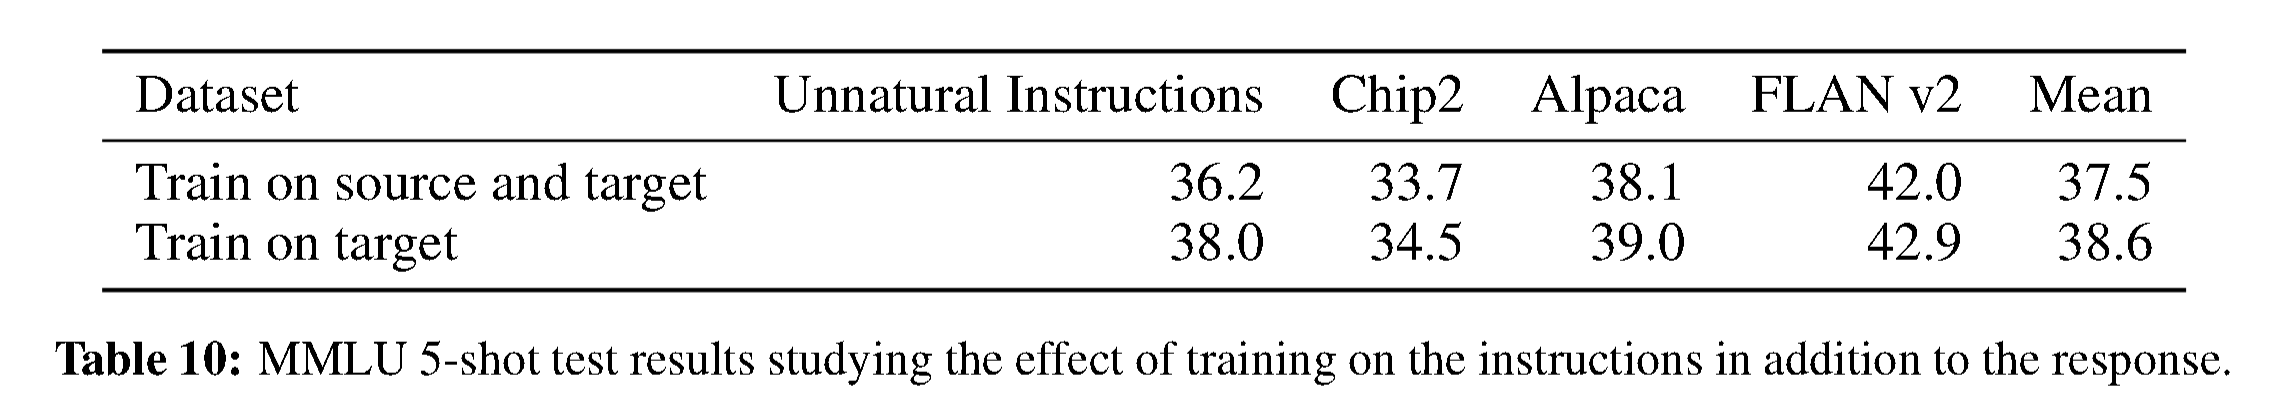
Le [QLoRA](https://arxiv.org/pdf/2305.14314) montre que masquer les entrées et **entraîner uniquement sur les complétions** (sorties ou messages de l'assistant) peut encore **augmenter la précision** de quelques points de pourcentage (*1%*). Ci-dessous, on montre comment cela se fait dans Unsloth :

{% columns %}
{% column %}
**PAS** entraînement uniquement sur les complétions :

**UTILISATEUR :** <mark style="background-color:green;">Bonjour, combien font 2+2 ?</mark>\
**ASSISTANT :** <mark style="background-color:green;">La réponse est 4.</mark>\
**UTILISATEUR :** <mark style="background-color:green;">Bonjour, combien font 3+3 ?</mark>\
**ASSISTANT :** <mark style="background-color:green;">La réponse est 6.</mark>
{% endcolumn %}

{% column %}
**Entraînement** sur les complétions uniquement :

**UTILISATEUR :** ~~Bonjour, combien font 2+2 ?~~\
**ASSISTANT :** <mark style="background-color:green;">La réponse est 4.</mark>\
**UTILISATEUR :** ~~Bonjour, combien font 3+3 ?~~\
**ASSISTANT :** <mark style="background-color:green;">La réponse est 6</mark><mark style="background-color:green;">**.**</mark>
{% endcolumn %}
{% endcolumns %}

L'article QLoRA indique que **l'entraînement uniquement sur les complétions** augmente beaucoup la précision, en particulier pour les affinages conversationnels à plusieurs tours ! Nous faisons cela dans nos [carnets conversationnels ici](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(1B_and_3B\)-Conversational.ipynb).

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e73b480d1db1dd3d52dd0d4a7e24caff6a54be0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Pour permettre **entraînement sur les complétions** dans Unsloth, vous devrez définir les parties instruction et assistant. :sloth: *Nous prévoyons d'automatiser encore davantage cela pour vous à l'avenir !*

Pour les modèles Llama 3, 3.1, 3.2, 3.3 et 4, vous définissez les parties comme suit :

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
)
```

Pour les modèles Gemma 2, 3, 3n, vous définissez les parties comme suit :

```python
from unsloth.chat_templates import train_on_responses_only
trainer = train_on_responses_only(
    trainer,
    instruction_part = "<start_of_turn>user\n",
    response_part = "<start_of_turn>model\n",
)
```

## &#x20;:mag\_right:Entraînement uniquement sur les réponses de l'assistant pour les modèles de vision, VLM

Pour les modèles de langage, nous pouvons utiliser `from unsloth.chat_templates import train_on_responses_only` comme décrit précédemment. Pour les modèles de vision, utilisez les arguments supplémentaires dans `UnslothVisionDataCollator` comme avant !

{% code overflow="wrap" %}

```python
class UnslothVisionDataCollator:
def __init__(
    self,
    ...
    # from unsloth.chat_templates import train_on_responses_only
    # trainer = train_on_responses_only(
    #     trainer,
    #     instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    #     response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    # )
    train_on_responses_only = False, # ÉQUIVALENT à train_on_responses_only pour les LLM
    instruction_part = None, # ÉQUIVALENT à train_on_responses_only(instruction_part = ...)
    response_part    = None, # ÉQUIVALENT à train_on_responses_only(response_part = ...)
    force_match      = True, # Faire correspondre aussi les retours à la ligne !
)
```

{% endcode %}

Par exemple pour Llama 3.2 Vision :

```python
UnslothVisionDataCollator(
    model, tokenizer,
    ...
    train_on_responses_only = True,
    instruction_part = "<|start_header_id|>user<|end_header_id|>\n\n",
    response_part = "<|start_header_id|>assistant<|end_header_id|>\n\n",
    ...
)
```

## :key: **Éviter le surapprentissage et le sous-apprentissage**

### **Surapprentissage** (Mauvaise généralisation / trop spécialisé)

Le modèle mémorise les données d'entraînement, y compris leur bruit statistique, et ne parvient donc pas à généraliser à des données inédites.

{% hint style="success" %}
Si votre perte d'entraînement descend sous 0,2, votre modèle est probablement **un surapprentissage** — ce qui signifie qu'il peut mal performer sur des tâches inédites.

Une astuce simple consiste à mettre à l'échelle alpha de LoRA — il suffit de multiplier la valeur alpha de chaque matrice LoRA par 0,5. Cela réduit effectivement l'impact du fine-tuning.

**Cela est étroitement lié à la fusion / au moyennage des poids.**\
Vous pouvez prendre le modèle de base original (ou instruct), ajouter les poids LoRA, puis diviser le résultat par 2. Cela vous donne un modèle moyenné — ce qui est fonctionnellement équivalent à réduire `alpha` de moitié.
{% endhint %}

**Solution :**

* **Ajustez le taux d'apprentissage :** Un taux d'apprentissage élevé conduit souvent au surapprentissage, surtout lors de courtes sessions d'entraînement. Pour un entraînement plus long, un taux d'apprentissage plus élevé peut mieux fonctionner. Il est préférable d'expérimenter avec les deux pour voir lequel donne les meilleurs résultats.
* **Réduisez le nombre d'époques d'entraînement**. Arrêtez l'entraînement après 1, 2 ou 3 époques.
* **Augmentez** `weight_decay`. Une valeur de `0.01` ou `0.1` est un bon point de départ.
* **Augmentez** `lora_dropout`. Utilisez une valeur comme `0.1` pour ajouter de la régularisation.
* **Augmentez la taille du lot ou les étapes d'accumulation des gradients**.
* **Expansion du jeu de données** - rendez votre jeu de données plus grand en combinant ou en concaténant des jeux de données open source avec votre jeu de données. Choisissez ceux de meilleure qualité.
* **Arrêt anticipé sur évaluation** - activez l'évaluation et arrêtez-vous lorsque la perte d'évaluation augmente pendant quelques étapes.
* **Mise à l'échelle de l'alpha LoRA** - réduisez l'alpha après l'entraînement et pendant l'inférence - cela rendra le fine-tuning moins marqué.
* **Moyennage des poids** - additionnez littéralement le modèle instruct original et le fine-tune, puis divisez les poids par 2.

### **Sous-apprentissage** (Trop générique)

Le modèle ne parvient pas à capturer les schémas sous-jacents des données d'entraînement, souvent en raison d'une complexité ou d'une durée d'entraînement insuffisante.

**Solution :**

* **Ajustez le taux d'apprentissage :** Si le taux actuel est trop faible, l'augmenter peut accélérer la convergence, surtout pour de courtes sessions d'entraînement. Pour des sessions plus longues, essayez plutôt de réduire le taux d'apprentissage. Testez les deux approches pour voir laquelle fonctionne le mieux.
* **Augmentez le nombre d'époques d'entraînement :** Entraînez-vous sur davantage d'époques, mais surveillez la perte de validation pour éviter le surapprentissage.
* **Augmentez le rang LoRA** (`r`) et alpha : le rang doit être au moins égal à la valeur alpha, et il doit être plus grand pour les modèles plus petits / les ensembles de données plus complexes ; il se situe généralement entre 4 et 64.
* **Utilisez un jeu de données plus pertinent pour le domaine**: Assurez-vous que les données d'entraînement sont de haute qualité et directement pertinentes pour la tâche cible.
* **Réduisez la taille du lot à 1**. Cela amènera le modèle à se mettre à jour plus vigoureusement.

{% hint style="success" %}
Le fine-tuning n'a pas une seule approche « meilleure », seulement des bonnes pratiques. L'expérimentation est essentielle pour trouver ce qui fonctionne pour vos besoins spécifiques. Nos notebooks définissent automatiquement des paramètres optimaux sur la base de nombreux articles de recherche et de nos expériences, vous offrant ainsi un excellent point de départ. Bon fine-tuning !
{% endhint %}

***Remerciements :** Un immense merci à* [*Eyera*](https://huggingface.co/Orenguteng) *pour avoir contribué à ce guide !*


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.