> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
# Entraînement gpt-oss à long contexte
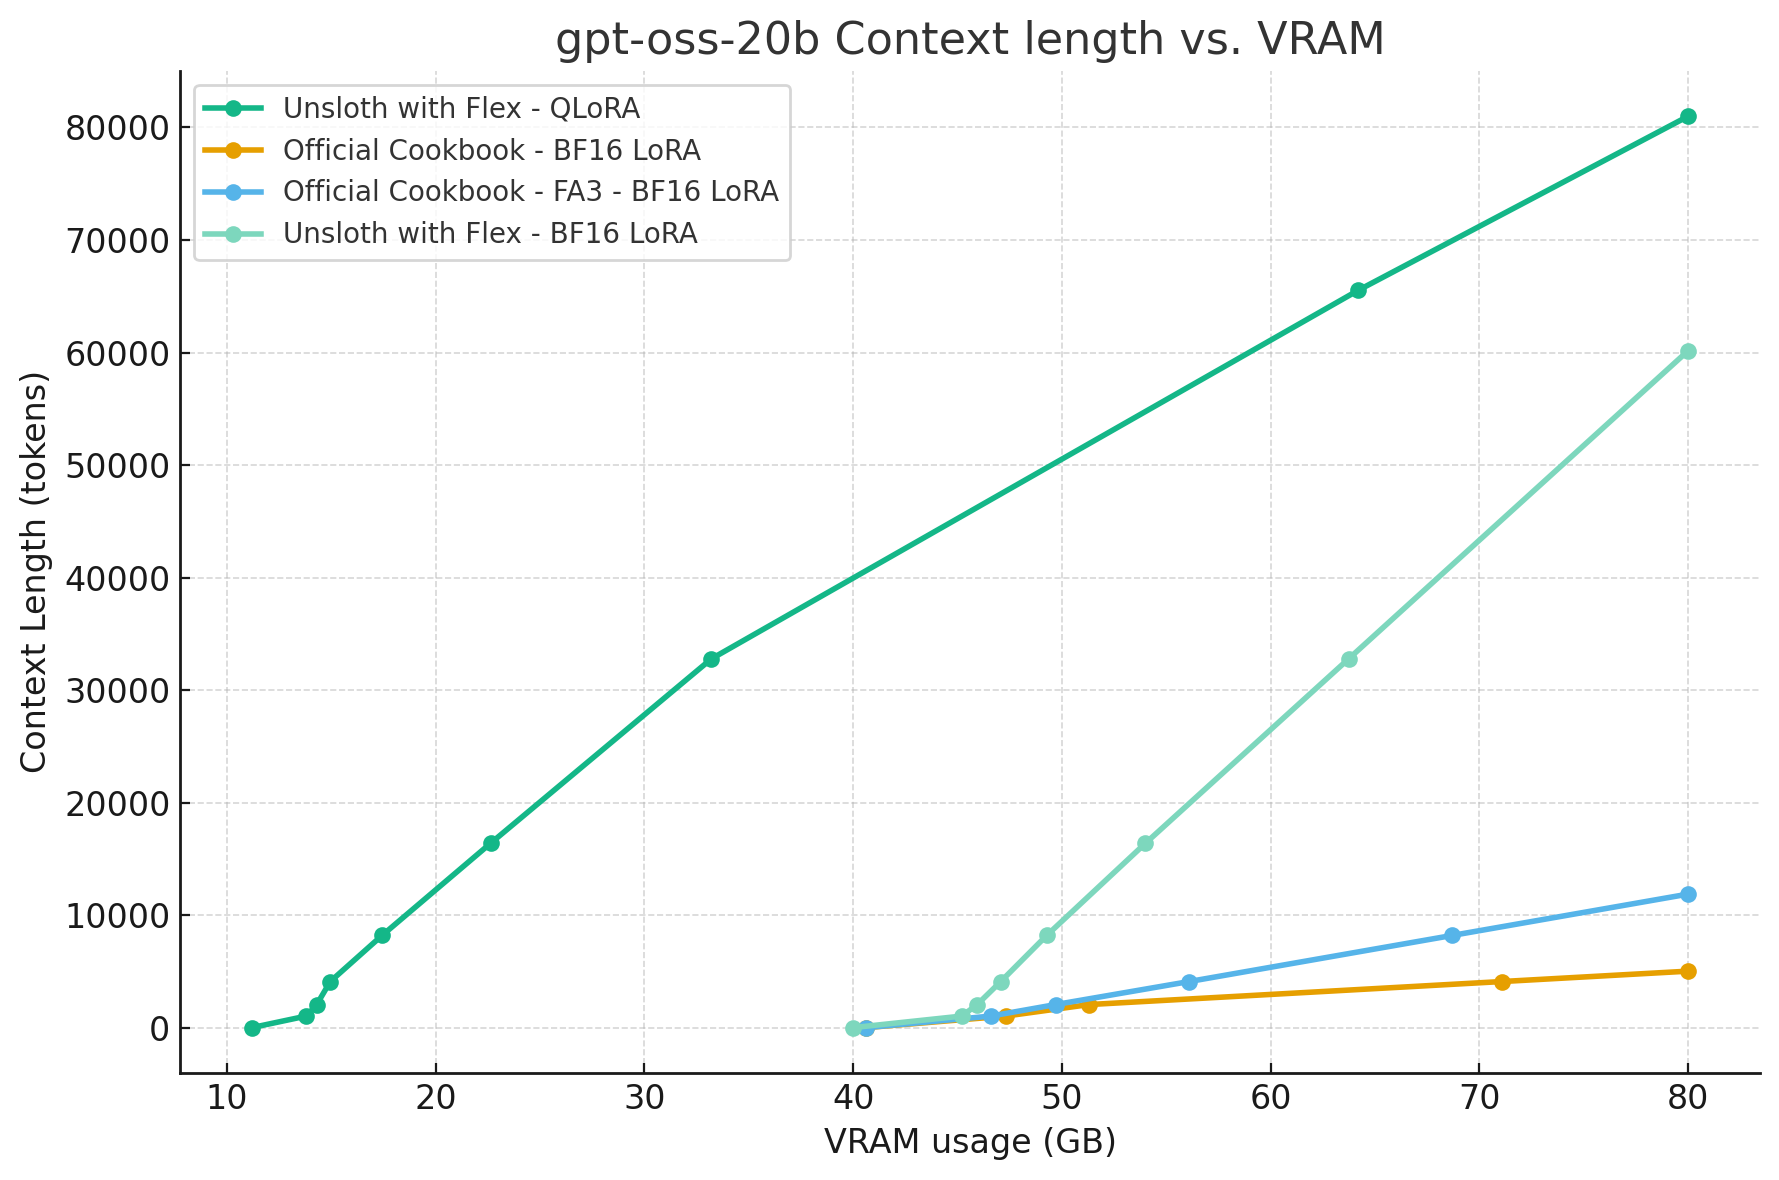
Nous sommes ravis de présenter la prise en charge d'Unsloth Flex Attention pour l'entraînement OpenAI gpt-oss, ce qui permet **>8× plus longues longueurs de contexte**, **>50 % d'utilisation de VRAM en moins** et **>1,5× plus rapide (sans dégradation de la précision)** par rapport à toutes les implémentations, y compris celles utilisant Flash Attention 3 (FA3). Unsloth Flex Attention rend possible l'entraînement avec une **longueur de contexte de 60K** sur un GPU H100 de 80 Go de VRAM pour BF16 LoRA. Aussi :
* Vous pouvez [exporter/enregistrer maintenant](#new-saving-to-gguf-vllm-after-gpt-oss-training) votre modèle gpt-oss affiné par QLoRA vers llama.cpp, vLLM, Ollama ou HF
* Nous [**corrections de l'entraînement de gpt-oss**](#bug-fixes-for-gpt-oss) **des pertes qui divergeaient vers l'infini** sur les GPU float16 (comme T4 Colab)
* Nous [implémentation gpt-oss corrigée](#bug-fixes-for-gpt-oss) problèmes sans rapport avec Unsloth, notamment s'assurer que `swiglu_limit = 7.0` est correctement appliqué pendant l'inférence MXFP4 dans transformers
## 🦥Présentation de la prise en charge d'Unsloth Flex Attention
Avec la prise en charge Flex Attention d'Unsloth, un seul H100 de 80 Go de VRAM peut gérer jusqu'à une longueur de contexte de 81K avec QLoRA et 60K de contexte avec BF16 LoRA ! Ces gains s'appliquent à **LES DEUX** gpt-oss-20b et **gpt-oss-120b**! Plus vous utilisez de longueur de contexte, plus vous gagnerez avec Unsloth Flex Attention :
En comparaison, toutes les autres implémentations non-Unsloth plafonnent à une longueur de contexte de 9K sur un GPU de 80 Go, et ne peuvent atteindre que 15K de contexte avec FA3. Mais, **FA3 ne convient pas à l'entraînement de gpt-oss car il ne prend pas en charge le passage arrière pour les puits d'attention**. Donc si vous utilisiez auparavant FA3 pour l'entraînement de gpt-oss, nous vous recommandons de **ne pas l'utiliser** pour l'instant. Ainsi, la longueur de contexte maximale que vous pouvez obtenir sans Unsloth sur 80 Go de VRAM est d'environ 9K.
L'entraînement avec Unsloth Flex Attention offre au moins un gain de vitesse de 1,3×, les gains augmentant avec la longueur de contexte jusqu'à atteindre 2× plus rapide. Comme Flex Attention s'adapte au contexte, des séquences plus longues permettent de plus grandes économies de VRAM et de temps d'entraînement, comme [décrit ici](#unsloths-flex-attention-implementation).
Un immense merci à Rohan Pandey pour son [implémentation de Flex Attention](https://x.com/khoomeik/status/1955693558914310608), qui a directement inspiré le développement de l'implémentation Flex Attention d'Unsloth.
## :dark\_sunglasses: Puits d'attention
Le modèle GPT OSS d'OpenAI utilise un **schéma alterné d'attention à fenêtre glissante, d'attention complète**, d'attention à fenêtre glissante, etc. (SWA, FA, SWA, FA, etc.). Chaque fenêtre glissante n'accorde son attention qu'aux **128 jetons** (y compris le jeton courant), ce qui réduit énormément le calcul. Cependant, cela signifie aussi que la récupération et le raisonnement sur de longs contextes deviennent inutiles à cause de la petite fenêtre glissante. La plupart des laboratoires corrigent cela en élargissant la fenêtre glissante à 2048 ou 4096 jetons.
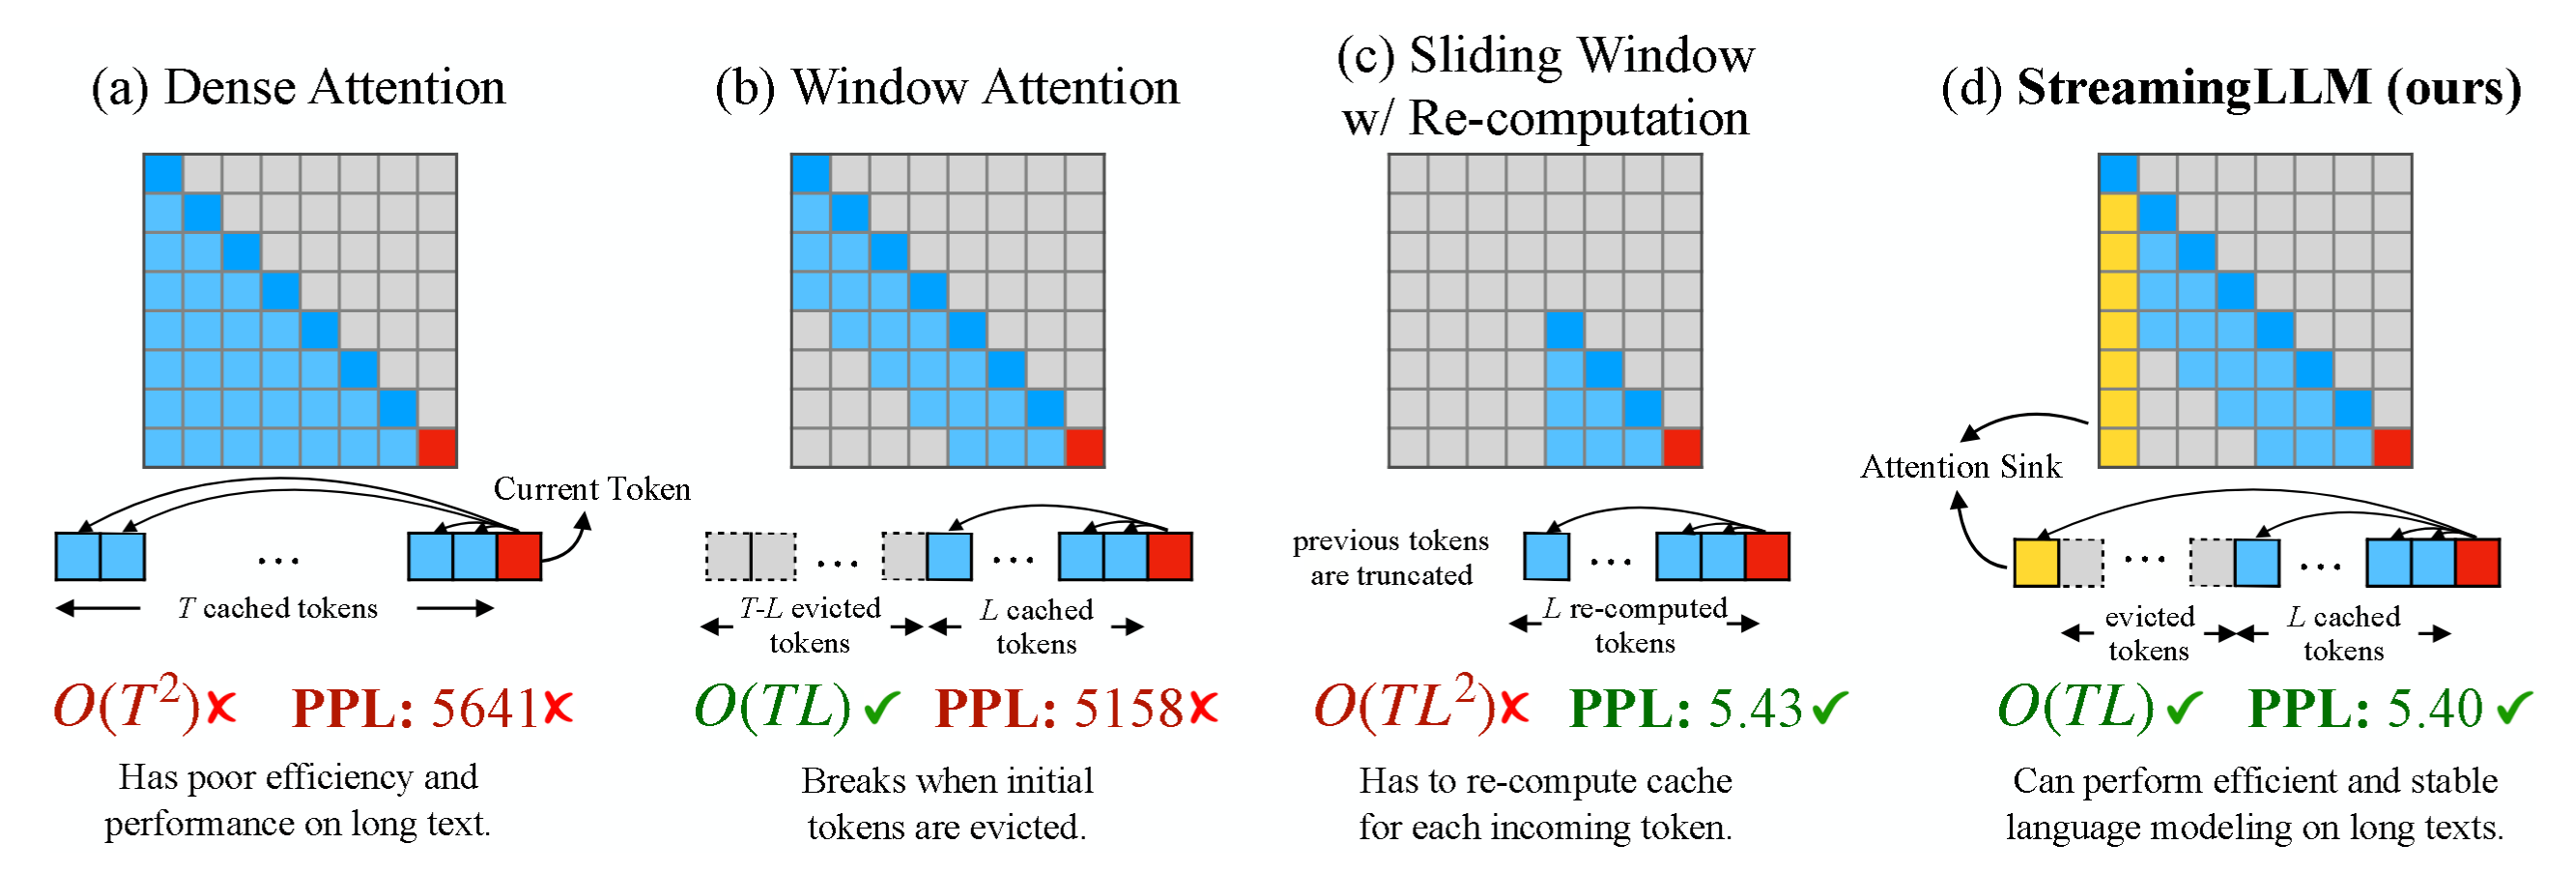
OpenAI s'est appuyé sur **Puits d'attention** les idées tirées de l'article Efficient Streaming Language Models with Attention Sinks [article](https://arxiv.org/abs/2309.17453) qui montre qu'on peut utiliser une petite fenêtre glissante, à condition d'ajouter une attention globale sur le premier jeton ! L'article fournit une bonne illustration ci-dessous :
L'article constate que le **mécanisme d'attention semble attribuer beaucoup de poids aux premiers jetons (1 à 4)**, et en les supprimant pendant l'opération de fenêtre glissante, ces premiers jetons « importants » disparaissent, ce qui entraîne une mauvaise récupération sur long contexte.
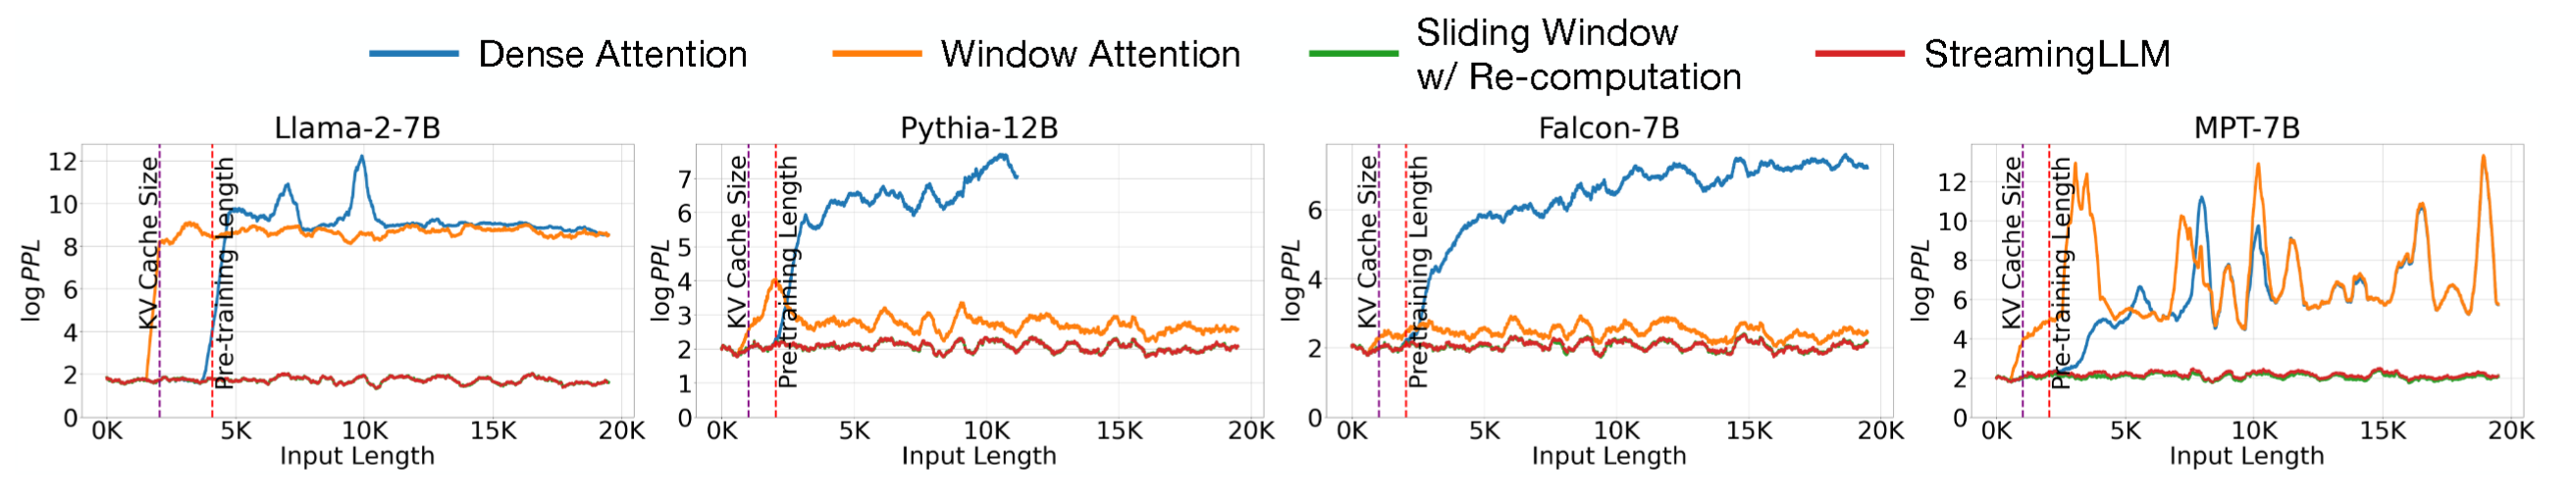
Si nous traçons la perplexité logarithmique (plus elle est élevée, pire c'est), et effectuons une inférence sur long contexte après la longueur de contexte définie du modèle préentraîné, nous voyons la perplexité grimper en flèche (pas bon). Cependant la ligne rouge (qui utilise Attention Sinks) reste basse, ce qui est très bien !
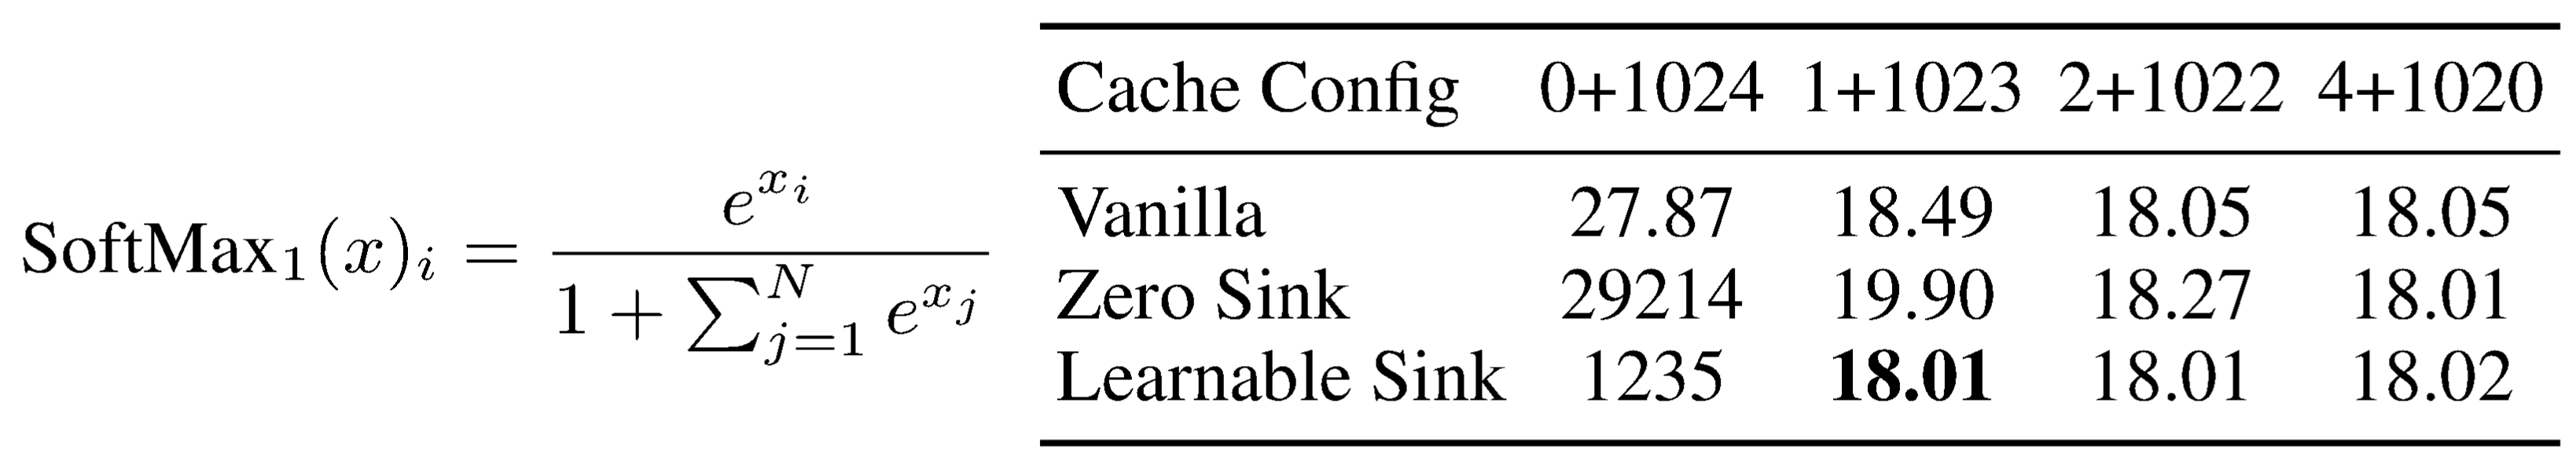
L'article montre aussi que la [méthode Attention Is Off By One](https://www.evanmiller.org/attention-is-off-by-one.html) fonctionne partiellement, sauf qu'il faut aussi ajouter quelques jetons puits supplémentaires pour obtenir des perplexités plus faibles. **L'article montre que l'ajout d'un seul jeton puits apprenable donne des résultats remarquablement bons ! Et c'est ce qu'OpenAI a fait pour GPT-OSS !**
## :triangular\_ruler:L'implémentation Flex Attention d'Unsloth
Flex Attention est extrêmement puissante, car elle offre au praticien 2 voies de personnalisation du mécanisme d'attention - un **modificateur de score (f)** et un **fonction de masquage (M)**.
Le **modificateur de score (f)** nous permet de modifier les logits d'attention avant l'opération softmax, et **fonction de masquage (M)** nous permet de sauter des opérations si nous n'en avons pas besoin (par ex. l'attention à fenêtre glissante ne voit que les 128 derniers jetons).
**L'astuce est que Flex Attention fournit des noyaux Triton rapides générés automatiquement avec des modificateurs de score et des fonctions de masquage arbitraires !**
\sigma\bigg(s\times\bold{f}(QK^T+\bold{M})\bigg)
Cela signifie que nous pouvons utiliser Flex Attention pour implémenter les puits d'attention ! L'implémentation d'un seul puits d'attention est fournie à la fois dans [le dépôt GPT-OSS original d'OpenAI](#implementations-for-sink-attention) et l'implémentation de transformers de Hugging Face.
```python
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
probs = F.softmax(combined_logits, dim=-1)
scores = probs[..., :-1]
```
Ce qui précède montre que nous concaténons le puits tout à la fin du `Q @ K.T` , effectuons le softmax, puis supprimons la dernière colonne qui était le jeton puits.
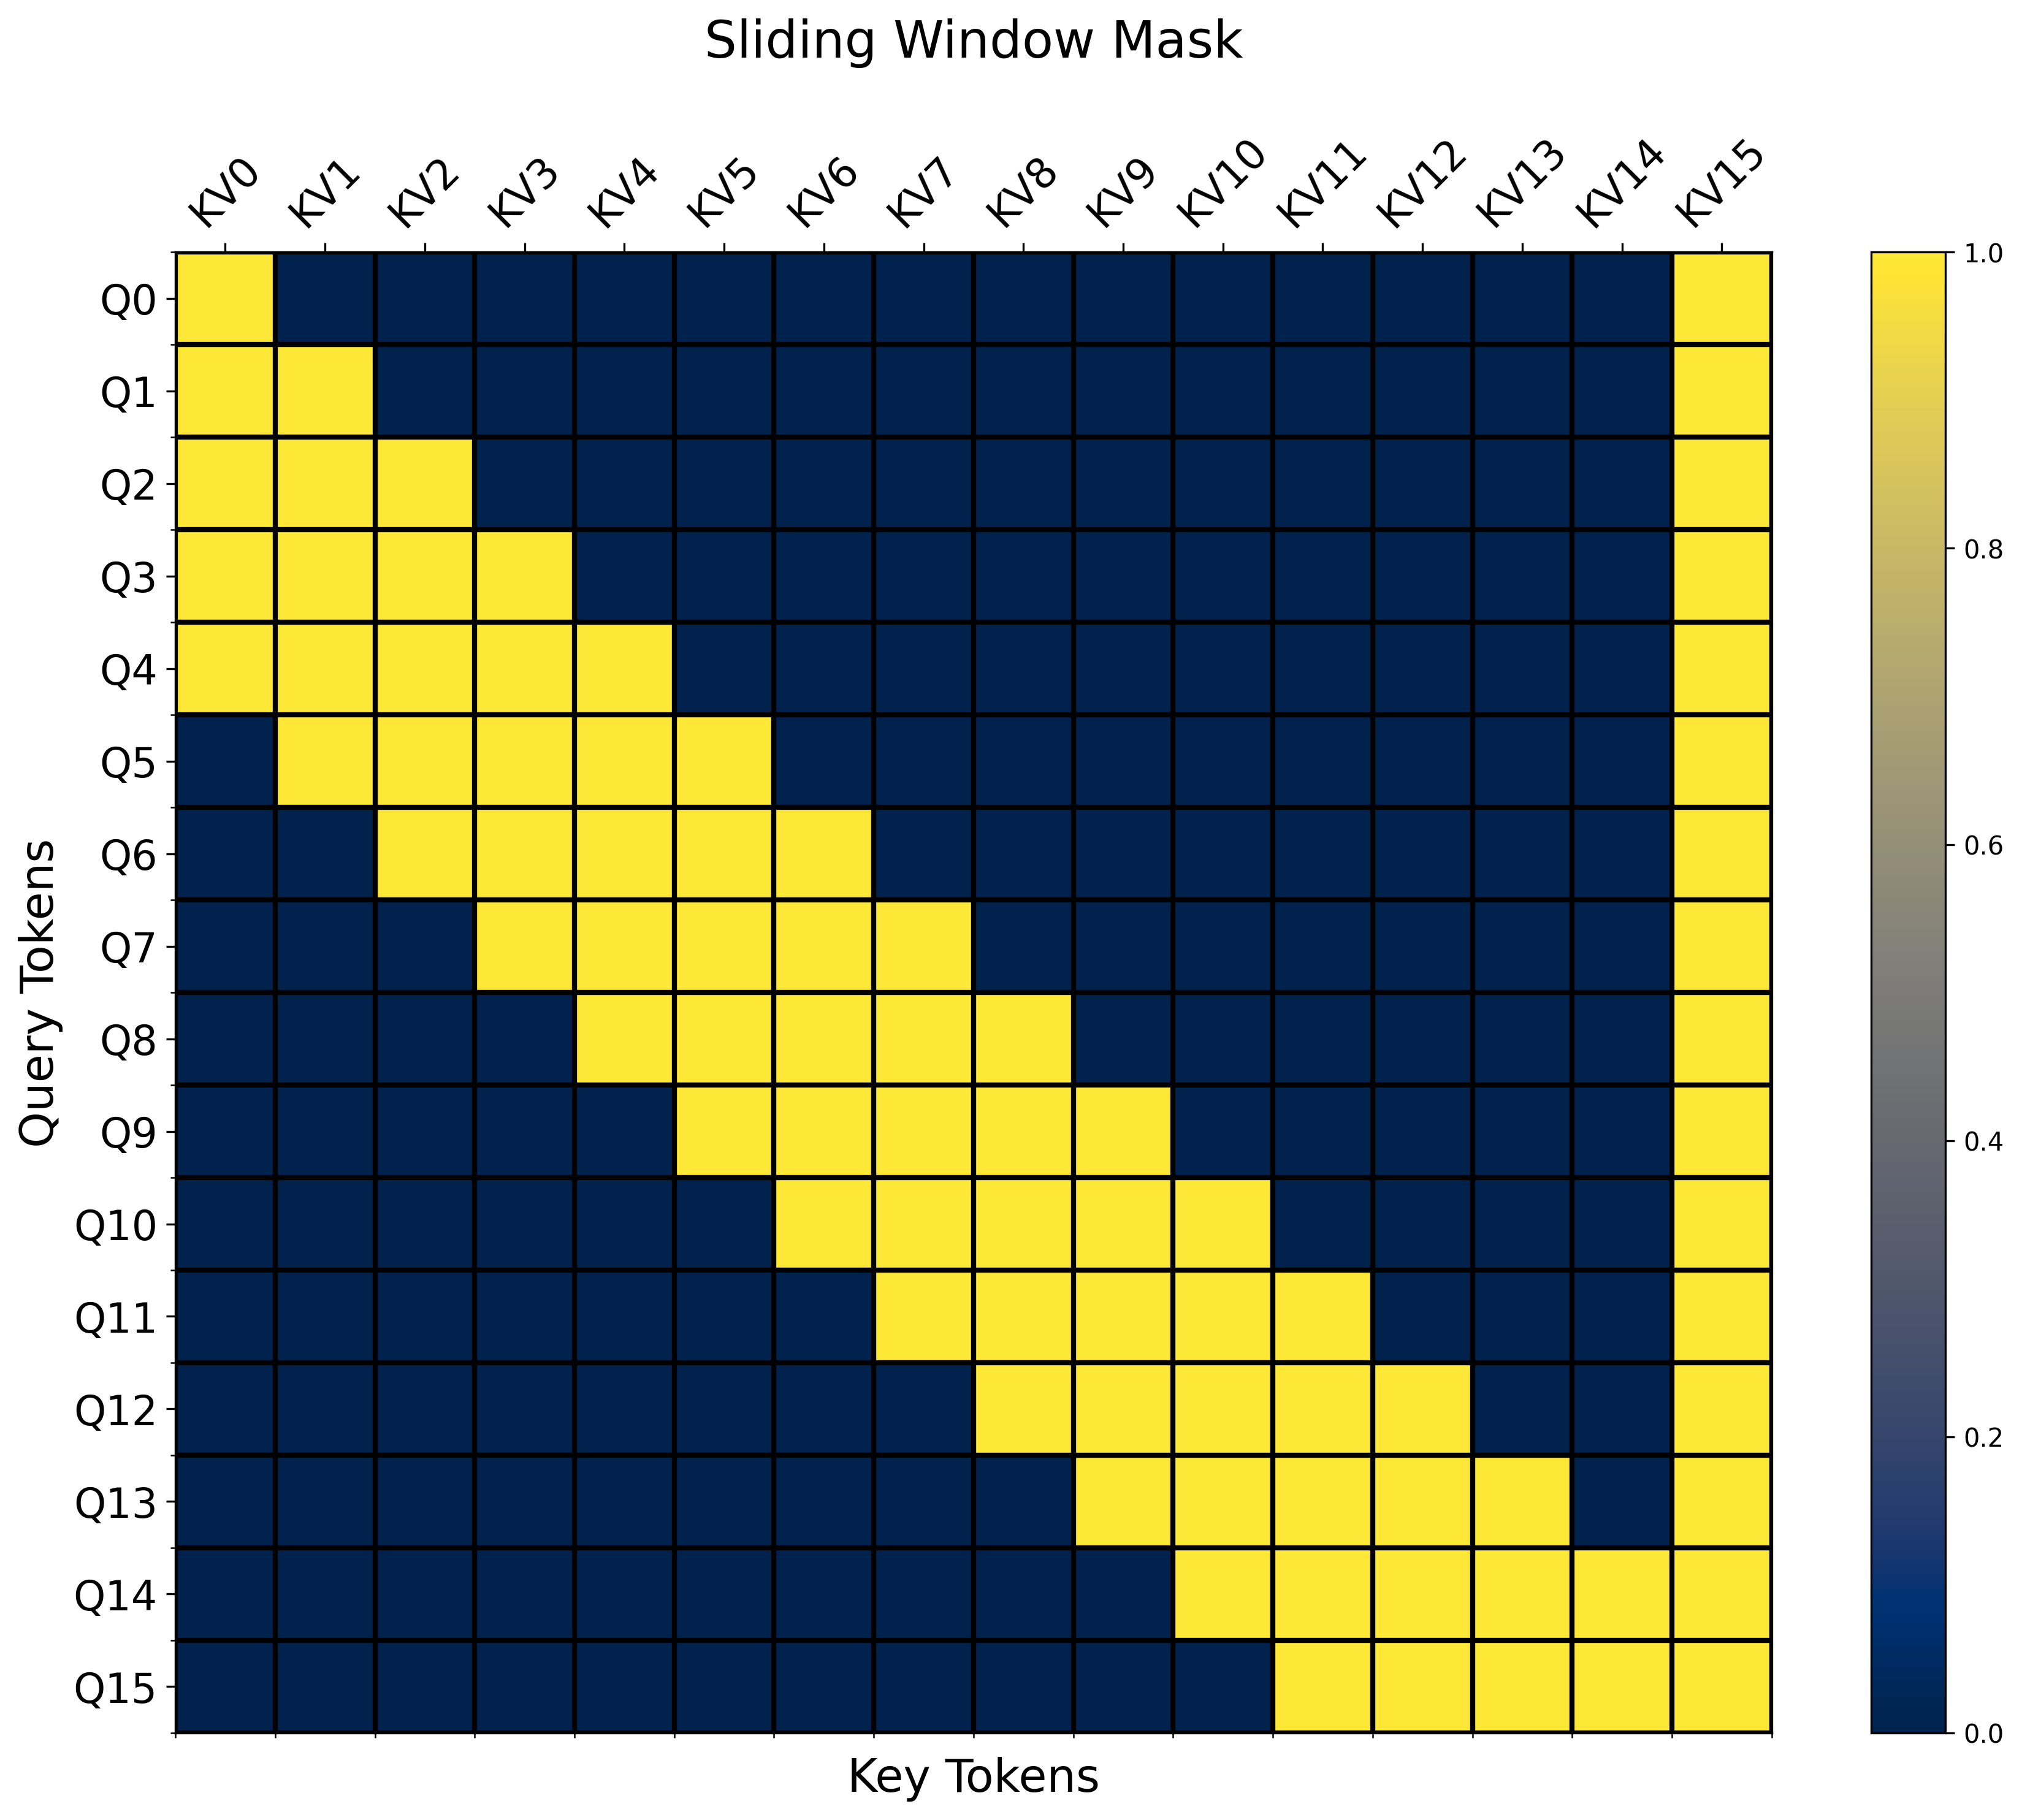
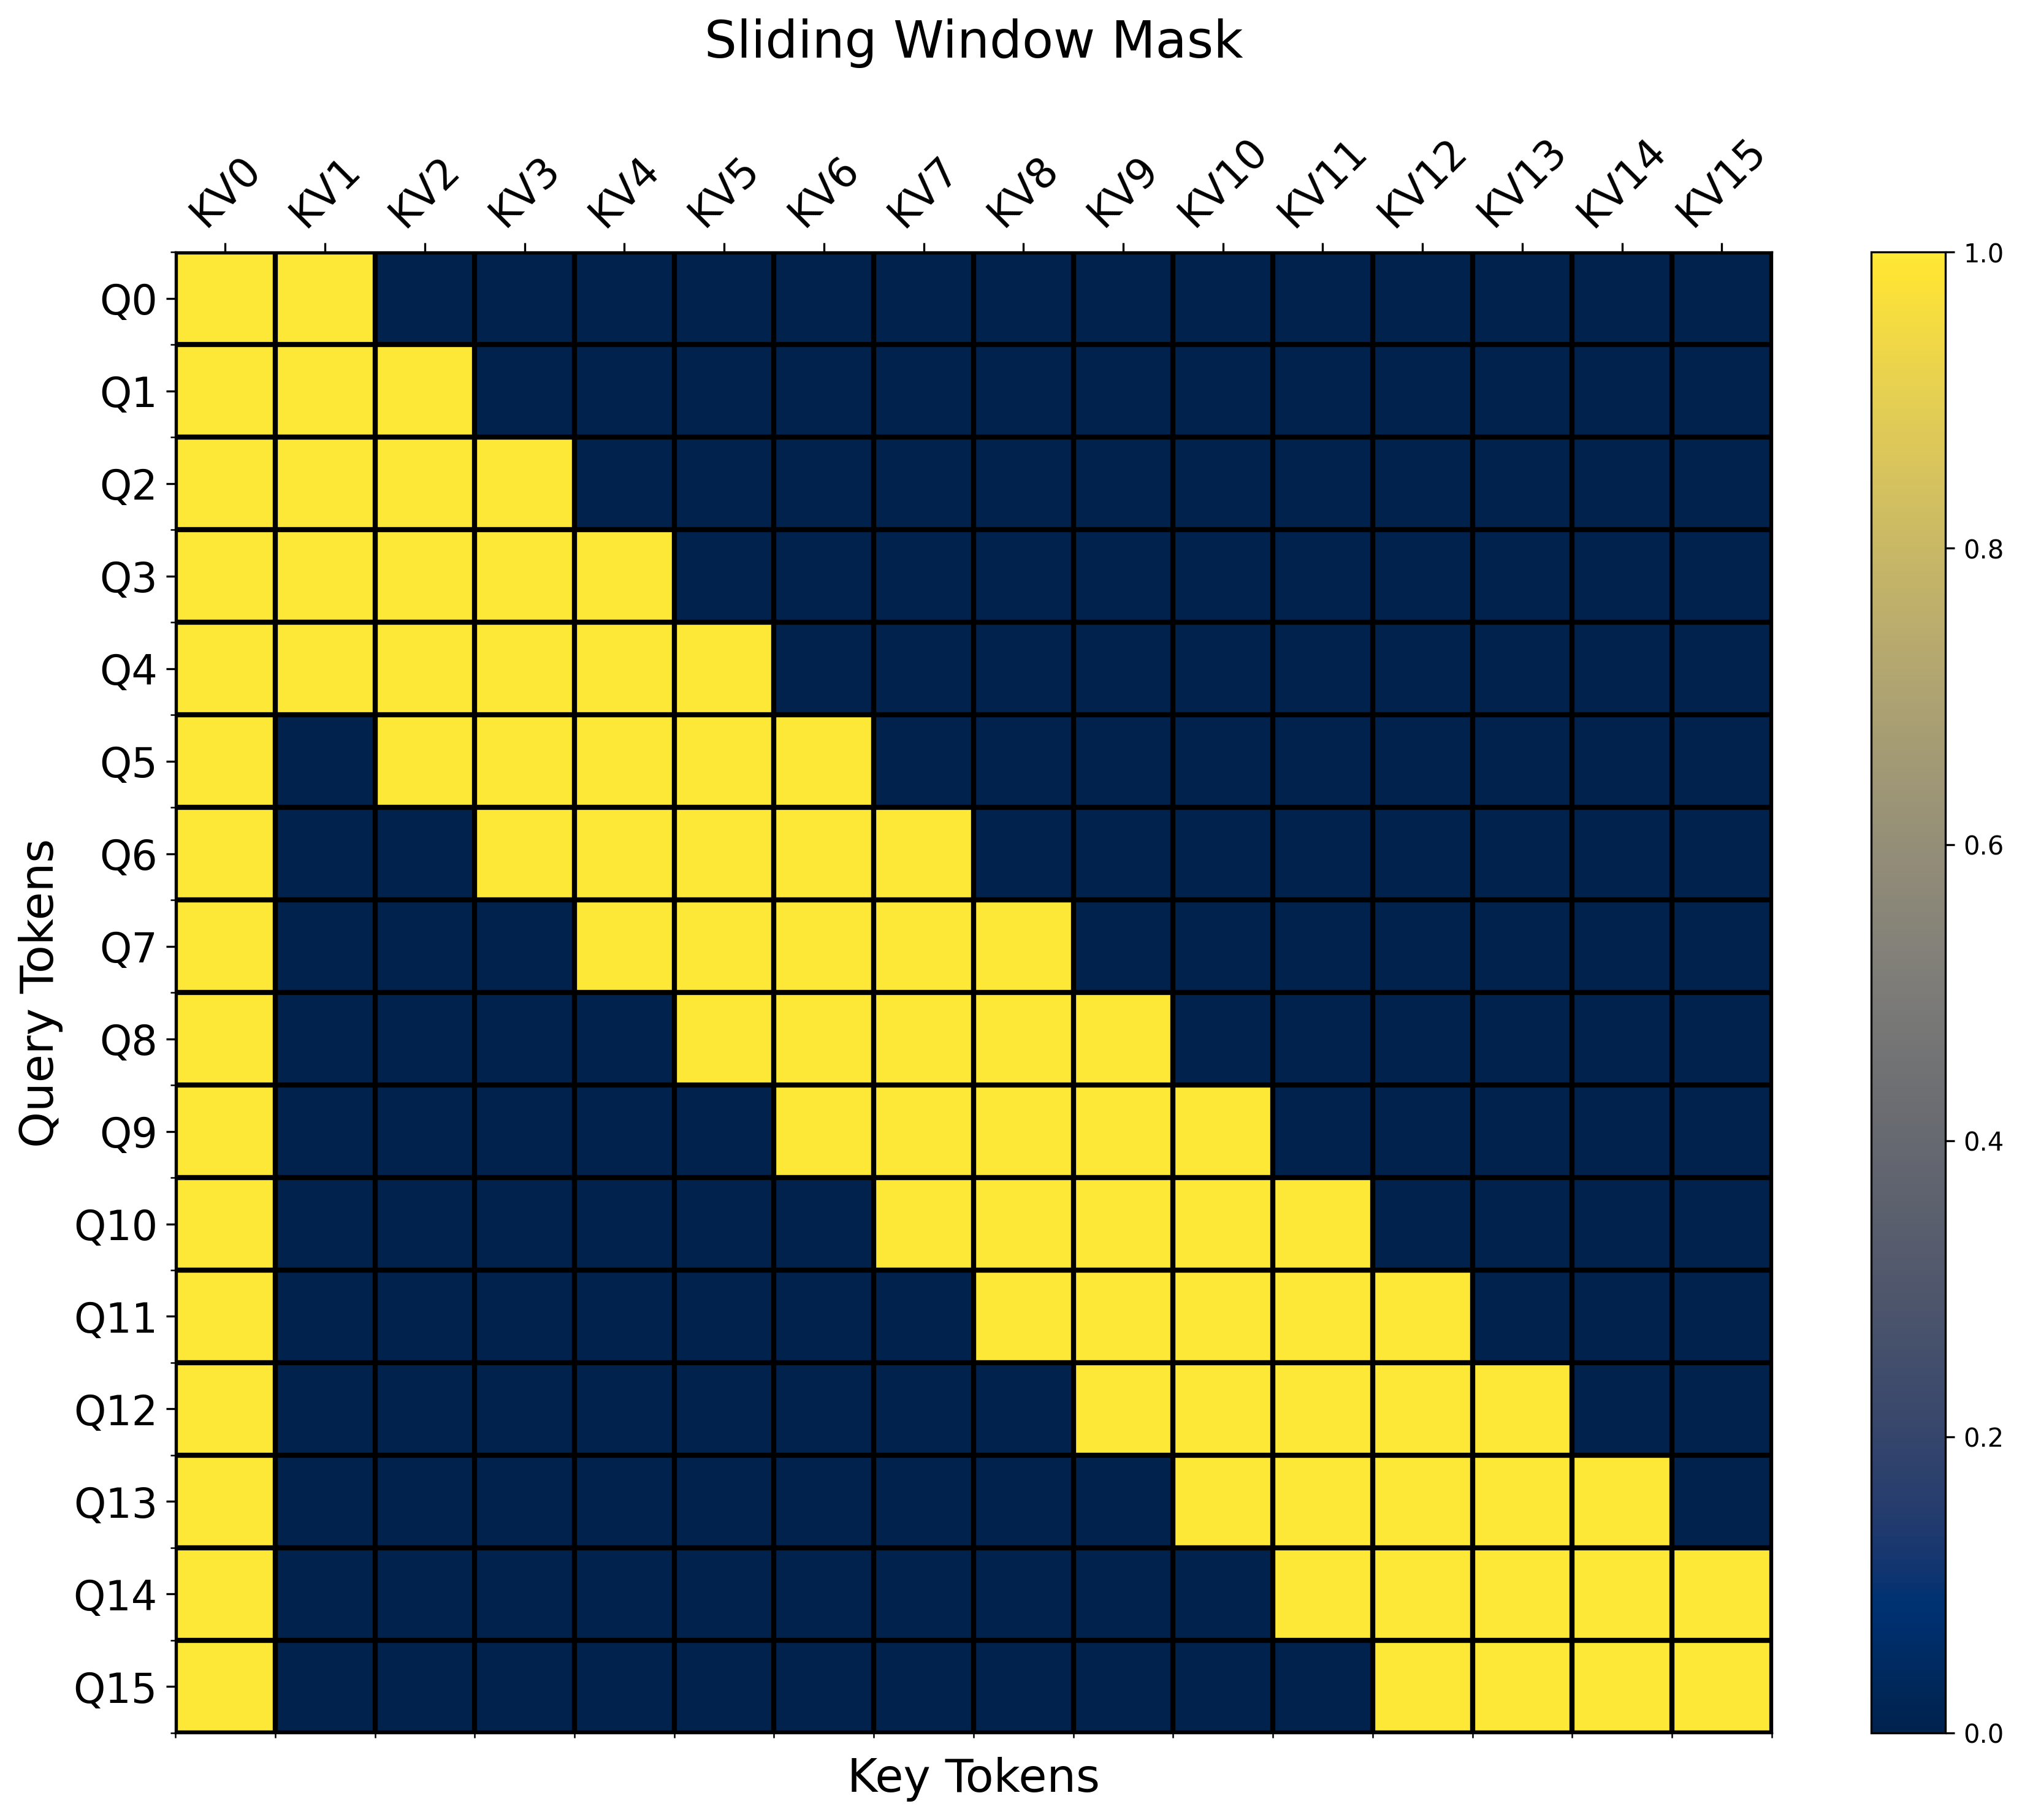
En utilisant quelques utilitaires de visualisation du [dépôt GitHub de Flex Attention](https://github.com/meta-pytorch/attention-gym), nous pouvons visualiser cela. Supposons que la longueur de séquence soit 16 et la fenêtre glissante de 5. À gauche se trouve la dernière colonne puits (implémentation par défaut), et à droite le cas où nous déplaçons la position du puits à l'indice 0 (notre implémentation).
{% columns %}
{% column %}
***Position du puits à la fin (par défaut)***
{% endcolumn %}
{% column %}
***Déplacer la position du puits à l'indice 0***
{% endcolumn %}
{% endcolumns %}
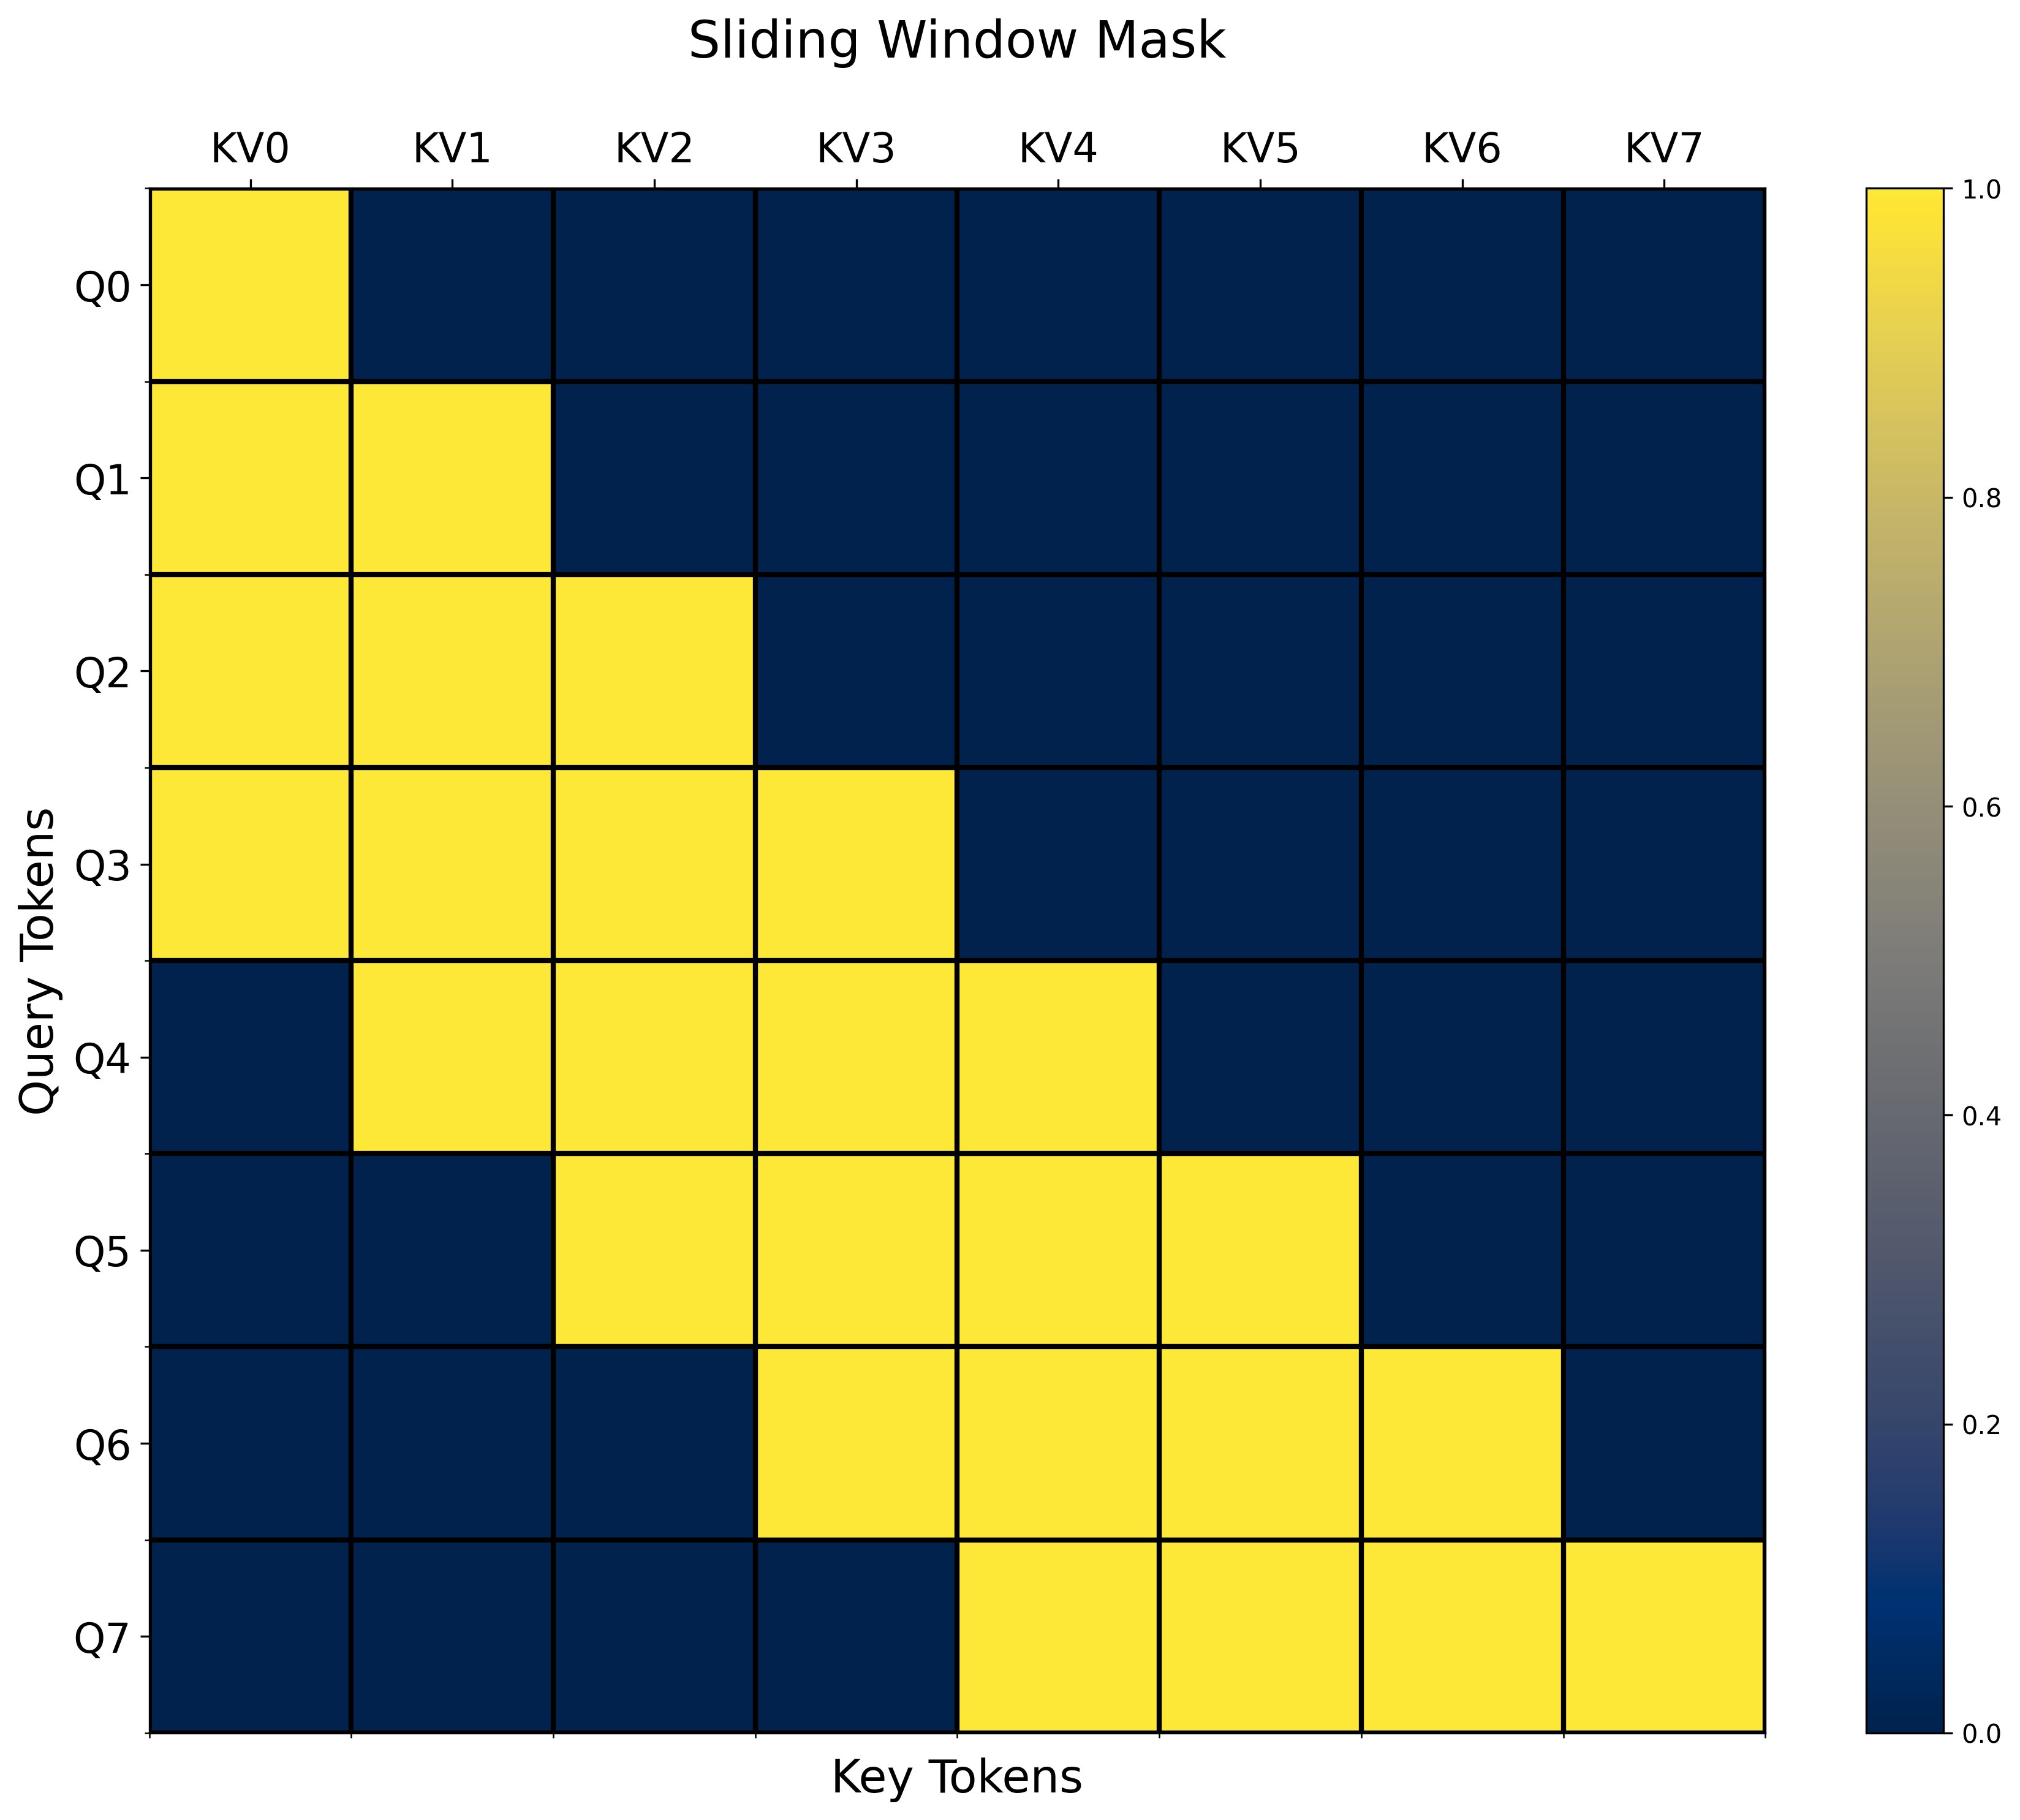
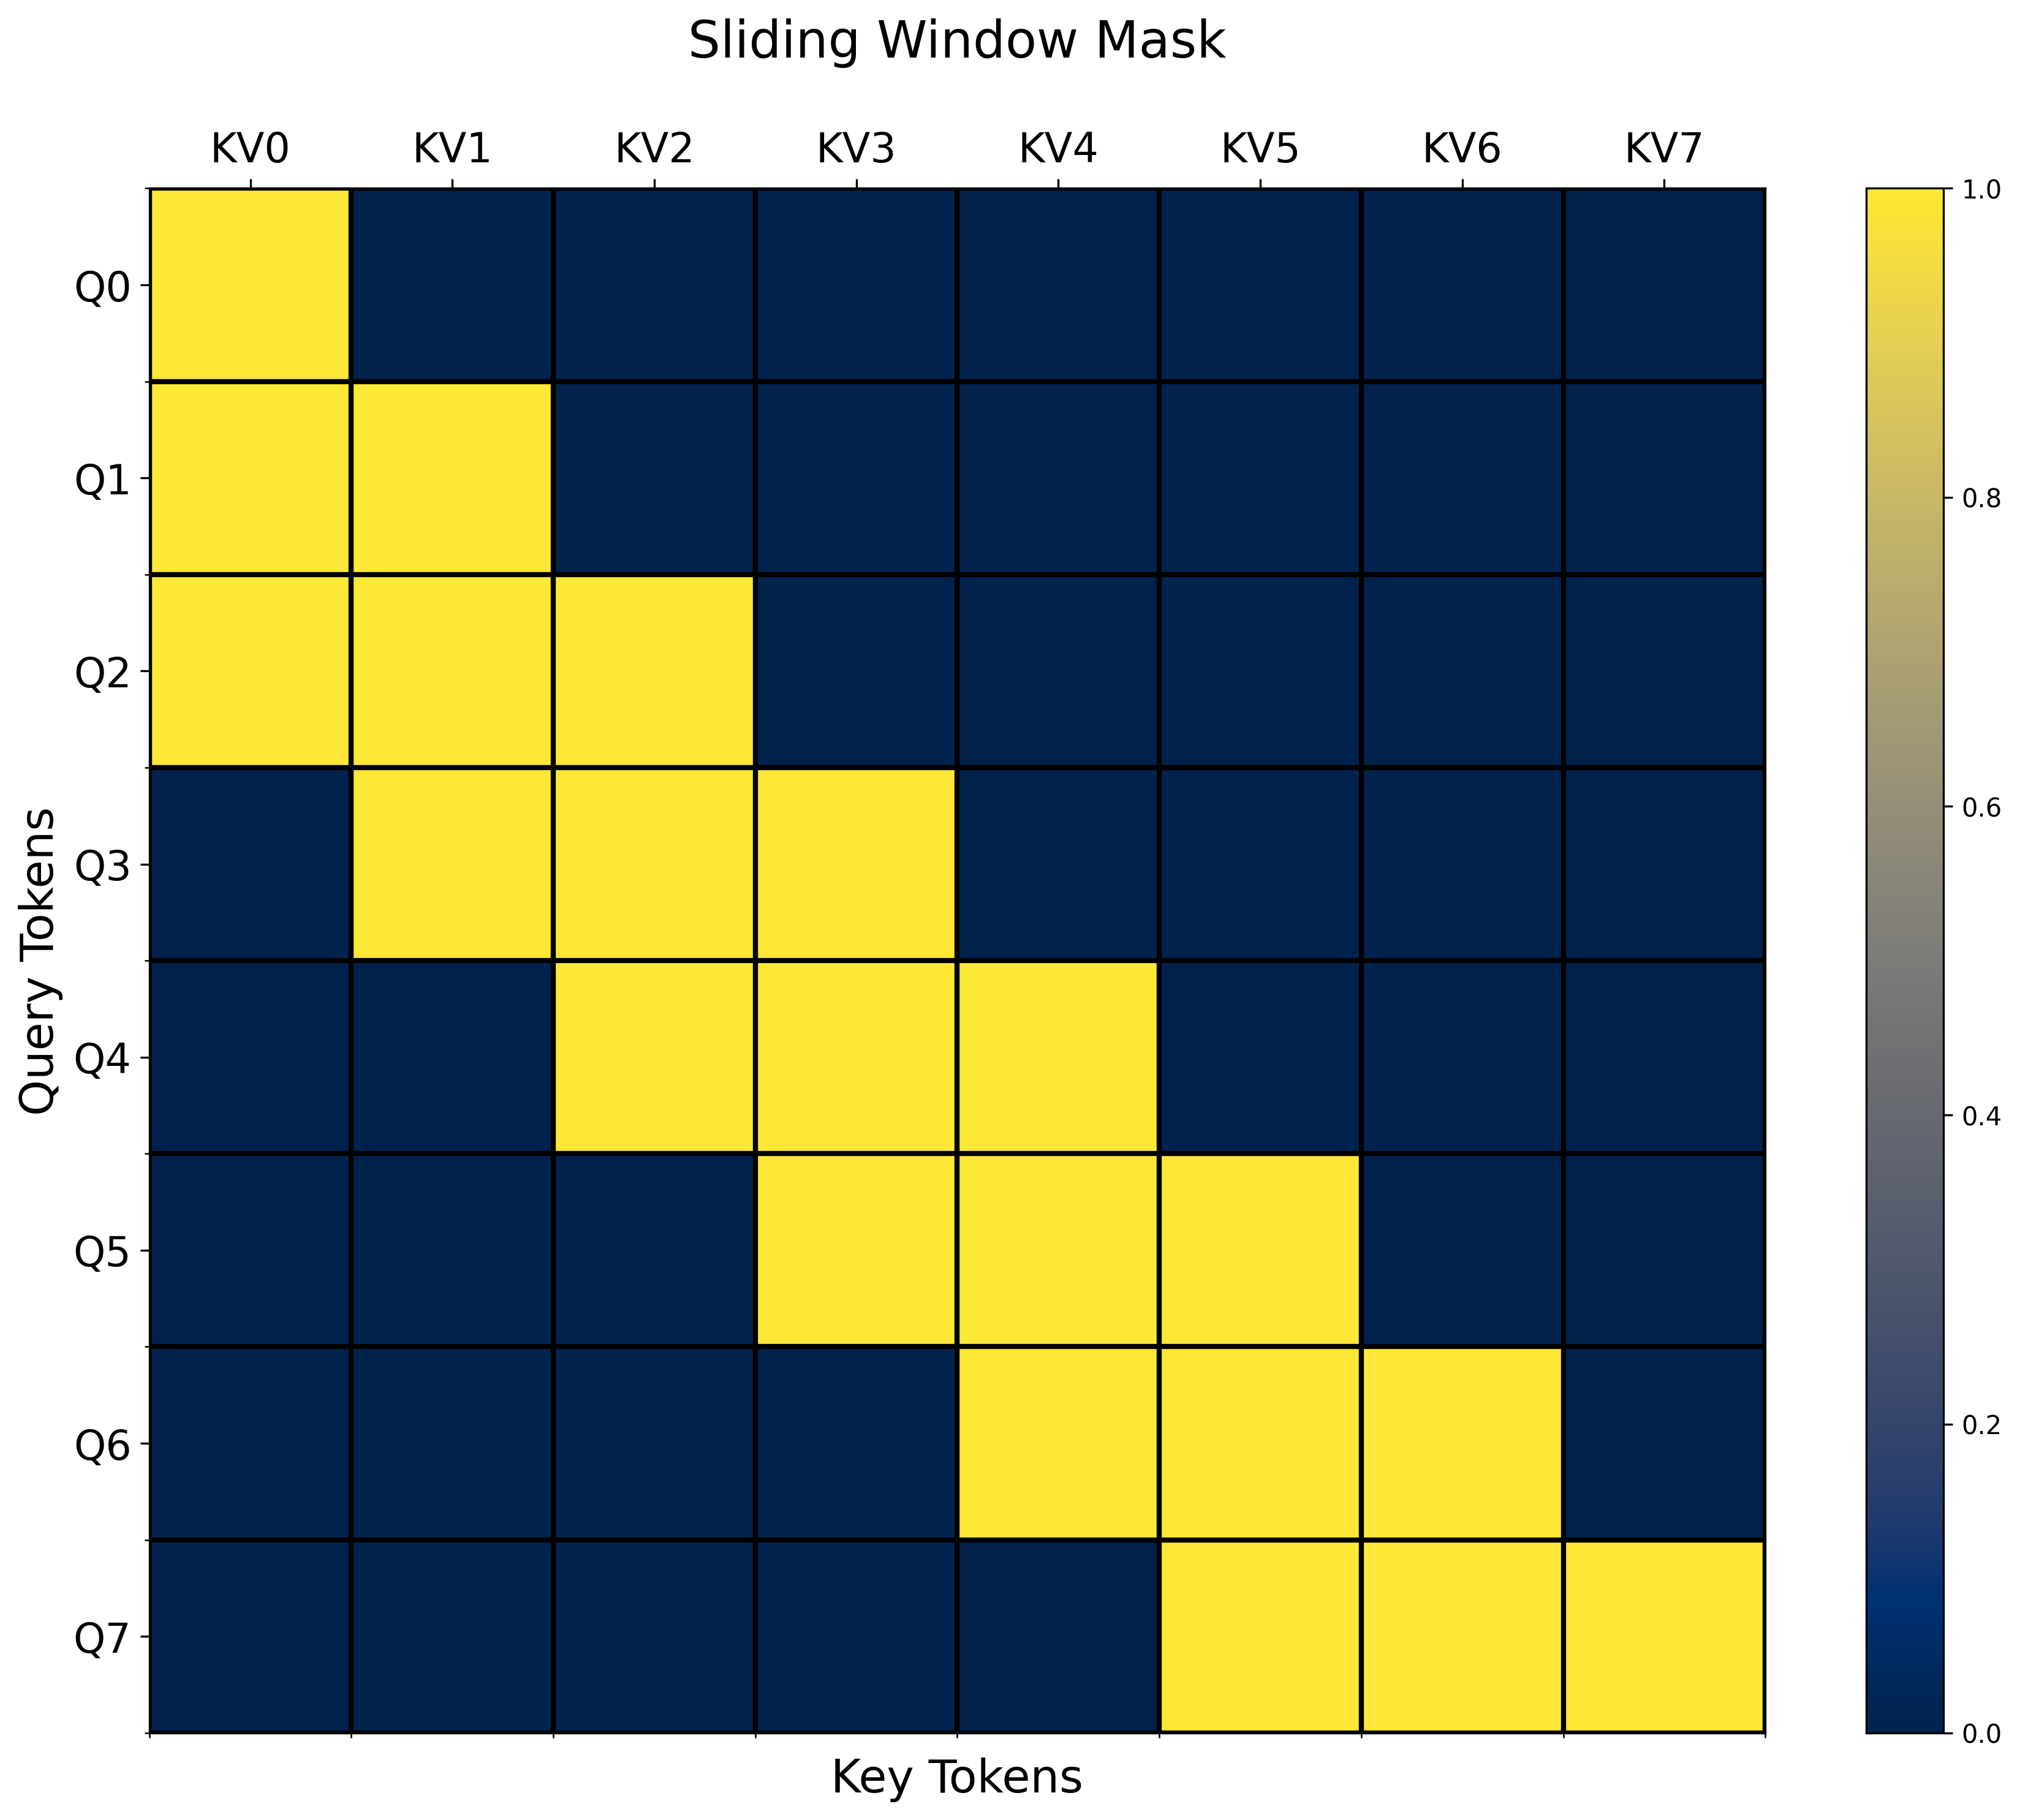
**Découverte intéressante**: Les implémentations officielles de fenêtre glissante de Flex Attention considèrent la taille de fenêtre comme le nombre des derniers jetons **PLUS UN** car elle inclut le jeton courant. Les implémentations Hugging Face et GPT-OSS ne voient strictement que les N derniers jetons. C.-à-d. que ce qui suit vient de et :
{% code overflow="wrap" %}
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW
return causal_mask & window_mask
```
{% endcode %}
{% columns %}
{% column %}
Fenêtre glissante Flex Attention par défaut (3+1 jetons)
{% endcolumn %}
{% column %}
Hugging Face, GPT-OSS (3+0 jetons)
{% endcolumn %}
{% endcolumns %}
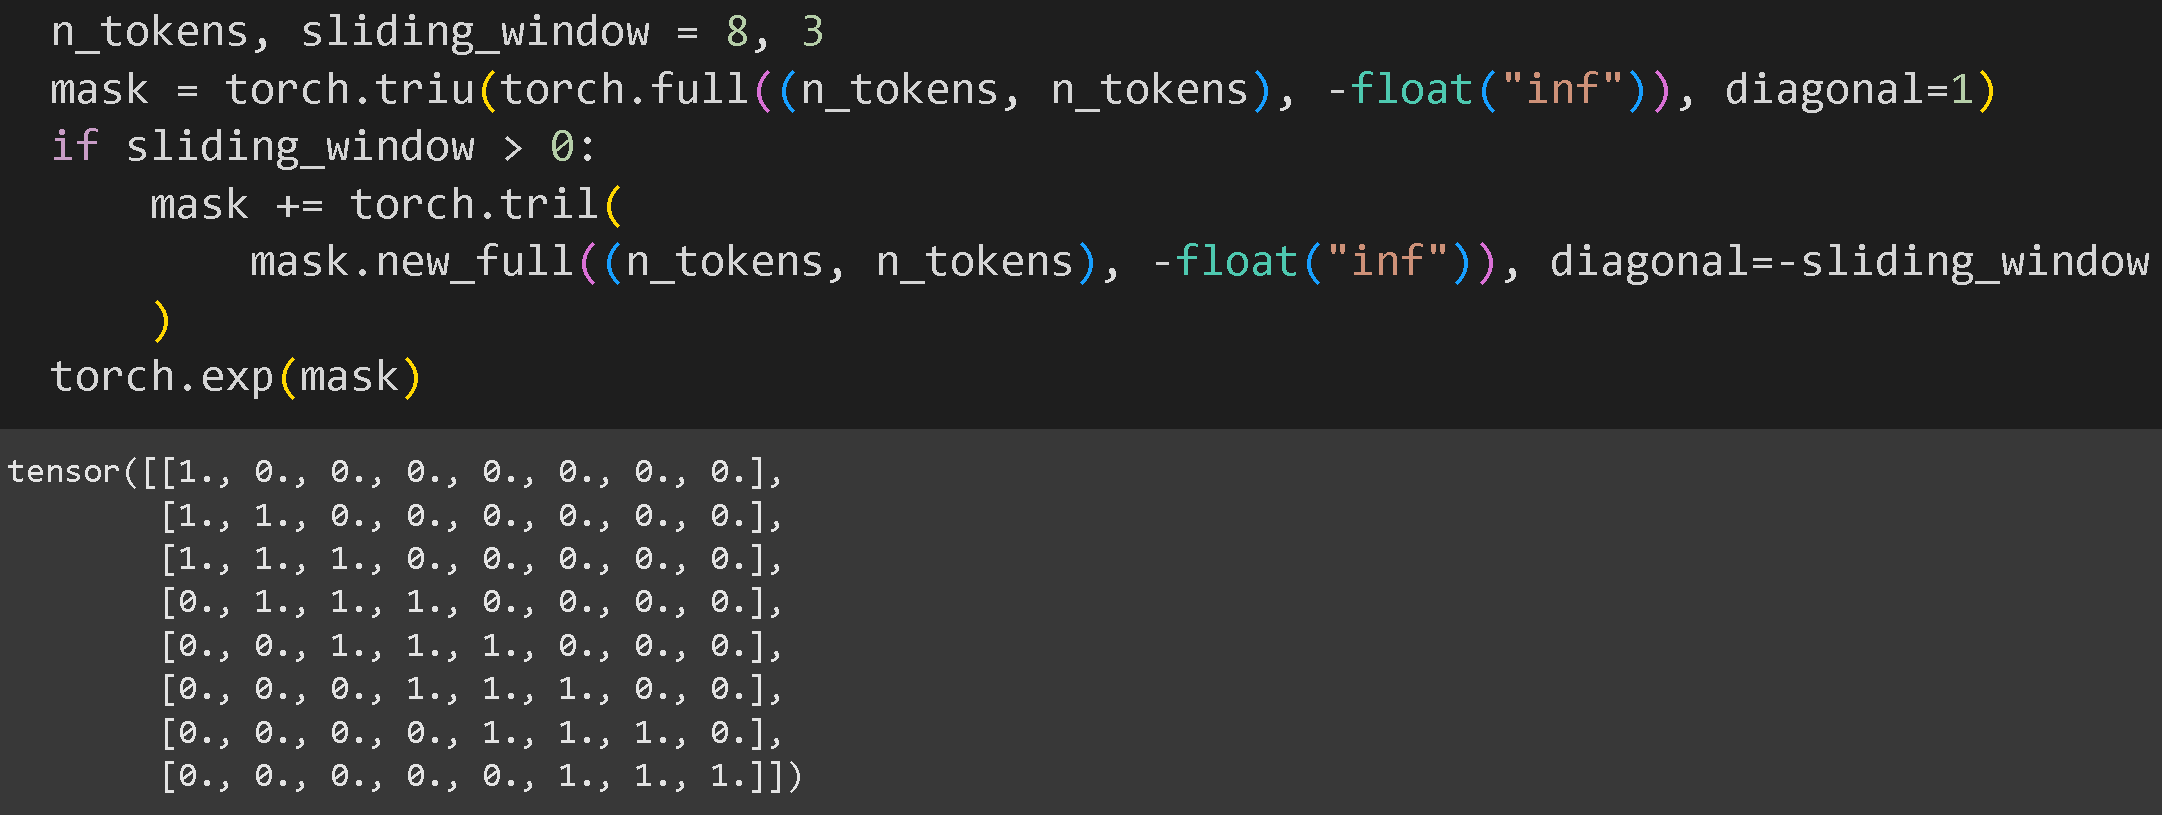
Nous avons également confirmé via l'implémentation officielle GPT-OSS d'OpenAI si, ici, on prête attention aux N derniers jetons ou aux N+1 derniers jetons :
```python
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
```
Et nous voyons que seuls les 3 derniers jetons (et non 3+1) reçoivent de l'attention ! Cela signifie qu'au lieu d'utiliser `<= SLIDING_WINDOW`, utilisez `< SLIDING_WINDOW` (c.-à-d. utiliser inférieur à, et non égal à).
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW # Flex Attention par défaut
window_mask = q_idx - kv_idx < SLIDING_WINDOW # version GPT-OSS
return causal_mask & window_mask
```
Comme nous avons déplacé l'indice du jeton puits au premier rang, nous devons ajouter 1 à q\_idx pour indexer correctement :
```python
def causal_mask_with_sink(batch, head, q_idx, kv_idx):
"""
0 1 2 3 0 1 2 3
0 X X 1 X
1 X X X 2 X X
2 X X X X 3 X X X
"""
# Nous ajoutons (q_idx + 1) puisque la première colonne est le jeton puits
causal_mask = (q_idx + 1) >= kv_idx
sink_first_column = kv_idx == 0
return causal_mask | sink_first_column
```
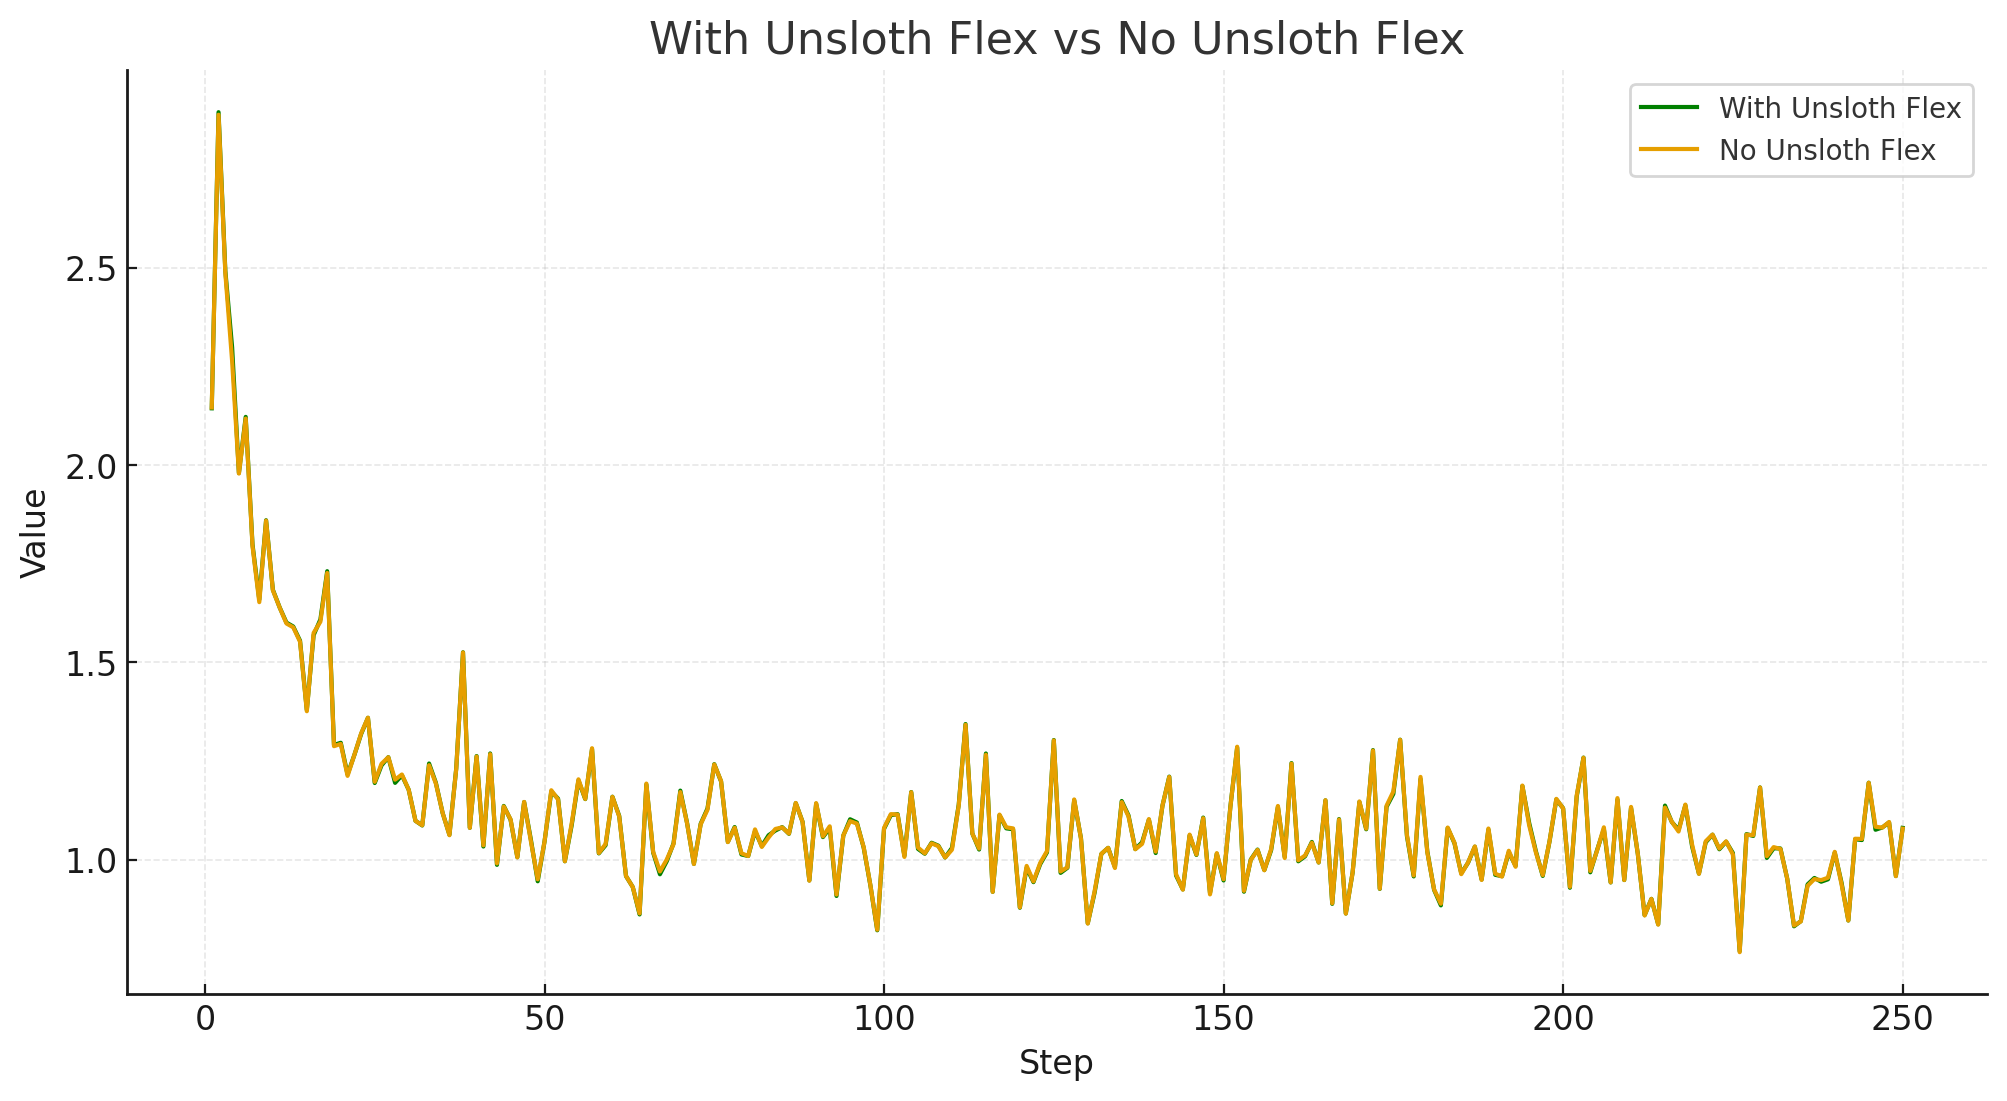
Pour confirmer notre implémentation à l'indice 0, nous avons vérifié que la perte d'entraînement reste cohérente avec les exécutions standard de Hugging Face (sans Unsloth Flex Attention), comme le montre notre graphique :
## :scroll: Dérivation mathématique pour les puits d'attention
Il existe une autre façon de calculer les puits d'attention sans remplir K et V. Nous remarquons d'abord ce que fait l'opération softmax, et nous voulons pour l'instant la 2e version avec puits sous forme scalaire :\\
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
A\_{sink}(x) = \frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}}
$$
Nous pouvons obtenir le logsumexp depuis Flex Attention via `return_lse = True` , et donc nous faisons :
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
\frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}} = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \frac{\sum{\exp{(x\_i)}}}{\exp{(s)}+ \sum{\exp{(x\_i)}}} \\
\text{LSE}(x) = \text{logsumexp}(x) = \log{\sum\exp(x\_i)} \\
\exp{(\text{LSE}(x))} = \exp{\big(\log{\sum\exp(x\_i)}\big)} = \sum\exp(x\_i)
$$
Et nous pouvons maintenant dériver facilement la version avec puits de l'attention. Nous constatons toutefois que ce processus a une erreur quelque peu plus élevée que l'approche avec padding nul, nous conservons donc malgré tout notre version originale par défaut.
## 💾**NOUVEAU : Enregistrement au format GGUF, vLLM après l'entraînement de gpt-oss**
Vous pouvez désormais affiner gpt-oss avec QLoRA et enregistrer, exporter ou fusionner directement le modèle vers **llama.cpp**, **vLLM**, ou **HF** - pas seulement Unsloth. Nous publierons bientôt, nous l'espérons, un notebook gratuit.
Auparavant, tout modèle gpt-oss affiné avec QLoRA était limité à une exécution dans Unsloth. Nous avons supprimé cette limite en introduisant la possibilité de fusionner dans **MXFP4** **format natif** en utilisant `save_method="mxfp4"` et **déquantification à la demande de MXFP4** des modèles de base (comme gpt-oss), ce qui rend possible de **exporter votre modèle affiné au format bf16 à l'aide de** `save_method="merged_16bit"` .
Le **MXFP4** le format de fusion natif offre d'importantes améliorations de performances par rapport au **format bf16**: il utilise jusqu'à 75 % d'espace disque en moins, réduit l'utilisation de VRAM de 50 %, accélère la fusion de 5 à 10×, et permet une conversion beaucoup plus rapide vers le **GGUF** format.
Après avoir affiné votre modèle gpt-oss, vous pouvez le fusionner au **MXFP4** format avec :
```python
model.save_pretrained_merged(save_directory, tokenizer, save_method="mxfp4")
```
Si vous préférez fusionner le modèle et le pousser sur Hugging Face Hub, utilisez :
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token=hf_token, save_method="mxfp4")
```
Pour exécuter l'inférence sur le modèle fusionné, vous pouvez utiliser vLLM et Llama.cpp entre autres. OpenAI recommande ces [paramètres d'inférence](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md#recommended-settings) pour les deux modèles : `temperature=1.0`, `top_p=1.0`, `top_k=0`
#### :sparkles: Enregistrement dans Llama.cpp
1. Obtenez la dernière version `llama.cpp` sur [GitHub ici](https://github.com/ggml-org/llama.cpp). Vous pouvez également suivre les instructions de compilation ci-dessous. Modifiez `-DGGML_CUDA=ON` à `-DGGML_CUDA=OFF` si vous n'avez pas de GPU ou si vous souhaitez simplement une inférence CPU.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Convertissez le **MXFP4** modèle fusionné :
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned-mxfp4.gguf
```
3. Exécutez l'inférence sur le modèle quantifié :
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-mxfp4.gguf \
--jinja -ngl 99 --threads -1 --ctx-size 16384 \
--temp 1.0 --top-p 1.0 --top-k 0 \
-p "The meaning to life and the universe is"
```
✨ Enregistrement dans SGLang
1. Compilez SGLang à partir des sources:\\
```bash
# compilation à partir des sources
git clone https://github.com/sgl-project/sglang
cd sglang
pip3 install pip --upgrade
pip3 install -e "python[all]"
# ROCm 6.3
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/rocm6.3
git clone https://github.com/triton-lang/triton
cd python/triton_kernels
pip3 install .
# hopper
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu126
pip3 install sgl-kernel==0.3.2
# blackwell cu128
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu128
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2+cu128-cp39-abi3-manylinux2014_x86_64.whl
# blackwell cu129
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu129
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2-cp39-abi3-manylinux2014_x86_64.whl
```
2. Lancez le serveur SGLang:\\
```bash
python3 -m sglang.launch_server --model-path ./gpt-oss-finetuned-merged/
```
3. Exécutez l'inférence:\\
```python
import requests
from sglang.utils import print_highlight
url = f"http://localhost:8000/v1/chat/completions"
data = {
"model": "gpt-oss-finetuned-merged",
"messages": [{"role": "user", "content": "Quelle est la capitale de la France ?"}],
}
response = requests.post(url, json=data)
print_highlight(response.json())
```
### :diamonds:Affiner gpt-oss directement
Nous avons également ajouté la prise en charge de l'affinage direct des modèles gpt-oss en implémentant des correctifs qui permettent de charger le format natif quantifié MXFP4. Cela permet de charger le modèle 'openai/gpt-oss' avec moins de 24 Go de VRAM, et de l'affiner avec QLoRA. Il suffit de charger le modèle en utilisant :
```python
model, tokenizer = FastLanguageModel.from_pretrained(
# model_name = "unsloth/gpt-oss-20b-BF16",
model_name = "unsloth/gpt-oss-20b",
dtype = dtype, # None pour la détection automatique
max_seq_length = max_seq_length, # Choisissez n'importe quelle valeur pour un long contexte !
load_in_4bit = True, # Quantification 4 bits pour réduire la mémoire
full_finetuning = False, # [NOUVEAU !] Nous avons maintenant l'ajustement fin complet !
# token = "hf_...", # utilisez-en un si vous utilisez des modèles protégés
)
```
ajouter une couche Peft à l'aide de `FastLanguageModel.get_peft_model` et lancer l'affinage SFT sur le modèle Peft.
## 🐛Corrections de bugs pour gpt-oss
Nous [a récemment collaboré avec Hugging Face](https://github.com/huggingface/transformers/pull/40197) pour résoudre les problèmes d'inférence en utilisant les noyaux d'OpenAI et en s'assurant que `swiglu_limit = 7.0` est correctement appliqué pendant l'inférence MXFP4.
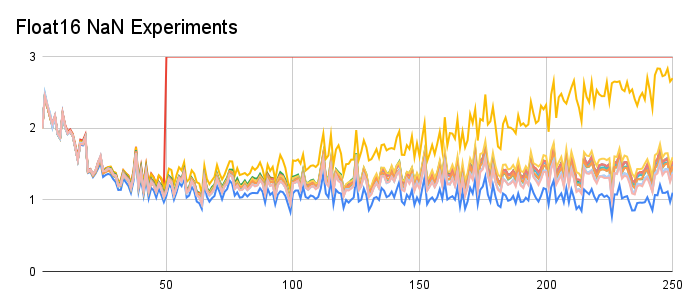
D'après les retours des utilisateurs, nous avons découvert que les exécutions prolongées d'entraînement QLoRA (au-delà de 60 étapes) pouvaient provoquer **la divergence de la perte et finalement une erreur**. Ce problème ne se produisait que sur les appareils ne prenant pas en charge BF16 et retombant donc sur F16 (par ex. les GPU T4). Important : cela n'affectait pas l'entraînement QLoRA sur les GPU A100 ou H100, ni l'entraînement LoRA sur les GPU f16.
**Après une enquête approfondie, nous avons désormais aligné le comportement de la perte d'entraînement sur toutes les configurations GPU, y compris les GPU limités au F16**. Si vous rencontriez auparavant des problèmes à cause de cela, nous vous recommandons d'utiliser notre nouveau notebook gpt-oss mis à jour !
Nous avons dû faire de très nombreuses expériences pour faire en sorte que la courbe de perte d'entraînement du float16 soit équivalente à celle des machines bfloat16 (ligne bleue). Nous avons trouvé ce qui suit :
1. **Le float16 pur divergera vers l'infini à l'étape 50**
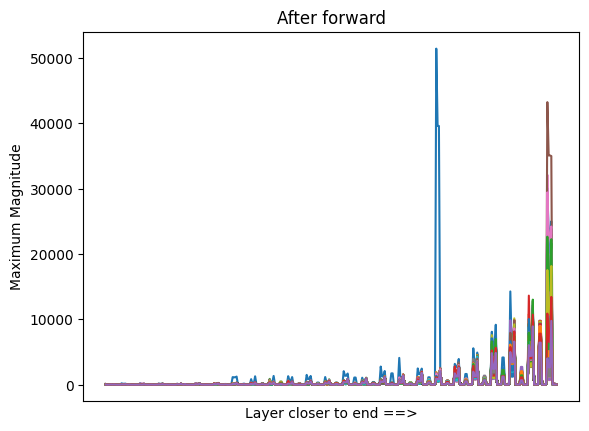
2. **Nous avons constaté que les projections descendantes dans le MoE présentent d'énormes valeurs aberrantes**
3. **Les activations doivent être sauvegardées en bfloat16 ou float32**
**Ci-dessous sont montrées les activations de magnitude absolue pour GPT OSS 20B, et certaines présentent de très fortes pointes - cela débordera sur les machines float16 puisque la plage maximale du float16 est de 65504.**
**Nous avons corrigé cela dans Unsloth, donc tout l'entraînement float16 fonctionne immédiatement !**
## :1234: Implémentations pour Sink Attention
L'implémentation du jeton puits d'OpenAI est [fournie ici](https://github.com/openai/gpt-oss/blob/main/gpt_oss/torch/model.py). Nous la fournissons ci-dessous :
{% code fullWidth="false" %}
```python
def sdpa(Q, K, V, S, sm_scale, sliding_window=0):
# sliding_window == 0 signifie aucune fenêtre glissante
n_tokens, n_heads, q_mult, d_head = Q.shape
assert K.shape == (n_tokens, n_heads, d_head)
assert V.shape == (n_tokens, n_heads, d_head)
K = K[:, :, None, :].expand(-1, -1, q_mult, -1)
V = V[:, :, None, :].expand(-1, -1, q_mult, -1)
S = S.reshape(n_heads, q_mult, 1, 1).expand(-1, -1, n_tokens, -1)
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
QK = torch.einsum("qhmd,khmd->hmqk", Q, K) * sm_scale
QK += mask[None, None, :, :]
QK = torch.cat([QK, S], dim=-1)
W = torch.softmax(QK, dim=-1)
W = W[..., :-1]
attn = torch.einsum("hmqk,khmd->qhmd", W, V)
return attn.reshape(n_tokens, -1)
```
{% endcode %}
L'implémentation transformers de Hugging Face est [fournie ici](https://github.com/huggingface/transformers/blob/main/src/transformers/models/gpt_oss/modeling_gpt_oss.py). Nous la fournissons également ci-dessous :
{% code fullWidth="false" %}
```python
def eager_attention_forward(
module: nn.Module,
query: torch.Tensor,
key: torch.Tensor,
value: torch.Tensor,
attention_mask: Optional[torch.Tensor],
scaling: float,
dropout: float = 0.0,
**kwargs,
):
key_states = repeat_kv(key, module.num_key_value_groups)
value_states = repeat_kv(value, module.num_key_value_groups)
attn_weights = torch.matmul(query, key_states.transpose(2, 3)) * scaling
if attention_mask is not None:
causal_mask = attention_mask[:, :, :, : key_states.shape[-2]]
attn_weights = attn_weights + causal_mask
sinks = module.sinks.reshape(1, -1, 1, 1).expand(query.shape[0], -1, query.shape[-2], -1)
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
# Cela ne faisait pas partie de l'implémentation originale et affecte légèrement les résultats ; cela évite un débordement en BF16/FP16
# lors de l'entraînement avec bsz>1, nous limitons les valeurs maximales.
combined_logits = combined_logits - combined_logits.max(dim=-1, keepdim=True).values
probs = F.softmax(combined_logits, dim=-1, dtype=combined_logits.dtype)
scores = probs[..., :-1] # nous supprimons ici le puits
attn_weights = nn.functional.dropout(scores, p=dropout, training=module.training)
attn_output = torch.matmul(attn_weights, value_states)
attn_output = attn_output.transpose(1, 2).contiguous()
return attn_output, attn_weights
```
{% endcode %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.