> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md).

# Guide des jeux de données

Découvrez comment créer et préparer un jeu de données pour le fine-tuning.

## Qu'est-ce qu'un jeu de données ?

Pour les LLM, les jeux de données sont des collections de données qui peuvent être utilisées pour entraîner nos modèles. Afin d'être utiles à l'entraînement, les données textuelles doivent être dans un format pouvant être tokenisé. Vous apprendrez aussi comment [utiliser des jeux de données dans Unsloth](#applying-chat-templates-with-unsloth).

L'une des parties clés de la création d'un jeu de données est votre [modèle de chat](/docs/fr/notions-de-base/chat-templates.md) et la façon dont vous allez le concevoir. La tokenisation est également importante, car elle découpe le texte en jetons, qui peuvent être des mots, des sous-mots ou des caractères, afin que les LLM puissent le traiter efficacement. Ces jetons sont ensuite transformés en vecteurs d'intégration (embeddings) et ajustés pour aider le modèle à comprendre le sens et le contexte.

### Format des données

Pour permettre le processus de tokenisation, les jeux de données doivent être dans un format lisible par un tokeniseur.

<table data-full-width="false"><thead><tr><th>Format</th><th>Description</th><th>Type d'entraînement</th></tr></thead><tbody><tr><td>Corpus brut</td><td>Texte brut provenant d'une source telle qu'un site web, un livre ou un article.</td><td>Pré-entraînement continu (CPT)</td></tr><tr><td>Instruction</td><td>Des instructions que le modèle doit suivre et un exemple de la sortie visée.</td><td>Ajustement fin supervisé (SFT)</td></tr><tr><td>Conversation</td><td>Conversation à plusieurs tours entre un utilisateur et un assistant IA.</td><td>Ajustement fin supervisé (SFT)</td></tr><tr><td>RLHF</td><td>Conversation entre un utilisateur et un assistant IA, avec les réponses de l'assistant classées par un script, un autre modèle ou un évaluateur humain.</td><td>Apprentissage par renforcement (RL)</td></tr></tbody></table>

{% hint style="info" %}
Il convient de noter qu'il existe différents styles de format pour chacun de ces types.
{% endhint %}

## Prise en main

Avant de formater nos données, nous voulons identifier les éléments suivants :

{% stepper %}
{% step %} <mark style="color:vert;">Objectif du jeu de données</mark>

Connaître l'objectif du jeu de données nous aidera à déterminer quelles données nous devons utiliser et quel format choisir.

L'objectif pourrait être d'adapter un modèle à une nouvelle tâche comme le résumé ou d'améliorer la capacité d'un modèle à incarner un personnage spécifique. Par exemple :

* Dialogues basés sur le chat (Q\&R, apprentissage d'une nouvelle langue, support client, conversations).
* Tâches structurées ([classification](https://colab.research.google.com/github/timothelaborie/text_classification_scripts/blob/main/unsloth_classification.ipynb), résumé, tâches de génération).
* Données spécifiques à un domaine (médical, finance, technique).
  {% endstep %}

{% step %} <mark style="color:vert;">Style de sortie</mark>

Le style de sortie nous indiquera quelles sources de données nous utiliserons pour obtenir la sortie souhaitée.

Par exemple, le type de sortie que vous voulez obtenir peut être du JSON, du HTML, du texte ou du code. Ou peut-être voulez-vous qu'elle soit en espagnol, en anglais ou en allemand, etc.
{% endstep %}

{% step %} <mark style="color:vert;">Source des données</mark>

Lorsque nous connaissons l'objectif et le style des données dont nous avons besoin, nous devons analyser la qualité et la [quantité](#how-big-should-my-dataset-be) des données. Hugging Face et Wikipédia sont d'excellentes sources de jeux de données, et Wikipédia est particulièrement utile si vous cherchez à entraîner un modèle à apprendre une langue.

La source des données peut être un fichier CSV, un PDF ou même un site web. Vous pouvez aussi [générer de manière synthétique](#synthetic-data-generation) des données, mais une attention particulière est nécessaire pour s'assurer que chaque exemple est de haute qualité et pertinent.
{% endstep %}
{% endstepper %}

{% hint style="success" %}
L'une des meilleures façons de créer un meilleur jeu de données est de le combiner avec un jeu de données plus général de Hugging Face comme ShareGPT afin de rendre votre modèle plus intelligent et plus diversifié. Vous pourriez aussi ajouter [des données générées synthétiquement](#synthetic-data-generation).
{% endhint %}

## 🦥 Recettes de données Unsloth

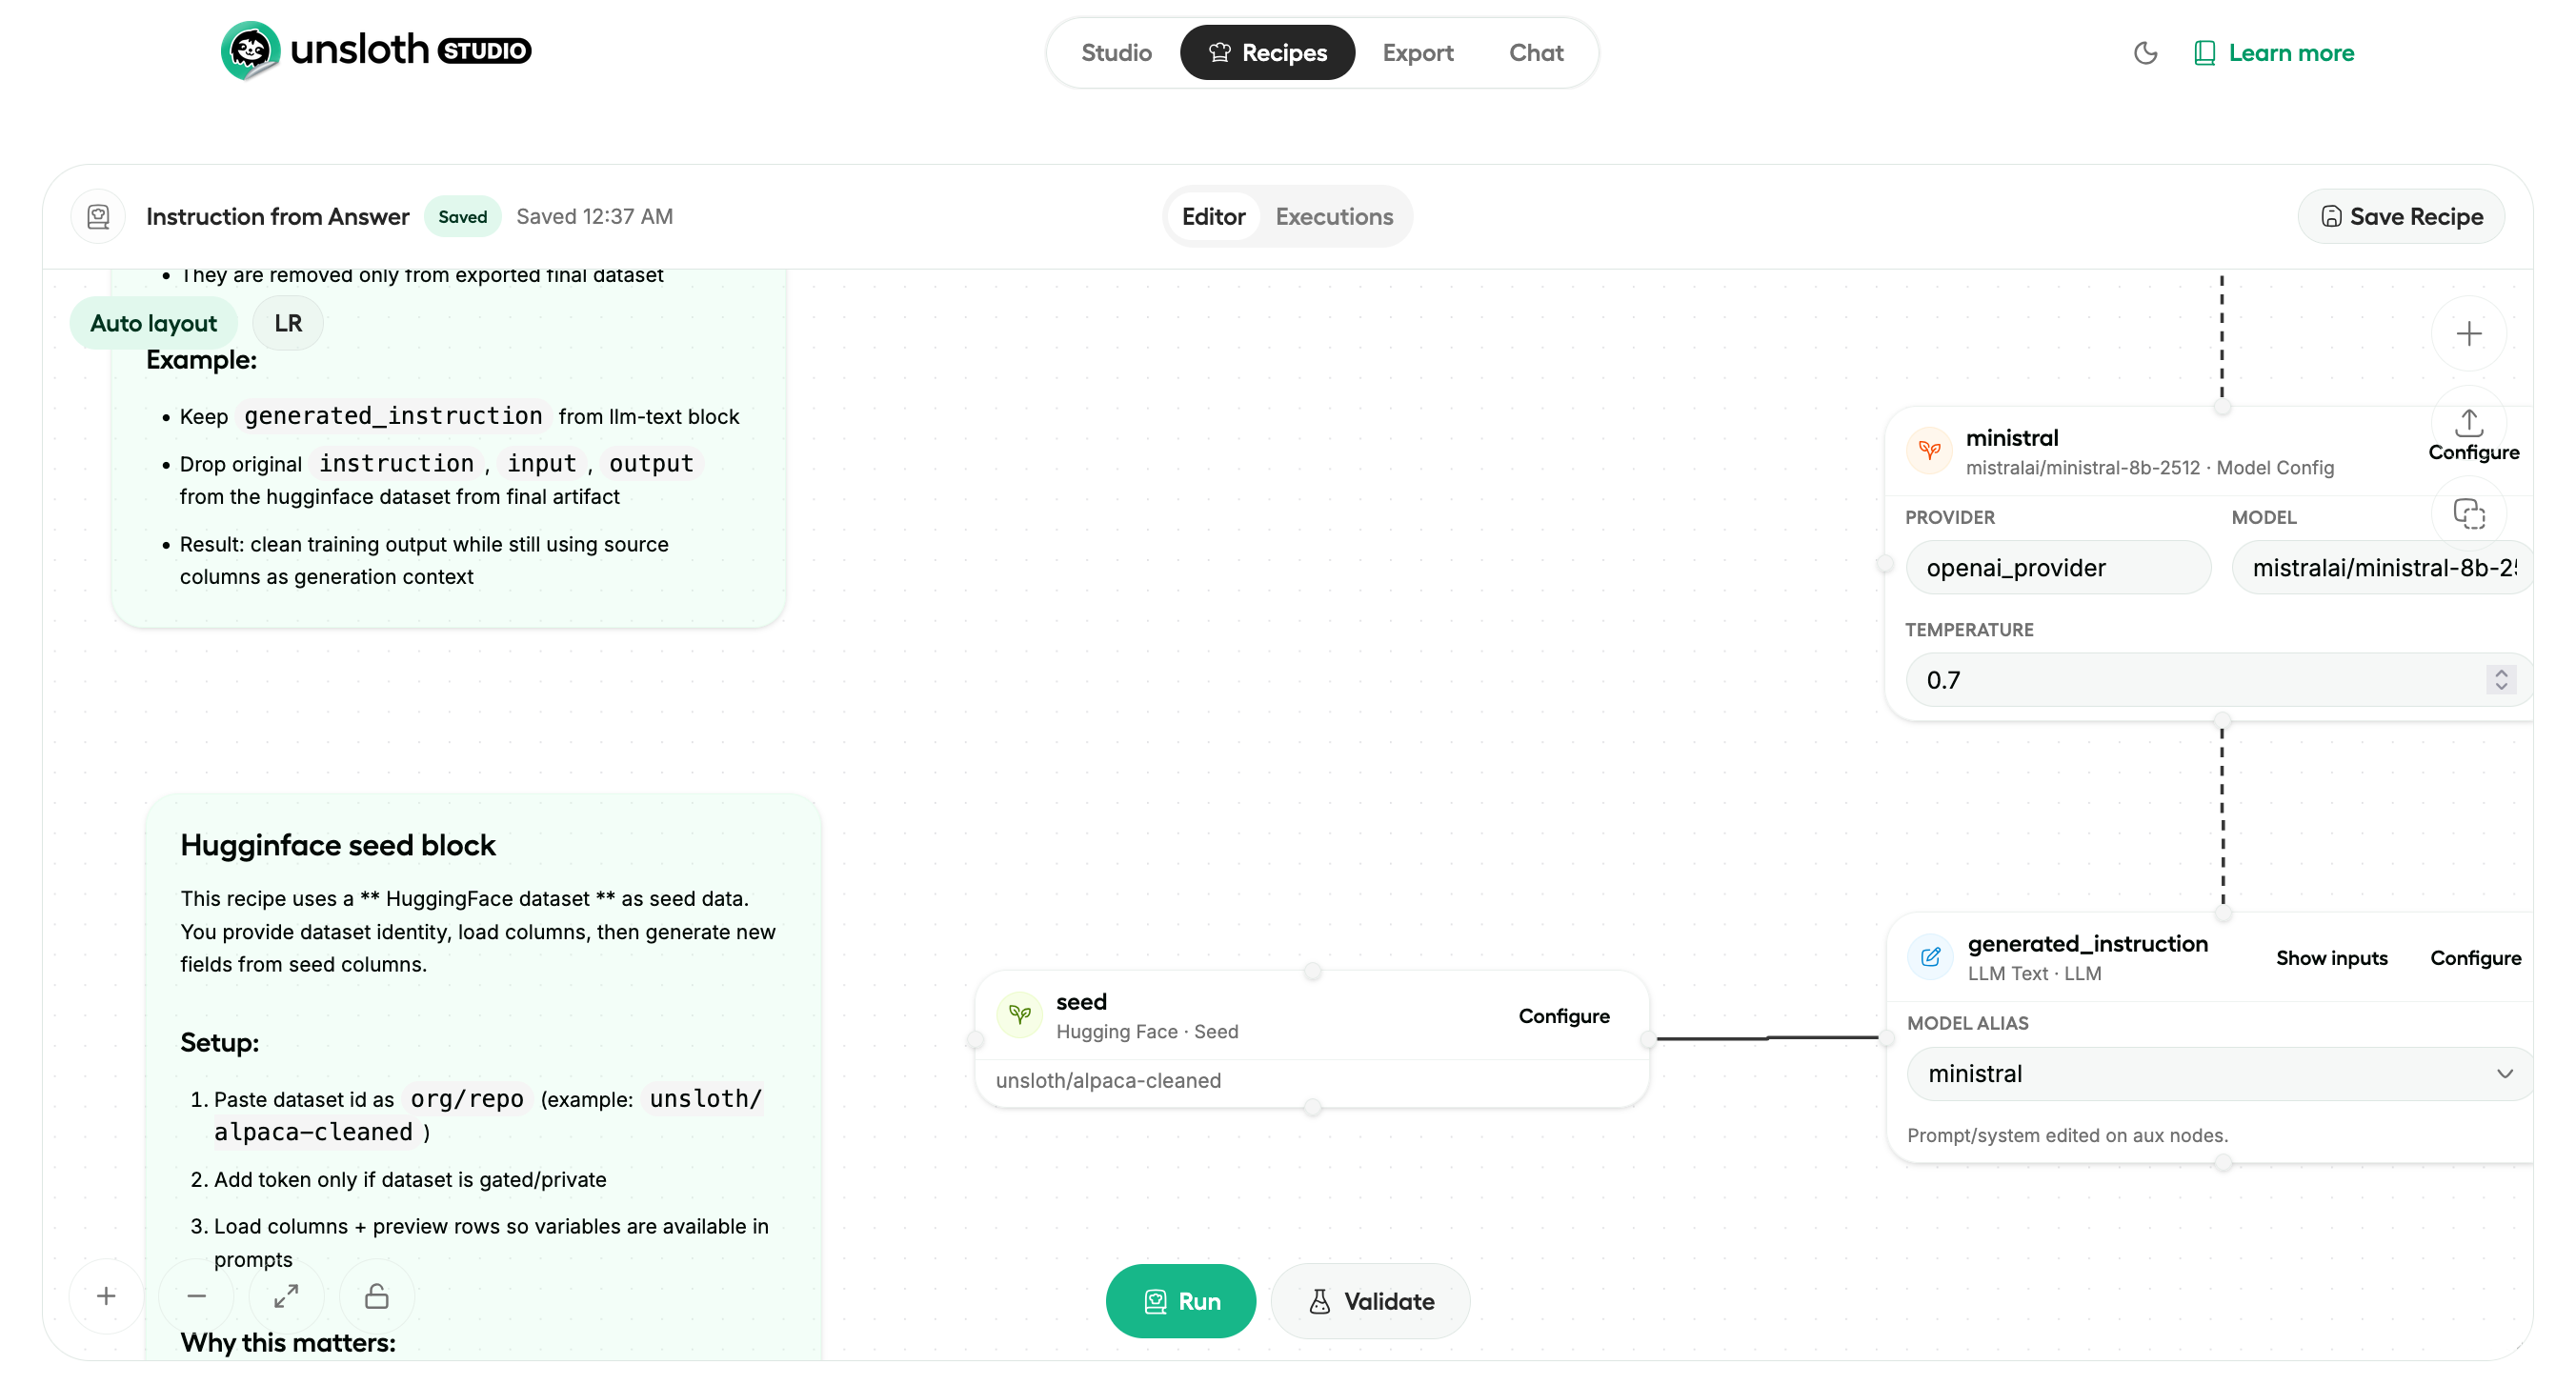
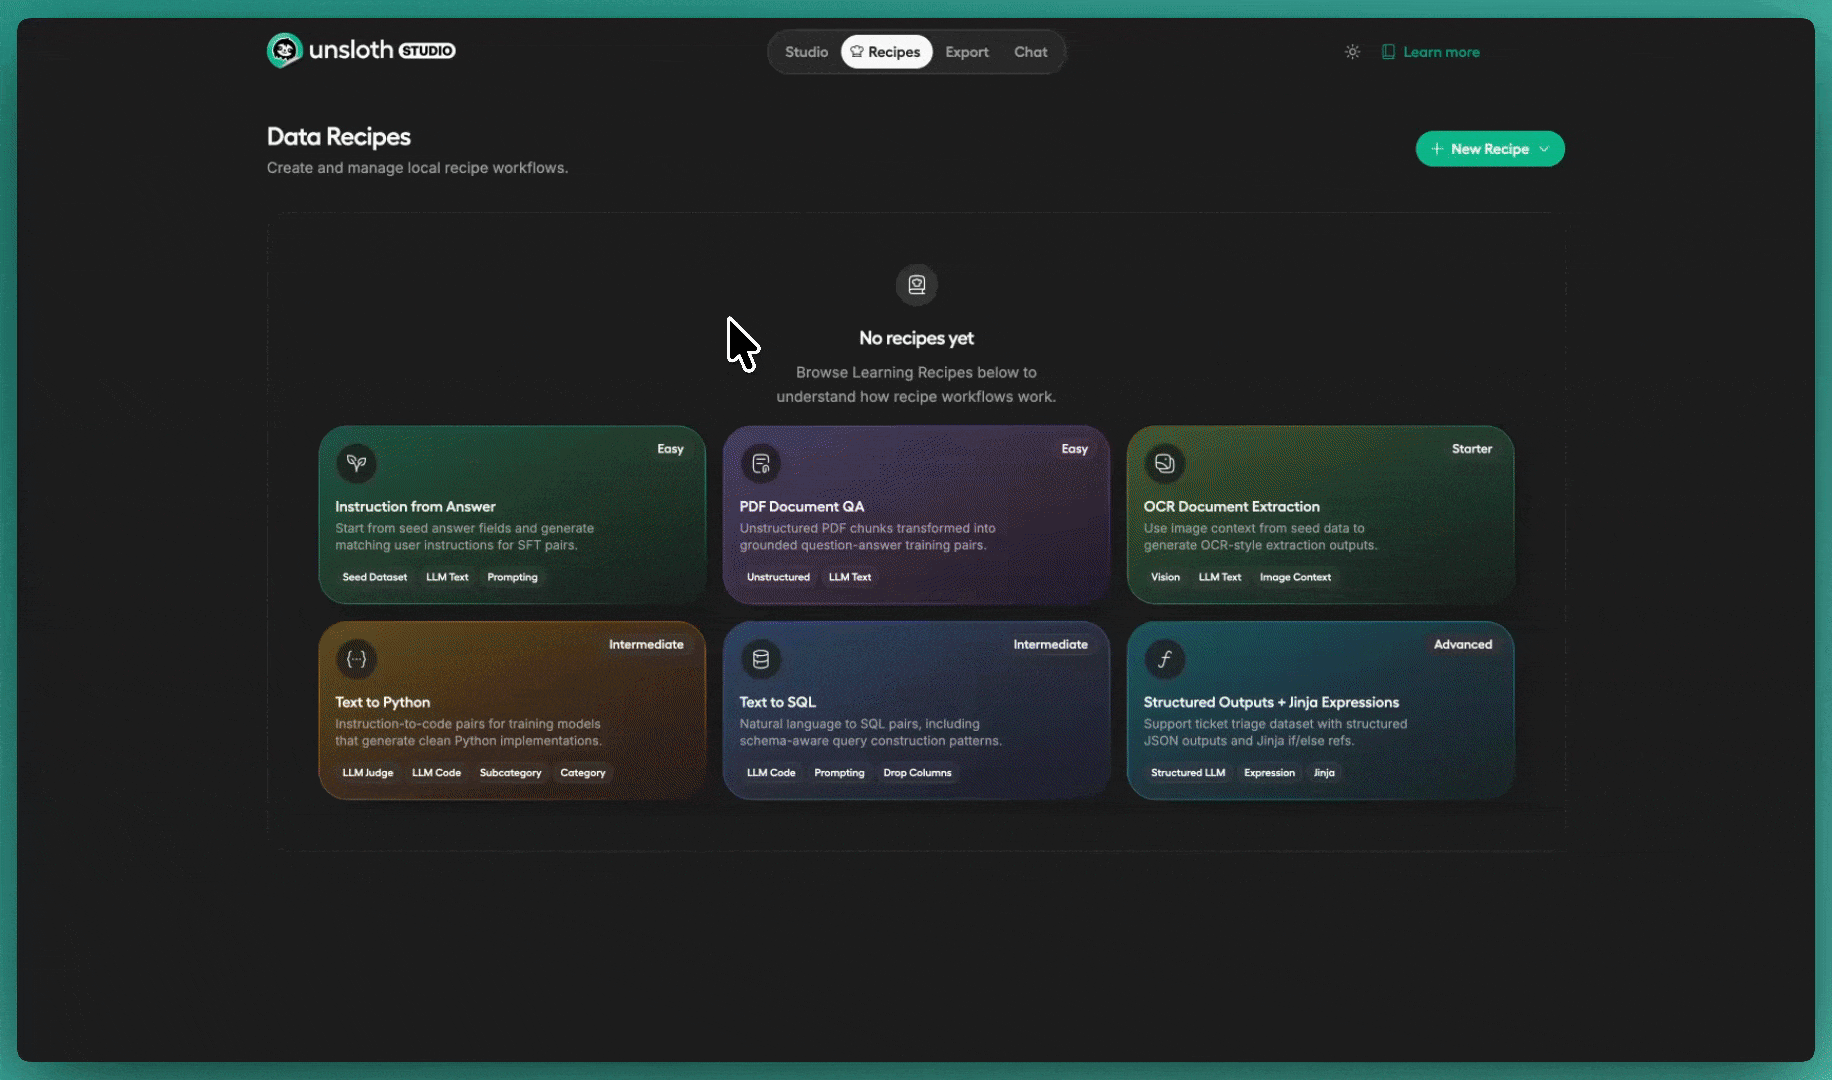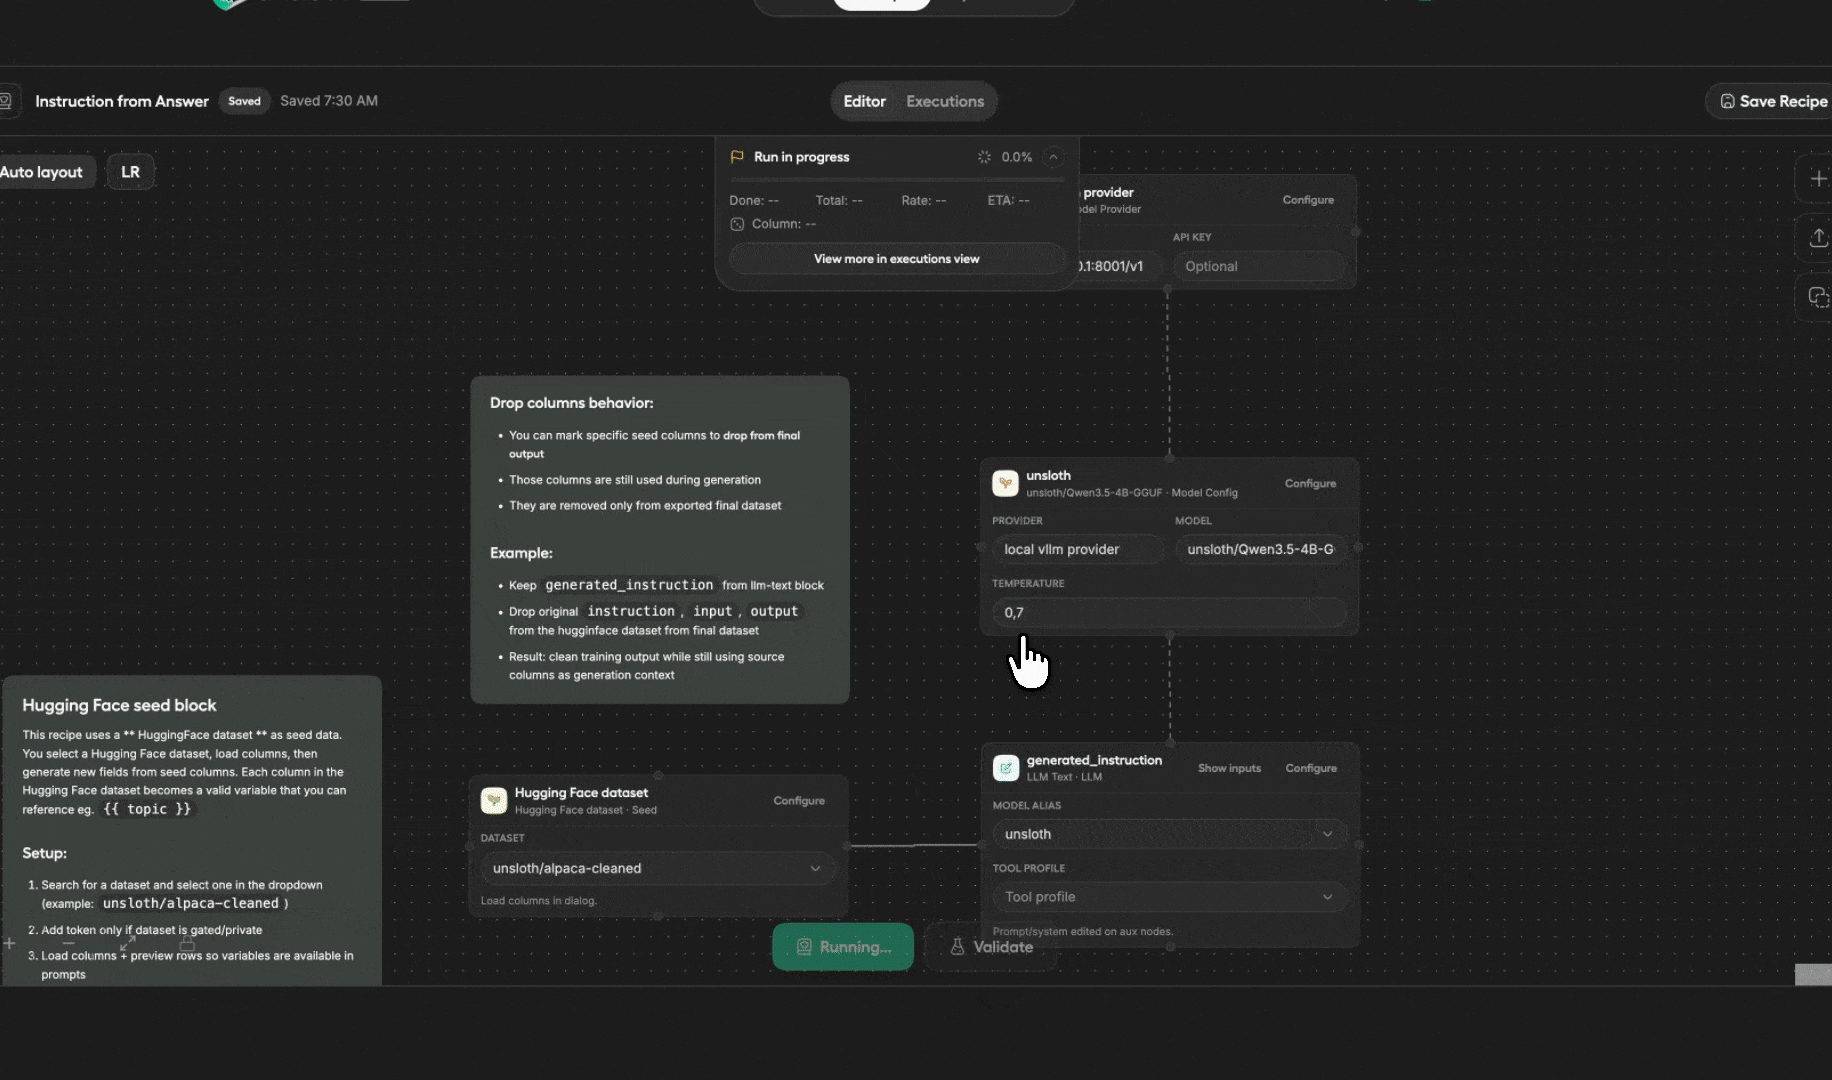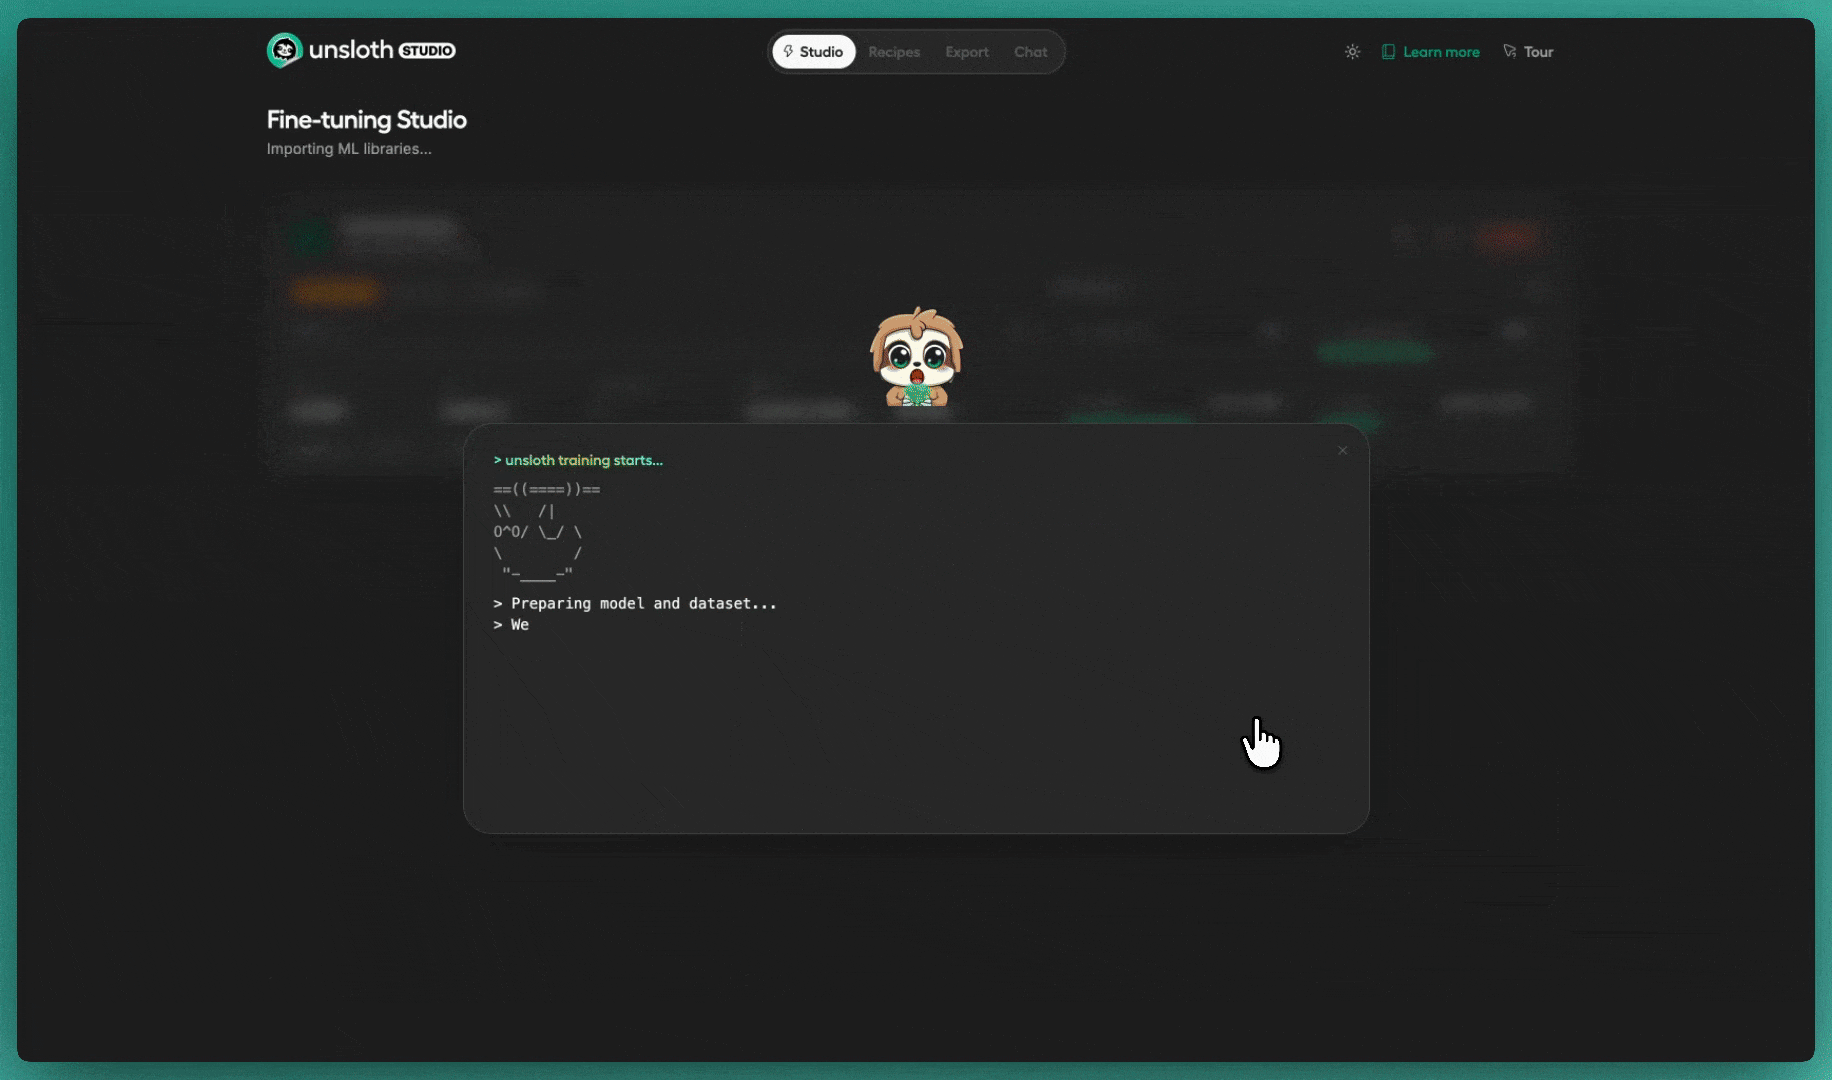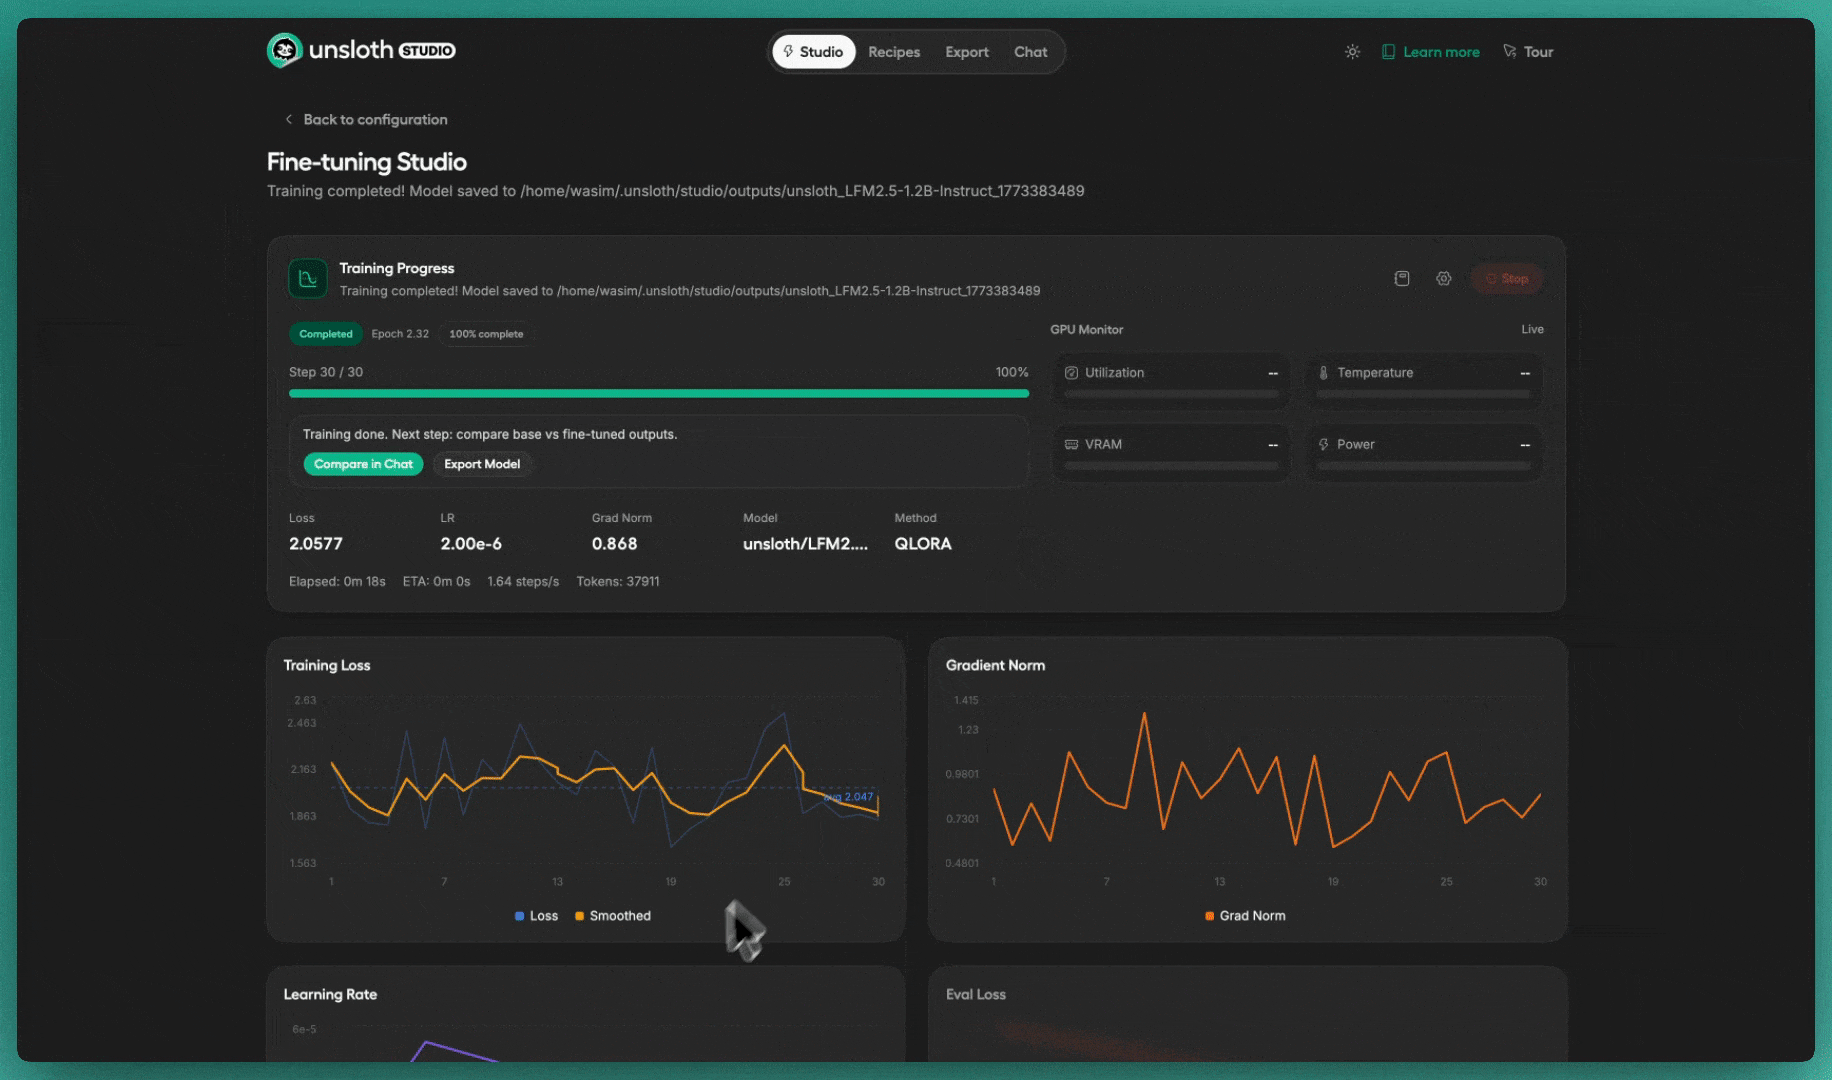
[Recettes de données Unsloth](/docs/fr/nouveau/studio/data-recipe.md) vous permet de téléverser des documents comme des PDF ou des fichiers CSV et de les transformer en jeux de données exploitables. Créez et modifiez visuellement des jeux de données via un flux de travail basé sur des nœuds graphiques.

La page des recettes est le point d’entrée principal. Les recettes sont stockées localement dans le navigateur, ce qui vous permet de revenir plus tard sur votre travail sauvegardé. Depuis ici, vous pouvez créer une recette vierge ou ouvrir une recette d’apprentissage guidée.

<div data-with-frame="true"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fc5m3JX1kUA3UwmdcJcxH%2FArea.gif?alt=media&amp;token=33bbd908-7d6c-456a-bc58-ce495c0adca1" alt=""><figcaption></figcaption></figure></div>

Les recettes de données suivent le même chemin de base. Vous ouvrez la page des recettes, créez ou choisissez une recette, construisez le flux de travail dans l'éditeur, validez-le, lancez un aperçu, puis exécutez l'ensemble du jeu de données une fois que le résultat paraît correct. Ajoutez des données d'amorçage et des blocs de génération, validez le flux de travail, prévisualisez un échantillon de sortie, puis lancez la création complète du jeu de données.

À première vue, un flux de travail habituel devrait ressembler à ceci :

1. Ouvrez la page des recettes.
2. Créez une nouvelle recette ou ouvrez-en une existante.
3. Ajoutez des blocs pour définir le flux de travail de votre jeu de données.
4. Cliquez sur **Valider** pour détecter rapidement les problèmes de configuration.
5. Exécutez un aperçu pour inspecter rapidement des lignes d’exemple.
6. Lancez une création complète du jeu de données lorsque la recette est prête.
7. Suivez la progression et la sortie en direct dans le graphe ou dans **Exécutions** vue pour plus de détails sur le mode.
8. Sélectionnez le jeu de données résultant dans Unsloth et affinez un modèle. Lire plus :

{% content-ref url="/pages/ec921eec2a37820cfd0cf432328d619c9fa1080b" %}
[Data Recipes](/docs/fr/nouveau/studio/data-recipe.md)
{% endcontent-ref %}

## Formatage des données

Lorsque nous avons identifié les critères pertinents et collecté les données nécessaires, nous pouvons alors formater nos données dans un format lisible par une machine, prêt pour l'entraînement.

### Formats de données courants pour l'entraînement des LLM

Pour [**pré-entraînement continu**](/docs/fr/notions-de-base/continued-pretraining.md), nous utilisons un format de texte brut sans structure spécifique :

```json
  "text": "Les pâtes carbonara sont un plat de pâtes romain traditionnel. La sauce est préparée en mélangeant des œufs crus avec du fromage Pecorino Romano râpé et du poivre noir. Les pâtes chaudes sont ensuite mélangées avec du guanciale croustillant (joue de porc salée) et le mélange d'œufs, créant une sauce crémeuse grâce à la chaleur résiduelle. Contrairement à une croyance répandue, une véritable carbonara ne contient jamais de crème ni d'ail. Le plat est probablement apparu à Rome au milieu du XXe siècle, bien que ses origines exactes soient débattues..."
```

Ce format préserve le flux du langage naturel et permet au modèle d'apprendre à partir d'un texte continu.

Si nous adaptons un modèle à une nouvelle tâche et voulons que le modèle produise du texte en un seul tour à partir d'un ensemble spécifique d'instructions, nous pouvons utiliser **Instruction** format dans le style [Alpaca](https://docs.unsloth.ai/basics/tutorial-how-to-finetune-llama-3-and-use-in-ollama#id-6.-alpaca-dataset)

```json
"Instruction": "Tâche que nous voulons que le modèle exécute."

"Input": "Optionnel, mais utile, cela sera essentiellement la requête de l'utilisateur."

"Output": "Le résultat attendu de la tâche et la sortie du modèle."
```

Lorsque nous voulons plusieurs tours de conversation, nous pouvons utiliser le format ShareGPT :

```json
{
  "conversations": [
    {
      "from": "humain",
      "value": "Pouvez-vous m'aider à faire des pâtes carbonara ?"
    },
    {
      "from": "gpt",
      "value": "Voulez-vous la recette romaine traditionnelle, ou une version plus simple ?"
    },
    {
      "from": "humain",
      "value": "La version traditionnelle, s'il vous plaît"
    },
    {
      "from": "gpt",
      "value": "La véritable carbonara romaine utilise seulement quelques ingrédients : pâtes, guanciale, œufs, Pecorino Romano et poivre noir. Voulez-vous la recette détaillée ?"
    }
  ]
}
```

Le format modèle utilise les clés d'attributs "from"/"value" et les messages alternent entre `humain`et `gpt`, ce qui permet un flux de dialogue naturel.

L'autre format courant est le format ChatML d'OpenAI, et c'est celui par défaut de Hugging Face. C'est probablement le format le plus utilisé, et il alterne entre `utilisateur` et `assistant`

```
{
  "messages": [
    {
      "role": "user",
      "content": "Quelle est 1+1 ?"
    },
    {
      "role": "assistant",
      "content": "C'est 2 !"
    },
  ]
}
```

### Application des modèles de chat avec Unsloth

Pour les jeux de données qui suivent généralement le format chatml courant, le processus de préparation du jeu de données pour l'entraînement ou le fine-tuning consiste en quatre étapes simples :

* Vérifiez les modèles de chat actuellement pris en charge par Unsloth :\\

  ```
  from unsloth.chat_templates import CHAT_TEMPLATES
  print(list(CHAT_TEMPLATES.keys()))
  ```

  \
  Cela affichera la liste des modèles actuellement pris en charge par Unsloth. Voici un exemple de sortie :\\

  ```
  ['unsloth', 'zephyr', 'chatml', 'mistral', 'llama', 'vicuna', 'vicuna_old', 'vicuna old', 'alpaca', 'gemma', 'gemma_chatml', 'gemma2', 'gemma2_chatml', 'llama-3', 'llama3', 'phi-3', 'phi-35', 'phi-3.5', 'llama-3.1', 'llama-31', 'llama-3.2', 'llama-3.3', 'llama-32', 'llama-33', 'qwen-2.5', 'qwen-25', 'qwen25', 'qwen2.5', 'phi-4', 'gemma-3', 'gemma3']
  ```

  \\\\
* Utilisez `get_chat_template` pour appliquer le bon modèle de chat à votre tokenizer :\\

  ```
  from unsloth.chat_templates import get_chat_template

  tokenizer = get_chat_template(
      tokenizer,
      chat_template = "gemma-3", # modifiez ceci avec le bon nom de chat_template
  )
  ```

  \\\\
* Définissez votre fonction de formatage. Voici un exemple :\\

  ```
  def formatting_prompts_func(examples):
     convos = examples["conversations"]
     texts = [tokenizer.apply_chat_template(convo, tokenize = False, add_generation_prompt = False) for convo in convos]
     return { "text" : texts, }
  ```

  \
  \
  Cette fonction parcourt votre jeu de données en appliquant le modèle de chat que vous avez défini à chaque exemple.\\
* Enfin, chargeons le jeu de données et appliquons les modifications requises à notre jeu de données : \\

  ```
  # Importer et charger le jeu de données
  from datasets import load_dataset
  dataset = load_dataset("repo_name/dataset_name", split = "train")

  # Appliquez la fonction de formatage à votre jeu de données à l'aide de la méthode map
  dataset = dataset.map(formatting_prompts_func, batched = True,)
  ```

  \
  Si votre jeu de données utilise le format ShareGPT avec les clés "from"/"value" au lieu du format ChatML "role"/"content", vous pouvez utiliser la `standardize_sharegpt` fonction pour le convertir d'abord. Le code révisé ressemblera désormais à ceci :\
  \\

  ```
  # Importer le jeu de données
  from datasets import load_dataset
  dataset = load_dataset("mlabonne/FineTome-100k", split = "train")

  # Convertissez votre jeu de données au format "role"/"content" si nécessaire
  from unsloth.chat_templates import standardize_sharegpt
  dataset = standardize_sharegpt(dataset)

  # Appliquez la fonction de formatage à votre jeu de données à l'aide de la méthode map
  dataset = dataset.map(formatting_prompts_func, batched = True,)
  ```

### Formatage des données Q\&R

<mark style="color:vert;">**Q :**</mark> Comment puis-je utiliser le format d'instruction Alpaca ?

<mark style="color:vert;">**R :**</mark> Si votre jeu de données est déjà formaté au format Alpaca, alors suivez les étapes de formatage comme indiqué dans Llama3.1 [notebook ](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-Alpaca.ipynb#scrollTo=LjY75GoYUCB8). Si vous devez convertir vos données au format Alpaca, une approche consiste à créer un script Python pour traiter vos données brutes. Si vous travaillez sur une tâche de résumé, vous pouvez utiliser un LLM local pour générer des instructions et des sorties pour chaque exemple.

<mark style="color:vert;">**Q :**</mark> Dois-je toujours utiliser la méthode standardize\_sharegpt ?

<mark style="color:vert;">**R :**</mark> N'utilisez la méthode standardize\_sharegpt que si votre jeu de données cible est formaté au format sharegpt, mais que votre modèle attend à la place un format ChatML.

\ <mark style="color:vert;">**Q :**</mark> Pourquoi ne pas utiliser la fonction apply\_chat\_template fournie avec le tokeniseur.

<mark style="color:vert;">**R :**</mark> Le `chat_template` L'attribut lorsqu'un modèle est d'abord téléversé par les propriétaires du modèle original contient parfois des erreurs et peut mettre du temps à être mis à jour. En revanche, chez Unsloth, nous vérifions minutieusement et corrigeons toute erreur dans le `chat_template` pour chaque modèle lorsque nous téléversons les versions quantifiées dans nos dépôts. De plus, nos `get_chat_template` et `apply_chat_template` méthodes offrent des fonctionnalités avancées de manipulation des données, entièrement documentées dans notre documentation sur les Chat Templates [page](https://docs.unsloth.ai/basics/chat-templates).

<mark style="color:vert;">**Q :**</mark> Et si mon template n'est actuellement pas pris en charge par Unsloth ?

<mark style="color:vert;">**R :**</mark> Soumettez une demande de fonctionnalité sur les issues GitHub d'Unsloth [forum](https://github.com/unslothai/unsloth). Comme solution temporaire, vous pouvez aussi utiliser la fonction apply\_chat\_template du tokeniseur jusqu'à ce que votre demande de fonctionnalité soit approuvée et fusionnée.

## Génération de données synthétiques

Vous pouvez également utiliser n'importe quel LLM local comme Llama 3.3 (70B) ou GPT 4.5 d'OpenAI pour générer des données synthétiques. En général, il vaut mieux utiliser un modèle plus grand comme Llama 3.3 (70B) afin de garantir des sorties de la plus haute qualité. Vous pouvez utiliser directement des moteurs d'inférence comme vLLM, Ollama ou llama.cpp pour générer des données synthétiques, mais cela nécessitera un certain travail manuel pour les collecter et demander davantage de données. Il y a 3 objectifs pour les données synthétiques :

* Produire des données entièrement nouvelles - soit à partir de zéro, soit à partir de votre jeu de données existant
* Diversifier votre jeu de données afin que votre modèle ne [surapprenne](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md#avoiding-overfitting-and-underfitting) et ne devienne trop spécifique
* Enrichir les données existantes, par exemple en structurant automatiquement votre jeu de données dans le bon format choisi

### Utiliser Unsloth pour les données synthétiques

Vous pouvez facilement téléverser n'importe quelles données non structurées ou structurées dans Unsloth Studio's [Recettes de données](/docs/fr/nouveau/studio/data-recipe.md) et elles seront automatiquement converties en un jeu de données exploitable / synthétique. Plus de détails dans [notre guide](/docs/fr/nouveau/studio/data-recipe.md).

<div data-with-frame="true"><figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2FQ6e19jESrJg0VjHnX58c%2Fdata%20recipes%20final.png?alt=media&amp;token=8d74e453-815d-4790-83d1-76d0bc80a3ce" alt="" width="563"><figcaption></figcaption></figure></div>

### Utiliser un LLM local ou ChatGPT pour les données synthétiques

Votre objectif est d'inciter le modèle à générer et traiter des données QA dans le format que vous avez spécifié. Le modèle devra apprendre la structure que vous avez fournie ainsi que le contexte, alors assurez-vous d'avoir au moins 10 exemples de données déjà préparés. Exemples d'invites :

* **Invite pour générer davantage de dialogues à partir d'un jeu de données existant**:

  <pre data-overflow="wrap"><code><strong>À partir de l'exemple de jeu de données que j'ai fourni, suivez la structure et générez des conversations basées sur les exemples.
  </strong></code></pre>
* **Invite si vous n'avez pas de jeu de données**:

  {% code overflow="wrap" %}

  ```
  Créez 10 exemples d'avis produits pour Coca-Cola classés comme positifs, négatifs ou neutres.
  ```

  {% endcode %}
* **Invite pour un jeu de données sans formatage**:

  {% code overflow="wrap" %}

  ```
  Structurez mon jeu de données afin qu'il soit dans un format QA ChatML pour l'ajustement fin. Générez ensuite 5 exemples de données synthétiques avec le même sujet et le même format.
  ```

  {% endcode %}

Il est recommandé de vérifier la qualité des données générées afin de supprimer ou d'améliorer les réponses non pertinentes ou de mauvaise qualité. Selon votre jeu de données, il peut aussi devoir être équilibré à de nombreux endroits afin que votre modèle ne surapprenne pas. Vous pouvez ensuite renvoyer ce jeu de données nettoyé à votre LLM pour régénérer des données, cette fois avec encore plus de guidance.

## FAQ + conseils sur les jeux de données

### Quelle taille mon jeu de données devrait-il avoir ?

Nous recommandons généralement d'utiliser un minimum absolu d'au moins 100 lignes de données pour l'ajustement fin afin d'obtenir des résultats raisonnables. Pour des performances optimales, un jeu de données de plus de 1 000 lignes est préférable, et dans ce cas, davantage de données conduit généralement à de meilleurs résultats. Si votre jeu de données est trop petit, vous pouvez aussi ajouter des données synthétiques ou ajouter un jeu de données provenant de Hugging Face pour le diversifier. Cependant, l'efficacité de votre modèle ajusté dépend fortement de la qualité du jeu de données, alors veillez à nettoyer et préparer vos données minutieusement.

### Comment dois-je structurer mon jeu de données si je veux ajuster finement un modèle de raisonnement ?

Si vous voulez ajuster finement un modèle qui possède déjà des capacités de raisonnement comme les versions distillées de DeepSeek-R1 (par ex. DeepSeek-R1-Distill-Llama-8B), vous devrez toujours suivre des paires question/tâche et réponse ; cependant, pour votre réponse, vous devrez la modifier de sorte qu'elle inclue le processus de raisonnement/de chaîne de pensée et les étapes utilisées pour dériver la réponse.\
\
Pour un modèle qui n'a pas de raisonnement et que vous souhaitez entraîner afin qu'il acquière ensuite des capacités de raisonnement, vous devrez utiliser un jeu de données standard mais cette fois sans raisonnement dans ses réponses. Ce processus d'entraînement est connu comme [Apprentissage par renforcement et GRPO](/docs/fr/commencer/reinforcement-learning-rl-guide.md).

### Jeux de données multiples

Si vous avez plusieurs jeux de données pour l'ajustement fin, vous pouvez soit :

* Standardiser le format de tous les jeux de données, les combiner en un seul jeu de données et effectuer l'ajustement fin sur ce jeu de données unifié.
* Utilisez le [Jeux de données multiples](https://colab.research.google.com/drive/1njCCbE1YVal9xC83hjdo2hiGItpY_D6t?usp=sharing) notebook pour effectuer directement l'ajustement fin sur plusieurs jeux de données.

### Puis-je ajuster finement le même modèle plusieurs fois ?

Vous pouvez ajuster finement plusieurs fois un modèle déjà ajusté, mais il est préférable de combiner tous les jeux de données et d'effectuer l'ajustement fin en un seul processus à la place. L'entraînement d'un modèle déjà ajusté peut potentiellement modifier la qualité et les connaissances acquises lors du précédent processus d'ajustement fin.

## Utiliser des jeux de données dans Unsloth

### Jeu de données Alpaca

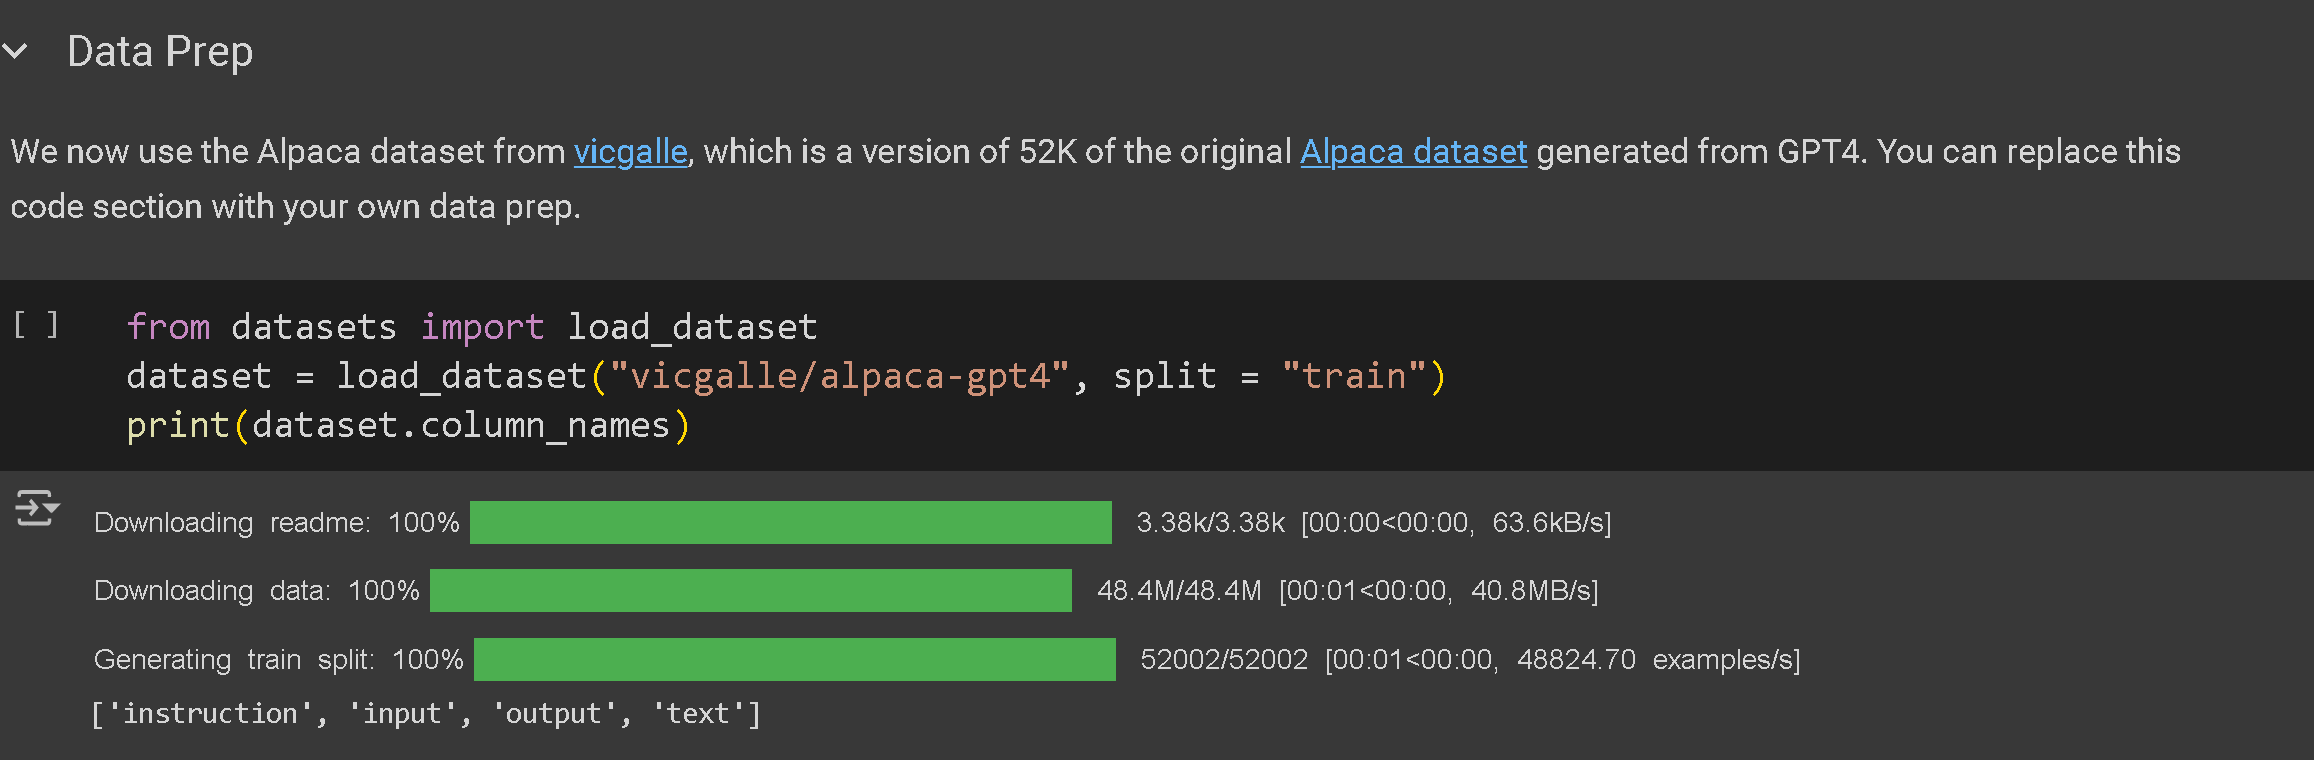
Voir un exemple d'utilisation du jeu de données Alpaca dans Unsloth sur Google Colab :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-1d66d8714e44d90513dd87b9356eec67886ab3f7%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Nous allons maintenant utiliser le jeu de données Alpaca créé en appelant GPT-4 lui-même. C'est une liste de 52 000 instructions et sorties qui était très populaire lors de la sortie de Llama-1, car elle permettait à un LLM de base ajusté finement d'être compétitif avec ChatGPT lui-même.

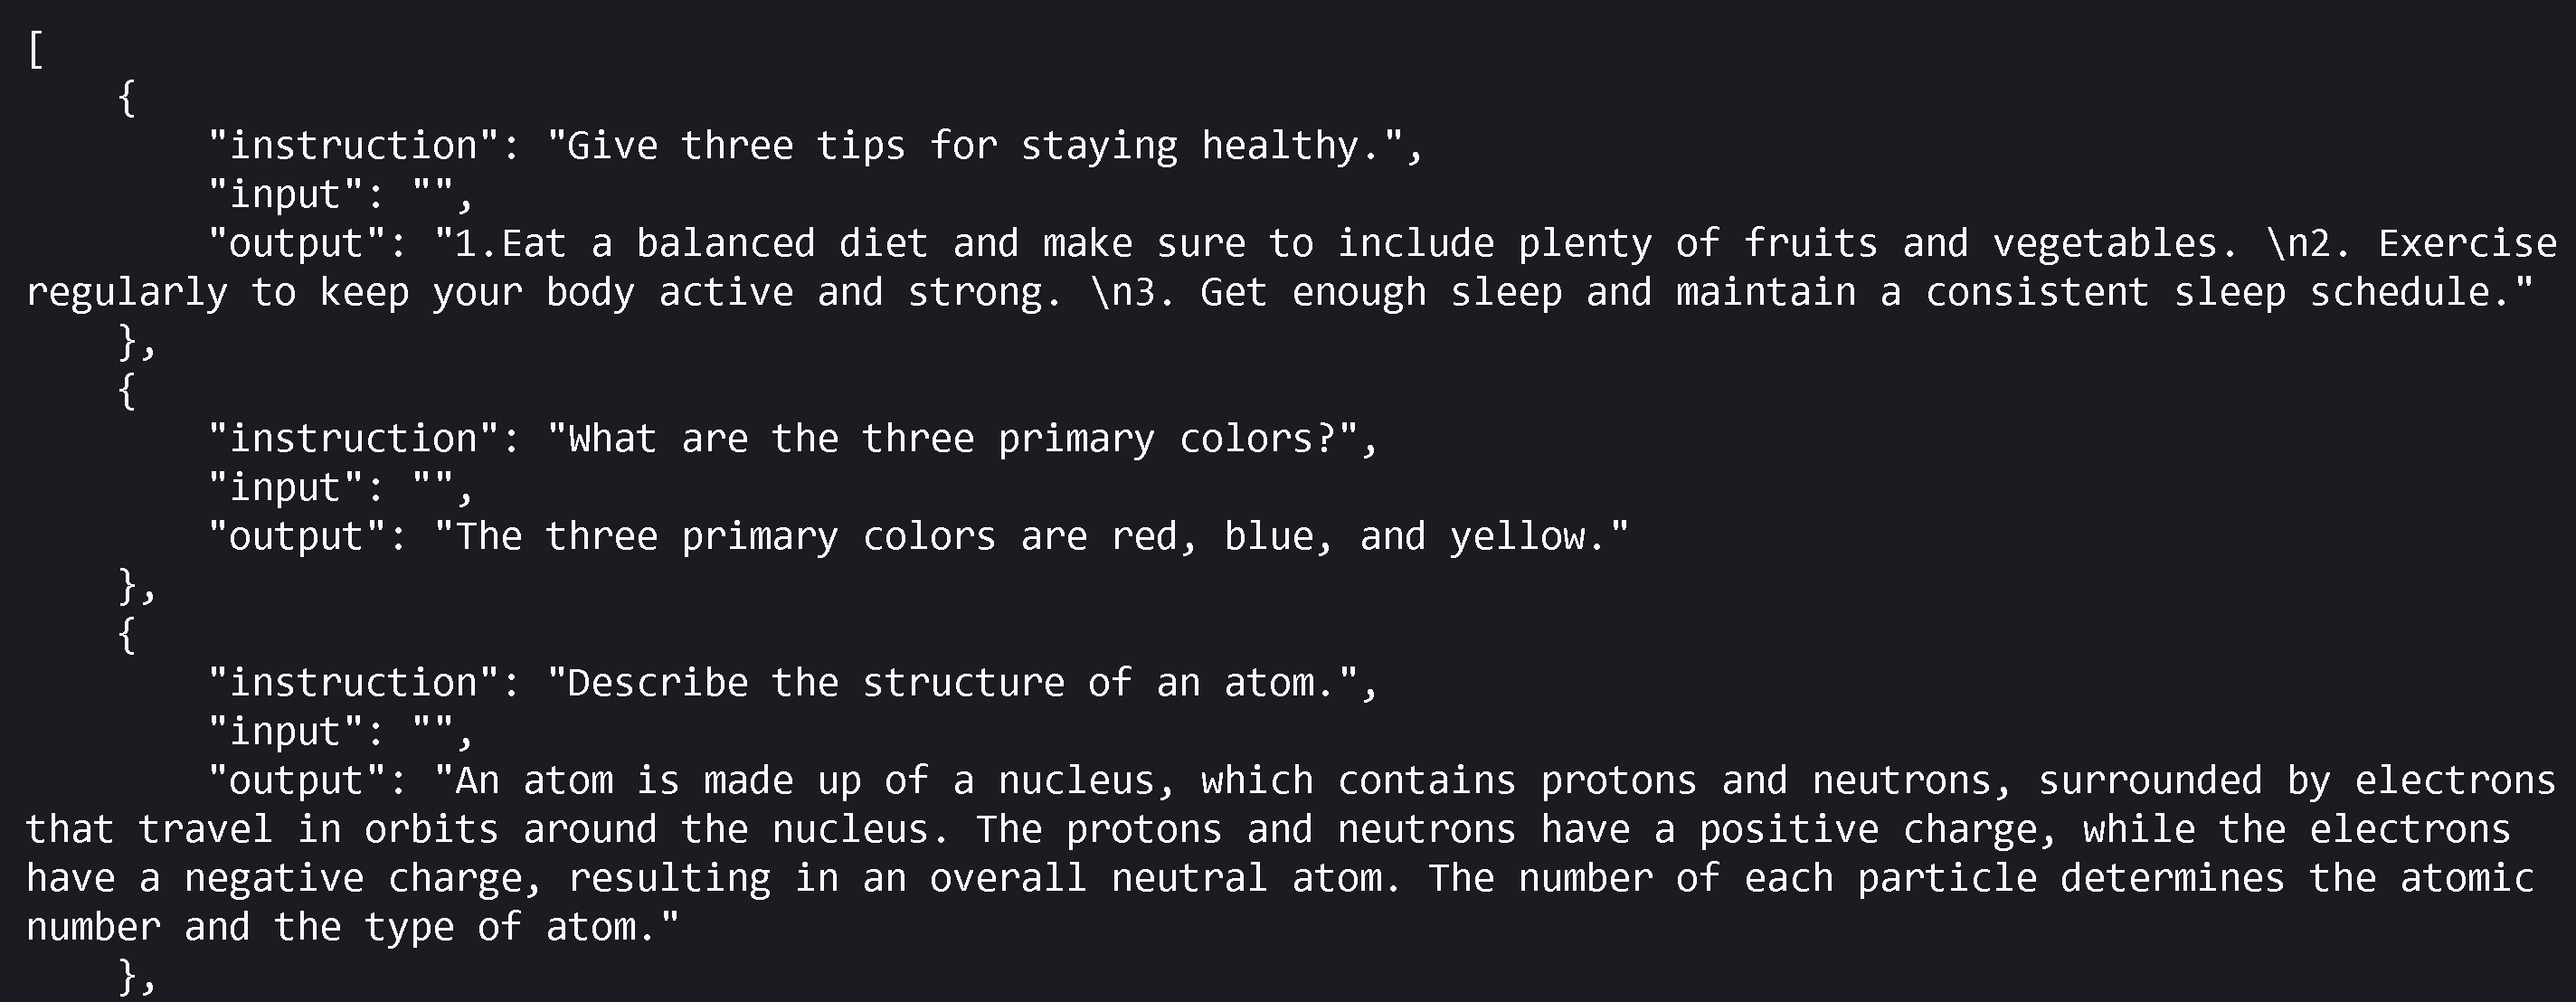
Vous pouvez accéder à la version GPT-4 du jeu de données Alpaca [ici](https://huggingface.co/datasets/vicgalle/alpaca-gpt4.). Ci-dessous, quelques exemples du jeu de données :

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-0dde50e386e7b245d3e8a57e10a4a81755b3769a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

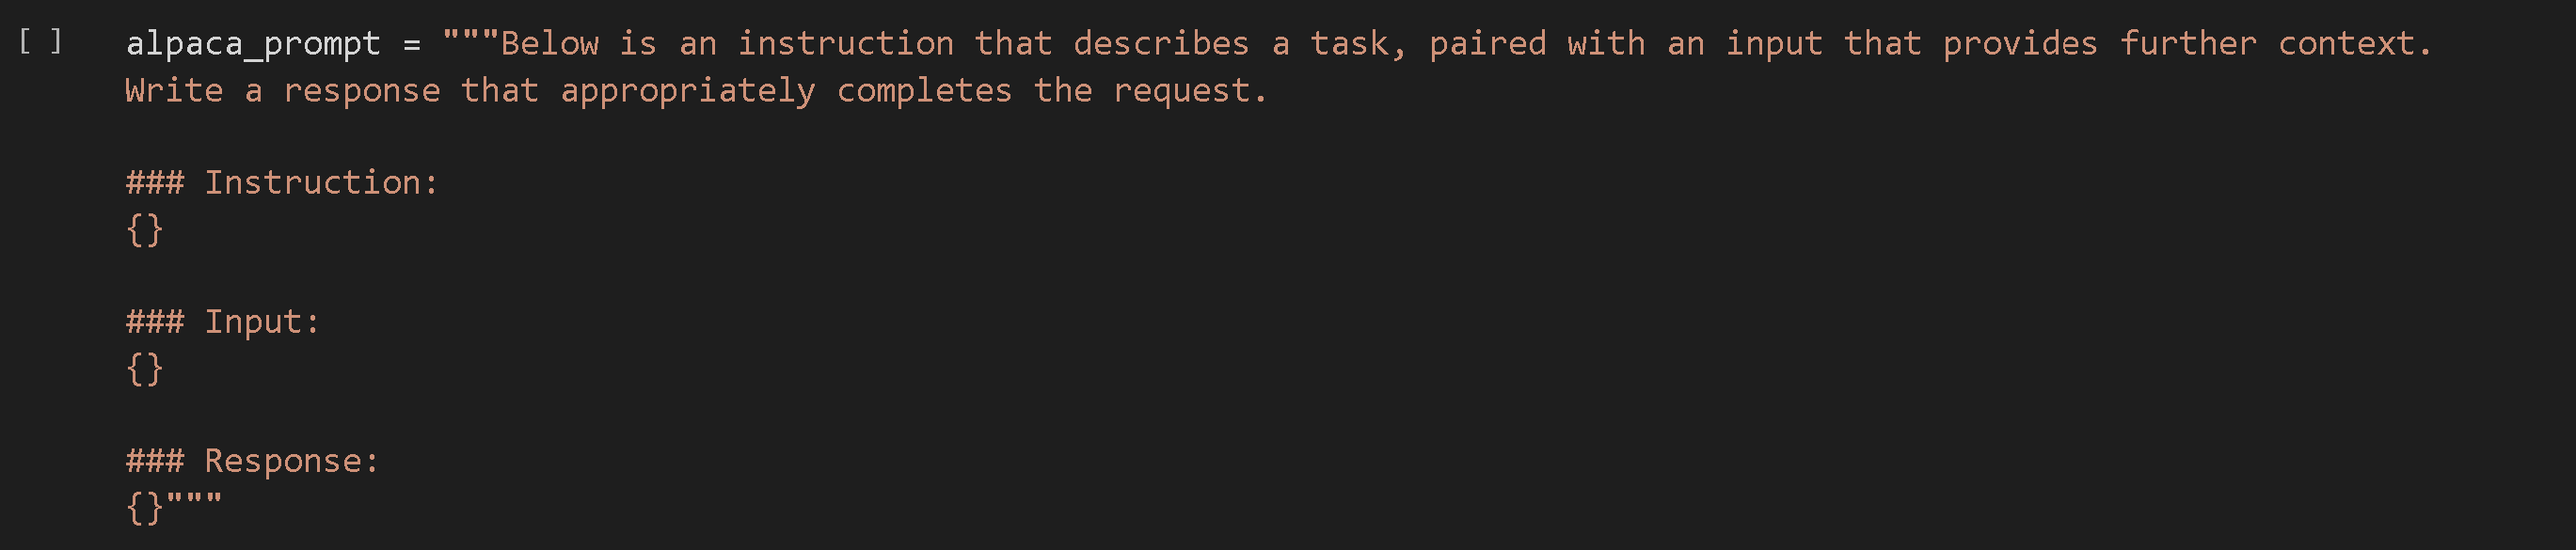
Vous pouvez voir qu'il y a 3 colonnes dans chaque ligne - une instruction, une entrée et une sortie. Nous combinons essentiellement chaque ligne en une grande invite comme ci-dessous. Nous l'utilisons ensuite pour ajuster finement le modèle de langage, et cela l'a rendu très similaire à ChatGPT. Nous appelons ce processus **ajustement fin supervisé par instruction**.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-8b3663c5d80adcb935ff77661500f08e13c9af2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### Plusieurs colonnes pour l'ajustement fin

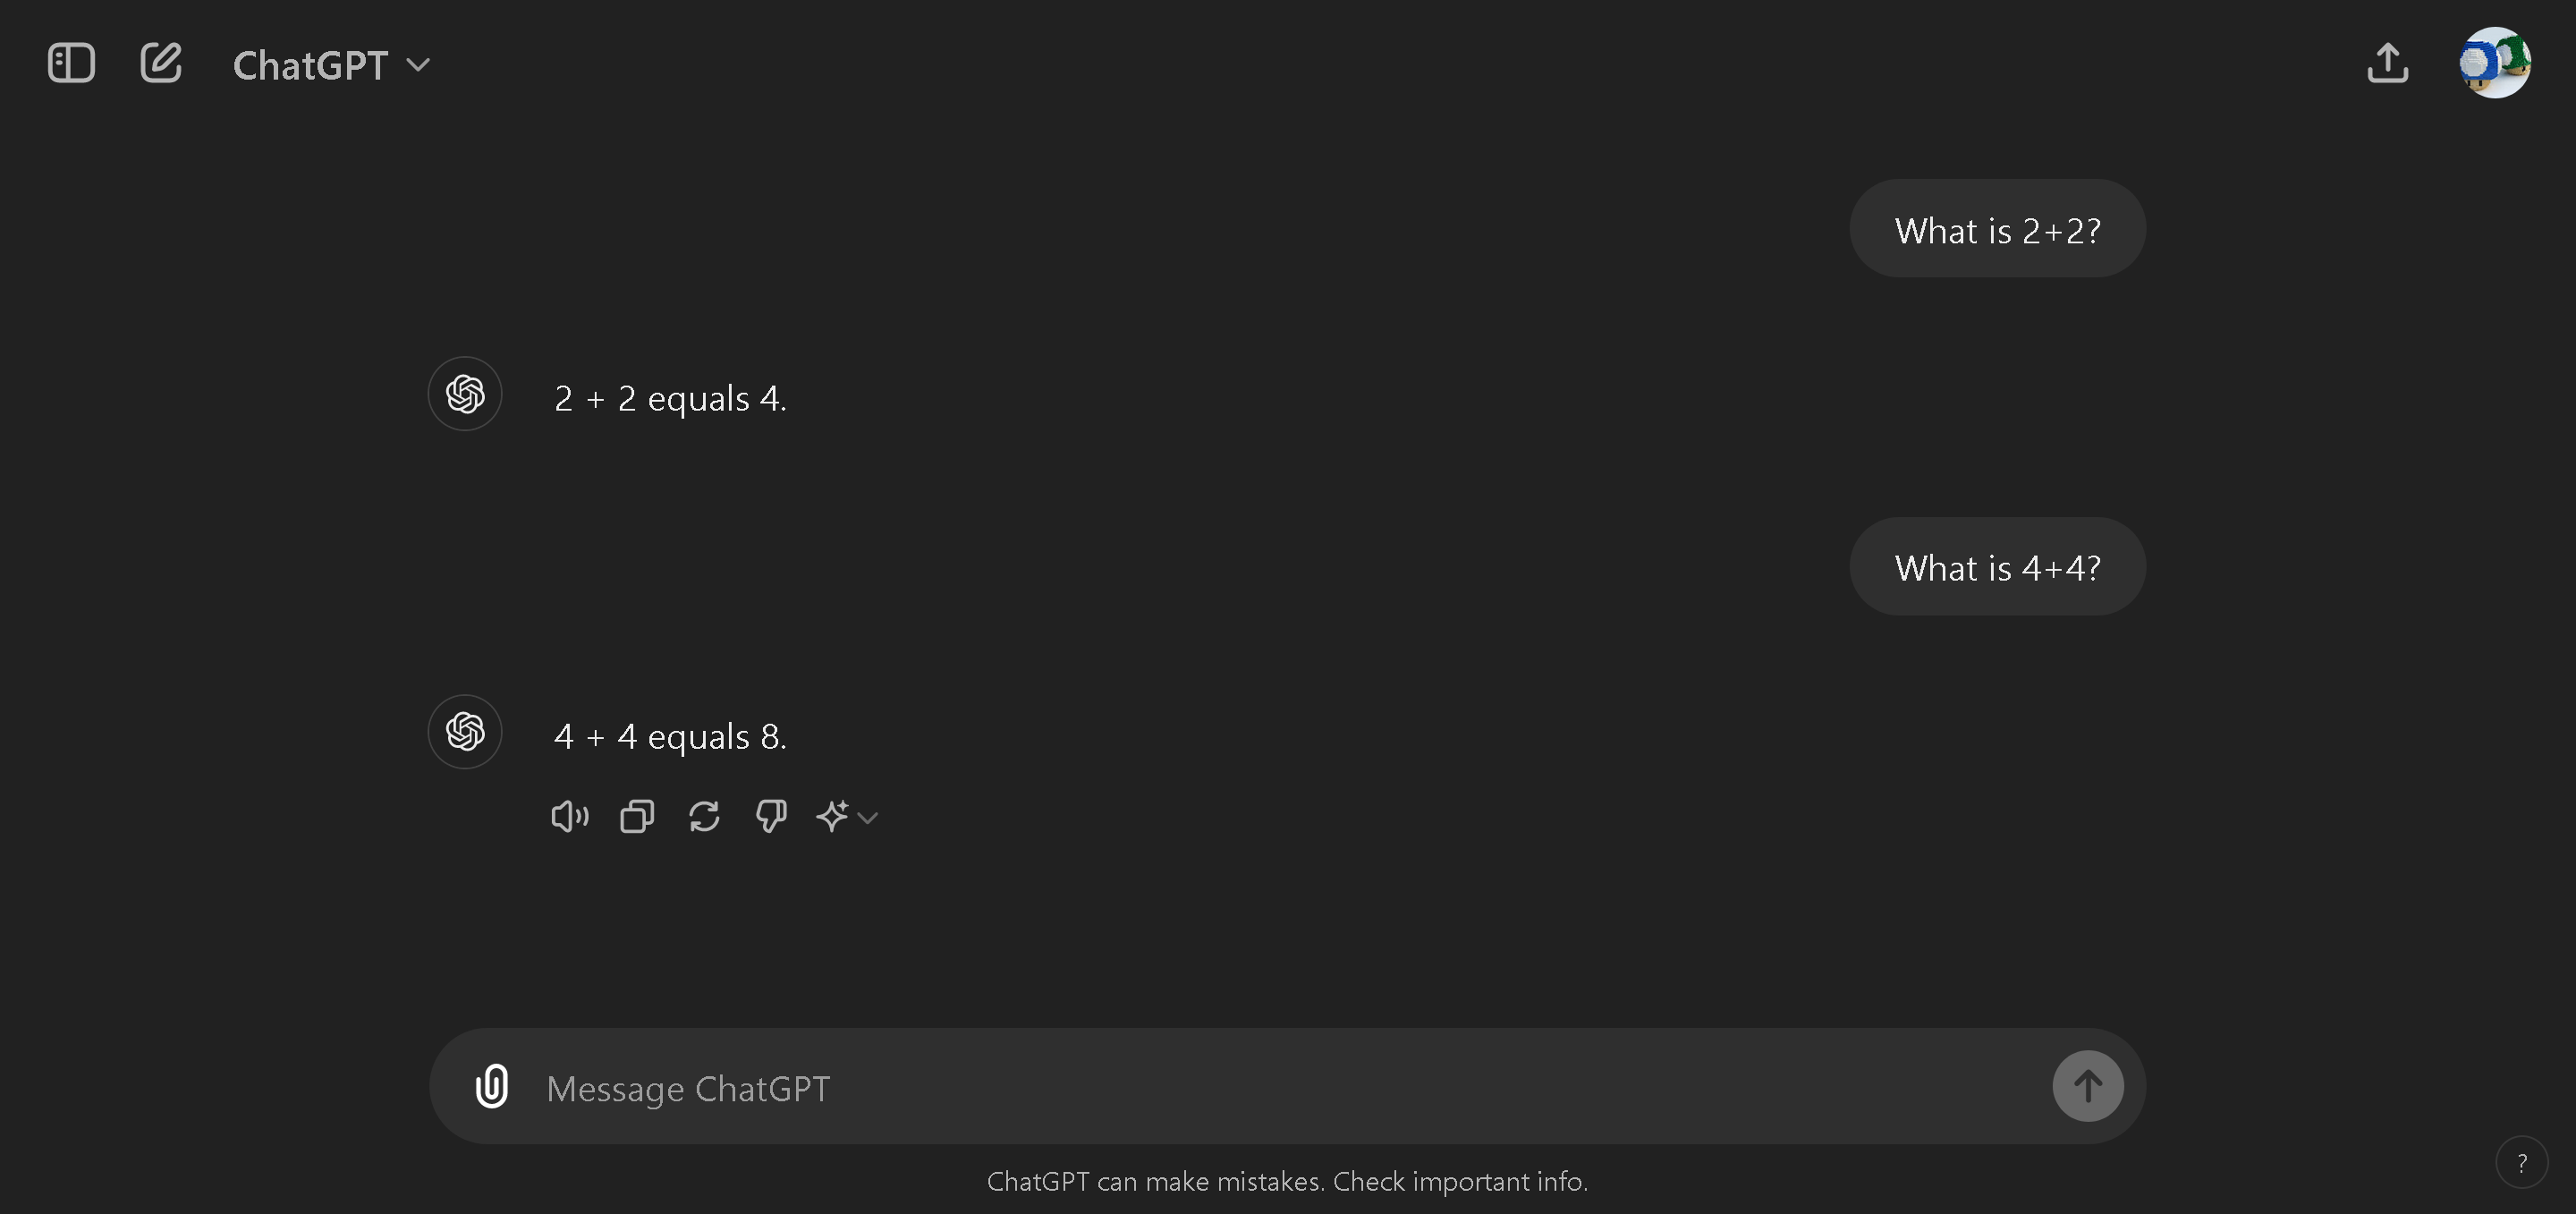
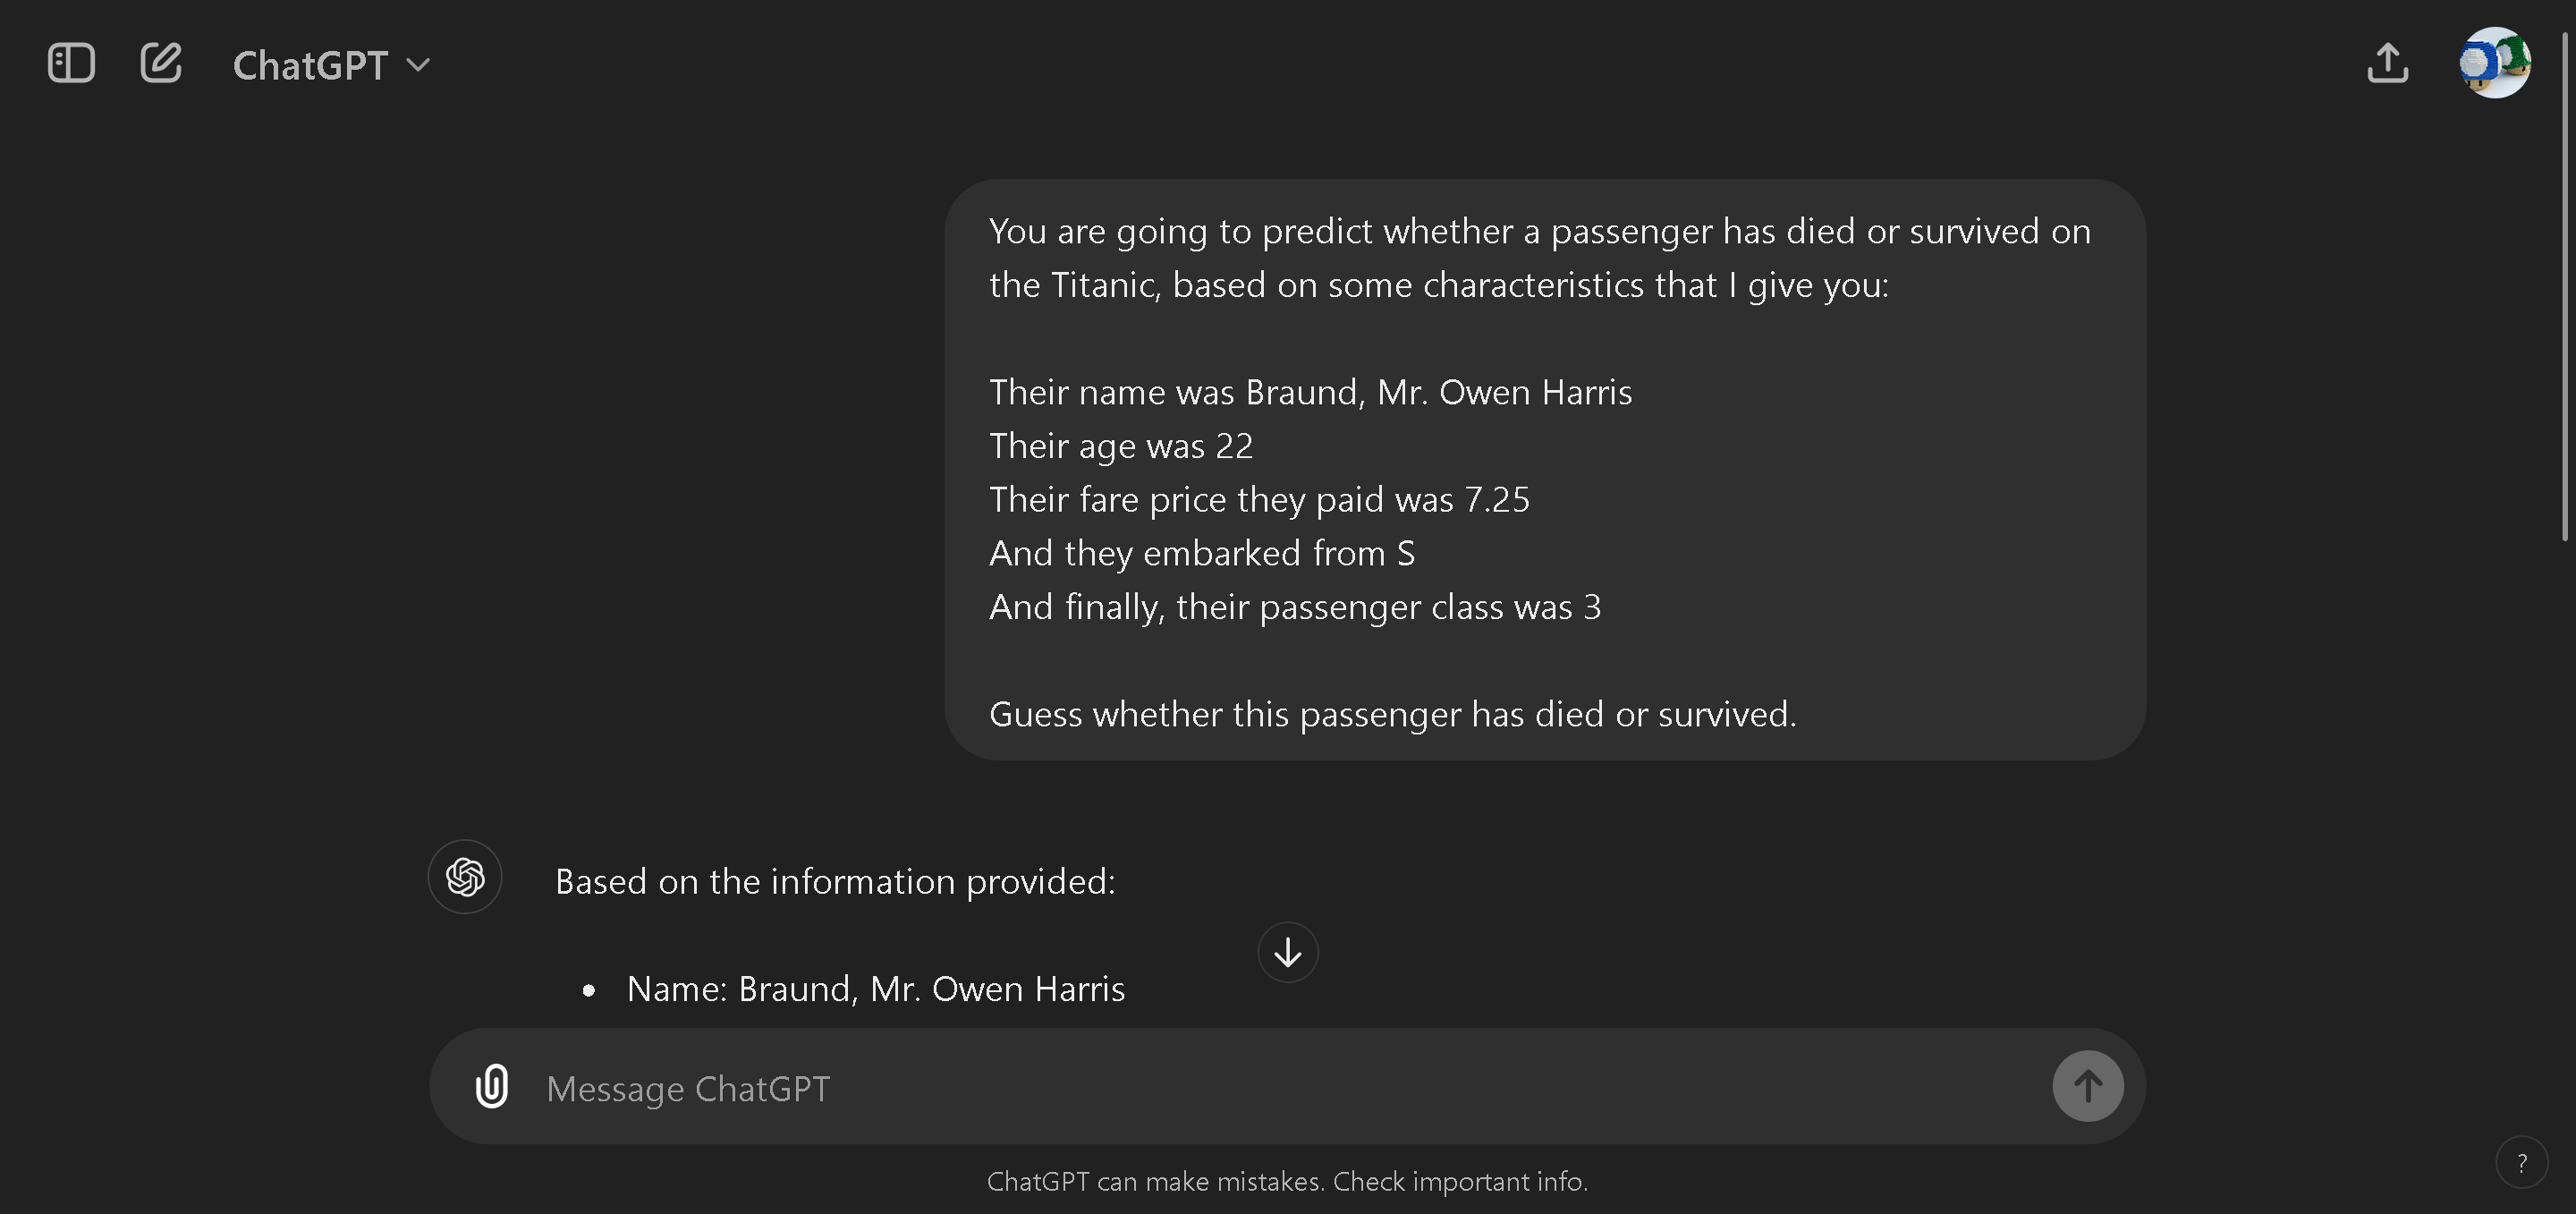
Mais un gros problème est que pour les assistants de style ChatGPT, nous n'autorisons qu'une seule instruction / une seule invite, et non plusieurs colonnes / entrées. Par exemple dans ChatGPT, vous pouvez voir que nous devons soumettre une seule invite, et non plusieurs invites.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-d90162c2685ced871f4151369aadcaee40a9c54f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

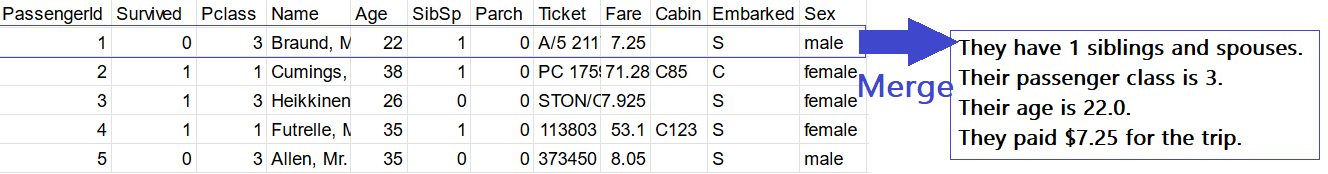
Cela signifie essentiellement que nous devons "fusionner" plusieurs colonnes en une seule grande invite pour que l'ajustement fin fonctionne réellement !

Par exemple, le très célèbre jeu de données Titanic comporte de très nombreuses colonnes. Votre travail consistait à prédire si un passager avait survécu ou était décédé en fonction de son âge, de sa classe de passager, du prix du billet, etc. Nous ne pouvons pas simplement transmettre cela à ChatGPT, mais nous devons plutôt "fusionner" ces informations en une seule grande invite.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-a2df04874bfc879182cb66c789341d49700227ea%2FMerge.png?alt=media" alt=""><figcaption></figcaption></figure>

Par exemple, si nous interrogeons ChatGPT avec notre seule invite "fusionnée" qui comprend toutes les informations relatives à ce passager, nous pouvons alors lui demander de deviner ou de prédire si le passager est mort ou a survécu.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-b3da2b36afe37469cd3962f37186e758871864a5%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

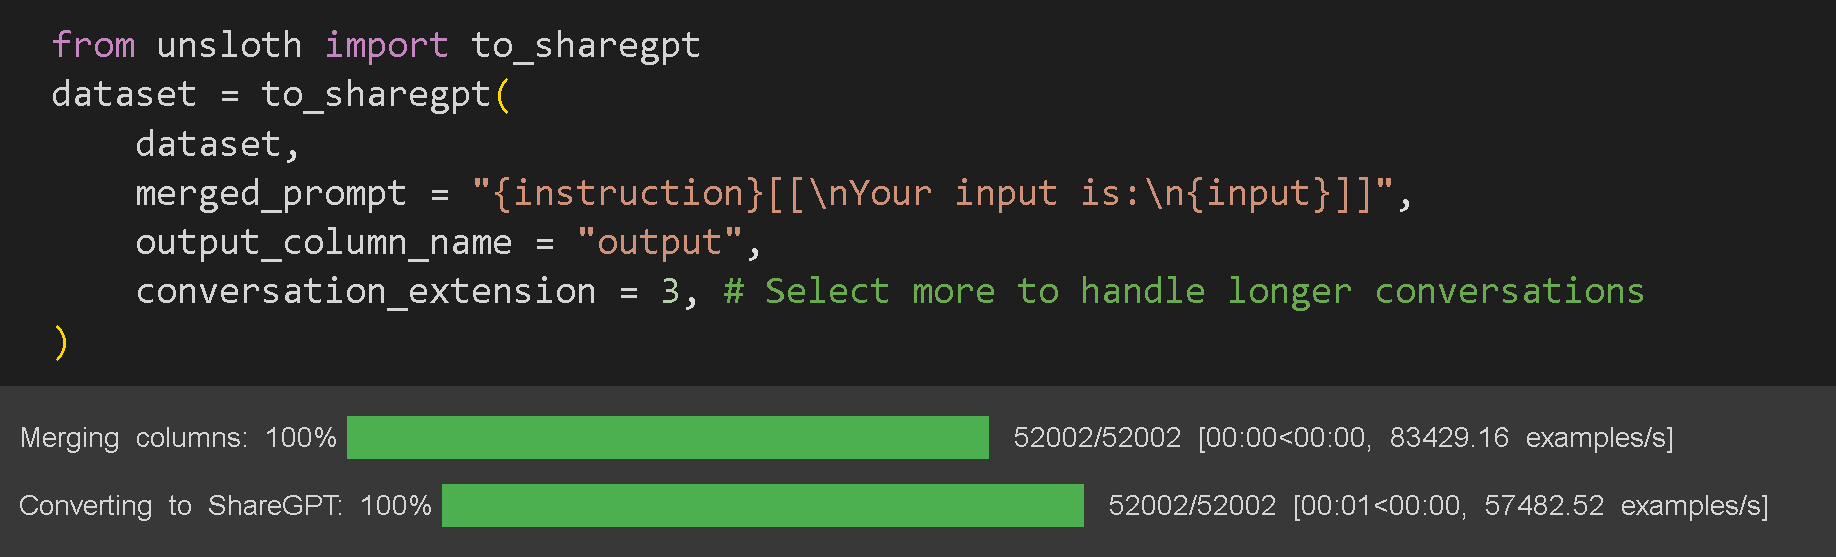
D'autres bibliothèques d'ajustement fin exigent que vous prépariez manuellement votre jeu de données pour l'ajustement fin, en fusionnant toutes vos colonnes en une seule invite. Dans Unsloth, nous fournissons simplement la fonction appelée `to_sharegpt` qui fait tout cela d'un seul coup !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-62b94dc44f2e343020d31de575f52eb22be4b0fc%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

C'est maintenant un peu plus compliqué, puisque nous autorisons beaucoup de personnalisation, mais voici quelques points :

* Vous devez enfermer toutes les colonnes entre accolades `{}`. Ce sont les noms de colonnes dans le fichier CSV / Excel réel.
* Les composants textuels optionnels doivent être enfermés entre `[[]]`. Par exemple, si la colonne "input" est vide, la fonction de fusion n'affichera pas le texte et le sautera. C'est utile pour les jeux de données avec des valeurs manquantes.
* Sélectionnez la colonne de sortie ou cible / prédiction dans `output_column_name`. Pour le jeu de données Alpaca, ce sera `sortie`.

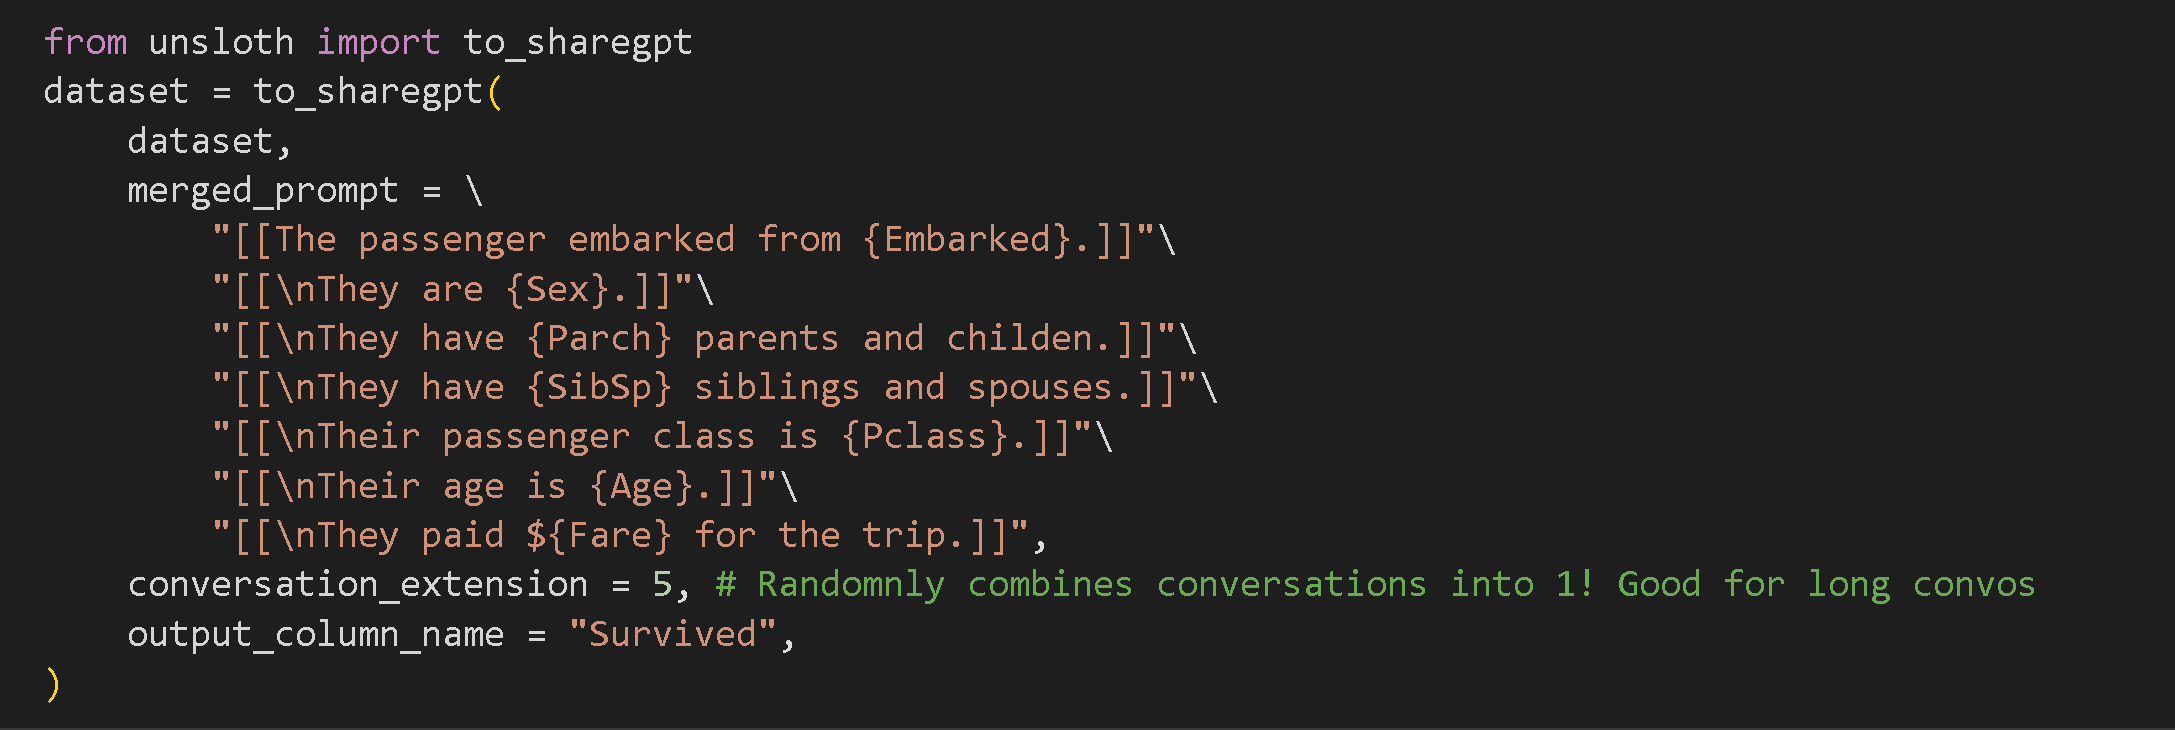
Par exemple, dans le jeu de données Titanic, nous pouvons créer un grand format d'invite fusionnée comme ci-dessous, où chaque colonne / morceau de texte devient optionnel.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-e6228cf6e5c0bb4e4b45e6f3e045910d567c33d2%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Par exemple, imaginez que le jeu de données ressemble à ceci avec beaucoup de données manquantes :

| Embarqué | Âge | Tarif |
| -------- | --- | ----- |
| S        | 23  |       |
|          | 18  | 7.25  |

Alors, nous ne voulons pas que le résultat soit :

1. Le passager a embarqué à S. Son âge est 23. Son tarif est **VIDE**.
2. Le passager a embarqué à **VIDE**. Son âge est 18. Son tarif est 7,25 $.

Au lieu de cela, en entourant éventuellement les colonnes à l'aide de `[[]]`, nous pouvons exclure entièrement cette information.

1. \[\[Le passager a embarqué à S.]] \[\[Son âge est 23.]] \[\[Son tarif est **VIDE**.]]
2. \[\[Le passager a embarqué à **VIDE**.]] \[\[Son âge est 18.]] \[\[Son tarif est 7,25 $.]]

devient :

1. Le passager a embarqué à S. Son âge est 23.
2. Son âge est 18. Son tarif est 7,25 $.

### Conversations à plusieurs tours

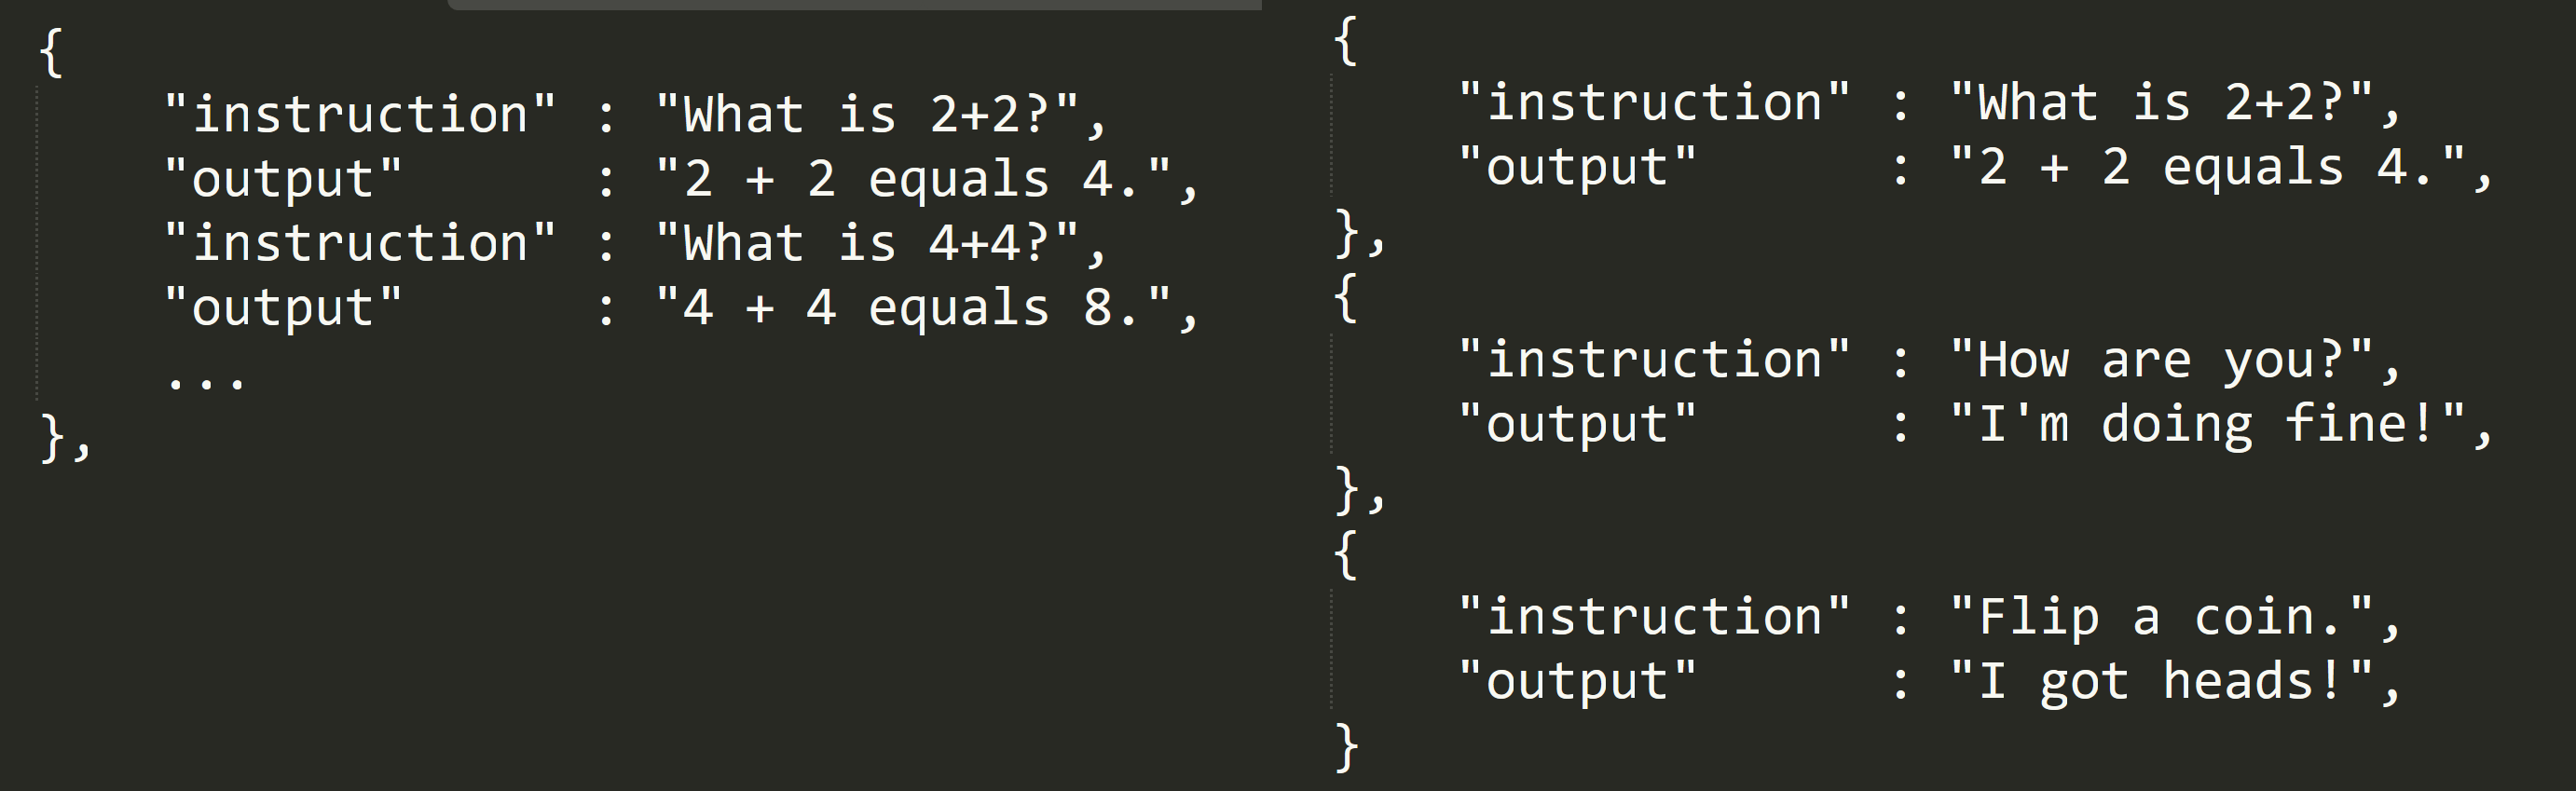
Un problème si vous ne l’aviez pas remarqué est que l’ensemble de données Alpaca est à tour unique, alors que rappelez-vous que l’utilisation de ChatGPT était interactive et que vous pouviez lui parler en plusieurs tours. Par exemple, la partie gauche est ce que nous voulons, mais la partie droite, qui est l’ensemble de données Alpaca, ne fournit que des conversations uniques. Nous voulons que le modèle de langage affiné apprenne en quelque sorte à faire des conversations à plusieurs tours, tout comme ChatGPT.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2a65cd74ddd03a6bcbbc9827d9d034e4879a8e6a%2Fdiff.png?alt=media" alt=""><figcaption></figcaption></figure>

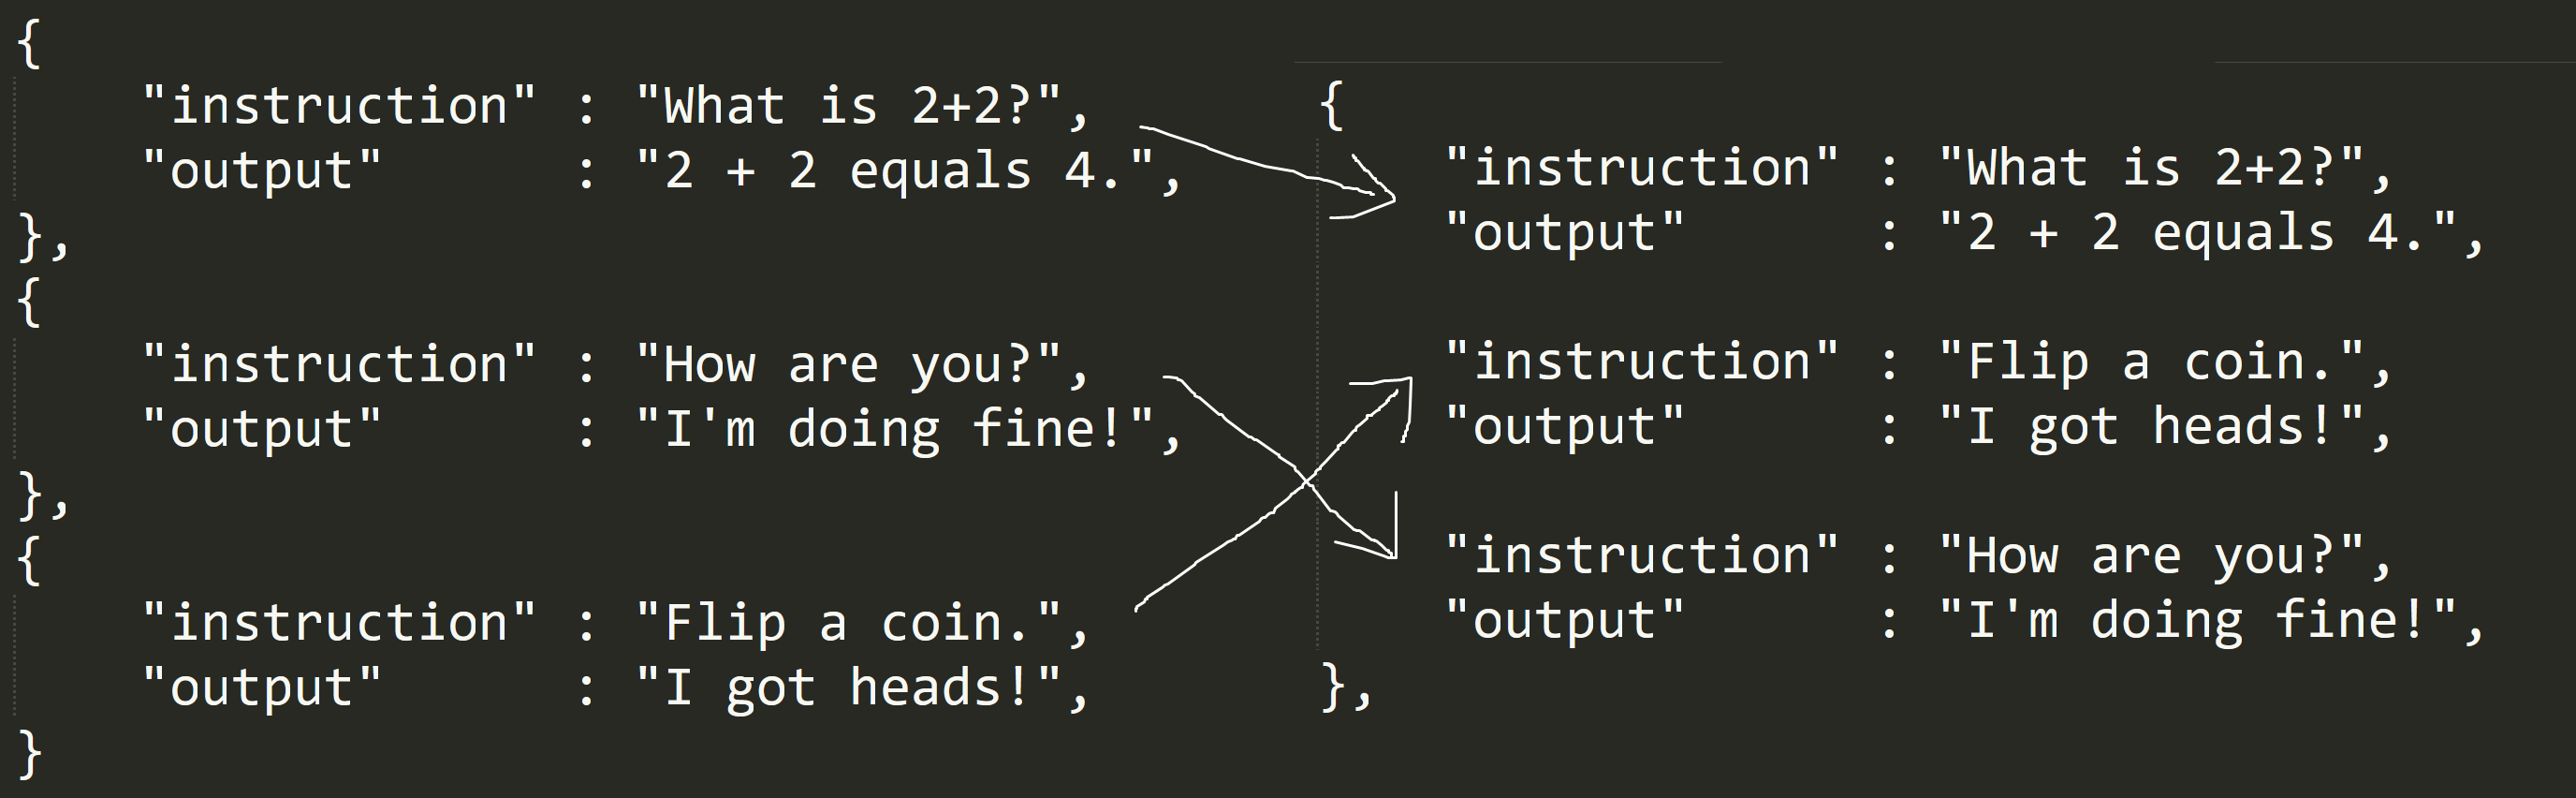
Nous avons donc introduit le `conversation_extension` paramètre, qui sélectionne essentiellement certaines lignes aléatoires dans votre ensemble de données à tour unique, et les fusionne en une seule conversation ! Par exemple, si vous le réglez sur 3, nous sélectionnons aléatoirement 3 lignes et les fusionnons en 1 ! Les régler trop longtemps peut rendre l’entraînement plus lent, mais cela peut améliorer considérablement votre chatbot et votre affinage final !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2b1b3494b260f1102942d86143a885225c6a06f2%2Fcombine.png?alt=media" alt=""><figcaption></figcaption></figure>

Puis réglez `output_column_name` à la colonne de prédiction / sortie. Pour le jeu de données Alpaca, ce serait la colonne de sortie.

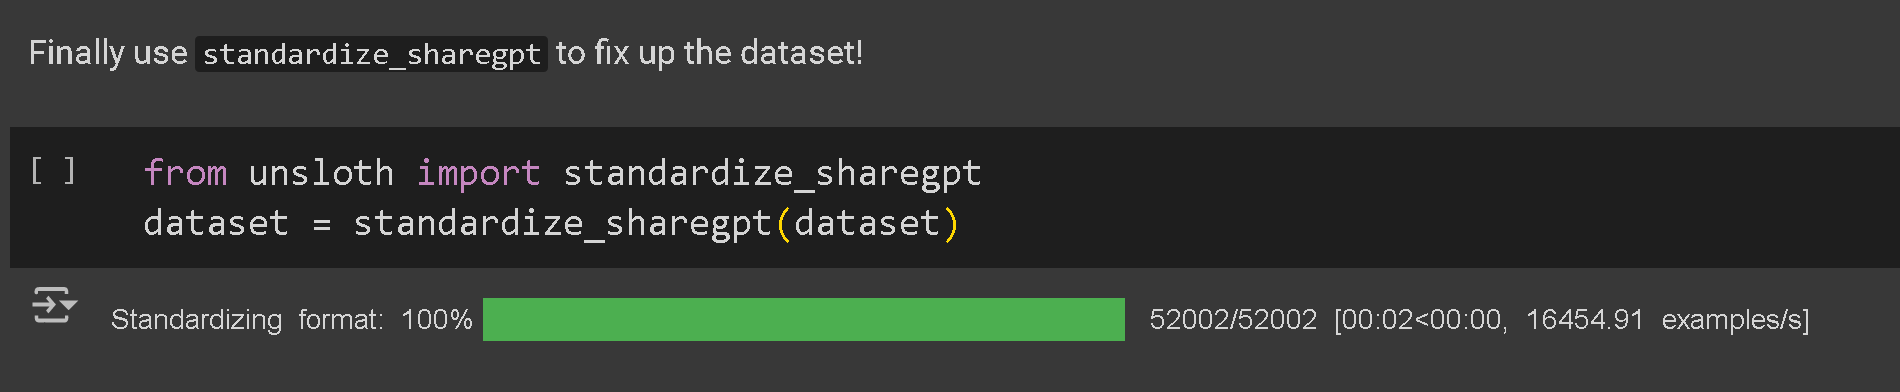
Nous utilisons ensuite la fonction `standardize_sharegpt` pour mettre simplement l’ensemble de données dans un format correct pour l’affinage ! Appelez toujours cela !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7bf83bf802191bda9e417bbe45afa181e7f24f38%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## Ajustement fin vision

Le jeu de données pour l'ajustement fin d'un modèle vision ou multimodal inclut également des entrées d'image. Par exemple, le [Notebook Vision Llama 3.2](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX) utilise un cas de radiographie pour montrer comment l'IA peut aider les professionnels de santé à analyser plus efficacement les radiographies, les scanners et les échographies.

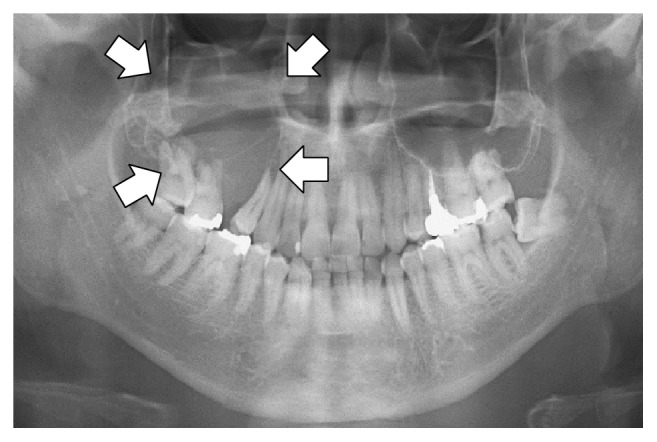
Nous utiliserons une version échantillonnée du jeu de données de radiographie ROCO. Vous pouvez accéder au jeu de données [ici](https://www.google.com/url?q=https%3A%2F%2Fhuggingface.co%2Fdatasets%2Funsloth%2FRadiology_mini). Le jeu de données comprend des radiographies, des scanners et des échographies illustrant des affections et maladies médicales. Chaque image possède une légende rédigée par des experts la décrivant. L'objectif est d'ajuster finement un VLM pour en faire un outil d'analyse utile aux professionnels de santé.

Jetons un coup d'œil au jeu de données et voyons ce que montre le 1er exemple :

```
Dataset({
    features: ['image', 'image_id', 'caption', 'cui'],
    num_rows: 1978
})
```

| Image                                                                                                                                                                                                                                 | Légende                                                                                                                                                               |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| <img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-97d4489827403bd4795494f33d01a10979788c30%2Fxray.png?alt=media" alt="" data-size="original"> | La radiographie panoramique montre une lésion ostéolytique dans la partie postérieure droite du maxillaire avec résorption du plancher du sinus maxillaire (flèches). |

Pour formater le jeu de données, toutes les tâches d'ajustement fin vision doivent être formatées comme suit :

```python
[
{ "role": "user",
  "content": [{"type": "text",  "text": instruction}, {"type": "image", "image": image} ]
},
{ "role": "assistant",
  "content": [{"type": "text",  "text": réponse} ]
},
]
```

Nous allons élaborer une instruction personnalisée demandant au VLM d'être un radiographe expert. Notez aussi qu'au lieu d'une seule instruction, vous pouvez ajouter plusieurs tours pour en faire une conversation dynamique.

```notebook-python
instruction = "Vous êtes un radiographe expert. Décrivez avec précision ce que vous voyez dans cette image."

def convert_to_conversation(sample):
    conversation = [
        { "role": "user",
          "content" : [
            {"type" : "text",  "text"  : instruction},
            {"type" : "image", "image" : sample["image"]} ]
        },
        { "role" : "assistant",
          "content" : [
            {"type" : "text",  "text"  : sample["caption"]} ]
        },
    ]
    return { "messages" : conversation }
pass
```

Convertissons le jeu de données au format "correct" pour l'ajustement fin :

```notebook-python
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```

Le premier exemple est maintenant structuré comme ci-dessous :

```notebook-python
converted_dataset[0]
```

{% code overflow="wrap" %}

```
{'messages': [{'role': 'user',
   'content': [{'type': 'text',
     'text': 'Vous êtes un radiographe expert. Décrivez avec précision ce que vous voyez dans cette image.'},
    {'type': 'image',
     'image': <PIL.PngImagePlugin.PngImageFile image mode=L size=657x442>}]},
  {'role': 'assistant',
   'content': [{'type': 'text',
     'text': 'La radiographie panoramique montre une lésion ostéolytique dans la partie postérieure droite du maxillaire avec résorption du plancher du sinus maxillaire (flèches).'}]}]}
```

{% endcode %}

Avant de faire un quelconque ajustement fin, peut-être que le modèle vision sait déjà analyser les images ? Vérifions si c'est le cas !

```notebook-python
FastVisionModel.for_inference(model) # Activer pour l'inférence !

image = dataset[0]["image"]
instruction = "Vous êtes un radiographe expert. Décrivez avec précision ce que vous voyez dans cette image."

messages = [
    {"role": "user", "content": [
        {"type": "image"},
        {"type": "text", "text": instruction}
    ]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt = True)
inputs = tokenizer(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to("cuda")

from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 128,
                   use_cache = True, temperature = 1.5, min_p = 0.1)
```

Et voici le résultat :

```
Cette radiographie semble être une vue panoramique de la dentition supérieure et inférieure, plus précisément une orthopantomographie (OPG).

* La radiographie panoramique montre des structures dentaires normales.
* Il y a une zone anormale en haut à droite, représentée par une zone d'os radiotransparent, correspondant à l'antre.

**Observations clés**

* L'os entre les dents supérieures gauches est relativement radio-opaque.
* Il y a deux grandes flèches au-dessus de l'image, suggérant la nécessité d'examiner cette zone de plus près. L'une des flèches est du côté gauche, et l'autre est du côté droit. Cependant, seulement
```

Pour plus de détails, consultez notre section jeux de données dans le [notebook ici](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.2_\(11B\)-Vision.ipynb#scrollTo=vITh0KVJ10qX).


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.