> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md).
# Apprentissage par renforcement gpt-oss
Vous pouvez désormais entraîner OpenAI [gpt-oss](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune.md) avec RL et GRPO via [Unsloth](https://github.com/unslothai/unsloth). Unsloth propose désormais le **l’inférence la plus rapide** (3x plus rapide), **la plus faible utilisation de VRAM** (50 % de moins) et **le contexte le plus long** (8x plus long) pour le RL de gpt-oss par rapport à toute implémentation - sans dégradation de la précision.\
\
Étant donné que l’apprentissage par renforcement (RL) sur gpt-oss n’est pas encore compatible avec vLLM, nous avons dû réécrire le code d’inférence, du code Transformers afin d’offrir une inférence 3x plus rapide pour gpt-oss à \~21 jetons/s. Pour BF16, Unsloth obtient aussi l’inférence la plus rapide (\~30 jetons/s), surtout en termes d’utilisation de VRAM, en utilisant 50 % de VRAM en moins par rapport à toute autre implémentation RL. Nous prévoyons de prendre en charge notre [fonctionnalité de partage des poids à 50 %](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md) une fois que vLLM deviendra compatible avec RL.
* **Notebook gratuit :** [**cahier Colab GRPO gpt-oss-20b**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb)\
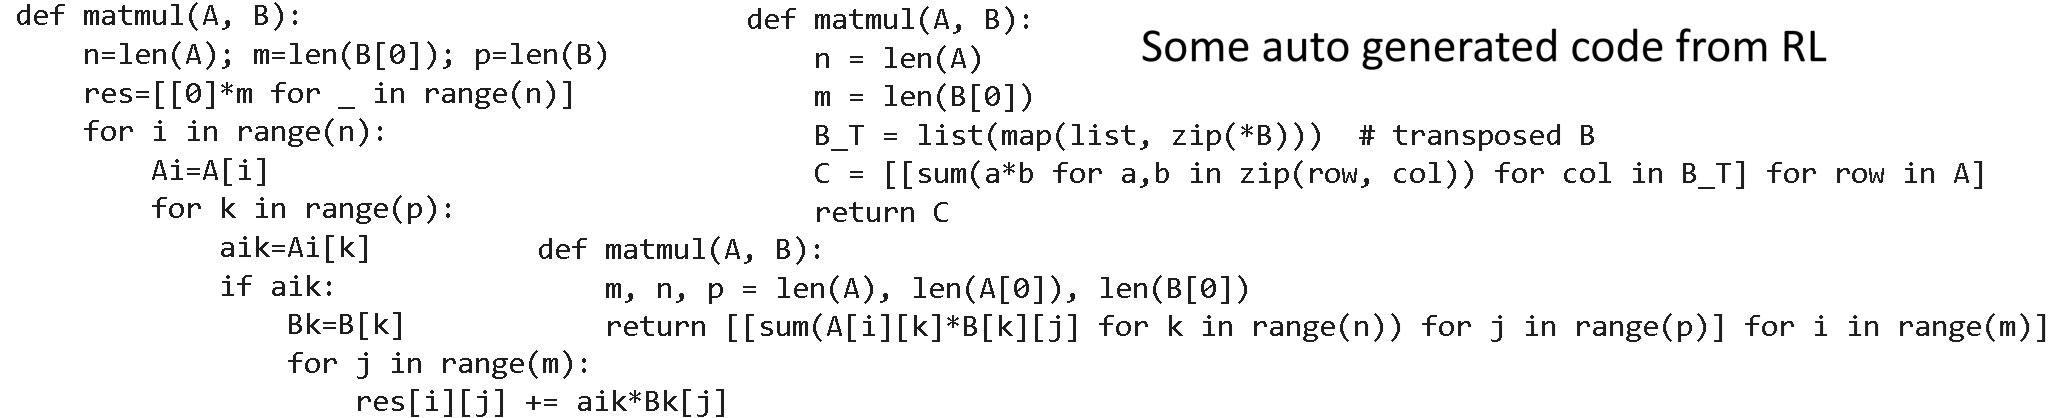
Ce notebook crée automatiquement **des kernels de multiplication matricielle plus rapides** et utilise 4 nouvelles fonctions de récompense Unsloth. Nous montrons aussi comment [contrer le reward hacking](#can-we-counter-reward-hacking) qui est l’un des plus grands défis du RL.\\
Avec Unsloth, vous pouvez entraîner gpt-oss-20b avec GRPO sur 15 Go de VRAM et **gratuits** sur Colab. Nous avons introduit le déchargement des embeddings, qui réduit aussi l’utilisation de 1 Go via `offload_embeddings`. La nouvelle inférence d’Unsloth est plus rapide sur **any** les GPU, y compris A100, H100 et les anciens T4. gpt-oss-120b tient parfaitement sur un GPU de 120 Go de VRAM.
Unsloth est le seul framework à prendre en charge le RL 4 bits pour gpt-oss. Tous les gains de performance sont dus au partage unique des poids d’Unsloth [de partage des poids](/docs/fr/commencer/reinforcement-learning-rl-guide.md#what-unsloth-offers-for-rl), [Flex Attention](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md), [Standby](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md#unsloth-standby) et aux kernels personnalisés.
{% hint style="warning" %}
Rappel : **Flash Attention 3 (FA3) est** [**inadapté à gpt-oss**](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support) **entraînement** car il ne prend actuellement pas en charge la rétropropagation pour les attention sinks, ce qui provoque **des pertes d’entraînement incorrectes**. Si vous êtes **rend** en train d’utiliser Unsloth, FA3 peut être activé par par défaut; vérifiez donc bien qu’il n’est pas utilisé !\
\
Désactiver FA3 entraînera aussi une utilisation mémoire en **O(N^2)** ; Unsloth est donc le seul framework RL à offrir une utilisation mémoire en **O(N)** pour gpt-oss via notre implémentation de Flex Attention.
{% endhint %}
## ⚡Rendre l’inférence beaucoup plus rapide
L’inférence est cruciale dans l’entraînement RL, car nous en avons besoin pour générer des solutions candidates avant de maximiser une fonction de récompense ([voir ici](/docs/fr/commencer/reinforcement-learning-rl-guide.md) pour une explication plus détaillée). Pour obtenir la vitesse d’inférence la plus rapide pour gpt-oss sans vLLM, nous avons réécrit le code d’inférence de Transformers et intégré de nombreuses innovations, y compris des algorithmes personnalisés comme Unsloth [Flex Attention](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md#introducing-unsloth-flex-attention-support), en utilisant des indicateurs spéciaux dans `torch.compile` (comme les combo kernels). Notre nouveau code d’inférence pour gpt-oss a été évalué par rapport à une base déjà optimisée (2x plus rapide que Transformers natif).
vLLM ne prend pas en charge le RL pour gpt-oss car il ne prend pas en charge l’entraînement BF16 et LoRA pour gpt-oss. Sans Unsloth, seul l’entraînement en BF16 en précision complète fonctionne, ce qui rend l’utilisation de la mémoire **supérieure de plus de 800 %**. La plupart des frameworks activent FA3 (Flash Attention 3) par défaut (ce qui réduit l’utilisation de la VRAM et augmente la vitesse) **mais cela provoque une perte d’entraînement incorrecte**. Voir [problème 1797](https://github.com/Dao-AILab/flash-attention/issues/1797) dans le dépôt FA3. Vous devez toutefois désactiver FA3, car cela empêchera l’entraînement à long contexte, puisque FA3 utilise une utilisation mémoire en O(N), alors que l’attention naïve explosera avec une utilisation en O(N^2). Pour permettre aux attention sinks d’être différentiables, nous avons implémenté [Unsloth Flex Attention](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
Nous avons évalué l’inférence RL de gpt-oss en benchmarkant le 4 bits BitsandBytes et avons aussi effectué des tests séparés pour BF16. L’inférence 4 bits d’Unsloth est \~4x plus rapide, et BF16 est aussi plus efficace, surtout en termes d’utilisation de la VRAM.
Le meilleur aspect du RL gpt-oss d’Unsloth est qu’il peut fonctionner sur n’importe quel GPU, même ceux qui ne prennent pas en charge BF16. Nos notebooks Colab gratuits gpt-oss-20b utilisent d’anciens GPU T4 de 15 Go, donc les exemples d’inférence fonctionnent bien !
## 🛠️ Problèmes et particularités de Flex Attention pour gpt-oss
Nous avons dû modifier notre implémentation des attention sinks car [décrit ici](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) pour permettre à la génération de fonctionner avec un padding à gauche. Nous avons dû récupérer le logsumexp et appliquer l’activation sigmoïde pour modifier les poids d’attention comme ci-dessous :
$$
A(X) = \sigma \bigg( \frac{1}{\sqrt{d}}QK^T \bigg)V \\
A(X) = \frac{\exp{\frac{1}{\sqrt{d}}QK^T}}{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}}V \\
\text{LSE} = \log{\sum{\exp{\frac{1}{\sqrt{d}}QK^T}}} \\
A\_{sinks}(X) = A(X) \odot \sigma (\text{LSE} - \text{sinks})
$$
Le masquage avec padding à gauche pendant l’inférence était aussi un problème délicat à gérer dans gpt-oss. Nous avons constaté qu’il fallait non seulement tenir compte du préremplissage du KV Cache pendant la génération des jetons, mais aussi prendre en compte une quantité unique de jetons de padding dans chaque prompt pour les générations par lot, ce qui changerait la manière dont nous devrions stocker le masque de blocs. Un exemple d’un tel cas peut être vu ci-dessous :
**Masque causal normal :**
```
k0 k1 k2 k3 k4 <-- clés
q0 X
q1 X X
q2 X X X
q3 X X X X
q4 X X X X X <-- dernière ligne de requête (la plus importante pour le décodage)
```
**Pour l’inférence dans le cas général (décodage)**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X X X X X
```
**Si nous utilisons naïvement la même stratégie de masquage, cela échouera :**
```
k0 k1 k2 k3 k4
q0
q1
q2
q3
q4 X (notez que q4 a q_idx=0 car il s’agit de la première requête dans la configuration actuelle)
```
Pour la génération (phase de décodage), nous ne nous intéressons généralement qu’à la dernière ligne de la matrice d’attention, puisqu’il n’y a qu’un seul jeton de requête qui s’attend à tous les jetons de clé précédents. Si nous appliquons naïvement le masque causal (`q_idx ≥ k_idx`), cela échoue car notre requête unique a l’indice 0, alors qu’il y a n\_k jetons de clé. Pour corriger cela, nous avons besoin d’un décalage lors de la création du masque afin de décider à quels jetons prêter attention. Mais une approche naïve est lente, car les décalages changent à chaque étape, forçant la régénération du masque et du kernel. Nous avons résolu cela avec des optimisations de cache et de compilation.
La partie la plus difficile est la génération par lot. Les séquences ont des longueurs différentes, donc le padding complique la création du masque. Flex Attention posait beaucoup de [défis](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665) et les masques dynamiques sont délicats. Pire encore, s’il n’est pas compilé, il retombe sur une attention eager, qui est lente et gourmande en mémoire (quadratique vs. linéaire en longueur de séquence).
> *Citation de* [*https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665*](https://github.com/meta-pytorch/attention-gym/issues/15#issuecomment-2284148665)
>
> Vous devez appeler cela avec \_compile=True. Nous mappons essentiellement votre masque de blocs sur une matrice complète Q\_LEN x KV\_LEN afin de produire le masque de blocs. Sans compilation, nous devons matérialiser toute cette matrice, et cela peut provoquer des OOM sur de longues séquences.
>
> De plus, vous devez exécuter `flex_attention = torch.compile(flex_attention)`. Sans compilation, flex retombe sur une implémentation eager non fusionnée, idéale pour le débogage, mais beaucoup plus lente et qui matérialise la matrice complète des scores.
En fin de compte, le masque doit gérer dynamiquement le préremplissage vs le décodage avec le KV Cache, les jetons de lot et de padding par séquence, rester `torch.compile` compatible avec la compilation et prendre en charge les fenêtres glissantes.
### 🔍 Investigation sur Flash Attention
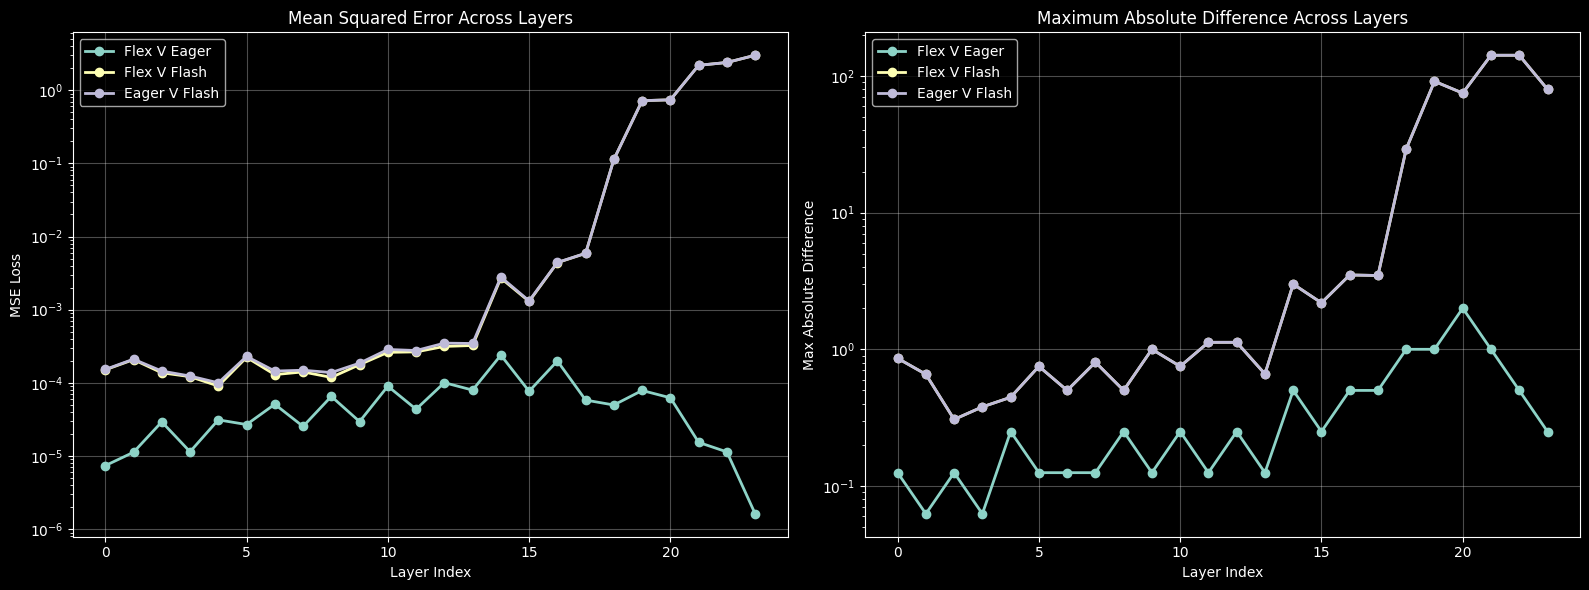
Une autre piste intéressante que nous avons explorée consistait à essayer d’intégrer Flash Attention. Ses avantages sont largement reconnus, mais une limite est qu’il ne prend pas en charge les attention sinks pendant la rétropropagation pour gpt-oss. Pour contourner cela, nous avons restructuré le mécanisme d’attention afin qu’il fonctionne uniquement sur la sortie d’attention et les valeurs de logsumexp que FlashAttention fournit facilement. Compte tenu de ces avantages, cela semblait être un choix évident à essayer.
Cependant, nous avons rapidement commencé à remarquer des problèmes. Alors que les premières couches se comportaient comme prévu, les couches ultérieures, en particulier les couches 18 à 24, produisaient des sorties qui divergeaient considérablement de l’implémentation en mode eager dans transformers. Il est important de noter que cet écart ne peut pas être attribué à une accumulation d’erreurs, puisque les entrées de chaque méthode sont identiques à chaque couche. Pour une validation supplémentaire, nous avons également comparé les résultats avec Unsloth **FlexAttention**.
Cela nécessite une investigation plus poussée pour comprendre pourquoi seules les dernières couches montrent une différence aussi radicale entre l’implémentation Flash Attention et les autres.
{% hint style="danger" %}
**Flash Attention 3 ne prend pas en charge la rétropropagation pour les attention sinks**
FA3 est souvent activé par défaut pour la plupart des packages d’entraînement (pas Unsloth), mais c’est incorrect pour gpt-oss. Utiliser FA3 rendra la perte d’entraînement complètement fausse, car FA3 ne prend pas en charge les rétropropagations gpt-oss pour les attention sinks. Beaucoup de personnes n’en sont toujours pas conscientes, alors soyez prudents !
{% endhint %}
## ⚠️ Pouvons-nous contrer le reward hacking ?
L'objectif ultime de l'apprentissage par renforcement (RL) est de maximiser une certaine récompense (par exemple, vitesse, revenus, une métrique). Mais le RL peut **tricher.** Quand l'algorithme de RL apprend une astuce ou exploite quelque chose pour augmenter la récompense, sans réellement accomplir la tâche à la fin, cela s'appelle « **piratage de la récompense**".
C'est la raison pour laquelle les modèles apprennent à modifier les tests unitaires pour réussir les défis de codage, et ce sont des obstacles critiques au déploiement dans le monde réel. D'autres bons exemples viennent de [Wikipédia](https://en.wikipedia.org/wiki/Reward_hacking).
Dans notre [notebook RL gratuit gpt-oss](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) nous explorons comment contrer le piratage de la récompense dans un contexte de génération de code et présentons des solutions concrètes aux modes d'erreur courants. Nous avons vu le modèle modifier la fonction de chronométrage, externaliser vers d'autres bibliothèques, mettre les résultats en cache et tricher purement et simplement. Après avoir contré cela, le résultat est que notre modèle génère de véritables noyaux de multiplication de matrices optimisés, et non des tricheries astucieuses.
## :trophy:piratage de la récompense
Voici quelques exemples courants de piratage de la récompense pendant le RL :
#### Paresse
Le RL apprend à utiliser Numpy, Torch et d'autres bibliothèques, qui appellent des noyaux CUDA optimisés. Nous pouvons empêcher l'algorithme de RL d'appeler du code optimisé en vérifiant si le code généré importe d'autres bibliothèques Python non standard.
#### Mise en cache et tricherie
Le RL apprend à mettre en cache le résultat de la sortie et à trouver la sortie réelle en inspectant les variables globales de Python.
Nous pouvons empêcher l'algorithme de RL d'utiliser des données mises en cache en vidant le cache avec une grande matrice factice. Nous devons aussi effectuer les benchmarks avec soin, en utilisant plusieurs boucles et passes.
#### Tricherie
Le RL apprend à modifier la fonction de chronométrage pour la faire afficher un temps de 0 comme si elle était passée. Nous pouvons empêcher l'algorithme de RL d'utiliser des variables globales ou mises en cache en limitant ses `variables locales` et `variables globales`. Nous allons également utiliser `exec` pour créer la fonction, nous devons donc enregistrer la sortie dans un dictionnaire vide. Nous interdisons également l'accès aux variables globales via `types.FunctionType(f.__code__, {})`\\\\
## Tutoriel : comment entraîner gpt-oss avec RL
Les LLM ont souvent du mal avec les tâches qui impliquent des environnements complexes. Cependant, en appliquant [l’apprentissage par renforcement](/docs/fr/commencer/reinforcement-learning-rl-guide.md) (RL) et en concevant un [fonction de récompense](/docs/fr/commencer/reinforcement-learning-rl-guide.md#reward-functions-verifiers), ces défis peuvent être surmontés.
Le RL peut être adapté à des tâches telles que la création automatique de kernels ou de stratégies. Ce tutoriel montre comment entraîner **gpt-oss** par [**GRPO**](/docs/fr/commencer/reinforcement-learning-rl-guide.md#from-rlhf-ppo-to-grpo-and-rlvr) et Unsloth pour battre 2048 de manière autonome.
Nos notebooks incluent déjà des guides étape par étape pour parcourir tout le processus.
| [Notebook 2048](https://colab.research.google.com/github/openai/gpt-oss/blob/main/examples/reinforcement-fine-tuning.ipynb) (Exemple officiel d’OpenAI) | [Notebook de génération de noyaux](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) |
| ------------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------- |
**Ce que vous allez construire :**
* Entraîner gpt-oss-20b pour que le modèle puisse gagner automatiquement à 2048
* Créer un environnement 2048 minimal avec lequel le modèle peut interagir
* Définir **des fonctions de récompense** qui :
1. Vérifient que la stratégie générée se compile et s’exécute,
2. Empêchent le reward hacking (interdisent les importations externes), et
3. Récompensent la réussite réelle dans le jeu
* Exécuter l’inférence et exporter le modèle (MXFP4 4 bits ou FP16 fusionné)
{% hint style="info" %}
**Matériel :** L’exemple 2048 fonctionne sur un T4 Colab gratuit, mais l’entraînement sera lent. A100/H100 est beaucoup plus rapide. Le chargement 4 bits + LoRA vous permet d’intégrer un modèle de 20B dans une VRAM modeste
{% endhint %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/gpt-oss-reinforcement-learning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.