> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md).
# Tutoriel : entraînez votre propre modèle de raisonnement avec GRPO
Guide du débutant pour transformer un modèle comme Llama 3.1 (8B) en modèle de raisonnement en utilisant Unsloth et GRPO.
DeepSeek a développé [GRPO](https://unsloth.ai/blog/grpo) (Optimisation de politique relative au groupe) pour entraîner ses modèles de raisonnement R1.
### Démarrage rapide
Ces instructions concernent notre Google Colab préconfiguré [notebooks](/docs/fr/commencer/unsloth-notebooks.md). Si vous installez Unsloth localement, vous pouvez aussi copier nos notebooks dans votre éditeur de code préféré. Nous utiliserons l’un de ces notebooks :
| [**Qwen3.5 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_5_\(4B\)_Vision_GRPO.ipynb) **- Vision - nouveau** | [**gpt-oss-20b**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/gpt-oss-\(20B\)-GRPO.ipynb) **-** GSPO | [Gemma 3 (4B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(4B\)-Vision-GRPO.ipynb) - GRPO Vision |
| ----------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------- |
| [**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) - Avancé | [Qwen3-VL-8B](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_VL_\(8B\)-Vision-GRPO.ipynb) - GRPO Vision | [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - Avancé |
{% stepper %}
{% step %}
#### Installer Unsloth
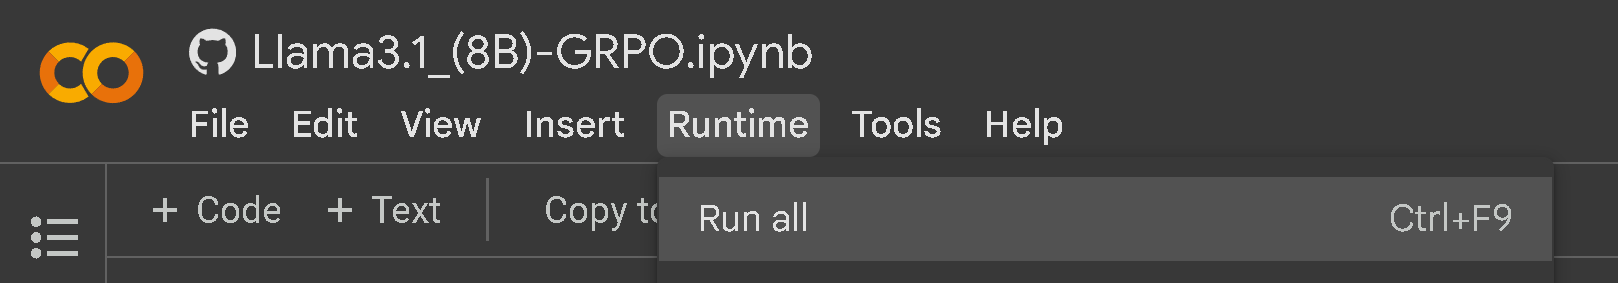
Si vous utilisez notre notebook Colab, cliquez sur **Runtime > Run all**. Nous vous recommandons vivement de consulter notre [de fine-tuning](/docs/fr/commencer/fine-tuning-llms-guide.md) avant de commencer.
Si vous installez localement, assurez-vous d’avoir les [prérequis](/docs/fr/commencer/fine-tuning-for-beginners/unsloth-requirements.md) corrects `pip install unsloth` et utilisez [l’installation Windows ](/docs/fr/commencer/install/windows-installation.md)instructions.
{% endstep %}
{% step %}
#### En savoir plus sur GRPO et les fonctions de récompense
Avant de commencer, il est recommandé d’en apprendre davantage sur GRPO, les fonctions de récompense et leur fonctionnement. En savoir plus à leur sujet, y compris [astuces et conseils](/docs/fr/commencer/reinforcement-learning-rl-guide.md#basics-tips)[ ici](/docs/fr/commencer/reinforcement-learning-rl-guide.md#basics-tips).
Vous aurez également besoin de suffisamment de VRAM. En général, paramètres du modèle = quantité de VRAM dont vous aurez besoin. Dans Colab, nous utilisons leurs GPU gratuits de 16 Go de VRAM, qui peuvent entraîner n’importe quel modèle jusqu’à 16B de paramètres.
{% endstep %}
{% step %}
#### Configurer les paramètres souhaités
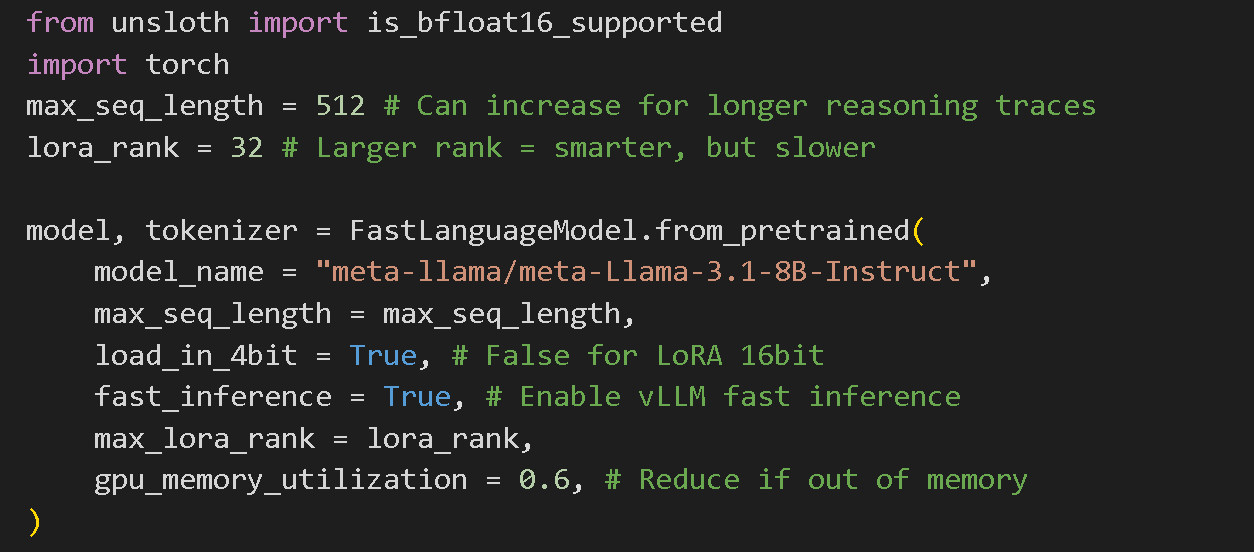
Nous avons déjà présélectionné pour vous des paramètres optimaux pour obtenir les meilleurs résultats, et vous pouvez changer le modèle pour celui que vous voulez dans notre [modèles pris en charge](/docs/fr/commencer/unsloth-model-catalog.md). Nous ne recommandons pas de modifier les autres paramètres si vous êtes débutant.
{% hint style="success" %}
Pour **GRPO avancé** documentation sur les paramètres de batching, de génération et d’entraînement, [lisez notre guide !](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
{% endhint %}
{% endstep %}
{% step %}
#### Préparation des données
Nous avons présélectionné le [GSM8K](https://huggingface.co/datasets/openai/gsm8k) jeu de données d’OpenAI, qui contient des problèmes de mathématiques de niveau école primaire, mais vous pouvez le remplacer par le vôtre ou par n’importe quel jeu public sur Hugging Face. Vous pouvez en savoir plus sur les [jeux de données ici](/docs/fr/commencer/fine-tuning-llms-guide/datasets-guide.md).
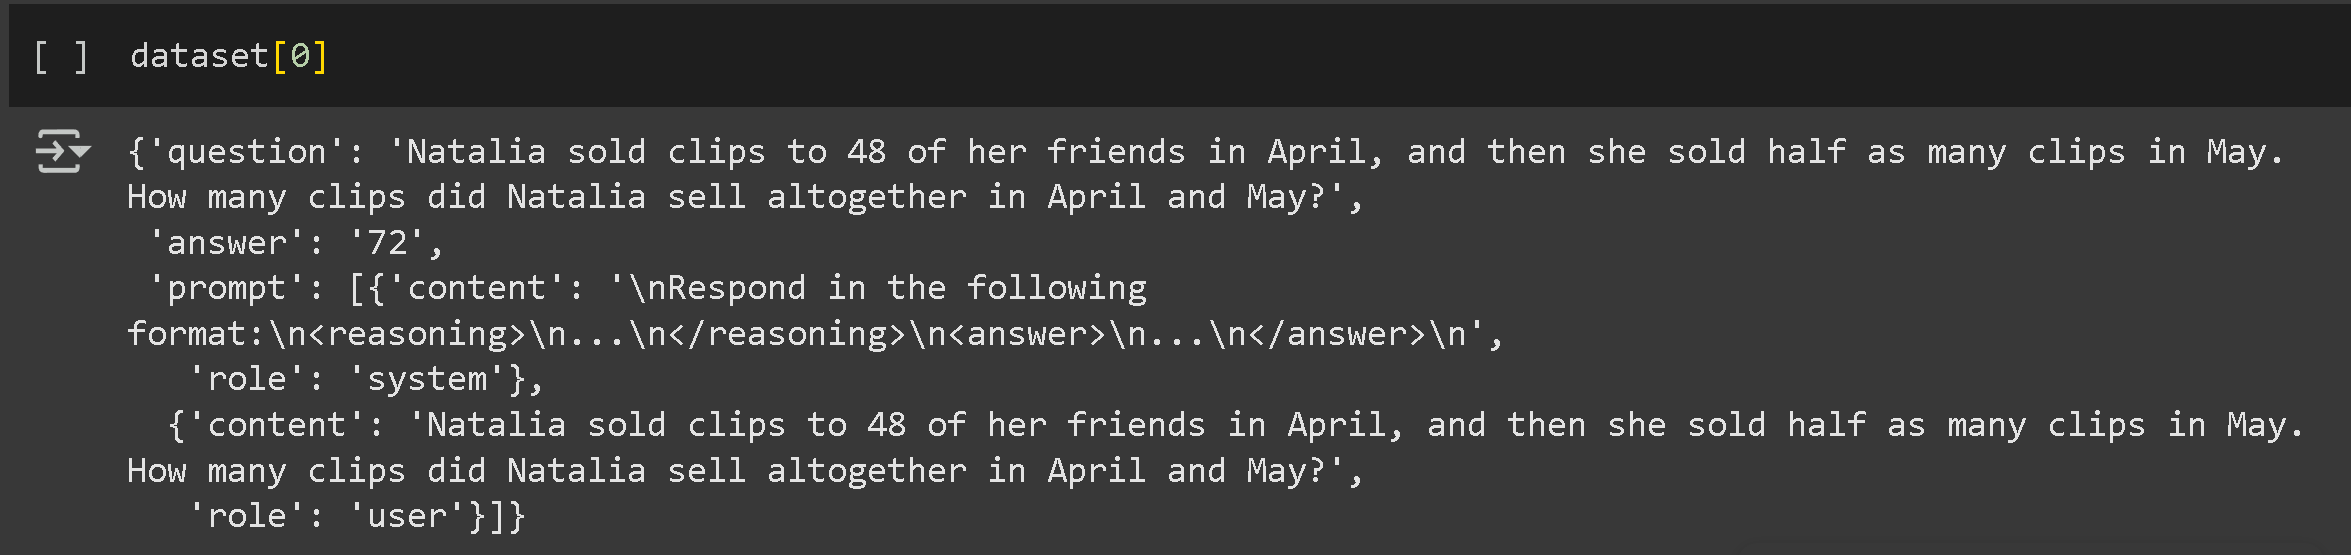
Votre jeu de données doit tout de même comporter au moins 2 colonnes pour les paires question-réponse. Cependant, la réponse ne doit pas révéler le raisonnement derrière la manière dont elle a été déduite de la question. Voir ci-dessous un exemple :
Nous allons structurer les données pour inciter le modèle à expliciter son raisonnement avant de fournir une réponse. Pour commencer, nous établirons un format clair pour les invites et les réponses.
```
# Définir l’invite système qui demande au modèle d’utiliser un format spécifique
SYSTEM_PROMPT = """
Répondez dans le format suivant :
...
...
"""
XML_COT_FORMAT = """\
{reasoning}
{answer}
"""
```
Maintenant, pour préparer le jeu de données :
```
import re
from datasets import load_dataset, Dataset
# Fonctions utilitaires pour extraire les réponses de différents formats
def extract_xml_answer(text: str) -> str:
answer = text.split("")[-1]
answer = answer.split("")[0]
return answer.strip()
def extract_hash_answer(text: str) -> str | None:
if "####" not in text:
return None
return text.split("####")[1].strip()
# Fonction pour préparer le jeu de données GSM8K
def get_gsm8k_questions(split="train") -> Dataset:
data = load_dataset("openai/gsm8k", "main")[split]
data = data.map(
lambda x: {
"prompt": [
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": x["question"]},
],
"answer": extract_hash_answer(x["answer"]),
}
)
return data
dataset = get_gsm8k_questions()
```
Le jeu de données est préparé en extrayant les réponses et en les formatant sous forme de chaînes structurées.
{% endstep %}
{% step %}
#### Fonctions de récompense/Vérificateur
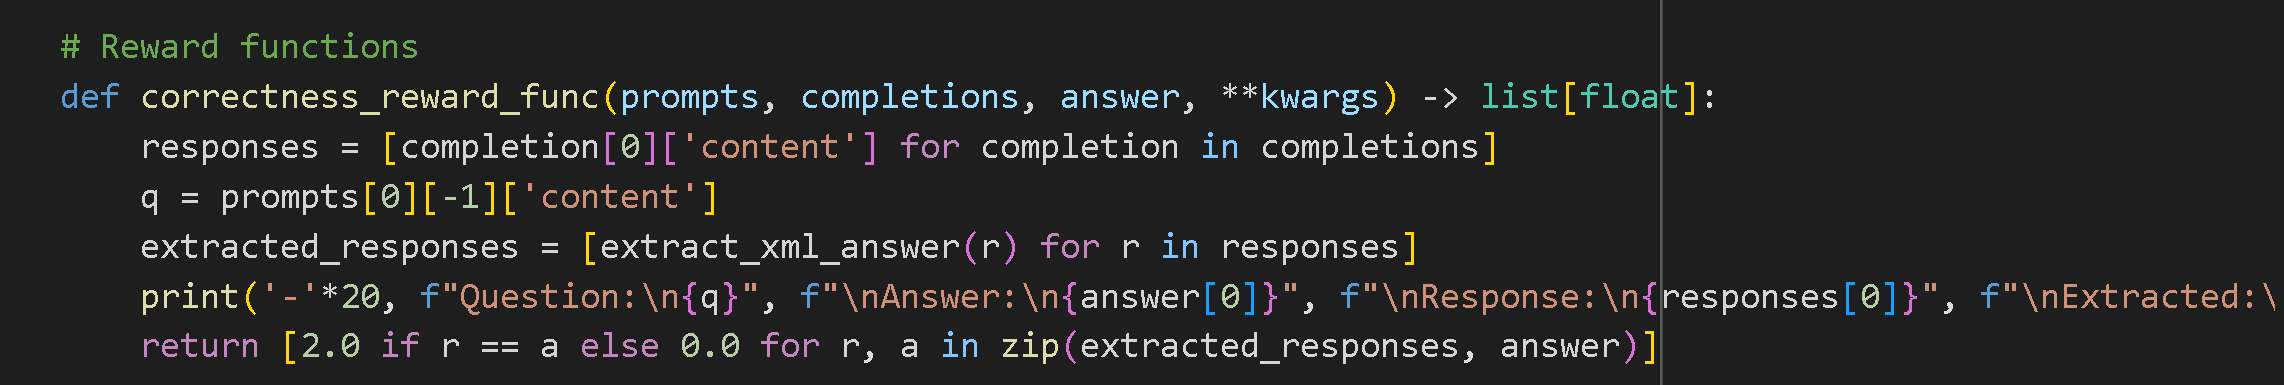
[Fonctions de récompense/Vérificateurs](/docs/fr/commencer/reinforcement-learning-rl-guide.md#reward-functions-verifier) nous indique si le modèle fonctionne bien ou non selon le jeu de données que vous avez fourni. Chaque génération sera évaluée en fonction de sa performance par rapport au score de la moyenne des autres générations. Vous pouvez créer vos propres fonctions de récompense, mais nous les avons déjà présélectionnées pour vous avec [Will's GSM8K](/docs/fr/commencer/reinforcement-learning-rl-guide.md#gsm8k-reward-functions) fonctions de récompense. Avec cela, nous disposons de 5 façons différentes de récompenser chaque génération.
Vous pouvez envoyer vos générations à un LLM comme ChatGPT 4o ou Llama 3.1 (8B) et concevoir une fonction de récompense et un vérificateur pour l’évaluer. Par exemple, alimentez le LLM de votre choix avec vos générations et définissez une règle : « Si la réponse semble trop robotique, retirez 3 points. » Cela aide à affiner les sorties selon des critères de qualité. **Voir des exemples** de leur apparence possible [ici](/docs/fr/commencer/reinforcement-learning-rl-guide.md#reward-function-examples).
**Exemple de fonction de récompense pour une tâche d’automatisation des e-mails :**
* **Question :** E-mail entrant
* **Réponse :** E-mail sortant
* **Fonctions de récompense :**
* Si la réponse contient un mot-clé requis → **+1**
* Si la réponse correspond exactement à la réponse idéale → **+1**
* Si la réponse est trop longue → **-1**
* Si le nom du destinataire est inclus → **+1**
* Si un bloc de signature (téléphone, e-mail, adresse) est présent → **+1**
{% endstep %}
{% step %}
#### Entraînez votre modèle
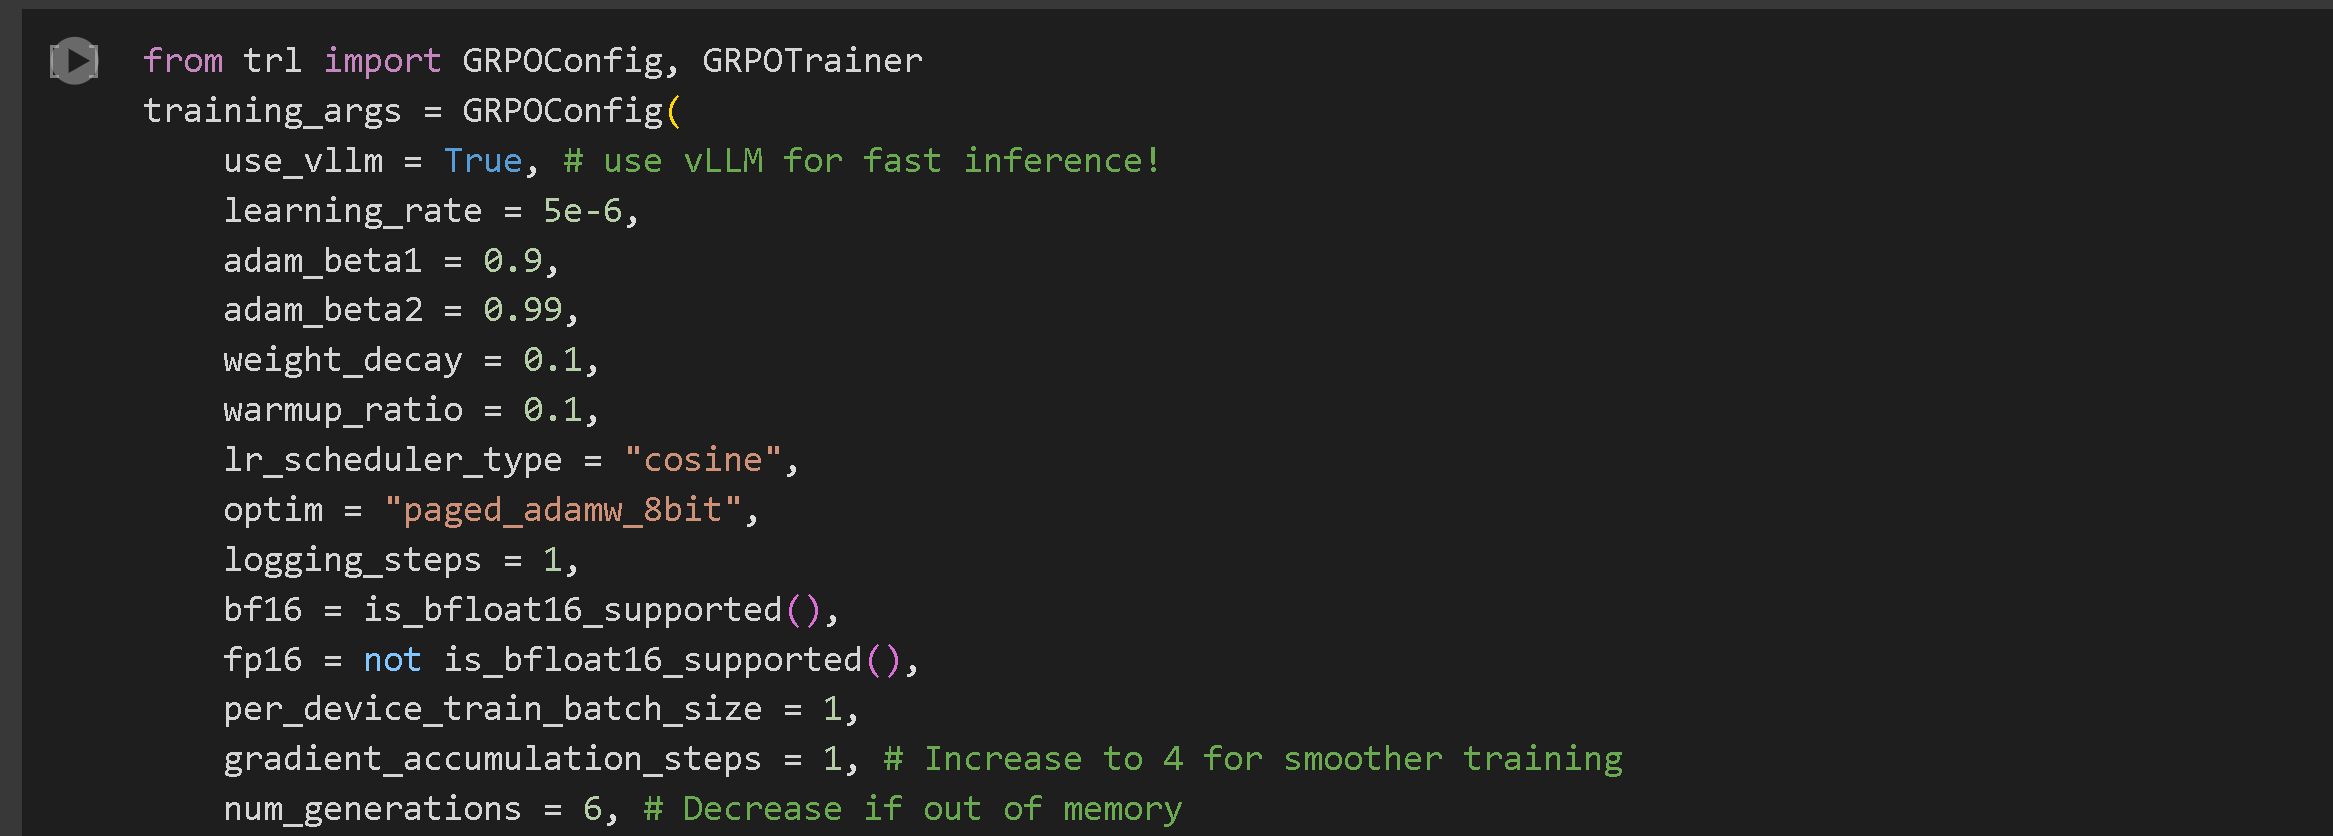
Nous avons présélectionné des hyperparamètres pour obtenir les résultats les plus optimaux, mais vous pouvez les modifier. Lisez tout sur les [paramètres ici](/docs/fr/commencer/fine-tuning-llms-guide/lora-hyperparameters-guide.md). Pour **GRPO avancé** documentation sur les paramètres de batching, de génération et d’entraînement, [lisez notre guide !](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation.md)
Le **GRPOConfig** définit les hyperparamètres clés pour l’entraînement :
* `use_vllm`: Active l’inférence rapide via vLLM.
* `learning_rate`: Détermine la vitesse d’apprentissage du modèle.
* `num_generations`: Spécifie le nombre de complétions générées par invite.
* `max_steps`: Définit le nombre total d’étapes d’entraînement.
{% hint style="success" %}
**NOUVEAU !** Nous prenons désormais en charge DAPO, Dr. GRPO et la plupart des autres nouvelles techniques GRPO. Vous pouvez jouer avec les arguments suivants dans GRPOConfig pour activer :
```python
epsilon=0.2,
epsilon_high=0.28, # un seul côté
delta=1.5 # deux côtés
loss_type='bnpo',
# ou :
loss_type='grpo',
# ou :
loss_type='dr_grpo',
# ou :
loss_type='dapo',
mask_truncated_completions=True,
```
{% endhint %}
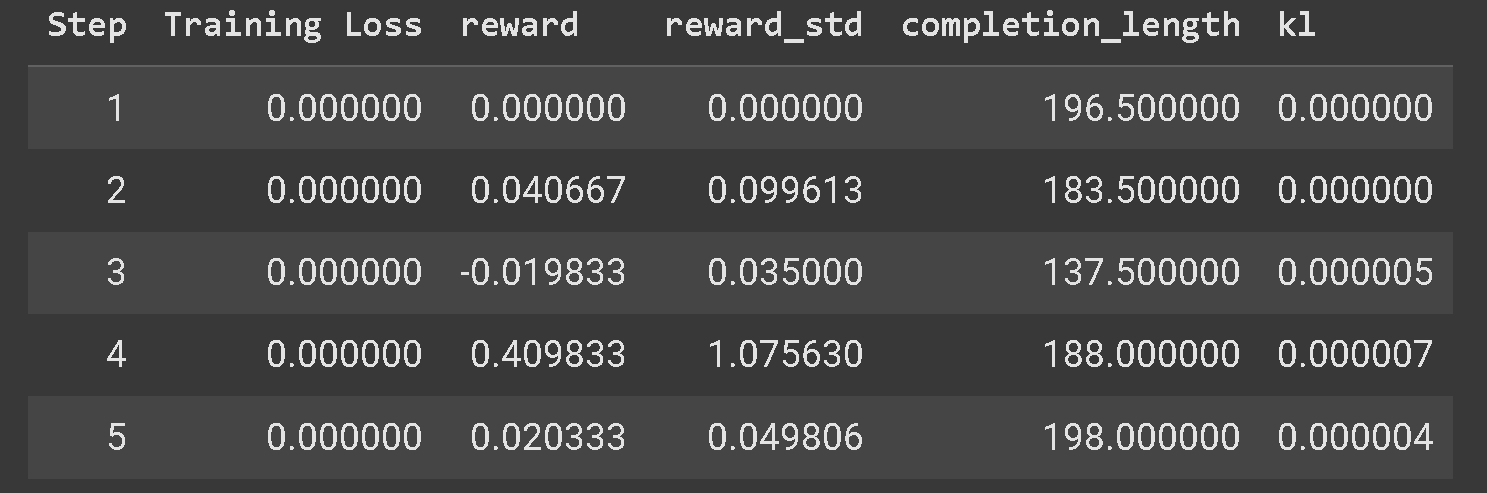
Vous devriez voir la récompense augmenter au fil du temps. Nous vous recommanderions d’entraîner pendant au moins 300 étapes, ce qui peut prendre 30 minutes ; cependant, pour des résultats optimaux, vous devriez entraîner plus longtemps.
{% hint style="warning" %}
Si vous avez des problèmes parce que votre modèle GRPO n’apprend pas, nous vous recommandons vivement d’utiliser nos [notebooks GRPO avancés](/docs/fr/commencer/unsloth-notebooks.md#grpo-reasoning-notebooks) car ils ont une fonction de récompense bien meilleure et vous devriez voir des résultats beaucoup plus rapidement et plus fréquemment.
{% endhint %}
Vous verrez également des exemples de réponses, ce qui vous permet de voir comment le modèle apprend. Certaines peuvent contenir des étapes, des balises XML, des tentatives, etc., et l’idée est qu’au fil de l’entraînement, il va devenir de plus en plus performant parce qu’il recevra des scores de plus en plus élevés jusqu’à ce que nous obtenions les sorties désirées avec de longues chaînes de raisonnement en réponse.
{% endstep %}
{% step %}
#### Exécuter et évaluer votre modèle
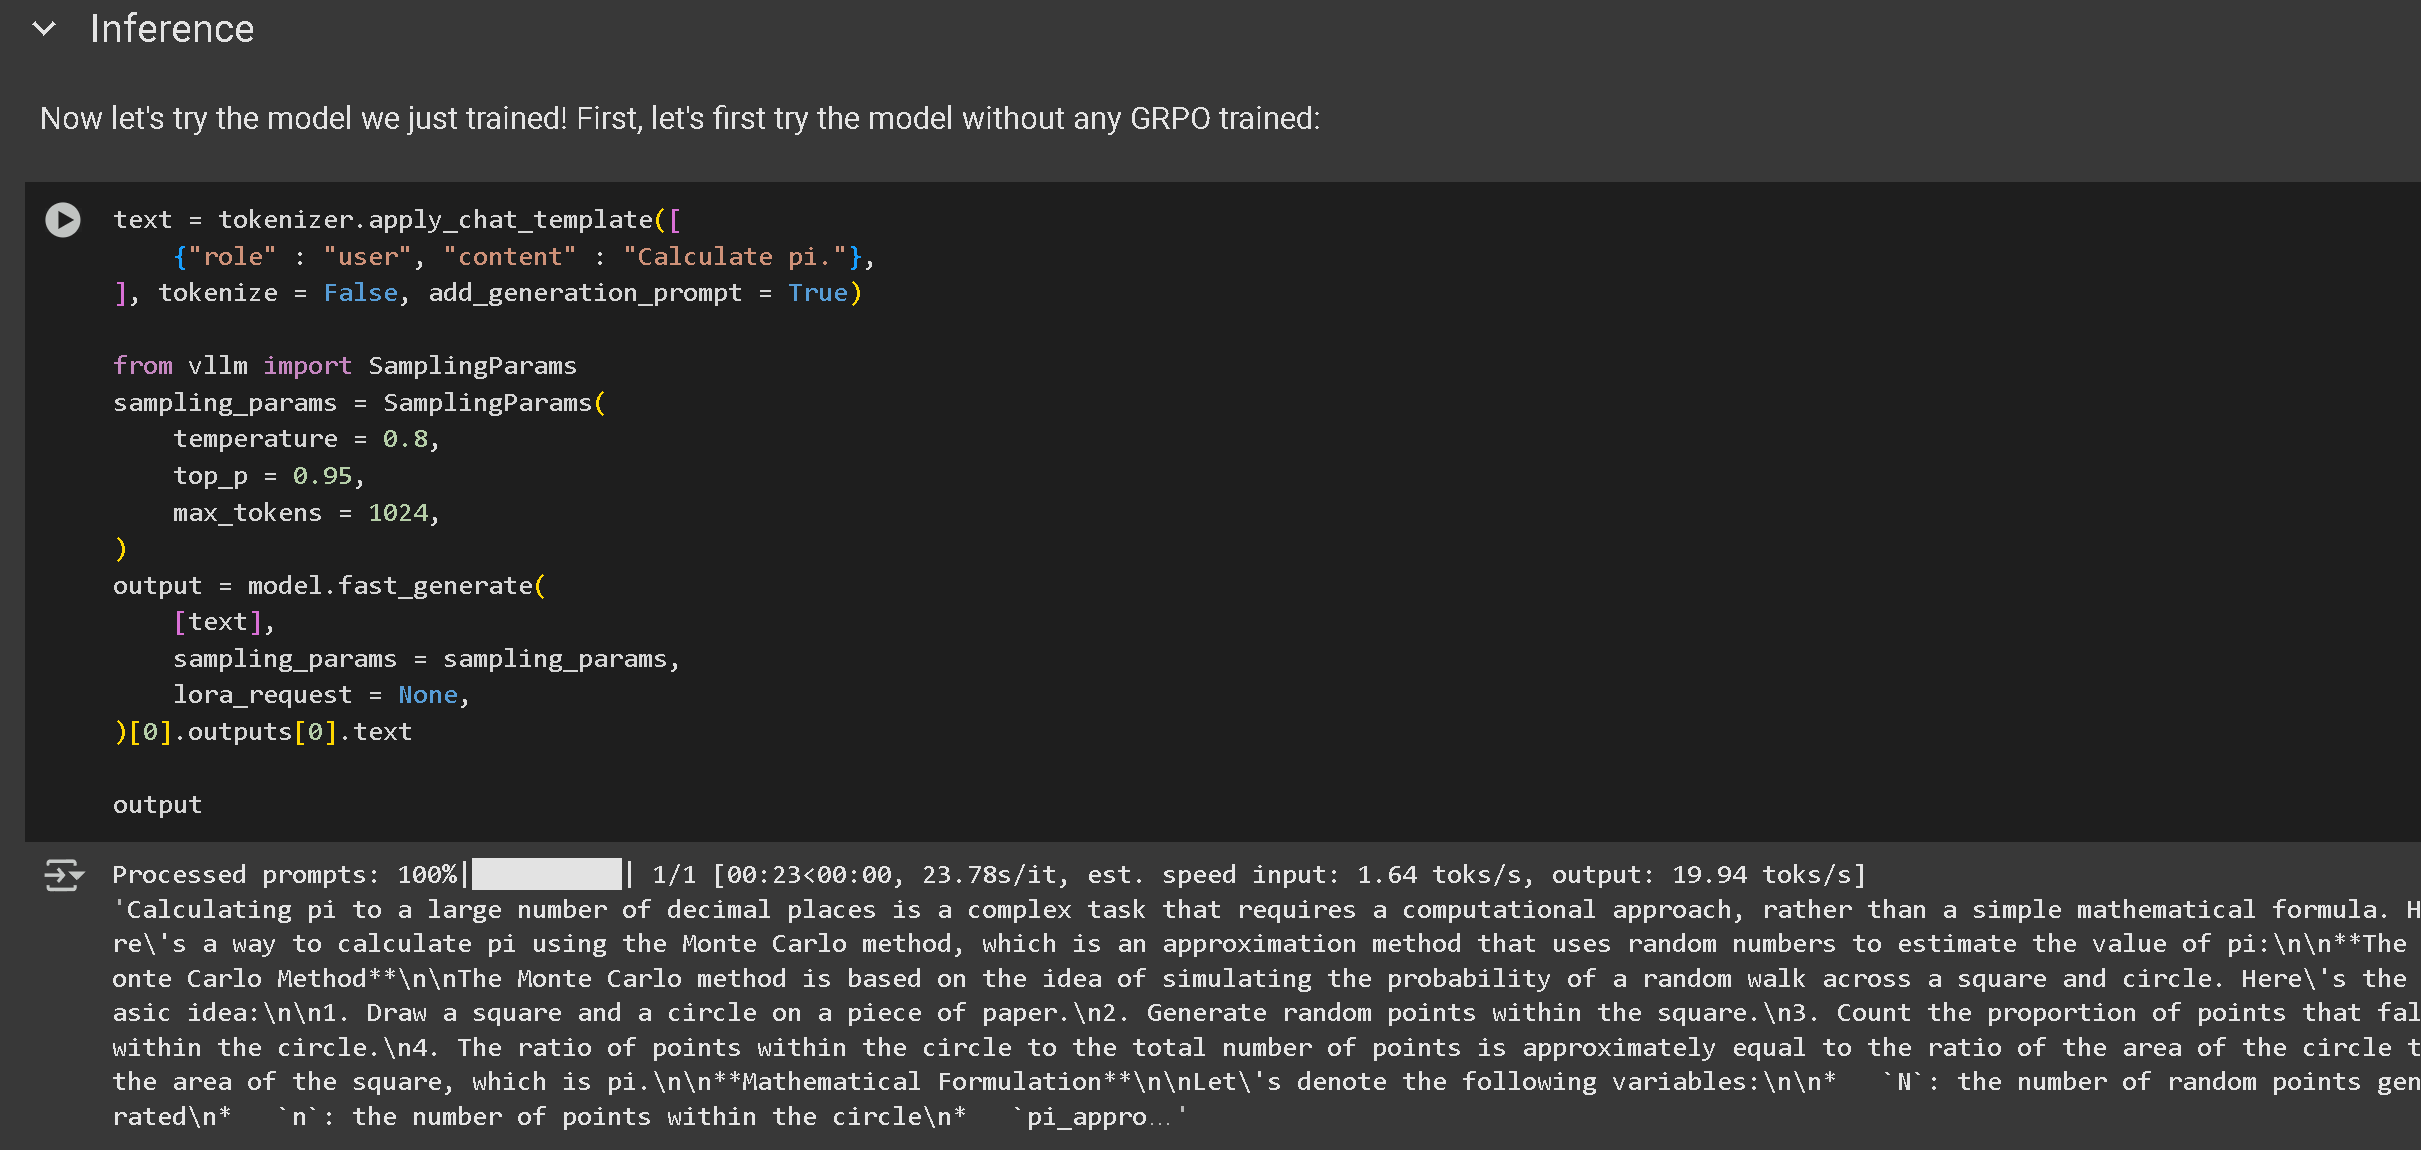
Exécutez votre modèle en cliquant sur le bouton de lecture. Dans le premier exemple, il n’y a généralement pas de raisonnement dans la réponse et, pour voir le raisonnement, nous devons d’abord enregistrer les poids LoRA que nous venons d’entraîner avec GRPO à l’aide de :
model.save_lora("grpo_saved_lora")
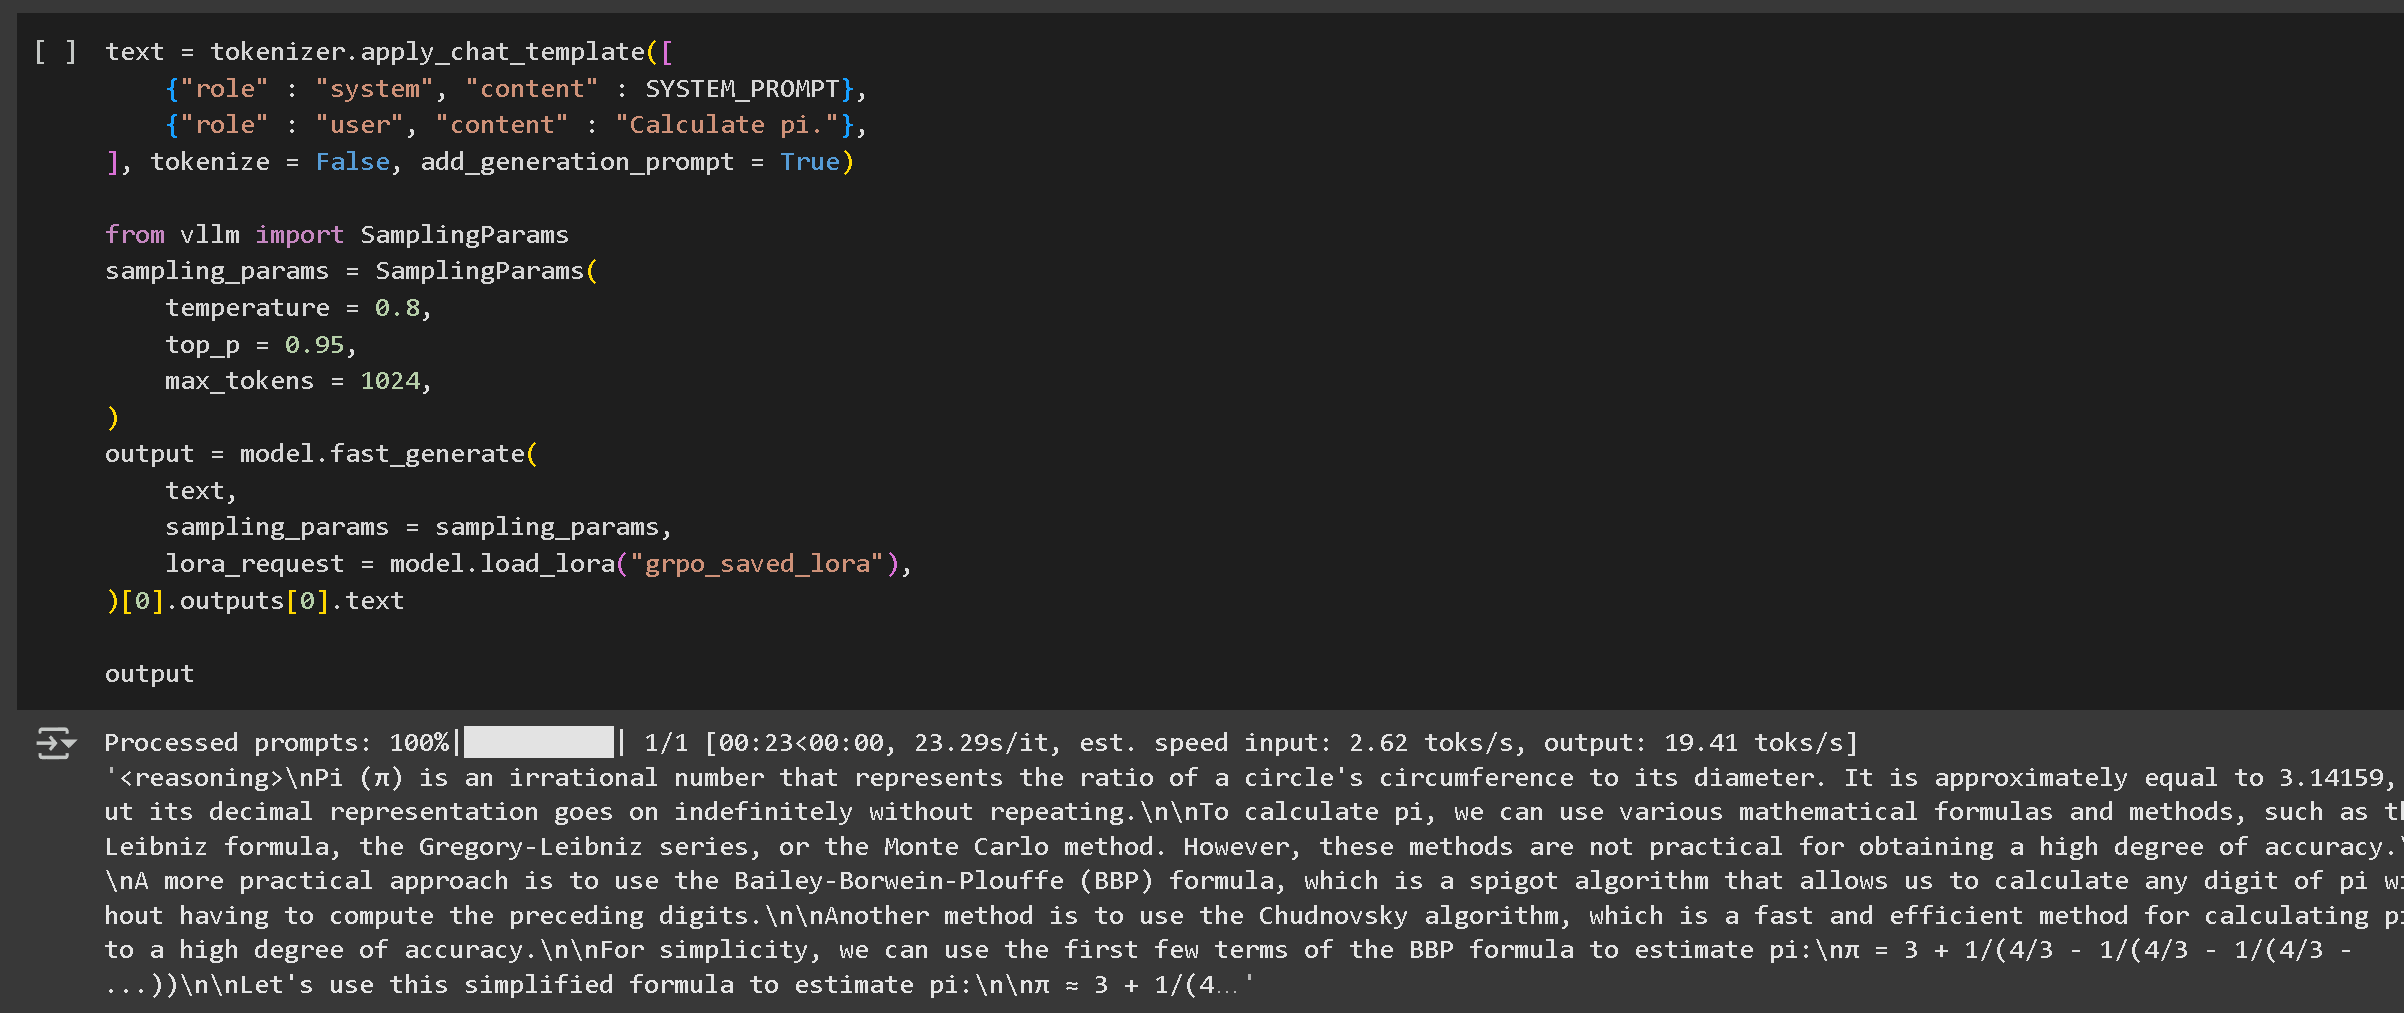
La première exécution de l’exemple d’inférence ne comporte pas de raisonnement. Vous devez charger la LoRA et la tester pour révéler le raisonnement.
Ensuite, nous chargeons la LoRA et la testons. Notre modèle de raisonnement est bien meilleur — il n’est pas toujours correct, puisque nous ne l’avons entraîné qu’environ une heure — il sera meilleur si nous prolongeons la longueur de séquence et entraînons plus longtemps !
Vous pouvez ensuite enregistrer votre modèle en GGUF, Ollama, etc. en suivant notre [guide ici](https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/pages/9bbe6f156adffaddead7109d8475ab4a8547be46#id-7.-running--saving-the-model).
Si vous n’obtenez toujours aucun raisonnement, vous avez peut-être entraîné pendant trop peu d’étapes ou votre fonction de récompense/vérificateur n’était pas optimale.
{% endstep %}
{% step %}
#### Enregistrer votre modèle
Nous avons plusieurs options pour enregistrer votre modèle affiné, mais nous nous concentrerons sur les approches les plus simples et les plus populaires, à propos desquelles vous pouvez en savoir plus [ici](/docs/fr/notions-de-base/inference-and-deployment.md)
**Enregistrement en précision 16 bits**
Vous pouvez enregistrer le modèle en précision 16 bits à l’aide de la commande suivante :
```python
# Enregistrer en précision 16 bits
model.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")
```
**Publication sur Hugging Face Hub**
Pour partager votre modèle, nous allons le publier sur Hugging Face Hub en utilisant la méthode `push_to_hub_merged` . Cela permet d’enregistrer le modèle dans plusieurs formats de quantification.
```python
# Publier sur Hugging Face Hub (nécessite un jeton)
model.push_to_hub_merged(
"your-username/model-name", tokenizer, save_method="merged_16bit", token="your-token"
)
```
**Enregistrement au format GGUF pour llama.cpp**
Unsloth prend également en charge l’enregistrement en **format GGUF**, ce qui le rend compatible avec **llama.cpp** et **Ollama**.
```python
model.push_to_hub_gguf(
"your-username/model-name",
tokenizer,
quantization_method=["q4_k_m", "q8_0", "q5_k_m"],
token="your-token",
)
```
Une fois enregistré au format GGUF, le modèle peut être facilement déployé dans des environnements légers à l’aide de **llama.cpp** ou utilisé dans d’autres moteurs d’inférence.
{% endstep %}
{% endstepper %}
## Tutoriels vidéo
Voici quelques tutoriels vidéo créés par d’incroyables YouTubeurs que nous trouvons fantastiques !
{% embed url="" %}
{% columns %}
{% column width="50%" %}
{% embed url="" %}
Excellent pour apprendre à préparer votre jeu de données et les explications derrière les bases de l’apprentissage par renforcement + GRPO
{% endembed %}
{% embed url="" %}
{% endcolumn %}
{% column width="50%" %}
{% embed url="" %}
{% embed url="" %}
GRPO local sur votre propre appareil
{% endembed %}
{% endcolumn %}
{% endcolumns %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/tutorial-train-your-own-reasoning-model-with-grpo.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.