> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md).
# Apprentissage par renforcement FP8
Entraînez l'apprentissage par renforcement (RL) et GRPO en précision FP8 avec Unsloth.
Nous introduisons l'entraînement en précision FP8 pour le RL, ce qui rend désormais possible le GRPO FP8 sur **GPU grand public** (RTX 40, 50 etc). DeepSeek-R1 a montré à quel point le FP8 peut être puissant et, avec Unsloth, le GRPO FP8 pour Qwen3-1.7B fonctionne désormais avec seulement **5 Go de VRAM**.
Une inférence RL plus rapide est essentielle, car c'est la charge de travail la plus intensive en calcul dans le RL. Nous avons collaboré avec [TorchAO](https://github.com/pytorch/ao) de PyTorch pour permettre des gains de performance sans perte de précision.
* **environ 1,4× plus rapide** l'inférence RL via [vLLM](https://github.com/vllm-project/vllm) • contexte 2x plus long par rapport à BF16 et FP16
* **60 % de VRAM en moins** et **10× plus long** que les autres implémentations FP8 de RL
* Unsloth est le **seul framework** pour faire fonctionner le LoRA RL FP8 sur des GPU grand public (par ex. les séries NVIDIA GeForce RTX 40 et 50). Fonctionne aussi sur H100, H200, B200, etc.
* Utilisez `load_in_fp8 = True` dans `FastLanguageModel` pour activer le RL FP8.
* Bien que Qwen3-8B tienne dans 16 Go de VRAM, les GPU NVIDIA Tesla T4 gratuits de Colab **ne prennent pas en charge FP8**. Donc nos notebooks utilisent **des GPU L4 de 24 Go, ce qui convient à Qwen3-14B**.
**Notebooks :** [Qwen3-8B FP8 GRPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_8B_FP8_GRPO.ipynb) et [Llama-3.2-1B FP8 GRPO](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama_FP8_GRPO.ipynb)
{% hint style="success" %}
Bonus : Vous remarquerez qu'Unsloth utilise désormais beaucoup moins de VRAM. Nous partagerons bientôt les détails dans un nouveau billet.
{% endhint %}
Notre prise en charge du FP8 utilise la [fonction de partage des poids](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md), réduisant l'utilisation de VRAM d'un autre **50%**, permettant **10× plus** de contexte avec aucune perte de précision. Nous utilisons [vLLM](https://github.com/vllm-project/vllm) pour une inférence rapide et, nos techniques comme Unsloth [Standby](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md) et [Flex Attention](/docs/fr/modeles/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md) pour réduire encore l'utilisation de VRAM. TorchAO permet un FP8 universel à la volée, donc Llama, Gemma, Mistral et plus fonctionnent. Nous avons également [téléversé](#unsloth-fp8-uploads) la plupart des modèles FP8 (y compris Qwen3).
Le graphique des récompenses montre que le FP8 suit la même tendance que le BF16
### :sunflower:Entraînement FP8 vs BF16
Les recherches montrent que l'entraînement en FP8 peut largement égaler la précision du BF16 et, si vous servez les modèles en FP8, **l’entraînement et le service dans la même précision** cela aide à préserver la précision. De plus, le FP8 par rapport au BF16 offre un débit 1,6x plus élevé sur les H100 et une consommation mémoire 2x plus faible.
#### Échelles de poids et types FP8
L'entraînement quantifié stocke un poids en basse précision (par ex. FP8) plus une échelle en plus haute précision (FP16/BF16/FP32). Vous récupérez approximativement le poids d'origine via : `poids_original ≈ poids_quantifié * échelle_du_poids`
L'échelle mappe la plage du poids dans la plage représentable du FP8. Davantage d'échelles améliorent généralement la précision, mais elles coûtent de la mémoire supplémentaire en haute précision ; c'est donc un compromis. [DeepSeek R1](https://arxiv.org/abs/2501.12948), par exemple, favorise surtout la quantification par blocs.
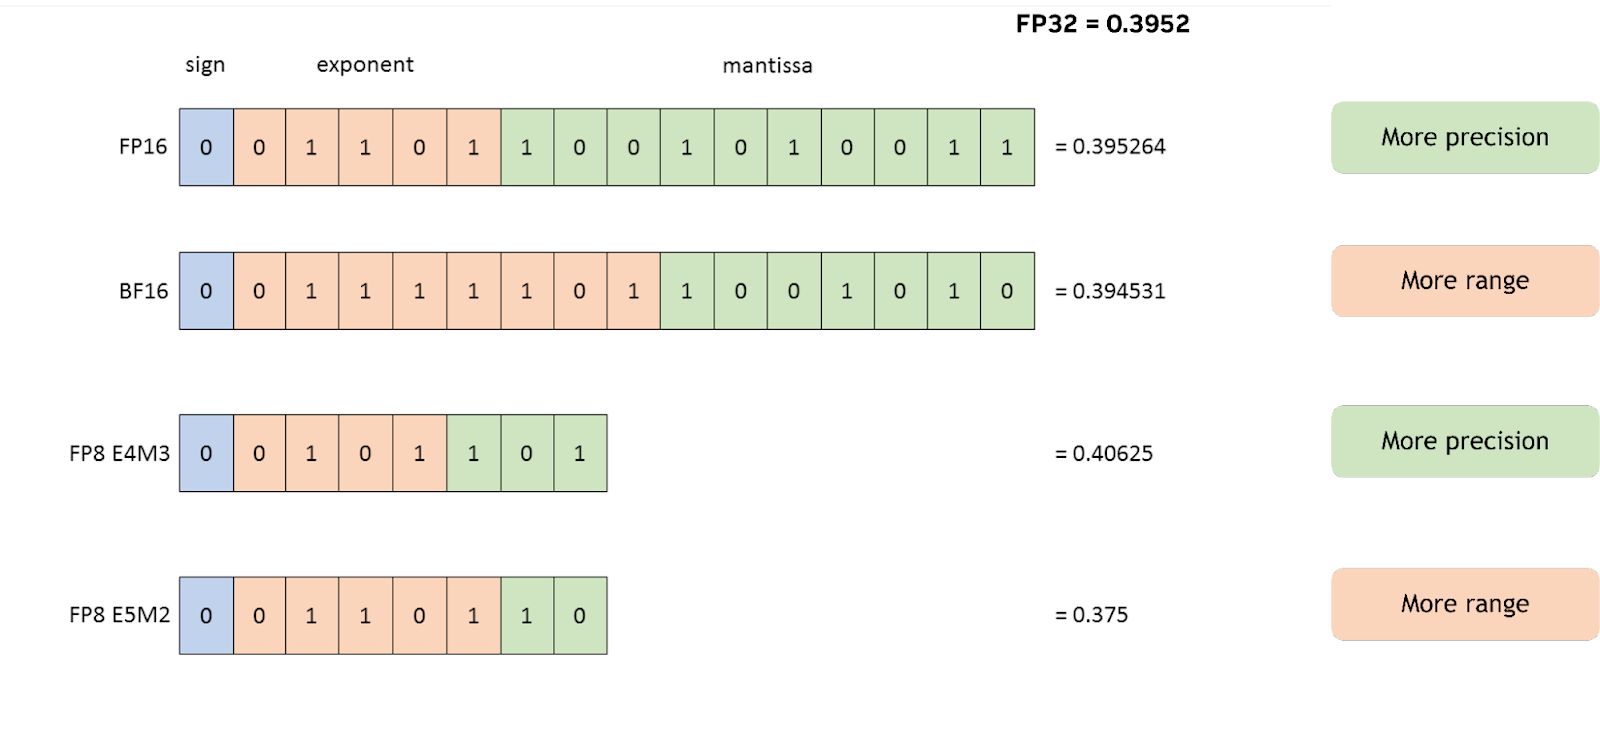
Il existe 3 types courants de FP8 définis par le [llm-compressor](https://github.com/vllm-project/llm-compressor). Nous avons évalué Qwen3-8B avec les 3 types, et avons aussi vérifié le débit, MMLU Pro et GQPA Diamond. Nous constatons **que le FP8 par blocs ou par canal (-FP8-Dynamic) est le meilleur** en termes de précision et de débit.
Type
Débit
MMLU Pro
GQPA Diamond
Référence Bfloat16
11,367
62.04%
28.79%
Par blocs
Échelles par bloc (128x128)
12,041
62.37%
29.29%
Par canal
1 échelle par ligne ou colonne
12,963
61.89%
31.82%
Par tenseur
1 échelle pour tout le tenseur
13,681
61.83%
27.78%
### :zap:Benchmarks de performance FP8
L'inférence RL FP8 d'Unsloth via vLLM est généralement 1,4x plus rapide que BF16. Vous pouvez voir des gains de vitesse encore plus importants si le modèle est plus grand !
#### Benchmarks de précision et de perte d'entraînement
Nous avons testé plusieurs modèles, notamment Qwen3-4B, 8B, 14B, Llama 3.2 1B, 3B, Qwen3-VL-2B, Qwen3-VL 4B et bien d'autres. Tous ont été entraînés à la fois en BF16 et en FP8. Comme on peut le voir sur les graphiques, les **courbes de perte pendant le SFT pour BF16 et FP8 se suivent de très près**. Il n'y a pas grand-chose à départager entre les deux types de données en termes de perte d'entraînement :
{% columns %}
{% column %}
{% endcolumn %}
{% column %}
{% endcolumn %}
{% endcolumns %}
Pour le GRPO en particulier, en raison des différences de génération, l'objectif est de voir si les graphiques de récompense s'alignent au moins et ne divergent pas (parfois, par ex. les exécutions Qwen3-14B peuvent ne pas être exactement similaires)
{% columns %}
{% column width="50%" %}
{% endcolumn %}
{% column width="50%" %}
{% endcolumn %}
{% endcolumns %}
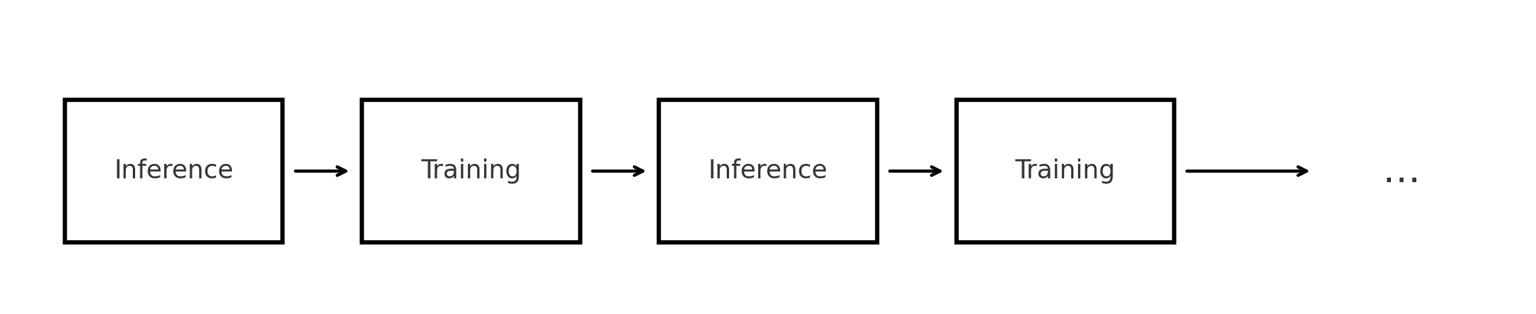
### :shinto\_shrine:L'inférence = 96 % de l'entraînement RL
En RL, nous devons appeler le LLM / VLM pour générer des solutions candidates possibles pour une exécution donnée, puis nous notons chaque solution possible et **récompensons les bonnes solutions, et pénalisons les mauvaises réponses**. Pour atteindre une efficacité maximale, nous devons faire en sorte que l'inférence représente près de 100 % de l'exécution d'entraînement. Dans Unsloth, nous **avons réussi à faire en sorte que l'entraînement ne prenne que <4 % de l'exécution RL totale, avec 96 % étant purement de l'inférence vLLM.**
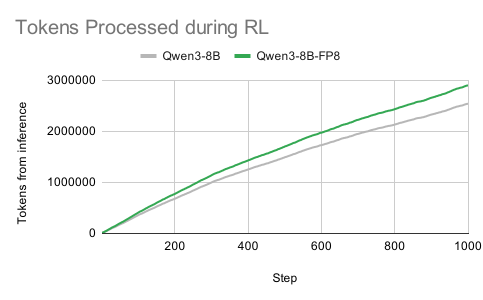
Par exemple, pour Qwen-3-8B, qui est 1,15x plus rapide sur des longueurs de séquence plus courtes, le débit d'inférence vLLM FP8 lui-même (sans entraînement) est aussi 1,15x plus rapide. Nous constatons que notre exécution RL dans Unsloth atteint elle aussi 1,15x plus rapide en tokens traités, montrant à quel point **la surcharge d'entraînement est négligeable dans Unsloth.**
### :1234:60 % de mémoire en moins
En théorie, on s'attendrait à ce que les économies de mémoire soient approximativement **égales à la mémoire des poids du modèle**, car : les états de l'optimiseur sont toujours stockés en haute précision et les activations sont aussi stockées en haute précision (pour l'instant). Nos résultats correspondent à la théorie. Pour le fine-tuning LoRA, nous avons observé : **\~30 Go économisés** pour **Qwen3-32B, \~14 Go économisés** pour **Qwen2.5-14B** et **\~8 Go économisés** pour **Qwen3-8B**
Pour **le fine-tuning LoRA en BF16 sur** Qwen3-32B, nous étions en OOM à des tailles de batch plus élevées et avons dû réduire le batch. La **variante FP8 n'avait pas ce genre de problèmes**, et nous pouvions utiliser **des tailles de batch plus grandes** sans OOM.
Rappel également : dans Unsloth, nous partageons l'espace mémoire de vLLM pour les poids comme introduit dans [RL économe en mémoire](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md) - nous avons porté cette astuce dans le domaine FP8 !
| GPU de 80 Go | Moteur d'inférence | Moteur d'entraînement |
| --------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------- | --------------------------------------------- |
| Poids du modèle | **8Go PARTAGÉ FP8** | **<<< PARTAGÉ** |
|
Polyvalent
espace de 72 Go
| Cache KV | Activations, gradients, états de l'optimiseur |
Pour permettre [Unsloth Standby](/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md) pour le RL FP8 (ou BF16), ajoutez simplement ce qui suit à toutes les exécutions d'entraînement RL / GRPO avant tout import d'Unsloth :
```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1"
```
### :question:Comment utiliser le RL FP8 / installation
Il suffit de mettre à jour Unsloth ou d'installer Unsloth dans un nouvel environnement virtuel pour H100, L4, RTX 50x, RTX 40x, H200, B200, et tout GPU NVIDIA (grand public ou datacenter) sorti après la RTX 4090.
Pour mettre à jour Unsloth : `pip install --upgrade --force-reinstall --no-cache-dir --no-deps unsloth unsloth_zoo`Ou créez un nouvel environnement :
{% code overflow="wrap" %}
```bash
python -m venv unsloth_env
source unsloth_env/bin/activate
pip install unsloth vllm
pip install --pre torchao --index-url https://download.pytorch.org/whl/nightly/cu128 --force-reinstall
pip install --pre fbgemm-gpu fbgemm-gpu-genai --index-url https://download.pytorch.org/whl/cu128 --force-reinstall
pip install --upgrade numba numpy
```
{% endcode %}
Utilisez ensuite `load_in_fp8 = True` et vous êtes prêt ! Nous mapperons automatiquement le nom du modèle vers la variante Float8, ou nous convertirons le modèle en Float8 à la volée !
import os
os.environ['UNSLOTH_VLLM_STANDBY'] = "1" # Unsloth standby économise plus de 30 % de mémoire pour le RL
from unsloth import FastLanguageModel
import torch
max_seq_length = 2048 # Peut être augmenté pour des traces de raisonnement plus longues
lora_rank = 32 # Rang plus élevé = plus intelligent, mais plus lent
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B",
    max_seq_length = max_seq_length,
    load_in_4bit = False, # False pour LoRA 16 bits
    fast_inference = True, # Activer l'inférence rapide vLLM
    max_lora_rank = lora_rank,
    load_in_fp8 = True, # RL / GRPO en Float8 !
)
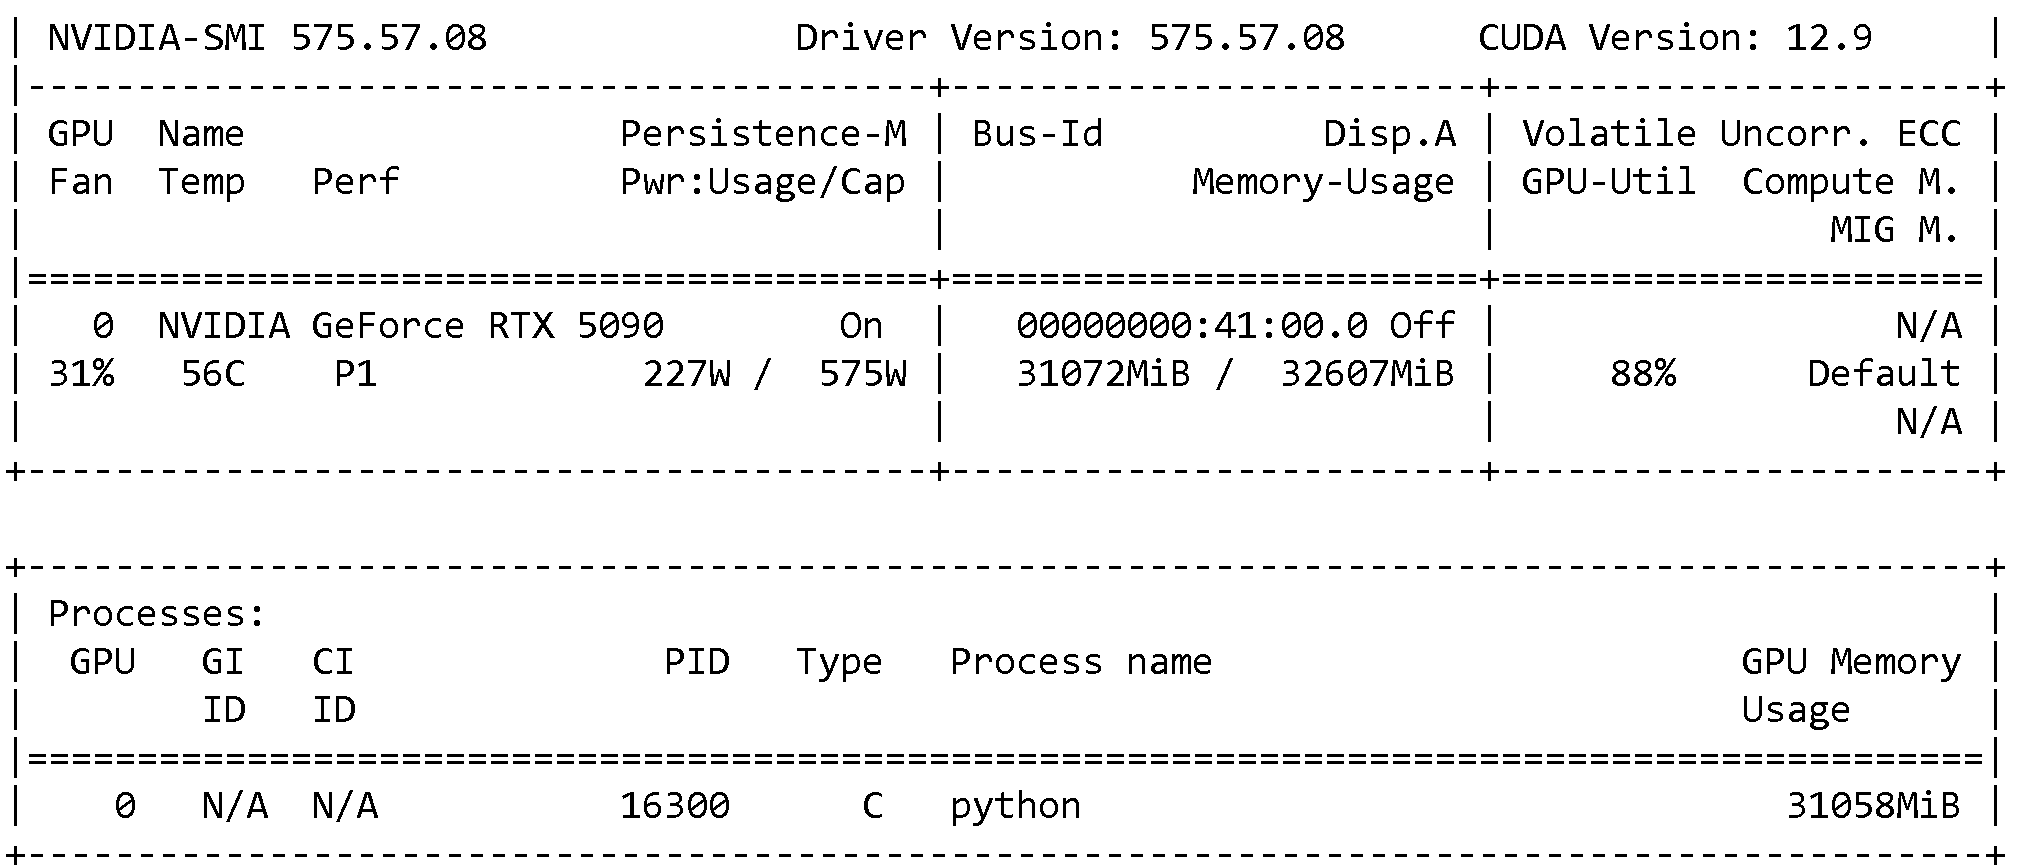
Par exemple sur une RTX 5090 (rappel de définir `os.environ["UNSLOTH_VLLM_STANDBY"] = "1"` )
Utilisez ensuite nos 2 notebooks FP8 pour le RL :
{% columns %}
{% column %}
**Qwen3-8B FP8 RL Colab**
{% embed url="" %}
{% endcolumn %}
{% column %}
**Llama-3.2-1B-FP8 RL Colab**
{% embed url="" %}
{% endcolumn %}
{% endcolumns %}
### :cd:Implémentation de l'entraînement FP8
Notre premier point de référence était `transformers`, qui prend déjà en charge FP8 de plusieurs façons. L'une d'elles est une implémentation de matmul quantifiée par blocs : lorsqu'une couche reçoit des activations en 16 bits, elle les quantifie et les transmet à un noyau matmul FP8 personnalisé. Après l'avoir intégré et benchmarké sur un NVIDIA H100, nous avons vu l'inverse de ce que nous voulions : le fine-tuning est devenu environ **4× plus lent** que le fine-tuning BF16 standard.
### 🔥Collaboration TorchAO
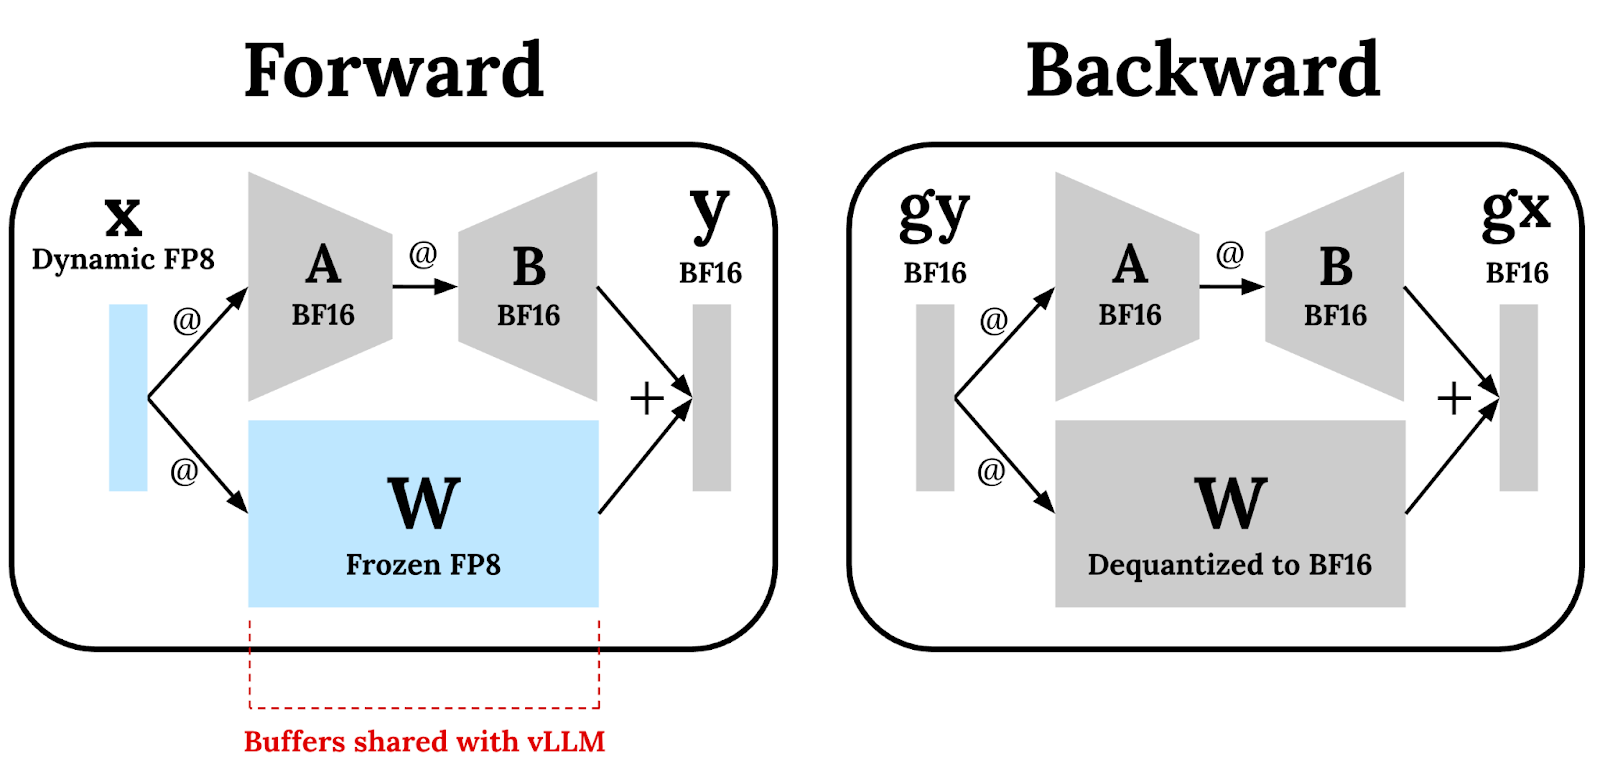
Nous avons donc travaillé avec l'équipe [TorchAO](https://github.com/pytorch/ao) (un immense merci à[ Andrew](https://github.com/unslothai/unsloth/pull/3440)) pour intégrer la prise en charge FP8 de TorchAO à nos charges de travail RL et avons observé environ **un débit 1,4× plus rapide** et jusqu'à **60 % d'utilisation mémoire du modèle en moins**. À un niveau élevé :
* Nous stockons les poids LoRA figés en FP8.
* Pendant le passage avant, nous appliquons une quantification FP8 dynamique aux activations d'entrée, tout en conservant les adaptateurs LoRA entraînables en BF16.
* Ces poids FP8 partagent les mêmes tampons que les poids du modèle vLLM, il n'existe donc qu'une seule copie FP8 du modèle en mémoire à tout moment (pas de surcoût mémoire de « double modèle »).
* Pendant le passage arrière, nous déquantifions les poids LoRA afin que tout le calcul des gradients soit effectué en BF16 pour une meilleure précision.
Cette configuration générale fonctionne avec tous les algorithmes RL pris en charge, y compris [GSPO](/docs/fr/commencer/reinforcement-learning-rl-guide/advanced-rl-documentation/gspo-reinforcement-learning.md), Dr. GRPO, PPO et DPO.
TorchAO fournit une prise en charge FP8 native à PyTorch pour l'entraînement et l'inférence, offrant une variété de granularités de mise à l'échelle, notamment tensorwise, row-wise et blockwise 128x128 (prototype). La prise en charge FP8 de TorchAO peut améliorer le débit d'inférence jusqu'à [1,64x à l'échelle 27B](https://huggingface.co/pytorch/gemma-3-27b-it-FP8/blob/main/README.md#results-h100-machine) avec une granularité de mise à l'échelle par ligne. Pour plus de détails, consultez le README FP8 de TorchAO [README FP8](https://github.com/pytorch/ao/blob/main/torchao/float8/README.md).
#### Le matmul FP8 quantifié par blocs de TorchAO
Nous avons utilisé l'implémentation matmul FP8 quantifiée par blocs de TorchAO, qui offrait :
* **80 % du débit BF16**
* Sans dégrader la perte ou la stabilité de l'entraînement
Pendant un certain temps, cela est donc devenu notre backend matmul FP8 par défaut, jusqu'à ce que FBGEMM rattrape son retard - nous utilisons désormais par défaut l'implémentation de FBGEMM, si votre GPU la prend en charge ! La version actuelle d'Unsloth peut choisir automatiquement le meilleur backend en fonction de ce qui est installé. Si vous avez les bons paquets, vous n'avez pas à laisser de performance sur la table 🙂
PS : nous avons aussi expérimenté avec DeepGEMM de DeepSeek, mais nous n'avons pas réussi à l'intégrer entièrement de bout en bout pour faire des comparaisons propres, à armes égales.
### :bird:Quantification FP8 TorchAO à la volée
Un immense merci à [Andrew](https://github.com/unslothai/unsloth/pull/3440) de TorchAO, le RL FP8 d'Unsloth vous permet aussi de quantifier le modèle à la volée en effectuant la quantification pendant le chargement du modèle et en la transmettant à vLLM. De cette façon, vous n'avez pas besoin de quantifier explicitement le modèle vous-même (nous nous en chargeons pour vous). Vous pouvez le faire en définissant `load_in_fp8 = True` dans les arguments de chargement du modèle, et nous effectuerons le FP8 hors ligne si nous ne trouvons pas de checkpoint pré-quantifié approprié.
```python
from unsloth import FastLanguageModel
fp8_model = FastLanguageModel.from_pretrained(
"unsloth/Llama-3.3-70B-Instruct", # Peut être n'importe quel nom de modèle !
load_in_fp8 = True, # Peut être "block" pour le FP8 par blocs, True pour le FP8 par ligne, False
)
```
### :tada:Téléversements FP8 d'Unsloth
Pour plus de commodité, nous avons téléversé des modèles FP8 Dynamic et FP8 Block sur Hugging Face. Vous pouvez les utiliser pour l'entraînement FP8 ou aussi pour un service/déploiement efficace et rapide via [vLLM](/docs/fr/notions-de-base/inference-and-deployment/vllm-guide.md)/[SGLang](/docs/fr/notions-de-base/inference-and-deployment/sglang-guide.md) etc.
FP8 Dynamic offre un entraînement légèrement plus rapide et une utilisation VRAM plus faible que FP8 Block, mais avec un léger compromis en précision. [Voir ici](/docs/fr/commencer/unsloth-model-catalog.md#fp8) pour notre liste complète de quantifications FP8, mais ici les plus populaires :
| Modèle | Téléversements FP8 |
| --------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Qwen3 (2507)** |
|
### :person\_tipping\_hand:Remerciements
Un immense merci à toute l'équipe PyTorch et TorchAO pour leur aide et leur collaboration ! Un immense merci tout particulièrement à : Andrew Or, Jerry Zhang, Supriya Rao, Scott Roy et Mergen Nachin pour leur aide dans de nombreuses discussions sur le RL FP8, et pour avoir aidé à l'intégrer dans Unsloth ! Merci également à l'équipe Executorch !
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/fp8-reinforcement-learning.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.