> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md).

# RL économe en mémoire

Nous sommes ravis de présenter un apprentissage par renforcement (RL) plus efficace dans Unsloth grâce à plusieurs avancées algorithmiques :

* **longueurs de contexte augmentées de 1,2 à 1,7×** sans ralentissement ni consommation mémoire supplémentaire !
* **exécutions d'entraînement RL 10 % plus rapides** avec des kernels remaniés et des mouvements de données asynchrones
* **2x plus rapide `torch.compile` fois** lors du chargement du modèle

Unsloth **déjà** augmente déjà la vitesse d'entraînement RL, la fenêtre de contexte et réduit l'utilisation de VRAM de 50 à 90 % par rapport à toutes les autres configurations avec FA2, mais maintenant [**le Standby d'Unsloth**](#unsloth-standby) améliore encore cela. Notre fonctionnalité Standby limite de manière unique la dégradation des performances par rapport aux autres implémentations et rend parfois l'entraînement encore plus rapide !

Désormais, Qwen3-32B LoRA 16 bits peut atteindre des longueurs de contexte de 6 144 contre 3 600 (**1,7× plus long**) auparavant sur un GPU 1xH100 80 Go. Llama-3.1-8B QLoRA 4 bits peut atteindre 47 500 longueurs contre 42 000 auparavant (1,13× plus long).

Nous avons rendu les exécutions RL 10 % plus rapides grâce à diverses optimisations de kernels, et supprimé le canal de communication LoRA entre le CPU et le GPU lors du passage du mode entraînement au mode inférence. Enfin, nous avons utilisé des `torch.compile` flags personnalisés pour accélérer les rollouts de vLLM de 10 %, et réduit le temps de compilation d'un facteur 2.

## :sparkles:Comment activer les optimisations

Pour permettre **le Standby d'Unsloth** fonctionnalité, définissez la variable d'environnement `UNSLOTH_VLLM_STANDBY` avant tout import d'Unsloth. Ensuite, définissez `gpu_memory_utilization = 0.95` et c'est tout !

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1"

from unsloth import FastLanguageModel
import torch
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B-Base",
    max_seq_length = 2048, # Peut être augmenté pour des traces de raisonnement plus longues
    load_in_4bit = False, # False pour LoRA 16 bits
    fast_inference = True,
    max_lora_rank = 32, # Rang plus élevé = plus intelligent, mais plus lent
    gpu_memory_utilization = 0.95,
)
```

## :mortar\_board:Plus besoin de `gpu_memory_utilization`!

Avec les nouvelles améliorations RL d'Unsloth, vous n'avez JAMAIS à vous soucier de régler ou de définir `gpu_memory_utilization` à nouveau - il suffit de le régler à 90 % ou 95 % d'utilisation du GPU - 100 % ne fonctionnera malheureusement pas, car un peu d'espace est nécessaire pour les petits tenseurs. Auparavant, il fallait le régler de 30 % à 95 % - plus maintenant ! Réglez-le au maximum et Unsloth se chargera du reste !

## :interrobang:Pourquoi le RL utilise-t-il autant de mémoire ?

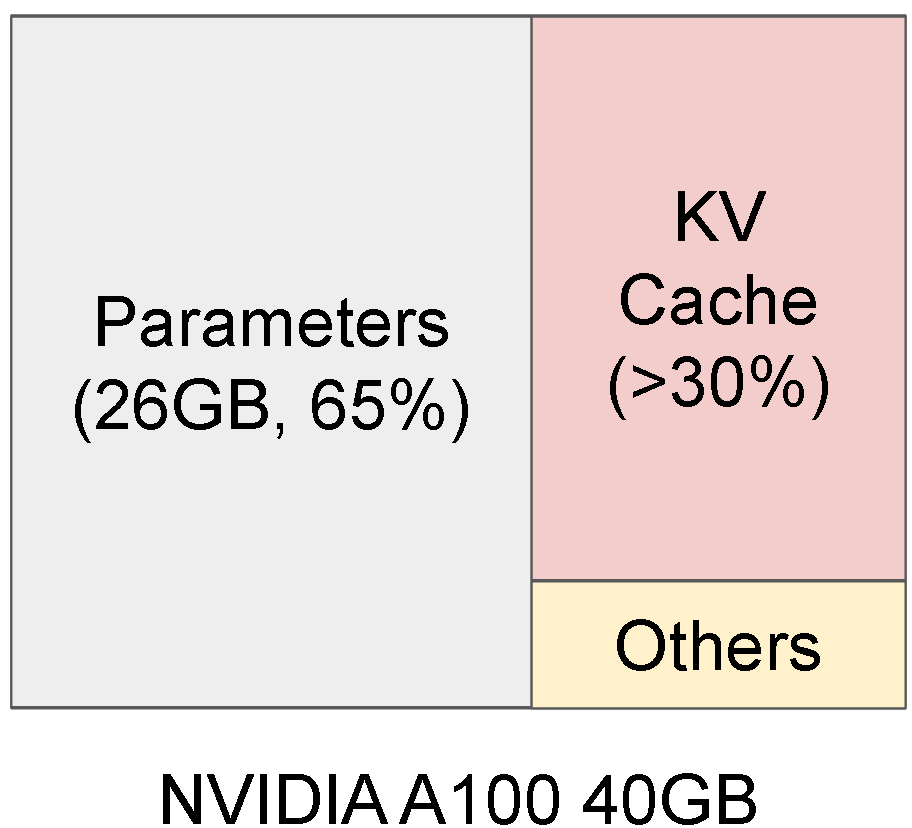
GRPO (et de nombreuses variantes de RL) s'appuient fortement sur la génération, principalement assurée par vLLM. Mais cela s'accompagne d'un coût élevé, car cela nécessite une **mémoire GPU pour les poids, les activations et le cache KV**.

{% columns %}
{% column %}
L'inférence consomme beaucoup de VRAM

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-7e25501083081b201d59f6000219cafa535d2b2d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}

{% column %}
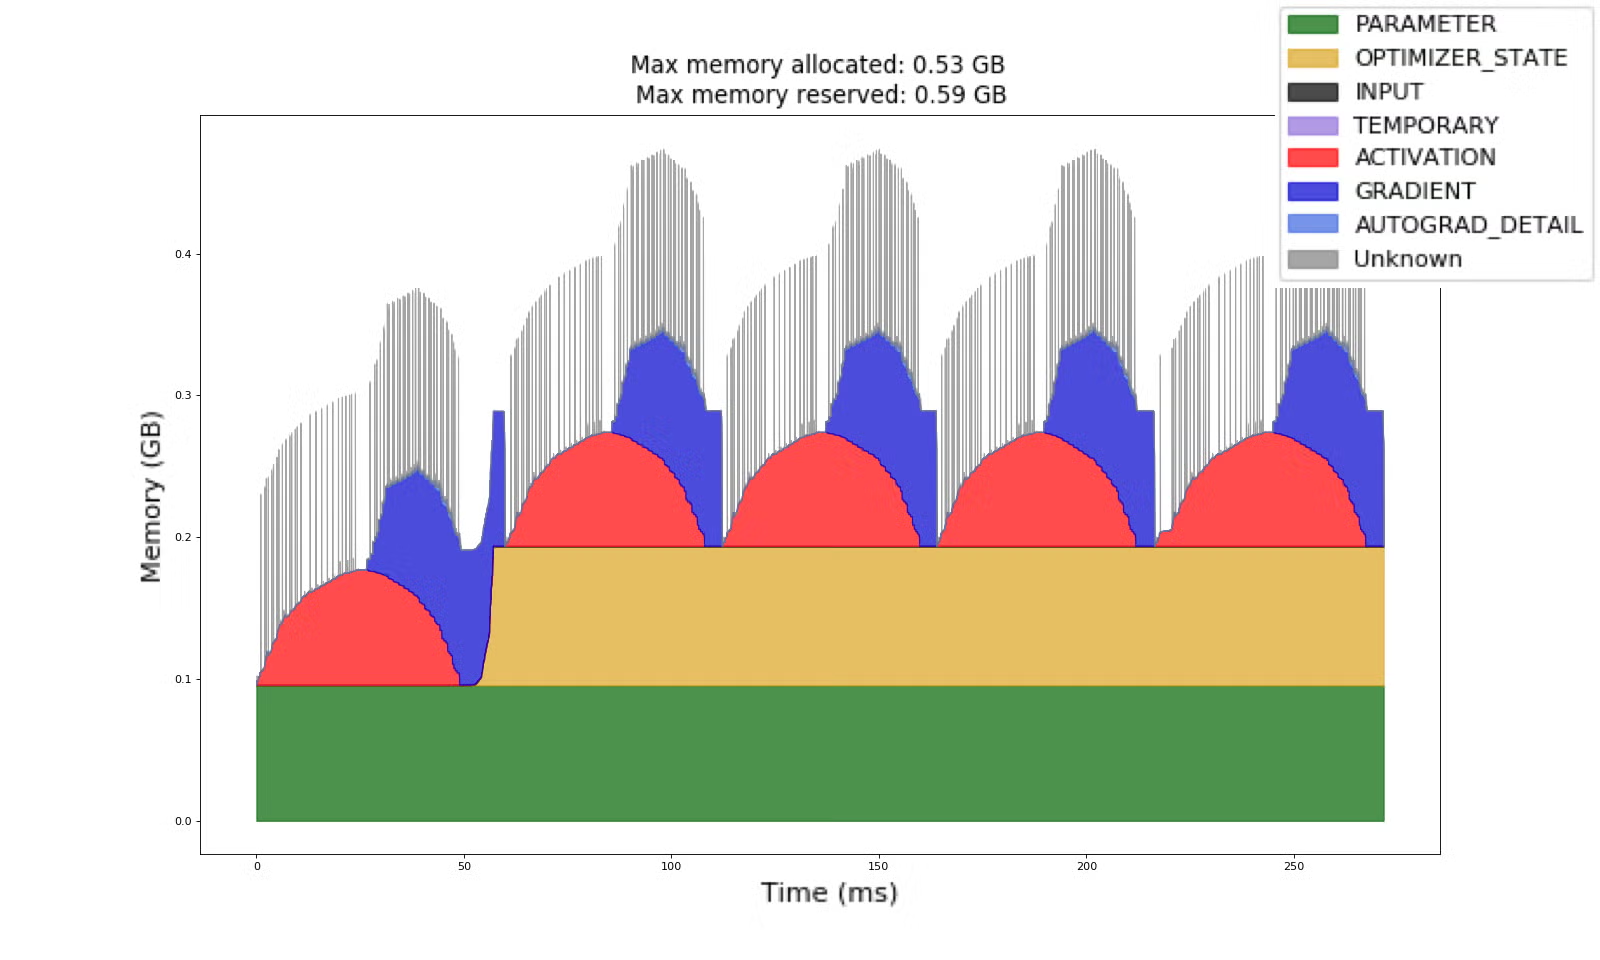
Alors que l'entraînement utilise aussi de la VRAM !

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-189fd45a9e7a6fa1e98d1c9646b57bd0ec48481d%2Ffig6-2.avif?alt=media" alt=""><figcaption></figcaption></figure>
{% endcolumn %}
{% endcolumns %}

Cela signifie que le RL doit conserver 2 ensembles de VRAM / mémoire sur le GPU en même temps :

1. Moteur d'inférence (contient les poids du modèle, le cache KV)
2. Moteur d'entraînement (contient les poids du modèle, les activations, les gradients, les états de l'optimiseur)

Les frameworks RL actuels doivent répartir 50/50 sur un GPU de 80 Go, avec 50 % pour l'inférence et 50 % pour l'entraînement. Et déplacer les poids du mode entraînement au mode inférence peut prendre pas mal de temps.

<table><thead><tr><th width="251.51666259765625">GPU de 80 Go</th><th>Moteur d'inférence (50 %)</th><th>Moteur d'entraînement (50 %)</th></tr></thead><tbody><tr><td>Poids du modèle</td><td>16 Go</td><td>16 Go</td></tr><tr><td>Cache KV</td><td>24 Go</td><td></td></tr><tr><td>Activations, gradients, états de l'optimiseur</td><td></td><td>24 Go</td></tr></tbody></table>

Les versions précédentes d'Unsloth optimisent déjà intelligemment ce qui précède, car nous **partageons directement l'espace mémoire des poids de vLLM, ce qui supprime la double utilisation mémoire des poids du modèle**. Cela libère par exemple 16 Go d'espace qui peuvent être utilisés pour augmenter la longueur de contexte ou la vitesse de génération. De plus, nous n'avons pas besoin d'effectuer de mouvements de mémoire, ce qui accélère l'entraînement.

| GPU de 80 Go                                  | Moteur d'inférence (50 %) | Moteur d'entraînement (50 %) |
| --------------------------------------------- | ------------------------- | ---------------------------- |
| Poids du modèle                               | **16 Go PARTAGÉS**        | **<<< PARTAGÉ**              |
| Cache KV                                      | 24 Go + 8 Go= **32 Go**   |                              |
| Activations, gradients, états de l'optimiseur |                           | 24 Go + 8 Go=**32 Go**       |

## 🦥 Unsloth Standby

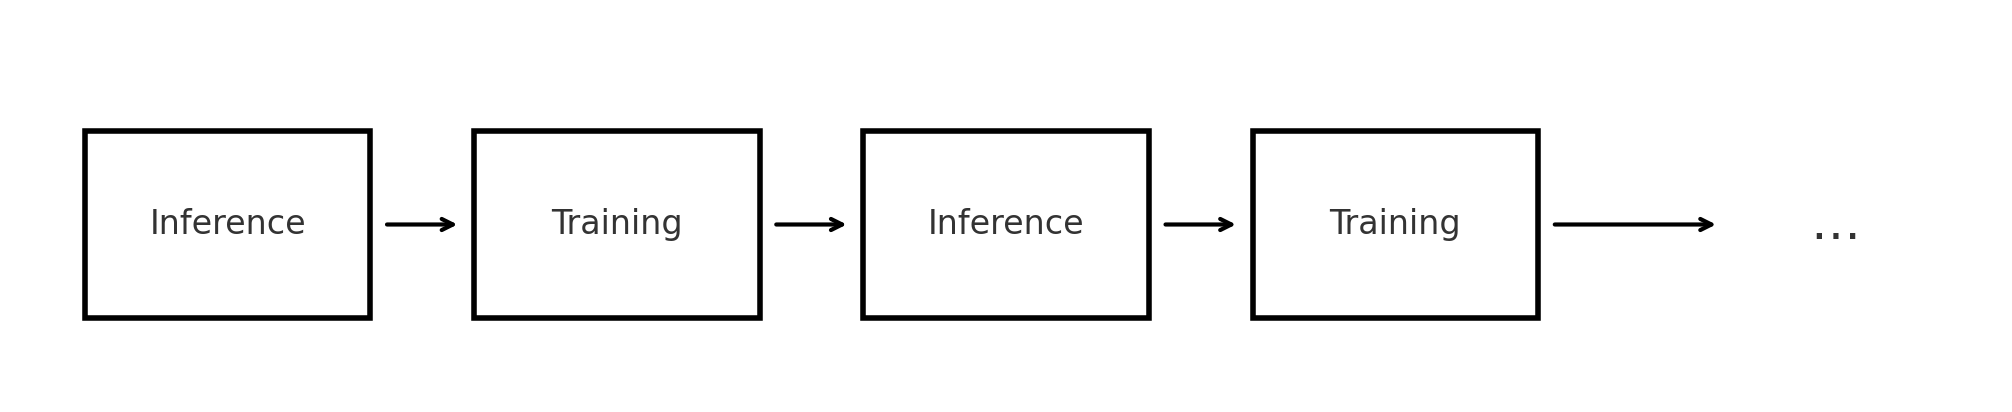
Mais nous pouvons aller plus loin - nous remarquons d'abord que le RL fait de l'inférence puis de l'entraînement puis de l'inférence puis de l'entraînement, etc.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-6e9b6a2f7381de84ed6eeb0feedc566cd443acf3%2F5b957843-eb58-4778-8b90-f25767c51495.png?alt=media" alt=""><figcaption></figcaption></figure>

Cela signifie que l'espace mémoire pour l'inférence et l'entraînement peut en théorie être réutilisé, puisque l'inférence et l'entraînement sont des modes séparés - c'est là que [la fonctionnalité de mode veille de vLLM](https://docs.vllm.ai/en/latest/features/sleep_mode.html#rlhf-weight-updates) intervient, et elle comporte 2 options :

1. `level = 1` copie les poids vers le CPU et supprime le cache KV
2. `level = 2` supprime les poids et supprime le cache KV

Mais rappelons qu'avec Unsloth nous partageons l'espace mémoire de vLLM pour les poids - cela signifie que nous avons besoin d'une nouvelle manière de supprimer le cache KV, et d'ignorer la suppression des poids, et nous appelons cela Unsloth Standby.

| GPU de 80 Go                                                                                                                                                         | Moteur d'inférence | Moteur d'entraînement                         |
| -------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------ | --------------------------------------------- |
| Poids du modèle                                                                                                                                                      | **16 Go PARTAGÉS** | **<<< PARTAGÉ**                               |
| <p><mark style="background-color:purple;"><strong>Polyvalent</strong></mark></p><p><mark style="background-color:purple;"><strong>64 Go d'espace</strong></mark></p> | Cache KV           | Activations, gradients, états de l'optimiseur |

Pour l'activer, ajoutez simplement ce qui suit à toutes les exécutions d'entraînement RL / GRPO avant tout import d'Unsloth :

```python
import os
os.environ["UNSLOTH_VLLM_STANDBY"] = "1"
```

## 🧪 Expériences de performance

Vous trouverez ici comment nous avons benchmarké l'utilisation mémoire et la longueur de contexte pour GRPO. Notez que nous faisons **2 générations par prompt, car pour que GRPO fonctionne**, nous avons besoin d'au moins 2 générations pour calculer la moyenne et la variance de l'échantillon. **Sans 2 générations, l'écart type d'un échantillon est 0**. Cela rend les avantages qui utilisent ceci : (reward - mean)/std **indéfinis**.

$$
Z=\frac{r\_i - \mu}{\sqrt{\frac{1}{n}\sum(r\_i-\mu)^2}} \\
Z\_{n=1}=\frac{r\_1 - \mu}{\sqrt{\frac{1}{1}\sum(r\_1-\mu)^2}}=\frac{0}{0}=\text{undefined}
$$

Cela signifie que, spécifiquement pour GRPO, une longueur de contexte maximale de 6 144 pour Qwen-3 32B correspond en réalité à 6 144 multiplié par 2 générations, soit une longueur de 12 288.

Nous présentons ci-dessous des expériences pour Llama-3.1 8B en LoRA (16 bits) et en QLoRA (4 bits) :
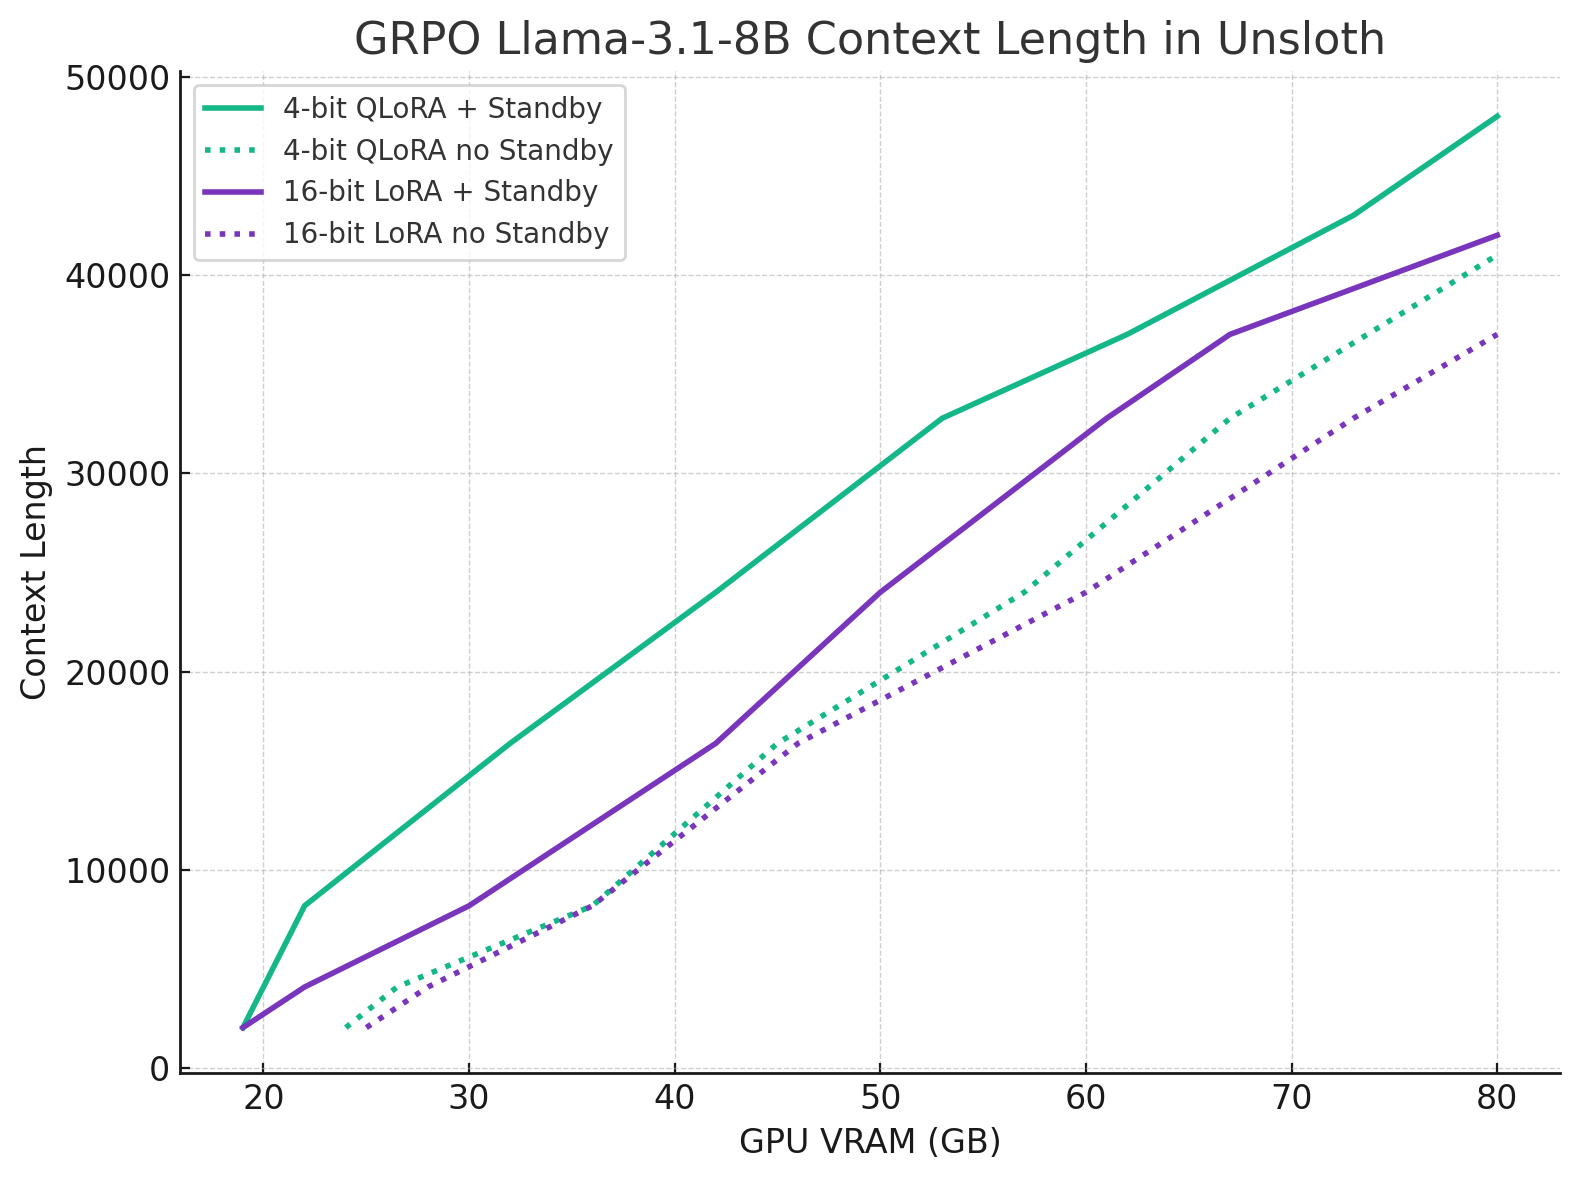
<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f83185e373186aa67bc2ce7d1814b2edb0f3ce6%2Foutput%20(10).png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

**Si vous constatez des différences de temps d'entraînement, ce n'est pas grand-chose**. Dans notre comparaison à configuration égale, nous avons observé des ralentissements de l'entraînement inférieurs à 1 %, voire des accélérations, qui peuvent être attribuées à la marge d'erreur.

Nous pensons aussi que des accélérations sont possibles grâce à une pression mémoire réduite, il pourrait donc y avoir moins de nettoyage mémoire du côté de l'allocateur mémoire CUDA.

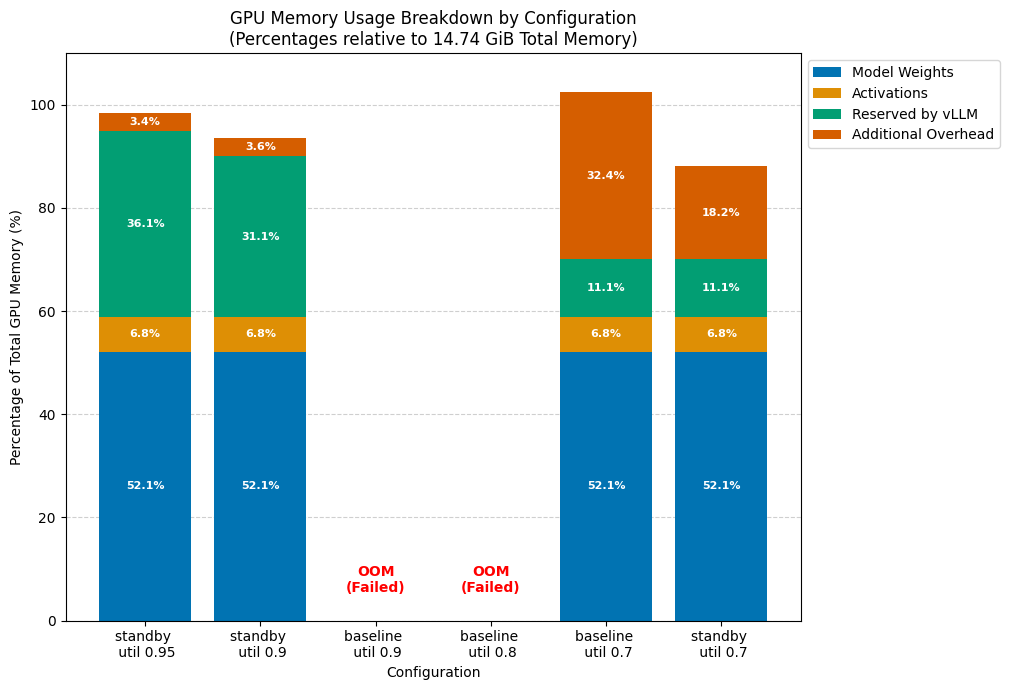
<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-db26f62f9080dba942add171880537c3f516f065%2Fgpu%20mem%20cofigure.png?alt=media" alt=""><figcaption></figcaption></figure>

Dans l'image ci-dessus, vous voyez la différence entre le mode de base et le mode standby sur un seul GPU T4 pour Qwen 3 4B. <mark style="background-color:green;">**Nous pouvons pousser le**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**`gpu_memory_utilisation`**</mark><mark style="background-color:green;">**&#x20;**</mark><mark style="background-color:green;">**jusqu'à 0,95 sans craindre que cela n'affecte l'entraînement**</mark>. Cela signifie que vous pouvez faire tenir des séquences de plus grande longueur de contexte et qu'un plus grand nombre de séquences peut être traité. Dans le premier cas, par exemple, nous avons suffisamment de mémoire pour faire tenir et traiter des séquences de longueur 32K, à condition que l'entraînement le permette, alors qu'auparavant, toute entrée de plus de 2K pouvait potentiellement ne pas tenir et finir par provoquer des OOM (manque de mémoire).

<table data-full-width="true"><thead><tr><th>Expériences</th><th>Configuration</th><th>État</th><th>Utilisation de la mémoire GPU</th><th>Commentaires</th></tr></thead><tbody><tr><td><ol><li><a href="https://colab.research.google.com/drive/18CssBY5C0mStnLvu2Hlt4aFLoPugRG0K?usp=sharing">u0.95gen2ga1s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.95</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>S'exécute pendant 40 étapes / 40 minutes</td><td><p>14.5 GiB (défini par vllm_gpu_util)</p><p><br></p></td><td>Suffisant pour faire tenir un KVCache de 32K avec des blocs de 2 à 4K, ou disons un KVCache de 16K + des blocs de 16K</td></tr><tr><td><ol start="2"><li><a href="https://colab.research.google.com/drive/1q0TOUychygfreI2wKpg51sqnRhs5cYnX?usp=sharing">u9ge2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>S'exécute sur 32 étapes en 40 min</td><td>13.8 GiB (défini par…)</td><td>À peu près suffisant pour faire tenir un KVCache d'environ 28K avec des blocs de 2 à 4K, ou disons un KVCache de 15K + des blocs de 15K</td></tr><tr><td><ol start="3"><li><a href="https://colab.research.google.com/drive/12Uw8y5beLzPtx11mCWCYyh9Z_PEHHdId?usp=sharing">u9ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.9</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>le modèle se charge mais ne peut pas s'entraîner car même une taille de lot de 1 ne tient pas</td><td>OOM</td><td><br></td></tr><tr><td><ol start="4"><li><a href="https://colab.research.google.com/drive/1GwTlaP5CLsW-BcE1LqZWkz6S8VTWYdJ2?usp=sharing">u8ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.8</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td>le modèle se charge mais ne peut pas s'entraîner car même une taille de lot de 1 ne tient pas</td><td>OOM</td><td><br></td></tr><tr><td><ol start="5"><li><a href="https://colab.research.google.com/drive/1IuSUNzEBTiURK-vbTQuRDuUl0Ya2pz2t?usp=sharing">u7ge2ga2ns Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby False</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>S'entraîne correctement</p><p>28 étapes prennent 39 min</p></td><td>~15.1GiB</td><td>toute entrée légèrement plus longue entraînera une OOM sur Colab</td></tr><tr><td><ol start="6"><li><a href="https://colab.research.google.com/drive/1RY7HwpZ0luJT70OyLJ6zXKZQ2COdT9QJ?usp=sharing">u7gen2ga2s Qwen3_(4B)-GRPO.ipynb</a></li></ol></td><td><p><code>standby True</code></p><p><code>vllm_gpu_util 0.7</code></p><p><code>num_gen 2</code></p><p><code>grad_acc_steps 2</code></p></td><td><p>S'entraîne correctement</p><p>29 étapes prennent 40 min</p></td><td>13 GiB mais la plupart du temps autour de 10-11 Go</td><td>Avec la même configuration, nous économisons ici 2 GiB, soit 15 % de mémoire.<br>Cela peut être plus élevé pour des séquences plus longues</td></tr></tbody></table>

### Expériences H100

| Modèle               | GPU                    | Long. de séq. | Nombre de générations | Étapes d'accumulation du gradient |
| -------------------- | ---------------------- | ------------- | --------------------- | --------------------------------- |
| Qwen2.5-14B-Instruct | NVIDIA H100 80 Go PCIe | 32,768        | 8                     | 4                                 |

Dans nos résultats repliables ci-dessous, vous pouvez voir qu'il y a une différence de 9 GiB dans le pic de mémoire utilisé (notez que 90 % du temps, l'utilisation de la mémoire GPU est dans notre cas égale à la mémoire de pic). **Pour mettre les choses en perspective, avec TRL et LoRA nous n'avons pu affiner qu'un modèle de 8 milliards de paramètres avec une longueur de contexte maximale de 1024 (32× moins).** Tout ce qui a une longueur de séquence plus élevée (avec une configuration similaire) entraîne l'échec du processus avec une OOM.

<details>

<summary>Cliquez pour les benchmarks du mode Unsloth Standby vs. sans Standby</summary>

```
Mode Standby activé :

|===========================================================================|
|                  Résumé mémoire CUDA PyTorch, ID de périphérique 0                 |
|---------------------------------------------------------------------------|
|            OOM CUDA : 0            |        tentatives cudaMalloc : 0         |
|===========================================================================|
|        Métrique        | Util. act. | Util. max. | Alloc. tot. | Libéré total |
|---------------------------------------------------------------------------|
| Mémoire allouée       |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       du grand pool |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       du petit pool |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| Mémoire active        |  32249 MiB |  43042 MiB | 128336 GiB | 128305 GiB |
|       du grand pool |  31415 MiB |  42165 MiB | 127204 GiB | 127173 GiB |
|       du petit pool |    834 MiB |   1184 MiB |   1132 GiB |   1131 GiB |
|---------------------------------------------------------------------------|
| Mémoire demandée      |  32199 MiB |  42987 MiB | 128176 GiB | 128145 GiB |
|       du grand pool |  31364 MiB |  42110 MiB | 127047 GiB | 127016 GiB |
|       du petit pool |    834 MiB |   1184 MiB |   1129 GiB |   1128 GiB |
|---------------------------------------------------------------------------|
| Mémoire GPU réservée  |  37644 MiB |  47504 MiB | 705806 MiB | 668162 MiB |
|       du grand pool |  36376 MiB |  46588 MiB | 682818 MiB | 646442 MiB |
|       du petit pool |   1268 MiB |   1284 MiB |  22988 MiB |  21720 MiB |
|---------------------------------------------------------------------------|
| Mémoire non libérable | 713142 KiB |   4633 MiB | 103206 GiB | 103205 GiB |
|       du grand pool | 525312 KiB |   4594 MiB | 101923 GiB | 101922 GiB |
|       du petit pool | 187830 KiB |    250 MiB |   1283 GiB |   1283 GiB |
|---------------------------------------------------------------------------|
| Allocations           |    3460    |    4809    |   15606 K  |   15603 K  |
|       du grand pool |     395    |     563    |    2812 K  |    2811 K  |
|       du petit pool |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| Allocations actives   |    3460    |    4809    |   15606 K  |   15603 K  |
|       du grand pool |     395    |     563    |    2812 K  |    2811 K  |
|       du petit pool |    3065    |    4270    |   12794 K  |   12791 K  |
|---------------------------------------------------------------------------|
| Segments GPU réservés |     913    |     920    |   13260    |   12347    |
|       du grand pool |     279    |     305    |    1766    |    1487    |
|       du petit pool |     634    |     642    |   11494    |   10860    |
|---------------------------------------------------------------------------|
| Allocations non libérables |     422    |     628    |    4766 K  |    4765 K  |
|       du grand pool |      66    |      92    |    1290 K  |    1289 K  |
|       du petit pool |     356    |     555    |    3476 K  |    3475 K  |
|---------------------------------------------------------------------------|
| Allocations surdimensionnées  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Segments GPU surdimensionnés |       0    |       0    |       0    |       0    |
|===========================================================================|


Sans Standby :

|===========================================================================|
|                  Résumé mémoire CUDA PyTorch, ID de périphérique 0                 |
|---------------------------------------------------------------------------|
|            OOM CUDA : 0            |        tentatives cudaMalloc : 0         |
|===========================================================================|
|        Métrique        | Util. act. | Util. max. | Alloc. tot. | Libéré total |
|---------------------------------------------------------------------------|
| Mémoire allouée       |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       du grand pool |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       du petit pool |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| Mémoire active        |  32711 MiB |  52084 MiB | 142756 GiB | 142724 GiB |
|       du grand pool |  31877 MiB |  51207 MiB | 141499 GiB | 141467 GiB |
|       du petit pool |    834 MiB |   1184 MiB |   1257 GiB |   1256 GiB |
|---------------------------------------------------------------------------|
| Mémoire demandée      |  32572 MiB |  51658 MiB | 141898 GiB | 141866 GiB |
|       du grand pool |  31738 MiB |  50780 MiB | 140644 GiB | 140613 GiB |
|       du petit pool |    833 MiB |   1184 MiB |   1253 GiB |   1252 GiB |
|---------------------------------------------------------------------------|
| Mémoire GPU réservée  |  49552 MiB |  52188 MiB |  86354 MiB |  36802 MiB |
|       du grand pool |  48320 MiB |  51300 MiB |  84740 MiB |  36420 MiB |
|       du petit pool |   1232 MiB |   1232 MiB |   1614 MiB |    382 MiB |
|---------------------------------------------------------------------------|
| Mémoire non libérable |      0 B   |      0 B   |      0 B   |      0 B   |
|       du grand pool |      0 B   |      0 B   |      0 B   |      0 B   |
|       du petit pool |      0 B   |      0 B   |      0 B   |      0 B   |
|---------------------------------------------------------------------------|
| Allocations           |    3460    |    4809    |   17440 K  |   17437 K  |
|       du grand pool |     395    |     564    |    2742 K  |    2741 K  |
|       du petit pool |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| Allocations actives   |    3460    |    4809    |   17440 K  |   17437 K  |
|       du grand pool |     395    |     564    |    2742 K  |    2741 K  |
|       du petit pool |    3065    |    4270    |   14698 K  |   14695 K  |
|---------------------------------------------------------------------------|
| Segments GPU réservés |       0    |       0    |       0    |       0    |
|       du grand pool |       0    |       0    |       0    |       0    |
|       du petit pool |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Allocations non libérables |       0    |       0    |       0    |       0    |
|       du grand pool |       0    |       0    |       0    |       0    |
|       du petit pool |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Allocations surdimensionnées  |       0    |       0    |       0    |       0    |
|---------------------------------------------------------------------------|
| Segments GPU surdimensionnés |       0    |       0    |       0    |       0    |
|===========================================================================|
```

</details>

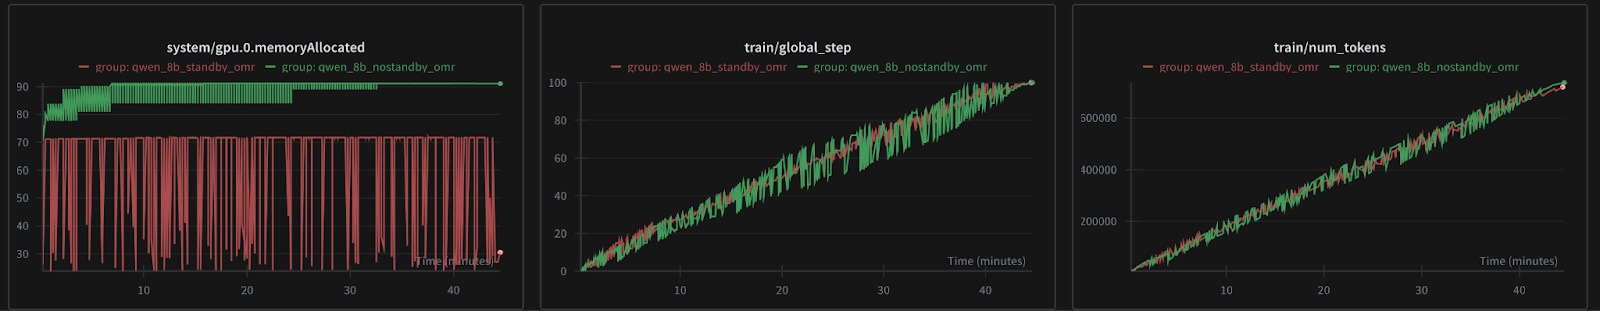
L'image ci-dessous montre comment le mode standby se compare à l'entraînement sans standby avec Unsloth. Les résultats sont moyennés sur 3 exécutions pour s'assurer que les métriques ne sont pas bruitées. En fait, si vous zoomez suffisamment, vous verrez que l'activation du standby le rend aussi plus rapide, probablement en raison d'une pression mémoire moindre comme indiqué précédemment.

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-2f285043ea8afa38d1082513e424662d8cd04b90%2Ftrainglobalstep.png?alt=media" alt=""><figcaption></figcaption></figure>

### Expériences précédentes sur A100 40 Go

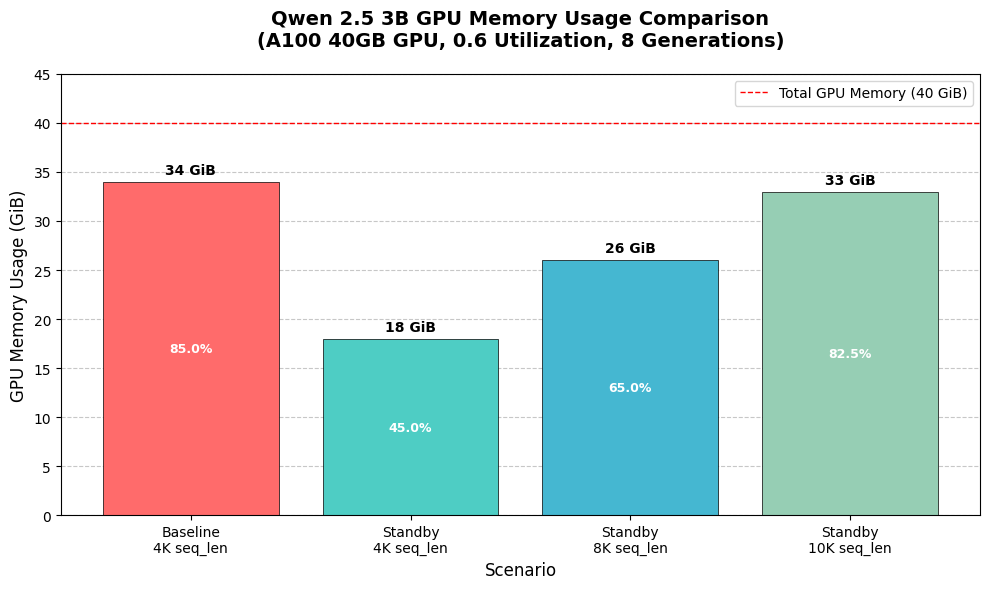
Dans nos expériences précédentes sur un GPU A100 40 Go avec Qwen-2.5-3b-instruct et 8 générations par échantillon, nous avons observé que sans standby, l'entraînement GRPO (modèle chargé en 16 bits, LoRA, seuls les poids étaient entraînables), nous ne pouvions faire tenir que des longueurs de séquence de 6K. Avec notre fonctionnalité standby, nous avons pu faire tenir 10K et au-delà ! **À titre de comparaison, TRL ne peut vous donner que des longueurs de contexte jusqu'à 1K à taille de lot identique.**

<figure><img src="https://550366147-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FxhOjnexMCB3dmuQFQ2Zq%2Fuploads%2Fgit-blob-c7cd807b5d513b04f5f3a6219bfcea0fb12e442a%2Fqwen3%20gpu%20mem.png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

## :tada:Autres optimisations

Nous sélectionnons désormais de meilleurs flags de compilation et réduisons les temps de compilation de 50 % ou plus. Nous avons également réussi à patcher dynamiquement n'importe quelle version de vLLM pour prendre en charge `gc.collect` mieux, pour des raisons de rétrocompatibilité, comme inspiré par ce [pull request vLLM](https://github.com/vllm-project/vllm/pull/21146). Cela réduit les temps de compilation de 2 minutes à moins de 40 secondes.

Nous avons également optimisé `torch.compile` flags et essayé d'activer certains flags - malheureusement `combo_kernels` et `multi_kernel` n'ont pas pu fonctionner correctement sur vLLM 0.10 et Torch 2.8/2.9 nightly et `coordinate_descent_tuning` a rendu l'autotuning de tous les kernels énormément plus lent. Cela compilait auparavant en moins d'une minute, mais l'activer prenait plus de 13 minutes, voire davantage, avec des gains de performance minimes.

## :books:Notebooks GRPO

Tous nos notebooks GRPO ont Unsloth Standby activé par défaut ainsi que toutes les optimisations ! Voir <https://docs.unsloth.ai/get-started/unsloth-notebooks> pour tous nos notebooks GRPO, ou essayez ci-dessous :

* [**Qwen3 (4B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen3_\(4B\)-GRPO.ipynb) **-** LoRA GRPO avancé
* [**DeepSeek-R1-0528-Qwen3 (8B)**](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/DeepSeek_R1_0528_Qwen3_\(8B\)_GRPO.ipynb) (pour les cas d'utilisation multilingues)
* [Gemma 3 (1B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Gemma3_\(1B\)-GRPO.ipynb)
* [Llama 3.2 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Advanced_Llama3_2_\(3B\)_GRPO_LoRA.ipynb) - LoRA GRPO avancé
* [Llama 3.1 (8B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Llama3.1_\(8B\)-GRPO.ipynb)
* [Phi-4 (14B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Phi_4_\(14B\)-GRPO.ipynb)
* [Mistral v0.3 (7B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Mistral_v0.3_\(7B\)-GRPO.ipynb)
* [Qwen2.5 (3B)](https://colab.research.google.com/github/unslothai/notebooks/blob/main/nb/Qwen2.5_\(3B\)-GRPO.ipynb)


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://unsloth.ai/docs/fr/commencer/reinforcement-learning-rl-guide/memory-efficient-rl.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.