> For the complete documentation index, see [llms.txt](https://unsloth.ai/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://unsloth.ai/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md).
# Langer Kontext gpt-oss-Training
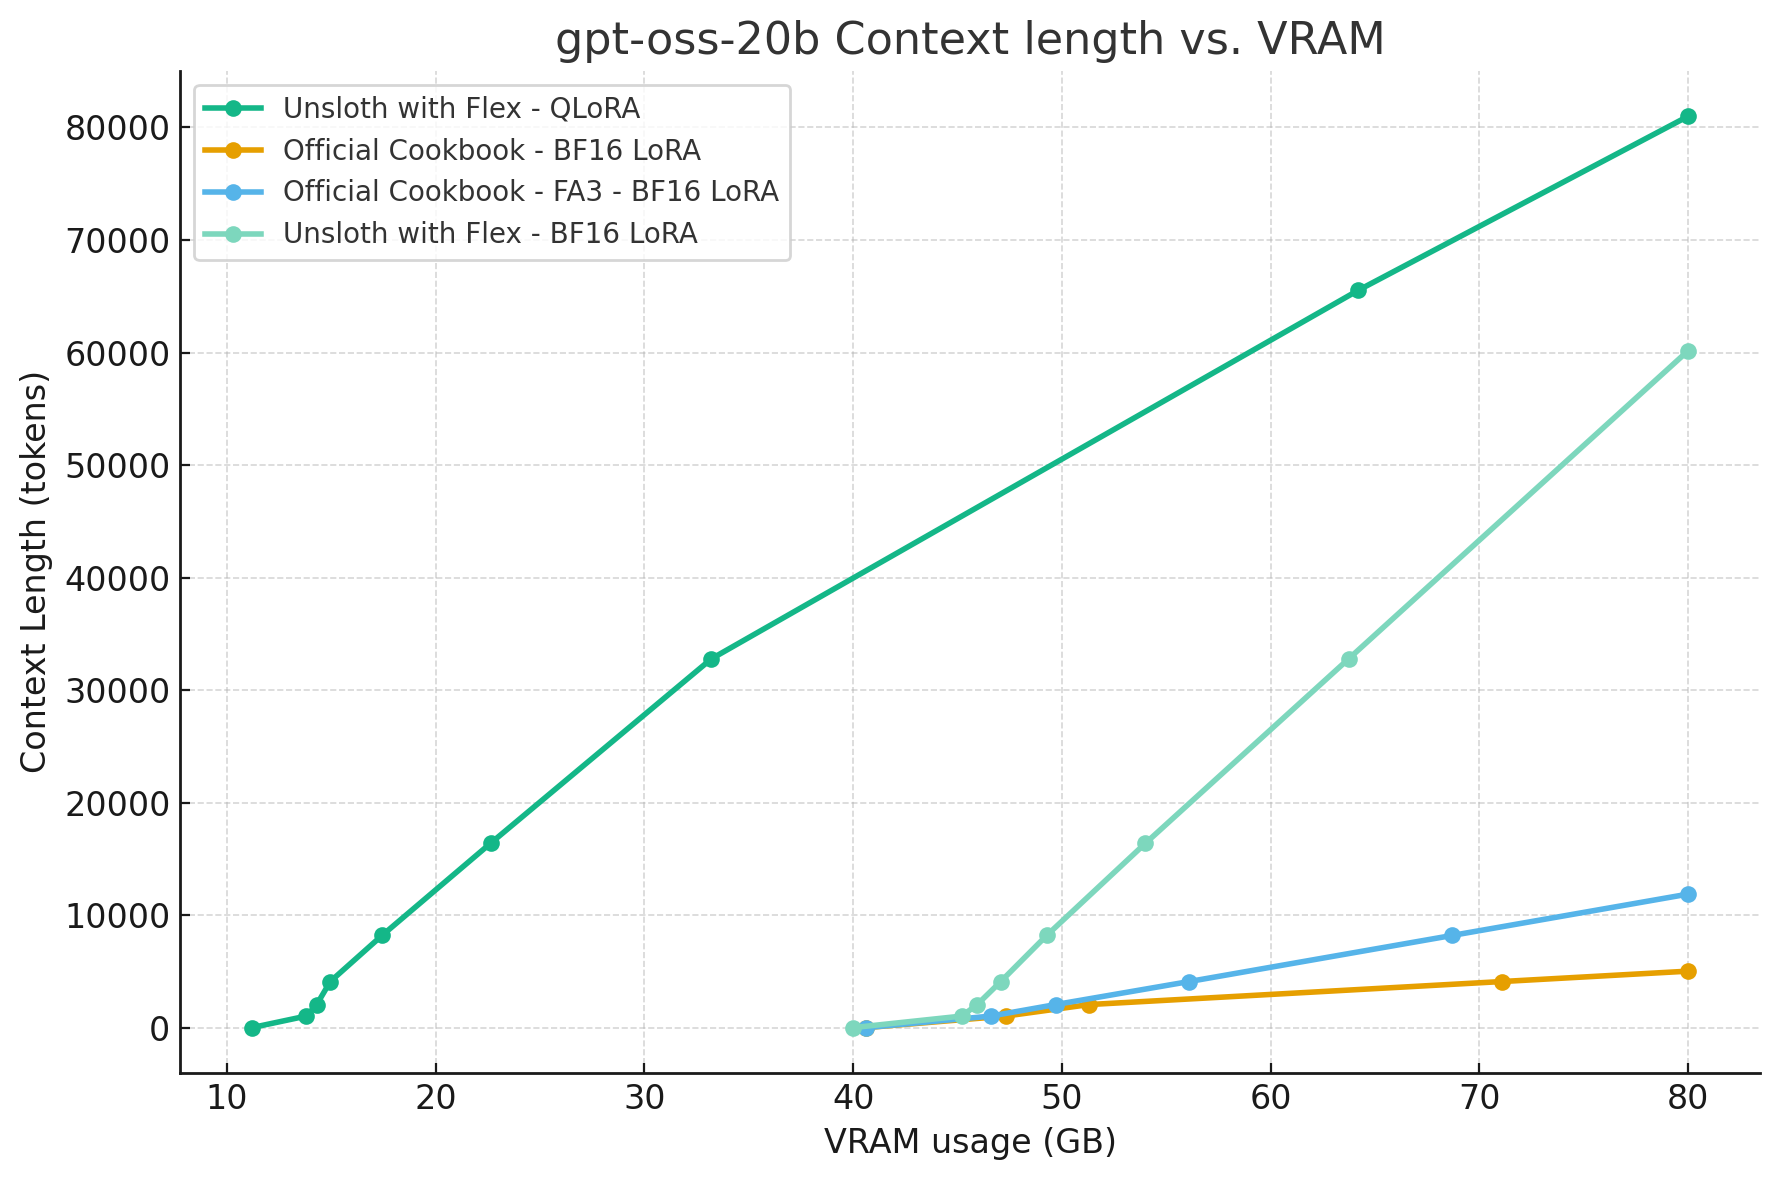
Wir freuen uns, Unsloth Flex Attention-Unterstützung für das Training von OpenAI gpt-oss vorzustellen, die es ermöglicht **>8× längere Kontextlängen**, **>50 % weniger VRAM-Nutzung** und **>1,5× schnelleres Training (ohne Genauigkeitsverlust)** im Vergleich zu allen Implementierungen, einschließlich solcher mit Flash Attention 3 (FA3). Unsloth Flex Attention ermöglicht das Training mit einer **Kontextlänge von 60K** auf einer H100-GPU mit 80 GB VRAM für BF16 LoRA. Außerdem:
* Sie können [jetzt exportieren/speichern](#new-saving-to-gguf-vllm-after-gpt-oss-training) Ihr QLoRA-feinabgestimmtes gpt-oss-Modell nach llama.cpp, vLLM, Ollama oder HF
* Wir [**behobene gpt-oss-Trainings**](#bug-fixes-for-gpt-oss) **Verluste, die ins Unendliche gehen** auf GPUs mit float16 (wie T4 Colab)
* Wir [behobene gpt-oss-Implementierung](#bug-fixes-for-gpt-oss) für Unsloth irrelevante Probleme, insbesondere die Sicherstellung, dass `swiglu_limit = 7.0` während der MXFP4-Inferenz in Transformers korrekt angewendet wird
## 🦥Unsloth Flex Attention-Unterstützung vorstellen
Mit Unsloths Flex-Attention-Unterstützung kann eine einzelne H100 mit 80 GB VRAM bis zu 81K Kontextlänge mit QLoRA und 60K Kontext mit BF16 LoRA verarbeiten! Diese Verbesserungen gelten für **BEIDE** gpt-oss-20b und **gpt-oss-120b**! Je mehr Kontextlänge Sie verwenden, desto mehr Gewinne erhalten Sie durch Unsloth Flex Attention:
Im Vergleich dazu erreichen alle anderen nicht von Unsloth stammenden Implementierungen maximal 9K Kontextlänge auf einer 80-GB-GPU und kommen mit FA3 nur auf 15K Kontext. Aber, **FA3 ist für das gpt-oss-Training ungeeignet, da die Rückwärtsausführung für Attention Sinks fehlt**. Wenn Sie zuvor FA3 für das gpt-oss-Training verwendet haben, würden wir Ihnen empfehlen, **es vorerst nicht zu verwenden** fürs Erste. Somit liegt die maximale Kontextlänge, die Sie ohne Unsloth auf 80 GB VRAM erreichen können, bei etwa 9K.
Das Training mit Unsloth Flex Attention liefert mindestens einen 1,3×-Geschwindigkeitsgewinn, wobei die Gewinne mit steigender Kontextlänge zunehmen und bis zu 2× schneller werden. Da Flex Attention mit dem Kontext skaliert, führen längere Sequenzen zu größeren Einsparungen sowohl beim VRAM als auch bei der Trainingszeit, wie [hier beschrieben](#unsloths-flex-attention-implementation).
Ein riesiges Dankeschön an Rohan Pandey für seine [Flex-Attention-Implementierung](https://x.com/khoomeik/status/1955693558914310608), die die Entwicklung von Unsloths Flex-Attention-Implementierung direkt inspiriert hat.
## :dark\_sunglasses: Attention-Sinks
OpenAIs GPT-OSS-Modell verwendet ein **alternierendes Muster aus Sliding-Window-Attention, Full Attention**, Sliding-Window-Attention und so weiter (SWA, FA, SWA, FA usw.). Jedes Sliding Window achtet nur auf **128 Tokens** (einschließlich des aktuellen Tokens), sodass die Berechnung stark reduziert wird. Dies bedeutet jedoch auch, dass das Abrufen und Schlussfolgern über lange Kontexte aufgrund des kleinen Sliding Window nutzlos wird. Die meisten Labs beheben dies, indem sie das Sliding Window auf 2048 oder 4096 Tokens erweitern.
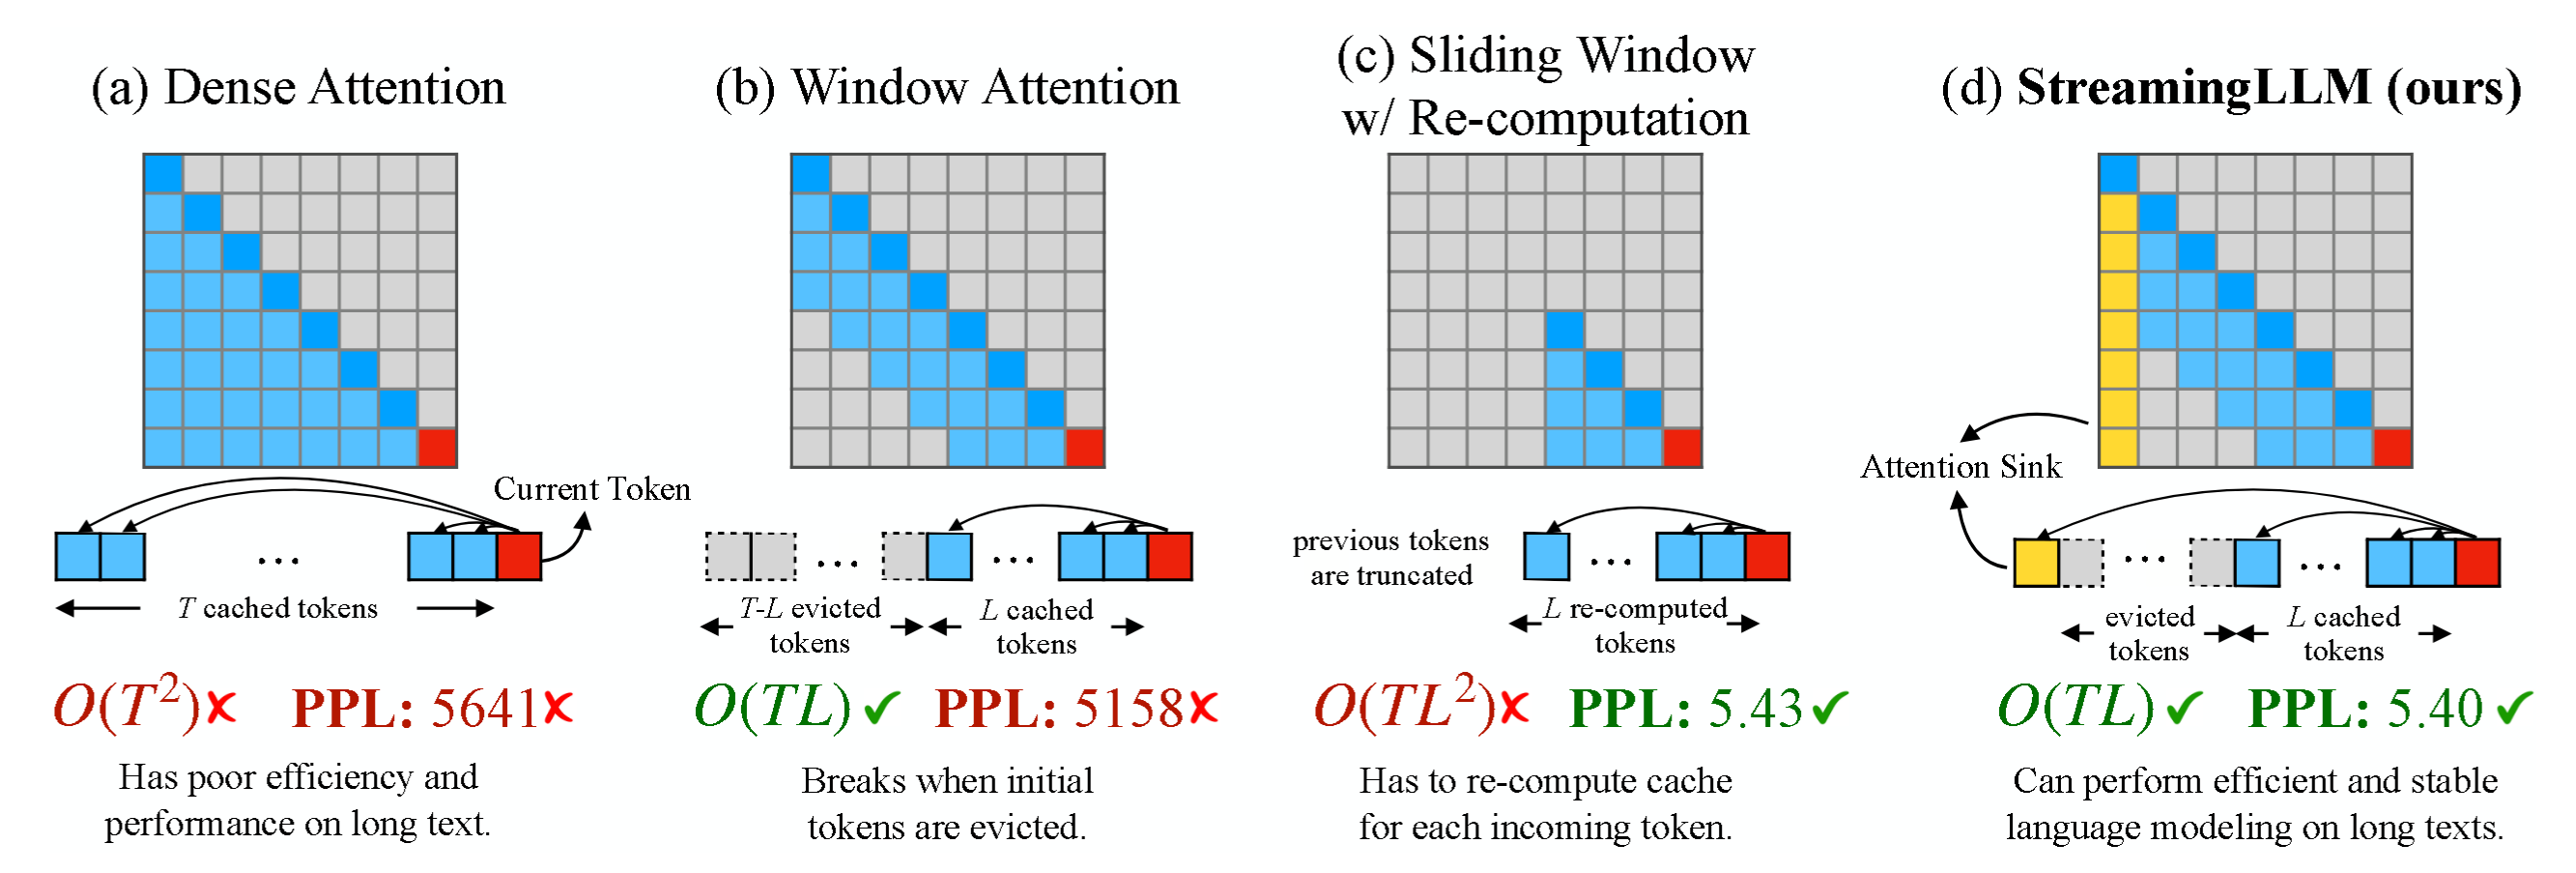
OpenAI nutzte **Attention-Sinks** aus dem Paper „Efficient Streaming Language Models with Attention Sinks“ [Paper](https://arxiv.org/abs/2309.17453) das zeigt, dass man ein kleines Sliding Window verwenden kann, allerdings muss man am ersten Token globale Attention hinzufügen! Das Paper liefert unten eine gute Abbildung:
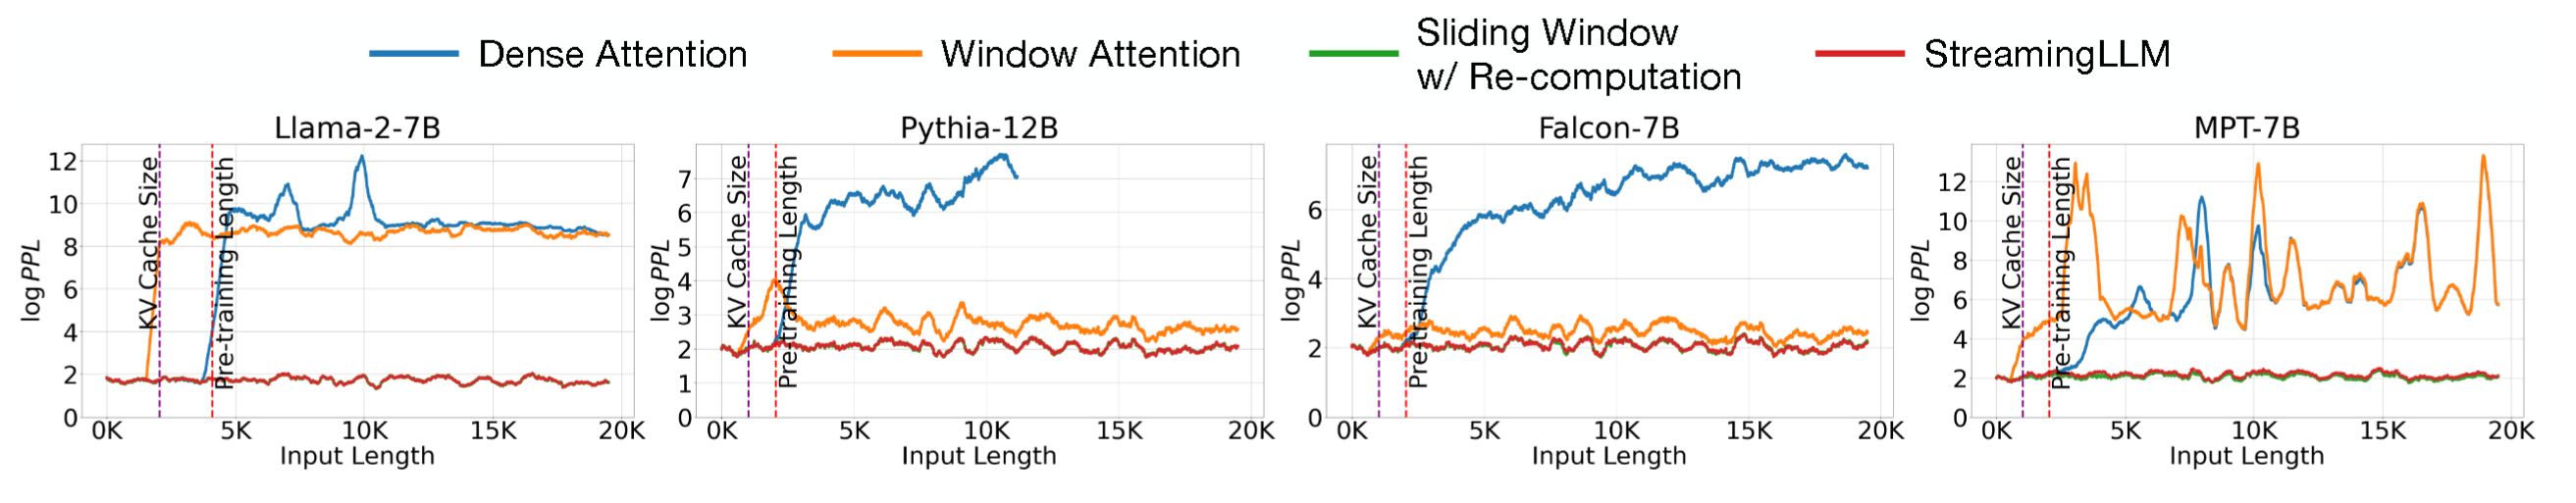
Das Paper stellt fest, dass der **Aufmerksamkeitsmechanismus den ersten wenigen Tokens (1 bis 4) offenbar sehr viel Gewicht beimisst**, und indem man sie während der Sliding-Window-Operation entfernt, verschwinden diese „wichtigen“ ersten wenigen Tokens, was zu schlechtem Abrufen langer Kontexte führt.
Wenn wir die log-Perplexität auftragen (höher ist schlechter) und Inferenz über einen langen Kontext nach der festgelegten Kontextlänge des vortrainierten Modells durchführen, sehen wir, dass die Perplexität stark ansteigt (nicht gut). Die rote Linie (verwendet Attention Sinks) bleibt jedoch niedrig, was sehr gut ist!
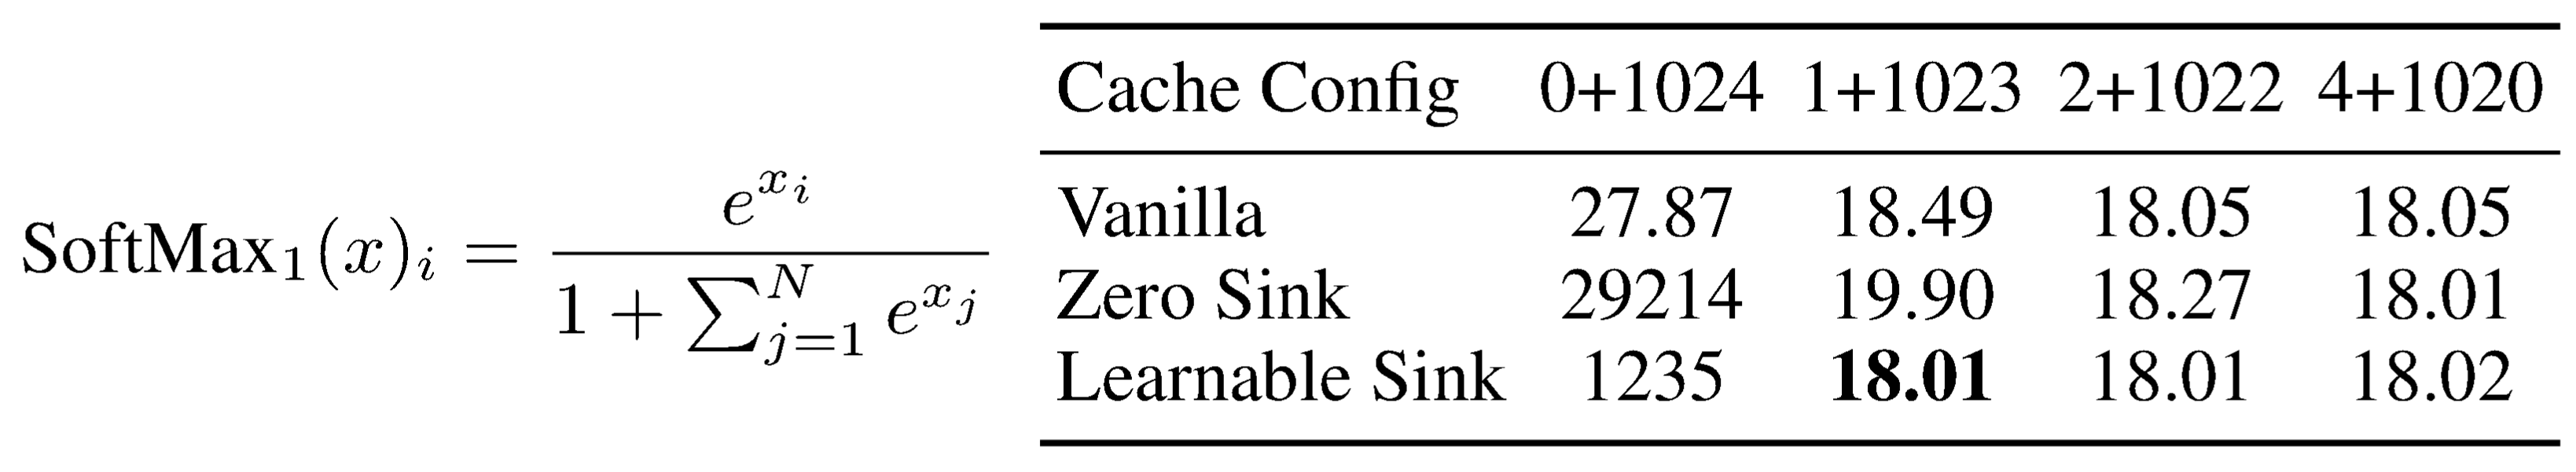
Das Paper zeigt auch, dass die [Methode „Attention Is Off By One“](https://www.evanmiller.org/attention-is-off-by-one.html) teilweise funktioniert, allerdings muss man auch ein paar zusätzliche Sink-Tokens hinzufügen, um niedrigere Perplexitäten zu erhalten. **Das Paper zeigt, dass das Hinzufügen eines einzigen Sink-Tokens, das lernbar ist, bemerkenswert gut funktioniert! Und genau das hat OpenAI für GPT-OSS gemacht!**
## :triangular\_ruler:Unsloths Flex-Attention-Implementierung
Flex Attention ist extrem leistungsfähig, da sie dem Anwender 2 Anpassungswege für den Aufmerksamkeitsmechanismus bietet - eine **Score-Modifikator (f)** und ein **Maskierungsfunktion (M)**.
Der **Score-Modifikator (f)** ermöglicht es uns, die Attention-Logits vor der Softmax-Operation zu bearbeiten, und die **Maskierungsfunktion (M)** ermöglicht es uns, Operationen zu überspringen, wenn wir sie nicht brauchen (z. B. sieht die Sliding-Window-Attention nur die letzten 128 Tokens).
**Der Trick ist, dass Flex Attention schnelle, automatisch generierte Triton-Kernels mit beliebigen Score-Modifikatoren und Maskierungsfunktionen bereitstellt!**
\sigma\bigg(s\times\bold{f}(QK^T+\bold{M})\bigg)
Das bedeutet, dass wir Flex Attention verwenden können, um Attention Sinks zu implementieren! Die Implementierung eines einzelnen Attention Sink ist sowohl im [ursprünglichen GPT-OSS-Repo von OpenAI](#implementations-for-sink-attention) und in HuggingFaces Transformers-Implementierung enthalten.
```python
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
probs = F.softmax(combined_logits, dim=-1)
scores = probs[..., :-1]
```
Das Obige zeigt, dass wir den Sink ganz am Ende von `Q @ K.T` , anhängen, die Softmax durchführen und die letzte Spalte entfernen, die das Sink-Token war.
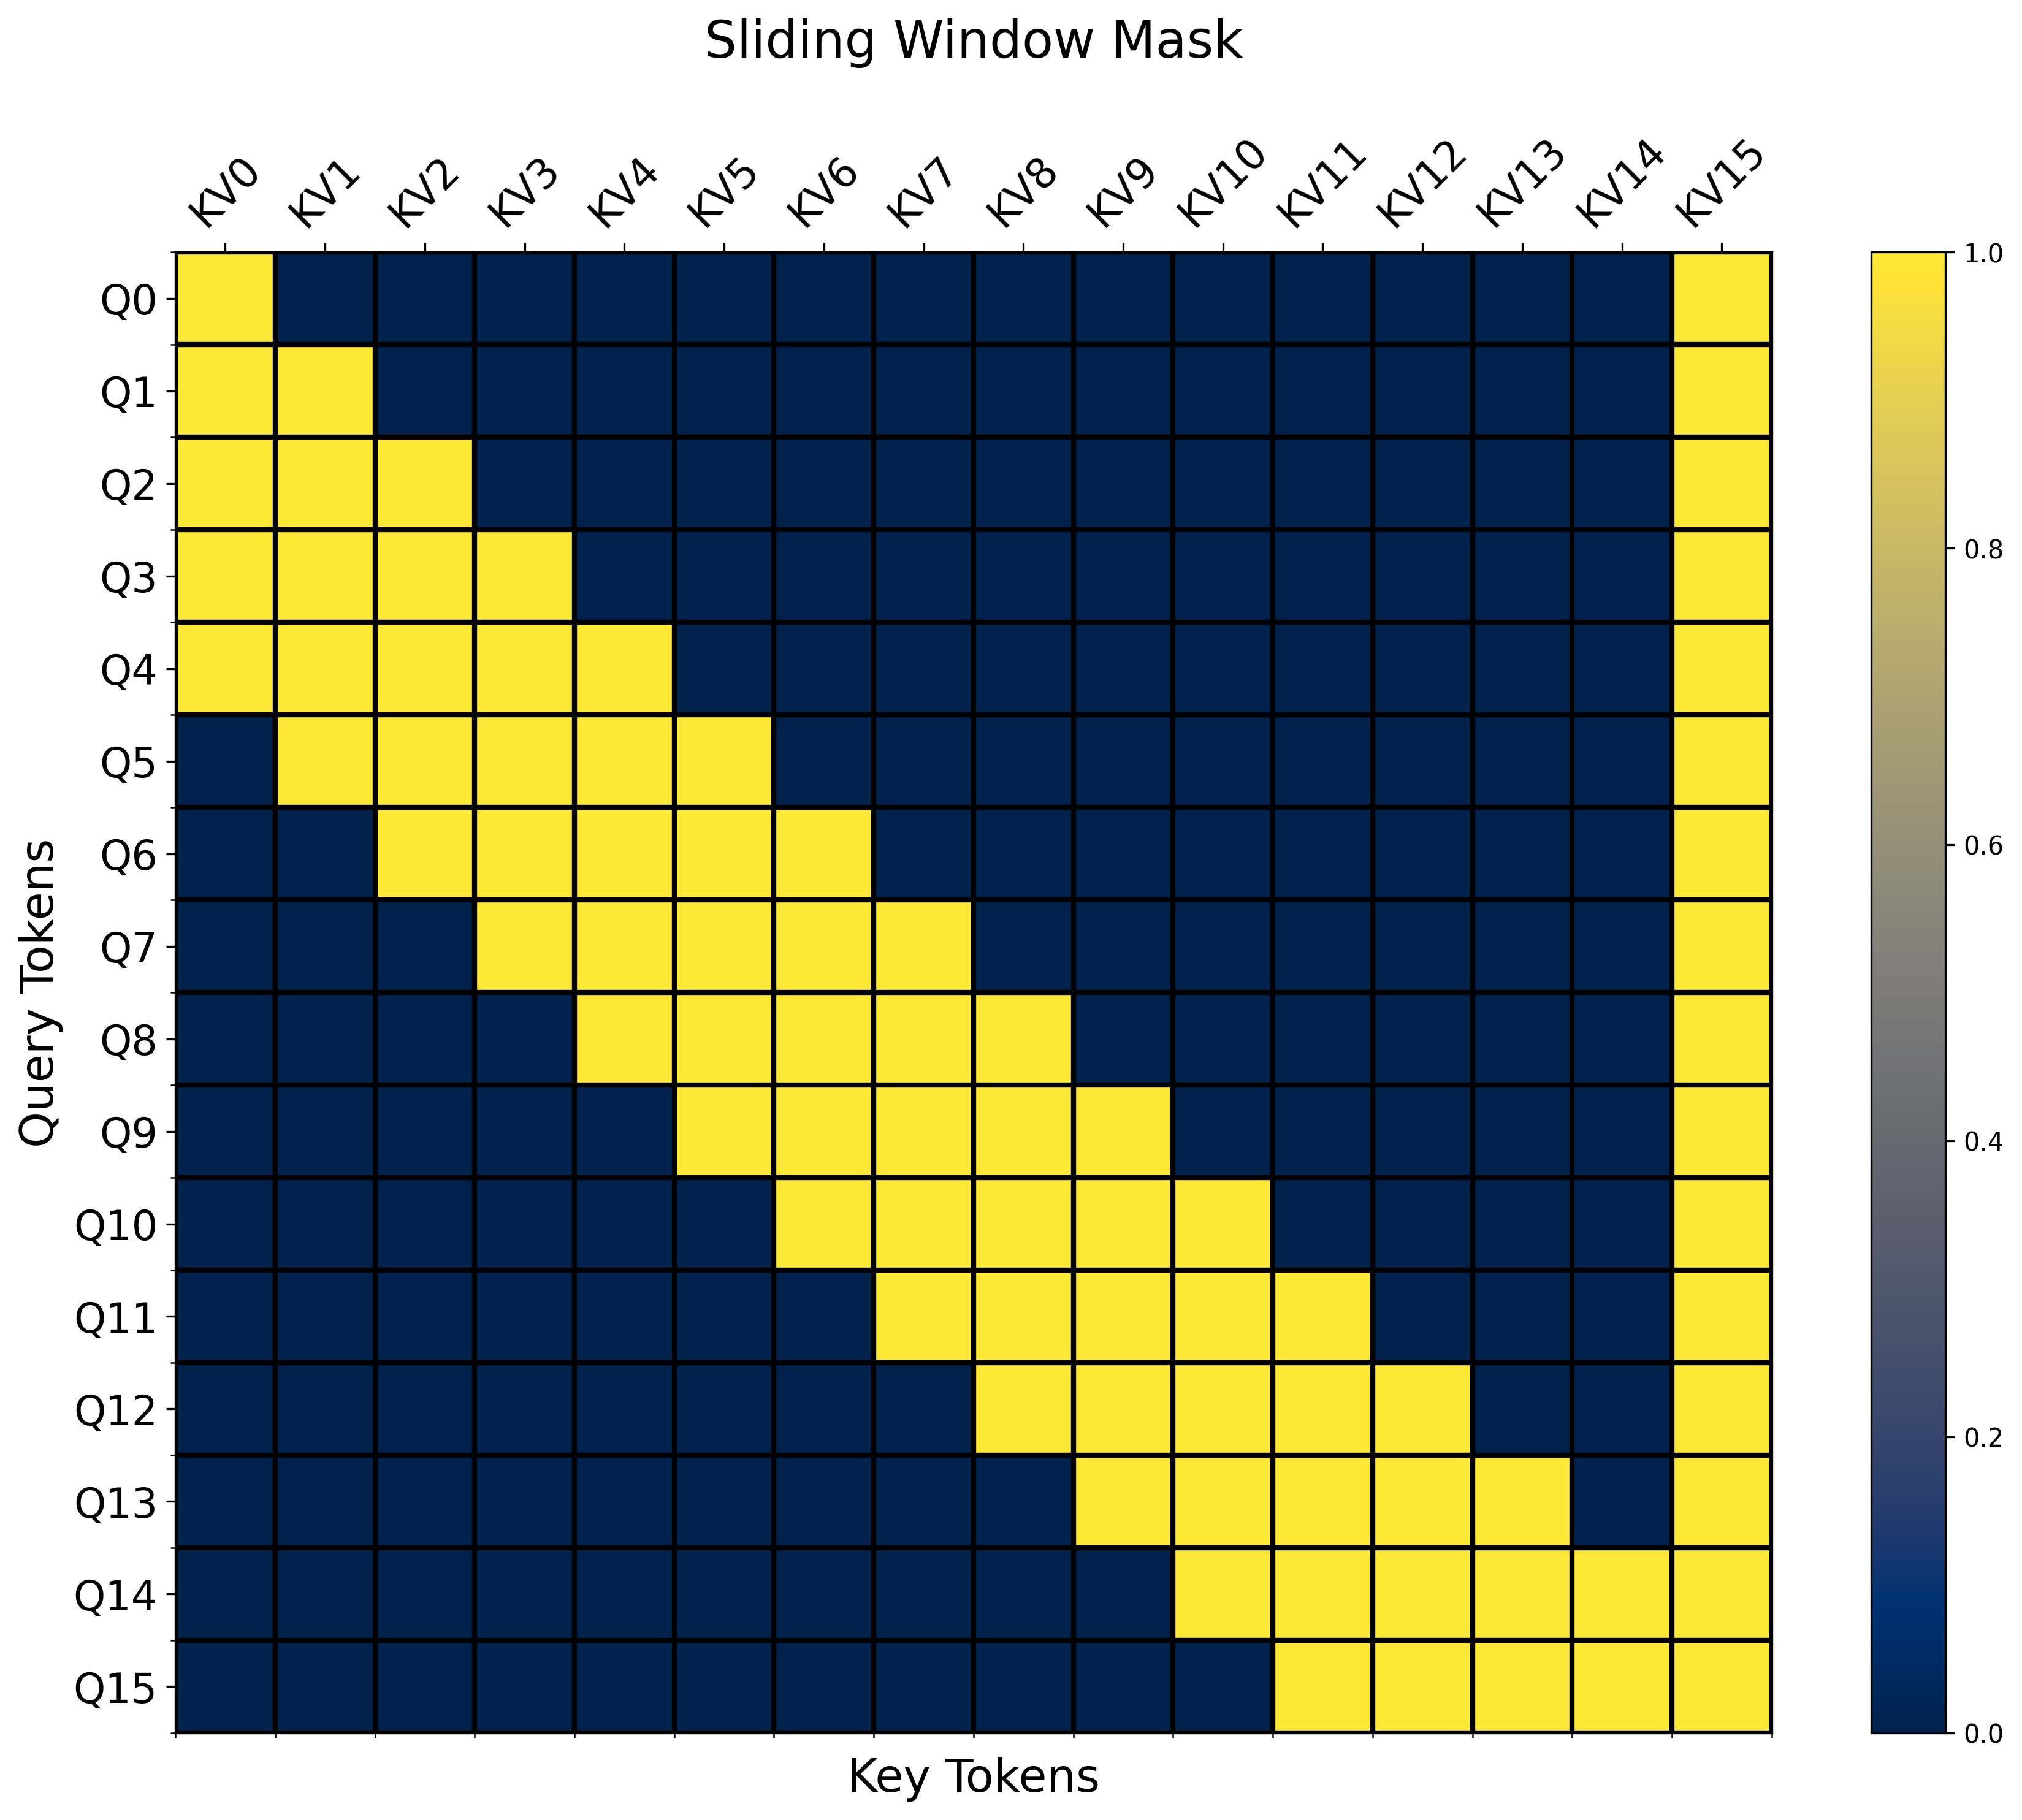
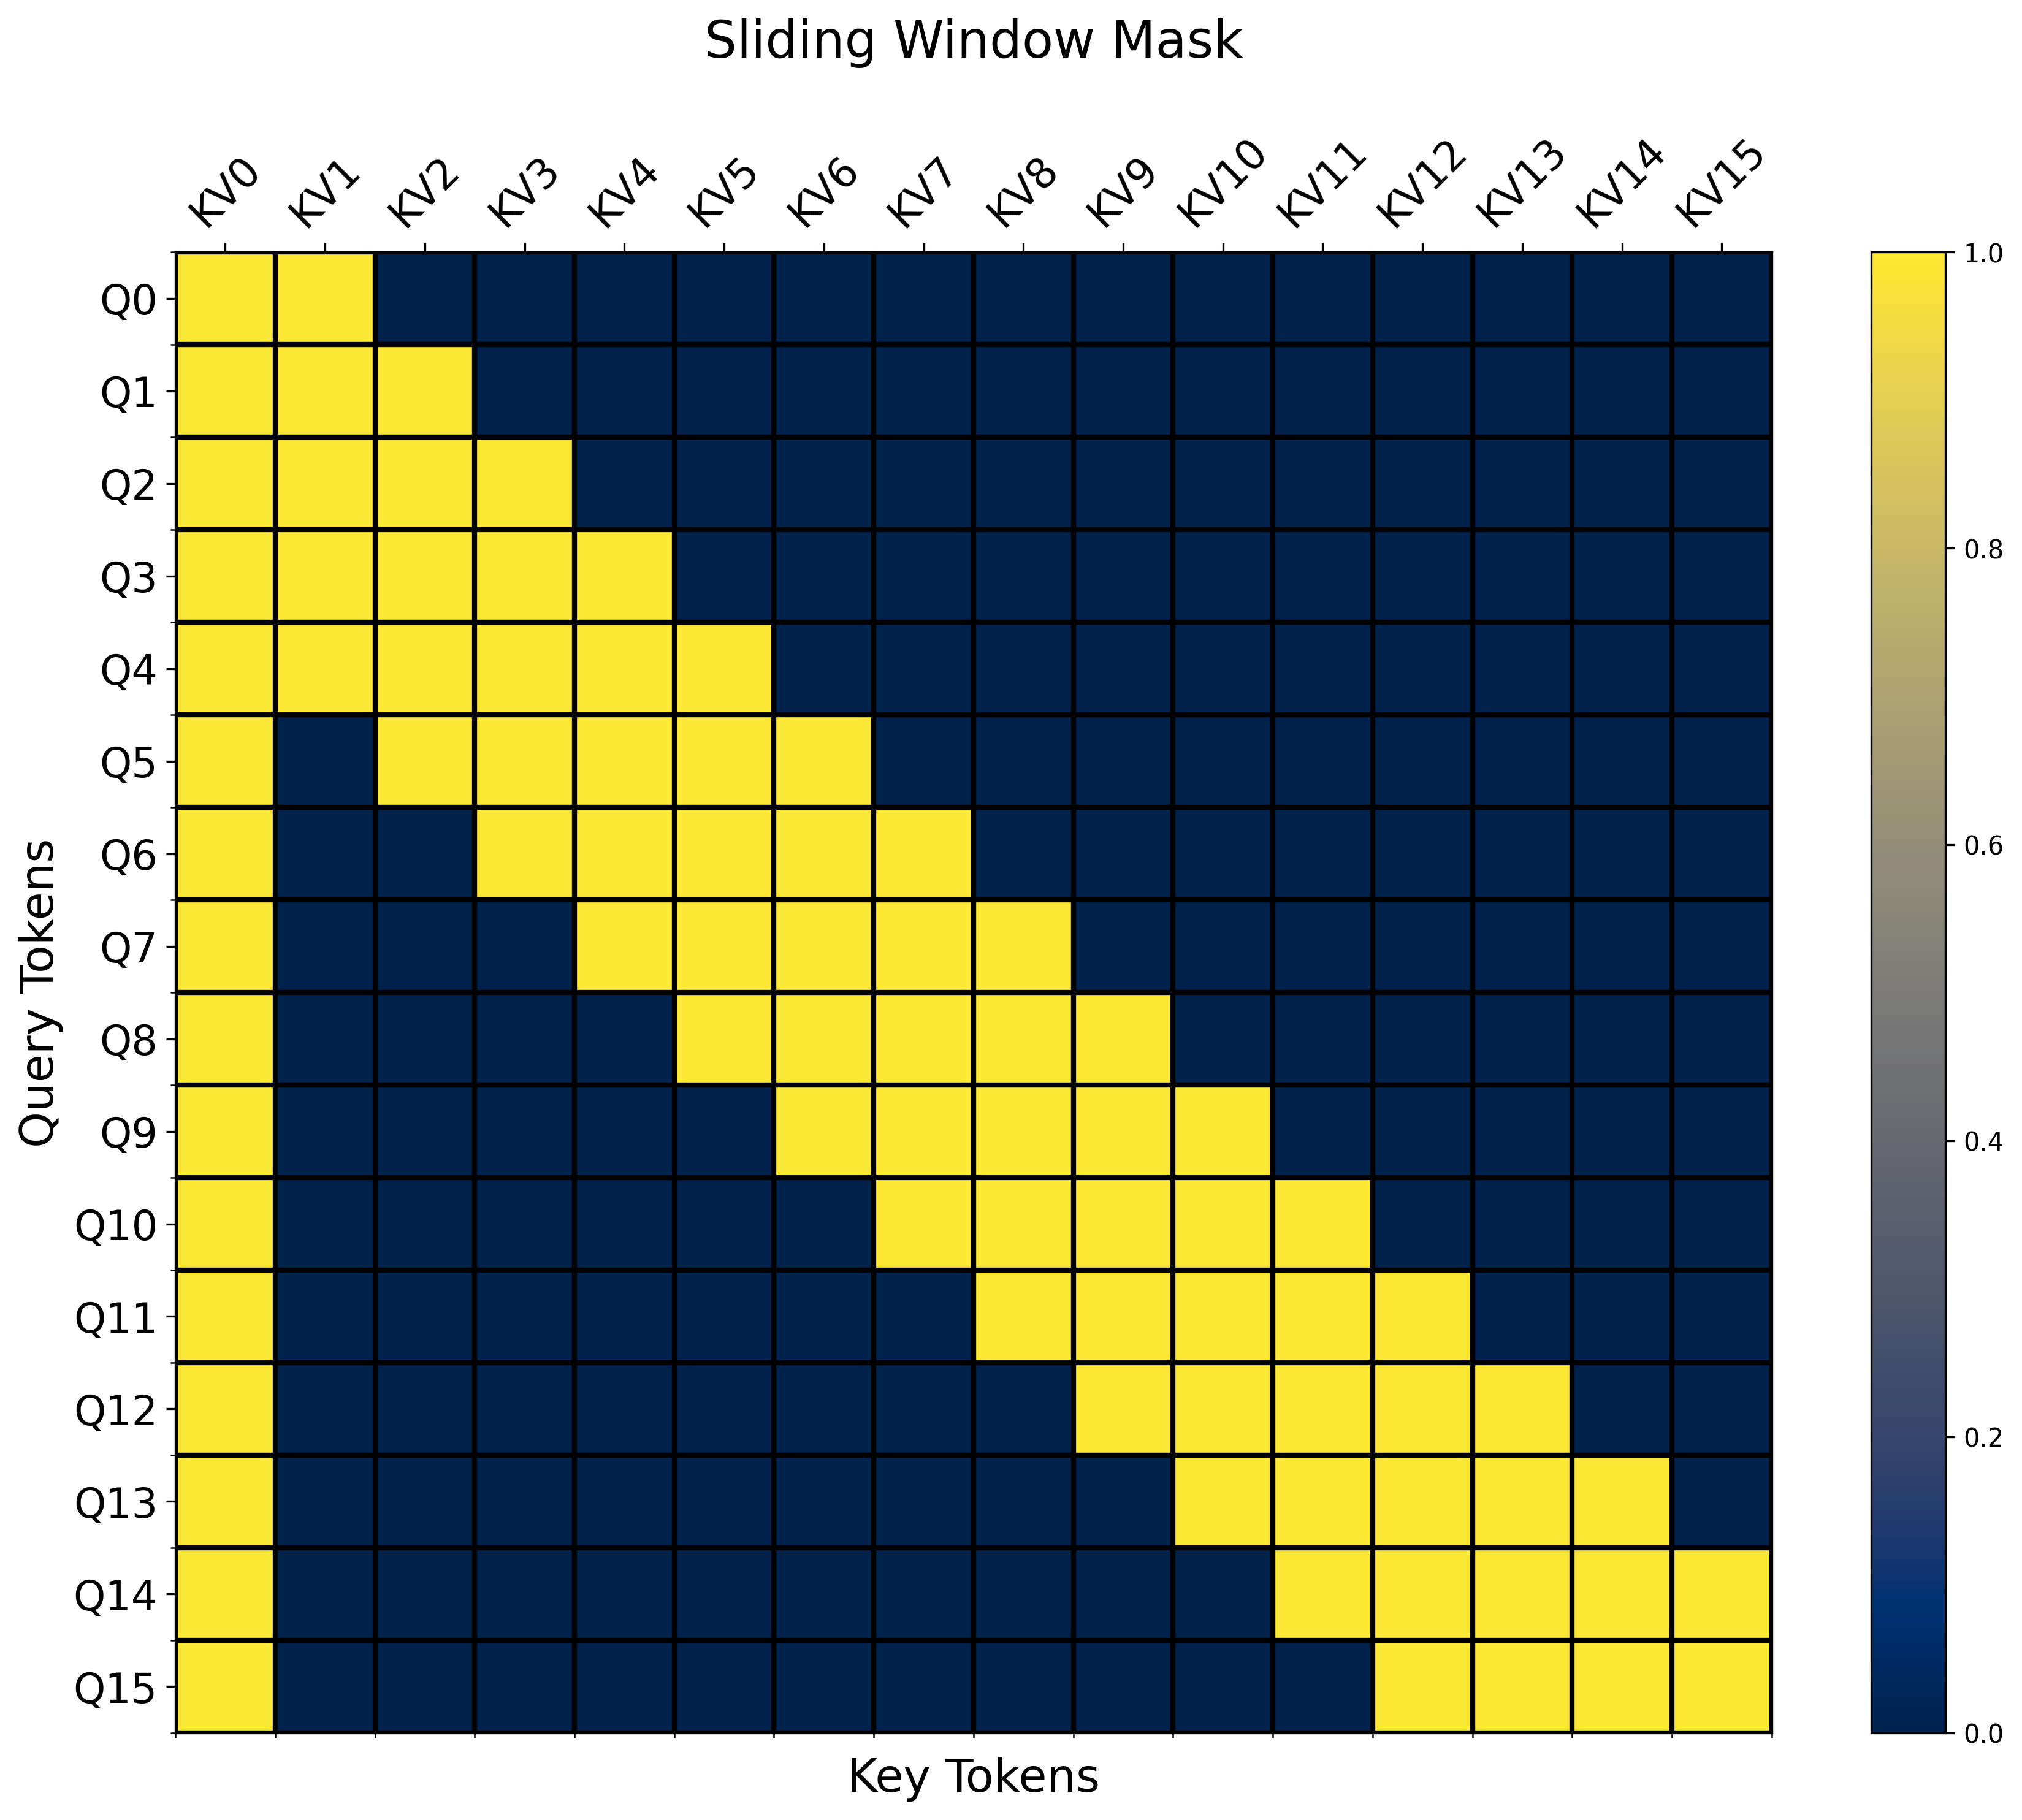
Mithilfe einiger Visualisierungswerkzeuge aus [Flex Attentions GitHub-Repo](https://github.com/meta-pytorch/attention-gym), können wir dies visualisieren. Nehmen wir an, die Sequenzlänge beträgt 16 und das Sliding Window 5. Links ist die letzte Sink-Spalte (Standardimplementierung) und rechts ist, wenn wir die Sink-Position auf Index 0 verschieben (unsere Implementierung).
{% columns %}
{% column %}
***Sink-Position am Ende (Standard)***
{% endcolumn %}
{% column %}
***Sink-Position auf Index 0 verschieben***
{% endcolumn %}
{% endcolumns %}
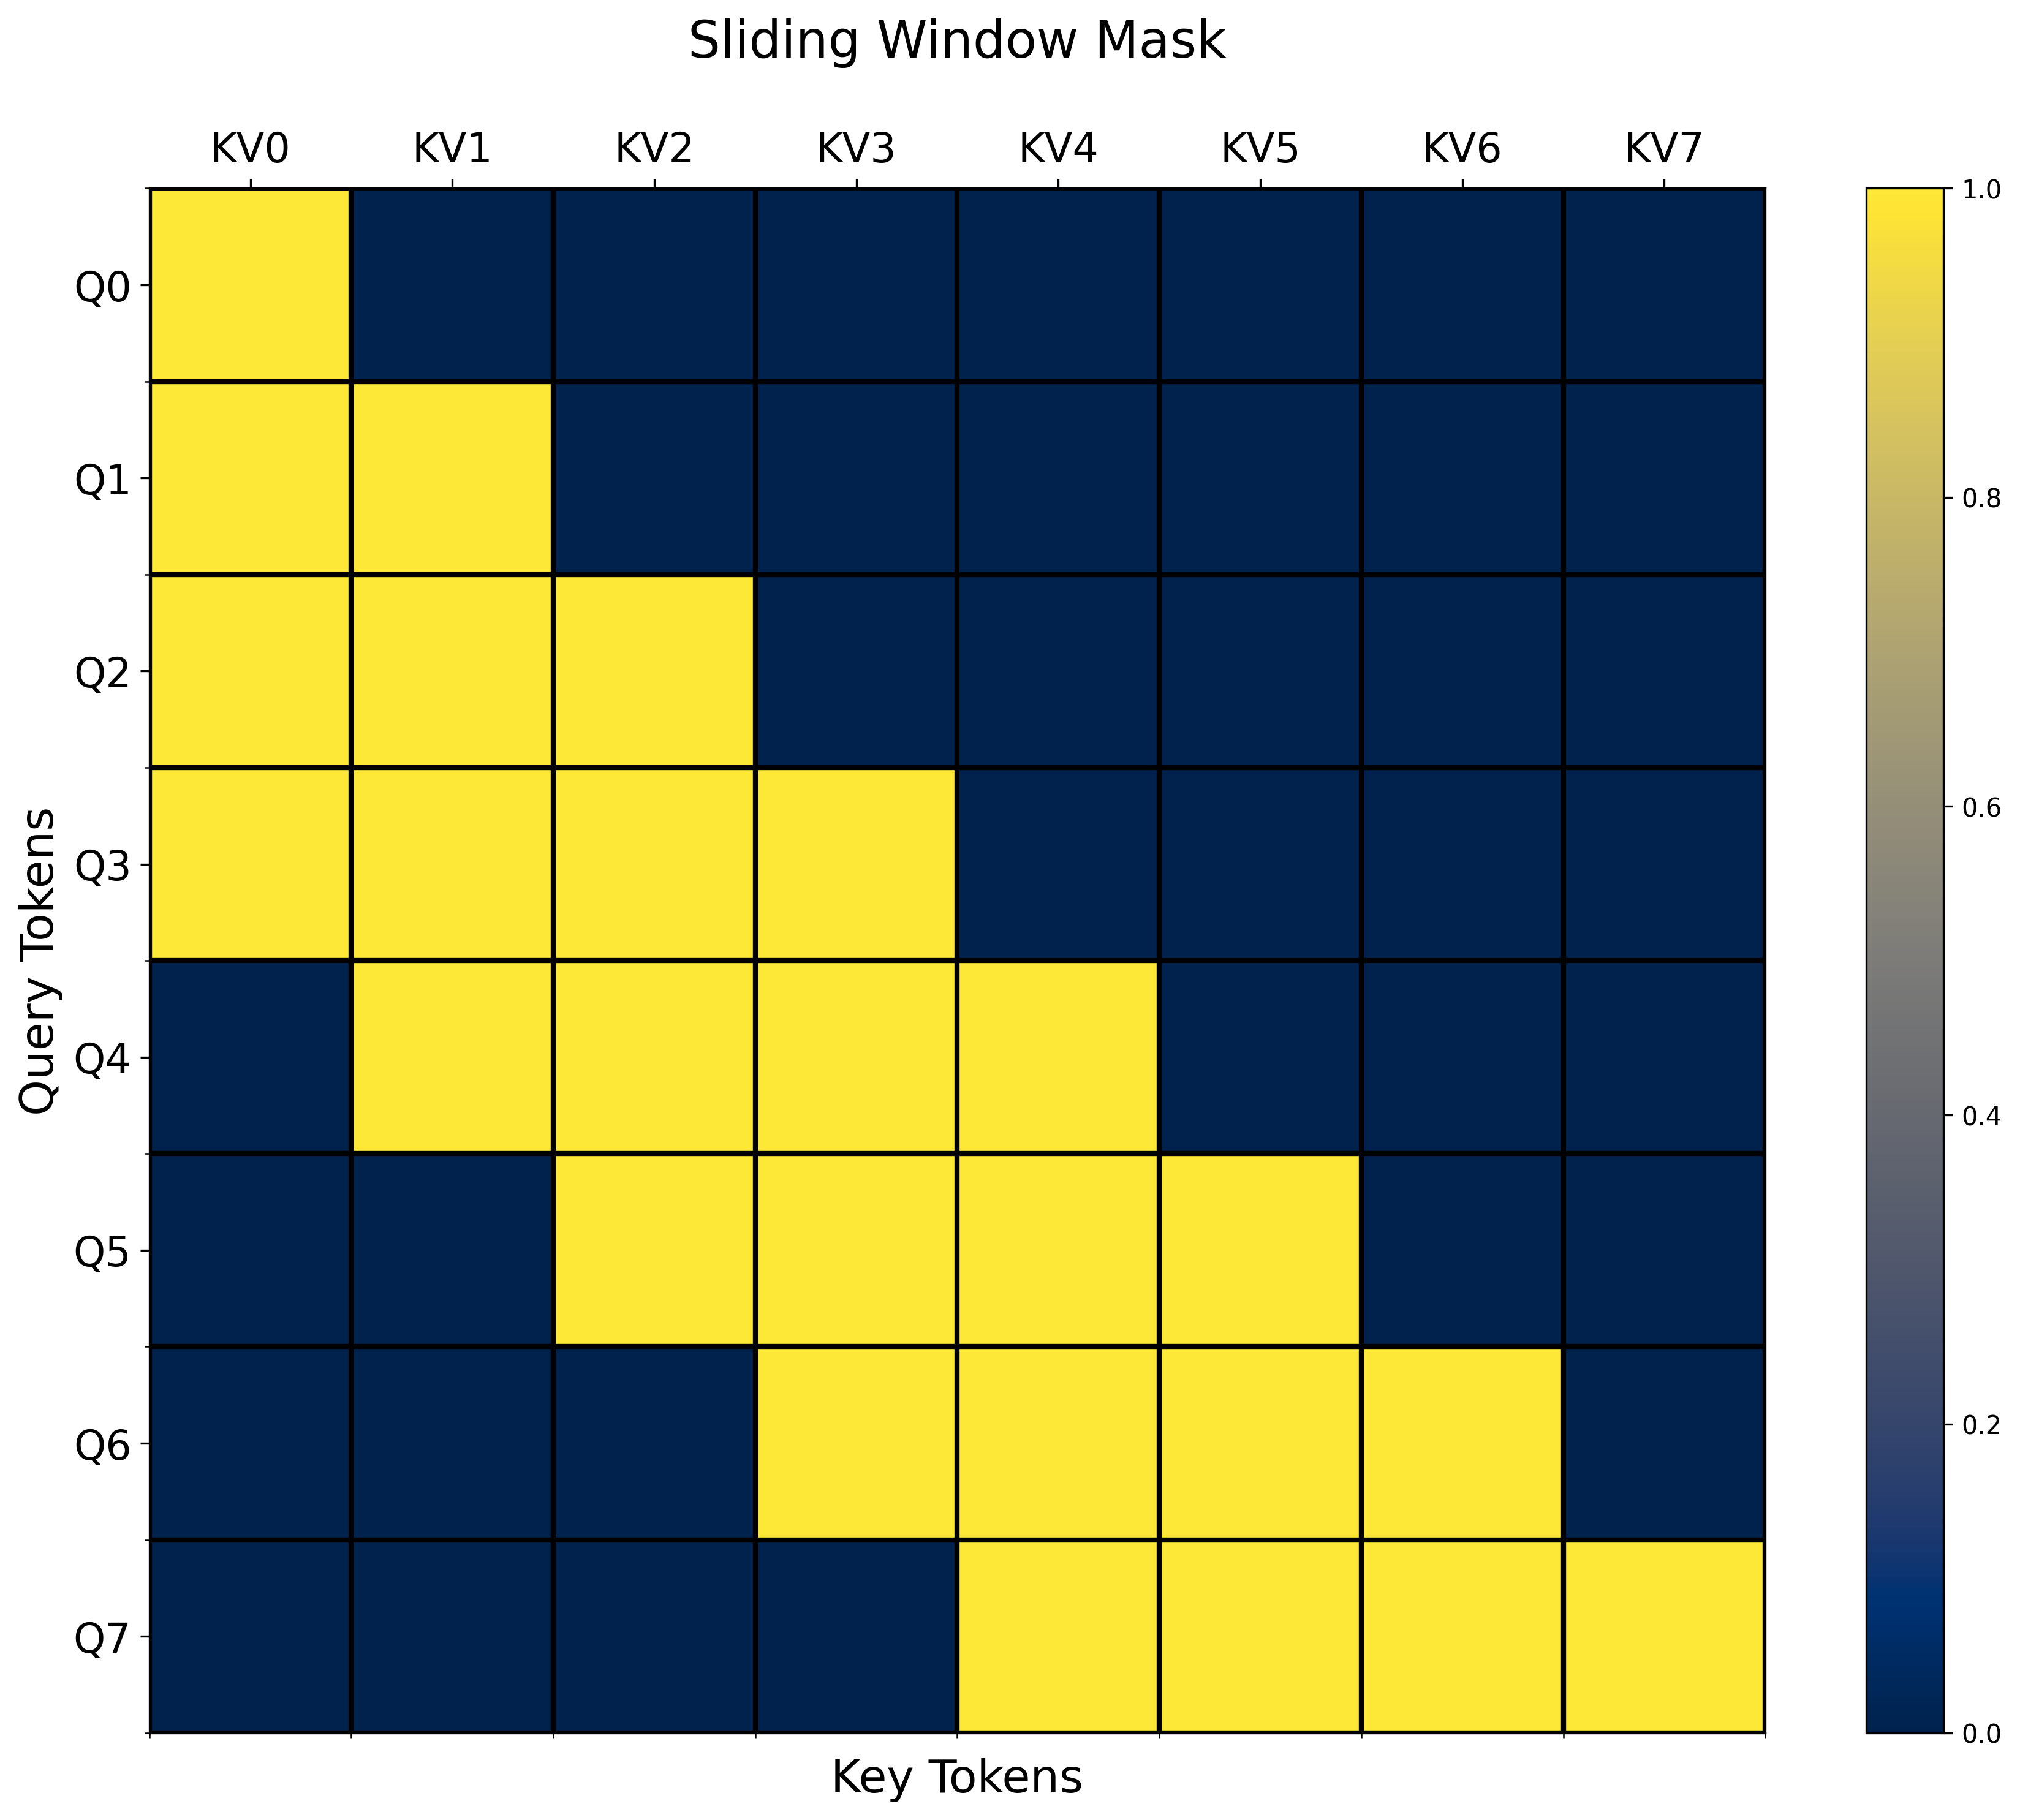
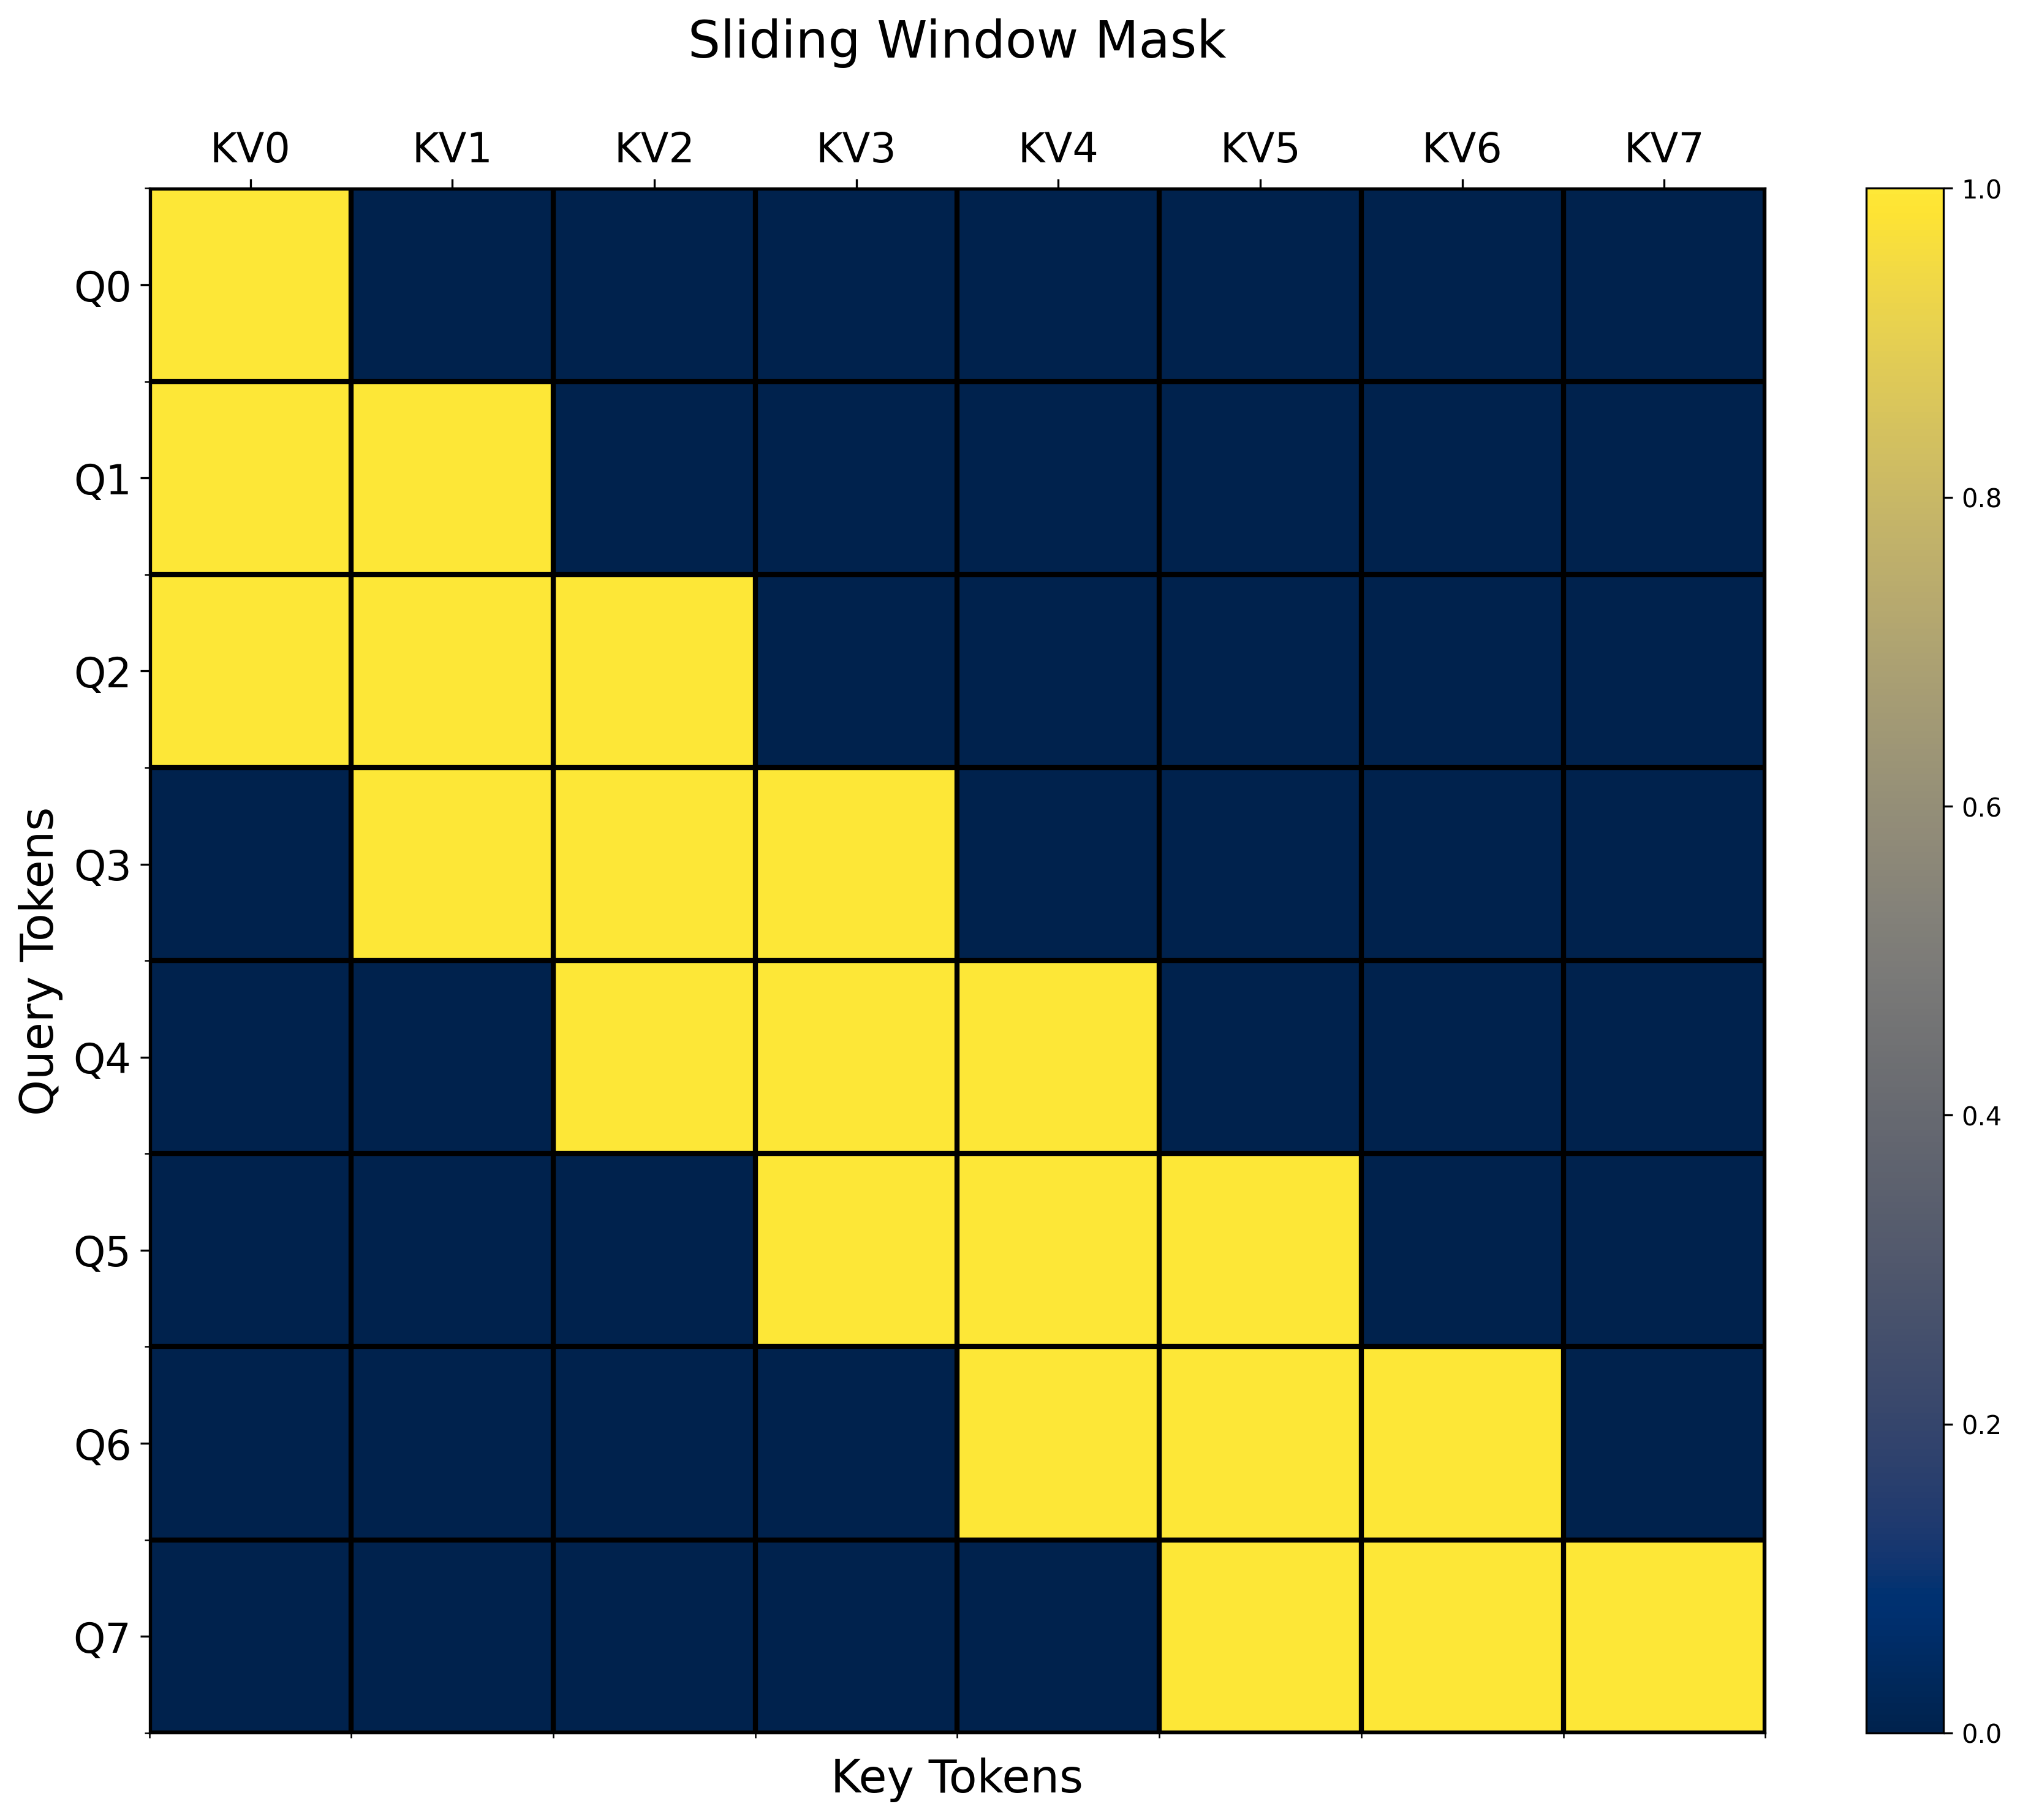
**Interessante Erkenntnis**: Die offizielle Flex-Attention-Sliding-Window-Implementierung betrachtet die Fenstergröße als die Anzahl der letzten Tokens **PLUS EINS** da sie das aktuelle Token einschließt. Die HuggingFace- und GPT-OSS-Implementierungen sehen strikt nur die letzten N Tokens. Also stammt das Folgende aus und :
{% code overflow="wrap" %}
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW
return causal_mask & window_mask
```
{% endcode %}
{% columns %}
{% column %}
Standard-Flex-Attention (3+1 Tokens)
{% endcolumn %}
{% column %}
HuggingFace, GPT-OSS (3+0 Tokens)
{% endcolumn %}
{% endcolumns %}
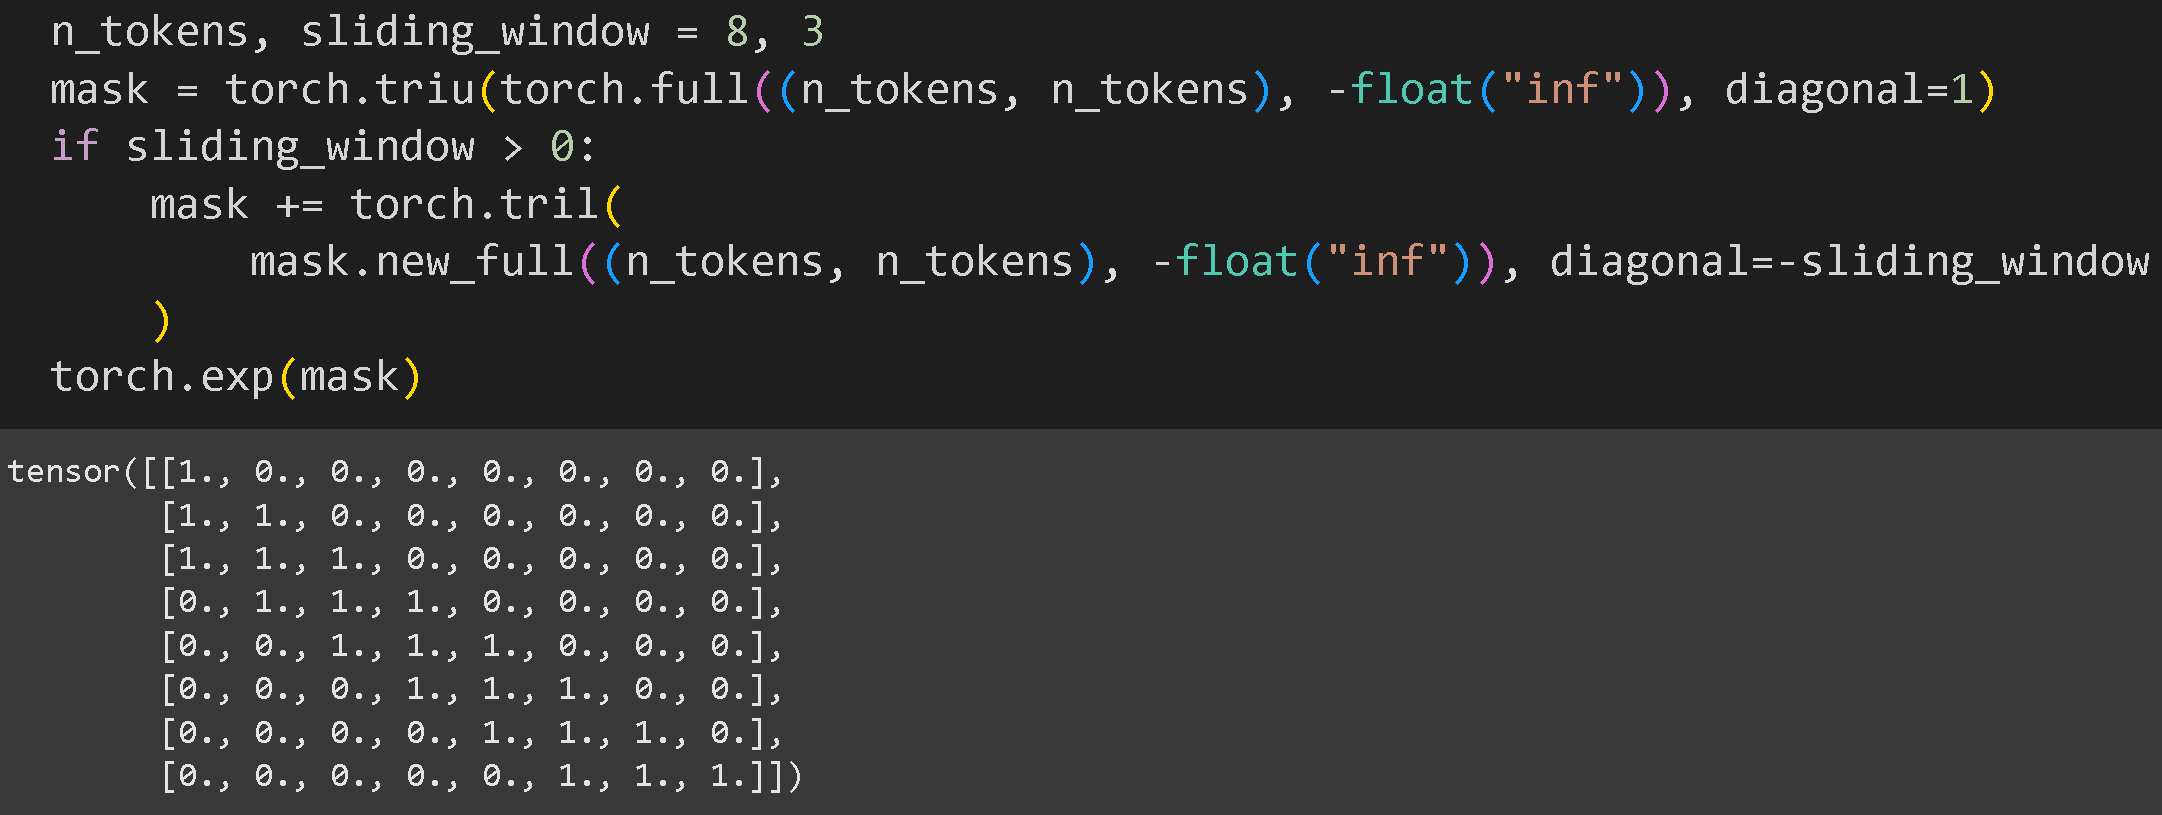
Wir haben auch anhand der offiziellen GPT-OSS-Implementierung von OpenAI bestätigt, ob hier die letzten N oder N+1 Tokens berücksichtigt werden:
```python
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
```
Und wir sehen, dass nur die letzten 3 Tokens (nicht 3+1) berücksichtigt werden! Das bedeutet, dass statt `<= SLIDING_WINDOW`, verwenden Sie `< SLIDING_WINDOW` (also kleiner als, nicht gleich).
```python
def sliding_window_causal(b, h, q_idx, kv_idx):
causal_mask = q_idx >= kv_idx
window_mask = q_idx - kv_idx <= SLIDING_WINDOW # Standard-Flex-Attention
window_mask = q_idx - kv_idx < SLIDING_WINDOW # GPT-OSS-Version
return causal_mask & window_mask
```
Außerdem müssen wir, da wir den Sink-Token-Index an den Anfang verschoben haben, 1 zu q\_idx addieren, um korrekt zu indizieren:
```python
def causal_mask_with_sink(batch, head, q_idx, kv_idx):
"""
0 1 2 3 0 1 2 3
0 X X 1 X
1 X X X 2 X X
2 X X X X 3 X X X
"""
# Wir addieren (q_idx + 1), da die erste Spalte das Sink-Token ist
causal_mask = (q_idx + 1) >= kv_idx
sink_first_column = kv_idx == 0
return causal_mask | sink_first_column
```
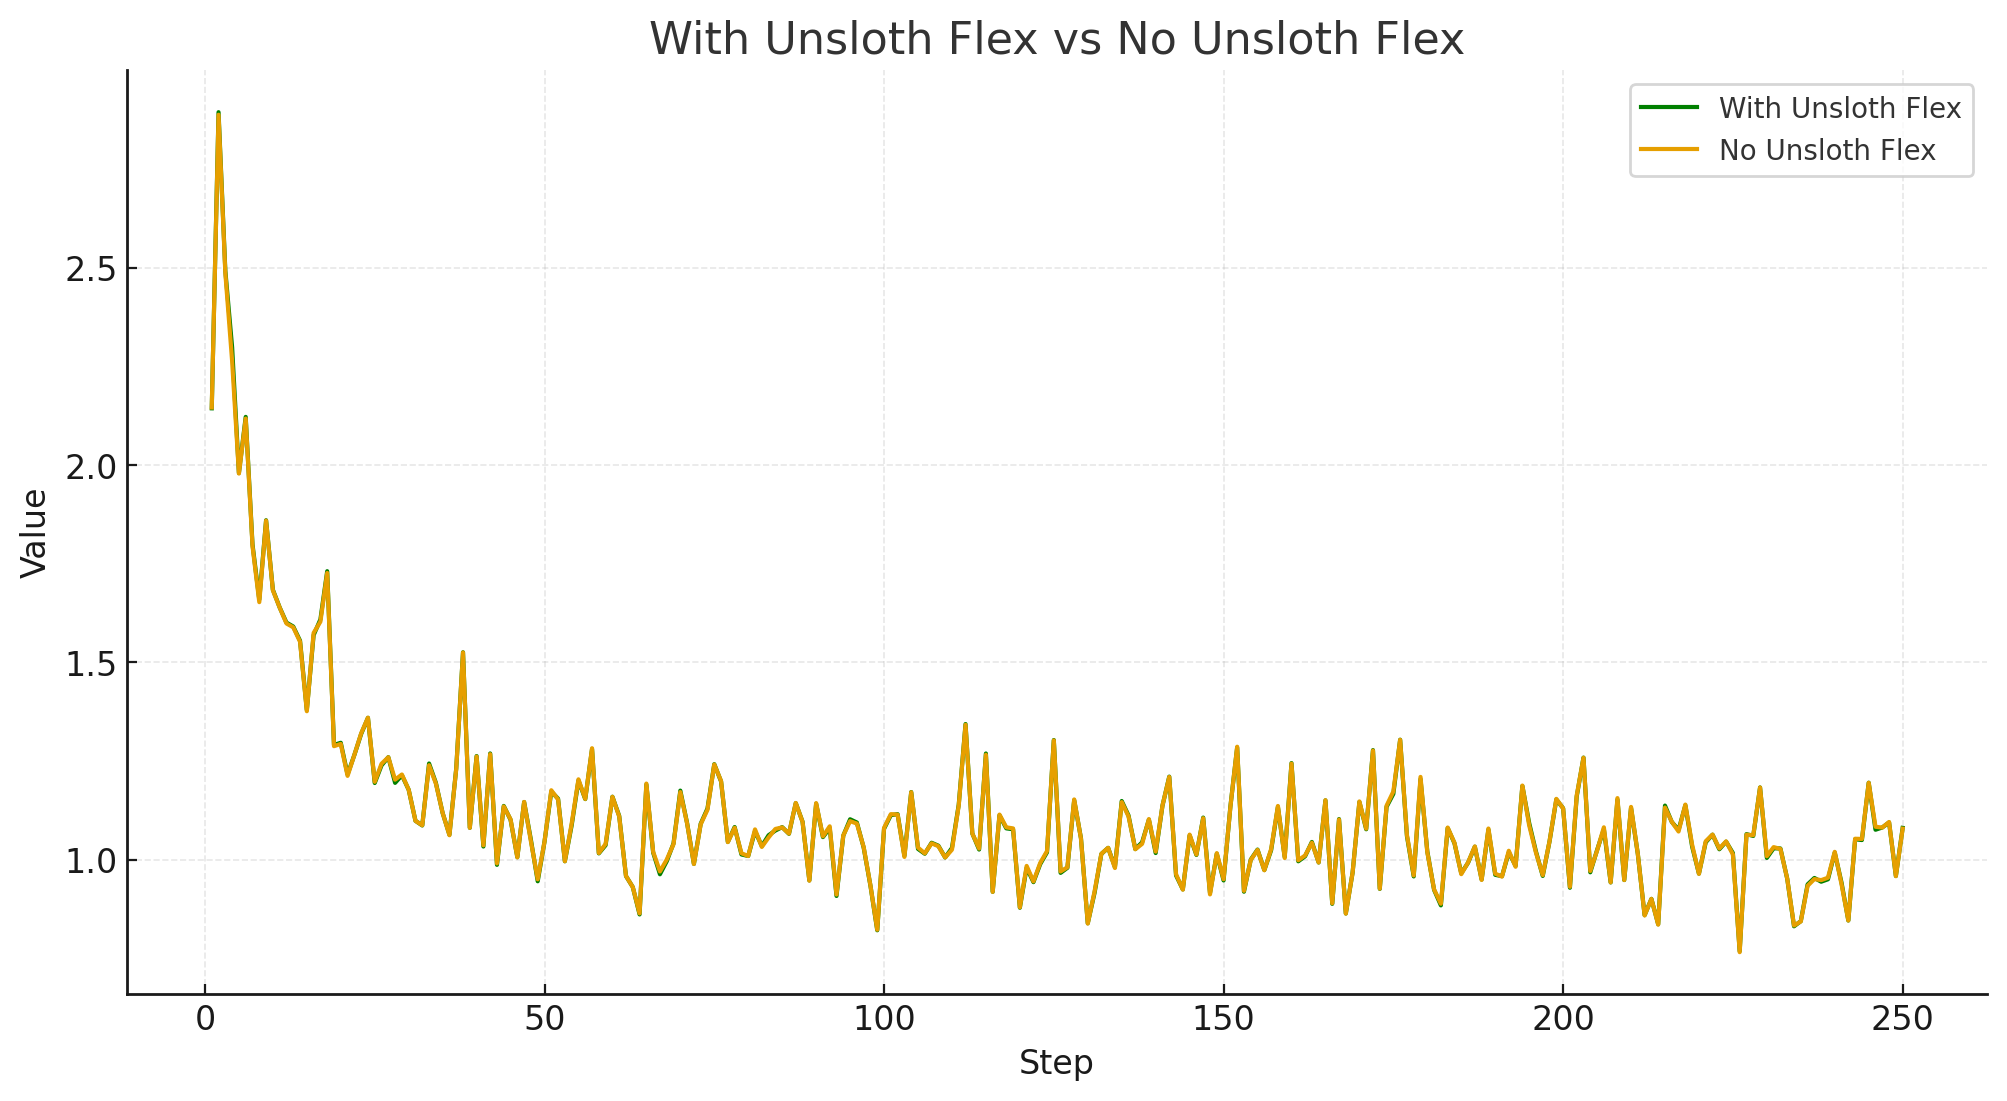
Um unsere Implementierung mit Index 0 zu bestätigen, haben wir überprüft, dass der Trainingsverlust mit Standardläufen von Hugging Face (ohne Unsloth Flex Attention) konsistent bleibt, wie in unserer Grafik gezeigt:
## :scroll: Mathematische Herleitung für Attention-Sinks
Es gibt noch eine andere Möglichkeit, die Attention-Sinks ohne Padding von K und V zu berechnen. Zuerst beachten wir die Softmax-Operation, und wir möchten vorerst die zweite Version mit Sinks als Skalar:
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
A\_{sink}(x) = \frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}}
$$
Wir können die LogSumExp von Flex Attention über `return_lse = True` , und so machen wir:
$$
A(x) = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \\
\frac{\exp(x\_i)}{\exp{(s)}+ \sum{\exp{(x\_i)}}} = \frac{\exp(x\_i)}{\sum{\exp{(x\_i)}}} \frac{\sum{\exp{(x\_i)}}}{\exp{(s)}+ \sum{\exp{(x\_i)}}} \\
\text{LSE}(x) = \text{logsumexp}(x) = \log{\sum\exp(x\_i)} \\
\exp{(\text{LSE}(x))} = \exp{\big(\log{\sum\exp(x\_i)}\big)} = \sum\exp(x\_i)
$$
Und wir können nun die Sink-Version der Attention leicht herleiten. Wir stellen jedoch fest, dass dieser Prozess einen etwas höheren Fehler aufweist als der Zero-Padding-Ansatz, daher verwenden wir standardmäßig weiterhin unsere ursprüngliche Version.
## 💾**NEU: Speichern in GGUF, vLLM nach dem gpt-oss-Training**
Sie können gpt-oss jetzt mit QLoRA feinabstimmen und das Modell direkt speichern, exportieren oder zusammenführen in **llama.cpp**, **vLLM**, oder **HF** - nicht nur Unsloth. Wir werden hoffentlich bald ein kostenloses Notebook veröffentlichen.
Zuvor war jedes QLoRA-feinabgestimmte gpt-oss-Modell darauf beschränkt, nur in Unsloth ausgeführt zu werden. Wir haben diese Einschränkung aufgehoben, indem wir die Möglichkeit eingeführt haben, in **MXFP4** **nativem Format** mit `save_method="mxfp4"` und **On-Demand-Dekwantisierung von MXFP4** Basismodelle (wie gpt-oss) zu **Ihr feinabgestimmtes Modell im bf16-Format zu exportieren, mit** `save_method="merged_16bit"` .
Der **MXFP4** das native Merge-Format bietet im Vergleich zum **bf16-Format**: Es nutzt bis zu 75 % weniger Speicherplatz, reduziert den VRAM-Verbrauch um 50 %, beschleunigt das Mergen um das 5- bis 10-Fache und ermöglicht eine viel schnellere Konvertierung in **GGUF** Format.
Nach dem Feinabstimmen Ihres gpt-oss-Modells können Sie es zusammenführen in **MXFP4** Format mit:
```python
model.save_pretrained_merged(save_directory, tokenizer, save_method="mxfp4")
```
Wenn Sie es vorziehen, das Modell zusammenzuführen und auf den Hugging-Face Hub zu pushen, verwenden Sie:
```python
model.push_to_hub_merged(repo_name, tokenizer=tokenizer, token=hf_token, save_method="mxfp4")
```
Zur Inferenz auf dem zusammengeführten Modell können Sie unter anderem vLLM und Llama.cpp verwenden. OpenAI empfiehlt diese [Inferenz-Einstellungen](/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune.md#recommended-settings) für beide Modelle: `temperature=1.0`, `top_p=1.0`, `top_k=0`
#### :sparkles: Speichern nach Llama.cpp
1. Holen Sie sich die neueste `llama.cpp` auf [hier auf GitHub](https://github.com/ggml-org/llama.cpp). Sie können auch die folgenden Build-Anweisungen befolgen. Ändern Sie `-DGGML_CUDA=ON` zu `-DGGML_CUDA=OFF` wenn Sie keine GPU haben oder nur CPU-Inferenz möchten.
```bash
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build \\
-DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-cli llama-gguf-split
cp llama.cpp/build/bin/llama-* llama.cpp
```
2. Konvertieren Sie das **MXFP4** zusammengeführte Modell:
```bash
python3 llama.cpp/convert_hf_to_gguf.py gpt-oss-finetuned-merged/ --outfile gpt-oss-finetuned-mxfp4.gguf
```
3. Inference auf dem quantisierten Modell ausführen:
```bash
llama.cpp/llama-cli --model gpt-oss-finetuned-mxfp4.gguf \\
--jinja -ngl 99 --threads -1 --ctx-size 16384 \\
--temp 1.0 --top-p 1.0 --top-k 0 \\
-p "The meaning to life and the universe is"
```
✨ Speichern nach SGLang
1. Bauen Sie SGLang aus dem Quellcode:\\\\
```bash
# aus dem Quellcode bauen
git clone https://github.com/sgl-project/sglang
cd sglang
pip3 install pip --upgrade
pip3 install -e "python[all]"
# ROCm 6.3
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/rocm6.3
git clone https://github.com/triton-lang/triton
cd python/triton_kernels
pip3 install .
# Hopper
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu126
pip3 install sgl-kernel==0.3.2
# Blackwell cu128
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu128
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2+cu128-cp39-abi3-manylinux2014_x86_64.whl
# Blackwell cu129
pip3 install torch==2.8.0 torchvision torchaudio --index-url https://download.pytorch.org/whl/test/cu129
pip3 install https://github.com/sgl-project/whl/releases/download/v0.3.2/sgl_kernel-0.3.2-cp39-abi3-manylinux2014_x86_64.whl
```
2. Starten Sie den SGLang-Server:\\\\
```bash
python3 -m sglang.launch_server --model-path ./gpt-oss-finetuned-merged/
```
3. Inference ausführen:\\\\
```python
import requests
from sglang.utils import print_highlight
url = f"http://localhost:8000/v1/chat/completions"
data = {
"model": "gpt-oss-finetuned-merged",
"messages": [{"role": "user", "content": "What is the capital of France?"}],
}
response = requests.post(url, json=data)
print_highlight(response.json())
```
### :diamonds:gpt-oss direkt feinabstimmen
Wir haben außerdem Unterstützung für das direkte Feinabstimmen von gpt-oss-Modellen hinzugefügt, indem wir Patches implementiert haben, die das Laden des nativen MXFP4-quantisierten Formats ermöglichen. Dadurch ist es möglich, das Modell 'openai/gpt-oss' mit weniger als 24 GB VRAM zu laden und per QLoRA feinabzustimmen. Laden Sie das Modell einfach mit:
```python
model, tokenizer = FastLanguageModel.from_pretrained(
# model_name = "unsloth/gpt-oss-20b-BF16",
model_name = "unsloth/gpt-oss-20b",
dtype = dtype, # None für automatische Erkennung
max_seq_length = max_seq_length, # Wähle irgendetwas für langen Kontext!
load_in_4bit = True, # 4 bit quantization to reduce memory
full_finetuning = False, # [NEW!] We have full finetuning now!
# token = "hf_...", # verwende einen, wenn du gesperrte Modelle nutzt
)
```
eine Peft-Schicht hinzufügen mit `FastLanguageModel.get_peft_model` und SFT-Feinabstimmung über das Peft-Modell ausführen.
## 🐛Fehlerbehebungen für gpt-oss
Wir [kürzlich mit Hugging Face zusammengearbeitet](https://github.com/huggingface/transformers/pull/40197) um Inferenzprobleme zu beheben, indem OpenAIs Kernel verwendet und sichergestellt wurde, dass `swiglu_limit = 7.0` während der MXFP4-Inferenz korrekt angewendet wird.
Auf Grundlage des Nutzerfeedbacks stellten wir fest, dass verlängerte QLoRA-Trainingsläufe (über 60 Schritte hinaus) dazu führen konnten, dass der **Verlust divergiert und schließlich mit einem Fehler abbricht**. Dieses Problem trat nur auf Geräten auf, die BF16 nicht unterstützen und stattdessen auf F16 zurückfallen (z. B. T4-GPUs). Wichtig ist, dass dies das QLoRA-Training auf A100- oder H100-GPUs nicht beeinträchtigte, ebenso wenig das LoRA-Training auf f16-GPUs.
**Nach umfangreichen Untersuchungen haben wir nun das Verhalten des Trainingsverlusts über alle GPU-Setups hinweg angeglichen, einschließlich GPUs, die auf F16 beschränkt sind**. Wenn Sie zuvor aufgrund dessen Probleme hatten, empfehlen wir Ihnen, unser neues aktualisiertes gpt-oss-Notebook zu verwenden!
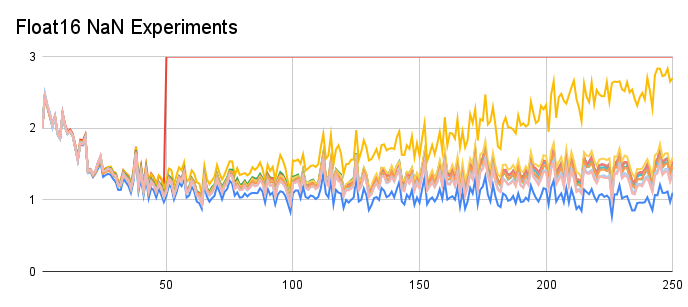
Wir mussten viele, viele Experimente durchführen, um die Trainingsverlustkurve von float16 so anzupassen, dass sie den bfloat16-Maschinen (blaue Linie) entspricht. Wir haben Folgendes festgestellt:
1. **Reines float16 geht bei Schritt 50 ins Unendliche**
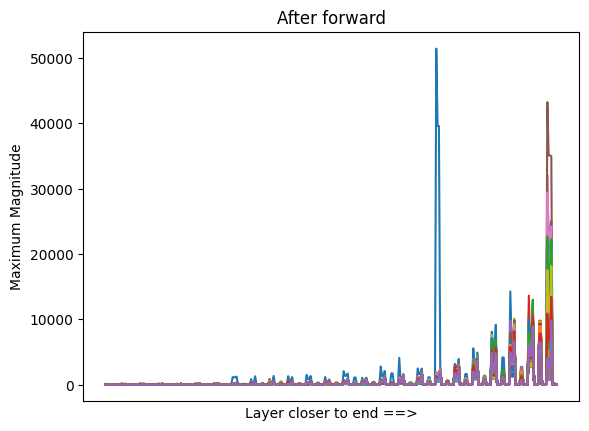
2. **Wir fanden heraus, dass die Down-Projektionen im MoE enorme Ausreißer aufweisen**
3. **Aktivierungen müssen in bfloat16 oder float32 gespeichert werden**
**Unten sind die absoluten Aktivierungsbeträge für GPT OSS 20B dargestellt, und einige haben wirklich starke Spitzen – das führt auf float16-Maschinen zu einem Overflow, da der maximale Bereich von float16 65504 beträgt.**
**Wir haben dies in Unsloth behoben, sodass das gesamte float16-Training sofort funktioniert!**
## :1234: Implementierungen für Sink-Attention
OpenAIs Sink-Token-Implementierung ist [hier bereitgestellt](https://github.com/openai/gpt-oss/blob/main/gpt_oss/torch/model.py). Wir stellen sie unten bereit:
{% code fullWidth="false" %}
```python
def sdpa(Q, K, V, S, sm_scale, sliding_window=0):
# sliding_window == 0 bedeutet kein Sliding Window
n_tokens, n_heads, q_mult, d_head = Q.shape
assert K.shape == (n_tokens, n_heads, d_head)
assert V.shape == (n_tokens, n_heads, d_head)
K = K[:, :, None, :].expand(-1, -1, q_mult, -1)
V = V[:, :, None, :].expand(-1, -1, q_mult, -1)
S = S.reshape(n_heads, q_mult, 1, 1).expand(-1, -1, n_tokens, -1)
mask = torch.triu(Q.new_full((n_tokens, n_tokens), -float("inf")), diagonal=1)
if sliding_window > 0:
mask += torch.tril(
mask.new_full((n_tokens, n_tokens), -float("inf")), diagonal=-sliding_window
)
QK = torch.einsum("qhmd,khmd->hmqk", Q, K) * sm_scale
QK += mask[None, None, :, :]
QK = torch.cat([QK, S], dim=-1)
W = torch.softmax(QK, dim=-1)
W = W[..., :-1]
attn = torch.einsum("hmqk,khmd->qhmd", W, V)
return attn.reshape(n_tokens, -1)
```
{% endcode %}
Die HuggingFace-Transformers-Implementierung ist [hier bereitgestellt](https://github.com/huggingface/transformers/blob/main/src/transformers/models/gpt_oss/modeling_gpt_oss.py). Wir stellen sie ebenfalls unten bereit:
{% code fullWidth="false" %}
```python
def eager_attention_forward(
module: nn.Module,
query: torch.Tensor,
key: torch.Tensor,
value: torch.Tensor,
attention_mask: Optional[torch.Tensor],
scaling: float,
dropout: float = 0.0,
**kwargs,
):
key_states = repeat_kv(key, module.num_key_value_groups)
value_states = repeat_kv(value, module.num_key_value_groups)
attn_weights = torch.matmul(query, key_states.transpose(2, 3)) * scaling
if attention_mask is not None:
causal_mask = attention_mask[:, :, :, : key_states.shape[-2]]
attn_weights = attn_weights + causal_mask
sinks = module.sinks.reshape(1, -1, 1, 1).expand(query.shape[0], -1, query.shape[-2], -1)
combined_logits = torch.cat([attn_weights, sinks], dim=-1)
# Dies war nicht in der ursprünglichen Implementierung enthalten und beeinflusst die Ergebnisse leicht; es verhindert ein Überlaufen in BF16/FP16
# Bei Training mit bsz>1 begrenzen wir die Maximalwerte.
combined_logits = combined_logits - combined_logits.max(dim=-1, keepdim=True).values
probs = F.softmax(combined_logits, dim=-1, dtype=combined_logits.dtype)
scores = probs[..., :-1] # wir entfernen hier den Sink
attn_weights = nn.functional.dropout(scores, p=dropout, training=module.training)
attn_output = torch.matmul(attn_weights, value_states)
attn_output = attn_output.transpose(1, 2).contiguous()
return attn_output, attn_weights
```
{% endcode %}
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://unsloth.ai/docs/de/modelle/gpt-oss-how-to-run-and-fine-tune/long-context-gpt-oss-training.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.